

Разработка библиотеки для создания PDF-файлов на MQL5 (Часть 1): Формируем PDF-файл вручную
 22
 0

Содержание
- Введение
- PDF — это текстовый файл
- Восемь типов значений
- Косвенные объекты: нумерация объектов, позволяющая ссылаться на них
- Четыре объекта, необходимые каждой странице
- Запись файла hello.pdf построчно
- Чтение потока содержимого
- Индекс в конце файла
- Открытие файла
- Доработка до документа, который стоит отправить
- Создание PDF средствами MQL5
- Когда что-то идет не так
- Шпаргалка
- Структура проекта
- Заключение
Введение
Рано или поздно любому инструменту для торговли приходится предоставлять человеку документ. Выписка для инвестора, подписанный тикет сделки, ежемесячный отчет о результатах торговли, квитанция для проверки проп-фирмой. Терминал предоставляет выписку в формате HTML. HTML работает нормально, пока кто-нибудь не распечатает его, не отправит по электронной почте или не откроет на телефоне. Тогда столбцы смещаются, а разрывы страниц могут оказаться посреди таблицы.
В PDF ничего не сдвигается. Именно ради этого он и существует. PDF-файл задаёт положение каждого символа так, что даже программа просмотра, написанная через двадцать лет, будет трактовать его точно так же.
Очевидное возражение: с PDF наверняка сложно работать. У него такая репутация: двоичный формат, сотни страниц спецификации, целая индустрия библиотек, созданных, чтобы скрыть все эти сложности. В MQL5 нет функции для работы с PDF, внешние библиотеки недоступны без DLL, и непонятно, с чего начать.
Эта репутация в основном не соответствует действительности. В этой статье объясняется, почему. PDF — это текстовый файл с индексом в конце. Такой файл можно набрать в «Блокноте». К концу этой статьи вы вручную наберёте два таких файла, откроете их в программе просмотра и будете понимать значение каждого введённого символа.
Это первая часть серии статей, посвящённой созданию полнофункциональной библиотеки PDF на чистом языке MQL5 без использования DLL-библиотек и внешних зависимостей. Но начинается серия вообще без библиотеки: читатель, который вручную создал рабочий PDF-файл, сможет отладить и файл, сгенерированный программой. А тот, кто этого не сделал, никогда не сможет.
Вот что вы наберёте к концу этой статьи.
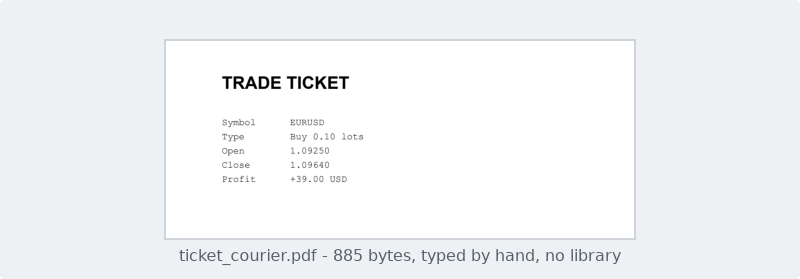
Рисунок 1. Тикет сделки, который мы наберём вручную в этой статье, — 885 байт.
Эта страница создана без использования библиотек. Это 885 байт текста, который можно было бы написать на салфетке, и такой файл открывается в Acrobat, Chrome, Preview и на телефоне.
PDF — это текстовый файл
Возьмите любой PDF-файл на вашем компьютере — не отсканированный, а сформированный программой — и откройте его в «Блокноте». Не в программе просмотра. В «Блокноте».
Вверху вы увидите примерно следующее:
%PDF-1.4
1 0 obj
<< /Type /Catalog /Pages 2 0 R >>
endobj
Это читается. Он не зашифрован и не скомпилирован. Дальше вы наткнётесь на стену нечитаемых символов — там хранятся изображения и сжатые потоки, — но каркас документа представляет собой обычный текст, и именно этот каркас держит PDF-файл воедино.
Каждый файл PDF — от 300-страничной книги до того, который мы собираемся написать, — состоит из одних и тех же пяти областей, расположенных в одном и том же порядке.
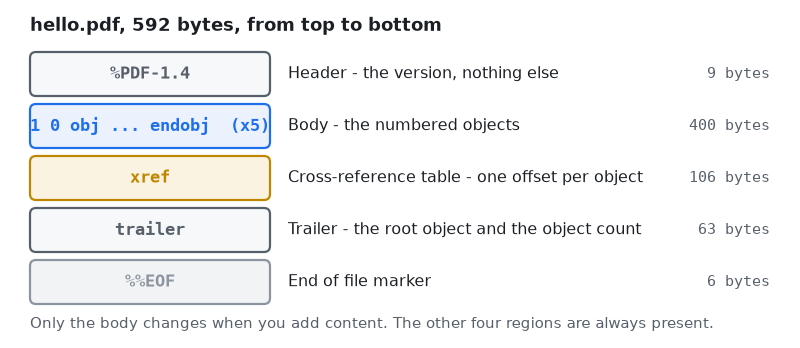
Рисунок 2. Пять областей, которые содержатся в каждом файле PDF, в порядке их следования.
Рассматривайте этот рисунок сверху вниз. Заголовок — это одна строка, в которой указана версия. Тело представляет собой список пронумерованных объектов и является единственной областью, размер которой увеличивается при добавлении содержимого — в нашем файле объемом 592 байта на него приходится 400 из этих байтов. Таблица перекрестных ссылок, которая всегда обозначается как xref, представляет собой указатель: каждая строка соответствует одному объекту и указывает, в каком месте файла начинается этот объект. В трейлере указано, какой объект является корневым объектом документа и сколько всего объектов. Затем %%EOF.
Четыре из этих пяти областей практически одинаковы во всех когда-либо созданных PDF-файлах. Только тело содержит ваш документ. Вот и первая хорошая новость: большая часть PDF-файла состоит из шаблонных конструкций, а их легко генерировать.
Вторая хорошая новость заключается в том, что тело PDF-файла представляет собой плоский список. Объекты не вложены друг в друга. Они расположены рядом, пронумерованы 1, 2, 3 и ссылаются друг на друга по номерам, как строки в таблице базы данных. Страница не содержит своего содержимого, а лишь ссылается на него.
Восемь типов значений
Прежде чем записывать объекты, нужно познакомиться с лексикой, используемой для их записи. В PDF существует ровно восемь типов значений, и шесть из них вам уже знакомы по другим языкам. Весь формат построен на основе этой таблицы, поэтому её стоит читать внимательно.
| Тип | Форма записи | Примечания |
|---|---|---|
| Логическое значение | true/false | Редко используется. |
| Число | 42, -3.5 | Экспоненциальная запись не допускается. 1e6 — недопустимая запись. |
| Строка | (Hello) | Круглые скобки. \( — запись экранированной скобки. |
| Имя | /Type/Helvetica | Косая черта и слово. Это ключ, а не текст. |
| Массив | [3 0 R] | Элементы заключаются в квадратные скобки и разделяются пробелами; допускаются элементы разных типов. |
| Словарь | << /Key value >> | Двойные угловые скобки. Ключи всегда представляют собой имена. |
| Поток | << ... >> stream ... endstream | Словарь и блок необработанных байтов. |
| Null | null | Редко используется. |
То, что зачастую сбивает людей с толку, — это разница между именем и строкой. /Helvetica и (Helvetica) — это не одно и то же значение. Имя — это идентификатор, понятный самому формату: ключ в словаре, имя шрифта, тип объекта. Строка — это текст, который нужно вывести на страницу. Если вы напишете (Type) вместо /Type, программа просмотра не распознает этот ключ и будет вести себя так, будто он отсутствует.
Еще один тип, на котором стоит остановиться, — это поток. Поток представляет собой словарь, к концу которого присоединен блок байтов, причём в словаре должен присутствовать ключ /Length, указывающий точный размер этого блока. В PDF потоки служат для хранения любых объёмных данных: команд рисования страницы, пикселей изображения, контуров встроенного шрифта. В этой статье мы используем ровно один поток.
Косвенные объекты: нумерация для ссылок на них
Объект в теле файла обрамляется заголовком и завершающей строкой, которые задают его номер:
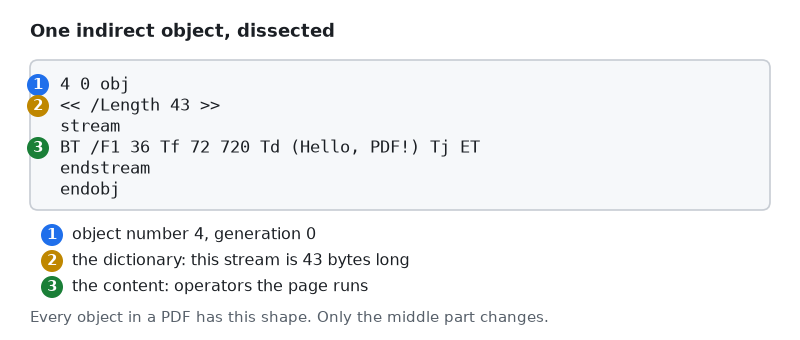
Рисунок 3. Один косвенный объект — от его номера до endobj.
Обратите внимание на первую строку на этом рисунке. 4 0 obj означает «объект № 4, поколение 0». Номер поколения нужен для того, чтобы файл можно было редактировать на месте, не перезаписывая его; для файла, который мы создаём с нуля, он всегда равен 0, и вы можете не обращать на него внимания, пока в части 2 не будет объяснено, где он снова появляется.
Всё, что находится между этой строкой и endobj, представляет собой значение объекта. На рисунке 3 это значение представляет собой поток: словарь с записью /Length 43, затем слово stream, далее 43 байта команд рисования и, наконец, endstream.
В любом другом месте файла 4 0 R означает «значение объекта 4». Буква R — сокращение от reference («ссылка»). Именно на этом механизме построен весь формат: объекты никогда не содержат других объектов, а обозначают их с помощью номеров. Таким образом, страница не содержит сам поток содержимого — вместо этого в ней указано /Contents 4 0 R. Страница не содержит сам шрифт — вместо этого в ней указано /F1 5 0 R.
Именно благодаря таким косвенным ссылкам сборка PDF и повторное использование его объектов требуют мало ресурсов. На один объект шрифта могут ссылаться четыреста страниц. Логотип можно нарисовать один раз и везде ссылаться на него. Именно поэтому и существует таблица перекрестных ссылок: если поиск ведётся по номерам, то что-то должно преобразовывать номер в позицию в файле.
Четыре объекта, необходимые для каждой страницы
Для одностраничного файла PDF требуется четыре объекта и ещё по одному для каждого используемого шрифта. Они образуют цепочку.
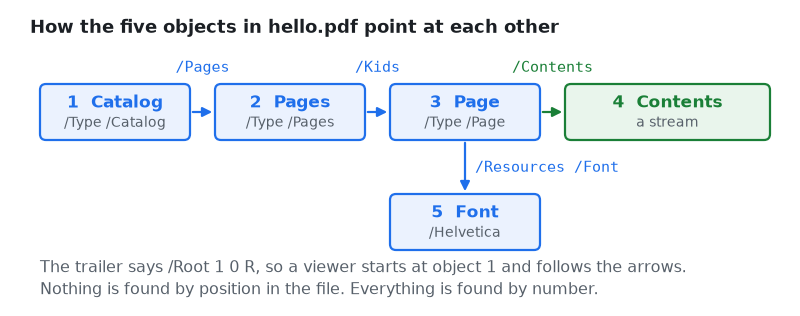
Рисунок 4. Как пять объектов файла hello.pdf ссылаются друг на друга.
Начните слева и следуйте по стрелкам. Каталог — корневой объект документа; трейлер указывает на него с помощью /Root 1 0 R, поэтому программа просмотра обращается к нему первым. Каталог указывает на дерево страниц, представляющее собой список страниц с указанием их количества. Дерево страниц указывает на страницу, в которой хранятся данные о формате бумаги и список ресурсов, которые разрешено использовать на этой странице. Страница указывает на свой поток содержимого — единственный объект во всём файле, который отвечает за рисование, — а также на необходимый ей шрифт.
Для одной страницы дерево страниц выглядит как излишняя бюрократия — и в этом случае так оно и есть. Оно оправдывает себя в документе на 400 страниц: при переходе к странице 380 программа просмотра обходит сбалансированное дерево вместо списка. Формат не предусматривает упрощённого варианта для небольших файлов, поэтому приходится добавлять две лишние строки.
Обратите внимание на то, чего нет на схеме: ничто не указывает назад, как бы говоря: «Я — седьмой элемент в файле». Позиция в файле не имеет абсолютно никакого значения. Объекты можно записывать в любом порядке, главное, чтобы таблица перекрестных ссылок в конце файла указывала, где находится каждый из них.
Запись файла hello.pdf построчно
Откройте «Блокнот». Не Word, не MetaEditor — «Блокнот» или любой другой редактор, который сохраняет обычный текст, ничего к нему не добавляя. Введите приведённый ниже текст и внимательно следите за пробелами внутри блока xref: мы ещё к этому вернёмся.
%PDF-1.4
1 0 obj
<< /Type /Catalog /Pages 2 0 R >>
endobj
2 0 obj
<< /Type /Pages /Kids [3 0 R] /Count 1 >>
endobj
3 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 595 842]
   /Resources << /Font << /F1 5 0 R >> >>
   /Contents 4 0 R >>
endobj
В первой строке указана версия. Это должна быть первая строка, и перед ней не должно быть ничего — ни пустой строки, ни маркера порядка байтов. Если ваш редактор из благих намерений добавит BOM, файл не откроется; это самая распространённая причина, по которой PDF-файл, созданный вручную, отказывается открываться, и в диалоговом окне «Сохранить как» программы «Блокнот» в раскрывающемся списке кодировок необходимо выбрать ANSI или UTF-8, а не «UTF-8 с BOM».
Объект 1 состоит из четырёх слов. /Type /Catalog указывает, что это за объект, а /Pages 2 0 R — где находится список страниц.
В объекте 2 приведен список страниц. /Kids — это массив, содержащий одну ссылку, а /Count 1 указывает количество страниц, расположенных ниже этого узла. Оба параметра обязательны, и если значение параметра /Count не совпадает с количеством дочерних элементов, некоторые программы просмотра будут отображать пустой документ, а не выдавать ошибку.
Объект 3 — это страница. В нём два параметра важнее всех остальных:
- /MediaBox [0 0 595 842] задаёт границы листа в формате [левая граница, нижняя граница, правая граница, верхняя граница] в пунктах, где один пункт равен 1/72 дюйма. Размер листа формата A4 составляет 210 × 297 мм, что соответствует 595 × 842 пунктам. Для формата US Letter значения будут такими: [0 0 612 792]. В части 4 мы введём на этой основе полноценные единицы измерения; пока достаточно знать, что 842 — это верхняя граница листа.
- /Resources представляет собой белый список. Страница может использовать только указанные здесь шрифты, изображения и другие ресурсы и ссылается на них по присвоенным им псевдонимам. Мы называем наш шрифт /F1, и /F1 имеет смысл только в пределах этой страницы. Дайте ему имя /Banana — и всё будет работать, главное, чтобы поток содержимого тоже запрашивал /Banana.
А теперь объект, который фактически что-то рисует:
4 0 obj
<< /Length 43 >>
stream
BT
/F1 36 Tf
72 720 Td
(Hello, PDF!) Tj
ET
endstream
endobj
5 0 obj
<< /Type /Font /Subtype /Type1 /BaseFont /Helvetica >>
endobj
/Length 43 — это количество байтов между переводом строки после слова stream и переводом строки перед endstream. Посчитайте байты: BT с переводом строки — 3, /F1 36 Tf — 10, 72 720 Td — 10, (Hello, PDF!) Tj — 17, ET — 3. Три плюс десять плюс десять плюс семнадцать плюс три равно 43.
Если это число неверно, программы просмотра реагируют по-разному, и ни одна из них не сообщает, что произошло. Некоторые считывают /Length байт, а затем ищут endstream там, где он должен находиться согласно словарю; если его там нет, они прекращают обработку. Другие просматривают данные дальше в поисках слова endstream и прощают вам ошибку. Создание файла, который открывается в Chrome, но не открывается в Acrobat, — неприятный способ провести вторую половину дня, поэтому значение /Length должно быть точным, а не приблизительным.
Объект 5 задает шрифт. /BaseFont /Helvetica выбирает один из 14 стандартных шрифтов — четыре начертания Helvetica, четыре Times, четыре Courier, а также Symbol и ZapfDingbats, — которые обязана предоставлять каждая программа просмотра PDF. Поскольку эти шрифты уже есть в программе просмотра, мы ничего не встраиваем. В части 13 мы встроим настоящий файл шрифта для тех, кто хочет использовать собственный фирменный шрифт; пока же каждый из этих четырнадцати шрифтов обходится нам всего в одну строку.
Чтение потока содержимого
Эти пять строк внутри данного потока — первый настоящий код рисования в этой серии, поэтому они заслуживают иллюстрации.
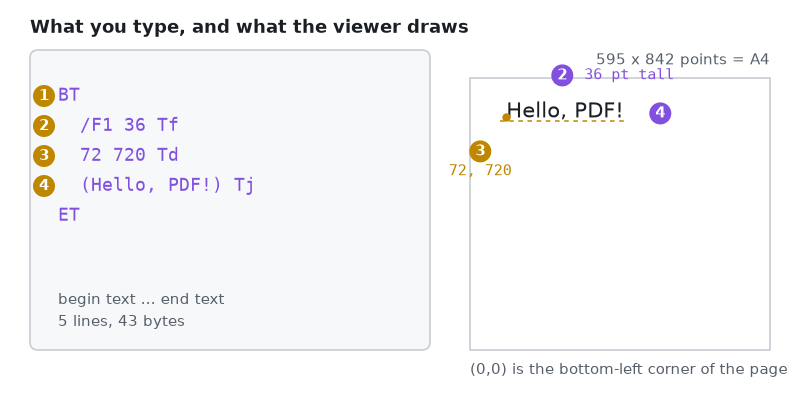
Рисунок 5. Каждый оператор в потоке содержимого и его действие на странице.
В потоке содержимого используется обратная польская запись: сначала идут аргументы, а затем — оператор. 72 720 Td — это не функция с именем 72, а оператор Td, примененный к числам 72 и 720. Как только вы это поймете, вы сможете читать любой поток содержимого в любом PDF-файле.
Рассмотрим рисунок 5 по отдельным маркерам:
- BT — начало текстового объекта. Текст можно выводить только между BT и ET, а позиция пера сбрасывается каждый раз, когда вы записываете BT. Всё, что выходит за пределы этой пары, относится к графике, которая рассматривается в части 4.
- /F1 36 Tf позволяет выбрать шрифт и размер. /F1 — это псевдоним из словаря ресурсов страницы; 36 — размер в пунктах. Если указать неверный псевдоним, ничего не будет выведено — ни сообщения об ошибке, ни текста, только пустая страница.
- 72 720 Td перемещает перо. Числа задают координаты в пунктах, отсчитываемые от левого нижнего угла страницы. Поначалу это удивляет большинство людей: координата y увеличивается вверх, поэтому на листе высотой 842 пункта значение 720 соответствует расстоянию 122 пункта от верхнего края — примерно 43 мм. В части 4 вводится система координат в миллиметрах с началом в левом верхнем углу, чтобы больше никому не приходилось заниматься этими вычислениями.
- (Hello, PDF!) Tj выводит строку в позиции пера. Tj принимает одну строку и выводит ее текущим шрифтом текущего размера, начиная с текущей точки.
ET завершает текстовый объект. Вот и весь «язык» этой статьи: четыре оператора, и каждый из них принимает аргументы, стоящие перед ним.
Индекс в конце файла
Именно последняя область делает создание PDF вручную по-настоящему кропотливым делом.
xref
0 6
0000000000 65535 f
0000000009 00000 n
0000000058 00000 n
0000000115 00000 n
0000000247 00000 n
0000000339 00000 n
trailer
<< /Size 6 /Root 1 0 R >>
startxref
409
%%EOF
0 6 означает «шесть записей, начиная с объекта № 0». Запись с нулевым индексом — это фиксированный заполнитель, стоящий во главе списка удаленных объектов, и в только что записанном файле она всегда имеет значение 0000000000 65535 f. Остальные пять записей соответствуют нашим объектам по порядку.
В каждой записи указано байтовое смещение начала соответствующего объекта относительно начала файла. Объект 1 начинается по байтовому смещению 9, то есть сразу после %PDF-1.4 и перевода строки — восемь символов плюс один. Объект 2 начинается по байтовому смещению 58. Объект 5 начинается по байтовому смещению 339.
Каждая запись имеет длину ровно двадцать байт: десять цифр, пробел, пять цифр, пробел, одна буква-флаг, а затем двухбайтовое окончание строки. Внимательно посмотрите на приведенный выше листинг, и вы заметите пробел после f и после каждой n. Этот пробел — не просто украшение: это девятнадцатый байт, а символ перевода строки — двадцатый. Удалите его — и длина каждой записи составит девятнадцать байт, вычисленная программой просмотра позиция окажется в середине предыдущей строки, и файл не откроется.
startxref 409 указывает байтовое смещение самого слова xref. Чтобы открыть PDF-файл, программа просмотра переходит к концу файла, просматривает его в обратном направлении в поисках startxref, переходит по указанному смещению и считывает индекс. Только тогда она понимает, где что находится.
Именно здесь создание PDF вручную становится непрактичным, и стоит прямо объяснить почему. Добавьте один символ в объект 2 — один пробел, удлините имя на один символ или добавьте ещё одну цифру — и объекты 3, 4 и 5 сдвинутся на один байт дальше от начала файла. Три записи в таблице перекрестных ссылок становятся неверными, значение startxref тоже становится неверным, и файл перестаёт работать. При этом никакого сообщения об ошибке не появляется. Часть 2 целиком посвящена этой проблеме, а в части 3 её решение передаётся компьютеру.
Открытие файла
Сохраните файл под именем hello.pdf. В диалоговом окне сохранения «Блокнота» в поле «Тип файла» выберите «Все файлы», иначе у вас получится файл с именем hello.pdf.txt. Затем дважды щелкните по нему.
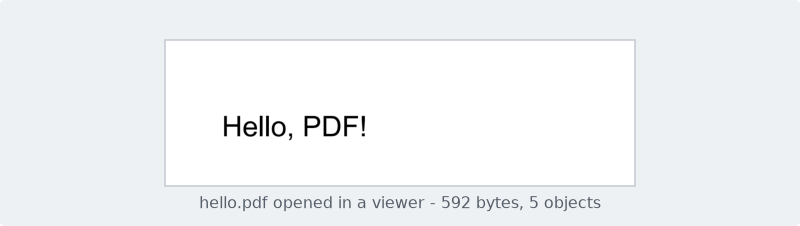
Рисунок 6. Так программа просмотра отображает hello.pdf, созданный вручную из 592 байтов текста.
Это настоящий PDF-файл. В нём заданы размер страницы, шрифт и положение строки с точностью до пункта. Он создан без какой-либо библиотеки, и в нём нет ничего игрушечного: те же пять объектов есть и в PDF-файле, который присылает вам банк.
Если файл не открывается, причина почти всегда в одной из четырёх проблем, перечисленных в порядке убывания вероятности: редактор сохранил маркер порядка байтов (BOM) в начале файла; редактор сохранил файл в кодировке UTF-16, а не как обычный текст; значение /Length не соответствует числу байтов в потоке; в таблице перекрестных ссылок указано неверное байтовое смещение. В части 2 представлен инструмент, который сообщает, какая именно из этих проблем возникла.
Доработка до документа, который стоит отправить
Hello, PDF! доказывает, что формат работает. Тикет сделки доказывает, что формат полезен, а для его создания нужны всего два изменения: больше текста и второй шрифт.
4 0 obj
<< /Length 232 >>
stream
BT
/F1 22 Tf
72 780 Td
(TRADE TICKET) Tj
/F2 12 Tf
0 -46 Td
(Symbol      EURUSD) Tj
0 -18 Td
(Type        Buy 0.10 lots) Tj
0 -18 Td
(Open        1.09250) Tj
0 -18 Td
(Close       1.09640) Tj
0 -18 Td
(Profit      +39.00 USD) Tj
ET
endstream
endobj
Новое здесь в том, что Td задает относительное перемещение. Первая команда 72 780 Td перемещает перо в абсолютную позицию, поскольку при выполнении BT перо находится в начале координат. Каждая последующая команда 0 -18 Td перемещает перо еще на 18 пунктов вниз от его текущей позиции. Таким образом, чтобы расположить строки одну под другой, достаточно повторять один и тот же оператор, а не вычислять пять абсолютных значений y; если же строки окажутся слишком близко друг к другу, нужно изменить значение -18 для каждой строки, а не пересчитывать весь столбец.
Команда /F2 12 Tf, расположенная посередине, переключает шрифт внутри текстового объекта. Объект 6 определяет /F2 как шрифт Courier, а в словаре ресурсов объекта 3 появляется вторая запись: /F2 6 0 R. Courier выбран осознанно, а не ради оформления.
Чтобы увидеть разницу, создайте тикет сделки дважды, изменив только это одно слово. Скрипт, приложенный к этой части, делает именно это: он вызывает один и тот же генератор сначала с параметром "Courier", а затем с параметром "Helvetica", поэтому поток содержимого, перемещения пера и заполнение пробелами в обоих файлах побайтово идентичны, а единственное различие между файлами на диске — имя /BaseFont внутри объекта 6. Обе страницы ниже показывают фактический результат отображения этих двух файлов.
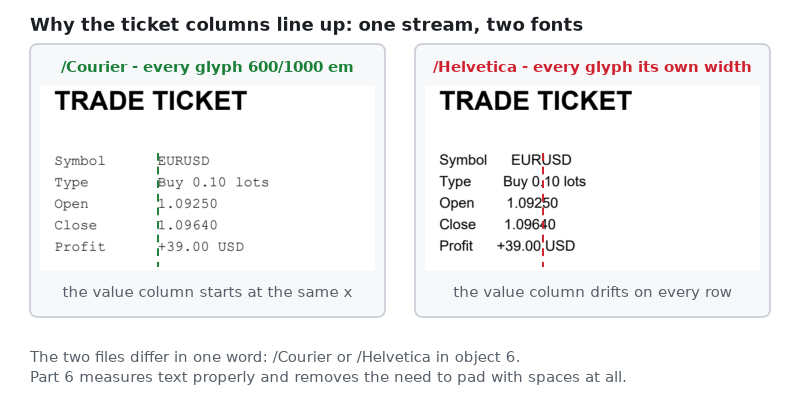
Рисунок 7. Один и тот же поток содержимого, отображенный с использованием двух разных шрифтов основного текста.
Обратите внимание на пунктирную линию. В шрифте Courier каждый глиф имеет одинаковую ширину — 600 единиц из 1000, соответствующих номинальному размеру шрифта, — поэтому заполнение из двенадцати символов всегда занимает 12 × 12 × 0.600 = 86.4 пункта, тринадцатый символ одной строки располагается точно над тринадцатым символом следующей, а дополнение подписи пробелами формирует ровный столбец. Справа тот же текст набран шрифтом Helvetica, где ширина пробела составляет 278 единиц, S — 667, а l — всего 222, поэтому подпись Symbol, дополненная пробелами до двенадцати символов, занимает иную ширину, чем подпись Profit с таким же дополнением, и столбец значений в каждой строке начинается с новой позиции.
Правильный способ — измерить ширину подписи и сдвинуть перо на это расстояние, для чего необходимо знать ширину каждого глифа в шрифте. Этому посвящена часть 6 — статья, в которой разбирается, как реализовать выравнивание по центру, перенос строк и выравнивание по ширине. А пока моноширинный шрифт — надежный способ выровнять два столбца; стоит знать, что именно поэтому так много автоматически создаваемых документов традиционно набирались шрифтом Courier.
Создание PDF средствами MQL5
Всё, что указано выше, — это набор текста. Приведенный ниже скрипт лишь набирает текст за вас и больше ничего не делает — он не вычисляет ни длин, ни смещений, поскольку каждое число в нём мы уже определили подсчётом. Это верное описание того, чего удалось достичь в этой части, и честное указание на то, что предстоит исправить в частях 2 и 3.
Скрипт начинается со стандартных свойств и двух входных параметров, чтобы можно было менять имена выходных файлов без редактирования кода.
//--- Every article in the series writes under one shared root folder, with
//--- its own subfolder, so the output of Part 1 never collides with Part 2.
#define PDF_ROOT_FOLDER  "MQLPDF"
#define PDF_SUB_FOLDER   "Part 01"

//--- File names, relative to the folder above.
input string InpHelloName     = "hello.pdf";             // Minimal PDF
input string InpTicketCourier = "ticket_courier.pdf";    // Ticket, monospaced
input string InpTicketHelv    = "ticket_helvetica.pdf";  // Ticket, proportional
Все файлы сохраняются в папке MQL5\Files\MQLPDF\Part 01. MQLPDF — корневая папка, в которую записываются результаты работы всех частей этой серии, а пронумерованная подпапка отделяет файлы каждой статьи от остальных, что важно начиная с части 2, когда несколько скриптов начинают создавать файлы с похожими именами.
Далее — самая маленькая вспомогательная функция в этой серии, которая определяет структуру всего файла:
//+-------------------------------------------------------------------+
//| Appends one line and the single line feed that ends it.           |
//+-------------------------------------------------------------------+
string L(const string text)
  {
   return(text + "\n");
  }
Легко было бы пропустить этот момент и по привычке к Windows написать "\r\n". Но тогда все смещения в этой статье изменятся, поскольку двухбайтовое окончание строки в каждой из пятнадцати строк сдвинет объект 4 на пятнадцать байтов дальше. Формат допускает CRLF, но не допускает, чтобы вы забыли, какой вариант окончания строки выбрали. Если задать окончание строки в одной функции, то в части 3 можно будет подсчитывать байты без дополнительных уточнений.
Ещё одна однострочная функция, чтобы не приходилось полностью прописывать путь к папке в каждом месте вызова:
//+-------------------------------------------------------------------+
//| Joins the folder parts into a path relative to MQL5\Files.        |
//+-------------------------------------------------------------------+
string OutputPath(const string file_name)
  {
   return(PDF_ROOT_FOLDER + "\\" + PDF_SUB_FOLDER + "\\" + file_name);
  }
А теперь сам файл. Заголовок и первые два объекта:
//+-------------------------------------------------------------------+
//| Builds hello.pdf: the smallest PDF worth writing.                 |
//+-------------------------------------------------------------------+
string BuildHelloPdf(void)
  {
   string s = "";

//--- The header. The version number is the highest feature set the file
//--- uses; 1.4 is old enough that every viewer ever written accepts it.
   s += L("%PDF-1.4");

//--- Object 1: the catalog. /Root in the trailer points here, and this
//--- points at the page tree. It is the root of the whole document.
   s += L("1 0 obj");
   s += L("<< /Type /Catalog /Pages 2 0 R >>");
   s += L("endobj");

//--- Object 2: the page tree. /Kids lists the pages, /Count says how
//--- many there are. One page, so one entry and a count of 1.
   s += L("2 0 obj");
   s += L("<< /Type /Pages /Kids [3 0 R] /Count 1 >>");
   s += L("endobj");
Формирование документа в виде одной строки и его однократная запись — это не деталь реализации, а единственный способ, который позволит нам впоследствии вычислять смещения. Если бы скрипт записывал каждый объект на диск по мере работы, ему пришлось бы после каждой записи запрашивать текущую позицию через хэндл файла. Если хранить байты в памяти, ответ всегда будет таким: «длина того, что уже накоплено» — именно эта идея в части 3 воплощается в виде класса.
Страница и её ресурсы:
//--- Object 3: the page. /MediaBox is the paper size in points, where
//--- one point is 1/72 inch, so 595 x 842 is A4. /Resources lists what
//--- the page is allowed to use -- here, one font we call /F1.
   s += L("3 0 obj");
   s += L("<< /Type /Page /Parent 2 0 R /MediaBox [0 0 595 842]");
   s += L("   /Resources << /Font << /F1 5 0 R >> >>");
   s += L("   /Contents 4 0 R >>");
   s += L("endobj");
Словарь разбит на три строки исключительно для удобства чтения. Для PDF разрывы строк внутри словаря несущественны — его границы задают << и >>, а любые пробельные символы между лексемами равнозначны. Эти три пробела в начале каждой строки продолжения добавляют по три байта на строку, зато делают листинг удобным для чтения — оправданный компромисс, пока байты всё ещё считает человек.
Поток содержимого с длиной, которую мы подсчитали вручную:
//--- Object 4: the content stream, the only part that draws anything.
//--- /Length must be the exact number of bytes between the line after
//--- "stream" and the line before "endstream". Count them: 43.
   s += L("4 0 obj");
   s += L("<< /Length 43 >>");
   s += L("stream");
   s += L("BT");                       // begin a text object
   s += L("/F1 36 Tf");                // use font /F1 at 36 points
   s += L("72 720 Td");                // move the pen to x=72, y=720
   s += L("(Hello, PDF!) Tj");         // draw this string
   s += L("ET");                       // end the text object
   s += L("endstream");
   s += L("endobj");

//--- Object 5: the font. Helvetica is one of the 14 standard fonts that
//--- every PDF viewer must provide, so we name it and embed nothing.
   s += L("5 0 obj");
   s += L("<< /Type /Font /Subtype /Type1 /BaseFont /Helvetica >>");
   s += L("endobj");
Литерал 43 — самое уязвимое место в этом файле. Если заменить Hello, PDF! на Hello, world!, поток увеличится на два байта, значение /Length станет неверным, и файл может открыться или не открыться в зависимости от того, какую программу просмотра использует читатель. Библиотека должна вычислить это число на основе байтов, которые она только что записала; скрипт, записывающий заранее заданное значение, этого сделать не может. CPdfBuffer в части 3 предназначен для того, чтобы сделать появление подобных ошибок невозможным, а не просто маловероятным.
Таблица перекрестных ссылок и трейлер со смещениями, определенными по готовому файлу:
//--- The cross-reference table: one line per object, each giving the
//--- byte position where that object starts. Entry 0 is always the
//--- free-list head. Every entry is exactly 20 bytes, including the
//--- trailing space before the line feed -- do not delete that space.
   s += L("xref");
   s += L("0 6");
   s += L("0000000000 65535 f ");
   s += L("0000000009 00000 n ");      // object 1 starts at byte 9
   s += L("0000000058 00000 n ");      // object 2 starts at byte 58
   s += L("0000000115 00000 n ");      // object 3 starts at byte 115
   s += L("0000000247 00000 n ");      // object 4 starts at byte 247
   s += L("0000000339 00000 n ");      // object 5 starts at byte 339

//--- The trailer: how many entries the xref has, and which object is
//--- the catalog. startxref is the byte position of the word "xref"
//--- above; a viewer reads the file backwards to find it.
   s += L("trailer");
   s += L("<< /Size 6 /Root 1 0 R >>");
   s += L("startxref");
   s += L("409");
   s += L("%%EOF");

   return(s);
  }
Семь жестко заданных чисел, каждое из которых изменяется, если изменяется любая строка, расположенная выше него. Именно от этой части ручной работы мы избавимся в следующих частях серии.
Тикет сделки формируется второй функцией той же структуры, но с двумя параметрами. base_font — это PostScript-имя шрифта основного текста, благодаря которому одна функция может создавать и ticket_courier.pdf, и ticket_helvetica.pdf. start_xref — это байтовое смещение слова xref. Причина, по которой его приходится передавать как параметр, заслуживает отдельного пояснения: имя Helvetica на два символа длиннее имени Courier, поэтому объект 6 увеличивается на два байта, а следующая за ним таблица перекрестных ссылок начинается на два байта дальше от начала файла. Сам скрипт никак не отслеживает это изменение. Во второй части рассматривается, как обеспечить соответствие смещений фактическому расположению байтов.
//+-------------------------------------------------------------------+
//| Builds a trade ticket: the same skeleton, more text, two fonts.   |
//+-------------------------------------------------------------------+
string BuildTicketPdf(const string base_font, const int start_xref)
  {
   string s = "";

   s += L("%PDF-1.4");

   s += L("1 0 obj");
   s += L("<< /Type /Catalog /Pages 2 0 R >>");
   s += L("endobj");

   s += L("2 0 obj");
   s += L("<< /Type /Pages /Kids [3 0 R] /Count 1 >>");
   s += L("endobj");

//--- Two fonts this time, so the resource dictionary has two entries.
   s += L("3 0 obj");
   s += L("<< /Type /Page /Parent 2 0 R /MediaBox [0 0 595 842]");
   s += L("   /Resources << /Font << /F1 5 0 R /F2 6 0 R >> >>");
   s += L("   /Contents 4 0 R >>");
   s += L("endobj");
Единственное изменение на странице — второй псевдоним. /F1 и /F2 — локальные подписи, а номера объектов, которым они соответствуют, — 5 и 6 — в потоке содержимого нигде не фигурируют. Переименование /F2 в /FBody в обоих местах даст тот же результат, а настоящая библиотека будет генерировать такие имена сама, а не оставлять их выбор на усмотрение человека.
//--- 232 bytes of operators. Td is relative: after the first "72 780 Td"
//--- every following "0 -18 Td" moves down another 18 points from where
//--- the last one left off, which is how the rows stack.
//---
//--- The labels are padded to 12 characters with spaces. That is the
//--- crutch this part is built on, and the reason the body font matters.
   s += L("4 0 obj");
   s += L("<< /Length 232 >>");
   s += L("stream");
   s += L("BT");
   s += L("/F1 22 Tf");
   s += L("72 780 Td");
   s += L("(TRADE TICKET) Tj");
   s += L("/F2 12 Tf");
   s += L("0 -46 Td");
   s += L("(Symbol      EURUSD) Tj");
   s += L("0 -18 Td");
   s += L("(Type        Buy 0.10 lots) Tj");
   s += L("0 -18 Td");
   s += L("(Open        1.09250) Tj");
   s += L("0 -18 Td");
   s += L("(Close       1.09640) Tj");
   s += L("0 -18 Td");
   s += L("(Profit      +39.00 USD) Tj");
   s += L("ET");
   s += L("endstream");
   s += L("endobj");
Команда 0 -46 Td после заголовка задает большее смещение, чем 0 -18 Td между строками, поскольку размер шрифта заголовка — 22 пункта, а строк — 12. Вертикальный ритм в PDF задается полностью вручную: сам формат не знает, что после строки текста размером 12 пунктов «полагается» сместиться на 18 пунктов. В части 7 это превращается в движок компоновки с курсором и значением интерлиньяжа; здесь же используются пять чисел, подобранных вручную, и для изменения расстояния между строками нужно отредактировать пять строк кода.
//--- Object 5: the heading font, bold and the same in both files.
   s += L("5 0 obj");
   s += L("<< /Type /Font /Subtype /Type1 /BaseFont /Helvetica-Bold >>");
   s += L("endobj");

//--- Object 6: the body font, and the one line that differs between
//--- ticket_courier.pdf and ticket_helvetica.pdf.
   s += L("6 0 obj");
   s += L("<< /Type /Font /Subtype /Type1 /BaseFont /" + base_font + " >>");
   s += L("endobj");
Два объекта шрифтов, по две строки в каждом, без встраивания самих шрифтов. Helvetica-Bold, Courier и Helvetica — еще три из четырнадцати стандартных шрифтов, поэтому полужирный заголовок и моноширинный шрифт основного текста обходятся этому файлу всего в 137 байт. Объект 6 — единственное место, где используется параметр base_font, и в нем заключается вся разница между двумя панелями на рисунке 7.
//--- Objects 1 to 6 start at the same byte in both files, because the
//--- font name only grows the very last object. Only startxref moves.
   s += L("xref");
   s += L("0 7");
   s += L("0000000000 65535 f ");
   s += L("0000000009 00000 n ");
   s += L("0000000058 00000 n ");
   s += L("0000000115 00000 n ");
   s += L("0000000257 00000 n ");
   s += L("0000000539 00000 n ");
   s += L("0000000614 00000 n ");
   s += L("trailer");
   s += L("<< /Size 7 /Root 1 0 R >>");
   s += L("startxref");
   s += L(IntegerToString(start_xref));
   s += L("%%EOF");

   return(s);
  }
Смещения всех шести объектов одинаковы в обоих тикетах, и это скорее удачное совпадение, чем результат продуманной структуры: объект шрифта основного текста — последний в файле, поэтому увеличение его размера сдвигает только следующую за ним таблицу перекрестных ссылок. Если поместить /F2 выше, то для каждого числа, расположенного ниже него, потребуется по две версии.
Сравните эти смещения со смещениями в файле hello.pdf. Объекты 1, 2 и 3 начинаются на байтовых позициях 9, 58 и 115 в обоих файлах, поскольку эти три объекта побайтово идентичны вплоть до строки с ресурсами. Начиная с объекта 4 байтовые смещения в двух файлах различаются — 247 против 257, — и эта разница обусловлена десятью дополнительными байтами /F2 6 0 R в словаре ресурсов. В этом одном числе заключается вся проблема данной серии: добавление десяти символов в верхней части файла привело к сдвигу всего, что находилось ниже, и каждую строку после этой точки пришлось пересчитывать заново.
При записи байтов в MQL5 есть одна серьезная ловушка:
//+------------------------------------------------------------------+
//| Writes a string to MQL5\Files as raw bytes.                       |
//+------------------------------------------------------------------+
bool WriteRawFile(const string name, const string content)
  {
   int handle = FileOpen(name, FILE_WRITE | FILE_BIN | FILE_ANSI);
   if(handle == INVALID_HANDLE)
     {
      PrintFormat("Cannot open %s for writing, error %d", name,
                  GetLastError());
      return(false);
     }
Функция FileOpen принимает набор флагов, и их сочетание здесь важнее, чем где-либо еще в скрипте. Флаг FILE_BIN указывает терминалу записывать полученные данные без их интерпретации. Флаг FILE_ANSI указывает, что на каждый символ строки приходится один байт. Если не указать FILE_ANSI, MQL5 будет обрабатывать строку как Unicode и записывать по два байта на символ, поэтому %PDF-1.4 попадет на диск в виде %\0P\0D\0F\0..., и программа просмотра, ищущая восьмибайтовый заголовок, не сможет его распознать.
//--- The third argument is the character count. Without it MQL5 writes
//--- a length prefix ahead of the text, which would corrupt the file.
   uint written = FileWriteString(handle, content, StringLen(content));
   FileClose(handle);

   if(written != (uint)StringLen(content))
     {
      PrintFormat("Short write on %s: %u of %d bytes", name, written,
                  StringLen(content));
      return(false);
     }

   PrintFormat("%s written, %d bytes", name, StringLen(content));
   return(true);
  }
Аргумент длины в функции FileWriteString — вторая ловушка. В случае двоичного файла вызов этой функции без указания длины заставляет MQL5 записать строку во внутреннем формате с префиксом, указывающим её длину. Явная передача результата StringLen заставляет MQL5 записывать только символы и ничего больше. Затем возвращаемое значение сравнивается с запрашиваемой длиной, поскольку при переполнении диска операция регистрируется как неполная запись, а не как ошибка.
И, наконец, точка входа:
//+-------------------------------------------------------------------+
//| Script entry point.                                               |
//|                                                                   |
//| Builds the three files and drops them in the article's own output |
//| folder. The two tickets are produced by the same builder, called  |
//| twice with a different body font, so the difference between the   |
//| two pages cannot be anything but the font.                        |
//+-------------------------------------------------------------------+
void OnStart(void)
  {
//--- Create the output folder up front, so a permissions problem is
//--- reported as a folder error and not as an unexplained INVALID_HANDLE.
//--- FolderCreate also succeeds when the folder is already there.
   string folder = PDF_ROOT_FOLDER + "\\" + PDF_SUB_FOLDER;
   if(!FolderCreate(folder))
     {
      PrintFormat("Cannot create folder %s, error %d", folder, GetLastError());
      return;
     }

   if(!WriteRawFile(OutputPath(InpHelloName), BuildHelloPdf()))
      return;

//--- Courier: monospaced, so the padded columns line up. 682 is the byte
//--- offset of the word "xref" in this version of the file.
   if(!WriteRawFile(OutputPath(InpTicketCourier),
                    BuildTicketPdf("Courier", 682)))
      return;

//--- Helvetica: proportional, so the same padding drifts. "Helvetica" is
//--- two characters longer than "Courier", which pushes the xref table
//--- two bytes further down -- hence 684 rather than 682. Getting this
//--- wrong by even one byte is the failure Part 3 dissects.
   if(!WriteRawFile(OutputPath(InpTicketHelv),
                    BuildTicketPdf("Helvetica", 684)))
      return;

   Print("Files written to ", TerminalInfoString(TERMINAL_DATA_PATH),
         "\\MQL5\\Files\\", folder);
   Print("Open both tickets side by side and compare the second column.");
  }
Функция FolderCreate создает всю структуру папок по указанному пути за один вызов и возвращает true, если папка уже существует, поэтому скрипт можно безопасно запускать повторно. Последние две строки выводят путь к создаваемому файлу, поскольку после первого запуска скрипта, записывающего файл, чаще всего возникает вопрос: куда терминал сохранил файл? Ответ дает функция TerminalInfoString с аргументом TERMINAL_DATA_PATH. При запуске скрипта выводится следующее:
MQLPDF\Part 01\hello.pdf written, 592 bytes
MQLPDF\Part 01\ticket_courier.pdf written, 885 bytes
MQLPDF\Part 01\ticket_helvetica.pdf written, 887 bytes
Files written to C:\Users\...\Terminal\D0E82...\MQL5\Files\MQLPDF\Part 01
Open both tickets side by side and compare the second column.
592, 885 и 887 — это те же размеры в байтах, которые мы измерили вручную, а разница в два байта между тикетами сделок — это разница в длине названий Helvetica и Courier, и ничего больше. Если ваши числа отличаются, значит, отличаются окончания строк, и смещения в таблице перекрестных ссылок xref больше не соответствуют файлу.
Когда что-то идет не так
Причиной почти всех неисправных PDF-файлов, созданных вручную, становятся три ошибки, и ни одна из них не сопровождается сообщением об ошибке.
Программа просмотра показывает пустую страницу. Структура файла корректна, поэтому сообщений об ошибках нет, но ничего не отображается. В девяти случаях из десяти поток содержимого запрашивает псевдоним шрифта, который не определён в словаре ресурсов /Resources страницы: например, /F2 12 Tf, тогда как объявлен только /F1. Отсутствие шрифта не является ошибкой в PDF; текст просто пропускается.
Страница открылась, но вы не уверены, что это должно было произойти. Именно такой исход впоследствии создаёт наибольшие проблемы. Большинство современных программ просмотра молча восстанавливают повреждённый индекс: они игнорируют таблицу, просматривают весь файл в поисках маркеров obj и заново строят индекс. Ваш файл выглядит исправным, но лишь благодаря снисходительности программы просмотра. В части 2 мы выясним, насколько снисходительна программа просмотра, и предложим инструмент, который вместо этого покажет истинное положение дел.
При двойном щелчке ничего не происходит. Файл не начинается с %PDF-. Либо редактор добавил маркер порядка байтов (BOM), либо сохранил файл в кодировке UTF-16, либо на самом деле файл называется hello.pdf.txt. Откройте файл в программе просмотра шестнадцатеричных данных и проверьте первые четыре байта: они должны иметь значения 25 50 44 46.
Шпаргалка
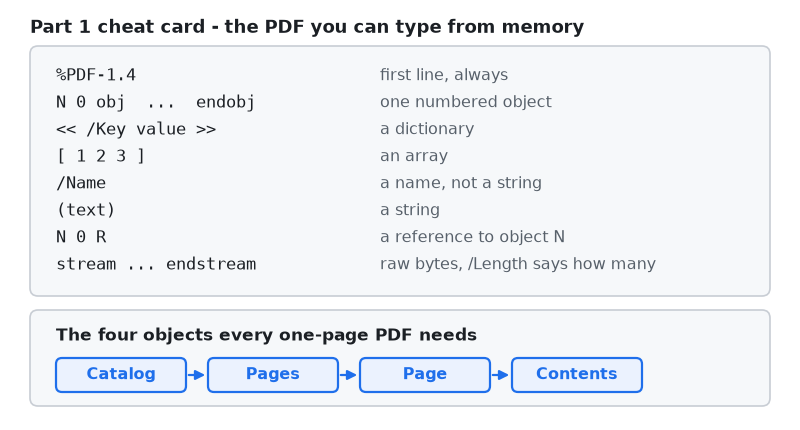
Рисунок 8. Всё, что было представлено в части 1, на одной карточке.
Восемь синтаксических конструкций и четыре объекта. Вот и всё, что нужно для знакомства с форматом, который славится своей непостижимостью.
Структура проекта
Во вложении находятся один скрипт и три создаваемых им PDF-файла, чтобы вы могли сравнить собственный результат с заведомо корректным образцом.
MQL5/
├── Scripts/
│    └── MQLPDF/
│        └── Part 01/
│            └── Demo01_HelloPdf.mq5    // Create first PDF using hardcoded values
│
└── Files/
     └── MQLPDF/
         └── Part 01/
             └── hello.pdf.txt        // hand-written pdf file in notepad
Скрипт сохраняет создаваемые им PDF-файлы в папку MQL5\Files\MQLPDF\Part 01. Для каждой части этой серии используется отдельная пронумерованная подпапка в одном и том же корневом каталоге MQLPDF.
Папки Include/ пока нет. В части 1 намеренно нет библиотеки: всё здесь относится к самому формату, и ничто не является специфичным для MQL5. Распакуйте файлы в папки MQL5\Scripts\ и MQL5\Files\, скомпилируйте скрипт и запустите его на любом графике.
Заключение
PDF — это текстовый файл, состоящий из пяти областей: строки версии, плоского списка пронумерованных объектов, индекса байтовых смещений, трейлера, указывающего корневой объект, и маркера конца. Объекты связаны друг с другом ссылками по номерам, а не вложенностью, поэтому и нужен индекс. На одну страницу требуется четыре объекта и ещё по одному на каждый шрифт. Рисование выполняется с помощью потока содержимого, записанного в обратной польской записи, где четырёх операторов — BT, Tf, Td, Tj — достаточно, чтобы разместить текст в любом месте листа.
Теперь у вас есть два рабочих PDF-файла, которые вы понимаете вплоть до каждого символа, и скрипт, который создаёт их средствами MQL5. Это уже реальная возможность: тикет сделки, подписанное подтверждение или чек ненамного сложнее того, что уже есть у вас на диске.
У вас нет ничего, что выдержало бы редактирование. Каждое число в таблице xref представляет собой литерал, и файл перестает работать, как только сдвигается хотя бы один символ. Библиотека должна вычислять эти числа, а прежде нам нужно точно понять, что именно ей предстоит вычислять.
В части 2 «Почему PDF-файлы ломаются: индекс байтовых смещений, о котором никто не предупреждает» мы подробно разберём hello.pdf. Мы намеренно нарушим работу файла тремя разными способами — изменим смещение, изменим строку, удалим пробел в конце записи таблицы xref — и посмотрим, что каждая программа просмотра сообщает о каждом сбое; окажется, что почти ничего. Затем мы напишем инструмент, на который будем опираться в следующих двадцати частях этой серии: валидатор на чистом MQL5, который читает PDF-файл, сверяет каждое смещение с фактическим положением объекта в файле, проверяет каждое значение /Length на соответствие длине потока и сообщает номер объекта и байтовую позицию ошибки.
| # | Файл | Папка | Содержимое |
|---|---|---|---|
| 1 | Demo01_HelloPdf.mq5 | MQL5/Scripts/MQLPDF/Part 01 | создать первый PDF-файл с использованием жестко заданных значений |
| 2 | hello.pdf.txt | MQL5/Files/MQLPDF/Part 01 | строка версии и основное содержимое PDF-файла |
| 3 | MQLPDF Library - Part 01.zip | архив, содержащий все приложенные файлы и их пути относительно корневой папки терминала. |
Проект поддерживается на платформе MQL5 Algo Forge. Для каждой части этой серии есть отдельный релиз, в котором зафиксирован именно тот код, который в ней разбирается, поэтому скачивайте релиз, соответствующий статье, которую читаете.
Релиз для части 1 доступен здесь: https://forge.mql5.io/SandroBegashvil/MQLPDF/releases/tag/part-01
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/24094
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


