Робастная регрессия на языке MQL5
 59
 0

Введение
Классический метод наименьших квадратов (МНК) лежит в основе большинства задач линейной регрессии. Его популярность объясняется простотой вычислений и математической оптимальностью (он дает наилучшие линейные несмещенные оценки). Однако на практике данные редко бывают идеальными: они часто содержат выбросы, ошибки измерений или шум с тяжелыми хвостами. В таких условиях МНК теряет эффективность. Возведение ошибок в квадрат заставляет модель уделять непропорционально большое внимание выбросам, что приводит к искажению всей линии регрессии. Робастная (устойчивая) регрессия как раз и предназначена для того, чтобы минимизировать влияние подобных аномалий.
Как показывают эмпирические исследования финансовых рынков (например, в работе Э. Петерса "Фрактальный анализ рынка"), реальные котировки и доходности активов далеко не всегда подчиняются нормальному распределению. В них регулярно встречаются резкие ценовые движения, которые не укладываются в стандартную модель. Робастные методы позволяют работать с такими данными и поэтому являются ценным инструментом в арсенале трейдера.
Главная сложность работы с такими моделями заключается в том, что аналитическое решение, как в случае МНК, уже недоступно. Приходится использовать численные методы оптимизации, что делает процесс обучения более трудоёмким. В этой статье мы рассмотрим три ключевых подхода к робастной регрессии: на основе распределения Стьюдента, распределения Лапласа и функции потерь Хубера, а также подробно разберём особенности их обучения.
Сравнение моделей робастной регрессии на одномерных данных
Прежде чем переходить к техническому разбору реализации классов робастной регрессии, давайте посмотрим, как эти модели работают на практике. Ниже представлен скрипт 1D_plot.mq5, который решает задачу одномерной регрессии на заранее сгенерированной и зафиксированной синтетической выборке, полученной на основе базовой модели
y = 1 + 2x + ϵ, ϵ ∼ U(−0.5,0.5)
с намеренно добавленными выбросами (рис. 1) (y = − 5 в точках x ∈ {0.1,0.5,0.9}).
//+------------------------------------------------------------------+
//|                                                      1D_plot.mq5 |
//|                                                           Eugene |
//|                                             https://www.mql5.com |
//+------------------------------------------------------------------+
#property copyright "Eugene"
#property link      "https://www.mql5.com"
#property version   "1.00"
#include <RobustRegression\RobustRegression.mqh>
#include <Graphics\Graphic.mqh>

//+------------------------------------------------------------------+
//| Функция построения графика                                       |
//+------------------------------------------------------------------+
void PlotRegressions1D(matrix &X, vector &y,
                       CStudentRegression &student,
                       CHuberRegression &huber,
                       CLaplaceRegression &laplace)
  {
   int n = (int)X.Rows();
   if(n <= 0)
      return;

//--- 1. Расчет обычной линейной регрессии (МНК/OLS)
   matrix X_aug(n, 2);
   for(int i = 0; i < n; i++)
     {
      X_aug[i][0] = 1.0;
      X_aug[i][1] = X[i][0];
     }
   vector w_ls = X_aug.PInv()  @ y;

//--- 2. Создаем тестовые данные от 0 до 1 с шагом 0.1
   int num_test = 11;
   matrix X_test(num_test, 1);
   vector x_test_vec(num_test);

   for(int i = 0; i < num_test; i++)
     {
      double val = i * 0.1;
      x_test_vec[i] = val;
      X_test[i][0]  = val;
     }

//--- 3. Создаем расширенную матрицу (с колонкой единиц) для МНК-прогноза
   matrix X_test_aug(num_test, 2);
   for(int i = 0; i < num_test; i++)
     {
      X_test_aug[i][0] = 1.0;
      X_test_aug[i][1] = X_test[i][0];
     }

//--- Получаем предсказания для всех моделей на тестовых данных
   vector y_ls    = X_test_aug @ w_ls;
   vector y_stud  = student.Predict(X_test);
   vector y_huber = huber.Predict(X_test);
   vector y_lap   = laplace.Predict(X_test);

   ulong width  = ChartGetInteger(0, CHART_WIDTH_IN_PIXELS);
   ulong height = ChartGetInteger(0, CHART_HEIGHT_IN_PIXELS);

   ChartSetInteger(0, CHART_SHOW, false);

   CGraphic graphic;
   graphic.Create(0, "RobustReg_1D_Comparison", 0, 0, 0, int(width), int(height));

   double px[], py[];
   ArrayResize(px, n);
   ArrayResize(py, n);

   for(int i = 0; i < n; i++)
     {
      px[i] = X[i][0];
      py[i] = y[i];
     }
   CCurve *curve_scatter = graphic.CurveAdd(px, py, ColorToARGB(clrBlack, 200), CURVE_POINTS, "Data Points");
   curve_scatter.PointsType(POINT_CIRCLE);
   curve_scatter.PointsSize(5);
   curve_scatter.PointsFill(true);

//--- Массивы для отрисовки линий регрессии по тестовой сетке
   double px_line[], py_line[];
   ArrayResize(px_line, num_test);
   ArrayResize(py_line, num_test);

   for(int i = 0; i < num_test; i++)
      px_line[i] = x_test_vec[i];

   for(int i = 0; i < num_test; i++)
      py_line[i] = y_ls[i];
   CCurve *curve_ls = graphic.CurveAdd(px_line, py_line, ColorToARGB(clrBlack, 255), CURVE_LINES, "OLS");
   curve_ls.LinesWidth(2);
   curve_ls.LinesStyle(STYLE_DASH);

//--- Student
   for(int i = 0; i < num_test; i++)
      py_line[i] = y_stud[i];
   CCurve *curve_stud = graphic.CurveAdd(px_line, py_line, ColorToARGB(clrRed, 255), CURVE_LINES, "Student");
   curve_stud.LinesWidth(3);

//--- Huber
   for(int i = 0; i < num_test; i++)
      py_line[i] = y_huber[i];
   CCurve *curve_huber = graphic.CurveAdd(px_line, py_line, ColorToARGB(clrOrange, 255), CURVE_LINES, "Huber");
   curve_huber.LinesWidth(2);

//--- Laplace
   for(int i = 0; i < num_test; i++)
      py_line[i] = y_lap[i];
   CCurve *curve_lap = graphic.CurveAdd(px_line, py_line, ColorToARGB(clrBlue, 255), CURVE_LINES, "Laplace");
   curve_lap.LinesWidth(2);

   graphic.BackgroundMainColor(ColorToARGB(clrBlack, 255));
   graphic.BackgroundMainSize(18);
   graphic.BackgroundMain("Robust Regressions vs Least Squares ");

   graphic.XAxis().Name("X");
   graphic.XAxis().NameSize(14);
   graphic.YAxis().Name("Y");
   graphic.YAxis().NameSize(14);

   graphic.CurvePlotAll();
   graphic.Update();
   Sleep(15 * 1000);
   graphic.Destroy();
   ChartSetInteger(0, CHART_SHOW, true);
   ChartRedraw(0);
  }

//+------------------------------------------------------------------+
//| Script program start function                                    |
//+------------------------------------------------------------------+
void OnStart()
  {
   matrix X =
     {
        {0.383441518825778},
        {0.423654799338905},
        {0.437587211262693},
        {0.544883182996897},
        {0.548813503927325},
        {0.602763376071644},
        {0.645894113066656},
        {0.715189366372419},
        {0.89177300078208},
        {0.963662760501029},
        {0.1},
        {0.5},
        {0.9}
     };

   vector y =
     {
      2.05860807573422,
      1.87620451843071,
      1.94321898361932,
      2.51536300428645,
      1.66866306605254,
      1.79265605184483,
      1.81200662357364,
      2.76299857829278,
      3.06170275251401,
      3.29733766924888,
      -5,
      -5,
      -5
     };

   int max_iter = 100;
   double tol = 1e-4;

   CStudentRegression student(max_iter, tol, 0.0, true, true);
   uint start_time = GetTickCount();

   if(student.Fit(X, y))
     {
      uint time_elapsed = GetTickCount() - start_time;
      Print("===============================================");
      Print("         РЕЗУЛЬТАТЫ ОЦЕНКИ MQL5 (Student EM)  ");
      Print("===============================================");
      PrintFormat("Intercept (intercept_) : %10.6f", student.intercept_);
      Print("Weights (coef_)        : ");
      for(ulong j = 0; j < student.coef_.Size(); j++)
         PrintFormat("  coef_[%d]            : %10.6f", (int)j, student.coef_[j]);
      PrintFormat("Sigma2                 : %10.6f", student.sigma2);
      PrintFormat("DOF (nu)               : %10.6f", student.dof);
      PrintFormat("Iterations             : %d", student.loglik_history.Size());
      PrintFormat("Final LogLik           : %10.6f", student.loglik_history[student.loglik_history.Size() - 1]);
      PrintFormat("Time Elapsed           : %d ms", time_elapsed);
      Print("===============================================");
     }
   else
     {
      Print("Ошибка обучения Student EM");
     }

   CHuberRegression huber(1.0, true,true);
   if(!huber.Fit(X, y))
      Print("Ошибка обучения Huber");


   CLaplaceRegression laplace(true,true);
   if(!laplace.Fit(X, y))
      Print("Ошибка обучения Laplace");

   PlotRegressions1D(X, y, student, huber, laplace);
  }
Классическая регрессия по методу наименьших квадратов отображается на графике штриховой черной линией. Мы видим, что под воздействием трех выбросов линия регрессии заваливается вниз. Робастные модели Хубера и Лапласа игнорируют эти аномалии и проходят через основное облако точек. В данном примере модель Стьюдента справляется несколько хуже.
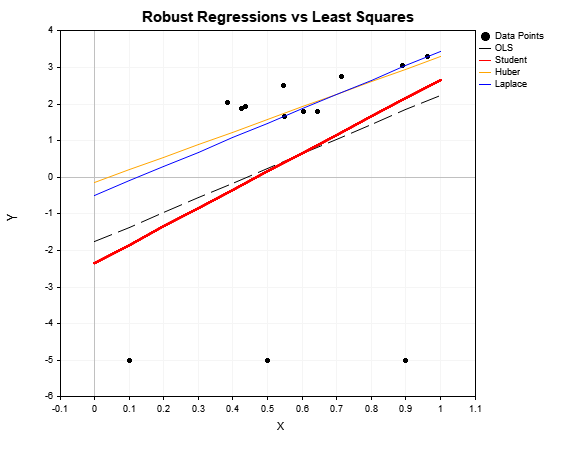
Рис. 1. Сравнение робастной регрессии и обыкновенного МНК
Базовый абстрактный класс CRobustRegression
В основе реализации лежит абстрактный класс CRobustRegression, который задаёт единый интерфейс для всех робастных моделей. Благодаря этому три совершенно разных подхода — регрессия Стьюдента, Лапласа и Хубера — используются одинаково просто и единообразно. При проектировании интерфейса я сознательно стремился сделать его максимально близким к стилю популярной Python-библиотеки scikit-learn.
Класс содержит три основных публичных поля:
- coef_ — вектор коэффициентов регрессии (веса признаков),
- intercept_ — смещение,
- sigma2 — квадрат параметра масштаба (Стьюдент) / дисперсия (Лаплас, Хубер)
Помимо данных, базовый класс реализует два универсальных метода, которые наследуются всеми дочерними моделями без изменений:
- Predict() — вычисляет вектор прогнозных значений по матрице признаков X с учётом обученных весов coef_ и смещения intercept_,
- Score() — оценивает качество работы модели на переданных данных с помощью вычисления регрессионной метрики. По умолчанию метод рассчитывает среднюю абсолютную ошибку (MAE). В то же время параметр metric позволяет пользователю опционально выбрать любую другую метрику из стандартного перечисления ENUM_REGRESSION_METRIC.
Единственный виртуальный метод — Fit(). Его реализуют наследники, потому что способ обучения у каждой модели свой. Благодаря единому интерфейсу с любой робастной моделью можно работать одинаково: создать объект, вызвать Fit(), затем Predict() и Score().
Конструктор класса принимает два параметра:
- fit_intercept — нужно ли оценивать смещение (по умолчанию true),
- verbose — выводить ли диагностическую информацию в процессе обучения.
Такой дизайн делает код гибким и удобным для расширения. Новую робастную модель можно добавить, унаследовав её от CRobustRegression и реализовав метод Fit(), без изменения остального кода.
//+------------------------------------------------------------------+
//|                                            RobustRegression.mqh  |
//|                                                           Eugene |
//|                                             https://www.mql5.com |
//+------------------------------------------------------------------+
#property copyright "Eugene"
#property link      "https://www.mql5.com"
#include <Math\Stat\Math.mqh>
#include <Math\Alglib\alglib.mqh>

//+------------------------------------------------------------------+
//| Базовый класс робастной регрессии                                |
//+------------------------------------------------------------------+
class CRobustRegression
  {
protected:
   bool              m_fit_intercept;
   bool              m_verbose;

public:
   vector            coef_;          // Параметры регрессии
   double            intercept_;     // Смещение (intercept / w0)
   double            sigma2;         // Квадрат параметра масштаба (Стьюдент) / дисперсия (Лаплас, Хубер)

                     CRobustRegression(bool fit_intercept = true, bool verbose = false)
      :              m_fit_intercept(fit_intercept), m_verbose(verbose), intercept_(0.0), sigma2(0.0) {}

   virtual          ~CRobustRegression() {}

   virtual bool      Fit(const matrix &X, const vector &y) = 0;
   vector            Predict(const matrix &X)
     {
      vector y_pred = X @ coef_;
      if(m_fit_intercept)
         y_pred += intercept_;
      return y_pred;
     }
   double            Score(const matrix &X, const vector &y,ENUM_REGRESSION_METRIC metric = REGRESSION_MAE)
     {
      vector y_pred = Predict(X);
      return y_pred.RegressionMetric(y, metric);
     }
  };
Модель Стьюдента
Распределение Стьюдента — классический пример распределения с тяжёлыми хвостами. Стандартное распределение Стьюдента имеет только один параметр — число степеней свободы ν. Однако для задач регрессии используется более общее масштабированное распределение Стьюдента (Location-Scale Student’s t-distribution), которое определяется тремя параметрами:
- Параметр локации μ — определяет центр распределения (в стандартном распределении μ = 0),
- Параметр масштаба σ — задает горизонтальный масштаб распределения, растягивая или сжимая его относительно центра (в стандартном варианте σ = 1),
Важно: параметр σ не следует путать с дисперсией случайной величины. В отличие от нормального распределения, здесь дисперсия зависит и от масштаба, и от числа степеней свободы:
Var = σ2 (ν/ν−2),
а при ν ≤ 2 и вовсе не определена (равна бесконечности).
- Параметр степеней свободы ν (dof) — определяет форму распределения: остроту пика в центре и тяжесть хвостов. У этого параметра есть два интересных предельных случая:
- При ν → ∞ распределение Стьюдента стремится к обычному нормальному распределению,
- При ν = 1 оно превращается в распределение Коши — распределение с экстремально тяжелыми хвостами, у которого не определены ни среднее, ни дисперсия.
В регрессии Стьюдента параметр локации задаётся с помощью линейной модели:
μi = xi^T@ w,
где:
- xi – вектор признаков для i-й точки данных,
- w – вектор коэффициентов регрессии.
При этом параметр локации всегда является условной медианой целевой переменной, а при ν>1 — ещё и условным математическим ожиданием.
Таким образом, каждое наблюдение yi рассматривается как случайная величина, распределенная по закону Стьюдента вокруг своего условного центра (предсказания модели) с общим масштабом σ и числом степеней свободы ν.Теперь мы можем записать логарифм плотности вероятности для каждого отдельного наблюдения y:
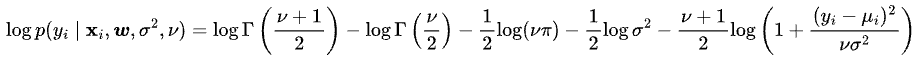
где
- logΓ — логарифм гамма-функции.
Поскольку наблюдения предполагаются независимыми, то полное маргинальное правдоподобие по всей выборке из N точек представляет собой просто сумму индивидуальных лог-вероятностей:
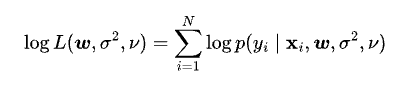
В коде:
- метод LinregLogprob() возвращает вектор лог-вероятностей, а их сумма даёт значение маргинального правдоподобия,
- метод NLL() возвращает отрицательное правдоподобие (поскольку численные оптимизаторы ищут минимум функции). Именно эту величину минимизирует метод Брента при подборе оптимального числа степеней свободы.
//+------------------------------------------------------------------+
//| Расчет лог-правдоподобия                                         |
//+------------------------------------------------------------------+
vector CStudentRegression::LinregLogprob(double dof_val)
  {
   vector mu = m_X @ coef_;
   return studentLogprob(mu, sigma2, dof_val, m_y);
  }

//+------------------------------------------------------------------+
//| Плотность вероятности распределения Стьюдента                    |
//| [in] mu         - вектор математических ожиданий                 |
//| [in] sigma2_val - квадрат параметра масштаба                     |
//| [in] dof_val    - степени свободы (nu)                           |
//| [in] y          - вектор фактических значений                    |
//| [out]: вектор лог-вероятностей                                   |
//+------------------------------------------------------------------+
vector CStudentRegression::studentLogprob(const vector &mu, const double sigma2_val, const double dof_val, const vector &y)
  {
   vector logp(m_N);
   double logc = MathGammaLog((dof_val + 1.0) / 2.0) - MathGammaLog(dof_val / 2.0) - 0.5 * MathLog(dof_val * M_PI) - 0.5 * MathLog(sigma2_val);
   double factor = (dof_val + 1.0) / 2.0;
   for(ulong i = 0; i < m_N; i++)
     {
      double diff = y[i] - mu[i];
      double delta = (diff * diff) / sigma2_val;
      logp[i] = logc - factor * MathLog1p(delta / dof_val);
     }
   return logp;
  }

//+------------------------------------------------------------------+
//| Функция потерь (отрицательное лог-правдоподобие)                 |
//+------------------------------------------------------------------+
double CStudentRegression::NLL(double dof_val)
  {
   vector logprob = LinregLogprob(dof_val);
   return -logprob.Sum();
  }
Обучение с помощью EM-алгоритма
Распределение Стьюдента можно представить как бесконечную смесь нормальных распределений. Поэтому для оценки параметров удобно использовать EM-алгоритм (Expectation-Maximization). Ключевая идея заключается во введении скрытых переменных — весов робастности sᵢ (в коде m_weights_s). Для каждого наблюдения алгоритм оценивает вес sᵢ, который регулирует влияние каждой точки на итоговую модель:
- чем ближе точка к линии регрессии, тем больше её вес,
- чем сильнее точка отклоняется, тем меньше её вес и влияние выброса.
В отличие от L-BFGS, EM-алгоритм не является универсальным методом оптимизации. Он задаёт лишь итеративную процедуру чередования E и M шагов, но для каждой вероятностной модели эти шаги вычисляются индивидуально. Интересно, что в случае модели Стьюдента M-шаг оказывается гибридным: часть параметров находится аналитически, а число степеней свободы требует численной оптимизации. Таким образом, внутри каждой итерации EM-алгоритма дополнительно работает одномерный оптимизатор — метод Брента.
Шаг E (Expectation) — метод Estep()
Фиксируются текущие параметры модели (coef_, sigma2, dof). Для каждого наблюдения вычисляются:
- квадраты ошибок err²,
- нормированные отклонения δᵢ = errᵢ² / σ²,
- веса робастности по формуле:
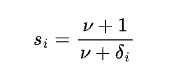
На основе полученных весов формируются взвешенные матрицы признаков и целевой переменной (m_x_weighted, m_y_weighted).
//+------------------------------------------------------------------+
//| Шаг E (Expectation)                                              |
//| Вычисление весов робастности (m_weights_s) и лог-правдоподобия на|
//| основе текущих параметров распределения Стьюдента                |
//+------------------------------------------------------------------+
void CStudentRegression::Estep()
  {
   vector logp = LinregLogprob(dof);
   m_current_loglik = logp.Sum();

   vector err = m_y - (m_X @ coef_);
   vector err2 = err * err;       // квадраты ошибок
   vector delta = err2 / sigma2 ; // нормированные отклонения

   for(ulong i = 0; i < m_N; i++)
      m_weights_s[i] = (dof + 1.0) / (dof + delta[i]);

   vector sqrt_s = MathSqrt(m_weights_s);
   m_y_weighted = m_y * sqrt_s;

   for(ulong i = 0; i < m_N; i++)
     {
      vector row = m_X.Row(i) * sqrt_s[i];
      m_x_weighted.Row(row, i);
     }
  }
Шаг M (Maximization) — метод Mstep()
Фиксируются скрытые веса и обновляются параметры модели:
- коэффициенты регрессии находятся аналитически через взвешенный метод наименьших квадратов (WLS),
- квадрат параметра масштаба σ² обновляется как среднее взвешенных квадратов остатков,
- число степеней свободы ν оптимизируется численно методом Брента путём минимизации отрицательного лог-правдоподобия в диапазоне от 0.1 до 100.
Таким образом, для коэффициентов регрессии и параметра σ² используется аналитический M-шаг, а для степеней свободы — одномерный численный поиск. Сходимость контролируется по относительному изменению маргинального лог-правдоподобия: алгоритм останавливается, когда оно оказывается ниже заданного порога m_tol.
//+------------------------------------------------------------------+
//| Шаг M (Maximization)                                             |
//| Обновление весов регрессии (coef_), квадрата параметра масштаба  |
//| (sigma2) и степеней свободы (dof)                                |
//+------------------------------------------------------------------+
void CStudentRegression::Mstep()
  {
   matrix Xw_pinv = m_x_weighted.PInv();
   coef_ = Xw_pinv @ m_y_weighted;

   //--- пересчитываем sigma2 по новым коэффициентам
   vector err_new = m_y - (m_X @ coef_);
   vector err2_new = err_new * err_new;
   sigma2 = (m_weights_s * err2_new).Sum() / m_N;

   if(estimate_dof)
     {
      double min_dof = 0.0;
      double min_f = 0.0;
      int funccount = 0;

      CStudentNLL objective(GetPointer(this)); // целевая функция
      if(BrentMin(objective, 0.1, 100.0, 100, m_tol, min_dof, min_f, funccount))
        {
         dof = min_dof;
        }
      else
        {
         if(m_verbose)
            Print("Warning: BrentMin for DOF optimization did not converge within limit.");
        }
     }
  }

//+-----------------------------------------------------------------------------+
//| Абстрактный класс для передачи скалярных функций в метод оптимизации Брента |
//+-----------------------------------------------------------------------------+
class C1D_Function
  {
public:
   //--- [in] x - скалярный аргумент функции
   //--- [out] вычисленное значение функции в точке x
   virtual double    Value(double x) = 0;
  };

//+------------------------------------------------------------------+
//| Класс целевой функции отрицательного лог-правдоподобия           |
//| Связывает модель t-регрессии с интерфейсом C1D_Function          |
//+------------------------------------------------------------------+
class CStudentNLL : public C1D_Function
  {
private:
   CStudentRegression *m_model; // Указатель на объект модели t-регрессии
public:
                     CStudentNLL(CStudentRegression *model) { m_model = model; }

   virtual double    Value(double dof_val) override
     {
      return m_model.NLL(dof_val);
     }
  };
Метод Брента BrentMin()
Для оптимизации числа степеней свободы в модели Стьюдента используется метод Брента. Это комбинированный алгоритм поиска локального минимума одномерной функции, который сочетает метод золотого сечения и параболическую интерполяцию. Важное преимущество метода состоит в том, что он является безградиентным — не требует вычисления производных и работает только со значениями самой целевой функции. BrentMin() реализован как универсальный вспомогательный инструмент: его можно применять для решения любой одномерной задачи оптимизации в рамках интерфейса C1D_Function, задавая границы поиска и требуемую точность.
//+---------------------------------------------------------------------+
//| Метод Брента для поиска локального минимума одномерной функции      |
//| Комбинированный метод золотого сечения и параболической интерполяции|
//| для поиска минимума функции без вычисления производных              |
//| [in]  func      - объект целевой функции (наследник C1D_Function)   |
//| [in]  xlow      - левая граница интервала поиска                    |
//| [in]  xupp      - правая граница интервала поиска                   |
//| [in]  Nitmax    - максимально допустимое количество итераций        |
//| [in]  tol       - требуемая точность остановки                      |
//| [out] xmin      - найденная точка минимума аргумента                |
//| [out] fmin      - минимальное значение функции в точке xmin         |
//| [out] funccount - итоговое количество вызовов целевой функции       |
//+---------------------------------------------------------------------+
bool BrentMin(C1D_Function &func, double xlow, double xupp, int Nitmax, double tol,
              double &xmin, double &fmin, int &funccount)
  {
   double eps = 2.2204460492503131e-16;
   tol = MathMax(tol, eps);
   double fa = func.Value(xlow);
   double fb = func.Value(xupp);
   funccount = 2;
   double c = 0.5 * (3.0 - MathSqrt(5.0));
   double a = xlow, b = xupp, v = a + c * (b - a), w_val = v, xf = v;
   double fx = func.Value(xf);
   funccount++;
   double fv = fx, fw = fx, xm = 0.0, tol1 = 0.0, tol2 = 0.0, d = 0.0, e = 0.0, x = 0.0, fu = 0.0;
   double seps = MathSqrt(eps);
   bool converged = false;

   while(true)
     {
      xm = 0.5 * (a + b);
      tol1 = seps * MathAbs(xf) + tol / 3.0;
      tol2 = 2.0 * tol1;
      //--- Условие успешной сходимости
      if(MathAbs(xf - xm) <= (tol2 - 0.5 * (b - a)))
        {
         converged = true;
         break;
        }
      bool gs = true;
      double p = 0.0, q = 0.0, r = 0.0;
      if(MathAbs(e) > tol1)
        {
         gs = false;
         r = (xf - w_val) * (fx - fv);
         q = (xf - v) * (fx - fw);
         p = (xf - v) * q - (xf - w_val) * r;
         q = 2.0 * (q - r);
         if(q > 0.0)
            p = -p;
         q = MathAbs(q);
         r = e;
         e = d;
         if(MathAbs(p) < MathAbs(0.5 * q * r) && p > q * (a - xf) && p < q * (b - xf))
           {
            d = p / q;
            x = xf + d;
            if((x - a) < tol2 || (b - x) < tol2)
              {
               double si = (xm >= xf) ? 1.0 : -1.0;
               d = tol1 * si;
              }
           }
         else
            gs = true;
        }
      if(gs)
        {
         e = (xf >= xm) ? a - xf : b - xf;
         d = c * e;
        }
      double si = (d >= 0) ? 1.0 : -1.0;
      x = xf + si * MathMax(MathAbs(d), tol1);
      fu = func.Value(x);
      funccount++;
      if(fu <= fx)
        {
         if(x >= xf)
            a = xf;
         else
            b = xf;
         v = w_val;
         fv = fw;
         w_val = xf;
         fw = fx;
         xf = x;
         fx = fu;
        }
      else
        {
         if(x < xf)
            a = x;
         else
            b = x;
         if(fu <= fw || w_val == xf)
           {
            v = w_val;
            fv = fw;
            w_val = x;
            fw = fu;
           }
         else
            if(fu <= fv || v == xf || v == w_val)
              {
               v = x;
               fv = fu;
              }
        }
      if(funccount >= Nitmax)
         break;
     }
   if(fa < fx && fa <= fb)
     {
      xf = xlow;
      fx = fa;
     }
   else
      if(fb < fx)
        {
         xf = xupp;
         fx = fb;
        }
   xmin = xf;
   fmin = fx;
   return converged;
  }
Вспомогательные методы
- Init(): определяет стартовые значения параметров перед началом работы ЕМ-алгоритма,
- studentLogprob(): логарифм плотности вероятности распределения Стьюдента,
- Convergence(): проверка сходимости по относительному изменению правдоподобия,
- CStudentNLL: вспомогательный класс, передающий целевую функцию NLL в оптимизатор метода Брента.
//+------------------------------------------------------------------+
//|    Класс регрессии Стьюдента                                     |
//+------------------------------------------------------------------+
class CStudentRegression : public CRobustRegression
  {
private:
   int               m_max_iter;       // Максимальное число итераций EM-алгоритма
   double            m_tol;            // Порог сходимости по лог-правдоподобию
   double            m_init_dof;       // Начальное число степеней свободы (nu)
   bool              estimate_dof;

   vector            m_y;              // вектор целевой переменной
   matrix            m_X;              // Исходная матрица признаков
   matrix            m_x_weighted;     // Взвешенная матрица признаков
   vector            m_y_weighted;     // Взвешенный вектор целевой переменной
   vector            m_weights_s;      // Веса робастности (скрытые переменные)

   vector            m_meanX;          // Средние значения признаков по столбцам
   double            m_ybar;           // Среднее значение целевой переменной y
   double            m_current_loglik; // Текущее значение лог-правдоподобия
   ulong             m_N;              // Количество строк (наблюдений) в матрице X
   ulong             m_D;              // Количество столбцов (признаков) в матрице X

   void              Init();
   void              Estep();          // Е-шаг
   void              Mstep();          // М-шаг

   vector            LinregLogprob(double dof_val);
   vector            studentLogprob(const vector &mu, const double sigma2_val, const double dof_val, const vector &y);
   bool              Convergence(const double fval, const double previous_fval, const double threshold = 1e-4);

public:
   double            dof;                 // оптимизированное число степеней свободы
   vector            loglik_history;      // История значений лог-правдоподобия по итерациям

                     CStudentRegression(int max_iter = 100,
                      double tol = 1e-4,
                      double init_dof = 0.0,
                      bool fit_intercept = true,
                      bool verbose = false);
   virtual bool      Fit(const matrix &X, const vector &y) override;
   double            NLL(double dof_val);
  };

//+------------------------------------------------------------------+
//| Конструктор                                                      |
//+------------------------------------------------------------------+
CStudentRegression::CStudentRegression(int max_iter, double tol, double init_dof, bool fit_intercept, bool verbose)
   : CRobustRegression(fit_intercept, verbose),
     m_max_iter(max_iter), m_tol(tol), m_init_dof(init_dof)
  {
  }

//+------------------------------------------------------------------+
//| Метод обучения Fit (EM-алгоритм)                                 |
//+------------------------------------------------------------------+
bool CStudentRegression::Fit(const matrix &X, const vector &y)
  {
   m_N = X.Rows();
   m_D = X.Cols();

   if(m_N == 0 || m_D == 0)
      return false;

   m_X = X;

   if(m_fit_intercept)
     {
      m_ybar = y.Mean();
      m_y = y - m_ybar;

      m_meanX.Resize(m_D);
      for(ulong j = 0; j < m_D; j++)
        {
         m_meanX[j] = X.Col(j).Mean();
         m_X.Col(m_X.Col(j) - m_meanX[j], j); //--- Центрируем каждый столбец матрицы X
        }
     }
   else
     {
      m_ybar = 0.0;
      m_y = y;
      m_meanX.Fill(0.0);
     }

   Init();

   loglik_history.Resize(m_max_iter + 1);

   m_weights_s.Resize(m_N);
   m_x_weighted.Resize(m_N, m_D);
   m_y_weighted.Resize(m_N);

   int iter = 0;
   bool done = false;

   while(!done)
     {
      Estep();
      loglik_history[iter] = m_current_loglik;
      Mstep();

      if(iter >= m_max_iter - 1)
         done = true;
      else
         if(iter > 0)
            done = Convergence(loglik_history[iter], loglik_history[iter - 1], m_tol);
      iter++;
     }

   if(m_verbose)
     {
      PrintFormat("StudentRegression:EM converged at %d iterations. Final value: %.6f", iter, loglik_history[iter - 1]);
     }

   loglik_history.Resize(iter);

   if(m_fit_intercept)
     {
      intercept_ = m_ybar - m_meanX @ coef_;
     }
   else
     {
      intercept_ = 0.0;
     }

   return true;
  }

//+------------------------------------------------------------------+
//| Инициализация модели t-регрессии перед циклом EM-алгоритма       |
//+------------------------------------------------------------------+
void CStudentRegression::Init()
  {
   dof = (m_init_dof <= 0.0) ? 10.0 : m_init_dof;
   estimate_dof = (m_init_dof <= 0.0);

   matrix X_pinv = m_X.PInv();
   coef_ = X_pinv @ m_y;

   vector err = m_y - (m_X @ coef_);
   sigma2 = (err @ err) / (double)m_X.Rows();
  }

//+------------------------------------------------------------------+
//| Проверка сходимости модели по изменению функции правдоподобия    |
//+------------------------------------------------------------------+
bool CStudentRegression::Convergence(const double fval, const double previous_fval, const double threshold)
  {
   double eps = 2.2204460492503131e-16;
   double delta_fval = MathAbs(fval - previous_fval);
   double avg_fval   = (MathAbs(fval) + MathAbs(previous_fval) + eps) / 2.0;
   return ((delta_fval / avg_fval) < threshold);
  }
Регрессия Лапласа
Если классический метод наименьших квадратов предполагает нормальное распределение ошибок, то регрессия на основе распределения Лапласа исходит из предположения, что остатки модели подчиняются лапласовскому (двойному экспоненциальному) распределению. Функция плотности этого распределения имеет более острый пик в нуле и более тяжёлые хвосты по сравнению с нормальным законом. Именно поэтому модель оказывается значительно устойчивее к выбросам.
Класс CLaplaceRegression реализует L1-регрессию (метод наименьших абсолютных отклонений, Least Absolute Deviations). Вместо суммы квадратов ошибок минимизируется сумма их абсолютных значений. Благодаря линейному (а не квадратичному) штрафу за отклонения единичные выбросы оказывают гораздо меньшее влияние на итоговые оценки коэффициентов регрессии.
Важно отметить, что минимизация суммы абсолютных отклонений математически эквивалентна максимизации правдоподобия при условии, что ошибки модели распределены по закону Лапласа. Поэтому, в отличие от модели Стьюдента, где мы явно работали с лог-правдоподобием, здесь мы сразу оптимизируем соответствующую функцию потерь. Это более прямой и эффективный способ решения той же самой статистической задачи.
Однако оптимизация L1-регрессии имеет одну важную математическую особенность: ее функция потерь недифференцируема в точках, где остаток равен нулю. Из-за этого стандартные градиентные методы (L-BFGS и подобные) здесь неприменимы напрямую. К счастью, задачу минимизации суммы абсолютных отклонений можно точно и эффективно переформулировать как задачу линейного программирования (Linear Programming). Линейное программирование — это раздел математической оптимизации, в котором и целевая функция, и все ограничения являются линейными. Такие задачи хорошо изучены и решаются специализированными алгоритмами очень надёжно и с высокой точностью (в отличие от общих нелинейных задач). Именно поэтому сведение L1-регрессии к линейному программированию является предпочтительным подходом.
Чтобы перейти к задаче линейного программирования, используют стандартный приём. Для каждого наблюдения (i) вводят две дополнительные неотрицательные переменные ui и vi, которые позволяют выразить ошибку модели ei (разницу между реальным значением yi и предсказанием) следующим образом:
ei = ui − vi,
- ui ≥ 0,
- vi ≥ 0.
|ei| = ui + vi
После такой замены и целевая функция, и все ограничения становятся линейными. Именно в таком виде задача передаётся оптимизатору линейного программирования ALGLIB. В коде общая размерность пространства оптимизации рассчитывается как:M = D1 + 2*N
где- D1 — количество параметров модели (коэффициенты + intercept, если он оценивается),
- 2*N — количество вспомогательных переменных ui и vi (по две на каждое наблюдение).
Формирование целевой функции (cost vector):
В задаче линейного программирования мы минимизируем выражение c_vect^T x → min, где x — вектор всех переменных (коэффициенты модели + вспомогательные переменные ui и vi). Наша цель — минимизировать сумму абсолютных ошибок ∑|ei|. Поскольку |ei| = ui + vi, в векторе стоимостей c_vect мы задаем:
- 0 для всех коэффициентов модели (coef_ и intercept_) — сами коэффициенты напрямую не входят в целевую функцию,
- 1 для всех вспомогательных переменных ui и vi.
Коэффициенты модели влияют на решение не через целевую функцию, а через ограничения. Оптимизатор подбирает такие значения коэффициентов, при которых сумма ui+vi оказывается минимальной.
Задание границ переменных. Переменные делятся на две категории по допустимым диапазонам:
- параметры регрессии не ограничены и могут принимать любые значения,
- вспомогательные переменные (ui, vi) должны быть неотрицательными (≥0).
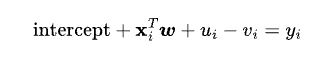
В коде это оформлено в виде матрицы ограничений Aeq, куда для каждой строки записываются:
- константа 1 для смещения (intercept),
- фактические значения признаков X,
- единицы и минус единицы в позициях, соответствующих переменным ui и vi.
Правая часть ограничений привязывается к целевому вектору y.
Запуск оптимизатора ALGLIB и извлечение параметров.
- Метод CAlglib::MinLPOptimize() решает задачу симплекс-методом или методом внутренних точек,
- После успешного завершения оптимизации вспомогательные переменные ui и vi отбрасываются, а первые D1 элементов итогового вектора сохраняются в переменные intercept_ и coef_.
Оценка дисперсии шума
После нахождения оптимальных параметров метод дополнительно вычисляет две оценки дисперсии: классическую выборочную дисперсию остатков (sigma2) и робастную оценку на основе медианы абсолютных отклонений (MAD) (m_laplace_sigma2)
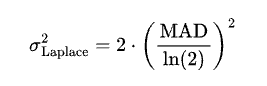
где:
- знаменатель ln(2) связывает медианное абсолютное отклонение с параметром масштаба Лапласа b=MAD/ln(2),
- множитель 2 учитывает теоретическую связь между параметром масштаба b и истинной дисперсией распределения Лапласа.
Получить робастную оценку дисперсии можно через метод GetLaplaceSigma2().
В итоге CLaplaceRegression даёт простой и надёжный способ построения модели, устойчивой к выбросам в целевой переменной.
//+------------------------------------------------------------------+
//|  Класс регрессии Лапласа (L1-регрессии)                          |
//+------------------------------------------------------------------+
class CLaplaceRegression : public CRobustRegression
  {
private:
   double            m_laplace_sigma2; // Дисперсия шума, оцененная через MAD (медиану абсолютных отклонений)

public:
                     CLaplaceRegression(bool fit_intercept = true, bool verbose = false);
   virtual bool      Fit(const matrix &X, const vector &y) override;
   double            GetLaplaceSigma2() const { return m_laplace_sigma2; }
  };

//+------------------------------------------------------------------+
//| Конструктор                                                      |
//+------------------------------------------------------------------+
CLaplaceRegression::CLaplaceRegression(bool fit_intercept, bool verbose)
   : CRobustRegression(fit_intercept, verbose), m_laplace_sigma2(0.0)
  {
  }

//+--------------------------------------------------------------------+
//| Метод обучения Fit с помощью линейного программирования(LP) Alglib |
//+--------------------------------------------------------------------+
bool CLaplaceRegression::Fit(const matrix &X, const vector &y)
  {
   int N = (int)X.Rows();  // Количество наблюдений
   int D = (int)X.Cols();  // Количество признаков
   if(N == 0 || D == 0)
      return false;

   int D1 = m_fit_intercept ? D + 1 : D; // Количество параметров модели (коэффициенты + intercept)
   int M = D1 + 2 * N;     // Общая размерность задачи LP: D1 параметров модели + N переменных u_i + N переменных v_i

//---------------------------------------------------------------
//--- 1. Целевая функция
//--- Минимизируем сумму (u_i + v_i) = сумму абсолютных ошибок
//---------------------------------------------------------------
   vector c_vec = vector::Zeros(M);
   for(int i = D1; i < M; i++)
      c_vec[i] = 1.0;
   CRowDouble c = c_vec;

//---------------------------------------------------------------
//--- 2. Границы переменных
//--- Параметры модели (coef_ и intercept_) не ограничены
//--- Вспомогательные переменные u_i и v_i ≥ 0
//---------------------------------------------------------------
   vector bndl_vec = vector::Zeros(M);
   vector bndu_vec = vector::Zeros(M);

   for(int i = 0; i < D1; i++)
     {
      bndl_vec[i] = -AL_POSINF; // параметры модели: от -∞
      bndu_vec[i] =  AL_POSINF; //                   до +∞
     }
   for(int i = D1; i < M; i++)
     {
      bndl_vec[i] = 0.0;       // u_i ≥ 0 и v_i ≥ 0
      bndu_vec[i] =  AL_POSINF;
     }
   CRowDouble bndl = bndl_vec;
   CRowDouble bndu = bndu_vec;

//---------------------------------------------------------------
//--- 3. Матрица ограничений-равенств Aeq
//--- Для каждого наблюдения i должно выполняться:
//--- intercept + x_i · coef + u_i - v_i  =  y_i
//---------------------------------------------------------------
   matrix Aeq = matrix::Zeros(N, M);

   int col_offset = 0;
   if(m_fit_intercept)
     {
      Aeq.Col(vector::Ones(N), 0); // столбец intercept = 1
      col_offset = 1;
     }

//--- Заполняем столбцы признаков
   for(int r = 0; r < N; r++)
     {
      for(int col = 0; col < D; col++)
        {
         Aeq[r][col + col_offset] = X[r][col];
        }
     }

//--- Добавляем столбцы вспомогательных переменных:
   for(int r = 0; r < N; r++)
     {
      Aeq[r][D1 + r]     =  1.0; // + u_i
      Aeq[r][D1 + N + r] = -1.0; // - v_i
     }

//---------------------------------------------------------------
//--- 4. Запуск оптимизатора  ALGLIB
//---------------------------------------------------------------
   CMatrixDouble a_alglib = Aeq;
   CRowDouble al = y;  // нижняя граница ограничений = y
   CRowDouble au = y;  // верхняя граница ограничений = y

   CMinLPState state;
   CMinLPReport rep;

   CAlglib::MinLPCreate(M, state);
   CAlglib::MinLPSetCost(state, c);                       // целевая функция
   CAlglib::MinLPSetBC(state, bndl, bndu);                // границы переменных
   CAlglib::MinLPSetLC2Dense(state, a_alglib, al, au, N); // ограничения

//--- Масштабирование
   vector s_vec = vector::Ones(M);
   CRowDouble scale = s_vec;
   CAlglib::MinLPSetScale(state, scale);

   CAlglib::MinLPOptimize(state);   // запуск оптимизации

//---------------------------------------------------------------
//--- 5. Результаты оптимизации
//---------------------------------------------------------------
   CRowDouble x_res;
   CAlglib::MinLPResults(state, x_res, rep);

   if(rep.m_terminationtype <= 0)
     {
      if(m_verbose)
         Print("Ошибка оптимизации LP: termination type = ", rep.m_terminationtype);
      return false;
     }

//--- Берем только первые D1 элементов — это параметры модели.
//--- Вспомогательные переменные u_i и v_i отбрасываем.
   vector raw_w;
   raw_w.Resize(D1);
   for(int i = 0; i < D1; i++)
      raw_w[i] = x_res[i];

   if(m_fit_intercept)
     {
      intercept_ = raw_w[0];
      coef_.Resize(D);
      for(int i = 0; i < D; i++)
         coef_[i] = raw_w[i + 1];
     }
   else
     {
      intercept_ = 0.0;
      coef_ = raw_w;
     }
//---------------------------------------------------------------
//--- 6. Оценка дисперсии шума
//---------------------------------------------------------------
   vector y_pred = Predict(X);
   vector err = y_pred - y;

//--- Классическая выборочная дисперсия
   sigma2 = err.Var(1);

//--- Робастная оценка через MAD (Median Absolute Deviation)
   vector err_abs = MathAbs(err);
   double mad = err_abs.Median();
   double b_scale = mad / MathLog(2.0); //параметр масштаба Лапласа
   m_laplace_sigma2 = 2.0 * b_scale * b_scale; // дисперсия для Лапласа = 2 * b^2

   if(m_verbose)
     {
      Print("Оптимизация регрессии Лапласа успешно завершена");
     }

   return true;
  }
Регрессия Хубера
Класс CHuberRegression реализует линейную регрессию с функцией потерь Хубера. Это гибридный подход, который удачно сочетает преимущества метода наименьших квадратов и L1-регрессии. При малых ошибках функция потерь Хубера ведёт себя как квадратичная (как в обычном МНК), при больших ошибках (выбросах) она переходит на линейный штраф (как в L1-регрессии). Благодаря этому влияние аномальных точек на коэффициенты ограничивается.
Функция потерь Хубера
Пусть для каждого наблюдения остаток модели определяется как ri. Тогда функция потерь Хубера с пороговым параметром d (в коде m_delta) задаётся следующим образом:
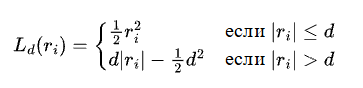
Общая целевая функция для всей выборки из N наблюдений представляет собой сумму потерь по всем точкам:
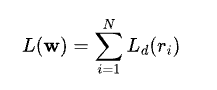
Благодаря такому определению функция потерь Хубера обладает двумя важными свойствами:
- При малых ошибках (∣ri∣ ≤ d) штраф квадратичный, что гарантирует дифференцируемость функции потерь в нуле,
- При крупных выбросах (∣ri∣ > d) штраф становится линейным. Производная функции потерь по остатку в этой области равна константе (± d). Благодаря этому вклад выбросов в градиент по параметрам модели остаётся ограниченным и не зависит от величины отклонения.
Параметр delta является ключевым гиперпараметром модели. Он определяет границу перехода от квадратичного штрафа к линейному: чем он меньше, тем раньше подавляются отклонения. По умолчанию используется значение 1.0, но на практике его выбирают с учетом масштаба данных — например, во вводном примере, где шум ограничен диапазоном [−0.5,0.5], порог delta=1.0 гарантирует, что основные точки остаются в квадратичной зоне, а аномальные выбросы переводятся в линейный режим.
Расчет функции потерь и градиента (HuberLoss)
Для оптимизации методом L-BFGS необходимо одновременно вычислять значение функции и её градиент по вектору параметров модели. Это реализовано в методе HuberLoss().
Производная функции потерь по остатку (вектор весов градиента) задает индивидуальный вклад каждого наблюдения в общий градиент:
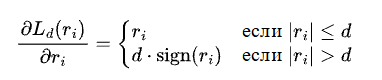
Полный градиент функции потерь по вектору параметров w вычисляется через матричное умножение транспонированной матрицы признаков на вектор весов градиента (grad_weights):
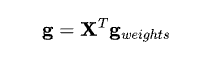
////+------------------------------------------------------------------+
////| Функция потерь Хубера и расчет градиента                         |
////| [in]  w - вектор текущих коэффициентов регрессии                 |
////| [in]  X - матрица признаков                                      |
////| [in]  y - вектор целевых значений                                |
////| [in]  d - порог дельта                                           |
////| [out] f - значение функции потерь                                |
////| [out] g - градиент функции потерь                                |
////+------------------------------------------------------------------+
void CHuberRegression::HuberLoss(const vector &w, const matrix &X, const vector &y, double d,
                                 double &f, vector &g)
  {
   vector r = (X @ w) - y;
   ulong N = X.Rows();
   f = 0.0;

   vector grad_weights(N);

   for(ulong i = 0; i < N; i++)
     {
      double abs_r = MathAbs(r[i]);
      if(abs_r <= d)
        {
         f += 0.5 * abs_r * abs_r;
         grad_weights[i] = r[i];
        }
      else
        {
         f += d * abs_r - 0.5 * d * d;
         grad_weights[i] = d * ((r[i] > 0.0) ? 1.0 : -1.0);
        }
     }

   g = X.Transpose() @ grad_weights;
  }
Метод Fit()
Обучение модели выполняется в несколько этапов:
1. Подготовка данных.
Если включён флаг m_fit_intercept, к матрице признаков слева добавляется столбец единиц.
2. Стартовые значения параметров.
В качестве начального приближения берётся решение обычного метода наименьших квадратов. Это даёт хорошую стартовую точку и ускоряет сходимость.
3. Оптимизация L-BFGS.
Используется реализация метода L-BFGS из библиотеки ALGLIB. Задаются критерии остановки. Для связи оптимизатора с нашим классом применяются два вспомогательных объекта:
- CHuberObjective — передаёт текущие веса в метод Huber_Value_and_Grad и возвращает значение функции и градиента,
- CHuberReport — при включённом режиме verbose выводит в журнал ход оптимизации.
4. Оценка дисперсии.
После нахождения оптимальных коэффициентов рассчитывается дисперсия модели (sigma2).
//+------------------------------------------------------------------+
//| Класс линейной регрессии с функцией потерь Хубера                |
//+------------------------------------------------------------------+
class CHuberRegression : public CRobustRegression
  {
private:
   double            m_delta; // Параметр порога Хубера
   matrix            m_X;     // Матрица признаков
   vector            m_y;     // Вектор целевых значений
   ulong             m_N;     // Количество наблюдений
   ulong             m_D;     // Количество признаков

public:
                     CHuberRegression(double delta = 1.0, bool fit_intercept = true, bool verbose = false);
   virtual bool      Fit(const matrix &X, const vector &y) override;

   void              Huber_Value_and_Grad(CRowDouble &arg, double &func, CRowDouble &grad);
   void              HuberLoss(const vector &w, const matrix &X, const vector &y, double k, double &f, vector &g);
  };

//+------------------------------------------------------------------+
//| Конструктор                                                      |
//+------------------------------------------------------------------+
CHuberRegression::CHuberRegression(double delta, bool fit_intercept, bool verbose)
   : CRobustRegression(fit_intercept, verbose)
  {
   if(delta <= 0.0)
     {
      if(m_verbose)
         PrintFormat("CHuberRegression: Warning! Invalid delta = %.2f. Defaulting to 1.0.", delta);
      m_delta = 1.0;
     }
   else
     {
      m_delta = delta;
     }
  }
//+------------------------------------------------------------------+
//| Метод обучения Fit (оптимизация L-BFGS, ALGLIB)                  |
//+------------------------------------------------------------------+
bool CHuberRegression::Fit(const matrix &X, const vector &y)
  {
   m_N = X.Rows();
   m_D = X.Cols();

   if(m_N == 0 || m_D == 0)
      return false;

   m_y = y;

   if(m_fit_intercept)
     {
      m_X.Resize(m_N, m_D + 1);
      m_X.Col(vector<double>::Ones(m_N), 0);
      for(ulong j = 0; j < m_D; j++)
         m_X.Col(X.Col(j), j + 1);
     }
   else
     {
      m_X = X;
     }

   matrix X_pinv = m_X.PInv();
   vector wLS = X_pinv @ m_y;

   int dim = (int)m_X.Cols();
   double x0[];
   ArrayResize(x0, dim);
   for(int i = 0; i < dim; i++)
      x0[i] = wLS[i];

   CMinLBFGSStateShell state;
   CMinLBFGSReportShell rep_results;

   double epsg = 1e-4;
   double epsf = 0;
   double epsx = 0;
   int maxits  = 100;

   CHuberObjective objective(GetPointer(this));
   CHuberReport report(m_verbose);
   CObject dummy_obj;

   if(m_verbose)
      Print("=== Запуск оптимизации ALGLIB L-BFGS (Huber Loss) ===");

   ulong start_time = GetMicrosecondCount();

   CAlglib::MinLBFGSCreate(dim, x0, state);
   CAlglib::MinLBFGSSetCond(state, epsg, epsf, epsx, maxits);

   if(m_verbose)
      CAlglib::MinLBFGSSetXRep(state, true);

   CAlglib::MinLBFGSOptimize(state, objective, report, true, dummy_obj);
   CAlglib::MinLBFGSResults(state, x0, rep_results);

// --- Проверка статуса завершения оптимизации
   int term_type = rep_results.GetTerminationType();
   if(term_type <= 0)
     {
      if(m_verbose)
         PrintFormat("HuberRegression: L-BFGS optimization failed with termination code: %d", term_type);
      return false;
     }

   ulong end_time = GetMicrosecondCount();

   vector w_opt(dim);
   for(int i = 0; i < dim; i++)
      w_opt[i] = x0[i];

   if(m_fit_intercept)
     {
      intercept_ = w_opt[0];
      coef_.Resize(m_D);
      for(ulong j = 0; j < m_D; j++)
         coef_[j] = w_opt[j + 1];
     }
   else
     {
      intercept_ = 0.0;
      coef_ = w_opt;
     }

   vector y_pred = Predict(X);
   vector err = y_pred - m_y;
   sigma2 = err.Var(1);

   if(m_verbose)
     {
      PrintFormat("Оптимизация регрессии Хубера завершена за %I64u мкс (итераций: %d)",
                  (end_time - start_time), rep_results.GetIterationsCount());
     }

   return true;
  }

//+------------------------------------------------------------------+
//| Расчет функции потерь и ее градиента для оптимизатора L-BFGS     |
//| [in]     arg  - текущие значения весов регрессии                 |
//| [out]    func - вычисленное значение функции потерь              |
//| [out]    grad - вычисленный градиент функции потерь              |
//+------------------------------------------------------------------+
void CHuberRegression::Huber_Value_and_Grad(CRowDouble &arg, double &func, CRowDouble &grad)
  {
   int sz = arg.Size();
   vector w(sz);
   for(int i = 0; i < sz; i++)
      w[i] = arg[i];

   vector g(sz);
   HuberLoss(w, m_X, m_y, m_delta, func, g);
   for(int i = 0; i < sz; i++)
      grad.Set(i, g[i]);
  }

//+------------------------------------------------------------------+
//| Класс целевой функции (Huber) для оптимизатора L-BFGS ALGLIB     |
//+------------------------------------------------------------------+
class CHuberObjective : public CNDimensional_Grad
  {
private:
   CHuberRegression   *m_model; // Указатель на объект регрессии Хубера

public:
                     CHuberObjective(CHuberRegression *model) : m_model(model) {}

   virtual void      Grad(CRowDouble &arg, double &func, CRowDouble &grad, CObject &obj) override
     {
      m_model.Huber_Value_and_Grad(arg, func, grad);
     }
  };

//+------------------------------------------------------------------+
//| Класс вызова отчета для оптимизации Хубера                       |
//| Выводит промежуточные результаты итераций L-BFGS в журнал        |
//+------------------------------------------------------------------+
class CHuberReport : public CNDimensional_Rep
  {
private:
   int               m_iter_count; // Счетчик итераций оптимизации
   bool              m_verbose;    // Флаг вывода сообщений

public:
                     CHuberReport(bool verbose) : m_iter_count(0), m_verbose(verbose) {}

   virtual void      Rep(CRowDouble &arg, double func, CObject &obj) override
     {
      if(m_verbose)
        {
         string params_str = "";
         for(int i = 0; i < arg.Size(); i++)
            params_str += StringFormat("coef_[%d]=%.4f ", i, arg[i]);

         PrintFormat("HuberFit Итерация %2d: Loss = %.10f | %s", m_iter_count, func, params_str);
        }
      m_iter_count++;
     }

   void              Reset() { m_iter_count = 0; }
  };
Заключение
В этой статье мы рассмотрели три различных подхода к построению робастной линейной регрессии в MQL5: модель на основе распределения Стьюдента, регрессию Лапласа (L1) и регрессию с функцией потерь Хубера. Каждый из методов решает одну и ту же задачу — снижение влияния выбросов — но делает это по-своему:
- Регрессия Стьюдента — использует вероятностную модель с тяжёлыми хвостами и обучается с помощью EM-алгоритма. Она автоматически оценивает вклад каждой точки в оценку параметров, уменьшая влияние выбросов,
- Регрессия Лапласа — модель на основе абсолютных отклонений, реализованная с помощью метода линейного программирования из библиотеки ALGLIB,
- Регрессия Хубера — занимает промежуточное положение между обычным методом наименьших квадратов и L1-регрессией. Оптимизируется с помощью численного метода L-BFGS (ALGLIB).
Робастные методы особенно актуальны при работе с финансовыми временными рядами, где тяжёлые хвосты — не исключение, а правило. Использование таких моделей позволяет получать устойчивые оценки параметров, не подверженные искажениям при появлении редких, но значительных ценовых изменений.
Программы, используемые в статье
| # | Имя | Тип | Описание |
|---|---|---|---|
| 1 | RobustRegression.mqh | Включаемый файл | Класс робастной регрессии. Содержит модели Стьюдента, Лапласа и Хубера. |
| 2 | 1D_plot.mq5 | Скрипт | Демонстрация работы моделей на примере одномерных данных. |
| 3 | MQL5.zip | Архив | Архив со всеми файлами статьи |
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.