

Архитектура машинного обучения в MetaTrader 5 (Часть 17): Tестирование на исторических данных методом комбинаторной перекрестной проверки с очисткой (CPCV) — от модели на Python к проверке на уровне тиков
 49
 0

Содержание
- Введение
- Что экспортирует конвейер и что требуется MQL5
- Скрипт экспорта: преобразование артефактов в форматы MQL5
- Воспроизведение конвейера признаков в MQL5
- ONNX-инференс и калибровка в MQL5
- Реализация комбинаторной перекрестной проверки с очисткой (CPCV) с помощью тестера стратегий
- Отчеты по траекториям и постобработка в Python
- Практическое руководство
- Заключение
- Прикрепленные файлы
Введение
Описанный в частях 8–12 конвейер на Python создает обученную модель, обученный калибратор вероятностей, спецификацию признаков и DataFrame событий. Эти артефакты позволяют ответить на один вопрос о модели: обладает ли она статистическим преимуществом по историческим доходностям на уровне баров? Они оставляют без ответа второй вопрос: сохранится ли это статистическое преимущество с учетом издержек исполнения? Спред, проскальзывание, комиссия и своп — не абстрактные числа, а торговые издержки, которые уменьшают выявленное моделью теоретическое преимущество. Распределение коэффициентов Шарпа, рассчитанное по прибылям и убыткам на каждом баре, — полезный диагностический инструмент. А распределение, рассчитанное по результатам исполнения сделок на уровне тиков, служит доказательной базой для принятия решения о запуске стратегии в реальную торговлю.
Эта статья служит мостом между этими двумя мирами. Конвейер экспортирует свои артефакты в форматы, нативные для Python (ONNX, pickle, parquet). Тестер стратегий MetaTrader 5 использует плоские файлы (CSV, JSON). Скрипт экспорта обеспечивает преобразование между ними. На стороне MQL5 советник загружает преобразованные артефакты в функции OnInit(). Он формирует признаки на основе данных баров, выполняет инференс ONNX, применяет калибровочное отображение, определяет размер позиций по логике из части 10 и части 11 и исполняет ордера на потоке тиков. Затем в режиме оптимизации тестера стратегий каждая из φ[N, k] комбинаторных траекторий запускается как отдельный агент тестирования, формируя кривые эквити с точностью до тика, которые собираются и анализируются в Python.
В результате получаем распределение коэффициентов Шарпа по траекториям и оценку вероятности переобучения при тестировании на исторических данных (PBO), рассчитанные на основе исполнения сделок на реальных тиках. Решение о запуске стратегии в реальную торговлю принимается на основе трех показателей из этого распределения: медианы коэффициентов Шарпа по траекториям (сохраняется ли статистическое преимущество после учета издержек?), стандартного отклонения коэффициентов Шарпа по траекториям (стабильны ли результаты при разных временных конфигурациях?) и вероятности переобучения при тестировании на исторических данных (PBO) (лучше ли выбор стратегии, чем случайный выбор?).
Эта статья — Часть 17 серии «Схема машинного обучения в MetaTrader 5». В Части 12 была создана откалиброванная модель, экспорт которой в формате ONNX служит здесь основными входными данными. В статье «Единый конвейер валидации» были определены структура блоков комбинаторной перекрестной проверки с очисткой (CPCV) и расчет вероятности переобучения при тестировании на исторических данных (PBO), которые воспроизводятся в описанной здесь схеме управления запусками тестера стратегий.
Что экспортирует конвейер и что требуется MQL5
Артефакты конвейера
После завершения ModelDevelopmentPipeline.run(export_onnx=True, calibrate=True) метод _save_all_artifacts() записывает следующие файлы в каталог модели с указанием версии:
| Артефакт Python | Формат | Содержание | |
|---|---|---|---|
| 1. | model_*.onnx | ONNX | Полный конвейер sklearn Pipeline (StandardScaler + классификатор), преобразованный с помощью skl2onnx. Преобразователь масштабирования встроен в граф. |
| 2. | calibrator_*.joblib | joblib | Обученный CalibratorCV.calibrator_: объект класса IsotonicRegression или LogisticRegression в зависимости от параметра method. |
| 3. | feature_names_*.pkl | cloudpickle | Упорядоченный список имен столбцов признаков, соответствующий порядку признаков во входном тензоре модели ONNX. |
| 4. | events_*.parquet | parquet | События метода тройного барьера с полями t1 (время окончания интервала разметки), bin, tW, w. Используются для вычисления границ блоков комбинаторной перекрестной проверки с очисткой (CPCV). |
| 5. | config_*.json | JSON | Полная конфигурация обучения: символ, тип бара, параметры определения размера позиции, настройки HPO. |
Ни один из этих форматов не поддерживается MQL5 напрямую. Файл ONNX является исключением: встроенная функция MetaTrader OnnxCreate() загружает его напрямую. Всё остальное требует преобразования. Калибратор необходимо разложить на массивы узловых точек. Спецификации признаков необходимо сериализовать в плоский JSON. Назначения блоков CPCV по траекториям необходимо вычислить заранее и записать в CSV-файлы масок.
Критическое ограничение: преобразователь масштабирования уже встроен
Весь конвейер sklearn Pipeline (StandardScaler + классификатор) экспортируется в виде единого графа ONNX с помощью convert_sklearn(model, ...). Таким образом, параметры StandardScaler уже являются частью вычислительного графа ONNX. MetaTrader 5 должен передавать исходные значения признаков непосредственно в OnnxRun(). Ручное применение z-преобразования перед инференсом привело бы к повторному масштабированию входных данных и незаметному искажению каждого предсказания.
В спецификацию признаков в формате JSON действительно экспортируются среднее значение и стандартное отклонение каждого признака на обучающей выборке. Эти значения включены для диагностической проверки — чтобы убедиться, что исходные значения, вычисленные в MQL5, находятся в ожидаемом диапазоне распределения из конвейера Python, — а не для преобразования. Функция BuildFeatureVector() возвращает только исходные значения.
Контракт реализации
Python отвечает за формирование блоков, преобразование артефактов и постобработку результатов. MQL5 отвечает за моделирование одной траектории комбинаторной перекрестной проверки с очисткой (CPCV) с точностью до тика за каждый проход тестера стратегий. Такое распределение обязанностей позволяет каждой стороне заниматься тем, что у неё получается лучше всего. CombinatorialPurgedCV в Python формирует распределение по φ[N, k] траекториям с учетом очистки, эмбарго и комбинаторного объединения. Встроенный механизм параллелизации тестера стратегий выполняет эти задания одновременно на разных ядрах процессора; сам тестер учитывает спред, проскальзывание, своп и комиссию.
Ключевое проектное решение — заранее определить в Python соответствие между траекториями и барами и экспортировать отдельный файл маски для каждой траектории. Это позволяет избежать экспорта границ блоков и воссоздания комбинаторной логики в MQL5. Задача советника сводится к бинарному поиску: есть ли временная метка текущего бара в файле маски его траектории?
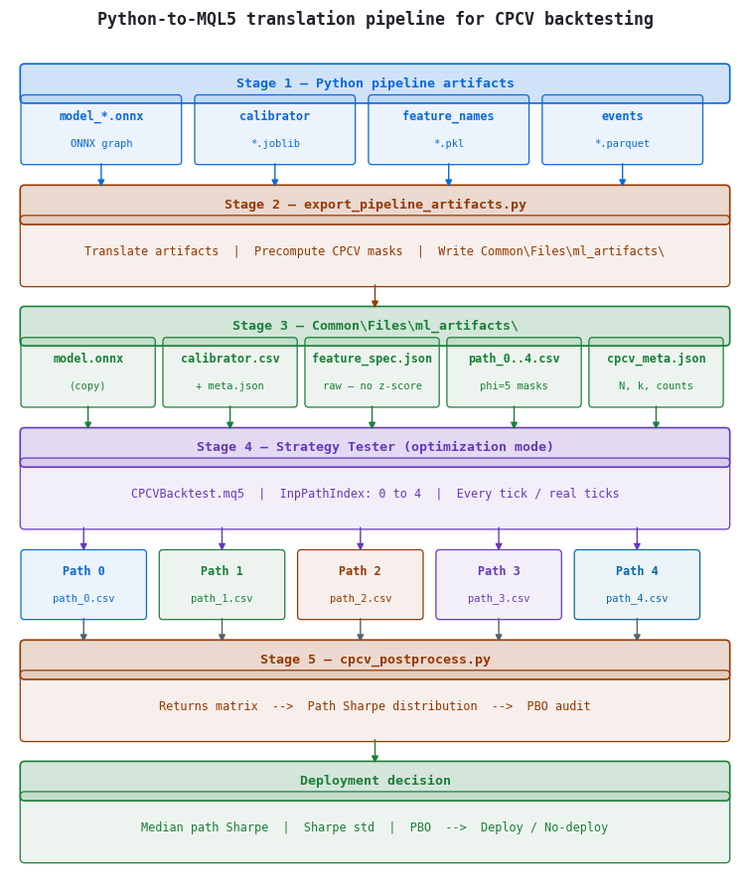
Рисунок 1. Пятиэтапная схема архитектуры переноса из Python в MQL5 для тестирования на исторических данных методом комбинаторной перекрестной проверки с очисткой (CPCV)
- Этап 1: Артефакты конвейера Python (model_*.onnx, calibrator_*.joblib, feature_names_*.pkl, events_*.parquet).
- Этап 2: скрипт export_pipeline_artifacts.py преобразует каждый артефакт в файл с простой структурой и заранее вычисляет маски траекторий комбинаторной перекрестной проверки с очисткой (CPCV).
- Этап 3: в папку MQL5/Files/ml_artifacts/ поступают преобразованные файлы, в том числе по одному файлу path_N.csv для каждой комбинаторной траектории.
- Этап 4: в режиме оптимизации тестера стратегий советник CPCVBacktest.mq5 запускается один раз для каждой траектории (InpPathIndex от 0 до 4 при N = 6, k = 2).
- Этап 5: скрипт cpcv_postprocess.py собирает CSV-файлы с данными о эквити по каждой траектории, вычисляет распределение коэффициентов Шарпа по траекториям и выполняет аудит вероятности переобучения при тестировании на исторических данных (PBO).
Скрипт экспорта: преобразование артефактов в форматы MQL5
Скрипт экспорта служит единой точкой преобразования данных при передаче из конвейера Python в MetaTrader 5. Он загружает каталог модели с помощью функции load_from_path(), извлекает каждый артефакт, преобразует его в формат файла с простой структурой и записывает результаты в каталог Common\Files\ml_artifacts\, где советник ожидает их найти. Файлы, сохраненные в папке Common\Files\, доступны как из MQL5, так и из процесса Python на том же компьютере.
Загрузка каталога модели
from pathlib import Path
import json
import shutil
import numpy as np
import pandas as pd
from sklearn.isotonic import IsotonicRegression
from sklearn.linear_model import LogisticRegression
from afml.production.file_manager import ModelFileManager
from afml.cross_validation.combinatorial import CombinatorialPurgedCV

MODEL_DIR  = Path("./Models/my_strategy/EURUSD/.../a1b2c3d4")
MQL5_FILES = Path(r"C:\...\AppData\Roaming\MetaQuotes\Terminal\...\Common\Files")
OUT_DIR    = MQL5_FILES / "ml_artifacts"
OUT_DIR.mkdir(parents=True, exist_ok=True)
(OUT_DIR / "results").mkdir(exist_ok=True)

N_FOLDS = 6
K_TEST  = 2
# phi = C(6, 2) * 2 // 6 = 15 * 2 // 6 = 5 paths

mgr  = ModelFileManager()
arts = mgr.load_from_path(MODEL_DIR)

model         = arts["model"]          # sklearn Pipeline (scaler + classifier)
calibrator    = arts["calibrator"]     # IsotonicRegression or LogisticRegression
feature_names = arts["feature_names"]  # ordered list
events        = arts["events"]         # DataFrame with t1
config        = arts["config"]         # training config dict
Экспорт калибратора
Калибратор представляет собой либо IsotonicRegression, либо LogisticRegression, в зависимости от параметра method, переданного в CalibratorCV. Для обоих типов калибратора необходимо извлечь числовые параметры и записать их в формате CSV или JSON, чтобы в MQL5 можно было восстановить отображение без использования форматов сериализации, специфичных для Python.
В случае изотонической регрессии отображение представляет собой кусочно-постоянную ступенчатую функцию, определяемую двумя параллельными массивами: узловыми точками по оси x и значениями по оси y. В Scikit-learn эти массивы доступны как атрибуты X_thresholds_ и y_thresholds_. При калибровке Платта отображение представляет собой сигмоиду, определяемую коэффициентом и свободным членом обученной модели LogisticRegression.
if isinstance(calibrator, IsotonicRegression):
    x_pts = calibrator.X_thresholds_
    y_pts = calibrator.y_thresholds_
    pd.DataFrame({"x": x_pts, "y": y_pts}).to_csv(
        OUT_DIR / "calibrator.csv", index=False
    )
    cal_meta = {"method": "isotonic", "n_breakpoints": len(x_pts)}
elif isinstance(calibrator, LogisticRegression):
    A = float(calibrator.coef_[0, 0])
    B = float(calibrator.intercept_[0])
    cal_meta = {"method": "platt", "A": A, "B": B}

json.dump(cal_meta, open(OUT_DIR / "calibrator_meta.json", "w"), indent=2)
Экспорт спецификации признаков
Модель ONNX ожидает признаки строго в том порядке столбцов, который зафиксирован в feature_names. Любое отклонение в порядке признаков, глубине ретроспективного окна или типе вычислений приводит к прогнозам, численно правдоподобным, но неверным по смыслу: модель применяет выученные веса признака A к значению признака B, не выдавая сообщения об ошибке, которое указывало бы на это несоответствие.
Скрипт экспорта записывает JSON-файл, содержащий имя и индекс каждого признака, а также параметры нормализации по обучающей выборке (среднее и стандартное отклонение из обученного компонента предобработки). Эти параметры носят исключительно диагностический характер; советник не применяет их перед вызовом функции OnnxRun(). Два поля — type и lookback — записываются как заготовки, которые специалист должен заполнить в соответствии с фактической логикой формирования признаков, использованной при обучении.
# Extract normalization params from the fitted preprocessor
preprocessor = model.steps[0][1]   # (name, transformer) → transformer
has_mean  = hasattr(preprocessor, "mean_")
has_scale = hasattr(preprocessor, "scale_")

feature_specs = []
for i, name in enumerate(feature_names):
    spec = {
        "name": name,
        "index": i,
        "type": "RSI"
,  # placeholder — edit to match your feature set
        "lookback": 14, # placeholder — edit to match your feature set
        "mean": float(preprocessor.mean_[i])  if has_mean  else 0.0,
        "std": float(preprocessor.scale_[i]) if has_scale else 1.0,
    }
    feature_specs.append(spec)

json.dump(feature_specs,
          open(OUT_DIR / "feature_spec.json", "w"), indent=2)
Генерация масок траекторий комбинаторной перекрестной проверки с очисткой (CPCV)
Это самый важный этап экспорта. Каждая траектория комбинаторной перекрестной проверки с очисткой (CPCV) должна быть представлена набором временных меток баров, составляющих тестовую выборку этой траектории. Советник загружает один файл маски на каждый проход тестера стратегий и торгует только на барах, временные метки которых указаны в этом файле.
Число восстановленных траекторий тестирования на исторических данных составляет φ[N, k] = C(N, k) × k // N. Для N = 6, k = 2: C(6, 2) = 15 разбиений, φ = 15 × 2 // 6 = 5 траекторий. Распространенная ошибка — путать число разбиений (15) с числом траекторий (5). Метод CombinatorialPurgedCV.get_path_ids() возвращает матрицу размера (n_splits, k). Эта матрица сопоставляет каждому тестовому блоку в каждом разбиении индекс траектории. Скрипт экспорта перебирает элементы этой структуры и собирает временные метки для каждой траектории.
cv = CombinatorialPurgedCV(
    n_folds=N_FOLDS, n_test_folds=K_TEST,
    t1=events["t1"], pct_embargo=0.01,
)

n_paths  = cv.n_test_paths    # 5 for N=6, k=2
path_ids = cv.get_path_ids()  # shape (n_splits, k)
X_dummy  = pd.DataFrame(np.zeros((len(events), 1)), index=events.index)

path_bars = {p: [] for p in range(n_paths)}

for split_idx, (_, test_lists) in enumerate(cv.split(X_dummy)):
    for fold_j, test_idx in enumerate(test_lists):
        path_id = path_ids[split_idx, fold_j]
        timestamps = events.index[test_idx]
        path_bars[path_id].extend(timestamps.tolist())

for path_id, timestamps in path_bars.items():
    pd.Series(sorted(set(timestamps)), name="timestamp").to_csv(
        OUT_DIR / f"path_{path_id}.csv", index=False
    )

meta = {"n_folds": N_FOLDS, "k_test": K_TEST,
        "n_paths": n_paths, "symbol": config.get("symbol", "")}
json.dump(meta, open(OUT_DIR / "cpcv_meta.json", "w"), indent=2)
print(f"Exported {n_paths} path masks — InpPathIndex: 0..{n_paths-1}")
После выполнения этого скрипта каталог Common\Files\ml_artifacts\ содержит: файл модели ONNX, файлы calibrator.csv и calibrator_meta.json, файл feature_spec.json, пять файлов path_N.csv (для N=6, k=2) и файл cpcv_meta.json.
Дескрипторы индикаторов и структура спецификации признаков
В API индикаторов MQL5 используются дескрипторы: каждая из функций iRSI(), iATR() и iMA() возвращает целочисленный дескриптор, а не значение индикатора. Значения извлекаются с помощью функции CopyBuffer(), в которой указывается этот дескриптор. Советник создает все необходимые дескрипторы один раз в функции OnInit() и освобождает их в функции OnDeinit(). Этим жизненным циклом управляет модуль FeatureEngine.mqh.
Перечисление типов признаков и структура спецификации отдельного признака определены в файле FeatureEngine.mqh:
//+------------------------------------------------------------------+
//| ENUM_FEAT_TYPE: indicator type for each feature.                 |
//| Extend this enum and add a matching case in BuildFeatureVector() |
//| for any indicator type used in your Python feature engineering.  |
//+------------------------------------------------------------------+
enum ENUM_FEAT_TYPE
  {
   FEAT_RSI,        // RSI(period)
   FEAT_ATR_NORM,   // ATR(period) / Close
   FEAT_LOG_RETURN, // log(Close[1] / Close[1+period])
   FEAT_MA_RATIO,   // Close / SMA(period) - 1.0
   FEAT_HIST_VOL,   // rolling std-dev of log-returns over last period bars
  };

struct SFeatureSpec
  {
   string         name;      // column name from Python
   int            index;     // position in the ONNX input tensor
   ENUM_FEAT_TYPE type;      // computation type
   int            lookback;  // indicator window
   double         mean;      // training-set mean (diagnostic only)
   double         std_dev;   // training-set std  (diagnostic only)
  };
Построение вектора признаков
Функция BuildFeatureVector() перебирает массив спецификаций, извлекает значение каждого индикатора с помощью CopyBuffer() и записывает в выходной массив исходное значение типа float. Преобразование в z-оценку не применяется; StandardScaler является частью графа ONNX. Во всех функциях индикаторов и ценовых данных аргумент, задающий индекс бара, равен 1 (последний закрытый бар). Использование индекса бара 0 приводит к смещению из-за использования будущих данных на уровне тиков, поскольку цена закрытия формирующегося бара все еще меняется.
//+------------------------------------------------------------------+
//| BuildFeatureVector: compute raw features for the closed bar.     |
//|                                                                  |
//| Returns raw (unscaled) float values.  The StandardScaler is      |
//| baked into the ONNX graph; passing scaled values would corrupt   |
//| inference results.                                               |
//+------------------------------------------------------------------+
bool BuildFeatureVector(float &features[])
  {
   if(!g_handles_valid || g_n_features == 0)
      return(false);
   if(ArrayResize(features, g_n_features) < 0)
      return(false);

   double buf[1];
   for(int i = 0; i < g_n_features; i++)
     {
      double raw = 0.0;
      switch(g_feat_specs[i].type)
        {
         case FEAT_RSI:
            if(CopyBuffer(g_rsi_handle[i], 0, 1, 1, buf) < 0)
               return(false);
            raw = buf[0];
            break;

         case FEAT_ATR_NORM:
           {
            if(CopyBuffer(g_atr_handle[i], 0, 1, 1, buf) < 0)
               return(false);
            double close1 = iClose(_Symbol, _Period, 1);
            raw = (close1 > 0) ? buf[0] / close1 : 0.0;
            break;
           }

         case FEAT_LOG_RETURN:
           {
            double c1 = iClose(_Symbol, _Period, 1);
            double c0 = iClose(_Symbol, _Period, g_feat_specs[i].lookback + 1);
            raw = (c1 > 0 && c0 > 0) ? MathLog(c1 / c0) : 0.0;
            break;
           }

         case FEAT_MA_RATIO:
           {
            if(CopyBuffer(g_ma_handle[i], 0, 1, 1, buf) < 0)
               return(false);
            double close1 = iClose(_Symbol, _Period, 1);
            raw = (buf[0] > 0) ? (close1 / buf[0]) - 1.0 : 0.0;
            break;
           }
        }
      features[i] = (float)raw;  // ONNX input is float32
     }
   return(true);
  }
Этап проверки, который нельзя пропускать: после построения вектора признаков для первого бара тестирования на исторических данных запишите исходные значения в журнал и сравните их с выходными данными конвейера Python для того же бара. Ошибки смещения индекса на единицу при индексации по глубине ретроспективного окна — наиболее распространенная причина незаметного искажения предсказаний. Непосредственное сравнение данных первого бара позволяет выявить эти ошибки до того, как они распространятся на тысячи вызовов инференса.
Инференс ONNX и калибровка в MQL5
Загрузка и запуск модели ONNX
Модель загружается один раз в OnInit() и повторно используется на всех барах. Форма входного тензора должна точно соответствовать количеству признаков. Важное отличие от предыдущей редакции заключается в том, что на вход ONNX должен подаваться двумерный тензор формы (1, n_features), а не одномерный массив. Функция OnnxRun() в MQL5 требует, чтобы размеры массива соответствовали форме, заданной функцией OnnxSetInputShape().
//+------------------------------------------------------------------+
//| OnTick: new-bar guard, mask check, inference, sizing, execution. |
//+------------------------------------------------------------------+
void OnTick()
  {
//--- New-bar guard
   datetime current = iTime(_Symbol, _Period, 0);
   if(current == g_last_bar_time)
      return;
   g_last_bar_time = current;

//--- Use the most recently CLOSED bar (index 1)
   datetime bar_time = iTime(_Symbol, _Period, 1);
   if(!IsTestBar(bar_time))
      return;

//--- Build raw feature vector (no z-score — scaler is baked into ONNX)
   float features[];
   if(!BuildFeatureVector(features))
      return;

//--- 2D input tensor required by OnnxRun()
   float input_data[1][FE_MAX_FEATURES];
   for(int i = 0; i < g_n_features; i++)
      input_data[0][i] = features[i];

   float output_data[1][2];
   if(!OnnxRun(g_onnx_handle, ONNX_DEFAULT, input_data, output_data))
      return;

   double raw_prob = (double)output_data[0][1];  // P(class=1)
   double cal_prob = ApplyCalibrator(raw_prob);

//--- Signal + Kelly sizing from Parts 10 and 11
   double signal     = GetSignal(cal_prob, 2);
   double kelly_m    = KellyMultiplier(cal_prob, InpPayoffRatio, InpKellyFraction);
   double final_size = signal * kelly_m;

   ExecuteOrder(final_size, bar_time);
  }
Применение калибратора
В случае изотонической регрессии откалиброванное значение для любой исходной вероятности в интервале [x[i], x[i+1]) непосредственно равно y[i]. Изотоническая регрессия является кусочно-постоянной, а не кусочно-линейной. Бинарный поиск возвращает значение левого сегмента с индексом lo; интерполяция не производится. Это в точности соответствует поведению метода IsotonicRegression.predict() в scikit-learn.
При калибровке Платта откалиброванное значение вычисляется по двухпараметрической сигмоиде: 1 / (1 + exp(-(A × raw + B))). Параметры A и B экспортируются в файл calibrator_meta.json и считываются в функции OnInit().
//+------------------------------------------------------------------+
//| ApplyCalibrator: piecewise constant lookup or sigmoid.           |
//+------------------------------------------------------------------+
double ApplyCalibrator(double raw_prob)
  {
   if(g_cal_method == CAL_METHOD_ISOTONIC)
     {
      int n = ArraySize(g_cal_x);
      if(n == 0)              return(raw_prob);
      if(raw_prob <= g_cal_x[0])     return(g_cal_y[0]);
      if(raw_prob >= g_cal_x[n-1])  return(g_cal_y[n-1]);
      int lo = 0, hi = n - 1;
      while(hi - lo > 1)
        {
         int mid = (lo + hi) / 2;
         if(g_cal_x[mid] <= raw_prob) lo = mid;
         else hi = mid;
        }
      return(g_cal_y[lo]);  // piecewise constant: left-segment value
     }
//--- Platt scaling: sigmoid(A * x + B)
   return(1.0 / (1.0 + MathExp(-(g_platt_A * raw_prob + g_platt_B))));
  }
Реализация комбинаторной перекрестной проверки с очисткой (CPCV) с помощью тестера стратегий
Загрузка маски траектории
При каждом проходе тестера стратегий загружается один файл маски траектории. Вместо использования хеш-таблицы (для которой требуется файл Generic/HashMap.mqh) советник загружает временные метки в отсортированный массив и на каждом баре выполняет двоичный поиск со сложностью O(log n). Для типичных тестовых окон комбинаторной перекрестной проверки с очисткой (CPCV) размером от нескольких сотен до нескольких тысяч баров такие накладные расходы пренебрежимо малы.
Файлы открываются с флагом FILE_COMMON, при котором пути определяются относительно папки терминала Common\Files\. Этот флаг обязателен: без него в некоторых конфигурациях брокера тестер стратегий не сможет найти файлы, созданные скриптом экспорта на Python.
//+------------------------------------------------------------------+
//| LoadPathMask: load sorted timestamp array from path_N.csv.       |
//+------------------------------------------------------------------+
bool LoadPathMask(int path_index)
  {
   string fname = StringFormat(ARTIFACTS_DIR + "path_%d.csv", path_index);
   int fh = FileOpen(fname, FILE_READ | FILE_CSV | FILE_COMMON, ",");
   if(fh == INVALID_HANDLE)
     {
      PrintFormat("LoadPathMask: cannot open %s, error=%d", fname, GetLastError());
      return(false);
     }
   FileReadString(fh);   // skip header
   g_n_test_bars = 0;

   while(!FileIsEnding(fh))
     {
      string ts_str = FileReadString(fh);
      if(StringLen(ts_str) == 0)
         continue;
      if(ArrayResize(g_test_bars, g_n_test_bars + 1) < 0)
        {
         FileClose(fh);
         return(false);
        }
      g_test_bars[g_n_test_bars] = StringToTime(ts_str);
      g_n_test_bars++;
     }
   FileClose(fh);
   ArraySort(g_test_bars);  // sort for binary search
   PrintFormat("LoadPathMask: path %d — %d bars", path_index, g_n_test_bars);
   return(g_n_test_bars > 0);
  }

bool IsTestBar(datetime bar_time)
  {
   int lo = 0, hi = g_n_test_bars - 1;
   while(lo <= hi)
     {
      int mid = (lo + hi) / 2;
      if(g_test_bars[mid] == bar_time) return(true);
      if(g_test_bars[mid] < bar_time)  lo = mid + 1;
      else hi = mid - 1;
     }
   return(false);
  }
Исполнение ордеров
Функция ExecuteOrder() обрабатывает три случая: открытие новой позиции, разворот существующей позиции при смене направления сигнала и закрытие позиции, когда сигнал опускается ниже минимального порога. Каждый объем в лотах нормализуется с помощью NormalizeLot() перед передачей в CTrade, а перед отправкой каждого ордера выполняется проверка маржи с помощью OrderCalcMargin().
//+------------------------------------------------------------------+
//| NormalizeLot: clamp to broker step and limits.                   |
//+------------------------------------------------------------------+
double NormalizeLot(string symbol, double raw_lot)
  {
   double step = SymbolInfoDouble(symbol, SYMBOL_VOLUME_STEP);
   double mn   = SymbolInfoDouble(symbol, SYMBOL_VOLUME_MIN);
   double mx   = SymbolInfoDouble(symbol, SYMBOL_VOLUME_MAX);
   double lot  = MathRound(raw_lot / step) * step;
   lot = MathMax(mn, MathMin(mx, lot));
   return(NormalizeDouble(lot, 2));
  }

//+------------------------------------------------------------------+
//| CheckMargin: return false if margin is insufficient.             |
//+------------------------------------------------------------------+
bool CheckMargin(string symbol, double lots, ENUM_ORDER_TYPE order_type)
  {
   MqlTick tick;
   if(!SymbolInfoTick(symbol, tick))
      return(false);
   double price  = (order_type == ORDER_TYPE_SELL) ? tick.bid : tick.ask;
   double margin = 0.0;
   double free   = AccountInfoDouble(ACCOUNT_MARGIN_FREE);
   if(!OrderCalcMargin(order_type, symbol, lots, price, margin))
      return(false);
   return(margin <= free);
  }
Параллелизация по траекториям
В режиме оптимизации тестер стратегий выполняет проход для каждого значения InpPathIndex в отдельном агенте тестирования (0..φ − 1). Речь идет не о поиске параметров, а об использовании параллельной инфраструктуры тестера для моделирования траекторий. Для N=6, k=2 (φ=5 траекторий) настройте оптимизатор следующим образом:
//--- Strategy Tester settings:
//---   Optimization:  Complete (slow)
//---   Model:         Every tick based on real ticks
//---   InpPathIndex:  from=0, to=4, step=1  (phi=5 for N=6, k=2)
//---   Custom criterion: OnTester() return value

//+------------------------------------------------------------------+
//| OnTester: return path Sharpe as optimization criterion.          |
//+------------------------------------------------------------------+
double OnTester()
  {
   return(ComputePathSharpe());
  }

//+------------------------------------------------------------------+
//| OnDeinit: close position, write equity CSV, release resources.   |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
  {
   ClosePosition();
   WritePathCSV(InpPathIndex);
   ReleaseIndicatorHandles();
   if(g_onnx_handle != INVALID_HANDLE)
      OnnxRelease(g_onnx_handle);
  }
Диапазон дат в тестере стратегий должен охватывать весь период событий, а не только тестовые блоки. Советник пропускает бары, временные метки которых отсутствуют в его маске траектории. Если диапазон дат короче периода событий, советник пропустит тестовые бары, оказавшиеся за пределами окна тестера.
Отчеты по траекториям и постобработка в Python
Сбор результатов по траекториям
После завершения всех проходов для каждой траектории уже сохранен CSV-файл Common\Files\ml_artifacts\results\path_N.csv, содержащий временной ряд средств на уровне баров для этой траектории. Постпроцессор считывает эти файлы, формирует матрицу доходностей, вычисляет распределение коэффициентов Шарпа по траекториям и выполняет оценку вероятности переобучения при тестировании на исторических данных (PBO).
Функция compute_pbo() требует ряд t1, выровненный по индексу матрицы доходностей. Поскольку комбинаторная перекрестная проверка с очисткой (CPCV) симметрична, мы передаем нейтральный ряд t1, в котором каждая временная метка служит собственным временем окончания:
from pathlib import Path
import pandas as pd
import numpy as np
from afml.cross_validation.pbo import compute_pbo

results_dir = Path(r"C:\...\Common\Files\ml_artifacts\results")
n_paths = 5   # phi = 5 for N=6, k=2

path_series = []
for i in range(n_paths):
    df  = pd.read_csv(results_dir / f"path_{i}.csv", parse_dates=["timestamp"])
    eq  = df.set_index("timestamp")["equity"]
    ret = eq.pct_change().fillna(0)
    path_series.append(ret.rename(i))

returns_matrix = pd.concat(path_series, axis=1).fillna(0)

# Neutral t1 for symmetric CPCV (required parameter)
t1_neutral = pd.Series(returns_matrix.index, index=returns_matrix.index)

# Path Sharpe distribution
path_sharpes = returns_matrix.apply(
    lambda s: s.mean() / s.std() * np.sqrt(252)
    if s.std() > 1e-9 else 0
)

# PBO audit
pbo_result = compute_pbo(returns_matrix, t1=t1_neutral, n_folds=8)

print(f"Median path Sharpe:  {path_sharpes.median():.3f}")
print(f"Path Sharpe std:     {path_sharpes.std():.3f}")
print(f"PBO:                 {pbo_result['pbo']:.4f}")
Интерпретация распределения
Три вопроса позволяют определить, подходит ли стратегия для ввода в эксплуатацию:
- Положительна ли медиана коэффициентов Шарпа по траекториям после учета издержек? Если результаты комбинаторной перекрестной проверки с очисткой (CPCV) на уровне баров выглядели многообещающими, но центр распределения на уровне тиков находится вблизи нуля, то статистическое преимущество стратегии полностью поглощается издержками исполнения. Сдвиг между распределениями на уровне баров и на уровне тиков позволяет точно оценить издержки торговли по этой стратегии в долларовом выражении.
- Узкое ли распределение? Широкое распределение свидетельствует о неустойчивости стратегии. Результативность модели зависит от того, с какой временной конфигурацией она столкнулась, а не от устойчивой структурной закономерности. Стандартное отклонение выше 0.5 требует осторожности; при значении выше 1.0 стратегия зависит от конкретной траектории, а не опирается на устойчивые структурные закономерности.
- Значение вероятности переобучения при тестировании на исторических данных (PBO) ниже 0.5? Вероятность переобучения при тестировании на исторических данных (PBO) измеряет вероятность того, что конфигурация стратегии, лучшая на обучающей выборке, покажет результат ниже медианного вне обучающей выборки. Показатель вероятности переобучения при тестировании на исторических данных (PBO), близкий к 0.5, означает, что эффективность отбора не превосходит случайного выбора. Показатель вероятности переобучения при тестировании на исторических данных (PBO) ниже 0.15 служит весомым свидетельством отсутствия переобучения.
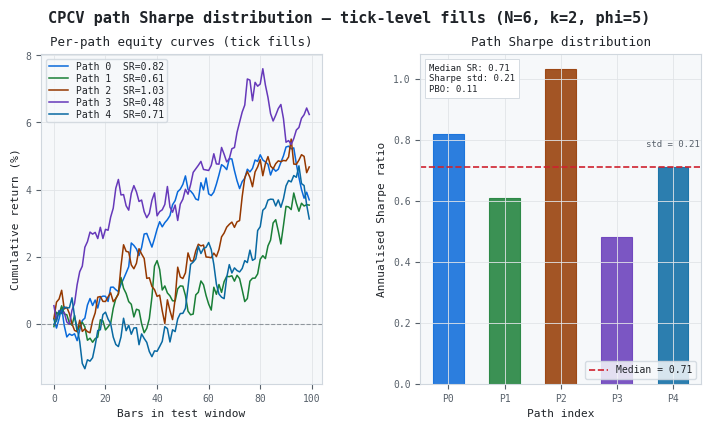
Рисунок 2. Иллюстрация из двух панелей: распределение коэффициентов Шарпа по траекториям комбинаторной перекрестной проверки с очисткой (CPCV) по результатам моделирования на уровне тиков (N=6, k=2, φ=5 траекторий)
- Панель (a): Накопленные доходности для каждой из пяти комбинаторных траекторий, рассчитанные по значениям средств на уровне баров, записанным в OnDeinit(). Все пять траекторий прибыльны; разброс результатов невелик.
- Панель (b): Коэффициенты Шарпа по траекториям с медианой, обозначенной пунктирной линией. Три сводных показателя (медиана коэффициентов Шарпа: 0.71, стандартное отклонение: 0.21, вероятность переобучения при тестировании на исторических данных (PBO): 0.11) удовлетворяют всем трем критериям ввода в эксплуатацию.
Практическое руководство
Полный процесс — от обученной модели до принятия решения о запуске стратегии в реальную торговлю — состоит из семи этапов.
- Запустите конвейер с включенными функциями экспорта в формат ONNX и калибровки:
model, features, metrics, config = pipeline.run( calibrate=True, export_onnx=True ) - Запустите скрипт экспорта. В результате создаются пять артефактов, пригодных для использования в MQL5, и выводится корректный диапазон значений InpPathIndex:
python export_pipeline_artifacts.py \ --model-dir ./Models/.../a1b2c3d4 \ --mql5-dir "C:\...\AppData\Roaming\MetaQuotes\Terminal\...\Common\Files" \ --n-folds 6 --k-test 2 # Output: Exported 5 path masks — InpPathIndex: from=0, to=4 - Отредактируйте файл feature_spec.json. Скрипт экспорта записывает значения-заглушки для полей type и lookback. Обновите каждую запись в соответствии с фактическим типом индикатора и окном расчета, использованными при формировании признаков в Python. Порядок признаков в файле должен точно соответствовать списку feature_names.
- Скомпилируйте файл CPCVBacktest.mq5 в MetaEditor. Убедитесь, что при использовании #property strict отсутствуют ошибки и предупреждения.
- Настройте тестер стратегий. Установите символ и период в соответствии с конфигурацией обучения. Выберите «Каждый тик на основе реальных тиков». Укажите диапазон дат, охватывающий весь временной интервал событий. На вкладке «Оптимизация» установите для параметра InpPathIndex значения: от=0, до=4, шаг=1. Выберите режим оптимизации «Медленная (полный перебор параметров)».
- Запустите оптимизацию. Каждый из пяти агентов тестирования обрабатывает одну траекторию независимо от других. На компьютере с 8 ядрами выполнение задачи занимает примерно в 1.5–2 раза больше времени, чем при одном проходе.
- Запустите постпроцессор:
python cpcv_postprocess.py \
    --results-dir "C:\...\Common\Files\ml_artifacts\results" \
    --n-paths 5
Если медиана коэффициентов Шарпа по траекториям положительна, стандартное отклонение ниже 0.5, а вероятность переобучения при тестировании на исторических данных (PBO) ниже 0.5, то стратегия прошла проверку на уровне тиков. Следующий шаг — форвард-тестирование на демосчете, которое выходит за рамки этой статьи.
Заключение
Эта статья завершает цикл от обучения модели на Python до моделирования на MQL5 с точностью до тика. Конвейер экспортирует пять типов артефактов; скрипт экспорта преобразует их в плоские файлы. Советник загружает эти файлы в OnInit(), применяет их последовательно для каждого бара в OnTick() и выводит результаты по траекториям через CSV и OnTester(). Благодаря параллелизации тестер стратегий одновременно выполняет все φ[N, k] траекторий, а Python на основе полученных рядов формирует распределение коэффициентов Шарпа по траекториям и проводит проверку вероятности переобучения при тестировании на исторических данных (PBO).
Основные моменты реализации:
- Конвейер sklearn (StandardScaler + классификатор) экспортируется в виде единого графа ONNX. Код MQL5 должен передавать в OnnxRun() исходные значения признаков; применение z-нормализации перед инференсом приводит к двойному масштабированию входных данных и искажает предсказания без каких-либо сообщений об ошибке.
- API индикаторов MQL5 основан на использовании дескрипторов: функции iRSI(), iATR() и iMA() возвращают дескрипторы, а не значения. Значения получают с помощью CopyBuffer(). Все дескрипторы должны создаваться в OnInit() и освобождаться в OnDeinit().
- Входной тензор ONNX должен представлять собой двумерный массив размером (1, n_features). В некоторых версиях среды выполнения передача одномерного массива приводит к сбою без сообщения об ошибке.
- Маски траекторий необходимо загружать из папки Common\Files\ с использованием флага FILE_COMMON. Без этого флага в некоторых конфигурациях тестер стратегий не сможет найти файлы по путям, записанным скриптом экспорта на Python.
- Для N = 6, k = 2: C(6, 2) = 15 разбиений, φ = 5 траекторий. Для оптимизации в тестере стратегий необходимо задать диапазон значений InpPathIndex: от 0 до 4 с шагом 1. При значении параметра to=14 выполняется перебор несуществующих траекторий.
- Решение о запуске стратегии в реальную торговлю основывается на трех показателях: медиане коэффициентов Шарпа по траекториям (положительна?), стандартном отклонении коэффициентов Шарпа (ниже 0.5?) и вероятности переобучения при тестировании на исторических данных (PBO) (ниже 0.5?). Результаты на уровне баров носят диагностический характер; результаты на уровне тиков служат доказательной базой.
Прикрепленные файлы
| Файл | Язык | Описание | |
|---|---|---|---|
| 1. | CPCVBacktest.mq5 | MQL5 | Советник, реализующий полный цикл OnInit / OnTick / OnTester / OnDeinit. Загружает модель ONNX, калибратор, спецификацию признаков и маску траектории. Применяет логику определения размера позиции, описанную в частях 10 и 11. При каждом проходе оптимизации записывает CSV-файл с данными о эквити для соответствующей траектории. |
| 2. | FeatureEngine.mqh | MQL5 | Подключаемый файл, в котором реализованы функции LoadFeatureSpec(), CreateIndicatorHandles(), BuildFeatureVector() и ReleaseIndicatorHandles(). Считывает файл feature_spec.json и управляет всеми дескрипторами индикаторов. Возвращает исходные значения признаков (до масштабирования). |
| 3. | Calibrator.mqh | MQL5 | Подключаемый файл, реализующий функции LoadCalibrator() и ApplyCalibrator() как для изотонической регрессии (кусочно-постоянное отображение с двоичным поиском), так и для масштабирования Платта (сигмоидальное отображение). |
| 4. | export_pipeline_artifacts.py | Python | Загружает результаты работы конвейера с помощью load_from_path(), извлекает узловые точки калибратора, формирует спецификацию признаков в формате JSON, предварительно вычисляет маски траекторий комбинаторной перекрестной проверки с очисткой (CPCV) и копирует файл ONNX в папку Common\Files\. |
| 5. | cpcv_postprocess.py | Python | Считывает CSV-файлы со средствами по каждой траектории, формирует матрицу доходностей, вычисляет распределение коэффициентов Шарпа по траекториям и выполняет проверку вероятности переобучения при тестировании на исторических данных (PBO) с помощью функции compute_pbo(), а также записывает файл summary.json. |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/21954
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


