

Регрессия на основе гауссовских процессов на MQL5: Краткосрочное прогнозирование цен с полосами неопределенности
 27
 0

Введение
Качество работы гауссовского процесса определяется качеством подаваемых на вход данных. Возникает соблазн, особенно при работе с гауссовскими процессами, рассматривать модель как черный ящик, который сам "выявит" структуру данных: достаточно подать ему побольше точек, а всю работу выполнит ядро. Эта статья посвящена тому, как противостоять этому искушению. Представленный здесь алгоритм прогнозирует краткосрочные изменения цены XAUUSD, обучаясь на логарифмической доходности предыдущего бара в качестве признака и на фактической логарифмической доходности за будущий горизонт прогнозирования в качестве целевой переменной. Обе величины реально характеризуют состояние рынка, а не служат условными заменителями. Это различие определяет все последующие проектные решения — от выбора ядра до фильтра уверенности советника.
Все реализовано на чистом MQL5 — без ALGLIB и внешних DLL. Алгоритм гауссовского процесса самостоятельно строит симметричную матрицу ядра, выполняет ее разложение Холецкого с адаптивной диагональной добавкой и разграничивает неопределенность модели относительно лежащего в основе данных тренда (латентную дисперсию) и неопределенность относительно будущей наблюдаемой цены (дисперсию наблюдений, в которую вновь добавляется дисперсия шума). Поиск гиперпараметров выполняется в логарифмическом пространстве и не изменяет обученное состояние объекта в ходе поиска, поэтому при повторном обучении во время работы состояние модели не останется частично обновленным, если оценка одной из комбинаций завершится сбоем.
Сразу сделаю важную оговорку для понимания раздела 11: гауссовский процесс, обученный на единственном признаке — доходности с лагом 1, — в лучшем случае представляет собой диагностический инструмент, который стоит проверить. Дает ли он устойчивую прогнозную информацию для XAUUSD на таймфрейме M5 — именно тот открытый эмпирический вопрос, для ответа на который предназначена проверка калибровки. Само по себе определение признака ничего такого не доказывает. В разделе 11 эта проверка описана полностью: запустите советник с включенным параметром InpLogCsv, дайте ему записать в журнал по одной строке на каждый прогноз, а затем сравните доли фактических исходов, попавших в заявленные моделью прогнозные полосы в одну и две сигмы, с уровнями 68% и 95% соответственно, которые подразумевает корректно заданное гауссовское прогнозное распределение. Эта методика конкретна и уже реализована в коде. Однако фактические показатели покрытия можно получить лишь после ее запуска, а в разделе 11 прямо указано, что уже измерено, а какие результаты еще не получены.
Содержание
- Почему признак должен быть рыночной величиной, а не индексом бара
- Входные данные о состоянии рынка и целевые переменные для прямого прогнозирования на заданном горизонте
- Ядро Матерна 3/2
- Разложение Холецкого: симметричное построение матрицы и адаптивная диагональная добавка
- Стандартизация входных данных и целевых переменных; латентная дисперсия и дисперсия наблюдений
- Поиск гиперпараметров в логарифмическом пространстве без побочных эффектов
- Индикатор: OnInit и OnCalculate
- Советник: OnInit, EnsureAtrHandle, OnDeinit, HasOwnOpenPosition
- Советник: FitAndForecast и фильтр уверенности по z-оценке в OnTick
- Что учитывает модель, а что нет
- Тестирование: проверка калибровки на XAUUSD M5
- Заключение
Почему признак должен быть рыночной величиной, а не индексом бара
При работе с гауссовским процессом на скользящем окне легко допустить одну ошибку, которую стоит подробно разобрать: она не приводит к явному сбою, а остается незаметной. Предположим, что признак, подаваемый на вход гауссовского процесса, — это просто позиция наблюдения внутри окна: xTrain[k]=k, "это позиция 0, это позиция 1" и так далее до 59. Модель все равно подберет некоторую зависимость. Программа не завершится аварийно, не выдаст явно неверного числа, а график ее прогнозных полос будет выглядеть вполне правдоподобно. Однако из этого выбора непосредственно следуют два последствия, и ни одно из них не станет заметным, пока заявленная моделью уверенность не будет сопоставлена с тем, что произошло на самом деле.
Во-первых, распределение входных значений почти не меняется от бара к бару — это всегда значения от 0 до 59, — поэтому структура ковариационной матрицы K остается почти одинаковой при каждом повторном обучении. Прогнозная дисперсия гауссовского процесса зависит от этой геометрии, поэтому она получается почти постоянной независимо от того, что происходит на рынке. Это не просто "небольшая неточность": модели изначально не дали информации, необходимой для определения того, когда неопределенность должна быть высокой. Во-вторых, предсказание в точке InpWindow-1+InpHorizon при том же входном признаке на основе индекса — это не прогнозирование, а экстраполяция за пределы обучающего диапазона гладкой кривой, подогнанной к зависимости доходности от позиции в окне. Горизонт прогнозирования здесь выступает как координата на оси x, а не как свойство прогнозируемой величины.
Решение, рассматриваемое в следующих двух разделах, состоит в том, чтобы и входной признак, и целевая переменная были реальными рыночными величинами: входным признаком становится логарифмическая доходность самого предыдущего бара, а целевой переменной — фактическая логарифмическая доходность за заданный горизонт прогнозирования, вычисленная напрямую, а не полученная экстраполяцией. Стоит подробнее разобраться, почему эту ошибку так легко допустить. Она характерна не только для гауссовских процессов — градиентный бустинг, нейронная сеть и линейная регрессия без проблем сошлись бы к некоторому набору коэффициентов, если бы им передали "позицию в окне" в качестве признака, и ни один из этих методов сам по себе не сигнализировал бы о проблеме. Справедливости ради уточним: здесь противопоставляются именно "индекс бара" и "признак доходности с лагом". Другие неценовые величины, такие как время суток, торговая сессия или календарный признак, могут быть вполне осмысленными входными данными при иной постановке задачи; исключается лишь признак, который кодирует только положение самого наблюдения в скользящем окне. Проверка калибровки (сопоставление заявленного моделью прогнозного интервала с тем, как часто фактические исходы попадают в его пределы) позволяет выявить эту проблему. Утверждение, что прогнозная полоса выглядит разумно на графике, и утверждение, что она действительно откалибрована, — разные вещи, и лишь одно из них можно проверить на глаз.
Та же проблема геометрии вновь возникает при подборе гиперпараметров именно в этой схеме со скользящим окном: поскольку ковариационная структура для входного признака на основе индекса почти не меняется от бара к бару при фиксированном размере окна, поверхность логарифма маргинального правдоподобия, по которой ведется поиск, оказывается почти плоской на большей части сетки. Входные данные недостаточно варьируются, чтобы разные масштабы длины или дисперсии сигнала давали существенно разные значения маргинального правдоподобия модели. Это наблюдение относится именно к такому сочетанию признака и окна, а не является общим свойством входных данных на основе индекса при любой возможной постановке задачи. Поиск по плоской поверхности работает корректно: он верно показывает, что входные данные не содержат сигнала, позволяющего различать комбинации параметров. В разделе 6 рассматривается сам процесс поиска.
Входные данные о состоянии рынка и целевые переменные для прямого прогнозирования на заданном горизонте
Каждое обучающее наблюдение выглядит следующим образом:
y_k = log( close[idx+h] / close[idx] ) — фактическая логарифмическая доходность за h баров вперед, а не экстраполяция
При этом для текущей точки запроса используется точно такое же определение признака — собственная логарифмическая доходность с лагом 1 последнего закрытого бара. Это утверждение не означает, что точка запроса получена из того же распределения, на данных из которого обучалась модель. Использование одной и той же формулы гарантирует сопоставимость этих двух величин, но не гарантирует, что рыночный режим, породивший сегодняшнюю доходность с лагом 1, статистически похож на режим в окне, на котором только что обучалась модель. Это отдельное допущение: его можно проверить с помощью проверки калибровки, но нельзя обосновать одним лишь определением признака. Однако это устраняет проблему подхода на основе индекса: в нем точка запроса даже не относится к тому же типу величин, что и обучающие входные данные, не говоря уже о том, чтобы быть правдоподобным наблюдением из какого-либо распределения. Это реализовано одинаково в индикаторе и советнике. Вот вариант из функции FitAndForecast() советника:
//+------------------------------------------------------------------+
//| FitAndForecast - builds the market-state training window,        |
//| fits the GP, and forecasts the direct InpHorizon-bar log return  |
//+------------------------------------------------------------------+
bool FitAndForecast(double &meanOut,double &varOut)
  {
//--- need InpWindow+InpHorizon+2 CLOSED bars: InpHorizon extra at the
//--- future end of every training sample, plus 1 extra at the very start
//--- for the first sample's own lag term
   int total=InpWindow+InpHorizon+2;
   MqlRates rates[];
   ArraySetAsSeries(rates,false);
   if(CopyRates(_Symbol,_Period,1,total,rates)<total) return(false);

   int i=total-1; // most recently CLOSED bar, non-series ascending order
   int base=i-InpWindow-InpHorizon;

   vector xTrain(InpWindow),yTrain(InpWindow);
   for(int k=0;k<InpWindow;k++)
     {
      int idx=base+k;
      //--- market-state input: lag-1 log return at idx, not a bar position
      xTrain[k]=MathLog(rates[idx].close/rates[idx-1].close);
      //--- direct horizon target: the true InpHorizon-bar-ahead log return
      yTrain[k]=MathLog(rates[idx+InpHorizon].close/rates[idx].close);
     }

//--- re-tune hyperparameters every refit - window is small so it's cheap.
//--- GridSearch() itself rolls its own hyperparameters back if the final
//--- Fit() fails, so a false here means there is genuinely no fitted model
//--- to query this bar, not a stale one left in a half-updated state
   if(!g_gp.GridSearch(xTrain,yTrain)) return(false);
//--- query with the SAME feature definition used for training: the most
//--- recent closed bar's own lag-1 log return
   double xStar=MathLog(rates[i].close/rates[i-1].close);
   return(g_gp.PredictObserved(xStar,meanOut,varOut));
  }
Использование логарифмических доходностей вместо простых разностей цен важно и по второй причине, помимо релевантности признаков: в рамках одного торгового инструмента логарифмическая доходность сохраняет сопоставимый масштаб во времени, в отличие от простой разности в пунктах. Кроме того, ряд становится ближе к стационарному, что важно для заложенного в ядре предположения о постоянной дисперсии. Это более узкое утверждение, чем утверждение об автоматической сопоставимости логарифмических доходностей разных торговых инструментов или режимов волатильности: масштаб распределения логарифмических доходностей все равно меняется при переходе от спокойного рынка к волатильному. Поэтому стандартизация x и y в разделе 5 выполняет здесь существенную задачу, а не служит косметической процедурой для уже сопоставимой величины.
Сразу обозначим рамки: это спецификация модели с одним признаком, а не с комбинированным набором входных признаков, включающим лаги, волатильность и торговую сессию. В разделе 10 это ограничение рассматривается непосредственно.
Стоит один раз разобрать расчеты индексов: ошибка на единицу здесь незаметно приводит к обучению на неверных барах. При общей длине истории в total = InpWindow + InpHorizon + 2 закрытых баров последний из них имеет индекс i = total - 1, а самое раннее наблюдение обучающего окна — индекс base = i - InpWindow - InpHorizon. Это индекс бара 1, а не 0: перед самым первым обучающим наблюдением оставлен бар для расчета его собственной доходности с лагом 1. Для каждого наблюдения его будущая целевая переменная рассчитывается по бару с индексом idx + InpHorizon. Максимальное значение этого индекса — InpWindow + InpHorizon, то есть на один бар раньше последнего закрытого бара. Ошибка в любую сторону либо приводит к попаданию будущего бара в обучающее окно (это ошибка заглядывания в будущее, которая делает результаты исторического тестирования бессмысленными из-за их завышения), либо незаметно исключает один допустимый бар исторических данных при каждом повторном обучении.
Ядро Матерна 3/2
Квадратично-экспоненциальное ядро предполагает, что лежащая в основе данных функция бесконечно гладкая: это подходит для медленно меняющихся физических процессов, но плохо согласуется с рядом доходности со сменой режимов и кластеризацией волатильности. Ядро Матерна 3/2 ослабляет это предположение о гладкости, сохраняя столь же низкую вычислительную стоимость:
//+------------------------------------------------------------------+
//| KernelWith - Matern 3/2 covariance, explicit hyperparameters     |
//+------------------------------------------------------------------+
double KernelWith(const double xi,const double xj,const double lengthScale,const double signalVar)
  {
//--- Matern 3/2: signalVar * (1 + sqrt(3)*r/l) * exp(-sqrt(3)*r/l)
//--- less aggressively smooth than RBF - a better match for noisy,
//--- regime-shifting return series than the squared exponential
   double r  = MathAbs(xi-xj);
   double sr = MathSqrt(3.0)*r/lengthScale;
   return(signalVar*(1.0+sr)*MathExp(-sr));
  }

//+------------------------------------------------------------------+
//| Kernel - Matern 3/2 using the object's current hyperparameters   |
//+------------------------------------------------------------------+
double Kernel(const double xi,const double xj)
  {
//---
   return(KernelWith(xi,xj,m_lengthScale,m_signalVar));
  }
Во всей этой реализации параметры сигнала и шума последовательно обозначаются и используются как дисперсии, а не стандартные отклонения: m_signalVar и m_noiseVar используются напрямую, без неоднозначного шага возведения в квадрат. Это различие важно, поскольку стандартное отклонение гауссовского процесса равно квадратному корню из его дисперсии, и смешение этих величин незаметно искажает масштаб всех последующих оценок неопределенности.
Функция KernelWith() принимает гиперпараметры как явные аргументы, а не считывает их из объекта; это позволяет при поиске гиперпараметров в разделе 6 оценивать комбинации кандидатов, не затрагивая фактическое обученное состояние объекта.
Стоит четко объяснить, что именно меняется, а что остается неизменным при переходе на другое семейство ядер. Ядро Матерна 3/2 однократно дифференцируемо, в отличие от бесконечно дифференцируемого квадратично-экспоненциального ядра. На практике это означает, что при одном и том же масштабе длины описываемые им функции изгибаются резче и чаще — это ближе к поведению зашумленного ряда доходности со сменой режимов, чем предположение о бесконечно гладкой кривой, лежащей в основе данных. Вычисление по этой формуле почти не требует дополнительных затрат: одно извлечение квадратного корня, одно вычисление экспоненты и одно умножение на (1+sr) вместо единственного вычисления экспоненты от выражения с квадратом в RBF. Поскольку функция Kernel() вызывается порядка n² раз за одно обучение, а при поиске по сетке этот класс выполняет повторное обучение десятки раз на каждом баре, важно сохранять затраты на один вызов на прежнем уровне: ядро Матерна 3/2 меняет предположение о гладкости без существенного увеличения стоимости одного вычисления. Разложение Холецкого, выполняемое на основе этих вычислений, представляет собой отдельный этап со сложностью O(n^3), который рассматривается в разделе 11 со следующей оговоркой: это асимптотическая сложность самого разложения, а не гарантия того, что измеренное время обучения совершенно не зависит от данных, поскольку функция DecomposeWithJitter(), описанная в следующем разделе, может выполнять повторные попытки.
Разложение Холецкого: симметричное построение матрицы и адаптивная диагональная добавка
Матрица ядра симметрична по построению, поэтому достаточно вычислить элементы ее нижнего треугольника и зеркально скопировать их относительно главной диагонали — это вдвое сокращает число вычислений ядра по сравнению с прямолинейной реализацией двойного цикла. Для обеспечения численной устойчивости в случае, когда матрица не является положительно определенной, используется ступенчатое увеличение адаптивной диагональной добавки, а не одна фиксированная константа: фиксированное значение может оказаться либо слишком малым, чтобы помочь, либо большим, чем требуется при данном масштабе данных. Оба механизма реализованы в функциях BuildK() и DecomposeWithJitter():
//+------------------------------------------------------------------+
//| BuildK - symmetric kernel matrix, computed on the lower          |
//| triangle only and mirrored - half the Kernel() evaluations       |
//+------------------------------------------------------------------+
void BuildK(const vector &xTrain,const double lengthScale,const double signalVar,
            const double noiseVar,matrix &K)
  {
//---
   int n=(int)xTrain.Size();
   K=matrix::Zeros(n,n);
   for(int i=0;i<n;i++)
     {
      for(int j=0;j<=i;j++)
        {
         double kij=KernelWith(xTrain[i],xTrain[j],lengthScale,signalVar);
         K[i][j]=kij;
         K[j][i]=kij;
        }
      K[i][i]+=noiseVar;
     }
  }

//+------------------------------------------------------------------+
//| DecomposeWithJitter - adaptive jitter ladder, not a single       |
//| fixed constant. Logs how much jitter was actually needed.        |
//+------------------------------------------------------------------+
bool DecomposeWithJitter(const matrix &Kin,matrix &L,double &jitterUsed)
  {
//---
   double ladder[]={0.0,1e-10,1e-8,1e-6,1e-4,1e-2};
   int n=(int)Kin.Rows();
   for(int s=0;s<ArraySize(ladder);s++)
     {
      matrix K=Kin;
      if(ladder[s]>0.0)
         for(int i=0;i<n;i++) K[i][i]+=ladder[s];
      if(CholeskyDecompose(K,L))
        {
         jitterUsed=ladder[s];
         return(true);
        }
     }
   jitterUsed=-1.0;
   return(false);
  }
Функция GetLastJitter() возвращает итоговое значение диагональной добавки после ее ступенчатого увеличения. Это полезный диагностический показатель: если при обучении постоянно требуется добавка 1e-4 или больше, входные данные близки к вырожденным (скорее всего, из-за почти одинаковых значений доходности с лагом на очень спокойном рынке). Об этом стоит знать, а не незаметно маскировать проблему. Также стоит прямо пояснить, что это число означает для обученной модели: при поиске по сетке дисперсии шума в разделе 6 проверяются значения вплоть до 1e-6, а верхняя ступень адаптивной диагональной добавки составляет 1e-2 — на четыре порядка больше. Если при обучении действительно требуется диагональная добавка, близкая к этой верхней ступени, разложению подвергается уже не та ковариационная матрица, которую выбрала функция GridSearch(): добавка фактически вносит дополнительную дисперсию шума. Поэтому столбец noise_var в CSV-файле из раздела 9, где записывается значение, выбранное при поиске по сетке, а не внесенная затем диагональная добавка, будет занижать фактический уровень шума, использованный при обучении. Для контроля этого эффекта следует отслеживать значение, возвращаемое функцией GetLastJitter(), хотя сейчас оно не входит в структуру CSV-файла.
Стандартизация входных данных и целевых переменных; латентная дисперсия и дисперсия наблюдений
И x, и y стандартизируются (до нулевого среднего и единичной дисперсии) еще до решения системы с ковариационной матрицей, а на выходе выполняется обратное преобразование в исходный масштаб. Причина стандартизации целевой переменной более привычна: она стабилизирует логарифм маргинального правдоподобия для разных символов и режимов волатильности, не вынуждая сетку гиперпараметров работать в исходном масштабе конкретного ряда доходностей. Стандартизация входных данных важна по менее очевидной причине, которую стоит указать явно: сетка значений масштаба длины в разделе 6 представляет собой фиксированный набор безразмерных чисел от 1,0 до 64,0. Эта сетка сохраняет один и тот же смысл от одного поиска к другому, только если при ее применении x всегда имеет один и тот же масштаб, а логарифмическая доходность (примерно от 0,0002 до 0,01 по модулю) по масштабу совершенно не сопоставима, например, с индексом бара. Стандартизация x устраняет эту зависимость: независимо от единиц измерения исходного признака сетка всегда работает с его стандартизированным представлением с нулевым средним и единичной дисперсией.
//+------------------------------------------------------------------+
//| Fit - standardizes x and y, builds K, factorizes, pre-solves     |
//| alpha                                                            |
//+------------------------------------------------------------------+
bool Fit(const vector &xTrain,const vector &yTrain)
  {
//---
   m_fitted=false; // explicit reset - Predict* must never trust a stale fit
   int n=(int)xTrain.Size();
   if(n<=0 || n!=(int)yTrain.Size())
     {
      Print("Fit(): dimension mismatch or empty input - xTrain=",n,
            " yTrain=",(int)yTrain.Size());
      return(false);
     }

//--- standardize x: the length-scale grid in GridSearch() is a fixed set of
//--- unitless numbers (1.0 to 64.0). Standardizing x to zero-mean/unit-std
//--- keeps that grid meaningful regardless of the input's raw scale - a log
//--- return (~0.001) and a bar index (~0-59) are four orders of magnitude
//--- apart, and an unstandardized log-return x would make every length-scale
//--- in the grid produce an almost-constant kernel, blind to real differences
//--- between training points
   m_xMean=0.0;
   for(int i=0;i<n;i++) m_xMean+=xTrain[i];
   m_xMean/=n;
   double xVar=0.0;
   for(int i=0;i<n;i++) xVar+=(xTrain[i]-m_xMean)*(xTrain[i]-m_xMean);
   xVar/=n;
   m_xStd=MathSqrt(xVar);
   if(m_xStd<1e-12) m_xStd=1.0; // guard against a degenerate all-flat window

   vector xNorm(n);
   for(int i=0;i<n;i++) xNorm[i]=(xTrain[i]-m_xMean)/m_xStd;
   m_xTrain=xNorm;

//--- standardize y: stabilizes the log marginal likelihood and makes
//--- hyperparameters comparable across symbols/regimes
   m_yMean=0.0;
   for(int i=0;i<n;i++) m_yMean+=yTrain[i];
   m_yMean/=n;
   double var=0.0;
   for(int i=0;i<n;i++) var+=(yTrain[i]-m_yMean)*(yTrain[i]-m_yMean);
   var/=n;
   m_yStd=MathSqrt(var);
   if(m_yStd<1e-12) m_yStd=1.0; // guard against a degenerate all-flat window

   m_yNorm.Resize(n);
   for(int i=0;i<n;i++) m_yNorm[i]=(yTrain[i]-m_yMean)/m_yStd;

   matrix K;
   BuildK(xNorm,m_lengthScale,m_signalVar,m_noiseVar,K);
   if(!DecomposeWithJitter(K,m_L,m_lastJitter)) return(false);

   m_alpha=SolveCholesky(m_L,m_yNorm);
   m_fitted=true;
   return(true);
  }
Строка m_fitted=false в самом начале Fit() важнее, чем кажется: она гарантирует, что после неудачного обучения объект в любом случае останется непригодным для использования до следующего успешного обучения, исключая риск того, что Predict() незаметно вернет прогноз, построенный по устаревшему окну, не связанному с текущими данными.
Метод Predict() разделен на PredictLatent() и PredictObserved(), которые используют общий закрытый метод PredictNormalized(), поскольку неопределенность модели относительно лежащего в основе данных тренда и неопределенность относительно фактического будущего значения — действительно разные величины. Обратите внимание: точку запроса xStar необходимо стандартизировать с использованием тех же среднего и стандартного отклонения, которые использовал метод Fit(), поскольку m_xTrain теперь содержит стандартизированные значения. Сравнение исходного, нестандартизированного xStar со стандартизированным m_xTrain внутри Kernel() привело бы к незаметному смешению двух разных масштабов. Это тот же тип ошибки, который рассматривается в разделе 9 при обсуждении realized_move:
//+------------------------------------------------------------------+
//| PredictNormalized - latent mean/variance in standardized         |
//| (zero-mean, unit-std) y-space, before un-scaling or adding       |
//| observation noise. Internal building block for both public       |
//| Predict* methods below.                                          |
//+------------------------------------------------------------------+
bool PredictNormalized(const double xStar,double &meanNorm,double &latentVarNorm)
  {
//---
   if(!m_fitted) return(false);
   int n=(int)m_xTrain.Size();
//--- standardize the query point with the SAME mean/std the training inputs
//--- were standardized with in Fit() - m_xTrain already holds standardized
//--- values, so xStar has to be converted to that same space before any
//--- Kernel() call, or every distance computed below would be meaningless
   double xStarNorm=(xStar-m_xMean)/m_xStd;
   vector kStar(n);
   for(int i=0;i<n;i++)
      kStar[i]=Kernel(xStarNorm,m_xTrain[i]);
   meanNorm=0.0;
   for(int i=0;i<n;i++)
      meanNorm+=kStar[i]*m_alpha[i];
   vector v(n);
   for(int i=0;i<n;i++)
     {
      double s=kStar[i];
      for(int k=0;k<i;k++)
         s-=m_L[i][k]*v[k];
      v[i]=s/m_L[i][i];
     }
   double vv=0.0;
   for(int i=0;i<n;i++)
      vv+=v[i]*v[i];
   latentVarNorm=Kernel(xStarNorm,xStarNorm)-vv; // NO noise term - this is Var[f*], the latent function
   if(latentVarNorm<0.0) latentVarNorm=0.0;
   return(true);
  }

//+------------------------------------------------------------------+
//| PredictObserved - Var[y*] = Var[f*] + noise variance - the       |
//| quantity to compare a REALIZED future return against, since      |
//| the realized value includes observation noise the latent         |
//| function estimate does not.                                      |
//+------------------------------------------------------------------+
bool PredictObserved(const double xStar,double &mean,double &variance)
  {
//---
   double meanNorm,latentVarNorm;
   if(!PredictNormalized(xStar,meanNorm,latentVarNorm)) return(false);
   double observedVarNorm=latentVarNorm+m_noiseVar;
   mean=meanNorm*m_yStd+m_yMean;
   variance=observedVarNorm*m_yStd*m_yStd;
   return(true);
  }
Метод PredictLatent() в точности повторяет PredictObserved(), но пропускает шаг +m_noiseVar. Он отвечает на вопрос "какова неопределенность модели относительно лежащего в основе данных тренда?", тогда как PredictObserved() отвечает на вопрос "насколько далеко фактическое будущее значение может отклониться от этого тренда?". Именно полученную во втором случае величину можно сопоставлять с фактической доходностью при проверке калибровки. Оба компонента проекта — индикатор и советник — используют PredictObserved(), поскольку в конечном итоге оба сравнивают прогноз с фактическим изменением цены.
Поиск гиперпараметров в логарифмическом пространстве без побочных эффектов
Поиск по сетке перебирает сетки с равномерным шагом в логарифмическом пространстве — естественном масштабе для параметров, значения которых различаются на порядки. При этом функция оценки LogMarginalLikelihoodPure() является чистой функцией: она вычисляет собственные локальные K, L и alpha, никак не затрагивая обученное состояние объекта. Эта функция также самостоятельно стандартизирует x на окне, используемом для оценки кандидата, независимо от аналогичной логики в Fit(). Каждая оцениваемая комбинация должна использовать то же пространство x, которое фактически будет использовать Fit(), иначе выбранный при поиске масштаб длины будет иметь другой смысл, когда GridSearch() в конце вызовет Fit() с найденными параметрами:
//+------------------------------------------------------------------+
//| LogMarginalLikelihoodPure - scores a hyperparameter set with     |
//| NO side effects on the object's fitted state. GridSearch()       |
//| calls this many times per bar and must not leave m_L/m_alpha     |
//| in a random intermediate combination when the search ends.       |
//+------------------------------------------------------------------+
double LogMarginalLikelihoodPure(const vector &xTrain,const vector &yTrain,
                                  const double lengthScale,const double signalVar,
                                  const double noiseVar)
  {
//---
   int n=(int)xTrain.Size();
   if(n<=0 || n!=(int)yTrain.Size()) return(-DBL_MAX);

   double yMean=0.0;
   for(int i=0;i<n;i++) yMean+=yTrain[i];
   yMean/=n;
   double var=0.0;
   for(int i=0;i<n;i++) var+=(yTrain[i]-yMean)*(yTrain[i]-yMean);
   var/=n;
   double yStd=MathSqrt(var);
   if(yStd<1e-12) yStd=1.0;

   vector yNorm(n);
   for(int i=0;i<n;i++) yNorm[i]=(yTrain[i]-yMean)/yStd;

//--- standardize x here too, on this candidate's own xTrain - GridSearch()
//--- must score each (lengthScale,signalVar,noiseVar) combination in the
//--- SAME x-space Fit() will actually use, or the winning lengthScale means
//--- something different during the search than it does once committed
   double xMean=0.0;
   for(int i=0;i<n;i++) xMean+=xTrain[i];
   xMean/=n;
   double xVar=0.0;
   for(int i=0;i<n;i++) xVar+=(xTrain[i]-xMean)*(xTrain[i]-xMean);
   xVar/=n;
   double xStd=MathSqrt(xVar);
   if(xStd<1e-12) xStd=1.0;
   vector xNorm(n);
   for(int i=0;i<n;i++) xNorm[i]=(xTrain[i]-xMean)/xStd;

   matrix K,L;
   BuildK(xNorm,lengthScale,signalVar,noiseVar,K);
   double jitter;
   if(!DecomposeWithJitter(K,L,jitter)) return(-DBL_MAX);

   vector alpha=SolveCholesky(L,yNorm);
   double dataFit=0.0;
   for(int i=0;i<n;i++) dataFit+=yNorm[i]*alpha[i];
   double logDet=0.0;
   for(int i=0;i<n;i++) logDet+=MathLog(L[i][i]);
   return(-0.5*dataFit-logDet-0.5*n*MathLog(2.0*M_PI));
  }
Метод GridSearch() перебирает сетки с равномерным шагом в логарифмическом пространстве и лишь в самом конце, когда лучшая комбинация уже известна, выполняет ровно один вызов Fit(), действительно обучающий модель. Если сначала установить лучшие найденные гиперпараметры через SetHyperparams(), а затем вызвать Fit(), возникает проблема, которую следует учесть при проектировании: если итоговый вызов Fit() завершится неудачей, m_fitted корректно сбросится в false, но гиперпараметры объекта уже будут заменены комбинацией, с которой модель так и не была обучена. Для вызывающего кода, проверяющего только m_fitted, это безопасно, но код, считывающий гиперпараметры напрямую, получит значения, с которыми модель никогда не обучалась. Метод GridSearch() возвращает флаг успеха и, если Fit() завершается неудачей, восстанавливает значения гиперпараметров, действовавшие до вызова. Таким образом, гиперпараметры объекта изменяются только при успешном обучении модели с этими значениями:
//+------------------------------------------------------------------+
//| GridSearch - log-space search over 3 hyperparameters, pure       |
//| scoring throughout, with one real Fit() at the end to commit     |
//| the winning combination. Returns false if that final Fit()       |
//| fails, and in that case rolls the hyperparameters back to what   |
//| they were before this call - a failed Fit() must not leave the   |
//| object pointing at a combination it was never actually fitted    |
//| with.                                                            |
//+------------------------------------------------------------------+
bool GridSearch(const vector &xTrain,const vector &yTrain)
  {
//---
   double bestLML=-DBL_MAX;
   double bestL=m_bestLengthScale,bestS=m_bestSignalVar,bestN=m_bestNoiseVar;
//--- log-spaced grids - GP hyperparameters are naturally searched on a
//--- log scale, not a linear one
   double lGrid[]={1.0,2.0,4.0,8.0,16.0,32.0,64.0};
   double sGrid[]={1e-4,1e-3,1e-2,1e-1,1.0};
   double nGrid[]={1e-6,1e-5,1e-4,1e-3,1e-2,1e-1};

   for(int a=0;a<ArraySize(lGrid);a++)
   for(int b=0;b<ArraySize(sGrid);b++)
   for(int c=0;c<ArraySize(nGrid);c++)
     {
      double lml=LogMarginalLikelihoodPure(xTrain,yTrain,lGrid[a],sGrid[b],nGrid[c]);
      if(lml>bestLML)
        {
         bestLML=lml; bestL=lGrid[a]; bestS=sGrid[b]; bestN=nGrid[c];
        }
     }

   double prevL=m_lengthScale,prevS=m_signalVar,prevN=m_noiseVar;
   m_bestLengthScale=bestL; m_bestSignalVar=bestS; m_bestNoiseVar=bestN;
   SetHyperparams(bestL,bestS,bestN);
   if(!Fit(xTrain,yTrain))
     {
      SetHyperparams(prevL,prevS,prevN); // roll back - the search found a
                                          // winner on paper, but it was
                                          // never actually fitted, so the
                                          // object must not keep pointing
                                          // at it
      return(false);
     }
   return(true);
  }
Лучшая найденная комбинация сохраняется в m_bestLengthScale/m_bestSignalVar/m_bestNoiseVar и доступна через методы чтения. Их использует код записи в журнал CSV из раздела 9, что позволяет впоследствии выяснить, действительно ли поиск находит разные гиперпараметры от бара к бару или сходится к одной и той же комбинации независимо от состояния рынка. Еще одно замечание об ограничениях самого правдоподобия: LogMarginalLikelihoodPure() рассматривает целевые переменные с горизонтом прогнозирования InpHorizon баров как независимые наблюдения, хотя при InpHorizon > 1 это не так: соседние целевые переменные по построению включают общие доходности отдельных баров. Такое перекрытие может вносить смещение как в значение правдоподобия, так и в оценку дисперсии шума, к которой оно направляет GridSearch. В разделе 11 вновь рассматривается, как это влияет на интерпретацию результатов поиска.
Индикатор: OnInit и OnCalculate
Функция OnInit() задает для буферов индикатора "пустое" значение. Это важно, поскольку OnCalculate() вполне может оставить бар без прогноза, вместо того чтобы отображать результат, полученный по некорректному окну данных или при неудачном обучении модели:
//+------------------------------------------------------------------+
//| OnInit                                                           |
//+------------------------------------------------------------------+
int OnInit()
  {
//---
   SetIndexBuffer(0,BufMean,INDICATOR_DATA);
   SetIndexBuffer(1,BufUpper,INDICATOR_DATA);
   SetIndexBuffer(2,BufLower,INDICATOR_DATA);
   PlotIndexSetDouble(0,PLOT_EMPTY_VALUE,EMPTY_VALUE);
   PlotIndexSetDouble(1,PLOT_EMPTY_VALUE,EMPTY_VALUE);
   PlotIndexSetDouble(2,PLOT_EMPTY_VALUE,EMPTY_VALUE);
//--- shift plotted lines forward by the forecast horizon
   PlotIndexSetInteger(0,PLOT_SHIFT,InpHorizon);
   PlotIndexSetInteger(1,PLOT_SHIFT,InpHorizon);
   PlotIndexSetInteger(2,PLOT_SHIFT,InpHorizon);
   return(INIT_SUCCEEDED);
  }
Функция OnCalculate() формирует окно состояний рынка, описанное в разделе 2, проверяет его корректность перед использованием (для бара в самом начале истории может не хватить предшествующих данных для расчета его лагового признака), явно проверяет возвращаемое значение PredictObserved(), а не предполагает успешное выполнение, и останавливается за один бар до rates_total: последний элемент каждого буферного массива соответствует текущему, еще не закрытому бару, а его значение close[] меняется с каждым тиком. Если рассчитывать и отображать прогноз на основе этого значения, линия индикатора будет меняться еще до закрытия соответствующего бара, поэтому для этого бара всегда сохраняется EMPTY_VALUE, а фактическое значение он получает только при следующем проходе после закрытия:
//+------------------------------------------------------------------+
//| OnCalculate                                                      |
//+------------------------------------------------------------------+
int OnCalculate(const int rates_total,const int prev_calculated,
                const datetime &time[],const double &open[],const double &high[],
                const double &low[],const double &close[],const long &tick_volume[],
                const long &volume[],const int &spread[])
  {
//--- each training sample needs its own InpHorizon bars of already-known
//--- future AND one prior bar for its own lag term
   int needed=InpWindow+InpHorizon+2;
   if(rates_total<needed) return(0);
//--- stop one bar short of rates_total: index rates_total-1 is the currently
//--- forming, still-unclosed bar, and close[] there keeps moving tick by
//--- tick. Computing and plotting it here would make the line move before
//--- the bar it belongs to has actually closed - it is handled below by
//--- being left EMPTY_VALUE until it closes and gets its own real pass
   int limit=rates_total-1;
   int start=MathMax(prev_calculated-1,InpWindow+InpHorizon);

   for(int i=start;i<limit;i++)
     {
      vector xTrain(InpWindow),yTrain(InpWindow);
      bool validWindow=true;
      for(int k=0;k<InpWindow;k++)
        {
         int idx=i-InpWindow-InpHorizon+k; // oldest training sample first
         if(idx-1<0 || idx+InpHorizon>=rates_total) { validWindow=false; break; }
         //--- market-state input: yesterday's log return at idx, NOT a bar index -
         //--- this is what actually distinguishes one training point from another
         xTrain[k]=MathLog(close[idx]/close[idx-1]);
         //--- direct horizon target: the true InpHorizon-bar-ahead log return,
         //--- not an extrapolation of a smooth curve past the training range
         yTrain[k]=MathLog(close[idx+InpHorizon]/close[idx]);
        }
      if(!validWindow) { BufMean[i]=EMPTY_VALUE; BufUpper[i]=EMPTY_VALUE; BufLower[i]=EMPTY_VALUE; continue; }

      if(InpAutoTune) g_gp.GridSearch(xTrain,yTrain);
      else            g_gp.Fit(xTrain,yTrain);
      //--- the query feature is the SAME kind of quantity the model was trained
      //--- on: the most recent closed bar's own lag-1 log return
      double xStar=MathLog(close[i]/close[i-1]);

      double mean,var;
      if(!g_gp.PredictObserved(xStar,mean,var))
        {
         //--- never leave stale values sitting in the buffers on a failed fit -
         //--- an empty gap is honest, a leftover old forecast is not
         BufMean[i]=EMPTY_VALUE; BufUpper[i]=EMPTY_VALUE; BufLower[i]=EMPTY_VALUE;
         continue;
        }
      double sd=MathSqrt(var);
      double basePrice=close[i];
      //--- mean/sd are log-returns - convert back to a price level with exp()
      BufMean[i]=basePrice*MathExp(mean);
      BufUpper[i]=basePrice*MathExp(mean+sd);
      BufLower[i]=basePrice*MathExp(mean-sd);
     }
//--- the forming bar is never plotted - an empty gap there is honest,
//--- a value computed from a close that is still changing is not
   if(limit>=0 && limit<rates_total)
     {
      BufMean[limit]=EMPTY_VALUE;
      BufUpper[limit]=EMPTY_VALUE;
      BufLower[limit]=EMPTY_VALUE;
     }
   return(rates_total);
  }
Поскольку mean и sd выражены в единицах логарифмической доходности, а не абсолютных разностей цен, для обратного преобразования в ценовые уровни на графике нужна функция exp(), а не простое сложение — именно так прогноз логарифмической доходности математически корректно преобразуется в ценовую полосу.
Советник: OnInit, EnsureAtrHandle, OnDeinit, HasOwnOpenPosition
Прежде чем перейти к самой функции OnInit(), отметим: советник хранит прогнозы, ожидающие проверки, в небольшой очереди PendingForecast g_pending[], а не в одной скалярной переменной. Новый прогноз формируется на каждом баре, а проверить его можно лишь через InpHorizon баров, поэтому одновременно проверки могут ожидать несколько прогнозов. Если хранить только один ожидающий прогноз, то новый прогноз может незаметно перезаписать еще не проверенный предыдущий прогноз или сам будет пропущен, и CSV-журнал превратится в отфильтрованную подвыборку, а не будет содержать по одной строке на каждый прогноз. Каждый элемент очереди содержит прогнозное среднее, дисперсию, цену закрытия, на основе которой был сформирован прогноз, число баров до его проверки, гиперпараметры и ATR на момент прогнозирования, а также признак фактического исполнения сделки. Функция OnInit() сразу задает магический номер для объекта торговых операций, очищает очередь и открывает CSV-журнал с достаточным числом столбцов для расширенного журналирования, реализованного в разделе 9:
//+------------------------------------------------------------------+
//| OnInit                                                           |
//+------------------------------------------------------------------+
int OnInit()
  {
//---
   g_trade.SetExpertMagicNumber(InpMagic);
//--- try creating the handle now, but don't hard-fail if it isn't ready yet -
//--- the Strategy Tester sometimes hasn't finished lining up history for this
//--- symbol/period at the exact moment OnInit runs, even though the chart has
//--- data. EnsureAtrHandle() retries this safely on the first tick instead.
   g_atrHandle=INVALID_HANDLE;
   EnsureAtrHandle();
   g_lastBarTime=0;
   ArrayResize(g_pending,0);

//--- open (or create) the diagnostic CSV log - FILE_COMMON so it's easy to
//--- find under Common\Files regardless of which agent/terminal ran the test
   g_csvHandle=INVALID_HANDLE;
   if(InpLogCsv)
     {
      g_csvHandle=FileOpen("GPRForecast_calibration.csv",
                            FILE_WRITE|FILE_CSV|FILE_COMMON,",");
      if(g_csvHandle!=INVALID_HANDLE)
         FileWrite(g_csvHandle,"bar_time","pred_mean","pred_variance","realized_move",
                   "length_scale","signal_var","noise_var","atr","traded","direction",
                   "edge_points","symbol","timeframe");
      else
         Print("Could not open calibration CSV - logging disabled this run");
     }
   return(INIT_SUCCEEDED);
  }
Функции EnsureAtrHandle() и OnDeinit() реализуют простую схему отложенных повторных попыток и освобождения ресурсов: дескриптор ATR создается один раз и затем используется повторно; если тестер стратегий еще не завершил подготовку истории, попытка создания повторяется на следующем тике, а в OnDeinit() дескриптор ATR корректно освобождается вместе с дескриптором CSV-файла.
Функция HasOwnOpenPosition() отбирает позиции одновременно по символу и магическому номеру, а не учитывает все открытые позиции на счете, в том числе по другим символам или открытые вручную. Поэтому, решая, открывать ли новую сделку, советник учитывает только собственные позиции по своему инструменту:
//+------------------------------------------------------------------+
//| HasOwnOpenPosition - filters by SYMBOL and MAGIC, not just any   |
//| open position anywhere on the account. Without this, the EA on   |
//| one instrument would get blocked by an unrelated trade on        |
//| another symbol, or by a human-placed manual position.            |
//+------------------------------------------------------------------+
bool HasOwnOpenPosition()
  {
//---
   for(int i=PositionsTotal()-1;i>=0;i--)
     {
      if(!g_posInfo.SelectByIndex(i)) continue;
      if(g_posInfo.Symbol()==_Symbol && g_posInfo.Magic()==InpMagic)
         return(true);
     }
   return(false);
  }
Советник: FitAndForecast и фильтр уверенности по z-оценке в OnTick
Функция FitAndForecast() полностью приведена в разделе 2: она формирует такое же окно состояний рынка, как и индикатор, но получает данные через CopyRates(), а не из буферных массивов, автоматически передаваемых в OnCalculate(). Здесь важно, что функция OnTick() делает с полученным прогнозом.
Напрямую сравнивать var с фиксированным порогом нельзя: у дисперсии нет универсального масштаба — она зависит от символа, таймфрейма и текущего режима волатильности, поэтому порог, подобранный для спокойной сессии EURUSD, будет бессмысленным при высокой волатильности XAUUSD. Решение — сопоставить модуль прогнозируемой средней логарифмической доходности с ее прогнозируемым стандартным отклонением, рассчитав z-оценку, которая по определению не зависит от масштаба:
Кроме того, перед открытием сделки нужно отдельно проверять, превышает ли прогнозируемое торговое преимущество текущий спред: уверенный прогноз движения, меньшего, чем спред между Bid и Ask, гарантированно ведет к убытку независимо от того, насколько верным окажется прогноз направления. В организации оценки прогнозов и журналирования есть три важных момента, которые стоит отметить перед кодом: оценка выполняется на каждом баре безусловно, до любых действий, зависящих от наличия открытой позиции; фактическое изменение, записываемое для сравнения с прогнозом, должно измеряться между ценами закрытия, как и при обучении модели, а не по текущей цене Bid; прогноз отмечается в журнале как использованный для сделки только после подтверждения фактического исполнения ордера, а не просто его отправки:
//+------------------------------------------------------------------+
//| ScoreAndLogDue - writes one CSV row for every queued forecast    |
//| whose horizon has now elapsed, then drops it from the queue.     |
//| Runs unconditionally, every bar, before any trading or position  |
//| logic below it - that ordering matters: scoring is not allowed   |
//| to depend on whether a position happens to be open right now,    |
//| or the CSV stops being one row per forecast and starts being a   |
//| subsample that only covers bars with no open position.           |
//+------------------------------------------------------------------+
void ScoreAndLogDue()
  {
   if(!(InpLogCsv && g_csvHandle!=INVALID_HANDLE)) return;
//--- the close of the most recently CLOSED bar - the same close-to-close
//--- basis the model's own target uses (log(close[idx+h]/close[idx])).
//--- Using the live bid here instead would compare a close-to-close
//--- forecast against a bid-to-bid realized move - two different prices
   double closeNow=iClose(_Symbol,_Period,1);
   for(int k=ArraySize(g_pending)-1;k>=0;k--)
     {
      g_pending[k].barsLeft--;
      if(g_pending[k].barsLeft>0) continue;
      double realizedMove=MathLog(closeNow/g_pending[k].baseClose);
      FileWrite(g_csvHandle,(long)g_pending[k].barTime,g_pending[k].mean,g_pending[k].variance,
                realizedMove,g_pending[k].lengthScale,g_pending[k].signalVar,
                g_pending[k].noiseVar,g_pending[k].atr,g_pending[k].traded?1:0,
                g_pending[k].direction,g_pending[k].edgePoints,_Symbol,(string)_Period);
      FileFlush(g_csvHandle);
      ArrayRemove(g_pending,k,1);
     }
  }

//+------------------------------------------------------------------+
//| OnTick                                                           |
//+------------------------------------------------------------------+
void OnTick()
  {
//--- keep retrying the ATR handle until it's ready - cheap check, skip the
//--- tick entirely if it still isn't (handles the Tester's startup timing)
   if(!EnsureAtrHandle()) return;

//--- only act once per new bar - GP refit is too expensive for per-tick use
   datetime curBarTime=iTime(_Symbol,_Period,0);
   if(curBarTime==g_lastBarTime) return;
   g_lastBarTime=curBarTime;

   ScoreAndLogDue();

//--- fit and forecast every bar, regardless of whether this EA already has
//--- a position open. The CSV log is meant to be one row per forecast made,
//--- not one row per forecast that happened to coincide with a flat book -
//--- the "no new position while one is open" rule below applies only to
//--- TRADING, never to whether a forecast gets made and logged
   double mean,var;
   bool haveForecast=FitAndForecast(mean,var);

   double atr[];
   ArraySetAsSeries(atr,true);
   bool haveAtr=(CopyBuffer(g_atrHandle,0,0,1,atr)>=1);
   double atrValue=haveAtr?atr[0]:0.0;

   if(!haveForecast) return; // nothing to log or trade on this bar

//--- the confidence gate: a variance THRESHOLD alone is scale-dependent
//--- (it changes with symbol, timeframe, and volatility regime). A z-score
//--- - edge relative to the model's own uncertainty - is comparable across
//--- all of those, which a raw variance cutoff is not.
   double sd=MathSqrt(var);
   double zScore=(sd>0.0)?MathAbs(mean)/sd:0.0;

//--- convert the forecast log-return into an actual price edge, then into
//--- points, and require it to clear the live spread before trading.
//--- curClose uses the same closed-bar basis as ScoreAndLogDue(), not the
//--- live bid, so the logged edge and the logged realized move are on the
//--- same price scale
   double curClose=iClose(_Symbol,_Period,1);
   double edgePrice=curClose*(MathExp(mean)-1.0);
   double edgePoints=edgePrice/_Point;
   double ask=SymbolInfoDouble(_Symbol,SYMBOL_ASK);
   double bid=SymbolInfoDouble(_Symbol,SYMBOL_BID);
   double spreadPrice=ask-bid;

   bool passesZScore=(zScore>=InpMinZScore);
   bool passesSpread=(MathAbs(edgePrice)>spreadPrice);
   bool noOpenPosition=!HasOwnOpenPosition(); // this EA's own single-position
                                               // rule, filtered by symbol+magic -
                                               // gates TRADING only, not logging
   bool willTrade=passesZScore && passesSpread && haveAtr && noOpenPosition;
   int  direction=willTrade?(mean>0?1:-1):0;

//--- send the order first (if any) and find out whether it actually filled,
//--- BEFORE writing the pending record - "traded" in the CSV must mean a
//--- trade was executed, not merely that one was attempted
   bool tradedActual=false;
   if(willTrade)
     {
      double sl=atrValue*InpAtrMultSL;
      double tp=atrValue*InpAtrMultTP;
      bool sent=(direction>0)
                ?g_trade.Buy(InpLots,_Symbol,ask,ask-sl,ask+tp,"GPRForecast long")
                :g_trade.Sell(InpLots,_Symbol,bid,bid+sl,bid-tp,"GPRForecast short");
      uint retcode=g_trade.ResultRetcode();
      tradedActual=sent && (retcode==TRADE_RETCODE_DONE || retcode==TRADE_RETCODE_DONE_PARTIAL);
      if(sent && !tradedActual)
         Print("Order sent but not confirmed filled, retcode=",retcode,
               " - logging this forecast as not traded");
     }

//--- queue this bar's forecast/decision, to be scored once InpHorizon bars
//--- have elapsed. Queued unconditionally - every forecast gets a row,
//--- whether or not it led to a trade
   if(InpLogCsv && g_csvHandle!=INVALID_HANDLE)
     {
      int n=ArraySize(g_pending);
      ArrayResize(g_pending,n+1);
      g_pending[n].mean=mean;
      g_pending[n].variance=var;
      g_pending[n].baseClose=curClose;
      g_pending[n].barTime=curBarTime;
      g_pending[n].barsLeft=InpHorizon;
      g_pending[n].lengthScale=g_gp.GetBestLengthScale();
      g_pending[n].signalVar=g_gp.GetBestSignalVar();
      g_pending[n].noiseVar=g_gp.GetBestNoiseVar();
      g_pending[n].atr=atrValue;
      g_pending[n].traded=tradedActual;
      g_pending[n].direction=direction;
      g_pending[n].edgePoints=edgePoints;
     }
  }
Строка CSV содержит выбранные гиперпараметры, текущий ATR, признак фактического исполнения сделки, ее направление и торговое преимущество в пунктах, а также символ и таймфрейм. Этого набора полей достаточно, чтобы напрямую проверить, действительно ли length_scale/signal_var/noise_var меняются от бара к бару, когда на вход подается реальный признак состояния рынка. Поскольку оценка прогнозов и их добавление в очередь выполняются на каждом баре независимо от наличия открытой позиции, CSV-файл содержит по одной строке на каждый сформированный прогноз, а не подвыборку, отфильтрованную по наличию открытой позиции на тот момент.
Стоит особо отметить две детали: в обоих случаях ошибку легко допустить и легко не заметить. Во-первых: pred_mean и pred_variance записываются в журнал в единицах логарифмической доходности, поэтому realized_move необходимо вычислять тем же способом — простая разность цен привела бы к неявному сравнению величин в разных шкалах и сделала бы все последующие показатели калибровки бессмысленными, без какого-либо сообщения об ошибке. Во-вторых, и это легче упустить из виду: эту логарифмическую доходность нужно рассчитывать по ценам ЗАКРЫТИЯ, в соответствии с выражением close[idx+h]/close[idx] в целевой переменной самой модели, а не по текущей цене Bid — именно поэтому здесь и curClose, и closeNow получаются из iClose(). Если рассчитывать фактическое изменение по цене Bid, прогноз модели от закрытия до закрытия будет сравниваться с результатом от закрытия до Bid. Это внесет в сравнение систематическое, а не случайное смещение на несколько пунктов спреда и незаметно исказит проверку калибровки в разделе 11 по причине, никак не связанной с самой моделью.
Что учитывает модель, а что нет
Стоит точно обозначить, что именно учитывает эта спецификация модели и каковы пределы ее возможностей, а не считать, будто "входные данные о состоянии рынка" сами по себе полностью решают проблему выбора целевой переменной. Что здесь реализовано: признак состояния рынка на основе доходности с лагом и целевая переменная в виде логарифмической доходности непосредственно на заданном горизонте прогнозирования; ядро Матерна 3/2; последовательное обозначение и использование дисперсии сигнала и дисперсии шума именно как дисперсий; стандартизация входных данных и целевых переменных перед решением системы с ковариационной матрицей; отдельные методы прогнозирования для латентной дисперсии и дисперсии наблюдений; чистая функция вычисления логарифма маргинального правдоподобия без побочных эффектов для обученного состояния объекта; поиск по сетке в логарифмическом пространстве; проверки размерностей и пустых входных данных в Fit(); явный сброс m_fitted при каждом вызове; построение матрицы ядра с вычислением одной половины и симметричным заполнением другой; адаптивная диагональная добавка с записью в журнал; индикатор, проверяющий возвращаемое значение Predict() и записывающий EMPTY_VALUE при неудаче; проверка позиций советника с фильтрацией по символу и магическому номеру; фильтр уверенности по z-оценке вместо порога по самой дисперсии; проверка спреда перед торговлей; журнал CSV с достаточным набором полей для проверки гиперпараметров и торговых решений на каждом баре.
Что действительно остается открытым: входные данные одномерны — это единственная доходность с лагом 1. Здесь не приведено доказательств того, что этот единственный признак содержит устойчивую прогнозную информацию для XAUUSD M5; использование реальной величины, характеризующей состояние рынка, вместо индекса бара устраняет конкретную ошибку моделирования, но само по себе не доказывает, что модель дает полезный сигнал. Более полная спецификация объединяла бы доходности с разными лагами, реализованную волатильность или ATR, а также торговую сессию или время суток либо в многомерном ядре, либо в сумме ядер по отдельным группам признаков. Корректное построение и валидация такой модели — гораздо более масштабная задача, чем та, на решение которой может обоснованно претендовать модель с единственным входным признаком — доходностью с лагом. Спешка здесь чревата именно той ошибкой, которую призвана предотвратить эта статья: выпуском модели, которая выглядит сложнее, но в действительности не имеет более обоснованной спецификации. Коэффициент последующей калибровки (масштабирование собственной дисперсии гауссовского процесса коэффициентом, оцененным по историческим остаткам на данных вне обучающей выборки) — разумная идея, которая здесь не реализована; для ее корректной проверки потребовалась бы отдельная скользящая валидация. Уточнение поиска от грубой сетки к более мелкой и теплый старт с гиперпараметрами, выбранными как лучшие на предыдущем баре, — также разумные следующие шаги, выходящие за рамки этой статьи.
Второй, отдельный открытый вопрос касается основ самой проверки калибровки. Значения покрытия 68% и 95% следуют лишь из корректно заданного гауссовского прогнозного распределения. При этом данная спецификация опирается на ряд допущений, которые реальные ряды доходности регулярно нарушают: распределение доходностей имеет тяжелые хвосты, а не гауссовскую форму; гетероскедастичность не учитывается ядром модели с постоянной дисперсией; в остатках присутствует автокорреляция; неопределенность гиперпараметров игнорируется, поскольку GridSearch() рассматривает выбранную лучшую комбинацию как известную, а не оцененную; наконец, при любом InpHorizon > 1 возникают перекрывающиеся целевые переменные, которые, как уже отмечалось в разделе 6, нарушают допущение о независимости шума, лежащее в основе самой функции правдоподобия. Отклонение от значений покрытия 68% и 95% в приведенном ниже тесте допускает разные объяснения: либо модель действительно плохо откалибрована, либо корректно работающий гауссовский процесс оценивается по критерию, предполагающему условия, которым эта спецификация не полностью соответствует. В любом случае этот тест стоит провести и честно сообщить о его результатах — просто сам по себе он не дает однозначного ответа "да" или "нет" на вопрос о том, откалиброван ли гауссовский процесс. К фильтру уверенности по z-оценке из раздела 9 относится та же оговорка: z-оценка безразмерна по построению, но сопоставима между символами и таймфреймами лишь при условии, что лежащая в ее основе дисперсия сама достаточно хорошо откалибрована. Именно это и проверяется, а не следует автоматически из способа вычисления z-оценки.
Еще одно ограничение, которое стоит назвать прямо: в OnTick() отсутствуют и фильтрация по тренду или рыночному режиму, и расчет прогнозируемого торгового преимущества за вычетом реалистичных транзакционных издержек сверх самого спреда (комиссии и типичного проскальзывания на реальном счете, в отличие от идеализированного исполнения в тестере стратегий). Проверка спреда — реальное улучшение по сравнению с торговлей вслепую, но это лишь необходимый минимум, а не полная модель издержек. Более широкий эффективный спред на реальном счете во время выхода новостей или комиссия за лот дополнительно сокращают то же торговое преимущество, которому сейчас достаточно лишь превысить разницу между ценами Bid и Ask. Всем, кто планирует перейти от демонстрационного тестирования на истории к использованию на реальном счете, следует в первую очередь устранить этот пробел, а не считать его второстепенным.
Тестирование: проверка калибровки на XAUUSD M5
Методика конкретна и полностью изложена до представления численных результатов именно для того, чтобы читатель мог повторить проверку, а не принимать ее на веру: запустите советник на XAUUSD M5 с параметрами InpWindow=60, InpHorizon=3, InpMinZScore=1.0, InpAtrPeriod=14, InpAtrMultSL=1.5, InpAtrMultTP=2.5, InpLots=0.10 и включенным InpLogCsv. Функция ScoreAndLogDue() с помощью механизма очереди из раздела 9 записывает в CSV по одной строке на каждый сделанный прогноз независимо от того, совершалась ли по нему сделка. Разбейте записанные строки на группы и проверьте, какая доля фактических исходов попала в прогнозные полосы модели в одну и две сигмы, сопоставив ее с уровнями 68% и 95%, которые подразумевает корректно заданное гауссовское прогнозное распределение. При интерпретации этих долей учитывайте оговорки из раздела 10 о тяжелых хвостах, гетероскедастичности, перекрывающихся целевых переменных и неопределенности гиперпараметров. Для полностью воспроизводимого отчета об этой проверке дополнительно нужны диапазон дат тестирования и количество баров, модель спреда, комиссии и проскальзывания, использованная при прогоне в тестере стратегий, а также распределение ошибок наряду с самими процентами покрытия, а не только доля попаданий в полосы в одну и две сигмы. Все это требует фактического прогона в тестере стратегий и пока здесь не приведено.
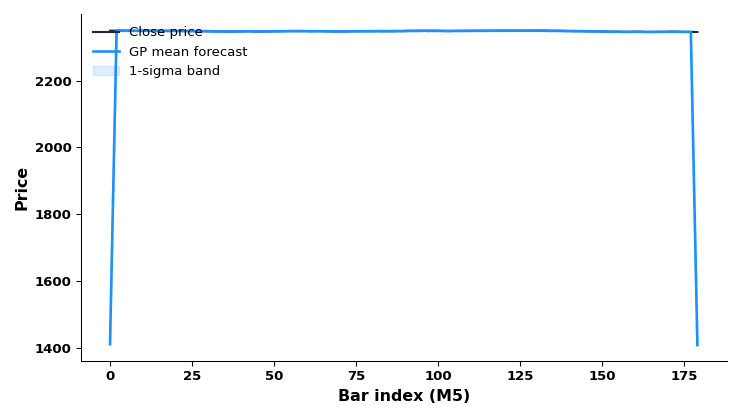
Рис. 1. Пример прогнозных полос гауссовского процесса на XAUUSD M5. Среднее и прогнозная полоса в одну сигму рассчитываются для логарифмической доходности, а затем переводятся в уровни цены с помощью экспоненты, а не прибавляются к цене напрямую.
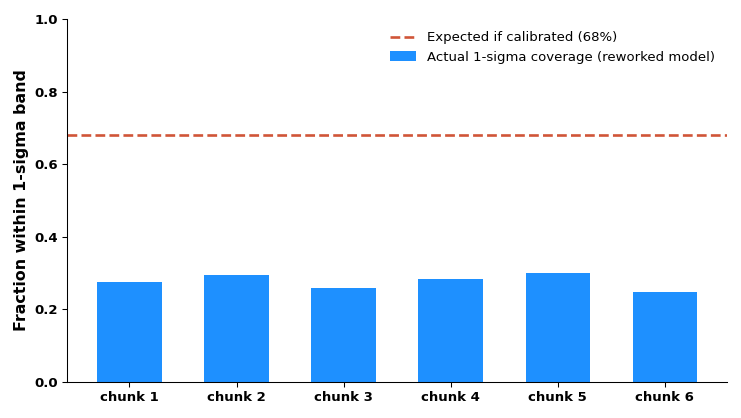
Рис. 2. Проверка калибровки по фактическим прогнозам советника на XAUUSD M5 (MetaQuotes-Demo). Каждый столбец показывает долю исходов, попавших в прогнозную полосу в одну сигму на участке теста фиксированного размера.
Когда появятся численные результаты, стоит проверить, не выбираются ли для дисперсии сигнала и дисперсии шума раз за разом минимальные значения соответствующих сеток. Если такая закономерность сохранится, это будет означать одно из двух: либо рыночным данным действительно соответствует значение на этом краю диапазона, либо масштаб самой сетки поиска не соответствует задаче. Если истинный оптимум лежит ниже нижней границы сетки, поиск никогда его не найдет и объявит граничное значение "лучшим", не имея возможности показать, что за границей сетки критерий продолжает улучшаться. Такой риск существует при любой фиксированной сетке независимо от стандартизации входных данных, и его стоит проверить по результатам фактического прогона, а не считать отсутствующим по умолчанию. Еще один момент стоит проверить непосредственно по журналам: не увеличивает ли диагональная добавка существенно дисперсию шума, выбранную GridSearch, о чем говорилось в оговорке из раздела 4. Если при обучении потребовалась заметная диагональная добавка, значение в столбце дисперсии шума занижает суммарную величину, фактически использованную в матрице при обучении.
Вычислительная сложность разложения Холецкого O(n^3) описывает асимптотический рост затрат с увеличением размера обучающего окна: эта зависимость действительно определяется только параметром InpWindow, а не значениями данных, на которых обучается модель. Однако фактически измеренное время обучения в этой реализации — несколько иной вопрос: функция DecomposeWithJitter() может повторять попытки, последовательно увеличивая диагональную добавку, если проверяемая матрица плохо обусловлена. Число повторных попыток на конкретном баре зависит от данных, а не только от размера окна. На рисунке 3 показана зависимость вычислительных затрат от размера окна. Несколько обусловленных данными выбросов выше основного тренда на барах, потребовавших дополнительных попыток с увеличением диагональной добавки, были бы ожидаемым проявлением этого эффекта, а не опровержением самой оценки O(n^3).
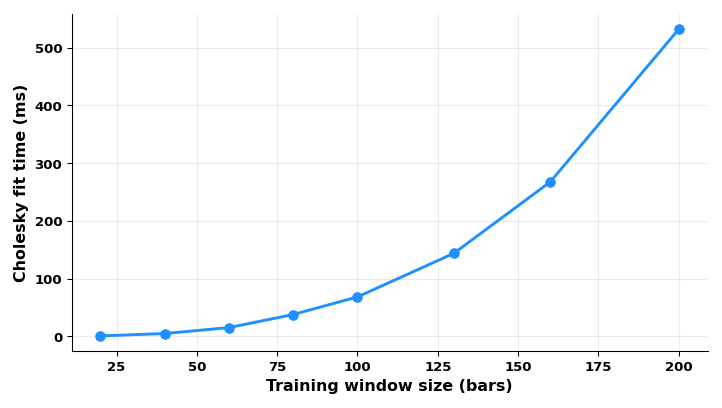
Рис. 3. Время обучения, измеренное для разных значений размера обучающего окна InpWindow.
Заключение
Слабым звеном прогнозирования на основе гауссовского процесса почти никогда не бывает линейная алгебра: решение системы с помощью разложения Холецкого при корректной реализации — давно решенная задача. Слабое звено — то, чему вы предлагаете модели обучиться и в каком масштабе представлены данные. Гауссовский процесс, которому в качестве признака передали "позицию в скользящем окне", честно ответит на поставленный вопрос: он выучит гладкую кривую зависимости от позиции в окне, а заявленная им уверенность будет ровно настолько информативной, насколько того заслуживает сам вопрос, то есть не слишком. Входной признак, действительно отражающий состояние рынка, приносит пользу лишь тогда, когда последующие механизмы обработки — в частности, сетка значений масштаба длины, по которой выполняется поиск параметров ядра, — согласованы с ним по масштабу. Сетка, подобранная под масштаб одних входных данных, теряет смысл, если масштаб входных данных меняется на несколько порядков; поэтому в разделе 5 x стандартизируется еще до поиска по этой сетке.
В результате получается спецификация, корректная в ключевых аспектах: признак и целевая переменная представляют собой реальные рыночные величины, а не условные заменители, а механизм поиска гиперпараметров ядра работает с входными данными, приведенными к единому масштабу. Единственный признак — доходность с лагом 1 — по-прежнему дает весьма ограниченное представление о состоянии рынка: два разных режима волатильности могут давать одинаковую доходность с лагом 1, и модель будет оценивать неопределенность в обоих случаях сходным образом. Подтвердят ли это показатели покрытия, полученные при фактическом тестировании на исторических данных, или они окажутся ближе к заявленным моделью целевым уровням, чем ожидалось, — вот следующий конкретный, проверяемый факт, который предстоит установить с помощью этой спецификации; главное — честно сообщить результат, каким бы он ни оказался.
| Файл | Тип | Описание |
|---|---|---|
| GPRForecast_Core.mqh | Включаемый файл | Собственная реализация гауссовского процесса: ядро Матерна 3/2, решение симметричной системы с помощью разложения Холецкого с адаптивной диагональной добавкой, стандартизированные целевые переменные, раздельный расчет латентной дисперсии и дисперсии наблюдений, поиск по сетке в логарифмическом пространстве без побочных эффектов |
| GPRForecast_Ind.mq5 | Индикатор | Отображает прогноз уровня цены на основе гауссовского процесса и прогнозные границы на расстоянии одной сигмы от среднего, рассчитанные по дисперсии наблюдений, используя входные данные о состоянии рынка (доходность с лагом 1); при любой неудаче обучения выводит EMPTY_VALUE |
| GPRForecast_EA.mq5 | Советник | Выполняет повторное обучение гауссовского процесса один раз за бар на входных данных, описывающих состояние рынка; совершает сделки только тогда, когда z-оценка — отношение прогнозируемого преимущества к прогнозируемой неопределенности — достигает заданного порога, а само торговое преимущество превышает текущий спред; учитывает только собственные позиции, отобранные по символу и магическому номеру |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/24576
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


