

Машинное обучение и Data Science (Часть 47): Прогнозирование рынка с помощью модели DeepAR на Python
 300
 1

Содержание
- Введение
- Что такое DeepAR?
- Принципы работы DeepAR
- Подготовка данных для модели DeepAR
- Обучение модели DeepAR на Python
- Прогнозирование рынка в режиме с помощью модели DeepAR
- Мультивалютный подход на основе модели DeepAR
- Заключение
Введение
Прогнозирование временных рядов никогда не было простой задачей в области машинного обучения; для решения этой проблемы было предложено несколько методов и моделей, однако большинство из них не принесло однозначного успеха. Линейные и нелинейные модели зачастую также не способны справиться с этой задачей, несмотря на то, что в некоторых случаях они демонстрируют неплохие результаты при прогнозировании данных временных рядов.
Для решения задач прогнозирования временных рядов трейдеры обращаются к моделям на основе нейронных сетей, таким как рекуррентные нейронные сети (RNN).
Однако RNN больше похожи на нелинейные модели, чем на модели временных рядов. Те, кто знаком с авторегрессионной интегрированной моделью скользящего среднего (ARIMA) и векторной авторегрессионной моделью (VAR), возможно, уже заметили это. Этим моделям действительно требуются дополнительные шаги по подготовке данных в виде окон, чтобы нейронная сеть могла учитывать паттерны временных рядов; при этом они все равно не рассчитаны на сезонные паттерны, которые традиционные модели прогнозирования временных рядов учитывают.
В этой статье мы рассмотрим модель DeepAR. Авторегрессионная нейросетевая модель. Она ведет себя как нелинейная модель, поскольку содержит нейронную сеть, и в то же время обладает авторегрессионным свойством, характерным для классических моделей временных рядов, таких как ARIMA.
Что такое DeepAR?
Согласно документации.
Алгоритм прогнозирования Amazon SageMaker DeepAR представляет собой алгоритм обучения с учителем, предназначенный для прогнозирования скалярных (одномерных) временных рядов с использованием рекуррентных нейронных сетей (RNN). Классические методы прогнозирования, такие как авторегрессионная интегрированная модель скользящего среднего (ARIMA) или экспоненциальное сглаживание (ETS), подгоняют отдельную модель к каждому отдельному временному ряду. Затем они используют эту модель для экстраполяции временного ряда на будущие периоды.
Однако во многих приложениях имеется множество схожих временных рядов по различным объектам. Например, у вас могут быть временные ряды спроса на различные продукты, нагрузки на серверы и запросов к веб-страницам. Для задач такого рода целесообразно обучить одну модель совместно на всех временных рядах. DeepAR использует именно такой подход. Если ваш набор данных содержит сотни взаимосвязанных временных рядов, DeepAR превосходит стандартные методы ARIMA и ETS. Кроме того, вы можете использовать обученную модель для построения прогнозов по новым временным рядам, аналогичным тем, на которых она была обучена.
Итак, рассмотрим основные принципы этой модели.
Принципы работы DeepAR
Ниже приведены некоторые ключевые принципы работы модели DeepAR.
01: Вероятностное прогнозирование временных рядов
DeepAR не просто выдает единственную точечную оценку будущих значений; она обучается на выводах и моделирует полное распределение будущих значений.
Это позволяет модели выражать неопределенность и строить интервалы прогнозирования или квантили (например, P10, P50, P90). Эти прогнозы имеют большое значение для принятия решений с учетом рисков.
02: Глобальное моделирование на множестве рядов
В отличие от традиционных моделей прогнозирования, таких как ARIMA и ETS, которые строят отдельные модели для каждого временного ряда, DeepAR обучает единую модель одновременно на нескольких взаимосвязанных временных рядах.
Эта глобальная модель выявляет общие закономерности и повышает качество, особенно когда для отдельных временных рядов доступен ограниченный объем данных. Эта модель может даже обобщаться на новые, но схожие ряды, которых она раньше не видела.
03: Архитектура авторегрессионной рекуррентной нейронной сети
DeepAR использует архитектуру на основе рекуррентной нейронной сети (RNN), обычно с ячейками LSTM в авторегрессионной схеме. Это означает, что модель формирует прогнозы с учетом собственных ранее спрогнозированных значений и прошлых наблюдений.
Это позволяет учитывать временные зависимости, такие как тенденции, сезонность и нелинейную динамику данных.
04: Использование статических и динамических признаков
Эта модель разработана для обработки как динамических, так и категориальных признаков:
- примеры статических/категориальных признаков – категория товара или регион;
- пример динамического/зависимого от времени признака – цена.
Эта возможность отличает модель от нелинейных моделей, таких как XGBoost и базовые нейронные сети.
05: Конструирование признаков с учетом времени
DeepAR извлекает из временного ряда временные признаки, такие как день недели, месяц и т. д., помогая модели учитывать сезонность и периодические закономерности без трудоемкого ручного конструирования признаков.
Это позволяет нам значительно сэкономить время на создании тех основанных на времени признаков, которые обычно требуются при прогнозировании временных рядов.
В приведенной ниже таблице перечислены производные признаки для поддерживаемых базовых временных частот.
| Частота временного ряда | Производные признаки |
|---|---|
| Минута | Минута часа, час суток, день недели, число месяца, день года. |
| Час | Час суток, день недели, число месяца, день года. |
| День | День недели, число месяца, день года. |
| Неделя | Число месяца, неделя года. |
| Месяц | Месяц года. |
06: Сэмплирование контекстного окна и окна прогнозирования
Эта модель позволяет управлять тем, насколько далеко в прошлое заглядывать для наблюдения и насколько далеко в будущее строить прогноз.
Гиперпараметры context_length и prediction_length управляют соответственно тем, сколько исторических данных использует модель и насколько далеко вперед она строит прогноз.
07: Обработка пропущенных значений
DeepAR изначально умеет обрабатывать пропущенные значения во временных рядах. Внешняя импутация не требуется, при этом точность прогноза сохраняется даже на неполных данных.
Подготовка данных для модели DeepAR
Теперь, когда мы разобрались с основными принципами этой модели, реализуем ее на Python и посмотрим, действительно ли она так хороша, как о ней говорят
Для начала установите все зависимости, указанные в файле requirements.txt (прилагается в конце этой статьи), в своей виртуальной среде Python.
pip install -r requirements.txt
В файле main.py мы начинаем с импорта всех необходимых модулей.
import pandas as pd
import torch
import lightning.pytorch as pl
import matplotlib.pyplot as plt
import pytorch_forecasting
from pytorch_forecasting import Baseline, DeepAR, TimeSeriesDataSet, GroupNormalizer
from lightning.pytorch.callbacks import EarlyStopping
from pytorch_forecasting.metrics import SMAPE, MultivariateNormalDistributionLoss, QuantileLoss
from pytorch_forecasting import DeepAR
import MetaTrader5 as mt5
import warnings
Поскольку всем моделям машинного обучения нужны данные, на которых они могут обучаться, импортируем данные из MetaTrader 5.
if not mt5.initialize(): # initialize MetaTrader 5
    print(f"failed to initialize MetaTrader5, Error = {mt5.last_error()}")
    exit()

symbol = "EURUSD"
df = pd.DataFrame(mt5.copy_rates_from_pos(symbol, mt5.TIMEFRAME_H1, 1, 1000))

print(df.head())
Вывод:
         time     open     high      low    close  tick_volume  spread  real_volume
0  1760598000  1.16621  1.16623  1.16559  1.16563         1209       0            0
1  1760601600  1.16561  1.16615  1.16541  1.16602         2113       0            0
2  1760605200  1.16602  1.16680  1.16521  1.16539         3925       0            0
3  1760608800  1.16539  1.16569  1.16431  1.16521         4533       0            0
4  1760612400  1.16518  1.16599  1.16487  1.16591         3948       0            0
Нам нужно преобразовать время из секунд в объекты datetime.
df['time'] = pd.to_datetime(df['time'], unit='s')
Затем мы сортируем значения по столбцу времени.
df = df.sort_values("time").reset_index(drop=True)
Вывод:
                 time     open     high      low    close  tick_volume  spread  real_volume
0 2025-10-16 07:00:00  1.16621  1.16623  1.16559  1.16563         1209       0            0
1 2025-10-16 08:00:00  1.16561  1.16615  1.16541  1.16602         2113       0            0
2 2025-10-16 09:00:00  1.16602  1.16680  1.16521  1.16539         3925       0            0
3 2025-10-16 10:00:00  1.16539  1.16569  1.16431  1.16521         4533       0            0
4 2025-10-16 11:00:00  1.16518  1.16599  1.16487  1.16591         3948       0            0
Для создания объекта TimeSeriesDataset (объекта, полезного для подготовки набора данных временных рядов для моделей pytorch_forecasting) нам нужны два столбца: time_idx и group_id (последний необязателен).
df["time_idx"] = (df["time"] - df["time"].min()).dt.total_seconds().astype(int) // 3600
df["symbol"] = symbol
Столбец time_idx отражает временную последовательность всех строк в датафрейме.
Столбец symbol используется для группировки различных инструментов, присутствующих в датафрейме. В данном случае у нас есть одна группа с именем EURUSD.
При визуализации DataFrame выглядит следующим образом:
                 time     open     high      low    close  tick_volume  spread  real_volume  time_idx  symbol
0 2025-10-16 07:00:00  1.16621  1.16623  1.16559  1.16563         1209       0            0         0  EURUSD
1 2025-10-16 08:00:00  1.16561  1.16615  1.16541  1.16602         2113       0            0         1  EURUSD
2 2025-10-16 09:00:00  1.16602  1.16680  1.16521  1.16539         3925       0            0         2  EURUSD
3 2025-10-16 10:00:00  1.16539  1.16569  1.16431  1.16521         4533       0            0         3  EURUSD
4 2025-10-16 11:00:00  1.16518  1.16599  1.16487  1.16591         3948       0            0         4  EURUSD
Повторим: модель DeepAR является одномерной, то есть она обучается на одной переменной и учится прогнозировать будущие значения этой переменной на основе ее прошлых значений.
Поскольку мы обычно ищем способы прогнозировать цену закрытия, переменная close является единственным нужным нам признаком.
Однако цена закрытия – непрерывная величина; попытка прогнозировать ее может оказаться сложной задачей даже для этой модели. При прогнозировании временных рядов мы обычно имеем дело со стационарными данными, поскольку по своей природе они имеют постоянные во времени среднее значение и дисперсию.
Создание целевой переменной
Для решения этой задачи обучим нашу модель прогнозированию доходности:
df["returns"] = (df["close"].shift(-1) - df["close"]) / df["close"]
df = df.dropna().reset_index(drop=True)
Затем мы фильтруем датафрейм, оставляя только 3 столбца, необходимые для объекта данных временных рядов.
ts_df = df[["time_idx", "returns", "symbol"]]
При выводе на экран он выглядит так.
   time_idx   returns  symbol
0         0  0.000335  EURUSD
1         1 -0.000540  EURUSD
2         2 -0.000154  EURUSD
3         3  0.000601  EURUSD
4         4 -0.000069  EURUSD
Имея под рукой подходящий DataFrame, сначала создадим объект TimeSeriesDataset для обучения.
max_encoder_length = 24
max_prediction_length = 6
training_cutoff = df["time_idx"].max() - max_prediction_length

training = TimeSeriesDataSet(
    data=ts_df[ts_df.time_idx <= training_cutoff],
    time_idx="time_idx",
    target="returns",
    group_ids=["symbol"],

    max_encoder_length=max_encoder_length,
    max_prediction_length=max_prediction_length,

    min_encoder_length=1,

    allow_missing_timesteps=True,

    time_varying_known_reals=["time_idx"],
    time_varying_unknown_reals=["returns"],

    target_normalizer=GroupNormalizer(groups=["symbol"],
                                      transformation="log1p")
)
Переменная max_encoder_length указывает модели, какой объем прошлых данных учитывать.
Переменная max_prediction_length задает горизонт прогнозирования модели.
Мы подготавливаем для валидационных данных аналогичный объект, такой же, как для обучающих данных.
validation = TimeSeriesDataSet.from_dataset(training, ts_df, min_prediction_idx=training_cutoff + 1) Как описано в разделе «Принципы», модель DeepAR имеет встроенный механизм создания дополнительных временных признаков в зависимости от указанной в наборе данных даты и времени.
Это справедливо, если вы явно используете модель DeepAR, предоставляемую Amazon SageMaker AI. К сожалению, мне не удалось найти хорошую документацию по этому вопросу, поэтому мы реализуем модель с помощью модуля PyTorch Forecasting с вручную добавленными временными признаками.
df["hour"] = df["time"].dt.hour.astype(str)
df["day_of_week"] = df["time"].dt.dayofweek.astype(str)
df["month"] = df["time"].dt.month.astype(str)

ts_df = df[["time_idx", "returns", "symbol", "hour", "day_of_week", "month"]]
Обучение модели DeepAR на Python
Для нашей модели нужны загрузчики данных (это обычная практика в PyTorch Forecasting).
batch_size = 64

train_dataloader = training.to_dataloader(train=True, batch_size=batch_size, num_workers=0, batch_sampler="synchronized")
val_dataloader = validation.to_dataloader(train=False, batch_size=batch_size, num_workers=0, batch_sampler="synchronized")
Нам нужен объект Trainer для нашей модели; мы будем использовать модуль Lightning.
# create trainer

trainer = pl.Trainer(
    max_epochs=100,
    accelerator="gpu" if torch.cuda.is_available() else "cpu",
    gradient_clip_val=0.1,
    callbacks=[EarlyStopping(monitor="val_loss", patience=10, mode="min")],
)
Мы обучаем модель максимум 100 эпох и отслеживаем потери на валидации для ранней остановки (прекращения обучения, когда качество модели перестает улучшаться).
Затем мы обучаем модель DeepAR с помощью только что созданного объекта Trainer.
trainer.fit(
    model,
    train_dataloaders=train_dataloader,
    val_dataloaders=val_dataloader,
)
Вывод:
┏━━━┳━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━┳━━━━━━━┳━━━━━━━━┓
┃   ┃ Name                   ┃ Type                               ┃ Params ┃Mode   ┃FLOPs  ┃
┡━━━╇━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━╇━━━━━━━╇━━━━━━━━┩
│ 0 │ loss                   │ MultivariateNormalDistributionLoss │      0 │ train │     0 │
│ 1 │ logging_metrics        │ ModuleList                         │      0 │ train │     0 │
│ 2 │ embeddings             │ MultiEmbedding                     │    245 │ train │     0 │
│ 3 │ rnn                    │ LSTM                               │ 22.9 K │ train │     0 │
│ 4 │ distribution_projector │ Linear                             │  1.3 K │ train │     0 │
└───┴────────────────────────┴────────────────────────────────────┴────────┴───────┴───────┘
Trainable params: 24.4 K
Non-trainable params: 0
Total params: 24.4 K
Total estimated model params size (MB): 0
Modules in train mode: 14
Modules in eval mode: 0
Total FLOPs: 0
Epoch 10/99 ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ 933/933 0:00:23 • 0:00:00 40.63it/s v_num: 38.000 train_loss_step: -7.305 val_loss: -60.929 train_loss_epoch: -44.401
По завершении процесса обучения мы извлекаем лучшую модель из объекта Trainer.
best_model_path = trainer.checkpoint_callback.best_model_path
best_model = DeepAR.load_from_checkpoint(best_model_path, weights_only=False)
Сделаем прогнозы для оценки.
raw_predictions = best_model.predict(val_dataloader, mode="raw", return_x=True)
Наконец, мы строим график прогнозов для оценки результатов.
for idx in range(len(raw_predictions.x["decoder_time_idx"])):

    best_model.plot_prediction(
        raw_predictions.x,
        raw_predictions.output,
        idx=idx,
        add_loss_to_title=True
    )

    plt.show()
Результаты (прогнозы и фактические значения, построенные на одной оси):
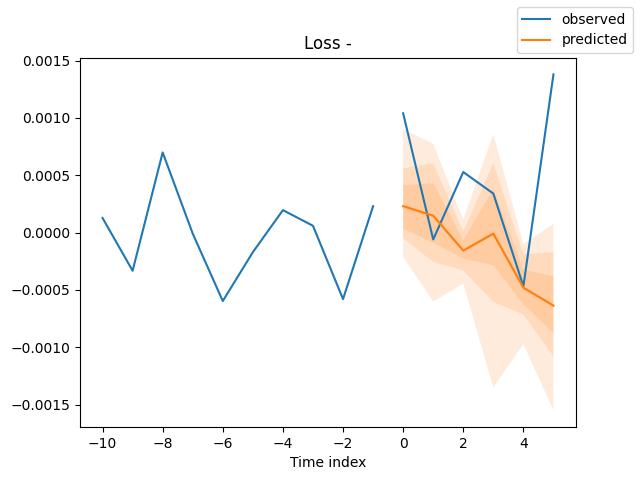
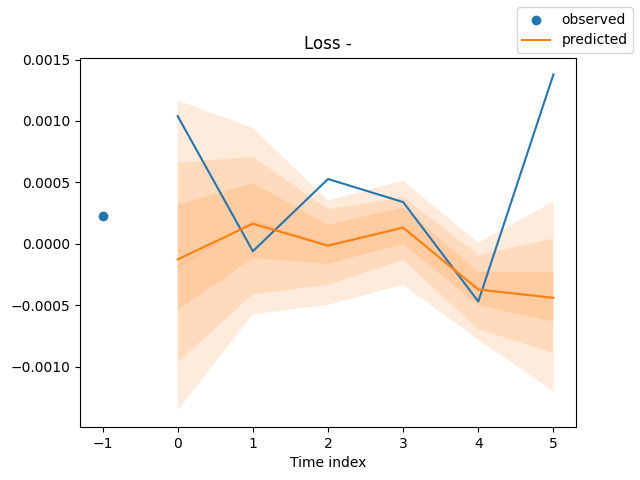
Теперь, когда у нас есть способ обучить модель (или модели), воспользуемся одной из них для получения полезных прогнозов.
Прогнозирование рынка в реальном времени с использованием модели DeepAR
Чтобы значительно упростить себе жизнь, нам нужно вынести процесс обучения в отдельный файл, а затем создать отдельную функцию для обработки и конструирования признаков.
Внутри файла train.py
import torch
import lightning.pytorch as pl
import matplotlib.pyplot as plt
import pytorch_forecasting
from pytorch_forecasting import DeepAR, TimeSeriesDataSet
from lightning.pytorch.callbacks import EarlyStopping, ModelCheckpoint
from pytorch_forecasting.metrics import MultivariateNormalDistributionLoss
from pytorch_forecasting import DeepAR
# from lightning.pytorch.tuner import Tuner
import os
import config
import warnings

warnings.filterwarnings("ignore")
torch.serialization.add_safe_globals([pytorch_forecasting.data.encoders.GroupNormalizer])
torch.serialization.safe_globals([pytorch_forecasting.data.encoders.GroupNormalizer])

pl.seed_everything(config.random_seed) # set random seed for the lightning module

def run(training: TimeSeriesDataSet,
        train_dataloader: any,
        val_dataloader: any,
        loss: pytorch_forecasting.metrics = MultivariateNormalDistributionLoss(rank=30),
        best_model_name: str=config.best_model_name) -> DeepAR:

    # model's checkpoint

    checkpoint_callback = ModelCheckpoint(
        dirpath=config.models_path,
        filename=best_model_name,
        save_top_k=1,
        mode="min",
        monitor="val_loss"
    )

    # create trainer

    trainer = pl.Trainer(
        max_epochs=config.num_epochs,
        accelerator="gpu" if torch.cuda.is_available() else "cpu",
        gradient_clip_val=config.grad_clip,
        callbacks=[EarlyStopping(monitor="val_loss", patience=config.patience, mode="min"), checkpoint_callback],
        logger=False,
    )

    # create DeepAR model

    model = DeepAR.from_dataset(
        training,
        learning_rate=config.learning_rate,
        hidden_size=config.hidden_size,
        rnn_layers=config.rnn_layers,
        dropout=config.dropout,

        # --- probabilistic forecasting ---
        loss=loss,

        log_interval=config.log_interval,
        log_val_interval=config.log_val_interval,
    )

    res = None
    try:
        # find the optimal learning rate

        """
        res = Tuner(trainer).lr_find(
            model, train_dataloaders=train_dataloader, val_dataloaders=val_dataloader, early_stop_threshold=1000.0, max_lr=0.3,
        )

        # and plot the result - always visually confirm that the suggested learning rate makes sense
        print(f"suggested learning rate: {res.suggestion()}")
        fig = res.plot(show=True, suggest=True)
        fig.savefig(os.path.join(config.images_path, "lr_finder.png"))
        """

        # fit the model

        trainer.fit(
            model,
            train_dataloaders=train_dataloader,
            val_dataloaders=val_dataloader,
        )

    except Exception as e:
        raise RuntimeError(e)

    best_model_path = checkpoint_callback.best_model_path
    best_model = DeepAR.load_from_checkpoint(best_model_path, weights_only=False)

    # make probabilistic forecasts

    raw_predictions = best_model.predict(val_dataloader, mode="raw", return_x=True)

    # plot predictions

    # for idx in range(config.max_prediction_length):
    for idx in range(len(raw_predictions.x["decoder_time_idx"])):
        best_model.plot_prediction(
            raw_predictions.x,
            raw_predictions.output,
            idx=idx,
            add_loss_to_title=True
        )

        plt.savefig(os.path.join(config.images_path, "deepar_forecast_{}.png".format(idx+1)))
        # plt.show()

    return model
Обучение модели – ресурсоемкий процесс, и его, безусловно, не стоит выполнять слишком часто. Нам нужна функция для загрузки предварительно обученной (сохраненной) модели.
Внутри файла main.py
def load_model():
    global model

    try:
        model = DeepAR.load_from_checkpoint(
            checkpoint_path=os.path.join(config.models_path, config.best_model_name+".ckpt"),
            weights_only=False,
        )
    except Exception as e:
        print(f"Failed to load model from checkpoint: {e}")
        model = None
        return False

    return True
Поскольку перед передачей данных в модель для инференса нам нужно применять к ним тот же процесс сбора и конструирования признаков. Лучше обернуть все необходимые процессы в отдельную функцию.
def feature_engineering(df: pd.DataFrame) -> pd.DataFrame:

    # convert time in seconds to datetime
    df['time'] = pd.to_datetime(df['time'], unit='s')
    df = df.sort_values("time").reset_index(drop=True)

    # print(df.head())

    df["time_idx"] = np.arange(len(df))
    df["symbol"] = symbol

    # print(df.head())

    # instead of using close price, which is very hard to predict, let's use close price returns

    df["returns"] = (df["close"].shift(-1) - df["close"]) / df["close"]
    df = df.dropna().reset_index(drop=True)

    df["hour"] = df["time"].dt.hour.astype(str)
    df["day_of_week"] = df["time"].dt.dayofweek.astype(str)
    df["month"] = df["time"].dt.month.astype(str)

    return df[["time_idx", "returns", "symbol", "hour", "day_of_week", "month"]]
Внутри функции training_job,которая будет запускаться по расписанию. При плановом обучении мы начинаем со сбора данных и конструирования признаков.
Внутри файла main.py
def training_job():
    global model

    # ----- feature engineering -----

    try:
        df = pd.DataFrame(mt5.copy_rates_from_pos(symbol, timeframe, config.train_start_bar, config.train_total_bars))
        ts_df = feature_engineering(df)
    except Exception as e:
        print(f"Failed to get historical data from MetaTrader 5: {e}")
        return

    print(ts_df.head())
После получения исходных данных в формате pandas.DataFrame нам необходимо создать объекты TimeSeriesData и загрузчики данных аналогично тому, как мы делали ранее.
def training_job():
    global model

    # ----- feature engineering -----

    try:
        df = pd.DataFrame(mt5.copy_rates_from_pos(symbol, timeframe, config.train_start_bar, config.train_total_bars))
        ts_df = feature_engineering(df)
    except Exception as e:
        print(f"Failed to get historical data from MetaTrader 5: {e}")
        return

    print(ts_df.head())

    # ----- create timeseries datasets and dataloaders -----

    training_cutoff = ts_df["time_idx"].max() - config.max_prediction_length

    training = TimeSeriesDataSet(
        data=ts_df[ts_df.time_idx <= training_cutoff],
        time_idx="time_idx",
        target="returns",
        group_ids=["symbol"],

        max_encoder_length=config.max_encoder_length,
        max_prediction_length=config.max_prediction_length,

        min_encoder_length=config.min_encoder_length,
        # min_prediction_length=1,

        allow_missing_timesteps=True,

        time_varying_known_categoricals=["hour", "day_of_week", "month"],

        time_varying_known_reals=["time_idx"],
        time_varying_unknown_reals=["returns"],

        target_normalizer=GroupNormalizer(groups=["symbol"],
                                        transformation="log1p")
    )

    validation = TimeSeriesDataSet.from_dataset(training, ts_df, min_prediction_idx=training_cutoff + 1)

    train_dataloader = training.to_dataloader(train=True, batch_size=config.batch_size, num_workers=config.num_workers, batch_sampler="synchronized")
    val_dataloader = validation.to_dataloader(train=False, batch_size=config.batch_size, num_workers=config.num_workers, batch_sampler="synchronized")

    model = train.run(training=training,
              train_dataloader=train_dataloader,
              val_dataloader=val_dataloader,
              loss=MultivariateNormalDistributionLoss(rank=30),
              best_model_name=config.best_model_name)
Наконец, с помощью модуля Schedule мы назначаем выполнение операции обучения через заданный интервал времени в минутах.
import schedule

#....
#....

schedule.every(config.train_interval_minutes).minutes.do(training_job)
Обратите внимание, что большинство переменных имеют формат (config.some_variable). Это связано с тем, что большинство переменных хранятся в файле с именем config.py
Теперь, когда все процедуры обучения уже реализованы, нам нужна заключительная функция для получения последних тиков и баров из MetaTrader 5 и использования этой информации при принятии окончательных торговых решений.
def trading_loop():

    global model
    if model is None:
        if not load_model():
            print("Model not loaded, skipping trading loop.")
            return False
Прежде всего необходимо убедиться, что глобальная переменная с именем model содержит объект; если это не так, мы загружаем оптимальную модель для данного инструмента и таймфрейма.
После успешной загрузки модели мы получаем данные в реальном времени и выполняем конструирование признаков аналогично тому, как мы делали это во время обучения.
    try:
        df = pd.DataFrame(mt5.copy_rates_from_pos(symbol, timeframe, 1, config.max_encoder_length + config.max_prediction_length))
        ts_df = feature_engineering(df)
    except Exception as e:
        print(f"Failed to get realtime data from MetaTrader 5: {e}")
        return False
Затем мы передаем данные объекту модели и получаем прогнозы.
Поскольку в обучающих данных у нас есть только одна группа, мы преобразуем двумерный массив в одномерный массив NumPy.
    predictions = model.predict(data=ts_df, mode="prediction")
    predictions = np.array(predictions).ravel()
Поскольку мы обучили модель прогнозировать 6 шагов с использованием переменной max_prediction_length, модель всегда будет возвращать 6 прогнозируемых значений для 6 последовательных баров, следующих за последним известным наблюдением.
Нам нужно выбрать, для какого бара использовать прогноз, в зависимости от наших целей (в данном случае – для задания значений стоп-лосса и тейк-профита).
    forecast_index = -1  # last-step forecast

    predicted_return = predictions[forecast_index]
Мы должны помнить, как именно сформировали целевую переменную на этапе обучения, поскольку это определяет, как нам следует интерпретировать и использовать прогнозируемые значения.
В данном случае мы обучили модель прогнозировать суточную относительную доходность. Чтобы получить оценочное рыночное значение, нам нужно умножить это значение на последнюю цену закрытия (напомним, что доходность рассчитывалась на основе цен закрытия).
price_delta = predicted_return * df["close"].iloc[-1]
Мы будем использовать это рыночное значение цены для определения уровней стоп-лосса и тейк-профита по нашей сделке, а также использовать прогнозируемую величину доходности в качестве торгового сигнала (то есть, если прогнозируемая доходность отрицательная, это является медвежьим сигналом, а в обратном случае – бычьим сигналом).
    # ------------ sl and tp according to model predictions ------------

    if predicted_return > 0:

        tp = round(ask + price_delta, digits)
        sl = round(ask - abs(price_delta), digits)

        if not is_valid_sl_tp(sl=sl, tp=tp, price=ask):
            return

        if not pos_exists(magic_number=m_trade.magic_number, symbol=symbol, pos_type=mt5.POSITION_TYPE_BUY):
            if not m_trade.buy(symbol=symbol, volume=min_lotsize, price=ask, sl=sl, tp=tp):
                print(f"Buy order failed, Error = {mt5.last_error()} | price= {ask}, sl= {sl}, tp= {tp}")

    else:

        tp = round(bid - abs(price_delta), digits)
        sl = round(bid + abs(price_delta), digits)

        if not is_valid_sl_tp(sl=sl, tp=tp, price=bid):
            return

        if not pos_exists(magic_number=m_trade.magic_number, symbol=symbol, pos_type=mt5.POSITION_TYPE_SELL):
            if not m_trade.sell(symbol=symbol, volume=min_lotsize, price=bid, sl=sl, tp=tp):
                print(f"Sell order failed, Error = {mt5.last_error()} | price= {bid}, sl= {sl}, tp= {tp}")
Заметили что-то знакомое?
Модули m_trade, m_symbol и другие – это модули в стиле MQL5, созданные для того, чтобы упростить нам работу в Python по аналогии с MQL5.
Ниже приведено их объявление в файле main.py.
import MetaTrader5 as mt5
from Trade.PositionInfo import CPositionInfo
from Trade.SymbolInfo import CSymbolInfo
from Trade.Trade import CTrade

# --------------- configure metatrader5 modules -------------------

if not mt5.initialize(): # initialize MetaTrader 5
    print(f"failed to initialize MetaTrader5, Error = {mt5.last_error()}")
    exit()

m_position = CPositionInfo(mt5_instance=mt5)
m_trade = CTrade(mt5_instance=mt5, magic_number=123456, filling_type_symbol=symbol, deviation_points=100)
m_symbol = CSymbolInfo(mt5_instance=mt5)

m_symbol.name(symbol_name=symbol) # set symbol name
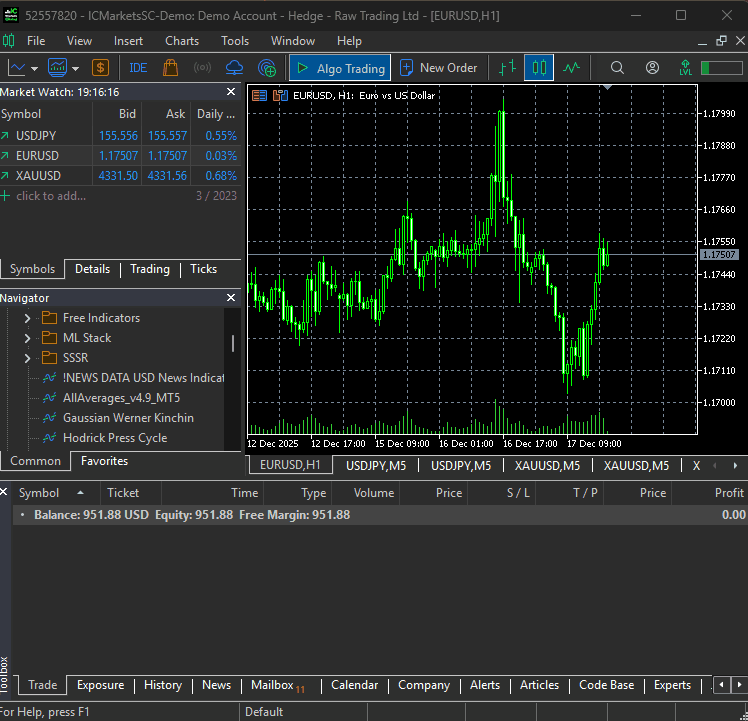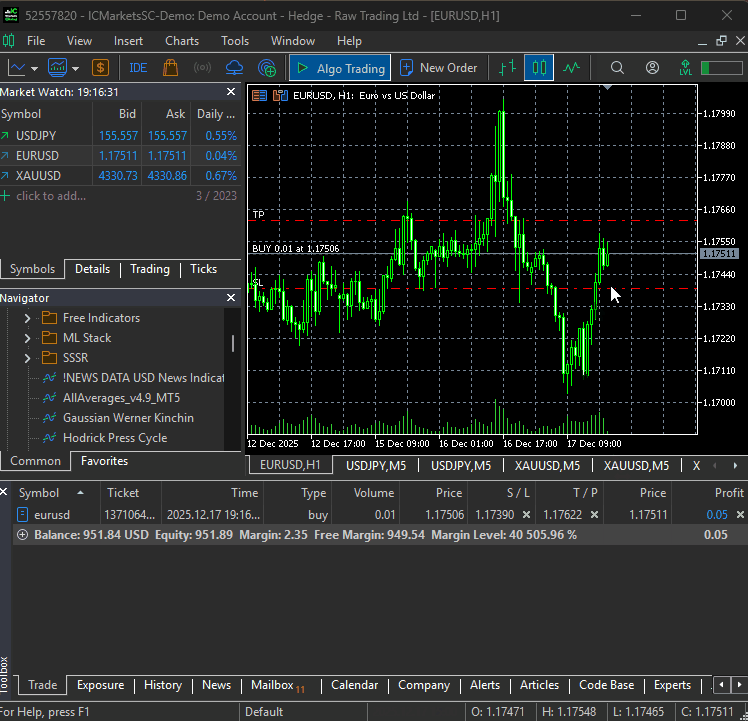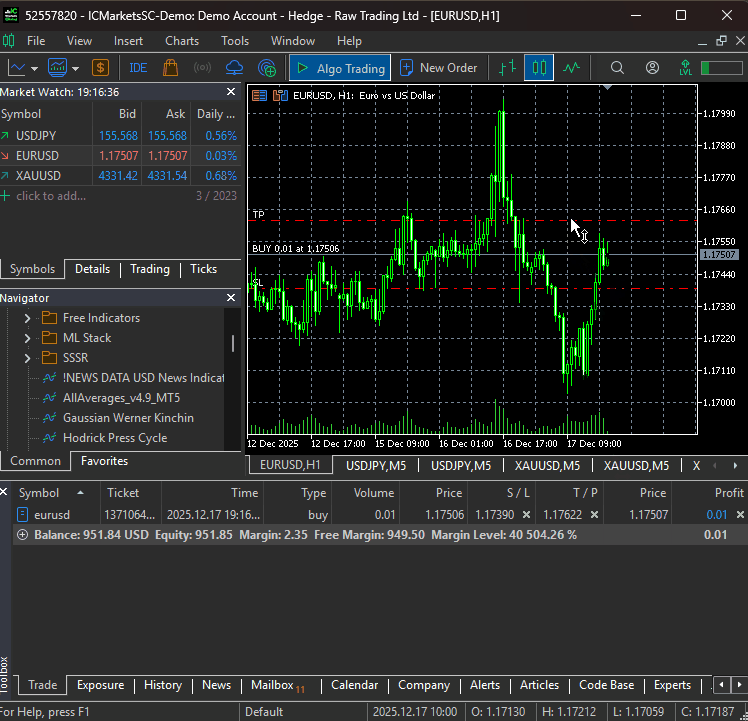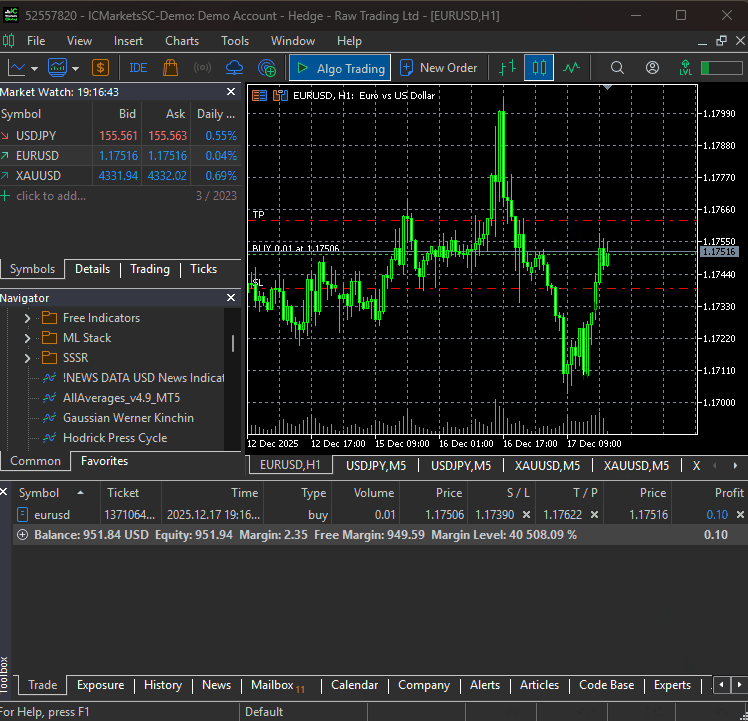
Как бы то ни было, при запуске файла main.py наш простой бот смог инициировать свою самую первую торговую операцию.
Мультивалютный подход на основе модели DeepAR
Как уже отмечалось при рассмотрении основных принципов модели DeepAR, она способна моделировать данные из разных временных рядов. Некоторые считают, что результаты будут еще лучше, если этой модели предоставить разные временные ряды со схожими закономерностями, поскольку выученные закономерности будут повторно использоваться, что улучшит способность модели к обобщению.
Чтобы сделать модель мультивалютной, нам необходимо передать ей данные по всем нужным инструментам.
Мы будем использовать тот же подход с некоторыми корректировками в сборе данных и обработке двумерных прогнозов, выдаваемых моделью для разных временных рядов и окон прогнозирования (горизонтов прогнозирования).
Вместо одной переменной для конкретного символа у нас теперь есть массив из нескольких символов.
symbols = [
    "EURUSD",
    "GBPUSD",
    "USDJPY",
    "USDCHF",
    "AUDUSD",
    "USDCAD",
    "NZDUSD"
]

timeframe = mt5.TIMEFRAME_D1
На этот раз мы собираем данные (бары) из MetaTrader 5 по различным инструментам.
Мы добавляем все новые строки в конец большого датафрейма с именем ts_df.
def training_job():
    global model

    # -------- feature engineering ---------

    ts_df = pd.DataFrame()
    for symbol in symbols:
        try:

            df = pd.DataFrame(mt5.copy_rates_from_pos(symbol, timeframe, config.train_start_bar, config.train_total_bars))
            temp_df = feature_engineering(df, symbol)

            ts_df = pd.concat([ts_df, temp_df], axis=0, ignore_index=True)

        except Exception as e:
            print(f"Failed to get historical data from MetaTrader 5: {e} for symbol {symbol}")
            continue

    print(ts_df.head())
    print(ts_df.tail())
Вывод:
   time_idx   returns  symbol hour day_of_week month
0         0  0.023229  EURUSD    0           2     4
1         1  0.013703  EURUSD    0           3     4
2         2 -0.000493  EURUSD    0           4     4
3         3 -0.006018  EURUSD    0           0     4
4         4  0.010389  EURUSD    0           1     4
      time_idx   returns  symbol hour day_of_week month
1248       174  0.006002  NZDUSD    0           1    12
1249       175 -0.001272  NZDUSD    0           2    12
1250       176 -0.001670  NZDUSD    0           3    12
1251       177 -0.002759  NZDUSD    0           4    12
1252       178  0.000017  NZDUSD    0           0    12
Внутри функции trading_loop мы собираем данные так же, как и во время обучения (на этот раз внутри цикла for).
    # ----------- get realtime data from MetaTrader 5 -----------

    ts_df = pd.DataFrame()
    for symbol in symbols:
        try:

            df = pd.DataFrame(mt5.copy_rates_from_pos(symbol, timeframe, 1, config.max_encoder_length + config.max_prediction_length))
            temp_df = feature_engineering(df, symbol)

            ts_df = pd.concat([ts_df, temp_df], axis=0, ignore_index=True)

        except Exception as e:

            print(f"Failed to get realtime data from MetaTrader 5: {e} for symbol {symbol}")
            continue
Нам нужен еще один цикл для нескольких символов (мультивалютный режим).
    # ---------- use the model to make predictions ----------

    predictions = model.predict(data=ts_df, mode="prediction")
    predictions = np.array(predictions)
    # print("Predictions: ", predictions)

    forecast_index = -1  # last-step forecast

    for idx, (symbol, m_trade, m_symbol) in enumerate(zip(symbols, m_trades, m_symbols)):

        # get latest symbol info

        if not m_symbol.refresh_rates():
            print(f"failed to refresh rates for symbol {symbol}, Error = {mt5.last_error()}")
            return

        min_lotsize = m_symbol.lots_min()

        ask = m_symbol.ask()
        bid = m_symbol.bid()

        # ------------ Get a corresponding prediction -----------

        predicted_return = predictions[idx][forecast_index]
        price_delta = predicted_return * df["close"].iloc[-1]

        digits = m_symbol.digits()

        # ------------ sl and tp according to model predictions ------------

        if predicted_return > 0:

            tp = round(ask + price_delta, digits)
            sl = round(ask - abs(price_delta), digits)

            if not is_valid_sl_tp(sl=sl, tp=tp, price=ask, m_symbol=m_symbol):
                return

            if not pos_exists(magic_number=m_trade.magic_number, symbol=symbol, pos_type=mt5.POSITION_TYPE_BUY, m_symbol=m_symbol):
                if not m_trade.buy(symbol=symbol, volume=min_lotsize, price=ask, sl=sl, tp=tp):
                    print(f"Buy order failed, Error = {mt5.last_error()} | price= {ask}, sl= {sl}, tp= {tp}")

        else:

            tp = round(bid - abs(price_delta), digits)
            sl = round(bid + abs(price_delta), digits)

            if not is_valid_sl_tp(sl=sl, tp=tp, price=bid, m_symbol=m_symbol):
                return

            if not pos_exists(magic_number=m_trade.magic_number, symbol=symbol, pos_type=mt5.POSITION_TYPE_SELL, m_symbol=m_symbol):
                if not m_trade.sell(symbol=symbol, volume=min_lotsize, price=bid, sl=sl, tp=tp):
                    print(f"Sell order failed, Error = {mt5.last_error()} | price= {bid}, sl= {sl}, tp= {tp}")
Если во время обучения нашей модели было назначено несколько групп, модель для инференса сгенерирует двумерный массив прогнозов с формой (group_ids, predictions).
        predicted_return = predictions[idx][forecast_index]
        price_delta = predicted_return * df["close"].iloc[-1]
Поскольку этот бот теперь мультивалютный, нам приходится обрабатывать классы SymbolInfo и CTrade отдельно для каждого инструмента.
m_trades = [CTrade(mt5_instance=mt5, magic_number=123456, filling_type_symbol=symbol, deviation_points=100) for symbol in symbols]

m_symbols = []
for symbol in symbols:
    s = CSymbolInfo(mt5_instance=mt5)
    s.name(symbol)
    m_symbols.append(s)
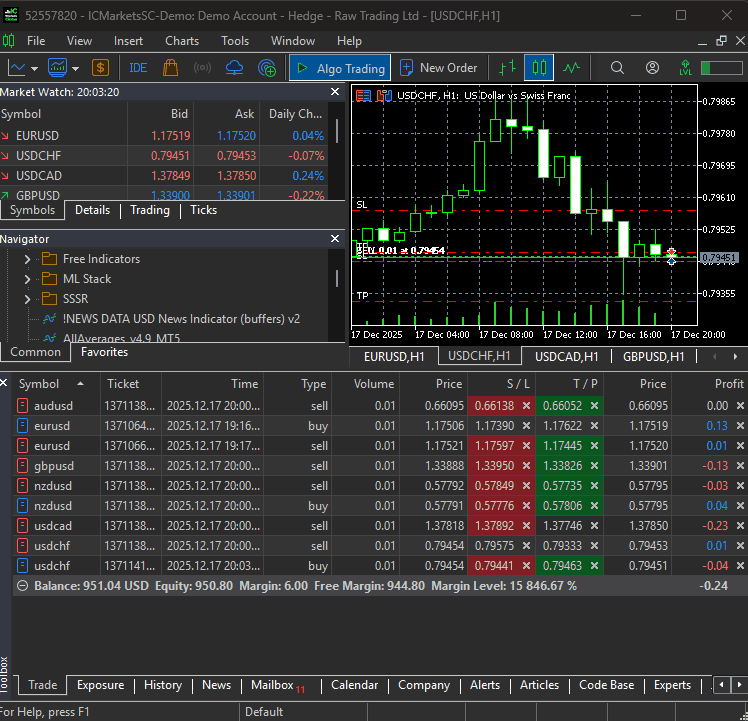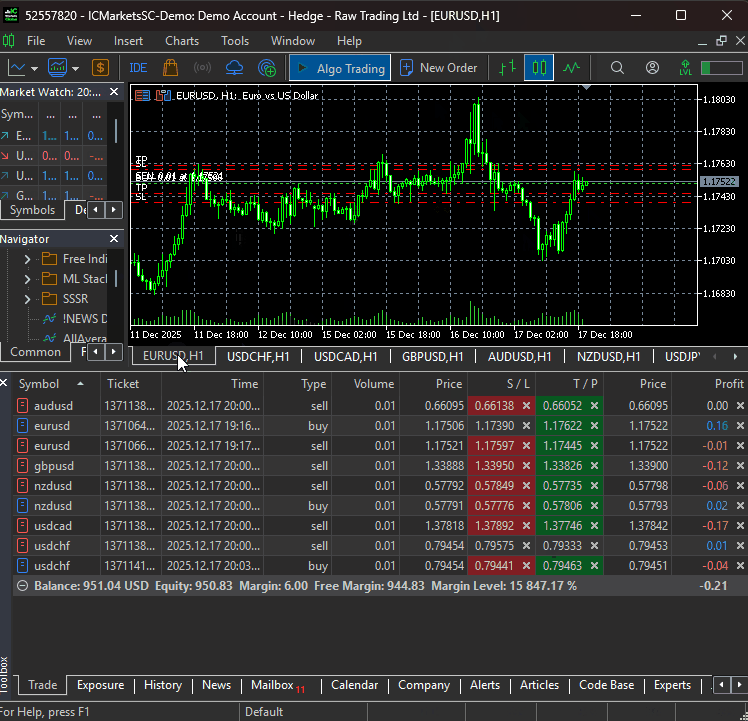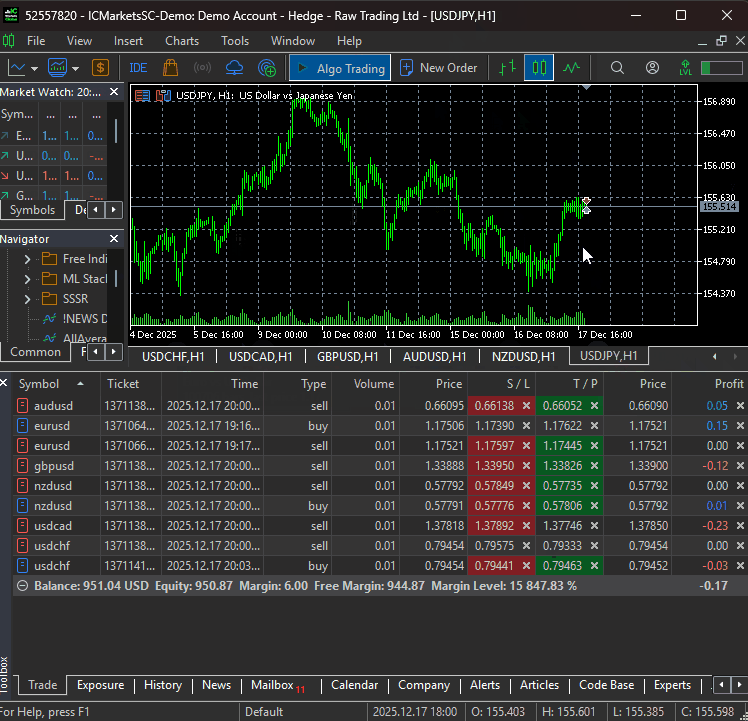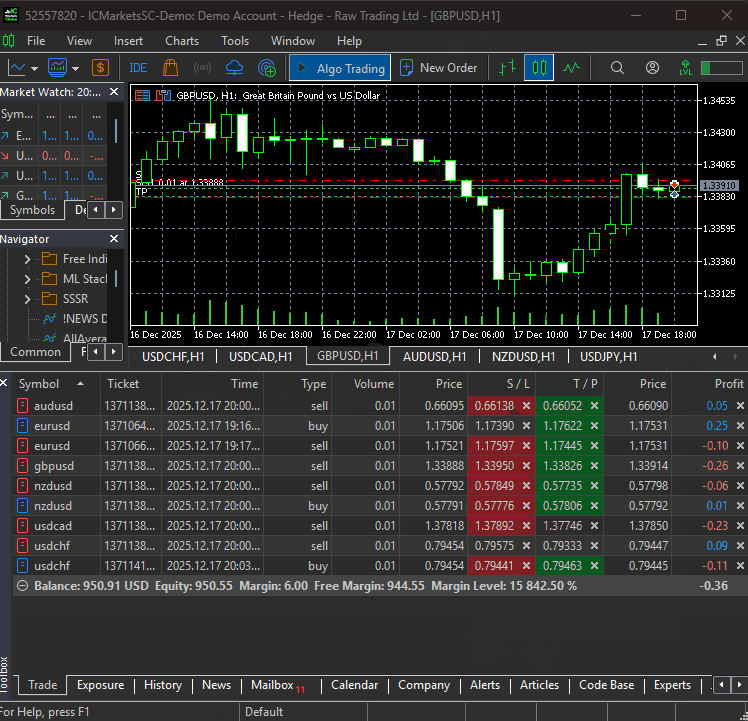
После обучения модели мы должны получить возможность совершать сделки по всем указанным инструментам.
Итоги
Модель DeepAR – хороший выбор для вероятностного прогнозирования временных рядов, однако у нее есть некоторые недостатки, которые необходимо учитывать, включая допущение о том, что будущие значения зависят в основном от прошлых (что не всегда соответствует действительности).
Как и классические модели прогнозирования временных рядов, она зависит от стационарности данных и предполагает, что схожая динамика в данных повторяется с течением времени. Как всем известно, финансовые рынки быстро меняются, и в большинстве случаев о стационарности речи не может быть.
На данный момент нет возможности проверить эффективность данной конкретной модели в реальных торговых условиях; мы можем опираться лишь на графики прогнозов, чтобы оценить, насколько прогнозы модели близки к реальным рыночным значениям.
Всем пока.
Таблица вложений
| Имя файла | Описание и использование |
|---|---|
| main.py | Основной файл на языке Python, предназначенный для объединения всех модулей, обучения моделей машинного обучения и открытия сделок в MetaTrader 5. |
| configs.py | Файл конфигурации на языке Python, в котором содержатся все необходимые переменные. Он предоставляет нашему проекту глобальное пространство для настройки. |
| train.py | Содержит функцию и модули для обучения модели DeepAR. |
| error_description.py | В нем есть функции для преобразования кодов ошибок MetaTrader 5 в понятные человеку сообщения об ошибках. |
| Trade/ | Каталог, аналогичный каталогу MQL5/Include/Trade. В этом каталоге находятся модули Python, аналогичные стандартным библиотекам торговых классов. |
| requirements.txt | Содержит все зависимости Python и их версии, используемые в данном проекте. |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/20571
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.
 База данных — это просто (Часть 1): Легковесный ORM-фреймворк для MQL5 на базе SQLite
 Эволюция городских советов — City Councils Evolution (CCE)
 Машинное обучение и Data Science (Часть 48): Насколько важны трансформеры для трейдинга?
 Нейросети в трейдинге: Адаптация прогноза при смене рыночного режима (Объект верхнего уровня)

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования
Очень интересная статья!
Есть ли у вас какие-нибудь книги, с которыми я мог бы ознакомиться, чтобы глубже изучить эту тему?
Я читал об ARIMA, GARCH и VAR, но не знаю, где можно найти дополнительную информацию об ARIMA и моделях машинного обучения!