Integração do MQL5 com pacotes de processamento de dados (Parte 5): Aprendizado adaptativo e flexibilidade
 14
 0

Introdução
Um dos principais problemas enfrentados por muitos traders algorítmicos é a falta de adaptabilidade dos sistemas de negociação tradicionais. Como discutimos no artigo anterior, a maioria dos EAs é programada com regras rígidas, baseadas em condições e limiares estáticos que muitas vezes não conseguem acompanhar as mudanças na dinâmica do mercado, as variações de volatilidade ou o surgimento de novos padrões ainda não observados, em tempo real. Por isso, esses sistemas tendem a apresentar bons resultados apenas em determinadas condições de mercado, mas perdem eficiência quando o comportamento do mercado muda. Isso pode resultar em oportunidades perdidas, sinais falsos frequentes ou períodos prolongados de drawdown.
O aprendizado adaptativo e a flexibilidade oferecem uma solução para esse problema. Com o Python, podemos construir um modelo de aprendizado por reforço capaz de aprender continuamente com dados históricos do XAUUSD, permitindo que o sistema ajuste sua estratégia conforme as condições de mercado mudam. A flexibilidade das bibliotecas Python, como PyTorch, Gym, Pandas e outras, permite realizar um pré-processamento avançado dos dados, simular o ambiente de negociação e otimizar os modelos. Após o treinamento, o modelo pode ser exportado para o formato ONNX, permitindo sua implantação no ambiente MQL5.
Obtenção de dados históricos
from datetime import datetime
import MetaTrader5 as mt5
import pandas as pd
import pytz

# Display data on the MetaTrader 5 package
print("MetaTrader5 package author: ", mt5.__author__)
print("MetaTrader5 package version: ", mt5.__version__)

# Configure pandas display options
pd.set_option('display.max_columns', 500)
pd.set_option('display.width', 1500)

# Establish connection to MetaTrader 5 terminal
if not mt5.initialize():
    print("initialize() failed, error code =", mt5.last_error())
    quit()

# Set time zone to UTC
timezone = pytz.timezone("Etc/UTC")
# Create 'datetime' objects in UTC time zone to avoid the implementation of a local time zone offset
utc_from = datetime(2025, 05, 15, tzinfo=timezone.utc)
utc_to = datetime.(2025, 07,08, tzinfo=timezone.utc)

# Get bars from XAU H1 (hourly timeframe) within the specified interval
rates = mt5.copy_rates_range("XAUUSD", mt5.TIMEFRAME_H1, utc_from, utc_to)

# Shut down connection to the MetaTrader 5 terminal
mt5.shutdown()

# Check if data was retrieved
if rates is None or len(rates) == 0:
    print("No data retrieved. Please check the symbol or date range.")
else:
    # Display each element of obtained data in a new line (for the first 10 entries)
    print("Display obtained data 'as is'")
    for rate in rates[:10]:
        print(rate)

    # Create DataFrame out of the obtained data
    rates_frame = pd.DataFrame(rates)
    # Convert time in seconds into the 'datetime' format
    rates_frame['time'] = pd.to_datetime(rates_frame['time'], unit='s')

    # Save the data to a CSV file
    filename = "XAU_H1.csv"
    rates_frame.to_csv(filename, index=False)
    print(f"\nData saved to file: {filename}")
Para obter os dados históricos, começamos inicializando a conexão com o terminal MetaTrader 5 por meio da função mt5.initialize(), que permite a comunicação entre o Python e a plataforma MetaTrader 5. Em seguida, definimos o intervalo de datas para consultar os dados, especificando as datas inicial e final. Essas datas são representadas por objetos datetime em UTC, para levar em conta os fusos horários. Neste caso, o script está configurado para obter dados históricos de barras de uma hora do XAUUSD, referentes ao período de 15 de maio de 2025 a 8 de julho de 2025, utilizando a função mt5.copy_rates_range().
filename = "XAUUSD_H1.csv"
rates_frame.to_csv(filename, index=False)
print(f"\nData saved to file: {filename}")
Como você talvez já saiba, eu utilizo Linux. Se você utiliza Windows, pode obter os dados históricos com o seguinte script Python:
from datetime import datetime
import MetaTrader5 as mt5
import pandas as pd
import pytz

# Display data on the MetaTrader 5 package
print("MetaTrader5 package author: ", mt5.__author__)
print("MetaTrader5 package version: ", mt5.__version__)

# Configure pandas display options
pd.set_option('display.max_columns', 500)
pd.set_option('display.width', 1500)

# Establish connection to MetaTrader 5 terminal
if not mt5.initialize():
    print("initialize() failed, error code =", mt5.last_error())
    quit()

# Set time zone to UTC
timezone = pytz.timezone("Etc/UTC")
# Create 'datetime' objects in UTC time zone to avoid the implementation of a local time zone offset
utc_from = datetime(2025, 05, 15, tzinfo=timezone.utc)
utc_to = datetime(2025, 07, 08, tzinfo=timezome.utc)

# Get bars from XAUUSD H1 (hourly timeframe) within the specified interval
rates = mt5.copy_rates_range("XAUUSD", mt5.TIMEFRAME_H1, utc_from, utc_to)

# Shut down connection to the MetaTrader 5 terminal
mt5.shutdown()

# Check if data was retrieved
if rates is None or len(rates) == 0:
    print("No data retrieved. Please check the symbol or date range.")
else:
    # Display each element of obtained data in a new line (for the first 10 entries)
    print("Display obtained data 'as is'")
    for rate in rates[:10]:
        print(rate)

    # Create DataFrame out of the obtained data
    rates_frame = pd.DataFrame(rates)
    # Convert time in seconds into the 'datetime' format
    rates_frame['time'] = pd.to_datetime(rates_frame['time'], unit='s')

    # Display data directly
    print("\nDisplay dataframe with data")
    print(rates_frame.head(10)
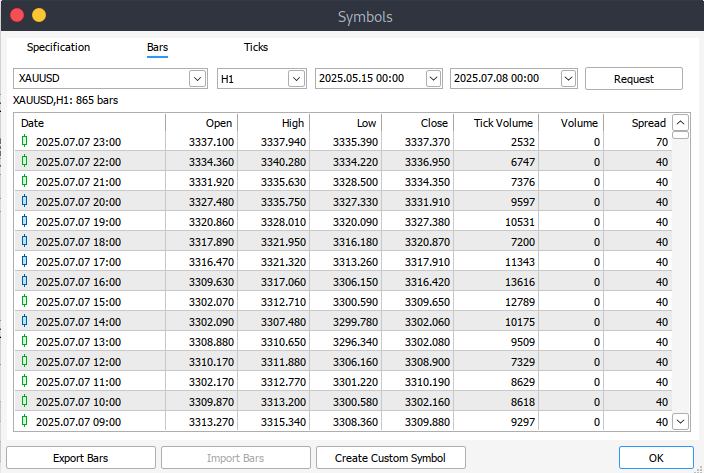
Se, por algum motivo, você não conseguir obter os dados históricos por meio de código, também poderá baixá-los manualmente pela própria plataforma MetaTrader 5. Para isso, abra o terminal, acesse Ferramentas > Opções no menu superior e selecione a aba Gráficos. Nessa aba, é necessário definir a quantidade de barras exibidas no gráfico. Recomenda-se selecionar a opção sem limite de barras (unlimited bars), especialmente porque estamos trabalhando com intervalos de datas e nem sempre é possível prever exatamente quantas barras haverá em determinado timeframe.
Para baixar os dados, acesse Exibir > Símbolos. A janela de símbolos será aberta na aba Especificação. Em seguida, selecione a aba Barras ou Ticks, dependendo do tipo de dado desejado. Defina as datas inicial e final do período e clique no botão "Solicitar". Após o download, você poderá exportar os dados e salvá-los em um arquivo .csv para uso posterior.
Primeiros passos
import pandas as pd

# Load the uploaded BTC 1H CSV file
file_path = '/home/int_j/Documents/Art Draft/Data Science/Adaptive Learning/XAUUSD_H1.csv'
xau_data = pd.read_csv(file_path)

# Display basic information about the dataset
xau_data_info = xau_data.info()
xau_data_head = xau_data.head()

xau_data_info, xau_data_head
Vamos começar analisando o conjunto de dados para entender sua estrutura. Para isso, usamos a função info() para verificar os tipos de dados, as dimensões e a presença de valores ausentes. Também utilizamos head() para exibir as primeiras linhas, que oferecem uma visão geral do conteúdo e da estrutura do conjunto de dados. Essa é uma etapa padrão da análise exploratória de dados (EDA), que permite confirmar se os dados foram carregados corretamente e obter uma visão inicial do formato dos dados.
# Reload the data with tab-separated values
xau_data = pd.read_csv(file_path, delimiter='\t')

# Display basic information and the first few rows after parsing
xau_data_info = xau_data.info()
xau_data_head = xau_data.head()

xau_data_info, xau_data_head
No próximo bloco de código, os dados históricos do XAUUSD são carregados novamente a partir do arquivo especificado, utilizando o caractere de tabulação (\t) como delimitador, em vez da vírgula padrão. Isso é importante para interpretar corretamente arquivos no formato TSV (Tab-Separated Values), nos quais os valores são separados por tabulações. Após o carregamento no DataFrame xau_data, a função info() exibe informações sobre o conjunto de dados, como os tipos das colunas, a quantidade de valores não nulos e o uso de memória. A função head() também é utilizada para exibir as primeiras linhas e permitir uma inspeção rápida dos dados.
import pandas as pd
import numpy as np
import ta
from sklearn.preprocessing import StandardScaler

# Split the single column into proper columns
if len(xau_data.columns) == 1:
    # Extract column headers from the first row
    headers = xau_data.columns[0].split('\t')

    # Split data into separate columns
    xau_data = xau_data[xau_data.columns[0]].str.split('\t', expand=True)
    xau_data.columns = headers

# Convert columns to proper data types
numeric_cols = ['<OPEN>', '<HIGH>', '<LOW>', '<CLOSE>', '<TICKVOL>', '<VOL>', '<SPREAD>']
xau_data[numeric_cols] = xau_data[numeric_cols].apply(pd.to_numeric, errors='coerce')

# Clean and create features
xau_data = xau_data.dropna()
xau_data['return'] = xau_data['<CLOSE>'].pct_change()

# Add technical indicators
xau_data['rsi'] = ta.momentum.RSIIndicator(xau_data['<CLOSE>'], window=14).rsi()
xau_data['macd'] = ta.trend.MACD(xau_data['<CLOSE>']).macd_diff()
xau_data['sma_20'] = ta.trend.SMAIndicator(xau_data['<CLOSE>'], window=20).sma_indicator()
xau_data['sma_50'] = ta.trend.SMAIndicator(xau_data['<CLOSE>'], window=50).sma_indicator()
xau_data = xau_data.dropna()

# Normalize features
scaler = StandardScaler()
features = ['rsi', 'macd', 'sma_20', 'sma_50', 'return']
xau_data[features] = scaler.fit_transform(xau_data[features])
Esse bloco de código realiza a limpeza e a formatação dos dados históricos do XAUUSD. Caso os dados tenham sido importados incorretamente para uma única coluna, o que pode acontecer com arquivos TSV, o script separa o conteúdo dessa coluna pelos caracteres de tabulação, recuperando os nomes das colunas e os respectivos valores. Em seguida, colunas importantes, como open, high, low, close, volume e spread, são convertidas explicitamente para tipos numéricos. O parâmetro errors='coerce' permite tratar eventuais erros de conversão, substituindo os valores inválidos por NaN. Depois, as linhas com valores ausentes são removidas e uma nova coluna é adicionada para registrar o retorno diário, calculada a partir da variação percentual do preço de fechamento.
Na etapa seguinte, o conjunto de dados é enriquecido com indicadores técnicos calculados por meio de uma biblioteca de análise técnica. Entre eles estão o RSI (Índice de Força Relativa), o MACD (Convergência e Divergência de Médias Móveis) e as médias móveis simples de 20 e 50 períodos, calculadas com base no preço de fechamento. Esses atributos são amplamente utilizados no trading algorítmico e ajudam os modelos a identificar tendências e momentum. Por fim, todos os atributos selecionados são padronizados com o StandardScaler da biblioteca scikit-learn, de modo que cada um passe a ter média zero e variância unitária. Essa é uma etapa importante antes de alimentar os modelos de machine learning ou de aprendizado por reforço com os dados.
import gym
from gym import spaces

class TradingEnv(gym.Env):
    def __init__(self, df, window_size=30, initial_balance=10000):
        super(TradingEnv, self).__init__()
        self.df = df.reset_index(drop=True)
        self.window_size = window_size
        self.initial_balance = initial_balance
        self.action_space = spaces.Discrete(3)  # 0: hold, 1: buy, 2: sell

        # Use correct shape (window_size, number of features)
        self.observation_space = spaces.Box(
            low=-np.inf, high=np.inf,
            shape=(self.window_size, len(features)), dtype=np.float32
        )

    def reset(self):
        self.current_step = self.window_size
        self.balance = self.initial_balance
        self.position = 0  # 1 = long, -1 = short, 0 = neutral
        self.entry_price = 0
        self.trades = []
        return self._next_observation()

    def _next_observation(self):
        # Use iloc to prevent overshooting shape
        obs = self.df.iloc[self.current_step - self.window_size : self.current_step]
        obs = obs[features].values
        return obs

    def step(self, action):
        current_price = self.df.loc[self.current_step, '<CLOSE>']
        reward = 0

        if action == 1 and self.position == 0:  # Buy
            self.position = 1
            self.entry_price = current_price
        elif action == 2 and self.position == 0:  # Sell
            self.position = -1
            self.entry_price = current_price
        elif action == 0 and self.position != 0:  # Close position
            if self.position == 1:
                reward = current_price - self.entry_price
            elif self.position == -1:
                reward = self.entry_price - current_price
            self.position = 0

        self.current_step += 1
        done = self.current_step >= len(self.df) - 1
        obs = self._next_observation()
        return obs, reward, done, {}
Como podemos observar no código, é definida uma classe de ambiente personalizada do OpenAI Gym, chamada TradingEnv, destinada a treinar agentes de aprendizado por reforço para tomar decisões de negociação com base em dados financeiros históricos, neste caso, do XAUUSD. O ambiente simula a negociação com três ações discretas: manter a posição (0), comprar (1) e vender (2). Ele é inicializado com uma janela de tamanho fixo de observações anteriores (window_size) e utiliza os atributos dos dados para simular o comportamento de negociação. O espaço de observações consiste em uma janela de valores históricos dos atributos, como RSI e MACD, enquanto o ambiente acompanha parâmetros essenciais, como saldo, estado da posição e preço de entrada.
A função reset() prepara o ambiente para um novo episódio, redefinindo o contador de passos, o saldo, a posição atual e todas as operações abertas. Já a função step() implementa a lógica das ações do agente. Quando o agente escolhe comprar ou vender sem ter uma posição aberta, uma operação é aberta. Se escolher manter uma posição já aberta, ela é encerrada, e o lucro ou prejuízo resultante é calculado como recompensa. O episódio avança pelo conjunto de dados, passo a passo, até chegar ao final (done=True). As observações retornadas correspondem a recortes dos atributos históricos, que o agente utiliza para tomar suas próximas decisões.
import torch.nn as nn
import torch.nn.functional as F

class DuelingDQN(nn.Module):
    def __init__(self, state_shape, action_dim):
        super(DuelingDQN, self).__init__()
        # Calculate flattened dimension
        flattened_dim = np.prod(state_shape)

        # Network layers
        self.fc1 = nn.Linear(flattened_dim, 128)

        # Value stream
        self.value_stream = nn.Sequential(
            nn.Linear(128, 128),
            nn.ReLU(),
            nn.Linear(128, 1)
        )

        # Advantage stream
        self.advantage_stream = nn.Sequential(
            nn.Linear(128, 128),
            nn.ReLU(),
            nn.Linear(128, action_dim)
        )

    def forward(self, state):
        # Flatten state while keeping batch dimension
        x = state.view(state.size(0), -1)
        x = F.relu(self.fc1(x))
        value = self.value_stream(x)
        advantages = self.advantage_stream(x)
        return value + (advantages - advantages.mean(dim=1, keepdim=True))
Em seguida, definimos a arquitetura Dueling Deep Q-Network (Dueling DQN) utilizando PyTorch. Trata-se de uma variação da DQN tradicional, na qual a função de valor do estado e a função de vantagem de cada ação são estimadas separadamente. A classe DuelingDQN herda de nn. Module e recebe como parâmetros o formato do estado de entrada e o número de ações possíveis (action_dim). Primeiro, os dados de entrada são convertidos em um vetor unidimensional e passam por uma camada totalmente conectada compartilhada (fc1). Depois, a rede se divide em dois fluxos: um estima o valor do estado, enquanto o outro calcula a vantagem de cada ação.
No método forward(), os dois fluxos são combinados pela seguinte fórmula:
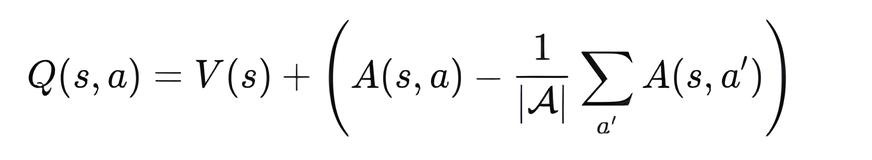
Isso permite que o modelo diferencie o valor do próprio estado (V(s)) da vantagem relativa de cada ação (A(s, a)), melhorando a estabilidade e a eficiência do treinamento em tarefas de aprendizado por reforço, como a negociação no mercado financeiro.
# Training loop parameters
env = TradingEnv(xau_data)

# Use positional arguments instead of keyword arguments
model = DuelingDQN(150, 3)  # input_dim=150 (flattened state), action_dim=3
target_model = DuelingDQN(150, 3)  # Same dimensions
target_model.load_state_dict(model.state_dict())
Resultado:
<All keys matched successfully>
Nesta etapa, inicializamos o ambiente de treinamento e os modelos do agente Dueling DQN. O ambiente TradingEnv é criado a partir do conjunto de dados preparado, xau_data, que fornece os atributos de mercado utilizados no treinamento. São criadas duas instâncias do modelo DuelingDQN: model (rede principal) e target_model (rede-alvo). Ambas possuem uma dimensão de entrada de 150 e um espaço de ações com três possibilidades: comprar, vender e manter a posição. A rede-alvo é inicializada com uma cópia dos pesos da rede principal. Essa é uma prática comum no treinamento de modelos DQN, pois ajuda a estabilizar o aprendizado ao utilizar uma rede-alvo cujos pesos são atualizados lentamente durante o cálculo das diferenças temporais.
class ReplayBuffer:
    def __init__(self, capacity=10000):
        self.buffer = deque(maxlen=capacity)

    def push(self, state, action, reward, next_state, done):
        self.buffer.append((state, action, reward, next_state, done))

    def sample(self, batch_size):
        batch = random.sample(self.buffer, batch_size)
        state, action, reward, next_state, done = map(np.array, zip(*batch))
        return (
            torch.tensor(state, dtype=torch.float32),          # Shape: [batch, state_dim]
            torch.tensor(action, dtype=torch.int64),           # Should be integer (for indexing)
            torch.tensor(reward, dtype=torch.float32),
            torch.tensor(next_state, dtype=torch.float32),
            torch.tensor(done, dtype=torch.float32)
        )

    def __len__(self):
        return len(self.buffer)
A classe ReplayBuffer implementa um buffer de memória utilizado no aprendizado por reforço para armazenar e selecionar experiências anteriores. Ela utiliza a estrutura deque, com capacidade máxima fixa de 10.000 elementos por padrão, permitindo armazenar de forma eficiente tuplas no formato (state, action, reward, next_state, done). O método push() adiciona uma nova experiência ao buffer e remove automaticamente a mais antiga quando a capacidade máxima é excedida.
O método sample() seleciona aleatoriamente um lote de amostras do buffer e as converte em tensores PyTorch adequados ao treinamento do modelo. Durante essa conversão, são utilizados os tipos de dados apropriados para cada elemento, como int64 para as ações e float32 para os estados e as recompensas. Esse mecanismo contribui para a estabilidade do treinamento ao reduzir a correlação entre as amostras utilizadas. Assim, o agente pode aprender com um conjunto diversificado de interações anteriores, em vez de depender apenas de experiências obtidas em passos consecutivos.
env = TradingEnv(xau_data)
obs_shape = env.observation_space.shape
n_actions = env.action_space.n

# Calculate flattened dimension
flattened_dim = np.prod(obs_shape)  # 30*5 = 150

model = DuelingDQN(flattened_dim, n_actions)
target_model = DuelingDQN(flattened_dim, n_actions)
target_model.load_state_dict(model.state_dict())

optimizer = optim.Adam(model.parameters(), lr=0.0005)
buffer = ReplayBuffer()
gamma = 0.99
epsilon = 1.0
batch_size = 64
target_update_interval = 10

all_rewards = []
all_actions = []  # We'll collect actions for the entire dataset

# Training loop
for episode in range(200):
    state = env.reset()
    total_reward = 0
    done = False
    episode_actions = []  # Store actions for this episode

    while not done:
        if random.random() < epsilon:
            action = env.action_space.sample()
        else:
            with torch.no_grad():
                # Flatten state and pass to model
                state_tensor = torch.tensor(state, dtype=torch.float32).flatten().unsqueeze(0)
                q_values = model(state_tensor)
                action = q_values.argmax().item()

        next_state, reward, done, _ = env.step(action)
        buffer.push(state, action, reward, next_state, done)
        state = next_state
        total_reward += reward
        episode_actions.append(action)  # Record action

        if len(buffer) >= batch_size:
            s, a, r, s2, d = buffer.sample(batch_size)

            q_val = model(s).gather(1, a.unsqueeze(1)).squeeze()
            next_q_val = target_model(s2).max(1)[0]
            target = r + (1 - d) * gamma * next_q_val

            loss = nn.MSELoss()(q_val, target)
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()

    epsilon = max(0.01, epsilon * 0.995)
    if episode % target_update_interval == 0:
        target_model.load_state_dict(model.state_dict())
        print(f"Episode {episode}, Reward: {total_reward}")

    # After episode completes
    all_rewards.append(total_reward)
    all_actions.extend(episode_actions)  # Add episode actions to master list
Resultado:
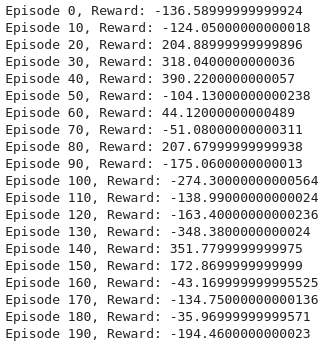
Esse laço de treinamento configura um ambiente de aprendizado por reforço para negociação utilizando a arquitetura Dueling Deep Q-Network (Dueling DQN). Primeiro, o ambiente é inicializado com dados históricos do XAUUSD e, em seguida, os principais parâmetros são extraídos dos espaços de observações e ações. São criadas a rede principal Dueling DQN e a rede-alvo, ambas com dimensão de entrada de 150 (correspondente a 30 passos de tempo × 5 atributos). Também são configurados o otimizador Adam e o buffer de reprodução de experiências (replay buffer), além dos hiperparâmetros: fator de desconto (gamma), taxa de exploração (epsilon), tamanho do lote e frequência de atualização da rede-alvo.
A cada episódio, o ambiente é reinicializado e o agente interage com ele passo a passo, selecionando ações de acordo com a estratégia epsilon-greedy (ε-gulosa). Se um número aleatório for menor que epsilon, o agente escolhe uma ação aleatória. Caso contrário, o modelo seleciona a ação com o maior valor Q previsto. Após executar a ação, o agente recebe uma resposta do ambiente, que é armazenada no buffer de reprodução de experiências. Quando há experiências suficientes no buffer, um lote é selecionado para treinar o modelo. Em seguida, são calculados os valores Q e os valores-alvo, e o erro quadrático médio é utilizado na retropropagação do erro (backpropagation) para atualizar os parâmetros do modelo.
Para estabilizar o treinamento, a rede-alvo recebe periodicamente uma cópia dos pesos da rede principal. O valor de epsilon é reduzido gradualmente, diminuindo a proporção de ações aleatórias e permitindo que o agente se baseie cada vez mais no que aprendeu. Durante o treinamento, são registradas as recompensas acumuladas e as ações de cada episódio para avaliar o desempenho do agente. Ao longo de 200 episódios, esse laço ajuda o agente a desenvolver uma estratégia de negociação otimizada, equilibrando a exploração de novas possibilidades com o aproveitamento dos padrões já aprendidos.
import matplotlib.pyplot as plt

# Plotting performance metrics like cumulative reward
plt.plot([r for r in range(len(buffer.buffer))], label="Reward Trend")
plt.title("Training Rewards")
plt.show()
Resultado:
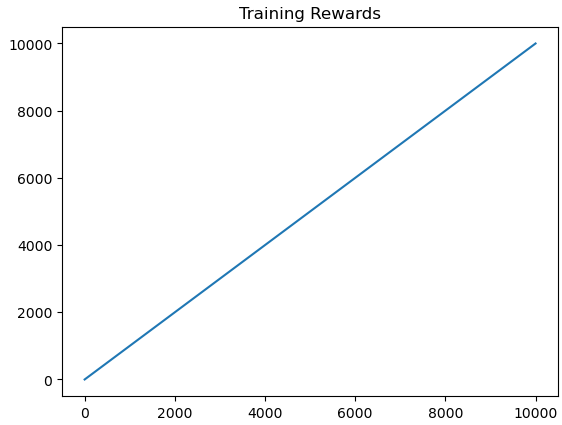
Para visualizar os resultados do treinamento, utilizamos a biblioteca matplotlib e criamos um gráfico da evolução das recompensas com base nos dados armazenados no buffer de reprodução de experiências. Isso permite acompanhar como a recompensa acumulada do agente varia durante o treinamento.
import matplotlib.pyplot as plt

plt.figure(figsize=(12, 6))
plt.plot(all_rewards)
plt.xlabel("Episode")
plt.ylabel("Total Reward")
plt.title("Training Performance")
plt.grid(True)
plt.show()
Resultado:
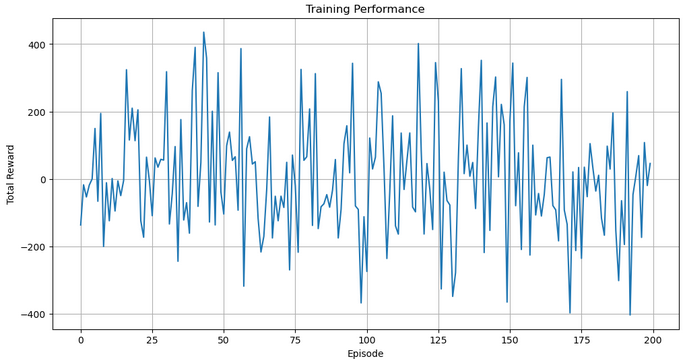
Em seguida, visualizamos o desempenho do agente ao longo dos episódios por meio de um gráfico gerado a partir de all_rewards, que apresenta a recompensa total obtida em cada episódio. Esse gráfico permite acompanhar o progresso do treinamento e a estabilidade do comportamento do agente de negociação ao longo do tempo. Para facilitar a leitura, foram adicionados uma grade e rótulos aos eixos.
# Run a clean evaluation with the trained model (no exploration)
eval_env = TradingEnv(xau_data)
state = eval_env.reset()
eval_actions = []  # Store actions for this single episode

with torch.no_grad():
    while True:
        # Flatten state and predict
        state_tensor = torch.tensor(state, dtype=torch.float32).flatten().unsqueeze(0)
        q_values = model(state_tensor)
        action = q_values.argmax().item()

        next_state, _, done, _ = eval_env.step(action)
        eval_actions.append(action)
        state = next_state

        if done:
            break

# Now plot using eval_actions
close_prices = xau_data['<CLOSE>'].values
window_size = eval_env.observation_space.shape[0]

# Create action array with same length as price data
action_array = np.full(len(close_prices), np.nan)
action_array[window_size:window_size + len(eval_actions)] = eval_actions

# Create plot
plt.figure(figsize=(14, 8))
plt.plot(close_prices, label='XAUUSD Price', alpha=0.7)

# Plot buy signals (action=1)
buy_mask = (action_array == 1)
buy_indices = np.where(buy_mask)[0]
plt.scatter(buy_indices, close_prices[buy_mask],
            color='green', label='Buy', marker='^', s=100)

# Plot sell signals (action=2)
sell_mask = (action_array == 2)
sell_indices = np.where(sell_mask)[0]
plt.scatter(sell_indices, close_prices[sell_mask],
            color='red', label='Sell', marker='v', s=100)

plt.legend()
plt.title("Trading Actions on XAUUSD (Trained Policy)")
plt.xlabel("Time Step")
plt.ylabel("Price")
plt.grid(True)
plt.show()
Resultado:
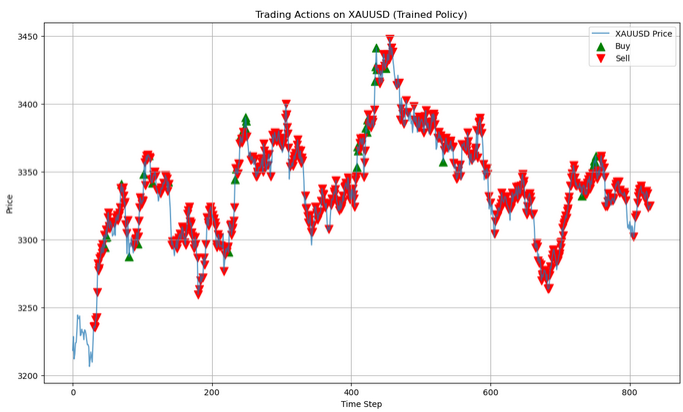
Na etapa de avaliação (evaluation), o modelo treinado é utilizado para tomar decisões em um ambiente preparado para avaliação, sem exploração aleatória (eval_env). O agente observa o estado atual do mercado, seleciona a ação com o maior valor Q (estratégia gulosa) e registra cada decisão tomada. A execução continua até o final do episódio, permitindo avaliar o comportamento do agente sem a influência da aleatoriedade na escolha das ações.
dummy_input = torch.randn(1, *obs_shape)
torch.onnx.export(model, dummy_input, "dueling_dqn_xauusd.onnx",
                  input_names=["input"], output_names=["output"],
                  dynamic_axes={"input": {0: "batch_size"}, "output": {0: "batch_size"}}
Por fim, exportamos o modelo Dueling DQN treinado para o formato ONNX, utilizando um vetor de entrada fictício (dummy input) para garantir a compatibilidade com outras plataformas. Isso permite utilizar o modelo fora do PyTorch, por exemplo, em sistemas que operam em tempo real ou diretamente no ambiente MQL5.
Integrando tudo no MQL5
//+------------------------------------------------------------------+
//|                                  ONNX_DQN_Trading_Script.mq5     |
//|                        Copyright 2023, MetaQuotes Ltd.           |
//|                                             https://www.mql5.com |
//+------------------------------------------------------------------+
#property copyright "Copyright 2023, MetaQuotes Ltd."
#property link      "https://www.mql5.com"
#property version   "1.00"
#property script_show_inputs

//--- input parameters
input string   ModelPath = "dueling_dqn_xauusd.onnx";  // File in MQL5\Files\
input int      WindowSize = 30;                        // Observation window size
input int      FeatureCount = 5;                       // Number of features

//--- ONNX model handle
long onnxHandle;

//--- Normalization parameters (REPLACE WITH YOUR ACTUAL VALUES)
const double   RSI_MEAN = 55.0,       RSI_STD = 15.0;
const double   MACD_MEAN = 0.05,      MACD_STD = 0.5;
const double   SMA20_MEAN = 1800.0,   SMA20_STD = 100.0;
const double   SMA50_MEAN = 1800.0,   SMA50_STD = 100.0;
const double   RETURN_MEAN = 0.0002,  RETURN_STD = 0.01;

//+------------------------------------------------------------------+
//| Script program start function                                    |
//+------------------------------------------------------------------+
void OnStart()
{
   //--- Load ONNX model
   onnxHandle = OnnxCreate(ModelPath, ONNX_DEFAULT);
   if(onnxHandle == INVALID_HANDLE)
   {
      Print("Error loading model: ", GetLastError());
      return;
   }

   //--- Prepare input data buffer
   double inputData[];
   ArrayResize(inputData, WindowSize * FeatureCount);

   //--- Collect and prepare data
   if(!PrepareInputData(inputData))
   {
      Print("Data preparation failed");
      OnnxRelease(onnxHandle);
      return;
   }

   //--- Set input shape (no need to set shape for dynamic axes)
   //--- Run inference
   double outputData[3];
   if(!RunInference(inputData, outputData))
   {
      Print("Inference failed");
      OnnxRelease(onnxHandle);
      return;
   }

   //--- Interpret results
   InterpretResults(outputData);
   OnnxRelease(onnxHandle);
}
//+------------------------------------------------------------------+
//| Prepare input data for the model                                 |
//+------------------------------------------------------------------+
bool PrepareInputData(double &inputData[])
{
   //--- Get closing prices
   double closes[];
   int closeCount = WindowSize + 1;
   if(CopyClose(_Symbol, _Period, 0, closeCount, closes) != closeCount)
   {
      Print("Not enough historical data. Requested: ", closeCount, ", Received: ", ArraySize(closes));
      return false;
   }

   //--- Calculate returns (percentage changes)
   double returns[];
   ArrayResize(returns, WindowSize);
   for(int i = 0; i < WindowSize; i++)
      returns[i] = (closes[i] - closes[i+1]) / closes[i+1];

   //--- Calculate technical indicators
   double rsi[], macd[], sma20[], sma50[];
   if(!CalculateIndicators(rsi, macd, sma20, sma50))
      return false;

   //--- Verify indicator array sizes
   if(ArraySize(rsi) < WindowSize || ArraySize(macd) < WindowSize ||
      ArraySize(sma20) < WindowSize || ArraySize(sma50) < WindowSize)
   {
      Print("Indicator data mismatch");
      return false;
   }

   //--- Normalize features and fill input data
   int dataIndex = 0;
   for(int i = WindowSize - 1; i >= 0; i--)
   {
      inputData[dataIndex++] = (rsi[i] - RSI_MEAN) / RSI_STD;
      inputData[dataIndex++] = (macd[i] - MACD_MEAN) / MACD_STD;
      inputData[dataIndex++] = (sma20[i] - SMA20_MEAN) / SMA20_STD;
      inputData[dataIndex++] = (sma50[i] - SMA50_MEAN) / SMA50_STD;
      inputData[dataIndex++] = (returns[i] - RETURN_MEAN) / RETURN_STD;
   }

   return true;
}
//+------------------------------------------------------------------+
//| Calculate technical indicators                                   |
//+------------------------------------------------------------------+
bool CalculateIndicators(double &rsi[], double &macd[], double &sma20[], double &sma50[])
{
   //--- RSI (14 period)
   int rsiHandle = iRSI(_Symbol, _Period, 14, PRICE_CLOSE);
   if(rsiHandle == INVALID_HANDLE) return false;
   if(CopyBuffer(rsiHandle, 0, 0, WindowSize, rsi) != WindowSize) return false;
   IndicatorRelease(rsiHandle);

   //--- MACD (12,26,9)
   int macdHandle = iMACD(_Symbol, _Period, 12, 26, 9, PRICE_CLOSE);
   if(macdHandle == INVALID_HANDLE) return false;
   double macdSignal[];
   if(CopyBuffer(macdHandle, 0, 0, WindowSize, macd) != WindowSize) return false;
   if(CopyBuffer(macdHandle, 1, 0, WindowSize, macdSignal) != WindowSize) return false;

   // Calculate MACD difference (histogram)
   for(int i = 0; i < WindowSize; i++)
      macd[i] = macd[i] - macdSignal[i];

   IndicatorRelease(macdHandle);

   //--- SMA20
   int sma20Handle = iMA(_Symbol, _Period, 20, 0, MODE_SMA, PRICE_CLOSE);
   if(sma20Handle == INVALID_HANDLE) return false;
   if(CopyBuffer(sma20Handle, 0, 0, WindowSize, sma20) != WindowSize) return false;
   IndicatorRelease(sma20Handle);

   //--- SMA50
   int sma50Handle = iMA(_Symbol, _Period, 50, 0, MODE_SMA, PRICE_CLOSE);
   if(sma50Handle == INVALID_HANDLE) return false;
   if(CopyBuffer(sma50Handle, 0, 0, WindowSize, sma50) != WindowSize) return false;
   IndicatorRelease(sma50Handle);

   return true;
}
//+------------------------------------------------------------------+
//| Run model inference                                              |
//+------------------------------------------------------------------+
bool RunInference(const double &inputData[], double &outputData[])
{
   //--- Run model directly without setting shape (for dynamic axes)
   if(!OnnxRun(onnxHandle, ONNX_DEBUG_LOGS, inputData, outputData))
   {
      Print("Model inference failed: ", GetLastError());
      return false;
   }
   return true;
}
//+------------------------------------------------------------------+
//| Interpret model results                                          |
//+------------------------------------------------------------------+
void InterpretResults(const double &outputData[])
{
   //--- Find best action
   int bestAction = ArrayMaximum(outputData);
   string actionText = "";

   switch(bestAction)
   {
      case 0: actionText = "HOLD"; break;
      case 1: actionText = "BUY"; break;
      case 2: actionText = "SELL"; break;
   }

   //--- Print results
   Print("Model Output: [HOLD: ", outputData[0], ", BUY: ", outputData[1], ", SELL: ", outputData[2], "]");
   Print("Recommended Action: ", actionText);
}
O script MQL5 ONNX_DQN_Trading_Script.mq5 foi desenvolvido para executar o modelo Dueling DQN treinado e exportado no formato ONNX, com o objetivo de gerar sinais de negociação no MetaTrader 5. Primeiro, o modelo ONNX é carregado do diretório Files e os dados de entrada são preparados com base em uma janela de observações de tamanho fixo. O script coleta os dados de preços mais recentes e calcula os indicadores técnicos RSI, histograma do MACD, SMA20 e SMA50, além dos retornos. Em seguida, esses valores são normalizados com base em médias e desvios-padrão predefinidos. Os atributos processados são então convertidos em um array unidimensional compatível com o formato de entrada esperado pelo modelo.
Com o vetor de entrada preparado, o script executa a inferência com OnnxRun e obtém, no array de saída, três valores Q previstos, correspondentes às ações HOLD, BUY e SELL. A ação com o maior valor Q é interpretada como a recomendação do modelo e exibida no terminal. Durante a inferência, são realizadas verificações de erros para aumentar a confiabilidade da execução, e os recursos utilizados são liberados ao final das operações.
Conclusão
Ao longo deste artigo, desenvolvemos um modelo de negociação adaptativo e flexível, baseado na arquitetura Dueling DQN e treinado com dados históricos do XAUUSD. O modelo utiliza uma janela deslizante de atributos técnicos, incluindo RSI, histograma do MACD, SMA20, SMA50 e retornos percentuais, normalizados com base em parâmetros estatísticos. Também visualizamos a evolução das recompensas acumuladas durante o treinamento para acompanhar a estabilidade do aprendizado. Após o treinamento, exportamos o modelo para o formato ONNX, permitindo sua integração com o MetaTrader 5. Na plataforma, um script MQL5 específico carrega o modelo, prepara dinamicamente os dados de entrada, executa a inferência e identifica a ação recomendada (HOLD, BUY ou SELL) com base no maior valor Q previsto.
Esse pipeline completo (end-to-end) oferece aos traders um sistema automatizado de apoio à tomada de decisões, combinando aprendizado por reforço profundo com dados de mercado em tempo real. Sua flexibilidade permite adaptá-lo a novos instrumentos financeiros ou conjuntos de indicadores por meio de alterações nos atributos de entrada e de um novo treinamento do modelo. Com a integração da inferência ONNX diretamente ao MQL5, os traders podem utilizar modelos inteligentes na própria plataforma de negociação, aumentando a eficiência na execução de suas estratégias e a capacidade de resposta às mudanças do mercado, sem depender de software externo para executar o modelo.
| Nome do arquivo | Descrição |
|---|---|
| Ada_flex.mq5 | Arquivo que contém o script MQL5 para utilizar o modelo de aprendizado por reforço treinado em Python. |
| Ada_L.ipynb | Arquivo que contém o notebook para treinamento e salvamento do modelo. |
| XAUUSD_H1.csv | Arquivo com dados históricos de preços do XAUUSD. |
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/18761
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.