

Desarrollo de asesores expertos autooptimizables en MQL5 (Parte 12): Construcción de clasificadores lineales mediante factorización matricial
 35
 0

La factorización matricial es una herramienta importante para los operadores algorítmicos interesados en desarrollar aplicaciones guiadas por métodos numéricos. Estas herramientas pueden ayudarnos a construir diversos tipos de algoritmos de aprendizaje automático, y mucho más. Hasta ahora, en nuestra discusión, solo hemos considerado tareas de regresión. Centrémonos ahora en el problema de la clasificación. Hoy abordaremos el reto de construir un clasificador de mercado. Este clasificador podrá distinguir entre movimientos alcistas y bajistas en el mercado. Queremos que nos ayude a realizar nuestras operaciones correctamente. La tarea del clasificador consiste en aprender de las observaciones históricas del comportamiento del mercado e inferir la acción correcta que debemos tomar en un día de trading determinado.
Nuestra estrategia de trading funciona como se describe a continuación. El objetivo es anticipar los movimientos del mercado basándose en el comportamiento esperado del indicador de media móvil. Además, queremos que el precio evolucione en consonancia con la media móvil. Es decir, si nuestro modelo de clasificación prevé que la media móvil baje, también queremos observar que los niveles de precios caigan por debajo del indicador. Si prevemos que tanto la media móvil como el precio bajarán, abriremos posiciones de venta. La media móvil indica la dirección del precio, pero también queremos que los precios aceleren a la baja y se sitúen claramente por debajo del indicador antes de abrir posiciones de venta.
La misma lógica se aplica a las posiciones largas. Queremos anticipar que la media móvil subirá, y los niveles de precios deberían acelerarse muy por encima de ella para que podamos entrar en una señal clara de compra.
A partir de esta descripción, observará que nuestro modelo predecirá dos resultados categóricos al mismo tiempo. Sin embargo, esto no debe confundirse con un modelo de clasificación multiclase. Cada una de las dos variables que predice nuestro modelo es un resultado binario. En otras palabras, el modelo registra dos resultados binarios distintos. La arquitectura que describiremos aquí no es adecuada para clasificar más de dos clases a la vez.
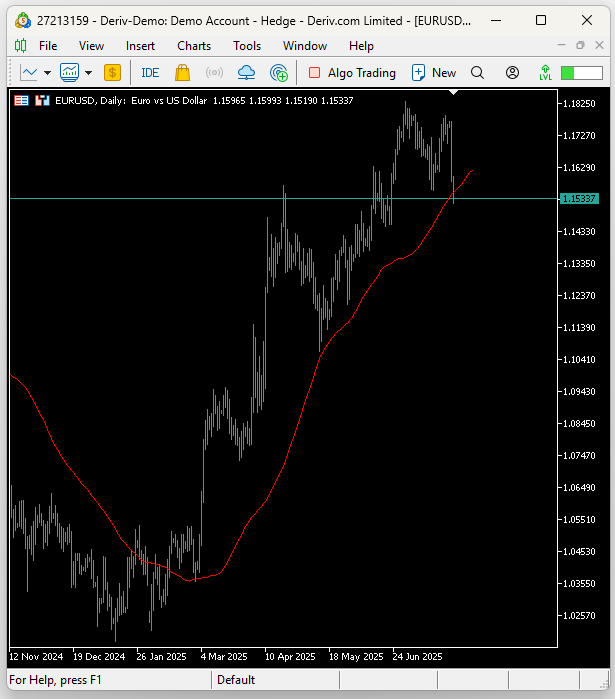
Figura 1: Visualización de nuestra estrategia de trading en funcionamiento.
Factorización matricial para la construcción de clasificadores lineales
Como en la mayoría de nuestras aplicaciones de trading, comenzaremos definiendo los parámetros del sistema. En este caso particular, vamos a tener seis entradas que vamos a registrar en nuestra matriz de datos de entrada X.
//+------------------------------------------------------------------+
//|                                            Linear Regression.mq5 |
//|                                               Gamuchirai Ndawana |
//|                    https://www.mql5.com/en/users/gamuchiraindawa |
//+------------------------------------------------------------------+
#property copyright "Gamuchirai Ndawana"
#property link      "https://www.mql5.com/en/users/gamuchiraindawa"
#property version   "1.00"
//+------------------------------------------------------------------+
//| System constants                                                 |
//+------------------------------------------------------------------+
#define TOTAL_INPUTS 6
A continuación, tras definir las definiciones del sistema, definimos los parámetros configurables por el usuario. En concreto, queremos que nuestro usuario final pueda elegir el plazo adecuado y el tamaño de nuestro stop loss.
//+------------------------------------------------------------------+
//| System Inputs                                                    |
//+------------------------------------------------------------------+
int bars = 200;//Number of historical bars to fetch
int horizon = 1;//How far into the future should we forecast
int MA_PERIOD = 50; //Moving average period
ENUM_TIMEFRAMES TIME_FRAME = PERIOD_D1;//User Time Frame
input ENUM_TIMEFRAMES RISK_TIME_FRAME = PERIOD_D1;
input double sl_size = 2;
Además, también debemos incluir bibliotecas importantes del sistema que necesitamos, como la biblioteca de operaciones y dos bibliotecas personalizadas que he escrito para llevar un registro del tiempo y obtener información importante sobre las operaciones.
//+------------------------------------------------------------------+
//| Dependencies                                                     |
//+------------------------------------------------------------------+
#include <Trade\Trade.mqh>
#include <VolatilityDoctor\Time\Time.mqh>
#include <VolatilityDoctor\Trade\TradeInfo.mqh>
Continuando, nuestro sistema también depende de nosotros para crear variables globales importantes para nuestro ejercicio. En este caso concreto, necesitamos variables globales que actúen como manejadores para nuestros indicadores técnicos. Necesitamos variables globales para realizar un seguimiento de los datos de entrada y de los datos de salida a medida que los recibimos del mercado. Además, necesitamos búferes para que nuestros indicadores técnicos recuperen sus valores actuales.
//+------------------------------------------------------------------+
//| Global Variables                                                 |
//+------------------------------------------------------------------+
int        ma_close_handler;
double     ma_close[];
Time       *Timer;
TradeInfo  *TradeInformation;
vector     bias,temp,Z1,Z2;
matrix     X,y,prediction,b;
int        time;
CTrade Trade;
int state;
int atr_handler;
double atr[];
Cuando nuestro sistema se cargue por primera vez, tendremos un método específico llamado initialize que se llamará para inicializar todas las variables del sistema.
//+------------------------------------------------------------------+
//| Expert initialization function                                   |
//+------------------------------------------------------------------+
int OnInit()
  {
//---
   initialize();
//---
   return(INIT_SUCCEEDED);
  }
Cuando nuestro sistema deje de utilizarse, liberaremos la memoria que estaba siendo consumida por los indicadores técnicos.
//+------------------------------------------------------------------+
//| Expert deinitialization function                                 |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
  {
//---
   IndicatorRelease(atr_handler);
   IndicatorRelease(ma_close_handler);
  }
Cuando se formen nuevas velas de precios actualizadas, utilizaremos dos métodos específicos. El primer método es el método setup, y la segunda es la función findSetup. Analizaremos estos temas en detalle más adelante, a medida que avancemos.
//+------------------------------------------------------------------+
//| Expert tick function                                             |
//+------------------------------------------------------------------+
void OnTick()
  {
//---
   if(Timer.NewCandle())
     {
      setup();
      find_setup();
     }
  }
Cuando nuestro sistema se inicializa por primera vez, cargaremos nuevas instancias de manejadores con sus identificadores correspondientes. Así, por ejemplo, crearemos dinámicamente un nuevo objeto para nuestra biblioteca de tiempo que registre la formación de las velas. También creamos un nuevo objeto para nuestra clase de información operativa. Recuerda que esta clase se encarga de registrar detalles importantes, como el volumen mínimo de lote permitido en el mercado actual para operar, y los precios de compra y venta actuales. Además, la función de inicialización se encarga de cargar todos los valores predeterminados en nuestras matrices y sus identificadores asociados.
//+------------------------------------------------------------------+
//| Initialize our system variables                                  |
//+------------------------------------------------------------------+
void initialize(void)
  {
   Timer                   = new Time(Symbol(),TIME_FRAME);
   TradeInformation        = new TradeInfo(Symbol(),TIME_FRAME);
   ma_close_handler        = iMA(Symbol(),TIME_FRAME,MA_PERIOD,0,MODE_SMA,PRICE_CLOSE);
   atr_handler             = iATR(Symbol(),RISK_TIME_FRAME,14);
   bias = vector::Ones(TOTAL_INPUTS);
   Z1 = vector::Ones(TOTAL_INPUTS);
   Z2 = vector::Ones(TOTAL_INPUTS);
   X = matrix::Ones(TOTAL_INPUTS,bars);
   y = matrix::Ones(1,bars);
   time = 0;
   state = 0;
  }
La función "find_setup()" es bastante más compleja que las demás funciones que hemos considerado hasta ahora. En primer lugar, la función findSetup realizará un seguimiento del precio de cierre actual y, a continuación, copiaremos la lectura actual de nuestros indicadores. Por lo tanto, copiaremos las lecturas del ATR y de media móvil en sus respectivos búferes. A partir de ahí, si no tenemos posiciones abiertas, reiniciamos el estado del sistema. Ahora debemos considerar la predicción que recibimos de nuestro clasificador lineal.
Recordemos que nuestro clasificador está modelando dos salidas al mismo tiempo. La primera predicción es la dirección que se espera que siga el indicador de media móvil en el futuro, mientras que la segunda predicción será la diferencia entre el precio y la media móvil. Por lo tanto, queremos que estas dos predicciones coincidan entre sí. Si se prevé que el indicador de media móvil baje, también queremos ver que los niveles de precios caigan aún más por debajo de él. Y si se prevé que la media móvil suba, queremos que los niveles de precios la superen.
Estos dos parámetros constituyen la base de nuestra estrategia de trading. Ambas predicciones deben ser superiores a 0,5 para que decidamos comprar. Además, ambas predicciones deberían ser inferiores a 0,5 para que podamos vender. De lo contrario, si ya tenemos posiciones abiertas, simplemente haremos un seguimiento de nuestra posición y de las expectativas de nuestro clasificador lineal. Si estamos vendiendo, pero nuestro modelo prevé que el indicador de media móvil suba, entonces cerraremos nuestra posición. Y lo contrario también es cierto si estamos comprando.
De lo contrario, si todo parece estar bien, simplemente actualizaremos nuestro stop loss a un nivel más rentable y continuaremos desde ahí.
//+------------------------------------------------------------------+
//| Find a trading setup for our linear classifier model             |
//+------------------------------------------------------------------+
void find_setup(void)
  {
   double c =  iClose(Symbol(),TIME_FRAME,0);
   CopyBuffer(atr_handler,0,0,1,atr);
   CopyBuffer(ma_close_handler,0,0,1,ma_close);

   if(PositionsTotal() == 0)
     {
      state = 0;
      if((prediction[0,0] > 0.5) && (prediction[1,0] > 0.5))
        {
         Trade.Buy(TradeInformation.MinVolume(),Symbol(),TradeInformation.GetAsk(),(TradeInformation.GetBid() - (sl_size * atr[0])),0);
         state = 1;
        }
      if((prediction[0,0] < 0.5) && (prediction[1,0] < 0.5))
        {
         Trade.Sell(TradeInformation.MinVolume(),Symbol(),TradeInformation.GetBid(),(TradeInformation.GetAsk() + (sl_size * atr[0])),0);
         state = -1;
        }
     }

   if(PositionsTotal() > 0)
     {
      if(((state == -1) && (prediction[0,0] > 0.5)) || ((state == 1)&&(prediction[0,0] < 0.5)))
         Trade.PositionClose(Symbol());
      if(PositionSelect(Symbol()))
        {
         double current_sl = PositionGetDouble(POSITION_SL);

         if((state == 1) && ((ma_close[0] - (2 * atr[0]))>current_sl))
           {
            Trade.PositionModify(Symbol(),(ma_close[0] - (2 * atr[0])),0);
           }

         else
            if((state == -1) && ((ma_close[0] + (2 * atr[0]))<current_sl))
              {
               Trade.PositionModify(Symbol(),(ma_close[0] + (2 * atr[0])),0);
              }
        }
     }
  }
Contamos con métodos específicos que utilizamos para ajustar nuestro clasificador lineal. El método de ajuste, como se muestra a continuación, ajustará nuestros datos, mapeando las entradas de precios anteriores a los dos objetivos que nos interesa seguir. Recordemos que utilizamos el método de descomposición en valores singulares (SVD) de la biblioteca OpenBLAS para factorizar rápidamente nuestro modelo en un formato que nos permita encontrar los coeficientes óptimos y almacenarlos en B.
//+------------------------------------------------------------------+
//| Fir our classification model                                     |
//+------------------------------------------------------------------+
void fit(void)
  {
//--- Fit the model
   matrix OB_U,OB_VT,OB_SIGMA;
   vector OB_S;
   X.SingularValueDecompositionDC(SVDZ_S,OB_S,OB_U,OB_VT);
   OB_SIGMA.Diag(OB_S);
   b = y.MatMul(OB_VT.Transpose().MatMul(OB_SIGMA.Inv()).MatMul(OB_U.Transpose()));
  }
Como siempre, la obtención y el almacenamiento de datos son una parte importante de cualquier modelo de aprendizaje automático. Restaremos el valor medio y dividiremos por la desviación estándar para cada uno de nuestros datos.
Por ejemplo, queremos hacer un seguimiento del precio de apertura, el precio máximo, el precio mínimo y los valores de los indicadores técnicos. Todos estos valores deben ser restados por la media y divididos por la desviación estándar antes de ser almacenados en la matriz de datos X.
Posteriormente, tras copiar y reformatear nuestra matriz Y, debemos almacenar nuestros resultados como ceros (para indicar que los niveles de precios bajaron) o como unos (para indicar que los niveles de precios subieron). Así es como construimos un modelo de clasificación.
//+------------------------------------------------------------------+
//| Prepare the data needed for our classifier                       |
//+------------------------------------------------------------------+
void fetch_data(void)
  {
//--- Reshape the matrix
   X = matrix::Ones(TOTAL_INPUTS,bars);

//--- Store the Z-scores
   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_OPEN,horizon,bars);
   Z1[0] = temp.Mean();
   Z2[0] = temp.Std();
   temp = ((temp - Z1[0]) / Z2[0]);
   X.Row(temp,1);

//--- Store the Z-scores
   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_HIGH,horizon,bars);
   Z1[1] = temp.Mean();
   Z2[1] = temp.Std();
   temp = ((temp - Z1[1]) / Z2[1]);
   X.Row(temp,2);

//--- Store the Z-scores
   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_LOW,horizon,bars);
   Z1[2] = temp.Mean();
   Z2[2] = temp.Std();
   temp = ((temp - Z1[2]) / Z2[2]);
   X.Row(temp,3);

//--- Store the Z-scores
   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_CLOSE,horizon,bars);
   Z1[3] = temp.Mean();
   Z2[3] = temp.Std();
   temp = ((temp - Z1[3]) / Z2[3]);
   X.Row(temp,4);

//--- Store the Z-scores
   temp.CopyIndicatorBuffer(ma_close_handler,0,horizon,bars);
   Z1[4] = temp.Mean();
   Z2[4] = temp.Std();
   temp = ((temp - Z1[4]) / Z2[4]);
   X.Row(temp,5);

//--- Reshape the output target
   y.Reshape(2,bars);
   vector temp_2,temp_3,temp_4;

//--- Prepare to label the target accordingly
   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_CLOSE,horizon,bars);
   temp_4.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_CLOSE,0,bars);

   temp_2.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_CLOSE,0,bars);
   temp_3.CopyIndicatorBuffer(ma_close_handler,0,0,bars);

   for(int i=0;i<bars;i++)
     {
      //--- Record if price levels appreciated or depreciated
      if(temp[i] > temp_4[i])
         y[0,i] = 0;
      else
         if(temp[i] < temp_4[i])
            y[0,i] = 1;

      //--- Record if price levels remained above the moving average indicator, or fell beneath it.
      if(temp_2[i] < temp_3[i])
         y[1,i] = 0;
      if(temp_2[i] > temp_3[i])
         y[1,i] = 1;
     }

   Print("Training Input Data: ");
   Print(X);

   Print("Training Target");
   Print(y);
  }
A partir de ese momento, ya estamos preparados para empezar a obtener predicciones de nuestro modelo de clasificación. Para obtener una predicción de nuestro modelo de clasificación, necesitamos la última fila de nuestros datos de entrada X. También podemos considerarla como la lectura actual del mercado: las condiciones actuales del mercado. Tomamos las condiciones actuales del mercado y las multiplicamos por los coeficientes que hemos aprendido de los datos históricos, y eso nos dará una predicción.
//+------------------------------------------------------------------+
//| Obtain a prediction from our classification model                |
//+------------------------------------------------------------------+
void predict(void)
  {
//--- Prepare to get a prediction
//--- Reshape the data
   X = matrix::Ones(TOTAL_INPUTS,1);

//--- Get a prediction
   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_OPEN,0,1);
   temp = ((temp - Z1[0]) / Z2[0]);
   X.Row(temp,1);

   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_HIGH,0,1);
   temp = ((temp - Z1[1]) / Z2[1]);
   X.Row(temp,2);

   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_LOW,0,1);
   temp = ((temp - Z1[2]) / Z2[2]);
   X.Row(temp,3);

   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_CLOSE,0,1);
   temp = ((temp - Z1[3]) / Z2[3]);
   X.Row(temp,4);

   temp.CopyIndicatorBuffer(ma_close_handler,0,0,1);
   temp = ((temp - Z1[4]) / Z2[4]);
   X.Row(temp,5);

   Print("Prediction Inputs: ");
   Print(X);

//--- Get a prediction
   prediction = b.MatMul(X);
   Print("Prediction");
   Print(prediction);
  }
Sin embargo, llamar a cada uno de estos métodos uno por uno puede resultar engorroso. Por lo tanto, hemos diseñado un método de configuración específico que llamará a cada uno de estos tres métodos en el orden en que los necesitamos. Primero, vamos a obtener los datos. Luego ajustaremos nuestro modelo a los datos. Y por último, obtendremos una predicción.
Este sencillo método de configuración nos permite realizar los tres pasos, siempre en el orden correcto.
//+------------------------------------------------------------------+
//| Obtain a prediction from our model                               |
//+------------------------------------------------------------------+
void setup(void)
  {
   fetch_data();
   fit();
   predict();
  }
//+------------------------------------------------------------------+
Por último, debemos anular la definición del sistema que hicimos al inicio de la aplicación.
#undef TOTAL_INPUTS Nuestras pruebas retrospectivas comenzarán en enero de 2020 y se extenderán durante cinco años en un marco temporal diario, hasta 2025. Probaremos nuestra aplicación con el símbolo EURUSD.
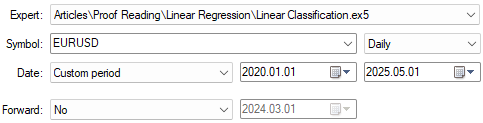
Figura 2: Selección de nuestros días de backtesting y optimización.
Además, para obtener la mejor configuración posible, siempre utilizamos ajustes de retardo aleatorios para garantizar que las condiciones en las que probamos nuestra aplicación coincidan con los entornos de mercado reales que esperamos encontrar en el futuro.
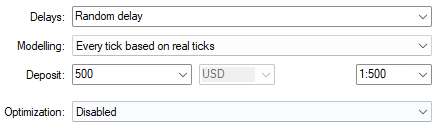
Figura 3: Seleccionar nuestras condiciones de backtesting también es importante.
Hice una captura de pantalla del rendimiento de nuestra aplicación durante el backtest. Como podemos ver, la aplicación nos muestra los datos de predicción que se le proporcionaron. Recuerde que la primera entrada siempre es 1 y representa el término independiente (bias). Pero en realidad, nuestra atención se centra principalmente en las predicciones que proporciona nuestro modelo.
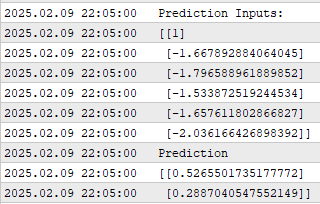
Figura 4: El resultado obtenido al ejecutar nuestro algoritmo clasificador lineal.
Como podemos ver, nuestro modelo nos da dos predicciones, como ya hemos dicho. La primera predicción está relacionada con el cambio en la posición de la media móvil en el futuro, mientras que la segunda predicción está relacionada con la diferencia entre el precio y la media móvil. Y recordemos que queremos que ambos cambios se produzcan en una misma dirección.
También podemos observar la curva de capital generada por nuestra estrategia de trading. Como podemos observar, la curva de capital presenta una tendencia ascendente a lo largo del tiempo, aunque no es del todo estable.
Además, el lector debe tener en cuenta que en esta curva se ilustran dos líneas. La línea azul representa nuestro saldo a lo largo del tiempo, y la línea verde representa el capital acumulado en la cuenta a lo largo del tiempo. Como podemos ver, hay muchos casos en los que observamos que la equidad —la línea verde— se dispara por encima de la línea azul.
Desde mi experiencia como autor, esto representa ganancias perdidas o señales en nuestra estrategia de trading que aún no hemos logrado detectar. Esta señal está escapando a nuestra estrategia de trading y no estamos aprovechando esas ganancias. Esto sugiere que aún hay margen de mejora en nuestra estrategia.
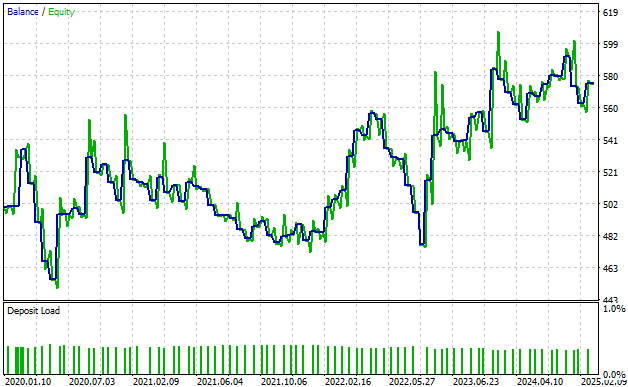
Figura 5: Nuestra curva de equidad nos está indicando que todavía hay alguna señal que no estamos aprendiendo.
Por último, podemos considerar las estadísticas detalladas de nuestro desempeño a lo largo del tiempo. Y como podemos ver, en promedio, nuestra operación rentable promedio es mayor que nuestra operación perdedora promedio. El mayor beneficio que obtuvimos siguiendo nuestra estrategia también es mayor que la mayor pérdida que sufrimos, lo cual es alentador.
Sin embargo, cuando observamos el porcentaje de operaciones rentables, vemos que tenemos un 43% de operaciones rentables, lo que es menos de la mitad. Esto refuerza lo que señalé al lector cuando analizamos la curva de capital y vimos esos picos de ganancias no aprovechadas que nuestro sistema no logró detectar.
Esto no hace más que reforzar nuestra convicción de que el sistema puede mejorarse aún más, de que todavía hay información que no estamos captando. Si bien este es un buen comienzo, todavía hay más señal que podemos detectar y aprender a explotar.
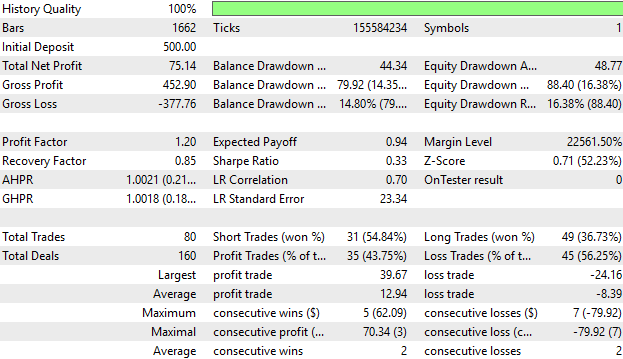
Figura 6: Las estadísticas detalladas de nuestro rendimiento respaldan nuestras deducciones anteriores de que el sistema tiene margen de mejora.
Conclusión
En conclusión, este artículo ha demostrado al lector las múltiples aplicaciones de la factorización matricial que nosotros, como operadores algorítmicos, podemos aprovechar en nuestras aplicaciones MQL5. Cuando mencionamos por primera vez la factorización matricial, la consideramos una herramienta que puede utilizarse para la regresión. Ahora lo consideramos una herramienta que puede utilizarse para la clasificación.
Pero solo le hago una promesa al lector: que aún nos queda mucho por cubrir. Esto es solo lo básico. En mi opinión, como autor, estas son las aplicaciones más sencillas que nos muestran rápidamente el valor de la factorización matricial. Si has estado siguiendo esta serie de artículos, ahora sabrás cómo construir un modelo de regresión utilizando la factorización matricial, o un modelo clasificador, o una combinación de ambos; modelos que no se limitan a una sola predicción a la vez, sino que pueden predecir múltiples objetivos simultáneamente.
Y aun así, le prometo al lector que todavía hay muchos más beneficios de la factorización matricial que aún no hemos abordado. Pero antes de poder empezar a explorar esos beneficios, primero debemos dominar lo básico. Además, ya habrás visto lo fácil que es, gracias a las funciones específicas que tenemos a nuestra disposición en la API MQL5. Ya ha podido comprobar lo fácil que resulta incorporar estos potentes métodos matriciales a sus aplicaciones de trading.
Traducción del inglés realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/en/articles/18987
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Del nivel básico al intermedio: Archivo de plantilla (III)
 Del nivel básico al intermedio: Archivo de plantilla (II)
 Red neuronal en la práctica: Lectura de PNG del MNIST
 Red neuronal en la práctica: Retropropagación manual

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso