
Recursos do Assistente MQL5 que você precisa conhecer (Parte 70): Uso dos padrões SAR e RVI com uma rede neural cujos kernels crescem exponencialmente
 22
 0

Introdução
No artigo anterior, apresentamos dois indicadores complementares: o Parabolic SAR e o oscilador Índice de Vigor Relativo (Relative Vigor Index, RVI). Dos 10 padrões avaliados, três não passaram no teste forward: os padrões 1, 2 e 6. Como os padrões são indexados de 0 a 9, podemos calcular facilmente o valor da máscara de bits utilizado pelo parâmetro PatternsUsed para definir quais padrões serão habilitados no EA. Por exemplo, para habilitar o padrão de índice 1, precisamos atribuir ao parâmetro PatternsUsed o valor 2, correspondente a 2 elevado à potência 1.
Para o índice 2, calculamos 2 elevado à potência 2, obtendo 4, e assim por diante. O valor máximo permitido para esse parâmetro é 1023, pois temos apenas 10 padrões. O valor 0 não habilita nenhum padrão, as potências de 2 habilitam um único padrão e os demais valores entre 1 e 1023 representam combinações de padrões. O leitor pode explorar a possibilidade de configurar o EA para utilizar vários deles simultaneamente. No entanto, com base nos argumentos e resultados apresentados nos artigos anteriores, decidimos deixar essa possibilidade fora do escopo desta série por enquanto.
Conforme prometido em um dos artigos recentes, tentaremos agora utilizar aprendizado supervisionado para "reabilitar" os padrões de sinal 1, 2 e 6, que não passaram no teste forward do artigo anterior. Para aplicar machine learning aos sinais gerados por esses indicadores no MQL5, utilizaremos Python para implementar e treinar o modelo de rede neural, aproveitando a eficiência dessa abordagem mesmo sem uma GPU. Para isso, recorremos ao módulo Python do MetaTrader, que permite estabelecer conexão com o servidor da corretora após informar o nome de usuário e a senha de acesso.
Uma vez estabelecida a conexão por meio do módulo Python para MetaTrader 5, podemos acessar os dados de preços disponibilizados pela corretora. O Python também oferece bibliotecas de indicadores técnicos, mas elas exigem instalação e frequentemente utilizam formatos de dados específicos. Felizmente, implementar nossa própria solução do zero é relativamente simples. Por isso, começaremos implementando os dois indicadores, SAR e RVI, em Python.
Função Parabolic SAR
O SAR é um indicador de acompanhamento de tendência utilizado para identificar possíveis pontos fractais de reversão do movimento dos preços. No gráfico, os pontos indicam a tendência predominante e também podem servir como níveis de stop-loss. Assim, em uma tendência de alta, os pontos ficam abaixo das mínimas, enquanto, em uma tendência de baixa, ficam acima das máximas. A função para calcular o SAR é a seguinte:
def SAR(df: pd.DataFrame, af: float = 0.02, af_max: float = 0.2) -> pd.DataFrame:
    """
    Calculate Parabolic SAR indicator and append it as 'SAR' column to the input DataFrame.

    Args:
        df (pd.DataFrame): DataFrame with 'high', 'low', 'close' columns
        af (float): Acceleration factor, default 0.02
        af_max (float): Maximum acceleration factor, default 0.2

    Returns:
        pd.DataFrame: Input DataFrame with new 'SAR' column
    """
    if not all(col in df.columns for col in ['high', 'low', 'close']):
        raise ValueError("DataFrame must contain 'high', 'low', 'close' columns")
    if af <= 0 or af_max <= 0 or af > af_max:
        raise ValueError("Invalid acceleration factors")
    if df.empty:
        raise ValueError("DataFrame is empty")

    result_df = df.copy()
    result_df['SAR'] = 0.0

    sar = df['close'].iloc[0]
    ep = df['high'].iloc[0]
    af_current = af
    trend = 1 if len(df) > 1 and df['close'].iloc[1] > df['close'].iloc[0] else -1

    for i in range(1, len(df)):
        prev_sar = sar
        high, low = df['high'].iloc[i], df['low'].iloc[i]

        if trend > 0:
            sar = prev_sar + af_current * (ep - prev_sar)
            if low < sar:
                trend = -1
                sar = ep
                ep = low
                af_current = af
            else:
                if high > ep:
                    ep = high
                    af_current = min(af_current + af, af_max)
        else:
            sar = prev_sar + af_current * (ep - prev_sar)
            if high > sar:
                trend = 1
                sar = ep
                ep = high
                af_current = af
            else:
                if low < ep:
                    ep = low
                    af_current = min(af_current + af, af_max)

        result_df.loc[i, 'SAR'] = sar

    return result_df
A função apresentada acima recebe um DataFrame do pandas contendo as colunas de preços high (máxima), low (mínima) e close (fechamento), além de dois parâmetros do tipo float que controlam o fator de aceleração. Os valores calculados são adicionados ao DataFrame de entrada em uma nova coluna denominada SAR. A lógica geral da função consiste em acompanhar a direção da tendência e atualizar o SAR com base no ponto extremo e no fator de aceleração.
Analisando o código em detalhes, começamos criando uma cópia do DataFrame de entrada para evitar alterações nos dados originais. A função extrai as colunas de máximas e mínimas como arrays NumPy, permitindo realizar os cálculos com mais eficiência. Em seguida, inicializamos o array sar com zeros para armazenar os valores calculados. Essa inicialização prepara a estrutura para armazenar os valores calculados do SAR, enquanto a cópia do DataFrame preserva os dados originais. O uso de .copy() evita efeitos colaterais inesperados. Além disso, arrays NumPy geralmente oferecem melhor desempenho do que Series do pandas em cálculos iterativos.
Na sequência, definimos a tendência inicial como de alta, utilizando trend = 1. O ponto extremo é inicializado com a primeira máxima, enquanto o valor inicial do SAR corresponde à primeira mínima. O fator de aceleração começa com o valor fornecido pelo parâmetro af-start. Essa etapa estabelece as condições iniciais para o cálculo do SAR, considerando uma tendência de alta. A escolha de low[0] para o SAR inicial está relacionada à função do indicador como nível de stop-loss em tendências de alta. Embora o SAR deva permanecer abaixo das mínimas durante uma tendência de alta, seu valor inicial coincide com a primeira mínima, definida por low[0]. Seu posicionamento é ajustado pelo fator de aceleração af-start, que influencia a distância em relação aos preços conforme a volatilidade do mercado.
Na etapa seguinte, atualizamos o SAR. A cada período, a fórmula ajusta o valor atual, aproximando-o do ponto extremo de acordo com o fator de aceleração. Esse mecanismo constitui a base do cálculo do indicador. À medida que a tendência avança, os níveis do SAR seguem uma trajetória parabólica em relação aos preços. Na implementação desse método, é importante manter o parâmetro af relativamente baixo para evitar deslocamentos excessivamente bruscos do SAR durante a formação da tendência. Também é fundamental preservar a estabilidade numérica em condições de mercado voláteis.
Depois disso, implementamos a lógica de reversão da tendência. Quando a tendência é de alta e o valor do SAR ultrapassa a mínima do período atual, ocorre uma reversão para uma tendência de baixa. Nesse momento, o SAR é redefinido para o ponto extremo anterior, enquanto o novo ponto extremo passa a corresponder à mínima atual. O fator de aceleração também retorna ao seu valor inicial.
Isso é importante porque a identificação de reversões de tendência é uma das principais funções do SAR na determinação dos pontos de entrada e saída. Essa condição garante que o SAR permaneça abaixo do preço durante uma tendência de alta. Podemos avaliar a sensibilidade do indicador às reversões ajustando o parâmetro af-increment.
Se a tendência de alta continuar, precisamos atualizar os valores do buffer SAR e, principalmente, aumentar o fator de aceleração em incrementos definidos por af-increment. O valor do SAR permanece limitado ao menor valor entre o nível calculado e as duas mínimas anteriores, evitando que ultrapasse os limites estabelecidos pelos preços. Além disso, sempre que a máxima superar o ponto extremo, esse ponto será atualizado e o fator de aceleração aumentará, desde que não ultrapasse o limite definido pelo parâmetro af-max. Essa etapa é importante porque garante que o SAR continue funcionando como um nível válido de stop-loss e que sua aceleração acompanhe a evolução da tendência. Considerar as duas mínimas anteriores aumenta a confiabilidade do indicador, embora alguns ajustes possam ser necessários em timeframes mais curtos.
Em seguida, implementamos a lógica do SAR para tendências de baixa. Ela funciona, em grande parte, de maneira simétrica à lógica da tendência de alta que acabamos de analisar. Se o valor do SAR ficar abaixo da máxima do período atual, ocorrerá uma reversão para uma tendência de alta. Caso não haja reversão, o valor do SAR permanecerá limitado ao maior valor entre o nível calculado e as máximas anteriores. Tanto o ponto extremo quanto o fator de aceleração são atualizados. Com isso, concluímos a lógica de acompanhamento das tendências de alta e de baixa. Manter o comportamento simétrico nas duas condições ajuda a evitar distorções no indicador. Também podemos realizar testes com dados históricos para avaliar a precisão na identificação das reversões.
Concluídos os cálculos do SAR, definimos os dados de saída. Nessa etapa, armazenamos os valores calculados em uma nova coluna denominada SAR e retornamos o DataFrame atualizado. Isso permite integrar o indicador à estrutura de dados e utilizá-lo em análises ou visualizações posteriores. Antes de utilizar os resultados, é recomendável verificar se os valores da coluna SAR estão corretamente posicionados em relação à série de preços. Para isso, podemos recorrer a bibliotecas de visualização, como Matplotlib, e representar graficamente os pontos do SAR.
Em resumo, o SAR é mais adequado a mercados com tendências bem definidas, nos quais pode ajudar a identificar níveis de stop-loss e pontos de reversão. Já em mercados laterais ou com movimentos erráticos, sua eficácia tende a ser menor. Embora o ajuste de parâmetros não seja tão crítico para o SAR, ele pode ser importante em determinados ativos, pois o valor inicial e o incremento do fator de aceleração podem exigir ajustes em relação aos valores usuais de 0,02 e 0,2. Também é recomendável validar o comportamento do indicador por meio de testes com dados históricos da corretora. A principal limitação do SAR é sua tendência a apresentar sinais com atraso em mercados sujeitos a mudanças rápidas, o que pode resultar em diversos sinais falsos.
Função RVI
O principal objetivo do RVI é acompanhar a força da tendência, que, em nossa abordagem, está diretamente relacionada ao momentum. Para isso, o indicador compara a variação entre os preços de abertura e fechamento com a amplitude entre a máxima e a mínima do período e aplica médias móveis para suavizar os resultados. Trata-se de um oscilador que pode ser utilizado para confirmar tendências por meio da análise do momentum ou identificar divergências. A implementação em Python é a seguinte:
def RVI(df: pd.DataFrame, period: int, signal_period: int) -> pd.DataFrame:
    """
    Calculate Relative Vigor Index (RVI) with signal line and append as 'RVI' and 'RVI_Signal' columns.

    Args:
        df (pd.DataFrame): DataFrame with 'open', 'high', 'low', 'close' columns
        period (int): Lookback period for RVI calculation
        signal_period (int): Lookback period for signal line calculation

    Returns:
        pd.DataFrame: Input DataFrame with new 'RVI' and 'RVI_Signal' columns
    """
    # Input validation
    if not all(col in df.columns for col in ['open', 'high', 'low', 'close']):
        raise ValueError("DataFrame must contain 'open', 'high', 'low', 'close' columns")
    if period < 1 or signal_period < 1:
        raise ValueError("Period and signal period must be positive")

    # Create a copy to avoid modifying the input DataFrame
    result_df = df.copy()

    # Calculate price change and range
    close_open = df['close'] - df['open']
    high_low = df['high'] - df['low']

    # Calculate SMA for numerator and denominator
    num = close_open.rolling(window=period).mean()
    denom = high_low.rolling(window=period).mean()

    # Calculate RVI
    result_df['RVI'] = num / denom * 100

    # Calculate signal line (SMA of RVI)
    result_df['RVI_Signal'] = result_df['RVI'].rolling(window=signal_period).mean()

    return result_df
No código apresentado acima, utilizamos um DataFrame do pandas contendo as colunas open, high, low e close. Além disso, a função recebe o parâmetro period, que define o período da média móvel simples (SMA) utilizada na linha de sinal. Ao final do cálculo, o RVI suavizado e sua linha de sinal são adicionados como novas colunas ao DataFrame. A fórmula básica do RVI é (close - open) / (high - low). Em seguida, aplicamos uma SMA de 4 períodos para suavizar o RVI e utilizamos uma segunda SMA, com período definido pelo usuário, para gerar a linha de sinal.
Analisando a implementação linha por linha, começamos criando uma cópia do DataFrame de entrada. Isso permite preservar os dados originais e evitar alterações involuntárias. O uso de .copy() é uma maneira simples de garantir essa separação e prevenir efeitos colaterais inesperados.
Em seguida, calculamos o RVI. Nessa etapa, o valor bruto do indicador é obtido pela razão entre a variação do preço e a amplitude de negociação. Essa relação expressa a intensidade do movimento dos preços em comparação com a amplitude do período, constituindo a base do Índice de Vigor Relativo (RVI). Como high e low podem apresentar valores iguais, precisamos tratar as possíveis divisões por zero. Faremos isso na próxima etapa. Nessa formulação, o indicador representa o momentum intradiário com base na variação entre abertura e fechamento.
Para tratar as divisões por zero, convertemos em NaN os valores infinitos que podem surgir quando high e low são iguais. Em seguida, todos os valores NaN são substituídos por zero. Esse tratamento é importante para preservar a estabilidade numérica e evitar problemas nos cálculos posteriores. Trata-se de uma solução simplificada, e o leitor pode considerar outras formas de tratamento caso a substituição por zeros provoque distorções significativas nos valores do buffer RVI.
Na etapa seguinte, suavizamos o RVI e calculamos sua linha de sinal. Primeiro, aplicamos uma SMA de 4 períodos aos valores brutos do RVI para atenuar as oscilações dos valores brutos do RVI, embora os zeros introduzidos no tratamento de dados inválidos ainda possam influenciar a média, conforme mencionado anteriormente. O resultado constitui a linha principal do indicador RVI. Em seguida, aplicamos outra SMA, com período definido pelo usuário, sobre os valores já suavizados do RVI para gerar a linha de sinal. Essa etapa é fundamental porque a suavização facilita a interpretação do indicador, enquanto a linha de sinal permite identificar os cruzamentos entre ela e a linha principal do RVI. Enquanto a SMA de 4 períodos costuma permanecer fixa, o período da média utilizada na linha de sinal pode ser ajustado para refinar o comportamento do indicador, por exemplo, utilizando valores entre 6 e 14.
Por fim, armazenamos o RVI suavizado e sua linha de sinal em colunas separadas do DataFrame de saída. Com isso, ambos podem ser utilizados em análises ou visualizações posteriores. Por exemplo, representar graficamente as duas linhas ajuda a identificar seus pontos de cruzamento.
Em resumo, o RVI é utilizado para confirmar a força da tendência, funcionando como um indicador de momentum. Ele também permite identificar precocemente possíveis divergências, como quando o preço atinge novas máximas, mas o RVI não acompanha esse movimento. Além disso, os cruzamentos do RVI com sua linha de sinal também podem gerar sinais secundários de alta ou de baixa. O ajuste dos parâmetros do RVI concentra-se principalmente na definição do período da SMA utilizada para gerar a linha de sinal a partir dos valores suavizados do indicador. Períodos mais curtos, próximos de 6, podem produzir sinais mais rápidos e frequentes, enquanto períodos próximos de 14 produzem uma linha de sinal mais suavizada. Para avaliar a confiabilidade desses sinais, é fundamental analisar os cruzamentos e as divergências do RVI em dados históricos. A principal limitação do indicador é sua tendência a apresentar sinais com atraso devido à dupla suavização. Além disso, em condições de baixa volatilidade, o RVI pode ter dificuldade para gerar sinais relevantes.
Complementaridade entre SAR e RVI
Como nas demais combinações de indicadores analisadas nesta série, escolhemos o SAR e o RVI por suas funções complementares. O SAR é um indicador de acompanhamento de tendência exibido diretamente no gráfico de preços. Já o RVI é um oscilador apresentado em uma janela separada, utilizado principalmente para medir o momentum. O SAR é mais adequado à definição de níveis de stop-loss, enquanto o RVI se destaca na confirmação de tendências e na identificação de divergências.
Ambos os indicadores foram implementados em Python, utilizando a biblioteca pandas para o processamento dos dados. O NumPy, por sua vez, contribui para acelerar os cálculos. A lógica do SAR, baseada em cálculos iterativos, tende a ser mais complexa devido à necessidade de identificar e tratar as reversões de tendência. Em contrapartida, o RVI utiliza operações vetorizadas mais simples, embora exija cuidados com possíveis divisões por zero. Dessa forma, podemos melhorar a eficiência da implementação utilizando arrays NumPy nos cálculos iterativos do SAR e DataFrames do pandas no processamento vetorizado do RVI.
Como melhorias adicionais para essa combinação de indicadores, o leitor pode realizar testes com dados históricos em Python, utilizando bibliotecas como Zipline; criar gráficos com os pontos do SAR e o RVI acompanhado de sua linha de sinal, especialmente úteis para quem opera manualmente; aprimorar o tratamento de erros do código apresentado, incluindo a validação dos dados de entrada, como a presença das colunas necessárias no DataFrame do pandas e a validade do período definido para o indicador; e, por fim, acrescentar novas funcionalidades a cada indicador. Por exemplo, podemos incorporar ao RVI um mecanismo de detecção de divergências ou experimentar métodos alternativos de suavização.
Padrões de sinal selecionados
Atributo 1
A maioria dos padrões apresentados no artigo anterior passou no teste forward, com exceção dos padrões 1, 2 e 6. Até agora, concentramos nossas análises nos padrões que passaram nesse teste, investigando se o machine learning poderia melhorar ainda mais seu desempenho. Neste artigo, utilizaremos machine learning para tentar melhorar os resultados dos padrões que não passaram no teste forward. Essa abordagem provavelmente também será explorada em artigos futuros.
Em Python, assim como em MQL5, precisamos implementar uma função para cada um desses padrões, capaz de retornar true ou false. O valor true indica que o sinal correspondente ao padrão está presente, enquanto false indica sua ausência. Como cada padrão indica a presença ou ausência de determinadas condições, seus resultados podem ser representados por valores binários, 0 e 1. Essas condições combinam sinais dos dois indicadores com os dados de preços. Cada função gera um array de atributos com duas colunas. A primeira coluna (column-0) registra os sinais de alta, enquanto a segunda (column-1) registra os sinais de baixa. Em ambas, o valor 0 indica ausência de sinal, e o valor 1 indica sua presença.
Como vimos no artigo anterior, o atributo 1 (feature-1) identifica tendências nas quais o preço permanece acima ou abaixo do SAR, enquanto o RVI apresenta movimentos de alta ou de baixa, respectivamente. Esse atributo verifica se o preço permanece acima ou abaixo do SAR e se a variação do RVI confirma a direção do movimento. Sua implementação em Python é a seguinte:
def feature_1(sar_df, rvi_df, price_df):
    """

    """
    feature = np.zeros((len(sar_df), 2))

    feature[:, 0] = ((price_df['low'].shift(1) > sar_df['SAR'].shift(1)) &
                     (price_df['low'] > sar_df['SAR']) &
                     (rvi_df['RVI'] > rvi_df['RVI'].shift(1))).astype(int)

    feature[:, 1] = ((price_df['high'].shift(1) < sar_df['SAR'].shift(1)) &
                     (price_df['high'] < sar_df['SAR']) &
                     (rvi_df['RVI'] < rvi_df['RVI'].shift(1))).astype(int)


    feature[0, :] = 0
    feature[1, :] = 0

    return feature
No código apresentado acima, inicializamos um array NumPy com zeros, com dimensões [número de linhas dos DataFrames de entrada, 2]. As duas colunas são reservadas para registrar os sinais de alta e de baixa, respectivamente. A inicialização com np.zeros garante que todas as posições do array contenham valores definidos desde o início, evitando resultados inesperados que poderiam surgir com o uso de memória não inicializada.
Após inicializar o array, definimos as condições para gerar o sinal de alta. Na coluna 0, atribuímos o valor 1 quando três condições são atendidas simultaneamente: a mínima do período anterior está acima do nível atual do SAR, indicando a continuidade da tendência de alta; a mínima do período atual também permanece acima do SAR; e o RVI atual é maior que seu valor anterior, indicando uma evolução favorável do momentum para o sinal de alta. A combinação dessas condições reforça o sinal de alta ao reunir informações de tendência fornecidas pelo SAR e de momentum fornecidas pelo RVI. Também precisamos garantir que shift(1) seja aplicado corretamente para comparar os valores atuais com os do período anterior, tratando os valores NaN introduzidos no início da série. Por fim, utilizamos astype(int) para converter os resultados booleanos em valores binários, 0 e 1.
Definido o sinal de alta, estabelecemos as condições para gerar o sinal de baixa. A lógica utilizada é simétrica à anterior, o que torna pouco provável obter um vetor de atributos com valor 1 simultaneamente nas colunas de alta e de baixa. Além disso, utilizamos apenas dois atributos binários por observação, um para o sinal de alta e outro para o sinal de baixa. Já discutimos e implementamos vetores muito maiores, nos quais cada posição representa um sinal individual dos indicadores. No entanto, essa abordagem apresentou resultados fracos nos testes forward, realizados com uma janela de avaliação bastante limitada. Por esse motivo, mantemos a representação bidimensional, composta por um atributo de alta e outro de baixa.
Assim, na segunda coluna, definimos o sinal de baixa quando a máxima do período anterior está abaixo do SAR anterior e a máxima do período atual também permanece abaixo do SAR atual. Além disso, o RVI atual deve ser menor que seu valor anterior, indicando uma evolução descendente do RVI, compatível com o momentum de baixa. A combinação dessas condições produz um sinal de baixa apoiado pela posição dos preços em relação ao SAR e pela trajetória descendente do RVI. Assim como na lógica de alta, precisamos aplicar corretamente shift(1) para alinhar as comparações com o período anterior e tratar os valores NaN introduzidos no início da série.
Depois de definir os sinais de alta e de baixa, ajustamos o array de saída para considerar as comparações com valores defasados. Para evitar sinais baseados em dados incompletos, atribuímos zero às duas primeiras linhas do array de saída. Esse tratamento é importante em séries temporais que utilizam comparações com períodos anteriores. Os testes, abrangendo tanto o treinamento quanto o período forward, produziram o seguinte relatório:
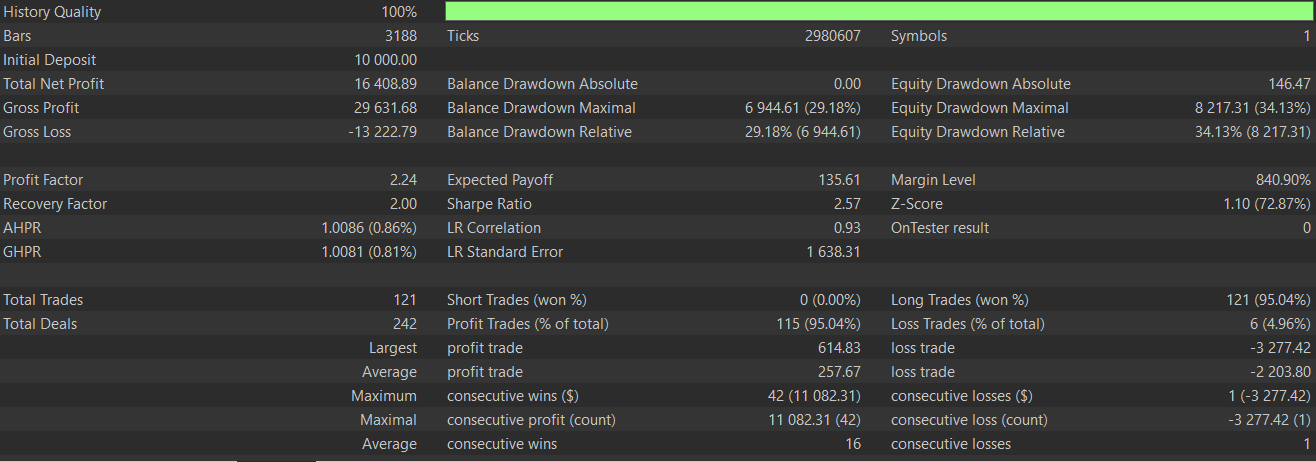
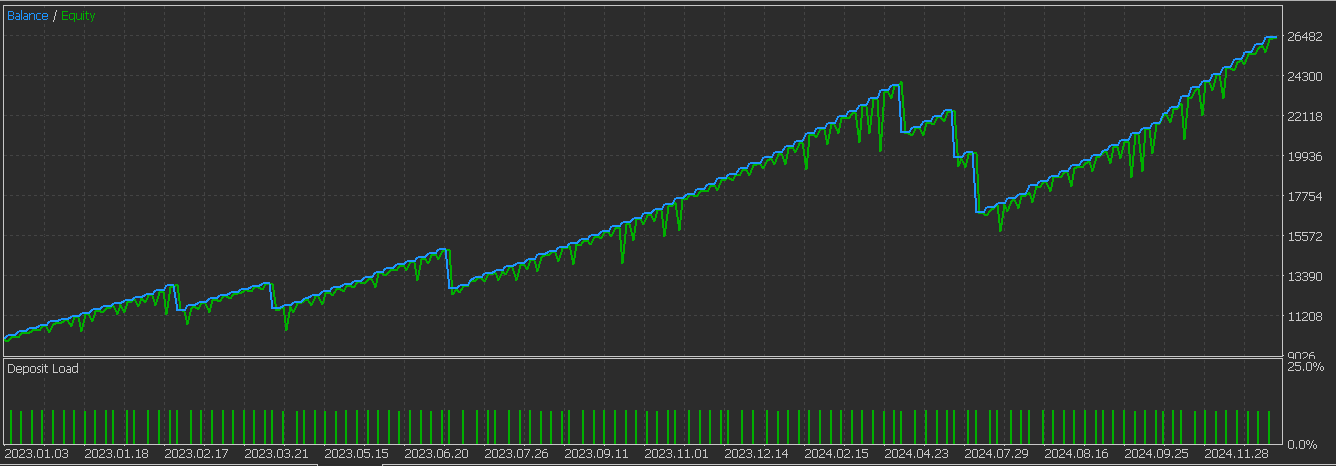
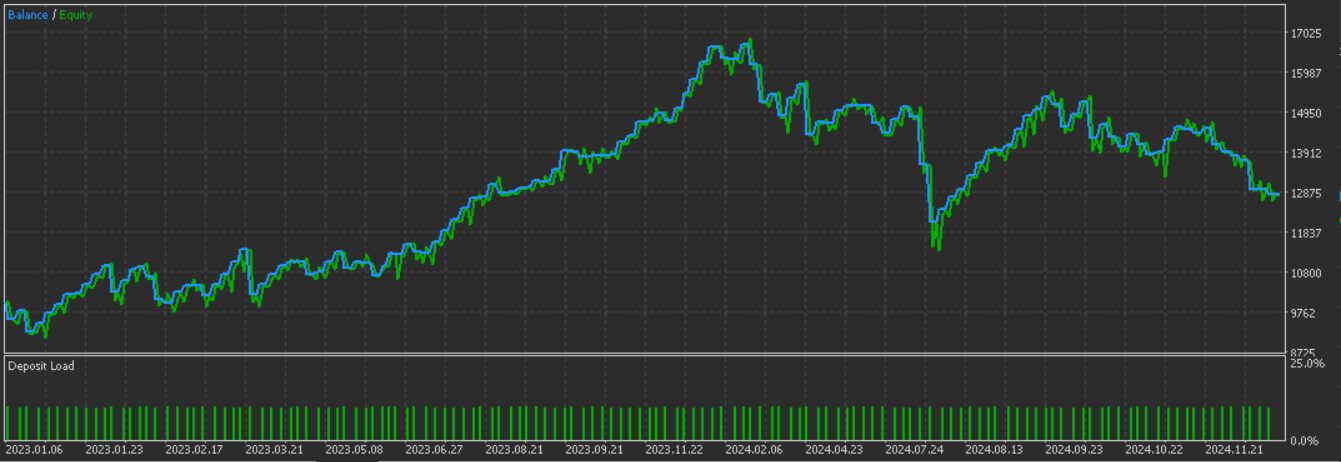
Os resultados sugerem que o aprendizado supervisionado melhorou o desempenho nesse conjunto de testes. Para comparação, abaixo apresentamos o gráfico obtido para o padrão 1 sem utilizar aprendizado supervisionado:
Atributo 2
O padrão de índice 2, terceiro na numeração iniciada em zero, também não passou no teste forward. Como discutimos no artigo anterior, esse padrão busca identificar possíveis reversões quando o preço cruza o SAR e o comportamento do RVI fornece uma indicação adicional de momentum. Ele também considera a direção do movimento dos preços, utilizando o preço de fechamento como referência adicional. A implementação em Python é a seguinte:
def feature_2(sar_df, rvi_df, price_df):
    """

    """
    feature = np.zeros((len(sar_df), 2))

    feature[:, 0] = ((price_df['high'].shift(1) <= sar_df['SAR'].shift(1)) &
                     (price_df['low'] >= sar_df['SAR']) &
                     (rvi_df['RVI'] > rvi_df['RVI'].shift(1)) &
                     (price_df['close'].shift(1) > price_df['close'])).astype(int)

    feature[:, 1] = ((price_df['low'].shift(1) >= sar_df['SAR'].shift(1)) &
                     (price_df['high'] <= sar_df['SAR']) &
                     (rvi_df['RVI'].shift(1) > rvi_df['RVI']) &
                     (price_df['close'] > price_df['close'].shift(1))).astype(int)


    feature[0, :] = 0
    feature[1, :] = 0

    return feature
Inicializamos um array NumPy com zeros, destinado a armazenar os sinais de alta e de baixa. Como mencionado anteriormente, essa inicialização garante que todas as posições do array de saída comecem com zero, evitando valores não inicializados. Eventuais valores NaN produzidos posteriormente precisam ser tratados separadamente. Essa estrutura mantém o formato de saída consistente com o das demais funções de geração de atributos.
Em seguida, definimos as condições para gerar um sinal de alta. Para atribuir o valor 1, todas as condições precisam ser atendidas; caso contrário, o valor permanece em 0. Por isso, inicializar os arrays com zeros garante que os sinais permaneçam desativados até que todas as condições necessárias sejam atendidas. Assim, quando a máxima do período anterior está no mesmo nível ou abaixo do SAR anterior, enquanto a mínima do período atual está no mesmo nível ou acima do SAR atual, temos um possível sinal de reversão da tendência. Além disso, o RVI deve apresentar alta, enquanto o preço de fechamento registra queda, sugerindo uma possível divergência. Essa combinação ajuda a identificar reversões de alta quando o preço cruza o SAR, com confirmação pelo momentum do RVI. Atribuímos o valor true ou 1 somente quando a posição dos preços em relação ao SAR e as condições de preço e RVI são atendidas simultaneamente.
Para identificar o sinal de baixa, utilizamos a segunda coluna do array NumPy de atributos. Nesse caso, a mínima do período anterior deve estar no mesmo nível ou abaixo do SAR anterior, enquanto a máxima do período atual deve estar no mesmo nível ou abaixo do SAR atual. Além disso, o RVI precisa estar em queda e o preço de fechamento deve apresentar alta. O padrão de sinal 2 busca identificar divergências de baixa. Como suas condições envolvem comparações entre períodos, precisamos garantir que os dados estejam corretamente alinhados. Por fim, atribuímos zero às primeiras linhas do array de atributos para evitar sinais baseados em dados incompletos. Esse tratamento é comum em séries temporais que utilizam comparações com períodos anteriores.
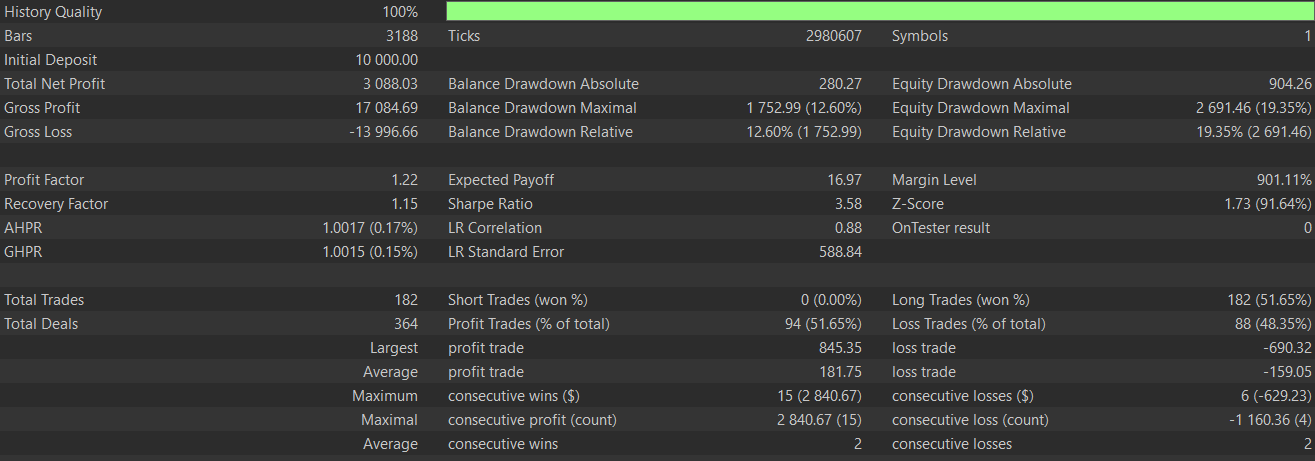
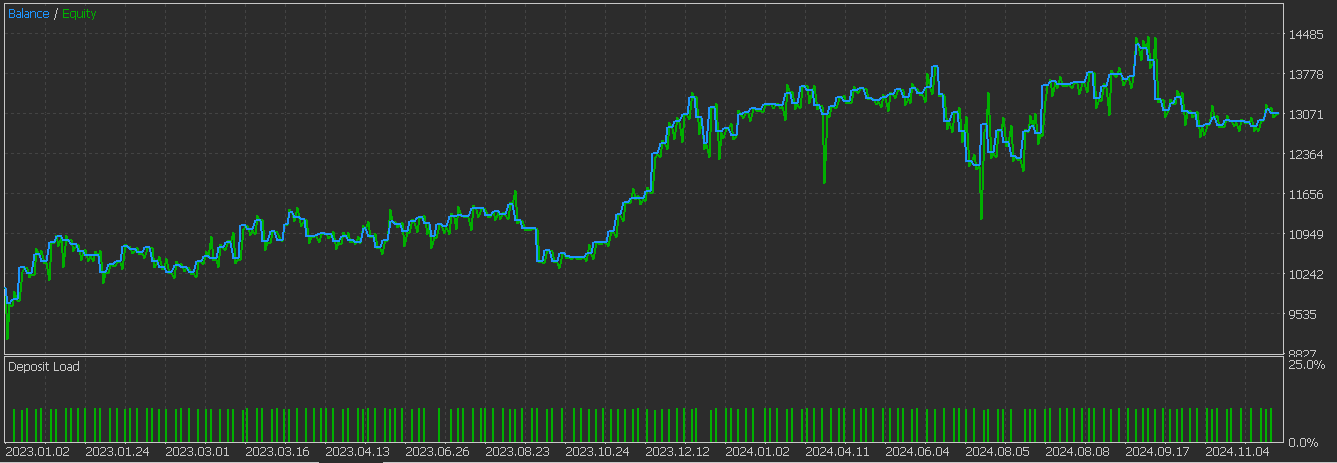
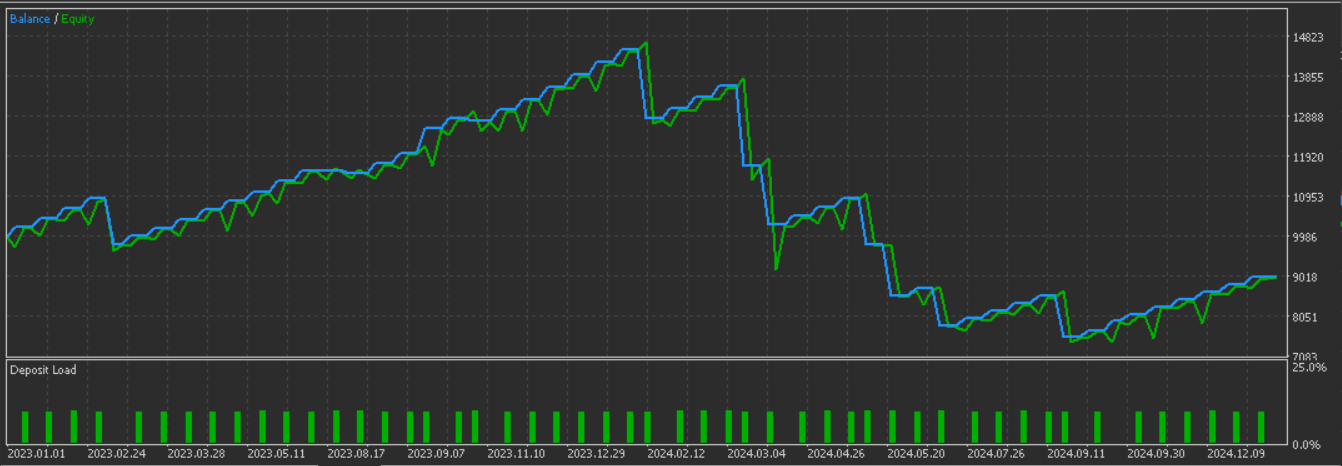
Em teoria, o atributo 2 pode ser utilizado em conjunto com o padrão de sinal 1, descrito anteriormente, pois ambos apresentam características complementares. O atributo 1 segue uma abordagem exclusivamente voltada ao acompanhamento de tendências, enquanto o atributo 2 busca identificar reversões associadas a divergências. Essa combinação poderia ser explorada em estratégias de swing trading para desenvolver um sistema mais robusto. No entanto, como já discutimos e demonstramos nos artigos anteriores, combinar diferentes padrões tende a provocar a supressão prematura de sinais entre eles. Por isso, a avaliação de um sistema desse tipo exige um histórico suficientemente amplo e testes forward rigorosos. Abaixo, apresentamos o relatório com os resultados obtidos nos períodos de treinamento e teste do padrão. Mais uma vez, a aplicação de machine learning parece produzir resultados mais favoráveis:
Para comparação, abaixo apresentamos o gráfico obtido para o padrão 2 sem utilizar aprendizado supervisionado:
Atributo 6
O último atributo que analisaremos, entre os 10 apresentados no artigo anterior, corresponde ao padrão de sinal 6. Diferentemente dos anteriores, esse método utiliza o cruzamento do RVI com sua linha de sinal como confirmação, em vez de considerar apenas o momentum do indicador. O objetivo é identificar sinais de tendência mais fortes, combinando a posição dos preços em relação ao SAR com os cruzamentos do RVI com sua linha de sinal. A implementação em Python é a seguinte:
def feature_6(sar_df, rvi_df, price_df):
    """

    """
    feature = np.zeros((len(sar_df), 2))

    feature[:, 0] = ((price_df['low'].shift(1) > sar_df['SAR'].shift(1)) &
                     (price_df['low'] > sar_df['SAR']) &
                     (rvi_df['RVI'] > rvi_df['RVI_Signal']) &
                     (rvi_df['RVI'].shift(1) < rvi_df['RVI_Signal'].shift(1))).astype(int)

    feature[:, 1] = ((price_df['high'].shift(1) < sar_df['SAR'].shift(1)) &
                     (price_df['high'] < sar_df['SAR']) &
                     (rvi_df['RVI'] < rvi_df['RVI_Signal']) &
                     (rvi_df['RVI'].shift(1) > rvi_df['RVI_Signal'].shift(1))).astype(int)

    feature[0, :] = 0
    feature[1, :] = 0

    return feature
Inicializamos um array NumPy com zeros, definindo as dimensões necessárias para armazenar os sinais de saída. Essa inicialização é importante e segue o mesmo procedimento adotado nas funções anteriores, garantindo que todas as posições do array comecem com zero, sem valores não inicializados. Essa inicialização mantém o formato de saída consistente com o das demais funções de geração de atributos.
Em seguida, definimos as condições para gerar um sinal de alta, registrado na primeira coluna do array, de índice 0. Atribuímos o valor 1 quando a mínima do período anterior está acima do SAR anterior; a mínima do período atual também permanece acima do SAR atual; o RVI atual está acima de sua linha de sinal; e, por fim, o RVI anterior estava abaixo de sua linha de sinal.
Para gerar o sinal de baixa, exigimos que quatro condições sejam atendidas simultaneamente: a máxima anterior deve estar abaixo do SAR anterior; a máxima atual deve permanecer abaixo do SAR atual; o RVI atual deve estar abaixo de sua linha de sinal; e o RVI anterior deve estar acima da linha de zero. Abaixo, apresentamos o relatório com os resultados dos testes. Mais uma vez, os resultados do teste forward sugerem uma melhora no desempenho.
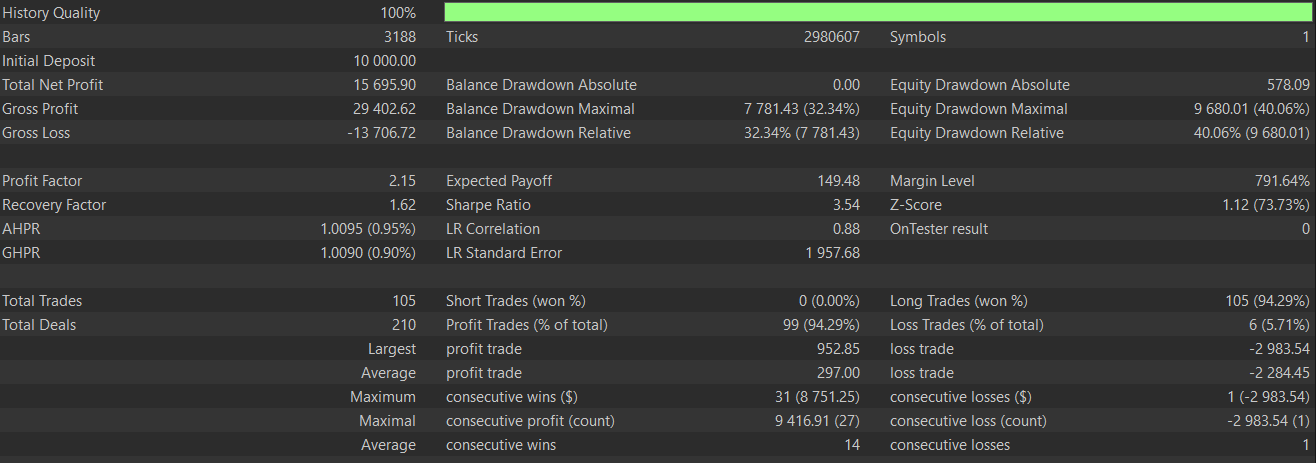
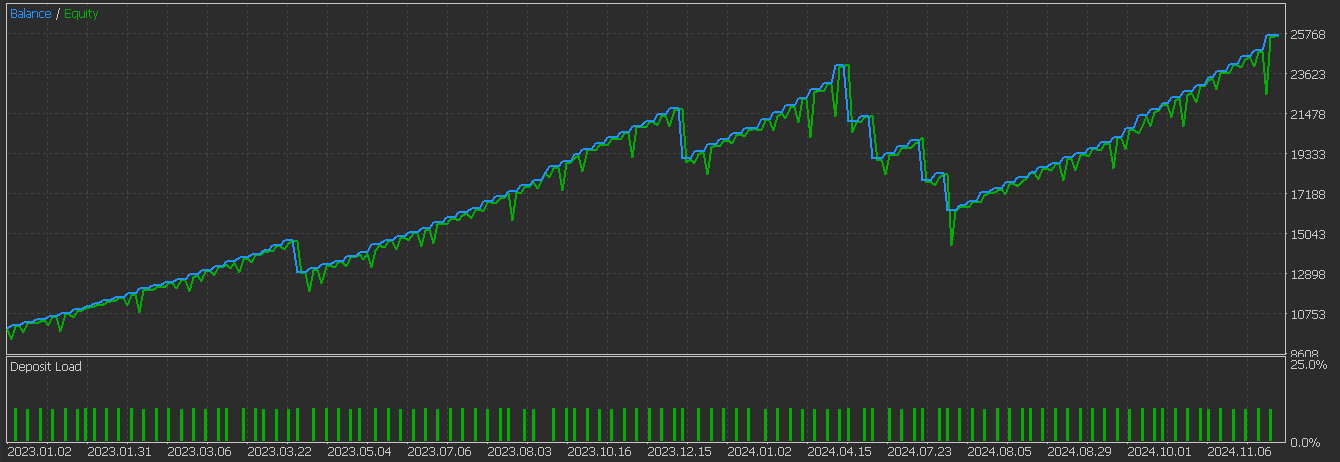
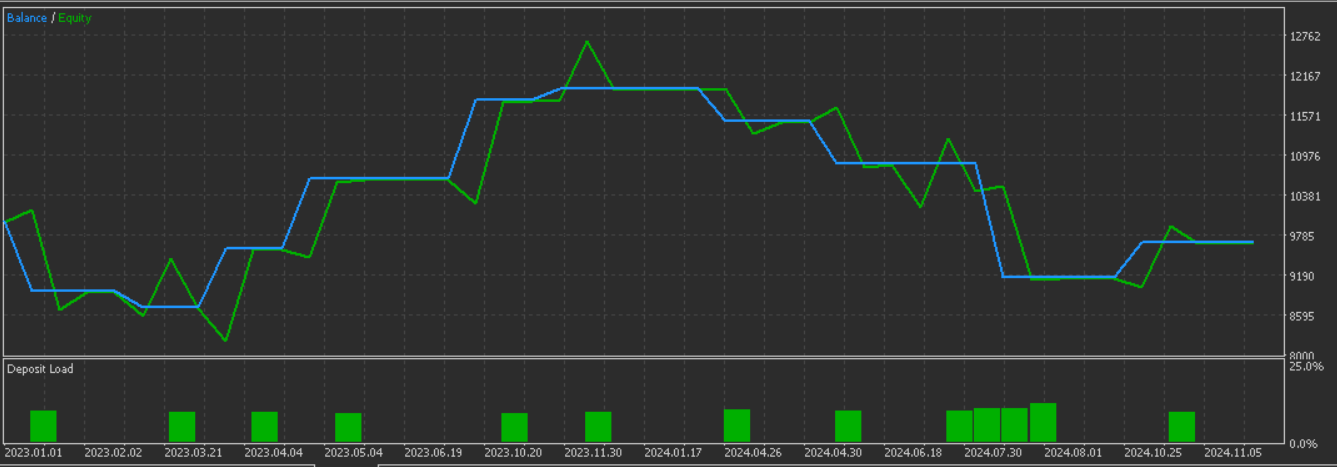
Para comparação, abaixo apresentamos o gráfico obtido para o padrão 6 sem utilizar aprendizado supervisionado:
Rede neural
Nos testes realizados com os três padrões descritos acima, utilizamos uma rede neural convolucional unidimensional. Sua arquitetura contém três camadas convolucionais, nas quais o número de filtros e o tamanho dos kernels aumentam exponencialmente. Em seguida, aplicamos max-pooling, que seleciona o maior valor de cada janela e reduz o comprimento da representação produzida pelas camadas convolucionais. Por fim, utilizamos camadas totalmente conectadas para gerar a saída final. A implementação em Python é a seguinte:
class ExpConv1DNetwork(nn.Module):
    def __init__(self, input_length, input_channels=1, base_filters=16, base_kernel_size=3, exp_base=2):
        super(ExpConv1DNetwork, self).__init__()
        self.conv_layers = nn.ModuleList()
        self.pool_layers = nn.ModuleList()

        for i in range(3):
            filters = int(base_filters * (exp_base ** i))
            kernel_size = int(base_kernel_size * (exp_base ** i)) | 1
            self.conv_layers.append(
                nn.Conv1d(
                    in_channels=input_channels if i == 0 else int(base_filters * (exp_base ** (i-1))),
                    out_channels=filters,
                    kernel_size=kernel_size,
                    padding='same'
                )
            )
            # Use smaller kernel size for pooling to prevent size reduction to 0
            self.pool_layers.append(nn.MaxPool1d(kernel_size=2, ceil_mode=True))

        self.flatten_size = self._get_flatten_size(input_length, input_channels, base_filters, exp_base)
        self.flatten = nn.Flatten()
        self.dense1 = nn.Linear(self.flatten_size, 128)
        self.relu = nn.ReLU()
        self.dropout = nn.Dropout(0.5)
        self.dense2 = nn.Linear(128, 1)

    def _get_flatten_size(self, input_length, input_channels, base_filters, exp_base):
        current_length = input_length
        current_channels = input_channels

        for i in range(3):
            current_channels = int(base_filters * (exp_base ** i))
            # Update length after pooling
            current_length = (current_length + 1) // 2  # Ceiling division for ceil_mode=True

        return current_channels * current_length

    def forward(self, x):
        for conv, pool in zip(self.conv_layers, self.pool_layers):
            x = self.relu(conv(x))
            x = pool(x)
        x = self.flatten(x)
        x = self.relu(self.dense1(x))
        x = self.dropout(x)
        x = self.dense2(x)
        return x
A rede neural processa sequências unidimensionais organizadas em um tensor de entrada cujas dimensões são definidas por batch-size, input-channels e input-length. Sua arquitetura também pode ser configurada por meio de parâmetros como base-filters, base-kernel-size e exp-base. A saída consiste em um único valor escalar no intervalo de 0 a 1. Valores próximos de 0 indicam uma previsão de baixa, enquanto valores próximos de 1 indicam uma previsão de alta. A configuração dessa classe é fundamental para ajustar o desempenho da rede neural aplicada aos padrões de sinal selecionados. Por enquanto, porém, deixaremos possíveis melhorias em sua implementação para uma etapa posterior.
Conclusão
Neste artigo, investigamos os possíveis benefícios da aplicação de aprendizado supervisionado a padrões de sinal que não passaram no teste forward, utilizando uma janela bastante limitada de dados do par GBP/CHF, com apenas dois anos de histórico. Mesmo nessas condições bastante restritas, os resultados dos testes sugerem uma melhora em relação aos obtidos no artigo anterior. Isso é encorajador. No entanto, como sempre, é fundamental que o leitor realize suas próprias análises, de forma mais abrangente e rigorosa, antes de considerar a aplicação de qualquer uma das ideias apresentadas aqui.
| Arquivo | Descrição |
|---|---|
| WZ-70.mq5 | Arquivo cujo cabeçalho faz referência aos arquivos utilizados na geração do EA pelo Assistente MQL5. |
| SignalWZ_70.mqh | Arquivo personalizado da classe de sinais utilizado pelo Assistente MQL5. |
| 70_1.onnx | Modelo de rede neural exportado para o padrão 1. |
| 70_2.onnx | Modelo de rede neural exportado para o padrão 2. |
| 70_6.onnx | Modelo de rede neural exportado para o padrão 6. |
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/18433
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.
 Caminhe em novos trilhos: Personalize indicadores no MQL5
 Criação de EAs auto-otimizáveis em MQL5 (Parte 8): Análise de múltiplas estratégias
 Está chegando o novo MetaTrader 5 e MQL5
 Criação de um painel administrativo de negociação em MQL5 (Parte XII): Integração de uma calculadora Forex

- Aplicativos de negociação gratuitos
- 8 000+ sinais para cópia
- Notícias econômicas para análise dos mercados financeiros
Você concorda com a política do site e com os termos de uso