

Robot de trading multiflujo con aprendizaje automático: del concepto a la implementación
 25
 1

Este proyecto consiste en reanimar uno de mis códigos antiguos. El código lleva mucho tiempo guardado en discos duros llenos de polvo y se cae desde hace tiempo: han cambiado demasiadas cosas en el entorno de desarrollo a lo largo de estos años. He decidido no solo retomar el desarrollo, sino también explicarlo paso a paso en una serie de artículos.
En un principio, la idea consistía en desarrollar un robot multiflujo que utilizara una potente computación paralela, quizá incluso recurriendo a clústeres de computación en la nube. Imagina la siguiente situación: estás sentado frente a varias pantallas, observando la evolución de los pares de divisas, y te das cuenta de que el cerebro humano simplemente no es capaz de seguir al mismo tiempo decenas de instrumentos, analizar cientos de características y tomar decisiones a la velocidad que exigen los mercados actuales. Es precisamente en ese momento cuando surge la idea de crear un robot de trading inteligente, capaz de gestionar una cartera de instrumentos y analizar decenas de años de datos de forma simultánea.
Pero, ¿por qué precisamente Python y no el lenguaje MQL5 integrado en MetaTrader? Seguramente, esta pregunta se la plantea cualquiera que vea la arquitectura híbrida de nuestra solución. La respuesta radica en la naturaleza de los problemas que resolvemos. El aprendizaje automático requiere bibliotecas potentes como scikit-learn, XGBoost y pandas: un ecosistema que, en Python, parece haber sido creado específicamente para el aprendizaje automático y el análisis de datos.
Otra razón que justifica esta elección: la arquitectura de nuestro robot se basa en la filosofía de la separación de responsabilidades y la división del trabajo. Python se encarga del «cerebro»: la recopilación de datos, su preprocesamiento, la creación de características, el entrenamiento de modelos y la generación de señales de trading. MetaTrader 5, a través de su API de Python, actúa como las «manos»: ejecuta órdenes, gestiona posiciones y proporciona datos de mercado en tiempo real.
La ejecución multiflujo deja de ser simplemente una solución técnica y se convierte en una necesidad. Cuando tu robot tiene que analizar simultáneamente el EURUSD, el GBPUSD, el AUDUSD y otros pares, el procesamiento secuencial se convierte en un cuello de botella. Cada flujo cuenta con su propio par de divisas, su propio modelo y su propio contexto de toma de decisiones. Es parecido a cuando un trader experimentado puede mantener en mente varias ideas de trading a la vez, pero con la potencia de cálculo de una máquina.
La particularidad de nuestro enfoque radica en la integración de la gestión de riesgos a nivel de cartera. En lugar de que cada instrumento se negocie de forma independiente, introducimos la variable global TOTAL_PORTFOLIO_RISK, que limita el riesgo total de la cartera. Esto significa que el tamaño de la posición en cada instrumento se calcula no solo en función de su volatilidad, sino también teniendo en cuenta las posiciones ya abiertas en otros instrumentos.
TOTAL_PORTFOLIO_RISK: float = 500.0
POSITION_SIZES: Dict[str, float] = {}
SYMBOL_TRADES: Dict[str, bool] = {}
Sistema de registro y obtención de datos de mercado
Antes de adentrarnos en los algoritmos de aprendizaje automático, debemos sentar unas bases sólidas: un sistema de registro y obtención de datos. ¿Alguna vez has intentado depurar una aplicación multiflujo sin logs? Es como buscar una aguja en un pajar con los ojos vendados.
Nuestro sistema de registro se basa en una cola de tamaño limitado: una solución que puede parecer excesivamente compleja, pero que tiene mucho sentido. Imagina la siguiente situación: cinco flujos intentan escribir información en la consola al mismo tiempo. Sin coordinación, te encontrarás con una mezcla caótica de mensajes mezclados. La cola garantiza el orden, mientras que un flujo de impresión independiente asegura la legibilidad de los logs.
log_queue = queue.Queue(maxsize=1000)

def log_printer():
    while True:
        try:
            log_message = log_queue.get(timeout=10)
            if log_message is None:
                break
            print(log_message)
        except queue.Empty:
            continue
¿Por qué exactamente 1000 mensajes en la cola? Es el resultado de la experiencia práctica. Una cola demasiado pequeña hará que se pierdan mensajes importantes en momentos de gran actividad, mientras que una demasiado grande provocará un consumo excesivo de memoria. 1.000 mensajes: el equilibrio óptimo para un robot de trading.
Ahora pasamos al núcleo de nuestro sistema: la función `retrieve_data`. Parece sencilla, pero en ella subyace una filosofía de fiabilidad. Fíjate en la variable `retries_limit = 300`. No es un número al azar. En el trading real, los servidores de los brókeres pueden no estar disponibles durante segundos, a veces incluso minutos. 300 intentos con un intervalo de un segundo nos dan una ventana de recuperación de 5 minutos.
Se ha prestado especial atención a la creación de indicadores técnicos. No nos limitamos a calcular el RSI o el MACD: creamos todo un ecosistema de características interrelacionadas. El RSI indica si un activo se encuentra en zona de sobrecompra o de sobreventa. El MACD revela los cambios en el impulso. El ATR mide la volatilidad. Pero la magia surge cuando estos indicadores interactúan dentro de un modelo de aprendizaje automático.
# RSI (Relative Strength Index)
delta = raw_data['close'].diff()
gain = delta.where(delta > 0, 0).rolling(14).mean()
loss = (-delta.where(delta < 0, 0)).rolling(14).mean()
rs = gain / loss
raw_data['RSI_14'] = (100 - (100 / (1 + rs))).astype(np.float64)
Ten en cuenta que utilizamos np.float64 en lugar de float32. Puede parecer un derroche de memoria, pero las funciones posteriores requieren una gran precisión en los cálculos. Ahorrar en precisión puede provocar inestabilidad en la agrupación de características.
Cada indicador técnico tiene su propia «personalidad». El indicador Williams %R reacciona de forma agresiva a las variaciones del precio. El oscilador Aroon muestra la fuerza de la tendencia. El Efficiency Ratio mide la «pureza» del movimiento del precio. Cuando todos estos indicadores se combinan en modelos de aprendizaje automático, crean una representación multidimensional del mercado que escapa a la percepción humana.
Aumento de datos y creación de muestras sintéticas
El aprendizaje automático tiene hambre de datos, pero los mercados financieros son parcos en ejemplos históricos. ¿Cómo resolver este dilema? El aumento de datos se convierte en nuestra clave para crear un conjunto de entrenamiento rico a partir de un historial limitado.
La función `augment_data` implementa cuatro estrategias para aumentar el volumen de datos, cada una de las cuales tiene una justificación bien fundamentada. La primera estrategia consiste en añadir ruido. Quizá te preguntes: ¿para qué estropear unos datos limpios? La respuesta está en la naturaleza de los mercados reales. Los precios nunca evolucionan de forma perfectamente uniforme: siempre hay microfluctuaciones, deslizamientos y picos aleatorios. Al añadir ruido controlado, preparamos el modelo para condiciones reales.
noisy_data = raw_data.astype(np.float32) + np.random.normal(0, noise_level, raw_data.shape).astype(np.float32) El parámetro `noise_level = 0.01` no se ha elegido al azar. Esto supone aproximadamente el 1 % del valor de la característica: lo suficiente para generar variabilidad, pero no tanto como para distorsionar los patrones. Imagínatelo como unas ligeras ondulaciones en el agua: no cambian la dirección de la corriente, pero le dan más realismo.
La segunda estrategia es el desplazamiento temporal. Creamos una copia de los datos adelantada una hora. Puede parecer artificial, pero los patrones financieros suelen repetirse con pequeños desfases temporales. La volatilidad matutina puede manifestarse por la tarde, y los ciclos semanales pueden desplazarse uno o dos días.
La tercera estrategia es el escalado. Multiplicamos todos los valores por un coeficiente aleatorio comprendido entre 0,9 y 1,1. Esto simula diversas condiciones de mercado: periodos de alta y baja volatilidad, mercados alcistas y bajistas. Un modelo entrenado únicamente con datos de un único periodo puede resultar ineficaz si cambia el régimen de mercado.
La cuarta estrategia es la inversión de las columnas de precios. Multiplicamos los datos de precios por -1, lo que en la práctica pone el gráfico patas arriba. Esto enseña al modelo a reconocer patrones especulares. El patrón «cabeza y hombros», al invertirse, se convierte en un patrón «cabeza y hombros invertido», pero las relaciones matemáticas entre las características se mantienen.
for col in price_columns:
    if col in inverted_data.columns:
        inverted_data[col] *= -1
Resulta fundamental procesar correctamente los resultados del aumento de datos. Las operaciones con números de coma flotante pueden generar valores infinitos o NaN. Nuestra estrategia de limpieza utiliza las medianas para completar los valores problemáticos, lo que supone un enfoque más robusto que el uso de los valores medios, que pueden verse sesgados por los valores atípicos.
Tras el aumento de datos, el volumen de datos se multiplica por cinco. A partir de 1.000 horas históricas obtenemos 5.000 ejemplos de entrenamiento. Pero no se trata solo de un aumento cuantitativo, sino de un enriquecimiento cualitativo. El modelo no solo ve lo que ocurrió, sino también variantes de lo que podría haber ocurrido en condiciones ligeramente diferentes.
Prestamos especial atención al tratamiento del volumen de operaciones. A diferencia de los precios, el volumen no puede ser negativo, por lo que, al invertir, no lo modificamos, y al añadir ruido, lo limitamos inferiormente a cero. Esto garantiza la coherencia económica de los datos.
Etiquetado de datos y creación de variables objetivo
El aprendizaje automático sin datos correctamente etiquetados es como intentar enseñar a un niño a leer mostrándole letras sin explicarle su significado. Las funciones markup_data y label_data resuelven la tarea fundamental de convertir datos de precios sin procesar en ejemplos de entrenamiento con etiquetas objetivo claras.
La función markup_data implementa el enfoque más sencillo para el etiquetado: predice si, al cabo de un periodo, el precio será superior al actual en una magnitud markup_ratio. Este enfoque parece primitivo, pero su sencillez es engañosa. El parámetro markup_ratio = 0.00002 (2 pips para la mayoría de los pares de divisas) tiene en cuenta los costes reales de trading.
def markup_data(
    data: pd.DataFrame,
    target_column: str,
    label_column: str,
    markup_ratio: float = 0.00002
) -> pd.DataFrame:
    log("Starting markup_data function")
    data[label_column] = np.where(
        data[target_column].shift(-1) > data[target_column] + markup_ratio,
        1,
        0
    ).astype(np.int8)
    data.loc[data[label_column].isna(), label_column] = 0
    log(f"Number of labels set for price change greater than markup ratio: {data[label_column].sum()}")
    return data
La función label_data ofrece un enfoque más sofisticado. En lugar de limitarse a comparar precios después de un solo periodo, modela una estrategia de trading real con stop-loss y take-profit. Esto es de vital importancia, ya que los mercados financieros no son lineales. Es posible que el precio alcance tu objetivo, pero que, por el camino, toque el stop-loss.
def label_data(
    data: pd.DataFrame,
    symbol: str,
    min_days: int = 2,
    max_days: int = 72
) -> pd.DataFrame:
    if not mt5.initialize(path=TERMINAL_PATH):
        log("Terminal connection error")
        return data

    symbol_info = mt5.symbol_info(symbol)
    stop_level: float = 300 * symbol_info.point
    take_level: float = 800 * symbol_info.point
    labels: List[Optional[int]] = []

    for i in range(data.shape[0] - max_days):
        rand: int = random.randint(min_days, max_days)
        curr_pr: float = data['close'].iloc[i]
        future_pr: float = data['close'].iloc[i + rand]
        min_pr: float = data['low'].iloc[i:i + rand].min()
        max_pr: float = data['high'].iloc[i:i + rand].max()
        price_change: float = abs(future_pr - curr_pr)

        if (price_change > take_level and
            future_pr > curr_pr and
            min_pr > curr_pr - stop_level):
            labels.append(1)
        elif (price_change > take_level and
              future_pr < curr_pr and
              max_pr < curr_pr + stop_level):
            labels.append(0)
        else:
            labels.append(None)
El algoritmo de etiquetado de datos funciona de la siguiente manera: para cada punto en el tiempo, seleccionamos un horizonte aleatorio entre min_days y max_days (de 2 a 72 horas). A continuación, analizamos la evolución del precio en ese intervalo. La lógica de verificación es de tres niveles: si el movimiento del precio es lo suficientemente grande (price_change > take_level), si la dirección es la correcta (future_pr > curr_pr para las compras) y si no se ha producido una activación prematura del stop-loss (min_pr > curr_pr - stop_level).
¿Por qué horizontes temporales aleatorios? Esto evita que el modelo se sobreajuste a intervalos de tiempo fijos. Los mercados no conocen nuestros periodos de análisis: un patrón puede formarse en 5 horas o en 50. La aleatoriedad hace que el modelo sea más adaptable a las distintas escalas temporales de los movimientos del mercado.
data = data.iloc[:len(labels)].copy()
    data['labels'] = labels
    data.dropna(inplace=True)

    X = data.drop('labels', axis=1)
    y = data['labels']

    rus = RandomUnderSampler(random_state=2)
    X_balanced, y_balanced = rus.fit_resample(X, y)

    data_balanced = pd.concat([X_balanced, y_balanced], axis=1)
    log(f"Number of growth labels (1.0): {data_balanced['labels'].value_counts().get(1.0, 0)}")
    log(f"Number of decline labels (0.0): {data_balanced['labels'].value_counts().get(0.0, 0)}")
    return data_balanced
Los parámetros stop_level = 300 puntos y take_level = 800 puntos establecen una relación riesgo/beneficio de aproximadamente 1:2,67. Estos valores se multiplican por symbol_info.point, lo que los adapta automáticamente al instrumento concreto. Para EURUSD, con point = 0,00001, esto implica un stop-loss de 300 pips y un take-profit de 800 pips.
RandomUnderSampler resuelve el problema del desequilibrio entre clases de forma radical: elimina ejemplos aleatorios de la clase mayoritaria hasta alcanzar el equilibrio. En los datos financieros, los periodos «sin una señal clara» siempre son más numerosos que las oportunidades de trading bien definidas. Sin balanceo, el modelo aprenderá a predecir «sin señal» en el 90 % de los casos y será formalmente preciso, pero en la práctica resultará inútil.
Generación de características y clustering mediante modelos de mezcla gaussiana
Una vez creado el conjunto básico de indicadores técnicos, surge la siguiente pregunta: ¿cómo podemos extraer aún más información de los datos disponibles? La función generate_new_features resuelve esta tarea mediante la generación automática de características derivadas, utilizando combinaciones aleatorias de las ya existentes.
La filosofía de este enfoque es sencilla, pero potente: si dos características por separado contienen información útil, sus combinaciones matemáticas pueden revelar patrones ocultos. Imagina que un indicador muestra la fuerza de la tendencia y otro, su solidez. Su producto puede poner de manifiesto los momentos en los que una tendencia fuerte se vuelve inestable.
def generate_new_features(
    data: pd.DataFrame,
    num_features: int = 10,
    random_seed: int = 1
) -> pd.DataFrame:
    random.seed(random_seed)
    new_features: Dict[str, pd.Series] = {}

    columns = data.columns
    for i in range(num_features):
        feature_name = f'feature_{i}'
        col1_idx, col2_idx = random.sample(range(len(columns)), 2)
        col1, col2 = columns[col1_idx], columns[col2_idx]
        operation = random.choice([
            'add', 'subtract', 'multiply', 'divide',
            'shift', 'rolling_mean', 'rolling_std',
            'rolling_max', 'rolling_min', 'rolling_sum'
        ])
La aleatoriedad en la elección de las columnas y las operaciones puede parecer caótica, pero garantiza la diversidad. Un enfoque determinista podría pasar por alto combinaciones que, aunque no sean evidentes, resultan útiles. La operación de división requiere especial precaución: añadimos un pequeño valor, 1e-8, al denominador para evitar la división por cero.
elif operation == 'divide':
            new_features[feature_name] = (data[col1] / (data[col2] + 1e-8)).astype(np.float32)
        elif operation == 'shift':
            shift = random.randint(1, 10)
            new_features[feature_name] = data[col1].shift(shift).fillna(method='ffill').fillna(method='bfill').astype(np.float32)
Las operaciones de desplazamiento generan características rezagadas con una profundidad aleatoria de entre 1 y 10 periodos. Esto permite que el modelo «recuerde» el pasado en distintos horizontes temporales. Las estadísticas móviles añaden versiones suavizadas de las características originales, lo que puede revelar tendencias a largo plazo ocultas entre el ruido a corto plazo.
La siguiente etapa consiste en el clustering de características mediante modelos de mezcla gaussiana. Es una de las piezas más elegantes de nuestro sistema. El modelo GMM parte de la hipótesis de que los datos se generan a partir de una combinación de varias distribuciones normales. En el contexto de los mercados financieros, esto significa una división en distintos regímenes: mercado alcista, mercado bajista, movimiento lateral, alta volatilidad y baja volatilidad.
def cluster_features_by_gmm(
    data: pd.DataFrame,
    n_components: int = 6
) -> pd.DataFrame:
    X = data.drop(['label', 'labels'], axis=1, errors='ignore').astype(np.float32)
    X = X.replace([np.inf, -np.inf], np.nan).fillna(X.median(numeric_only=True))

    gmm = GaussianMixture(
        n_components=n_components,
        covariance_type='full',
        reg_covar=0.1,
        random_state=1
    )
    gmm.fit(X)
    data['cluster'] = gmm.predict(X).astype(np.int16)
    return data
Se ha elegido el parámetro n_components = 6 como término medio entre el nivel de detalle y la facilidad de interpretación. Si hay muy pocos clústeres, se pierden los matices; si hay demasiados, se produce sobreajuste e inestabilidad. Los seis clústeres permiten identificar los principales regímenes del mercado: tendencia alcista fuerte, tendencia alcista débil, movimiento lateral con baja volatilidad, movimiento lateral con alta volatilidad, tendencia bajista débil y tendencia bajista fuerte.
El parámetro covariance_type='full' permite que el GMM modele las correlaciones entre las características. Esto es de vital importancia en el ámbito financiero, donde las características rara vez son independientes entre sí. El RSI y el MACD pueden comportarse de forma diferente en distintas condiciones de mercado, y la matriz de covarianza completa tiene esto en cuenta.
La regularización de la covarianza (reg_covar=0.1) evita que el modelo degenere en los casos en que los datos presentan una dependencia casi lineal. En los datos financieros, este tipo de situaciones se dan con frecuencia, por ejemplo, cuando varios indicadores muestran al mismo tiempo valores extremos.
La pertenencia a un clúster se convierte en una nueva y potente característica. El modelo de aprendizaje automático obtiene información no solo sobre los valores concretos de los indicadores, sino también sobre a qué régimen de mercado corresponde la situación actual. Esto aporta información contextual que puede cambiar radicalmente la interpretación de otras características.
Eliminación recursiva de características y entrenamiento de XGBoost con ensamblado de modelos
Al disponer de decenas de indicadores técnicos, características generadas y etiquetas de clústeres, nos enfrentamos al clásico problema de la «maldición de la dimensionalidad». Tener más características no siempre significa obtener un modelo mejor. Por el contrario, las características redundantes y correlacionadas pueden provocar un sobreajuste y una disminución de la capacidad de generalización.
La función feature_engineering resuelve este dilema mediante la eliminación recursiva de características con validación cruzada (RFECV). Este método funciona como un trader experimentado que va descartando poco a poco los indicadores innecesarios de su arsenal, quedándose solo con los más informativos.
def feature_engineering(
    data: pd.DataFrame,
    n_features_to_select: int = 15
) -> pd.DataFrame:
    X = data.drop(['label', 'labels'], axis=1, errors='ignore').astype(np.float32)
    y = data['labels'].astype(np.int8)
    X = X.replace([np.inf, -np.inf], np.nan).fillna(X.median(numeric_only=True))

    unique_classes = y.unique()
    if len(unique_classes) < 2:
        log(f"Error in feature_engineering: Only one class found in labels: {unique_classes}")
        raise ValueError(f"The target 'y' needs to have more than 1 class. Got {len(unique_classes)} class instead")

    clf = RandomForestClassifier(n_estimators=100, random_state=1)
    rfecv = RFECV(
        estimator=clf,
        step=1,
        cv=5,
        scoring='accuracy',
        n_jobs=1,
        verbose=1,
        min_features_to_select=n_features_to_select
    )
    rfecv.fit(X, y)
El RFECV funciona de forma iterativa: comienza con todas las características, entrena el modelo, determina la importancia de cada característica, elimina la menos importante y repite el proceso. El parámetro step=1 significa que en cada iteración solo se elimina una característica: lentamente, pero con precisión. Una alternativa podría ser establecer step=5 para acelerar el proceso, pero en el ámbito financiero el coste de un error es demasiado elevado.
La elección de RandomForestClassifier como estimador base no es casual. Un bosque aleatorio funciona bien con características heterogéneas y es resistente a los valores atípicos. Sus feature_importances_ se basan en la reducción de la impureza de Gini, lo que proporciona una métrica de importancia intuitiva.
selected_features = X.columns[rfecv.get_support()]
    selected_data = data[selected_features.tolist() + ['label', 'labels']]
    log("\nBest features:")
    log(str(pd.DataFrame({'Feature': selected_features})))
    return selected_data
Pasemos ahora al núcleo de nuestro sistema: el entrenamiento de XGBoost con ensamblado de modelos. XGBoost destaca por su eficacia en problemas financieros, gracias a su capacidad para modelar interacciones no lineales entre las características y a su resistencia al sobreajuste.
def train_xgboost_classifier(
    data: pd.DataFrame,
    num_boost_rounds: int = 500
) -> BaggingClassifier:
    if data.empty:
        raise ValueError("Data should not be empty")

    X = data.drop(['label', 'labels'], axis=1).astype(np.float32)
    y = data['labels'].astype(np.int8)

    clf = xgb.XGBClassifier(
        objective='binary:logistic',
        random_state=1,
        max_depth=5,
        learning_rate=0.2,
        n_estimators=300,
        subsample=0.01,
        colsample_bytree=0.1,
        reg_alpha=1,
        reg_lambda=1
    )
Los parámetros de XGBoost se han seleccionado para trabajar con datos financieros: max_depth=5 limita la profundidad de los árboles, lo que evita el sobreajuste con datos ruidosos; learning_rate=0.2 garantiza un aprendizaje lo suficientemente rápido sin perder estabilidad. Los parámetros de regularización son fundamentales: subsample=0.01 significa que cada árbol se entrena únicamente con el 1 % de los datos, lo que reduce drásticamente el sobreajuste; colsample_bytree=0.1 indica que cada árbol utiliza solo el 10 % de las características. Puede parecer extremo, pero, combinado con un gran número de árboles (n_estimators=300), da lugar a un potente ensamblado de modelos con diversos aprendices débiles.
bagging_clf = BaggingClassifier(estimator=clf, random_state=1)
    param_grid = {
        'n_estimators': [10, 20, 30],
        'max_samples': [0.5, 0.7, 1.0],
        'max_features': [0.5, 0.7, 1.0]
    }

    grid_search = GridSearchCV(bagging_clf, param_grid, cv=5, scoring='accuracy')
    grid_search.fit(X, y)
    accuracy = grid_search.best_score_
    log(f"Average cross-validation accuracy: {accuracy:.2f}")
    return grid_search.best_estimator_
Sí, se me había olvidado añadirlo: BaggingClassifier añade otro nivel de ensamblado de modelos sobre XGBoost. Creamos un metaensamble: cada elemento ya es un ensamble de gradient boosting, y el bagging combina varios modelos XGBoost de este tipo. Este ensamblado de modelos en dos niveles garantiza una resistencia excepcional al sobreajuste.
GridSearchCV selecciona automáticamente los parámetros óptimos de bagging mediante validación cruzada; max_samples controla qué proporción de datos se utiliza para entrenar cada modelo del ensamble; max_features determina la proporción de características a las que tiene acceso cada modelo. La combinación de estos parámetros aporta diversidad al ensamble, lo cual es la clave de su eficacia.
Gestión del riesgo de cartera y cálculo dinámico del tamaño de las posiciones
Imagina la siguiente situación: tu robot obtiene excelentes resultados en cada instrumento por separado, pero al poner en marcha la cartera se produce una catástrofe. La razón es sencilla: la falta de coordinación entre las distintas posiciones. Cinco operaciones simultáneas de 1 lote cada una, en un contexto de alta correlación entre los pares de divisas, pueden suponer un riesgo equivalente al de una posición de 5 lotes.
La función calculate_portfolio_position_sizes revoluciona el enfoque de la gestión del riesgo. En lugar de utilizar tamaños fijos para las posiciones, los calculamos de forma dinámica, basándonos en la volatilidad actual de cada instrumento y en el límite total de riesgo de la cartera.
def calculate_portfolio_position_sizes(symbols: List[str]) -> None:
    global POSITION_SIZES

    if not mt5.initialize(path=TERMINAL_PATH):
        log("Error de conexión al terminal para el cálculo de posiciones")
        return

    try:
        symbol_risks = {}
        for symbol in symbols:
            symbol_info = mt5.symbol_info(symbol)
            if symbol_info is None:
                continue

            # Obtenemos el ATR de los últimos 14 días
            rates = mt5.copy_rates_from_pos(symbol, mt5.TIMEFRAME_D1, 0, 20)
            if rates is None or len(rates) < 14:
                continue

            df = pd.DataFrame(rates)
            df['tr'] = np.maximum(df['high'] - df['low'],
                                 np.maximum(abs(df['high'] - df['close'].shift(1)),
                                           abs(df['low'] - df['close'].shift(1))))
            atr = df['tr'].rolling(14).mean().iloc[-1]

            # Riesgo por lote estándar
            risk_per_lot = (atr / symbol_info.point) * symbol_info.trade_tick_value
            symbol_risks[symbol] = risk_per_lot
El ATR (Average True Range) constituye la base de nuestro sistema de gestión del riesgo. Este indicador mide la volatilidad media del instrumento durante 14 días, teniendo en cuenta no solo las oscilaciones diarias, sino también los gaps entre el cierre y la apertura. El True Range de cada día se calcula como el máximo de tres valores: la diferencia entre el máximo y el mínimo del día, la diferencia entre el máximo y el cierre anterior, y la diferencia entre el cierre anterior y el mínimo del día.
La fórmula risk_per_lot = (atr / symbol_info.point) * symbol_info.trade_tick_value convierte la volatilidad a términos monetarios. Si el ATR de EURUSD es de 0,00080 (80 pips), el riesgo de un lote estándar será de 80 dólares si el valor de un pip es de 1 dólar.
# Riesgo por instrumento
        risk_per_instrument = TOTAL_PORTFOLIO_RISK / len(symbols)

        # Calculamos los tamaños de las posiciones
        for symbol, risk_per_lot in symbol_risks.items():
            symbol_info = mt5.symbol_info(symbol)
            base_size = risk_per_instrument / risk_per_lot

            # Normalizamos según los requisitos del bróker
            min_lot = symbol_info.volume_min
            lot_step = symbol_info.volume_step
            normalized_size = max(min_lot, round(base_size / lot_step) * lot_step)

            POSITION_SIZES[symbol] = normalized_size
            SYMBOL_TRADES[symbol] = False

            log(f"{symbol}: lote={normalized_size:.3f}, riesgo={normalized_size * risk_per_lot:.2f}")
La distribución uniforme del riesgo entre los instrumentos (risk_per_instrument = TOTAL_PORTFOLIO_RISK / len(symbols)) puede parecer simplista, pero garantiza que la cartera esté equilibrada. Si TOTAL_PORTFOLIO_RISK es igual a 500 dólares y hay cinco pares de divisas, a cada instrumento se le asigna un límite de riesgo de 100 dólares.
Normalizar el tamaño de la posición según los requisitos del bróker es fundamental. Los brókers reales tienen restricciones: un lote mínimo (normalmente 0,01) y un paso de variación del lote (normalmente 0,01). La función round(base_size / lot_step) * lot_step redondea el tamaño calculado al valor admisible más cercano.
El sistema de banderas SYMBOL_TRADES evita que se abran varias posiciones en un mismo instrumento. Esto es especialmente importante en un entorno multiflujo, en el que cada flujo puede recibir una señal de trading de forma independiente.
def check_and_update_position_flags() -> None:
    global SYMBOL_TRADES

    if not mt5.initialize(path=TERMINAL_PATH):
        return

    try:
        positions = mt5.positions_get()
        if positions is None:
            positions = []

        open_symbols = set()
        for pos in positions:
            if pos.magic == 123456:  # Nuestro magic number
                open_symbols.add(pos.symbol)

        # Restablecemos las banderas de los símbolos sin posiciones abiertas
        for symbol in list(SYMBOL_TRADES.keys()):
            if symbol not in open_symbols and SYMBOL_TRADES[symbol]:
                SYMBOL_TRADES[symbol] = False
                log(f"Bandera reseteada {symbol} - posición cerrada")
La función check_and_update_position_flags garantiza la sincronización entre el estado interno del robot y las posiciones reales en el terminal. Una posición puede cerrarse manualmente por parte del trader, por stop-loss o por take-profit. Sin una comprobación periódica, el robot puede «pensar» que la posición sigue abierta y perder nuevas oportunidades de trading.
El magic number 123456 sirve para identificar nuestras posiciones entre otros robots de trading u operaciones manuales. Esto garantiza que solo gestionemos aquellas posiciones que hayamos abierto nosotros mismos.
Lógica de trading y ejecución de órdenes en tiempo real
El momento de la verdad de cualquier robot de trading llega cuando se ejecutan las órdenes. Todas las etapas anteriores —la recopilación de datos, la creación de características y el entrenamiento de los modelos— tienen un único objetivo: tomar la decisión de «comprar», «vender» o «esperar». La función online_trading convierte estas decisiones en posiciones reales en el mercado.
def online_trading(
    symbol: str,
    features: np.ndarray,
    model: Any
) -> Optional[Any]:
    global SYMBOL_TRADES, POSITION_SIZES

    # Comprobamos y actualizamos las banderas de las posiciones
    check_and_update_position_flags()

    if not mt5.initialize(path=TERMINAL_PATH):
        log("Error: Failed to connect to MetaTrader 5 terminal")
        return None

    # Comprobamos si ya hay una posición abierta para este símbolo
    if SYMBOL_TRADES.get(symbol, False):
        log(f"Posición de {symbol} ya abierta")
        mt5.shutdown()
        return None

    # Obtenemos el tamaño de la posición a partir del cálculo de la cartera
    volume = POSITION_SIZES.get(symbol, 0.1)
Las primeras líneas de la función son un ejemplo de programación defensiva. La comprobación de las banderas de posición evita la duplicación de operaciones. La inicialización del terminal puede fallar inesperadamente debido a problemas de red o a un reinicio del terminal. La obtención del volumen a partir de los POSITION_SIZES precalculados garantiza la conformidad con la estrategia general de gestión del riesgo.
El ciclo de búsqueda de información sobre el instrumento merece una atención especial. En las operaciones reales, symbol_info puede devolver temporalmente None debido a problemas de conexión con el servidor del bróker. En lugar de fallar de inmediato, el robot realiza hasta 30 000 intentos con intervalos de 5 segundos.
attempts: int = 30000
    symbol_info = None
    for _ in range(attempts):
        symbol_info = mt5.symbol_info(symbol)
        if symbol_info is not None:
            break
        log(f"Error: Instrument not found. Attempt {_ + 1} of {attempts}")
        time.sleep(5)

    if symbol_info is None:
        mt5.shutdown()
        return None

    tick = mt5.symbol_info_tick(symbol)
    price_bid: float = tick.bid
    price_ask: float = tick.ask
    signal = model.predict(features)
    positions_total: int = mt5.positions_total()
30 000 intentos pueden parecer excesivos, pero en el contexto del trading algorítmico esto supone aproximadamente 41 horas de intentos ininterrumpidos. Los mercados funcionan las 24 horas del día, y los problemas técnicos puntuales no deben hacer que se pierdan oportunidades de trading.
La lógica de toma de decisiones de trading es elegante en su sencillez. El modelo devuelve una probabilidad, y utilizamos un umbral de 0,5 para distinguir entre compras y ventas. La comprobación adicional positions_total < MAX_OPEN_TRADES evita un apalancamiento excesivo.
request = None
    if positions_total < MAX_OPEN_TRADES and signal[-1] > 0.5:
        request = {
            "action": mt5.TRADE_ACTION_DEAL,
            "symbol": symbol,
            "volume": volume,
            "type": mt5.ORDER_TYPE_BUY,
            "price": price_ask,
            "sl": price_ask - 50 * symbol_info.point,
            "tp": price_ask + 100 * symbol_info.point,
            "deviation": 20,
            "magic": 123456,
            "comment": "Portfolio Buy",
            "type_time": mt5.ORDER_TIME_GTC,
            "type_filling": mt5.ORDER_FILLING_FOK,
        }
La estructura de una solicitud de trading incluye numerosos parámetros de importancia crítica. TRADE_ACTION_DEAL significa ejecución inmediata al precio de mercado. ORDER_TYPE_BUY/SELL determina la dirección. Un stop-loss de 50 puntos y un take-profit de 100 puntos crean una relación riesgo/beneficio de 1:2.
El parámetro deviation=20 permite al bróker ejecutar una orden con una desviación de hasta 20 puntos respecto al precio solicitado. En mercados de movimiento rápido, esto evita que se rechacen las órdenes debido a variaciones microscópicas del precio entre el momento en que se recibe la cotización y el momento en que se envía la orden.
ORDER_TIME_GTC (Good Till Cancelled) significa que la orden permanece vigente hasta que se cancele. ORDER_FILLING_FOK (Fill Or Kill) exige la ejecución completa de la orden o su rechazo; no se admite la ejecución parcial.
for _ in range(attempts):
        result = mt5.order_send(request)
        if result.retcode == mt5.TRADE_RETCODE_DONE:
            # Se marca que hay una posición abierta para este símbolo
            SYMBOL_TRADES[symbol] = True
            log(f"Posición abierta {symbol}: {'Buy' if signal[-1] > 0.5 else 'Sell'}, lote={volume}")
            mt5.shutdown()
            return result.order
        log(f"Error: Trade request not executed, retcode={result.retcode}. Attempt {_ + 1}/{attempts}")
        time.sleep(3)
El ciclo de ejecución de la orden también utiliza múltiples intentos. TRADE_RETCODE_DONE indica una ejecución correcta. Otros códigos pueden indicar falta de fondos, problemas de liquidez o fallos técnicos. Los intervalos de 3 segundos entre cada intento dan tiempo al mercado para estabilizarse.
Establecer la bandera SYMBOL_TRADES[symbol] = True tras una ejecución correcta es fundamental para evitar la duplicación de posiciones en un entorno multiflujo. El registro con indicación de la dirección de la posición y del volumen garantiza la trazabilidad completa de la actividad de trading.
Arquitectura multiflujo y coordinación de flujos
Imagine una orquesta en la que cada músico toca su parte, pero todos siguen las indicaciones de un único director. Nuestra arquitectura multiflujo funciona según el mismo principio: cada flujo procesa su propio instrumento de divisas de forma independiente, pero todos se coordinan a través de variables y funciones globales compartidas.
La función process_symbol se convierte en el componente principal de ejecución de cada flujo. Encapsula todo el ciclo de vida del procesamiento de un instrumento: desde la obtención de datos históricos hasta el ciclo infinito de trading en tiempo real.
def process_symbol(symbol: str) -> None:
    global all_symbols_done
    try:
        raw_data = retrieve_data(symbol)
        if raw_data is None:
            log(f"Data not found for symbol {symbol}")
            return

        labeled_data_engineered = process_data(raw_data)
        train_data = labeled_data_engineered[labeled_data_engineered.index <= FORWARD]
        test_data = labeled_data_engineered[labeled_data_engineered.index > FORWARD]

        if train_data.empty or len(train_data['labels'].unique()) < 2:
            log(f"Skipping symbol {symbol}: Insufficient data or single class in labels")
            return

        xgb_clf = train_xgboost_classifier(train_data, num_boost_rounds=1000)
        test_features = test_data.drop(['label', 'labels'], axis=1)
        test_labels = test_data['labels']
        accuracy = evaluate_xgboost_classifier(xgb_clf, test_features, test_labels)
        log(f"Accuracy for symbol {symbol}: {accuracy * 100:.2f}%")
La división de los datos en muestras de entrenamiento y de prueba según criterios temporales es de vital importancia en el ámbito financiero. El límite FORWARD = datetime(2025, 1, 1) significa que el modelo se entrena con datos hasta el año 2025 y se evalúa con datos posteriores. Esto simula condiciones reales, en las que el modelo debe predecir el futuro basándose en el pasado.
La comprobación len(train_data['labels'].unique()) < 2 evita que se intente entrenar con datos que contengan una sola clase. En periodos de baja volatilidad, todos los ejemplos pueden recibir la etiqueta «sin señal», lo que hace imposible el entrenamiento.
El ciclo de trading infinito comienza una vez que el modelo se ha entrenado con éxito:
features = test_features.values
        position_id = None
        while not all_symbols_done:
            position_id = online_trading(symbol, features, xgb_clf)
            time.sleep(6)

        all_symbols_done = True
    except Exception as e:
        log(f"Error processing symbol {symbol}: {e}")
La variable global all_symbols_done sirve como mecanismo para finalizar de forma elegante todos los flujos. Cualquier flujo puede establecer esta bandera en `True`, señalando a los demás que deben finalizar. Esto puede ocurrir por diversas razones: un error crítico, alcanzar el límite diario de pérdidas o un comando del usuario.
El intervalo `time.sleep(6)` entre ciclos de trading se ha elegido como un compromiso entre la capacidad de respuesta y la carga del sistema. Los intervalos demasiado cortos generan una carga excesiva sobre la API del bróker y pueden provocar un bloqueo; los demasiado largos, en cambio, pueden hacer que se pierdan oportunidades de trading.
La función principal coordina la creación y la finalización de los flujos:
if __name__ == "__main__":
    symbols = ["EURUSD", "GBPUSD", "AUDUSD", "NZDUSD", "USDCAD"]

    # En primer lugar, calculamos los tamaños de las posiciones para toda la cartera
    calculate_portfolio_position_sizes(symbols)

    threads = []
    for symbol in symbols:
        thread = threading.Thread(target=process_symbol, args=(symbol,))
        thread.start()
        threads.append(thread)

    for thread in threads:
        thread.join()

    log_queue.put(None)
La llamada a `calculate_portfolio_position_sizes(symbols)` antes de iniciar los flujos garantiza que todos los tamaños de las posiciones se calculen y estén disponibles en `POSITION_SIZES` antes de que comience el trading. Esto evita situaciones en las que el flujo intenta operar con un tamaño de posición indefinido.
El método `thread.join()` para cada flujo garantiza la finalización correcta del programa. El flujo principal espera a que finalicen todos los flujos secundarios antes de finalizar él mismo. La llamada final a `log_queue.put(None)` señala al flujo de logging que debe finalizar.
La elección de estos pares de divisas concretos ["EURUSD", "GBPUSD", "AUDUSD", "NZDUSD", "USDCAD"] no es casual. Todos los pares incluyen el dólar estadounidense como divisa base o divisa cotizada, lo que proporciona cierta correlación, pero también suficiente variedad para diversificar los riesgos.
La arquitectura ofrece una solución elegante a un problema clásico de la programación paralela: cómo garantizar la independencia de los flujos cuando es necesario coordinarlos. Las variables globales `POSITION_SIZES`, `SYMBOL_TRADES` y `all_symbols_done` sirven como canales de comunicación entre flujos, mientras que el sistema de logging mediante cola evita conflictos al mostrar mensajes de forma simultánea.
El manejo de excepciones en cada flujo es de vital importancia. Una excepción no gestionada en un flujo no debería provocar la caída de todo el sistema. Cada flujo «muere con dignidad», registrando el error y liberando recursos.
Pruebas del sistema y planes ambiciosos de desarrollo
La función actual `test_model` muestra un enfoque básico para la validación de estrategias de trading, simulando el P&L sobre datos históricos y teniendo en cuenta el `markup` y los horizontes temporales de salida:
def test_model(
    model: Any,
    X_test: pd.DataFrame,
    y_test: pd.Series,
    markup: float,
    initial_balance: float = 10000.0,
    point_cost: float = 0.00001
) -> None:
    balance = initial_balance
    trades = 0
    profits = []

    predicted_labels = model.predict(X_test.values)
    close = X_test['close'].values

    for i in range(len(predicted_labels) - 10):
        entry_price = close[i]
        exit_price = close[i + 10]
        # Lógica de trading detallada teniendo en cuenta la dirección y el markup
        ...
    total_profit = balance - initial_balance
    log(f"Total accumulated profit or loss: {total_profit:.2f}")
Pero esto es solo el principio. El verdadero futuro del sistema pasa por un escalado radical y por dar un salto a un nivel cualitativamente nuevo.
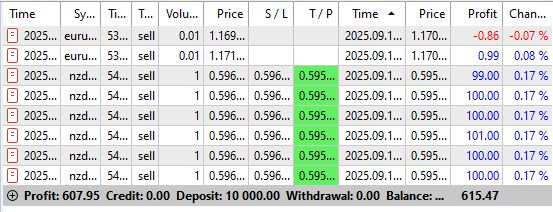
Por el momento, la precisión del sistema en el tramo out-of-sample es de alrededor del 64-65 %, mientras que la ganancia media es muy superior a la pérdida media.
Esto es lo que he conseguido en unos días de trading:
Las simulaciones de rentabilidad con una tasa de aciertos y un riesgo determinados para la cartera de posiciones y para una posición por separado también resultan muy alentadoras:
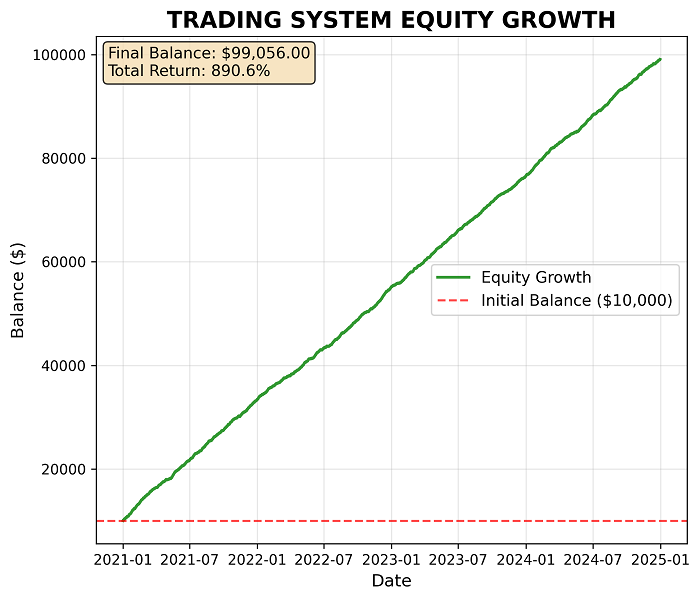
Sin embargo, no me fío mucho de los testers caseros en Python, por lo que tendré que probar el sistema durante bastante tiempo en trading real o reescribir la lógica en MQL5 para acceder a un potente tester de estrategias con una base de ticks reales y emulación de recotizaciones.
Migración completa a MQL5: una revolución arquitectónica
La arquitectura híbrida Python-MetaTrader 5 presenta limitaciones fundamentales de velocidad. La migración completa a MQL5 requerirá la creación de bibliotecas propias de aprendizaje automático. Entre los módulos clave se incluyen operaciones matriciales de alto rendimiento para XGBoost, una implementación de boosting por gradiente con optimización nativa para la arquitectura x64 y una versión adaptada de Gaussian Mixture Models para clustering de características. Se trata de una tarea técnicamente compleja, pero eliminará todos los retrasos de la API y supondrá un aumento del rendimiento de entre 10 y 50 veces.
Interfaz gráfica de nueva generaciónSe prevé la creación de un sistema GUI completo en tiempo real con arquitectura modular. El dashboard mostrará las posiciones actuales de todos los instrumentos, el P&L en tiempo real, el uso de los límites de riesgo y el estado de cada flujo de trading. El módulo de gestión dinámica de parámetros será de vital importancia: permitirá modificar TOTAL_PORTFOLIO_RISK, los umbrales del modelo y los horizontes temporales sin necesidad de reiniciar el sistema. El sistema de alertas incluirá notificaciones sobre la superación de los límites diarios de pérdidas, señales anómalas de los modelos y la pérdida de conexión con el bróker.
Gestor de riesgos de nivel superior: un salto cuántico en la gestión de carterasEl sistema actual de gestión de riesgos parece rudimentario en comparación con el previsto. El nuevo gestor de riesgos analizará las correlaciones entre instrumentos en tiempo real utilizando ventanas móviles de distintas longitudes. Los cálculos de Value-at-Risk (VaR) basados en simulaciones de Monte Carlo permitirán predecir las pérdidas potenciales de la cartera con distintos niveles de probabilidad. El sistema de cobertura dinámica abrirá automáticamente posiciones compensatorias cuando se superen los riesgos de correlación.
Aprendizaje multiflujo: un ejército de modelosLa transición al entrenamiento masivamente paralelo de modelos supondrá una auténtica revolución. Cada flujo de CPU probará diferentes combinaciones de hiperparámetros de XGBoost, periodos de entrenamiento y conjuntos de características. El sistema seleccionará automáticamente el mejor modelo para cada periodo temporal basándose en los resultados fuera de muestra. El ensamblado de modelos con Random Forest, SVM, redes neuronales y LightGBM dará lugar a un metamodelo que superará a cualquier implementación individual.
GAN para generar conjuntos de datos de 25 años: historia sintética de los mercadosEl plan más ambicioso consiste en utilizar redes generativas antagónicas (GAN) para crear series de precios sintéticas de 25 años de los principales pares de divisas. La GAN se entrenará con datos históricos reales y, a continuación, generará enormes conjuntos de datos que conserven las propiedades estadísticas de los mercados reales: clustering de volatilidad, colas gruesas en las distribuciones y autocorrelaciones. Esto resolverá el problema de la falta de datos para el aprendizaje profundo.
Ensamble de 100 modelos especializados: segmentación del espacio temporal y de precioEl punto culminante será la creación de un ensamble formado por 100 modelos, en el que cada uno se encargará de su propio «segmento» de condiciones de mercado. Cada modelo se entrenará con datos de un régimen concreto: alta volatilidad, movimiento lateral, tendencias marcadas, periodos de noticias y sesiones previas a días festivos. Estos regímenes se pueden obtener, por ejemplo, mediante clustering de características, el uso de cadenas de Markov o SSM. BaggingClassifier aportará una mayor estabilidad a cada modelo. El metaclasificador determinará con una precisión extremadamente alta el régimen de mercado actual y activará los modelos especializados correspondientes. Esta arquitectura permitirá alcanzar una precisión sin precedentes en las predicciones, adaptándose a cualquier condición de mercado en tiempo real.
Integración con Google Cloud Platform: la potencia de cálculo de superordenadores de 1.000 núcleosLos recursos informáticos locales se convierten en un cuello de botella a la hora de llevar a cabo planes tan ambiciosos. Google Cloud Platform ofrece una solución mediante la integración directa con la API de Python. La biblioteca google-cloud-compute permite crear mediante programación máquinas virtuales con cientos de núcleos de CPU y terabytes de memoria para el entrenamiento paralelo de modelos.
from google.cloud import compute_v1
from google.cloud import storage

# Creación de un clúster de alto rendimiento
instance_client = compute_v1.InstancesClient()
operation = instance_client.insert(
    project="trading-ai-project",
    zone="us-central1-a",
    instance_resource={
        "name": "trading-cluster-node",
        "machine_type": "zones/us-central1-a/machineTypes/c2-standard-60",
        "scheduling": {"preemptible": True}  # Reducción del coste por un factor de 5
    }
)
AI Platform Training permite ejecutar el entrenamiento distribuido de XGBoost y redes neuronales en decenas de máquinas a la vez. Cloud Storage permite almacenar petabytes de datos históricos con acceso inmediato. BigQuery ML se integra directamente con los algoritmos de trading para analizar patrones en tiempo real.
Una ventaja clave es el autoescalado de los recursos computacionales. Durante los periodos de reentrenamiento de los modelos, el sistema pone en marcha automáticamente cientos de instancias, mientras que en los periodos de menor actividad las reduce al mínimo, optimizando así los gastos. Las instancias preemptibles reducen el coste de los cálculos a una quinta parte, lo que hace que el entrenamiento de nuestros futuros modelos extremadamente complejos resulte económicamente viable.
Conclusión
En este artículo hemos dado los primeros pasos para crear un robot de trading multiflujo utilizando métodos de aprendizaje automático. La arquitectura analizada abarca todo el proceso, desde la recopilación y el aumento de datos hasta la generación de características, el clustering, el entrenamiento de modelos XGBoost y la integración de la gestión de riesgos de cartera. Hemos podido comprobar cómo la división de funciones entre Python y MetaTrader 5 permite aprovechar lo mejor de ambos entornos: la flexibilidad y el amplio ecosistema de bibliotecas de Python para el aprendizaje automático, y la fiabilidad de MetaTrader 5 para ejecutar decisiones de trading en tiempo real.
Sin embargo, esta es solo la primera parte de una serie de artículos. En las próximas publicaciones tengo previsto abordar temas como la migración del sistema a MQL5, el desarrollo de la interfaz gráfica, la integración con servicios en la nube, el uso de GAN para generar conjuntos de datos sintéticos y la construcción de ensambles de modelos especializados. Estas medidas permitirán ampliar considerablemente el alcance y mejorar la eficacia del robot de trading, allanando el camino para su plena implementación.
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19577
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Utilizando redes neuronales en MetaTrader
 Red neuronal en la práctica: Descenso de gradiente estocástico
 Particularidades del trabajo con números del tipo double en MQL4
 Del nivel básico al intermedio: Indicadores técnicos (II)

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso
¡Un artículo excelente! Muchas gracias por publicarlo. ¡Estoy deseando leer el próximo!