

取引におけるニューラルネットワーク:クロスドメイン時系列予測フレームワーク「TimeFound」
 24
 4

はじめに
時系列予測は、長年にわたり金融アナリストにとって欠かせないツールとなっています。 株価が今後どのように推移するのか、あるいは金融指数のボラティリティがどのように変化するのかを予測しようとしたことがあれば、それがまるで茶葉占いをしているようなものだということをよくご存じでしょう。 とはいえ、こうした「占い」なしに生き残れる本格的なファンドはありません。
かつては、ARIMAや指数平滑法といった古典的な統計モデルが広く用いられていました。 考えてみれば、線形回帰でさえ役立つことが少なくありませんでした。 モデルはより単純であるべきだという主張も、深層ニューラルネットワークが登場するまでは説得力がありました。 今日では、深層ニューラルネットワークは単に成果を上げるだけではありません。テラバイト規模の過去データを処理する際の精度と速度で人々を驚かせ、大きな収穫をもたらしています。
しかし、どんな強力な武器にも弱点があるように、深層モデルにも欠点があります。 モデルを学習させるには、特定のタスクに対応するラベル付きデータが山ほど必要です。 これがなければ、ニューラルネットワークという「ビッグ・ブラザー」は機能しません。 では、過去データが限られている場合や、市場での取引が始まったばかりの場合はどうすればよいのでしょうか。 ブローカーの取引ターミナルに十分な過去データがまだ蓄積されていない新規発行トークンの価格を、どのように予測すればよいのでしょうか。 そこで登場するのがゼロショット予測という概念です。これは、従来の手法では対応できない状況でもモデルが予測をおこなえるようにするアプローチです。
時系列の研究者たちは、大規模言語モデル(Large Language Models)との類似点に着目してきました。LLMはすでにテキスト処理の分野で大きな成功を収めており、翻訳や詩の創作、質問への回答などをおこなっています。 そのアイデアを価格トレンドの予測にも応用できないでしょうか。 こうして、時系列向けのいわゆる基盤モデルのブームが始まりました。 想像してみてください。株価、電力消費量、失業率のいずれを予測する場合でも利用できる、単一の汎用モデルです。 重要なのは、多様なデータセットを用いて適切に学習させることです。
こうした汎用性の考え方に着想を得て、論文「TimeFound: A Foundation Model for Time Series Forecasting」の著者らは、時系列予測の基盤としてTransformerアーキテクチャを採用した新しいフレームワーク、TimeFoundを提案しました。 彼らはNLPの分野から優れたアイデアを取り入れ、時系列予測に応用しました。
TimeFoundフレームワークは、従来のエンコーダ・デコーダアーキテクチャを基盤としています。 エンコーダは過去のデータ系列を分析し、そこからコンテキストを抽出します。 一方、デコーダは因果関係を維持しながら、将来を見通す形で予測します。
このモデルは、時系列のパッチ化に対する新しいアプローチに基づいています。 固定されたウィンドウサイズにこだわる必要はありません。 このフレームワークの著者らは、シーケンスをサイズの異なる複数のパッチに同時に分割することを提案しています。 企業の株価の動きを分析していると想像してください。月次の変動は比較的均一である一方、日中の値動きには急激な変動が数多く見られます。マルチ解像度パッチ化を用いることで、長期的なトレンドと、ボラティリティに伴うノイズの両方を捉えることが可能になります。
事前学習のために、フレームワークの著者らは、複数のドメインにまたがる大規模なデータセットを構築しました。 モデルが汎用的なパターンを識別できるようになるには、こうした多様性が不可欠です。 データが多ければ多いほど、モデルが学習するパターンの語彙は豊かになります。
学習の目的は単純です。自己回帰予測です。 過去のデータをモデルに入力し、後続の値を段階的に予測するように学習させます。 ただし、この場合、予測のステップ幅は過去データの時間ステップ幅と異なる場合があります。 これは、モデルが結果をパッチの形式で出力するためです。 1つのパッチには、分析対象システムの複数の時間ステップが含まれる場合があります。
TimeFoundアルゴリズム
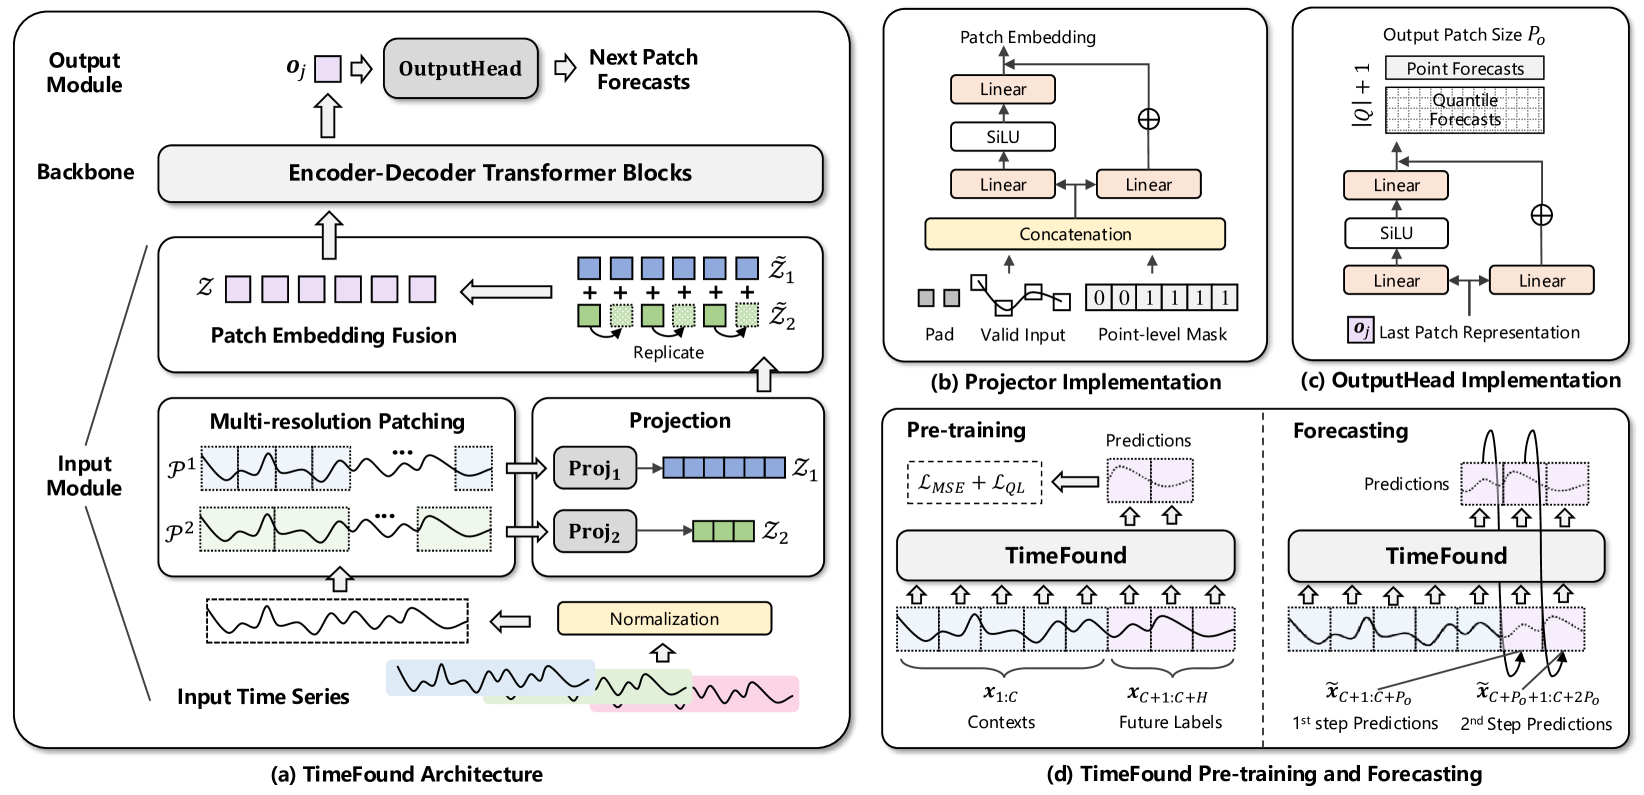
TimeFoundは、金融市場をはじめとするさまざまな分野で、予測システムを構築するための基盤となるよう設計された汎用モデルです。 このモデルは、モジュール式のデータ処理アプローチを採用したエンコーダ・デコーダ構造で構築されています。 正規化、マルチレベル・パッチ化、相対位置情報を用いた注意機構、および点予測損失と分位点損失を組み合わせた学習方式を採用しています。
このフレームワークのアルゴリズムは、入力時系列の入念な前処理から始まります。確かな基盤がなければ、予測の信頼性が損なわれるおそれがあるためです。 まず、データを比較可能な形式に整えます。具体的には、系列全体の平均値を各データ点から差し引き、その標準偏差で割る標準化によって、各時系列を正規化します。 この手法により、電力消費量が大幅に増加する場合と比較して、株式市場の値動きが小さな正弦波のように見える場合でも、モデルが混乱することはありません。逆に、微細な変動が重要な意味を持つ場合には、それらも検出できるようになります。
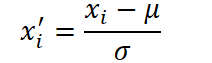
ここで、μおよびσは、それぞれ時系列Xの平均および標準偏差を表します。 この処理によって、時間的な構造を損なうことなく、データを同じ尺度に揃えることができます。
スケールの調整が完了したら、次に時系列をセグメント、すなわちパッチに分割します。 従来の手法では、すべてのパッチを同じサイズにします。しかし、同一の時系列には、急激なスパイクと緩やかなトレンドの両方が含まれる可能性があります。 そのため、TimeFoundフレームワークの著者らは、マルチスケール・パッチ化を提案しています。 最初のレベルでは、最も小さなスケールのパッチが生成されます。 このレベルでは、パッチの数が最も多くなります。 レベルが上がるにつれてパッチのサイズは大きくなり、それに応じてパッチの数は減少します。 フレームワークの著者らは、この研究において、サイズが2の冪乗となるパッチを使用しました。
このような各パッチは、ボラティリティの短期的な急上昇から長期間にわたる下落トレンドまで、時系列の動的な変化の一部分を捉えます。
次に、生成されたパッチにバイナリマスクを追加します。このマスクは、実際のデータが存在する位置と、パッチのサイズを統一するために追加されたパディング(埋め合わせのデータ)が存在する位置を区別します。 その後、時系列の各断片は、残差接続を備えた専用の2層パーセプトロンを通過します。 これらのMLP(多層パーセプトロン)プロジェクタは、長さの異なるパッチを、統一されたd次元の潜在空間に写像します。この潜在空間では、各ベクトルが、分析対象の時系列における局所的な挙動の特徴を表現します。
しかし、これですべての準備が整ったわけではありません。 前述のように、マルチスケール・パッチ化では、レベルごとに生成される要素の数が異なります。大きなブロックと比べて、小さなブロックは数倍多く生成されます。 これらを統合するために、フレームワークの著者らは、大きなパッチの表現を必要な回数だけ複製(レプリケーション)し、最小スケールのパッチ数に合わせることを提案しています。 その結果、すべてのスケールのベクトルが各時間ステップで整列した、マルチチャネル表現が得られます。 続いて、これらの特徴量を単一の潜在行列に統合します。 この行列が注意機構のブロックに入力され、異なるスケール間の相互作用が可能になります。
モデルの中核は、注意機構を改良したエンコーダ・デコーダ構造です。 エンコーダは、双方向注意を用いて、生成された系列を詳細に分析します。 つまり、各位置は、ほかのすべての位置を参照し、それぞれの位置の前後で事象がどのように展開したかを把握できます。そして、重み付けされた情報を統合することで、より深い表現を形成します。 同時に、この注意機構はパッチ間の相対位置関係も利用します。たとえば、モデルは直近の断片(3パッチ前など)を、遠く離れた断片(20パッチ前など)よりも重要な情報として捉え、それに応じて重みを割り当てます。
エンコーダの処理が完了すると、その結果はデコーダに渡されます。デコーダは将来の予測対象の実測値にアクセスすることができず、過去のデータだけを頼りに予測をおこなわなければなりません。 注意機構は、過去に生成された予測の集約によって許容される範囲を超えて、モデルが未来の情報を参照することを防ぎます。そのため、各予測は因果関係に沿った妥当なものとなります。ここで重要な役割を果たすのが、クロスアテンションです。 デコーダが次のパッチの表現を構築する際には、エンコーダが生成した豊富なコンテキストベクトルを再び参照し、そこから直近のトレンドに関する情報を抽出します。
デコーダの出力は、次のパッチに対する予測ベクトルです。これは、過去に起きた事象や重要な信号を簡潔に表現したものです。 このベクトルは、変換モジュールに渡されます。このモジュールは、残差接続を備えた2層のMLPとして実装されています。 ここでは、潜在表現が通常の時系列の数値に変換され、将来の複数時点の値が一度に生成されます。 このように予測をまとめて生成することで、モデルの処理速度が向上します。特に、長期の予測期間を扱う場合に効果的です。
モデルの学習において、フレームワークの著者らは、平均的な予測誤差の最小化だけに重点を置いているわけではありません。 予測値と実測値の差の二乗にペナルティを課す標準的なMSE損失に加え、モデルに不確実性を推定させるため、分位点損失も使用しています。 各時間ステップにおいて、モデルは平均値だけでなく、たとえば第10、第50、第90パーセンタイルといった複数の分位点も出力するように学習します。 MSE損失と分位点損失を組み合わせた複合損失関数により、予測精度と信頼区間の幅とのバランスを取ります。
このように、TimeFoundのアルゴリズム全体は、統合された、よく設計された処理パイプラインとなっています。 Transformerの能力に、マルチスケール・パッチ化の柔軟性と不確実性を捉える機能を組み合わせることで、幅広い時系列データに対応できるようにしています。
TimeFoundの事前学習にあたり、フレームワークの著者らは、さまざまな分野の実データと合成データを含む、大規模で多様なデータセットを構築しました。 公開されている時系列データを、5分間隔のデータから年次データまで、さまざまな頻度で収集しました。 使用されたデータには、金融市場のデータ(株価、通貨先物)、エネルギー消費量、気温、販売数量などが含まれています。 さらに、合成データを生成することで、データセットの多様性を高めました。 これにより、TimeFoundは時系列データの汎用的な表現を獲得し、新しいタスクに適用する際に追加のファインチューニングを行わなくても、高い汎化性能を発揮できるようになります。
以下に、TimeFoundフレームワークの著者らによる構成図を示します。
MQL5での実装
TimeFoundフレームワークの理論的側面を整理したところで、次はMQL5による実装に進みます。本記事では、フレームワークの著者らが提案した手法を独自に解釈し、実装していきます。 まず、コードの詳細に入る前に、処理全体の流れと各タスクの関係を整理しておきましょう。 最初におこなうのは入力データの準備です。この前処理の品質が、その後の予測精度を大きく左右します。
分析対象の時系列データを正規化するために、独自の仕組みを一から実装するのではなく、既存の正規化ブロック(バッチ正規化ベース)を利用します。 このモジュールは、蓄積された価格バッファを走査し、各ステップで平均値と分散を計算して、データ分布をリアルタイムで正規化します。これにより、市場環境の変化に伴う急激な分布の変化に対する感度を抑えます。 こうしたスライディング正規化によって、重要なパターンの動的な特徴を維持しながら、安定した学習や予測を妨げるデータのばらつきを抑制できます。
データのスケールを統一したら、次は重要な処理であるマルチスケール・パッチ化に取り組みます。 従来の逐次複製方式では、まず時系列を異なるサイズの断片に分割し、大きなベクトルを複製して小さなブロックの数に合わせた後、それらを再び結合します。 この方法は単純ですが、処理遅延の観点から問題があります。 新しいローソク足が到着するたびに複製処理が必要となり、貴重な計算時間を消費します。さらに、大きなスケールの埋め込み表現が繰り返し複製されるため、元の表現が持つ独自性も損なわれます。
そこで、本実装では別のアプローチを採用します。 ここで利用するのが、マルチウィンドウ畳み込みの概念です。 3つの独立した処理を行う代わりに、それぞれ異なるウィンドウサイズを持つ3つの畳み込み層のカーネルを並列に実行すると考えてください。 ゼロパディングとオーバーラップのおかげで、同じストライドを持つ畳み込みフィルタは、分析対象の時系列全体に沿って滑らかに移動し、同時に同じ長さの3つの特徴量配列を形成します。
このアプローチには、いくつもの利点があります。 第一に、すべての計算が同時に実行されます。小さなパッチの処理が完了するのを待ってから、大きなパッチのデータで補う必要はありません。 第二に、固定ストライドのスライディングウィンドウを使用するため、時系列の各新しい値は3つすべての変換に含まれ、位置合わせの問題が生じません。 出力テンソルは、最初から同じ時間インデックスに揃っています。 第三に、オーバーラップのおかげで、より大きなフィルターのウィンドウは隣接するセグメントを捉えることができます。そのため、単なる固定的なブロックではなく、緩やかなトレンドや平滑化された変動を検出しやすくなります。
同時に、手動で複製や補間をおこなう必要もありません。このアルゴリズムは、各時間ステップで同じ数の要素を維持し、統一された表現を保つためです。
その結果、必要な詳細度で市場の状況を捉えた、コンパクトなスナップショットが即座に得られます。これは、MLPプロジェクタの潜在空間へ投影する準備が整った表現です。
まさにこのような並列型のマルチスケール・パッチ化が、前処理モジュールの中核を成します。各スケールにおける埋め込み表現の独自性を維持し、冗長な複製を排除することで、自動売買ロボットはより迅速かつ正確に意思決定を行い、マイクロレベルの急激な変動と長期的なトレンドの両方に即座に対応できるようになります。
次に、得られた埋め込み表現を、情報量の豊富な特徴量へと変換します。 マルチウィンドウ畳み込みの後、各時間ステップには、指定された数のチャネルが埋め込み表現としてすでに存在しています。 しかし、深層モデルにとって、それだけでは十分ではありません。 真に表現力の高い表現を得るためには、非線形性と学習可能な結合の層を追加する必要があります。 オリジナルのTimeFoundでは、著者らは残差接続を備えた2層のMLPを提案しています。 しかし、本実装では、StockFormerフレームワークに用意されているマルチヘッド型のFeed-Forwardブロックを使用します。
異なるスケールの特徴量ストリームが3つあり、それぞれを共通の品質基準まで引き上げる必要があると想像してみてください。 このモジュールは、これらのストリームを独立したヘッドに分割し、各ヘッドをそれぞれ独自の重みとバイアスを用いて並列に処理します。 その後、すべての結果を再び1つのベクトルにまとめます。 残差接続によって、初期の埋め込み表現に関する情報が保持され、層の出力と滑らかに統合されます。これにより、学習の収束が改善され、データに含まれるノイズに対するモデルの堅牢性が高まります。
このFeed-Forwardブロックでは、各ヘッドは、層間に非線形変換を備えた2層のMLPとして構成されています。 MLPの出力は入力データに加算され、その後、正規化されます。 こうして得られる各時間ステップの最終ベクトルは、局所的なパターンとグローバルな特徴量を統合したものであり、次のモジュールに渡せる状態になります。
このアプローチにより、オリジナルのTimeFoundアーキテクチャとの概念的な整合性を維持しながら、StockFormerの実績ある最適化済みコンポーネントを活用できます。その結果、開発時間を短縮し、高いリアルタイム処理性能を確保できます。
マルチスケール特徴量の準備における最終段階では、それらの集約に取り組みます。ここでは、単純な加算方式に代わり、畳み込みと最大プーリングを組み合わせた、より柔軟な仕組みを採用します。 3つの埋め込みチャネルがあり、それぞれが市場で何が起きているのかを理解するための情報を提供していると想像してみてください。 これらのチャネルを要素ごとに加算すると、その時間区間における短期的なスパイクや長期的なトレンドの重要度にかかわらず、すべてに同じ重みが割り当てられます。 そこで、異なるスケールの値を学習可能なフィルタで分析し、最も情報量の多い組み合わせを特定する畳み込み処理を実行します。
畳み込み層が3チャネルのテンソル上を移動する際、各フィルタはすべてのスケールを一度に捉え、その中から特徴的なパターンを探し出します。 その結果、新しい特徴量の集合が得られ、それぞれが局所的な信号とグローバルな信号の組み合わせを反映します。 ここで、最大プーリングが効果を発揮します。最大プーリングは、得られた特徴量マップ上をスライドしながら、ノイズや重要でない変動を無視し、最も強い応答のみを保持します。 したがって、同じ時間区間内で、ミクロレベルでは出来高の急激なスパイクが記録される一方、マクロレベルでは安定した成長が示される場合、プーリングによって、両方の信号が最終ベクトル内で適切に表現されます。
畳み込みと最大プーリングを組み合わせることで、各スケールの重みを手動で設定する必要がなくなります。 モデルは、現在の予測に最も関連性の高い特徴量の組み合わせに焦点を当てることを自ら学習します。 この適応的な仕組みは、推論精度を向上させるだけでなく、市場の急変やノイズに対するアルゴリズムの堅牢性も高めます。弱い信号や発生頻度の低い信号の影響を抑える一方、重要なスパイクを増幅し、情報を失うことなくエンコーダとデコーダの各段階へと伝達するためです。
以上で説明したアプローチをCNeuronTimeFoundPatchingオブジェクト内に実装します。その構造を以下に示します。
class CNeuronTimeFoundPatching   :  public CNeuronConvOCL
  {
protected:
   CNeuronTransposeOCL              cToVarSeq;
   CNeuronMultiWindowsConvWPadOCL   cProjecting;
   CNeuronTransposeVRCOCL           cToVarProjSeq;
   CNeuronMultiWindowsConvWPadOCL   cPatchingProj;
   CNeuronMHFeedForward             cPatchsFeedForward;
   CNeuronConvOCL                   cPatchingAgr;
   CNeuronProofOCL                  cProof;
   CNeuronTransposeOCL              cToPatchVarEmb;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL)  override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL)  override;

public:
                     CNeuronTimeFoundPatching(void) {};
                    ~CNeuronTimeFoundPatching(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint count, uint patchs, uint variables,
                          uint embedding_size, uint patch_filters,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual int       Type(void)  override const {  return defNeuronTimeFoundPatching; }
   //---
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
  };
内部のすべての CNeuronTimeFoundPatchingモジュールは、プログラムの起動時からそれぞれ独立して動作します。 これらは静的に宣言され、ライブラリの読み込み時に初期化されます。 そのため、コンストラクタでこれらを生成する必要も、デストラクタでの解放を気にする必要もありません。これらのメソッドは空のまま となり、オブジェクトの構成を管理する処理は、単一の汎用的なInitメソッドに集約されています。
初期化メソッドのパラメータでは、内部オブジェクトの構成を定義する一連の定数を受け取ります。
bool CNeuronTimeFoundPatching::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                    uint count, uint patchs, uint variables,
                                    uint embedding_size, uint patch_filters,
                                    ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   uint inside_emb = MathMax((embedding_size + 2) / 6, 8);
   if(!CNeuronConvOCL::Init(numOutputs, myIndex, open_cl, 3 * inside_emb, 3 * inside_emb,
                            embedding_size, patchs * variables, 1, optimization_type, batch))
      return false;
   SetActivationFunction(SoftPlus);
このオブジェクトの構築にあたっては、Mantisフレームワークの優れたアイデアを取り入れたことに触れておく必要があります。 固定されたパッチサイズをハードコードする代わりに、当クラスでは、最も細かいレベルのセグメント数と、希望する出力トークンサイズのみを入力として受け取ります。 これにより、コードを編集することなく、パッチ化の粒度をすばやく変更できる柔軟性が得られます。
しかし、私たちはさらに一歩踏み込みました。Mantisでは、単一の畳み込みによって特徴量チャネルを生成していましたが、私たちはマルチウィンドウ畳み込みを実装し、入力信号を複数のレベルで表現できるようにしました。 初期化フェーズでは、各詳細度レベルにおけるトークンベクトルの内部サイズを計算する必要があります。 ユーザーは、オブジェクトの出力トークン長を任意に指定できます。 しかし、その値がレベル数で必ず割り切れるとは限りません。 ここで親クラスである畳み込みクラスの出番となります。このクラスは、最適化されたフィルタを適用しながら、チャネル数を指定されたサイズに慎重に調整し、特徴量が一貫性のある均一な表現となるようにします。
これまでと同様に、このオブジェクトは、マルチモーダル時系列を表す2次元テンソルを入力として受け取ることを想定しています。各行は、1つの時間ステップについての詳細な記述を表します。 ただし、パッチ化の処理系で個々の特徴量をそれぞれ独立した単変量系列として扱うため、まず入力データ行列を転置します。
このシンプルでありながら重要な手法により、以降のすべての処理で、異なるソースからの信号を混在させることなく、「1つの時系列、1つのストーリー」という厳格な原則に従うことができます。 これによって、各時系列の整合性と解釈可能性を維持しています。
int index = 0;
  if(!cToVarSeq.Init(0, index, OpenCL, count, variables, optimization, iBatch))
     return false;
次に、マルチウィンドウ畳み込みをおこないます。 ウィンドウサイズがそれぞれ3、5、7本のバーで、ストライドが1の3つのフィルターを同時に適用します。 ゼロパディングにより、出力系列の長さは変わりませんが、各値は近傍値とそのコンテキストを反映した表現になります。
index++;
  {
   int windows[] = {3, 5, 7};
   if(!cProjecting.Init(0, index, OpenCL, windows, 1, inside_emb, count, variables,
                        optimization, iBatch))
      return false;
   cProjecting.SetActivationFunction(SoftPlus);
  }
この段階で、後続の分析に必要となる基本的な特徴量の生成が完了しました。 次に、モデルの後続ブロックに入力できるようにデータを構造化する必要があります。つまり、パッチ化をおこないます。 ただし、時系列をセグメントに分割する前に、重要な技術的処理をおこなう必要があります。それは、得られた4次元テンソルの最後の軸の順序を入れ替えることです。
前のステップで生成されたテンソルの形状は、[変数 × 系列長 × チャネル数 × 特徴量数]です。ここでは、各時間ステップが、異なる畳み込みスケールから得られた3チャネルのベクトルで表現されています。 しかし、個々の単変量系列を独立してセグメント化し、扱いやすくするためには、データを[変数 × チャネル数 × 特徴量数 × 系列長]という形式に並べ替える必要があります。 これにより、各特徴量を独立した時系列として処理し、その後、固定長のセグメント、すなわちパッチに分割できるようになります。
index++;
if(!cToVarProjSeq.Init(0, index, OpenCL, variables, count, 3 * inside_emb, optimization, iBatch))
   return false;
この表現形式は、特に金融分野で有用です。マルチウィンドウ畳み込みによって情報が付加された各チャネルは、独立した市場指標として機能し、その変動特性をパッチ化によって分析できるようになります。
次に、重要な段階であるマルチスケール・パッチ化に進みます。これは、時系列の前処理アーキテクチャの基盤となるものです。 ここでは、従来の手法というよりも、高頻度の市場データ分析の実践から着想を得た概念を実装します。このような分析では、広い範囲を捉えることと、変化に素早く対応することの両方が重要です。
系列を単純な一次元の方法で固定的にパッチへ分割するのではなく、複数のスケールを同時に扱えるマルチウィンドウ畳み込み層を使用します。 これにより、モデルは異なる時間軸から市場を見ることができます。これは、1分足、時間足、日足のチャートを同時に確認するアナリストの見方に似ています。
index++;
  {
   uint step = (count + patchs) / (patchs + 1);
   uint windows[] = {step, 3 * step / 2, 2 * step};
   if(!cPatchingProj.Init(0, index, OpenCL, windows, step, patch_filters, patchs,
                          3 * inside_emb * variables, optimization, iBatch))
      return false;
   cPatchingProj.SetActivationFunction(SoftPlus);
  }
この場合、畳み込みウィンドウのサイズは自動的に決定されます。分析対象となる時系列の長さと、ユーザーが指定したパッチ数に応じて変化します。 より大きなスケールでは、ウィンドウサイズを拡大するとともに、パッチ同士をオーバーラップさせます。これにより、パッチ間の情報の一貫性と連続性を確保します。
次のステップでは、あらかじめ抽出されたパッチを、マルチヘッドのFeedForwardモジュールに入力します。 これは単なる形式的な処理ではありません。ここから、データの意味を捉えるための本格的な処理が始まります。 異なるスケールで得られた各パッチは、ここで本格的な埋め込み表現へと変換されます。つまり、対応する時系列セグメントの主要な特性を符号化した、情報密度の高いコンパクトな表現です。 このモジュールは、コンパクトでありながら表現力の高いベクトル群を生成します。それぞれのベクトルは、対応する時間区間の本質を凝縮したものと考えることができます。
index++;
if(!cPatchsFeedForward.Init(0, index, OpenCL, 3 * patch_filters, 6 * patch_filters, patchs,
                            3 * inside_emb * variables, 3, optimization, iBatch))
   return false;
index++;
すべてのスケールについて各パッチの表現力豊かな埋め込みを得たら、データの集約段階に進みます。 モデルが現在の市場状況を包括的に把握するには、異なる詳細度の情報を単一の特徴量ベクトルに統合する必要があるためです。
この課題を解決するために、畳み込みと最大プーリングを組み合わせて使用します。 畳み込み層は、異なるスケールの埋め込み間にある局所的な依存関係を捉えます。 これは、短期と長期のパターンの特徴的な組み合わせを探すアナリストのような役割を果たします。たとえば、長期的に安定したトレンドを背景とした短期的なボラティリティなどです。 このような組み合わせは、特に市場環境が複雑な場合、取引判断において重要な意味を持つことがあります。
続いて、データに最大プーリングを適用し、得られたテンソルの各領域から、最も強く、際立った特徴量を抽出します。 その結果、単一の集約特徴量ベクトルが得られます。 これは、複数のスケールで処理された入力履歴全体を、コンパクトかつ情報豊かに表現したものです。
index++;
if(!cPatchingAgr.Init(0, index, OpenCL, 3 * patch_filters, 3 * patch_filters, patch_filters,
                      patchs, 3 * inside_emb * variables, optimization, iBatch))
   return false;
cPatchingAgr.SetActivationFunction(SoftPlus);
index++;
if(!cProof.Init(0, index, OpenCL, patch_filters, patch_filters, 3 * patchs * inside_emb * variables,
                optimization, iBatch))
   return false;
ただし、得られたトークンをアーキテクチャの次の段階へ渡す前に、もう1つ重要な処理が必要です。得られたテンソルを転置し、時間軸を再び先頭に戻します。
   index++;
   if(!cToPatchVarEmb.Init(0, index, OpenCL, variables * 3 * inside_emb, patchs, optimization, iBatch))
      return false;
//---
   return true;
  }
なぜこれが必要なのでしょうか。 その理由は、直前の段階、特に埋め込みの生成とパッチの集約では、主にパッチと特徴量に着目した形式でデータを表現していたためです。 この軸の順序は局所的な処理には適していますが、時間的な順序に敏感な仕組みには適していません。
時間軸を先頭に戻すことで、得られたトークンを実質的に時系列順に並べ直します。 各トークンは、複数のスケールから得られた情報を付加された時間ステップに対応するようになります。 これにより、モデルはデータを抽象的な特徴量の集合としてではなく、完全な時系列として解釈できるようになります。
テンソルはこの形式で後続の処理段階へ渡されます。そこで、時間的依存関係の把握、文脈の分析、予測の生成がおこなわれます。 この並び順によって、データにおける因果関係と時間的な関係性が保たれます。これがなければ、金融市場をモデル化しようとしても意味を成しません。
オブジェクト内部のアーキテクチャは一見複雑に見えますが、順方向伝播と逆方向伝播のアルゴリズムの実装は、非常にシンプルです。 計算処理は、ネストされたループや複雑な分岐を使わず、段階を追って順次実行されるように構成されています。 これらのメソッドの動作を理解するのは難しくないと思います。 そのため、本記事では意図的に詳細な説明を省略しました。 CNeuronTimeFoundPatchingオブジェクトの技術的な実装をさらに詳しく知りたい方のために、すべてのメソッドを含む完全なソースコードを、本記事の添付ファイルとして提供する予定です。
記事の形式上、妥当な限界に近づいてきました。 すでにかなりの量になっています。 しかし、ご覧のとおり、私たちの作業はまだ完了にはほど遠い段階です。 ここまでで、基礎を築き、その後の分析全体を支える極めて重要なデータ前処理モジュールを実装したにすぎません。
ここで少し休憩し、ひと息ついてから、次の記事で続きを進めましょう。これまでに説明したフレームワークの残りの構成要素を、順を追って実装していきます。
結論
本記事では、時系列データの混沌とした構造を、形式化された予測可能なパターンへと変換できるフレームワーク、TimeFoundの理論的な側面を検討しました。
また、フレームワークの著者らが提案した手法を、私たちなりに解釈して実装する作業にも着手しました。 特に、データの前処理モジュールに重点を置きました。このモジュールが、入力信号の構造をモデルがどれだけ正確かつ豊かに捉えられるかを左右するためです。
今後も同じように興味深い作業が待っています。次の記事では、その内容をさらに掘り下げていきます。
参考文献
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Research.mq5 | EA | サンプル収集用EA |
| 2 | ResearchRealORL.mq5 | EA | サンプル収集用EA(Real-ORL手法) |
| 3 | StudyEncoder.mq5 | EA | 環境エンコーダの学習用EA |
| 4 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 5 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 6 | Test.mq5 | EA | モデルテスト用EA |
| 7 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 8 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを作成するためのクラスライブラリ |
| 9 | NeuroNet.cl | ライブラリ | OpenCLプログラム用のコードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/18414
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。

 取引におけるニューラルネットワーク:高精度分類のための効果的な特徴抽出(オブジェクトの実装)
 エラー 146 (「トレードコンテキスト ビジー」) と、その対処方法
 初級から中級まで:オブジェクト(II)

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索
こんにちは、ドミトリー・ギズリクさん。お元気でいらっしゃいますように。
CNeuronTimeFoundPatchingクラスはどのファイルに実装されていますか?
よく分かりませんが、もしかすると、すでにzipアーカイブ内のいずれかのフォルダに入っているのでしょうか、それともこの記事のファイルの一部としてまだアップロードされていないものなのでしょうか。
このアプローチはとても興味深いです。近いうちに次のパート(私の母国語であるスペイン語版)が公開されるのを楽しみにしています。それでは。
(可能であれば)コードを補完するライブラリについて、もう少し詳しく教えていただけませんか。どのファイルをコンパイルしようとしても、多くの依存関係が不足しているようです
(「EXPERTS」ファイルは存在していますが、おそらく「include」などにある他のファイルが欠けている可能性があります)。
ドミトリー・ギズリクさん、こんにちは。お元気でいらっしゃいますように。
CNeuronTimeFoundPatchingクラスは、どのファイルに実装しましたか?
よく分かりません。おそらくZIPファイル内のいずれかのフォルダにすでに含まれているか、あるいはこの記事のファイルの一部としてまだアップロードされていないものかもしれません。
このアプローチはとても興味深いです。次のパートを(私の母国語であるスペイン語で)早く読めるのを楽しみにしています。よろしく。
ミゲルさん、こんにちは。
CNeuronTimeFoundPatching クラスは、NeuroNet.mqh ライブラリに含まれています。
(可能であれば)どのライブラリがコードを補完しているのか、もう少し詳しく教えていただけませんか。どのファイルをコンパイルしようとしても、多くの依存関係が不足しているようです。
(「EXPERTS」ファイルのみが存在していますが、おそらく「include」などにある他のファイルが欠落している可能性があります)。