

交易中的神经网络:自适应周期分段(结论)
 22
 0

引言
在前面的文章中,我们分步介绍了LightGTS框架如何将时间序列转化为乐谱。首先在周期分块(Period Patching)模块中,待分析数据会依据快速傅里叶变换(FFT)自动切分为完整周期片段。之后每个周期片段通过柔性投影层(Flex Projection Layer)映射为token,支持对不同长度片段的灵活处理。在编码器(Encoder)内部,这些token会经过旋转位置编码(RoPE)处理 —— 一种简洁的嵌入方式,用于编码相位偏移和相对位置信息;随后由带多头注意力的标准Transformer模块,将局部模式融合为统一上下文。预测结果由周期并行解码(Periodical Parallel Decoding)机制一次性生成完整预测序列,无需自回归。输出结果经由柔性尺寸调整(Flex-resize)模块修正,保证周期的一致性。
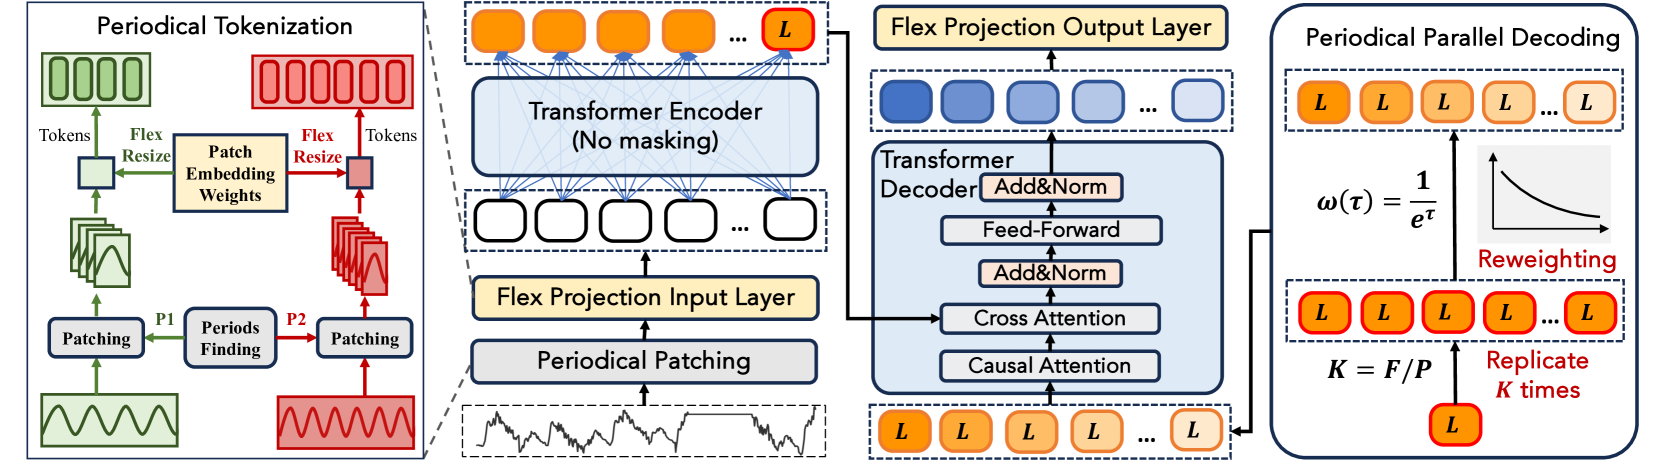
至此,我们已经完成LightGTS核心思想的代码实现:如何基于自适应分块自动对时间序列做周期分段,并把每个片段转换为具备丰富信息的token。我们在原有算法基础上进行了定制优化,完善柔性投影底层逻辑,得到可直接使用的局部市场周期表征。现在,我们将继续推进,基于原LightGTS框架作者提出的思路,构建属于我们自己的实现方案。
RoPE机制
自适应卷积已经从原始时间序列中提取出一组信息高度凝练的token,接下来需要把这些token送入Transformer模块做深度特征提取。在标准编码器 - 解码器架构中,一般是将正弦位置编码或可学习位置编码向量直接加到token上,再送入注意力机制。而LightGTS框架作者采用了更精巧灵活的方法:旋转位置编码(RoPE)。它不再使用固定位置的编码向量,而是在嵌入空间内对每个token执行旋转变换。
RoPE的核心思想是引入与token位置和维度索引成正比的向量相位偏移,不额外增加可训练参数。该技术最早出自论文《RoFormer:带旋转位置嵌入的增强型Transformer》。论文作者证明:利用旋转矩阵对查询(Query)向量与键(Key)向量中成对的坐标做旋转变换,模型就能稳定地捕捉时序上的相对偏移。
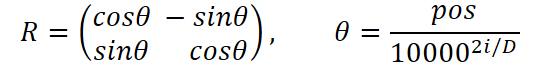
该方法可以将维度两两分组,轻松推广到高维空间。由此引出一个约束:嵌入空间维度数必须为偶数。
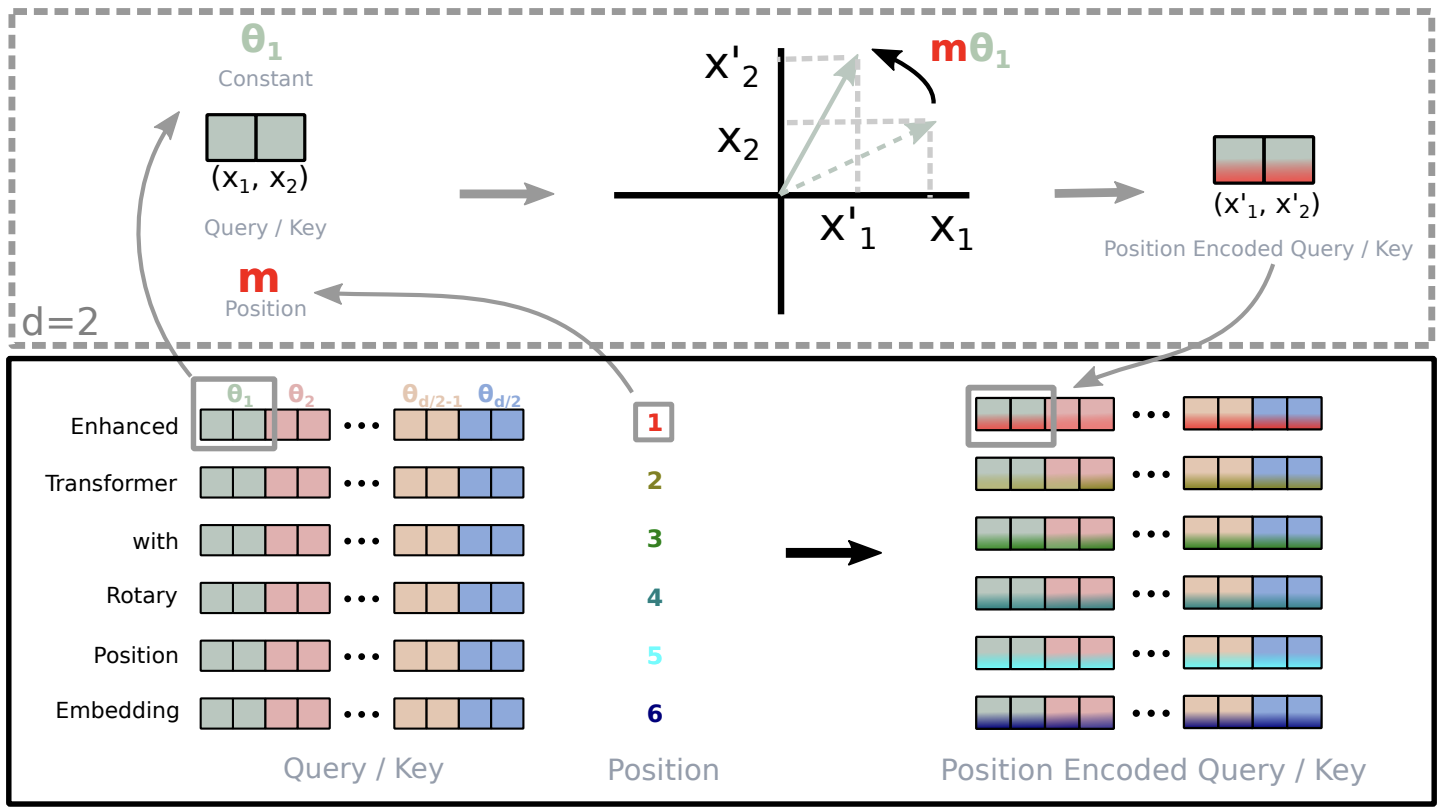
借助这种旋转变换,即便窗口大小、步长动态变化,模型也能精准判断token之间的时序远近关系。于是自注意力(Self-Attention)机制成为时序模式的高灵敏检测器:它不只对比查询与键的内容,还会考虑token之间的相位差。经过多层多头注意力与前馈网络(Feed-Forward)计算后,得到具备深度上下文信息的token。
在理解旋转位置编码的数学原理与核心概念后,我们进入底层实现细节,看一下如何把这套逻辑编写为OpenCL程序代码。我们已经准备好token:一组D维向量构成的数组。除此之外,我们预先计算每个位置对应的正弦和余弦表。我们的目标是在嵌入空间旋转每一个向量,让向量相位体现时间戳信息,同时不降低整个计算流水线的吞吐性能。为此,我们实现一个RoPE内核,工作在三维任务空间:第一维:向量内部坐标对的索引,长度等于向量维度的一半;第二维:序列长度,即token数量;第三维:单元序列的数量。
请注意,为方便成对坐标运算,我们使用float2向量数据类型。
__kernel void RoPE(__global const float2* __attribute__((aligned(8))) inputs,
                   __global const float2* __attribute__((aligned(8))) position_emb,
                   __global float2* __attribute__((aligned(8))) outputs
                  )
  {
   const size_t id_d = get_global_id(0);     // dimension
   const size_t id_u = get_global_id(1);     // unit
   const size_t id_v = get_global_id(2);     // variable
   const size_t dimension = get_global_size(0);
   const size_t units = get_global_size(1);
   const size_t variables = get_global_size(2);
在内核主体中,我们首先确定当前工作项在三维任务空间中的坐标。这一步至关重要,目的是让每个工作项明确自身负责处理的数据片段:需要运算哪一组向量坐标对、该坐标对归属哪个token,以及该数据来自哪个变量(或通道)。
确定工作项坐标后,下一步就是计算OpenCL缓冲区展平数组中的偏移量。尽管逻辑上是多维结构,但OpenCL中的所有数据均以线性方式存储,因此需要手动计算目标元素在内存中的精确位置。
   const int shift_in = (id_v * units + id_u) * dimension + id_d;
   const int shift_pos = id_u * dimension + id_d;
   const float2 inp = inputs[shift_in];
   const float2 pe = position_emb[shift_pos];
为减少开销巨大的全局内存访问操作,我们将初始坐标对以及对应的正弦、余弦因子直接加载到局部向量变量中,这些变量会驻留在内核的寄存器里。毕竟,访问全局内存缓冲区的开销远高于操作已加载至本地的向量。该方式几乎完全消除对全局内存的重复读取,将热数据保存在寄存器或GPU本地内存中,大幅加快token旋转变换的整体流程,最大化内核执行效率。
当所有计算要素(输入数据与正弦/余弦值)准备就绪后,即可进入核心计算环节 —— 相位偏移。正是这一偏移操作赋予token时序感知能力,保障注意力机制正常运行。
   float2 result = 0;
   result.s0 = inp.s0 * pe.s0 - inp.s1 * pe.s1;
   result.s1 = inp.s0 * pe.s1 + inp.s1 * pe.s0;
//---
   outputs[shift_in] = result;
  }
这里,我们对局部变量执行基础算术运算:每组坐标对需要四次乘法与两次加法。得益于预先加载的数据,该步骤几乎可以瞬时完成。
随后,我们立刻将完成旋转变换的坐标对写入结果缓冲区。
原理就是这么简单:通过乘以预先计算好的余弦和正弦值,我们为每个token注入相位与相对时间信息,且无需新增任何可训练参数。由此,该内核具备以下特性:
- 高度并行性 —— 每个工作项独立运行;
- 零训练开销 —— 位置编码不含任何可训练参数;
- 可无缝对接后续注意力模块 —— 嵌入向量不仅承载token本身内容,还包含token之间的相位差信息。
尽管RoPE不会向模型引入任何可训练参数,但我们必须保证梯度能够顺利穿过该层,反向传播至输入数据。为此,我们专门实现了反向传播内核CalcHiddenGradRoPE,用来对向量执行逆旋转变换。
原理很简单:前向传播内核使用旋转矩阵对输入数据(x, y)做乘法运算。在反向传播阶段,则需要使用该矩阵的转置矩阵,也就是旋转−θ角度;其中cos(−θ) = cosθ,sin(−θ) = −sinθ。
反向传播内核的算法与前面介绍的前向传播内核基本一致。二者使用相同的任务空间,全局数据缓冲区的偏移量计算方式也类似。唯一细微的差别在于向量的旋转操作。此外,运算的输入数据是输出层传来的误差梯度。
__kernel void CalcHiddenGradRoPE(__global float2* __attribute__((aligned(8))) inputs_gr,
                                 __global const float2* __attribute__((aligned(8))) position_emb,
                                 __global const float2* __attribute__((aligned(8))) outputs_gr
                                )
  {
   const size_t id_d = get_global_id(0);     // dimension
   const size_t id_u = get_global_id(1);     // unit
   const size_t id_v = get_global_id(2);     // variable
   const size_t dimension = get_global_size(0);
   const size_t units = get_global_size(1);
   const size_t variables = get_global_size(2);
//---
   const int shift_in = (id_v * units + id_u) * dimension + id_d;
   const int shift_pos = id_u * dimension + id_d;
   const float2 grad = outputs_gr[shift_in];
   const float2 pe = position_emb[shift_pos];
//---
   float2 grad_x;
   grad_x.s0 = grad.s0 * pe.s0 + grad.s1 * pe.s1;
   grad_x.s1 = grad.s1 * pe.s0 - grad.s0 * pe.s1;
//---
   inputs_gr[shift_in] = grad_x;
  }
整个过程不含条件分支,也没有复杂公式,仅需四次乘法与两次加法。因此, RoPE层梯度的反向解算,其速度与效率不亚于前向传播阶段的token旋转变换。
最终,CalcHiddenGradRoPE使得RoPE层完整参与模型训练流程:我们可以将其置于网络任意深度,它能够无损地向输入张量回传梯度,同时保留计算速度与并行特性。
如今,旋转位置编码对应的OpenCL内核已经打磨完善。接下来,我们要把这套计算能力引入MQL5环境,并集成到交易EA中。GPU上已经具备现成的token旋转变换机制,剩余工作只需为其编写轻量封装层,适配MQL5智能交易系统(EA)的现有框架。为此,我们将新建CNeuronRoPE类,其结构如下所示。
class CNeuronRoPE  :  public CNeuronPositionEncoder
  {
protected:
   uint              iWindow;
   uint              iVariables;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL)override;

public:
                     CNeuronRoPE(void) : iWindow(0), iVariables(0) {};
                    ~CNeuronRoPE(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint count, uint window, uint variables,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual int       Type(void) override const {  return defNeuronRoPE; }
  };
CNeuronRoPE类在设计上力求简洁:仅包含两个成员变量:iWindow用于定义单个token向量的维度;iVariables指定通道数量。其余所有与缓冲区和参数校验相关的繁重功能均继承自CNeuronPositionEncoder,因此本类的构造函数与析构函数为空。整个层的运行基础在Init方法中完成初始化。
bool CNeuronRoPE::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                       uint count, uint window, uint variables,
                       ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(window % 2 > 0)
      return false;
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, count * window * variables, optimization_type, batch))
      return false;
该方法起始处会执行一项简单但至关重要的校验:每个token的向量维度必须为偶数,因为RoPE是以坐标对为单位进行运算。如果不满足该约束,程序无法继续执行,也就不能对坐标对完成确定的旋转变换。校验通过后,程序将控制权转交至父类的同名方法,父类中已经实现其余校验逻辑以及继承接口的初始化流程。
接下来,我们把输入数据张量的参数保存到类内部变量中。
   iWindow = window;
   iVariables = variables;
接下来构建RoPE的核心嵌入矩阵:这是一个二维数组,偶数列存放 cos(θ) ,奇数列存放sin(θ)。
首先,我们创建尺寸合适的pe矩阵。用于存放计算出的正弦与余弦值。为确定矩阵每一列与时序步长的对应关系,先构造位置向量:取单位向量,计算其前缀和后减1,最终得到[0, 1, 2, …, count–1]。该向量用于标识当前正在编码的时序步序号。
   matrix<float> pe = matrix<float>::Zeros(count, iWindow);
   vector<float> position = vector<float>::Ones(count);
   position = position.CumSum() - 1;
接下来进入核心计算部分:遍历所有维度对,因为每一组 token 坐标对都需要一组独立的角度参数。针对每一组维度对,取出位置向量,将其除以一个递增分母:pow(10000, 2 * i / iWindow) ,这一设计让低维分量旋转更快、高维分量旋转更慢。最终得到角度数组:它不是零散的标量数值,而是包含全部位置所对应的θ向量。
   for(uint i = 0; i < iWindow / 2; i++)
     {
      vector<float> temp = position / MathPow(10000.0f, 2.0f * i / window);
      pe.Col(MathCos(temp), i * 2);
      pe.Col(MathSin(temp), i * 2 + 1);
     }
随后,我们将计算得到角度的余弦值写入pe矩阵的各个偶数列,而在相邻的奇数列填入对应角度的正弦值。最终得到一张现成的查找表矩阵:矩阵每一列都存有一组[cos(θ), sin(θ)]数值对,可用于对任意token执行旋转变换。上述全部计算仅在CPU代码中执行一次,之后便可把这组预计算好的参数集传递给GPU内核。
我们将填充完成的矩阵传入数据缓冲区,最后向调用方返回本次操作的布尔结果,结束该方法。
   PositionEncoder.BufferFree();
   if(!PositionEncoder.AssignArray(pe))
      return false;
   SetActivationFunction(None);
//---
   return PositionEncoder.BufferCreate(open_cl);
  }
借助该方法,OpenCL内核接收预计算好的正弦/余弦查找表作为输入,能够满负荷运行,无需额外执行冗余数学运算。
由此,全部初始化配置集中在单个方法内:只需修改窗口大小或变量参数,该层便可立刻适配新的运行条件。这种设计保证代码严谨清晰,同时让我们能够完全掌控RoPE模块的运行行为。
前向传播启动时,您只需调用feedForward方法,并传入已经填充好token的源数据对象指针。在底层,该方法会完成多项细节处理:校验传入指针的有效性、按合适的工作组大小将RoPE内核加入任务队列、等待内核执行完成,随后交还程序控制权。输出结果为经过旋转变换的token缓冲区,可直接送入注意力模块。
模型训练阶段,calcInputGradients方法开始发挥作用。该方法负责启动CalcHiddenGradRoPE内核。其逻辑几乎是前向传播的镜像:坐标体系、偏移量计算方式完全一致,只是旋转操作反向执行,将梯度还原为原始表征形式。最终计算结果存入输入梯度缓冲区,并继续向前传递至模型更浅层网络。
本质上,这两个方法都是对应内核的封装函数,所遵循的算法您已经很熟悉。因此,本文不再详细展开介绍。完整代码及其全部成员方法可参见附件。
token经过RoPE相位编码处理后,便可进入模型的核心部分 —— 注意力模块。LightGTS框架原生基于经典编码器 - 解码器(Encoder–Decoder)架构构建,因此我们无需从头重新实现这些组件:所需的全部组件都已经在代码库中就绪。只需将旋转变换后的token送入现有的自注意力(Self-Attention)模块,多头注意力机制就会高效运行,把局部时序模式关联到时间序列的全局上下文当中。
原版LightGTS中,作者提出取出编码器输出的最后一个隐状态token,按指定预测区间所需的次数精确复制该token,供解码器一次性生成完整输出序列。而我们做了一项大胆的简化改进:不再需要复制操作。原因有两点:第一,我们的目标并非得到极高精度的数值预测,而是从隐空间表征中提取全部有效信息,交由智能体(Agent)据此生成交易决策;第二,我们在每一根新K线到来时执行计算,单根K线对应的时长始终小于完整市场周期。因此,每个单变量序列仅保留最后一个token就足够满足需求。
所以我们省去多次复制的步骤,直接将该最终嵌入向量送入主计算流水线,传递至解码器。在解码器内,数据同样经过多头注意力与前馈网络,但不再做多余的复制;这份高度浓缩的纯粹表征,已经包含了最新市场走势的全部关键信息,模型正是依靠它来决策。该方法节约算力资源、简化逻辑,令智能体尽可能快速响应。毕竟每根K线都要求即时判断:我们需要的不是上千份token副本,而是一个足够强、能够直接支撑盈利决策的信号。
模型架构
最后,我们来到整个项目的收尾环节:所有经过精细调试的模块整合为一套流畅运行的完整系统。在我们的MQL5项目中,整合逻辑在CreateDescriptions函数内实现。我们在这里分步搭建神经网络的7条分支:编码器、三条预测流,以及智能体的三个组成部分 —— Actor(行动者)、Director(调度器)与Critic(评估器)。
bool CreateDescriptions(CArrayObj *&encoder,
                        CArrayObj *&forecast1,
                        CArrayObj *&forecast2,
                        CArrayObj *&forecast3,
                        CArrayObj *&actor,
                        CArrayObj *&director,
                        CArrayObj *&critic
                       )
  {
//---
   CLayerDescription *descr;
//---
   if(!encoder)
     {
      encoder = new CArrayObj();
      if(!encoder)
         return false;
     }
   if(!forecast1)
     {
      forecast1 = new CArrayObj();
      if(!forecast1)
         return false;
     }
   if(!forecast2)
     {
      forecast2 = new CArrayObj();
      if(!forecast2)
         return false;
     }
   if(!forecast3)
     {
      forecast3 = new CArrayObj();
      if(!forecast3)
         return false;
     }
   if(!actor)
     {
      actor = new CArrayObj();
      if(!actor)
         return false;
     }
   if(!director)
     {
      director = new CArrayObj();
      if(!director)
         return false;
     }
   if(!critic)
     {
      critic = new CArrayObj();
      if(!critic)
         return false;
     }
首先,我们校验每个容器内动态数组的指针是否有效。如果其中任意一个数组尚未创建,就为新的动态数组分配内存。这些容器将构成基础框架,模型各神经网络层的描述信息会挂载在该框架之上。
在编码器中,整个流程始于一个基础全连接层。该层接收原始输入数据:一段历史K线序列,每根K线由一组特征表征。
//--- Encoder
   encoder.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   uint prev_count = descr.count = (HistoryBars * BarDescr);
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormWithNoise;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
接下来,我们引入带噪声的批量归一化,对激活值的分布进行平滑均衡处理。在此之后,执行针对输入数据的第一项运算:提取序列相邻数据点之间的差值。这样能够凸显数据的变化动态。
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConcatDiff;
   prev_count = descr.count = HistoryBars;
   descr.layers = BarDescr;
   descr.step = 1;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
下一层会向原始数据中加入时间戳谐波分量,不再将每一根K线仅仅表征为一组价格与成交量特征,而是转化为时间轴上的一个数据点。
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defMamba4CastEmbeding;
   prev_count = descr.count = HistoryBars;
   descr.window = 2 * BarDescr;
   uint prev_out = descr.window_out = NSkills;
     {
      uint temp[] = {PeriodSeconds(PERIOD_H1), PeriodSeconds(PERIOD_D1)};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.count = prev_count;
   prev_count = descr.window = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = descr.count;
接下来,我们对结果做转置处理,为数据输入自适应卷积类CNeuronAdaptConv做好准备。乍看只是常规的技术操作,但其中发生了关键转变:我们重排了数据,让每条单变量序列都能被拆分为自适应分块。
这使得CNeuronAdaptConv可以灵活适配输入数据的特性:部分分块捕捉脉冲式行情波动,另一些分块则捕捉平稳区间或振荡行情。本质上,我们向模型提供的不再只是一维平铺数值数组,而是具备清晰时空层级结构的表征形式。这使得编码器既能保留短期上下文信息,同时还能挖掘复杂时间序列中深层隐藏的模式。
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronAdaptConv;
   descr.count = Segments;
   descr.window = 2*prev_out/Segments;
   descr.variables = prev_count;
   prev_out = descr.window_out = EmbeddingSize;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_count = descr.count;
   uint prev_var = descr.variables;
下一步是RoPE(旋转位置编码),乍一看,既然原始数据中已经添加了时间戳,该机制似乎显得多余。然而,二者最核心的区别在于作用层级不同。
我们添加的时间戳作用于单根K线,也就是原始源数据。用于在结构化处理开始前,记录每一个观测样本的绝对时间坐标。
随后,数据进入分块阶段,连续的多根K线被组合成片段。该片段会转换为单个token,也就是该局部时间区间的聚合表征。到这一步,才对生成的token施加RoPE。
因此,RoPE并不对分块内部的位置做编码 —— 毕竟到这一阶段,块内信息已经被压缩为单一表征。相反,它嵌入的是该分块在整个序列中的位置信息。换言之,RoPE让模型能够理解各个分块之间的先后顺序,这对于解析待分析时间序列的全局结构至关重要。
RoPE的这种部署方式,使其成为完美的补充机制:当与K线级时间戳配合使用时,可以提供分层时间感知能力 —— 从K线粒度的精细数值,到各个聚合块之间的相对位置。
//--- layer 6
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronRoPE;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.variables = prev_var;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
应用RoPE后,我们再次对数据进行转置。这一次转置是为了让后续的多头自注意力 (Multi-Head Self-Attention)模块能够读取token向量数组,并同时考虑它们的时间先后顺序。这一步属于纯技术操作,但却至关重要:注意力模块必须接收形状正确的数据,否则得到的就不是token之间有意义的加权比对,而是一堆混乱无效的数据
接下来,启用自注意力模块,配置为4个注意力头,共连续3层。该架构让模型能够从不同维度并行分析token间的关联:每个注意力头负责一个独立的特征子空间,就像四位专家从各自角度衡量分块之间的关联程度。
//--- layer 7
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeRCDOCL;
   descr.count = prev_var;
   descr.window = prev_count;
   descr.step = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 8
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronComplexMLMHAttentionOCL;
   descr.count = prev_count;
   descr.window = prev_out / 2 * prev_var;
   descr.window_out = descr.window / 4;
   descr.layers = 3;
   descr.step = 4;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
这里需要着重强调RoPE机制并不仅仅是一种添加位置信息的手段。它利用复数学原理,在复平面内对token向量做旋转变换。该方法通过在嵌入向量中引入相移,显式刻画token之间的相对位置。
这正是我们与原版LightGTS框架实现方案的区别 —— 原版采用标准自注意力,而我们特意选用复数版本的注意力模块CNeuronComplexMLMHAttentionOCL。此举保证了数学上的一致性:如果位置编码在复数域完成,那么注意力层也必须能够处理复数数值。
最终,模型不仅可以感知token之间的关联关系,还能捕捉它们的相移信息。这一点在处理金融时间序列中的周期与波动结构时尤为关键。三层注意力网络提供了足够的处理深度,使模型能够同时捕捉时间序列内局部以及远距离依赖关系。由此生成富含上下文的表征,相当于对整个序列的精简总览,为模型后续阶段做好准备。
解码器部分我们采用CNeuronTimeMoEAttention模块,该模块融合多头注意力的能力与稀疏混合专家(MoE)的精巧机制。该模块专为高效分析时间序列、构建高表达力的隐表征而设计,这在金融场景中尤为重要 —— 时序动态的每一处细节都会影响结果。
核心创新之一,是用稀疏混合专家块CNeuronTimeMoESparseExperts取代传统的前馈网络块。这种方案能够在不同专家子网络之间灵活且高效地分配计算资源;每个专家负责分析专属的特征子集,以此提升处理效果并减少计算冗余。
//--- layer 9
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTimeMoEAttention;
   descr.window_out = EmbeddingSize;
     {
      uint temp[] = {prev_out, prev_out, 8, TopK};               //Window Main, Window Cross, Experts dimension, TopK
      if(ArrayCopy(descr.windows, temp) < ArraySize(temp))
         return false;
     }
     {
      uint temp[] = {prev_var, prev_var * prev_count, NExperts}; //Units Main, Units Cross, Experts
      if(ArrayCopy(descr.units, temp) < ArraySize(temp))
         return false;
     }
   descr.layers = 3;
   descr.step = 4;                                                // Attention heads
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }//---
   CLayerDescription *latent = descr;
环境状态编码器(Environment State Encoder)的输出,是一份精简且具备强表达能力的待分析数据隐表征。
该表征不只是一组向量。它是经过精细提炼、信息丰富的当前市场状态描述,完整保留市场动态、季节性与短期异常的全部关键特征。编码器就像在消化市场行为:滤除噪声、提炼精髓,再以精简token的形式传给下游。
这些token并不囊括全部历史行情,而是积累了语义层面的信息,聚合各类因果关系,并识别最重要的影响因子。正是这些token,后续成为系统其余所有组件的通用知识源:预测模块、决策模块(Actor)以及评估模块(Director与Critic)。
实际上,在我们的架构中,编码器是唯一的语义压缩通道 ,所有历史与实时市场信息都经由它处理。其输出结果可以类比为复杂场景下的高清照片:经过压缩但焦点清晰,保留着对后续分析与决策至关重要的细节。
在训练阶段,为构建丰富且稳定的隐空间,我们采用三个并行预测模型,每个模型对应不同预测时域。该方案能让编码器同时捕捉短期脉冲行情与长期市场趋势,且不会损失泛化能力。
这三个模型读取相同的编码器输出,但各自使用对应特定预测时域的目标值进行训练。反向传播过程中,会聚合来自三个模型的梯度,令编码器基于多维目标同步训练:
- 在短期预测上做到快速且精准;
- 对市场噪声保持鲁棒性;
- 不丢失长期战略判断能力。
因此,即便在训练阶段,我们就让隐空间学习不同层级的市场逻辑。这会为系统其他所有组件带来显著优势。该编码器生成的状态表征,既适用于生成交易决策(Actor),也可用于评估决策质量(Critic与Director)。
预测模型的架构完全沿用我们前期研究成果,未做任何修改。由于这套架构已经在多项任务中验证有效,本文不再赘述其细节。
然而,Actor的架构经过了大幅改进,旨在提升策略的适应性与表达能力。更新后的结构共包含七层,每一层都为模型赋予特定能力。首先,和之前一样使用基础全连接层;我们向该层输入当前账户状态与持仓信息。
//--- Actor
   actor.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = AccountDescr;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = AccountDescr;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
随后接入批量归一化层,用以稳定训练过程,并对来自不同来源的特征进行尺度对齐。
多头交叉注意力层使得模型把当前账户状态与环境状态编码器输出的市场上下文关联起来。
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronCrossDMHAttention;
     {
      uint temp[] = {AccountDescr,           // Input window
                    latent.windows[0]        // Cross window
                   };
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
     {
      uint temp[] = {1,                      // Input units
                    latent.units[0]          // Cross units
                   };
      if(ArrayCopy(descr.units, temp) < (int)temp.Size())
         return false;
     }
   descr.step = 4;                  // Heads
   descr.window_out = 8;
   descr.batch = 1e4;
   descr.layers = 2;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
得益于两层、四头注意力架构,模型能够筛选上下文里的相关信息,以此生成交易动作。
接下来是三层决策多层感知机MLP。这里,每一层都采用独立的激活函数。双曲正切函数(tanh)可将token压缩至紧凑的连续空间,增强模型对边界特征的敏感度。
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = LatentCount;
   descr.batch = BatchSize;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
之后接入一种保持输出为正值的平滑非线性激活函数。这一点对于生成交易动作参数至关重要。
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = LatentCount;
   descr.activation = SoftPlus;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
该层还输出用于动作采样的 logits(原始得分)。输出维度设为动作数的两倍,显然是借鉴概率策略的思想,对均值与方差做参数化建模。
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = 2 * NActions;
   descr.activation = SoftPlus;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
有了变分层,模型便能随机生成动作,同时对概率分布保持可控。此举提升智能体的探索能力。
//--- layer 6
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronVAEOCL;
   descr.count = NActions;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
最后一步是对已经生成的动作执行卷积运算。该操作能够强化动作参数之间的局部依赖关系,并引入柔性概率滤波器,将动作参数映射至[0, 1]区间。
//--- layer 7
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = NActions / 3;
   descr.window = 3;
   descr.step = 3;
   descr.window_out = 3;
   descr.activation = SIGMOID;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
总体来看,新版Actor能与上下文做更深层的交互,行为更多样,做出交易决策时也能顾及历史依赖关系。
Director与Critic评估模型,以及预测组件,均直接沿用前期研究成果,未做改动。该部分架构已经过长期验证,在智能体训练任务中表现可靠。所有可训练组件的完整架构详见附件。
测试
模型训练流程分为两个阶段,以此保证系统构建过程连贯、可靠,避免仓促开发。
首先,第一阶段为离线训练。训练数据取自EURUSD(欧元兑美元)货币对在M1(1分钟)图表上长达15年的历史行情。该数据集覆盖了丰富多样的市场环境:从长期横盘震荡到快速趋势行情,从平稳阶段到高波动阶段。模型得以充分学习各类场景下的市场运行特征。编码器学习识别市场规律、挖掘有效模式,并将市场状态编码为精简且信息丰富的特征向量。该向量将作为智能体后续所有决策的基础。训练过程中,Actor基于Critic与Director反馈信号学习行为策略,逐步形成稳定、自洽的行为模式。
随后,我们进入第二阶段:使用2024年的历史数据对模型进行在线微调。该阶段训练环境高度贴近实盘交易场景:模型逐根K线与市场交互,会遭遇市场噪声、随机波动以及时序上的各种失真。这一过程不只是微调模型,还让其行为贴合实时市场动态、不断打磨策略,从而在不确定的环境下更加稳健。
全部完成训练后,我们使用全新数据开展完整测试:测试集为2025年1至3月的报价数据。所有参数预先固定,并且在整个测试期间保持不变。此举保障评估的客观性与透明度,杜绝任何形式的曲线拟合和人为干预。测试结果如下所示。
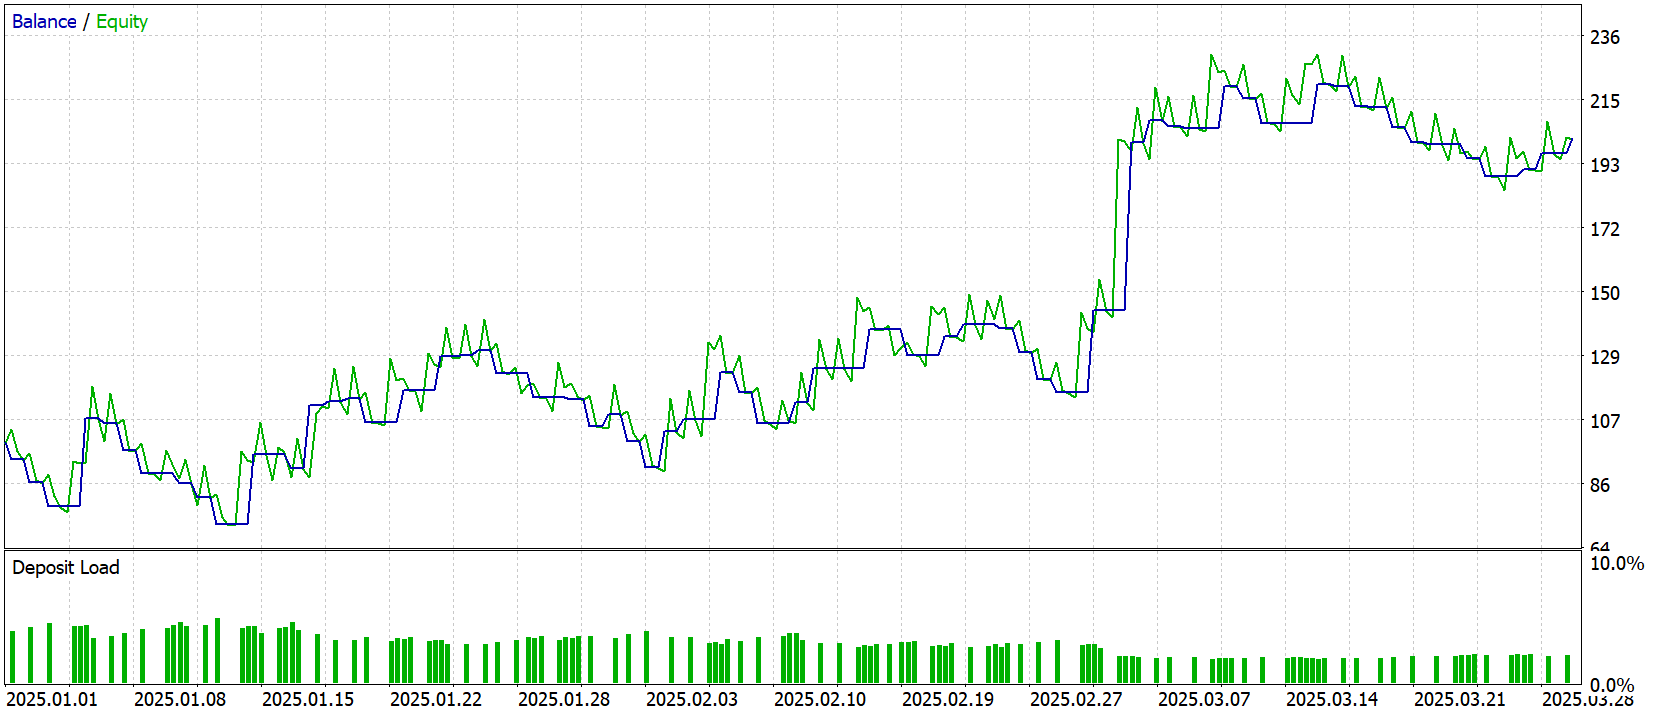
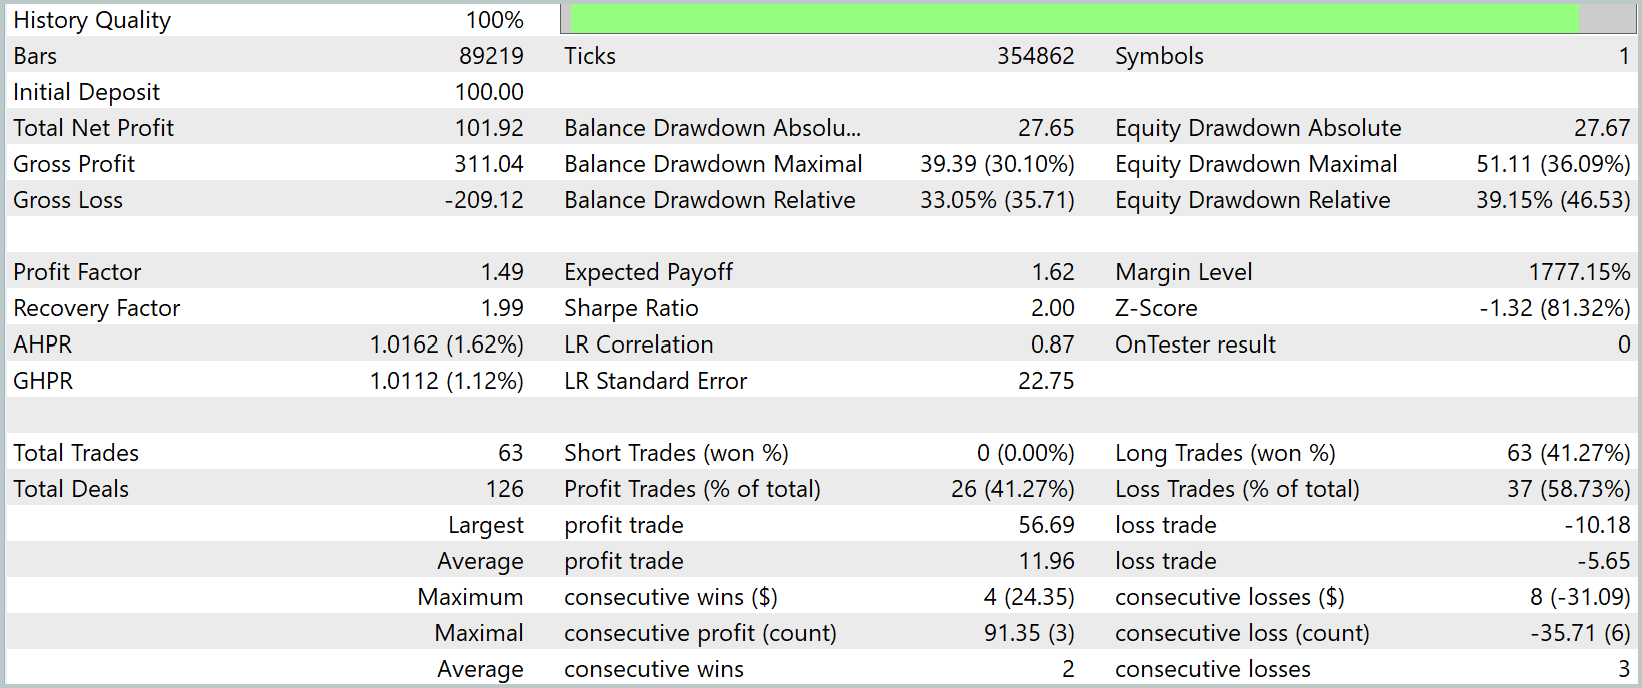
在M1图表上的三个月测试中,模型取得了可观的资金增长:初始资金从100美元增长到近202美元,实现了翻倍。与此同时,盈利交易占比仅约41%,但平均盈利12美元,远高于5.6美元的平均亏损,最终得到1.49的盈利因子。由权益曲线清晰可见:每次回撤后都能迅速收复;接近2的恢复系数,印证模型在36%的最大回撤下具备快速回本能力。
尽管整体表现亮眼,但存在一处明显偏差:模型始终只开立多头订单,顺着大级别上涨趋势交易。这一点在M1周期上尤为突出:只要价格持续上行,智能体就能锁定利润;但一旦出现反转苗头,模型就无法通过做空获取收益。
想打造真正通用的策略,还有进一步优化的空间。
结论
在本研究工作中,我们搭建了一套灵活的神经网络架构:涵盖自适应分块、RoPE、以及Time‑MoE注意力、Actor–Director–Critic等复杂模块。该系统既能捕捉短期脉冲行情,也能识别长期趋势;通过多预测时域的三重预测机制,模型对市场噪声具备良好鲁棒性。下一步优化目标是实现双向交易策略,增加多空双向开仓能力,并针对两个交易方向分别微调风控规则。只有完成基于真实行情数据的大规模测试与微调,我们才能够开发出具备真正竞争力的自动化交易系统。
参考文献
文中所用的程序
| # | 名称 | 类型 | 描述 |
|---|---|---|---|
| 1 | Study.mq5 | EA | 用于离线模型训练的EA |
| 2 | StudyOnline.mq5 | EA | 用于在线模型训练的EA |
| 3 | Test.mq5 | EA | 用于模型测试的EA |
| 4 | Trajectory.mqh | 类库 | 用于描述系统状态与模型架构的结构体 |
| 5 | NeuroNet.mqh | 类库 | 用于构建神经网络的类库 |
| 6 | NeuroNet.cl | 库 | OpenCL程序代码库 |
本文由MetaQuotes Ltd译自俄文
原文地址: https://www.mql5.com/ru/articles/18686
注意: MetaQuotes Ltd.将保留所有关于这些材料的权利。全部或部分复制或者转载这些材料将被禁止。
本文由网站的一位用户撰写,反映了他们的个人观点。MetaQuotes Ltd 不对所提供信息的准确性负责,也不对因使用所述解决方案、策略或建议而产生的任何后果负责。

 市场模拟(第 22 部分):SQL 入门(五)
 新手在交易中的10个基本错误
 科学家群体优化(CoSO):算法实现
