交易中的神经网络:智能预测流程(Time-MoE)
 155
 0

引言
时间序列预测依旧是现代算法交易赖以建立的核心任务之一。模型的预测精度不仅决定交易策略能否取得成功,还决定策略能否适应瞬息万变的市场。大多数模型都是为特定任务设计,市场环境稍有变动,模型鲁棒性就会下降。近些年来,所谓基础模型的发展十分迅速。《Time‑MoE:具备混合专家结构的十亿级别时间序列基础模型》一文就提出了这样一款模型。
Time-MoE是专为时间序列数据打造的新一代仅解码器Transformer 。它以稀疏学习、模块化、多尺度预测为设计原则。该框架的作者论证了大模型的可扩展性与灵活性同样适用于时间序列领域,且不会牺牲计算效率。论文提出的模型架构支持任意长度的分析序列与预测时域。 与此同时,该模型可以对数据流进行实时处理。
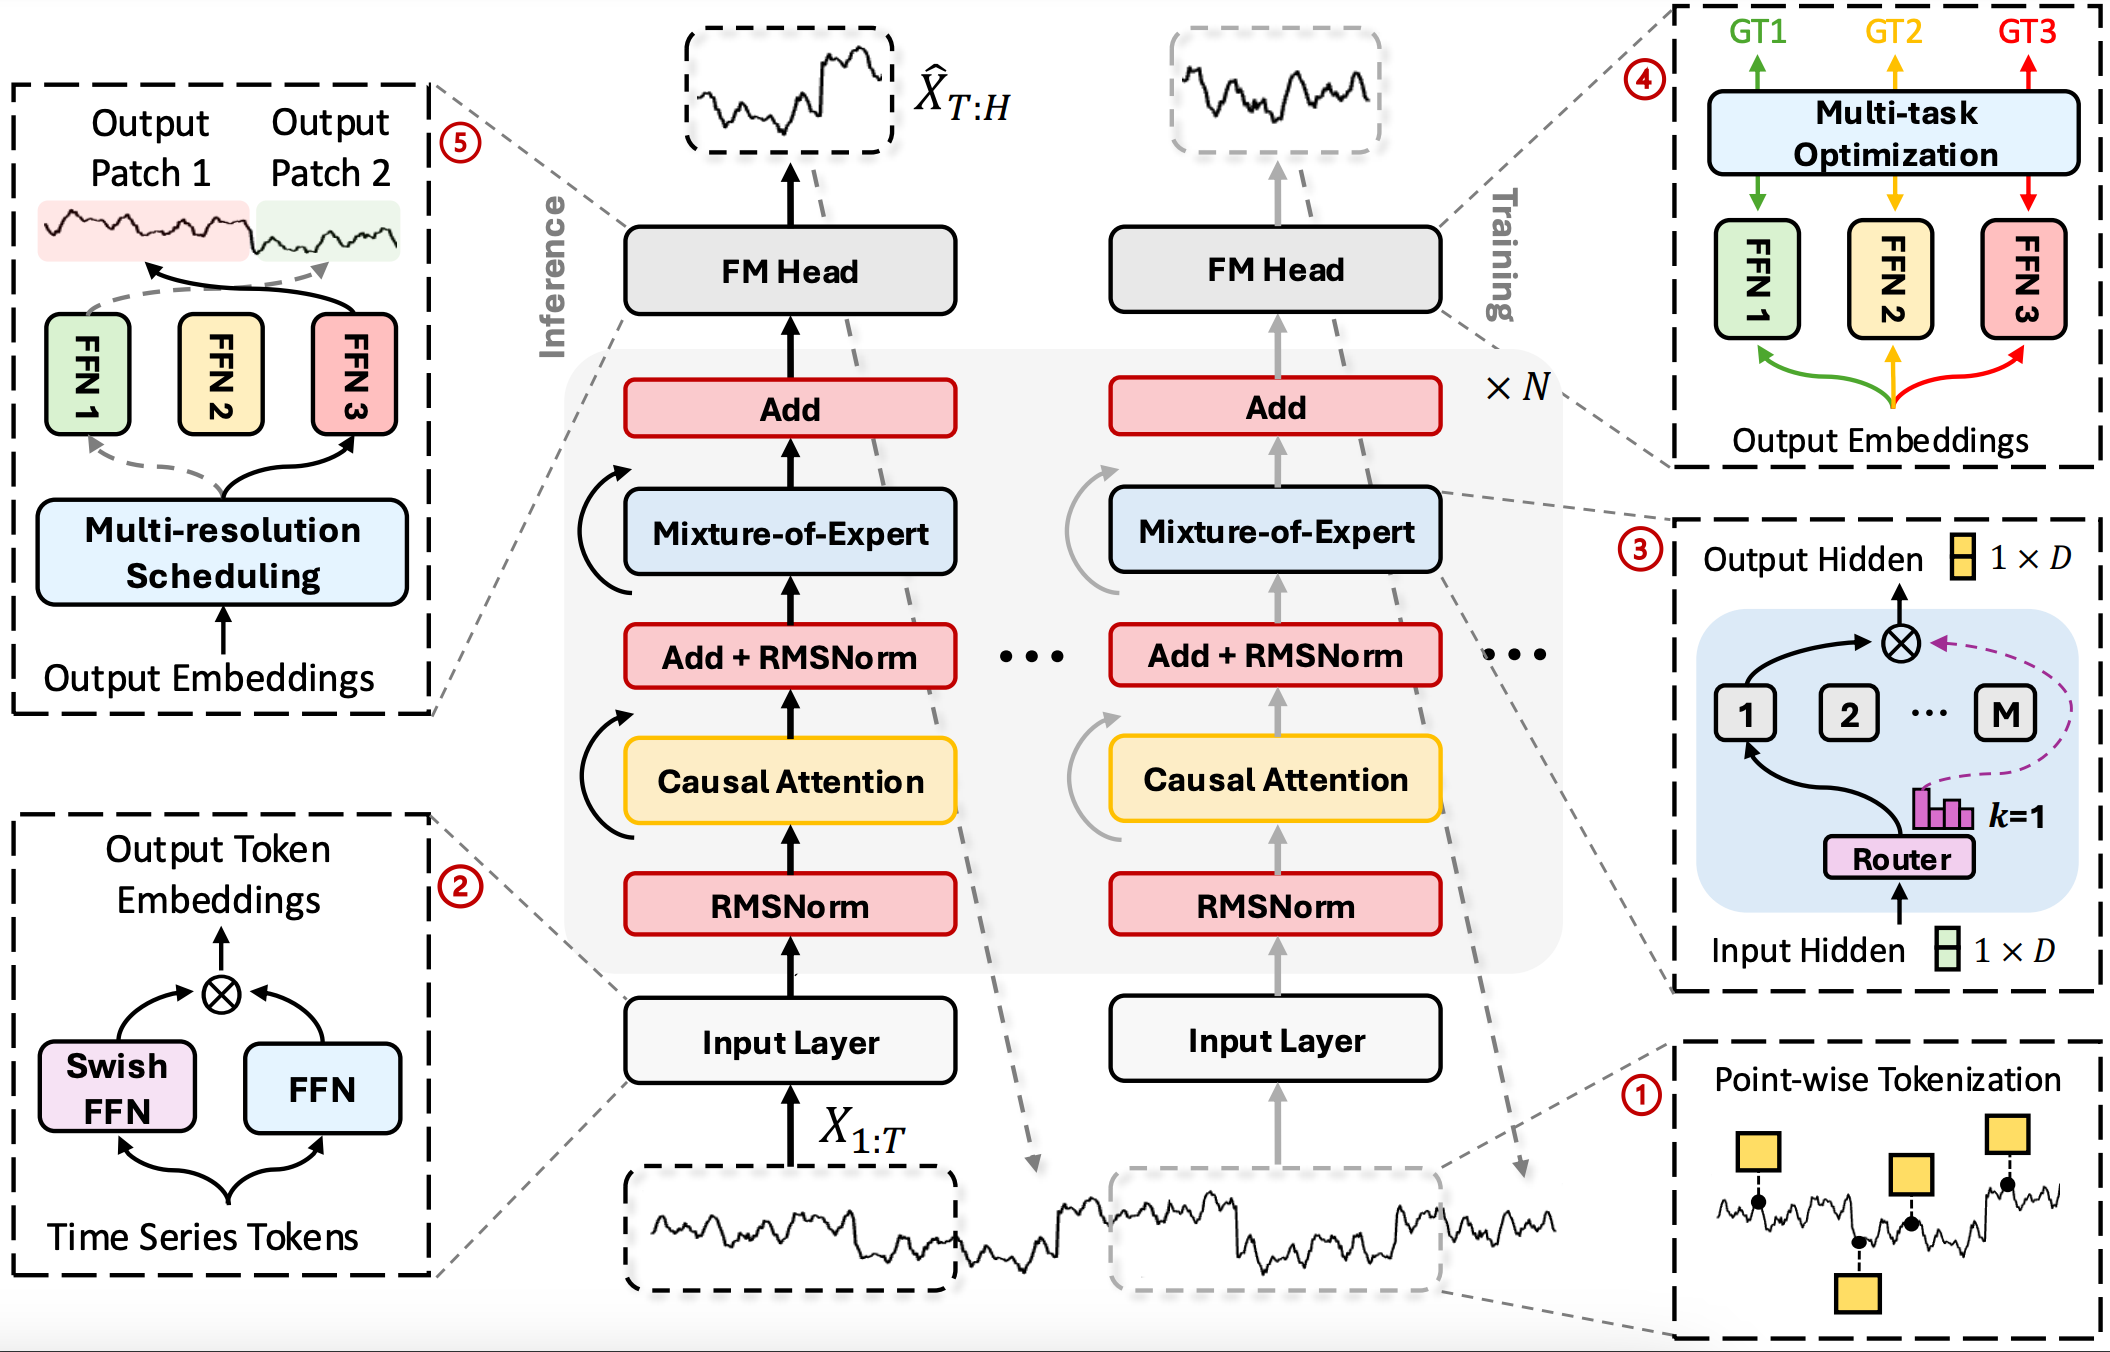
该架构的第一个组件为逐点分词(Point-Wise Tokenization)。不同于基于窗口或者聚合统计的处理方式,这里每一个时间步都会转换为一个独立的词元(token)。该特性在高频交易场景下十分有用,哪怕仅有一笔tick,都有可能改变市场格局。在MQL5环境中,词元可以由K线、tick数据以及衍生指标构建而成,包含波动率、成交量、自定义策略输出信号等。
完成分词之后,数据送入采用SwiGLU机制的嵌入层,它是一种融合Swish与门控线性单元(Gated Linear Unit)的门控结构。它可以生成更加平滑、鲁棒的信息表征,当市场存在噪声、趋势不稳定时,该特性尤为重要。
模型核心由N个重复堆叠的模块构成;每个模块融合因果多头自注意力(Causal Multi‑Head Self‑Attention)与稀疏混合专家(Sparse MoE)。注意力机制严格指向历史数据,以此保证时序的因果性:模型无法获取未来信息,因此可以直接应用于真实市场环境。MoE赋予架构强大的可扩展性:不会激活全部模型参数,针对每个词元,只会挑选少量专用子模型(专家)参与运算。部分专家更擅长处理脉冲式行情,另外一些则专攻盘整阶段或者区间震荡市场。由自适应路由机制决定每个词元应分配给哪些专家。
然而,模型的能力并不止步于数据处理阶段。Time‑MoE的一大核心特性是多尺度预测(Multiscale Forecasting)。训练阶段,模型需要同时完成不同预测时域的预测任务。该功能依靠并行的预测头(heads)实现;每一个预测头使用各自的目标标签训练,分别对应短期、中期、长期预测。这套架构可以同时捕捉市场微观动态以及大范围市场走势。模型还可以根据市场上下文,在不同预测模式之间自动切换。
推理阶段,动态预测头调度(Dynamic Head Scheduling)开始生效。模型会根据波动率、趋势强度、模型置信度,激活不同的预测模块。这套自适应机制,让Time-MoE在交易场景中极具价值 —— 市场行情转瞬万变。
需要注意的是,Time-MoE针对大规模时间序列数据集训练进行了优化。框架作者使用Time-300B数据集训练模型。这是目前规模最大的公开数据集,涵盖九大领域,包含超过3000亿条时间序列数据点。这使得模型具备极强通用性、对分布偏移的鲁棒性,以及对未曾见过任务的泛化能力。同时,Time-MoE参数量最高可达24亿,但是推理阶段只会激活其中一部分参数,兼顾高性能与计算资源效率。
Time‑MoE算法
Time-MoE的核心思想是构建一套统一、可扩展的时间序列预测模型,既可以适配分析环境下的各类场景,又能够把计算资源负载控制在合理范围。该算法首先执行逐点分词 ,提取时间序列每一个时间步全部重要特征。该处理方式可以保证做数据聚合的时候不会丢失细节信息。
原始词元借助SwiGLU嵌入层完成变换,映射到富含信息的隐空间。
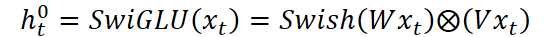
其中矩阵W和V与模型一同参与训练。按元素相乘运算⨂用来放大关键特征;Swish函数搭配门控线性单元,生成表达能力更强的嵌入向量,可以对复杂的非线性依赖关系进行编码。
嵌入完成后,随后,这些词元被送入由N个相同Transformer块组成的堆叠结构中。每个模块分为三个阶段:
- 归一化与因果注意力:对输入向量h_{t,l-1}首先进行归一化处理,之后送入带掩码约束的多头自注意力机制,其中掩码用来禁止模型访问未来时刻数据。词元仿佛回头审视此前的全部历史,但禁止窥探未来。就像一条铁则:当前的决策只能基于过往经验。
- 第二层 归一化可避免模型对罕见异常行情过度反应。
- 稀疏混合专家层:这里会把每个词元对应的历史表征分配给一组专家,即混合专家模块。自适应路由器从N个专家当中选出K个专家进行激活。还有第(N+1)个共享专家 ,会通过sigmoid加权函数始终参与计算。被激活的专家独立处理输入数据并输出各自预测结果。模块最终输出会和原始输入信号做残差相加。
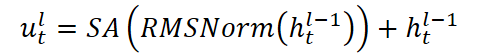
其中,SA代表具有H个注意力头的自注意力;每个注意力头只分析前面t-1个位置。该设计让模型可以捕捉历史中的关键事件,同时严格保留因果时序关系。
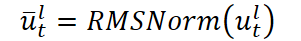
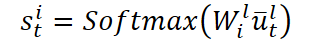
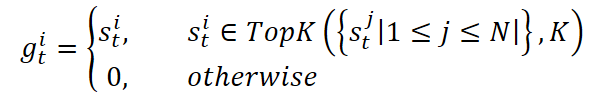
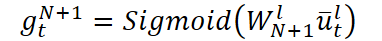
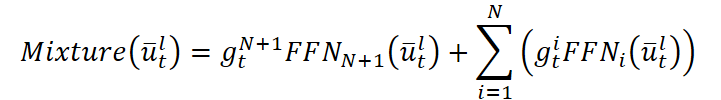
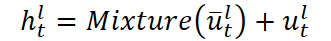
该结构支持动态选择专精子模型:市场处于高波动阶段时,词元会被路由至专门识别脉冲行情的专家子模型;而在行情平稳时期,则分配给更擅长处理趋势或者区间震荡状态的专家。Top-K专家选择机制可以限制处于激活状态的子网络数量,让绝大部分参数保持休眠状态。借此,模型可以扩展至数十亿参数量,同时把推理算力开销维持在固定水平。
当词元xT全部经过N层网络之后,我们得到上下文向量hT,L,该向量完整蕴含全部市场历史数据以及其中的行情模式。针对多分辨率预测(Multi‑Resolution Forecasting),通过若干个单层前馈网络(FFN),基于该向量生成P组预测结果,分别对应预测时域p1,…,pP。
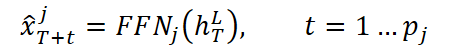
此架构能够在保持统一隐藏表示的同时,输出不同时间跨度的预测。
训练阶段,模型需要同时完成多个预测时域的预测任务:既包含分钟级的短期震荡,也覆盖以日、周为单位展开的中长期趋势。针对每一项预测任务,论文作者采用Huber损失函数,兼顾了平方误差的平滑性与线性误差的稳健性。当误差较小时,Huber 损失表现和经典均方误差MSE类似,对微小偏差做温和惩罚;当误差较大时,会逐步切换至 L1损失,降低稀有异常值带来的影响,避免梯度爆炸。随后模型对全部预测头输出的损失做聚合计算。
依托这套训练方式,模型可以同时学习捕捉短期脉冲行情与追踪长期趋势,并且保证各个时间层级的预测结果具备一致性。
但稀疏混合专家(MoE)架构会带来负载分配不均衡的风险:部分专家子模型负载过高,而另一些专家却处于闲置状态。为缓解该问题,训练中加入一项辅助正则项,用来度量专家之间的负载失衡程度。最终训练目标为主损失项与辅助正则项之和。
最后形成一套完整协同的流水线:从细粒度的词元化、专家动态路由、多层级预测,再到均衡化训练。
论文作者绘制的Time-MoE框架结构图如下。
在MQL5中的实现
至此,我们已经详细了解了Time-MoE框架的理论与核心要点,接下来进入实践环节,通过代码将理论转化为实现。然而,我们不会一次性完成全部开发,而是把整套系统拆解为逻辑独立的模块。我们将顺着数据流的流向,使用MQL5逐步实现该框架。这种分阶段、面向实操的开发方式,不仅便于对每个模块开展测试与调试,还能够将各个模块组装成一套功能完整、响应迅速的Time-MoE实现,使其可以在真实市场环境下高效稳定地运行。
根据Time-MoE论文作者提出的原始设计,全部输入数据首先经过逐点分词模块,它可以借助现有的卷积层高效实现。简单来说,每一根K线或者每一笔tick都会送入一个短一维卷积滤波器,卷积运算输出的结果就是携带一组特征的原子词元(atomic token)。该技术具备两大优势:第一,保留每一个时间点的全部信息,不会因为数据聚合产生信息损失;第二,卷积运算可以直接提取局部行情模式。
接下来,将数据送入SwiGLU嵌入层,下面我们就来讲解该模块。
SwiGLU嵌入层
词元生成完成之后,会进入第二阶段 —— SwiGLU嵌入模块。该模块将原始特征转换为表达能力丰富的隐空间向量。SwiGLU层会执行两路变换:
- 首先,词元经过线性投影,再送入平滑的Swish激活函数;
- 随后,再经过另一路投影以及具备选择功能的门控线性单元。
输出阶段,两路结果通过按元素相乘进行融合。
Swish起到平滑嵌入向量的作用,帮助模型捕捉微弱信号;而GLU会对向量各个分量执行开启或关闭操作,以此凸显真正关键的行情模式。
在我们的实现代码中,SwiGLU层封装为CNeuronSwiGLUOCL类,该类继承自基础神经网络层对象。我们会在此类内部创建两个专用卷积层,对输入向量执行双路投影,输出两路信号。该新对象的结构如下。
class CNeuronSwiGLUOCL  :  public   CNeuronBaseOCL
  {
protected:
   CNeuronConvOCL    caProjections[2];
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL)          override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL)   override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL)   override;

public:
                     CNeuronSwiGLUOCL(void) {};
                    ~CNeuronSwiGLUOCL(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl, uint window,
                          uint step, uint window_out, uint units_count, uint variables,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override const {   return defNeuronSwiGLUOCL; }
   //--- methods for working with files
   virtual bool      Save(int const file_handle)   override;
   virtual bool      Load(int const file_handle)   override;
   //---
   virtual void      SetOpenCL(COpenCLMy *obj)     override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
  };
我们这个新类的所有内部对象均采用静态声明。因此,构造函数与析构函数保持为空。所有投影矩阵与卷积参数的初始化,以及OpenCL上下文的连接,都由Init方法完成。用户可在该函数的入参中指定卷积窗口大小、步长、滤波器数量以及OpenCL上下文指针。以上设计使得我们能够在使用该层之前完成全部配置工作。
bool CNeuronSwiGLUOCL::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                            uint window, uint step, uint window_out, uint units_count,
                            uint variables, ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, units_count * window_out * variables,
                                                                    optimization_type, batch))
      return false;
   SetActivationFunction(None);
在该方法内部,我们将所有基础配置统一向上交给至父类处理,基础校验与通用接口的配置逻辑已在父类中实现。实现方式很简单:直接调用父类中同名方法。这样可以避免底层操作代码重复,同时保障执行环境的可靠性。
这里,我们在接口层面显式禁用当前层的激活函数,因为所有非线性变换都由内部对象实现。
基础设施相关细节处理完毕后,我们开始对该层进行精细调优。需要重点指出的是,两个内部卷积层的输出向量尺寸必须保持一致,这一点至关重要。原因在于只有维度匹配,我们才能正确执行逐元素乘法运算。二者唯一的区别是后续使用的激活函数各不相同。
因此,在初始化阶段,我们通过循环完成这两个层的初始化,自动为它们配置相同的卷积窗口、滤波器数量以及步长。该做法消除了代码冗余,并保证两个投影层的维度始终保持一致。
for(uint i = 0; i < caProjections.Size(); i++)
  {
   if(!caProjections[i].Init(0, i, OpenCL, window, step, window_out, units_count,
                                                variables, optimization, iBatch))
      return false;
  }
维度与基础参数校验完成后,我们为每一层单独配置激活函数,使最终得到的嵌入向量同时兼具平滑特征与选择性特征。该方案简化了代码维护工作,并实现了SwiGLU层内部职责的清晰划分。
   caProjections[0].SetActivationFunction(GELU);
   caProjections[1].SetActivationFunction(None);
//---
   return true;
  }
现在,我们就完成了SwiGLU层的初始化方法,将操作返回的布尔值结果传回调用程序。
当该层所有参数配置完成后,便可启动运算引擎,将待分析数据送入两个卷积投影层。我们开始构建前向传播算法,该算法在feedForward方法内实现。
bool CNeuronSwiGLUOCL::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   for(uint i = 0; i < caProjections.Size(); i++)
      if(!caProjections[i].FeedForward(NeuronOCL))
         return false;
和之前一样,该方法的入参接收一个指向输入数据对象的指针。这正是我们需要传入两个数据投影层的内容。我们通过循环执行该操作。声明对象数组即可实现这一能力。
正是因为两个层输出的张量维度完全一致,我们可以直接对其做逐元素乘法,无需担心维度不匹配问题。运算结果为单个输出张量,张量内每个数值都是Swish投影与GLU投影各自“观点”的乘积。该技术的核心是循环将数据指针在层数组中传递,这样能够保持代码简洁;只需要修改数组长度,就可以轻松扩展层内“分支”的数量。
   if(!ElementMult(caProjections[0].getOutput(), caProjections[1].getOutput(), Output))
      return false;
//---
   return true;
  }
我们将运算结果保存至该层的输出缓冲区,并向调用程序返回布尔值,结束本方法。
完成SwiGLU层的前向传播后,就需要追溯误差的传播路径,并构建反向传播流程。核心思路是把输出端的梯度反向分发回输入数据端,使梯度依次经过两个卷积投影器。该过程在calcInputGradients方法中实现。
bool CNeuronSwiGLUOCL::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
在方法体内部,我们获取输入数据对象的指针,也就是前向传播过程中使用的指针。只是这一次,我们需要按照输入数据对最终结果的影响权重,向其回传误差梯度。当然,想要正确传递数据,必须保证对象有效。因此,在执行后续操作前,我们先校验接收到的指针是否合法。
在该层的外部接口中,已经保存了当前预测值与目标值之间的差值。接下来,由于向量维度相互匹配,我们可以轻松分离出每个内部滤波器所对应的误差分量。
if(!ElementMultGrad(caProjections[0].getOutput(), caProjections[0].getGradient(),
                    caProjections[1].getOutput(), caProjections[1].getGradient(),
                    Gradient, caProjections[0].Activation(), caProjections[1].Activation()
                   ))
   return false;
我们将这两路数据流送入对应的卷积神经元。由于两个层各自维护独立的梯度缓冲区,每一层都会接收一个和输入数据维度相同的向量。
之后,每个内部卷积对象会独立继续传播自身对应的误差分量。但此时我们不能在循环内向输入数据对象直接写入数值。原因是后续操作会覆盖原有数据,抹掉之前保存的结果。而我们需要汇总所有信息流的数值。因此,我们先处理来自第一个投影层的误差梯度。
if(!NeuronOCL.calcHiddenGradients(caProjections[0].AsObject()))
   return false;
接下来,我们将输入数据对象的误差梯度缓冲区指针存入局部变量。再用另一个大小相同的空闲数据缓冲区接替它。
   CBufferFloat *temp = NeuronOCL.getGradient();
   if(!NeuronOCL.SetGradient(NeuronOCL.getPrevOutput(), false) ||
      !NeuronOCL.calcHiddenGradients(caProjections[1].AsObject()) ||
      !SumAndNormilize(temp, NeuronOCL.getGradient(), temp, 1, false, 0, 0, 0, 1) ||
      !NeuronOCL.SetGradient(temp, false)
     )
      return false;
//---
   return true;
  }
现在我们就可以安全地将数据送入第二条信息流。随后,对来自两个投影层的输出结果求和。这样来自不同信息流的每一分误差都能保留并正确累加,确保后续优化步骤中权重更新精准、稳定
最后,我们将各个数据缓冲区的指针恢复至初始状态,并向调用程序返回操作的布尔结果,结束本方法。
和往常一样,反向传播算法分为两个逻辑阶段。对于第一阶段 —— 误差梯度分发,我们已经进行了详细地讲解。这是关键步骤:它能够让误差沿着多分支信息流的全部特性,从层输出端正确传递至输入数据。
第二阶段是参数优化,目标是降低整体误差,这部分内容超出本文的讨论范围。并非因为它不重要,而是该逻辑被严格封装在各个卷积对象内部。这能带来一项重要的优势:类的接口不会充斥冗余细节,保持架构简洁与模块化。
权重更新所需的全部逻辑,已经在每个投影层内部实现。因此,要完成一轮完整的优化周期,只需依次调用所有内部对象对应的方法。得益于这种设计,主类代码保持精简,参数更新逻辑经过独立测试,具备高可靠性。
CNeuronSwiGLUOCL类及其全部方法(包含前向传播和反向传播函数)的完整源码见附件,可查阅以深入理解其全部内部运行机制。
至此,我们完成了SwiGLU嵌入组件的开发,可以进入下一阶段 —— 实现Time-MoE框架的核心模块 —— 改造后的Transformer块。这是模型开发的全新阶段:序列的高层语义理解正是在Transformer块内构建。模型将学习识别长期依赖关系、解析上下文,并预测未来行情的演化趋势。
将经过SwiGLU块变换后的时间序列送入Transformer模块,并非单纯的数据传递,而本质上是在传递知识。这些嵌入向量经过压缩,富含局部形态信息,成为深度分析的基础。然而,Time-MoE中的Transformer结构与经典版本差异很大。最明显的一点是,每一层注意力机制之后,不再附带常见的前馈网络( FeedForward)块。
论文作者没有使用标准模块,而是提出采用稀疏混合专家(简称MoE)。这种架构选择不仅赋予模型自适应能力,还让训练过程具备更强的上下文关联性。MoE的核心思想:把单一通用层拆分为一组高度专用的子模块(专家),每个专家专门学习处理特定类型的输入数据。借助这一机制,输入序列中的每个词元只会激活与其特征最匹配的少数专家,其余专家则保持待机状态。
自适应专家选择机制由路由(router)实现:这是一个独立子模块,根据词元的初始表征,决定启用哪些专家。原文重点说明的是,采用稀疏路由机制,每个词元不会一次性送入全部专家,仅选择其中少数专家(例如10个专家中选取2个)。这既能大幅降低计算开销,又避免了算力资源的严重过载,从而令大规模MoE的部署成为可能。
该方案为模型带来诸多的优势。第一,模型学会在专家之间分配任务:部分专家适配短期价格波动,另一些则专门处理趋势行情或波动率状态。第二,模型获得更强的知识泛化能力:不同专家学到不同模式,相比传统单层结构,能够拟合更复杂的交互关系。
因此,在Time-MoE的Transformer中引入稀疏混合专家结构,是该框架的核心创新点。这不只是一次架构实验,更是对时间序列处理范式的一次根本性重构。
这就引出了一个问题:我们该如何将这些架构思想落地实现?毕竟我们不只是做理论探讨,而是在一步步搭建一套可运行的系统。其实我们在此前的DUET框架时就已经接触过混合专家(MoE)的概念。当时我们搭建了一个非常简易的原型,帮助我们理解路由机制以及专家输出结果的聚合逻辑。但那套实现很难称得上是真正稀疏的。它更像是在模拟选择机制:所有专家会同时计算输出,之后再把输出结果与对应的掩码相乘。
从数学角度出发,最终结果看起来是合理的:掩码可以把不需要的专家输出置零,以此构造出可控的叠加结果。然而,坦白来说,在计算效率层面,这套方案存在明显短板。因为在这种实现方式下,无论专家的输出最终是否会被使用,每个专家都要完整执行全部计算。因此,计算复杂度会随专家数量线性增长,这直接抵消了MoE架构最核心的优势之一 —— 在不带来算力成本指数级上涨的前提下实现模型扩容。
当然,如果模型规模很小,专家数量和张量维度都不大,性能要求也不苛刻,这种方案尚可接受。但在真实场景下 —— 例如深层、宽层Transformer,每隔一层就使用MoE,专家数量可达数十个时,该方案就完全不可行。计算负载会迅速超出合理范围,尤其当我们需要实时运行模型时,比如用于金融市场的算法交易场景。
除此之外,随着专家数量增多,路由流程本身也会变得更加复杂。如果仍然一次性启用全部专家,必然会遇到GPU内存占用过高,以及OpenCL环境下性能下降的问题。这时候,遵循真正稀疏的设计理念就显得尤为重要:只让网络中的一小部分处于激活状态,并且恰好是当下所需的那部分。这一方案不仅节省算力,还能增强模型的适应性与抗噪能力。
在当前的实现中,我们不再局限于单纯形式上的掩码操作,而是更进一步,按照Time-MoE框架的设计理念,构建一套真正稀疏的算法。毫无疑问,这是一项涉及多个架构层级的艰巨开发任务。关键不只是简单编写一个新模块,而是搭建一套逻辑自洽的系统,让路由、激活、结果聚合与参数优化协同工作,完全贴合原始算法的设计思路。因此到这里,我建议我们稍作停顿。
我们已经取得了重大进展:完成自研SwiGLU嵌入层、搭建好了信息流,并且为集成混合专家打好了架构基础。这已经是一个扎实的底座,可以在此之上继续搭建模型的上层结构。然而,为了避免内容庞杂、偏离主线,我们计划单独用一篇文章讲解稀疏 MoE 的构建。这样一来,我们既能尽可能细致地剖析全部细节,也能保证代码与逻辑不会碎片化。
所以,我们就在这个合适的节点结束本篇内容,欢迎大家在下一篇文章中继续探索,届时我们将正式引入稀疏MoE模块。
结论
在本文中,我们探讨了Time-MoE架构,该高级框架出自论文《Time‑MoE:具备混合专家结构的十亿级别时间序列基础模型》。该模型成功融合Transformer方法与稀疏混合专家理念,借助自适应计算路由机制提升预测效果。Time-MoE的核心优势之一是能够有效处理时间序列中的短期与长期依赖关系。SwiGLU模块的引入进一步提升了模型的灵活性。
在实践章节,我们基于MQL5,按照自己的理解对上述方案进行开发,一步步将理论概念转化为可运行代码。在当前阶段,我们实现了SwiGLU嵌入块:由两个卷积投影层构成,并采用逐元素乘法运算。我们重点讲解了前向传播、反向传播、梯度的合理分发,以及卷积层内部的数据处理流程。
至此,基础框架已经搭建完毕,我们可以继续推进。在下一部分中,我们将着手构建真正的稀疏MoE块,该模块需要更复杂的路由逻辑与专家管理机制。它是Time-MoE架构的核心组件,其实现既需要周密规划,也离不开创造性的工程方案。
链接
文中所用的程序
| # | 名称 | 类型 | 描述 |
|---|---|---|---|
| 1 | Research.mq5 | EA | EA示例集合 |
| 2 | ResearchRealORL.mq5 | EA | 使用Real-ORL方法的EA示例集合 |
| 3 | Study.mq5 | EA | 用于离线模型训练的EA |
| 4 | StudyOnline.mq5 | EA | 用于在线模型训练的EA |
| 5 | Test.mq5 | EA | 模型测试EA |
| 6 | Trajectory.mqh | 类库 | 用于描述系统状态与模型架构的结构 |
| 7 | NeuroNet.mqh | 类库 | 用于构建神经网络的类库 |
| 8 | NeuroNet.cl | 库 | OpenCL程序代码库 |
本文由MetaQuotes Ltd译自俄文
原文地址: https://www.mql5.com/ru/articles/18499
注意: MetaQuotes Ltd.将保留所有关于这些材料的权利。全部或部分复制或者转载这些材料将被禁止。
本文由网站的一位用户撰写,反映了他们的个人观点。MetaQuotes Ltd 不对所提供信息的准确性负责,也不对因使用所述解决方案、策略或建议而产生的任何后果负责。