

Superando las limitaciones del aprendizaje automático (Parte 4): Cómo superar el error irreducible mediante múltiples horizontes de previsión
 34
 1

El aprendizaje automático es un campo muy amplio que puede estudiarse e interpretarse desde muchas perspectivas diferentes. Precisamente esta amplitud hace que resulte desafiante para cualquiera de nosotros dominarlo. En nuestra serie de artículos, hemos tratado algunos temas relacionados con el aprendizaje automático desde un punto de vista estadístico o desde la perspectiva del álgebra lineal. Sin embargo, rara vez prestamos atención a la interpretación geométrica de los modelos de aprendizaje automático. Tradicionalmente, se dice que los modelos de aprendizaje automático se aproximan a una función que asigna a cada entrada una salida. No obstante, desde un punto de vista geométrico, esto es incompleto.
Lo que hacen realmente los modelos es incrustar la imagen del objetivo en el espacio definido por las entradas, de modo que, en el futuro, puedan intentar describir la variable objetivo utilizando únicamente esas entradas. Haciendo esto, el modelo define una nueva variedad a partir de los datos de entrada y realiza predicciones en esta nueva variedad. Pero la variable objetivo real se encuentra en su propia variedad. Esta desalineación da lugar a una forma sutil, pero inevitable, de error irreducible: el modelo nunca apunta realmente a la variable objetivo, sino que solo puede apuntar a alguna combinación de las entradas.
Quizá nos sirva de ayuda un experimento mental. Imagine que le dan registros de las velocidades de dos coches y le piden que decida cuál de los dos se desplaza más rápido. Parece bastante sencillo… hasta que descubre que la velocidad de un coche se mide en millas por minuto y la del otro en kilómetros por hora. Sus juicios dejan de ser fiables porque las mediciones están expresadas en unidades distintas. Del mismo modo, las predicciones del modelo se expresan en un sistema de coordenadas diferente de aquel en el que se encuentra la variable objetivo real. Es decir, el modelo puede crear sus propias unidades sobre la marcha.
A veces, estas discrepancias entre unidades son inofensivas; en los casos en que la variable objetivo pertenece realmente al espacio generado por las entradas, este error de desalineación puede ser prácticamente igual a 0. Pero en el trading, ignorarlas puede salir muy caro. Los modelos de aprendizaje automático transforman internamente las coordenadas y nos sitúan en un sistema de coordenadas distinto del sistema en el que vive la variable objetivo. En los mercados financieros, a diferencia de lo que ocurre en las ciencias naturales, no tenemos la garantía de que nuestros datos de entrada expliquen perfectamente la variable objetivo. En este caso, estamos trabajando en parte a ciegas.
En nuestra serie relacionada sobre asesores expertos autooptimizables, analizamos cómo se pueden construir modelos de regresión lineal mediante la factorización de matrices, presentamos la biblioteca OpenBLAS y explicamos la descomposición en valores singulares (SVD). Los lectores que no estén familiarizados con esa explicación deberían consultarla, ya que este artículo parte de esa misma base; el enlace está disponible aquí.
Para los lectores que nos acompañan de artículos anteriores, recordemos que la SVD factoriza una matriz en tres matrices más pequeñas: U, S y VT. Cada una de ellas tiene propiedades geométricas especiales. U y VT son matrices ortogonales, lo que significa que representan rotaciones o reflexiones de los datos originales y, lo que resulta crucial, no modifican la longitud de los vectores, sino que solo cambian su dirección. S, la matriz central, es diagonal y escala los valores de los datos. En conjunto, la SVD puede entenderse como una secuencia de rotación, escalado y rotación aplicada a los datos. Así es como los modelos de regresión lineal incorporan imágenes de la variable objetivo al espacio de las entradas. Por consiguiente, si reducimos la regresión lineal a su esencia geométrica, se trata simplemente de girar, escalar y volver a girar. Nada más. Y ya está. Girar, escalar, girar. Estudiar geometría le enseñará a verlo de esta manera, pero una vez que lo haga, surgirá una pregunta provocadora: ¿dónde tiene lugar realmente todo ese «aprendizaje»?La respuesta es inquietante. Lo que los profesionales denominan «aprendizaje» no es, en realidad, más que alinear sistemas de coordenadas y reescalar los ejes para que la variable objetivo pueda proyectarse en el subespacio generado por las entradas. No estamos descubriendo verdades ocultas en los datos. Estamos aplicando una secuencia de transformaciones geométricas hasta que dos variedades se alineen lo suficiente como para que las predicciones parezcan razonables.
De hecho, la SVD es el proceso mediante el cual se genera el nuevo sistema de coordenadas. En la regresión lineal, los datos de entrada se proyectan sobre un conjunto de ejes ortogonales, se escalan y se rotan de nuevo a su orientación original, creando así un espacio transformado en el que se puede aproximar la variable objetivo con la mayor precisión posible. El «aprendizaje» del modelo no supone más que la alineación de la variable objetivo con este nuevo sistema de coordenadas.
Desde este marco geométrico, podemos fundamentar ciertas buenas prácticas acotadas al dominio que, de otro modo, parecerían carecer de fundamento. La conclusión principal consiste en que debemos dejar de hacer comparaciones directas entre las predicciones de un modelo y el valor real de la variable objetivo. En cambio, deberíamos comparar las predicciones del modelo entre sí, en distintos horizontes temporales.
Por ejemplo, supongamos que el modelo predice que el precio de cierre a un paso por delante será de 5 $ y a diez pasos por delante será de 15 $. La pendiente entre estas previsiones es positiva, así que compramos. Si la pendiente es negativa, vendemos. Dejamos de esperar que las predicciones coincidan perfectamente con la realidad —porque la desalineación entre variedades puede hacer que eso sea imposible para siempre— y, en su lugar, operamos basándonos en la pendiente relativa entre las previsiones. Este formato de predicción a varios pasos no es nuevo en el trading algorítmico; más bien, el objetivo de este artículo es transmitir al lector que las predicciones a varios pasos deberían ser el patrón oro de facto a la hora de emplear modelos de aprendizaje automático.
Este artículo no pretende reducir ni eliminar el error geométrico. En cambio, nos enseña a minimizar nuestra interacción con él, manteniéndonos al margen del ámbito en el que predomina el error.
En nuestra metodología, partimos de un modelo de aprendizaje automático entrenado con nueve variables objetivo diferentes. Estas variables objetivo eran las medias móviles de los precios de cierre, máximo y mínimo a 1, 5 y 10 velas diarias por delante. La configuración de control siguió el enfoque clásico: predecir el valor real de la variable objetivo a una vela por delante, compararlo con el valor actual de la variable objetivo y operar en consecuencia. Como podrá comprobar el lector, hemos superado en repetidas ocasiones los resultados de esta metodología clásica al prescindir de las comparaciones directas y, en su lugar, comparar entre sí las predicciones del propio modelo en distintos horizontes temporales. La idea general es sencilla, pero muy eficaz: las predicciones de nuestro modelo pueden resultarnos más rentables si las comparamos entre sí que si las comparamos con la variable objetivo real.
Hemos realizado una prueba retrospectiva de la configuración de control con datos históricos de tres años, desde marzo de 2022 hasta mayo de 2025. La configuración de control generó un beneficio neto de 71$ durante este periodo. Con solo modificar la forma en que interpretamos las predicciones del modelo, conseguimos aumentar el beneficio neto hasta los 180$, lo que supone una mejora de la rentabilidad del 153 %. Nuestro ratio de Sharpe ha aumentado de 0,45 a 2,16 y nuestro porcentaje de operaciones rentables ha pasado del 46 % al 65 %, lo que supone una mejora del 41 % en la precisión de las operaciones.
La conclusión clave es que todas las mejoras que ahora vamos a mostrar al lector se llevarán a cabo sin cambiar en ningún momento el modelo en el que nos basamos y pueden aplicarse a cualquier otro modelo de aprendizaje automático que el lector ya conozca.
Recuperación de datos de mercado
Vamos a comenzar escribiendo un script en MQL5 para obtener los datos históricos del mercado que necesitamos. Extraer datos históricos de mercado de su terminal MetaTrader 5 supone una práctica recomendada, ya que garantiza que nuestros modelos ONNX se entrenen con datos históricos que sean coherentes con el entorno de producción final. Nuestro script de MQL5 recopila registros detallados sobre los cuatro niveles de precio principales y sus medias móviles. También vamos a prestar atención al crecimiento de cada uno de estos niveles de precio con respecto a su valor cinco pasos atrás. Todos estos datos se exportan a un archivo CSV y se guardan en su disco duro.
//+------------------------------------------------------------------+
//|                                                      ProjectName |
//|                                      Copyright 2020, CompanyName |
//|                                       http://www.companyname.net |
//+------------------------------------------------------------------+
#property copyright "Copyright 2024, MetaQuotes Ltd."
#property link      "https://www.mql5.com"
#property version   "1.00"
#property script_show_inputs

//--- Define our moving average indicator
#define MA_PERIOD 5                 //--- Moving Average Period
#define MA_TYPE   MODE_SMA          //--- Type of moving average we have
#define HORIZON   5                 //--- Forecast horizon

//--- Our handlers for our indicators
int ma_handle,ma_o_handle,ma_h_handle,ma_l_handle;

//--- Data structures to store the readings from our indicators
double ma_reading[],ma_o_reading[],ma_h_reading[],ma_l_reading[];

//--- File name
string file_name = Symbol() + " Detailed Market Data As Series Moving Average.csv";

//--- Amount of data requested
input int size = 3000;

//+------------------------------------------------------------------+
//| Our script execution                                             |
//+------------------------------------------------------------------+
void OnStart()
  {
   int fetch = size + (HORIZON * 2);
//---Setup our technical indicators
   ma_handle = iMA(_Symbol,PERIOD_CURRENT,MA_PERIOD,0,MA_TYPE,PRICE_CLOSE);
   ma_o_handle = iMA(_Symbol,PERIOD_CURRENT,MA_PERIOD,0,MA_TYPE,PRICE_OPEN);
   ma_h_handle = iMA(_Symbol,PERIOD_CURRENT,MA_PERIOD,0,MA_TYPE,PRICE_HIGH);
   ma_l_handle = iMA(_Symbol,PERIOD_CURRENT,MA_PERIOD,0,MA_TYPE,PRICE_LOW);

//---Set the values as series
   CopyBuffer(ma_handle,0,0,fetch,ma_reading);
   ArraySetAsSeries(ma_reading,true);
   CopyBuffer(ma_o_handle,0,0,fetch,ma_o_reading);
   ArraySetAsSeries(ma_o_reading,true);
   CopyBuffer(ma_h_handle,0,0,fetch,ma_h_reading);
   ArraySetAsSeries(ma_h_reading,true);
   CopyBuffer(ma_l_handle,0,0,fetch,ma_l_reading);
   ArraySetAsSeries(ma_l_reading,true);

//---Write to file
   int file_handle=FileOpen(file_name,FILE_WRITE|FILE_ANSI|FILE_CSV,",");

   for(int i=size;i>=1;i--)
     {
      if(i == size)
        {
         FileWrite(file_handle,"Time",
                   //--- OHLC
                   "True Open",
                   "True High",
                   "True Low",
                   "True Close",
                   //--- MA OHLC
                   "True MA C",
                   "True MA O",
                   "True MA H",
                   "True MA L",
                   //--- Growth in OHLC
                   "Diff Open",
                   "Diff High",
                   "Diff Low",
                   "Diff Close",
                   //--- Growth in MA OHLC
                   "Diff MA Close 2",
                   "Diff MA Open 2",
                   "Diff MA High 2",
                   "Diff MA Low 2"
                  );
        }

      else
        {
         FileWrite(file_handle,
                   iTime(_Symbol,PERIOD_CURRENT,i),
                   //--- OHLC
                   iClose(_Symbol,PERIOD_CURRENT,i),
                   iOpen(_Symbol,PERIOD_CURRENT,i),
                   iHigh(_Symbol,PERIOD_CURRENT,i),
                   iLow(_Symbol,PERIOD_CURRENT,i),
                   //--- MA OHLC
                   ma_reading[i],
                   ma_o_reading[i],
                   ma_h_reading[i],
                   ma_l_reading[i],
                   //--- Growth in OHLC
                   iOpen(_Symbol,PERIOD_CURRENT,i)   - iOpen(_Symbol,PERIOD_CURRENT,(i + HORIZON)),
                   iHigh(_Symbol,PERIOD_CURRENT,i)   - iHigh(_Symbol,PERIOD_CURRENT,(i + HORIZON)),
                   iLow(_Symbol,PERIOD_CURRENT,i)    - iLow(_Symbol,PERIOD_CURRENT,(i + HORIZON)),
                   iClose(_Symbol,PERIOD_CURRENT,i)  - iClose(_Symbol,PERIOD_CURRENT,(i + HORIZON)),
                   //--- Growth in MA OHLC
                   ma_reading[i] - ma_reading[(i + HORIZON)],
                   ma_o_reading[i] - ma_o_reading[(i + HORIZON)],
                   ma_h_reading[i] - ma_h_reading[(i + HORIZON)],
                   ma_l_reading[i] - ma_l_reading[(i + HORIZON)]
                  );
        }
     }
//--- Close the file
   FileClose(file_handle);
  }
//+------------------------------------------------------------------+

//+------------------------------------------------------------------+
//| Undefine system constants                                        |
//+------------------------------------------------------------------+
#undef HORIZON
#undef MA_PERIOD
#undef MA_TYPE
//+------------------------------------------------------------------+
Análisis de datos de mercado
Ya podemos prepararnos para importar nuestros datos históricos de mercado. En primer lugar, cargue algunas bibliotecas de Python para la manipulación de datos.
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
Ahora vamos a definir tres horizontes temporales distintos para los que queremos realizar previsiones.
#Define our different forecast horizons
H1 = 1
H2 = 5
H3 = 10
Después leemos los datos de mercado que hemos exportado desde nuestro terminal y a crear variables objetivo para las medias móviles en distintos horizontes temporales.
#Read in the data
data = pd.read_csv('../EURUSD Detailed Market Data As Series Moving Average.csv')

#Label the data
data['Target 1'] = data['True MA C'].shift(-H1)
data['Target 2'] = data['True MA C'].shift(-H2)
data['Target 3'] = data['True MA C'].shift(-H3)
data['Target 4'] = data['True MA H'].shift(-H1)
data['Target 5'] = data['True MA H'].shift(-H2)
data['Target 6'] = data['True MA H'].shift(-H3)
data['Target 7'] = data['True MA L'].shift(-H1)
data['Target 8'] = data['True MA L'].shift(-H2)
data['Target 9'] = data['True MA L'].shift(-H3)

#Drop missing rows
data = data.iloc[:-H3,:]
Ahora cree una partición de entrenamiento.
data      = data.iloc[:-(365*3),:]
data_test = data.iloc[-(365*3):,:]
Separe las entradas y las variables objetivo.
X = data.iloc[:,1:-9]
y = data.iloc[:,-9:]
Cargue cualquier modelo de aprendizaje automático que elija. En esta explicación utilizamos la biblioteca sklearn y demostramos los principios expuestos mediante un modelo lineal.
from sklearn.linear_model import LinearRegression
Inicialice el modelo.
model = LinearRegression()
Ajuste el modelo.
model.fit(X,y)
Obtenga las predicciones del modelo para el conjunto de prueba, pero no ajuste el modelo con ese conjunto. Como podemos ver, las predicciones del modelo parecen ajustarse bien a los valores de la variable objetivo, pero, como veremos a continuación, nuestro modelo puede ofrecer un rendimiento aún mejor.
preds = pd.DataFrame(model.predict(data_test.iloc[:,1:-9]))
plt.plot(data_test.iloc[:,-9].reset_index(drop=True),color='black')
plt.plot(preds.iloc[:,0],color='red',linestyle=':')
plt.grid()
plt.title("Out Of Sample Forecasting")
plt.ylabel('EUR/USD Exchange Rate')
plt.xlabel('Time')
plt.legend(['Actual Price','Forecasted Price'])
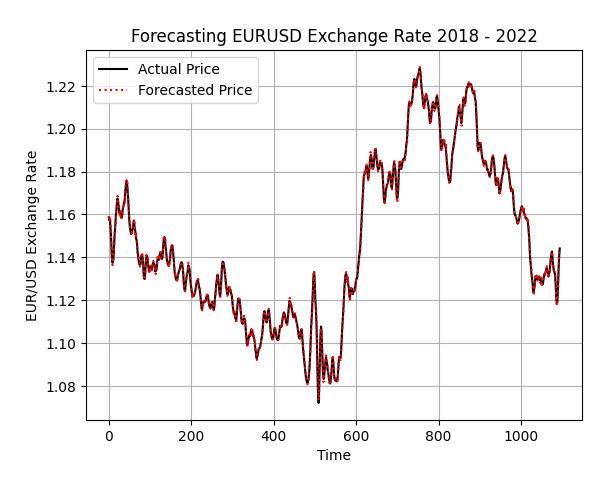
Figura 1: Las predicciones del modelo fuera de la muestra parecen concordar con los valores reales de la variable objetivo, pero es posible superar este nivel de rendimiento
ONNX son las siglas de «Open Neural Network Exchange» y nos permite crear e implementar modelos de aprendizaje automático en una biblioteca estandarizada que está siendo adoptada por un número cada vez mayor de lenguajes de programación. Utilizaremos la biblioteca ONNX para exportar nuestro modelo de aprendizaje automático desde Python y, a continuación, lo importaremos a MQL5. ONNX nos permite desarrollar rápidamente modelos de aprendizaje automático e implementarlos.
import onnx
from skl2onnx import convert_sklearn
from skl2onnx.common.data_types import FloatTensorType
Debemos definir las dimensiones de entrada y salida de nuestros modelos ONNX. Esto se puede hacer fácilmente porque antes separamos las entradas de las salidas. Basta con obtener el número de columnas de cada partición y guardar esos valores. Con Pandas, obtener esta información es muy sencillo gracias a la propiedad «shape».
initial_types = [("FLOAT INPUT",FloatTensorType([1,X.shape[1]]))]
final_types = [("FLOAT OUTPUT",FloatTensorType([y.shape[1],1]))]
Cree un prototipo ONNX del modelo de aprendizaje automático. Especificaremos el número de entradas y salidas que necesitamos para nuestro modelo.
model_proto = convert_sklearn(model,initial_types=initial_types,target_opset=12) Guarde el modelo ONNX en el disco.
onnx.save(model_proto,"EURUSD MFH LR D1.onnx")
Establecimiento de un nivel de rendimiento de referencia
Ya estamos listos para establecer un nivel de rendimiento de referencia. Vamos a empezar fijando el mayor número posible de parámetros de la estrategia, para garantizar la coherencia de las pruebas.//+------------------------------------------------------------------+ //| MFH.mq5 | //| Gamuchirai Ndawana | //| https://www.mql5.com/en/users/gamuchiraindawa | //+------------------------------------------------------------------+ #property copyright "Gamuchirai Ndawana" #property link "https://www.mql5.com/en/users/gamuchiraindawa" #property version "1.00" //+------------------------------------------------------------------+ //| System definitions | //+------------------------------------------------------------------+ #define SYSTEM_INPUTS 16 #define SYSTEM_OUTPUTS 9 #define ATR_PERIOD 14 #define ATR_PADDING 1 #define TF_1 PERIOD_D1 #define TF_2 PERIOD_M15 #define MA_PERIOD 5 #define MA_TYPE MODE_SMA #define HORIZON 5
Cargue el búfer ONNX que hemos exportado desde Python.
//+------------------------------------------------------------------+ //| System resources | //+------------------------------------------------------------------+ #resource "\\Files\\EURUSD MFH LR D1.onnx" as const uchar onnx_buffer[];
También podemos recurrir a algunas bibliotecas para gestionar tareas rutinarias de nuestra negociación algorítmica, como la ejecución de operaciones, la formación de velas y la gestión del búfer ONNX.
//+------------------------------------------------------------------+ //| System libraries | //+------------------------------------------------------------------+ #include <Trade\Trade.mqh> #include <VolatilityDoctor\ONNX\ONNXFloat.mqh> #include <VolatilityDoctor\Time\Time.mqh> #include <VolatilityDoctor\Trade\TradeInfo.mqh> ONNXFloat *ONNXHandler; Time *TimeHandler; Time *LowerTimeHandler; TradeInfo *TradeHandler; CTrade Trade;
Se necesitan unas cuantas variables globales, principalmente para gestionar los indicadores técnicos y almacenar las predicciones del modelo ONNX.
//+------------------------------------------------------------------+ //| Global variables | //+------------------------------------------------------------------+ int ma_handle,ma_o_handle,ma_h_handle,ma_l_handle,fetch,atr_handler; double ma_reading[],ma_o_reading[],ma_h_reading[],ma_l_reading[],atr[]; double padding; vector model_prediction;
Cuando se cargue nuestra aplicación por primera vez, inicializaremos nuestras variables globales y clases personalizadas, y también almacenaremos los identificadores de los indicadores técnicos que hemos creado.
//+------------------------------------------------------------------+ //| Expert initialization function | //+------------------------------------------------------------------+ int OnInit() { //--- fetch = HORIZON * 2; ONNXHandler = new ONNXFloat(onnx_buffer); LowerTimeHandler = new Time(Symbol(),TF_2); TimeHandler = new Time(Symbol(),TF_1); TradeHandler = new TradeInfo(Symbol(),TF_1); ONNXHandler.DefineOnnxInputShape(0,1,SYSTEM_INPUTS); ONNXHandler.DefineOnnxOutputShape(0,1,SYSTEM_OUTPUTS); ma_handle = iMA(Symbol(),TF_1,MA_PERIOD,0,MA_TYPE,PRICE_CLOSE); ma_o_handle = iMA(Symbol(),TF_1,MA_PERIOD,0,MA_TYPE,PRICE_OPEN); ma_h_handle = iMA(Symbol(),TF_1,MA_PERIOD,0,MA_TYPE,PRICE_HIGH); ma_l_handle = iMA(Symbol(),TF_1,MA_PERIOD,0,MA_TYPE,PRICE_LOW); atr_handler = iATR(Symbol(),TF_1,MA_PERIOD); model_prediction = vector::Zeros(SYSTEM_OUTPUTS); //--- return(INIT_SUCCEEDED); }
En MQL5 es habitual aplicar una buena gestión de la memoria y liberar los recursos que ya no se utilizan.
//+------------------------------------------------------------------+ //| Expert deinitialization function | //+------------------------------------------------------------------+ void OnDeinit(const int reason) { //--- delete ONNXHandler; IndicatorRelease(ma_h_handle); IndicatorRelease(ma_o_handle); IndicatorRelease(ma_l_handle); IndicatorRelease(ma_handle); IndicatorRelease(atr_handler); }
Cuando se reciban nuevos niveles de precios, actualizaremos los búferes de los indicadores técnicos y los niveles de stop loss. A continuación, comprobaremos si tenemos posiciones abiertas. Si no hay ninguna posición abierta, buscaremos una oportunidad de negociación; de lo contrario, gestionaremos la posición abierta utilizando un stop loss dinámico.
//+------------------------------------------------------------------+ //| Expert tick function | //+------------------------------------------------------------------+ void OnTick() { //--- Has a new candle formed if(TimeHandler.NewCandle()) { //---Set the values as series CopyBuffer(ma_handle,0,0,fetch,ma_reading); ArraySetAsSeries(ma_reading,true); CopyBuffer(ma_o_handle,0,0,fetch,ma_o_reading); ArraySetAsSeries(ma_o_reading,true); CopyBuffer(ma_h_handle,0,0,fetch,ma_h_reading); ArraySetAsSeries(ma_h_reading,true); CopyBuffer(ma_l_handle,0,0,fetch,ma_l_reading); ArraySetAsSeries(ma_l_reading,true); CopyBuffer(atr_handler,0,0,fetch,atr); ArraySetAsSeries(atr,true); padding = (atr[0] * ATR_PADDING); //--- Obtain a prediction from our model if(PositionsTotal() == 0) { model_predict(); } //--- Manage open positions if(PositionsTotal() >0) { manage_setup(); } } } //+------------------------------------------------------------------+
Nuestro stop loss dinámico se definirá mediante el indicador ATR (rango verdadero medio). El ATR mide la volatilidad del mercado y nos ayuda a ajustar dinámicamente nuestros niveles de riesgo. Si es posible ajustar el stop loss de forma segura a un nivel más rentable, lo haremos; de lo contrario, esperaremos.
//+------------------------------------------------------------------+ //| Manage our open positions | //+------------------------------------------------------------------+ void manage_setup(void) { //--- Select the position by its ticket number if(PositionSelectByTicket(PositionGetTicket(0))) { //--- Store the current tp and sl levels double current_tp,current_sl; current_tp = PositionGetDouble(POSITION_TP); current_sl = PositionGetDouble(POSITION_SL); //--- Before we calculate the new stop loss or take profit double new_sl,new_tp; //--- We first check the position type if(PositionGetInteger(POSITION_TYPE) == POSITION_TYPE_BUY) { new_sl = TradeHandler.GetBid()-padding; new_tp = TradeHandler.GetBid()+padding; //--- Check if the new stops are more profitable if(new_sl>current_sl) Trade.PositionModify(Symbol(),new_sl,new_tp); } if(PositionGetInteger(POSITION_TYPE) == POSITION_TYPE_SELL) { new_sl = TradeHandler.GetAsk()+padding; new_tp = TradeHandler.GetAsk()-padding; //--- Check if the new stops are more profitable if(new_sl<current_sl) Trade.PositionModify(Symbol(),new_sl,new_tp); } } }
En primer lugar, probaremos nuestra aplicación sin un modelo de aprendizaje automático para establecer un nivel de referencia de rentabilidad. Utilizaremos una estrategia de ruptura sencilla como referencia que nuestros modelos de aprendizaje automático deberán superar. Los modelos que no alcanzan este nivel de rendimiento son inaceptables.
//+------------------------------------------------------------------+ //| Obtain a prediction from our model | //+------------------------------------------------------------------+ void model_predict(void) { if(iHigh(Symbol(),TF_2,1)<iOpen(Symbol(),TF_2,0)) { Trade.Buy(TradeHandler.MinVolume(),TradeHandler.GetSymbol(),TradeHandler.GetAsk(),TradeHandler.GetBid()-padding,TradeHandler.GetBid()+padding); } if(iLow(Symbol(),TF_2,1)>iOpen(Symbol(),TF_2,0)) { Trade.Sell(TradeHandler.MinVolume(),TradeHandler.GetSymbol(),TradeHandler.GetBid(),TradeHandler.GetAsk()+padding,TradeHandler.GetAsk()-padding); } } //+------------------------------------------------------------------+
Por último, anule la definición de todas las constantes del sistema que hemos creado anteriormente.
//+------------------------------------------------------------------+ //| Undefine system constants | //+------------------------------------------------------------------+ #undef MA_PERIOD #undef MA_TYPE #undef HORIZON #undef TF_1 #undef TF_2 #undef SYSTEM_INPUTS #undef SYSTEM_OUTPUTS #undef ATR_PADDING #undef ATR_PERIOD
En conjunto, este es el aspecto de nuestro sistema.
//+------------------------------------------------------------------+ //| MFH.mq5 | //| Gamuchirai Ndawana | //| https://www.mql5.com/en/users/gamuchiraindawa | //+------------------------------------------------------------------+ #property copyright "Gamuchirai Ndawana" #property link "https://www.mql5.com/en/users/gamuchiraindawa" #property version "1.00" //+------------------------------------------------------------------+ //| System definitions | //+------------------------------------------------------------------+ #define SYSTEM_INPUTS 16 #define SYSTEM_OUTPUTS 9 #define ATR_PERIOD 14 #define ATR_PADDING 1 #define TF_1 PERIOD_D1 #define TF_2 PERIOD_M15 #define MA_PERIOD 5 #define MA_TYPE MODE_SMA #define HORIZON 5 //+------------------------------------------------------------------+ //| System resources | //+------------------------------------------------------------------+ #resource "\\Files\\EURUSD MFH LR D1.onnx" as const uchar onnx_buffer[]; //+------------------------------------------------------------------+ //| System libraries | //+------------------------------------------------------------------+ #include <Trade\Trade.mqh> #include <VolatilityDoctor\ONNX\ONNXFloat.mqh> #include <VolatilityDoctor\Time\Time.mqh> #include <VolatilityDoctor\Trade\TradeInfo.mqh> ONNXFloat *ONNXHandler; Time *TimeHandler; Time *LowerTimeHandler; TradeInfo *TradeHandler; CTrade Trade; //+------------------------------------------------------------------+ //| Global variables | //+------------------------------------------------------------------+ int ma_handle,ma_o_handle,ma_h_handle,ma_l_handle,fetch,atr_handler; double ma_reading[],ma_o_reading[],ma_h_reading[],ma_l_reading[],atr[]; double padding; vector model_prediction; //+------------------------------------------------------------------+ //| Expert initialization function | //+------------------------------------------------------------------+ int OnInit() { //--- fetch = HORIZON * 2; ONNXHandler = new ONNXFloat(onnx_buffer); LowerTimeHandler = new Time(Symbol(),TF_2); TimeHandler = new Time(Symbol(),TF_1); TradeHandler = new TradeInfo(Symbol(),TF_1); ONNXHandler.DefineOnnxInputShape(0,1,SYSTEM_INPUTS); ONNXHandler.DefineOnnxOutputShape(0,1,SYSTEM_OUTPUTS); ma_handle = iMA(Symbol(),TF_1,MA_PERIOD,0,MA_TYPE,PRICE_CLOSE); ma_o_handle = iMA(Symbol(),TF_1,MA_PERIOD,0,MA_TYPE,PRICE_OPEN); ma_h_handle = iMA(Symbol(),TF_1,MA_PERIOD,0,MA_TYPE,PRICE_HIGH); ma_l_handle = iMA(Symbol(),TF_1,MA_PERIOD,0,MA_TYPE,PRICE_LOW); atr_handler = iATR(Symbol(),TF_1,MA_PERIOD); model_prediction = vector::Zeros(SYSTEM_OUTPUTS); //--- return(INIT_SUCCEEDED); } //+------------------------------------------------------------------+ //| Expert deinitialization function | //+------------------------------------------------------------------+ void OnDeinit(const int reason) { //--- delete ONNXHandler; IndicatorRelease(ma_h_handle); IndicatorRelease(ma_o_handle); IndicatorRelease(ma_l_handle); IndicatorRelease(ma_handle); IndicatorRelease(atr_handler); } //+------------------------------------------------------------------+ //| Expert tick function | //+------------------------------------------------------------------+ void OnTick() { //--- Has a new candle formed if(TimeHandler.NewCandle()) { //---Set the values as series CopyBuffer(ma_handle,0,0,fetch,ma_reading); ArraySetAsSeries(ma_reading,true); CopyBuffer(ma_o_handle,0,0,fetch,ma_o_reading); ArraySetAsSeries(ma_o_reading,true); CopyBuffer(ma_h_handle,0,0,fetch,ma_h_reading); ArraySetAsSeries(ma_h_reading,true); CopyBuffer(ma_l_handle,0,0,fetch,ma_l_reading); ArraySetAsSeries(ma_l_reading,true); CopyBuffer(atr_handler,0,0,fetch,atr); ArraySetAsSeries(atr,true); padding = (atr[0] * ATR_PADDING); } if(LowerTimeHandler.NewCandle()) { //--- Obtain a prediction from our model if(PositionsTotal() == 0) { model_predict(); } //--- Manage open positions if(PositionsTotal() >0) { manage_setup(); } } } //+------------------------------------------------------------------+ //+------------------------------------------------------------------+ //| Manage our open positions | //+------------------------------------------------------------------+ void manage_setup(void) { //--- Select the position by its ticket number if(PositionSelectByTicket(PositionGetTicket(0))) { //--- Store the current tp and sl levels double current_tp,current_sl; current_tp = PositionGetDouble(POSITION_TP); current_sl = PositionGetDouble(POSITION_SL); //--- Before we calculate the new stop loss or take profit double new_sl,new_tp; //--- We first check the position type if(PositionGetInteger(POSITION_TYPE) == POSITION_TYPE_BUY) { new_sl = TradeHandler.GetBid()-padding; new_tp = TradeHandler.GetBid()+padding; //--- Check if the new stops are more profitable if(new_sl>current_sl) Trade.PositionModify(Symbol(),new_sl,new_tp); } if(PositionGetInteger(POSITION_TYPE) == POSITION_TYPE_SELL) { new_sl = TradeHandler.GetAsk()+padding; new_tp = TradeHandler.GetAsk()-padding; //--- Check if the new stops are more profitable if(new_sl<current_sl) Trade.PositionModify(Symbol(),new_sl,new_tp); } } } //+------------------------------------------------------------------+ //| Obtain a prediction from our model | //+------------------------------------------------------------------+ void model_predict(void) { if(iHigh(Symbol(),TF_2,1)<iOpen(Symbol(),TF_2,0)) { Trade.Buy(TradeHandler.MinVolume(),TradeHandler.GetSymbol(),TradeHandler.GetAsk(),TradeHandler.GetBid()-padding,TradeHandler.GetBid()+padding); } if(iLow(Symbol(),TF_2,1)>iOpen(Symbol(),TF_2,0)) { Trade.Sell(TradeHandler.MinVolume(),TradeHandler.GetSymbol(),TradeHandler.GetBid(),TradeHandler.GetAsk()+padding,TradeHandler.GetAsk()-padding); } } //+------------------------------------------------------------------+ //+------------------------------------------------------------------+ //| Undefine system constants | //+------------------------------------------------------------------+ #undef MA_PERIOD #undef MA_TYPE #undef HORIZON #undef TF_1 #undef TF_2 #undef SYSTEM_INPUTS #undef SYSTEM_OUTPUTS #undef ATR_PADDING #undef ATR_PERIOD //+------------------------------------------------------------------+
Empezamos por establecer una expectativa razonable de rentabilidad. Este paso resulta especialmente importante para asegurarnos de que evaluamos de forma imparcial las mejoras que realmente aportan nuestros modelos de aprendizaje automático.
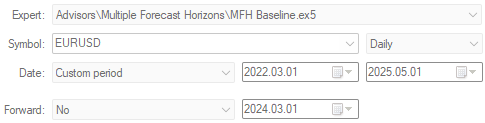
Figura 2: Selección de los días de backtest para nuestra configuración de control
A continuación se facilitan al lector los resultados detallados de la configuración de control. Como podemos ver, la mayoría de las operaciones realizadas por la estrategia no fueron rentables; sin embargo, la ganancia media de las operaciones ganadoras fue superior a la pérdida media de las operaciones perdedoras. Esta estructura asimétrica de rendimientos nos dio confianza en la configuración de control.
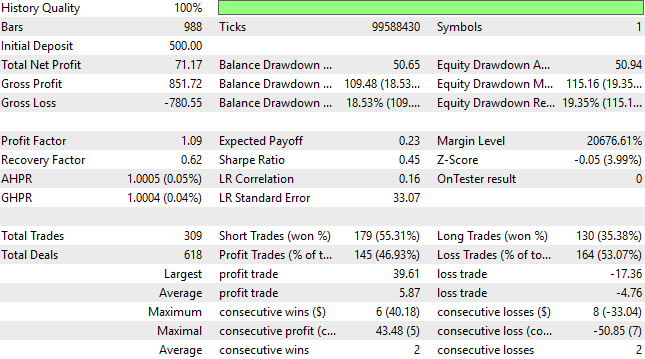
Figura 3: Análisis de la rentabilidad del algoritmo de negociación de control
Por otro lado, la curva de capital generada por la estrategia de trading parece extremadamente volátil y nos inspira poca confianza para seguir aplicando esta estrategia en el futuro. Por lo tanto, ahora intentaremos utilizar modelos de aprendizaje automático para amortiguar la volatilidad de nuestra estrategia de negociación, que actualmente es sencilla.
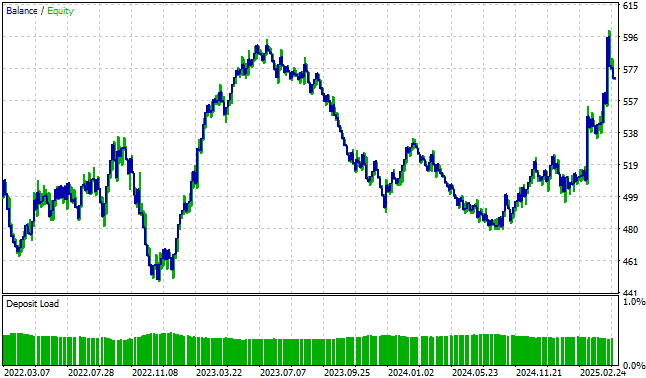
Figura 4: La versión original de nuestra estrategia de negociación inspira poca confianza a cualquier desarrollador
Un intento clásico de superar el control
Ahora intentaremos obtener mejores resultados que la estrategia de negociación de control utilizando la configuración clásica de negociación. Normalmente, en el enfoque clásico, predecimos la variable objetivo con un horizonte de 1 vela y, a continuación, comparamos el precio previsto con el precio real para obtener nuestras señales de trading. Este artículo pretende convencer al lector de que esta práctica quizá no sea la más adecuada para nuestra comunidad; veamos por qué.
Dejaremos sin cambios deliberadamente la mayor parte del código de la aplicación, por lo que podremos centrarnos exclusivamente en la parte del código MQL5 que hay que modificar para poner a prueba nuestras ideas. Como el lector puede ver a continuación, ahora debemos obtener las 16 entradas necesarias para que nuestro modelo ONNX pueda realizar predicciones y asegurarnos de convertir cada una de ellas al tipo de datos «float» antes de realizar cualquier cálculo. A continuación, obtendremos una predicción de nuestro modelo ONNX y la compararemos con el valor real de la variable objetivo.
//+------------------------------------------------------------------+
//| Obtain a prediction from our model                               |
//+------------------------------------------------------------------+
void model_predict(void)
  {
   vectorf model_inputs(SYSTEM_INPUTS);

   model_inputs[0] = (float) iClose(_Symbol,PERIOD_CURRENT,0);
   model_inputs[1] = (float) iOpen(_Symbol,PERIOD_CURRENT,0);
   model_inputs[2] = (float) iHigh(_Symbol,PERIOD_CURRENT,0);
   model_inputs[3] = (float) iLow(_Symbol,PERIOD_CURRENT,0);
   model_inputs[4] = (float) ma_reading[0];
   model_inputs[5] = (float) ma_o_reading[0];
   model_inputs[6] = (float) ma_h_reading[0];
   model_inputs[7] = (float) ma_l_reading[0];
   model_inputs[8] = (float)(iOpen(_Symbol,PERIOD_CURRENT,0) - iOpen(_Symbol,PERIOD_CURRENT,(0 + HORIZON)));
   model_inputs[9] = (float)(iHigh(_Symbol,PERIOD_CURRENT,0)   - iHigh(_Symbol,PERIOD_CURRENT,(0 + HORIZON)));
   model_inputs[10] = (float)(iLow(_Symbol,PERIOD_CURRENT,0)    - iLow(_Symbol,PERIOD_CURRENT,(0 + HORIZON)));
   model_inputs[11] = (float)(iClose(_Symbol,PERIOD_CURRENT,0)  - iClose(_Symbol,PERIOD_CURRENT,(0 + HORIZON)));
   model_inputs[12] = (float)(ma_reading[0] - ma_reading[(0 + HORIZON)]);
   model_inputs[13] = (float)(ma_o_reading[0] - ma_o_reading[(0 + HORIZON)]);
   model_inputs[14] = (float)(ma_h_reading[0] - ma_h_reading[(0 + HORIZON)]);
   model_inputs[15] = (float)(ma_l_reading[0] - ma_l_reading[(0 + HORIZON)]);

//--- Obtain the prediction
   ONNXHandler.Predict(model_inputs);

   for(int i=0;i<SYSTEM_OUTPUTS;i++)
     {
      model_prediction[i] = ONNXHandler.GetPrediction(i);
     }

   if(iHigh(Symbol(),TF_2,1)<iOpen(Symbol(),TF_2,0))
     {
      if(model_prediction[0]>iClose(Symbol(),TF_2,0))
      Trade.Buy(TradeHandler.MinVolume(),TradeHandler.GetSymbol(),TradeHandler.GetAsk(),TradeHandler.GetBid()-padding,TradeHandler.GetBid()+padding);
     }


   if(iLow(Symbol(),TF_2,1)>iOpen(Symbol(),TF_2,0))
     {
      if(model_prediction[0]<iClose(Symbol(),TF_2,0)
      Trade.Sell(TradeHandler.MinVolume(),TradeHandler.GetSymbol(),TradeHandler.GetBid(),TradeHandler.GetAsk()+padding,TradeHandler.GetAsk()-padding);
     }
  }
//+------------------------------------------------------------------+
Ejecutamos el algoritmo clásico de trading basado en el aprendizaje automático durante el mismo periodo de prueba que utilizamos para establecer los niveles de rentabilidad de la configuración de control.
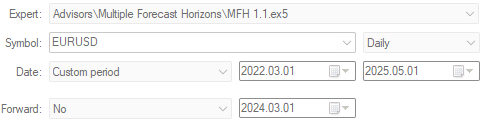
Figura 5: Primer intento de superar la configuración de control
Los niveles de rentabilidad de nuestra aplicación de trading se han reducido de forma alarmante. Aunque la estrategia demostró una elevada tasa de acierto, ya que el 63 % de todas las operaciones que realizó resultaron rentables, este resultado es poco impresionante, pues no logró superar el beneficio de 71 $ obtenido por la aplicación de control.
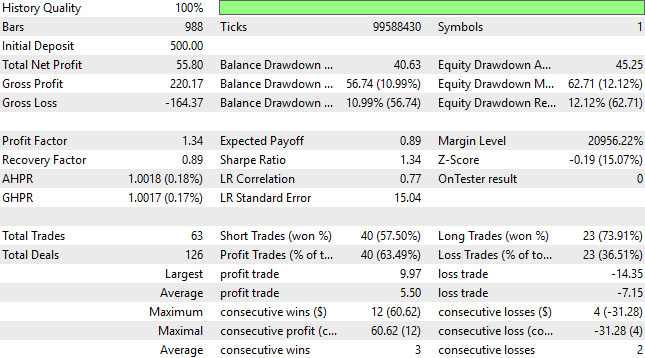
Figura 6: Análisis detallado de nuestro primer intento de superar a la aplicación de control
La aplicación revisada que hemos desarrollado no alcanza el mismo nivel que la versión original de la estrategia de negociación. Pero, para ser justos, también hay que señalar que esta versión de nuestra aplicación parece ser mucho menos volátil y más fiable que la estrategia original.
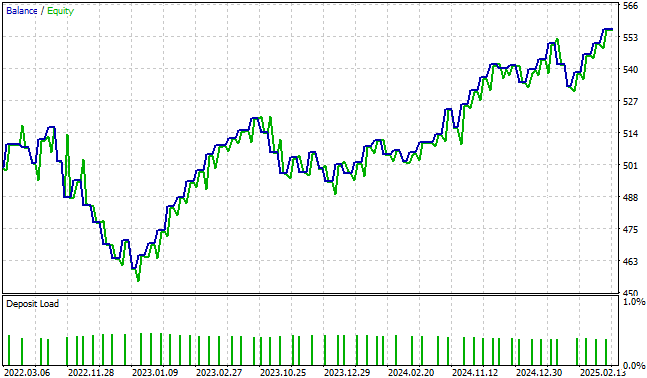
Figura 7: La curva de capital generada por la versión mejorada de nuestra aplicación de trading es menos volátil que la de la estrategia original, pero tampoco alcanza los mismos máximos
Llevando el enfoque clásico hasta sus límites
Recordemos que estamos prediciendo la variable objetivo con un horizonte de 1, 5 y 10 velas. Veamos si la predicción a 10 velas vista puede resultar más informativa que la sencilla predicción a un paso con la que empezamos. Por lo tanto, al igual que hicimos anteriormente, nos centraremos únicamente en aquellas partes de la aplicación de negociación que fue necesario modificar para que esta comparación resultara imparcial.
   if(iHigh(Symbol(),TF_2,1)<iOpen(Symbol(),TF_2,0))
     {
      if(model_prediction[
    2 ]>iClose(Symbol(),TF_2,0))
         Trade.Buy(TradeHandler.MinVolume()*2,TradeHandler.GetSymbol(),TradeHandler.GetAsk(),TradeHandler.GetBid()-padding,TradeHandler.GetBid()+padding);

      Trade.Buy(TradeHandler.MinVolume(),TradeHandler.GetSymbol(),TradeHandler.GetAsk(),TradeHandler.GetBid()-padding,TradeHandler.GetBid()+padding);
     }

   if(iLow(Symbol(),TF_2,1)>iOpen(Symbol(),TF_2,0))
     {

      if(model_prediction[
    2 ]<iClose(Symbol(),TF_2,0))
         Trade.Sell(TradeHandler.MinVolume()*2,TradeHandler.GetSymbol(),TradeHandler.GetBid(),TradeHandler.GetAsk()+padding,TradeHandler.GetAsk()-padding);

      Trade.Sell(TradeHandler.MinVolume(),TradeHandler.GetSymbol(),TradeHandler.GetBid(),TradeHandler.GetAsk()+padding,TradeHandler.GetAsk()-padding);
     }
Al igual que en la configuración de control de la aplicación de negociación, seleccionaremos el mismo periodo de tres años para probar nuestra aplicación.
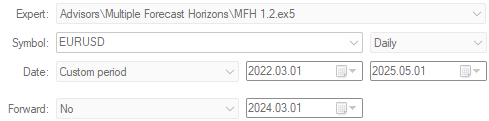
Figura 8: Recuerde que todas las pruebas retrospectivas deben realizarse en el mismo periodo de tiempo para garantizar que la estrategia realmente aprovecha mejor el tiempo.
En la mayoría de los libros que enseñan a los profesionales a realizar previsiones de los mercados financieros mediante el aprendizaje automático, se suele presentar la previsión a un paso como una práctica habitual. Sin embargo, los operadores humanos rentables rara vez intentan operar con una sola vela a la vez y, del mismo modo, tal y como demostramos en este artículo, nuestros modelos también parecen ser más rentables cuando se les permite ir más allá de la vela inmediata. De hecho, el lector debe tener en cuenta que es la primera vez que superamos los resultados de la configuración de control en este análisis.
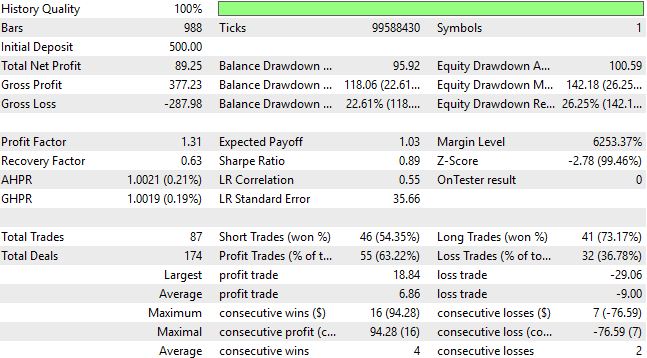
Figura 9: Realizar previsiones a 10 pasos pareció resultarnos más rentable que limitarnos a realizar previsiones a un paso
Huelga decir que se ha corregido la indeseable volatilidad de nuestra curva de capital. Sin duda, es alentador observar esto, pero, como el lector podrá comprobar en breve, aún podemos mejorar estos resultados.
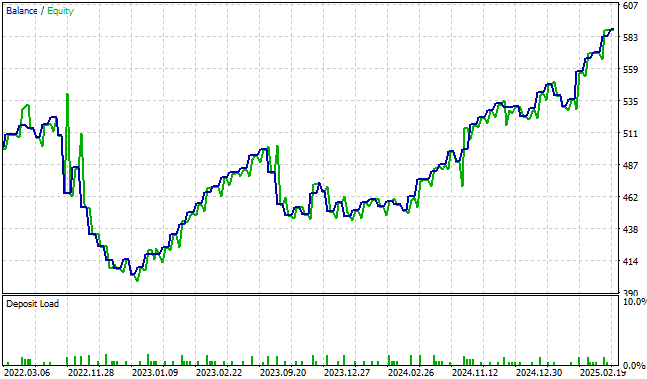
Figura 10: La curva de capital generada por la segunda iteración de nuestra aplicación de negociación es superior a la de la configuración de control, pero ahora vamos a mostrar al lector cómo llevarla a nuevas cotas.
Nuevo margen de mejora
Ya estamos listos para comparar las predicciones de nuestro modelo a varios pasos en el futuro. Compararemos los niveles que el modelo prevé para el precio máximo dentro de 1 y 10 pasos y, a continuación, utilizaremos el crecimiento previsto de ese nivel de precios como señal de negociación. if(iHigh(Symbol(),TF_2,1)<iOpen(Symbol(),TF_2,0)) { if(model_prediction[3]<model_prediction[5]) Trade.Buy(TradeHandler.MinVolume()*2,TradeHandler.GetSymbol(),TradeHandler.GetAsk(),TradeHandler.GetBid()-padding,TradeHandler.GetBid()+padding); Trade.Buy(TradeHandler.MinVolume(),TradeHandler.GetSymbol(),TradeHandler.GetAsk(),TradeHandler.GetBid()-padding,TradeHandler.GetBid()+padding); } if(iLow(Symbol(),TF_2,1)>iOpen(Symbol(),TF_2,0)) { if(model_prediction[3]>model_prediction[5]) Trade.Sell(TradeHandler.MinVolume()*2,TradeHandler.GetSymbol(),TradeHandler.GetBid(),TradeHandler.GetAsk()+padding,TradeHandler.GetAsk()-padding); Trade.Sell(TradeHandler.MinVolume(),TradeHandler.GetSymbol(),TradeHandler.GetBid(),TradeHandler.GetAsk()+padding,TradeHandler.GetAsk()-padding); }
Veamos si comparar las predicciones del modelo en distintos horizontes temporales aporta alguna ventaja frente a las comparaciones directas, más sencillas, entre las predicciones del modelo y el valor real de la variable objetivo.
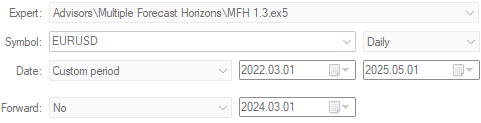
Figura 11: Ejecución de la tercera versión de nuestra aplicación de negociación durante el periodo de prueba retrospectiva de tres años
Como puede ver el lector, los resultados que hemos obtenido hablan prácticamente por sí solos. Nuestra aplicación es ahora más rentable que en cualquier momento anterior de nuestro ciclo de desarrollo. Recordemos que estamos utilizando el mismo modelo ONNX que exportamos anteriormente. Y que la base de nuestras condiciones de negociación no ha cambiado. Más bien, al interpretar con detenimiento las predicciones de nuestro modelo, parece que estamos obteniendo más alfa de la misma estrategia de negociación.
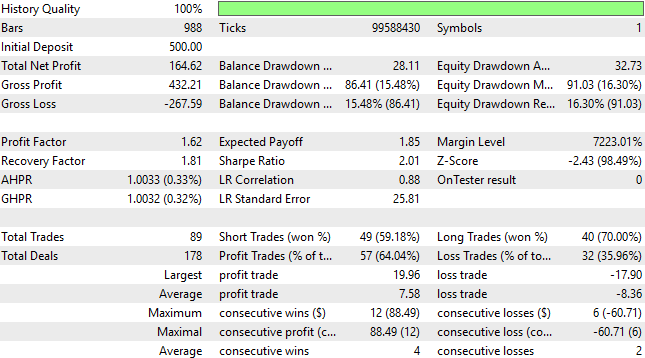
Figura 12: Las estadísticas detalladas generadas por la tercera versión de nuestra aplicación de negociación nos dan la seguridad de que hemos introducido cambios acertados en la aplicación.
Nuestra curva de capital no deja de alcanzar nuevos máximos, superando con creces el rango de la configuración de control de nuestra aplicación de trading o cualquiera de los niveles de rentabilidad que pudimos establecer utilizando el enfoque clásico del aprendizaje automático aplicado a las finanzas.
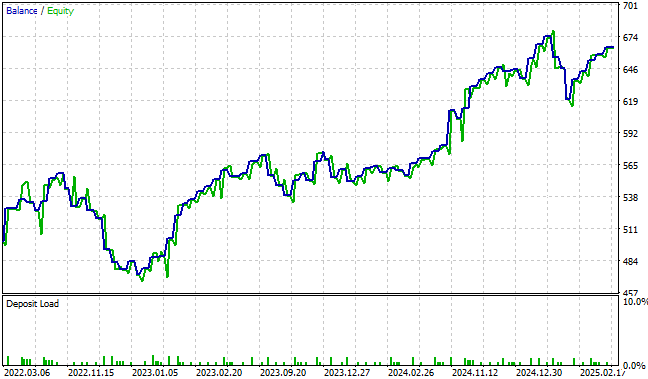
Figura 13: La curva de capital generada por la versión actual de nuestra aplicación de trading está alcanzando nuevos máximos que no habíamos podido alcanzar en ninguna de las versiones anteriores de la aplicación.
Mejoras finales
Como autor, me gusta buscar cualquier estructura de mercado que sea más fácil de predecir que el propio precio, pero que resulte tan reveladora como conocer los propios niveles de precios futuros. Por lo tanto, dado que estamos ante medias móviles en el canal de precios máximos y mínimos, mi intuición me llevó a preguntarme si el crecimiento del punto medio entre estas dos medias móviles podría ser más fácil de predecir. Sin duda, así parecía ser en el caso aquí analizado.
if(iHigh(Symbol(),TF_2,1)<iOpen(Symbol(),TF_2,0))
     {
      if(((model_prediction[3]+model_prediction[6])/2)<((model_prediction[5]+model_prediction[8])/2))
         Trade.Buy(TradeHandler.MinVolume()*2,TradeHandler.GetSymbol(),TradeHandler.GetAsk(),TradeHandler.GetBid()-padding,TradeHandler.GetBid()+padding);

      Trade.Buy(TradeHandler.MinVolume(),TradeHandler.GetSymbol(),TradeHandler.GetAsk(),TradeHandler.GetBid()-padding,TradeHandler.GetBid()+padding);
     }

if(iLow(Symbol(),TF_2,1)>iOpen(Symbol(),TF_2,0))
     {

      if(((model_prediction[3]+model_prediction[6])/2)>((model_prediction[5]+model_prediction[8])/2))
         Trade.Sell(TradeHandler.MinVolume()*2,TradeHandler.GetSymbol(),TradeHandler.GetBid(),TradeHandler.GetAsk()+padding,TradeHandler.GetAsk()-padding);

      Trade.Sell(TradeHandler.MinVolume(),TradeHandler.GetSymbol(),TradeHandler.GetBid(),TradeHandler.GetAsk()+padding,TradeHandler.GetAsk()-padding);
     }
Ejecute la versión final de nuestra aplicación en el mismo periodo de tres años con el que hemos estado trabajando.
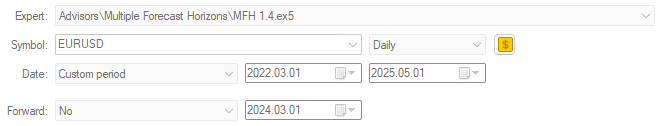
Figura 14: Ejecución de la versión definitiva de nuestra aplicación de negociación para intentar superar a todas las iteraciones anteriores que hemos desarrollado hasta ahora
Como podemos ver a continuación, nuestra aplicación ha ido alcanzando de forma constante nuevos niveles de rendimiento que estaban fuera de nuestro alcance al comienzo de este artículo. Parece que la versión final de la aplicación que hemos desarrollado hasta ahora ha merecido todo el esfuerzo que supuso crearla.
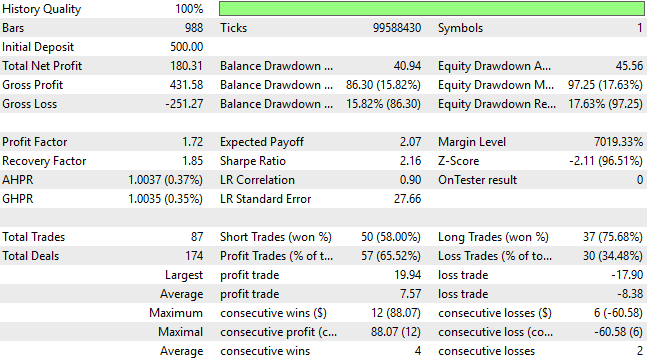
Figura 15: Los resultados detallados de rendimiento de la versión final de nuestra aplicación superan todos los niveles de rendimiento que habíamos alcanzado anteriormente en este artículo.
La volatilidad que hemos observado en nuestra curva de capital está casi totalmente bajo nuestro control. Resulta sorprendente la cantidad de beneficios que se pueden obtener sin añadir ninguna complejidad adicional a sus estrategias de trading basadas en el aprendizaje automático.
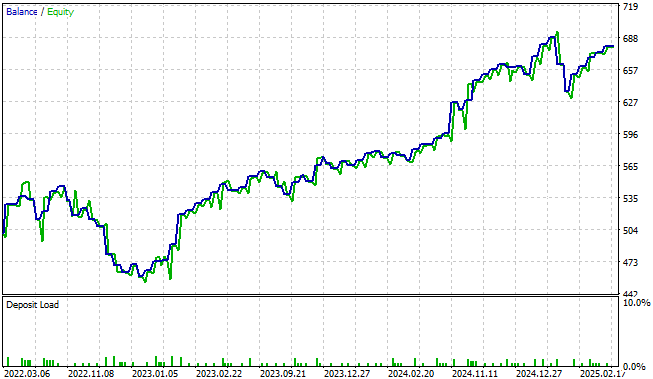
Figura 16: La visualización de la curva de capital generada por la versión definitiva de nuestra aplicación de trading nos da confianza en todos los cambios que hemos realizado hasta ahora.
Conclusión
La idea de las predicciones a varios pasos no es nueva para la comunidad del trading algorítmico. Lo nuevo —y en lo que insiste este artículo— es la perspectiva de que las predicciones a varios pasos no deben considerarse una técnica alternativa, sino más bien un posible estándar de referencia para el propio trading algorítmico.
Antes le planteé una pregunta a usted, lector. Hemos demostrado que, desde un punto de vista geométrico, la regresión lineal no es más que una secuencia de rotaciones y cambios de escala. Entonces le pregunté: ¿dónde se produce realmente el aprendizaje?
Para los lectores que aún recuerden esta pregunta, debo proponer una posible hipótesis, aunque prefiero con mucho que usted mantenga su independencia para descubrir la suya propia.
El principio que hemos demostrado a lo largo de este artículo es que los conceptos matemáticos siempre tienen análogos geométricos. Cualquier modelo de aprendizaje automático que se le ocurra puede reinterpretarse como una serie coordinada de acrobacias de escalado, reflexión, proyección, convolución y rotación, aplicadas a las variedades definidas por los propios datos. Ni siquiera las redes neuronales avanzadas son un misterio: no son más que elaboradas coreografías de transformaciones geométricas que pliegan y remodelan los datos una y otra vez.
Por lo tanto, la respuesta a la pregunta «¿Dónde tiene lugar el aprendizaje?» podría ser la siguiente: el aprendizaje se produce cuando la información se codifica en patrones geométricos. El ciclo de rotación y escalado es uno de los más elementales de estos patrones. Se trata de una estructura geométrica poderosa, en el mismo sentido en que los tres colores primarios constituyen la base a partir de la cual se forman todos los demás colores. En geometría, existen transformaciones primarias a partir de las cuales se componen todas las demás.
La comunidad dedicada a la clasificación de imágenes ya ha asumido esta realidad. Su éxito se debe a unos procesos de preprocesamiento largos y minuciosos, que, en esencia, consisten en una cuidadosa coordinación de transformaciones geométricas. Pueden parecer tareas rutinarias de ingeniería de características, pero, en realidad, se trata de la aplicación silenciosa de esos mismos principios, a menudo sin que se reconozcan plenamente sus implicaciones más profundas.
Así pues, el lector se lleva una valiosa reflexión: la predicción a varios pasos en el ámbito del trading puede ser una de las estrategias más infravaloradas de nuestro sector, precisamente porque aporta mucho más de lo que realmente se le reconoce. Las predicciones a varios pasos garantizan que mantengamos nuestras comparaciones en el mismo sistema de coordenadas. De lo contrario, comparar directamente las predicciones de su modelo con el valor real de la variable objetivo equivale a comparar dos magnitudes que no tienen por qué estar expresadas en las mismas unidades.
| Nombre del archivo | Descripción del archivo |
|---|---|
| Fetch_Data_MA_2.1.mq5 | El script de MQL5 que utilizamos para obtener datos históricos desde nuestra terminal de MetaTrader 5. |
| MFH_Baseline.mq5 | Versión de referencia de nuestra estrategia de negociación, que no utilizaba modelos de aprendizaje automático. |
| MFH_1.1.mq5 | Primer intento que hicimos de desarrollar una aplicación de negociación siguiendo únicamente los paradigmas clásicos del aprendizaje automático aplicado a las finanzas. |
| MFH_1.2.mq5 | Último intento que hicimos de desarrollar una aplicación de negociación utilizando los paradigmas clásicos del aprendizaje automático aplicado a las finanzas. |
| MFH_1.3.mq5 | Primer intento que hicimos de dejar de comparar directamente el precio actual con el precio previsto. |
| MFH_1.4.mq5 | Versión definitiva de nuestra estrategia de negociación, que generó los niveles de rentabilidad más altos mostrados en este artículo. |
| Multiple_Forecast_Horizons.ipynb | Cuaderno de Jupyter que utilizamos para exportar nuestro modelo ONNX. |
Traducción del inglés realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/en/articles/19383
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Explorador de la biblioteca estándar de MQL5 (Parte 1): Introducción con CTrade, CiMA y CiATR
 Redes neuronales en el trading: señales de trading estables en cualquier régimen de mercado (Módulos de atención)
 Cómo crear y optimizar un sistema de trading basado en ciclos (Detrended Price Oscillator - DPO)
 Redes neuronales en el trading: Señales de trading robustas en cualquier régimen de mercado (Conclusión)

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso
EURUSD MFH LR D1.onnx