Superando las limitaciones del aprendizaje automático (Parte 5): Un breve resumen de la validación cruzada en series temporales
 19
 0

En nuestra serie de artículos relacionados, hemos abordado numerosas tácticas para hacer frente a los problemas derivados del comportamiento del mercado. Sin embargo, en esta serie nos centramos en los problemas que plantean los algoritmos de aprendizaje automático que queremos emplear en nuestras estrategias. Muchos de estos problemas se derivan de la arquitectura del modelo, de los algoritmos utilizados en la selección del modelo, de las funciones de pérdida que definimos para medir el rendimiento y de muchos otros aspectos de la misma índole.
Todos los componentes que, en conjunto, conforman un modelo de aprendizaje automático pueden generar obstáculos imprevistos a la hora de aplicar el aprendizaje automático al trading algorítmico, lo que requiere una evaluación diagnóstica minuciosa. Por lo tanto, resulta importante que cada uno de nosotros comprenda estas limitaciones y que, como comunidad, desarrollemos nuevas soluciones y definamos nuevas normas para nosotros mismos.
Los modelos de aprendizaje automático utilizados en el trading algorítmico se enfrentan a retos específicos, a menudo debidos a la forma en que los validamos y probamos. Un paso fundamental es la validación cruzada de series temporales, un método para evaluar el rendimiento del modelo con datos no vistos y ordenados cronológicamente.
A diferencia de lo que ocurre en la validación cruzada estándar, los datos de series temporales no pueden barajarse, ya que eso provocaría que se filtrara información futura hacia el pasado. Esto hace que el remuestreo resulte más complejo y obliga a buscar equilibrios específicos entre el sesgo, la varianza y la robustez.
En este artículo, presentaremos la validación cruzada para series temporales, explicaremos su función a la hora de evitar el sobreajuste y mostraremos cómo puede ayudar a entrenar modelos fiables incluso con datos limitados. A partir de un pequeño conjunto de datos de dos años, demostramos cómo una validación cruzada adecuada mejoró el rendimiento de una red neuronal profunda en comparación con un modelo lineal sencillo.
Nuestro objetivo es poner de relieve tanto el valor como las limitaciones de los métodos habituales de validación cruzada de series temporales, sentando así las bases para un análisis más profundo en la siguiente parte de la serie.
Recuperación de datos en MQL5
Para este análisis, empezamos por obtener datos históricos del terminal MetaTrader 5 mediante un script en MQL5 que hemos escrito nosotros mismos. El script comienza guardando el nombre del archivo en el que se va a escribir.
A continuación, almacenamos la cantidad de datos que se van a recuperar como un parámetro de entrada que el usuario puede pasar al script. Asegúrese de configurar la propiedad #property script_show_inputs en el encabezado de su script para garantizar que el usuario final pueda especificar el número de barras que desea recuperar.
Una vez recopilada toda la información necesaria, iniciamos el proceso de escritura del archivo. Mediante la función FileOpen, creamos un nuevo identificador de archivo. Esta función admite parámetros que definen el tipo de archivo que se está usando, las operaciones que se van a realizar en él y el delimitador o la convención de espaciado del archivo.
Por lo tanto, pasamos al método FileOpen el nombre del archivo generado al principio del script, los modos y tipos de operación de archivo adecuados, y la coma como delimitador elegido.
A continuación, inicializamos un bucle «for» que itera en orden descendente desde el número total de barras que hay que recuperar hasta el principio. En la primera iteración, escribimos los nombres de las columnas que queremos guardar en nuestro archivo CSV. En cada iteración posterior, recopilamos los datos de mercado pertinentes correspondientes a ese momento, avanzando gradualmente desde el pasado hacia el presente.
De este modo, nos aseguramos de que nuestro archivo CSV esté estructurado de tal forma que las fechas más antiguas aparezcan al principio y las más recientes, al final.
//+------------------------------------------------------------------+
//|                                                      Fetch_Data  |
//|                                      Copyright 2020, CompanyName |
//|                                       http://www.companyname.net |
//+------------------------------------------------------------------+
#property copyright "Copyright 2024, MetaQuotes Ltd."
#property link      "https://www.mql5.com"
#property version   "1.00"
#property script_show_inputs

//--- File name
string file_name = Symbol() + " Detailed Market Data As Series.csv";

//--- Amount of data requested
input int size = 3000;

//+------------------------------------------------------------------+
//| Our script execution                                             |
//+------------------------------------------------------------------+
void OnStart()
  {
   int fetch = size;

//---Write to file
   int file_handle=FileOpen(file_name,FILE_WRITE|FILE_ANSI|FILE_CSV,",");

   for(int i=size;i>=1;i--)
     {
      if(i == size)
        {
         FileWrite(file_handle,"Time",
                   //--- OHLC
                   "True Open",
                   "True High",
                   "True Low",
                   "True Close"
                  );
        }

      else
        {
         FileWrite(file_handle,
                   iTime(_Symbol,PERIOD_CURRENT,i),
                   //--- OHLC
                   iClose(_Symbol,PERIOD_CURRENT,i),
                   iOpen(_Symbol,PERIOD_CURRENT,i),
                   iHigh(_Symbol,PERIOD_CURRENT,i),
                   iLow(_Symbol,PERIOD_CURRENT,i)
                  );
        }
     }
//--- Close the file
   FileClose(file_handle);
  }
//+------------------------------------------------------------------+
Análisis de nuestros datos en Python
Una vez escrito correctamente nuestro archivo CSV, el siguiente paso es importar las bibliotecas Pandas, NumPy y Matplotlib para poder empezar con nuestro análisis.
#Import basic libraries
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
Al leer los datos creados mediante el script MQL5, tenga en cuenta que, en el código de ejemplo que aparece a continuación, debe sustituir la ruta por la de su propio sistema.
#Read in the data
data = pd.read_csv("/ENTER/YOUR/PATH/HERE/EURUSD Detailed Market Data As Series.csv")
En nuestro ejemplo, queremos demostrar que la validación cruzada puede utilizarse para ajustar modelos complejos incluso con conjuntos de datos limitados. Por ello, seleccionaremos los datos de los dos últimos años y descartaremos todo lo demás.
data = data.iloc[(365*2):,:]
data.reset_index(drop=True,inplace=True)
A partir de ahí, debemos definir con qué horizonte temporal queremos realizar las previsiones.
#Define a forecast horizon
HORIZON  = 1
El siguiente paso consiste en preparar las entradas con las que queremos trabajar: las entradas en diferencias. Las calculamos restando el valor actual de la entrada a su valor anterior. También añadimos la etiqueta al conjunto de datos. A continuación, eliminamos todos los valores ausentes.
#Let us start by following classical rules
data['True Close Diff'] = data['True Close'] - data['True Close'].shift(HORIZON)
data['True Open Diff'] = data['True Open'] - data['True Open'].shift(HORIZON)
data['True High Diff'] = data['True High'] - data['True High'].shift(HORIZON)
data['True Low Diff'] = data['True Low'] - data['True Low'].shift(HORIZON)

#Add the target
data['Target'] = data['True Close'] - data['True Close'].shift(-HORIZON)
data.dropna(inplace=True)
data.reset_index(inplace=True,drop=True)
Vamos ahora a visualizar los datos.
#Let's visualize the data
plt.plot(data['True Close'],color='black')
plt.grid()
plt.title('EURUSD Data From 2023 - 2024')
plt.xlabel('Time')
plt.ylabel('EURUSD Exchange Rate') 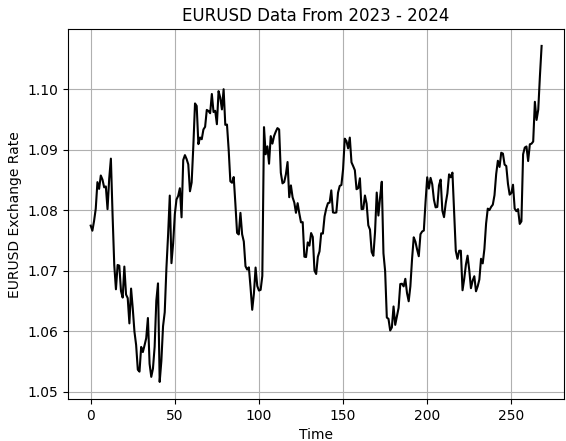
Figura 1: Visualización de nuestra pequeña muestra de tipos de cambio históricos del EUR/USD
A continuación, dividimos nuestro conjunto de datos en dos mitades: la primera para el entrenamiento y la segunda para las pruebas.
#Partition the data
train , test = data.iloc[:data.shape[0]//2,:] , data.iloc[data.shape[0]//2:,:]
Guarde las entradas y los objetivos por separado.
#Differenced inputs
X = train.iloc[:,5:-4].columns
y = 'Target'
Ahora cargamos nuestras bibliotecas de aprendizaje automático y las métricas que utilizaremos para evaluar los modelos.
#Load a machine learning library
from sklearn.neural_network import MLPRegressor
from sklearn.linear_model import LinearRegression,Ridge
from sklearn.metrics import root_mean_squared_error
Como hemos señalado anteriormente en la introducción de este artículo, lo primero que hacemos para definir una configuración de control es crear nuestro modelo lineal.
#Start the model
model   = Ridge(alpha=1e-7)
Ajuste el modelo.
model.fit(train.loc[:,X],train.loc[:,y])
Por último, almacenamos las predicciones realizadas por el modelo sobre el conjunto de prueba sin ajustar el modelo a dicho conjunto. Recuerde que es importante no ajustar el modelo al conjunto de prueba, ya que usaremos esa parte de los datos más adelante para evaluar nuestro modelo durante la prueba retrospectiva en MetaTrader 5.
test['Predictions'] = model.predict(test.loc[:,X])
Analicemos ahora, en términos generales, hasta qué punto es sólido nuestro modelo. Comenzamos representando gráficamente las predicciones que nuestro modelo ha realizado sobre los datos fuera de la muestra y comparándolas con los niveles de precios reales observados. Como podemos ver, al representar gráficamente el rendimiento de nuestro modelo, este parece tener una comprensión razonable del comportamiento futuro de los niveles de precios. Las predicciones que realizó parecen coherentes y se ajustan bien a la trayectoria real seguida por la variable objetivo. Sin embargo, hay ocasiones en las que también podemos observar que el modelo no refleja las fluctuaciones en los datos de precios con la eficacia que nos gustaría.
plt.plot(test.loc[:,'Target'],color='black')
plt.plot(test.loc[:,'Predictions'],color='red',linestyle=':')
plt.legend(['Target','Predictions'])
plt.title('Visualizing Model Accuracy Out of Sample')
plt.xlabel('Time')
plt.ylabel('EURUSD Exchange Rate')
plt.grid()
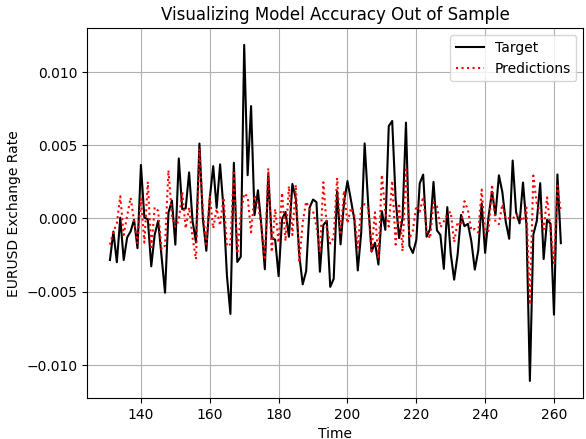
Figura 2: Visualización de la precisión fuera de la muestra que podría alcanzar nuestro modelo lineal simple
Además, los niveles de correlación entre las predicciones de nuestro modelo lineal y los valores reales de la variable objetivo son bastante bajos. El modelo arroja una correlación de 0,58, un valor relativamente bajo.
test.loc[:,['Target','Predictions']].corr().iloc[0,1]
0,5826364163824712
Conversión a ONNX
ONNX, siglas de Open Neural Network Exchange, es un protocolo de código abierto que nos permite crear e implementar modelos de aprendizaje automático en diferentes frameworks. Es independiente del lenguaje, lo que significa que podemos entrenar un modelo en un lenguaje que admita la API ONNX y exportarlo a otro para su implementación, siempre y cuando ambos admitan ONNX. Esto permite usar el mismo modelo en numerosos sistemas.
Todo esto es posible gracias a la amplia adopción de la API de ONNX. Así pues, empezamos importando la biblioteca ONNX, junto con una biblioteca de conversión que transforma los modelos de scikit-learn en sus representaciones ONNX. Una representación ONNX no es más que un grafo de cálculo matemático que describe el modelo. Este grafo se puede volver a convertir fácilmente en la implementación original.
import onnx
from skl2onnx import convert_sklearn
from skl2onnx.common.data_types import FloatTensorType
Una vez importada la biblioteca ONNX, definimos las dimensiones de entrada y salida que el modelo acepta y devuelve.
initial_types = [("FLOAT INPUT",FloatTensorType([1,4]))]
final_types = [("FLOAT OUTPUT",FloatTensorType([1,1]))]
A continuación, convertimos cada uno de nuestros modelos entrenados en su correspondiente prototipo ONNX.
model_proto = convert_sklearn(model,initial_types=initial_types,target_opset=12)
model2_proto = convert_sklearn(model2,initial_types=initial_types,target_opset=12)
Luego guardamos estos prototipos como archivos .onnx utilizando el método «save» de ONNX.
onnx.save(model_proto,"EURUSD LR D1 DIFFERENCED.onnx")
onnx.save(model2_proto,"EURUSD LR 2 D1 RAW.onnx")
Definición de nuestro nivel de rendimiento de referencia
Empezaremos cargando el búfer ONNX creado anteriormente.
//-- Load the onnx buffer
#resource "\\Files\\EURUSD LR D1 DIFFERENCED.onnx" as const uchar onnx_buffer[];
A continuación, definimos las variables globales relacionadas con el modelo ONNX, incluidas las destinadas al almacenamiento de predicciones y los identificadores de modelo.
//--- Global variables
long   onnx_model;
vector onnx_inputs,onnx_output;
Después cargamos la biblioteca Trade, que nos ayuda a gestionar las posiciones y los niveles de riesgo.
//--- Libraries
#include <Trade\Trade.mqh>
CTrade Trade;
Cuando se inicializa el modelo por primera vez, lo preparamos con el método OnnxCreateFromBuffer(). Este método admite dos parámetros:
- El búfer ONNX creado a partir del archivo.
-
Los argumentos de inicialización, como la especificación de «float» como tipo de datos de ONNX, ya que las entradas y salidas de tipo «float» son estables y se usan ampliamente en ONNX.
A continuación, configuramos las dimensiones de entrada y salida del modelo para que coincidan con las definidas anteriormente en Python.
//+------------------------------------------------------------------+
//| Expert initialization function                                   |
//+------------------------------------------------------------------+
int OnInit()
  {
//--- Prepare the ONNX model
onnx_model = OnnxCreateFromBuffer(onnx_buffer,ONNX_DEFAULT);

//--- Set the input shape of the model
ulong model_input[] = {1,4};
OnnxSetInputShape(onnx_model,0,model_input);

ulong model_output[] = {1,1};
OnnxSetOutputShape(onnx_model,0,model_output);

//---
   return(INIT_SUCCEEDED);
  }
Cuando se cierra la aplicación, liberamos los recursos asignados al modelo ONNX, lo cual es una buena práctica en MQL5.
//+------------------------------------------------------------------+
//| Expert deinitialization function                                 |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
  {
//--- Free up dedicated ONNX resources
OnnxRelease(onnx_model);
  }
Cada vez que recibimos nuevos precios, lo primero que hacemos es comprobar que no haya posiciones abiertas. Si ese es el caso, nos preparamos para obtener una predicción del modelo ONNX con el fin de decidir qué posición adoptar.
Para ello, redimensionamos el vector de entrada para que tenga las dimensiones esperadas; en este caso, un tamaño de cuatro. Cada entrada se procesa y se convierte al tipo «float». También obtenemos datos de mercado, como las cotizaciones bid y ask. Una variable llamada «padding» determina cuál será la amplitud de nuestro stop loss.
Luego preparamos un vector de longitud uno para almacenar la predicción del modelo. Después utilizamos el comando OnnxRun() para obtener una previsión, la mostramos en el terminal y la comparamos con el precio real de mercado para generar una señal de negociación.
Esta es la forma clásica en que se utilizan los modelos de aprendizaje automático en los sistemas de negociación. Si ya hay una posición abierta, simplemente esperamos a que alcance el stop loss o el take profit. Esto nos ayuda a evaluar el grado de precisión y coherencia de la
//+------------------------------------------------------------------+
//| Expert tick function                                             |
//+------------------------------------------------------------------+
void OnTick()
  {
//--- Check if we have no open positions
if(PositionsTotal() ==0)
   {
      //--- Prepare the model inputs
      onnx_inputs.Resize(4);
      onnx_inputs[0] = (float) iClose(Symbol(),PERIOD_D1,0) - iClose(Symbol(),PERIOD_D1,1);
      onnx_inputs[1] = (float) iOpen(Symbol(),PERIOD_D1,0) - iOpen(Symbol(),PERIOD_D1,1);
      onnx_inputs[2] = (float) iHigh(Symbol(),PERIOD_D1,0) - iHigh(Symbol(),PERIOD_D1,1);
      onnx_inputs[3] = (float) iLow(Symbol(),PERIOD_D1,0) - iLow(Symbol(),PERIOD_D1,1);

      //--- Market data
      double ask = SymbolInfoDouble(Symbol(),SYMBOL_ASK);
      double bid = SymbolInfoDouble(Symbol(),SYMBOL_BID);
      double padding = 5e-3;

      //--- Store the model's prediction
      onnx_output.Resize(1);
      if(OnnxRun(onnx_model,ONNX_DATA_TYPE_FLOAT,onnx_inputs,onnx_output))
         {
            Print("Model forecast: ",onnx_output[0]);

            //--- Buy setup
            if(onnx_output[0] > iClose(Symbol(),PERIOD_D1,0)) Trade.Buy(0.01,Symbol(),ask,ask-padding,ask+padding,"");

            //--- Sell setup
            else if(onnx_output[0] <  iClose(Symbol(),PERIOD_D1,0)) Trade.Sell(0.01,Symbol(),bid,bid+padding,bid-padding,"");
         }
   }

//--- Otherwise, if we do have open positions
else if(PositionsTotal()>0)
   {
      //--- Then
      Print("Position Open");
   }
  }
//+------------------------------------------------------------------+
Comenzaremos, como de costumbre, señalando las fechas que hemos reservado para nuestra prueba retrospectiva. Recordemos que, en Python, dividimos nuestro conjunto de datos en dos mitades y no ajustamos nuestro modelo con los datos del conjunto de prueba. Estas son las mismas fechas que hemos elegido para nuestra prueba retrospectiva en MetaTrader 5. Esto nos ofrece un punto de referencia sólido que intentaremos superar con nuestra red neuronal profunda.
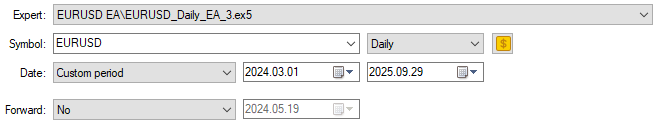
Figura 3: Selección de las fechas que necesitamos para nuestra prueba retrospectiva de control
También seleccionaremos una configuración de retardo aleatorio para garantizar que las condiciones de nuestra prueba retrospectiva se ajusten a las condiciones reales de negociación.
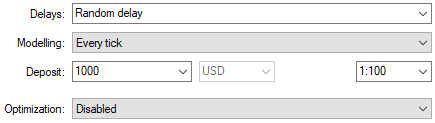
Figura 4: Selección de las condiciones de la prueba retrospectiva que reproduzcan las condiciones previstas de uso en producción
Al analizar la curva de capital generada por la estrategia de negociación, podemos observar que, aunque la estrategia inicial tuvo un comienzo lento durante la primera mitad del periodo de prueba retrospectiva, al final resultó rentable.
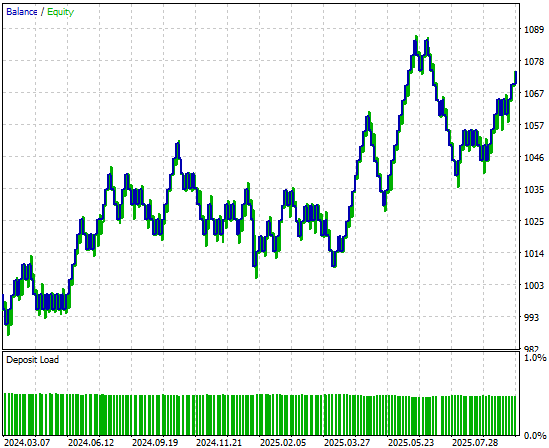
Figura 5: La curva de capital generada por nuestro modelo lineal sencillo parece prometedora, pero aún podemos alcanzar niveles de rendimiento más altos.
Al analizar las estadísticas detalladas de rendimiento, podemos observar que aún hay margen de mejora. Por ejemplo, las entradas en corto del modelo obtienen unos resultados especialmente malos: una precisión cercana al cincuenta por ciento, apenas superior a la que se obtendría por azar. Sin embargo, también resulta interesante observar que el modelo parece sólido en las entradas en largo.
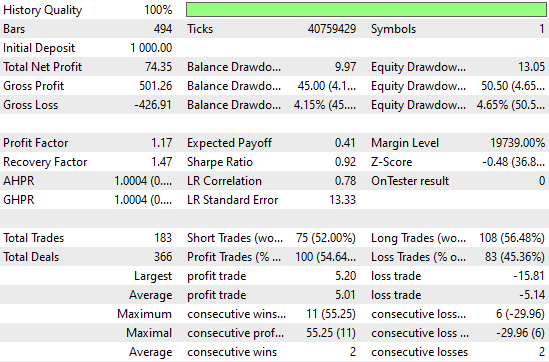
Figura 6: Visualización de las estadísticas detalladas obtenidas al evaluar nuestro modelo Ridge simple con datos fuera de la muestra
Mejora de nuestros resultados iniciales
Ahora, intentaremos mejorar estos resultados iniciales. Empezaremos importando los métodos de remuestreo adecuados de la biblioteca scikit-learn: RandomizedSearchCV y TimeSeriesSplit. Estos dos se pueden utilizar conjuntamente para el remuestreo de series temporales.
from sklearn.model_selection import RandomizedSearchCV,TimeSeriesSplit
A continuación, creamos un objeto `TimeSeriesSplit` con cinco particiones y establecemos un intervalo entre las particiones igual al horizonte de previsión.
tscv = TimeSeriesSplit(n_splits=5,gap=HORIZON) A partir de ahí, creamos una red neuronal con unos parámetros básicos que se mantendrán constantes en todas las iteraciones de nuestras pruebas de validación cruzada.
nn = MLPRegressor(random_state=0,shuffle=False,early_stopping=False,max_iter=1000)
También creamos un diccionario de parámetros para nuestra red neuronal profunda. Se probará y comparará cada uno de estos parámetros con el fin de identificar el mejor modelo.
distributions = dict(activation=['identity','logistic','tanh','relu'],
                     alpha=[100,10,1,1e-1,1e-2,1e-3,1e-4,1e-5,1e-6,1e-7],
                     hidden_layer_sizes=[(4,40,20,10,2),(4,100,200,500,100,4),(4,20,40,20,4,2),(4,10,50,10,4),(4,4,4,4)],
                     solver=['adam','sgd','lbfgs'],
                     learning_rate = ['constant','invscaling','adaptive']
                     )
A continuación, utilizamos el procedimiento de búsqueda aleatoria, que realiza un número controlado de iteraciones a partir de todas las combinaciones posibles de parámetros. No realiza una búsqueda exhaustiva en todo el espacio de entradas, sino que nos permite controlar el nivel de rigor de la búsqueda ajustando el parámetro n_iter.
rscv = RandomizedSearchCV(nn,distributions,random_state=0,n_iter=50,n_jobs=-1,scoring='neg_mean_squared_error',cv=tscv)
Para ejecutar la validación cruzada, basta con llamar al método `fit()` del objeto `RandomizedSearchCV` que hemos creado anteriormente y almacenar los resultados en una variable cuyo nombre haga referencia a nuestro procedimiento de búsqueda de redes neuronales.
nn_search = rscv.fit(train.loc[:,X],train.loc[:,y])
Una vez finalizada la búsqueda, recuperamos los mejores parámetros encontrados mediante validación cruzada.
nn_search.best_params_
{'solver': 'lbfgs',
'learning_rate': 'adaptive',
'hidden_layer_sizes': (4, 40, 20, 10, 2),
'alpha': 0.0001,
'activation': 'identity'}
A continuación, inicializamos un nuevo modelo con estos parámetros y lo ajustamos al conjunto de entrenamiento.
model = MLPRegressor(random_state=0,shuffle=False,early_stopping=False,max_iter=1000,solver='lbfgs',learning_rate='adaptive',hidden_layer_sizes=(4, 40, 20, 10, 2),alpha=0.0001,activation='identity')

model.fit(train.loc[:,X],train.loc[:,y])
Por último, convertimos el modelo a su prototipo ONNX.
model_proto = convert_sklearn(model,initial_types=initial_types,target_opset=12)
Y, finalmente, guardamos el archivo ONNX de la red neuronal en nuestro disco duro para poder probar las mejoras que hemos introducido.
onnx.save(model_proto,'EURUSD NN D1.onnx')
Puesta en práctica de nuestras mejoras
La mayor parte de nuestra aplicación anterior sigue siendo la misma, así que ahora podemos centrarnos en las pocas líneas de código que tenemos que actualizar para reflejar nuestro modelo mejorado. La única línea que hay que cambiar es la ruta del recurso en nuestro archivo de encabezado: hay que actualizarla para que apunte al nuevo modelo de red neuronal que acabamos de crear.
//-- Load the onnx buffer
#resource "\\Files\\EURUSD NN D1.onnx" as const uchar onnx_buffer[];
Una vez hecho esto, podremos observar cómo se comporta nuestra nueva aplicación durante el mismo periodo de prueba retrospectiva. Seleccionaremos las mismas fechas que antes para garantizar una comparación justa.
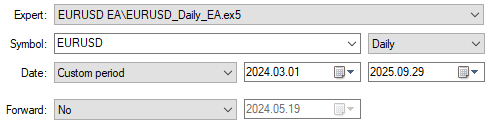
Figura 7: Selección de nuestra nueva y mejorada aplicación de red neuronal profunda para operar durante el mismo periodo de prueba
Al analizar las estadísticas detalladas de rendimiento, ya podemos observar cambios notables. El beneficio neto total ha aumentado considerablemente, al igual que el número de señales de trading registradas por el sistema. Esto significa que la red neuronal ha aumentado la rentabilidad al tiempo que ha realizado más operaciones que la versión anterior, manteniendo unos niveles de precisión constantes. Son mejoras realmente impresionantes.
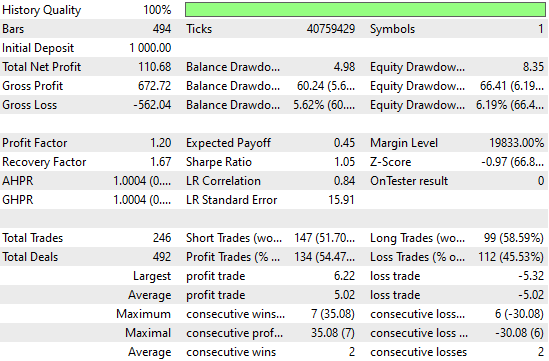
Figura 8: Nuestros niveles de rendimiento han mejorado considerablemente con respecto al valor de referencia de control que establecimos
Por último, al observar la curva de capital generada por la nueva versión de la aplicación, podemos ver claramente que el periodo de consolidación que anteriormente frenaba el crecimiento en nuestra prueba retrospectiva inicial ha sido sustituido ahora por una fuerte y explosiva tendencia alcista generada por nuestra red neuronal. Esta nos ofrece una fuente de señales de negociación más fiable y sólida de cara al futuro.
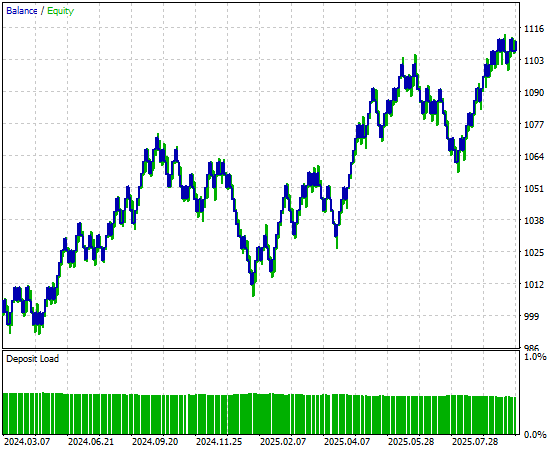
Figura 9: Visualización de la curva de capital generada por nuestra estrategia, que hemos mejorado mediante la validación cruzada de series temporales
Conclusión
Este artículo ha ofrecido al lector una visión general de las ventajas de las técnicas de validación cruzada de series temporales cuando se aplican de forma adecuada. Tras leer el artículo, el lector sabe que la validación cruzada de series temporales puede usarse para ayudar a mitigar el riesgo de sobreajuste, buscar y ajustar mejores parámetros del modelo, identificar el mejor método posible entre un conjunto de modelos candidatos y estimar el error de prueba de un modelo con datos que aún no ha visto.
Como hemos repetido a lo largo de este artículo, esta lista de casos de uso no es, en absoluto, exhaustiva. Sería imposible abordar todas las ventajas que la validación cruzada de series temporales aporta a nuestro proceso de modelización.
Sin embargo, ahora que hemos llegado a este punto de nuestro análisis, el lector debería estar bien preparado para plantearse preguntas más profundas. ¿Es posible mejorar aún más los niveles de rendimiento que hemos demostrado hoy aquí utilizando métodos de validación cruzada de series temporales más rigurosos que el sencillo método de K particiones que se ha presentado aquí? Sin duda, son cuestiones que merece la pena analizar más a fondo.
En las próximas entregas, analizaremos métodos alternativos de validación cruzada, como la validación cruzada de series temporales «Walk-Forward», y los compararemos con el enfoque de K particiones. A través de esta comparación, aprenderemos a razonar por qué un método puede ser más adecuado que otro. Y para que usted entienda cuándo podría ser aplicable, primero debe tener una idea clara de lo que una buena validación cruzada puede aportarle.
| Nombre del archivo | Descripción del archivo |
|---|---|
| Fetch_Data.mq5 | El script personalizado de MQL5 que hemos creado para obtener nuestros datos históricos desde la terminal de MetaTrader 5. |
| The_Limitations_of_AI_Model_Selection.ipynb | El Jupyter Notebook que hemos creado para analizar los datos de mercado que hemos obtenido de la terminal MetaTrader 5. |
| EURUSD_LR_D1_DIFFERENCED.onnx | El modelo ONNX de regresión lineal que hemos creado como modelo de referencia. |
| EURUSD_NN_D1.onnx | El modelo ONNX de red neuronal profunda que hemos creado para superar el modelo de referencia. |
| EURUSD_Daily_EA.mq5 | La aplicación de negociación mejorada con una red neuronal profunda que hemos optimizado mediante validación cruzada de series temporales. |
| EURUSD_Daily_EA_3.mq5 | La aplicación de negociación de referencia que pretendíamos superar, aunque el conjunto de datos era limitado. |
Traducción del inglés realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/en/articles/19775
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.