Redes neuronales en el trading: Un enfoque semántico de impulsos para la identificación espaciotemporal (Componentes principales)
 22
 0

Introducción
En el mundo del trading algorítmico y el análisis financiero, la idea de ver no solo cifras, sino eventos, siempre ha llamado la atención de los investigadores. Los flujos de cotizaciones y órdenes, los picos de actividad, las caídas bruscas y los momentos de calma: todo ello se asemeja a un organismo vivo en el que late el ritmo de la liquidez mundial. Sin embargo, la mayoría de los modelos tradicionales solo ven en ello estadísticas, un conjunto de valores sucesivos. Analizan el precio, pero no lo perciben. La capacidad de reconocer el significado de los cambios se convierte en la piedra angular del enfoque moderno del procesamiento de datos de mercado.
En el artículo anterior de esta serie, hemos analizado en detalle el framework S3CE-Net, que combina los principios de la percepción basada en eventos y el aprendizaje profundo. Este framework constituye una especie de puente entre dos mundos: el biológico y el informático. Por un lado, hereda la rapidez y la eficiencia de los sistemas de impulsos, en los que la información se transmite en forma de impulsos poco frecuentes, pero significativos. Por otro lado, conserva la profundidad estructural de las redes neuronales clásicas, capaces de realizar generalizaciones y análisis complejos.
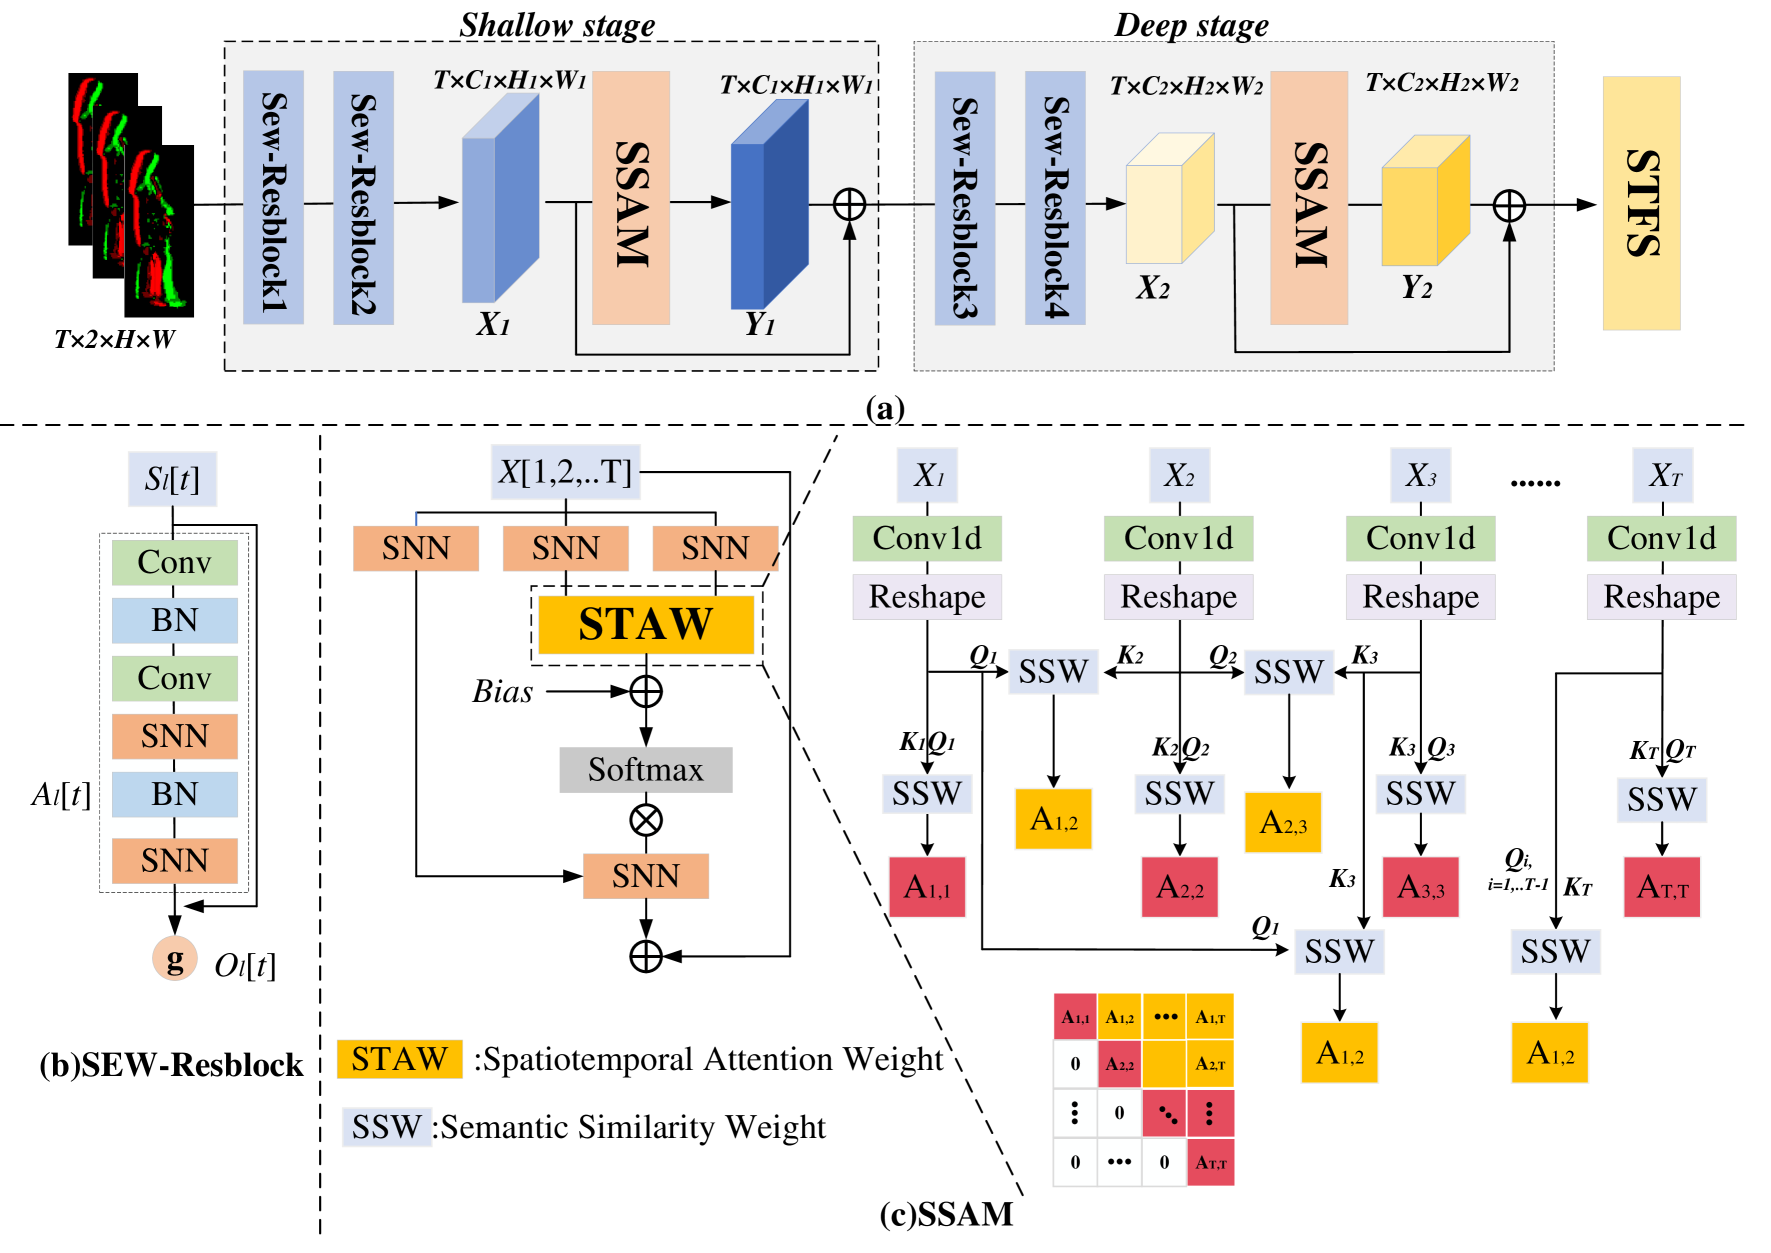
La base de la arquitectura la constituye el framework SEW-ResNet, que garantiza una extracción de características estable y eficaz sin pérdida de información en las capas profundas. Sobre él se superponen mecanismos más sofisticados: la atención espaciotemporal SSAM y el módulo STFS. El primero relaciona los eventos de una secuencia, estableciendo dependencias fundamentadas en la causalidad, mientras que el segundo se encarga del muestreo adaptativo de características en el tiempo y el espacio. Todo ello convierte a S3CE-Net en un sistema de percepción vivo, en el que cada impulso tiene un significado.
La esencia de la arquitectura se puede resumir así: aprende a ver la estructura donde otros solo ven ruido. Gracias a su naturaleza basada en eventos, el modelo no funciona con intervalos fijos, sino a nivel de impulsos, lo que le permite ajustarse mejor al ritmo real del mercado. SSAM centra su atención en aquellos fragmentos del conjunto de datos analizados en los que realmente se producen cambios, mientras que STFS aporta flexibilidad y estabilidad, lo que permite que el modelo se entrene sin depender excesivamente de escenarios concretos. Esto convierte a S3CE-Net en un sistema integral de análisis semántico del flujo de eventos.
El valor práctico de S3CE-Net en el trading radica precisamente en su naturaleza basada en eventos. Un modelo basado en estos principios no reacciona ante cada fluctuación, sino solo ante los microeventos que realmente alteran el equilibrio del mercado. Un repunte del volumen, la aparición de una orden de gran volumen, un cambio en la estructura de la liquidez… Todo ello se interpreta como una señal significativa, y no como ruido aleatorio. Las decisiones que toma el modelo se basan en el contexto y en la experiencia acumulada: en cómo el mercado había respirado hasta ese momento.
Este enfoque cobra especial relevancia en situaciones en las que los métodos tradicionales pierden su solidez. Allí donde los indicadores se pierden entre datos contradictorios y los modelos clásicos empiezan a sobreajustarse, S3CE-Net mantiene la claridad de percepción. Su atención se centra en lo esencial. Gracias a ello, es capaz de analizar el pasado y captar la situación actual del mercado con un retraso mínimo, casi al ritmo de su propio movimiento.
Pero no hay que olvidar que detrás de cada idea elegante hay una ingeniería rigurosa. Para que el modelo siga siendo rápido, estable y adaptable, es necesario organizar los cálculos de forma bien planificada, hacer un uso racional de la memoria y respetar estrictamente la causalidad en el procesamiento de los eventos. Por eso, la implementación práctica no es solo una comprobación de la teoría, sino una etapa fundamental en la evolución del framework. Permite comprender hasta qué punto una idea es viable fuera del entorno de laboratorio y si puede convertirse en una herramienta analítica real para el operador.
Así, la teoría va cobrando vida poco a poco. Y quizá sea precisamente en la capacidad del modelo para captar el ritmo y el impulso del flujo financiero donde se esconde ese matiz que distingue a la inteligencia artificial de un simple algoritmo. Seguimos trabajando para convertir S3CE-Net en una herramienta capaz de sentir el mercado.
A continuación mostramos una visualización del framework S3CE-Net elaborada por el autor.
Módulo SSAM
En la parte práctica del trabajo anterior nos detuvimos en una etapa fundamental: la implementación de los algoritmos de propagación directa y retropropagación del módulo SSAM en el programa OpenCL. Es precisamente allí, en los núcleos computacionales, donde se forma la base del comportamiento del mecanismo de atención, capaz de procesar un flujo de eventos de impulsos respetando una causalidad temporal estricta. Era un paso necesario, ya que es precisamente en el nivel de OpenCL donde se concentra la potencia de cálculo: el cálculo de matrices de atención, la aplicación de máscaras y la propagación de gradientes.
Hoy subimos un nivel más: a la estructura del programa principal, donde se establece la lógica de interacción entre todos los módulos del framework. Aquí creamos la clase CNeuronSSAM, que se convierte en un representante de pleno derecho de la capa de atención de impulsos dentro de la arquitectura. Si en el ámbito de OpenCL nos ocupábamos de las matemáticas puras, ahora se trata de una composición arquitectónica que combina cálculos de bajo nivel con lógica neuronal de alto nivel.
class CNeuronSSAM    :  public CNeuronSpikeActivation
  {
protected:
   uint                 iUnits;
   uint                 iHeads;
   uint                 iDimension;
   bool                 bMaskFuture;
   CNeuronSpikeConv     cQKV;
   CParams              cDiaganalBias;
   int                  ciScore;
   CNeuronBaseOCL       cMHAttentionOut;
   CNeuronSpikeConv     cW0;
   CNeuronBaseOCL       cResidual;
   CNeuronBatchNormOCL  cNorm;
   //---
   virtual bool      SpikeMHAttention(void);
   virtual bool      SpikeMHAttentionGrad(void);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronSSAM(void) {};
                    ~CNeuronSSAM(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint heads, uint dimension_k,
                          bool mask_future, ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override const  {  return defNeuronSSAM;   }
   //--- methods for working with files
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   virtual void      SetOpenCL(COpenCLMy *obj)   override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      TrainMode(bool flag) override;
   virtual bool      Clear(void) override;
  };
Esta clase hereda la funcionalidad básica de CNeuronSpikeActivation, conservando la mecánica general de activación de las neuronas de impulsos. Sin embargo, al mismo tiempo introduce su propia jerarquía de componentes, cada uno de los cuales se encarga de un aspecto concreto de la atención espacio-temporal. En la sección protegida se declaran los siguientes parámetros clave:
- iUnits: la dimensión de la secuencia analizada,
- iHeads — número de cabezas de atención,
- iDimension — longitud del vector que representa cada elemento de las representaciones internas,
- bMaskFuture — bandera de enmascaramiento que señala si el modelo puede mirar al futuro al construir el mapa de atención.
El núcleo de la clase lo constituye un conjunto de objetos internos por los que discurre todo el flujo de cálculos. El objeto cQKV se encarga de generar un trío de tensores de las entidades internas Q, K y V; la capa neuronal básica cMHAttentionOut acumula el resultado de la atención multi-cabeza, mientras que cResidual implementa las técnicas clásicas de conexión residual y normalización.
Sin embargo, cDiaganalBias ocupa un lugar especial: es un componente que permite corregir la atención en la proyección espacial. Este componente materializa la idea de Intra-Frame Relative Position Bias, propuesta por los autores del framework S3CE-Net: un mecanismo de sesgo posicional relativo dentro del fotograma que permite al modelo comprender mejor las relaciones locales entre los tokens.
Desde un punto de vista práctico, este sesgo cumple varias funciones a la vez. En primer lugar, estabiliza los cálculos, evitando que la atención se disperse cuando las dimensiones espaciales son grandes. En segundo lugar, aporta al modelo una comprensión contextual de las estructuras locales: el modelo aprende a identificar patrones característicos de los elementos más cercanos sin perder por ello la perspectiva global. Por último, en un contexto de datos de mercado en el que los tokens pueden representar niveles de precios, agrupaciones de volumen o segmentos del flujo de órdenes, cDiaganalBias ayuda al algoritmo a centrar su atención precisamente en las zonas de mayor actividad. Y es que los eventos del mercado cercanos en precio o en el tiempo rara vez son independientes entre sí. Y es precisamente esta dependencia la que alimenta el mecanismo de atención entrenable.
La principal ventaja del diseño de la clase CNeuronSSAM radica en la declaración estática de todos sus componentes internos. Esta decisión, que a primera vista parece puramente técnica, presenta en realidad importantes ventajas arquitectónicas.
En primer lugar, la organización estática elimina la necesidad de asignar y liberar memoria de forma dinámica. El constructor y el destructor de la clase pueden dejarse vacíos. No hay riesgo de fugas, fragmentación ni accesos erróneos a punteros no inicializados. Cada objeto interno existe a lo largo de todo el ciclo de vida de una instancia de la clase, creando una estructura extremadamente estable, totalmente controlada a nivel de compilación.
En segundo lugar, el esquema estático aumenta considerablemente el determinismo de los cálculos, una propiedad de vital importancia al trabajar con OpenCL y modelos de impulsos. Aquí, cada ciclo y cada operación son importantes. La ausencia de una asignación dinámica de memoria garantiza que el tiempo de inicialización y de ejecución sea siempre predecible, y que la arquitectura del modelo no dependa del estado de la memoria en el momento del inicio. Esto resulta especialmente valioso a la hora de crear algoritmos de negociación, en los que la estabilidad y la precisión de los cálculos influyen directamente en la fiabilidad de las decisiones tomadas.
Además, la declaración estática encaja a la perfección con el concepto de optimización de bajo nivel que subyace en OpenCL. A diferencia de los objetos creados dinámicamente, las instancias estáticas pueden asociarse de antemano a búferes específicos de la GPU, lo que minimiza los costes adicionales en cada acceso al dispositivo. Esto no solo acelera el funcionamiento de la capa, sino que también evita los retrasos habituales que se producen al crear y eliminar con frecuencia contextos de cálculo.
Por lo tanto, la estructura interna estática de CNeuronSSAM no es solo una cuestión de comodidad. Se trata de una solución arquitectónica bien concebida que garantiza la estabilidad, la previsibilidad y la máxima eficiencia del proceso de cálculo.
Sobre esta base sólida, con una estructura estática cuidadosamente definida, se desarrolla todo el proceso posterior de inicialización, implementado en el método Init, que convierte la clase en un elemento completo del framework S3CE-Net, listo para funcionar en tiempo real.
bool CNeuronSSAM::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                       uint units, uint window, uint heads, uint dimension_k,
                       bool mask_future, ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronSpikeActivation::Init(numOutputs, myIndex, open_cl, units * window, optimization_type, batch))
      return false;
El método Init se encarga de crear una instancia del bloque neuronal lista para funcionar y de interconectar todos sus elementos internos. El método comienza llamando al método homónimo de la clase padre, que establece los parámetros principales de la capa.
A continuación, se procede a la configuración de la arquitectura interna de la capa. Los parámetros iHeads e iDimension determinan la configuración de la atención multi-cabeza.
   iHeads = (uint)MathMax(heads, 1);
   iDimension = (uint)MathMax(dimension_k, 1);
   iUnits = units;
   bMaskFuture = mask_future;
Los valores se procesan mediante la función MathMax para descartar la posibilidad de que haya tamaños nulos. Esto resulta especialmente importante a la hora de generar búferes en el lado de OpenCL.
El siguiente paso consiste en inicializar los componentes internos, es decir, los propios «ladrillos» que conforman la lógica de la capa. En primer lugar, se crea el objeto cQKV, encargado de generar los tres tensores básicos de atención: Query, Key y Value. Su tamaño se define como el triple del producto del número de cabezas de atención por la dimensión de los vectores, lo que garantiza una distribución correcta de los parámetros por todos los subespacios de atención.
   uint index = 0;
   if(!cQKV.Init(0, index, OpenCL, window, window, 3 * iHeads * iDimension, iUnits, 1, optimization, iBatch))
      return false;
A continuación, se inicializa cDiaganalBias, que crea una estructura para almacenar y calcular la matriz de sesgos posicionales, el denominado Intra-Frame Relative Position Bias, que añade una corrección inteligente en función de la posición relativa de los elementos dentro del fotograma. Este bloque puede considerarse un ajuste fino de la atención: permite al modelo percibir la proximidad de los tokens en el espacio y corregir el enfoque en función de su posición relativa.
   index++;
   if(!cDiaganalBias.Init(0, index, OpenCL, iUnits, optimization, iBatch))
      return false;
   cDiaganalBias.SetActivationFunction(None);
   CBufferFloat* temp=cDiaganalBias.getWeightsParams();
   if(!temp ||
      !temp.Fill(0))
     return false;
En la fase inicial, el objeto cDiaganalBias se inicializa con ceros, lo cual resulta totalmente lógico durante la primera puesta en marcha del modelo. En este momento, la red neuronal aún no dispone de información sobre la disposición relativa de los elementos dentro del fotograma: es «ciega» a la geometría interna del espacio de entrada. La inicialización a cero proporciona un punto de partida limpio, en el que todos los sesgos relativos son iguales y el mecanismo de atención actúa exclusivamente a través de los tensores básicos Q, K y V.
Merece especial atención la creación del búfer ciScore, que reserva un área de memoria para almacenar valores intermedios de similitud entre las consultas y las claves únicamente en el contexto de OpenCL. Este búfer se utiliza como almacenamiento temporal al calcular los pesos de atención. La comprobación del resultado garantiza que la memoria se haya asignado realmente; de lo contrario, la inicialización se interrumpe: esta comprobación hace que el proceso sea fiable y controlable.
   ciScore = OpenCL.AddBuffer(sizeof(float) * iUnits * iUnits * iHeads, CL_MEM_READ_WRITE);
   if(ciScore == INVALID_HANDLE)
      return false;
A continuación, se conectan de forma secuencial los demás módulos de la capa. El objeto cMHAttentionOut se encarga de agregar los resultados de la atención multi-cabeza, se inicializa con una dimensión total de iUnits * iDimension * iHeads y desactiva la función de activación para conservar el valor puro tras las operaciones de atención.
   index++;
   if(!cMHAttentionOut.Init(0, index, OpenCL, iUnits * iDimension * iHeads, optimization, iBatch))
      return false;
   cMHAttentionOut.SetActivationFunction(None);
A continuación viene cW0, un operador lineal que se aplica a la salida de la atención. Sus parámetros se entrenan de tal forma que pueda adaptar de manera flexible la dimensión del resultado a los cálculos posteriores.
   index++;
   if(!cW0.Init(0, index, OpenCL, iHeads * iDimension, iHeads * iDimension, window, iUnits, 1, optimization, iBatch))
      return false;
El componente cResidual proporciona una conexión residual que devuelve parte de la señal original al resultado de la capa, lo que ayuda al modelo a evitar la degradación de los gradientes durante el aprendizaje profundo. En el caso de cResidual, se desactiva explícitamente la función de activación y, además, se establece un gradiente compartido con cW0; esto permite sincronizar el aprendizaje entre capas y mantener la estabilidad durante la retropropagación del error.
   index++;
   if(!cResidual.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
      return false;
   cResidual.SetActivationFunction(None);
   if(!cResidual.SetGradient(cW0.getGradient(), true))
      return false;
En el último paso se inicializa cNorm, que estabiliza la distribución de los valores a la salida de la capa y corrige posibles desequilibrios provocados por cambios dinámicos en la atención y prepara los datos para la activación de impulsos mediante los recursos de la clase padre.
   index++;
   if(!cNorm.Init(0, index, OpenCL, Neurons(), iBatch, optimization))
      return false;
//---
   return true;
  }
Cada uno de estos componentes recibe su propio índice, un objeto OpenCL común y parámetros de optimización, formando así una jerarquía claramente estructurada y controlada por la clase principal. Una vez completadas con éxito todas las iteraciones del algoritmo, el método finaliza y la instancia de CNeuronSSAM está lista para funcionar: todos los búferes, conexiones y cadenas de cálculo están configurados, y la capa está totalmente integrada en la estructura del modelo.
El algoritmo de propagación directa se ha implementado en el método feedForward. Su funcionamiento ilustra cómo la información sobre los eventos de impulsos se propaga a través de todos los niveles del módulo de atención, incluidos los sesgos posicionales y las conexiones residuales.
bool CNeuronSSAM::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cQKV.FeedForward(NeuronOCL))
      return false;
En el primer paso se calculan los tensores Q, K y V, que constituyen la base para el cálculo de la atención multi-cabeza. Esta es una etapa clave: sin consultas, claves y valores correctamente definidos, no es posible realizar una agregación posterior de la información.
A continuación, se generan los parámetros de sesgo optimizados. En otras palabras, se crean los valores de trabajo que se utilizarán para ajustar los pesos de atención.
   if(bTrain)
      if(!cDiaganalBias.FeedForward())
         return false;
Es importante señalar que esta operación solo se lleva a cabo en modo de entrenamiento (bTrain == true). En producción, cuando el modelo ya está entrenado, los parámetros de sesgo permanecen estáticos y ya están almacenados en el búfer de resultados del objeto. Este enfoque permite minimizar la sobrecarga al trabajar en tiempo real.
En la siguiente etapa se invoca SpikeMHAttention, que, en realidad, es una envoltura del núcleo homónimo del programa OpenCL. Su función consiste en preparar el núcleo y ponerlo en la cola de ejecución. Aquí se crean todos los búferes necesarios, se configuran los parámetros y se pasan las referencias a Q, K, V, así como a los sesgos posicionales cDiaganalBias.
   if(!SpikeMHAttention())
      return false;
Toda la carga computacional, incluida la atención multi-cabeza, la normalización de pesos y la incorporación del sesgo de posición relativa intrafotograma, se ejecuta exclusivamente en la GPU, aprovechando sus capacidades de ejecución paralela. Este enfoque permite procesar tensores de gran tamaño y operaciones complejas de atención con un alto rendimiento, dejando la CPU libre para gestionar el flujo de datos y controlar el estado del modelo.
A continuación, se lleva a cabo una transformación lineal que adapta la salida de la atención multi-cabeza al tamaño de los datos originales y prepara los valores para la conexión residual.
   if(!cW0.FeedForward(cMHAttentionOut.AsObject()))
      return false;
Luego se suman las señales de los dos flujos de información.
   if(!SumAndNormilize(NeuronOCL.getOutput(), cW0.getOutput(), cResidual.getOutput(),
                       Neurons() / iUnits, false, 0, 0, 0, 1))
      return false;
Después hay que preparar los valores obtenidos para la activación de impulsos. Mantenemos el enfoque Element-Wise: cada celda del tensor de salida se procesa de forma independiente, lo que permite controlar con precisión la dinámica de los impulsos.
Para mantener los valores dentro de un rango comparable y evitar la pérdida de detalle en las señales, se aplica la capa de normalización por lotes cNorm. Estabiliza la distribución de los datos tras sumar los valores de dos flujos de información, manteniéndolos dentro de unos límites adecuados para su posterior activación.
   if(!cNorm.FeedForward(cResidual.AsObject()))
      return false;
Tras la normalización, la señal controlada se transmite al método del mismo nombre de la clase padre, donde se llevan a cabo las operaciones de activación de impulsos adaptativa.
   return CNeuronSpikeActivation::feedForward(cNorm.AsObject());
  }
Este enfoque permite que el módulo SSAM se integre correctamente en la red general, transmitiendo los eventos de impulsos a lo largo de la cadena y manteniendo una alta precisión y estabilidad en el funcionamiento del mecanismo de atención.
Tras realizar la propagación directa y obtener los valores previstos, llega la etapa de retropropagación del error, en la que es necesario comparar la predicción con los datos reales y distribuir los gradientes entre todos los componentes de la capa. Esta tarea se ha encomendado al método calcInputGradients.
bool CNeuronSSAM::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
El método comienza comprobando la validez del puntero recibido al objeto de datos de origen NeuronOCL. A continuación, se invoca el método del mismo nombre de la clase padre. En esta etapa, los gradientes de activación de impulsos se distribuyen hasta el nivel de la capa de normalización por lotes.
   if(!CNeuronSpikeActivation::calcInputGradients(cNorm.AsObject()))
      return false;
A continuación, el error se transmite al objeto encargado de gestionar las conexiones residuales. Y gracias a la sustitución de los punteros a los búferes de datos de los gradientes de error, los valores obtenidos se transfieren automáticamente al objeto de agregación de valores de la atención multi-cabeza.
   if(!cResidual.CalcHiddenGradients(cNorm.AsObject()))
      return false;
El siguiente paso es llamar a SpikeMHAttentionGrad, donde se lleva a cabo la retropropagación a través de la atención multi-cabeza de impulsos.
   if(!SpikeMHAttentionGrad())
      return false;
Aquí se tienen en cuenta todos los pesos de atención, los tensores QKV y los sesgos posicionales cDiaganalBias. Esta etapa es de vital importancia: es precisamente la que permite ajustar los parámetros de atención en función de la estructura local y global de la señal analizada.
A continuación, los gradientes se propagan hacia los datos de origen. En primer lugar, distribuimos el error procedente de los componentes Q, K y V.
   if(!NeuronOCL.CalcHiddenGradients(cQKV.AsObject()))
      return false;
Luego hay que sumar los valores que llegan por la ruta de las conexiones residuales. En este caso, hay dos posibilidades, según si el objeto de datos de origen tiene o no una función de activación. En caso de que no exista la función de activación, los gradientes de las conexiones residuales se transmiten directamente y se suman a los valores acumulados anteriormente.
   if(NeuronOCL.Activation() == None)
     {
      if(!SumAndNormilize(NeuronOCL.getGradient(), cResidual.getGradient(),
                          NeuronOCL.getGradient(), Neurons() / iUnits, false, 0, 0, 0, 1))
         return false;
     }
   else
     {
      if(!DeActivation(NeuronOCL.getOutput(), cResidual.getPrevOutput(),
                       cResidual.getGradient(), NeuronOCL.Activation()))
         return false;
      if(!SumAndNormilize(NeuronOCL.getGradient(), cResidual.getPrevOutput(),
                          NeuronOCL.getGradient(), Neurons() / iUnits, false, 0, 0, 0, 1))
         return false;
     }
//---
   return true;
  }
Si existe una función de activación, primero se ajustan los gradientes de error de la ruta de las conexiones residuales en función de la derivada de la función de activación utilizada. Y solo después de eso se suman los gradientes.
En definitiva, el método calcInputGradients distribuye el error entre todos los componentes del proceso: desde la activación de impulsos, pasando por la normalización, las conexiones residuales, las transformaciones lineales y la atención multi-cabeza, hasta la secuencia analizada y el sesgo posicional. Este mecanismo garantiza la actualización correcta de todos los parámetros de la capa durante el entrenamiento y permite que el modelo mejore progresivamente la precisión de las predicciones, manteniendo la estabilidad y la coherencia de los cálculos.
La optimización directa de los parámetros se lleva a cabo en el método updateInputWeights. Aquí no hay una lógica compleja de redistribución ni es necesario calcular los nuevos valores manualmente: todos los parámetros entrenables ya se encuentran en los componentes internos de la clase. El proceso de optimización consiste en llamar sucesivamente a los métodos del mismo nombre de estos componentes, cada uno de los cuales actualiza de forma independiente sus pesos y búferes basándose en los gradientes obtenidos.
bool CNeuronSSAM::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cQKV.UpdateInputWeights(NeuronOCL))
      return false;
   if(!cDiaganalBias.UpdateInputWeights())
      return false;
   if(!cW0.UpdateInputWeights(cMHAttentionOut.AsObject()))
      return false;
   if(!cNorm.UpdateInputWeights(cResidual.AsObject()))
      return false;
//---
   return CNeuronSpikeActivation::updateInputWeights(cNorm.AsObject());
  }
Esta arquitectura garantiza la modularidad y facilita el mantenimiento del código. Cada bloque se encarga únicamente de sus propios parámetros, mientras que la clase controla el orden de actualización y garantiza la coherencia de los datos.
Como resultado, el método updateInputWeights se convierte en un nodo coordinador que ejecuta sucesivamente la optimización de todas las estructuras internas, lo que garantiza una actualización coherente y estable del modelo. Este enfoque se ajusta plenamente al principio de encapsulación: los detalles del entrenamiento quedan ocultos dentro de los componentes, y el nivel superior solo controla su sincronización y el orden de ejecución.
El código completo de la clase CNeuronSSAM, junto con todos sus métodos, está disponible en el archivo adjunto al artículo. Además, permite al lector no solo comprender la lógica de funcionamiento de la capa a nivel conceptual, sino también, si lo desea, utilizar el código ya preparado para realizar experimentos o adaptarlo a sus propias necesidades.
Integración con la versión de impulsos de ResNeXt
La siguiente fase de nuestro trabajo consistirá en integrar el módulo SSAM en el algoritmo ya desarrollado SEW-ResNeXt. En la descripción del framework S3CE‑Net realizada por sus autores se destaca que es posible integrar varios módulos de atención entre los bloques SEW-ResNet en distintos niveles. Y este enfoque encaja de forma natural en la estructura de los modelos secuenciales, sin necesidad de crear módulos o marcos adicionales.
Sin embargo, cabe recordar aquí que, en nuestra implementación del bloque SEW-ResNeXt, se utilizan dos bloques Bottleneck en paralelo que analizan los datos de entrada en diferentes representaciones: temporal y espacial. Cada uno de estos flujos contiene información única. El análisis temporal permite captar la dinámica de las señales e identificar patrones en la secuencia de eventos, mientras que el análisis espacial registra las relaciones locales entre los elementos de datos en el corte actual.
Teniendo en cuenta esta arquitectura, sería lógico integrar el módulo SSAM en cada una de las ramas de información, garantizando un procesamiento independiente de la atención en las representaciones espacial y temporal. Este enfoque permitirá aprovechar el potencial de la atención multi-cabeza de impulsos en distintos contextos, sin alterar la estructura general del modelo, y podría mejorar su precisión gracias a la adaptación independiente de los pesos de atención para cada tipo de información.
Por lo tanto, la integración de SSAM en ambas ramas del bloque SEW-ResNeXt constituye una prolongación natural del concepto arquitectónico de S3CE-Net, lo que garantiza flexibilidad, robustez y la capacidad de captar con precisión las dependencias espaciotemporales de los datos analizados.
Es precisamente en el marco del concepto descrito donde se crea el nuevo módulo CNeuronSSAMResNeXtBlock, que hereda la funcionalidad básica de CNeuronSpikeResNeXtBlock.
class CNeuronSSAMResNeXtBlock   :  public CNeuronSpikeResNeXtBlock
  {
protected:
   CNeuronSSAM        caSSAM[2];
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronSSAMResNeXtBlock(void) {};
                    ~CNeuronSSAMResNeXtBlock(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint chanels_in, uint chanels_out, uint units_in,
                          uint units_out, uint group_size, uint groups,
                          uint heads, uint dimension_k,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   override const   {  return defNeuronSSAMResNeXtBlock;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      TrainMode(bool flag) override;
   virtual bool      Clear(void) override;
  };
En la sección protegida de la clase solo se declara el array caSSAM, que contiene dos instancias del módulo SSAM: una para cada rama de análisis de los datos de origen. Todos los demás componentes que necesitamos se heredan de la clase padre.
El constructor y el destructor de la clase permanecen vacíos, ya que todos los componentes internos son estáticos. Su inicialización y configuración se llevan a cabo en el método Init, que se encarga del despliegue completo del bloque, la creación de todos los objetos internos y su configuración.
bool CNeuronSSAMResNeXtBlock::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                   uint chanels_in, uint chanels_out, uint units_in,
                                   uint units_out, uint group_size, uint groups,
                                   uint heads, uint dimension_k,
                                   ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronSpikeResNeXtBlock::Init(numOutputs, myIndex, open_cl, chanels_in, chanels_out,
                                      units_in, units_out, group_size, groups, optimization_type, batch))
      return false;
El algoritmo del método comienza con la inicialización del bloque básico SEW-ResNeXt, en la que se configuran los parámetros principales del módulo: el número de canales de entrada y salida, el número de elementos de la secuencia, el tamaño de los grupos y la estrategia de optimización. Esto garantiza que la arquitectura inicial Bottleneck esté correctamente configurada antes de añadir la atención.
A continuación, se inicializan dos módulos SSAM: uno para cada flujo de información del bloque. La primera instancia trabaja con las salidas de Bottleneck en la dimensión temporal, aplicando el enmascaramiento de pasos futuros (mask_future = true).
   if(!caSSAM[0].Init(0, 0, OpenCL, units_out, chanels_out, heads, dimension_k, true, optimization, iBatch))
      return false;
La segunda instancia procesa los resultados del Bottleneck espacial. Y aquí ya no utilizamos el enmascaramiento (mask_future = false).
   if(!caSSAM[1].Init(0, 0, OpenCL, chanels_out, units_out, heads, dimension_k, false, optimization, iBatch))
      return false;
Después conviene recordar que, durante la inicialización de la clase padre, sincronizamos los punteros a los búferes de gradientes del primer Bottleneck y del objeto de conexiones residuales para reducir las operaciones de copia de datos entre búferes. Por nuestra parte, tenemos que integrar entre ellos el módulo SSAM correspondiente. Aprovechando la igualdad entre los tensores de entrada y salida del módulo, simplemente intercambiamos los punteros a los búferes de los gradientes de error entre los módulos.
   CBufferFloat* temp = caBottleneck[0].getGradient();
   if(!caBottleneck[0].SetGradient(caSSAM[0].getGradient(), false))
      return false;
   if(!caSSAM[0].SetGradient(temp, false))
      return false;
//---
   return true;
  }
Este intercambio garantiza una propagación correcta del error entre los bloques y permite que ambos componentes adapten sus parámetros.
Como resultado, el método Init crea un módulo totalmente listo para funcionar, en el que SEW-ResNeXt y SSAM están integrados en una única cadena de cálculo, y los gradientes y los búferes están organizados para garantizar la estabilidad del aprendizaje y la máxima eficiencia.
El algoritmo de propagación directa se ha implementado completamente desde cero, ya que la integración de dos módulos SSAM en el interior del bloque impide utilizar el método homónimo de la clase padre. Los datos recorren toda la cadena de forma secuencial, y cada rama se procesa teniendo en cuenta sus características específicas y su posición en la arquitectura.
bool CNeuronSSAMResNeXtBlock::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!caTranspose[0].FeedForward(NeuronOCL))
      return false;
En primer lugar, la señal de entrada pasa por la capa de transposición caTranspose[0], que prepara los datos para su procesamiento en paralelo y los alinea según la dimensión espacial. A continuación, los módulos Bottleneck SEW-ResNeXt, dispuestos en serie, procesan el flujo de entrada: el primero analiza los datos originales directamente en forma de secuencia temporal.
   if(!caBottleneck[0].FeedForward(NeuronOCL))
      return false;
Y el segundo recibe la señal transpuesta, lo que permite percibir la información de forma independiente en diferentes representaciones.
   if(!caBottleneck[1].FeedForward(caTranspose[0].AsObject()))
      return false;
En esta fase se lleva a cabo la conexión de los módulos SSAM: cada una de las dos instancias procesa su propio flujo, ya sea temporal o espacial. El primer SSAM aplica el enmascaramiento de los pasos futuros, ajustando la dinámica temporal, mientras que el segundo genera un mapa de atención para la representación espacial.
   for(int i = 0; i < 2; i++)
      if(!caSSAM[i].FeedForward(caBottleneck[i].AsObject()))
         return false;
El resultado del segundo módulo pasa además por una capa de transposición, lo que garantiza una alineación correcta antes de combinarse con la señal residual cResidual.
   if(!caTranspose[1].FeedForward(caSSAM[1].AsObject()))
      return false;
A continuación, se suman las salidas de los módulos SSAM y de la rama de conexiones residuales. El resultado se guarda en el búfer de la primera capa del módulo Element-Wise de la función cG. Esto garantiza una integración coordinada de todos los flujos de información y estabiliza los valores antes de su transmisión a los elementos siguientes del bloque.
   if(!cResidual.FeedForward(NeuronOCL))
      return false;
//---
   CNeuronBaseOCL* current = cG[0];
   if(!current)
      return false;
   if(!SumAndNormilize(caSSAM[0].getOutput(), caTranspose[1].getOutput(),
                       current.getOutput(), caTranspose[1].GetCount(), false, 0, 0, 0, 1) ||
      !SumAndNormilize(current.getOutput(), cResidual.getOutput(),
                       current.getOutput(), caTranspose[1].GetCount(), false, 0, 0, 0, 1))
      return false;
A continuación, los datos pasan sucesivamente por todos los elementos restantes de la función cG, donde cada objeto recibe la señal del paso anterior y realiza su propagación directa.
   for(int i = 1; i < cG.Total(); i++)
     {
      current = cG[i];
      if(!current ||
         !current.FeedForward(cG[i - 1]))
         return false;
     }
Finalmente, la señal normalizada y agregada se transmite al método del mismo nombre de la clase padre para aplicar la activación de impulsos adaptativa.
   return CNeuronSpikeActivation::feedforward(cG[-1]);
  }
Este enfoque permite conservar plenamente la modularidad y la integridad estructural del bloque, al tiempo que garantiza el procesamiento y la integración correctos de los flujos de datos temporales y espaciales, así como el aprovechamiento eficaz del potencial de la atención multi-cabeza de impulsos.
Se han introducido cambios similares en los métodos de retropropagación, en los que también se ha tenido en cuenta la integración de los dos módulos SSAM y su interacción con las ramas SEW-ResNeXt. Para comprender mejor la estructura y el funcionamiento del bloque, le recomendamos que examine estos métodos por su cuenta.
Cabe señalar que el principio sigue siendo el mismo: los gradientes se propagan secuencialmente a través de cada componente: Bottleneck, los módulos SSAM, las capas de transposición y las capas residuales. Y la actualización de los parámetros se lleva a cabo de forma secuencial mediante los métodos del mismo nombre de los objetos internos.
En general, CNeuronSSAMResNeXtBlock actúa como una capa de integración que combina armoniosamente SEW-ResNeXt y SSAM, lo que permite tener en cuenta simultáneamente las dependencias espaciotemporales locales y globales de los datos, sin alterar la estructura modular del modelo. El código completo de la clase y de todos sus métodos se incluye en el archivo adjunto.
Hoy hemos trabajado muy bien. Ha llegado el momento de hacer una pequeña pausa para dejar que las ideas se asienten y asimilar los conocimientos adquiridos. En el próximo artículo continuaremos el trabajo iniciado hasta llevarlo a su conclusión lógica y verificaremos los enfoques implementados con datos históricos reales. Esto permitirá evaluar la eficacia del modelo en condiciones lo más cercanas posible a la práctica y comprobar que todos los componentes se han integrado correctamente.
Conclusión
En este artículo hemos continuado trabajando en la implementación de los enfoques propuestos por los autores del framework S3CE-Net, prestando especial atención a la integración del módulo SSAM en el bloque SEW-ResNeXt. Esta integración permite crear un potente bloque combinado en el que la atención multi-cabeza de impulsos funciona simultáneamente con los bloques residuales de SEW-ResNeXt, lo que garantiza un análisis profundo y preciso de las características temporales y espaciales de los datos originales.
La flexibilidad arquitectónica y la modularidad del framework permiten adaptar el bloque a distintos escenarios de procesamiento de señales. Cada componente conserva su autonomía. Bottleneck analiza los datos de entrada en sus propias representaciones. Los módulos SSAM ajustan el mapa de atención en cada flujo, mientras que las capas de transposición y residuales garantizan una integración coherente de la información. Este enfoque garantiza que el modelo sea capaz de tener en cuenta simultáneamente las dependencias locales y los patrones globales, lo que asegura una alta precisión en las predicciones y robustez frente al ruido en los datos.
Enlaces
- S3CE-Net: Spike-guided Spatiotemporal Semantic Coupling and Expansion Network for Long Sequence Event Re-Identification
- Otros artículos de la serie
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | Study.mq5 | Asesor experto | Asesor experto para el aprendizaje offline de modelos |
| 2 | StudyOnline.mq5 | Asesor experto | Asesor experto para el aprendizaje en línea de modelos |
| 3 | Test.mq5 | Asesor experto | Asesor experto para probar el modelo |
| 4 | Trajectory.mqh | Biblioteca de clases | Estructura de la descripción del estado del sistema y de la arquitectura de los modelos |
| 5 | NeuroNet.mqh | Biblioteca de clases | Biblioteca de clases para crear una red neuronal |
| 6 | NeuroNet.cl | Biblioteca | Biblioteca de código del programa OpenCL |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19956
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.