Redes neuronales en el trading: Un enfoque semántico de impulsos para la identificación espaciotemporal (Final)
 11
 0

Introducción
Que el mercado esté en silencio no significa que esté tranquilo. Bajo su superficie, la vida bulle constantemente: ráfagas de órdenes, fluctuaciones de la liquidez, cambios en los volúmenes. Todo ello son impulsos breves, casi imperceptibles, de los que surge la evolución del precio. Cada tick es una señal en el tejido vivo del mercado. Y es precisamente en esos instantes, cuando la mayoría aún solo ve silencio, cuando comienza el verdadero proceso de formación de una tendencia.
Los métodos clásicos de análisis son demasiado lentos para captar este momento. Ven un hecho ya consumado: una vela, un extremo, una formación. Pero para un trader lo importante es otra cosa: percibir el cambio antes de que se haga evidente. Y aquí es donde entran en juego los modelos de nueva generación: arquitecturas capaces de reconocer eventos.
Una de estas arquitecturas es S3CE-Net: Spike-guided Spatiotemporal Semantic Coupling and Expansion Network. En un principio, se propuso para trabajar con flujos de datos de cámaras de eventos, en las que cada píxel no registra una imagen estática, sino un cambio instantáneo de luz: una especie de spike, un impulso. En esencia, se trata de los mismos eventos que en el mercado: irregulares, asíncronos, breves, pero significativos.
Nos planteamos lo siguiente: en realidad, el mercado financiero también es un sistema basado en eventos. Aquí el tiempo no transcurre de forma uniforme. Todo viene determinado por las ráfagas de actividad: esos momentos en los que, de repente, se hace presente un gran participante del mercado en el flujo de órdenes, la liquidez se contrae y el movimiento del precio se acelera. Si se enseña al modelo a interpretar estos impulsos como una estructura, podrá anticiparse y reaccionar.
En artículos anteriores ya nos familiarizamos con los fundamentos teóricos del framework S3CE-Net. Hemos analizado el concepto del enfoque basado en eventos, hemos explicado por qué el mercado puede considerarse como un flujo de impulsos y hemos sentado las bases para trasladar los enfoques propuestos al entorno de MQL5.
La siguiente etapa supuso un avance en ingeniería: implementamos el módulo SSAM (Spike-guided Spatial-Temporal Attention Mechanism) y lo adaptamos a las particularidades computacionales del terminal de trading.
Ahora ha llegado el momento de la fase final. Aquí lo unimos todo: desde el concepto hasta la práctica, desde la teoría de los eventos hasta la evaluación de los resultados. Comprobaremos cómo se comporta S3CE-Net con datos históricos reales, hasta qué punto es resistente al ruido del mercado y si su mecanismo de atención es capaz de distinguir las señales verdaderas entre las fluctuaciones aleatorias.
La arquitectura de S3CE-Net se basa en dos ideas que se complementan entre sí. La primera es SSAM, un mecanismo de atención que aprende a centrarse en los eventos importantes y a suprimir los insignificantes. Es como un trader experimentado que percibe el sentimiento del mercado tras el flujo de combinaciones de velas: dónde el impulso está lleno de energía y dónde no es más que una onda que se va atenuando. La segunda es STFS (Spatiotemporal Feature Sampling Strategy). Amplía la percepción del modelo, permitiéndole ver una secuencia fluida de eventos interrelacionados.
Por analogía, SSAM es la atención del trader y STFS, su memoria. Juntos forman un modelo capaz de percibir y recordar lo que ha sucedido anteriormente. Esa es precisamente la esencia del análisis: no quedarse estancado en el momento presente, pero tampoco perder de vista el contexto.
Cuando trasladamos estas ideas al entorno de MQL5, la tarea deja de ser solo técnica para convertirse también en filosófica. La cámara de vídeo registra los cambios de luminosidad, mientras que el mercado registra los cambios en el precio y el volumen. Cada tick, cada repunte de volatilidad, cada cambio en el libro de órdenes: todo ello puede convertirse en un spike si se define correctamente el criterio de relevancia.
Este enfoque nos obliga a ver el mercado de otra manera. Vemos un sistema de impulsos a partir de los cuales se forma el movimiento a gran escala. S3CE-Net parece traducir el lenguaje del mercado al lenguaje de los eventos, donde cada cambio es una letra y toda la serie es una frase. El modelo aprende a interpretar este lenguaje del mismo modo que un analista experimentado interpreta un gráfico de cotizaciones: no con los ojos, sino con la intuición. S3CE-Net no espera a que se confirme el patrón, sino que reacciona ante los indicios previos. Esto es especialmente importante en situaciones de alta volatilidad, en las que los indicadores clásicos se retrasan.
A un trader acostumbrado a basarse en patrones de velas o indicadores, esta idea puede resultarle poco habitual. Pero si lo analizamos con más detenimiento, se trata de una continuación lógica de la evolución del análisis. Primero evaluábamos los niveles y las zonas, luego pasábamos a los modelos probabilísticos y ahora ha llegado el momento de los modelos basados en eventos. Es un paso natural: de la observación a la comprensión, de los datos al significado.
Precisamente por eso, el trabajo en la implementación de S3CE-Net mediante MQL5 no se limita a objetivos puramente técnicos. Nuestro objetivo es mostrar cómo los principios arquitectónicos, creados para un ámbito totalmente distinto, pueden dar un nuevo impulso al análisis de mercado. Al fin y al cabo, tanto el trading como el análisis basado en eventos consisten en buscar una estructura en el caos, en saber extraer sentido de un flujo de información.
El mercado, al igual que cualquier sistema vivo, respira de forma irregular, y quien sea capaz de percibir ese ritmo obtiene una ventaja. S3CE-Net es un intento de dotar a las máquinas de este sentido del oído, de dar al algoritmo la capacidad de percibir dónde empieza el movimiento y dónde termina. No es magia, sino el resultado de un análisis minucioso de la estructura de los eventos.
A continuación mostramos una visualización del framework S3CE-Net elaborada por el autor.

Hoy llegamos al final lógico. Ya hemos dejado atrás la arquitectura, la implementación y la adaptación. Ahora nos esperan las pruebas, la evaluación y, quizá, un replanteamiento del enfoque habitual de predicción. Así, veremos cómo se comporta el modelo creado ante los flujos reales del mercado, con qué precisión distingue las señales auténticas y cómo su mecanismo de atención por impulsos influye en la calidad de las previsiones.
Módulo STFS
Hoy nos queda dar el último paso para poner en práctica los enfoques propuestos por los autores del framework S3CE-Net: construir el módulo STFS (Spatio-Temporal Feature Sampling Strategy). Se trata del elemento final de toda la arquitectura, capaz de enseñar al modelo a ver el mercado de forma integral: a percibir el contexto general, en lugar de centrarse exclusivamente en patrones locales.
Al igual que cualquier trader con experiencia, STFS aprende a distinguir lo esencial de lo secundario. Su objetivo es lograr que el modelo analice no solo fragmentos concretos de datos de mercado, sino también las relaciones entre ellos, combinando la percepción del tiempo y del espacio. Al fin y al cabo, el mercado no es solo una línea en un gráfico. Se trata de un sistema multidimensional en el que cada vela, cada volumen o cada impulso están conectados entre sí por hilos invisibles. Son precisamente esos vínculos los que el algoritmo debe aprender a reconocer.
Los autores de S3CE-Net han propuesto un mecanismo muy ingenioso para ello. Durante el proceso de aprendizaje, el módulo divide el mapa de características en submuestras según el tiempo y el espacio.
En primer lugar, se lleva a cabo un muestreo temporal. De toda la secuencia se selecciona aleatoriamente un conjunto de pasos temporales. Para cada uno de ellos se calcula una representación media, una especie de instantánea de la situación del mercado en un momento concreto. Estas instantáneas conforman un conjunto de características temporales que reflejan la dinámica del proceso.
A continuación, se realiza el muestreo espacial. El mapa de características se divide en varias regiones aleatorias. Cada región se promedia por separado, lo que permite identificar las estructuras locales. Si hacemos una analogía con el mercado, es como analizar los distintos sectores de la actividad del mercado.
Por último, se extrae un vector semántico global, que constituye una representación generalizada del estado del mercado en su conjunto. Este se elabora mediante el promedio de todos los datos del mapa de características y actúa como un indicador integral que sintetiza tanto los patrones temporales como los espaciales.
El entrenamiento del modelo se basa en dos funciones de pérdida clave: la pérdida de tripletas y la entropía cruzada con suavizado de etiquetas. La primera ayuda al modelo a identificar las características principales, acentuando las diferencias entre los estados del mercado que son realmente significativos. La segunda estabiliza el aprendizaje, evitando que se sobrevaloren las fluctuaciones aleatorias. En conjunto, aportan al sistema una intuición que le permite no perderse entre el ruido del mercado.
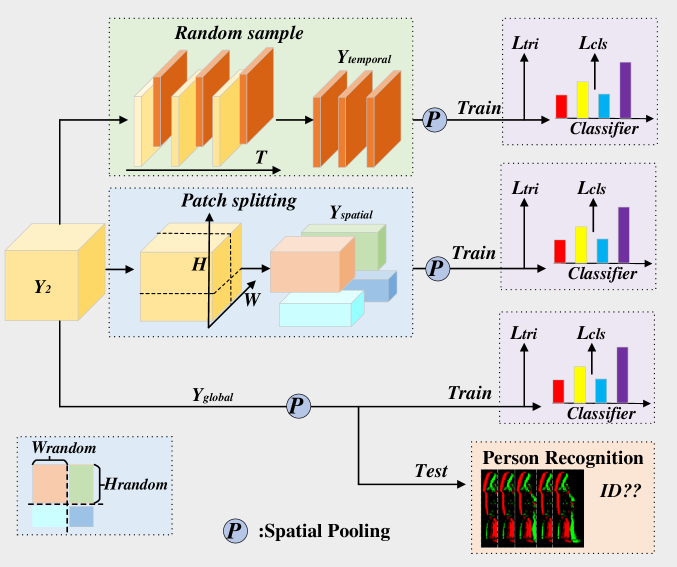
En nuestro trabajo nos permitiremos reinterpretar ligeramente el enfoque original propuesto por los autores de S3CE-Net. Si bien en el concepto original se prestaba especial atención al análisis de la estructura espaciotemporal de la imagen, en el caso de los datos financieros la naturaleza de la señal analizada es diferente. El mercado no tiene geometría: su estructura no es visual, sino semántica. En este caso, las características constituyen un vector de factores económicos, en el que cada coordenada aporta su propio contexto: precio, volumen, volatilidad, indicadores de sentimiento y métricas estructurales de liquidez. Y lo que resulta especialmente importante: sus relaciones no tienen por qué correlacionarse con la proximidad de los índices en este vector.
Precisamente por eso, la aplicación directa del muestreo espacial, tal y como se hace en la implementación clásica de STFS para imágenes, no siempre está justificada. No podemos dar por sentado que los elementos contiguos de un vector de características tengan un valor o una influencia similares. En los datos de mercado, la proximidad tiene un carácter lógico y funcional. El precio puede estar estrechamente relacionado con el volumen, pero no con el índice del indicador técnico situado a su lado en el array de datos.
Por este motivo, usamos una estrategia de muestreo replanteada, similar a la temporal, pero aplicada al eje espacial (de características). En otras palabras, al igual que en el muestreo temporal seleccionamos puntos temporales aleatorios, aquí también seleccionaremos aleatoriamente un subconjunto de características, formando así una muestra para el entrenamiento del modelo. Este enfoque conserva la idea de aleatoriedad y generalización, pero la hace relevante precisamente para los datos vectoriales de mercado, en los que lo fundamental es el significado, y no la ubicación.
Además, a diferencia del método original, en el que los datos que no se incluyen en la muestra simplemente se descartan, nosotros procederemos de otra manera. No se perderá ninguna característica. A partir de los datos restantes, elaboraremos muestras alternativas que se utilizarán como contextos de apoyo. Esto no solo aumenta la eficacia del aprendizaje, sino que también mejora la robustez del modelo: este aprende a ver el mercado desde diferentes perspectivas, como si lo analizara a través de un conjunto de observaciones independientes, pero coherentes.
Como resultado, se generan cinco representaciones diferentes de los datos analizados:
- completa (global), que refleja la situación general del mercado;
- Dos muestras, una temporal y otra de características, que permiten al modelo centrarse en aspectos locales;
- Dos muestras alternativas que sirven como fuentes adicionales para el aprendizaje contextual.
También estamos introduciendo cambios en la forma de elaborar la previsión final. En la variante clásica de STFS para imágenes, se utiliza el promedio de las características de los bloques seleccionados, tras lo cual se forma un vector único. En los datos de mercado, este enfoque puede suavizar señales importantes, haciendo que se pierdan impulsos sutiles pero significativos.
Por eso procedemos de otra manera: se elabora una previsión independiente para cada una de las muestras obtenidas. En otras palabras, el modelo no agrupa la información de antemano, sino que analiza cada perspectiva por separado. Esto permite evaluar las señales en distintos contextos sin perder la relevancia local de los datos y conservando la capacidad de distinguir tendencias débiles, pero potencialmente importantes.
Este enfoque se asemeja al estilo analítico de un trader profesional. Un especialista con experiencia nunca se basa en un solo indicador ni en un único intervalo de tiempo: elabora varios escenarios a la vez, los compara entre sí y, partiendo de ahí, toma una decisión sobre la posición. Del mismo modo, nuestro modelo aprende a generar varias previsiones a partir de la misma información, analizando el mercado desde diferentes perspectivas.
Ahora que se ha definido y concretado el concepto de diseño del módulo STFS, ha llegado el momento de pasar a su implementación práctica. Como primer paso, elaboramos cinco representaciones de los datos que se van a analizar. Para crear todas las muestras de forma eficaz y en paralelo, utilizamos un contexto OpenCL, lo que permite procesar matrices de datos simultáneamente y acelera considerablemente los cálculos.
La implementación se basa en el kernel STFS, que crea submuestras a partir de máscaras aleatorias de pasos temporales y características. Así, se comprueba la validez de cada dato y, a continuación, se generan todas las combinaciones de muestras necesarias. Este enfoque permite crear simultáneamente tanto la muestra principal como las muestras alternativas, sin tener que esperar a que se realice el procesamiento secuencial, lo cual es fundamental a la hora de trabajar con datos de mercado en flujo continuo.
__kernel void STFS(__global const float* inputs,
                   __global const float* mask_time,
                   __global const float* mask_spatial,
                   __global float* outputs
                  )
  {
   const size_t time_id = get_global_id(0);
   const size_t spat_id = get_global_id(1);
   const size_t head = get_local_id(2);
   const size_t total_times = get_global_size(0);
   const size_t total_spats = get_global_size(1);
   const size_t total_heads = get_local_size(2);
//---
   __local float temp[3];
Para cada posición del flujo de datos, definimos identificadores locales y globales en función del tiempo, el eje espacial y las cabezas (heads), que se encargan de los distintos tipos de muestras.
En la primera etapa se determinan los desplazamientos de los elementos correspondientes dentro de los búferes de datos planos.
   const int shift_in = RCtoFlat(time_id, spat_id, total_times, total_spats, 1);
   const int shift_out = RCtoFlat(time_id, spat_id, total_times, total_spats, head);
A continuación, se extraen de los búferes de datos globales los valores necesarios, incluidas las máscaras temporales y espaciales, con las que se filtra la información.
Con el fin de reducir al mínimo el número de costosas operaciones de acceso a la memoria global, las distribuimos entre los subprocesos del grupo de trabajo y almacenamos los valores en un array de memoria local. Como resultado, cada valor se extrae del búfer global solo una vez.
   switch(head)
     {
      case 0:
         temp[0] = IsNaNOrInf(inputs[shift_in], 0);
         break;
      case 1:
         temp[1] = IsNaNOrInf(mask_time[time_id], 0);
         break;
      case 2:
         temp[2] = IsNaNOrInf(mask_spatial[spat_id], 0);
         break;
     }
   BarrierLoc
A continuación, el algoritmo crea submuestras independientes. Una para la muestra temporal principal, la segunda para la muestra temporal alternativa, la tercera para la muestra de características y la cuarta para el conjunto alternativo de características.
   float out = temp[0];
   if(out != 0)
      switch(head)
        {
         case 1:
            out *= temp[1];
            break;
         case 2:
            out *= (1 - temp[1]);
            break;
         case 3:
            out *= temp[2];
            break;
         case 4:
            out *= (1 - temp[2]);
            break;
        }
//---
   outputs[shift_out] = IsNaNOrInf(out, 0);
  }
Cada una de estas submuestras se guarda en su propio bloque del array de resultados para su posterior procesamiento por parte del modelo.
De este modo, el resultado del trabajo del kernel es un conjunto completo de cinco representaciones de los datos de partida, listas para la posterior generación de previsiones individuales. Este es un aspecto clave de la implementación práctica de STFS: el modelo puede aprender simultáneamente a partir de diferentes perspectivas del mercado, observándolo tanto a nivel global como local y desde puntos de vista alternativos.
Cabe señalar que el algoritmo del kernel para la distribución de los gradientes de error se basa en una lógica similar. Proponemos dejar los detalles de la implementación de este mecanismo para que usted los estudie por su cuenta. El código completo del programa OpenCL se incluye en el archivo adjunto.
La siguiente fase de nuestro trabajo consiste en desarrollar el módulo STFS en el programa principal, lo que permitirá integrar todas las ideas relacionadas con el muestreo y la generación de previsiones en una arquitectura única. Para ello, se crea un nuevo objeto CNeuronSTFS, que hereda de CNeuronBaseOCL las capacidades básicas de una neurona con soporte para OpenCL.
class CNeuronSTFS    :  public   CNeuronBaseOCL
  {
protected:
   CNeuronBaseOCL    cMaskTime;
   CNeuronBaseOCL    cMaskSpatial;
   CNeuronBaseOCL    cConcatenated;
   CNeuronConvOCL    cSpatialDScale;
   CNeuronConvOCL    cTimeDScale;
   CNeuronTransposeVRCOCL caTranspose[2];
   CBufferFloat      cOne;
   //---
   virtual bool      STFS(CNeuronBaseOCL *NeuronOCL);
   virtual bool      STFSGrad(CNeuronBaseOCL *NeuronOCL);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronSTFS(void) {};
                    ~CNeuronSTFS(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint chanels_in, uint chanels_out, uint units_in, uint units_out,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   override const   {  return defNeuronSTFS;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
  };
La estructura de la clase refleja los componentes clave de STFS: objetos independientes para las máscaras temporales y de características (cMaskTime, cMaskSpatial), el tensor de concatenación de representaciones (cConcatenated) y las capas especializadas de convolución y transposición (cSpatialDScale, cTimeDScale, caTranspose[2]), que garantizan la proyección correcta de los datos espaciotemporales. Todos estos elementos, en conjunto, conforman una plataforma en la que el modelo es capaz de tener en cuenta simultáneamente diversos aspectos de la información de mercado y generar cinco variantes de valores pronosticados, obtenidos a partir de diferentes representaciones.
Todos los componentes internos de la clase CNeuronSTFS se declaran de forma estática, lo que permite dejar vacíos el constructor y el destructor. El objeto se crea y se prepara íntegramente en el método Init. Este enfoque simplifica la gestión de la memoria y garantiza una inicialización predecible de todas las partes del módulo.
bool CNeuronSTFS::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                       uint chanels_in, uint chanels_out, uint units_in, uint units_out,
                       ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, chanels_out * units_out, optimization_type, batch))
      return false;
   activation = None;
El método Init realiza la configuración secuencial de cada elemento interno del módulo STFS. En primer lugar, se ejecuta la inicialización básica de la clase padre; a continuación, se configura el objeto principal para que no utilice ninguna función de activación.
En este sentido, es especialmente importante señalar que la ausencia de la función de activación a nivel del módulo es una condición imprescindible para el correcto funcionamiento del algoritmo. Los autores del framework S3CE-Net recomiendan utilizar el módulo STFS únicamente en la fase de entrenamiento. En el modo de producción, cuando el sistema genera previsiones en tiempo real, solo se utiliza la representación completa de los datos, sin crear submuestras. Por lo tanto, como se verá más adelante, en la salida del módulo solo se devuelve la predicción obtenida a partir de la representación completa, mientras que todas las submuestras intermedias sirven exclusivamente para reforzar el proceso de aprendizaje y crear un modelo más robusto y preciso. Sin embargo, en el interior del módulo se establece un proceso paralelo de aprendizaje de submuestras, y para que los gradientes se propaguen correctamente entre todos los componentes del módulo se necesita un error puro, sin correcciones basadas en la derivada de la función de activación.
Al mismo tiempo, para ofrecer flexibilidad según las necesidades del usuario, se permite aplicar una función de activación, pero esta se traslada al último objeto de proyección de datos. Es precisamente ahí, al obtener la predicción final, donde se puede aplicar una transformación no lineal, si así lo requiere un escenario concreto de funcionamiento del modelo.
Pero volvamos al algoritmo de inicialización. A continuación, se crean y se configuran las máscaras para el muestreo temporal y de características. A cada una se le asigna un índice.
   int index = 0;
   if(!cMaskTime.Init(0, index, OpenCL, units_in, optimization, iBatch))
      return false;
   cMaskTime.SetActivationFunction(None);
   index++;
   if(!cMaskSpatial.Init(0, index, OpenCL, chanels_in, optimization, iBatch))
      return false;
   cMaskSpatial.SetActivationFunction(None);
El objeto de concatenación de representaciones se genera teniendo en cuenta todas las características y el tamaño de la secuencia, multiplicados por el número de muestras, lo que proporciona la base para la predicción posterior.
   index++;
   if(!cConcatenated.Init(0, index, OpenCL, chanels_in * units_in * 5, optimization, iBatch))
      return false;
   cConcatenated.SetActivationFunction(None);
Luego se inicializa el bloque de proyección, compuesto por capas convolucionales para la proyección de los componentes espaciales y temporales (cSpatialDScale, cTimeDScale), a las que se les asignan las funciones de activación correspondientes para escalar correctamente las señales de salida.
   if(!cSpatialDScale.Init(0, index, OpenCL, chanels_in, chanels_in, chanels_out, units_in, 5, optimization, iBatch))
      return false;
   cSpatialDScale.SetActivationFunction(SoftPlus);
   index++;
   if(!cTimeDScale.Init(0, index, OpenCL, units_in, units_in, units_out, chanels_out, 5, optimization, iBatch))
      return false;
   cTimeDScale.SetActivationFunction(TANH);
La inicialización concluye con los objetos de transposición, que garantizan una conversión coherente de los datos entre las distintas representaciones.
   index++;
   if(!caTranspose[0].Init(0, index, OpenCL, 5, units_in, chanels_out, optimization, iBatch))
      return false;
   if(!caTranspose[1].Init(0, index, OpenCL, 5, chanels_out, units_out, optimization, iBatch))
      return false;
El búfer cOne se utiliza únicamente en el algoritmo de distribución de gradientes de error y permite obtener copias de los datos para todas las proyecciones.
   if(!cOne.BufferInit(5, 1) ||
      !cOne.BufferCreate(OpenCL))
      return false;
//---
   return true;
  }
Todos los elementos se configuran para realizar cálculos en paralelo en el contexto de OpenCL, lo que garantiza un alto rendimiento en el procesamiento de matrices de datos de mercado.
El algoritmo de propagación directa se ha implementado en el método feedForward. Su función consiste en hacer pasar los datos, paso a paso, por todos los componentes del módulo, con el fin de obtener una representación lista para la predicción.
bool CNeuronSTFS::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!STFS(NeuronOCL))
      return false;
En primer lugar, se invoca el método STFS, que crea cinco representaciones de los datos: una completa, dos muestras y dos muestras alternativas. En él, a diferencia de los métodos habituales para añadir kernels a la cola de ejecución, primero se muestrean las máscaras de los pasos temporales y de las características analizadas. Y solo tras realizar las tareas preparatorias se transfiere el control al kernel correspondiente.
Acto seguido, los datos pasan por una capa convolucional de proyección de características espaciales, lo que permite al modelo identificar estructuras locales y relaciones entre las características en diferentes representaciones.
   if(!cSpatialDScale.FeedForward(cConcatenated.AsObject()))
      return false;
A continuación, se lleva a cabo una transformación del tensor que garantiza una conversión correcta entre las representaciones espacial y temporal.
   if(!caTranspose[0].FeedForward(cSpatialDScale.AsObject()))
      return false;
Luego la capa convolucional de proyección temporal procesa los datos a lo largo del eje temporal, captando la dinámica del mercado e identificando patrones temporales significativos.
   if(!cTimeDScale.FeedForward(caTranspose[0].AsObject()))
      return false;
La segunda capa de transposición devuelve los datos a su representación original.
   if(!caTranspose[1].FeedForward(cTimeDScale.AsObject()))
      return false;
En la fase final, seleccionamos únicamente los datos de la representación global, tal y como proponen los autores del framework de trabajo para la producción.
   if(!DeConcat(Output, caTranspose[1].getPrevOutput(), caTranspose[1].getOutput(),
                               Neurons(), caTranspose[1].Neurons() - Neurons(), 1))
      return false;
//---
   return true;
  }
De este modo, el método feedForward garantiza un flujo continuo de datos a lo largo de todo el módulo STFS, sentando las bases para los cálculos posteriores del error, la actualización de los pesos y la generación de la predicción final a partir de una representación completa de los datos.
Una vez que el modelo ha generado los valores predichos, llega la fase de corrección de errores: la retropropagación de gradientes. El método calcInputGradients se encarga de distribuir el error entre todos los componentes del módulo STFS en función de su influencia en el resultado final.
bool CNeuronSTFS::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
Es importante destacar que el módulo STFS puede utilizarse tanto en la salida del modelo como dentro de una arquitectura más compleja. En estos casos, en la entrada de la retropropagación no recibimos valores reales, sino el error transmitido desde los objetos posteriores de la red.
A su vez, las distintas proyecciones de los datos —global, temporal, por características y muestras alternativas— presentan errores diferentes. Además, para que el entrenamiento de cada proyección sea correcto, es recomendable disponer de valores objetivo, en lugar de desviaciones. Para obtener estos valores objetivo, los resultados de predicción del módulo se suman al error recibido, formando un tensor a partir del cual se pueden entrenar correctamente las proyecciones individuales.
Precisamente por eso, la ausencia de la función de activación en la salida del módulo cobra una importancia crucial. Cualquier transformación no lineal distorsionaría este proceso, y la red perdería la capacidad de distribuir correctamente los errores y generar valores objetivo precisos para cada proyección.
   if(!SumAndNormilize(Output, Gradient, PrevOutput, 1, false, 0, 0, 0, 1))
      return false;
   if(!MatMul(GetPointer(cOne), PrevOutput, caTranspose[1].getGradient(), cOne.Total(), 1, Neurons(), 1, false))
      return false;
Multiplicamos el tensor de valores objetivo obtenido por el vector unitario, con lo que obtenemos el número necesario de copias. Y ahora calculamos el error de cada una de las representaciones.
   float error = 1;
   if(!caTranspose[1].calcOutputGradients(caTranspose[1].getGradient(), error))
      return false;
A continuación, los gradientes se propagan a través del bloque de proyección de datos hasta el tensor de concatenación de representaciones, teniendo en cuenta con precisión la contribución de cada elemento a la predicción global.
   if(!cTimeDScale.CalcHiddenGradients(caTranspose[1].AsObject()))
      return false;
   if(!caTranspose[0].CalcHiddenGradients(cTimeDScale.AsObject()))
      return false;
   if(!cSpatialDScale.CalcHiddenGradients(caTranspose[0].AsObject()))
      return false;
   if(!cConcatenated.CalcHiddenGradients(cSpatialDScale.AsObject()))
      return false;
Se presta especial atención a STFSGrad, la función de envoltura del kernel del mismo nombre, que se encarga de recopilar los errores dentro del módulo STFS procedentes de todas las submuestras y de transmitirlos a los datos originales.
   if(!STFSGrad(NeuronOCL))
      return false;
//---
   return true;
  }
Es precisamente gracias a este mecanismo como el modelo aprende a identificar y distinguir los patrones globales y locales del mercado, dando lugar a un modelo de predicción estable y preciso.
En la práctica, para un trader esto significa que cada elemento del módulo, desde las submuestras hasta los bloques de convolución, recibe retroalimentación sobre su relevancia para la predicción final, lo que mejora la calidad del entrenamiento y permite al modelo gestionar eficazmente la información de mercado ruidosa y cambiante.
El código completo de la clase y de todos sus métodos se incluye en el archivo adjunto.
Arquitectura de modelos
Una vez implementados todos los módulos clave del framework de trabajo, pasamos a la siguiente fase: la descripción de la arquitectura del modelo. Siguiendo el enfoque de los autores de S3CE-Net, utilizamos como base el modelo de codificador del estado del entorno de SEW-ResNeXt, que ha demostrado su eficacia para extraer características significativas de datos en flujo.
Dentro de esta arquitectura, implementamos en tres niveles bloques SSAM, que garantizan una atención selectiva hacia las características más informativas y sus combinaciones. Este enfoque permite a la red centrarse en las señales clave del mercado, minimizando el impacto del ruido y las fluctuaciones aleatorias, lo cual es especialmente importante en el caso de los datos financieros con alta volatilidad.
Para no sobrecargar el texto del artículo y mantener su legibilidad, no incluimos el esquema completo del codificador. Los detalles de la arquitectura están disponibles en el archivo adjunto al artículo, donde se describen pormenorizadamente cada capa y cada bloque. El lector puede consultar por sí mismo las modificaciones puntuales de la arquitectura y la estructura completa.
Cabe destacar que el módulo STFS se utiliza exclusivamente en la fase de entrenamiento. En condiciones reales de funcionamiento, cuando el modelo genera predicciones en tiempo real, no se necesitan submuestras ni proyecciones individuales de los datos, y su generación solo aumenta la carga sobre los recursos. Para aprovechar de forma eficiente la potencia de cálculo, hemos trasladado STFS a un modelo independiente que solo se utiliza para el entrenamiento.
El modelo comienza con la creación de una capa de datos de entrada que se corresponde con las características analizadas y la ventana de observación.
//--- STFS
   stfs.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = (window * count);
   descr.activation = None;
   descr.optimization = ADAM;
   if(!stfs.Add(descr))
     {
      delete descr;
      return false;
     }
El siguiente paso consiste en añadir una capa STFS, en la que se definen los parámetros de los canales y las unidades de entrada y salida. Esta capa desempeña una función clave: crea cinco submuestras de datos y calcula las predicciones para cada una de ellas utilizando la función de activación TANH especificada. Es precisamente esta capa la que permite el aprendizaje paralelo en diferentes proyecciones del mercado, lo que aumenta la robustez del modelo y su capacidad para detectar señales significativas.
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronSTFS;
     {
      uint temp[] = {window,              // Chanels In
                     BarDescr             // Chanels Out
                    };
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
     {
      uint temp[] = {count,               // Units In
                     NForecast            // Units Out
                    };
      if(ArrayCopy(descr.units, temp) < (int)temp.Size())
         return false;
     }
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!stfs.Add(descr))
     {
      delete descr;
      return false;
     }
La configuración concluye con una capa BatchNorm, que normaliza el resultado del bloque STFS, lo que mantiene la estabilidad del entrenamiento y evita un desplazamiento excesivo de los gradientes. En este caso, esta capa cumple otra función importante: aprende la distribución de los datos objetivo y la añade a los valores de predicción generados por el módulo STFS.
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = NForecast*BarDescr;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!stfs.Add(descr))
     {
      delete descr;
      return false;
     }
Separar STFS en un modelo independiente permite separar el entrenamiento de la producción, lo que reduce la carga sobre el sistema en tiempo real y conserva plenamente las ventajas del entrenamiento paralelo con distintas proyecciones del mercado.
En cuanto a la arquitectura de los modelos «Actor» y «Crítico», se ha trasladado íntegramente desde nuestro trabajo anterior. Esto permite conservar soluciones contrastadas a lo largo del tiempo para generar acciones y evaluar su calidad. Y también integrar nuevos componentes sin afectar a la estabilidad del proceso de aprendizaje. El resultado es un modelo completo que combina tanto los enfoques tradicionales de gestión de la estrategia en el mercado como los métodos modernos para identificar características relevantes y realizar previsiones robustas.
Pruebas
Hemos finalizado un trabajo de gran envergadura para integrar todos los componentes clave del framework de trabajo, y ha llegado el momento de evaluar la eficacia de las soluciones implementadas. Pero primero es necesario entrenar y comprobar minuciosamente la estrategia con datos históricos y simulados, como si se tratara de perfeccionar las habilidades de un trader experimentado y de comprobar la capacidad del algoritmo para actuar en las más diversas condiciones de mercado.
Llevaremos a cabo la primera fase —el entrenamiento offline— utilizando datos históricos del par de divisas EURUSD en el marco temporal H1, correspondientes al periodo comprendido entre enero de 2024 y junio de 2025. Este periodo se convirtió en una especie de campo de entrenamiento. El modelo aprendió a reconocer patrones históricos, a comprender la dinámica de los precios y los volúmenes de las operaciones, a identificar patrones entre las características clave y a utilizarlos en sus previsiones. Gracias al módulo STFS, aprendía en paralelo las representaciones global y local de los datos, generando cinco proyecciones diferentes, lo que mejoraba la precisión y la robustez de las previsiones. Se podría decir que el modelo desarrollaba la intuición del trader, combinada con la rigurosidad matemática del análisis de datos.
La siguiente fase —el ajuste fino en línea en el probador de estrategias de MetaTrader 5— permitió que el modelo funcionara con flujos de datos en tiempo real. Allí aprendió a desenvolverse en la dinámica de un mercado en constante evolución, a mantener la estabilidad ante el ruido del mercado, a ajustar sus acciones en situaciones de baja liquidez y a reaccionar al instante ante movimientos bruscos del precio. Los bloques SSAM garantizaban que se prestara especial atención a las características más informativas, incluso cuando los datos eran inestables.
La comprobación final se llevó a cabo con datos correspondientes al periodo de julio a septiembre de 2025, totalmente nuevos y que no se habían utilizado anteriormente. Todos los parámetros obtenidos en las etapas anteriores se cargaron sin modificaciones, lo que garantizó una evaluación imparcial de la capacidad de generalización del modelo. Los resultados confirman que un enfoque gradual del aprendizaje y la adaptación, mediante el uso de STFS y SSAM, permite al modelo analizar el mercado y elaborar previsiones sobre la evolución de las características clave del mercado, en las que el trader puede basarse a la hora de tomar decisiones de negociación reales.

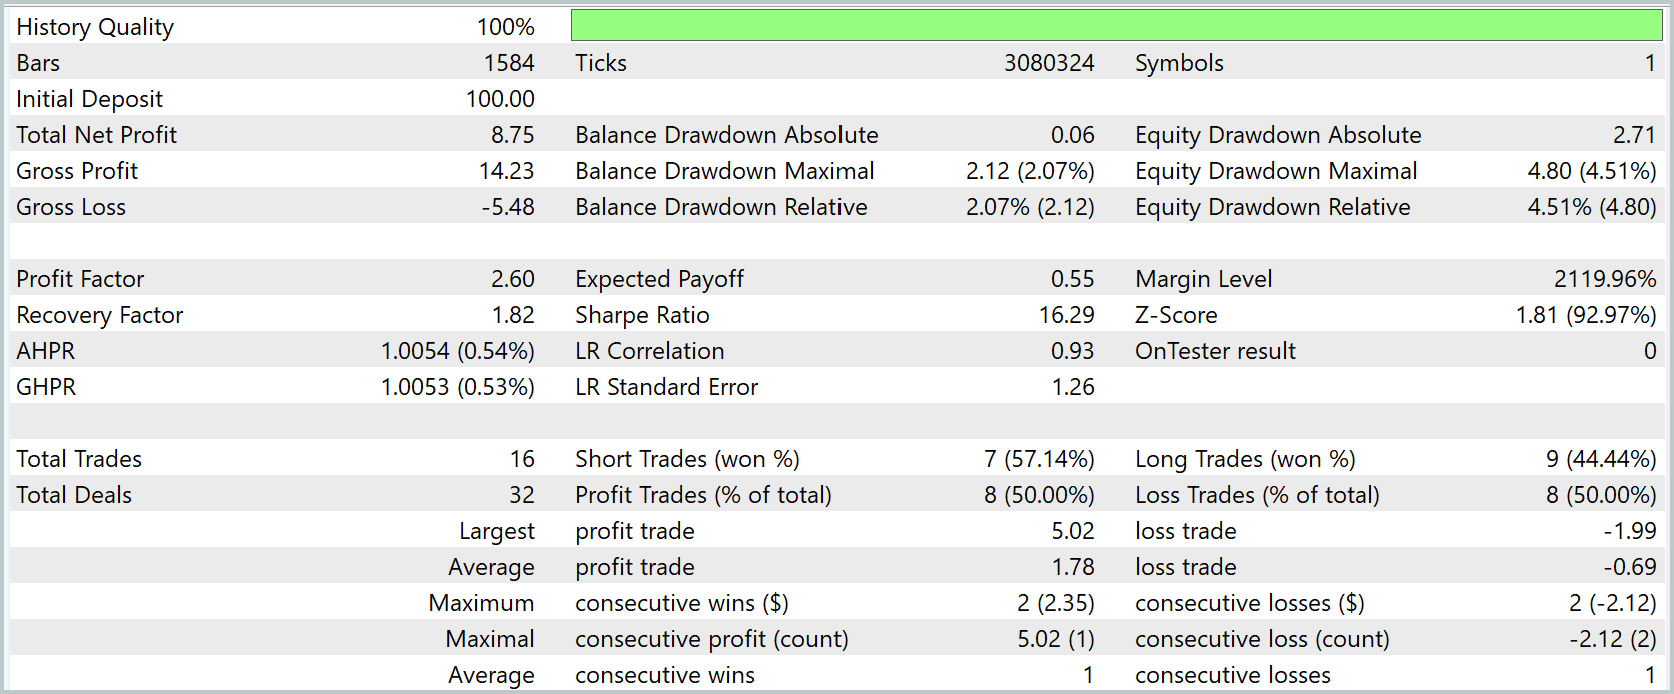
Los resultados de las pruebas del modelo demuestran una gran estabilidad y precisión en las previsiones. El saldo de la cuenta registró un crecimiento sostenido, pasando de un depósito inicial de 100 dólares a 108,75 dólares, mientras que el patrimonio neto siguió de forma gradual la evolución del saldo, lo que demuestra el correcto funcionamiento del mecanismo de distribución de previsiones y de gestión de riesgos.
El drawdown máximo del saldo fue de solo un 2,07 %, y la del patrimonio neto, del 4,51 %, lo que pone de manifiesto el bajo nivel de riesgo y la solidez de la estrategia, incluso ante las fluctuaciones del mercado. El factor de beneficio global es de 2,60, lo que confirma la capacidad del modelo para seleccionar eficazmente las señales rentables.
En cuanto a la distribución de las operaciones, de las 16 realizadas, 8 resultaron rentables, lo que supone un 50 % de operaciones exitosas; la ganancia media de las operaciones rentables fue de 1,78, mientras que la pérdida media se limitó a 0,69, lo que demuestra un buen equilibrio entre rentabilidad y riesgo. La mayor ganancia en una sola operación alcanzó 5,02, mientras que la mayor pérdida se limitó a 1,99, lo que también confirma la prudencia del modelo en la gestión del capital.
El modelo, que combina SSAM y STFS, ha mostrado un crecimiento del capital moderado y controlado, con un drawdown reducido y una buena relación entre beneficio y riesgo. El resultado es prometedor, pero, por el momento, tiene un alcance estadístico limitado. Antes de aplicar la estrategia en operaciones reales, es necesario realizar pruebas más amplias y pruebas de estrés para confirmar la estabilidad de su comportamiento durante periodos de mercado prolongados y adversos.
Conclusión
Ya hemos recorrido todo el camino, desde la idea hasta la herramienta funcional, y lo hemos hecho como si estuviéramos montando un mecanismo de relojería de precisión: con cuidado, paso a paso y prestando atención a los detalles.
Con MQL5, hemos implementado los bloques clave de S3CE-Net:
- hemos incorporado SSAM en el codificador SEW-ResNeXt,
- hemos adaptado STFS al vector de características del mercado,
- hemos preparado un kernel de OpenCL para la generación paralela de cinco representaciones.
La principal idea de ingeniería es la separación de modos. STFS funciona de manera eficaz, pero su lugar está en la fase de entrenamiento. En la producción dejamos únicamente la representación global. Esto ahorra recursos y mantiene la previsibilidad del comportamiento. Un matiz práctico que es importante tener en cuenta: la ausencia de activación dentro del módulo no es un capricho, sino un requisito para la correcta formación de los tensores objetivo y la propagación de los gradientes entre las proyecciones.
Las pruebas realizadas en el gráfico H1 del EUR/USD para el periodo comprendido entre julio y septiembre de 2025 han arrojado resultados prometedores. El modelo funciona de forma conservadora. Todo esto constituye una buena base, pero no es una sentencia definitiva para la estrategia.
Lo que debe tener claro el trader es que las métricas actuales invitan al optimismo, pero la muestra es pequeña. Los resultados elevados en una muestra pequeña pueden ser engañosos. Nuestra tarea a partir de ahora no es celebrar la victoria, sino comprobar su solidez.
Enlaces
- S3CE-Net: Spike-guided Spatiotemporal Semantic Coupling and Expansion Network for Long Sequence Event Re-Identification
- Otros artículos de la serie
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | Study.mq5 | Asesor experto | Asesor experto para el entrenamiento offline de modelos |
| 2 | StudyOnline.mq5 | Asesor experto | Asesor experto para el entrenamiento en línea de modelos |
| 3 | Test.mq5 | Asesor experto | Asesor experto para probar el modelo |
| 4 | Trajectory.mqh | Biblioteca de clases | Estructura para describir el estado del sistema y la arquitectura de los modelos |
| 5 | NeuroNet.mqh | Biblioteca de clases | Biblioteca de clases para crear una red neuronal |
| 6 | NeuroNet.cl | Biblioteca | Biblioteca de código del programa OpenCL |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19974
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.