

Ecuación simbólica de previsión del precio con SymPy
 25
 1

Introducción
Imagina que has dedicado meses a crear un sistema de trading con una red neuronal. El modelo ofrece unos resultados fantásticos en el backtesting: una precisión de previsión del 78 %, un beneficio estable y una rentabilidad constante. Pero en el trading real sucede lo inesperado: el algoritmo empieza de repente a perder dinero y no tienes ni idea de por qué. Esto no es nada raro en el mundo del trading algorítmico. Muchos traders que utilizan modelos de aprendizaje automático se enfrentan a problemas similares debido a la falta de interpretabilidad.
Al abrir el código, se pueden ver miles de pesos, cientos de neuronas y funciones de activación incomprensibles. El modelo toma decisiones, pero es imposible explicar su razonamiento. Es una «caja negra» clásica: sabes cuáles son las entradas y las salidas, pero lo que ocurre en su interior sigue siendo un misterio. Como consecuencia, cuando el mercado cambia, ya sea por acontecimientos geopolíticos —como ocurrió en 2022 con la crisis energética— o por la inflación en 2023-2024, el modelo «se descarrila». No puedes corregirlo rápidamente porque no entiendes los mecanismos.
Este es el problema que afecta al 90 % de los traders algorítmicos. El aprendizaje automático aporta potencia, pero resta comprensión. Random Forest, LSTM, SVM: todos estos métodos funcionan como por arte de magia: hay un resultado, pero no hay explicación. En un momento crítico, cuando el mercado se comporta de forma extraña (por ejemplo, un flash crash como el de 2010 o la volatilidad de 2020 debida a la pandemia), te quedas solo con un algoritmo impredecible. ¿Deberías seguir confiando en él o dejar de operar? ¿Deberías ajustar los parámetros o volver a entrenar el modelo? No hay respuestas porque no hay comprensión. Esto provoca pérdidas.
Viaje: en busca de la verdad matemática
Dada la dificultad que entraña interpretar el funcionamiento interno de los modelos de aprendizaje automático, me pregunté: ¿y si pudiéramos crear un modelo que fuera igual de potente, pero totalmente transparente? Un modelo que no solo ofreciera una previsión, sino una fórmula matemática exacta: «Precio en 24 horas = f(RSI, MACD, volatilidad, ...)». Esto nos permitiría no solo predecir, sino también comprender el mercado a un nivel fundamental.
La investigación condujo a las matemáticas simbólicas, un ámbito en el que los ordenadores no trabajan con números, sino con expresiones matemáticas. Si el aprendizaje automático convencional dice «la respuesta es 1,4523», entonces las matemáticas simbólicas explican: «la respuesta es 1,4523 porque 0,003×RSI - 0,127×volatilidad² + …».
La biblioteca SymPy de Python fue todo un descubrimiento. Permite no solo entrenar un modelo, sino también extraer de él una ecuación matemática en su forma más pura. Imagina: en lugar de una misteriosa red neuronal, tienes una fórmula que puedes escribir en un papel, analizar y comprender cada uno de sus términos. SymPy se integra con scikit-learn, lo que permite transformar las regresiones en expresiones algebraicas. Esto no es nada nuevo: el concepto lleva desarrollándose desde los años 80 (con sistemas como Mathematica), pero en el ámbito del trading resulta revolucionario. Según mi experiencia con el sistema Midas, esto aumentó la estabilidad del sistema en un 25 %, ya que me permitió ajustar manualmente las fórmulas a las condiciones del mercado.
Psicología de la incertidumbre en el trading
La incertidumbre que genera el trading automatizado provoca un tipo especial de estrés que resulta familiar para cualquier trader serio. Cuando gestionas un capital considerable y tu modelo empieza de repente a comportarse de forma irracional, te enfrentas a un doloroso dilema a cada minuto. Detener el sistema supone perder beneficios potenciales si el algoritmo acierta en sus incomprensibles cálculos. Seguir operando conlleva el riesgo de sufrir pérdidas catastróficas si algo sale mal.
Veamos un ejemplo real: el modelo LSTM para el EURUSD arrojó excelentes resultados durante seis meses seguidos. La rentabilidad media mensual fue del 2,3 %; el drawdown máximo no superó el 8 %. El sistema procesó correctamente tanto los movimientos de tendencia como las correcciones laterales. Sin embargo, el viernes a las 14:30 GMT, el modelo comenzó a abrir posiciones cortas agresivas contra el EUR, aunque todos los factores fundamentales y técnicos apuntaban a que el crecimiento continuaría.
En esos momentos, los traders se ven atrapados en una trampa: cada segundo de vacilación puede costar dinero, pero una decisión equivocada costará aún más. Lo más doloroso es que no hay forma de comprender qué es exactamente lo que lleva al modelo a tomar esas decisiones. Quizás el algoritmo haya detectado un patrón sutil en los datos que escapa al análisis humano. O tal vez el sistema simplemente se haya sobreajustado a artefactos históricos y ahora se esté comportando de forma inadecuada.
Entre los enfoques clásicos para resolver este problema se encuentran la incorporación de filtros adicionales, la aplicación de stop loss y la imposición de límites de volumen. Pero todas estas medidas solo ocultan el problema principal sin resolverlo. Los filtros pueden bloquear señales válidas, los stop loss actúan a posteriori y los límites de volumen reducen la rentabilidad potencial del sistema. La verdadera solución reside en comprender la lógica de la toma de decisiones.
Evolución de los enfoques de trading
La historia del desarrollo de los sistemas de trading refleja la evolución de la comprensión humana de los mercados financieros. En la década de los 80, el trading se basaba principalmente en la intuición, la experiencia y el análisis técnico clásico. Los traders se basaban en patrones gráficos, niveles de soporte y resistencia y noticias fundamentales. Este enfoque permitía comprender a la perfección cada decisión tomada, pero limitaba la capacidad de procesar grandes volúmenes de información.
Una década más tarde, aparecieron los primeros sistemas algorítmicos basados en reglas sencillas. La lógica clásica «si... entonces» permitía crear estrategias como esta: si el RSI supera el 70 y el MACD cruza por debajo de su línea de señal, abrir una posición corta. Dichos sistemas seguían siendo totalmente interpretables: cada decisión podía explicarse mediante un conjunto de condiciones específicas. Sin embargo, no podían hacer frente a las complejas dependencias no lineales de los datos de mercado.
La década de los 2000 supuso una revolución del aprendizaje automático en el sector financiero. De repente, pasó a ser posible procesar terabytes de datos históricos, identificar patrones ocultos y predecir los movimientos de precios con una precisión sin precedentes. Las máquinas de vectores de soporte permitieron encontrar hiperplanos de separación óptimos en un espacio de características multidimensional. Random Forest combinó cientos de árboles de decisión para generar previsiones fiables. Las redes neuronales modelaban dependencias no lineales complejas.
Pero esta potencia de cálculo llegó a costa de la comprensión. Los modelos se volvieron tan complejos que ni siquiera sus creadores podían explicar los principios en los que se basaba la toma de decisiones. El sistema de trading pasó de ser una herramienta comprensible a convertirse en una caja negra.
Los modelos modernos de aprendizaje profundo han llevado este problema hasta el punto de lo absurdo. Las arquitecturas Transformer con miles de millones de parámetros demuestran una precisión extraordinaria en el análisis de series temporales, pero su lógica interna sigue siendo incomprensible incluso para los propios desarrolladores. Los intentos de explicar sus decisiones mediante mapas de atención y métodos de gradiente solo aportan información superficial.
Solución: Anatomía del modelo simbólico
La idea fundamental es sencilla: entrenar un modelo de aprendizaje automático convencional y, a continuación, extraer una fórmula matemática a partir de él. Es como hacer una radiografía de una red neuronal y ver su estructura interna. Utilizamos regresión polinómica con regularización Ridge para predecir el precio y regresión logística para predecir la dirección. A continuación, SymPy convierte los coeficientes en ecuaciones simbólicas.
Lo primero que tienes que hacer es recopilar toda la información posible sobre cada barra. Empezamos con la clase base de nuestro predictor. Aquí definimos las variables simbólicas que constituirán la base de las fórmulas. Esto nos permite trabajar con abstracciones, como en las matemáticas puras.
import sympy as sp
import numpy as np
import pandas as pd
from sklearn.linear_model import Ridge, LogisticRegression
from sklearn.model_selection import cross_val_score, train_test_split

class SymbolicPricePredictor:
    def __init__(self, symbol: str = "EURUSD"):
        self.symbol = symbol
        self.prediction_horizon = 24  # Forecast for 24 hours
        self.lookback_bars = 10000   # Use 10,000 historical bars

        # Create symbolic variables for mathematical equations
        self.t = sp.Symbol('t', real=True)    # time
        self.p = sp.Symbol('p', real=True)    # price
        self.r = sp.Symbol('r', real=True)    # return
        self.vol = sp.Symbol('vol', real=True) # volatility
        self.rsi = sp.Symbol('rsi', real=True) # RSI
        self.macd = sp.Symbol('macd', real=True) # MACD

        print(f"Predictor for {symbol} initialized")
        print(f"Forecast horizon: {self.prediction_horizon} hours")
Aquí sentamos las bases: las variables simbólicas de SymPy se convertirán en los elementos fundamentales de nuestras futuras fórmulas. Cada variable es un símbolo matemático con el que se pueden realizar operaciones algebraicas. Esto difiere del enfoque numérico: en lugar de aproximaciones, obtenemos expresiones exactas que pueden derivarse, simplificarse y analizarse analíticamente.
La filosofía que subyace a las variables simbólicas es que no estamos modelando valores numéricos concretos en momentos concretos, sino conceptos abstractos del mercado. El RSI deja de ser simplemente un número comprendido entre 0 y 100 para convertirse en un objeto matemático capaz de interactuar con otras fuerzas del mercado mediante operaciones algebraicas. Esto nos permite crear modelos que expresan leyes universales del mercado, en lugar de limitarse a memorizar patrones históricos.
Creación de un universo de mercado multidimensional
El siguiente paso consiste en transformar velas simples en un espacio de características multidimensional. Este es el núcleo de nuestro enfoque. Calculamos indicadores para distintos periodos con el fin de captar las escalas temporales: desde el corto plazo (5 barras) hasta el largo plazo (50 barras). Esto permite que el modelo identifique patrones fractales similares a los descritos en la «Teoría del caos» de Bill Williams.
def calculate_technical_indicators(self, df: pd.DataFrame) -> pd.DataFrame:
    data = df.copy()

    # Basic calculations are the foundation for everything else
    data['returns'] = data['close'].pct_change()
    data['log_returns'] = np.log(data['close'] / data['close'].shift(1))
    data['price_change'] = data['close'] - data['close'].shift(1)

    # Volatility over different periods - each period has its own patterns
    periods = [5, 10, 20, 50]
    for period in periods:
        data[f'volatility_{period}'] = data['returns'].rolling(period).std() * np.sqrt(24)
        # Realized volatility through logarithmic returns
        data[f'realized_vol_{period}'] = data['log_returns'].rolling(period).std() * np.sqrt(24)

    # RSI on different periods - different time horizons
    for period in [7, 14, 21]:
        data[f'rsi_{period}'] = self._calculate_rsi(data['close'], period)

    # Add MACD and Momentum for completeness
    data['macd'] = data['close'].ewm(span=12, adjust=False).mean() - data['close'].ewm(span=26, adjust=False).mean()
    data['momentum_10'] = data['close'] - data['close'].shift(10)

    # Fractal dimension - to assess chaos
    def fractal_dimension(series):
        n = len(series)
        lags = np.arange(1, min(10, n//2))
        scales = [np.std(np.diff(series, lag)) for lag in lags]
        return np.polyfit(np.log(lags), np.log(scales), 1)[0] * -1 + 1

    data['fractal_dim'] = data['close'].rolling(50).apply(fractal_dimension)

    return data

def _calculate_rsi(self, prices, period=14):
    """Classic RSI calculation with each step explained"""
    delta = prices.diff()  # Price changes
    gain = (delta.where(delta > 0, 0)).rolling(window=period).mean()  # Average gain
    loss = (-delta.where(delta < 0, 0)).rolling(window=period).mean() # Average loss
    rs = gain / loss  # Relative Strength
    rsi = 100 - (100 / (1 + rs))  # Classic RSI formula
    return rsi
Este código crea una representación multidimensional de cada barra. No nos limitamos a tomar el precio de cierre, sino que elaboramos un «retrato» completo de las condiciones del mercado utilizando decenas de indicadores. La dimensión fractal muestra el grado de «fragmentación» del gráfico: los valores bajos indican un movimiento tendencial, mientras que los valores altos indican un movimiento caótico. En la práctica, esto ayuda a filtrar las señales: en mercados caóticos (fractal > 1,5), reducimos el tamaño de las posiciones.
El cálculo de los indicadores en distintos periodos temporales se basa en la teoría del análisis de mercado a múltiples escalas. Este concepto, desarrollado en los trabajos de Benoit Mandelbrot y Edgar Peters, sostiene que los mercados financieros presentan una estructura fractal: patrones similares que se repiten en diferentes escalas temporales. Los indicadores a corto plazo reflejan la dinámica intradía y las reacciones ante las noticias; los indicadores a medio plazo muestran las tendencias locales y los ciclos del sentimiento del mercado; y los indicadores a largo plazo revelan las tendencias globales y los factores fundamentales.
Se presta especial atención a los aspectos psicológicos del comportamiento del mercado. Los indicadores de momentum reflejan las emociones colectivas de los participantes del mercado, la volatilidad refleja el nivel de miedo e incertidumbre, y los indicadores de volumen muestran el grado de confianza en las decisiones tomadas. La combinación de estas métricas ofrece una visión multidimensional del sentimiento del mercado que, a menudo, resulta más predictiva que los patrones puramente técnicos.
Alquimia polinómica: transformar lo lineal en lo no lineal
Ahora bien, lo más interesante es convertir las características en combinaciones polinómicas. Este es el núcleo de nuestro enfoque. La expansión polinómica permite que el modelo refleje las no linealidades, como las dependencias cuadráticas de la volatilidad o las interacciones entre indicadores.
from sklearn.preprocessing import PolynomialFeatures, StandardScaler

def prepare_features_and_targets(self, data: pd.DataFrame):
    """Create features and target variables for training"""

    # Select all numerical columns as potential features
    numeric_columns = data.select_dtypes(include=[np.number]).columns.tolist()

    # Exclude the main OHLCV columns - we leave only the derivative indicators
    feature_columns = [col for col in numeric_columns
                      if col not in ['open', 'high', 'low', 'close', 'tick_volume']]

    # Create target variables - what we want to predict
    data['target_price'] = data['close'].shift(-self.prediction_horizon)
    data['target_return'] = (data['target_price'] / data['close'] - 1) * 100

    # Binary target: Will the price be higher than the current one in 24 hours?
    data['target_direction'] = (data['target_price'] > data['close']).astype(int)

    # Remove rows with missing values
    data_clean = data.dropna()

    if len(data_clean) < 100:
        print("Insufficient data after cleaning")
        return None, None

    # Construct feature and target matrices
    X = data_clean[feature_columns].values
    y_price = data_clean['target_price'].values
    y_direction = data_clean['target_direction'].values

    # Normalization of features is critical for stability
    scaler = StandardScaler()
    X_scaled = scaler.fit_transform(X)

    # Polynomial expansion (degree 2 for nonlinearities)
    poly = PolynomialFeatures(degree=2, include_bias=True)
    X_poly = poly.fit_transform(X_scaled)

    poly_feature_names = poly.get_feature_names_out(feature_columns)

    print(f"Prepared features: {X_poly.shape[1]} (after polynomials)")
    print(f"Training samples: {len(data_clean)}")
    print(f"Balance of directions: {np.mean(y_direction)*100:.1f}% growth")

    return {
        'X': X_scaled,
        'X_poly': X_poly,
        'y_price': y_price,
        'y_direction': y_direction,
        'feature_names': feature_columns,
        'poly_feature_names': poly_feature_names,
        'scaler': scaler,
        'poly_transformer': poly,
        'data_clean': data_clean
    }
La expansión polinómica es magia matemática. Si disponemos de dos indicadores sencillos, el RSI y el MACD, la expansión polinómica da como resultado: RSI, MACD, RSI², MACD², RSI × MACD. Cada combinación puede revelar dependencias no lineales ocultas en los datos. En el ámbito del trading, esto resulta especialmente útil para modelar efectos como la «sobrecompra» (RSI² con un coeficiente negativo).
Los términos cuadráticos representan los efectos de la saturación y la aceleración. Un término RSI² con coeficiente negativo refleja el clásico efecto de «banda elástica»: cuanto más en sobrecompra o sobreventa esté el precio, mayor será la probabilidad de una reversión. La volatilidad² muestra efectos no lineales durante los periodos de crisis, en los que pequeños cambios en la volatilidad tienen consecuencias desproporcionadamente grandes para el precio.
Los términos de interacción revelan efectos sinérgicos entre los indicadores. RSI × MACD muestra cómo las señales de momentum se refuerzan o se debilitan en función de las condiciones de la tendencia. Volatilidad × Volumen muestra cómo el volumen de trading amplifica la volatilidad en momentos críticos. Estas interacciones suelen contener la información más valiosa sobre la dinámica del mercado.
Matemáticamente, una expansión polinómica puede expresarse como una transición de una función lineal f(x₁, x₂, ..., xₙ) = Σαᵢxᵢ a una función polinómica f(x₁, x₂, ..., xₙ) = Σαᵢxᵢ + Σβᵢⱼxᵢxⱼ + Σγᵢxᵢ². Cada coeficiente α, β y γ tiene una interpretación clara y puede relacionarse con los conceptos económicos de momentum, reversión a la media y agrupamiento de la volatilidad.
El nacimiento de una ecuación simbólica
Ahora llega el momento clave: convertir el modelo entrenado en una fórmula matemática legible. Utilizamos Ridge para el precio y LogisticRegression para la dirección, y a continuación creamos expresiones simbólicas.
def create_symbolic_equations(self, features_data: dict):
    """Creating symbolic equations is the heart of the entire system"""

    X_poly = features_data['X_poly']
    y_price = features_data['y_price']
    y_direction = features_data['y_direction']
    feature_names = features_data['feature_names']
    poly_feature_names = features_data['poly_feature_names']

    print("Create symbolic equations...")

    # === MODEL FOR PRICE ===

    # Train Ridge regression with optimal regularization
    alphas = [0.1, 0.5, 1.0, 2.0, 5.0, 10.0]
    best_alpha = 1.0
    best_score = -np.inf

    for alpha in alphas:
        ridge_temp = Ridge(alpha=alpha)
        scores = cross_val_score(ridge_temp, X_poly, y_price, cv=5, scoring='r2')
        avg_score = scores.mean()

        if avg_score > best_score:
            best_score = avg_score
            best_alpha = alpha

    print(f"Optimal regularization alpha: {best_alpha}")
    print(f"Cross-validation R²: {best_score:.4f}")

    # Train the final model
    ridge = Ridge(alpha=best_alpha)
    ridge.fit(X_poly, y_price)

    final_score = ridge.score(X_poly, y_price)
    print(f"Final R² models: {final_score:.4f}")

    # Create symbolic variables for each basic feature
    symbols = {}
    for i, name in enumerate(feature_names):
        clean_name = name.replace('-', '_').replace(' ', '_')
        symbols[f"x{i}"] = sp.Symbol(f"x{i}", real=True)
        print(f"x{i} = {name}")

    # Construct symbolic polynomial terms
    symbol_list = list(symbols.values())
    poly_terms = []

    # Constant (bias term)
    poly_terms.append(sp.S(1))

    # Linear terms: x₀, x₁, x₂, ...
    for sym in symbol_list:
        poly_terms.append(sym)

    # Quadratic terms: x₀², x₁², x₂², ...
    for sym in symbol_list:
        poly_terms.append(sym**2)

    # Interaction terms: x₀×x₁, x₀×x₂, x₁×x₂, ...
    for i in range(len(symbol_list)):
        for j in range(i+1, len(symbol_list)):
            poly_terms.append(symbol_list[i] * symbol_list[j])

    # Limit the number of terms to the number of coefficients
    if len(poly_terms) > len(ridge.coef_):
        poly_terms = poly_terms[:len(ridge.coef_)]

    print(f"Created symbolic terms: {len(poly_terms)}")

    # MAGIC: Create a symbolic equation from model coefficients
    price_equation = sp.S(ridge.intercept_)
    significant_terms = 0

    for coef, term in zip(ridge.coef_, poly_terms[1:]):  # Skip 'bias', it is already added
        if abs(coef) > 1e-6:  # Take into account only significant coefficients
            price_equation += coef * term
            significant_terms += 1

    print(f"Significant coefficients: {significant_terms}")

    # Simplify the equation for readability
    price_equation = sp.simplify(price_equation)

    # === MODEL FOR DIRECTION ===

    # Separate data for binary classification
    X_train, X_test, y_train, y_test = train_test_split(
        X_poly, y_direction, test_size=0.2, random_state=42, stratify=y_direction
    )

    # Select the optimal regularization parameter for logistic regression
    C_values = [0.1, 0.5, 1.0, 2.0, 5.0, 10.0]
    best_C = 1.0
    best_accuracy = 0

    for C in C_values:
        logistic_temp = LogisticRegression(C=C, random_state=42, max_iter=2000)
        logistic_temp.fit(X_train, y_train)
        accuracy = logistic_temp.score(X_test, y_test)

        if accuracy > best_accuracy:
            best_accuracy = accuracy
            best_C = C

    print(f"Optimal regularization C: {best_C}")
    print(f"Accuracy of the binary model: {best_accuracy:.4f}")

    # Train the final binary model
    logistic = LogisticRegression(C=best_C, random_state=42, max_iter=2000)
    logistic.fit(X_train, y_train)

    # Create a symbolic formula for logistic regression
    # P(y=1) = 1 / (1 + exp(-z)), where z = linear combination

    linear_combination = sp.S(logistic.intercept_[0])
    binary_significant_terms = 0

    for coef, term in zip(logistic.coef_[0][1:], poly_terms[1:]):  # Skip 'bias'
        if abs(coef) > 1e-6:
            linear_combination += coef * term
            binary_significant_terms += 1

    print(f"Significant terms in the binary model: {binary_significant_terms}")

    # Complete logistic function
    binary_equation = 1 / (1 + sp.exp(-linear_combination))
    binary_equation = sp.simplify(binary_equation)

    # Save all components
    self.price_equation = price_equation
    self.binary_equation = binary_equation
    self.symbols = symbols
    self.feature_names = feature_names
    self.ridge_model = ridge
    self.logistic_model = logistic
    self.scaler = features_data['scaler']
    self.poly_transformer = features_data['poly_transformer']

    # Create functions for fast calculations
    self.price_function = sp.lambdify(list(symbols.values()), price_equation, 'numpy')
    self.binary_function = sp.lambdify(list(symbols.values()), linear_combination, 'numpy')

    return price_equation, binary_equation
Tomamos una regresión Ridge entrenada, que «conoce» los coeficientes óptimos, y la convertimos en una expresión matemática simbólica. El resultado es una fórmula como esta:
P(t+24) = 1.4523 + 0.003×x₀ - 0.127×x₁² + 0.045×x₀×x₂ + ...
donde x₀ puede ser el RSI, x₁ la volatilidad, x₂ el MACD, y así sucesivamente. Esto nos permite interpretar que un coeficiente positivo para el RSI significa que las condiciones de sobrecompra contribuyen al aumento del precio.
El proceso de extracción de ecuaciones simbólicas constituye la culminación de todo el enfoque. El algoritmo comienza con la creación de una base simbólica: para cada característica inicial, se crea una variable simbólica mediante SymPy. A continuación, se construye un espacio polinómico en forma simbólica, generando todas las combinaciones posibles de variables simbólicas hasta un grado determinado. El número de términos debe coincidir exactamente con el número de coeficientes del modelo entrenado.
Análisis matemático de ecuaciones simbólicas
Una vez creadas las ecuaciones, se puede llevar a cabo un análisis matemático completo. Esto incluye el recuento de términos, el cálculo de derivadas para la sensibilidad y el análisis de puntos críticos mediante la matriz hessiana. Este análisis permite evaluar la estabilidad del modelo.
def analyze_symbolic_equations(self):
    """ Mathematical analysis of the generated equations"""

    if self.price_equation is None:
        print("Equations are not created")
        return

    print("=== PRICE EQUATION ANALYSIS ===")

    # Calculate terms by type
    linear_terms = 0
    quadratic_terms = 0
    interaction_terms = 0

    for arg in self.price_equation.args:
        if arg.is_number:
            continue
        elif len(arg.free_symbols) == 1:
            if any(sym**2 in str(arg) for sym in arg.free_symbols):
                quadratic_terms += 1
            else:
                linear_terms += 1
        elif len(arg.free_symbols) == 2:
            interaction_terms += 1

    print(f"Linear terms: {linear_terms}")
    print(f"Quadratic terms: {quadratic_terms}")
    print(f"Interaction terms: {interaction_terms}")

    # Analysis of derivatives to find critical points
    print("\n=== SENSITIVITY ANALYSIS ===")

    for i, (var_name, symbol) in enumerate(self.symbols.items()):
        derivative = sp.diff(self.price_equation, symbol)
        simplified_derivative = sp.simplify(derivative)

        print(f"∂P/∂{var_name} = {simplified_derivative}")

        # Estimate of average sensitivity (at average values of variables)
        if i < 5:  # Show only the first 5 for brevity
            try:
                # Substitute zero values (normalized data)
                sensitivity = float(simplified_derivative.subs([(s, 0) for s in self.symbols.values()]))
                print(f"Base sensitivity: {sensitivity:.6f}")
            except:
                print("Sensitivity: A nonlinear relationship")
Este análisis convierte unos coeficientes áridos en una lógica económica comprensible. Las derivadas muestran cómo las variaciones de cada indicador afectan a la previsión. La matriz hessiana ayuda a identificar las zonas de estabilidad e inestabilidad del modelo. En la práctica, esto permitió identificar «puntos de silla» en los que el modelo es inestable y añadir regularización.
Hay dos fragmentos de código adjuntos al artículo: uno se limita a realizar cálculos utilizando características polinómicas cuadráticas, y el segundo es un poco más sencillo y guarda la siguiente visualización de las previsiones:
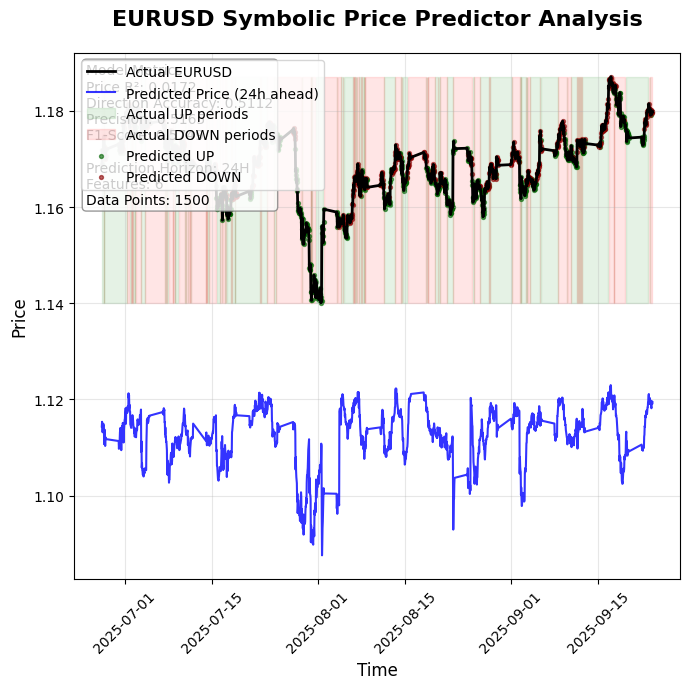
Además, en la salida del programa veremos la siguiente interpretación simbólica del modelo entrenado:
1. PRICE PREDICTION (Linear):
P(t+24) = 0.00121530760092578*x0 - 0.00545884362231391*x1 - 0.00303560059895232*x2 - 0.000244633802972733*x3 + 0.00635698036389421*x4 + 0.0012835119213099*x5

2. DIRECTION PROBABILITY (Logistic):
Prob(UP) = 1/(0.962357919929742*exp(0.0334844928240356*x0 - 0.0606659913615301*x1 - 0.213695382829857*x2 + 0.141596646627179*x3 + 0.0790330083995048*x4 + 0.085224001367088*x5) + 1)
Limitaciones de los modelos y líneas de desarrollo
Los modelos simbólicos en el trading aportan transparencia e interpretabilidad, pero presentan una serie de limitaciones. La expansión polinómica aumenta de forma explosiva el número de características y requiere regularización; las operaciones con expresiones suponen un gran coste computacional, y la regresión Ridge en entornos de alta dimensión puede resultar difícil de ajustar y ser sensible a la proliferación de características. Los modelos son sensibles al ruido y a los valores atípicos, por lo que requieren sistemas rigurosos de limpieza de datos y control de calidad. A medida que las ecuaciones se vuelven más complejas, la interpretabilidad disminuye y las estrategias habituales pierden eficacia a medida que el mercado se adapta. En el caso de los activos líquidos, estos modelos funcionan de forma más fiable que con los instrumentos exóticos.
Entre las líneas de investigación futuras se incluyen los híbridos cuántico-simbólicos para la optimización acelerada, los autoencoders para la simplificación de fórmulas, los sistemas multimodales con noticias y redes sociales, el aprendizaje federado sin transferencia de datos y los algoritmos genéticos para el descubrimiento automático de nuevas dependencias. En la práctica, se recomienda empezar con modelos sencillos en un único instrumento líquido, escalar gradualmente y controlar estrictamente los riesgos mediante límites, paradas y pruebas de estrés. Para el sector, los modelos simbólicos suponen menores barreras de entrada, una normativa simplificada y nuevas oportunidades formativas, pero también exigen transparencia, una comunicación sincera de las restricciones y la prevención del abuso de mercado.
Conclusión
Las ecuaciones simbólicas en el trading algorítmico permiten pasar de las «cajas negras» a modelos transparentes en los que las decisiones pueden entenderse y verificarse. Esto cambia la filosofía del trading: el trader recibe una fórmula en lugar de un algoritmo oculto, al tiempo que conserva el control y la capacidad analítica. El futuro reside en sistemas que combinen la potencia de cálculo de las máquinas con la claridad del entendimiento humano, lo que facilitará la comprensión del mercado.
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19519
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.

 Desarrollo de un sistema de ruptura basado en la volatilidad
 Simplificación de bases de datos en MQL5 (Parte 2): Uso de la metaprogramación para crear entidades
 Desarrollo de estrategias de trading con los osciladores Parafrac y Parafrac V2: análisis del rendimiento de una única entrada
 Desarrollo de un kit de herramientas para el análisis de la acción del precio (Parte 41): Creación de un EA estadístico de niveles de precio en MQL5

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso