Redes neuronales en el trading: Entrenamiento de modelos de picos profundos (Final)
 17
 0

Introducción
El mercado financiero, al igual que cualquier sistema complejo no lineal, se rige por sus propias leyes. Respira, oscila, acumula energía y la libera en forma de movimientos bruscos de los precios. Y cuanto más detenidamente estudiamos su dinámica, más claro nos queda que los métodos clásicos de análisis ya no siempre logran seguir el ritmo de la variabilidad de los escenarios de trading actuales. Los sustituye una nueva generación de algoritmos: más sensibles, adaptables y capaces de ver, más allá de la superficie del gráfico, el impulso interno del mercado.
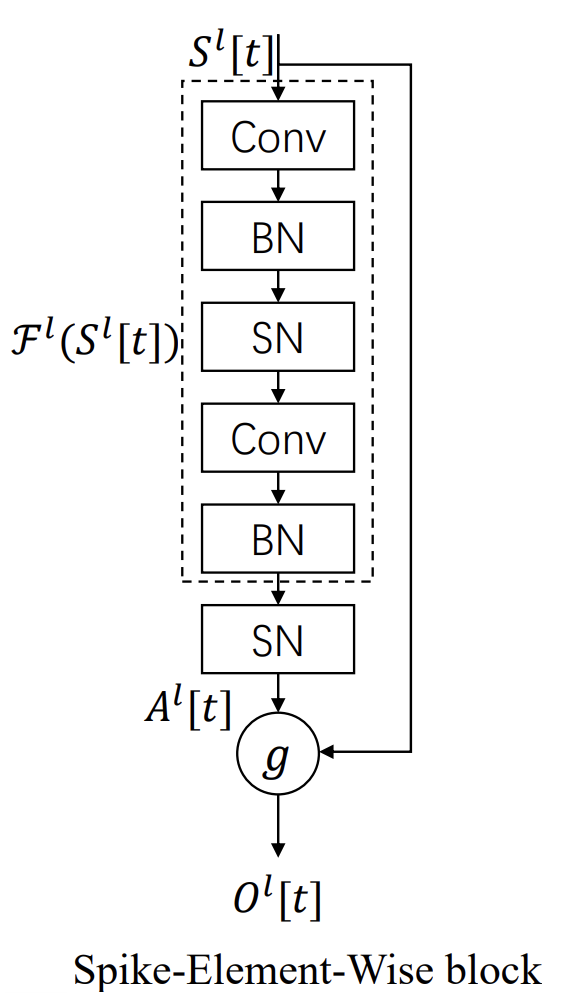
En trabajos anteriores hemos recorrido el camino desde los principios básicos de la computación por picos hasta la implementación de soluciones arquitectónicas clave que allanan el camino hacia el uso práctico de dichos modelos en el entorno MQL5. Y hoy llegamos a la etapa final de este recorrido: la aplicación de los enfoques propuestos por los autores del framework SEW ResNet (Spiking Elementary Weights Residual Network) al análisis y la predicción de series temporales financieras.
La aparición de SEW ResNet se debe al deseo de combinar la eficiencia computacional de los modelos de picos con la estabilidad y la profundidad de las arquitecturas ResNet clásicas. Este enfoque se basa en la idea de un aprendizaje energéticamente equilibrado, en el que la información se transmite mediante una serie de impulsos discretos. Cada pico tiene un significado asociado a su peso; cada retraso refleja la reacción del sistema ante la señal. Como resultado, el modelo no solo resulta más eficiente desde el punto de vista computacional, sino que también capta con mayor precisión las relaciones de causa y efecto entre los acontecimientos a lo largo del tiempo, lo cual resulta especialmente importante para el análisis de los impulsos de precios y los picos de actividad en los mercados.
En el contexto de los mercados financieros, esto abre nuevas oportunidades. Y es que, por su propia naturaleza, la señal del mercado se manifiesta en forma de picos. Es irregular, presenta periodos de silencio y ráfagas de actividad, en los que un instante separa el caos de la regularidad. Las redes neuronales clásicas, en estas condiciones, suelen atascarse con el ruido o perder sensibilidad ante fluctuaciones prolongadas. SEW ResNet, por el contrario, está diseñado para mantener la capacidad de respuesta: reacciona únicamente ante cambios realmente significativos en el flujo de datos, filtrando todo lo superfluo de forma natural.
En las fases anteriores fuimos sentando, paso a paso, las bases de la futura arquitectura. Cada módulo implementado se convirtió en un ladrillo más de los cimientos del framework de trabajo, en el que la rigurosidad técnica se combinaba con la lógica intuitiva de los procesos de mercado.
El módulo de activación por picos con umbrales adaptativos fue el primer elemento clave de este sistema. Su función consiste en controlar la respuesta de la neurona ante el flujo de señales entrantes, distinguiendo las oscilaciones importantes del ruido natural. En los modelos clásicos de picos, la activación es fija y suele reaccionar de la misma forma ante cualquier cambio. Nosotros, por nuestra parte, hemos optado por el enfoque del prototipo biológico: el umbral adaptativo varía en función de la intensidad de los impulsos de entrada y de la frecuencia de los picos. Como resultado, la red aprende a reaccionar solo cuando es realmente necesario, evitando el sobreajuste debido a fluctuaciones aleatorias de los precios.
Esto tiene una importancia práctica directa para el mercado. Este mecanismo permite que el algoritmo funcione de forma estable en condiciones de alta volatilidad, en las que los modelos clásicos suelen perder precisión. Cuando reina el caos en el gráfico, el umbral adaptativo actúa como un filtro integrado del ruido del mercado, lo que ayuda al sistema a mantener la claridad de percepción y a reaccionar únicamente ante los cambios clave de la tendencia.
El siguiente paso fue la implementación de un mecanismo de compuerta, encargado de regular la sensibilidad de la neurona ante la novedad de la señal entrante. En esencia, la compuerta determina en qué medida la señal actual debe influir en la acumulación del potencial de membrana. En otras palabras, regula el grado de participación del nuevo impulso en la formación del estado interno de la neurona. Esto confiere al sistema una flexibilidad dinámica. Es capaz de reaccionar de diferentes maneras ante patrones recurrentes y nuevos, desarrollando poco a poco su propia capacidad de habituación a acontecimientos del mismo tipo.
En términos del mercado financiero, esto se asemeja al comportamiento de un trader experimentado, que no se deja llevar por cada movimiento del precio, sino que presta atención únicamente a las señales verdaderamente nuevas que rompen el equilibrio establecido. El mecanismo de compuerta actúa como regulador de la atención del modelo: determina cuándo conviene intensificar la reacción y cuándo, por el contrario, reducirla, manteniendo la estabilidad de la percepción. Este control de la sensibilidad permite filtrar los impulsos falsos sin perder, por ello, la capacidad de aprender de los cambios reales en la dinámica del mercado.
La aplicación de los enfoques propuestos por los autores del framework SEW ResNet en nuestro trabajo se basa en la arquitectura ResNeXt, modificada para adaptarse a la dinámica de picos y a la sensibilidad adaptativa. Este enfoque se basa en la idea de la percepción multicanal, en la que cada rama paralela del modelo procesa los datos desde su propio punto de vista y, a continuación, los resultados se combinan con precisión en un único vector de percepción del mercado. Esta estructura permite que el modelo no se limite a registrar el hecho de que el precio se mueve, sino que distinga su naturaleza, intensidad y dirección —algo que, por lo general, el trader determina por intuición—.
El elemento clave del modelo es el módulo Spike ResNeXt Bottleneck, que actúa como una especie de filtro de significados. Este comprime el flujo de señales entrantes, lo hace pasar por un canal estrecho y lo vuelve a expandir, pero ya en una forma depurada y estructurada. Esta idea del clásico Bottleneck adquiere aquí una dimensión de picos. Cada elemento del bloque es capaz de decidir cuándo reaccionar y cuándo guardar silencio.
En la implementación de Bottleneck se utiliza un array dinámico de componentes cBottleneck, que conforma la ruta de cálculo del bloque. Las capas se crean mediante el programa, en función de los parámetros establecidos por el usuario. El flujo pasa por una serie de transformaciones sucesivas: operaciones de convolución, normalización, activación por picos y convoluciones agrupadas. Toda la cadena está diseñada para garantizar una combinación equilibrada de precisión y rapidez de reacción.
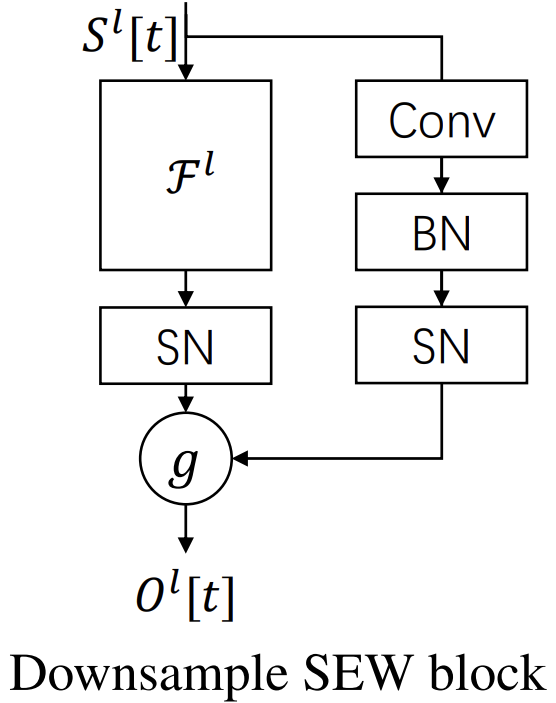
No menos importante es el módulo Spike ResNeXt Residual, que se encarga de transmitir la experiencia acumulada. Su estructura garantiza una correcta compatibilidad dimensional entre la ruta principal y la ruta corta, lo que permite conservar la información sobre los estados anteriores sin distorsiones. En el contexto financiero, es el equivalente a la «memoria del trader»: la capacidad de recordar lo que ocurrió antes del impulso actual y ajustar la reacción teniendo en cuenta el historial.
El bloque Residual se ha implementado basándose en el mismo principio dinámico: si las dimensiones de la entrada y la salida no coinciden, se añaden capas intermedias de convolución y normalización. Esta solución hace que la arquitectura sea resistente a los cambios en los parámetros del modelo, lo que permite escalar libremente la profundidad de la red sin alterar la lógica interna de las señales.
Una ventaja especial de este enfoque es la eficiencia energética. La comprobación de entradas de valor cero que se ha implementado evita cálculos innecesarios en los momentos en que el mercado está inactivo. Cuando la volatilidad es baja, muchas neuronas simplemente no se activan, lo que reduce la carga sobre el sistema y acelera los cálculos sin perder precisión. Este principio se ajusta a la economía natural de la atención: el modelo se centra únicamente en aquellos segmentos del mercado en los que realmente ocurre algo importante.
La combinación de la arquitectura multicanal ResNeXt y la lógica adaptativa de picos de SEW da lugar a un híbrido único en el que la precisión matemática se une a la intuición de mercado. Cada rama del modelo aprende su propia perspectiva sobre los datos, y las conexiones residuales garantizan la integración de estas perspectivas en una única solución. Gracias a ello, el modelo demuestra resistencia al ruido y capacidad para detectar patrones sutiles: esas señales débiles que anuncian el inicio de una tendencia.
El valor práctico de este enfoque es evidente: el modelo no se limita a analizar el pasado, sino que aprende a reconocer los momentos en los que cambia la situación del mercado. Esto supone una ventaja a la hora de elaborar estrategias de predicción, filtrar señales falsas y gestionar automáticamente las decisiones de negociación.
A continuación se muestra una representación del framework de trabajo realizada por el autor.
Principios fundamentales de la implementación
Una vez implementados sucesivamente los distintos módulos, se nos planteó una pregunta lógica: ¿cómo unir estos elementos en una arquitectura única y coherente, en la que cada parte complemente a la otra y todo el sistema funcione como un organismo integral?
Sin embargo, no hay que precipitarse. La arquitectura no debe limitarse a unir bloques, sino que debe garantizar una interacción armoniosa entre los niveles de procesamiento, en la que las características de bajo nivel den paso de forma fluida a estructuras de mercado más abstractas. Por eso, lo lógico es analizar primero la base misma: ese armazón sobre el que se construirá nuestra inteligencia de picos. Como ya hemos mencionado anteriormente, este esqueleto lo constituye el framework ResNeXt, conocido por su flexibilidad modular y su alto rendimiento.
Partimos de ResNeXt, pero lo dotamos de señales de picos. En su versión clásica, ResNeXt analiza los flujos de datos basándose en ramas de procesamiento paralelas, cada una de las cuales extrae un aspecto concreto de la información de entrada. En nuestra implementación, estas ramas se han transformado en canales de picos, capaces de regular de forma autónoma la sensibilidad y la frecuencia de las reacciones ante los cambios del mercado.
En el módulo Spike Bottleneck ya se ha implementado el ciclo básico de percepción de secuencias: la señal se comprime, se transforma y se vuelve a desplegar, conservando la integridad semántica de los datos. Este esquema funciona muy bien en el análisis de series temporales univariantes, en las que la dependencia entre los elementos de la secuencia es homogénea. Sin embargo, el mercado es más complejo. Nos encontramos ante una estructura temporal multimodal en la que se desarrollan en paralelo procesos interrelacionados: el precio, el volumen, la volatilidad, la liquidez, el interés abierto y muchas otras características.
Intentar analizar cada uno de estos canales de forma independiente, como una secuencia univariante separada, conlleva la pérdida de información de vital importancia. Existe una estrecha relación dinámica entre estas características: la variación del volumen influye en la amplitud de las fluctuaciones de los precios, la volatilidad determina el ritmo del mercado y la liquidez marca la intensidad de la reacción ante los factores externos. Al procesar estas señales por separado, dicha interrelación se rompe y el modelo pierde la capacidad de percibir la integridad estructural del comportamiento del mercado.
Para subsanar esta carencia, en nuestra implementación introducimos un segundo «Bottleneck», que opera con una representación transpuesta del tensor original. A diferencia del análisis estándar de secuencias univariantes, este bloque examina los datos por pasos temporales individuales, analizando todos los canales a la vez en cada instante. Esto permite al modelo identificar las dependencias entre canales, registrar su evolución y tener en cuenta las complejas interacciones entre las características.
Al mismo tiempo, conservamos un solo bloque residual para no potenciar en exceso la influencia de las conexiones residuales. Esta solución garantiza un equilibrio entre la conservación de la información sobre estados anteriores y el procesamiento eficaz de nuevas combinaciones de señales. Como resultado, el modelo puede realizar simultáneamente las siguientes tareas:
- extraer las regularidades locales dentro de cada secuencia univariante;
- identificar las relaciones entre canales y la dinámica coordinada de las características;
- mantener la resistencia al ruido y al exceso de señales gracias a la limitación de las conexiones residuales.
El enfoque híbrido convierte la arquitectura SEW ResNeXt en una herramienta capaz de percibir el mercado como un sistema dinámico complejo: cada característica está interrelacionada con las demás, y los cambios en un elemento repercuten en toda la estructura del modelo.
El siguiente aspecto importante que hay que abordar es la elección de la función de combinación de picos elemento por elemento para nuestros tres flujos de información. Desde el punto de vista del enfoque basado en el riesgo y la naturaleza binaria de los picos, la multiplicación elemento por elemento parece una opción atractiva. En este caso, la señal solo se transmite si se confirma en todos los flujos a la vez. Este principio se puede comparar con el de un trader prudente que solo abre una posición cuando todos los indicadores han confirmado la señal.
A primera vista, la solución parece lógica y rigurosa: el modelo solo reacciona ante la información concordante, lo que reduce el riesgo de falsas alarmas. Sin embargo, conviene analizar detenidamente cómo se distribuye el gradiente de error en este caso.
Si la señal se confirma en todos los flujos de información, el gradiente de error se distribuye uniformemente. Pero si al menos un flujo no ha generado un pico, el gradiente se dirige exclusivamente hacia él, mientras que los demás reciben una corrección nula. Desde el punto de vista de la lógica, tiene sentido. Cuando al menos un flujo devuelve un cero, la señal no se propaga, y es precisamente ese flujo el que requiere un ajuste. El gradiente de error indica que hay que activar este flujo.
El problema surge en el caso crítico, cuando todos los flujos de información permanecen cerrados. En este escenario, cada elemento de la multiplicación elemento por elemento es igual a cero, y el gradiente del error, multiplicado por esos ceros, queda totalmente bloqueado. Como resultado, la neurona deja de recibir retroalimentación: está muerta y sus parámetros se deterioran. En la práctica, esto puede provocar que se interrumpa el entrenamiento de una parte de la red o incluso de todo el modelo, sobre todo si estas situaciones se repiten con frecuencia.
En otras palabras, la multiplicación estricta elemento por elemento se convierte en una trampa para el aprendizaje. Protege contra las señales falsas, pero al mismo tiempo conlleva el riesgo de que las neuronas dejen de funcionar por completo.
La suma simple de los valores garantiza el paso sin obstáculos de los gradientes de error, tal como se implementa en la arquitectura ResNet clásica. Este enfoque garantiza que, incluso si todos los flujos de información están temporalmente cerrados, el gradiente de error pueda ajustar los parámetros de la neurona y el aprendizaje continúe sin bloqueos.
Sin embargo, aquí surge un conflicto con el concepto de los picos. A diferencia de la señal binaria «0» o «1», la suma de varios flujos activos puede dar como resultado los valores 2 o 3. Esto altera la naturaleza de la activación por picos y puede provocar una señalización excesiva indeseada, en la que el modelo reacciona de forma demasiado brusca. En términos de mercado, es como un trader que abre una posición con un exceso de confianza, sin que los datos lo respalden realmente.
Tras sopesar todos los riesgos, hemos llegado a un diseño más equilibrado: normalizamos la suma de los valores de los flujos de información y, a continuación, aplicamos la activación por picos. Esto permite, al mismo tiempo, conservar la interpretación binaria de la señal y garantizar la propagación correcta de los gradientes de error. La normalización limita el valor resultante dentro de un rango admisible, evitando respuestas excesivas, y permite generar una señal inversa. Esta señal se produce cuando varios flujos bloquean simultáneamente la activación y la red recibe información sobre la necesidad de realizar una corrección inversa. Es un comportamiento similar al del trader prudente que reduce su posición cuando las señales del mercado indican una fuerte oposición.
Módulo de nivel superior
Para la aplicación práctica del concepto propuesto, hemos creado un nuevo objeto, CNeuronSpikeResNeXtBlock, que integra de forma precisa todos los elementos clave de nuestra arquitectura.
class CNeuronSpikeResNeXtBlock   :  public CNeuronSpikeActivation
  {
protected:
   CNeuronTransposeOCL           caTranspose[2];
   CNeuronSpikeResNeXtBottleneck caBottleneck[2];
   CNeuronSpikeResNeXtResidual   cResidual;
   CLayer                        cG;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronSpikeResNeXtBlock(void) {};
                    ~CNeuronSpikeResNeXtBlock(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint chanels_in, uint chanels_out, uint units_in,
                          uint units_out, uint group_size, uint groups,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   override const   {  return defNeuronSpikeResNeXtBlock;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      TrainMode(bool flag) override;
   virtual bool      Clear(void) override;
  };
Se basa en dos bloques Bottleneck, un bloque Residual y representaciones transpuestas de los datos originales, lo que permite tener en cuenta secuencias univariantes individuales e interrelaciones complejas entre canales. Al heredar de CNeuronSpikeActivation, esta clase conserva la naturaleza de picos de las señales e integra compuertas con umbrales adaptativos, lo que garantiza una respuesta flexible de las neuronas ante los cambios en la dinámica del mercado.
Uno de los elementos clave del bloque es un array dinámico destinado a almacenar punteros a los objetos de la función de combinación de picos cG, lo que amplía considerablemente las posibilidades del bloque y abre nuevas vías para la experimentación. Este array permite conectar y utilizar diferentes opciones de combinación de señales elemento por elemento, incluyendo tanto la suma simple como la combinación normalizada seguida de una activación por picos. Gracias a este diseño, el bloque no es solo una estructura fija, sino una plataforma flexible que permite probar diversas estrategias de integración de señales, adaptándose a las características específicas de los datos de mercado.
La preparación de un nuevo bloque recae íntegramente en el método Init, que se encarga de inicializar todos sus componentes clave y de configurar su interacción.
bool CNeuronSpikeResNeXtBlock::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                    uint chanels_in, uint chanels_out, uint units_in,
                                    uint units_out, uint group_size, uint groups,
                                    ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronSpikeActivation::Init(numOutputs, myIndex, open_cl, chanels_out * units_out,
                                    optimization_type, batch))
      return false;
Su algoritmo comienza con la llamada al método homónimo de la clase padre, lo que sienta las bases para el procesamiento por picos y la integración de compuertas con umbrales adaptativos.
A continuación, el método inicializa las representaciones transpuestas del tensor original. El primer objeto prepara los datos para el análisis de secuencias univariantes, mientras que el segundo se encarga de la transposición inversa de los datos. Este enfoque permite que el modelo tenga en cuenta simultáneamente la estructura de los flujos individuales y la interacción entre ellos, sentando así las bases para una propagación correcta de las señales y los gradientes.
   uint index = 0;
   if(!caTranspose[0].Init(0, index, OpenCL, units_in, chanels_in, optimization, iBatch))
      return false;
   index++;
   if(!caTranspose[1].Init(0, index, OpenCL, chanels_out, units_out, optimization, iBatch))
      return false;
El siguiente paso consiste en inicializar los bloques Bottleneck. El primer Bottleneck procesa secuencias univariantes clásicas, identificando patrones locales en las señales, mientras que el segundo trabaja con una representación transpuesta, captando las dependencias entre canales y la dinámica coordinada de las características. Cada bloque recibe los parámetros de los canales, el número de grupos y el tamaño de agrupación, así como los parámetros de optimización necesarios y el tamaño del lote.
   index++;
   if(!caBottleneck[0].Init(0, index, OpenCL, chanels_in, chanels_out, units_in, units_out,
                            group_size, groups, optimization, iBatch))
      return false;
   index++;
   if(!caBottleneck[1].Init(0, index, OpenCL, units_in, units_out, chanels_in, chanels_out,
                            group_size, groups, optimization, iBatch))
      return false;
A continuación, el método inicializa el bloque Residual, que conserva las conexiones residuales de importancia crítica, garantizando la estabilidad y el equilibrio entre la memoria de la neurona y la adaptabilidad.
   index++;
   if(!cResidual.Init(0, index, OpenCL, chanels_in, chanels_out, units_in, units_out,
                      optimization, iBatch))
      return false;
Por último, el método crea cG, que contiene un array dinámico de objetos de la función de combinación de picos. Aquí se añaden sucesivamente una neurona básica sin activación y un objeto de normalización por lotes. Esta secuencia permite sumar y normalizar correctamente las señales procedentes de diferentes flujos de información.
   CNeuronBaseOCL*      neuron = NULL;
   CNeuronBatchNormOCL* norm = NULL;
   cG.Clear();
   cG.SetOpenCL(OpenCL);
   index++;
   neuron = new CNeuronBaseOCL();
   if(!neuron ||
      !neuron.Init(0, index, OpenCL, Neurons(), optimization, iBatch) ||
      !cG.Add(neuron))
     {
      DeleteObj(neuron)
      return false;
     }
   neuron.SetActivationFunction(None);
//---
   if(!cResidual.SetGradient(neuron.getGradient(), true) ||
      !caTranspose[1].SetGradient(neuron.getGradient(), true) ||
      !caBottleneck[0].SetGradient(neuron.getGradient(), true))
      return false;
//---
   index++;
   norm = new CNeuronBatchNormOCL();
   if(!norm ||
      !norm.Init(0, index, OpenCL, Neurons(), iBatch, optimization) ||
      !cG.Add(norm))
     {
      DeleteObj(norm)
      return false;
     }
//---
   return true;
  }
Además, el bloque cuenta con un sistema de sincronización de los punteros a los búferes de gradientes de error para los componentes clave, lo que garantiza una propagación correcta del error en la red sin copias innecesarias de datos y evita la degradación de las señales.
Como resultado, el método Init genera un bloque completamente listo, en el que cada componente está inicializado, configurado y vinculado al resto.
La propagación hacia adelante de las señales se implementa en el método feedForward, que garantiza el procesamiento secuencial de la información a través de todos los componentes clave del bloque SEW ResNeXt.
bool CNeuronSpikeResNeXtBlock::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!caTranspose[0].FeedForward(NeuronOCL))
      return false;
En primer lugar, los datos pasan por el primer bloque de transposición, lo que genera una representación de los pasos temporales para su posterior análisis. A continuación, la señal se procesa secuencialmente mediante el primer módulo Bottleneck, que identifica los patrones locales de las secuencias univariantes.
   if(!caBottleneck[0].FeedForward(NeuronOCL))
      return false;
El segundo Bottleneck, por su parte, procesa la salida del bloque de transposición, captando las dependencias entre canales y la dinámica coordinada de las características.
   if(!caBottleneck[1].FeedForward(caTranspose[0].AsObject()))
      return false;
   if(!caTranspose[1].FeedForward(caBottleneck[1].AsObject()))
      return false;
Luego la información pasa por el segundo bloque de transposición, que la prepara para su integración con las conexiones residuales que proporciona el bloque Residual*.
   if(!cResidual.FeedForward(NeuronOCL))
      return false;
En la siguiente fase se combinan los impulsos mediante la suma de las señales procedentes de ambos módulos Bottleneck y del bloque Residual.
   CNeuronBaseOCL* current = cG[0];
   if(!current)
      return false;
   if(!SumAndNormilize(caBottleneck[0].getOutput(), caTranspose[1].getOutput(),
                       current.getOutput(), caTranspose[1].GetCount(), false, 0, 0, 0, 1) ||
      !SumAndNormilize(current.getOutput(), cResidual.getOutput(),
                       current.getOutput(), caTranspose[1].GetCount(), false, 0, 0, 0, 1))
      return false;
Este enfoque permite integrar correctamente tanto las señales univariantes como las intercanales, conservando la naturaleza binaria de los picos y evitando la degradación de las neuronas.
A continuación, los elementos restantes del array cG pasan por su propio ciclo de propagación directa, en el que cada objeto recibe como entrada la salida de la neurona anterior, lo que garantiza la propagación secuencial de las señales a través de todas las funciones de combinación.
   for(int i = 1; i < cG.Total(); i++)
     {
      current = cG[i];
      if(!current ||
         !current.FeedForward(cG[i - 1]))
         return false;
     }
//---
   return CNeuronSpikeActivation::feedforward(cG[-1]);
  }
El proceso finaliza con la llamada al método homónimo de la clase padre, que lleva a cabo el procesamiento final de las señales de picos y transmite los resultados al siguiente nivel del modelo.
De este modo, el algoritmo de propagación directa garantiza un recorrido fluido y estructurado de las señales a través de todos los componentes del bloque, integrando las dependencias locales e intercanales, normalizando los picos combinados y manteniendo una propagación correcta de los gradientes de error para el aprendizaje. En el contexto del mercado, esto permite que el modelo reaccione simultáneamente a los cambios locales de cada flujo y a la dinámica coordinada de las características, creando así un sistema estable y adaptativo de análisis de datos financieros.
La distribución correcta de los gradientes se lleva a cabo en el método calcInputGradients, que garantiza una actualización secuencial y coherente de los parámetros de todos los componentes del bloque SEW ResNeXt.
bool CNeuronSpikeResNeXtBlock::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
El método comienza comprobando que el puntero recibido al objeto de datos de origen sea correcto y llamando al método homónimo de la clase padre, lo que garantiza la propagación correcta de los gradientes hasta la última capa del módulo de combinación de picos cG.
   if(!CNeuronSpikeActivation::calcInputGradients(cG[-1]))
      return false;
A continuación, recorremos todos los elementos del array dinámico cG en orden inverso, del último al primero, calculando los gradientes de error correspondientes a cada neurona a partir de la salida de la siguiente en la cadena.
   CNeuronBaseOCL* current = NULL;
   for(int i = cG.Total() - 2; i >= 0; i--)
     {
      current = cG[i];
      if(!current ||
         !current.CalcHiddenGradients(cG[i + 1]))
         return false;
     }
Este enfoque permite distribuir correctamente el error entre todas las funciones de combinación y normalización, lo que garantiza un aprendizaje coherente a nivel de picos.
Aquí cabe señalar que, gracias a la sustitución de los punteros a los búferes de los gradientes de error de los componentes principales, una vez que el error llega al primer elemento del array cG, se transmite automáticamente a todos los flujos de información del bloque. Esta técnica permite garantizar que cada flujo reciba la retroalimentación correcta sin necesidad de sincronizar manualmente los gradientes de cada componente. Como resultado, la distribución del error se produce de forma natural y continua, lo que garantiza un aprendizaje coordinado de toda la estructura del bloque y evita la degradación de las neuronas, incluso en el caso de señales complejas e interdependientes.
A continuación, los gradientes obtenidos se transmiten al segundo Bottleneck y al bloque de transposición, reflejando el efecto de las dependencias entre canales sobre el error del modelo.
   if(!caBottleneck[1].CalcHiddenGradients(caTranspose[1].AsObject()))
      return false;
   if(!caTranspose[0].CalcHiddenGradients(caBottleneck[1].AsObject()))
      return false;
Luego el error se propaga de forma inversa a través del bloque Residual, lo que permite corregir las conexiones residuales sin amplificar en exceso la influencia de las señales anteriores.
   if(!NeuronOCL.CalcHiddenGradients(cResidual.AsObject()))
      return false;
Se ha prestado especial atención al almacenamiento correcto de los datos de todos los flujos de información. Para ello se utiliza un búfer de datos temporal que acumula la información sobre el error y la devuelve correctamente a las entradas. Esto evita la aparición de neuronas muertas, lo que garantiza un aprendizaje estable y continuo incluso cuando hay una ausencia temporal de señales en determinados flujos.
   CBufferFloat* temp = NeuronOCL.getGradient();
   if(!NeuronOCL.SetGradient(caTranspose[0].getPrevOutput(), false))
      return false;
   if(!NeuronOCL.CalcHiddenGradients(caBottleneck[0].AsObject()))
      return false;
   if(!SumAndNormilize(temp, NeuronOCL.getGradient(), temp,
                       caTranspose[0].GetWindow(), false, 0, 0, 0, 1))
      return false;
   if(!NeuronOCL.CalcHiddenGradients(caTranspose[0].AsObject()))
      return false;
   if(!SumAndNormilize(temp, NeuronOCL.getGradient(), temp,
                       caTranspose[0].GetWindow(), false, 0, 0, 0, 1))
      return false;
   if(!NeuronOCL.SetGradient(temp, false))
      return false;
//---
   return true;
  }
Como resultado, el método calcInputGradients garantiza una distribución coherente y segura de los gradientes de error a través de todos los componentes del bloque, desde las secuencias transpuestas y los módulos Bottleneck hasta Residual y el bloque de combinación de picos. Este mecanismo garantiza que cada neurona reciba suficiente retroalimentación, corrija sus parámetros y mantenga la adaptabilidad del modelo, capaz de analizar secuencias de mercado multimodales complejas.
El código fuente completo de la clase CNeuronSpikeResNeXtBlock, con todos los métodos implementados, se incluye en el archivo adjunto, lo que permite estudiar en detalle el funcionamiento interno del bloque y seguir la lógica del procesamiento de señales en cada etapa.
Arquitectura del modelo
La siguiente etapa de nuestro trabajo consiste en diseñar la arquitectura de los modelos que se van a entrenar. Al igual que antes, seguimos trabajando con el paradigma Actor-Critic, creando un modelo capaz de tomar decisiones de negociación de forma autónoma y de reaccionar ante los cambios del mercado. Integramos todos los enfoques de SEW ResNeXt implementados anteriormente en el codificador de estado del entorno, que actúa como órgano de percepción del modelo, acumulando y procesando toda la información entrante sobre el mercado.
bool CreateDescriptions(CArrayObj *&encoder,
                        CArrayObj *&actor,
                        CArrayObj *&critic
                       )
  {
//---
   CLayerDescription *descr;
//---
   if(!encoder)
     {
      encoder = new CArrayObj();
      if(!encoder)
         return false;
     }
   if(!actor)
     {
      actor = new CArrayObj();
      if(!actor)
         return false;
     }
   if(!critic)
     {
      critic = new CArrayObj();
      if(!critic)
         return false;
     }
El proceso de construcción del codificador comienza con la inicialización del propio array de capas, tras lo cual se crea la capa de entrada, que recibe los datos brutos del historial de precios y de las características de las barras.
//--- Encoder
   encoder.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   uint prev_count = descr.count = (HistoryBars * BarDescr);
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   iLatentLayer = 0;
A continuación viene una capa de normalización por lotes con adición de ruido, que favorece un entrenamiento estable y una evolución gradual del aprendizaje.
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormWithNoise;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   iLatentLayer++;
Y, después, la capa ConcatDiff, que agrega las diferencias temporales para crear una representación oculta inicial.
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConcatDiff;
   prev_count = descr.count = HistoryBars;
   descr.layers = BarDescr;
   descr.step = 1;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   iLatentLayer++;
   uint prev_out = descr.layers * 2 ;
A continuación, se utiliza la capa Mamba4CastEmbedding, que codifica la información sobre los intervalos de tiempo, preparando los datos para un procesamiento más complejo.
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defMamba4CastEmbeding;
   prev_count = descr.count = HistoryBars;
   descr.window = prev_out;
   prev_out = descr.window_out = NSkills;
     {
      uint temp[] = {PeriodSeconds(PERIOD_D1), PeriodSeconds(PERIOD_MN1)};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   iLatentLayer++;
En la siguiente etapa, entran en funcionamiento las capas NeuronSpikeResNeXtBlock, que se repiten múltiples veces y conforman una representación profunda y multicanal del estado del mercado.
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronSpikeResNeXtBlock;
     {
      uint temp[] = {prev_out,            // Canales de entrada
                     prev_out,            // Canales de salida
                     EmbeddingSize/2      // Tamaño del grupo
                    };
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
     {
      uint temp[] = {prev_count,          // Unidades de entrada
                     prev_count,          // Unidades de salida
                     NScenarios           // Número de grupos
                    };
      if(ArrayCopy(descr.units, temp) < (int)temp.Size())
         return false;
     }
   descr.optimization = ADAM;
   descr.batch = BatchSize;
   descr.activation = None;
   for(int i = 0; i < 2; i++)
      if(!encoder.Add(descr))
        {
         delete descr;
         return false;
        }
      else
         iLatentLayer++;
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronSpikeResNeXtBlock;
     {
      uint temp[] = {prev_out,              // Canales de entrada
                     prev_out * 2,          // Canales de salida
                     EmbeddingSize/2        // Tamaño del grupo
                    };
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
     {
      uint temp[] = {prev_count,            // Unidades de entrada
                     prev_count / 2,        // Unidades de salida
                     NScenarios             // Número de grupos
                    };
      if(ArrayCopy(descr.units, temp) < (int)temp.Size())
         return false;
     }
   descr.optimization = ADAM;
   descr.batch = BatchSize;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   iLatentLayer++;
   prev_count = descr.units[1];
   prev_out = descr.windows[1];
//--- layer 6
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronSpikeResNeXtBlock;
     {
      uint temp[] = {prev_out,            // Canales de entrada
                     prev_out,            // Canales de salida
                     EmbeddingSize/2      // Tamaño del grupo
                    };
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
     {
      uint temp[] = {prev_count,          // Unidades de entrada
                     prev_count,          // Unidades de salida
                     NScenarios           // Número de grupos
                    };
      if(ArrayCopy(descr.units, temp) < (int)temp.Size())
         return false;
     }
   descr.optimization = ADAM;
   descr.batch = BatchSize;
   descr.activation = None;
   for(int i = 0; i < 2; i++)
      if(!encoder.Add(descr))
        {
         delete descr;
         return false;
        }
      else
         iLatentLayer++;
//--- layer 7
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronSpikeResNeXtBlock;
     {
      uint temp[] = {prev_out,              // Canales de entrada
                     prev_out * 2,          // Canales de salida
                     EmbeddingSize/2        // Tamaño del grupo
                    };
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
     {
      uint temp[] = {prev_count,            // Unidades de entrada
                     prev_count / 2,        // Unidades de salida
                     NScenarios             // Número de grupos
                    };
      if(ArrayCopy(descr.units, temp) < (int)temp.Size())
         return false;
     }
   descr.optimization = ADAM;
   descr.batch = BatchSize;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   iLatentLayer++;
   prev_count = descr.units[1];
   prev_out = descr.windows[1];
//--- layer 8
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronSpikeResNeXtBlock;
     {
      uint temp[] = {prev_out,            // Canales de entrada
                     prev_out,            // Canales de salida
                     EmbeddingSize/2      // Tamaño del grupo
                    };
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
     {
      uint temp[] = {prev_count,          // Unidades de entrada
                     prev_count,          // Unidades de salida
                     NScenarios           // Número de grupos
                    };
      if(ArrayCopy(descr.units, temp) < (int)temp.Size())
         return false;
     }
   descr.optimization = ADAM;
   descr.batch = BatchSize;
   descr.activation = None;
   for(int i = 0; i < 2; i++)
      if(!encoder.Add(descr))
        {
         delete descr;
         return false;
        }
      else
         iLatentLayer++;
//--- layer 9
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronSpikeResNeXtBlock;
     {
      uint temp[] = {prev_out,            // Canales de entrada
                     prev_out * 2,        // Canales de salida
                     EmbeddingSize/2      // Tamaño del grupo
                    };
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
     {
      uint temp[] = {prev_count,          // Unidades de entrada
                     prev_count / 2,      // Unidades de salida
                     NScenarios           // Número de grupos
                    };
      if(ArrayCopy(descr.units, temp) < (int)temp.Size())
         return false;
     }
   descr.optimization = ADAM;
   descr.batch = BatchSize;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   iLatentLayer++;
   prev_count = descr.units[1];
   prev_out = descr.windows[1];
//--- layer 10
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronSpikeResNeXtBlock;
     {
      uint temp[] = {prev_out,            // Canales de entrada
                     prev_out,            // Canales de salida
                     EmbeddingSize/2      // Tamaño del grupo
                    };
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
     {
      uint temp[] = {prev_count,          // Unidades de entrada
                     prev_count,          // Unidades de salida
                     NScenarios           // Número de grupos
                    };
      if(ArrayCopy(descr.units, temp) < (int)temp.Size())
         return false;
     }
   descr.optimization = ADAM;
   descr.batch = BatchSize;
   descr.activation = None;
   for(int i = 0; i < 2; i++)
      if(!encoder.Add(descr))
        {
         delete descr;
         return false;
        }
      else
         iLatentLayer++;
   uint window = prev_out;
   uint count = prev_count;
Cada bloque recibe como entrada las salidas del bloque anterior, tiene en cuenta las dependencias entre canales y normaliza los picos sumados, lo que garantiza una transmisión correcta de las señales a lo largo de toda la red. Los parámetros de los canales, el número de grupos, el tamaño del lote y la optimización se ajustan de tal forma que los bloques puedan codificar eficazmente secuencias multimodales y mantener su adaptabilidad incluso ante fuertes fluctuaciones del mercado.
Tras una serie de bloques de picos, el codificador concluye con capas de convolución y transposición, que consolidan la representación de salida y forman el vector de estado oculto final, destinado a predecir la evolución futura de las variables de mercado analizadas. Este tensor acumula información sobre las dependencias temporales y entre canales, lo que garantiza una representación precisa y coherente del estado del mercado.
//--- layer 11
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.step = prev_out;
   prev_out = descr.window_out = BarDescr;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 12
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.count = prev_count;
   prev_count = descr.window = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = descr.count;
//--- layer 13
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.step = prev_out;
   prev_out = descr.window_out = NForecast;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 14
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.count = prev_count;
   prev_count = descr.window = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = descr.count;
La última capa, NeuronRevInDenormOCL, garantiza el escalado y la desnormalización correctos de las señales.
//--- layer 15
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronRevInDenormOCL;
   descr.count = prev_count * prev_out;
   descr.layers = 1;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Las arquitecturas Actor y Critic se han trasladado íntegramente desde trabajos anteriores sin modificaciones, conservando una estructura y una funcionalidad contrastadas a lo largo del tiempo. Se pueden consultar en el archivo adjunto al artículo. Gracias a esta organización, nuestro modelo cuenta con un potente codificador capaz de captar las complejas dependencias temporales y entre canales del mercado, mientras que el Actor y el Critic utilizan esta representación para realizar previsiones precisas y tomar decisiones de negociación.
Pruebas
Hemos concluido un importante trabajo de integración de los componentes clave del framework SEW ResNeXt, y ha llegado el momento de evaluar la eficacia de las soluciones implementadas. Antes de confiar fondos reales a un modelo, es necesario comprobar minuciosamente la estrategia con datos históricos y simulados, como si se tratara de entrenar las habilidades de un trader experimentado y comprobar su capacidad para actuar en las más diversas condiciones de mercado. Cada etapa simula un mercado real, lo que permite al modelo adquirir experiencia de forma gradual, aprender a distinguir las señales del ruido y desarrollar algoritmos de comportamiento estables, necesarios para operar en un entorno de negociación real.
La primera fase —el aprendizaje offline— se lleva a cabo con datos históricos del par de divisas EURUSD en el marco temporal H1, correspondientes al periodo comprendido entre enero de 2024 y junio de 2025. Este periodo se convirtió en un auténtico campo de entrenamiento. El modelo aprendió a reproducir patrones históricos, a comprender la dinámica de los precios y los volúmenes de las operaciones, y a identificar regularidades y relaciones entre las características clave. Se podría decir que desarrollaba la intuición del trader, combinada con una evaluación estratégica precisa. Poco a poco, el modelo fue adquiriendo la capacidad de anticipar la evolución del mercado y evaluar el riesgo de cada operación potencial.
La siguiente fase —el ajuste fino en línea en el probador de estrategias de MetaTrader 5— permitirá al modelo trabajar con flujos de datos en tiempo real, vela a vela. Aquí aprende a desenvolverse en la dinámica del mercado real, a mantener la estabilidad ante el ruido del mercado, a ajustar sus acciones en situaciones de baja liquidez y a reaccionar al instante ante movimientos bruscos de los precios. Esta fase supuso, en cierto modo, el perfeccionamiento de la estrategia. La estructura básica, basada en datos históricos, se mantuvo inalterada, pero el modelo aprendió a reaccionar de forma flexible ante la situación actual del mercado, minimizando el riesgo de sobreajuste y aumentando la precisión de las previsiones incluso en un entorno inestable.
La comprobación final se llevó a cabo con datos correspondientes al periodo comprendido entre julio y septiembre de 2025, totalmente nuevos y que no se habían utilizado anteriormente. Todos los parámetros obtenidos en las etapas anteriores se cargaron sin modificaciones, lo que garantizó una evaluación imparcial de la capacidad de generalización del modelo. Los resultados de las pruebas confirman que el enfoque por etapas del aprendizaje y la adaptación permite al modelo analizar el mercado y elaborar una previsión de la evolución futura de las características clave del mercado, que puede servir de base para tomar decisiones de negociación reales.

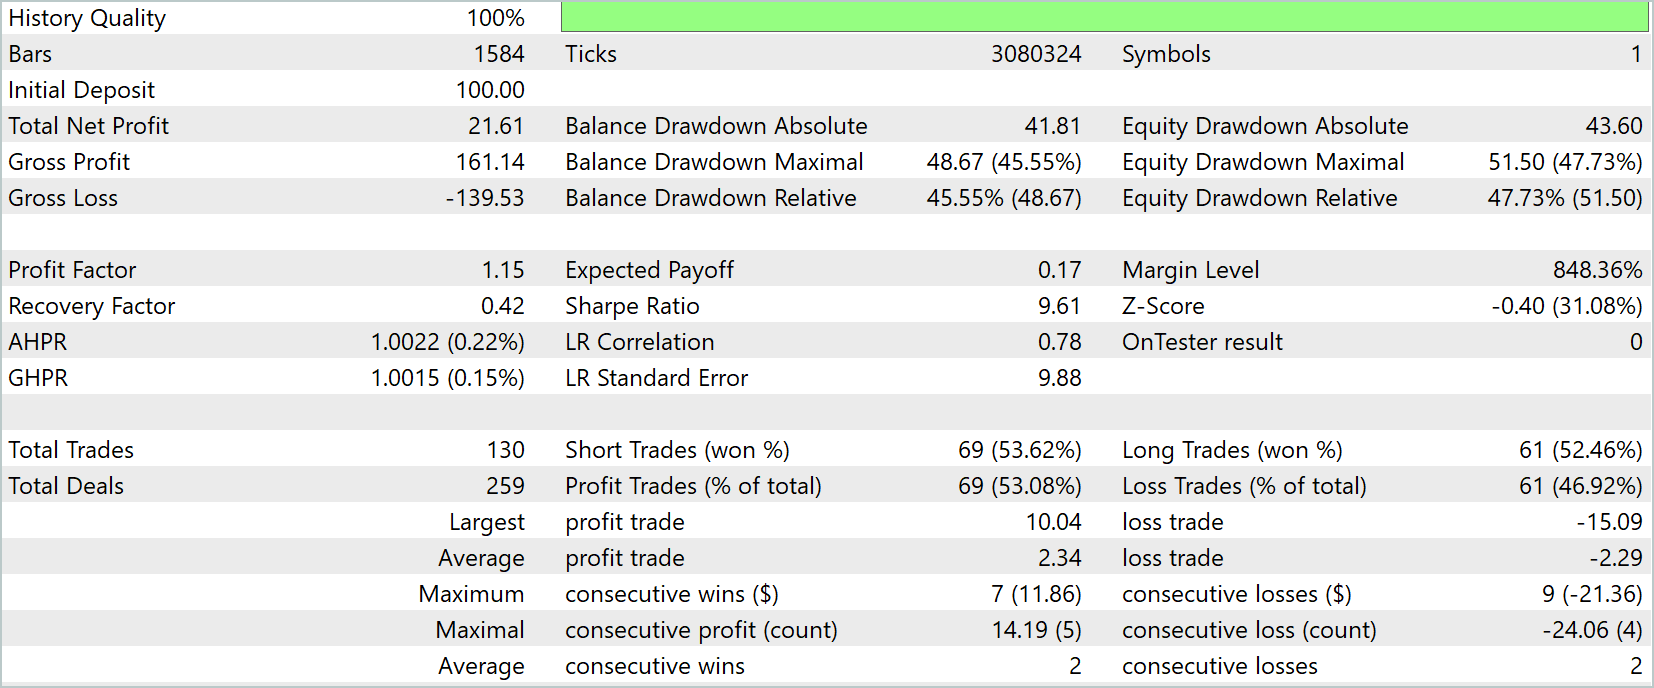
El gráfico del balance y la equity muestra un crecimiento estable del capital durante prácticamente todo el periodo de pruebas. A pesar de algunos drawdowns puntuales, la equity se mantiene cercana al balance. Esto pone de manifiesto una estrategia de gestión de riesgos prudente y controlada. El drawdown máximo de la equity fue del 47,73 %, un valor bastante elevado para unas condiciones volátiles, pero acorde con los escenarios de prueba en un periodo con fuertes fluctuaciones de los precios.
Las ganancias totales ascendieron a 21,61 USD con un depósito inicial de 100,0 USD, lo que supone un crecimiento del capital de más del 20 % durante el periodo analizado. El indicador Profit Factor es de 1,15. Esto indica que los beneficios totales superan la suma de las pérdidas, mientras que el coeficiente de Sharpe, de 9,61, pone de manifiesto la alta eficacia de la estrategia teniendo en cuenta el riesgo. En este contexto, el factor de recuperación es de 0,42. Esto pone de manifiesto la necesidad de prestar atención a la gestión de los drawdowns al extrapolar los resultados a grandes volúmenes de capital.
El modelo realizó 130 operaciones, de las cuales algo más de la mitad resultaron rentables (53,08 %), y el beneficio medio por operación fue de 2,34 USD, mientras que la pérdida media fue de 2,29 USD. La racha máxima de operaciones ganadoras es de 7, con un beneficio total de 11,86 USD, mientras que la racha máxima de operaciones perdedoras es de 9, con una pérdida total de 21,36 USD. Estos indicadores ponen de manifiesto el carácter moderadamente agresivo de la estrategia y la capacidad del modelo para adaptarse a las fluctuaciones del mercado a corto plazo.
Cabe destacar la distribución equilibrada de las operaciones entre posiciones cortas y largas: 69 posiciones cortas y 61 largas, con tasas de éxito del 53,62 % y del 52,46 %, respectivamente. Esto pone de manifiesto el comportamiento equilibrado del modelo en distintos escenarios de mercado y su capacidad para reaccionar tanto ante subidas como ante bajadas de precios.
En general, los resultados de las pruebas confirman el buen funcionamiento del framework de trabajo desarrollado a partir de SEW ResNeXt con elementos de activación por picos. El modelo demuestra solidez, capacidad de adaptación a la dinámica del mercado y una gestión prudente del riesgo, lo que lo hace adecuado para seguir trabajando con él en condiciones reales de los mercados financieros.
Conclusión
Hemos completado la implementación práctica de los enfoques propuestos por los autores del framework SEW ResNet y hemos creado una plataforma funcional en la que cada detalle tiene una aplicación práctica. Las activaciones por picos con umbrales adaptativos han enseñado al modelo a reaccionar con moderación. Las compuertas han añadido sensibilidad a la novedad. Los dos bloques Bottleneck ofrecieron un equilibrio entre el análisis local y la consideración de las dependencias entre canales. El bloque residual conservó la memoria, pero no permitió que esta sofocara la adaptación.
Los resultados de la prueba confirmaron la viabilidad del concepto. Un crecimiento del capital del 21,6 % es un indicador objetivo de eficacia. Un factor de beneficio de 1,15 y algo más del 50 % de operaciones ganadoras indican que la lógica de las señales funciona. El beneficio medio y la pérdida media son similares en magnitud: el modelo no depende de operaciones afortunadas poco frecuentes. No obstante, un drawdown máximo del 47 % supone un serio desafío que no se puede ignorar.
Las ventajas de esta implementación son evidentes. Este modelo filtra eficazmente el ruido del mercado y percibe las interrelaciones entre los canales, que se pierden cuando estos se analizan por separado. La arquitectura conserva el flujo de gradientes y sigue siendo entrenable incluso en escenarios complejos. El código es modular. La integración con OpenCL abre el camino hacia la aceleración y la escalabilidad.
Al mismo tiempo, también hay aspectos que requieren más trabajo. Un drawdown máximo elevado exige reforzar la gestión de riesgos. Las pruebas en el simulador no equivalen al trading real: el deslizamiento previsto, los spreads y la liquidez del mercado pueden alterar los perfiles de ganancias y pérdidas. El tamaño de la muestra y las características específicas del periodo también influyen: es necesario realizar una validación minuciosa con datos nuevos y en diferentes condiciones de mercado.
La conclusión práctica es sencilla: la arquitectura ha demostrado su valía como plataforma de investigación y aplicación. Ofrece al trader una herramienta que puede depurar, interpretar y mejorar. Pero esto no es el final del camino.
Enlaces
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | Study.mq5 | Asesor experto | Asesor experto para el entrenamiento de modelos sin conexión |
| 2 | StudyOnline.mq5 | Asesor experto | Asesor experto para el entrenamiento en línea de modelos |
| 3 | Test.mq5 | Asesor experto | Asesor experto para probar el modelo |
| 4 | Trajectory.mqh | Biblioteca de clases | Estructura para describir el estado del sistema y la arquitectura de los modelos |
| 5 | NeuroNet.mqh | Biblioteca de clases | Biblioteca de clases para crear una red neuronal |
| 6 | NeuroNet.cl | Biblioteca | Biblioteca de código del programa OpenCL |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19895
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.