

Redes neuronales en el trading: De los modelos Transformer a las neuronas de impulsos (componentes clave)
 25
 1

Introducción
Los mercados financieros son como un mar embravecido, en el que el capitán de un barco debe tomar decisiones en fracciones de segundo, basándose no solo en las cartas náuticas y la brújula, sino también en la intuición adquirida tras años de experiencia. En el mundo actual, los modelos computacionales están asumiendo cada vez más esta función, y la tarea del investigador consiste en crear un algoritmo capaz de igualar la flexibilidad y la capacidad de anticipación del ser humano. En el contexto de los métodos tradicionales de aprendizaje automático y las arquitecturas de redes neuronales ya consolidadas, el marco de trabajo SpikingBrain surgió como un soplo de aire fresco, capaz de hinchar las velas del investigador y llevarlo hacia nuevas costas del análisis de datos.
Una de las principales ventajas de SpikingBrain es su enfoque basado en eventos para el procesamiento de la información. A diferencia de los modelos clásicos, en los que los datos se tratan como un flujo continuo, las redes neuronales de impulsos responden a eventos discretos, lo que las hace más acordes con la naturaleza de las señales financieras reales. Los mercados financieros no evolucionan de manera uniforme: alternan períodos de calma, con fluctuaciones apenas perceptibles, con otros de bruscas oscilaciones de los precios. Una red neuronal tradicional se ve obligada a procesar ambos modos con la misma intensidad, lo que sobrecarga los recursos computacionales y provoca una pérdida de precisión durante los periodos de turbulencia repentina. SpikingBrain, por su parte, permite que el sistema se centre en los eventos, lo que le confiere una eficiencia y una adaptabilidad naturales.
Igualmente importante es el hecho de que los modelos de impulsos son eficientes desde el punto de vista energético. En los mercados financieros, donde los algoritmos suelen tener que funcionar de forma continua, la capacidad de reducir la carga sobre el hardware sin comprometer la calidad del análisis es un argumento de peso. En una época en la que los recursos informáticos se distribuyen entre miles de estrategias y docenas de servidores, la capacidad de maximizar los beneficios y minimizar al mismo tiempo el consumo energético adquiere una importancia no solo técnica, sino también estratégica. Se podría decir que SpikingBrain allana el camino hacia la informática inteligente. Lo importante no es la potencia bruta de las máquinas, sino una arquitectura elegante y la optimización de los procesos.
El punto fuerte de este marco de trabajo radica en su capacidad para facilitar una transferencia de conocimiento y una adaptación eficaces. A diferencia de los modelos de gran tamaño, que requieren grandes conjuntos de datos de entrenamiento para funcionar de forma fiable, la arquitectura de impulsos puede aprovechar los conocimientos adquiridos previamente y adaptarse a nuevos datos. Esto permite aplicar modelos preentrenados a tareas de análisis financiero y realizar su ajuste fino incluso con conjuntos de datos relativamente pequeños. Este enfoque agiliza considerablemente la implantación práctica del modelo y lo convierte en una herramienta flexible capaz de tener en cuenta las características específicas de un mercado concreto. Por consiguiente, SpikingBrain actúa como puente entre la versatilidad de las soluciones preentrenadas y las características únicas de los datos locales.
Cabe destacar que SpikingBrain no es simplemente una declaración de principios, sino un sistema coherente basado en un minucioso diseño de ingeniería. Se basa en la idea de convertir las señales de entrada en una secuencia de impulsos, que sirven como elementos básicos para todo el procesamiento posterior. Esto permite crear una representación detallada de las series temporales, en la que cada ráfaga de actividad contiene información significativa sobre el estado del sistema.
A continuación, unos bloques especializados que imitan los mecanismos biológicos se encargan de transmitir e integrar estas señales. Ofrecen flexibilidad a la hora de trabajar con distintos tipos de datos y sientan las bases para crear una estructura analítica de varios niveles.
En este punto, merece la pena analizar más detenidamente un elemento importante de la arquitectura: el mecanismo de codificación de las señales en impulsos. En el caso de las series temporales financieras, esta tarea resulta especialmente compleja: no basta con registrar simplemente los valores de los precios o los volúmenes; también es necesario transformarlos a un formato en el que cada impulso refleje un cambio significativo en los datos. Los autores proponen varias estrategias de codificación. Desde un enfoque sencillo basado en umbrales —en el que se produce un impulso cuando se supera un valor crítico— hasta esquemas más complejos que tienen en cuenta la tasa de variación y el contexto de los eventos anteriores. Esta amplia variedad de métodos hace que el modelo sea versátil. Puede funcionar igual de bien con datos de alta frecuencia, en los que cada milisegundo cuenta, que con gráficos diarios más tranquilos, en los que lo que más importa es la tendencia general.
El siguiente bloque clave lo constituyen los integradores. Se encargan de acumular y sumar los impulsos entrantes, determinando el momento en que una neurona se activa. Desde el punto de vista de los mercados financieros, esto es similar a un mecanismo de filtrado de ruido: muchas pequeñas fluctuaciones pueden ignorarse, pero su efecto acumulativo, una vez que alcanza un umbral determinado, desencadena una respuesta del modelo. Este principio permite que el modelo mantenga un equilibrio entre sensibilidad y estabilidad, lo cual resulta especialmente valioso ante el ruido de mercado.
Los autores del marco de trabajo propusieron un modelo en el que la organización híbrida de las capas desempeña un papel fundamental. Algunas de ellas se especializan en identificar patrones a corto plazo, captando las rápidas fluctuaciones del mercado. Otras se centran en integrar las señales en un horizonte temporal más amplio, lo que permite generar previsiones más estables. Esta combinación dota al sistema de una especie de visión dual. Es capaz tanto de captar los detalles más sutiles del momento presente como de mantener una perspectiva estratégica. Para los mercados financieros, esto equivale a poder ver tanto el movimiento de la manecilla de los segundos de un cronómetro como el ritmo general del péndulo que determina el paso del tiempo.
Los módulos encargados de la normalización y la estabilidad de la red constituyen una parte importante de la arquitectura. A diferencia de las redes neuronales tradicionales, en las que el equilibrio se consigue mediante exhaustivos procedimientos de regularización, SpikingBrain utiliza mecanismos más sutiles inherentes a la propia naturaleza de las señales de impulsos. Estos mecanismos están diseñados para mejorar la estabilidad de la red ante datos ruidosos, procurando mantener su capacidad predictiva. En el mercado financiero, es difícil exagerar la importancia de esta cualidad: al fin y al cabo, el caos es su compañero inseparable, y la capacidad de identificar patrones ocultos en él determina el éxito de cualquier modelo.
También cabe destacar la modularidad de la arquitectura propuesta. Los autores han establecido una serie de principios que permiten ampliar el modelo tanto en amplitud como en profundidad, combinar elementos de impulsos con bloques tradicionales de aprendizaje profundo y desarrollar soluciones híbridas. Esta síntesis abre aún más posibilidades para su aplicación en el ámbito financiero. Por ejemplo, es posible construir modelos en los que los mecanismos de impulsos se encarguen de procesar señales basadas en eventos, mientras que los bloques clásicos se ocupen de las previsiones a largo plazo o del análisis de información textual. El resultado es una herramienta versátil en la que cada parte del sistema desempeña una función específica y todas ellas, en conjunto, forman un mecanismo integral para analizar un entorno de mercado complejo.
A continuación se muestra la representación que hacen los autores del marco de trabajo SpikingBrain.
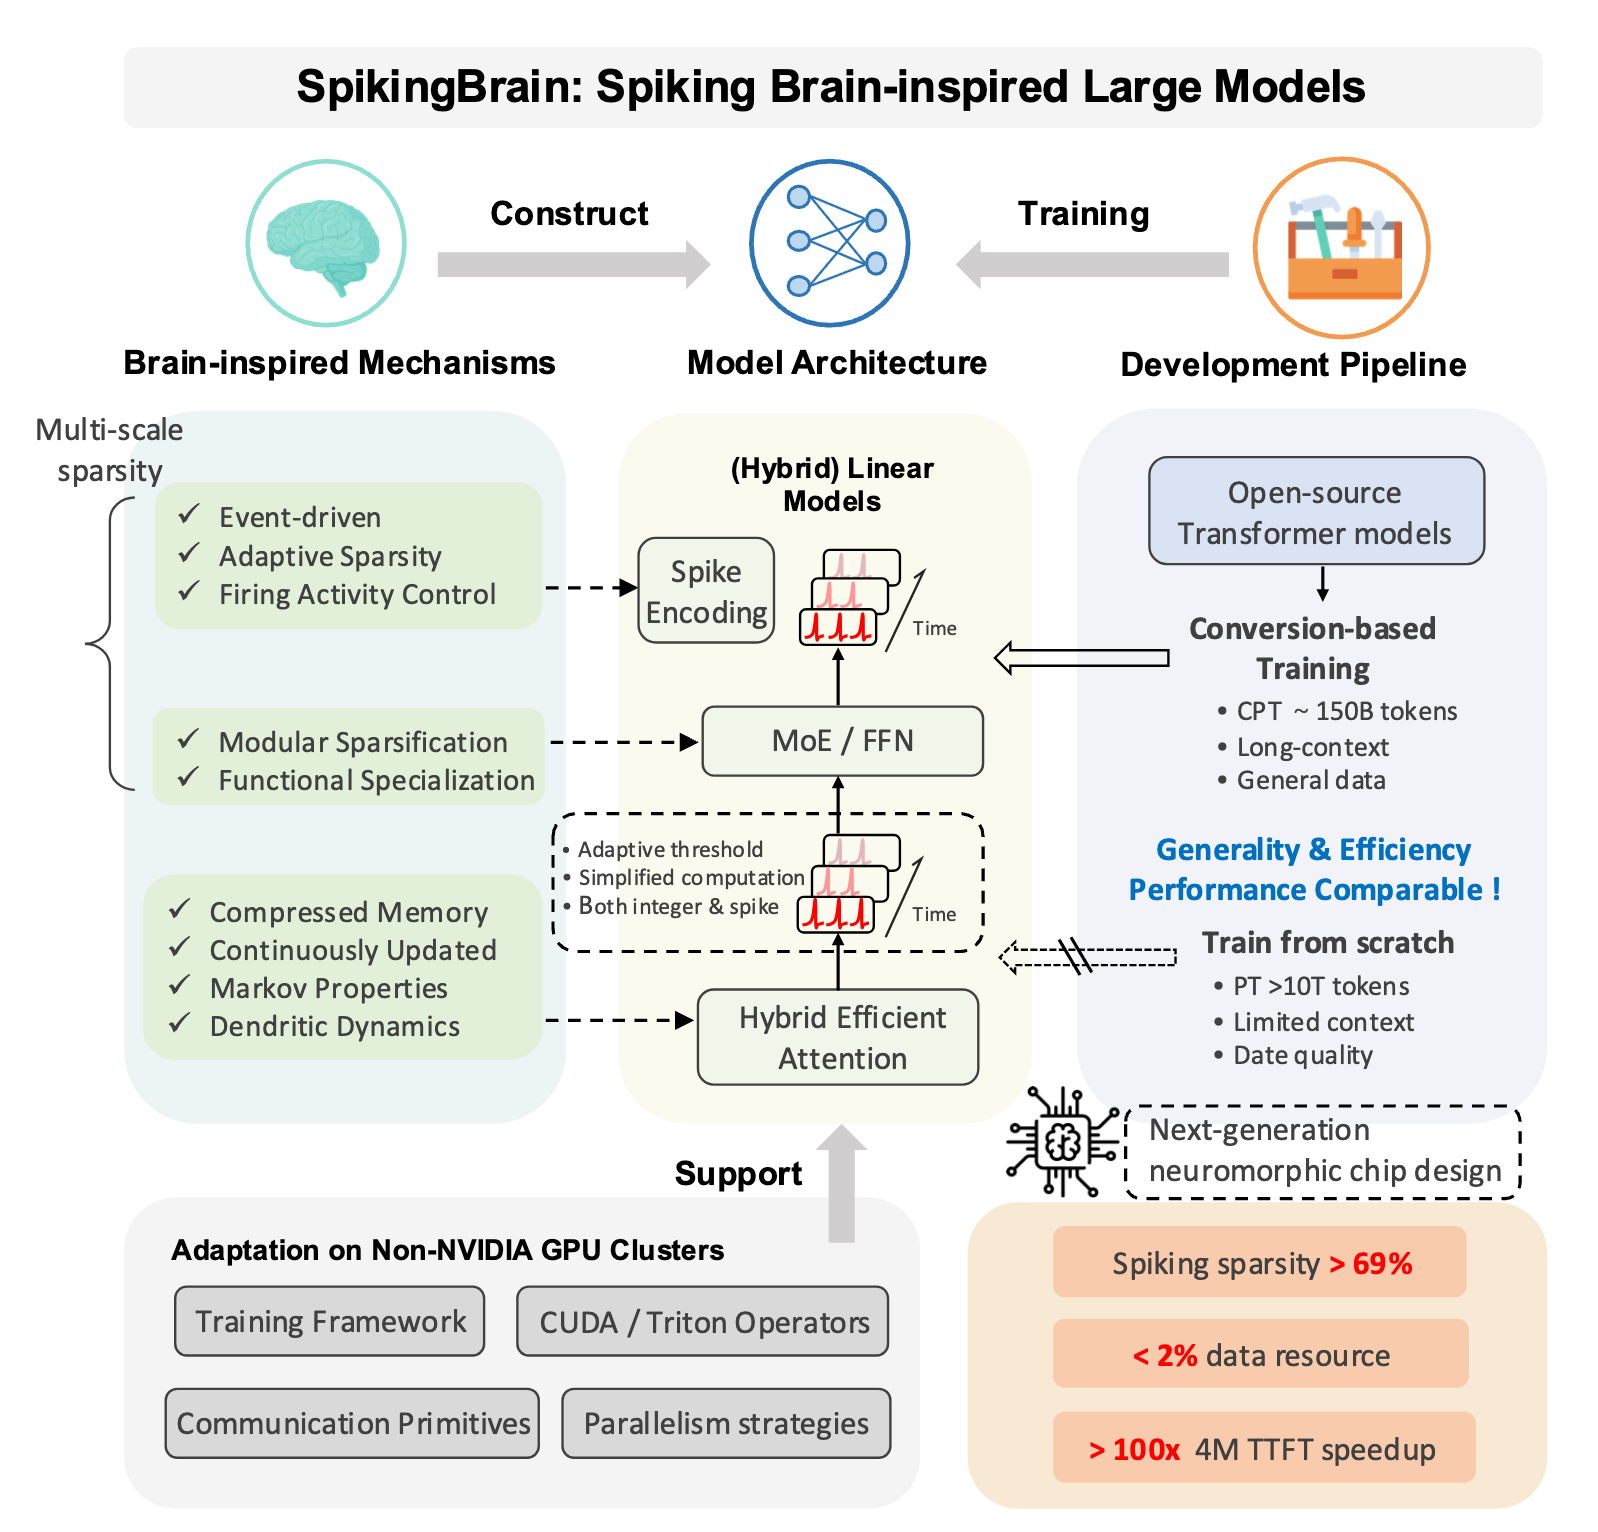
En la sección práctica del artículo anterior, nos centramos en sentar las bases necesarias para trasladar las ideas de SpikingBrain al entorno MQL5. Era importante demostrar cómo los principios teóricos pueden plasmarse en algoritmos concretos, capaces de procesar datos reales de mercado. Empezamos implementando un componente básico que convierte una señal continua en un impulso discreto. Esto allanó el camino para pasar de una idea abstracta a una herramienta capaz de funcionar en una plataforma de negociación muy popular. Este trabajo supuso el primer paso hacia la creación de un sistema completo en el que las innovaciones de los autores del marco de trabajo se pongan en práctica en un entorno de mercado real.
Ya hemos marcado el rumbo y sentado las bases; ahora pasaremos a un análisis más detallado de la arquitectura y los principios de funcionamiento del modelo.
Análisis de la implementación
Antes de pasar a la implementación de los enfoques propuestos, conviene esbozar los principios fundamentales de nuestro trabajo. Los autores del marco de trabajo utilizan modelos preentrenados basados en el Transformer estándar, y este es un detalle importante. Este enfoque nos permite evitar dedicar recursos al entrenamiento desde cero y, en su lugar, aprovechar directamente la experiencia acumulada de arquitecturas que han demostrado su eficacia. Por consiguiente, en nuestra implementación también podemos utilizar algoritmos y módulos ya desarrollados, lo que hace que el proceso sea más fiable y flexible.
El concepto de los módulos de atención híbridos resulta especialmente interesante. Los autores proponen combinar diferentes enfoques arquitectónicos en un único sistema; por ejemplo, utilizando en paralelo la atención lineal, la atención por ventanas o la atención completa. En cierto modo, esto se asemeja a los principios aplicados en el marco de trabajo Extralonger, donde la atención global-local se ha convertido en la base para un análisis más profundo de las relaciones temporales y espaciales.
No obstante, las aplicaciones financieras presentan características particulares que deben tenerse muy en cuenta a la hora de elegir una arquitectura. Por lo tanto, la atención por ventanas —que ha demostrado su eficacia en diversas aplicaciones— no siempre es, ni mucho menos, la herramienta óptima para analizar series temporales de mercado. Por un lado, los últimos valores de cotización reflejan la tendencia emergente, pero, por otro lado, es precisamente ahí donde se concentra el mayor nivel de ruido. Las señales más significativas que influyen en las tendencias a largo plazo no siempre se encuentran, ni mucho menos, en los datos más recientes de una serie temporal. A menudo, estas señales están más separadas en el tiempo y se manifiestan como dependencias dispersas; el simple hecho de ampliar la ventana de análisis no siempre resuelve el problema. Cuanto más amplia sea la ventana, más recursos computacionales se dedican a procesar el ruido en lugar de a identificar patrones útiles. Como consecuencia, la carga computacional del modelo aumenta, mientras que la calidad de la previsión no mejora necesariamente.
Por lo tanto, a la hora de desarrollar modelos para los mercados financieros, es preferible utilizar mecanismos de atención más adaptativos. Su tarea consiste en descartar lo superfluo e identificar señales poco frecuentes pero verdaderamente valiosas. Son precisamente estas señales las que a menudo resultan decisivas en los cambios de tendencia del mercado y permiten a los modelos generar previsiones de relevancia práctica.
En este sentido, la idea de atención dispersa basada en grafones parece especialmente interesante. Este enfoque nos permite no solo ampliar mecánicamente la ventana de análisis, sino también estructurar las relaciones entre los elementos de la serie temporal y, con ello, identificar las dependencias clave de manera más eficiente. En esencia, los grafones definen un marco de trabajo sobre el que la atención se extiende únicamente en aquellas direcciones en las que existen correlaciones reales y señales significativas. Esto reduce la carga sobre el modelo y permite centrar los recursos en las áreas de datos que realmente importan.
Además, el uso de grafones encaja a la perfección con la visión de los autores del marco de trabajo de implementar algoritmos como la mezcla de expertos (MoE). La estructura de atención dispersa y la arquitectura modular MoE se refuerzan mutuamente. Los grafones definen las rutas de interacción, mientras que MoE permite la activación selectiva de los bloques expertos más adecuados. El resultado es un sistema que puede llegar a gestionar series temporales financieras con ruido de forma más eficaz y adaptarse con flexibilidad a las características actuales del mercado.
De hecho, es precisamente la idea de combinar mecanismos de procesamiento de señales biológicamente plausibles con la flexibilidad arquitectónica de las redes neuronales modernas lo que constituye la esencia de SpikingBrain. Los autores del marco de trabajo proponen una solución original que va más allá de las arquitecturas tradicionales recurrentes o basadas en Transformer. Toman como base un modelo de neurona de impulsos, en el que la información se transmite mediante impulsos discretos y el aprendizaje está vinculado a la dinámica de las interacciones a lo largo del tiempo. Este enfoque se ajusta mejor al funcionamiento del cerebro humano y abre nuevas posibilidades para un procesamiento de datos más matizado y eficiente.
Además, resulta de especial interés la interpretación del módulo de atención lineal propuesta por los autores. En uno de nuestros proyectos anteriores, ya habíamos implementado un objeto de atención lineal y estamos muy familiarizados con sus capacidades. Sin embargo, los autores del marco de trabajo propusieron una opción más flexible. La atención lineal se implementa como un bloque recurrente con compuertas añadidas, lo que permite ampliar significativamente el alcance de la atención sin que ello suponga un aumento sustancial del coste computacional.
En esta versión, el estado de atención se calcula de forma recurrente. En cada paso se acumula información del estado anterior, ponderándola mediante compuertas, y se añaden nuevas interacciones entre claves y valores.
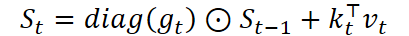
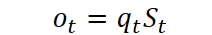
donde St es la matriz de estado acumulada, gt es el vector de compuerta, kt y vt son las claves y los valores en el paso actual, y qt es la consulta. Esta estructura permite conservar la información sobre las dependencias a largo alcance y, al mismo tiempo, controlar su relevancia mediante compuertas.
Desde el punto de vista del análisis financiero, esta solución resulta especialmente valiosa. Permite tener en cuenta eventos separados en el tiempo sin sobrecargar el modelo con señales y ruido innecesarios. Cuando se combina con la atención dispersa basada en grafones y la arquitectura MoE, la atención lineal recurrente se convierte en una potente herramienta para generar previsiones adaptativas capaces de identificar tendencias clave y responder a las condiciones del mercado en rápida evolución.
Los autores del marco de trabajo SpikingBrain proponen dos enfoques principales para el uso de la atención híbrida: el secuencial y el paralelo. La variante secuencial consiste en el uso de una pila de capas de atención con diferentes arquitecturas, con bloques de tipo MoE insertados entre ellas para que actúen como módulos FeedForward. Este enfoque permite que el modelo procese señales de diferentes tipos de forma secuencial, al tiempo que mantiene la flexibilidad estructural y la capacidad de activar selectivamente los expertos.
La mezcla paralela, por su parte, consiste en el uso simultáneo de diferentes bloques de atención dentro de una misma capa. A continuación, el resultado combinado se envía a un único bloque MoE para su procesamiento, lo que garantiza la integración de la información desde diferentes perspectivas. Además, incluso en una arquitectura paralela, es posible combinar diferentes módulos de atención entre las capas del modelo. El modelo ofrece la máxima flexibilidad, lo que permite adaptar la estructura de atención a las características específicas de los datos.
Desde la perspectiva de los mercados financieros, este enfoque resulta especialmente atractivo. Se pueden procesar simultáneamente diferentes fuentes de información, horizontes temporales y tipos de señales, sin que por ello el sistema deje de ser manejable y eficiente. Cuando se combinan con la atención dispersa basada en grafones y los bloques de atención lineal recurrente, los modos híbridos permiten construir modelos complejos capaces de captar tanto las fluctuaciones locales afectadas por el ruido como las tendencias globales del mercado.
Módulo de atención lineal con compuertas
Hoy comenzaremos nuestro trabajo práctico implementando un bloque de atención lineal recurrente con compuertas como un nuevo objeto denominado CNeuronGateLineAttention. Este objeto se crea como un módulo especializado dentro de la arquitectura SpikingBrain y hereda su funcionalidad básica de CNeuronSpikeConv. Esta herencia facilita la integración del objeto en la infraestructura existente de objetos neuronales de impulsos, permite aprovechar la dinámica de impulsos y la acumulación recurrente de información, y permite utilizar el cálculo paralelo a través de OpenCL para acelerar el procesamiento de datos.
Esta solución combina lo mejor de ambos mundos. Dentro del objeto se utiliza una variante de atención lineal multicabeza con valores continuos, diseñada para captar señales relevantes y dependencias a largo alcance. Al mismo tiempo, los algoritmos de la clase base reducen la dimensionalidad de la salida de la atención multicabeza a la dimensionalidad original de los datos y convierten los valores resultantes en impulsos discretos. De este modo, el modelo conserva la precisión del análisis continuo y, al mismo tiempo, adquiere la capacidad de funcionar en el marco de una dinámica de impulsos basada en eventos, lo cual resulta especialmente importante para el procesamiento de series temporales financieras ruidosas y dispersas.
A continuación se muestra la estructura del nuevo objeto.
class CNeuronGateLineAttention  :  public CNeuronSpikeConv
  {
protected:
   uint              iDimensionK;
   uint              iVariables;
   uint              iHeads;
   //---
   CNeuronConvOCL    cQKV;
   CNeuronBaseOCL    cQ;
   CNeuronBaseOCL    cK;
   CNeuronBaseOCL    cV;
   CNeuronBaseOCL    cKV;
   CNeuronConvOCL    cGate;
   CNeuronBaseOCL    cState;
   CNeuronBaseOCL    cMHAttention;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronGateLineAttention(void) {};
                    ~CNeuronGateLineAttention(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint variables, uint dimension, uint dimension_k, uint heads,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override const  {  return defNeuroneGateLineAttention;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   virtual void      SetOpenCL(COpenCLMy *obj)   override;
   virtual bool      Clear(void) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual uint      GetVariables(void) const { return iVariables; }
  };
El objeto contiene variables para almacenar los parámetros clave de su arquitectura:
- iDimensionK especifica la dimensionalidad de las claves, lo que determina la cantidad de información almacenada en cada cabeza de atención;
- iVariables almacena el número de variables que se están analizando para el procesamiento de señales;
- iHeads especifica el número de cabezas de atención paralelas, lo que permite el análisis multicanal de una serie temporal.
Las consultas, las claves y los valores se procesan mediante una combinación de objetos CNeuronBaseOCL y CNeuronConvOCL. El objeto cQKV desempeña un papel especial en este contexto, ya que genera simultáneamente todos los componentes de la atención multicabeza. A continuación, el resultado unificado se divide en tres tensores (q, k y v) para realizar las operaciones matemáticas que intervienen en la atención. Este enfoque permite generar simultáneamente todos los componentes necesarios, acelera los cálculos de la GPU y reduce la carga sobre el procesador central, al tiempo que mantiene la precisión del análisis multicabeza.
Todos los componentes internos de nuestro objeto CNeuronGateLineAttention se declaran de forma estática, por lo que el constructor y el destructor de la clase permanecen vacíos. El bloque se inicializa por completo en el método Init, que establece los parámetros de funcionamiento del objeto, conecta el núcleo de cálculo de OpenCL y configura los componentes internos.
bool CNeuronGateLineAttention::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                    uint variables, uint dimension, uint dimension_k, uint heads,
                                    ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronSpikeConv::Init(numOutputs, myIndex, open_cl, heads * dimension_k, heads * dimension_k,
                                                  dimension, 1, variables, optimization_type, batch))
      return false;
El algoritmo del método comienza cediendo el control a la clase base, CNeuronSpikeConv. Esto define la estructura básica del objeto. Este enfoque garantiza la coherencia en la configuración y permite utilizar algoritmos de procesamiento y de cálculo paralelo de probada eficacia que ya se han implementado en la clase base.
Además, como se ha mencionado anteriormente, la clase base proporciona mecanismos para combinar los resultados de la atención multicabeza en una única señal final, lo que se refleja en los parámetros que se pasan y facilita la integración de un nuevo objeto en la arquitectura general del modelo.
Una vez completada con éxito la inicialización de la clase base, guardamos los parámetros específicos del objeto: la dimensionalidad de la clave iDimensionK, el número de cabezas de atención iHeads y el número de variables que se están analizando iVariables.
   iDimensionK = dimension_k;
   iHeads = heads;
   iVariables = variables;
Estos parámetros determinan la escala de la atención multicabeza y la estructura de los tensores que acumularán y transmitirán información dentro del bloque.
A continuación, pasamos a la inicialización de los componentes internos. El primer objeto que inicializamos es cQKV. Genera simultáneamente los tres componentes de la atención multicabeza: las consultas q, las claves k y los valores v.
   int index = 0;
   if(!cQKV.Init(0, index, OpenCL, dimension, dimension, 3*iHeads*iDimensionK, 1, iVariables, optimization, iBatch))
      return false;
   cQKV.SetActivationFunction(SIGMOID);
Este enfoque agiliza los cálculos, asigna de forma eficiente los recursos de la GPU y garantiza la construcción precisa de todos los componentes de la atención multicabeza. En el caso de cQKV, se especifica una función de activación sigmoide, que modula suavemente la señal de entrada y la prepara para el procesamiento recurrente.
A continuación, se inicializan los objetos cQ, cK y cV.
   index++;
   if(!cQ.Init(0, index, OpenCL, iHeads * iDimensionK * iVariables, optimization, iBatch))
      return false;
   cQ.SetActivationFunction(None);
   index++;
   if(!cK.Init(0, index, OpenCL, cQ.Neurons(), optimization, iBatch))
      return false;
   cK.SetActivationFunction(None);
   index++;
   if(!cV.Init(0, index, OpenCL, cQ.Neurons(), optimization, iBatch))
      return false;
   cV.SetActivationFunction(None);
Estos objetos están diseñados para almacenar los tensores correspondientes y se utilizan en operaciones de multiplicación matricial. Aquí no se utilizan funciones de activación.
El siguiente componente clave es cKV. Está diseñado para almacenar los resultados de la multiplicación matricial de los tensores de clave y de valor.
   index++;
   if(!cKV.Init(0, index, OpenCL, cQ.Neurons()*iDimensionK, optimization, iBatch))
      return false;
   cKV.SetActivationFunction(None);
Como resultado, el objeto acumula la información necesaria para calcular la atención y la transmite a las etapas de procesamiento posteriores.
El objeto cGate se encarga de implementar el componente de compuertas de la atención recurrente. Mediante una función de activación sigmoide, controla dinámicamente qué parte del estado anterior se conserva y cómo se combina con los datos de entrada actuales.
   index++;
   if(!cGate.Init(0, index, OpenCL, dimension, dimension, iDimensionK * iHeads, 1, iVariables, optimization, iBatch))
      return false;
   cGate.SetActivationFunction(SIGMOID);
Esto reviste una importancia fundamental en el caso de las series temporales financieras, en las que las señales pueden ser dispersas y ruidosas: el mecanismo de compuertas permite filtrar las fluctuaciones irrelevantes y conservar la información significativa de los pasos anteriores.
El objeto cState acumula el estado de atención anterior, lo que permite el procesamiento recurrente. Almacena los datos acumulados sobre las dependencias clave a lo largo del tiempo, que luego se utilizan para generar el resultado final del bloque.
   index++;
   if(!cState.Init(0, index, OpenCL, cKV.Neurons(), optimization, iBatch))
      return false;
   cState.SetActivationFunction(None);
En combinación con cKV y cGate, esto permite implementar una atención lineal recurrente con compuertas, capaz de tener en cuenta tanto las fluctuaciones locales a corto plazo del mercado como las tendencias globales, lo que garantiza la identificación precisa de señales significativas.
cMHAttention completa la configuración interna. Almacena los resultados de las diferentes cabezas de atención. Posteriormente, la clase base CNeuronSpikeConv combina estos resultados y genera la salida final del bloque.
   index++;
   if(!cMHAttention.Init(0, index, OpenCL, cQ.Neurons(), optimization, iBatch))
      return false;
   cMHAttention.SetActivationFunction(None);
//---
   return true;
  }
El método Init comprueba minuciosamente si cada componente se ha inicializado correctamente y devuelve false si falla algún paso. De este modo, se crea un objeto plenamente operativo capaz de procesar de forma eficiente series temporales financieras, combinando la precisión de la atención multicabeza continua con las ventajas de la dinámica discreta de impulsos y la acumulación recurrente de información.
Una vez inicializado el objeto, el siguiente paso es organizar la propagación hacia delante. Este proceso se implementa en el método feedForward, que se encarga del procesamiento secuencial de los datos de entrada, la acumulación recurrente del estado y la generación de los resultados de la atención multicabeza.
bool CNeuronGateLineAttention::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cQKV.FeedForward(NeuronOCL))
      return false;
En el primer paso, se invoca el método del mismo nombre del objeto cQKV. Aquí se crean los tensores combinados de consulta q, clave k y valor v para la atención multicabeza. Este enfoque agiliza los cálculos, ya que las tres entidades se generan simultáneamente, y la posterior separación en tensores individuales permite realizar operaciones de atención estándar.
A continuación, se invoca el método FeedForward del objeto cGate, lo que genera las señales de la compuerta.
   if(!cGate.FeedForward(NeuronOCL))
      return false;
El mecanismo de compuertas regula qué parte de la información del estado anterior se conserva. Posteriormente, al estado ponderado se le añade la nueva información obtenida a partir de las claves y los valores de la entrada actual. Esto es especialmente importante en el caso de las series temporales financieras, en las que las señales pueden ser dispersas y ruidosas: las compuertas ayudan a filtrar las fluctuaciones debidas al ruido y a conservar los patrones significativos.
El siguiente paso consiste en dividir la salida combinada de cQKV en tres tensores independientes mediante la función DeConcat.
   if(!DeConcat(cQ.getOutput(), cK.getOutput(), cV.getOutput(), cQKV.getOutput(),
                     iDimensionK, iDimensionK, iDimensionK, iHeads * iVariables))
      return false;
A continuación, se realiza la multiplicación matricial de las claves por los valores mediante MatMul. El resultado se almacena en el objeto cKV, que acumula información para la acumulación recurrente del estado, lo que garantiza un almacenamiento eficiente de los datos para los cálculos posteriores.
   if(!MatMul(cK.getOutput(), cV.getOutput(), cKV.getOutput(), iDimensionK, 1,
                                      iDimensionK, iHeads * iVariables, true))
      return false;
Las actualizaciones recurrentes del estado se realizan en el objeto cState. En primer lugar, se invoca SwapOutputs para guardar los valores de la propagación hacia delante anterior.
   if(!cState.SwapOutputs())
      return false;
   if(!DiagMatMul(cGate.getOutput(), cState.getPrevOutput(), cState.getOutput(),
              iDimensionK, iDimensionK, iHeads * iVariables, cState.Activation()))
      return false;
   if(!SumAndNormilize(cState.getOutput(), cKV.getOutput(), cState.getOutput(),
                                                  iDimensionK, false, 0, 0, 0, 1))
      return false;
A continuación, se aplica DiagMatMul utilizando las salidas de las compuertas y el estado anterior. En este paso, se establece el nuevo estado actual del bloque. A continuación, el resultado se suma a los resultados de cKV. Estas operaciones aíslan las señales significativas y atenúan el ruido, lo que garantiza que la información se represente con precisión para el siguiente paso.
El último paso consiste en realizar la multiplicación matricial de la consulta cQ por el estado actualizado cState, lo que genera la salida final de la atención multicabeza en el objeto cMHAttention.
   if(!MatMul(cQ.getOutput(), cState.getOutput(), cMHAttention.getOutput(), 1,
                          iDimensionK, iDimensionK, iVariables * iHeads, true))
      return false;
Este resultado se pasa a la clase base CNeuronSpikeConv para generar impulsos discretos.
   if(!CNeuronSpikeConv::FeedForward(cMHAttention.AsObject()))
      return false;
//---
   return true;
  }
Como resultado, los cálculos continuos de atención se transforman en eventos que pueden utilizarse en la dinámica de impulsos y en la posterior previsión de las tendencias del mercado.
En conjunto, el método feedForward crea un flujo de datos coherente: generación de tensores, regulación mediante compuertas, acumulación recurrente del estado y agregación mediante atención multicabeza. Este enfoque permite que el modelo funcione de manera eficaz con series temporales financieras, teniendo en cuenta las fluctuaciones a corto plazo y las dependencias a largo alcance, y que genere señales precisas para pronosticar las tendencias del mercado.
En este caso, hemos optado deliberadamente por no incluir las conexiones residuales típicas de la arquitectura estándar Transformer. Esto se debe a que tenemos previsto utilizar varios módulos de atención en paralelo. La presencia de una conexión residual independiente en cada uno de ellos podría desplazar el énfasis hacia los datos de entrada y debilitar la influencia de las señales extraídas. Para eliminar este efecto, proporcionamos una única ruta compartida para las conexiones residuales entre todos los módulos de atención dentro de una misma capa del modelo, lo que ayuda a mantener un equilibrio entre el análisis de los datos brutos y el aprendizaje a partir de los patrones identificados.
Sin embargo, la propagación hacia delante es solo la mitad del camino. Para entrenar el modelo, es necesario distribuir correctamente el error de predicción entre todos los componentes que intervienen en el proceso, en función de su influencia en el resultado final. En el objeto CNeuronGateLineAttention, este mecanismo se implementa en el método calcInputGradients, que lleva a cabo la retropropagación y calcula los gradientes de todos los componentes internos.
bool CNeuronGateLineAttention::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
//---
   if(!CNeuronSpikeConv::calcInputGradients(cMHAttention.AsObject()))
      return false;
En el primer paso, el método comprueba que el puntero al objeto de datos de origen NeuronOCL sea válido. A continuación, se invoca el método homónimo de la clase base, pasándole un puntero al objeto cMHAttention, con el fin de propagar los gradientes recibidos de los objetos posteriores del modelo al mecanismo de atención multicabeza, distribuyendo así la contribución de cada cabeza al resultado global.
El siguiente paso consiste en calcular los gradientes para la consulta cQ y el estado acumulado cState. El método MatMulGrad distribuye el error de forma proporcional a la influencia de cada señal de entrada en el resultado final de la atención multicabeza.
   if(!MatMulGrad(cQ.getOutput(), cQ.getGradient(),
                  cState.getOutput(), cState.getGradient(),
                  cMHAttention.getGradient(), 1, iDimensionK,
                  iDimensionK, iVariables * iHeads, true))
      return false;
A continuación, los gradientes se pasan al objeto cKV, ajustando los valores según la función de activación.
   if(!DeActivation(cKV.getOutput(), cKV.getGradient(), cState.getGradient(), cKV.Activation()))
      return false;
Se presta especial atención al componente de compuertas. El método DiagMatMulGrad distribuye el error entre la salida de la compuerta cGate y el estado anterior cState.
   if(!DiagMatMulGrad(cGate.getOutput(), cGate.getGradient(),
                      cState.getPrevOutput(), cKV.getPrevOutput(),
                      cState.getGradient(), iDimensionK, iDimensionK,
                      iHeads * iVariables))
      return false;
   Deactivation(cGate)
A continuación, se aplica la derivada de la función de activación del bloque de compuertas para ajustar correctamente sus gradientes durante la retropropagación.
Los gradientes de las claves cK y los valores cV se calculan mediante MatMulGrad.
   if(!MatMulGrad(cK.getOutput(), cK.getGradient(),
                  cV.getOutput(), cV.getGradient(),
                  cKV.getGradient(), iDimensionK, 1,
                  iDimensionK, iHeads * iVariables, true))
      return false;
A continuación, todos los gradientes (cQ, cK, cV) se vuelven a combinar en un único tensor, cQKV, mediante la función Concat.
   if(!Concat(cQ.getGradient(), cK.getGradient(), cV.getGradient(), cQKV.getGradient(),
              iDimensionK, iDimensionK, iDimensionK, iHeads * iVariables))
      return false;
   Deactivation(cQKV)
Esto nos permite mantener la coherencia de los gradientes y distribuir correctamente el error entre los componentes de la atención multicabeza.
A continuación, debemos devolver los gradientes de error al nivel de los datos de entrada. Aquí, transmitimos valores a través de dos flujos de datos. En primer lugar, pasamos los valores del objeto cQKV.
   if(!NeuronOCL.CalcHiddenGradients(cQKV.AsObject()))
      return false;
A continuación, el puntero al búfer de gradientes se sustituye temporalmente para conservar los valores obtenidos anteriormente.
   CBufferFloat* temp = NeuronOCL.getGradient();
   if(!NeuronOCL.SetGradient(PrevOutput, false))
      return false;
A continuación, se transfieren los datos desde el objeto de compuerta cGate y se suman los valores de los dos flujos de información.
   if(!NeuronOCL.CalcHiddenGradients(cGate.AsObject()))
      return false;
   if(!SumAndNormilize(PrevOutput, temp, temp, GetFilters(), false, 0, 0, 0, 1))
      return false;
   if(!NeuronOCL.SetGradient(temp, false))
      return false;
//---
   return true;
  }
Por último, se restaura el búfer de gradientes original de NeuronOCL, de modo que el objeto quede preparado para la posterior fase de actualización de pesos.
De este modo, el método calcInputGradients establece un flujo completo de propagación de errores desde la atención multicabeza final hasta cada componente interno. Esto garantiza un entrenamiento adecuado de la atención lineal recurrente con compuertas y permite que el modelo se adapte de forma eficaz a las series temporales financieras, teniendo en cuenta tanto las fluctuaciones locales como las tendencias globales del mercado.
El último paso a la hora de trabajar con el objeto CNeuronGateLineAttention consiste en optimizar los parámetros del modelo, lo cual se lleva a cabo en el método updateInputWeights. Aquí es donde se actualizan los pesos de todos los componentes internos que contienen parámetros entrenables.
bool CNeuronGateLineAttention::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cQKV.UpdateInputWeights(NeuronOCL))
      return false;
   if(!cGate.UpdateInputWeights(NeuronOCL))
      return false;
   if(!CNeuronSpikeConv::updateInputWeights(cMHAttention.AsObject()))
      return false;
//---
   return true;
  }
El método pasa el control de forma secuencial a los objetos cQKV y cGate, actualizando sus pesos en función de los gradientes acumulados. A continuación, se pasa el control a la clase base para actualizar los parámetros del bloque de agregación de resultados de la atención multicabeza.
Cabe señalar que hay pocos parámetros entrenables dentro de CNeuronGateLineAttention, por lo que el método se limita a realizar una transferencia de control cuidadosa y secuencial entre los componentes. No obstante, este paso reviste una importancia fundamental: es aquí donde el modelo se adapta a las series temporales financieras, ajustando los pesos para predecir con precisión las tendencias y reconocer eficazmente las señales significativas.
Con esto concluimos nuestro trabajo con la clase CNeuronGateLineAttention. El código completo, junto con todos los métodos, se incluye en el archivo adjunto a este artículo.
Hoy hemos realizado un trabajo minucioso y exhaustivo, desglosando e implementando de forma sistemática los componentes clave de la atención lineal recurrente con compuertas. Es hora de tomarnos un breve descanso y dejar que se asienten las ideas. En el próximo artículo, continuaremos con nuestro trabajo y llevaremos la implementación hasta su conclusión lógica. Entrenaremos el modelo y comprobaremos su eficacia utilizando datos históricos reales de los mercados financieros.
Conclusión
En este artículo, hemos analizado e implementado en detalle un bloque de atención lineal recurrente con compuertas dentro del objeto CNeuronGateLineAttention. Paso a paso, hemos ido avanzando desde la inicialización y la generación de tensores hasta la propagación hacia delante, la retropropagación de errores y la optimización de pesos, demostrando cómo cada componente influye en el procesamiento de las series temporales financieras.
Se prestó especial atención a las decisiones arquitectónicas: la regulación mediante compuertas, la acumulación recurrente del estado, la combinación de atención multicabeza y una ruta de conexión residual unificada para todos los módulos de la capa. Todo ello da lugar a un mecanismo capaz de identificar señales significativas, filtrar el ruido y tener en cuenta tanto las fluctuaciones del mercado a corto plazo como las tendencias a largo plazo.
Hoy hemos sentado unas bases sólidas para el funcionamiento práctico del modelo. En el próximo artículo, continuaremos por este camino y pasaremos a las fases de entrenamiento y pruebas de la implementación con datos históricos reales. Esto permitirá evaluar el comportamiento de los enfoques propuestos utilizando datos históricos de mercado y analizar en qué medida contribuyen a mejorar la precisión de las previsiones.
Enlaces
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | Study.mq5 | Asesor experto | Asesor experto para el entrenamiento del modelo fuera de línea |
| 2 | StudyOnline.mq5 | Asesor experto | Asesor experto para el entrenamiento del modelo en línea |
| 3 | Test.mq5 | Asesor experto | Asesor experto para las pruebas del modelo |
| 4 | Trajectory.mqh | Biblioteca de clases | Estructura para describir el estado del sistema y la arquitectura del modelo |
| 5 | NeuroNet.mqh | Biblioteca de clases | Biblioteca de clases para crear una red neuronal |
| 6 | NeuroNet.cl | Biblioteca | Biblioteca de código para un programa OpenCL |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19762
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.


Se ha publicado el artículo «Redes neuronales en el trading: de los transformadores a las neuronas de impulsos (componentes básicos)» :
Autor: Dmitry Gizlyk