

Desarrollo de asesores expertos autooptimizables en MQL5 (Parte 11): Una introducción sencilla a los fundamentos del álgebra lineal
 21
 0

En nuestra introducción a la factorización de matrices, analizamos las numerosas ventajas que ofrece el uso de los comandos de álgebra lineal disponibles en la API de MQL5. En ese análisis inicial se daba por hecho que el lector contaba con ciertos conocimientos previos, concretamente, una comprensión básica de la modelización de series temporales y del análisis estadístico. Sin embargo, visto en retrospectiva, queda claro que es posible que esta suposición no sea válida para todos los lectores.
Si es la primera vez que te enfrentas a este tipo de temas, es posible que el artículo introductorio no te haya resultado tan útil como se pretendía. El contenido avanzaba rápidamente, y se presentaban muchos conceptos uno tras otro. Por lo tanto, en este artículo pretendo centrarme en aquellos lectores que no tengan absolutamente ninguna experiencia previa en las técnicas matemáticas que se van a presentar.
Presentaré estas técnicas desde una perspectiva que no requiere conocimientos previos, asegurándome de que todos los lectores puedan seguir la explicación y apreciar el valor de la API de matrices y vectores. La API de matrices y vectores que ofrece MQL5 es, sin duda, muy potente, pero por sí sola no es suficiente. No funciona de forma independiente. Solo si comprendemos los principios del álgebra lineal podremos hacer un uso inteligente y eficaz de esta API.
Este artículo servirá de puente para los lectores que no tengan formación matemática formal. Adoptaremos un estilo de enseñanza comparativo: empezaré mostrando un código que podría escribir un desarrollador de MQL5 sin conocimientos de álgebra lineal y, a continuación, lo compararé con el código escrito por alguien que sí comprende los principios matemáticos subyacentes. Este enfoque comparativo permitirá que las ventajas del álgebra lineal se pongan de manifiesto de forma clara e intuitiva.
Todos los conceptos teóricos que se presenten estarán directamente relacionados con aplicaciones prácticas de trading, que mostraremos aquí mismo, en la plataforma MetaTrader 5. Utilizando datos reales del mercado, aplicaremos la teoría matemática de forma práctica, poniendo de manifiesto la versatilidad y el valor práctico de estos comandos de álgebra lineal.
Hoy construiremos un modelo estadístico que prediga varios objetivos a la vez. Por lo general, los modelos de regresión lineal se utilizan para pronosticar una única variable objetivo; por ejemplo, la evolución futura de los precios. Sin embargo, en este caso, nuestro objetivo es predecir cuatro variables diferentes:
- La media móvil futura del cierre
- La media móvil futura del máximo
- La media móvil futura del mínimo
- El valor futuro del precio
Incorporaremos estas previsiones a nuestra estrategia de negociación para definir tanto las reglas de entrada y salida, así como filtros para el cierre de posiciones. La API de matrices y vectores de MQL5 nos ofrece potentes herramientas para desarrollar aplicaciones modernas de aprendizaje automático. Sin embargo, para aprovechar todo el potencial de la API, es necesario comprender las reglas básicas del álgebra lineal que subyacen al uso adecuado de estos métodos específicos.
El álgebra lineal suele ser una disciplina matemática abstracta. Sin embargo, quiero que te hagas una idea más clara del tema para que puedas ver con claridad las ventajas de lo que vamos a tratar; después, abordaremos los aspectos matemáticos hacia la mitad de la explicación. Por último, una vez que haya quedado clara la motivación de nuestro análisis y se haya explicado toda la notación matemática necesaria, mostraremos un ejemplo de cómo utilizar el álgebra lineal para desarrollar algoritmos de negociación basados en datos numéricos, capaces de pronosticar varios objetivos al mismo tiempo.
Código fuente fácil de mantener
En la mayoría de los casos, cuando se trata de precios de mercado —como los datos de los precios de apertura, máximo, mínimo y cierre—, resulta útil almacenar estos datos en forma de matriz. En MQL5, las matrices se indexan primero por fila y luego por columna. Por lo tanto, empezamos definiendo una nueva matriz A, de 3 por 5 y inicializada con ceros. Esto significa que la matriz A tendrá tres filas y cinco columnas, y que, inicialmente, todos los elementos estarán establecidos en cero. A continuación, mostramos la matriz A en su estado actual, que, tal y como se muestra en la figura 1, está efectivamente llena de ceros.
//--- Let's first create an empty matrix
matrix A=matrix::Zeros(3,5);

//--- Peek at the matrix
Print("Original A matrix");
Print(A);
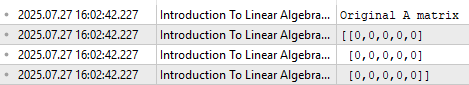
Figura 1: Visualización de nuestra matriz A vacía
A continuación, asignamos un valor a cada una de las filas: la primera fila se rellenará con valores constantes de uno, la segunda con valores de dos y la tercera con valores de tres.
Como puede observar el lector, la notación utilizada para acceder a los elementos de una matriz en MQL5 siempre comienza con el índice de fila, seguido del índice de columna entre corchetes, situado junto al identificador asociado a la matriz. Podemos volver a revisar la matriz A para confirmar que se ha rellenado correctamente; la figura 2 nos asegura que así es.
//--- The notation A[R,C] describes the Row and Column we want to manipulate
//--- We will set all the values in Row 1 to be 1
A[0,0] = 1;
A[0,1] = 1;
A[0,2] = 1;
A[0,3] = 1;
A[0,4] = 1;

//--- We will set all the values in Row 2 to be 2
A[1,0] = 2;
A[1,1] = 2;
A[1,2] = 2;
A[1,3] = 2;
A[1,4] = 2;

//--- We will set all the values in Row 3 to be 3
A[2,0] = 3;
A[2,1] = 3;
A[2,2] = 3;
A[2,3] = 3;
A[2,4] = 3;

Print("Current A matrix");
Print(A);
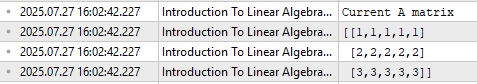
Figura 2: Etiquetado de las filas de nuestra matriz A para este ejercicio
Ahora, manipulemos los valores que hay dentro de nuestra matriz. Supongamos que queremos multiplicar por cinco todos los valores de la segunda fila de la matriz A. Una implementación sencilla podría consistir en crear un bucle «for» para recorrer cada entrada de la segunda fila, multiplicar cada una por cinco y almacenar el resultado. Como podemos ver, este enfoque logra el resultado deseado y superaría cualquier prueba funcional.
Sin embargo, ¿se le ocurren al lector razones por las que podríamos querer evitar el uso de un bucle «for» para esta tarea?
//--- Let's multiply all the values of Row 2 by 5 and leave all the other rows the same.

//--- Bad performing code
//--- Copy matrix A
matrix example_1;
example_1.Assign(A);

//--- Loop over matrix A and multiply each element by 5 and then replace the original elements
for(int i =0;i<5;i++)
{
   example_1[1,i] = example_1[1,i] * 5;
}

//--- Done
Print("Example 1: ");
Print(example_1);
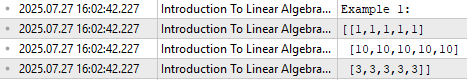
Figura 3: La manipulación de la matriz A mediante un bucle «for» puede resultar demasiado lenta a medida que A aumenta de tamaño
Consideremos un enfoque ligeramente mejorado. En lugar de utilizar un bucle, podríamos seleccionar la segunda fila de la matriz como un vector de fila, multiplicarla por cinco y, a continuación, asignar el resultado de nuevo a su posición original. Esto produce el mismo efecto y resulta más elegante. Aun así, vuelvo a preguntarle al lector: ¿se te ocurre alguna razón por la que incluso este enfoque podría no ser el mejor posible?
//--- Slightly better code
//--- Copy the row, multiply it and then put it back
matrix example_2;
vector copy_vector;

example_2.Assign(A);

copy_vector = example_2.Row(1);

example_2.Row(copy_vector*5,1);

Print("Example 2");
Print(example_2);
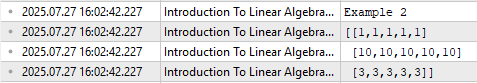
Figura 4: Manipular la matriz A mediante métodos vectoriales es mejor que un bucle «for» tradicional, pero no es óptimo.
Por último, voy a mostrar cuál se considera un enfoque adecuado en este contexto: empezamos creando un vector de escalado y, a continuación, utilizamos la multiplicación de matrices para aplicar este vector a la matriz A. Como se puede ver, los tres fragmentos de código producen el mismo resultado. No obstante, el lector debe tener en cuenta varias diferencias importantes.
El tercer método es el que requiere menos líneas de código. Esto pone de manifiesto una ventaja clave del uso del álgebra lineal en nuestras tareas diarias de negociación: nos permite escribir código más conciso y fácil de mantener. Para la mayoría de los desarrolladores, creo que esto por sí solo debería ser una razón de peso para dedicar tiempo a aprender álgebra lineal. Sin embargo, hay muchas más ventajas que iré mostrando a medida que avancemos. Es, sencillamente, un buen punto de partida.
//--- Reliable code
matrix example_3,scaler;
vector scale = {1,5,1};

scaler.Diag(scale);
example_3 = scaler.MatMul(A);

//--- Done
Print("Example 3");
Print(example_3);
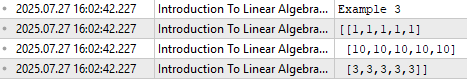
Figura 5: Siempre es mejor utilizar métodos específicos para matrices y vectores, cuando existan.
Ahora ampliemos el ejemplo. Al principio, solo multiplicamos la segunda fila por cinco. Multipliquemos ahora la primera fila por dos, la última fila por diez y dejemos la fila del medio tal cual. Llegados a este punto, es posible que el lector empiece a darse cuenta de los problemas que plantea el uso del bucle «for». A medida que aumenta el número de operaciones sobre la matriz A, también lo hace la longitud de nuestro bucle y, por lo tanto, el número de líneas que debemos escribir. Además, si la matriz A es lo suficientemente grande, iterar sobre cada valor uno por uno —tal y como sugiere el bucle— puede ralentizar considerablemente la ejecución, especialmente durante las pruebas retrospectivas.
//--- Now, multiply the first and last rows by 2 and 10, but leave the middle row as it is.

//--- Loops can slow us down during backtests, especially if they must be repeated often.
for(int i =0;i<5;i++)
{
   example_1[0,i] = example_1[0,i] * 2;
   example_1[2,i] = example_1[2,i] * 10;
}

//--- Done
Print("Example 1");
Print(example_1);
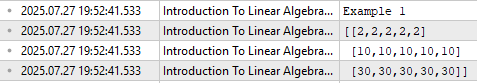
Figura 6: Tenemos que escribir más líneas de código en nuestro bucle «for», solo para conseguir el mismo efecto.
Del mismo modo, el método que consiste en seleccionar y reasignar filas individuales se vuelve cada vez más complejo a medida que aumenta el número de operaciones. Aunque este método es mejor que un bucle «for» básico, sigue dando lugar a un código recargado, lo que aumenta la probabilidad de que se produzcan errores.
//--- The difference between example 2 and 3 starts to show
//--- Copy the row, multiply it and then put it back
vector copy_vector_2;

copy_vector = example_2.Row(0);
copy_vector_2 = example_2.Row(2);

example_2.Row(copy_vector*2,0);
example_2.Row(copy_vector_2*10,2);

//--- Done
Print("Example 2");
Print(example_2);
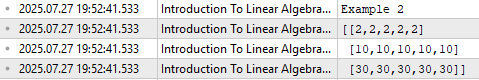
Figura 7: Aunque encadenar métodos generales de matrices y vectores sigue siendo una forma válida de resolver el problema, podemos hacerlo mejor.
Aún podemos hacerlo mejor recurriendo a la multiplicación de matrices. Con este enfoque, lo único que cambia son los valores de escala. El resto del código sigue siendo prácticamente el mismo, independientemente del número de filas que haya. Los tres métodos arrojan el mismo resultado, pero tras compararlos uno al lado del otro, pregunto al lector: ¿qué enfoque parece más adecuado a la hora de trabajar con grandes volúmenes de datos históricos de mercado?
//--- Reliable code
vector scale_2 = {2,1,10};
scaler.Diag(scale_2);
example_3 = scaler.MatMul(example_3);

//--- Done
Print("Example 3");
Print(example_3);
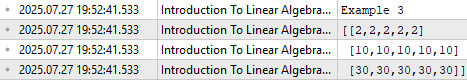
Figura 8: Podemos obtener el mismo resultado con menos líneas de código, programando de forma más concisa.
Tiempo necesario para realizar un backtest
Con los bucles «for» tradicionales, es posible que no podamos procesar todos los puntos de datos de forma eficiente, sobre todo durante operaciones en las que el tiempo es un factor clave, como las pruebas retrospectivas. Esto nos lleva a un segundo punto clave: no solo es más fácil mantener nuestro código cuando utilizamos correctamente las API de matrices y vectores, sino que el tiempo de ejecución de nuestras estrategias de negociación también resulta más eficiente.
En definitiva, lo más probable es que la mayoría de los lectores estén interesados en crear potentes modelos de IA para operar en los mercados financieros, modelos capaces de tomar decisiones informadas. Pero para que tu modelo de IA pueda tomar esas decisiones, necesita acceso a grandes volúmenes de datos. Y antes de introducir esos datos en el modelo, debemos realizar ciertos pasos de preprocesamiento y manipulaciones.
Si realizamos estas operaciones de forma ineficiente, el número de líneas necesarias para construir la aplicación crece rápidamente, especialmente si dependemos de bucles for. A medida que aumenta el tamaño del código, también aumenta el tiempo necesario para las pruebas retrospectivas.
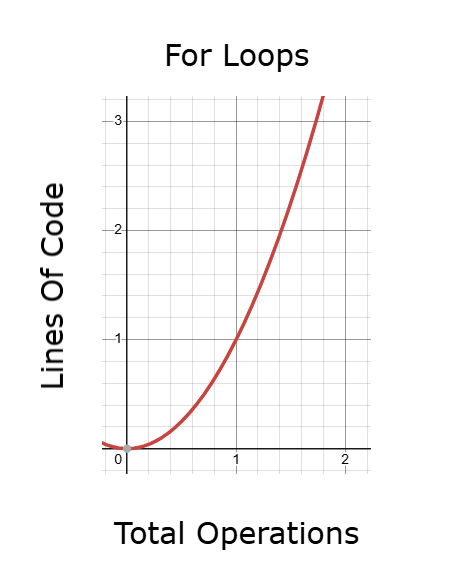
Figura 9: Los bucles for pueden generar código que tarda demasiado en ejecutarse durante las pruebas retrospectivas.
Una mejor alternativa es utilizar operaciones vectoriales y matriciales encadenadas. Este método es mucho más rápido que los bucles tradicionales, pero incluso este puede volverse engorroso si implica copiar, modificar y reasignar filas repetidamente. Si aumenta el número de dichas operaciones, también aumenta el tiempo necesario para ejecutar el código, lo que afecta de nuevo al rendimiento de las pruebas retrospectivas y a la optimización del modelo.
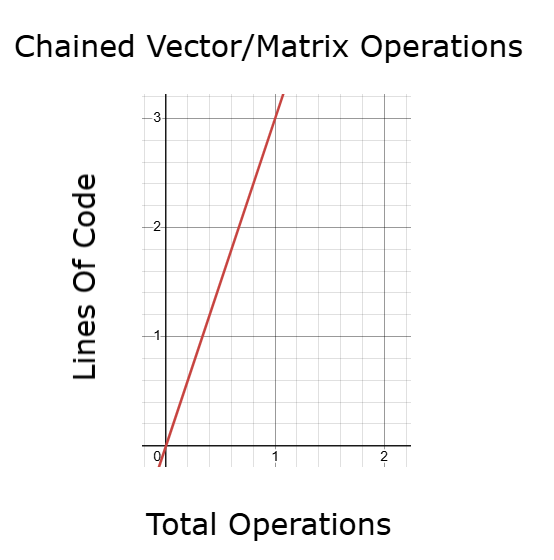
Figura 10: Encadenar las API de matrices y vectores será más rápido que un bucle for, pero podríamos hacerlo mejor.
Por otro lado, mediante el uso de las operaciones vectoriales y matriciales adecuadas, basadas en el álgebra lineal, podemos controlar el tiempo de ejecución y mantener constantes la longitud del código y el tiempo de las pruebas retrospectivas, incluso a medida que aumenta el tamaño de los datos. Esta es una cualidad muy deseable en cualquier aplicación. Esto significa que podemos realizar más operaciones sin tener que escribir proporcionalmente más código y sin aumentar el tiempo de ejecución, lo que nos permite iterar y optimizar los modelos de aprendizaje automático de forma más eficaz. Creo que la mayoría de los lectores se sorprenderán de cuánto progreso se puede lograr simplemente comprendiendo algunos conceptos fundamentales del álgebra lineal. No necesitamos teoría avanzada para empezar a ver mejoras significativas en nuestras aplicaciones.
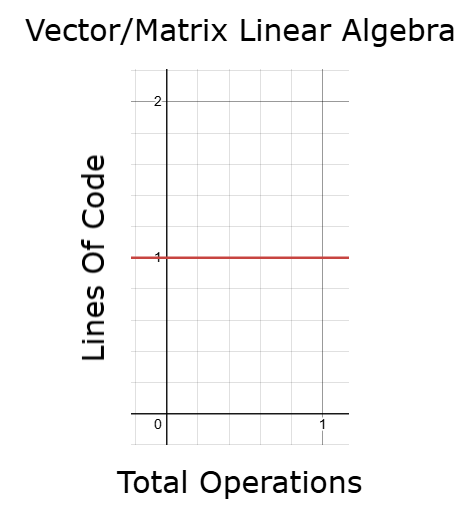
Figura 11: El uso del álgebra lineal puede ayudarnos a lograr un tiempo de ejecución constante en nuestras aplicaciones.
Precisión
También quisiera destacar una cuestión importante que, en mi opinión, a menudo se pasa por alto en los debates técnicos: la precisión. Creo que este tema no recibe la atención y el análisis que realmente merece. La precisión es uno de los componentes clave para construir una estrategia de trading fiable. Los resultados obtenidos mediante las pruebas retrospectivas deben ser precisos, y se espera que los cálculos internos y las decisiones tomadas por la aplicación sean exactos y fiables. Consideremos el siguiente escenario: en el fragmento de código de ejemplo, realizamos una resta básica de punto flotante: 0,3 - 0,1. El ordenador informa del resultado como 0,199999... en lugar del 0,2 esperado. Este es un problema bien conocido en la informática relacionado con la aritmética de punto flotante, y no es exclusivo de MQL5.
El punto que quiero destacar es este: imagínese realizar dicha operación de resta dentro de un bucle. Ahora, imagina recorrer una matriz como A, que puede tener más de un millón de filas, realizando esta operación en cada una de ellas. Resulta fácil comprender cómo estos pequeños errores de precisión pueden acumularse y agravarse, introduciendo finalmente una inestabilidad numérica significativa en los resultados.
Realizar operaciones aritméticas sin cuidado, como restas directas de este tipo en matrices grandes, es ineficiente y no producirá resultados precisos ni numéricamente estables.
Además, si consideramos algoritmos como los mostrados en ejemplos anteriores, donde los valores se copian repetidamente de un lugar a otro, se crean nuevos objetos, se reasignan datos y la memoria se asigna y libera constantemente, el problema se vuelve aún más acuciante. Los ordenadores tienen memoria limitada. Cuando realizamos operaciones matriciales de forma ineficiente, generando y destruyendo objetos constantemente, aumentamos innecesariamente la presión sobre la memoria. Intentar gestionar la memoria de una manera tan desorganizada tiene consecuencias materiales que a menudo pasamos por alto.
Además, existen algoritmos conocidos —muchos de los cuales ya están implementados en la API de matrices y vectores de MQL5, así como en las bibliotecas de soporte que analizaremos— que están diseñados teniendo en cuenta precisamente estos problemas. Estas implementaciones están optimizadas para minimizar el error de coma flotante y maximizar la estabilidad numérica. Por el contrario, cuando los desarrolladores optan por métodos menos eficientes, como los bucles for manuales para la manipulación de datos, aumentan sin saberlo la probabilidad de encontrarse con estos problemas.
//--- Why should you care?
//--- Let's start with an often overlooked need, precision!
Print("Our computers have limited memory to store numbers with precision");
Print("What is 0.3 - 0.1");
Print(0.3-0.1);
Print("You and I know the correct answer is 0.2");
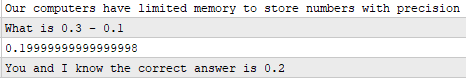
Figura 12: El uso del álgebra lineal matricial/vectorial apropiada puede ayudarnos a minimizar dichos errores.
¿Cómo podemos utilizar el álgebra lineal como traders?
Ahora que el lector ha comprendido las ventajas de aprender álgebra lineal, es momento de considerar algunas de las reglas fundamentales que rigen la forma en que tomamos decisiones al utilizarla. Comprender estas reglas básicas es una habilidad valiosa.
Para empezar a comprender el álgebra lineal, primero necesitamos un conocimiento sólido del álgebra básica. El álgebra es esencialmente la matemática de las cantidades desconocidas. Comencemos con un ejemplo sencillo, ilustrado en la Figura 13: Esta ecuación dice: algún valor desconocido, cuando se multiplica por 2, da 4. Para despejar x, dividimos ambos lados por 2. Si queremos comprobar nuestra solución, simplemente sustituimos x por el valor 2 en la ecuación original y luego verificamos si 2 multiplicado por 2 es efectivamente 4. Aunque esto pueda parecer básico, sienta las bases para conceptos más avanzados.
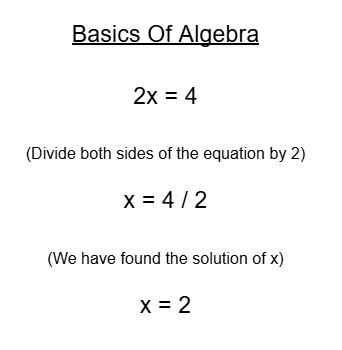
Figura 13: Visualización de un problema simple de álgebra donde el valor de x es 2.
Ahora, consideremos una ligera variación: ¿qué pasaría si la ecuación fuera A multiplicado por 2, da 4? Dividiríamos ambos lados por A y daríamos como solución x igual a 4 dividido por A. Como no se nos dice a qué es igual A, hemos terminado de resolver el problema.
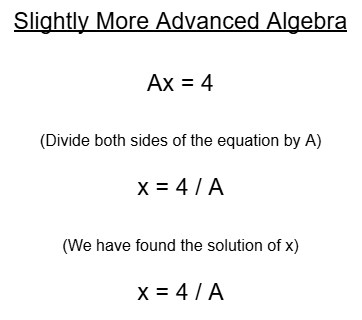
Figura 14: Considerando una versión ligeramente más compleja del problema representado en la Figura 13.
Ahora bien, ¿qué ocurre si A no es solo un número, sino una matriz? Aquí es donde pasamos del álgebra que se enseña en la escuela secundaria al álgebra lineal. Aquí, A es una matriz. Podríamos vernos tentados a dividir ambos lados por A, como hicimos anteriormente. Pero en álgebra lineal, la división por una matriz no está definida. En su lugar, utilizamos la inversa de una matriz. Si la matriz tiene inversa, resolvemos la ecuación multiplicando ambos lados por la inversa de A.
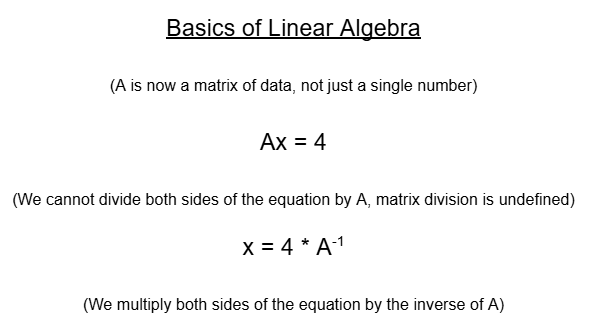
Figura 15: El álgebra lineal se basa en la misma lógica que usamos para nuestros ejemplos sencillos, pero modificamos algunas reglas.
¿Qué significa esto en el contexto de los datos de mercado? Supongamos que la matriz A representa datos de mercado actuales, como por ejemplo los niveles de precios. El vector y representa el precio futuro que intentas predecir. Quieres encontrar el vector de coeficientes tal que “Cuando multiplique mis datos actuales por el vector de coeficientes, debería obtener los niveles de precios futuros”.
Pero aquí está el problema: no todas las matrices tienen inversa. De hecho, invertir una matriz que no es invertible puede provocar que su algoritmo de negociación falle o que arroje resultados poco fiables. Por este motivo, no invertimos "a ciegas" ninguna matriz con la que nos encontramos. En cambio, suele ser más seguro y estable trabajar con submatrices más pequeñas —partes de los datos que podemos invertir o procesar de forma fiable utilizando otras técnicas numéricamente estables, como factorizaciones matriciales (por ejemplo, QR, SVD o pseudoinversas).
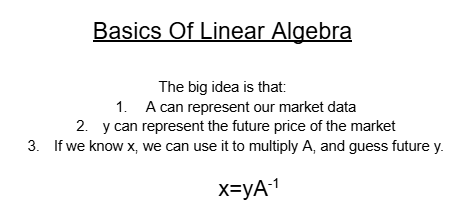
Figura 16: Generalización de la solución a cualquier sistema de ecuaciones lineales
Utilizando el álgebra lineal para mejorar nuestras operativa
Ahora que hemos adquirido cierto grado de familiaridad con la regla básica para resolver sistemas de ecuaciones lineales utilizando álgebra lineal, estamos listos para comenzar a aplicar lo que hemos aprendido sobre cómo hallar el vector de coeficientes x. Para este ejemplo en particular, quiero mostrarles que la fórmula que hemos comentado puede resolver para múltiples objetivos en y con la misma facilidad con la que puede resolver para un solo objetivo. Comencemos, pues, definiendo las constantes de nuestro sistema. Hoy necesitamos especificar cuántas entradas aceptará nuestro modelo. Este modelo en particular requerirá ocho entradas.
//+------------------------------------------------------------------+
//|                                            Linear Regression.mq5 |
//|                                               Gamuchirai Ndawana |
//|                    https://www.mql5.com/en/users/gamuchiraindawa |
//+------------------------------------------------------------------+
#property copyright "Gamuchirai Ndawana"
#property link      "https://www.mql5.com/en/users/gamuchiraindawa"
#property version   "1.00"

//+------------------------------------------------------------------+
//| System constants                                                 |
//+------------------------------------------------------------------+
#define TOTAL_INPUTS 8
Posteriormente, debemos definir los parámetros importantes del sistema. Por ejemplo, el número de barras históricas que se van a obtener, con cuánta antelación queremos realizar la previsión, los periodos de tiempo que estamos utilizando y otros ajustes relacionados. Todos estos detalles se almacenarán en los parámetros del sistema.
//+------------------------------------------------------------------+
//| System parameters                                                |
//+------------------------------------------------------------------+
int bars = 90;                                        //Number of historical bars to fetch
int horizon = 1;                                      //How far into the future should we forecast
int MA_PERIOD = 2;                                    //Moving average period
ENUM_TIMEFRAMES TIME_FRAME = PERIOD_D1;               //User Time Frame
ENUM_TIMEFRAMES RISK_TIME_FRAME = PERIOD_D1;          //Time Frame for our ATR stop loss
double sl_size = 2;                                   //ATR Stop loss size
Las dependencias en cualquier aplicación son importantes porque reducen la cantidad total de código que hay que reescribir de un proyecto a otro. Por lo tanto, cargaremos varias dependencias clave, como la dependencia Trade que viene preinstalada en todas las versiones de MetaTrader 5. Las dos dependencias restantes fueron escritas a medida para nuestras actividades comerciales.
//+------------------------------------------------------------------+
//| Dependencies                                                     |
//+------------------------------------------------------------------+
#include <Trade\Trade.mqh>
#include <VolatilityDoctor\Time\Time.mqh>
#include <VolatilityDoctor\Trade\TradeInfo.mqh>
Nuestro sistema también definirá variables globales importantes que se utilizarán en diferentes contextos dentro de la aplicación. Por ejemplo, tendremos variables globales para almacenar las lecturas actuales de los indicadores. Otros almacenarán los valores utilizados por las dependencias, y otros más contendrán los coeficientes que hemos aprendido a partir de los datos. Esto incluye valores como la lectura ATR y muchos otros componentes de nuestro sistema.
//+------------------------------------------------------------------+
//| Global Variables                                                 |
//+------------------------------------------------------------------+
int        ma_close_handler,ma_high_handler,ma_low_handler;
double     ma_close[],ma_high[],ma_low[];
Time       *Timer;
TradeInfo  *TradeInformation;
vector     bias,temp,temp_2,temp_3,temp_4,temp_5,Z1,Z2;
matrix     X,y,prediction,b;
int        time;
CTrade Trade;
int state;
int atr_handler;
double atr[];
Al inicializarse, el sistema creará nuevos objetos para las dependencias personalizadas que hemos cargado. El temporizador se encarga de controlar la formación de nuevas velas. El módulo de información de trading devuelve información importante como el volumen mínimo de negociación, el precio Ask y el precio Bid. También crearemos manejadores para realizar un seguimiento de nuestras medias móviles, así como inicializaremos nuestras matrices y vectores con valores de marcador de posición de uno solo para comenzar.
//+------------------------------------------------------------------+
//| Expert initialization function                                   |
//+------------------------------------------------------------------+
int OnInit()
  {
//---
   Timer                   = new Time(Symbol(),TIME_FRAME);
   TradeInformation        = new TradeInfo(Symbol(),TIME_FRAME);
   ma_close_handler        = iMA(Symbol(),TIME_FRAME,MA_PERIOD,0,MODE_SMA,PRICE_CLOSE);
   ma_high_handler        = iMA(Symbol(),TIME_FRAME,MA_PERIOD,0,MODE_SMA,PRICE_HIGH);
   ma_low_handler        = iMA(Symbol(),TIME_FRAME,MA_PERIOD,0,MODE_SMA,PRICE_LOW);

   bias = vector::Ones(TOTAL_INPUTS);
   Z1 = vector::Ones(TOTAL_INPUTS);
   Z2 = vector::Ones(TOTAL_INPUTS);
   X = matrix::Ones(TOTAL_INPUTS,bars);
   y = matrix::Ones(1,bars);
   time = 0;
   state = 0;
   atr_handler = iATR(Symbol(),RISK_TIME_FRAME,14);
//---
   return(INIT_SUCCEEDED);
  }
Cuando nuestra aplicación deje de utilizarse, liberaremos todos los objetos vinculados a los recursos de memoria. Esta es una buena práctica en MQL5 y siempre la seguiremos.
//+------------------------------------------------------------------+
//| Expert deinitialization function                                 |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
  {
//---
   IndicatorRelease(atr_handler);
   IndicatorRelease(ma_close_handler);
   IndicatorRelease(ma_high_handler);
   IndicatorRelease(ma_low_handler);
  }
Cada vez que se reciben precios actualizados en el controlador OnTick, primero comprobamos si se ha formado completamente una nueva vela. Si es así, copiamos todas las lecturas de los indicadores en sus matrices asociadas y preparamos el modelo para realizar una predicción del mercado. Una vez hecho esto, hacemos un seguimiento del precio de cierre actual y calculamos nuestro stop loss, tanto para las posiciones de venta como de compra.
A partir de ahí, mostramos los niveles de precios previstos por nuestro modelo. Recordemos que estamos pronosticando la media móvil de cierre, la media móvil de máximos, la media móvil de mínimos y el precio en sí. Si actualmente no hay posiciones abiertas, primero reiniciamos las variables de estado correspondientes. Luego, analizamos la relación entre el precio de cierre esperado y la media móvil de cierre esperada en el futuro.
En general, queremos ver que nuestro algoritmo prevea que la media móvil del precio de cierre esté por encima del precio de cierre actual. Esto sugiere que los precios están actualmente infravalorados, ya que se cotizan por debajo de lo que el modelo considera un valor justo.
Para mayor confirmación, también queremos asegurarnos de que sea improbable que se active nuestro stop loss, tanto para posiciones de compra como de venta. En condiciones de compra, verificamos que no se espera que la media móvil de los mínimos caiga por debajo del stop loss de compra. En condiciones de venta, comprobamos que no se espera que la media móvil de los máximos supere el límite de pérdidas de venta. Si se incumple cualquiera de las dos condiciones, evitamos tomar una posición.
Además, comparamos cada media móvil individual con su par complementario. Al comprar, esperamos que el valor futuro de la media móvil de los mínimos sea mayor que su valor actual. Al vender, esperamos que el valor futuro de la media móvil de los mínimos sea inferior a su valor actual. Del mismo modo, al comprar, queremos que la media móvil máxima futura supere su valor actual.
Cuando llega el momento de cerrar una posición, primero comprobamos si se prevé que los precios se muevan en nuestra contra. Si prevemos que alguna media móvil pueda superar el límite de pérdidas, cerramos la operación inmediatamente. De lo contrario, permitimos que el stop loss continúe desplazándose hacia un territorio más rentable.
//+------------------------------------------------------------------+
//| Expert tick function                                             |
//+------------------------------------------------------------------+
void OnTick()
  {
//---
   if(Timer.NewCandle())
     {
      CopyBuffer(atr_handler,0,0,1,atr);
      CopyBuffer(ma_close_handler,0,0,1,ma_close);
      CopyBuffer(ma_low_handler,0,0,1,ma_low);
      CopyBuffer(ma_high_handler,0,0,1,ma_high);

      setup();

      double c =  iClose(Symbol(),TIME_FRAME,0);
      double buy_sl = (TradeInformation.GetBid() - (sl_size * atr[0]));
      double sell_sl = (TradeInformation.GetAsk() + (sl_size * atr[0]));


      Comment("Forecasted MA: ",prediction[0,0],"\nForecasted MA High: ",prediction[1,0],"\nForecasted MA Low: ",prediction[2,0],"\nForecasted Price: ",prediction[3,0]);

      if(PositionsTotal() == 0)
        {
         state = 0;
         if((prediction[0,0] > c) && (prediction[2,0] > buy_sl) && (prediction[3,0] > c) && (prediction[2,0] > ma_low[0]) && (prediction[1,0] > ma_high[0]))
           {
            Trade.Buy(TradeInformation.MinVolume(),Symbol(),TradeInformation.GetAsk(),buy_sl,0);
            state = 1;
           }
         if((prediction[0,0] < c) && (prediction[1,0] < sell_sl) && (prediction[3,0] < c) && (prediction[2,0] < ma_low[0]) && (prediction[1,0] < ma_high[0]))
           {
            Trade.Sell(TradeInformation.MinVolume(),Symbol(),TradeInformation.GetBid(),sell_sl,0);
            state = -1;
           }
        }

      if(PositionsTotal() > 0)
        {
         double current_sl = PositionGetDouble(POSITION_SL);

         if(((state == -1) && (prediction[0,0] > c) && (prediction[1,0] > current_sl)) || ((state == 1)&&(prediction[0,0] < c)&& (prediction[2,0] < current_sl)))
            Trade.PositionClose(Symbol());
         if(PositionSelect(Symbol()))
           {


            if((state == 1) && ((ma_close[0] - (2 * atr[0]))>current_sl))
              {
               Trade.PositionModify(Symbol(),(ma_close[0] - (2 * atr[0])),0);
              }

            else
               if((state == -1) && ((ma_close[0] + (1 * atr[0]))<current_sl))
                 {
                  Trade.PositionModify(Symbol(),(ma_close[0] + (2 * atr[0])),0);
                 }
           }
        }
     }
  }
A continuación, debemos analizar algunas de las funciones individuales preparadas para las tareas mencionadas anteriormente. La primera función es prepare_data(). Esta función tiene un único propósito fundamental: copiar todos los niveles de precios que necesitamos en la matriz de datos de entrada x. Obtiene el precio de apertura, calcula la media y la desviación estándar del precio de apertura y normaliza los datos restando la media y dividiendo por la desviación estándar. Este proceso se repite para todas las entradas. Todos los valores del controlador de promedio móvil también se copian y se almacenan en el array de destino y.
//+------------------------------------------------------------------+
//| Prepare the training data for our model                          |
//+------------------------------------------------------------------+
void prepare_data(void)
  {
//--- Reshape the matrix
   X = matrix::Ones(TOTAL_INPUTS,bars);

//--- Store the Z-scores
   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_OPEN,horizon,bars);
   Z1[0] = temp.Mean();
   Z2[0] = temp.Std();
   temp = ((temp - Z1[0]) / Z2[0]);
   X.Row(temp,1);

//--- Store the Z-scores
   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_HIGH,horizon,bars);
   Z1[1] = temp.Mean();
   Z2[1] = temp.Std();
   temp = ((temp - Z1[1]) / Z2[1]);
   X.Row(temp,2);

//--- Store the Z-scores
   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_LOW,horizon,bars);
   Z1[2] = temp.Mean();
   Z2[2] = temp.Std();
   temp = ((temp - Z1[2]) / Z2[2]);
   X.Row(temp,3);

//--- Store the Z-scores
   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_CLOSE,horizon,bars);
   Z1[3] = temp.Mean();
   Z2[3] = temp.Std();
   temp = ((temp - Z1[3]) / Z2[3]);
   X.Row(temp,4);

//--- Store the Z-scores
   temp.CopyIndicatorBuffer(ma_close_handler,0,horizon,bars);
   Z1[4] = temp.Mean();
   Z2[4] = temp.Std();
   temp = ((temp - Z1[4]) / Z2[4]);
   X.Row(temp,5);

//--- Store the Z-scores
   temp.CopyIndicatorBuffer(ma_high_handler,0,horizon,bars);
   Z1[5] = temp.Mean();
   Z2[5] = temp.Std();
   temp = ((temp - Z1[5]) / Z2[5]);
   X.Row(temp,6);

//--- Store the Z-scores
   temp.CopyIndicatorBuffer(ma_low_handler,0,horizon,bars);
   Z1[6] = temp.Mean();
   Z2[6] = temp.Std();
   temp = ((temp - Z1[6]) / Z2[6]);
   X.Row(temp,7);

//--- Labelling our targets
   temp.CopyIndicatorBuffer(ma_close_handler,0,0,bars);
   temp_2.CopyIndicatorBuffer(ma_high_handler,0,0,bars);
   temp_3.CopyIndicatorBuffer(ma_low_handler,0,0,bars);
   temp_4.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_CLOSE,0,bars);

//--- Reshape y
   y.Reshape(4,bars);

//--- Store the targets
   y.Row(temp,0);
   y.Row(temp_2,1);
   y.Row(temp_3,2);
   y.Row(temp_4,3);
  }
A continuación, definimos una función para ajustar el modelo. Esta función comienza creando las matrices y vectores apropiados. Descomponemos (o factorizamos) la matriz x utilizando la biblioteca OpenBLAS, y almacenamos las matrices factorizadas en las variables que presentamos anteriormente. Siguiendo la solución analítica, podemos obtener B a partir de x y luego imprimir los coeficientes aprendidos a partir de B.
//+------------------------------------------------------------------+
//| Fit our model                                                    |
//+------------------------------------------------------------------+
void fit(void)
  {
//--- Fit the model
   matrix OB_U,OB_VT,OB_SIGMA;
   vector OB_S;

   PrintFormat("Computing Singular Value Decomposition of %s Data using OpenBLAS",Symbol());
   X.SingularValueDecompositionDC(SVDZ_S,OB_S,OB_U,OB_VT);
   OB_SIGMA.Diag(OB_S);
   b = y.MatMul(OB_VT.Transpose().MatMul(OB_SIGMA.Inv()).MatMul(OB_U.Transpose()));
   Print("OLS Solutions: ");
   Print(b);
  }
Para generar una predicción, volvemos a obtener todos los datos de entrada, tal como lo hicimos en prepare_data, y realizamos una última multiplicación de matrices para obtener nuestra previsión a partir de B. Es decir, multiplicamos los coeficientes por los datos de entrada.
//+------------------------------------------------------------------+
//| Get a prediction from our multiple output model                  |
//+------------------------------------------------------------------+
void predict(void)
  {
//--- Prepare to get a prediction
//--- Reshape the data
   X = matrix::Ones(TOTAL_INPUTS,1);

//--- Get a prediction
   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_OPEN,0,1);
   temp = ((temp - Z1[0]) / Z2[0]);
   X.Row(temp,1);

   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_HIGH,0,1);
   temp = ((temp - Z1[1]) / Z2[1]);
   X.Row(temp,2);

   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_LOW,0,1);
   temp = ((temp - Z1[2]) / Z2[2]);
   X.Row(temp,3);

   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_CLOSE,0,1);
   temp = ((temp - Z1[3]) / Z2[3]);
   X.Row(temp,4);

   temp.CopyIndicatorBuffer(ma_close_handler,0,0,1);
   temp = ((temp - Z1[4]) / Z2[4]);
   X.Row(temp,5);

   temp.CopyIndicatorBuffer(ma_high_handler,0,0,1);
   temp = ((temp - Z1[5]) / Z2[5]);
   X.Row(temp,6);

   temp.CopyIndicatorBuffer(ma_low_handler,0,0,1);
   temp = ((temp - Z1[6]) / Z2[6]);
   X.Row(temp,7);

   Print("Prediction Inputs: ");
   Print(X);

//--- Get a prediction
   prediction.Reshape(1,4);
   prediction = b.MatMul(X);
   Print("Prediction");
   Print(prediction);
  }
Finalmente, cada vez que recibimos precios actualizados en el controlador OnTick, llamamos a una función llamada setup. Esta función llama a las tres funciones principales que acabamos de describir. Prepara los datos, ajusta el modelo y obtiene una predicción.
//+------------------------------------------------------------------+
//| Obtain a prediction from our model                               |
//+------------------------------------------------------------------+
void setup(void)
  {
   prepare_data();
   fit();

   Print("Training Input Data: ");
   Print(X);

   Print("Training Target");
   Print(y);

   predict();
  }
//+------------------------------------------------------------------+

#undef TOTAL_INPUTS
//+------------------------------------------------------------------+
Con todo esto listo, estamos preparados para comenzar a probar nuestra aplicación con datos históricos. Como se muestra a continuación en la Figura 17, hemos aplicado nuestra aplicación al mercado EUR/USD desde 2022 hasta 2025. Estamos realizando backtesting con tres años de datos históricos.
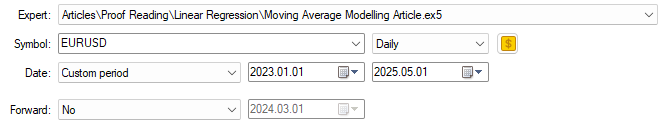
Figura 17: Nuestros días de backtesting abarcan 2 años de datos históricos del mercado EURUSD.
También seleccionamos configuraciones de retardo aleatorias basadas en ticks reales para obtener la representación más precisa posible de las condiciones del mercado. Asegúrese de utilizar la misma configuración si desea una emulación realista del rendimiento de su aplicación.
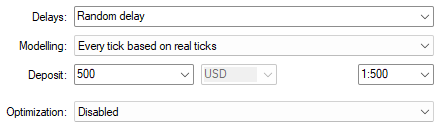
Figura 18: Selección de configuraciones de retardo aleatorias para probar nuestra aplicación de negociación en condiciones de mercado realistas.
En la Figura 19, podemos ver que nuestra aplicación genera con éxito cuatro pronósticos independientes, uno para cada nivel de precio de interés. Utiliza los filtros diseñados en el cuerpo principal de la aplicación para abrir posiciones basándose en las cuatro predicciones.
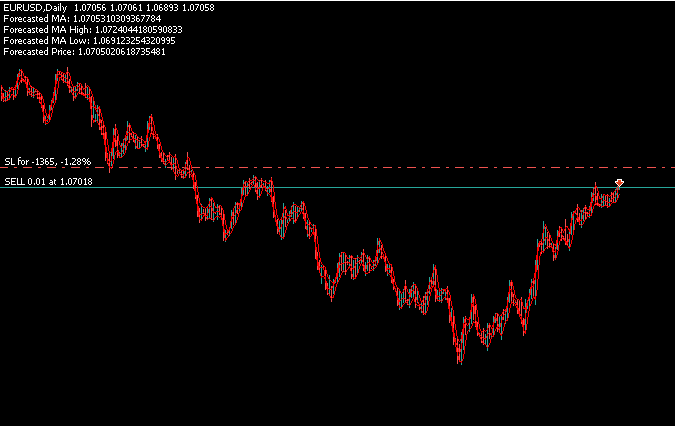
Figura 19: Prueba retrospectiva de nuestro algoritmo de negociación para evaluar su capacidad de predecir 4 objetivos diferentes simultáneamente.
He incluido una captura de pantalla del registro de la terminal para demostrar que nuestra aplicación ha aprendido efectivamente una matriz de coeficientes. Como puede observarse, la matriz de soluciones consta de cuatro filas, lo que significa que nuestra aplicación ha aprendido un conjunto único de coeficientes para cada uno de los cuatro objetivos que estamos prediciendo. La aplicación aprende cada objetivo de forma independiente.
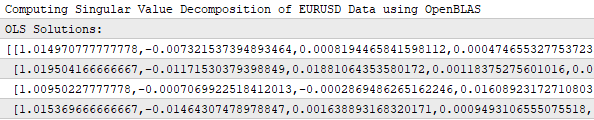
Figura 20: Nuestra aplicación de negociación aprende un conjunto único de coeficientes para cada uno de los 4 objetivos que le hemos asignado.
Además, nuestra aplicación está generando una tendencia positiva en el saldo de la cuenta a lo largo del tiempo. Si bien nos gustaría corregir las irregularidades en este equilibrio, continuaremos perfeccionando el sistema para lograr un crecimiento más consistente.
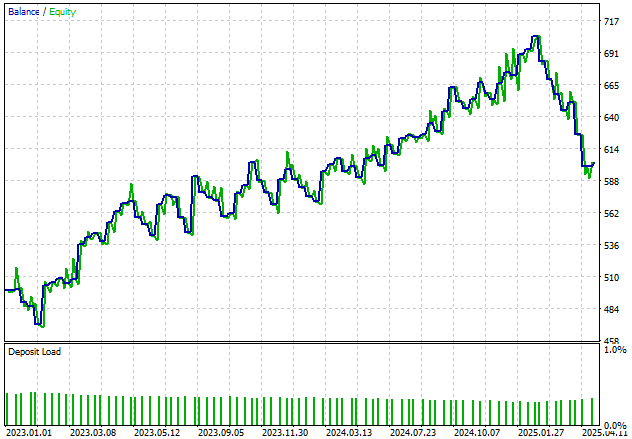
Figura 21: Visualización del crecimiento de nuestra curva de capital de cuenta durante el período de prueba retrospectiva de 2 años.
Al analizar el rendimiento de la cuenta en detalle, descubrimos que el 51% de nuestras operaciones fueron rentables. Si bien este es un buen punto de partida, nuestro objetivo es elevar esa cifra al 55% o incluso al 60% en el futuro. Por ahora, hemos tenido un buen comienzo: nuestro beneficio promedio es mayor que nuestra pérdida promedio, y nuestro mayor beneficio es casi el doble de nuestra mayor pérdida. Esto sugiere que el sistema es sólido, aunque todavía planeamos mejorarlo.
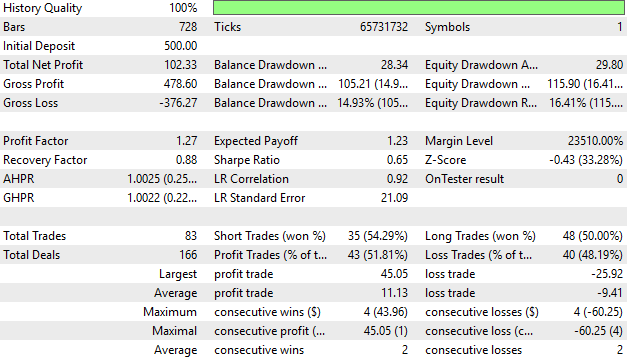
Figura 22: Análisis detallado del rendimiento de nuestra aplicación de negociación durante nuestra prueba retrospectiva.
Conclusión
En conclusión, este artículo ha demostrado al lector la importancia de una sólida comprensión de los conceptos de álgebra lineal y cómo estos afectan directamente nuestra capacidad para manipular datos de mercado en la terminal MetaTrader 5. Sin este conocimiento, analizar grandes volúmenes de datos de mercado se vuelve extremadamente difícil. Al aprender tan solo unos pocos principios clave del álgebra lineal y ver cómo se aplican en MQL5, conseguimos la capacidad de extraer información del mercado de forma mucho más rápida y fiable.A medida que avancemos en nuestro análisis, enseñaremos al lector a utilizar las herramientas del álgebra lineal y a reinterpretarlas en MQL5 para crear algoritmos de negociación rápidos y numéricamente estables. Tras leer esto, el lector estará capacitado para diseñar algoritmos que se ejecuten en un tiempo prácticamente constante, lo que le permitirá realizar pruebas retrospectivas rápidas y mejorar sus aplicaciones, incluso si desea predecir varios objetivos al mismo tiempo.
Traducción del inglés realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/en/articles/18974
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Utilizando redes neuronales en MetaTrader
 Redes neuronales en el trading: Señales de trading robustas en cualquier régimen de mercado (ST-Expert)
 Particularidades del trabajo con números del tipo double en MQL4
 Robot de trading multiflujo con aprendizaje automático: del concepto a la implementación

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso