
Desarrollo de asesores expertos autooptimizables en MQL5 (Parte 10): Factorización de matrices
 20
 0

En el debate inicial de esta serie (enlace disponible aquí), nos propusimos crear juntos un modelo de regresión lineal utilizando únicamente código MQL5 nativo y datos sin procesar de nuestra terminal MetaTrader 5. Tras leer los comentarios y las opiniones sobre el primer artículo, muchos lectores señalaron los problemas que habían tenido con la solución que mostramos. Se encontraron con numerosos fallos y errores, y algunos señalaron que el modelo solo abría un tipo de posición. En general, varios usuarios plantearon cuestiones relacionadas con la inestabilidad en relación con nuestro primer intento de elaborar un modelo lineal.
En resumen, los modelos lineales son herramientas predictivas que permiten a nuestra aplicación aprender directamente a partir de las observaciones del comportamiento del mercado y utilizar esa información para realizar operaciones que, según el modelo, tienen más probabilidades de éxito. Nuestro objetivo, por lo tanto, es ir más allá de indicar explícitamente a la aplicación cuándo debe comprar o vender. En cambio, queremos que aprenda de forma autónoma a partir de datos históricos.
En este artículo se abordarán los problemas de inestabilidad que los usuarios experimentaron en nuestro primer debate y se mostrará cómo crear modelos predictivos igualmente potente a partir de datos sin procesar que describan cualquier mercado en el que se desee operar. Para ello, presentaremos una familia de algoritmos conocida como factorización de matrices.
La factorización de matrices es una técnica matemática que se utiliza para descomponer una matriz grande en un producto de matrices más pequeñas y sencillas. Estas técnicas aportan numerosas ventajas. Sin embargo, antes de analizarlas, veamos primero cuál es la motivación que hay detrás de ellas.
En la vida cotidiana, hay ciertas experiencias compartidas que trascienden las culturas. Por ejemplo, creo que la mayoría de los lectores están familiarizados con la idea de que, al hablar con un niño y escuchar cómo describe a su madre o a su padre, podemos hacernos una idea de cómo es ese progenitor. Estas descripciones pueden incluso ayudarnos a intuir cómo actuaría el progenitor en situaciones que el niño no ha descrito directamente. Del mismo modo, la factorización de matrices descompone una matriz grande en otras más pequeñas: sus «hijas». Cada una de estas matrices hijas describe diferentes aspectos de la matriz original, lo que nos ayuda a comprender su estructura subyacente. Del mismo modo que la perspectiva de un niño puede revelar la esencia de sus padres, estas matrices más reducidas pueden aportar una visión en profundidad del mercado que estamos analizando.
Los resultados de la factorización de matrices suelen proporcionar soluciones numéricamente estables para los modelos lineales que hemos presentado anteriormente. En este artículo, también presentaremos una biblioteca numérica llamada OpenBLAS —abreviatura de «Basic Linear Algebra Subprograms»—. OpenBLAS es una bifurcación de código abierto de la biblioteca BLAS, rediseñada para funcionar de manera eficiente en las arquitecturas computacionales actuales. BLAS se escribió originalmente en Fortran y en código ensamblador escrito a mano.
Un concepto fundamental del álgebra lineal es que cualquier conjunto de datos puede desglosarse en componentes más pequeños, y que estos componentes pueden utilizarse para construir modelos predictivos a partir de los datos originales. Las representaciones que ofrecen estos conjuntos de datos más pequeños también pueden revelar características de los datos originales que, de otro modo, permanecerían ocultas.
Este artículo te presentará de forma sencilla los potentes comandos de álgebra lineal que se utilizan para crear modelos predictivos a partir de datos sin procesar. Y eso es solo el principio. Estas técnicas de factorización de matrices ofrecen mucho más que una simple capacidad predictiva: también nos ayudan a comprimir datos, descubrir tendencias ocultas y evaluar la estabilidad o el caos del mercado. Es realmente sorprendente la cantidad de información que podemos extraer de cualquier conjunto de datos con solo factorizarlo. Empecemos.
Primeros pasos en MQL5
El primer paso para empezar a usar MQL5 es definir las constantes del sistema que utilizaremos a lo largo de esta demostración. Estas constantes dan soporte al script que he creado para poner en marcha la factorización de matrices.
//+------------------------------------------------------------------+
//|                                                        Solve.mq5 |
//|                                               Gamuchirai Ndawana |
//|                    https://www.mql5.com/en/users/gamuchiraindawa |
//+------------------------------------------------------------------+
#property copyright "Gamuchirai Ndawana"
#property link      "https://www.mql5.com/en/users/gamuchiraindawa"
#property version   "1.00"
#property script_show_inputs

//+------------------------------------------------------------------+
//| System definitions                                               |
//+------------------------------------------------------------------+
#define HORIZON 10
#define START   0
A continuación, definimos las entradas del usuario para el script; concretamente, cuántas barras de información deseamos obtener.
//+------------------------------------------------------------------+
//| User inputs                                                      |
//+------------------------------------------------------------------+
input int FETCH =  10;//How many bars should we fetch?
A continuación, declaramos nuestras variables globales, que incluyen datos de entrenamiento y prueba, junto con algunas otras para almacenar los coeficientes aprendidos por nuestra aplicación a partir de los datos que proporcionamos.
//+------------------------------------------------------------------+
//| Global variables                                                 |
//+------------------------------------------------------------------+
int ROWS        =   5;
//Dependent variable
matrix y,y_test;
//Indenpendent variable
matrix X = matrix::Ones(ROWS,FETCH);
matrix X_test = matrix::Ones(ROWS,FETCH);
//Coefficients
matrix b;
vector temp;
//Row Norms
vector row_norms = vector::Zeros(4);
vector error_vector = vector::Zeros(4);
Para empezar, imprimimos la matriz de datos de entrada X tal como está actualmente. Como se muestra en la Figura 1, esta matriz está inicialmente llena de unos. Esto es intencional: en un modelo lineal, la primera fila de entradas representa el término independiente. Los datos reales del mercado, como los precios de apertura, máximo, mínimo y cierre, se irán incorporando a la matriz a partir de la segunda fila.
Un punto clave que merece la pena mencionar es la disposición de los datos. Si ha estado siguiendo nuestra serie, como por ejemplo "Reimaginando las estrategias clásicas", donde extraemos datos de MetaTrader 5 y los procesamos en Python, es posible que esté familiarizado con el formato en el que las columnas representan atributos del mercado (apertura, máximo, mínimo, cierre) y las filas representan el tiempo (por ejemplo, días). Sin embargo, en este caso, el diseño está invertido: el tiempo se representa en las columnas, mientras que las características del mercado, como la apertura, el máximo, el mínimo y el cierre, se representan en las filas.
//+------------------------------------------------------------------+
//| Script program start function                                    |
//+------------------------------------------------------------------+
void OnStart()
  {
//--- Observe the input matrix in its original form
PrintFormat("Input Matrix Gathered From %s",Symbol());
Print(X);
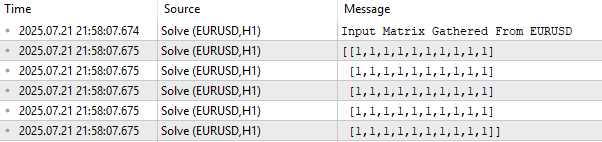
Figura 1: Visualización de nuestros datos de entrada actuales del EURUSD del mercado.
Una vez aclarado esto, pasamos a la parte del script encargada de obtener los datos históricos del mercado. Tras obtener los datos, almacenamos la norma de cada vector y, a continuación, dividimos cada vector por su norma. Este paso de normalización garantiza que cada vector tenga una longitud de 1, un requisito crucial antes de aplicar cualquier forma de factorización matricial.
¿Por qué normalizar? La factorización matricial busca comprender en qué dirección crece una matriz y compara las tasas de crecimiento entre filas y columnas. Para que estas comparaciones sean justas, convertimos cada fila en un vector unitario dividiéndola por su norma.
//--- Fetch the data
temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_OPEN,START+HORIZON+(FETCH*2),FETCH);
row_norms[0] = temp.Norm(VECTOR_NORM_P);
X.Row(temp/row_norms[0],1);

temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_HIGH,START+HORIZON+(FETCH*2),FETCH);
row_norms[1] = temp.Norm(VECTOR_NORM_P);
X.Row(temp/row_norms[1],2);

temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_LOW,START+HORIZON+(FETCH*2),FETCH);
row_norms[2] = temp.Norm(VECTOR_NORM_P);
X.Row(temp/row_norms[2],3);

temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_CLOSE,START+HORIZON+(FETCH*2),FETCH);
row_norms[3] = temp.Norm(VECTOR_NORM_P);
X.Row(temp/row_norms[3],4);

//--- Fetch the test data
temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_OPEN,START+HORIZON+(FETCH),FETCH);
X_test.Row(temp/row_norms[0],1);

temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_HIGH,START+HORIZON+(FETCH),FETCH);
X_test.Row(temp/row_norms[1],2);

temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_LOW,START+HORIZON+(FETCH),FETCH);
X_test.Row(temp/row_norms[2],3);

temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_CLOSE,START+HORIZON+(FETCH),FETCH);
X_test.Row(temp/row_norms[3],4);
Cuando imprimimos los datos de entrenamiento de entrada, la primera fila contiene unos (que representan la intersección), seguida de filas para la apertura, el máximo, el mínimo, el cierre y, finalmente, la media móvil. Los datos comienzan alrededor de 0,3 debido a la normalización.
//--- The train data
Print("Input");
Print(X);
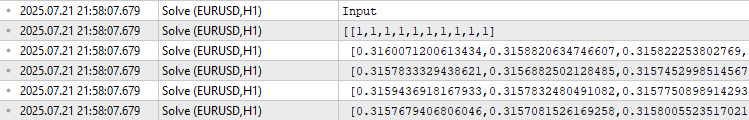
Figura 2: Visualización de nuestros datos de entrenamiento después de normalizar cada fila mediante su norma vectorial.
A continuación, definimos nuestros objetivos. En este ejemplo, el objetivo es el precio de cierre, que copiamos en la matriz y. Ahora, X contiene nuestras características de entrada, e y contiene los valores que pretendemos predecir.
//--- Fill the target
y.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_CLOSE,START+(FETCH*2),FETCH);
y_test.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_CLOSE,START,FETCH);

Print("Target");
Print(y);

Figura 3: Los valores de salida que intentábamos predecir a partir de las observaciones pasadas del mercado que teníamos disponibles.
¿Cómo encontramos entonces los coeficientes que relacionan X con y? Resulta que existen infinitos conjuntos de coeficientes que pueden hacer esto, por lo que necesitamos una manera de elegir el más apropiado. Normalmente, seleccionamos los coeficientes que minimizan el error entre los valores objetivo previstos y los reales. Un método bien conocido para lograr esto es mediante el uso de la pseudoinversa.
Para calcular los coeficientes, multiplicamos la pseudoinversa de X por y. Esta multiplicación de matrices produce los coeficientes de mejor ajuste mediante una solución cerrada. Afortunadamente, MQL5 proporciona una función integrada para esto mediante la función PInv() (pseudoinversa).
No se deje engañar por la simplicidad de esta solución. Podría dedicar fácilmente el resto de este artículo a explicar la importancia de esta única línea de código. Se garantiza que la solución de coeficientes generada por la función MQL5 PInv() minimiza al máximo el error RMSE entre las predicciones y las observaciones pasadas. Además, se garantiza que estas soluciones existen. El algoritmo es numéricamente estable y nos ofrece un código fuente compacto y fácil de mantener para crear nuestros propios modelos predictivos directamente a partir de datos sin procesar. Pero esta no es la solución recomendada que deberías utilizar.
//--- More Penrose Psuedo Inverse Solution implemented by MQL5 Developers
b = y.MatMul(X.PInv());

Print("Pseudo Inverse Solution: ");
Print(b);

Figura 4: Los coeficientes producidos al multiplicar matricialmente nuestro objetivo y la pseudoinversa de nuestras entradas son los coeficientes que minimizarán nuestro error.
El objetivo de este artículo es presentarle OpenBLAS y otros métodos de factorización de matrices. Entonces, ¿por qué deberíamos aprender OpenBLAS si MQL5 ya proporciona una forma sencilla de construir modelos predictivos utilizando únicamente los coeficientes calculados por la función PInv()? Existen varias razones de peso, entre las que destaca la velocidad. OpenBLAS es astronómicamente más rápido que la pseudoinversa integrada de MQL5. Aprender a usarlo aumentará drásticamente la velocidad de tus backtests.
Factorización matricial no supervisada: descomposición en valores singulares
Como se mencionó en la introducción, cualquier matriz de datos dada se puede descomponer en el producto de matrices más pequeñas. Estas matrices más pequeñas pueden considerarse como "hijas" de la matriz original, cada una de las cuales ofrece una descripción única de su "padre".
El algoritmo de descomposición en valores singulares (SVD, por sus siglas en inglés) es una de las muchas maneras de factorizar una matriz. La descomposición en valores singulares (SVD, por sus siglas en inglés) descompone cualquier matriz en el producto de tres matrices elementales más pequeñas. Cada una de estas tres matrices captura una característica distinta de la matriz original. En esta sección, conoceremos a cada uno de estos tres "hijos" de la factorización SVD. Exploraremos la motivación detrás de la descomposición en valores singulares (SVD) y lo que cada componente puede revelar sobre la matriz original.
Antes de profundizar, es importante aclarar la terminología. Es posible que hayas visto el término "factorización matricial no supervisada" utilizado junto con la factorización matricial, pero ambos términos no son intercambiables. La factorización matricial no supervisada es un tipo específico de técnica de factorización. Se diferencia de la factorización general en que se centra únicamente en los componentes más relevantes de los datos.
En esencia, la factorización matricial no supervisada no nos devuelve todos los hijos, sino solo los más importantes. El algoritmo descompone la matriz y luego utiliza sus propios criterios internos para decidir qué factores (o hijos) son los más valiosos. Esta decisión se toma de forma no supervisada, lo que significa que el algoritmo no se basa en resultados etiquetados ni en la intervención humana para determinar la relevancia. Nosotros no elegimos con qué niños reunirnos; el algoritmo decide por nosotros.
Como se ilustra en la Figura 5, la SVD es uno de esos métodos de factorización de matrices, que descompone cualquier matriz A en tres matrices "hijas".
OpenBLAS permite que el método SVD devuelva todas las matrices "hijas" o solo las matrices "hijas" más importantes; todo depende de los parámetros que se le pasen a la llamada a SVD.
En esta discusión, le indicaremos a la biblioteca OpenBLAS que solo nos devuelva las matrices "hijas" más importantes, de ahí el título de nuestra discusión: "Factorización de matrices no supervisada". Como ya hemos mencionado, la descomposición en valores singulares (SVD) descompondrá nuestra matriz original en el producto de 3 matrices elementales más simples. A continuación, analizaremos cada uno de estos tres componentes por separado.

Figura 5: Visualización de la factorización SVD.
La letra U describe fuerzas de mercado ocultas que parecen estar "impulsando" el comportamiento observado de nuestro mercado. Estas fuerzas ocultas se denominan más apropiadamente factores. Así, la primera columna de U nos informa de una fuerza impulsora del mercado que deprecia los 4 precios OHLC siempre que esta fuerza domine el mercado. La segunda fuerza del mercado está dominada por coeficientes positivos, lo que significa que tiene un efecto alcista general en el mercado. Dado que trabajamos con datos históricos del mercado, las fuerzas del mercado que analizamos pueden representar, en realidad, el sentimiento subyacente de los inversores.
//--- Native MQL5 SVD Solution are also possible without relying on OpenBLAS
Print("Computing Singular Value Decomposition using MQL5");
matrix U,VT;
vector S;
X.SVD(U,VT,S);

Print("U");
Print(U);
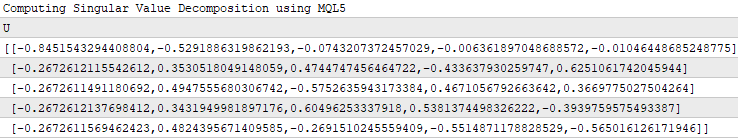
Figura 6: Comprensión del componente "U" de la descomposición en valores singulares (SVD).
V nos indica qué tan marcada o dominante es cada fuerza de U a lo largo de las observaciones temporales en el conjunto de datos original. Por ejemplo, si consideramos la primera fila de V, podemos ver que la entrada más grande es 0,4262. Este valor se encuentra en la tercera columna de la primera fila de V, lo que significa que la tercera columna de U describe la fuerza que dominó el mercado en el primer día histórico de negociación. La tercera columna de U describe una fuerza mixta que afecta negativamente a algunos componentes del precio y positivamente a otros. Dichas fuerzas pueden ser intermitentes o débiles.
Print("VT");
Print(VT);
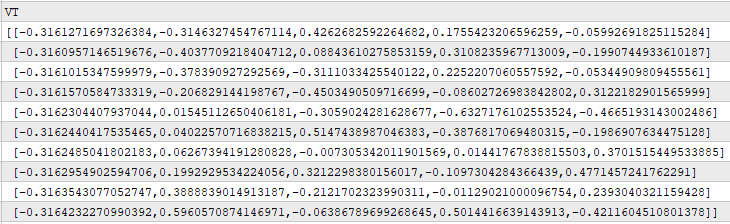
Figura 7: Comprender cuán pronunciadas son cada una de las fuerzas impulsoras del mercado en cada momento.
El factor Sigma nos informa sobre los niveles de importancia de cada una de las fuerzas del mercado, descritas en U. A la fuerza que predomina en nuestras observaciones históricas se le asigna el valor más alto en Sigma, mientras que a las fuerzas menos pronunciadas en los datos se les asignan valores más bajos en Sigma. Por lo tanto, podemos ver claramente que 3,741 es el valor más grande en Sigma, y este valor está en la primera columna de Sigma, lo que significa que la primera columna de U describe la fuerza de mercado más dominante observada en los datos.
Print("S");
Print(S);

Figura 8: Comprensión del factor Sigma a partir de la factorización SVD.
Esta discusión no pretende ser exhaustiva, aún hay mucho más que decir sobre los 3 factores, U, S y V. En las figuras 6, 7 y 8, analizamos lo que se devolvió cuando llamamos al método SVD integrado de forma nativa en MQL5. Estos resultados coinciden bastante con los que se obtienen al llamar a la función SingularValueDecompositionDC() de la biblioteca OpenBLAS.
En la Figura 9 que aparece a continuación, hemos incluido una captura de pantalla del factor U calculado con OpenBLAS. El lector puede comparar la Figura 9 con la Figura 6 para comprobar que tanto la función nativa de MQL5 como la función de OpenBLAS calculan aproximadamente el mismo factor U. Debido a las diferencias en las funciones que se implementan internamente, las dos figuras no coinciden exactamente hasta la última cifra decimal, pero esto es comprensible.
//--- OpenBLAS SVD Solution, considerably powerful substitute to the closed solution provided by the MQL5 developers
matrix OB_U,OB_VT,OB_SIGMA;
vector OB_S;

//--- Perform truncated SVD, we will explore what 'truncated' means later.
PrintFormat("Computing Singular Value Decomposition of %s Data using OpenBLAS",Symbol());
X.SingularValueDecompositionDC(SVDZ_S,OB_S,OB_U,OB_VT);

//--- U is a unitary matrix that is of dimension (m,r)
Print("Open BLAS U");
Print(OB_U);
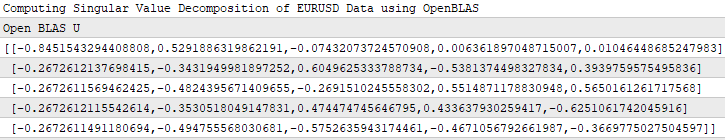
Figura 9: El factor U calculado por OpenBLAS.
En la Figura 4 anterior, demostramos que la función MQL5 PInv() siempre nos dará los coeficientes que mapean las entradas al objetivo con el menor error posible. Insistiré en este punto una vez más: no se dejen engañar por la simplicidad de la solución que se muestra en la Figura 4. Se trata de una solución matemáticamente potente cuya existencia está garantizada para cualquier matriz A arbitraria, y que además minimizará la norma L2 de la matriz Ax-b.
Lo que no mencionamos en la Figura 4 es que la función PInv() podría simplemente estar llamando a la función SVD() en su nombre. Desde el punto de vista matemático, la pseudoinversa se calcula normalmente utilizando la descomposición en valores singulares de los datos originales. Veámoslo por nosotros mismos.
En el fragmento de código que aparece a continuación, he tomado las 3 matrices hijas que almacenamos cuando llamamos a SVD() sobre nuestros datos de mercado. No repasaremos explícitamente todas las reglas del álgebra lineal que el lector necesita comprender, ni intentaremos derivar esta solución, sino que solo deseo demostrar que puedo obtener coeficientes lineales que relacionen mis datos de entrada con mi objetivo fácilmente utilizando las matrices hijas que me devolvió la descomposición en valores singulares (SVD).
Print("Comparing OLS Solutions");
Print("Native MQL5 Solution");
//--- We will always benchmark the native solution as the truth, the MQL5 developers implemented an extremely performant benchmark for us
Print(b);

//--- The OpenBLAS solution came closest to the native solution implemented for us
Print("OpenBLAS Solution");
matrix ob_solution = y.MatMul(OB_VT.Transpose().MatMul(OB_SIGMA.Inv()).MatMul(OB_U.Transpose()));
Print(ob_solution);

//--- Our manual solution was not even close! We will therefore rely on the OpenBLAS solution.
Print("Manual SVD Solution");
matrix svd_solution = y.MatMul(VT).MatMul(SIGMA.Inv()).MatMul(U.Transpose());
Print(svd_solution);
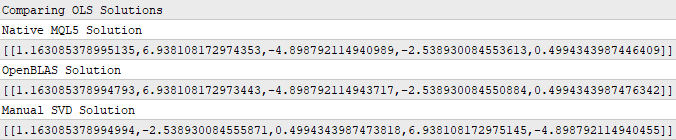
Figura 10: Los coeficientes que mejor representan mis datos de entrada y mis datos de salida se pueden obtener mediante SVD.
Si los lectores son observadores, probablemente habrán notado que ninguno de los conjuntos de coeficientes de la Figura 10 coincide exactamente con los demás. Esto es de esperar, recordemos que utilizamos 3 funciones diferentes para obtener cada conjunto de coeficientes. Esto es similar a tener 3 estudiantes independientes que realizan sus tareas utilizando sus propios métodos internos. Sin embargo, lo que más nos importa es el error que producirán estos coeficientes cuando los usemos para hacer predicciones sobre datos que no utilizamos para entrenar el modelo.
Como podemos ver en la Figura 11, la solución SVD de OpenBLAS produjo el menor error al predecir los datos de prueba. Sin embargo, quiero asegurarme de que el lector no confunda la Figura 11 con la motivación para introducir OpenBLAS.
Observe que los 3 niveles de error son moderadamente similares entre sí. Por lo tanto, si repetimos esta prueba varias veces, en diferentes mercados, obteniendo diferentes cantidades de datos en cada ronda de pruebas, es posible que OpenBLAS no siempre produzca el menor error. Quiero que el lector comprenda que la biblioteca OpenBLAS nos resulta atractiva porque está cuidadosamente optimizada y se mantiene activamente para que sea rápida y fiable. No se garantiza que siempre produzca el menor error; ninguna biblioteca puede hacer una afirmación tan general.
//--- Measuring the amount of error
//--- Information lost by MQL5 PsuedoInverse solution
//--- The Frobenius norm squares all
PrintFormat("Information Loss in Forcasting %s Market : ",Symbol());
Print("PInv: ");
matrix pinv_error = ((b.MatMul(X_test)) - y_test);
Print(pinv_error.Norm(MATRIX_NORM_FROBENIUS));

//--- Let the MQL5 implementation be our benchmark
double benchmark = pinv_error.Norm(MATRIX_NORM_FROBENIUS);

//--- Information lost by Manual SVD solution
Print("Manual SVD: ");
matrix svd_error = ((svd_solution.MatMul(X_test)) - y_test);
Print(svd_error.Norm(MATRIX_NORM_FROBENIUS));

//--- Information lost by OpenBLAS SVD solution
Print("OpenBLAS SVD: ");
matrix ob_error = ((ob_solution.MatMul(X_test)) - y_test);
Print(ob_error.Norm(MATRIX_NORM_FROBENIUS));
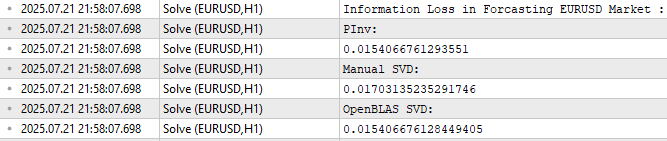
Figura 11: Cantidad de error producida por cada conjunto de coeficientes al realizar predicciones fuera del período de entrenamiento.
Aplicaciones de la factorización matricial no supervisada más allá de la modelización predictiva
Espero que, llegados a este punto, mi sencillo estilo de presentación les haya dado algunas ideas sobre qué es la factorización matricial y por qué puede ser útil al analizar datos del mercado financiero. Como ya he mencionado anteriormente, los modelos predictivos que podemos construir utilizando las factorizaciones matriciales adecuadas representan solo una fracción de las tareas útiles que podemos realizar mediante la factorización matricial. En esta sección, me gustaría mostrar otras aplicaciones útiles de la factorización matricial y cómo podemos incorporar estos conocimientos a nuestras aplicaciones y estrategias de trading.
Factorización matricial para el filtrado de mercado no supervisado
Doy por sentado que el lector tiene alguna experiencia personal en el mundo de las inversiones y que, gracias a su práctica independiente, comprende la cuestión que estoy a punto de plantear. Entre el mercado de divisas y el mercado de criptomonedas, ¿qué clase de activo cree que es más volátil?
Espero que la respuesta haya sido obvia para todos nosotros. Las criptomonedas son mucho más volátiles que los mercados de divisas tradicionales. Para los lectores que no estén seguros de cuál es la verdad, aplicamos el indicador Average True Range (ATR) al gráfico de 1 minuto de Bitcoin cotizado en Ethereum en un gráfico (Figura 12), y el segundo gráfico muestra el euro cotizado en dólares estadounidenses a continuación (Figura 13). El indicador ATR mide la volatilidad del mercado; valores más altos de ATR implican condiciones de mercado más volátiles. La lectura ATR en el gráfico BTCETH es aproximadamente un 6000% mayor que la lectura ATR en el gráfico EURUSD. Por lo tanto, esto ayuda a todos los lectores a comprender por qué los mercados de criptomonedas se consideran, en general, mucho más volátiles que los mercados de divisas tradicionales.
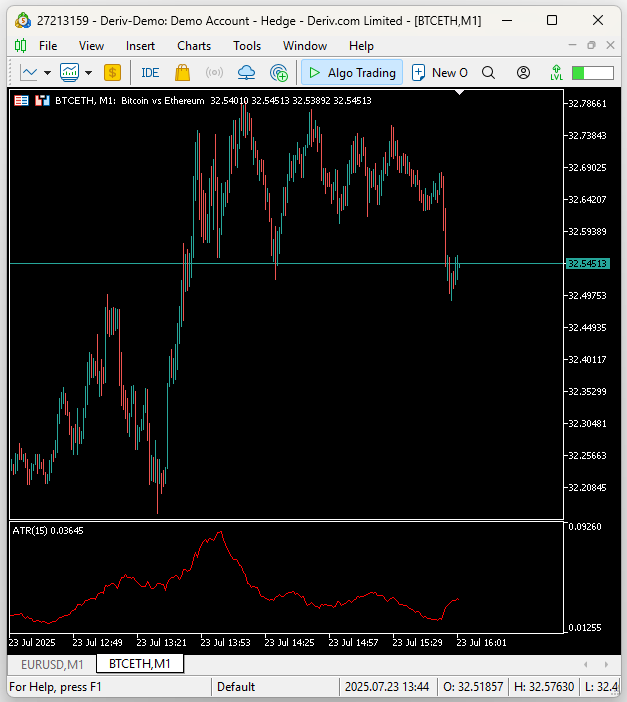
Figura 12: La lectura de volatilidad de BTCETH es considerablemente más volátil que la de EURUSD.
Recordemos que el EURUSD es el par de divisas con mayor liquidez del mundo, el par de divisas más negociado que se conoce, pero sus niveles de volatilidad palidecen en comparación con la volatilidad que observamos en los mercados de criptomonedas.
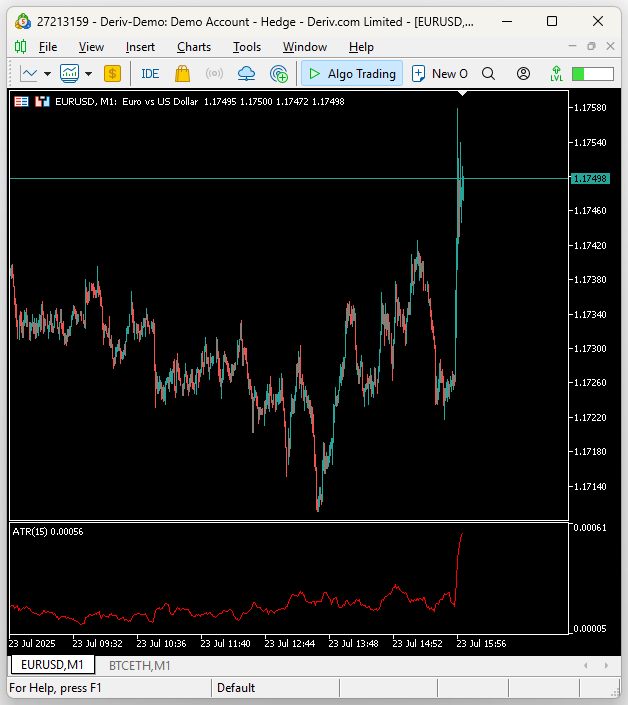
Figura 13: La volatilidad de las clases de activos tradicionales no se compara con la volatilidad generada por los mercados de criptomonedas.
Las factorizaciones matriciales que realizamos anteriormente podrían habernos proporcionado fácilmente la misma información. Recordemos que en la Figura 8 explicamos que el factor Sigma denota los niveles de importancia de cada una de las fuerzas impulsoras del mercado que aparecen en los datos. Los mercados estables solo tendrán una entrada importante en el factor S, y todas las demás entradas estarán cerca de 0. Cuantas más entradas en S estén lejos de 0, más caótico y volátil parece ser un mercado según los datos.
Podemos aplicar nuestro script dos veces, una vez en el mercado EURUSD y la segunda vez en el mercado BTCETH. Sin embargo, en las figuras 14 y 15, ambos mercados parecen ser estables. Parece que ambos mercados solo tienen una entrada importante distinta de cero en S. Esto implicaría que BTCETH es tan estable y se comporta tan bien como EURUSD. Sin embargo, esta no es toda la verdad. Para obtener una imagen fiable, debemos aprender otro uso de la factorización matricial.
//+------------------------------------------------------------------+
//| What are we demonstrating here?                                  |
//| 1) We have shown you that any matrix of market data you have,    |
//|    can be analyzed intelligently, to build a linear regression   |
//|    model, using just the raw data.                               |
//| 2) We have demonstrated that the solution to such Linear         |
//|    regression problems, can be obtained through effecient and    |
//|    dedicated functions available in MQL5 or through matrix       |
//|    factorization.                                                |
//|__________________________________________________________________|
//| I now ask the reader the following question:                     |
//|  "If dedicated functions exist, why bother learning matrix       |
//|   factorization?"                                                |
//+------------------------------------------------------------------+

//--- Matrix factorization gives us a description of the data and it properties
//--- Questions such as: "How stable/chaotic is the market we are in?" can be answered by the factorization we have just performed
//--- Or even questions such as: "How best can I expose the hidden trends in all of this market data?" can still be answered by the factorization we have just performed
//--- I'm only trying to give you a few examples of why you should bother learning these factorizations, even though dedicated functions exist.

//--- Any given matrix A can be represented as the sum of smaller matrices A = USV, this is theorem behind the Singular Value Decomposition.
//--- Each factor is special because each describes different charectersitics of its parent.

//--- Let's get to know Sigma, represented as the S in A = USV.
//--- Sigma technically tells us how many different modes our market appears to exist in, and how important each mode is.
//--- However, reintepreted in terms of market data, these modes may correspond to investor sentiment.
PrintFormat("Taking a closer look at The Eigenvalues of %s Market Data: ",Symbol());
Print(OB_S/OB_S.Sum());
Print("If sigma has a only few values that are far from 0, then investor's sentiment in this market appears well established and hardly changes");
//--- If Sigma has a lot values that are all far away from 0, then the market is chaotic and it appears investor's sentiment and expectations constantly change
//--- If Sigma has a few, or even just one value that is far away from 0, then investor sentiment in that market appears stable, and hardly changes.
//--- Traders explicitly looking for fast-action scalping oppurtunities may use Sigma as a filter of how much energy the market has.
//--- Quiet market will have a few dominant values in Sigma, not ideal for scalpers, better suited for long-term trend traders.

Figura 14: Visualización de la cantidad de energía en el mercado EURUSD.

Figura 15: Visualización de la cantidad de energía en el mercado BTCETH.
Factorización matricial para compresión de datos y extracción de señales.
La factorización matricial también puede utilizarse para comprimir datos y extraer la señal dominante de los mismos. Dado que las matrices hijas son más pequeñas que su matriz padre, estos algoritmos pueden compactar los datos de manera eficiente. Estas propiedades de la factorización matricial son bien conocidas por cualquier miembro de nuestra comunidad que tenga experiencia en campos como redes, procesamiento de señales, ingeniería eléctrica u otros ámbitos relacionados. Podemos comprimir nuestros datos originales multiplicando las matrices "hija" S y V. Nótese que, antes de realizar la multiplicación, aplicamos el método Diag() a S para convertirla en una matriz diagonal. El resultado de esta multiplicación es una nueva representación compacta de la matriz original.
Es posible que el lector ya esté familiarizado con este algoritmo, conocido comúnmente como «Análisis de Componentes Principales» (Principal Component Analysis, PCA). No profundizaremos en el análisis de componentes principales (PCA), sino que simplemente intentaré demostrar la gran cantidad de información útil que obtenemos al utilizar la factorización matricial. Existen muchas maneras de calcular los componentes principales de sus datos de mercado; la factorización matricial mediante OpenBLAS es probablemente uno de los métodos más rápidos disponibles de forma nativa en MQL5.
//--- Fetch the data and prepare to perform PCA
temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_OPEN,START+HORIZON+(FETCH*2),FETCH);
row_norms[0] = temp.Mean();
X.Row(temp-row_norms[0],1);

temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_HIGH,START+HORIZON+(FETCH*2),FETCH);
row_norms[1] = temp.Mean();
X.Row(temp-row_norms[1],2);

temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_LOW,START+HORIZON+(FETCH*2),FETCH);
row_norms[2] = temp.Mean();
X.Row(temp-row_norms[2],3);

temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_CLOSE,START+HORIZON+(FETCH*2),FETCH);
row_norms[3] = temp.Mean();
X.Row(temp-row_norms[3],4);

//--- Fetch the test data
temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_OPEN,START+HORIZON+(FETCH),FETCH);
X_test.Row(temp-row_norms[0],1);

temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_HIGH,START+HORIZON+(FETCH),FETCH);
X_test.Row(temp-row_norms[1],2);

temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_LOW,START+HORIZON+(FETCH),FETCH);
X_test.Row(temp-row_norms[2],3);

temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_CLOSE,START+HORIZON+(FETCH),FETCH);
X_test.Row(temp-row_norms[3],4);

//--- Perform truncated SVD, we will explore what 'truncated' means later.
Print("Computing Singular Value Decomposition using OpenBLAS");
X.SingularValueDecompositionDC(SVDZ_S,OB_S,OB_U,OB_VT);

OB_SIGMA.Diag(OB_S);

//--- Calculating Principal Components
Print("Principal Components");
matrix pc = OB_SIGMA.MatMul(OB_VT);
Print(pc);
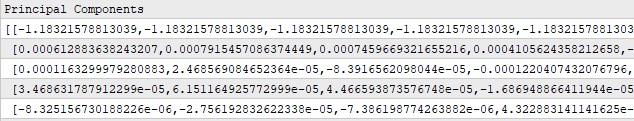
Figura 16: Al multiplicar los factores S y V, obtenemos una representación compacta de nuestro conjunto de datos original.
Todavía hay mucho más que podemos discutir sobre el producto resultante de multiplicar los "hijos" S y V. El resultado de esta multiplicación produce una nueva representación de nuestro conjunto de datos que tiene una correlación considerablemente menor. Para demostrarlo, compararemos la norma de la matriz de correlación de nuestro conjunto de datos original con la matriz de correlación resultante de la multiplicación de S y V. Recordemos que la norma en álgebra lineal es análoga a preguntar "cuán grande" es algo. Como podemos observar en la Figura 17, la norma de la matriz de correlación disminuyó considerablemente después de factorizar los datos de mercado originales.
El objetivo es ilustrar al lector que la factorización matricial mediante SVD puede utilizarse para eliminar características correlacionadas redundantes en el conjunto de datos original y, con suerte, al hacerlo, pretendemos exponer mejor las tendencias y patrones dominantes en los datos.
//--- PCA reduces the amount of correlation in our dataset
Print("How correlated is our new representation of the data?");
//--- First we will measure the size of our original correlation matrix
Print(X.Norm(MATRIX_NORM_FROBENIUS));
//--- Then, we will measure the size of our new correlation matrix produced by factorizing the data
Print(pc.CorrCoef().Norm(MATRIX_NORM_FROBENIUS));

Figura 17: La factorización matricial puede ayudarnos a reducir significativamente la cantidad de correlación en nuestro conjunto de datos.
Con esta información, podemos construir un modelo de mercado que utilice solo 3 filas de datos en lugar de las 5 filas de datos originales con las que empezamos. Con suerte, estas 3 filas menos correlacionadas explicarán mejor la relación entre el mercado y el objetivo, mejor que los datos originales. Esto se denomina extracción de características, porque aprendemos nuevas características a partir de los datos originales. Pero, como ocurre con la mayoría de las prácticas relacionadas con la optimización, no tenemos la garantía de que esto mejore nuestro rendimiento en el futuro, como se muestra en la Figura 18.
//--- Main principal components
matrix mpc;

mpc.Row(pc.Row(0),0);
mpc.Row(pc.Row(1),1);
mpc.Row(pc.Row(2),2);

//--- The factor VT describes the correlational structure across the columns of our data
Print("Performing PCA");
matrix pca_coefs = y.MatMul(mpc.PInv());

//--- Performing PCA on the test data
X_test.SingularValueDecompositionDC(SVDZ_S,OB_S,OB_U,OB_VT);
Print("Principal Components of Test Data");
pc = OB_SIGMA.MatMul(OB_VT);

Print(pc);

PrintFormat("Most Important Principal Components in %s Market Test Data",Symbol());
Print(OB_S / OB_S.Sum());

//--- Main principal components
mpc.Row(pc.Row(0),0);
mpc.Row(pc.Row(1),1);
mpc.Row(pc.Row(2),2);

matrix pca_error = pca_coefs.MatMul(mpc) - y_test;

Print("PCA Error: ");
Print(pca_error.Norm(MATRIX_NORM_FROBENIUS));

Print("OpenBLAS Error: ");
Print(ob_error.Norm(MATRIX_NORM_FROBENIUS));

Print("Manual Error: ");
Print(svd_error.Norm(MATRIX_NORM_FROBENIUS));
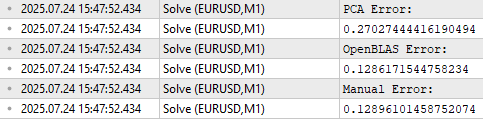
Figura 18: La extracción de características es un método numérico potente, pero no garantiza un mejor rendimiento.
En las figuras 14 y 15, intentamos ilustrar que la factorización matricial puede utilizarse para distinguir los mercados estables de los mercados volátiles. En nuestro primer intento, ambos mercados parecían tener solo 1 valor grande en el factor S. Sin embargo, tras examinar detenidamente los datos, descubrí que esto solo era cierto en el conjunto de entrenamiento. Si factorizamos el conjunto de prueba de nuestros datos de mercado y luego analizamos el factor S obtenido, podemos empezar a ver que, efectivamente, BTCETH tiene más "energía" que EURUSD, porque BTCETH tiene 2 entradas en S que están lejos de 0, mientras que EURUSD solo tiene 1.
//--- Performing PCA on the test data
X_test.SingularValueDecompositionDC(SVDZ_S,OB_S,OB_U,OB_VT);
Print("Principal Components of Test Data");
pc = OB_SIGMA.MatMul(OB_VT);


PrintFormat("Most Important Principal Components in %s Market Test Data",Symbol());
Print(OB_S / OB_S.Sum());

Figura 19: Análisis de la cantidad de energía contenida en el mercado EURUSD.

Figura 19-1: Análisis de la cantidad de energía contenida en el mercado BTCETH. Recuerda que cuantas más entradas individuales lejos de 0 observes, más caótico es el mercado.
Este es el script MQL5 que preparé para nuestra discusión sobre factorización matricial no supervisada.
//+------------------------------------------------------------------+
//|                                                        Solve.mq5 |
//|                                               Gamuchirai Ndawana |
//|                    https://www.mql5.com/en/users/gamuchiraindawa |
//+------------------------------------------------------------------+
#property copyright "Gamuchirai Ndawana"
#property link      "https://www.mql5.com/en/users/gamuchiraindawa"
#property version   "1.00"
#property script_show_inputs

//+------------------------------------------------------------------+
//| System definitions                                               |
//+------------------------------------------------------------------+
#define HORIZON 10
#define START   0

//+------------------------------------------------------------------+
//| User inputs                                                      |
//+------------------------------------------------------------------+
input int FETCH =  10;//How many bars should we fetch?

//+------------------------------------------------------------------+
//| Global variables                                                 |
//+------------------------------------------------------------------+
int ROWS        =   5;
//Dependent variable
matrix y,y_test;
//Indenpendent variable
matrix X = matrix::Ones(ROWS,FETCH);
matrix X_test = matrix::Ones(ROWS,FETCH);
//Coefficients
matrix b;
vector temp;
//Row Norms
vector row_norms = vector::Zeros(4);
vector error_vector = vector::Zeros(4);

//+------------------------------------------------------------------+
//| Script program start function                                    |
//+------------------------------------------------------------------+
void OnStart()
  {
//--- Observe the input matrix in its original form
PrintFormat("Input Matrix Gathered From %s",Symbol());
Print(X);

//--- Fetch the data
temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_OPEN,START+HORIZON+(FETCH*2),FETCH);
row_norms[0] = temp.Norm(VECTOR_NORM_P);
X.Row(temp/row_norms[0],1);

temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_HIGH,START+HORIZON+(FETCH*2),FETCH);
row_norms[1] = temp.Norm(VECTOR_NORM_P);
X.Row(temp/row_norms[1],2);

temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_LOW,START+HORIZON+(FETCH*2),FETCH);
row_norms[2] = temp.Norm(VECTOR_NORM_P);
X.Row(temp/row_norms[2],3);

temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_CLOSE,START+HORIZON+(FETCH*2),FETCH);
row_norms[3] = temp.Norm(VECTOR_NORM_P);
X.Row(temp/row_norms[3],4);

//--- Fetch the test data
temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_OPEN,START+HORIZON+(FETCH),FETCH);
X_test.Row(temp/row_norms[0],1);

temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_HIGH,START+HORIZON+(FETCH),FETCH);
X_test.Row(temp/row_norms[1],2);

temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_LOW,START+HORIZON+(FETCH),FETCH);
X_test.Row(temp/row_norms[2],3);

temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_CLOSE,START+HORIZON+(FETCH),FETCH);
X_test.Row(temp/row_norms[3],4);

//--- The train data
Print("Input");
Print(X);

//--- Fill the target
y.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_CLOSE,START+(FETCH*2),FETCH);
y_test.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_CLOSE,START,FETCH);

Print("Target");
Print(y);

//--- More Penrose Psuedo Inverse Solution implemented by MQL5 Developers, enterprise level effeciency!
b = y.MatMul(X.PInv());

Print("Pseudo Inverse Solution: ");
Print(b);

//--- Native MQL5 SVD Solution are also possible without relying on OpenBLAS
Print("Computing Singular Value Decomposition using MQL5");
matrix U,VT;
vector S;
X.SVD(U,VT,S);

Print("U");
Print(U);

Print("VT");
Print(VT);

Print("S");
Print(S);
matrix SIGMA;
SIGMA.Diag(S);

//--- OpenBLAS SVD Solution, considerably powerful substitute to the closed solution provided by the MQL5 developers
matrix OB_U,OB_VT,OB_SIGMA;
vector OB_S;

//--- Perform truncated SVD, we will explore what 'truncated' means later.
PrintFormat("Computing Singular Value Decomposition of %s Data using OpenBLAS",Symbol());
X.SingularValueDecompositionDC(SVDZ_S,OB_S,OB_U,OB_VT);

//--- U is a unitary matrix that is of dimension (m,r)
Print("Open BLAS U");
Print(OB_U);

//--- VT is a mathematically a symmetrical matrix that is (r,r), for effeciency in software it is represented as a vector that is (1,r)
Print("Open BLAS VT");
Print(OB_VT);

//--- We need it in its intended form as an (r,r) matrix, we will explore what this means later.
Print("Open BLAS S");
Print(OB_S);
OB_SIGMA.Diag(OB_S);

Print("Comparing OLS Solutions");
Print("Native MQL5 Solution");
//--- We will always benchmark the native solution as the truth, the MQL5 developers implemented an extremely performant benchmark for us
Print(b);

//--- The OpenBLAS solution came closest to the native solution implemented for us
Print("OpenBLAS Solution");
matrix ob_solution = y.MatMul(OB_VT.Transpose().MatMul(OB_SIGMA.Inv()).MatMul(OB_U.Transpose()));
Print(ob_solution);

//--- Our manual solution was not even close! We will therefore rely on the OpenBLAS solution.
Print("Manual SVD Solution");
matrix svd_solution = y.MatMul(VT).MatMul(SIGMA.Inv()).MatMul(U.Transpose());
Print(svd_solution);

//--- Measuring the amount of error
//--- Information lost by MQL5 PsuedoInverse solution
//--- The Frobenius norm squares all
PrintFormat("Information Loss in Forcasting %s Market : ",Symbol());
Print("PInv: ");
matrix pinv_error = ((b.MatMul(X_test)) - y_test);
Print(pinv_error.Norm(MATRIX_NORM_FROBENIUS));

//--- Let the MQL5 implementation be our benchmark
double benchmark = pinv_error.Norm(MATRIX_NORM_FROBENIUS);

//--- Information lost by Manual SVD solution
Print("Manual SVD: ");
matrix svd_error = ((svd_solution.MatMul(X_test)) - y_test);
Print(svd_error.Norm(MATRIX_NORM_FROBENIUS));

//--- Information lost by OpenBLAS SVD solution
Print("OpenBLAS SVD: ");
matrix ob_error = ((ob_solution.MatMul(X_test)) - y_test);
Print(ob_error.Norm(MATRIX_NORM_FROBENIUS));

//+------------------------------------------------------------------+
//| What are we demonstrating here?                                  |
//| 1) We have shown you that any matrix of market data you have,    |
//|    can be analyzed intelligently, to build a linear regression   |
//|    model, using just the raw data.                               |
//| 2) We have demonstrated that the solution to such Linear         |
//|    regression problems, can be obtained through effecient and    |
//|    dedicated functions available in MQL5 or through matrix       |
//|    factorization.                                                |
//|__________________________________________________________________|
//| I now ask the reader the following question:                     |
//|  "If dedicated functions exist, why bother learning matrix       |
//|   factorization?"                                                |
//+------------------------------------------------------------------+

//--- Matrix factorization gives us a description of the data and it properties
//--- Questions such as: "How stable/chaotic is the market we are in?" can be answered by the factorization we have just performed
//--- Or even questions such as: "How best can I expose the hidden trends in all of this market data?" can still be answered by the factorization we have just performed
//--- I'm only trying to give you a few examples of why you should bother learning these factorizations, even though dedicated functions exist.

//--- Any given matrix A can be represented as the sum of smaller matrices A = USV, this is theorem behind the Singular Value Decomposition.
//--- Each factor is special because each describes different charectersitics of its parent.

//--- Let's get to know Sigma, represented as the S in A = USV.
//--- Sigma technically tells us how many different modes our market appears to exist in, and how important each mode is.
//--- However, reintepreted in terms of market data, these modes may correspond to investor sentiment.
PrintFormat("Taking a closer look at The Eigenvalues of %s Market Data: ",Symbol());
Print(OB_S/OB_S.Sum());
Print("If sigma has a only few values that are far from 0, then investor's sentiment in this market appears well established and hardly changes");
//--- If Sigma has a lot values that are all far away from 0, then the market is chaotic and it appears investor's sentiment and expectations constantly change
//--- If Sigma has a few, or even just one value that is far away from 0, then investor sentiment in that market appears stable, and hardly changes.
//--- Traders explicitly looking for fast-action scalping oppurtunities may use Sigma as a filter of how much energy the market has.
//--- Quiet market will have a few dominant values in Sigma, not ideal for scalpers, better suited for long-term trend traders.

//--- Fetch the data and prepare to perform PCA
temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_OPEN,START+HORIZON+(FETCH*2),FETCH);
row_norms[0] = temp.Mean();
X.Row(temp-row_norms[0],1);

temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_HIGH,START+HORIZON+(FETCH*2),FETCH);
row_norms[1] = temp.Mean();
X.Row(temp-row_norms[1],2);

temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_LOW,START+HORIZON+(FETCH*2),FETCH);
row_norms[2] = temp.Mean();
X.Row(temp-row_norms[2],3);

temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_CLOSE,START+HORIZON+(FETCH*2),FETCH);
row_norms[3] = temp.Mean();
X.Row(temp-row_norms[3],4);

//--- Fetch the test data
temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_OPEN,START+HORIZON+(FETCH),FETCH);
X_test.Row(temp-row_norms[0],1);

temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_HIGH,START+HORIZON+(FETCH),FETCH);
X_test.Row(temp-row_norms[1],2);

temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_LOW,START+HORIZON+(FETCH),FETCH);
X_test.Row(temp-row_norms[2],3);

temp.CopyRates(Symbol(),PERIOD_CURRENT,COPY_RATES_CLOSE,START+HORIZON+(FETCH),FETCH);
X_test.Row(temp-row_norms[3],4);

//--- Perform truncated SVD, we will explore what 'truncated' means later.
Print("Computing Singular Value Decomposition using OpenBLAS");
X.SingularValueDecompositionDC(SVDZ_S,OB_S,OB_U,OB_VT);

//--- Calculating Principal Components
Print("Principal Components");
matrix pc = OB_SIGMA.MatMul(OB_VT);
Print(pc);

PrintFormat("Most Important Principal Components of %s Market Data",Symbol());
Print(OB_S / OB_S.Sum());

//--- Main principal components
matrix mpc;

mpc.Row(pc.Row(0),0);
mpc.Row(pc.Row(1),1);
mpc.Row(pc.Row(2),2);

//--- The factor VT describes the correlational structure across the columns of our data
Print("Performing PCA");
matrix pca_coefs = y.MatMul(mpc.PInv());

//--- Performing PCA on the test data
X_test.SingularValueDecompositionDC(SVDZ_S,OB_S,OB_U,OB_VT);
Print("Principal Components of Test Data");
pc = OB_SIGMA.MatMul(OB_VT);

Print(pc);

PrintFormat("Most Important Principal Components in %s Market Test Data",Symbol());
Print(OB_S / OB_S.Sum());

//--- Main principal components
mpc.Row(pc.Row(0),0);
mpc.Row(pc.Row(1),1);
mpc.Row(pc.Row(2),2);

matrix pca_error = pca_coefs.MatMul(mpc) - y_test;

Print("PCA Error: ");
Print(pca_error.Norm(MATRIX_NORM_FROBENIUS));

Print("OpenBLAS Error: ");
Print(ob_error.Norm(MATRIX_NORM_FROBENIUS));

Print("Manual Error: ");
Print(svd_error.Norm(MATRIX_NORM_FROBENIUS));

}
//+------------------------------------------------------------------+
Construyendo nuestra aplicación
Comenzaremos a combinar lo que hemos comentado hasta ahora en una única estrategia de inversión. Nuestra estrategia busca determinar un precio de mercado justo mediante la predicción del valor futuro del indicador de media móvil. Este valor esperado nos ayudará a posicionar nuestras operaciones de manera que, cuando los niveles de precios estén por encima de nuestras expectativas, venderemos porque creemos que el mercado está sobrevalorado; lo contrario ocurre con nuestras posiciones largas.Apliquemos una media móvil de 10 periodos al gráfico diario del EURUSD y desplacémosla hacia adelante para imaginar su valor desplazado como nuestra predicción.
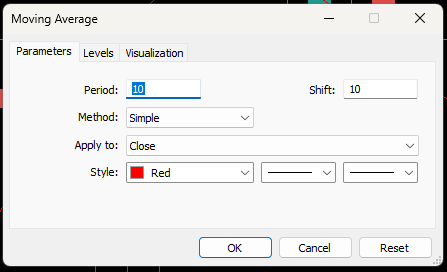
Figura 20: A modo de ejemplo, simplemente desplazamos el indicador de media móvil 10 pasos hacia adelante.
Nuestra estrategia de negociación parte esencialmente de la premisa de que los niveles de precios actuales acabarán alineándose con el valor esperado. En la configuración representada en la Figura 21, el precio esperado es bajo, mientras que el precio actual es alto. Supongamos que la Figura 21 fue generada por nuestra predicción de mercado; esta sería nuestra señal.
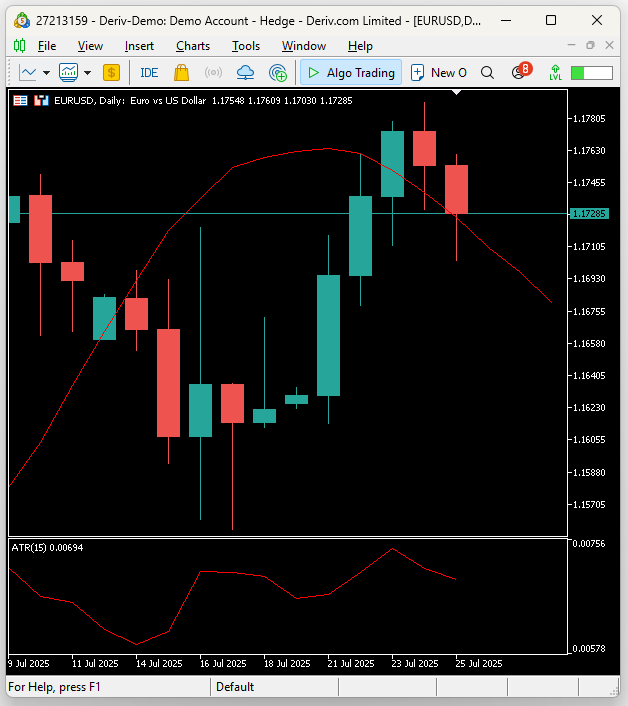
Figura 21: Visualizando nuestra estrategia de negociación, la media móvil desplazada implica que negociaremos en función de dónde anticipa nuestro modelo que estará la media móvil.
Establecimiento de una línea de base
Antes de desarrollar nuestra aplicación, debemos establecer una base de referencia para evaluar el rendimiento de nuestro modelo de IA. Esta línea de base demostrará el resultado esperado sin utilizar inteligencia artificial. Dado que en las siguientes secciones exploraremos la implementación completa de nuestra aplicación, ahora destacaré brevemente los elementos clave de la versión base.
//+------------------------------------------------------------------+
//| Obtain a prediction from our model                               |
//+------------------------------------------------------------------+
void setup(void)
  {
   y.CopyIndicatorBuffer(ma_close_handler,0,0,bars);

   Print("Training Target");
   Print(y);

//--- Get a prediction
   prediction = y.Mean();
   Print("Prediction");
   Print(prediction);
  }
//+------------------------------------------------------------------+
El modelo de referencia realiza sus predicciones replicando los valores del indicador de media móvil: calcula su media y opera en función de ella. Si el valor medio del indicador de media móvil supera el precio actual, compramos; de lo contrario, vendemos.
if(prediction > c)
  {
   Trade.Buy(TradeInformation.MinVolume(),Symbol(),TradeInformation.GetAsk(),proposed_buy_sl,0);
   state = 1;
  }
if(prediction < c)
  {
   Trade.Sell(TradeInformation.MinVolume(),Symbol(),TradeInformation.GetBid(),proposed_sell_sl,0);
   state = -1;
  }
Ahora aplicaremos nuestra aplicación al par EURUSD, como se muestra en la Figura 22, utilizando dos años de datos históricos desde enero de 2023 hasta marzo de 2025.
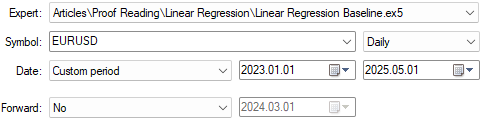
Figura 22: Prueba de nuestra aplicación base con datos históricos del mercado.
La figura 23 muestra la configuración de la aplicación que estamos utilizando. Es importante mantener fijos estos parámetros de entrada en todas las pruebas para garantizar comparaciones justas.
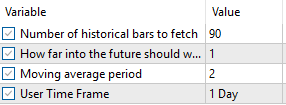
Figura 23: Mantendremos fijos nuestros parámetros de referencia para garantizar comparaciones justas.
La figura 24 presenta la curva de capital generada por nuestra estrategia de negociación. Los resultados demuestran que nuestro enfoque es sólido, ya que el saldo de la cuenta muestra una tendencia positiva a lo largo del tiempo.
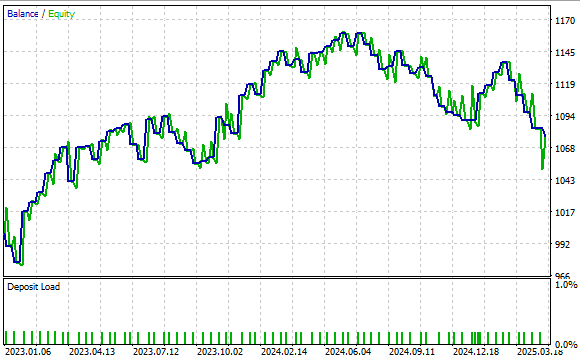
Figura 24: Nuestra aplicación de referencia ha establecido un alto nivel de rendimiento que nos permitirá superarlo con nuestra nueva comprensión de la factorización de matrices.
La figura 25 proporciona métricas de rendimiento detalladas. La estrategia logró una tasa de éxito del 51%, lo que demuestra una rentabilidad constante. Obtuvo un índice de Sharpe positivo de 0,47, un valor saludable. Si bien futuras mejoras podrían aumentar esta proporción, el sistema ya proporciona un sólido punto de referencia. Incluso con predicciones ingenuas de los valores futuros de la media móvil, podemos construir una estrategia rentable. Ahora, exploremos los beneficios de realizar predicciones mejor fundamentadas.
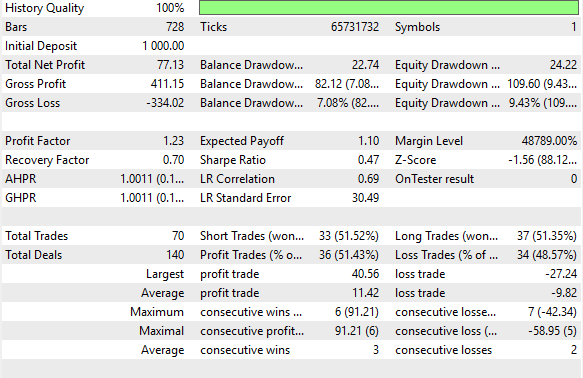
Figura 25: Análisis detallado de nuestros niveles de rendimiento de referencia.
Mejorando nuestros resultados
Ya estamos listos para comenzar a desarrollar nuestra aplicación en MQL5. Comenzaremos definiendo las constantes clave del sistema necesarias hasta el momento. Estas constantes controlarán los indicadores técnicos en los que se basará nuestro sistema, además de definir el número total de datos de entrada necesarios para la aplicación.
//+------------------------------------------------------------------+
//|                                            Linear Regression.mq5 |
//|                                               Gamuchirai Ndawana |
//|                    https://www.mql5.com/en/users/gamuchiraindawa |
//+------------------------------------------------------------------+
#property copyright "Gamuchirai Ndawana"
#property link      "https://www.mql5.com/en/users/gamuchiraindawa"
#property version   "1.00"

//+------------------------------------------------------------------+
//| System constants                                                 |
//+------------------------------------------------------------------+
#define TOTAL_INPUTS 6
A continuación, definiremos los parámetros de entrada del sistema que los usuarios pueden ajustar para modificar el comportamiento del mismo.
//+------------------------------------------------------------------+
//| System Inputs                                                    |
//+------------------------------------------------------------------+
input int bars = 10;//Number of historical bars to fetch
input int horizon = 10;//How far into the future should we forecast
input int MA_PERIOD = 24; //Moving average period
input ENUM_TIMEFRAMES TIME_FRAME = PERIOD_H1;//User Time Frame
También declararemos un conjunto de variables globales importantes para realizar un seguimiento de todos los parámetros utilizados por nuestro modelo de regresión lineal.
//+------------------------------------------------------------------+
//| Dependencies                                                     |
//+------------------------------------------------------------------+
#include <Trade\Trade.mqh>
#include <VolatilityDoctor\Time\Time.mqh>
#include <VolatilityDoctor\Trade\TradeInfo.mqh>
Durante la secuencia de inicialización de nuestro Asesor Experto, instanciaremos todas las variables globales con sus valores predeterminados e inicializaremos los indicadores técnicos relevantes.
//+------------------------------------------------------------------+
//| Global Variables                                                 |
//+------------------------------------------------------------------+
int        ma_close_handler;
double     ma_close[];
Time       *Timer;
TradeInfo  *TradeInformation;
vector     bias,temp,Z1,Z2;
matrix     X,y,prediction,b;
int        time;
CTrade Trade;
int state;
int atr_handler;
double atr[];
En la secuencia de desinicialización, liberaremos cualquier espacio previamente asignado a variables globales, incluidos los indicadores técnicos que ya no sean necesarios.
//+------------------------------------------------------------------+
//| Expert initialization function                                   |
//+------------------------------------------------------------------+
int OnInit()
  {
//---
   Timer            = new Time(Symbol(),TIME_FRAME);
   TradeInformation        = new TradeInfo(Symbol(),TIME_FRAME);
   ma_close_handler = iMA(Symbol(),TIME_FRAME,MA_PERIOD,0,MODE_SMA,PRICE_CLOSE);
   bias = vector::Ones(TOTAL_INPUTS);
   Z1 = vector::Ones(TOTAL_INPUTS);
   Z2 = vector::Ones(TOTAL_INPUTS);
   X = matrix::Ones(TOTAL_INPUTS,bars);
   y = matrix::Ones(1,bars);
   time = 0;
   state = 0;
   atr_handler = iATR(Symbol(),TIME_FRAME,14);
//---
   return(INIT_SUCCEEDED);
  }
Cuando nuestra aplicación recibe información actualizada sobre los precios, queremos ajustar adecuadamente las ponderaciones de los coeficientes de nuestro modelo y mantenerlos en estrecha relación con las condiciones actuales del mercado. Esto significa que calcularemos la factorización SVD un número considerable de veces durante nuestra prueba retrospectiva. Sin embargo, esta es la ventaja de la fácil implementación que nos proporcionó el equipo de OpenBLAS. Las múltiples llamadas que realizaremos apenas ralentizan la velocidad de nuestras pruebas retrospectivas históricas.
//+------------------------------------------------------------------+
//| Expert tick function                                             |
//+------------------------------------------------------------------+
void OnTick()
  {
//---
   if(Timer.NewCandle())
     {
      setup();
      double c =  iClose(Symbol(),TIME_FRAME,0);
      CopyBuffer(atr_handler,0,0,1,atr);
      CopyBuffer(ma_close_handler,0,0,1,ma_close);

      if(PositionsTotal() == 0)
        {
         state = 0;
         if(prediction[0,0] > c)
           {
            Trade.Buy(TradeInformation.MinVolume(),Symbol(),TradeInformation.GetAsk(),(TradeInformation.GetBid() - (2 * atr[0])),0);
            state = 1;
           }
         if(prediction[0,0] < c)
           {
            Trade.Sell(TradeInformation.MinVolume(),Symbol(),TradeInformation.GetBid(),(TradeInformation.GetAsk() + (2 * atr[0])),0);
            state = -1;
           }
        }

      if(PositionsTotal() > 0)
        {
         if(((state == -1) && (prediction[0,0] > c)) || ((state == 1)&&(prediction[0,0] < c)))
            Trade.PositionClose(Symbol());
            if(PositionSelect(Symbol()))
               {
                  double current_sl = PositionGetDouble(POSITION_SL);

                  if((state == 1) && ((ma_close[0] - (2 * atr[0]))>current_sl))
                     {
                        Trade.PositionModify(Symbol(),(ma_close[0] - (2 * atr[0])),0);
                     }

                  else if((state == -1) && ((ma_close[0] + (1 * atr[0]))<current_sl))
                     {
                        Trade.PositionModify(Symbol(),(ma_close[0] + (2 * atr[0])),0);
                     }
               }
        }
     }
  }
Finalmente, definimos la función utilizada para obtener predicciones de nuestro modelo de regresión lineal utilizando los valores Z estandarizados y escalados que se registran en vectores denominados Z1 (para la media) y Z2 (para la desviación estándar). Cada uno de estos vectores fila escalados se almacena en la matriz X_inputs, y el valor de media móvil asociado que pretendemos predecir se almacena en Y. A continuación, ajustamos el modelo utilizando los métodos de factorización descritos anteriormente y usamos los coeficientes aprendidos para realizar predicciones.
//+------------------------------------------------------------------+
//| Obtain a prediction from our model                               |
//+------------------------------------------------------------------+
void setup(void)
  {

//--- OpenBLAS SVD Solution, considerably powerful substitute to the closed solution provided by the MQL5 developers
matrix OB_U,OB_VT,OB_SIGMA;
vector OB_S;

//--- Reshape the matrix
   X = matrix::Ones(TOTAL_INPUTS,bars);

//--- Store the Z-scores
   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_OPEN,horizon,bars);
   Z1[0] = temp.Mean();
   Z2[0] = temp.Std();
   temp = ((temp - Z1[0]) / Z2[0]);
   X.Row(temp,1);

//--- Store the Z-scores
   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_HIGH,horizon,bars);
   Z1[1] = temp.Mean();
   Z2[1] = temp.Std();
   temp = ((temp - Z1[1]) / Z2[1]);
   X.Row(temp,2);

//--- Store the Z-scores
   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_LOW,horizon,bars);
   Z1[2] = temp.Mean();
   Z2[2] = temp.Std();
   temp = ((temp - Z1[2]) / Z2[2]);
   X.Row(temp,3);

//--- Store the Z-scores
   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_CLOSE,horizon,bars);
   Z1[3] = temp.Mean();
   Z2[3] = temp.Std();
   temp = ((temp - Z1[3]) / Z2[3]);
   X.Row(temp,4);

//--- Store the Z-scores
   temp.CopyIndicatorBuffer(ma_close_handler,0,horizon,bars);
   Z1[4] = temp.Mean();
   Z2[4] = temp.Std();
   temp = ((temp - Z1[4]) / Z2[4]);
   X.Row(temp,5);

   temp.CopyIndicatorBuffer(ma_close_handler,0,0,bars);
   y.Row(temp,0);

   Print("Training Input Data: ");
   Print(X);

   Print("Training Target");
   Print(y);

//--- Perform truncated SVD, we will explore what 'truncated' means later.
PrintFormat("Computing Singular Value Decomposition of %s Data using OpenBLAS",Symbol());
X.SingularValueDecompositionDC(SVDZ_S,OB_S,OB_U,OB_VT);
OB_SIGMA.Diag(OB_S);

//--- Fit the model
//--- More Penrose Psuedo Inverse Solution implemented by MQL5 Developers, enterprise level effeciency!
   b = y.MatMul(OB_VT.Transpose().MatMul(OB_SIGMA.Inv()).MatMul(OB_U.Transpose()));
   Print("OLS Solutions: ");
   Print(b);

//--- Prepare to get a prediction
//--- Reshape the data
   X = matrix::Ones(TOTAL_INPUTS,1);

//--- Get a prediction
   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_OPEN,0,1);
   temp = ((temp - Z1[0]) / Z2[0]);
   X.Row(temp,1);

   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_HIGH,0,1);
   temp = ((temp - Z1[1]) / Z2[1]);
   X.Row(temp,2);

   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_LOW,0,1);
   temp = ((temp - Z1[2]) / Z2[2]);
   X.Row(temp,3);

   temp.CopyRates(Symbol(),TIME_FRAME,COPY_RATES_CLOSE,0,1);
   temp = ((temp - Z1[3]) / Z2[3]);
   X.Row(temp,4);

   temp.CopyIndicatorBuffer(ma_close_handler,0,0,1);
   temp = ((temp - Z1[4]) / Z2[4]);
   X.Row(temp,5);

   Print("Prediction Inputs: ");
   Print(X);

//--- Get a prediction
   prediction = b.MatMul(X);
   Print("Prediction");
   Print(prediction[0,0]);
  }
//+------------------------------------------------------------------+
Ya estamos listos para comenzar a probar la versión mejorada de nuestro algoritmo de negociación. Recordemos que esta implementación está diseñada para proporcionar predicciones mejor fundamentadas del valor esperado del precio. Mantendremos las fechas de las pruebas de forma consistente con nuestra prueba inicial, como se muestra en la Figura 26. Además, como se muestra en la Figura 23, la configuración de la aplicación permanece sin cambios. Por lo tanto, el lector puede continuar siguiendo las instrucciones utilizando la misma configuración.
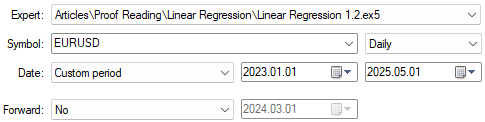
Figura 26: Preparándonos para probar las mejoras implementadas por nuestra nueva aplicación de comercio.
Analizando los nuevos resultados, podemos observar claramente mejoras significativas. La estrategia ingenua produjo una ganancia neta total de 77 dólares, mientras que nuestra estrategia mejorada logró una ganancia neta de 101 dólares, un aumento notable. Esto representa un crecimiento del 31% en el beneficio neto total. Además, el índice de Sharpe, que inicialmente era de 0,47 en la primera implementación, ha aumentado a 0,63. Esto supone una mejora del 34% en la rentabilidad ajustada al riesgo, lo que indica una mejora significativa en el rendimiento del sistema.
El porcentaje de operaciones rentables también aumentó, pasando del 51,4% en el sistema básico al 51,8% en la versión mejorada. Además, el número total de operaciones realizadas aumentó de 70 a 83, lo que sugiere que el nuevo sistema está descubriendo más señales de compraventa.
Si bien el tamaño promedio tanto de las operaciones ganadoras como de las perdedoras disminuyó, el sistema en general es más activo y efectivo. Todo esto se ha logrado utilizando código MQL5 nativo y aplicando adecuadamente factorizaciones matriciales a los datos disponibles.
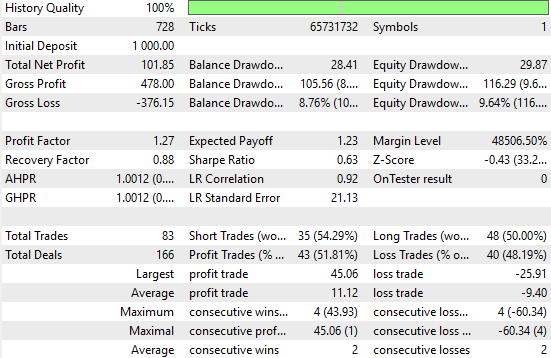
Figura 27: Un análisis detallado de los niveles de rendimiento alcanzados por nuestras predicciones fundamentadas de los niveles de precios futuros.
También hemos incluido la curva de beneficios generada por la versión mejorada de nuestra aplicación de negociación. Nuestro nuevo sistema de negociación está demostrando una tendencia positiva en el saldo de la cuenta con respecto a los datos históricos, lo que nos anima a seguir buscando nuevas mejoras para lograrlo.
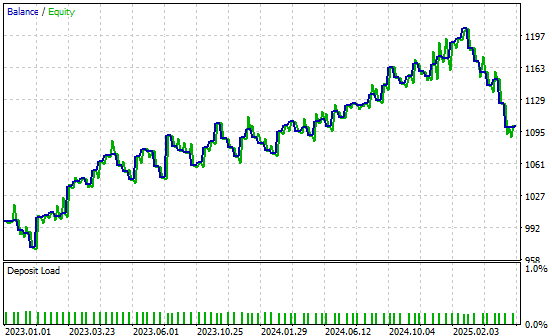
Figura 28: La curva de beneficios generada por nuestra aplicación de negociación mejorada.
Conclusión
Este artículo ha presentado al lector las numerosas ventajas de la API MQL5 Matrix. La API ofrece potentes herramientas matemáticas que mejoran nuestra capacidad para tomar decisiones de negociación bien fundamentadas.
Las factorizaciones matriciales nos permiten descubrir patrones ocultos en datos correlacionados, patrones que quizá no resulten evidentes mediante los métodos tradicionales de análisis de mercado. Los lectores disponen ahora de sólidas alternativas a los enfoques convencionales de series temporales que suelen impartirse en el ámbito de las finanzas. Por ejemplo, el análisis típico de series temporales comienza calculando las diferencias de los datos para medir los cambios periódicos. Por el contrario, nuestro enfoque evitó por completo el proceso de diferenciación y, en su lugar, se basó en la factorización de los datos.
Este cambio de perspectiva abre las puertas a una amplia gama de aplicaciones. Hemos demostrado cómo la factorización de matrices permite una modelización estadística rápida y numéricamente estable. Además, reduce la dimensionalidad de los datos, simplificándolos en formas más compactas que revelan mejor las tendencias subyacentes.
Aunque se podría decir mucho más sobre las ventajas de las factorizaciones matriciales, este artículo ofrece una base sólida. Es importante destacar que las técnicas de factorización pueden reducir la necesidad de definir explícitamente reglas de negociación, lo que permite al sistema aprender estrategias óptimas directamente a partir de los datos.
Es realmente sorprendente lo mucho que podemos ganar al integrar la API MQL5 Matrix en nuestros flujos de trabajo diarios de trading.
Traducción del inglés realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/en/articles/18873
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Redes neuronales en el trading: Entrenamiento de metaparámetros basado en la heterogeneidad (Componentes principales)
 De novato a experto: EA de informes — Configuración del flujo de trabajo
 Particularidades del trabajo con números del tipo double en MQL4
 Características del Wizard MQL5 que debe conocer (Parte 77): Uso del oscilador Gator y del oscilador de acumulación/distribución

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso