

Arbitraje estadístico mediante acciones cointegradas (Parte 3): Configuración de la base de datos
 28
 0

Introducción
En el artículo anterior de esta serie (Parte 2), realizamos un backtest de una estrategia de arbitraje estadístico compuesta por una cesta de acciones cointegradas del sector de los microprocesadores (acciones del Nasdaq). Comenzamos a filtrar entre cientos de símbolos bursátiles aquellos que tenían mayor correlación con Nvidia. A continuación, evaluamos la cointegración del grupo filtrado mediante la prueba de Johansen, la estacionariedad del diferencial (spread) mediante las pruebas ADF y KPSS y, finalmente, obtuvimos los pesos relativos de la cartera extrayendo el vector propio de Johansen correspondiente al primer rango. Los resultados de la prueba retrospectiva fueron prometedores.
Sin embargo, dos o más activos pueden haber estado cointegrados durante los últimos dos años y comenzar a perder esa cointegración mañana. Es decir, no hay garantía de que un par o grupo de activos cointegrados permanezcan cointegrados. Los cambios en la gestión de la empresa, el escenario macroeconómico o los cambios específicos del sector pueden afectar a los fundamentos que originalmente impulsaron la cointegración de los activos. Y viceversa. Los activos que no estaban cointegrados pueden comenzar a estarlo al instante siguiente por las mismas razones. El mercado es “un enigma en un estado continuo de cambio”. Tenemos que afrontar este cambio. [PALOMAR, 2025]
Una cesta de acciones cointegradas modificará sus ponderaciones relativas de cartera de forma casi continua, y las ponderaciones de cartera determinan no solo el volumen (cantidad) de nuestras órdenes, sino también su dirección (compra o venta). Así que también tenemos que afrontar este cambio. Si bien la cointegración es una relación a más largo plazo, las ponderaciones de la cartera cambian constantemente. Por lo tanto, debemos comprobarlas con mayor frecuencia y actualizar nuestro modelo tan pronto como cambien. Cuando detectamos que nuestro modelo está desactualizado, debemos actuar de inmediato; queremos reemplazarlo instantáneamente.
Nuestro asesor experto debe estar al tanto en tiempo real de si las ponderaciones de la cartera que hemos estado utilizando siguen siendo válidas o han cambiado. Si se producen cambios, se debe informar al EA lo antes posible de las nuevas ponderaciones de la cartera. Además, nuestro EA debe saber si el modelo en sí sigue siendo válido. De lo contrario, se deberá informar al EA qué activos deben sustituirse y la rotación deberá aplicarse lo antes posible en la cartera activa.
Hemos estado utilizando la integración de Python en MetaTrader 5 y las funciones estadísticas de la biblioteca statsmodels, desarrolladas por profesionales, pero hasta ahora solo hemos trabajado con datos en tiempo real, descargando las cotizaciones (los datos de precios) a medida que los necesitábamos. Este enfoque resulta útil en la fase exploratoria debido a su simplicidad. Pero si vamos a rotar nuestra cartera, actualizar nuestros modelos o las ponderaciones de la cartera, quizás deberíamos empezar a pensar en la persistencia de los datos. Es decir, debemos empezar a pensar en almacenar nuestros datos en una base de datos, ya que no es práctico descargarlos cada vez que los necesitemos. Es más, puede que tengamos que buscar relaciones entre diferentes clases de activos, entre símbolos que no estaban relacionados con nuestras primeras pruebas de cointegración.
Una base de datos de alta calidad, escalable y rica en metadatos es la base de cualquier iniciativa seria de arbitraje estadístico. Teniendo en cuenta que el diseño de bases de datos es una tarea muy particular, en el sentido de que una buena base de datos es aquella que se adapta a los requisitos de cada empresa, en este artículo veremos un posible enfoque para construir nuestra base de datos orientada al arbitraje estadístico.
¿Qué preguntas debe responder nuestra base de datos?
En nuestra búsqueda de un framework de arbitraje estadístico ‘modesto’, es decir, un marco adecuado para el inversor minorista medio con un ordenador portátil común y un ancho de banda de red medio, nos enfrentamos a varios desafíos relacionados con la falta de especialización en los ámbitos necesarios, como la estadística y el desarrollo de software. El diseño de bases de datos NO es una excepción en esta lista de conocimientos especializados requeridos. El diseño de bases de datos es un campo muy amplio en sí mismo. Se podrían escribir libros enteros sobre diseño de bases de datos sin agotar el tema. La solución ideal sería contar con un profesional especializado, posiblemente más de una persona, para diseñar, implementar y mantener nuestra base de datos.
Dado que estamos desarrollando este marco de arbitraje estadístico para el inversor minorista promedio, debemos trabajar con lo que tenemos, investigando en libros y foros y canales especializados de internet; aprendiendo de profesionales experimentados, mediante ensayo y error, realizando experimentos, asumiendo riesgos y estando preparados para modificar nuestro diseño si resulta inadecuado para la tarea en cuestión. Necesitamos flexibilidad para realizar cambios y comenzar poco a poco, trabajando de abajo hacia arriba, en lugar de arriba hacia abajo, para evitar la sobreingeniería.
A fin de cuentas, nuestra base de datos debería responder a una pregunta muy sencilla: ¿qué deberíamos operar ahora para obtener la máxima rentabilidad posible?
En referencia al último artículo de esta serie, donde definimos las direcciones y el volumen de nuestras órdenes en función de las ponderaciones de la cartera de acciones, una posible respuesta podría ser algo como esto:
| Símbolos | Pesos | Marco temporal |
|---|---|---|
| "MU", "NVDA", "MPWR", "MCHP" | 2.699439, 1.000000, -1.877447, -2.505294 | D1 |
Tabla 1 - Ejemplo ficticio de respuesta esperada a una consulta para la actualización del modelo en tiempo real
Si nuestra base de datos nos proporciona esta información bastante sencilla, actualizada con la frecuencia necesaria para la operativa, tendremos lo necesario para operar de forma continua a nuestro nivel más óptimo.
Actualizaciones de bases de datos como servicio
Hasta ahora, hemos estado realizando nuestro análisis de datos utilizando cotizaciones en tiempo real de la terminal MetaTrader 5 mediante código Python (técnicamente, la mayor parte del tiempo, hemos estado utilizando las cotizaciones almacenadas por el motor subyacente de la terminal). Una vez definidos los símbolos y las ponderaciones de la cartera, hemos estado actualizando manualmente nuestro Asesor Experto con el nuevo símbolo y/o las nuevas ponderaciones de la cartera.
A partir de ahora, desvincularemos nuestro análisis de datos del terminal y comenzaremos a utilizar los datos almacenados en nuestra base de datos para actualizar nuestro Asesor Experto tan pronto como dispongamos de nuevos pesos para la cartera, detener la operativa si se pierde la relación de cointegración o si se considera que otro grupo de símbolos ofrece mejores perspectivas. Es decir, queremos mejorar nuestra exposición al mercado de cada símbolo, actualizando las ponderaciones de la cartera en tiempo real y/o rotando nuestra cartera cada vez que nuestro análisis de datos lo recomiende.
Para actualizar la base de datos, implementaremos un servicio de MetaTrader 5.
Según la documentación de MetaTrader 5, sabemos que
- los servicios no están vinculados a un gráfico específico.
- Los servicios se cargan justo después de iniciar el terminal si se habían iniciado en el momento del apagado del terminal.
- Los servicios se ejecutan en su propio hilo.
Podemos concluir que un servicio es el método ideal para mantener actualizada nuestra base de datos. Si se está ejecutando cuando finalizamos una sesión de negociación y cerramos la terminal, se reanudará en cuanto volvamos a iniciar la terminal para una nueva sesión, independientemente del gráfico o símbolo que estemos utilizando en ese momento. Además, dado que se ejecutará en su propio hilo, no afectará ni se verá afectado por otros servicios, indicadores, scripts o asesores expertos que podamos tener en ejecución.
Así pues, nuestro flujo de trabajo será el siguiente:
- Todo el análisis de datos se realizará en Python, fuera del entorno de MetaTrader 5. Para realizar el análisis, descargaremos los datos históricos y los insertaremos en la base de datos.
- Cada vez que modificamos nuestra cartera activa, añadiendo o eliminando un símbolo, actualizamos los parámetros de entrada del Servicio con una matriz de símbolos y una matriz de marcos temporales.
- Cada vez que modificamos nuestra cartera activa, añadiendo o eliminando un símbolo, actualizamos los parámetros de entrada del Asesor Experto.
Por ahora, realizaremos las actualizaciones de los pasos 2 y 3 manualmente. Más adelante, lo automatizaremos.
Configuración de la base de datos
Mientras investigaba para este artículo, recordé que la herramienta ideal para esta tarea es una base de datos columnar especializada en series temporales. Existen muchos productos en el mercado que cumplen con este requisito, tanto de pago como gratuitos, con alternativas propietarias y de código abierto. Están diseñados para soportar cargas de trabajo altamente especializadas, un volumen masivo de datos con un tiempo de respuesta inferior a un segundo, tanto para la ingesta de datos como para la respuesta a consultas en tiempo real.
Pero aquí nuestro enfoque no es la escala. Nuestro principal objetivo es la simplicidad y la aplicabilidad por parte de un usuario individual, no de un equipo de administradores de bases de datos (DBA) profesionales altamente cualificados ni de diseñadores de gestión de datos de series temporales. Así pues, comenzaremos con la solución más sencilla, conscientes de sus limitaciones y teniendo en cuenta que el sistema evolucionará en el futuro según surja la necesidad.
Comenzaremos con la base de datos SQLite integrada de MetaTrader 5. Existe abundante información sobre cómo crear y utilizar la base de datos SQLite integrada en el entorno MetaTrader 5. Puedes encontrar esta información:
- En la documentación de MetaEditor sobre cómo utilizar la interfaz gráfica de MetaEditor para crear, utilizar y gestionar bases de datos
- Además, en la documentación de MetaEditor sobre las funciones de la API para trabajar con bases de datos
- En un artículo introductorio de MetaQuotes que ofrece una visión general sobre el manejo nativo de bases de datos SQL en MQL5
- En el libro de MQL5 sobre el uso avanzado de la base de datos integrada SQLite
Si tienes pensado trabajar en profundidad con la base de datos SQLite integrada, te recomendamos encarecidamente que consultes detenidamente todos estos enlaces. A continuación se presenta un resumen de los pasos para nuestro caso de uso concreto en este artículo, con algunas notas sobre los motivos que justifican las decisiones tomadas.
El esquema
Adjunto a este artículo encontrarás el archivo db-setup.mq5, que es un script MQL5. Aceptará como parámetros de entrada el nombre del archivo de la base de datos SQLite y el nombre del archivo del esquema de la base de datos. Estos parámetros tienen como valores predeterminados statarb-0.1.db y schema-0.1.sql, respectivamente.
ADVERTENCIA: Se recomienda encarecidamente que mantengas el archivo del esquema de la base de datos bajo control de versiones y que no lo dupliques en tu sistema de archivos. MetaTrader 5 ofrece un sólido sistema de control de versiones ya integrado en la plataforma.
Al ejecutar este script con los parámetros de entrada predeterminados, se creará una base de datos SQLite en la carpeta MQL5/Files/StatArb de tu terminal (NO en la carpeta común), con todas las tablas y campos que se indican a continuación. El script también generará un archivo output.sql en tu carpeta MQL/Files, exclusivamente con fines de depuración. En caso de tener algún problema, puede consultar este archivo para ver cómo su sistema está leyendo el archivo de esquema. Si todo va bien, puede eliminar este archivo sin problemas.
Como alternativa, puede crear la base de datos por otros medios y leer el archivo de esquema desde cualquier cliente SQLite3, en la interfaz de usuario de MetaEditor, Windows PowerShell o la línea de comandos de SQLite3. Recomiendo que, al menos la primera vez, cree la base de datos ejecutando el script adjunto. Siempre podrás ajustar este procedimiento más adelante.
Esquema de la base de datos
Nuestro esquema de base de datos inicial se compone de solo cuatro tablas, dos de las cuales son marcadores de posición para los siguientes pasos. Es decir, por ahora, solo utilizaremos las tablas "symbol" y "market_data".
La figura 1 muestra el diagrama entidad-relación (Entity-Relationship Diagram, ERD) de este esquema inicial.
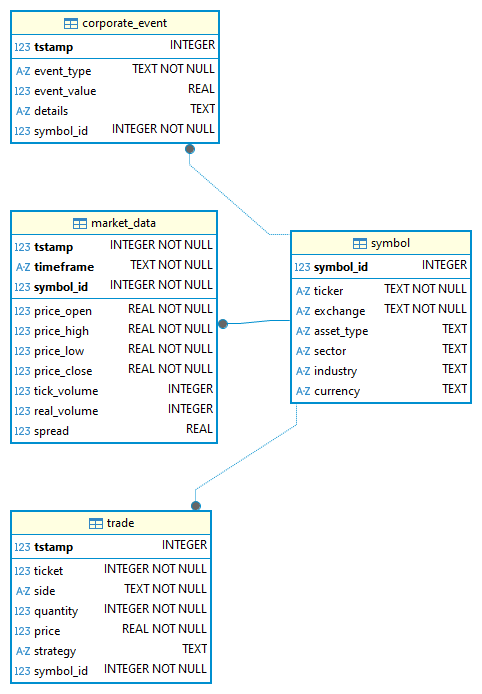
Figura 1: El diagrama ERD (Entity-Relationship Diagram) del esquema inicial de la base de datos
La tabla «corporate_event», como era de esperar, está destinada a almacenar eventos relacionados con las empresas de nuestra cartera, como los importes de los dividendos repartidos, las divisiones de acciones, las recompras de acciones, las fusiones y otros. Por ahora no vamos a tratar ese tema.
La tabla «trade» almacenará nuestras operaciones (transacciones). Al recopilar estos datos, dispondremos de un conjunto de datos único para su agregación y análisis. Solo lo utilizaremos cuando empecemos a operar.
La tabla «market_data» almacenará nuestros datos OHLC con todos los campos de MqlRates. Cuenta con una clave primaria compuesta (symbol_id, timeframe y timestamp) para garantizar que cada entrada sea única. La tabla «market_data» está vinculada a la tabla «symbol» mediante una clave foránea.
Como puedes ver, es la única tabla que utiliza una clave primaria compuesta. El resto de tablas utilizan como clave primaria la marca de tiempo almacenada como un INTEGER. Hay una razón para esta elección. Según la documentación de SQLite3,
«Los datos de las tablas rowid se almacenan en una estructura de árbol B que contiene una entrada por cada fila de la tabla, utilizando el valor rowid como clave. Esto significa que la recuperación o clasificación de registros por rowid es rápida. La búsqueda de un registro con un rowid específico, o de todos los registros con rowids dentro de un intervalo determinado, es aproximadamente el doble de rápida que una búsqueda similar realizada especificando cualquier otra CLAVE PRIMARIA o valor indexado.
(...) si una tabla rowid tiene una clave primaria formada por una sola columna y el tipo declarado de dicha columna es «INTEGER» (en cualquier combinación de mayúsculas y minúsculas), entonces la columna se convierte en un alias del rowid. A esta columna se la suele denominar «clave primaria entera».
(...) «Las consultas se ejecutan “aproximadamente el doble de rápido” si se utiliza un INTEGER como clave primaria». Las marcas de tiempo de la época Unix se pueden insertar como un tipo INTEGER en las bases de datos SQLite3.»
(...) «SQLite almacena los valores enteros en el formato de complemento a dos de 64 bits¹. Esto da un rango de almacenamiento comprendido entre -9223372036854775808 y +9223372036854775807, ambos inclusive. Los números enteros comprendidos en este intervalo son exactos. (Documentación de SQLite3)»
Así, podemos convertir nuestras fechas y horas de cadenas a marcas de tiempo de la época Unix e insertarlas como clave primaria para superar la velocidad de la luz. 🙂
Las tablas que figuran a continuación recogen la documentación completa del esquema (diccionario de datos) para que sirva de referencia a nuestro equipo y a nosotros mismos en el futuro.
Tabla: símbolo
Almacena metadatos sobre los instrumentos financieros con los que se opera o a los que se realiza un seguimiento.
| Campo | Tipo de datos | Null | Clave | Descripción |
|---|---|---|---|---|
| symbol_id | INTEGER | NO | PK | Identificador único para cada instrumento financiero. |
| ticker | TEXT(≤10) | NO | Símbolo bursátil del activo (p. ej., «AAPL», «MSFT»). | |
| exchange | TEXT(≤50) | NO | Bolsa en la que cotiza el activo (p. ej., «NASDAQ», «NYSE»). | |
| asset_type | TEXT(≤50) | SÍ | Tipo de activo (p. ej., «Renta variable», «ETF», «Divisas», «Criptomonedas»). | |
| sector | TEXT(≤50) | SÍ | Clasificación por sectores económicos (por ejemplo, «Tecnología», «Sanidad»). | |
| industry | TEXT(≤50) | SÍ | Clasificación industrial dentro de un sector. | |
| currency | TEXT(≤50) | SÍ | Moneda de denominación del activo (p. ej., «EUR», «USD»). |
Tabla 2 - Descripción del diccionario de datos de la tabla «symbol» (v0.1)
Tabla: corporate_event
Recopila los acontecimientos que afectan a los activos, como dividendos, divisiones de acciones o anuncios de resultados.
| Campo | Tipo de datos | Null | Clave | Descripción | Ejemplo |
|---|---|---|---|---|---|
| tstamp | INTEGER | NO | PK | Marca de tiempo Unix en la que el evento entra en vigor. | 1678905600 |
| event_type | TEXT ENUM {'dividend', 'split', 'earnings'} | NO | Tipo de operación societaria. | "dividend" | |
| event_value | REAL | SÍ | Valor numérico del evento: • Importe del dividendo por acción • Relación de desdoblamiento • Beneficio por acción (BPA). | 0.85, 2.0, 1.35 | |
| details | TEXT(≤255) | SÍ | Notas adicionales o contexto. | "Q2 dividend payout" | |
| symbol_id | INTEGER | NO | FK | Referencia al símbolo (symbol_id); vincula el evento al activo. | 1 |
Tabla 3 - Descripción del diccionario de datos de la tabla «corporate_event» (v0.1)
Tabla: market_data
Almacena los datos OHLCV (apertura, máximo, mínimo, cierre y volumen) y las series temporales relacionadas de los activos.
| Campo | Tipo de datos | Null | Clave | Descripción | Ejemplo |
|---|---|---|---|---|---|
| tstamp | INTEGER | NO | PK* | Marca de tiempo Unix de la barra o vela. | 1678905600 |
| timeframe | TEXT ENUM {M1,M2,M3,M4,M5,M6, M10,M12,M15,M20,M30,H1,H2,H3, H4,H6,H8,H12,D1,W1,MN1} | NO | PK* | Granularidad de los datos de series temporales. | "M5", "D1" |
| price_open | REAL | NO | Precio de apertura al inicio de la barra. | 145.20 | |
| price_high | REAL | NO | Precio máximo durante la barra. | 146.00 | |
| price_low | REAL | NO | Precio mínimo durante la barra. | 144.80 | |
| price_close | REAL | NO | Precio de cierre al final de la barra. | 145.75 | |
| tick_volume | INTEGER | SÍ | Número de ticks (actualizaciones de precios) dentro del intervalo de tiempo. | 200 | |
| real_volume | INTEGER | SÍ | Número de unidades o contratos negociados (si se dispone de este dato). | 15000 | |
| spread | REAL | SÍ | Diferencial medio o puntual entre el precio de compra y el de venta durante la barra. | 0.02 | |
| symbol_id | INTEGER | NO | PK*, FK | Referencia al símbolo (symbol_id). | 1 |
Tabla 4 - Descripción del diccionario de datos de la tabla «market_data» (v0.1)
Tabla: trade
Realiza un seguimiento de las operaciones, tanto en tiempo real como simuladas, para las estrategias.
| Campo | Tipo de datos | Null | Clave | Descripción | Ejemplo |
|---|---|---|---|---|---|
| tstamp | INTEGER | NO | PK | Marca de tiempo Unix de la ejecución de la operación. | 1678905600 |
| ticket | INTEGER | NO | N.º de ticket de operación/n.º de pedido. | 20230001 | |
| side | TEXT ENUM {'buy', 'sell'} | NO | Dirección de la operación. | "buy" | |
| quantity | INTEGER (>0) | NO | Número de acciones/contratos negociados. | 100 | |
| price | NO | Precio de ejecución. | 145.50 | ||
| strategy | SÍ | Identificador de la estrategia de negociación que genera la operación. | "StatArb_Pairs" | ||
| symbol_id | INTEGER | NO | FK | Referencia al símbolo (symbol_id). | 1 |
Tabla 5 - Descripción del diccionario de datos de la tabla «trade» (v0.1)
STRICT
Si revisas el archivo de esquema, verás que todas las tablas son tablas STRICT.
CREATE TABLE symbol(
    symbol_id INTEGER PRIMARY KEY,
    ticker TEXT CHECK(LENGTH(ticker) <= 10) NOT NULL,
    exchange TEXT CHECK(LENGTH(exchange) <= 50) NOT NULL,
    asset_type TEXT CHECK(LENGTH(asset_type) <= 50),
    sector TEXT CHECK(LENGTH(sector) <= 50),
    industry TEXT CHECK(LENGTH(industry) <= 50),
    currency TEXT CHECK(LENGTH(currency) <= 10)
) STRICT;
Esto significa que hemos optado por el tipado estricto en nuestras tablas, en lugar de la cómoda compatibilidad de tipos de SQLite. Es una decisión que, en nuestra opinión, podría evitar problemas más adelante.
«En una instrucción CREATE TABLE, si se añade la palabra clave de opción de tabla «STRICT» al final, después del cierre «)», se aplican reglas de tipado estrictas a esa tabla.» (Documentación de SQLite)
Restricción CHECK sobre la longitud
Además, exigimos una comprobación de la longitud de varios campos TEXT. Esto se debe a que SQLite no impone una longitud fija ni trunca las cadenas en función del valor (n) especificado en CHAR(n) o VARCHAR(n), como suele ser habitual en otros sistemas de gestión de bases de datos relacionales (RDBMS).
¿Y qué hay de los índices?
Quizá te preguntes por qué no hemos creado ningún índice. Lo haremos en cuanto empecemos a realizar consultas, para poder saber con certeza dónde son necesarias.
Introducción inicial de datos
Se espera que la base de datos se vaya completando de forma transparente mientras se lleva a cabo nuestro análisis de datos desde la integración de Python en MQL5. No obstante, para mayor comodidad, se adjunta un script de Python (db_store_quotes.ipynb) que te servirá de ayuda para almacenar las cotizaciones de una lista de símbolos, correspondientes a un periodo de tiempo concreto y a un intervalo de tiempo elegido. A partir de ahora, realizaremos nuestro análisis de datos (pruebas de correlación, cointegración y estacionariedad) con estos datos almacenados.
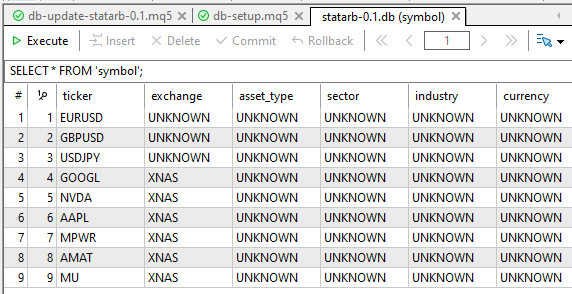
Figura 2: Tabla «Symbol» tras la inserción inicial de datos mediante el script de Python
Como puedes ver, la mayor parte de los metadatos del «símbolo» aparecen como «DESCONOCIDO». Esto se debe a que las funciones de Python para SymbolInfo no abarcan todos los metadatos de símbolos disponibles en la API de MQL5. Más adelante completaremos esta información.
   # Insert new symbol
    cursor.execute("""
    INSERT INTO Symbol (ticker, exchange, asset_type, sector, industry, currency)
    VALUES (?, ?, ?, ?, ?, ?)
    """, (
        mt5_symbol,
        # some of this data will be filled by the MQL5 DB Update Service
        # because some of them are not provided by the Python MT5 API
        symbol_info.exchange or 'UNKNOWN',
        symbol_info.asset_class or 'UNKNOWN',
        symbol_info.sector or 'UNKNOWN',
        symbol_info.industry or 'UNKNOWN',
        symbol_info.currency_profit or 'UNKNOWN'
    ))
La ruta de la base de datos debe indicarse como variable de entorno, y estamos utilizando el módulo python-dotenv para cargar esta variable. Esto debería evitar problemas derivados de que el editor no reconozca las variables de entorno de Terminal y/o PowerShell.
Encontrarás el cuaderno de Jupyter que carga la extensión «python-dotenv» y el archivo *.env correspondiente justo al principio del script.
%load_ext dotenv
%dotenv .env
En este artículo también se adjunta un archivo *.env de ejemplo.
# keep this file at the root of your project
# or in the same folder of the Python script that uses it
STATARB_DB_PATH="your/db/path/here"
La llamada principal a «db_store_quotes.ipynb» se encuentra al final del script.
symbols = ['MPWR', 'AMAT', 'MU']  # Symbols from Market Watch
timeframe = mt5.TIMEFRAME_M5    # 5-minute timeframe
start_date = '2024-02-01'
end_date = '2024-03-31'
db_path = os.getenv('STATARB_DB_PATH')  # Path to your SQLite database

if db_path is None:
        print("Error: STATARB_DB_PATH environment variable is not set.")
else:
        print("db_path: " + db_path)
# Download historical quotes and store them in the database
        download_mt5_historical_quotes(symbols, timeframe, start_date, end_date, db_path)
Actualizaciones
La base de nuestro mantenimiento de la base de datos para la actualización automática de modelos y la rotación de carteras reside en nuestro servicio MQL5, que se ejecuta en «segundo plano». A medida que nuestra base de datos vaya evolucionando, este servicio también necesitará actualizaciones.
El servicio se conecta a (o crea) un archivo de base de datos SQLite local.
ADVERTENCIA: Si vas a crear una base de datos completamente nueva utilizando el servicio de actualización de bases de datos, recuerda inicializarla con el script db_setup, tal y como se ha mencionado anteriormente.
A continuación, el servicio establece las restricciones necesarias para garantizar la integridad de los datos y, tras ello, entra en un bucle infinito en el que comprueba si
hay nuevos datos de mercado. Para cada símbolo y intervalo de tiempo, este
- obtiene la barra de precios completada más recientemente (incluyendo apertura, máximo, mínimo, cierre, volumen y spread),
- comprueba si ya está en la base de datos,
- e inserta la(s) nueva(s) cotización(es) si no es así
El servicio realiza la inserción dentro de una transacción de base de datos para garantizar la atomicidad. Si surge algún problema (por ejemplo, un error en la base de datos), vuelve a intentarlo hasta un límite establecido (por defecto, 3 veces) con pausas de un segundo. El registro es opcional. El bucle se detiene temporalmente entre cada actualización y solo se detiene cuando el servicio se detiene manualmente.
Veamos, pues, algunos de sus componentes.
En los parámetros de entrada, puedes seleccionar la ruta del archivo de base de datos, la frecuencia de actualización en minutos, el número máximo de reintentos si falla la inserción y si deseas que se muestren los mensajes de éxito o error en el registro de EA. Este último parámetro puede resultar útil cuando, tras el desarrollo, conseguimos un código estable.
//+------------------------------------------------------------------+
//|   Inputs                                                         |
//+------------------------------------------------------------------+
input string   InpDbPath      = "StatArb\\statarb-0.1.db";  // Database filename
input int      InpUpdateFreq  = 1;     // Update frequency in minutes
input int      InpMaxRetries  = 3;     // Max retries
input bool     InpShowLogs    = true; // Enable logging?
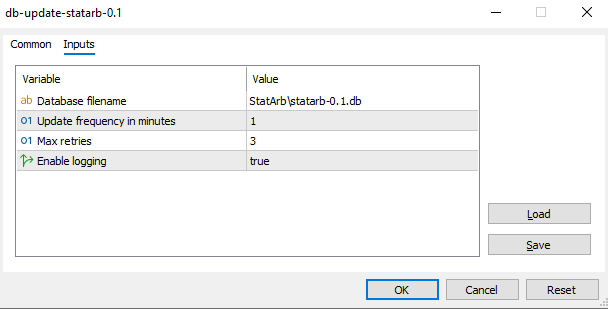
Figura 3: Cuadro de diálogo de MetaTrader 5 para los parámetros de entrada del servicio de actualización de la base de datos
Debes seleccionar los símbolos y los intervalos de tiempo correspondientes que se van a actualizar. Estas entradas se automatizarán en la siguiente fase.
//+------------------------------------------------------------------+
//|   Global vars                                                    |
//+------------------------------------------------------------------+
string symbols[] = {"EURUSD", "GBPUSD", "USDJPY"};
ENUM_TIMEFRAMES timeframes[] = {PERIOD_M5};
Aquí inicializamos el identificador de la base de datos como un INVALID_HANDLE. Se comprobará la próxima vez que abramos la base de datos.
// Database handle
int dbHandle = INVALID_HANDLE;
OnStart()
En el controlador de eventos único del servicio, OnStart, solo configuramos el bucle infinito y llamamos a la función UpdateMarketData, donde comienza el trabajo propiamente dicho. A la función «sleep» se le pasa el número de milisegundos que hay que esperar entre cada bucle (cada solicitud de actualización de cotizaciones). Lo convertimos a minutos para que resulte más fácil de entender. Además, no esperamos actualizaciones con una frecuencia inferior a un minuto.
//+------------------------------------------------------------------+
//| Main Service function                                            |
//| Parameters:                                                      |
//|   symbols    - Array of symbol names to update                   |
//|   timeframes - Array of timeframes to update                     |
//|   InpMaxRetries - Maximum number of retries for failed operations    |
//+------------------------------------------------------------------+
void OnStart()
  {
   do
     {
      printf("Updating db: %s", InpDbPath);
      UpdateMarketData(symbols, timeframes, InpMaxRetries);
      Sleep(1000 * 60 * InpUpdateFreq); // 60 secs
     }
   while(!IsStopped());
  }
UpdateMarketData()
Aquí empezamos a llamar a la función que inicializa la base de datos. Si surge algún problema, devolvemos «false» y el control vuelve al bucle principal. Por lo tanto, si tienes problemas con la inicialización de la base de datos, puedes dejar que el servicio siga funcionando sin ningún problema mientras solucionas el problema de inicialización de la base de datos. En el siguiente bucle, lo volverá a intentar.
//+------------------------------------------------------------------+
//| Update market data for multiple symbols and timeframes           |
//+------------------------------------------------------------------+
bool UpdateMarketData(string &symbols_array[], ENUM_TIMEFRAMES &time_frames[], int max_retries = 3)
  {
// Initialize database
   if(!InitializeDatabase())
     {
      LogMessage("Failed to initialize database");
      return false;
     }
   bool allSuccess = true;

If the database is initialized (open), we start processing each symbol and timeframe.

// Process each symbol
   for(int i = 0; i < ArraySize(symbols_array); i++)
     {
      string symbol = symbols_array[i];
      // Process each timeframe
      for(int j = 0; j < ArraySize(time_frames); j++)
        {
         ENUM_TIMEFRAMES timeframe = time_frames[j];
         int retryCount = 0;
         bool success = false;
En este bucle «while», controlamos el número máximo de reintentos y llamamos efectivamente a la función para actualizar la base de datos.
         // Retry logic
         while(retryCount < max_retries && !success)
           {
            success = UpdateSymbolTimeframeData(symbol, timeframe);
            if(!success)
              {
               retryCount++;
               Sleep(1000); // Wait before retry
              }
           }
         if(!success)
           {
            LogMessage(StringFormat("Failed to update %s %s after %d retries",
                                    symbol, TimeframeToString(timeframe), max_retries));
            allSuccess = false;
           }
        }
     }
   DatabaseClose(dbHandle);
   return allSuccess;
  }
UpdateSymbolTimeframeData()
Dado que nuestra tabla «market_data» requiere un «symbol_id» como clave foránea, primero debemos disponer de él. Así que comprobamos si existe o creamos un nuevo «symbol_id» en la tabla «symbol» si se trata de un símbolo nuevo.
//+------------------------------------------------------------------+
//| Update market data for a single symbol and timeframe              |
//+------------------------------------------------------------------+
bool UpdateSymbolTimeframeData(string symbol, ENUM_TIMEFRAMES timeframe)
  {
   ResetLastError();
// Get symbol ID (insert if it doesn't exist)
   long symbol_id = GetOrInsertSymbol(symbol);
   if(symbol_id == -1)
     {
      LogMessage(StringFormat("Failed to get symbol ID for %s", symbol));
      return false;
     }
Convertimos el intervalo de tiempo de MQL5 ENUM_TIMEFRAMES al tipo de cadena (TEXT) que requiere nuestra tabla.
   string tfString = TimeframeToString(timeframe);
   if(tfString == "")
     {
      LogMessage(StringFormat("Unsupported timeframe for symbol %s", symbol));
      return false;
     }
Copiamos los precios de la última barra cerrada.
// Get the latest closed bar
   MqlRates rates[];
   if(CopyRates(symbol, timeframe, 1, 1, rates) != 1)
     {
      LogMessage(StringFormat("Failed to get rates for %s %s: %d", symbol, tfString, GetLastError()));
      return false;
     }
Comprobamos si este dato ya existe. Si es así, lo registramos y devolvemos «true».
   if(MarketDataExists(symbol_id, rates[0].time, tfString))
     {
      LogMessage(StringFormat("Data already exists for %s %s at %s",
                              symbol, tfString, TimeToString(rates[0].time)));
      return true;
     }
Si se trata de un nuevo dato o de una nueva cotización, iniciamos una transacción en la base de datos para garantizar la atomicidad. Si algo falla, lo revertimos. Si todo va bien, confirmamos la transacción y devolvemos «true».
// Start transaction
   if(!DatabaseTransactionBegin(dbHandle))
     {
      LogMessage(StringFormat("Failed to start transaction: %d", GetLastError()));
      return false;
     }
// Insert the new data
   if(!InsertMarketData(symbol_id, tfString, rates[0]))
     {
      DatabaseTransactionRollback(dbHandle);
      return false;
     }
// Commit transaction
   if(!DatabaseTransactionCommit(dbHandle))
     {
      LogMessage(StringFormat("Failed to commit transaction: %d", GetLastError()));
      return false;
     }
   LogMessage(StringFormat("Successfully updated %s %s data for %s",
                           symbol, tfString, TimeToString(rates[0].time)));
   return true;
  }
InitializeDatabase()
Aquí abrimos la base de datos y validamos el identificador.
//+------------------------------------------------------------------+
//| Initialize database connection                                   |
//+------------------------------------------------------------------+
bool InitializeDatabase()
  {
   ResetLastError();
// Open database (creates if it doesn't exist)
   dbHandle = DatabaseOpen(InpDbPath, DATABASE_OPEN_READWRITE | DATABASE_OPEN_CREATE);
   if(dbHandle == INVALID_HANDLE)
     {
      LogMessage(StringFormat("Failed to open database: %d", GetLastError()));
      return false;
     }
Esta directiva «PRAGMA», que habilita las claves externas en SQLite, no es estrictamente necesaria cuando se trabaja con la base de datos SQLite integrada, ya que sabemos que se ha compilado con esta característica habilitada. Se trata únicamente de una medida de seguridad por si tuvieras que trabajar con una base de datos externa.
// Enable foreign key constraints
   if(!DatabaseExecute(dbHandle, "PRAGMA foreign_keys = ON"))
     {
      LogMessage(StringFormat("Failed to enable foreign keys: %d", GetLastError()));
      return false;
     }
   LogMessage("Database initialized successfully");
   return true;
  }
TimeframeToString()
La función para convertir MQL5 ENUM_TIMEFRAMES en un tipo de cadena es un simple «switch».
//+------------------------------------------------------------------+
//| Convert MQL5 timeframe to SQLite format                          |
//+------------------------------------------------------------------+
string TimeframeToString(ENUM_TIMEFRAMES tf)
  {
   switch(tf)
     {
      case PERIOD_M1:
         return "M1";
      case PERIOD_M2:
         return "M2";
      case PERIOD_M3:
         return "M3";
(...)
      case PERIOD_MN1:
         return "MN1";
      default:
         return "";
     }
  }
MarketDataExists()
Para comprobar si los datos de mercado ya existen, ejecutamos una consulta sencilla sobre la clave primaria compuesta de la tabla «market_data».
//+------------------------------------------------------------------+
//| Check if market data exists for given timestamp and timeframe     |
//+------------------------------------------------------------------+
bool MarketDataExists(long symbol_id, datetime tstamp, string timeframe)
  {
   ResetLastError();
   int stmt = DatabasePrepare(dbHandle, "SELECT 1 FROM market_data WHERE symbol_id = ? AND tstamp = ? AND timeframe = ? LIMIT 1");
   if(stmt == INVALID_HANDLE)
     {
      LogMessage(StringFormat("Failed to prepare market data existence check: %d", GetLastError()));
      return false;
     }
   if(!DatabaseBind(stmt, 0, symbol_id) ||
      !DatabaseBind(stmt, 1, (long)tstamp) ||
      !DatabaseBind(stmt, 2, timeframe))
     {
      LogMessage(StringFormat("Failed to bind parameters for existence check: %d", GetLastError()));
      DatabaseFinalize(stmt);
      return false;
     }
   bool exists = DatabaseRead(stmt);
   DatabaseFinalize(stmt);
   return exists;
  }
InsertMarketData()
Por último, para insertar los nuevos datos de mercado (la actualización), ejecutamos una consulta de inserción utilizando la función StringFormat de MQL5, tal y como sugiere la documentación.
Ten cuidado con las cadenas de texto en la sustitución de VALUES. Tienes que ponerlas entre comillas. Luego me lo agradecerás. 🙂
//+------------------------------------------------------------------+
//| Insert market data into database                                 |
//+------------------------------------------------------------------+
bool InsertMarketData(long symbol_id, string timeframe, MqlRates &rates)
  {
   ResetLastError();
   string req = StringFormat(
                   "INSERT INTO market_data ("
                   "tstamp, timeframe, price_open, price_high, price_low, price_close, "
                   "tick_volume, real_volume, spread, symbol_id) "
                   "VALUES(%d, '%s', %G, %G, %G, %G, %d, %d, %d, %d)",
                   rates.time, timeframe, rates.open, rates.high, rates.low, rates.close,
                   rates.tick_volume, rates.real_volume, rates.spread, symbol_id);
   if(!DatabaseExecute(dbHandle, req))
     {
      LogMessage(StringFormat("Failed to insert market data: %d", GetLastError()));
      return false;
     }
   return true;
  }
Mientras el servicio está en funcionamiento…
Figura 5: Navegador de MetaEditor con el servicio de actualización de la base de datos en ejecución.
… deberías ver algo parecido a esto en la pestaña «Expertos».
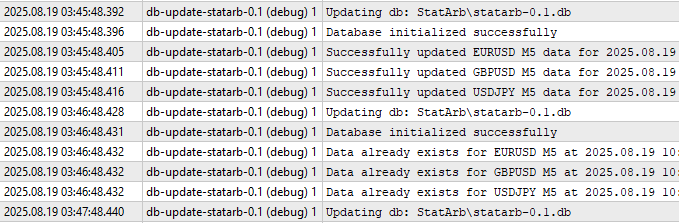
Figura 7: Pestaña de registro de Expertos de MetaTrader 5 con la salida del Servicio de actualización de la base de datos.
Tu tabla «market_data» debería tener este aspecto. Ten en cuenta que, por el momento, estamos almacenando todos los datos de mercado, correspondientes a todos los símbolos y intervalos de tiempo, en una única tabla. Más adelante lo mejoraremos, pero solo cuando sea necesario. Por ahora, esto nos basta con creces para empezar a analizar nuestros datos de forma más sostenible.
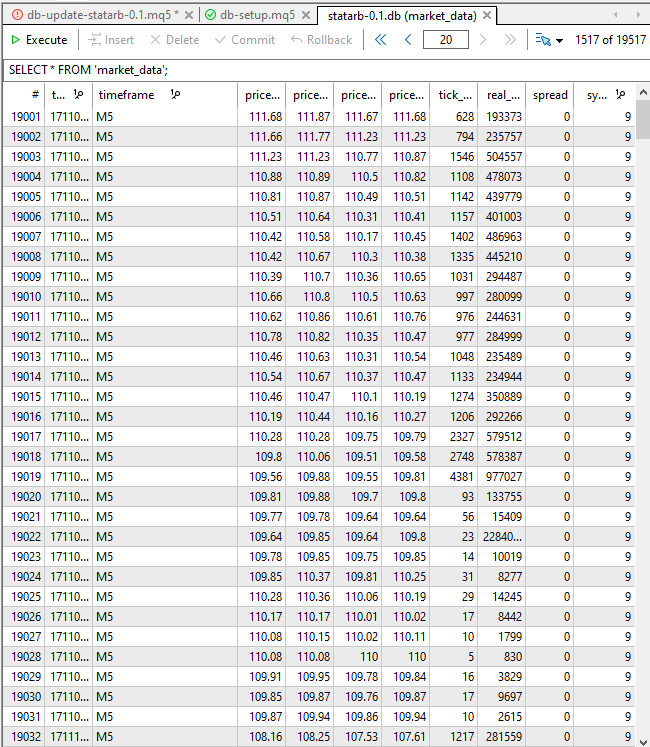
Figura 8: Vista de la pestaña SQLite integrada de MetaEditor con actualizaciones de la base de datos
Conclusión
En este artículo, vimos cómo estamos pasando de los datos de precios descargados de forma efímera a la primera versión de la base de datos para nuestro marco de arbitraje estadístico. Vimos la lógica detrás del diseño de su esquema inicial, cómo inicializarlo e insertar los datos iniciales.
Todas las tablas, campos y relaciones del esquema están ahora documentados, con descripciones de las tablas, restricciones y ejemplos.
También detallamos los pasos para mantener actualizada la base de datos mediante la creación de un servicio para MetaTrader 5, proporcionamos una implementación de este servicio, junto con scripts de Python para insertar datos iniciales para cualquier símbolo (ticker) y marco temporal disponibles.
Con estas herramientas y sin necesidad de escribir una sola línea de código, el inversor minorista medio, público objetivo de nuestro marco de arbitraje estadístico, puede empezar a almacenar no solo datos de mercado inmediatos (cotizaciones de precios), sino también algunos metadatos sobre las acciones involucradas en nuestra estrategia de cointegración y el historial de las operaciones.
Este diseño inicial evolucionará en la siguiente etapa, cuando actualizaremos las ponderaciones de la cartera en tiempo real y rotaremos la cartera si la cointegración de la cesta se debilita, reemplazando o añadiendo símbolos sin intervención manual.
Referencias
Daniel P. Palomar (2025). Portfolio Optimization: Theory and Application. Cambridge University Press.
* Una limitación destacable de SQLite en comparación con algunas bases de datos orientadas a series temporales es la ausencia de «uniones «as-of»». Dado que vamos a indexar nuestros datos de mercado por marca de tiempo, es casi seguro que no podremos utilizar «uniones» entre tablas en el futuro, ya que utilizamos las marcas de tiempo como claves primarias y estas rara vez, o quizá nunca, estarán alineadas en dos o más tablas, y las «uniones» (uniones internas, a la izquierda y externas) dependen de esta alineación de índices. Por lo tanto, al utilizar «uniones», obtendríamos conjuntos de resultados vacíos (nulos). En esta entrada de blog se explica el tema con detalle.
| Nombre del archivo | Descripción |
|---|---|
| StatArb/db-setup.mq5 | Script de MQL5 para crear e inicializar la base de datos SQLite leyendo el archivo de esquema schema-0.1.sql. |
| StatArb/db-update-statarb-0.1.mq5 | Servicio MQL5 para actualizar la base de datos SQLite con las barras de precios de cierre más recientes. |
| StatArb/schema-0.1.sql | Archivo de esquema SQL (DDL) para inicializar la base de datos (crear tablas, campos y restricciones). |
| db_store_quotes.ipynb | Cuaderno de Jupyter que contiene código en Python. Archivo auxiliar para rellenar la base de datos SQLite con cotizaciones de los símbolos correspondientes a un intervalo de tiempo y un periodo concretos. |
| .env | Archivo de ejemplo con las variables de entorno que debe leer el archivo auxiliar de Python anterior. (opcional) |
Traducción del inglés realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/en/articles/19242
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Desarrollo de un indicador personalizado de sentimiento del mercado
 Potencie su operativa con Smart Money Concepts (SMC): OB, BOS y FVG
 Particularidades del trabajo con números del tipo double en MQL4
 Desarrollo de un kit de herramientas para el análisis de la acción del precio (Parte 39): Automatización de la detección de BOS y ChoCH en MQL5

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso