
Desarrollo de un kit de herramientas para el análisis de la acción del precio (Parte 35): Entrenamiento y despliegue de modelos predictivos
 14
 1

Introducción
En el artículo anterior, establecimos un sistema fiable para transmitir datos históricos desde un script MQL5 a Python y almacenarlos en disco. Esa parte se detuvo intencionalmente en la capa de ingestión; demostramos que las barras de mercado se pueden capturar, serializar y recargar, pero no llegamos a la fase de ajuste del modelo.
Esta entrega retoma exactamente el punto en el que nos quedamos. Vamos más allá del almacenamiento y le mostramos cómo:
- entrenar modelos predictivos con los datos ingeridos,
- serializar y almacenar en caché esos modelos por símbolo, y
- desplegarlos tras una API REST ligera que un Asesor Experto de MQL5 pueda consultar a través de solicitudes en tiempo real.
Para lograrlo, combinamos las ventajas del ecosistema de aprendizaje automático de Python con la velocidad de ejecución de MetaTrader 5. El EA se encarga de la interacción con el mercado, mientras que el servicio Python realiza la ingeniería de variables, la inferencia del modelo y, opcionalmente, el reentrenamiento periódico.
En este contexto, un modelo entrenable es cualquier algoritmo cuyos parámetros internos pueden optimizarse a partir de datos. Las técnicas clásicas (a través de scikit-learn), como Gradient Boosting o las máquinas de vectores de soporte, son adecuadas para conjuntos de características tabulares, mientras que los marcos de aprendizaje profundo (TensorFlow, PyTorch) admiten arquitecturas más complejas cuando es necesario. El amplio soporte de bibliotecas de Python, su sintaxis clara y su comunidad activa lo convierten en el lenguaje preferido para esta etapa del proceso.
La siguiente tabla resume las responsabilidades respectivas en el sistema finalizado:
| Componente | Función en el flujo de trabajo |
|---|---|
| Asesor experto de MQL5 | Recopila datos en tiempo real de las barras y el estado de la cuenta; envía envía solicitudes con características; ejecuta las señales de compraventa devueltas por la API. |
| Script de ingesta de Python | Recibe bloques de datos históricos de MetaTrader 5, los depura y los almacena (Parquet). |
| Módulo de ingeniería de características | Convierte los datos brutos de OHLC en características técnicas y estadísticas. |
| Módulo de entrenamiento | Ajusta o actualiza los modelos por símbolo; los serializa con joblib. |
| Servicios REST de Flask | Expone endpoints como /predict y /upload_history; gestiona una caché de modelos en memoria para ofrecer respuestas en milisegundos. |
Este artículo está organizado de la siguiente manera:
- Introducción
- Resumen del proceso de ingesta
- Implementación de MQL5 y Python
- Entrenamiento de modelos en Python
- Despliegue del modelo e inferencia en tiempo real
- Conclusión
Vamos a ello.
Resumen del proceso de ingesta
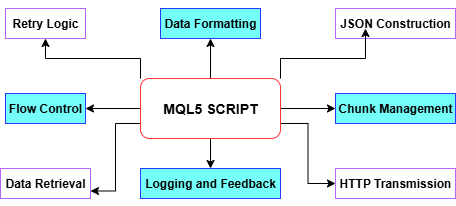
Tal y como se explicó en el artículo anterior, nuestro script de ingesta de históricos agiliza todo el flujo de trabajo de MetaTrader 5 a Python: primero extrae las barras históricas deseadas a través de CopyRates y, a continuación, analiza las marcas de tiempo, los máximos, los mínimos y los cierres para convertirlos en matrices, antes de agrupar cada parte en una carga útil JSON con BuildJSON. Para respetar los límites de tamaño de WebRequest de MetaTrader 5, divide automáticamente los datos en fragmentos manejables —reduciendo a la mitad el tamaño de los fragmentos según sea necesario hasta un mínimo definido— y envía cada fragmento a nuestro endpoint de Python mediante PostChunk, con lógica de reintentos y controles de tiempo de espera. A lo largo del proceso, registra cada paso y cada error en la pestaña «Expertos» y se cierra correctamente en caso de fallo o confirma que se ha completado una vez que se han cargado todos los datos, lo que sienta una base muy sólida para nuestro proceso de detección de picos.
Analicemos el diagrama que aparece a continuación para examinar cada función del script MQL5.
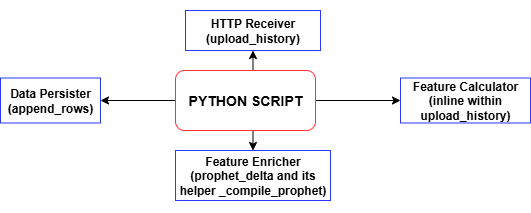
Cada vez que el script de MQL5 envía un lote de barras históricas, el controlador `upload_history` del endpoint de Python calcula todas las características técnicas y etiquetas, y a continuación llama a `append_rows` para escribir esos registros en `training_set.csv`, creando el archivo y el encabezado si aún no existen. Con cada subida sucesiva, vas creando un conjunto de datos completo y con marca de tiempo, listo para el entrenamiento del modelo. Este archivo «training_set.csv» es, sin duda, el que utilizaremos para entrenar nuestro modelo de detección de picos.
Implementación de MQL5 y Python
En este artículo, pasamos de usar un script sencillo a desarrollar un Asesor Experto (EA) completo que permita la monitorización continua y la comunicación en tiempo real con un backend de Python, algo que un script independiente no puede gestionar de forma eficiente. El Asesor Experto (EA) Spike Detector en MetaTrader 5 funciona en una configuración cliente-servidor, donde actúa como cliente y un servidor Python Flask actúa como backend. El EA observa continuamente la formación de nuevas velas japonesas. A intervalos definidos, recopila un número configurable de velas históricas (datos OHLCV y marcas de tiempo), los serializa en formato JSON y los envía mediante una solicitud HTTP POST al servidor Python.
El backend de Python, que normalmente contiene un modelo de aprendizaje automático o una lógica basada en reglas, analiza los datos de mercado entrantes y devuelve una señal: COMPRAR, VENDER, CERRAR o ESPERAR. Al recibir esta respuesta, el Asesor Experto interpreta la señal y reacciona en consecuencia (dibujando flechas en el gráfico, abriendo operaciones o cerrando posiciones existentes) según la configuración del usuario. Este ciclo de retroalimentación permite a MetaTrader ampliar sus capacidades nativas con inteligencia analítica externa en tiempo real, combinando eficazmente el motor de ejecución de MetaTrader 5 con la potencia de procesamiento de Python.
Implementación de MQL5
Metadatos del script y modo estricto
En la parte superior de su archivo MQL5, declare propiedades de metadatos, como #property copyright, #property link y #property version, para incorporar información de autoría y versión directamente en el EA compilado. Habilitar #property strict impone las comprobaciones de tiempo de compilación más rigurosas, lo que ayuda a detectar errores de sintaxis o de tipo de forma temprana y garantiza que su código se adhiera a las mejores prácticas.
#property copyright "Copyright 2025, MetaQuotes Ltd."
#property link      "https://www.mql5.com/en/users/lynnchris"
#property version   "1.0"
#property strict
Importación de la biblioteca de operaciones
Al incluir <Trade\Trade.mqh> e instanciar un objeto CTrade, se obtiene acceso a la API nativa de gestión de operaciones de MetaTrader. Esta biblioteca integrada ofrece métodos para órdenes de mercado, órdenes stop, cierre de posiciones y otras operaciones esenciales, lo que te permite abrir, modificar y cerrar operaciones mediante programación en respuesta a las señales de tu servidor.
#include <Trade\Trade.mqh>
static CTrade trade;
Definición de los parámetros de entrada
Todos los parámetros configurables por el usuario —desde la URL del punto final REST (InpServerURL) y el número de barras que se van a enviar (InpBufferBars), hasta las opciones de dibujo en el gráfico y las banderas de ejecución de órdenes— se declaran desde el principio mediante sentencias de entrada. Cada parámetro incluye un comentario en línea que explica su finalidad, lo que hace que el EA se documente por sí mismo y permite a los operadores ajustar su comportamiento directamente en la interfaz gráfica de usuario de MetaTrader 5 sin necesidad de modificar el código.
// REST endpoint & polling
input string InpServerURL      = "http://127.0.0.1:5000/analyze";
input int    InpBufferBars     = 200;
input int    MinSecsBetweenReq = 10;

// Visual & trading options
input color  ColorBuy          = clrLime;
input color  ColorSell         = clrRed;
input bool   DrawSLTPLines     = true;
input bool   EnableTrading     = true;
input double FixedLots         = 0.10;

// Debug & retry controls
input int    MaxRetry          = 3;
input bool   DebugPrintJSON    = true;
input bool   DebugPrintReply   = true;
Variables de estado globales
Mantienes varias variables globales, como «lastBarTime» y «lastReqTime» para limitar las solicitudes, «retryCount» para la lógica de reintentos HTTP, y «_digits» y «tickSize» para un formato preciso de los precios. Una cadena «objPrefix», que tiene como valor inicial el ID del gráfico actual, asigna un espacio de nombres a todos los objetos del gráfico (flechas y líneas) creados por este EA, de modo que puedan identificarse claramente y eliminarse posteriormente.
datetime lastBarTime = 0;
datetime lastReqTime = 0;
int      retryCount  = 0;
int      _digits;
double   tickSize;
string   objPrefix;
Inicialización en OnInit
Cuando se inicia el EA, la función OnInit() se ejecuta una vez para validar los datos de entrada (por ejemplo, asegurándose de que se hayan solicitado al menos dos barras), almacenar en caché las propiedades del símbolo (SYMBOL_DIGITS y SYMBOL_POINT) y generar un prefijo de objeto único. Un mensaje de inicio muestra en el registro cuántas barras se enviarán y la URL del servidor de destino, lo que confirma que el EA está listo para iniciar su ciclo de consultas periódicas.
int OnInit()
{
   if(InpBufferBars < 2)
      return INIT_FAILED;

   _digits   = (int)SymbolInfoInteger(_Symbol, SYMBOL_DIGITS);
   tickSize  = SymbolInfoDouble(_Symbol, SYMBOL_POINT);
   objPrefix = StringFormat("SpikeEA_%I64d_", ChartID());

   PrintFormat("[SpikeEA] Initialized: posting %d bars → %s",
               InpBufferBars, InpServerURL);
   return INIT_SUCCEEDED;
}
Limpieza en OnDeinit
Al eliminarse o cerrarse, la función OnDeinit() recorre hacia atrás todos los objetos de gráfico y elimina aquellos cuyos nombres comienzan por tu «objPrefix». Esto garantiza que no queden flechas sueltas ni líneas de SL/TP en el gráfico una vez desactivado el EA, lo que te permite mantener tu espacio de trabajo ordenado.
void OnDeinit(const int reason)
{
   for(int i = ObjectsTotal(0) - 1; i >= 0; --i)
   {
      string name = ObjectName(0, i);
      if(StringFind(name, objPrefix) == 0)
         ObjectDelete(0, name);
   }
}
Solicitudes y creación de cargas útiles en OnTick
En cada tick, el EA comprueba si se ha formado una nueva barra (si la opción «PollOnNewBarOnly» está activada) y se asegura de que haya transcurrido un intervalo mínimo (MinSecsBetweenReq) desde la última solicitud. A continuación, extrae los últimos InpBufferBars mediante CopyRates, los ordena según la secuencia y llama a BuildJSON() para serializar los cierres y las marcas de tiempo en la carga útil JSON. Si la depuración está activa, el JSON sin procesar se muestra en el registro de «Experts» antes de enviarse.
void OnTick()
{
   datetime barTime = iTime(_Symbol, _Period, 0);
   if(barTime == lastBarTime) return;
   lastBarTime = barTime;

   if(TimeCurrent() - lastReqTime < MinSecsBetweenReq) return;

   MqlRates rates[];
   if(CopyRates(_Symbol, _Period, 0, InpBufferBars, rates) != InpBufferBars)
      return;
   ArraySetAsSeries(rates, true);

   string payload = BuildJSON(rates);
   if(DebugPrintJSON) PrintFormat("[SpikeEA] >>> %s", payload);

   SServerMsg msg;
   if(CallServer(payload, msg))
      ActOnSignal(msg);

   lastReqTime = TimeCurrent();
}
Creación de JSON en BuildJSON
La función auxiliar BuildJSON() toma la matriz de MqlRates y construye una cadena JSON compacta que contiene el nombre del símbolo, una matriz de precios de cierre (formateados con el número correcto de decimales) y una matriz paralela de marcas de tiempo al estilo UNIX. Se aplica el escape de cadenas para gestionar cualquier carácter especial en el nombre del símbolo, garantizando una salida JSON válida.
string BuildJSON(const MqlRates &r[])
{
   string j = StringFormat("{\"symbol\":\"%s\",\"prices\":[", _Symbol);
   for(int i = 0; i < InpBufferBars; i++)
      j += DoubleToString(r[i].close, _digits) + (i+1<InpBufferBars?",":"");
   j += "],\"timestamps\":[";
   for(int i = 0; i < InpBufferBars; i++)
      j += IntegerToString(r[i].time) + (i+1<InpBufferBars?",":"");
   j += "]}";
   return j;
}
Comunicación con el servidor en CallServer
CallServer() convierte la cadena JSON en un búfer uchar[], y a continuación envía una petición HTTP POST a InpServerURL mediante WebRequest(). Gestiona los tiempos de espera y los códigos de estado distintos de 200 mediante una lógica de reintentos hasta el valor de MaxRetry, mostrando mensajes de error si las solicitudes fallan. Si se realiza correctamente, captura la respuesta de texto sin formato —registrándola opcionalmente— y la pasa a ParseJSONLite() para su interpretación.
bool CallServer(const string &payload, SServerMsg &out)
{
   uchar body[];
   int len = StringToCharArray(payload, body, 0, WHOLE_ARRAY, CP_UTF8);
   ArrayResize(body, len);

   string hdr = "Content-Type: application/json\r\n";
   uchar reply[]; string resp_hdr;
   int status = WebRequest("POST", InpServerURL, hdr,
                           InpTimeoutMs, body, reply, resp_hdr);

   if(status <= 0)
   {
      PrintFormat("WebRequest error %d (retry %d/%d)",
                  GetLastError(), retryCount+1, MaxRetry);
      ResetLastError();
      if(++retryCount >= MaxRetry) retryCount = 0;
      return false;
   }
   retryCount = 0;

   string resp = CharArrayToString(reply);
   if(DebugPrintReply)
      PrintFormat("[SpikeEA] <<< HTTP %d – %s", status, resp);
   if(status != 200) return false;

   return ParseJSONLite(resp, out);
}
Análisis ligero de JSON en ParseJSONLite
En lugar de utilizar una biblioteca JSON completa, ParseJSONLite() recurre a búsquedas sencillas en cadenas (StringFind) para detectar palabras clave como «signal»: «BUY» y claves numéricas como «conf:», «sl:» y «tp:».
bool ParseJSONLite(const string &txt, SServerMsg &o)
{
   o.code = SIG_WAIT; o.conf = o.sl = o.tp = 0.0;

   if(StringFind(txt, "\"signal\":\"BUY\"")   >= 0) o.code = SIG_BUY;
   if(StringFind(txt, "\"signal\":\"SELL\"")  >= 0) o.code = SIG_SELL;
   if(StringFind(txt, "\"signal\":\"CLOSE\"") >= 0) o.code = SIG_CLOSE;

   // extract numeric values
   ParseJSONDouble(txt, "\"conf\":", o.conf);
   ParseJSONDouble(txt, "\"sl\":",   o.sl);
   ParseJSONDouble(txt, "\"tp\":",   o.tp);

   return true;
}
Extrae y convierte estas subcadenas en la estructura SServerMsg, estableciendo el código de señal del EA, el valor de confianza y los niveles de stop-loss y take-profit.
void ParseJSONDouble(const string &txt, const string &key, double &out)
{
   int p = StringFind(txt, key);
   if(p >= 0)
      out = StringToDouble(StringSubstr(txt, p + StringLen(key)));
}
Actuación en respuesta a señales en ActOnSignal
Cuando llega una nueva señal, la función ActOnSignal() borra primero cualquier flecha o línea anterior que coincida con tu objPrefix. A continuación, dibuja una nueva flecha en el precio de compra actual —seleccionando el código del icono, el color y el tamaño en función del tipo de señal— y, si está activada, añade líneas horizontales de SL y TP con etiquetas. Por último, si se activa el trading en tiempo real, se utiliza el objeto de trading para abrir o cerrar posiciones según la señal: Buy(), Sell() o PositionClose().
void ActOnSignal(const SServerMsg &m)
{
   static ESignal last = SIG_WAIT;
   if(m.code == SIG_WAIT || m.code == last) return;
   last = m.code;

   // remove old objects
   for(int i=ObjectsTotal(0)-1;i>=0;--i)
      if(StringFind(ObjectName(0,i),objPrefix)==0)
         ObjectDelete(0,ObjectName(0,i));

   // draw arrow
   int    arrow = (m.code==SIG_BUY ? 233 : m.code==SIG_SELL ? 234 : 158);
   color  clr   = (m.code==SIG_BUY ? ColorBuy : m.code==SIG_SELL ? ColorSell : ColorClose);
   string id    = objPrefix + "Arr_" + TimeToString(TimeCurrent(),TIME_SECONDS);
   double y     = SymbolInfoDouble(_Symbol, SYMBOL_BID);
   if(ObjectCreate(0,id,OBJ_ARROW,0,TimeCurrent(),y))
   {
      ObjectSetInteger(0,id,OBJPROP_ARROWCODE,arrow);
      ObjectSetInteger(0,id,OBJPROP_COLOR,clr);
      ObjectSetInteger(0,id,OBJPROP_WIDTH,ArrowSize);
      PlaySound("alert.wav");
   }

   // draw SL/TP lines
   if(DrawSLTPLines && m.sl>0)
      ObjectCreate(0,objPrefix+"SL_"+id,OBJ_HLINE,0,0,m.sl);
   if(DrawSLTPLines && m.tp>0)
      ObjectCreate(0,objPrefix+"TP_"+id,OBJ_HLINE,0,0,m.tp);

   // execute trade
   if(EnableTrading)
   {
      bool hasPos = PositionSelect(_Symbol);
      if(m.code==SIG_BUY  && !hasPos) trade.Buy(FixedLots,_Symbol,0,m.sl,m.tp);
      if(m.code==SIG_SELL && !hasPos) trade.Sell(FixedLots,_Symbol,0,m.sl,m.tp);
      if(m.code==SIG_CLOSE&&  hasPos) trade.PositionClose(_Symbol,SlippagePoints);
   }
}
Compilación e implementación
Para terminar, pega el código del EA en MetaEditor, guárdalo en la carpeta «Experts» y pulsa F7. Una vez que hayas comprobado que no hay «0 errores, 0 advertencias», vuelve a MetaTrader 5, busca tu EA en el Navegador, arrástralo a un gráfico y configura los parámetros en el cuadro de diálogo emergente. Las pestañas «Expertos» y «Diario» mostrarán entonces registros en tiempo real de las solicitudes POST en formato JSON, las señales analizadas, los objetos gráficos creados y cualquier ejecución de operaciones.
Implementación en Python
Encabezado del archivo y requisitos
Justo al principio del archivo engine.py, incluimos un shebang de Unix (#!/usr/bin/env python3) y un bloque de comentarios descriptivo que resume las capacidades del back-end —ingesta vectorizada de datos históricos, normalización de CSV, almacenamiento en caché de Prophet, entrenamiento, backtesting y modos CLI— junto con el comando pip install para todas las dependencias necesarias. Este encabezado no solo describe de un vistazo lo que hace el script, sino que también proporciona a cualquier desarrollador la lista exacta de bibliotecas necesarias para ejecutar el sistema tal cual.
#!/usr/bin/env python3
# engine.py – Boom/Crash/Vol-75 ML back-end
# • vectorised /upload_history
# • /upload_spike_csv
# • Prophet cache (1h)
# • robust CSV writer
# • train() drops bad rows
# • SL/TP with ATR or fallback
# • backtest defaults to 30 days
# • CLI: collect · history · train · backtest · serve · info
#
# REQS: pip install numpy pandas ta prophet cmdstanpy pykalman \
#            scikit-learn flask MetaTrader5 joblib pytz
Ajustes configurables por el usuario
Inmediatamente después del encabezado, definimos constantes para los datos de inicio de sesión en el terminal (TERM_PATH, LOGIN, PASSWORD, SERVER) y una matriz de SÍMBOLOS que nuestro sistema procesará. También configuramos los parámetros que controlan la previsión para el etiquetado (LOOKAHEAD, THRESH_LABEL), los intervalos de sondeo (STEP_SECONDS), los umbrales para la apertura y el cierre de operaciones (THR_BC_OPEN, THR_O_OPEN, THR_O_CLOSE) y los multiplicadores de stop-loss y take-profit basados en el ATR (ATR_PERIOD, SL_MULT, TP_MULT, ATR_FALLBACK_P). Al centralizar estos valores, los usuarios pueden adaptar rápidamente los parámetros de riesgo, las ventanas de datos y la lista de símbolos de la estrategia sin tener que profundizar en la lógica del código.
TERM_PATH  = r""
LOGIN      = 123456
PASSWORD   = "passwd"
SERVER     = "DemoServer"

SYMBOLS = [
    "Boom 900 Index",  "Crash 1000 Index",
    "Volatility 75 (1s) Index"
]

LOOKAHEAD    = 10       # minutes
THRESH_LABEL = 0.0015   # 0.15 %
STEP_SECONDS = 60       # live collect interval

ATR_PERIOD     = 14
SL_MULT        = 1.0
TP_MULT        = 2.0
ATR_FALLBACK_P = 0.002
Rutas de los archivos y encabezado del CSV
A continuación, definimos las constantes del sistema de archivos: BASE_DIR como carpeta raíz de análisis, CSV_FILE que apunta a nuestro conjunto de datos de entrenamiento agregado, MODEL_DIR para los artefactos del modelo por símbolo y GLOBAL_PKL para el modelo genérico. También definimos CSV_HEADER, una lista fija de nombres de columnas que garantiza que cada fila escrita contenga los mismos 12 campos. Esta sección estandariza la ubicación de los datos y garantiza la coherencia en nuestros archivos CSV almacenados, lo cual es fundamental para que los procesos posteriores de formación y análisis se desarrollen sin problemas.
BASE_DIR   = r"C:\Analysis EA"
CSV_FILE   = rf"{BASE_DIR}\training_set.csv"
MODEL_DIR  = rf"{BASE_DIR}\models"
GLOBAL_PKL = rf"{MODEL_DIR}\_global.pkl"

CSV_HEADER = [
    "timestamp","symbol","price","spike_mag","macd","rsi",
    "atr","slope","env_low","env_up","delta","label"
]
Configuración de importaciones y registro
Importamos bibliotecas estándar (os, sys, time, threading, etc.), paquetes de ciencia de datos (numpy, pandas, ta, joblib), los módulos Prophet y del filtro de Kalman, Flask para nuestra API y el envoltorio de Python para MetaTrader 5. Las advertencias se ocultan para mantener la claridad, y el registro está configurado para mostrar marcas de tiempo, niveles de registro y mensajes en un formato legible para el usuario. Por último, nos aseguramos de que el directorio del modelo exista y cambiamos el directorio de trabajo a BASE_DIR, de modo que todas las operaciones relativas a los archivos se realicen en una ubicación conocida.
import os,sys,time,logging,warnings,argparse,threading,io
import datetime as dt
from pathlib import Path
import numpy as np, pandas as pd, ta, joblib, pytz
from flask import Flask, request, jsonify, abort
from prophet import Prophet
from pykalman import KalmanFilter
import MetaTrader5 as mt5

warnings.filterwarnings("ignore")
logging.basicConfig(level=logging.INFO,
                    format="%(asctime)s %(levelname)-7s %(message)s",
                    datefmt="%H:%M:%S")
Path(MODEL_DIR).mkdir(parents=True, exist_ok=True)
os.chdir(BASE_DIR)
Herramientas de inicialización de MetaTrader 5
La función init_mt5() inicializa de forma segura la conexión con MetaTrader 5; para ello, primero intenta una llamada predeterminada y, si es necesario, recurre a las credenciales; en caso de fallo, se produce una salida controlada acompañada de un mensaje de error. ensure_symbol(sym) simplemente envuelve mt5.symbol_select para garantizar que cada instrumento esté activo antes de solicitar datos. Un bloqueo de subprocesos (_mt5_lock) protege cualquier llamada multihilo a MetaTrader 5, garantizando la seguridad entre subprocesos cuando nuestro servidor genera tareas en segundo plano.
_mt5_lock = threading.Lock()
def init_mt5():
    if mt5.initialize(): return
    if not mt5.initialize(path=TERM_PATH, login=LOGIN,
                          password=PASSWORD, server=SERVER):
        sys.exit(f"MT5 init failed {mt5.last_error()}")

def ensure_symbol(sym):
    return mt5.symbol_select(sym, True)
Caché de Prophet y delta de previsión
Para evitar tener que recompilar el modelo Prophet en cada solicitud, mantenemos un diccionario _PROP, seguro para subprocesos, que asocia los símbolos a None (compilación pendiente) o a una tupla (modelo, marca de tiempo). _compile_prophet(df, sym) entrena un nuevo modelo Prophet a partir de datos históricos y registra la hora. prophet_delta(prices, times, sym) comprueba la caché: si falta o está obsoleta (más de una hora), lanza el entrenamiento en segundo plano; si ya está disponible, realiza una previsión para el segundo siguiente y devuelve el delta previsto. Este diseño garantiza que las previsiones sigan respondiendo con rapidez y evita que se bloqueen las solicitudes entrantes.
_PROP_LOCK = threading.Lock()
_PROP = {}  # sym -> (model, timestamp) or None

def _compile_prophet(df, sym):
    mdl = Prophet(daily_seasonality=False, weekly_seasonality=False)
    mdl.fit(df)
    with _PROP_LOCK:
        _PROP[sym] = (mdl, time.time())

def prophet_delta(prices, times, sym):
    if len(prices) < 20: return 0.0
    with _PROP_LOCK:
        entry = _PROP.get(sym)
        if entry is None:
            _PROP[sym] = None
            df = pd.DataFrame({"ds": pd.to_datetime(times, unit='s'),
                               "y": prices})
            threading.Thread(target=_compile_prophet, args=(df, sym), daemon=True).start()
            return 0.0
        mdl, ts = entry
    if time.time() - ts > 3600:
        with _PROP_LOCK: _PROP[sym] = None
        return 0.0
    fut = mdl.make_future_dataframe(periods=1, freq='s')
    return float(mdl.predict(fut).iloc[-1]["yhat"] - prices[-1])
Funciones auxiliares de características
Definimos un conjunto de pequeñas funciones —z_spike, macd_div, rsi_val, combo_spike y otras— que calculan señales técnicas individuales, como los picos de puntuación estándar, la divergencia del MACD, el RSI y una «puntuación de picos» combinada. Cada función auxiliar comprueba que haya un historial suficiente antes de realizar el cálculo y devuelve un valor por defecto cuando los datos son insuficientes. Al aislar estos cálculos, mantenemos limpia nuestra lógica principal de ingesta y facilitamos las pruebas unitarias de cada indicador.
def z_spike(prices, win=20):
    if len(prices) < win: return False, 0.0
    r = np.diff(prices[-win:])
    z = (r[-1] - r.mean())/(r.std()+1e-6)
    return abs(z) > 2.5, float(z)

def macd_div(prices):
    if len(prices) < 35: return 0.0
    return float(ta.trend.macd_diff(pd.Series(prices)).iloc[-1])

def rsi_val(prices, l=14):
    if len(prices) < l+1: return 50.0
    return float(ta.momentum.rsi(pd.Series(prices), l).iloc[-1])

def combo_spike(prices):
    _, z = z_spike(prices)
    m = macd_div(prices)
    v = prices[-1] - prices[-4] if len(prices) >= 4 else 0.0
    s = abs(z) + abs(m) + abs(v)/(np.std(prices[-20:])+1e-6)
    return s > 3.0, s
Ayuda para añadir datos a un archivo CSV y gen_row
append_rows(rows) toma una lista de listas de 12 elementos y las escribe en training_set.csv, creando el archivo con encabezados en la primera escritura y añadiendo los elementos posteriormente. gen_row(i, closes, times, sym, highs=None, lows=None) crea una única fila de entrenamiento: calcula las características a partir del historial de precios hasta el índice i (incluidas las bandas ATR y de envolvente si se proporcionan matrices de máximos y mínimos), llama a prophet_delta para la previsión y asigna una etiqueta «COMPRAR/VENDER/ESPERAR» en función de la evolución futura de los precios. Al separar la generación de filas de la importación, reutilizamos gen_row tanto en las importaciones en tiempo real como en las históricas.
def append_rows(rows):
    if not rows: return
    pd.DataFrame(rows, columns=CSV_HEADER)\
      .to_csv(CSV_FILE, mode="a", index=False,
              header=not Path(CSV_FILE).exists())

def gen_row(i, closes, times, sym, highs=None, lows=None):
    if i < LOOKAHEAD or i+LOOKAHEAD >= len(closes): return None
    seq = closes[:i]
    _, mag = combo_spike(seq)
    atr = ta.volatility.average_true_range(pd.Series(highs[:i+1]),
                                           pd.Series(lows[:i+1]),
                                           pd.Series(seq)).iloc[-1] if highs else 0.0
    row = [
        times[i], sym, closes[i], mag,
        macd_div(seq), rsi_val(seq),
        atr, 0.0, 0.0, 0.0,
        prophet_delta(seq, times[:i], sym)
    ]
    ch = (closes[i+LOOKAHEAD] - closes[i]) / closes[i]
    row.append("BUY" if ch > THRESH_LABEL else "SELL" if ch < -THRESH_LABEL else "WAIT")
    return row
Bucle de recopilación (datos en tiempo real)
En collect_loop(), nos aseguramos de que el archivo CSV exista y, a continuación, entramos en un bucle infinito que, para cada símbolo, solicita los últimos LOOKAHEAD+1 barras mediante mt5.copy_rates_from_pos, omite los duplicados por marca de tiempo y llama a gen_row para generar y añadir una nueva observación etiquetada. Una espera de STEP_SECONDS garantiza una frecuencia de sondeo controlada. Este bucle de datos en tiempo real amplía continuamente nuestro conjunto de entrenamiento con nuevas observaciones hasta que el usuario lo interrumpe.
def collect_loop():
    if not Path(CSV_FILE).exists(): append_rows([])
    last = {}
    print("Collecting… CTRL-C to stop")
    init_mt5()
    while True:
        for sym in SYMBOLS:
            if not ensure_symbol(sym): continue
            bars = mt5.copy_rates_from_pos(sym, mt5.TIMEFRAME_M1, 0, LOOKAHEAD+1)
            if bars is None or len(bars) < LOOKAHEAD+1: continue
            if last.get(sym) == bars[-1]['time']: continue
            last[sym] = bars[-1]['time']
            closes = bars['close'].tolist()
            times  = bars['time'].tolist()
            row = gen_row(len(closes)-LOOKAHEAD-1, closes, times, sym)
            if row: append_rows([row])
        time.sleep(STEP_SECONDS)
Importación del historial (MetaTrader 5 y archivo)
history_from_mt5(sym, start, end) y history_from_file(sym, path) permiten rellenar el archivo CSV a partir del historial almacenado en MetaTrader 5 o de un archivo local. Ambas funciones recorren cada barra con marca de tiempo, llaman a `gen_row` para generar características y una etiqueta, agrupan las filas en lotes (por ejemplo, 5.000 cada vez) y las añaden mediante `append_rows`. La función de envoltura history_cli(args) analiza los argumentos de la línea de comandos (--days, --from, --to o --file) para automatizar la importación del conjunto de datos completo correspondiente a los símbolos y los intervalos de fechas especificados.
def history_from_mt5(sym, start, end):
    init_mt5()
    r = mt5.copy_rates_range(sym, mt5.TIMEFRAME_M1,
                              start.replace(tzinfo=UTC),
                              end.replace(tzinfo=UTC))
    if r is None or len(r)==0: return
    closes, times = r['close'].tolist(), r['time'].tolist()
    highs, lows   = r['high'].tolist(), r['low'].tolist()
    rows = [gen_row(i, closes, times, sym, highs, lows)
            for i in range(len(closes)-LOOKAHEAD) if gen_row(i, closes, times, sym, highs, lows)]
    append_rows([rw for rw in rows if rw])
    print(sym, "imported", len(rows), "rows")
Modelos de formación
train_models() lee el archivo training_set.csv, convierte las columnas de características a formato numérico (eliminando cualquier fila con formato incorrecto) y, a continuación, recorre el subconjunto de cada símbolo: si hay al menos 400 filas, crea un Pipeline de scikit-learn (escalado estándar + gradient boosting), lo ajusta a los datos etiquetados y guarda el modelo como un archivo .pkl. Además, entrena y guarda un modelo global que abarca todos los símbolos. El resultado es un directorio de clasificadores listos para usar.
def build_pipe(X, y):
    pipe = Pipeline([
        ("sc", StandardScaler()),
        ("gb", GradientBoostingClassifier(n_estimators=400,
                                          learning_rate=0.05,
                                          max_depth=3,
                                          random_state=42))
    ])
    return pipe.fit(X, y)

def train_models():
    df = pd.read_csv(CSV_FILE)
    df = df.dropna(subset=FEATURES)
    for sym in SYMBOLS:
        d = df[df.symbol == sym]
        if len(d) < 400: continue
        model = build_pipe(d[FEATURES], d.label.map({"WAIT":0,"BUY":1,"SELL":2}))
        joblib.dump(model, Path(MODEL_DIR)/f"{sym.replace(' ','_')}.pkl")
    global_model = build_pipe(df[FEATURES], df.label.map({"WAIT":0,"BUY":1,"SELL":2}))
    joblib.dump(global_model, GLOBAL_PKL)
Puntos de conexión del servidor Flask
Ponemos en marcha una aplicación de Flask con tres rutas principales:
/upload_history analiza fragmentos de datos JSON, calcula las mismas características que gen_row, etiqueta cada fila y llama a append_rows.
/upload_spike_csv acepta registros sin procesar de EA (ya sean archivos de texto CSV o matrices JSON), los adapta a nuestro formato de 12 columnas y los añade al final.
/analyze carga el modelo adecuado mediante load_model(), calcula las características en tiempo real a partir de los precios publicados y las marcas de tiempo, predice las probabilidades de clase, aplica los umbrales de apertura y cierre, y devuelve un objeto JSON que contiene la señal, el nivel de confianza, el SL/TP y la fuerza de la señal.
app = Flask(__name__)
app.config["MAX_CONTENT_LENGTH"] = 32*1024*1024

@app.route("/upload_history", methods=["POST"])
def upload_history():
    j = request.get_json(force=True)
    close, ts = np.array(j["close"]), np.array(j["time"],dtype=int)
    high = np.array(j.get("high", close))
    low  = np.array(j.get("low", close))
    df = pd.DataFrame({"timestamp": ts, "price": close})
    # compute features as in gen_row…
    append_rows(df.assign(symbol=j["symbol"]).values.tolist())
    return jsonify(status="ok", rows_written=len(df))

@app.route("/upload_spike_csv", methods=["POST"])
def upload_spike_csv():
    j = request.get_json(force=True)
    df_ea = pd.read_csv(io.StringIO(j.get("csv","")), sep=",")
    # map EA columns → CSV_HEADER
    append_rows(mapped_rows)
    return jsonify(status="ok", rows_written=len(mapped_rows))

@app.route("/analyze", methods=["POST"])
def api_analyze():
    j = request.get_json(force=True)
    mdl = load_model(j["symbol"])
    feats = [...]  # compute from j["prices"], j["timestamps"]
    proba = mdl.predict_proba([feats])[0]
    signal = decide_open(proba[1], proba[2], j["symbol"])
    # build sl, tp, manage _trades…
    return jsonify(signal=signal, sl=sl, tp=tp, strength=max(proba))
Estos puntos finales permiten la ingesta de datos, el rellenado retrospectivo y la toma de decisiones en tiempo real para el EA de MQL5.
Herramientas de backtesting e información
backtest_one(sym, df) reutiliza los auxiliares de características offline y la lógica de inferencia del modelo para simular operaciones sobre el DataFrame histórico df, registrando las pérdidas y ganancias cuando se cumplen las condiciones de stop-loss, take-profit o cierre anticipado. backtest_cli(args) agrupa los resultados de todos los símbolos y muestra un resumen de las pérdidas y ganancias. La función info() simplemente muestra el número de filas del archivo CSV, la distribución de las etiquetas y el número de características de cada modelo, lo cual resulta muy útil para realizar una rápida comprobación del estado de los datos.
def backtest_one(sym, df):
    mdl = load_model(sym)
    for i in range(len(df)):
        feats = [...]  # offline feature calcs
        pr = mdl.predict_proba([feats])[0]
        # open/close logic identical to /analyze
    return trades

def info():
    df = pd.read_csv(CSV_FILE)
    print("Rows:", len(df), "Labels:", df.label.value_counts())
    for pkl in Path(MODEL_DIR).glob("*.pkl"):
        mdl = joblib.load(pkl)
        print(pkl.name, "features", mdl.named_steps["sc"].n_features_in_)
Interfaz de línea de comandos
Por último, el bloque «if __name__ == «__main__»:» define una interfaz de línea de comandos (CLI) de argparse con seis subcomandos —collect, history, train, backtest, serve e info— que invocan cada uno la función correspondiente. Este patrón ofrece un script único y coherente en el que puedes, por ejemplo, ejecutar «python engine.py history --days 180» para completar los datos de los últimos seis meses, o «python engine.py serve» para poner en marcha la API en tiempo real de tu EA.
if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    subs = parser.add_subparsers(dest="mode", required=True)
    subs.add_parser("collect")
    subs.add_parser("history")
    subs.add_parser("train")
    subs.add_parser("backtest")
    subs.add_parser("serve")
    subs.add_parser("info")
    args = parser.parse_args()
    if args.mode == "collect": init_mt5(); collect_loop()
    elif args.mode == "history": history_cli(args)
    elif args.mode == "train": train_models()
    elif args.mode == "backtest": backtest_cli(args)
    elif args.mode == "serve": init_mt5(); app.run("0.0.0.0", 5000, threaded=True)
    elif args.mode == "info": info()
Entrenamiento de modelos en Python
Ahora que ya hemos acumulado suficientes datos históricos en nuestro archivo CSV (alimentado a través de nuestra rutina de importación de datos históricos de MQL5 y el receptor de Python), la siguiente fase es el entrenamiento del modelo. Asegúrate de haber ingerido datos de todos los símbolos definidos en nuestros scripts MQL5 y Python. Una vez finalizada la importación, podemos pasar a:- Entrenar los modelos de aprendizaje automático
- Analizar su rendimiento en un periodo histórico
- Desplegar los modelos resultantes para la inferencia en tiempo real
En este paso, entrenamos un clasificador de boosting por gradiente para cada símbolo (y un modelo global) con el fin de predecir si la señal será COMPRAR, VENDER o ESPERAR tras nuestro periodo de previsión. El «Gradient Boosting» construye un conjunto de árboles de decisión de forma secuencial, en el que cada nuevo árbol corrige los errores de los anteriores; esto lo hace robusto ante datos financieros con ruido y capaz de captar patrones no lineales en nuestro conjunto de características. Lo integramos en un proceso de scikit-learn con un StandardScaler para normalizar las características antes del entrenamiento.
# 3) TRAIN MODELS
def build_pipe(X, y):
    """
    Construct and fit a pipeline: StandardScaler → GradientBoostingClassifier.
    """
    pipe = Pipeline([
        ("sc", StandardScaler()),
        ("gb", GradientBoostingClassifier(
            n_estimators=400,      # number of boosting rounds
            learning_rate=0.05,    # shrinkage factor per tree
            max_depth=3,           # depth of each tree
            random_state=42        # reproducibility
        ))
    ])
    pipe.fit(X, y)
    return pipe

def train_models():
    """
    Load the CSV, clean it, train per-symbol and global Gradient Boosting models, and save to disk.
    """
    if not Path(CSV_FILE).exists():
        sys.exit("No training_set.csv")

    # Read and sanitize
    df = pd.read_csv(CSV_FILE)
    if "symbol" not in df.columns:
        sys.exit("CSV missing 'symbol' column")

    # Ensure numeric features
    for col in FEATURES:
        df[col] = pd.to_numeric(df[col], errors="coerce")
    bad = df[FEATURES].isna().any(axis=1).sum()
    if bad:
        print(f"Discarding {bad} malformed rows")
        df = df.dropna(subset=FEATURES)

    # Train a Gradient Boosting model for each symbol
    for sym in SYMBOLS:
        d = df[df.symbol == sym]
        if len(d) < 400:
            print("Skip", sym, "(few rows)")
            continue
        model = build_pipe(
            d[FEATURES],
            d.label.map({"WAIT": 0, "BUY": 1, "SELL": 2})
        )
        joblib.dump(model, Path(MODEL_DIR) / f"{sym.replace(' ', '_')}.pkl")
        print("model", sym, "saved")

    # Train and save a global Gradient Boosting model
    global_model = build_pipe(
        df[FEATURES],
        df.label.map({"WAIT": 0, "BUY": 1, "SELL": 2})
    )
    joblib.dump(global_model, GLOBAL_PKL)
    print("global model saved")
Inicia el entrenamiento con:
python engine.py trainTras ejecutar nuestra rutina de entrenamiento, observamos esta salida en la consola:
C:\Users\hp\Pictures\Saved Pictures\Analysis EA>python engine.py train
Discarding 1152650 malformed rows
model Boom 900 Index saved
model Boom 1000 Index saved
model Boom 500 Index saved
model Crash 500 Index saved
model Boom 300 Index saved
....................................
....................................
All models saved
Una vez finalizado el entrenamiento y guardados todos los modelos —lo cual puede llevar un tiempo, dado el volumen de datos—, ya estás listo para los siguientes pasos. Puedes realizar pruebas retrospectivas de los modelos recién entrenados con datos históricos o pasar directamente a su implementación. En mi caso, pasé directamente a la implementación del modelo, tema que trataré en la siguiente sección.
Implementación de modelos e inferencia en tiempo real
Si el proceso sigue en ejecución, deténlo con Ctrl+C. A continuación, inicia el servidor de inferencia en tiempo real con:python engine.py serve
Este comando implementa los modelos entrenados y comienza a proporcionar señales de trading en tiempo real.
En MetaTrader 5, asigna el asesor experto a cada símbolo para el que hayas entrenado un modelo. A continuación, en MetaTrader 5, en Herramientas → Opciones → Asesores Expertos, activa la opción Permitir WebRequest para las siguientes URL para la URL indicada y añade la dirección de tu servidor a la lista.
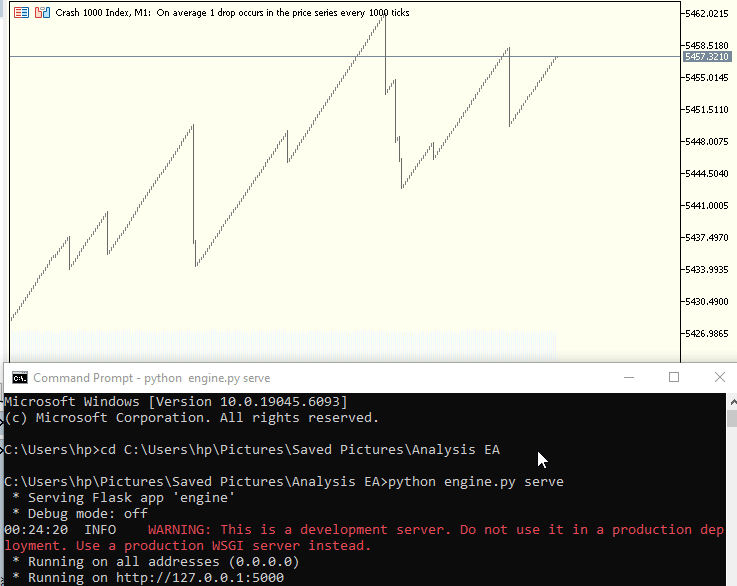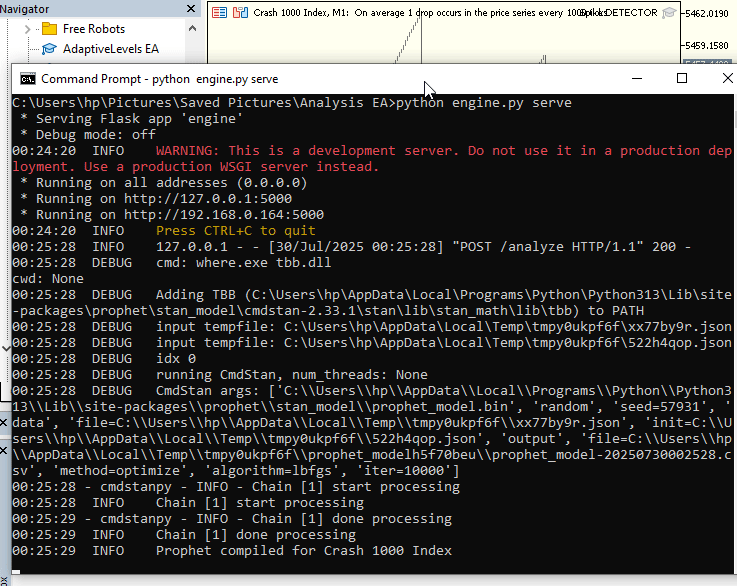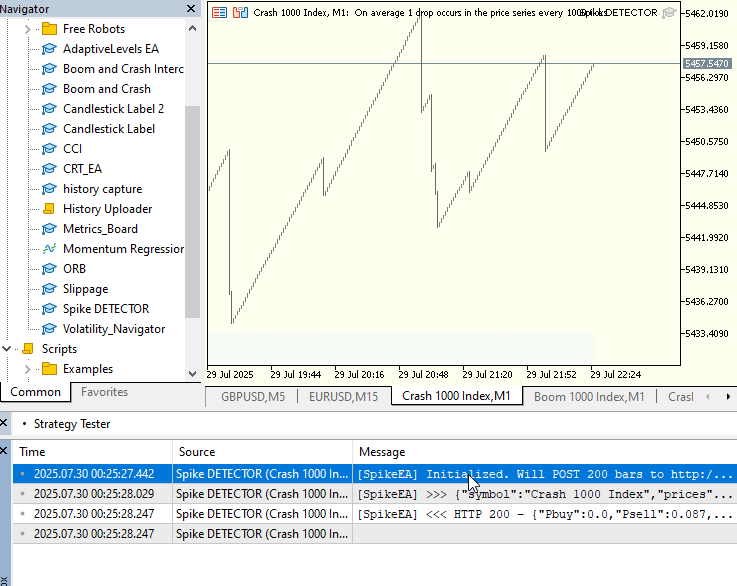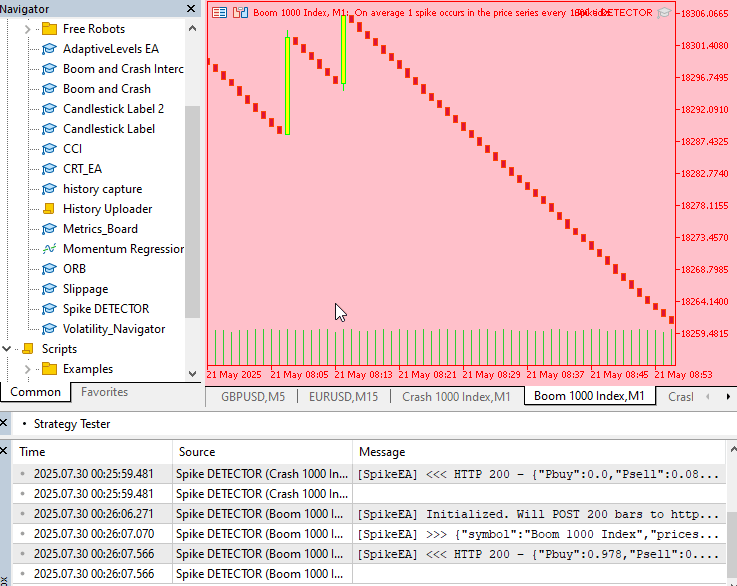
Un código de estado HTTP 200 significa «OK»: la solicitud se ha recibido, se ha interpretado y se ha procesado correctamente.
Durante nuestras pruebas con el servidor en vivo, cada instancia de EA se conectó correctamente al backend de Python (HTTP 200) y devolvió su recomendación de negociación en menos de 50 ms. Esto es lo que nos revelaron los registros:
Índice Crash 1000 (M1)
A las 00:31:59,717, el modelo indicó una probabilidad de COMPRA del 0 % y una probabilidad de VENTA del 2,6 %, lo que dio lugar a una confianza (fuerza) combinada de tan solo el 3 %. Dado que no se superó ninguno de los dos umbrales, el EA seleccionó correctamente la señal WAIT.
Índice Boom 1000 (M1)
Apenas 37 ms después (a las 00:31:59,754), el modelo de este símbolo indicó una probabilidad de COMPRA del 99,4 % y de VENTA del 0 %. Esa gran confianza activó de inmediato una señal OPEN BUY.
Estos registros confirman que nuestro proceso de implementación funciona de principio a fin.
2025.07.30 00:31:59.717 Spike DETECTOR (Crash 1000 Index,M1)    [SpikeEA] <<< HTTP 200 – {"Pbuy":0.0,"Psell":0.026,"scale_in":null
,"side":"NONE","signal":"WAIT","strength":0.03
2025.07.30 00:31:59.754 Spike DETECTOR (Boom 1000 Index,M1)     [SpikeEA] <<< HTTP 200 – {"Pbuy":0.994,"Psell":0.0,"scale_in":null
,"side":"BUY","signal":"OPEN"
, "strength":0.99
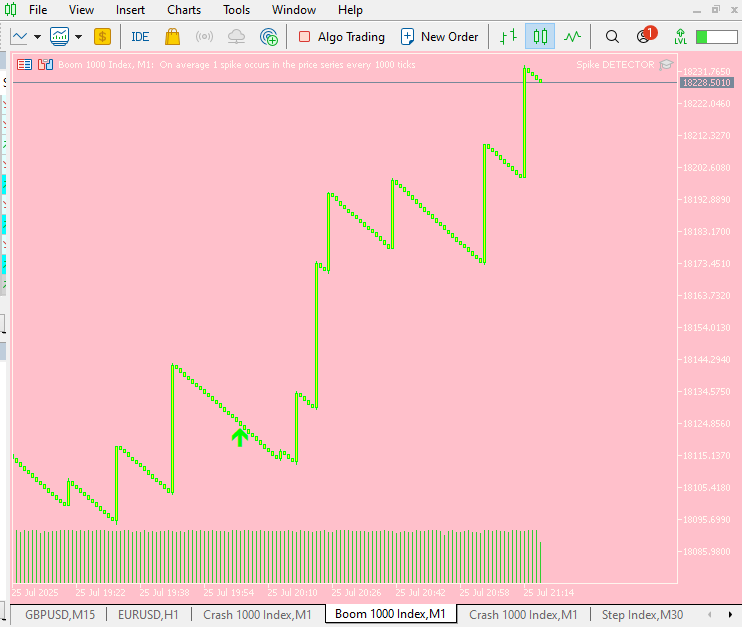
A continuación se muestra una prueba anterior del sistema. En ocasiones, el EA indicará una entrada; estas instrucciones «OPEN» aparecen en los registros de MetaTrader 5, aunque no se muestra ninguna flecha en el gráfico. La aparición de un indicador visual depende de la intensidad de la señal.
Registros de MetaTrader 5
2025.07.25 19:55:01.445 Spike DETECTOR (Boom 1000 Index,M1)     [SpikeEA] <<< HTTP 200 – {"Pbuy":0.999,"Psell":0.0,"scale_in":null
,"side":"BUY","signal":"OPEN","strength":1.0
Gráfico de MetaTrader 5
Conclusión
La combinación de MQL5 y Python nos ha proporcionado un marco de trading potente y flexible, que aprovecha lo mejor de ambos mundos. En el lado de MQL5, nuestro EA captura de forma fluida los picos, la divergencia del MACD, el RSI, el ATR, las pendientes filtradas mediante Kalman y los deltas de Prophet, y luego envía esas métricas directamente a Python. En cuanto a Python, un único script engine.py (con los comandos «collect», «history», «train», «backtest» y «serve») se encarga del trabajo más pesado del entrenamiento del modelo y de su puesta en servicio en tiempo real. En nuestra configuración, nos basamos en el EA de MQL5 para obtener todas las características necesarias, por lo que solo tuvimos que ejecutar:
python engine.py train
python engine.py serve
Nos saltamos la recopilación y el historial porque nuestra EA ya gestiona y nos proporciona el conjunto de datos completo.
¿El resultado? En cuestión de instantes tras pulsar Serve, nuestros modelos de Gradient Boosting devuelven señales BUY/SELL/WAIT en tiempo real a MetaTrader 5 en menos de 50 ms por barra, listas para que la lógica de órdenes de nuestro EA actúe en consecuencia. Tanto si acabas de empezar a explorar la amplia biblioteca de documentación y ejemplos de la comunidad de la página web de MQL5, como si eres un analista cuantitativo con experiencia que busca integrar nuevos generadores de funciones o algoritmos, este flujo de trabajo integral se adapta sin esfuerzo a distintos símbolos y estrategias.
Gracias a la comunidad de MQL5 y a la gran cantidad de ejemplos de código y consejos del foro disponibles en mql5.com; vuestros recursos han hecho que esta integración resultara muy sencilla. Animo a todos a seguir explorando: ajusten los hiperparámetros, añadan nuevos indicadores o incluso contenericen su servidor Python para llevarlo a producción. Y lo más importante: comparte tus conclusiones con la comunidad para que todos podamos seguir avanzando juntos en el trading algorítmico basado en datos.
Traducción del inglés realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/en/articles/18985
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.

 Trading algorítmico de arbitraje basado en la teoría de grafos
 Redes neuronales en el trading: Modelo de difusión adaptativa sobre grafos (Final)
 Particularidades del trabajo con números del tipo double en MQL4
 Robot de trading basado en un modelo GPT

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso