

Desarrollo de un kit de herramientas para el análisis de la acción del precio (Parte 34): Conversión de datos brutos del mercado en modelos predictivos mediante un pipeline avanzado de ingesta
 21
 0

Introducción
La evolución de los precios y sus trayectorias futuras dependen por completo del comportamiento histórico: los niveles clave de soporte y resistencia se definen a partir de las oscilaciones de precios pasadas, y los operadores que apuestan por los «Boom and Crash» suelen verse sorprendidos por repuntes repentinos —o llegar demasiado tarde para aprovecharlos—. Sin una forma sistemática de recopilar, procesar y aprender de ese pasado, cada operación es una apuesta.
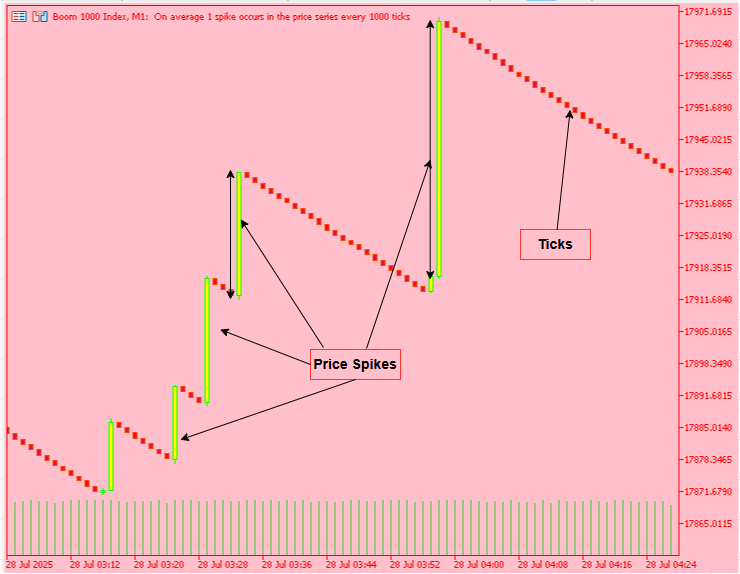
En esta entrega de "Desarrollo de un kit de herramientas para el análisis de la acción del precio", presentamos un marco integral que transforma el historial bruto de MetaTrader 5 en señales de trading precisas y en tiempo real mediante aprendizaje automático. Los dos lados del motor trabajan en conjunto:
Ingesta de datos MQL5
- División automática en fragmentos: un script ligero que se puede añadir a cualquier gráfico de MetaTrader 5 divide el historial de barras de varios símbolos en fragmentos JSON de tamaño adecuado. Reduce dinámicamente a la mitad el tamaño de los fragmentos si superan los 14 MiB, por lo que nunca alcanzará el límite de carga de MetaTrader 5 ni tendrá que exportar manualmente un archivo CSV.
- Entrega robusta: Cada carga útil se envía mediante un método POST a través de WebRequest, con una lógica de reintento y un registro detallado. Obtendrá información clara sobre los rangos de fragmentos, los códigos de estado HTTP y cualquier error, lo que garantiza que no haya lagunas de datos en su conjunto de entrenamiento.
Backend de aprendizaje automático con Python
- Matriz de características unificada: El historial entrante y los registros generados por EA se fusionan y vectorizan en una sola tabla, calculando la magnitud de los picos, la divergencia MACD, el RSI, el ATR, las pendientes de tendencia derivadas de Kalman, las bandas de envolvente y los deltas futuros basados en Prophet, todo en un solo lugar.
- Compilación y almacenamiento en caché asíncronos de modelos: los modelos Prophet se ajustan una vez por símbolo (se almacenan en caché durante una hora) y los clasificadores de potenciación de gradiente se entrenan bajo demanda, por lo que el análisis en tiempo real nunca se detiene. Un modelo de respaldo global garantiza la cobertura si los datos de los símbolos individuales son escasos.
- API y CLI completas: los puntos finales de Flask (/upload_history, /upload_spike_csv, /analyze) gestionan las cargas históricas masivas, los bucles de recopilación en directo y las solicitudes de señales en tiempo real, mientras que una CLI unificada se encarga de la importación del historial, el entrenamiento, las pruebas retrospectivas y los diagnósticos.
Antes de que cualquier modelo pueda aprender a anticipar los picos de Boom and Crash, necesita un historial fiable y de gran volumen. El módulo de ingesta de historial es nuestro motor principal de procesamiento de datos:
- Coherencia independiente del gráfico: independientemente del instrumento o del marco temporal (M1, H1, etc.) que se analice, al introducir los mismos parámetros de selección de símbolo y marco temporal siempre se obtendrá el mismo conjunto de datos, lo cual es un requisito esencial para una investigación reproducible.
- Cumplimiento del límite de tamaño: Cada carga útil JSON se mantiene por debajo de 14 MiB, sin poner en riesgo el límite de 16 MiB de MetaTrader 5 ni los datos enviados a medias.
- Funcionamiento de baja latencia: Incluso 20.000 barras se cargan en bastante menos de un segundo, lo que hace posible tanto la carga masiva de históricos como el sondeo en tiempo real sin ralentizar MetaTrader 5.
- Registro y auditoría centralizados: Las impresiones muestran los índices de los fragmentos, los tamaños de la carga útil, los detalles de la respuesta HTTP y el número de reintentos, para que pueda rastrear con precisión qué datos llegaron a su motor Python y cuándo.
Con esta base establecida, nuestro pipeline garantiza el flujo de datos histórico rico y consistente necesario para entrenar modelos que detecten —y actúen ante— los picos de precios antes de que lo tomen por sorpresa.
Próximas secciones:
- Analizaremos en detalle nuestro conjunto de herramientas de ingeniería de características y mostraremos cómo convertimos las barras sin procesar en datos predictivos.
- Profundiza en el entrenamiento de modelos, las estrategias de almacenamiento en caché y la optimización del rendimiento.
- Muestra cómo implementar esos modelos en MetaTrader 5 para obtener alertas de señales en el gráfico y ejecutar operaciones.
Al finalizar esta serie, dispondrás de un conjunto de herramientas infalible y totalmente automatizado —desde la recopilación de datos históricos hasta señales de negociación en tiempo real basadas en el aprendizaje automático—, diseñado para ofrecerte una ventaja competitiva en mercados volátiles, caracterizados por mercados Boom and Crash.
Implementación
Ingesta de datos MQL5
Esta sección explica cómo implementar la ingesta de datos en MQL5; siga las instrucciones paso a paso que se indican a continuación para integrarla en su proyecto.
Metadatos y entradas del script
La sección superior del script declara metadatos como derechos de autor, versión y autor, seguidos de parámetros de entrada configurables por el usuario. Estos incluyen:
- DaysBack: cuántos días de datos históricos se deben recuperar.
- Timeframe: el marco temporal del gráfico (por ejemplo, M1).
- StartChunkBars: tamaño inicial de las porciones de datos que se intentarán enviar.
- Timeout_ms: cuánto tiempo esperar para obtener una respuesta del servidor Python.
- MaxRetry: cuántas veces se debe reintentar una solicitud POST fallida.
- PauseBetween_ms: duración de la pausa entre solicitudes POST.
- PythonURL: el punto final del servidor Python local.
Estas opciones de entrada hacen que el script sea adaptable a diversas necesidades y entornos de red.
#property strict
#property script_show_inputs
#property version   "1.0"

input int              DaysBack        = 120;             // how many days of history to fetch
input ENUM_TIMEFRAMES  Timeframe       = PERIOD_M1;       // timeframe for bars
input int              StartChunkBars  = 5000;            // initial slice size (bars)
input int              Timeout_ms      = 120000;          // WebRequest timeout in ms
input int              MaxRetry        = 3;               // retry attempts per chunk
input int              PauseBetween_ms = 200;             // gap between chunk posts
input string           PythonURL       = "http://127.0.0.1:5000/upload_history";
Constantes y funciones auxiliares en línea
Se establecen algunas constantes #define para controlar el tamaño máximo de JSON (MAX_BYTES) y el tamaño mínimo del fragmento (MIN_CHUNK). A continuación, se definen funciones auxiliares como L2S (long a string) y D2S (double a string) para dar formato a los valores numéricos. La función add() agrega un valor a una cadena JSON en crecimiento y, opcionalmente, añade una coma, lo que agiliza el proceso de construcción del JSON más adelante en el script.
#define MAX_BYTES  14000000   // keep under MT5’s 16 MiB limit
#define MIN_CHUNK  1000       // don’t slice smaller than this many bars

inline string L2S(long v)        { return StringFormat("%I64d", v); }
inline string D2S(double v)      { return StringFormat("%.5f", v); }
void add(string& s, const string v, bool comma) { s += v; if(comma) s += ","; }
Función de construcción de JSON
La función BuildJSON() construye una cadena JSON a partir de una porción de las matrices de datos históricos (tiempo, cierre, máximo y mínimo). Crea una estructura JSON limpia que representa un bloque de barras históricas desde 'from' hasta 'to', adecuada para enviarla al backend de Python. Este enfoque garantiza la coherencia y la compacidad de los datos, al tiempo que permite serializar cada fragmento individualmente.
string BuildJSON(
    const string& sym,
    const long& T[], const double& C[],
    const double& H[], const double& L[],
    int from, int to
) {
    // start JSON with symbol & time array
    string j = "{\"symbol\":\"" + sym + "\",\"time\":[";
    for(int i = from; i < to; i++)
        add(j, L2S(T[i]), i < to - 1);
    j += "],\"close\":[";
    // append close prices
    for(int i = from; i < to; i++)
        add(j, D2S(C[i]), i < to - 1);
    // likewise for high
    j += "],\"high\":[";
    for(int i = from; i < to; i++)
        add(j, D2S(H[i]), i < to - 1);
    // and low
    j += "],\"low\":[";
    for(int i = from; i < to; i++)
        add(j, D2S(L[i]), i < to - 1);
    j += "]}";
    return j;
}
Envío POST con lógica de reintento
La función PostChunk() se encarga de enviar el fragmento JSON al servidor Python mediante WebRequest. Construye los encabezados HTTP, convierte el JSON en una matriz de bytes y gestiona los reintentos hasta alcanzar el número máximo de reintentos permitido en caso de fallos de conexión o errores HTTP. Cada intento registra información sobre el estado, lo que facilita la depuración de las transmisiones fallidas. Si todos los reintentos fallan, se omite el fragmento y el proceso se interrumpe.
bool PostChunk(const string& json, int from, int to) {
    // convert the JSON string into a UTF‑8 char array
    char body[];
    StringToCharArray(json, body, 0, StringLen(json), CP_UTF8);
    char reply[];
    string hdr = "Content-Type: application/json\r\n", rep_hdr;

    for(int r = 1; r <= MaxRetry; r++) {
        int http = WebRequest("POST", PythonURL, hdr, Timeout_ms,
                              body, reply, rep_hdr);
        if(http != -1 && http < 400) {
            PrintFormat("Chunk %d-%d  HTTP %d  %s", from, to, http,
                        CharArrayToString(reply, 0, WHOLE_ARRAY, CP_UTF8));
            return true;
        }
        // on failure, log and retry
        PrintFormat("Chunk %d-%d  retry %d failed (http=%d err=%d)",
                    from, to, r, http, GetLastError());
        Sleep(500);
    }
    return false;
}
Lógica principal en OnStart()
La rutina principal comienza registrando que el script de carga está listo y, a continuación, calcula el intervalo de tiempo solicitado (t1 … t2) a partir de la hora actual del servidor y del parámetro DaysBack. Mediante la función CopyRates(), se recuperan los datos OHLC de esa ventana y se divide el resultado en matrices independientes —marcas de tiempo, cierre, máximo y mínimo— para que la información pueda serializarse de forma eficiente.
Los datos de barras se transmiten en fragmentos. El bucle comienza con el tamaño StartChunkBars definido por el usuario, convierte ese fragmento en una carga útil JSON mediante BuildJSON(), y verifica que la carga útil sea menor que MAX_BYTES. Si la carga útil supera el límite, el tamaño del fragmento se reduce a la mitad hasta que la carga útil quepa o se alcance el umbral de reserva MIN_CHUNK. Se envía un fragmento válido al back-end de Python mediante PostChunk(), el script se detiene durante PauseBetween_ms y, a continuación, continúa con el siguiente fragmento.
int OnStart() {
    Print("History Ingestor v1.0 ready (timeout=", Timeout_ms, " ms)");
    datetime t2 = TimeCurrent();
    datetime t1 = t2 - (datetime)DaysBack * 24 * 60 * 60;

    // 1) Pull bar history from MT5
    MqlRates r[];
    int total = CopyRates(_Symbol, Timeframe, t1, t2, r);
    if(total <= 0) {
        Print("CopyRates error ", GetLastError());
        return INIT_FAILED;
    }
    ArraySetAsSeries(r, false);

    // 2) Unpack into simple arrays
    long   T[];  double Cl[], Hi[], Lo[];
    ArrayResize(T, total);
    ArrayResize(Cl, total);
    ArrayResize(Hi, total);
    ArrayResize(Lo, total);
    for(int i = 0; i < total; i++) {
        T[i]  = r[i].time;
        Cl[i] = r[i].close;
        Hi[i] = r[i].high;
        Lo[i] = r[i].low;
    }

    // 3) Loop over the data in chunks
    for(int i = 0; i < total;) {
        int  step = StartChunkBars;
        bool sent = false;

        // adaptively shrink chunk until it fits
        while(step >= MIN_CHUNK) {
            int to      = MathMin(total, i + step);
            string js   = BuildJSON(_Symbol, T, Cl, Hi, Lo, i, to);
            double size = double(StringLen(js)) / 1e6;
            PrintFormat("Testing %d–%d  size=%.2f MB", i, to, size);

            if(StringLen(js) < MAX_BYTES) {
                // post & advance index
                if(!PostChunk(js, i, to))
                    return INIT_FAILED;
                i    = to;
                sent = true;
                Sleep(PauseBetween_ms);
                break;
            }
            step /= 2;
        }

        // abort if even the minimum chunk is too big
        if(!sent) {
            Print("Unable to fit minimum chunk – aborting");
            return INIT_FAILED;
        }
    }

    Print("Upload finished: ", total, " bars.");
    return INIT_SUCCEEDED;
}
Para configurar el «History Ingestor» en MetaEditor, abre MetaTrader 5 y pulsa F4 para iniciar MetaEditor; a continuación, selecciona:
Archivo → Nuevo → Script MQL5
Asigna un nombre (por ejemplo, «HistoryIngestor») y finaliza el asistente; sustituye la plantilla generada por tu código completo (incluidas las declaraciones #property y la función OnStart), guárdalo en la carpeta «Scripts» y pulsa F7 para compilarlo; confirma que aparezca «0 errores, 0 advertencias». Vuelve al «Navegador» de MetaTrader 5, en la sección «Scripts», arrastra «HistoryIngestor» a un gráfico y, en el cuadro de diálogo de entrada, ajusta parámetros como:
DaysBack, Timeframe, tamaños de fragmentos, tiempos de espera y PythonURL
Asegúrate de habilitar tu dominio PythonURL en:
Herramientas → Opciones → Asesores expertos
Esto es para las llamadas WebRequest y garantiza que se cargue suficiente historial del gráfico para que CopyRates pueda recuperar las barras solicitadas. Una vez que haga clic en Aceptar, supervise las pestañas Expertos y Diario para comprobar el progreso de la carga y cualquier mensaje de reintento o error.
Back-end de aprendizaje automático en Python
Este sistema se basa en una serie de bibliotecas de Python (incluidos modelos para la detección de picos), pero este artículo se centra principalmente en la ingesta de datos; otros componentes se tratarán en futuras entregas. A continuación se muestra una lista completa de bibliotecas de terceros, junto con sus propósitos, seguida de los módulos de la biblioteca estándar utilizados:
Bibliotecas de terceros
- numpy y pandas: manejo de arrays y DataFrames
- pyarrow (o fastparquet): serialización de datos en columnas
- flask: API web ligera
- MetaTrader 5: recuperación de datos de mercado
- ta: indicadores de análisis técnico
- scikit-learn, joblib: entrenamiento y persistencia de modelos
- prophet, cmdstanpy: pronóstico de series temporales
- pykalman: filtrado de Kalman
- pytz: soporte para zonas horarias
Puedes instalarlos con:
pip install numpy pandas pyarrow flask MetaTrader5 ta scikit-learn \
            joblib prophet cmdstanpy pykalman pytz
La instalación de Prophet incluirá automáticamente dependencias como tqdm, holidays y lunarcalendar.
Biblioteca estándar (no requiere instalación)
os, sys, logging, warnings, argparse, threading, io, datetime, pathlib, typing, time
| Paquete | Propósito en el script | Dónde se utiliza |
|---|---|---|
| Numpy | Matemáticas vectoriales con matrices de gran tamaño; fundamentos de Pandas, TA-lib y scikit-learn. | Todas las funciones auxiliares de características (np.diff, np.std, predict_proba, …). |
| pandas | DataFrame de series temporales, E/S rápida de CSV/Parquet, ventanas deslizantes. | Construir DF en /upload_history, eliminar duplicados, ingeniería de características, entrenamiento del modelo, pruebas retrospectivas. |
| pyarrow (o fastparquet) | Motor para df.to_parquet() / read_parquet(); mucho más pequeño y rápido que CSV, mantiene marcas de tiempo de nanosegundos. | Almacenamiento en cDisk del historial cargado por símbolo. |
| flask | Servidor HTTP ligero que expone /upload_history, /upload_spike_csv, /analyze. Convierte JSON a Python. | Todos los puntos finales REST. |
| MetaTrader 5 | Puente Python a una terminal MetaTrader 5 sin interfaz gráfica: inicio de sesión, rango de tasas de copia, suscripción de símbolos. | Importación de historial, recopilación en vivo, backtester. |
| ta | Indicadores de análisis técnico (MACD, RSI, ATR) desarrollados íntegramente en Python. | Características macd_div, rsi_val, offline_atr. |
| scikit-learn | Núcleo de aprendizaje automático (StandardScaler + GradientBoostingClassifier + Pipeline). | Entrenamiento de modelos, inferencia de probabilidad dentro de /analyze y backtest. |
| joblib | Serialización y deserialización rápida de modelos scikit; implementa la caché de modelos por símbolo. | joblib.dump/load en todos los lugares donde se lean o escriban los archivos models/*.pkl. |
| cmdstanpy | El backend Stan es el que utiliza Prophet para compilarse; Prophet no funcionará sin él. | Importado indirectamente por Prophet durante fit(). |
| pykalman | Suavizado mediante filtro de Kalman lineal; devuelve la pendiente de los últimos 5 bares. | Característica kalman_slope(). |
| pytz | Localización UTC explícita de los objetos de fecha y hora para evitar confusiones entre la hora del intermediario y la del sistema. | Conversiones en rangos históricos/de pruebas retrospectivas. |
| prophet | Pronóstico de tendencias de baja frecuencia; proporciona la función "delta" (estimación del precio futuro). | Función auxiliar prophet_delta() y caché de compilación asíncrona. |
A continuación, analizaremos la parte del código que se encarga de la recopilación y el almacenamiento de datos, justo antes del entrenamiento del modelo.
Recepción del historial de MetaTrader 5 a través de WebRequest
En cuanto a Python, se ha configurado una API ligera de Flask (que suele ejecutarse en http://127.0.0.1:5000/upload_history) para gestionar las solicitudes HTTP POST entrantes. Cuando el script de MQL5 envía una carga JSON que contiene datos históricos (nombre del símbolo, marcas de tiempo, matrices OHLC), este punto final de Flask analiza y valida los datos. De este modo, se evita el manejo manual de archivos CSV y se garantiza que el back-end de Python pueda recibir datos en tiempo real y de forma automática desde cualquier gráfico de MetaTrader 5 o script de EA mediante el script de carga.
@app.route('/upload_history', methods=['POST'])
def upload_history():
    data = request.get_json()
    df = pd.DataFrame({
        'time': pd.to_datetime(data['time'], unit='s'),
        'close': data['close'],
        'high': data['high'],
        'low': data['low']
    })
    symbol = data['symbol']
    os.makedirs('uploaded_history', exist_ok=True)
    df.to_parquet(f'uploaded_history/{symbol}.parquet', index=False)
    return jsonify({"status": "ok", "rows": len(df)})
Almacenamiento y preprocesamiento de los datos
Una vez recibida, la carga útil JSON se analiza y se convierte en un DataFrame de Pandas y, opcionalmente, se almacena en un archivo local (por ejemplo, .parquet, .csv o .feather) o se escribe en una base de datos de series temporales. Esto proporciona durabilidad y permite que el sistema reproduzca las condiciones pasadas del mercado según sea necesario. Los datos de barras recibidos se limpian, se eliminan los duplicados y se indexan con marcas de tiempo para garantizar un comportamiento coherente en cargas o sesiones repetidas. El preprocesamiento también puede incluir la normalización de la zona horaria o el filtrado de barras cero.
def load_preprocess(symbol):
    df = pd.read_parquet(f'uploaded_history/{symbol}.parquet')
    df.drop_duplicates(subset='time', inplace=True)
    df.set_index('time', inplace=True)
    return df
Pipeline de ingeniería de características
El historial bruto de OHLC se transforma en una matriz de características enriquecida que incluye tanto indicadores técnicos clásicos como métricas relevantes para el aprendizaje automático. Estas características pueden incluir la intensidad de los picos (fórmulas personalizadas), valores MACD, RSI, ATR, pendientes filtradas por Kalman y deltas de tendencia generados por Prophet. Estas características permiten que el modelo comprenda tanto la volatilidad a corto plazo como el contexto de la tendencia a largo plazo, algo fundamental para pronosticar correctamente los picos de precios o las rupturas significativas.
def generate_features(df):
    df['return'] = df['close'].pct_change()
    df['volatility'] = df['return'].rolling(10).std()
    df['range'] = df['high'] - df['low']
    df['spike'] = (df['range'] > df['range'].rolling(50).mean() * 2).astype(int)
    return df.dropna()
Gestión y almacenamiento en caché de modelos por símbolo
Para cada símbolo introducido, el sistema Python mantiene un modelo de aprendizaje automático (ML) específico para cada símbolo. Estos modelos se entrenan desde cero utilizando los datos históricos cargados o se actualizan de forma incremental. Se serializan (mediante joblib, Pickle u ONNX) y se almacenan en una caché dedicada. Este diseño facilita la carga del modelo más reciente para cada símbolo cuando es necesario procesar señales, lo que permite tanto la reproducibilidad como la velocidad.
def train_model(symbol, df):
    X = df[['return', 'volatility', 'range']]
    y = df['spike']
    model = RandomForestClassifier(n_estimators=100)
    model.fit(X, y)
    os.makedirs('models', exist_ok=True)
    joblib.dump(model, f'models/{symbol}_model.pkl')
    return model
Acceso mediante línea de comandos y API para entrenamiento e inferencia.
La herramienta de Python proporciona tanto utilidades de línea de comandos (por ejemplo, python train.py --symbol BOOM500) como puntos finales de Flask en tiempo real (por ejemplo, /predict) para activar el entrenamiento del modelo, ejecutar pruebas retrospectivas u obtener predicciones en tiempo real. Esta interfaz dual admite tanto operaciones por lotes como la integración en tiempo real con EA o paneles de control. Por ejemplo, una vez que se entrena un modelo, un EA MQL5 puede consultar posteriormente el punto final /predict y recibir señales de "COMPRA", "VENTA" o "NO ACCIÓN".
@app.route('/predict', methods=['POST'])
def predict():
    data = request.get_json()
    features = pd.DataFrame([data['features']])
    model = joblib.load(f"models/{data['symbol']}_model.pkl")
    prediction = model.predict(features)[0]
    return jsonify({'signal': 'BUY' if prediction == 1 else 'NO ACTION'})
Carga histórica, reentrenamiento y aprendizaje continuo
El sistema de ingesta también puede funcionar en modo continuo, escuchando los nuevos fragmentos históricos o barras en tiempo real a medida que llegan y activando el reentrenamiento periódico o la generación de señales. Esto permite el desarrollo de modelos adaptativos que se mantienen actualizados a medida que evoluciona el comportamiento del mercado, algo especialmente valioso en instrumentos sintéticos como Boom/Crash, cuya volatilidad o frecuencia de picos puede variar con el tiempo.
def backfill_and_train(symbol):
    df = load_preprocess(symbol)
    df = generate_features(df)
    train_model(symbol, df)
Herramientas de registro, monitorización y depuración
Para garantizar la transparencia, el código Python registra cada carga recibida, cada paso de generación de características, cada evento de entrenamiento del modelo y cada señal recibida. Estos registros se guardan opcionalmente en archivos o paneles de control externos. Esto permite auditar el proceso, ayuda a rastrear el comportamiento del modelo y garantiza que tanto los desarrolladores como los operadores puedan comprender por qué se hicieron ciertas predicciones.
def log_upload(symbol, rows):
    logging.info(f"{symbol} upload received with {rows} rows.")
Carga del historial
En esta sección, mostraré cómo funcionó nuestro sistema automatizado. Una vez configurados los entornos tanto en MetaTrader 5 como en Python, empezamos accediendo al directorio donde se encuentra nuestro script de Python mediante la línea de comandos: RUTA A TU CARPETAC:\Users\hp>cd C:\Users\hp\Pictures\Saved Pictures\Analysis EALuego, inicie el servidor con: python script_name.py serveDeberías ver que el servidor se inicia correctamente; en mi caso, la consola mostró algo como esto:
 * Running on all addresses (0.0.0.0)
 * Running on http://127.0.0.1:5000
Una vez que el servidor esté en funcionamiento, simplemente arrastre el script al gráfico de MetaTrader 5; la ingesta e integración de datos comenzará de inmediato.
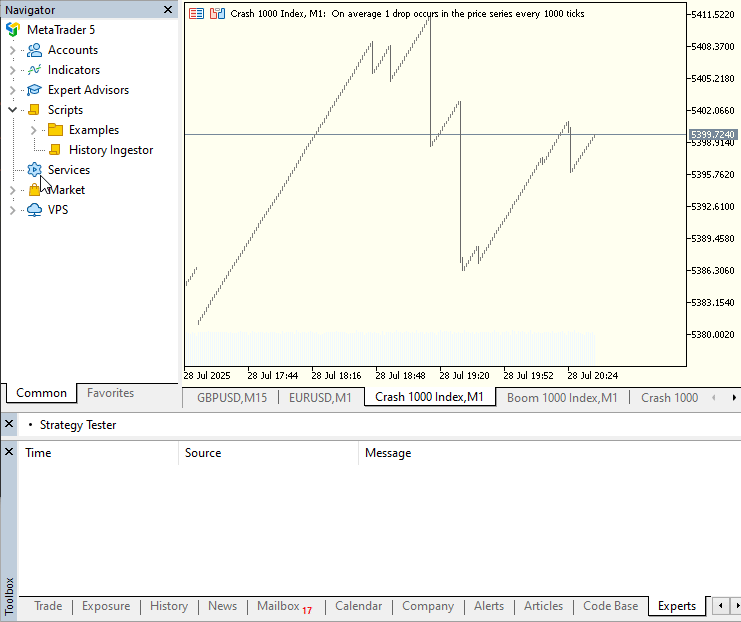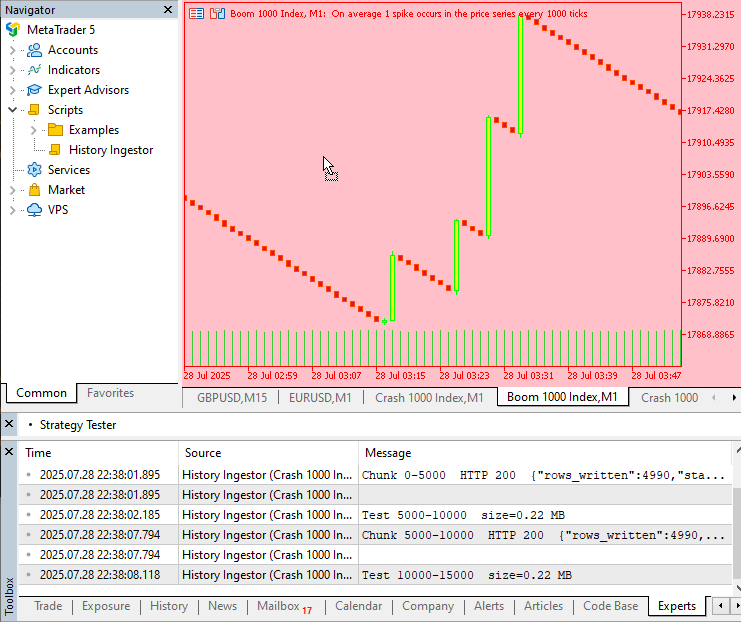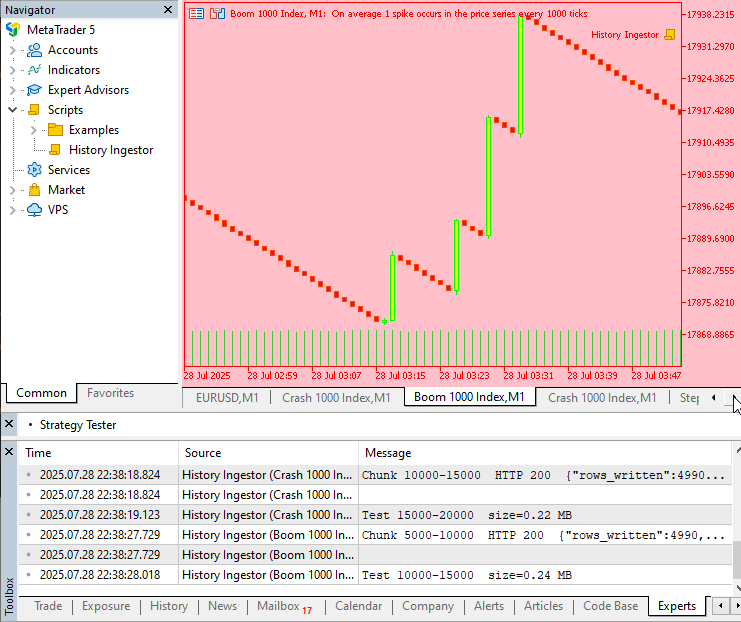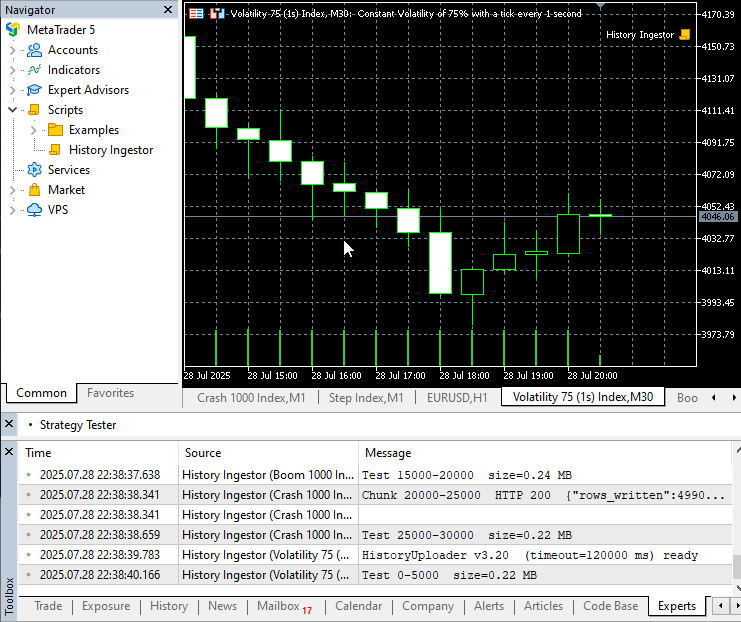
Registros de la pestaña Expertos de MetaTrader 5:
2025.07.28 22:37:58.239 History Ingestor (Crash 1000 Index,M1)  HistoryUploader v3.20  (timeout=120000 ms) ready
2025.07.28 22:37:58.365 History Ingestor (Crash 1000 Index,M1)  Test 0-5000  size=0.22 MB
2025.07.28 22:38:01.895 History Ingestor (Crash 1000 Index,M1)  Chunk 0-5000  HTTP 200  {"rows_written":4990,"status":"ok"}
2025.07.28 22:38:01.895 History Ingestor (Crash 1000 Index,M1)
2025.07.28 22:38:02.185 History Ingestor (Crash 1000 Index,M1)  Test 5000-10000  size=0.22 MB
2025.07.28 22:38:07.794 History Ingestor (Crash 1000 Index,M1)  Chunk 5000-10000  HTTP 200  {"rows_written":4990,"status":"ok"}
2025.07.28 22:38:07.794 History Ingestor (Crash 1000 Index,M1)
2025.07.28 22:38:08.118 History Ingestor (Crash 1000 Index,M1)  Test 10000-15000  size=0.22 MB
2025.07.28 22:38:13.531 History Ingestor (Boom 1000 Index,M1)   HistoryUploader v3.20  (timeout=120000 ms) ready
2025.07.28 22:38:13.677 History Ingestor (Boom 1000 Index,M1)   Test 0-5000  size=0.24 MB
2025.07.28 22:38:17.710 History Ingestor (Boom 1000 Index,M1)   Chunk 0-5000  HTTP 200  {"rows_written":4990,"status":"ok"}
Registros de Python en la línea de comandos:
Crash 1000 Index            4990 rows
22:38:01  INFO    127.0.0.1 - - [28/Jul/2025 22:38:01] "POST /upload_history HTTP/1.1" 200 -
22:38:01  DEBUG   cmd: where.exe tbb.dll
cwd: None
22:38:02  DEBUG   Adding TBB (C:\Users\hp\AppData\Local\Programs\Python\Python313\Lib\site-packages\
prophet\stan_model\cmdstan-2.33.1\stan\lib\stan_math\lib\tbb) to PATH
22:38:02  DEBUG   input tempfile: C:\Users\hp\AppData\Local\Temp\tmpjw4u6es7\0j91e5cb.json
22:38:02  DEBUG   input tempfile: C:\Users\hp\AppData\Local\Temp\tmpjw4u6es7\lzpoq1nb.json
22:38:02  DEBUG   idx 0
22:38:02  DEBUG   running CmdStan, num_threads: None
22:38:02  DEBUG   CmdStan args: ['C:\\Users\\hp\\AppData\\Local\\Programs\\Python\\Python313
\\Lib\\site-packages\\prophet\\stan_model\\prophet_model.bin', 'random', 'seed=46049', 'data',
'file=C:\\Users\\hp\\AppData\\Local\\Temp\\tmpjw4u6es7\\0j91e5cb.json', 'init=C:\\Users\\hp\\
AppData\\Local\\Temp\\tmpjw4u6es7\\lzpoq1nb.json', 'output', 'file=C:\\Users\\hp\\AppData\\
Local\\Temp\\tmpjw4u6es7\\prophet_modelo4ioyzqc\\prophet_model-20250728223802.csv',
'method=optimize', 'algorithm=lbfgs', 'iter=10000']
22:38:02 - cmdstanpy - INFO - Chain [1] start processing
22:38:02  INFO    Chain [1] start processing
22:38:07  DEBUG   cmd: where.exe tbb.dll
cwd: None
Crash 1000 Index            4990 rows
22:38:07  INFO    127.0.0.1 - - [28/Jul/2025 22:38:07] "POST /upload_history HTTP/1.1" 200 -
22:38:07  DEBUG   TBB already found in load path
22:38:07  DEBUG   input tempfile: C:\Users\hp\AppData\Local\Temp\tmpjw4u6es7\flzd3tj5.json
22:38:08  DEBUG   input tempfile: C:\Users\hp\AppData\Local\Temp\tmpjw4u6es7\et_obcyf.json
22:38:08  DEBUG   idx 0
22:38:08  DEBUG   running CmdStan, num_threads: None
22:38:08  DEBUG   CmdStan args: ['C:\\Users\\hp\\AppData\\Local\\Programs\\Python\\Python313
\\Lib\\site-packages\\prophet\\stan_model\\prophet_model.bin', 'random', 'seed=15747', 'data'
, 'file=C:\\Users\\hp\\AppData\\Local\\Temp\\tmpjw4u6es7\\flzd3tj5.json', 'init=C:\\Users\\hp
\\AppData\\Local\\Temp\\tmpjw4u6es7\\et_obcyf.json', 'output', 'file=C:\\Users\\hp\\AppData\\
Local\\Temp\\tmpjw4u6es7\\prophet_modelgjfhjsn1\\prophet_model-20250728223808.csv',
'method=optimize', 'algorithm=lbfgs', 'iter=10000']
22:38:08 - cmdstanpy - INFO - Chain [1] start processing
22:38:08  INFO    Chain [1] start processing
22:38:10 - cmdstanpy - INFO - Chain [1] done processing
22:38:10  INFO    Chain [1] done processing
22:38:10  INFO    Prophet compiled for Crash 1000 Index
22:38:15 - cmdstanpy - INFO - Chain [1] done processing
22:38:15  INFO    Chain [1] done processing
22:38:15  INFO    Prophet compiled for Crash 1000 Index
22:38:17  DEBUG   cmd: where.exe tbb.dll
cwd: None
Boom 1000 Index             4990 rows
22:38:17  INFO    127.0.0.1 - - [28/Jul/2025 22:38:17] "POST /upload_history HTTP/1.1" 200 -
22:38:17  DEBUG   TBB already found in load path
22:38:17  DEBUG   input tempfile: C:\Users\hp\AppData\Local\Temp\tmpjw4u6es7\9tu4ni1m.json
22:38:17  DEBUG   input tempfile: C:\Users\hp\AppData\Local\Temp\tmpjw4u6es7\dbjg87e6.json
22:38:17  DEBUG   idx 0
22:38:17  DEBUG   running CmdStan, num_threads: None
22:38:17  DEBUG   CmdStan args: ['C:\\Users\\hp\\AppData\\Local\\Programs\\Python\\Python313
\\Lib\\site-packages\\prophet\\stan_model\\prophet_model.bin', 'random', 'seed=45546', 'data',
 'file=C:\\Users\\hp\\AppData\\Local\\Temp\\tmpjw4u6es7\\9tu4ni1m.json', 'init=C:\\Users\\hp
\\AppData\\Local\\Temp\\tmpjw4u6es7\\dbjg87e6.json', 'output', 'file=C:\\Users\\hp\\AppData
\\Local\\Temp\\tmpjw4u6es7\\prophet_modele7mw_egb\\prophet_model-20250728223817.csv',
'method=optimize', 'algorithm=lbfgs', 'iter=10000']
22:38:17 - cmdstanpy - INFO - Chain [1] start processing
22:38:17  INFO    Chain [1] start processing
Crash 1000 Index            4990 rows
22:38:18  INFO    127.0.0.1 - - [28/Jul/2025 22:38:18] "POST /upload_history HTTP/1.1" 200 -
22:38:23 - cmdstanpy - INFO - Chain [1] done processing
22:38:23  INFO    Chain [1] done processing
22:38:24  INFO    Prophet compiled for Boom 1000 Index
Boom 1000 Index             4990 rows
22:38:27  INFO    127.0.0.1 - - [28/Jul/2025 22:38:27] "POST /upload_history HTTP/1.1" 200 -
Crash 1000 Index            4990 rows
22:38:28  INFO    127.0.0.1 - - [28/Jul/2025 22:38:28] "POST /upload_history HTTP/1.1" 200 -
Boom 1000 Index             4990 rows
22:38:37  INFO    127.0.0.1 - - [28/Jul/2025 22:38:37] "POST /upload_history HTTP/1.1" 200 -
Crash 1000 Index            4990 rows
22:38:38  INFO    127.0.0.1 - - [28/Jul/2025 22:38:38] "POST /upload_history HTTP/1.1" 200 -
22:38:49  DEBUG   cmd: where.exe tbb.dll
Los registros muestran que se importaron 4.990 filas de datos históricos de los índices Crash 1000 y Boom 1000 y se enviaron correctamente al servidor Python (HTTP 200). A continuación, CmdStan, a través de cmdstanpy, ejecutó cadenas de optimización para compilar modelos de Prophet para cada índice, confirmando el inicio y la finalización de cada cadena, así como los mensajes finales «Prophet compiled» para ambos instrumentos.
Conclusión
Hemos recopilado con éxito datos históricos de precios en MetaTrader 5, los hemos transmitido a un servicio de Python y los hemos almacenado para el entrenamiento del modelo; esto queda reflejado tanto en la pestaña «Expertos» de MetaTrader 5 como en los registros de la consola de nuestro ordenador. Este sólido pipeline de ingesta de datos sienta las bases de nuestro sistema de detección de picos. A continuación, entrenaremos el modelo de detección en Python y lo volveremos a integrar en MetaTrader 5 mediante un EA de MQL5, de modo que se puedan generar señales en tiempo real y recibirlas directamente en la plataforma de negociación. Hemos recopilado con éxito datos históricos de precios en MetaTrader 5, los hemos transmitido a un servicio de Python y los hemos almacenado para el entrenamiento del modelo; esto queda reflejado tanto en la pestaña «Expertos» de MetaTrader 5 como en los registros de la consola de nuestro ordenador. Este sólido pipeline de ingesta de datos sienta las bases de nuestro sistema de detección de picos.
A continuación, entrenaremos el modelo de detección en Python y lo volveremos a integrar en MetaTrader 5 mediante un EA de MQL5, de modo que se puedan generar señales en tiempo real y recibirlas directamente en la plataforma de negociación.
Si tienes alguna dificultad durante la configuración, no dudes en ponerte en contacto conmigo en cualquier momento.
Traducción del inglés realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/en/articles/18979
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Utilizando redes neuronales en MetaTrader
 Redes neuronales en el trading: Modelo de difusión adaptativa sobre grafos (SAGDFN)
 Particularidades del trabajo con números del tipo double en MQL4
 Asesor experto de trading neuronal basado en PatchTST

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso