

Redes neuronales en el trading: una visión unificada del espacio y el tiempo (Final)
 14
 0

Introducción
Los mercados financieros pueden compararse con un organismo vivo, en el que cada movimiento del precio recuerda a un pulso, y cada noticia o decisión macroeconómica, a un latido del corazón que desencadena ondas de cambio en todo el sistema. Respiran, oscilan, suben y bajan siguiendo un ritmo complejo que refleja el comportamiento de millones de participantes. En un entorno así, el analista y el trader se enfrentan al reto no solo de captar los impulsos momentáneos, sino también de predecir tendencias a más largo plazo, que a menudo quedan ocultas tras el ruido superficial. Aquí pasa a primer plano el trabajo con datos espaciotemporales. Y es que cualquier situación de mercado evoluciona simultáneamente en dos dimensiones: a lo largo del eje del tiempo y a lo largo del eje del precio, que refleja el espacio de las decisiones de trading.
El framework Extralonger pretende superar las limitaciones de los modelos tradicionales y llevar la predicción a un nuevo nivel. Su principal ventaja es su capacidad para trabajar de forma fiable con horizontes extremadamente largos. A modo de comparación, la inmensa mayoría de los algoritmos existentes se limitan a intervalos de minutos u horas. En esas condiciones, es posible seguir impulsos de corto plazo o tendencias locales, pero resulta imposible construir una visión sistémica que permita mirar más allá del horizonte y percibir cómo se forman los grandes movimientos. Extralonger, por su parte, abre el camino hacia el pronóstico a largo plazo, manteniendo la precisión y la estabilidad incluso allí donde otros métodos pierden la orientación.
Esta cualidad es especialmente importante en el trading. Para un trader que trabaja con marcos temporales intradía, cada minuto puede ser decisivo. Pero aún más valioso es comprender cómo se comportará el mercado mañana o dentro de unos días. Para el inversor, conocer las tendencias futuras en un horizonte de una semana o más se convierte en una herramienta para gestionar riesgos y construir estrategias. Extralonger combina estos dos enfoques, permitiendo observar el mercado simultáneamente de cerca y de lejos. Como un viajero utiliza una lupa para estudiar los detalles de un mapa y un catalejo para evaluar los contornos lejanos del terreno.
La segunda ventaja más importante del framework es su alta eficiencia computacional. El problema de los métodos clásicos radica en que analizan por separado las dimensiones temporal y espacial. Al analizar la dinámica de las series temporales, el algoritmo se ve obligado a repetir los cálculos para cada punto de mercado o instrumento, y al procesar los vínculos espaciales repite las operaciones en el plano temporal. Esta duplicación del procedimiento dispara rápidamente los costos computacionales. El modelo requiere cada vez más memoria y tiempo, lo que limita la extensión del horizonte de predicción. En un contexto de mercados financieros en los que la rapidez de reacción ante las variaciones de precios es fundamental, este tipo de restricciones se convierten en un serio obstáculo.
Extralonger resuelve este problema de una forma fundamentalmente nueva. Se basa en el concepto de Unified Spatial-Temporal Representation, es decir, la representación espacio-temporal unificada. Esta idea se inspira en la teoría de la relatividad de Einstein. Al igual que en física el espacio y el tiempo forman un continuo único, en los datos financieros no se puede considerar un momento concreto al margen del nivel de precios, ni la estructura local del mercado sin tener en cuenta el contexto temporal. De este modo, cada elemento de datos contiene, al mismo tiempo, información temporal y espacial. Esto elimina la necesidad de realizar cálculos repetidos y reduce la complejidad del modelo en un orden de magnitud.
En consecuencia, Extralonger ofrece ventajas colosales:
- reducción del consumo de memoria,
- aceleración del entrenamiento,
- aumento de la velocidad de predicción.
En la práctica, esto significa que el modelo puede entrenarse y funcionar incluso en entornos con recursos informáticos limitados.
A nivel arquitectónico, el framework Extralonger se articula en torno a tres ramas paralelas de procesamiento de la información: la rama temporal, la espacial y la mixta. Cada una de ellas desempeña un papel específico. La rama temporal analiza la secuencia de acontecimientos del mercado y busca patrones en la dinámica de los precios. La rama espacial examina la red de interrelaciones entre instrumentos y activos, revelando correlaciones y estructuras ocultas. La rama mixta combina ambos enfoques, creando una visión global.
En Extralonger, ocupa un lugar especial el módulo Global-Local Spatial Transformer, que puede compararse con una doble lente analítica. Por un lado, la atención global permite tener en cuenta las relaciones entre elementos del mercado muy alejados entre sí. Por otro lado, la atención local se centra en las relaciones más cercanas, como las correlaciones a corto plazo entre divisas próximas dentro de una misma sesión de trading. Esta combinación permite que el modelo funcione con igual éxito tanto con las grandes tendencias como con los impulsos locales.
Otra cualidad única de Extralonger es su campo receptivo total. Esto significa que el modelo es capaz de tener en cuenta simultáneamente todo el historial disponible y relacionarlo con cualquier acontecimiento actual. A diferencia de los algoritmos limitados por una ventana deslizante o un intervalo de tiempo fijo, Extralonger ve el mercado en su conjunto. Puede comparar la evolución del precio de hoy con los acontecimientos de hace una semana o detectar una relación a largo plazo que solo se manifiesta en intervalos de tiempo más amplios. Esto resulta especialmente valioso para los mercados financieros, ya que muchos movimientos no se deben a acontecimientos aislados, sino a la acumulación de factores que, poco a poco, se van sumando y se plasman en tendencias a gran escala.
A continuación se muestra una visualización del framework Extralonger creada por el autor.
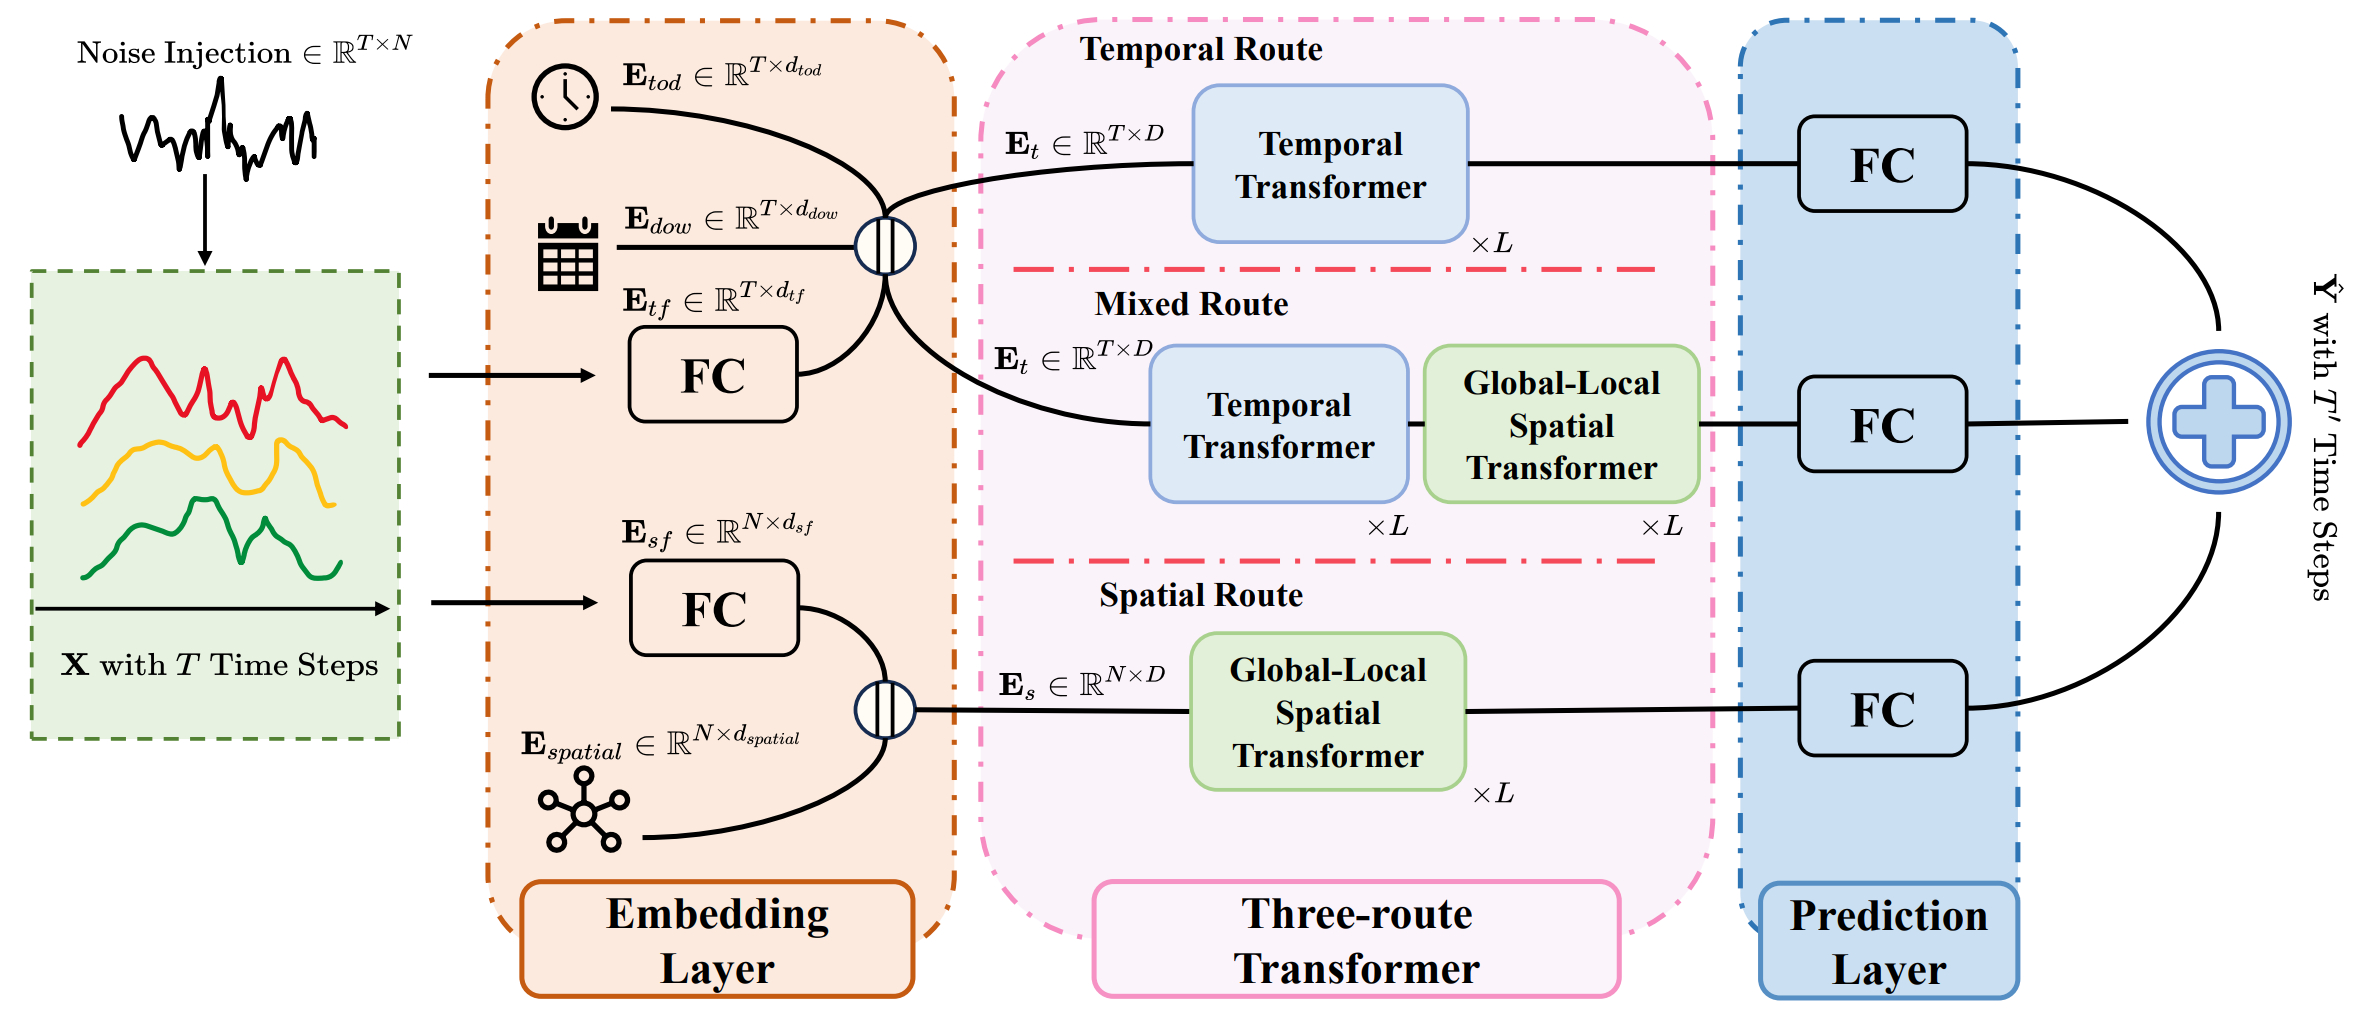
Nuestro proyecto se desarrolla como un proceso progresivo que va de lo sencillo a lo complejo, de los elementos individuales a una arquitectura integral. Al principio nos centramos en la base conceptual de Extralonger y dimos los primeros pasos prácticos para implementarla mediante MQL5. En esta fase implementamos módulos de codificación espacial y temporal que permitieron vincular los datos a la estructura del mercado y sentar las bases para una mayor integración.
A continuación, pasamos al diseño arquitectónico del framework. Si antes trabajábamos más bien con ladrillos, ahora hemos empezado a levantar paredes y forjados. Hemos analizado en detalle la implementación del módulo Global-Local Spatial Transformer. En esta fase, tuvimos la posibilidad de integrar los distintos elementos en un proceso de computación coherente. En otras palabras, empezamos a crear esa arquitectura de observación que, en el futuro, nos permitirá abarcar el mercado en toda su multidimensionalidad.
Estos dos pasos se pueden comparar con la preparación del escenario para una gran obra de teatro. Primero colocamos el decorado y decidimos dónde se situarían los elementos clave; a continuación, llevamos al escenario a los primeros actores: los módulos de procesamiento de datos. Y ahora se nos presenta la oportunidad de mostrar al espectador toda la concepción de la puesta en escena. Pasamos ahora al algoritmo en sí, al corazón de Extralonger. Es precisamente aquí, en la intersección de la atención global-local, la representación unificada y las tres ramas paralelas, donde se revela la singularidad de este enfoque.
Objeto de alto nivel
En la cúspide de toda la jerarquía de nuestra implementación de los enfoques del framework Extralonger se encuentra el objeto CNeuronExtralonger, que puede considerarse el corazón de la arquitectura, ya que integra los módulos clave en un único ciclo de cálculo. Si las clases y los bloques analizados anteriormente se encargaban de elementos concretos de la estructura, aquí nos encontramos ante un nodo central que lo une todo.
class CNeuronExtralonger   :  public CNeuronMHAttentionPooling
  {
protected:
   CLayer               cProjectionT;
   CLayer               cTimeModule;
   CLayer               cSpatialModule;
   CLayer               cMixModule;
   CNeuronBaseOCL       cConcatResults;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override {return false;}
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override {return false;}
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                        CBufferFloat *SecondInput,
                                        CBufferFloat *SecondGradient,
                                        ENUM_ACTIVATION SecondActivation = None
                                       ) override;

public:
                     CNeuronExtralonger(void) {};
                    ~CNeuronExtralonger(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint time_steps_in, uint time_steps_out, uint variables,
                          uint dimension, uint emb_dimension, uint period1,
                          uint frame1, uint period2, uint frame2, uint layers,
                          uint heads, uint dimension_k, uint m_units, float sparse,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronExtralonger;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
  };
En cuanto a su estructura, CNeuronExtralonger hereda de la clase CNeuronMHAttentionPooling, lo que indica de inmediato su orientación funcional. La base del procesamiento de datos sigue siendo el mecanismo de atención multicabeza con un mecanismo de agregación, sobre el que se superponen capas adicionales que implementan las ideas propias de Extralonger.
Y aquí llegamos a una diferencia importante entre nuestra implementación y la solución original. En la versión original de Extralonger, los coeficientes de ponderación para las tres ramas del flujo de datos (temporal, espacial y mixta) se establecen de forma rígida y permanecen fijos. Este enfoque resulta práctico por su sencillez, pero en un contexto de mercados financieros volátiles conduce inevitablemente a una pérdida de flexibilidad. En algunas situaciones, los patrones temporales a corto plazo desempeñan un papel clave; en otras, las correlaciones espaciales globales; y, en ocasiones, su combinación resulta decisiva. Los coeficientes fijos no son capaces de tener en cuenta de forma dinámica este cambio de ponderación, lo que reduce la precisión de las predicciones.
Precisamente por eso, en nuestra implementación fuimos más allá e incorporamos el mecanismo adaptativo Attention Pooling, tomado del framework R-MAT. Su esencia radica en que los coeficientes de ponderación de las ramas no se determinan de antemano, sino que se calculan durante el funcionamiento del modelo. Cada nueva señal de datos de entrada recibe su propia distribución de atención entre los módulos temporal, espacial y mixto. Gracias a ello, el sistema se vuelve sensible al contexto del mercado. En una fase de consolidación tranquila, se refuerza el papel del análisis temporal; ante perturbaciones externas, cobran mayor importancia las relaciones espaciales; y, en momentos de alta volatilidad, pasa a primer plano la rama mixta.
Esta solución convierte a CNeuronExtralonger en una herramienta mucho más viva. A diferencia del esquema estático del original, en el que la distribución de la atención es siempre la misma, el Attention Pooling adaptativo hace que el sistema sea flexible y autoajustable. Se comporta como un trader con experiencia, capaz de cambiar sus ponderaciones en función de la situación.
Dentro del objeto se concentran cuatro componentes clave, que son arrays dinámicos. En ellos se agrupan las secuencias de capas neuronales de los flujos de información internos. A primera vista, puede parecer extraño crear cuatro módulos internos. Y es que en la arquitectura de Extralonger solo se mencionan tres líneas troncales: la temporal, la espacial y la mixta. En este punto, es importante señalar una particularidad. Las líneas troncales de análisis temporal y mixto utilizan el mismo bloque de preparación de datos. Para evitar la duplicación y facilitar la gestión, decidimos separar el bloque de preparación de datos en un componente independiente: cProjectionT. En esencia, se trata de una puerta de enlace común que garantiza una conversión coherente de las secuencias originales en embeddings aptos para el procesamiento posterior.
Al mismo tiempo, integramos la línea troncal de análisis espacial con el módulo correspondiente de preparación de datos en un único bloque: cSpatialModule. Este paso viene dictado por las particularidades de las dependencias espaciales. En este caso, el preprocesamiento de los datos y el modelo en sí están tan estrechamente relacionados que conviene considerarlos como una única estructura interna.
De este modo, obtenemos cuatro componentes:
- cProjectionT: bloque de preparación de datos para las líneas troncales temporal y mixta,
- cTimeModule: modelo de análisis temporal,
- cSpatialModule: modelo unificado de preparación de datos y análisis espacial,
- cMixModule: una rama mixta que integra características temporales y espaciales.
Es precisamente esta organización la que permite conservar la lógica de la arquitectura original de Extralonger, al tiempo que hace que la implementación sea más modular y fácil de mantener.
Del esquema general de la arquitectura pasamos gradualmente a su contenido interno, y es precisamente aquí donde se pone de manifiesto la verdadera complejidad del objeto. En el nivel superior solo vemos cuatro arrays dinámicos: el bloque preparatorio de proyección temporal, el módulo temporal, el módulo espacial y la rama mixta. Pero tras esta fachada tan pulcra se esconde todo un ecosistema de componentes más pequeños: capas convolucionales y de normalización, transformadores de transposición, embeddings entrenables y bloques de atención. No existen de forma aislada; cada uno de ellos desempeña un papel estrictamente definido, y su interacción da lugar a un flujo vivo de información que atraviesa CNeuronExtralonger.
Todo este mundo interno se crea en el método Init. Se podría decir que es precisamente aquí donde se establecen la estructura y la lógica del comportamiento del modelo. La inicialización comienza con la llamada al método homónimo de la clase base, que proporciona el esquema general de Attention Pooling multicabeza.
bool CNeuronExtralonger::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                              uint time_steps_in, uint time_steps_out, uint variables,
                              uint dimension, uint emb_dimension, uint period1,
                              uint frame1, uint period2, uint frame2, uint layers,
                              uint heads, uint dimension_k, uint m_units, float sparse,
                              ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronMHAttentionPooling::Init(numOutputs, myIndex, open_cl, variables, time_steps_out,
                                       3, optimization_type, batch))
      return false;
Y a partir de ahí empieza lo más interesante. Paso a paso vamos construyendo un organismo complejo, en el que cada capa aporta su propio matiz al conjunto. Pero primero, un pequeño paso previo: declararemos una serie de variables locales para almacenar temporalmente los punteros a los objetos.
   CNeuronBatchNormOCL           *norm    = NULL;
   CNeuronConvOCL                *conv    = NULL;
   CNeuronTransposeOCL           *transp  = NULL;
   CNeuronLearnabledPE           *lnoise  = NULL;
   CNeuronSpatialEmbedding       *semb    = NULL;
   CNeuronTempEmbedding          *temb    = NULL;
   CNeuronMLMHAttentionOCL       *att     = NULL;
   CNeuronGlobalLocalAttention   *glatt   = NULL;
El primer bloque que entra en escena es el de preparación de los datos de partida para las líneas troncales de análisis temporal y mixto. Es como un afinador que prepara los instrumentos antes de un concierto. El objeto de codificación posicional añade al flujo de datos originales un desplazamiento entrenable, que los autores del framework denominaron «ruido entrenable». Es importante destacar aquí que no se trata de una mezcla fortuita, sino de un intento deliberado de integrar en el modelo la capacidad de percibir el ritmo temporal del mercado. Los datos de precios y volúmenes nunca son limpios: siempre fluctúan bajo el efecto de microvariaciones. La incorporación del ruido entrenable convierte esta característica en una herramienta: el modelo empieza a distinguir mejor los patrones del caos y a estructurar su percepción del tiempo basándose en los ritmos reales del mercado.
//--- Proyección temporal
   cProjectionT.Clear();
   cProjectionT.SetOpenCL(OpenCL);
   int index = 0;
   lnoise = new CNeuronLearnabledPE();
   if(!lnoise ||
      !lnoise.Init(0, index, OpenCL, time_steps_in * variables, optimization, iBatch) ||
      !cProjectionT.Add(lnoise))
     {
      DeleteObj(lnoise);
      return false;
     }
Justo después de él viene una capa convolucional que desempeña una función especial. Convierte cada paso temporal en un embedding que contiene información sobre todas las características analizadas en ese preciso momento. En esencia, a la salida se forma una representación compacta e informativa que se convierte en una especie de instantánea del estado del mercado para cada paso. El precio, los volúmenes, los indicadores y otras variables se combinan en un único vector. De este modo, el modelo puede trabajar no con números aislados, sino con representaciones completas que reflejan todo el espectro de observaciones a lo largo del tiempo.
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, variables, variables, dimension, time_steps_in, 1,
                 optimization, iBatch) ||
      !cProjectionT.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(None);
El siguiente paso es el embedding temporal, en el que las series adquieren una dimensión adicional que refleja los ciclos y los períodos. La arquitectura incorpora aquí dos tipos de periodicidad: una de corto plazo y otra más prolongada, relacionadas con los ritmos diarios y semanales del mercado. Es como cuando un músico percibe el compás y el ritmo. Independientemente de la melodía, siempre existe una base rítmica sin la cual es imposible construir una composición. En los datos financieros, esto se manifiesta en el cambio de las sesiones de trading, las fluctuaciones estacionales o las fases regulares de actividad de los grandes participantes. El embedding temporal literalmente incorpora esta rítmica en los datos, haciendo que el modelo sea sensible a lo que se repite día tras día o semana tras semana.
   index++;
   temb = new CNeuronTempEmbedding();
   uint half_emb = (emb_dimension + 1) / 2;
   if(!temb ||
      !temb.Init(0, index, OpenCL, time_steps_in, dimension, half_emb, period1,
                 frame1, dimension - half_emb, period2, frame2, optimization, iBatch) ||
      !cProjectionT.Add(temb))
     {
      DeleteObj(temb);
      return false;
     }
La normalización cierra el bloque preparatorio. Se puede comparar con alisar el lienzo antes de aplicar la pintura. Si la superficie es irregular, el dibujo quedará distorsionado. La normalización elimina sesgos aleatorios, lleva los datos a una distribución estable y, con ello, sienta las bases para el trabajo posterior de módulos más complejos.
   index++;
   norm = new CNeuronBatchNormOCL();
   if(!norm ||
      !norm.Init(0, index, OpenCL, temb.Neurons(), iBatch, optimization) ||
      !cProjectionT.Add(norm))
     {
      DeleteObj(norm);
      return false;
     }
Cuando los datos salen del bloque preparatorio, pasan a manos del módulo de análisis temporal. Aquí entra en juego la atención multicabeza, que abre varias perspectivas paralelas a la vez. Busca relaciones entre momentos temporales separados por decenas de pasos y aprende a detectar patrones que no están al alcance de una simple mirada lineal.
//--- Módulo temporal
   cTimeModule.Clear();
   cTimeModule.SetOpenCL(OpenCL);
   index++;
   att = new CNeuronMLMHAttentionOCL();
   if(!att ||
      !att.Init(0, index, OpenCL, dimension + emb_dimension, dimension_k, heads,
                time_steps_in, layers, optimization, iBatch) ||
      !cTimeModule.Add(att))
     {
      DeleteObj(att);
      return false;
     }
A continuación, se activa el bloque de proyección de datos sobre el horizonte de planificación establecido. Se puede comparar con un puente que conecta la historia con el futuro. Incluye varias capas convolucionales que transforman los embeddings en una secuencia multimodal de la serie temporal y, al mismo tiempo, modifican la longitud de la secuencia, extendiéndola hasta el horizonte de planificación requerido. Estas capas actúan como lentes con distinta profundidad de enfoque: unas resaltan los movimientos locales, mientras que otras construyen una perspectiva amplia.
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, dimension + emb_dimension, dimension + emb_dimension,
                 variables, time_steps_in, 1, optimization, iBatch) ||
      !cTimeModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(TANH);
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, time_steps_in, variables, optimization, iBatch) ||
      !cTimeModule.Add(transp))
     {
      DeleteObj(transp);
      return false;
     }
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, time_steps_in, time_steps_in, time_steps_out, variables,
                 1, optimization, iBatch) ||
      !cTimeModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, time_steps_out, time_steps_out, time_steps_out, variables,
                 1, optimization, iBatch) ||
      !cTimeModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(None);
   index++;
   norm = new CNeuronBatchNormOCL();
   if(!norm ||
      !norm.Init(0, index, OpenCL, conv.Neurons(), iBatch, optimization) ||
      !cTimeModule.Add(norm))
     {
      DeleteObj(norm);
      return false;
     }
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, variables, time_steps_out, optimization, iBatch) ||
      !cTimeModule.Add(transp))
     {
      DeleteObj(transp);
      return false;
     }
A la salida, ya no obtenemos simplemente un conjunto de embeddings, sino una trayectoria predictiva adaptada al horizonte de planificación.
En paralelo, comienza a funcionar el módulo mixto, y es precisamente aquí donde los datos recorren un trayecto especialmente intenso. Su función es única: conectar las características temporales y espaciales, convirtiéndolas en un único flujo de información. El primero en entrar en acción es el bloque clásico de atención multicabeza, que analiza la secuencia temporal de forma aislada. Busca patrones, correspondencias y motivos recurrentes ocultos en la estructura de la secuencia y, de este modo, crea un armazón sólido para el análisis posterior.
//--- Mix Module
   cMixModule.Clear();
   cMixModule.SetOpenCL(OpenCL);
   uint att_layers = (layers + 1) / 2;
   index++;
   att = new CNeuronMLMHAttentionOCL();
   if(!att ||
      !att.Init(0, index, OpenCL, dimension + emb_dimension, dimension_k, heads,
                time_steps_in, att_layers, optimization, iBatch) ||
      !cMixModule.Add(att))
     {
      DeleteObj(att);
      return false;
     }
A continuación, los datos se someten a una transposición, una especie de cambio de perspectiva. Si al principio observábamos las series en función de los pasos temporales, ahora la atención se desplaza hacia las características, y es precisamente en este nuevo sistema de coordenadas donde entra en juego el módulo de atención global-local. Aquí se equilibran dos aspectos opuestos: una visión global que abarca todo el mercado y un enfoque local que permite detectar relaciones apenas perceptibles entre distintos instrumentos o repuntes instantáneos. Esta combinación resulta especialmente importante en el contexto financiero: el mercado puede moverse durante semanas dentro de una gran tendencia, pero, al mismo tiempo, algunos activos cambian repentinamente de dinámica debido a noticias o acontecimientos locales.
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, time_steps_in, dimension + emb_dimension, optimization, iBatch) ||
      !cMixModule.Add(transp))
     {
      DeleteObj(transp);
      return false;
     }
   for(uint i = (att_layers == layers ? 0 : att_layers - 1); i < layers; i++)
     {
      index++;
      glatt = new CNeuronGlobalLocalAttention();
      if(!glatt ||
         !glatt.Init(0, index, OpenCL, dimension + emb_dimension, time_steps_in, dimension_k, heads,
                     m_units, sparse, optimization, iBatch) ||
         !cMixModule.Add(glatt))
        {
         DeleteObj(glatt);
         return false;
        }
     }
El colofón lo pone el bloque de previsión, que se encarga de plasmar toda la información acumulada en un formato adecuado para la planificación en el horizonte de planificación dado. Varias capas convolucionales de este bloque transforman los embeddings en una secuencia de valores pronosticados, ajustada a la longitud de la ventana requerida. Es precisamente aquí donde las representaciones abstractas se convierten en un resultado concreto: una previsión que refleja tanto el contexto global como las particularidades locales.
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, time_steps_in, time_steps_in, time_steps_out,
                             dimension + emb_dimension, 1, optimization, iBatch) ||
      !cMixModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, time_steps_out, time_steps_out, time_steps_out,
                 dimension + emb_dimension, 1, optimization, iBatch) ||
      !cMixModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(TANH);
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, dimension + emb_dimension, time_steps_out,
                                                          optimization, iBatch) ||
      !cMixModule.Add(transp))
     {
      DeleteObj(transp);
      return false;
     }
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, dimension + emb_dimension, dimension + emb_dimension,
                                     variables, time_steps_out, 1, optimization, iBatch) ||
      !cMixModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(None);
   index++;
   norm = new CNeuronBatchNormOCL();
   if(!norm ||
      !norm.Init(0, index, OpenCL, conv.Neurons(), iBatch, optimization) ||
      !cMixModule.Add(norm))
     {
      DeleteObj(norm);
      return false;
     }
Como resultado, el módulo mixto funciona como un laboratorio de síntesis: primero se registran las regularidades temporales; a continuación, estas se superponen a las relaciones espaciales; y, por último, la señal resultante pasa por un bloque de previsión y se convierte en una salida completa en la que se entrelazan varios niveles de análisis a la vez.
La etapa final del recorrido interno de los datos es el módulo espacial. Se encarga de que el mercado deje de percibirse como un conjunto de series independientes. En un primer momento, aquí se forman embeddings espaciales que capturan vínculos a largo plazo entre instrumentos, sectores e índices.
//--- Spatial Module
   cSpatialModule.Clear();
   cSpatialModule.SetOpenCL(OpenCL);
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, time_steps_in, variables, optimization, iBatch) ||
      !cSpatialModule.Add(transp))
     {
      DeleteObj(transp);
      return false;
     }
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, time_steps_in, time_steps_in, dimension, variables,
                 1, optimization, iBatch) ||
      !cSpatialModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(None);
   index++;
   semb = new CNeuronSpatialEmbedding();
   if(!semb ||
      !semb.Init(0, index, OpenCL, variables, dimension, emb_dimension, optimization, iBatch) ||
      !cSpatialModule.Add(semb))
     {
      DeleteObj(semb);
      return false;
     }
A partir de ellos, los bloques de atención global-local van construyendo, de forma sucesiva, una visión amplia de las correlaciones y vínculos detallados entre activos concretos. Se podría decir que este módulo convierte el mercado financiero en una red viva, en la que cada eslabón está conectado con los demás, y es precisamente esta red la que se convierte en objeto de análisis.
   index++;
   norm = new CNeuronBatchNormOCL();
   if(!norm ||
      !norm.Init(0, index, OpenCL, semb.Neurons(), iBatch, optimization) ||
      !cSpatialModule.Add(norm))
     {
      DeleteObj(norm);
      return false;
     }
   for(uint i = 0; i < layers; i++)
     {
      index++;
      glatt = new CNeuronGlobalLocalAttention();
      if(!glatt ||
         !glatt.Init(0, index, OpenCL, dimension + emb_dimension, variables, dimension_k,
                     heads, m_units, sparse, optimization, iBatch) ||
         !cSpatialModule.Add(glatt))
        {
         DeleteObj(glatt);
         return false;
        }
     }
Y, al igual que en las dos ramas presentadas anteriormente, los resultados del análisis se envían al bloque de previsión, que organiza cuidadosamente toda la información en un formato adecuado para la planificación del periodo establecido.
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, dimension + emb_dimension, dimension + emb_dimension,
                 time_steps_out, variables, 1, optimization, iBatch) ||
      !cSpatialModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, time_steps_out, time_steps_out, time_steps_out,
                 variables, 1, optimization, iBatch) ||
      !cSpatialModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(None);
   index++;
   norm = new CNeuronBatchNormOCL();
   if(!norm ||
      !norm.Init(0, index, OpenCL, conv.Neurons(), iBatch, optimization) ||
      !cMixModule.Add(norm))
     {
      DeleteObj(norm);
      return false;
     }
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, variables, time_steps_out, optimization, iBatch) ||
      !cMixModule.Add(transp))
     {
      DeleteObj(transp);
      return false;
     }
Las tres ramas (temporal, mixta y espacial) convergen en el punto de concatenación. Aquí se combinan sus resultados, y es precisamente en esta etapa cuando entra en acción nuestro mecanismo clave: Attention Pooling adaptativo. A diferencia de la versión original, en la que los pesos son fijos, permitimos que las ramas acuerden entre sí cuál de ellas tiene mayor importancia en cada momento. Como resultado, la señal final no es una estructura rígida, sino una herramienta flexible que respira al ritmo del mercado.
   index++;
   if(!cConcatResults.Init(0, index, OpenCL, 3 * variables * time_steps_out, optimization, iBatch))
      return false;
   cConcatResults.SetActivationFunction(None);
//---
   return true;
  }
Así, el método Init transforma una secuencia escueta de llamadas en una arquitectura viva, donde cada eslabón aporta una carga semántica y su interacción da lugar a una herramienta de análisis única. Aquí nace un organismo llamado CNeuronExtralonger, y cada uno de sus componentes contribuye al resultado global.
Tras inicializar el objeto, pasamos a construir el algoritmo de pasada directa, implementado en el método feedForward. La firma del método ya dice mucho por sí sola. Como parámetros, recibe un puntero al objeto de datos de origen NeuronOCL y un búfer adicional SecondInput, que contiene las marcas temporales de la secuencia analizada.
bool CNeuronExtralonger::feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)
  {
   CNeuronBaseOCL *prev = NeuronOCL;
   CNeuronBaseOCL *current = NULL;
La primera operación interna consiste en declarar dos variables locales. A una de ellas se le asigna un puntero al objeto de datos de origen. Es una técnica habitual para la transmisión de extremo a extremo: prev actúa como el último resultado disponible, que se pasa a la capa siguiente. Y current sirve como variable temporal en la que, en cada iteración, se almacena un puntero a la capa que se está procesando. Este enfoque permite construir de forma lineal una cadena de capas, evitando copias innecesarias y manteniendo el control sobre la secuencia de cálculos.
A continuación, se inicia un ciclo por el contenedor de preparación de datos de origen cProjectionT. Para cada proyección, tomamos un puntero al objeto actual y comprobamos inmediatamente su validez. A continuación, llamamos al método de pasada directa del objeto. Si se produce un error en cualquiera de las etapas, el método finaliza inmediatamente su ejecución con el resultado false. Se trata de un patrón fail-fast: es mejor detenerse ante el primer problema que seguir trabajando con datos dañados.
//--- Time projection
   for(int i = 0; i < cProjectionT.Total(); i++)
     {
      current = cProjectionT[i];
      if(!current ||
         !current.FeedForward(prev, SecondInput))
         return false;
      prev = current;
     }
Es importante señalar que, en este bloque, el método FeedForward de los objetos internos recibe dos argumentos: el resultado anterior y las marcas temporales de SecondInput. Y es que para generar embeddings temporales se necesitará contexto adicional.
Si todo ha salido bien, la variable prev se actualiza con un puntero a current, para que la siguiente iteración trabaje con la salida de la capa que se acaba de procesar.
Una vez finalizadas las proyecciones, el control pasa al módulo temporal. El ciclo por el contenedor cTimeModule es prácticamente igual, pero en este caso el método FeedForward de los objetos internos se invoca ya con un solo argumento. Esto indica que el módulo temporal procesa la secuencia resultante sin necesidad de un búfer adicional.
//--- Time Module
   for(int i = 0; i < cTimeModule.Total(); i++)
     {
      current = cTimeModule[i];
      if(!current ||
         !current.FeedForward(prev))
         return false;
      prev = current;
     }
Si falta alguna capa del módulo temporal, o si su FeedForward señala un error, volvemos a interrumpir el procesamiento y devolvemos false.
A continuación, el foco se desplaza hacia el módulo mixto. Pero hay que tener en cuenta que este módulo también trabaja con los resultados del preprocesamiento de los datos, por lo que, antes de iniciar el ciclo, asignamos a la variable prev un puntero a la última capa del contenedor cProjectionT. Las ramas temporal y mixta siguen cursos paralelos, procesando las mismas características iniciales de forma diferente.
//--- Mix Module
   prev = cProjectionT[-1];
   for(int i = 0; i < cMixModule.Total(); i++)
     {
      current = cMixModule[i];
      if(!current ||
         !current.FeedForward(prev))
         return false;
      prev = current;
     }
A continuación, para cada elemento de cMixModule se lleva a cabo la misma comprobación de la validez del puntero y se invoca el método de pasada directa, tras lo cual se actualiza el puntero en prev. Cualquier error provoca de nuevo la finalización inmediata del proceso y la devolución de false.
El módulo espacial está organizado de forma independiente y recibe NeuronOCL como datos de entrada. Esto significa que la rama Spatial analiza la señal de entrada en paralelo con las demás ramas, sin heredar las transformaciones intermedias. Tras la ejecución secuencial de las capas de cSpatialModule, con la lógica fail-fast habitual y la actualización de prev.
//--- Spatial Module
   prev = NeuronOCL;
   for(int i = 0; i < cSpatialModule.Total(); i++)
     {
      current = cSpatialModule[i];
      if(!current ||
         !current.FeedForward(prev))
         return false;
      prev = current;
     }
Como resultado, obtenemos tres ramas completas: la temporal, la mixta y la espacial. La siguiente etapa es la concatenación. Reunimos las salidas de las tres ramas en un único búfer, creando una ventana y estableciendo la dimensión final. Si la concatenación no se ha realizado correctamente, el método devuelve false.
//--- Concatenate
   if(!Concat(cTimeModule[-1].getOutput(), cMixModule[-1].getOutput(), cSpatialModule[-1].getOutput(),
              cConcatResults.getOutput(), iWindow, iWindow, iWindow, iUnits))
      return false;
//---
   return CNeuronMHAttentionPooling::feedForward(cConcatResults.AsObject());
  }
Tras una concatenación satisfactoria, solo queda pasar el resultado agregado al módulo Attention Pooling.
Desde el punto de vista arquitectónico, se aprecia que el sistema está construido como un conjunto de ramas paralelas, cada una de las cuales examina los datos de entrada con un objetivo propio: las proyecciones preparan representaciones temporales, el módulo temporal analiza la secuencia, el módulo mixto combina las proyecciones, y Spatial se centra en las características espaciales. Este esquema se parece a una orquesta: cada instrumento tiene su propia partitura, y el director es Attention Pooling, que lo une todo.
El método de distribución de los gradientes de error reproduce en gran medida la estructura de la pasada directa, pero con la diferencia de que, en este caso, los datos circulan en sentido inverso y es necesario sumar con precisión los flujos de error.
bool CNeuronExtralonger::calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                            CBufferFloat *SecondInput,
                                            CBufferFloat *SecondGradient,
                                            ENUM_ACTIVATION SecondActivation = None)
  {
   if(!NeuronOCL)
      return false;
//---
   if(!CNeuronMHAttentionPooling::calcInputGradients(cConcatResults.AsObject()))
      return false;
En primer lugar, comprobamos la validez del puntero al objeto de datos de origen. Si está vacío, el método devuelve inmediatamente false. A continuación, se invoca el método del mismo nombre de la clase padre. Este paso permite propagar el gradiente de error recibido de la capa neuronal siguiente hasta el nivel del búfer concatenado. A continuación, los valores obtenidos se distribuyen de nuevo en tres ramas: temporal, mixta y espacial. En este caso, es importante que el error acumulado en el búfer común se divida estrictamente de acuerdo con la arquitectura del modelo. Cada rama ha recibido su gradiente correcto. Si alguna de las operaciones falla, el proceso se interrumpe.
//--- DeConcatenate
   if(!cTimeModule[-1] || !cMixModule[-1] || !cSpatialModule[-1] ||
      !DeConcat(cTimeModule[-1].getGradient(), cMixModule[-1].getGradient(),
                cSpatialModule[-1].getGradient(), cConcatResults.getOutput(),
                iWindow, iWindow, iWindow, iUnits))
      return false;
A partir de ahí, los gradientes comienzan a propagarse por los módulos en orden inverso. Primero, la línea troncal espacial. El ciclo va de fin a principio; cada elemento actual toma una referencia a la capa siguiente y llama al método de distribución del gradiente de error del objeto interno. El gradiente de error se propaga cuidadosamente hacia atrás, capa por capa.
   CNeuronBaseOCL *next = NULL;
   CNeuronBaseOCL *current = NULL;
//--- Spatial Module
   for(int i = cSpatialModule.Total() - 1; i >= 0; i--)
     {
      current = (i > 0 ? cSpatialModule[i - 1] : NeuronOCL);
      next = cSpatialModule[i];
      if(!current ||
         !current.CalcHiddenGradients(next))
         return false;
     }
La misma lógica se aplica al módulo mixto, solo que en este caso se utiliza como punto de referencia el último elemento de las proyecciones temporales. Esto refleja la estructura paralela del modelo: las distintas ramas devuelven los errores por sus propios canales, pero siempre de forma sincronizada.
//--- Mix Module
   for(int i = cMixModule.Total() - 1; i >= 0; i--)
     {
      current = (i > 0 ? cMixModule[i - 1] : cProjectionT[-1]);
      next = cMixModule[i];
      if(!current ||
         !current.CalcHiddenGradients(next))
         return false;
     }
El módulo temporal reviste un interés especial. Cabe señalar aquí que transmite el gradiente de error a la última capa del módulo de preparación de datos. Y es precisamente a esa capa a la que acabamos de pasar los valores del módulo mixto. Por eso, antes de realizar la pasada inversa del módulo de análisis temporal, guardamos en la variable local temp. el puntero al búfer actual de gradientes de error con los valores guardados. Y pasamos al objeto un puntero a un búfer libre.
//--- Time Module
   CBufferFloat *temp = current.getGradient();
   if(!current.SetGradient(current.getPrevOutput(), false))
      return false;
   for(int i = cTimeModule.Total() - 1; i >= 0; i--)
     {
      current = (i > 0 ? cTimeModule[i - 1] : cProjectionT[-1]);
      next = cTimeModule[i];
      if(!current ||
         !current.CalcHiddenGradients(next))
         return false;
     }
   if(!SumAndNormilize(temp, current.getGradient(), temp, 1, false, 0, 0, 0, 1) ||
      !current.SetGradient(temp, false))
      return false;
Luego, en el ciclo, de nuevo de atrás hacia adelante, los gradientes se propagan por el módulo. Y, una vez finalizada la pasada inversa por la rama temporal, sumamos los valores obtenidos en los dos flujos de información y devolvemos los punteros a los búferes de datos a su estado inicial.
El último paso es el procesamiento de las proyecciones temporales. Aquí, el gradiente desciende hasta el nivel del objeto de datos de origen. Sin embargo, quiero recordar que ya hemos enviado allí los gradientes de error desde la línea troncal espacial. Por eso, repetimos el truco de sustituir el búfer de datos y, a continuación, llevamos a cabo las operaciones de distribución del gradiente de error.
//--- Time projection
   temp = NeuronOCL.getGradient();
   if(!NeuronOCL.SetGradient(NeuronOCL.getPrevOutput(), false))
      return false;
   for(int i = cProjectionT.Total() - 1; i >= 0; i--)
     {
      current = (i > 0 ? cProjectionT[i - 1] : NeuronOCL);
      next = cProjectionT[i];
      if(!current ||
         !current.CalcHiddenGradients(next, SecondInput, SecondGradient, SecondActivation))
         return false;
     }
   if(!SumAndNormilize(temp, NeuronOCL.getGradient(), temp, 1, false, 0, 0, 0, 1) ||
      !NeuronOCL.SetGradient(temp, false))
      return false;
//---
   return true;
  }
De este modo, el método distribuye con precisión los gradientes entre tres ramas paralelas: Spatial, Mix y Temporal. En cada rama, la pasada inversa se realiza capa por capa en orden inverso, y en las uniones entre ramas los errores se suman. Esto refleja la misma idea arquitectónica que en la pasada directa: los datos circulan por canales paralelos, pero al final se combinan en un resultado común.
El código completo de la clase, con todos los métodos, se incluye en el archivo adjunto, lo que permite examinar la estructura general y el funcionamiento interno de la implementación.
Arquitectura del modelo
Una vez que terminamos de crear todos los objetos necesarios para la implementación del framework Extralonger, el trabajo pasa lógicamente a describir la arquitectura del propio modelo. Es importante destacar lo siguiente: no nos limitamos a la tarea de pronosticar series temporales, como se hace en la implementación del autor. Nuestro objetivo es más amplio y práctico: estamos creando un robot de trading completo, capaz de tomar decisiones de forma autónoma y realizar operaciones de trading en el mercado.
En este planteamiento, la tarea de predecir las series de precios deja de ser el objetivo final y pasa a ser solo una parte del sistema, concretamente un Codificador del estado del entorno. Una especie de sensor que transforma los datos del mercado en un formato comprensible para el algoritmo. Manteniendo el concepto de «Actor-Critic», creamos tres modelos funcionales: el Codificador, el Actor y el Crítico.
Para describir su arquitectura se utiliza el método CreateDescriptions. En él se crean e inicializan cuidadosamente los arrays de descripción de capas para cada una de las tres partes del modelo.
bool CreateDescriptions(CArrayObj *&encoder,
                        CArrayObj *&actor,
                        CArrayObj *&critic
                       )
  {
//---
   CLayerDescription *descr;
//---
   if(!encoder)
     {
      encoder = new CArrayObj();
      if(!encoder)
         return false;
     }
   if(!actor)
     {
      actor = new CArrayObj();
      if(!actor)
         return false;
     }
   if(!critic)
     {
      critic = new CArrayObj();
      if(!critic)
         return false;
     }
El código comienza con la comprobación de los punteros a arrays recibidos. Si alguno de ellos aún no existe, se crea uno nuevo. Este paso garantiza la fiabilidad: nos aseguramos de que el llenado posterior de las descripciones no provoque fallos por la ausencia de una estructura.
A continuación, se limpian los arrays y comienza la construcción por etapas de las capas del Codificador. Lo primero que se añade es la capa de datos de entrada.
//--- Encoder
   encoder.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   uint prev_count = descr.count = (HistoryBars * BarDescr);
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
El siguiente paso es una capa de normalización con adición de ruido, que ayuda a mejorar la estabilidad del entrenamiento gracias a las distorsiones estocásticas.
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormWithNoise;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Después se crea una capa para añadir las características de primera diferencia. Su función es generar cortes temporales, relacionando entre sí los valores de las barras. A la salida, esta capa genera el doble de características, ya que se combinan tanto los propios valores como sus diferencias.
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConcatDiff;
   prev_count = descr.count = HistoryBars;
   descr.layers = BarDescr;
   descr.step = 1;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   uint prev_out = descr.layers*2 ;
La siguiente capa, defNeuronExtralonger, reviste un interés especial. Define la arquitectura del objeto de alto nivel CNeuronExtralonger que hemos creado. En esencia, se trata de todo el conjunto del framework Extralonger. En él indicamos todos los parámetros necesarios: ventanas temporales, profundidad de previsión, períodos corto y largo, así como la dimensionalidad de las características ocultas. Este bloque convierte el Codificador en un filtro inteligente que une el pasado y el futuro en una única representación.
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronExtralonger;
     {
      uint temp[] = {HistoryBars,   // Time steps history
                     NForecast,     // Time steps forecast
                     ShortPeriod,   // Period 2
                     LongPeriod,    // Period 2
                     BarDescr/2     // M units
                    };
      if(ArrayCopy(descr.units, temp) < (int)temp.Size())
         return false;
     }
   prev_count = descr.units[1];
   descr.window = prev_out;            // Variables
   descr.window_out = EmbeddingSize;   // Inside Dimension
     {
      uint temp[] = {EmbeddingSize,             // Embedding Dimension
                     PeriodSeconds(PERIOD_H1),  // Frame 1
                     PeriodSeconds(PERIOD_D1),  // Frame 2
                     2*EmbeddingSize/NHeads
                    };
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.layers=2;
   descr.step=NHeads;
   descr.probability=0.3f;
   descr.optimization=ADAM;
   descr.batch=BatchSize;
   descr.activation = None;
   if(!encoder. Add(descry))
     {
      delete descry;
      return false;
     }
   uint window=descr.window;
   uint count=prev_count;
A la salida del módulo Extralonger obtenemos un bloque ya formado de valores pronosticados, listo para su uso posterior. Pero es importante recordar que, incluso antes de introducir los datos en este módulo, ya los habíamos enriquecido con características de primera diferencia. Esta técnica permitió hacer que las series fueran más informativas, pero al mismo tiempo aumentó la dimensionalidad de los datos.
Parecería que la forma más sencilla de resolver este problema es simplemente descartar las características superfluas. Sin embargo, ese enfoque conllevaría la pérdida de la información por la que precisamente se introdujo la primera diferencia. En lugar de una solución simplificada, utilizamos una capa convolucional que no solo reduce la dimensionalidad, sino que también selecciona los patrones locales más significativos. Gracias a ello, la salida del módulo pasa por un filtrado fino: los datos se vuelven compactos, pero conservan todo el espectro de características esenciales necesarias para tomar decisiones de trading.
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.step = prev_out;
   prev_out = descr.window_out = BarDescr;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
El toque final del Codificador del estado del entorno es la capa de desnormalización inversa (defNeuronRevInDenormOCL). Esta capa devuelve los valores a la escala habitual de los datos analizados, eliminando el sesgo que surgió durante el proceso de codificación y normalización. De este modo, el resultado pasa a ser comparable con las magnitudes reales del mercado.
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronRevInDenormOCL;
   descr.count = prev_count * prev_out;
   descr.layers = 1;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
La arquitectura de los modelos Actor y Crítico se ha tomado íntegramente de nuestros trabajos anteriores y no ha sufrido ningún cambio. Precisamente por eso no nos detendremos en su análisis detallado en este artículo. Para completar el panorama, el lector dispone en el archivo adjunto de una descripción completa de la arquitectura de todos los modelos entrenables, donde puede seguir cada detalle de la implementación y comprobar la integridad de la solución desarrollada.
Pruebas
El entrenamiento del modelo es una preparación completa para el trading. Antes de lanzarla al mercado real, probamos a fondo la estrategia con datos históricos. La primera fase —el entrenamiento offline— se llevó a cabo con una muestra del par de divisas EURUSD en el marco temporal H1, durante el periodo comprendido entre enero de 2024 y junio de 2025. Este periodo resultó ser intenso y variado: las fases tranquilas de rangos laterales se alternaron con movimientos tendenciales bruscos, y, con la publicación de noticias, se disparaban episodios de alta volatilidad. Esta combinación de condiciones permitió que el modelo aprendiera a distinguir una amplia variedad de escenarios de mercado y a generar decisiones de trading sólidas sin perder la orientación en situaciones complejas.
Una vez finalizada la primera fase de preparación, pasamos a la segunda: el ajuste fino online en el Probador de Estrategias de MetaTrader 5. Aquí los datos llegaban en tiempo real, vela tras vela, y el modelo iba asimilando la dinámica del procesamiento en flujo. Aprendía a mantener la estabilidad en medio del ruido, a hacer frente a la baja liquidez y a no desorientarse ante picos repentinos de precios. Esta etapa supuso, en cierto modo, el perfeccionamiento de la estrategia. No modificaba el armazón construido con datos históricos, pero ayudaba a adaptarlo a las condiciones reales y reducía el riesgo de sobreajuste.
La comprobación final se llevó a cabo con los datos de julio de 2025, que no se habían utilizado anteriormente y eran totalmente nuevos para el modelo. Todos los parámetros obtenidos en las etapas anteriores se cargaron sin modificaciones. Esta prueba limpia permitió evaluar de forma objetiva la capacidad de generalización del modelo, sin ningún tipo de ajuste ni corrección.
A continuación se presentan los resultados de las pruebas.


Los resultados de las pruebas permiten evaluar el modelo en condiciones reales de mercado sin ningún tipo de ajuste. Empecemos por las cifras clave. Con un depósito inicial de 100 dólares, el resultado neto final fue de 3,02 dólares, es decir, el saldo aumentó un tres por ciento durante el mes de prueba. Las ganancias totales ascendieron a 27,26 dólares, mientras que las pérdidas fueron de 24,24 dólares. El Profit Factor es de 1,12. Esto indica que las operaciones rentables superan ligeramente a las operaciones con pérdidas.
Sin embargo, también se aprecia un punto débil: el factor de recuperación es de tan solo 0,22. Esto significa que, tras rachas de pérdidas, el modelo recupera el capital lentamente. La caída máxima del saldo fue del 12,75 %, una cifra bastante notable, pero que, no obstante, no resulta crítica para el trading totalmente automatizado. La esperanza matemática media por operación fue modesta: 0,06 dólares; en cambio, el indicador Sharpe Ratio (3,04) apunta a una buena relación entre rentabilidad y riesgo al tener en cuenta la volatilidad.
También son interesantes las estadísticas de las operaciones. En total fueron 50 operaciones: 28 operaciones en corto (con una tasa de acierto del 53,57 %) y 22 operaciones en largo (con ganancias solo en el 36,36 % de los casos). En general, el porcentaje de operaciones rentables fue del 46 %. La mayor ganancia en una operación individual fue de 6,70 dólares, y la pérdida máxima, de 4,73 dólares. Las rachas también mostraron su carácter: se lograron ganar hasta cinco operaciones seguidas, mientras que la racha máxima de pérdidas fue de tres.
El gráfico de la curva de capital confirma lo que muestran las cifras. Los primeros días de julio estuvieron marcados por fluctuaciones y una serie de caídas, tras lo cual el saldo comenzó a aumentar gradualmente. A mediados de mes aparecieron varias rachas de operaciones exitosas que permitieron llevar el capital a terreno positivo. Hacia finales de julio se observó una estabilización y el mantenimiento del resultado, sin nuevos descensos pronunciados.
Así pues, la prueba demostró que el modelo es capaz de generar beneficios moderados, manteniendo un equilibrio entre el riesgo y la rentabilidad. Sin embargo, el periodo de pruebas es bastante breve, por lo que será necesaria una mayor optimización para su uso real. En primer lugar, habrá que reducir la caída y aumentar el porcentaje de operaciones rentables. Pero lo principal es que el sistema superó una prueba limpia con datos nuevos y demostró su capacidad de generalización, lo cual es un criterio clave de la calidad de un modelo algorítmico.
Y no olvidemos que el entrenamiento de los transformadores es un proceso bastante complejo y requiere conjuntos de entrenamiento muy amplios.
Conclusión
En el transcurso del trabajo, hemos comprobado que los enfoques propuestos por el framework Extralonger son capaces de integrar de forma orgánica factores espaciales y temporales, creando una base sólida para el análisis de la dinámica del mercado.
Las pruebas confirmaron la eficacia práctica de los algoritmos, y la flexibilidad de la arquitectura permite adaptar el sistema a distintos horizontes de previsión y clases de instrumentos financieros. La implementación mediante MQL5 ha demostrado que los enfoques clásicos, combinados con métodos modernos de redes neuronales, ofrecen resultados comparables a los de sistemas más complejos, sin dejar de ser extremadamente transparentes y controlables.
Enlaces
- Extralonger: Toward a Unified Perspective of Spatial-Temporal Factors for Extra-Long-Term Traffic Forecasting
- Otros artículos de la serie
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | Study.mq5 | Asesor experto | Asesor experto para el entrenamiento offline de modelos |
| 2 | StudyOnline.mq5 | Asesor experto | Asesor experto para el entrenamiento online de modelos |
| 3 | Test.mq5 | Asesor experto | Asesor experto para probar el modelo |
| 4 | Trajectory.mqh | Biblioteca de clases | Estructura de la descripción del estado del sistema y de la arquitectura de los modelos |
| 5 | NeuroNet.mqh | Biblioteca de clases | Biblioteca de clases para crear una red neuronal |
| 6 | NeuroNet.cl | Biblioteca | Biblioteca de código del programa OpenCL |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19564
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Utilizando redes neuronales en MetaTrader
 Redes neuronales en el trading: una visión unificada del espacio y el tiempo (Global-Local Attention)
 Particularidades del trabajo con números del tipo double en MQL4
 Características del Wizard MQL5 que debe conocer (Parte 78): Estrategias con Gator y el oscilador AD para la resiliencia del mercado

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso