

Redes neuronales en el trading: una visión unificada del espacio y el tiempo (Global-Local Attention)
 13
 0

Introducción
Los mercados financieros son un sistema complejo y dinámico en el que el espacio y el tiempo están estrechamente entrelazados. Cada movimiento de la cotización refleja no solo el equilibrio instantáneo entre la oferta y la demanda, sino también las huellas de acontecimientos anteriores, así como la influencia de instrumentos relacionados, sectores e incluso economías enteras. Predecir el comportamiento de un sistema de este tipo mediante métodos tradicionales siempre ha sido una tarea de gran complejidad. Los modelos estadísticos y las redes neuronales clásicas funcionaban bastante bien en las predicciones a corto plazo, pero perdían estabilidad y precisión al intentar ampliar el horizonte más allá de unas pocas horas. El principal problema radicaba en que los factores temporales y espaciales se analizaban por separado. Y los intentos de combinarlos provocaban un aumento vertiginoso de los costes computacionales.
El framework Extralonger, que empezamos a conocer en el artículo anterior, propuso un enfoque radicalmente diferente. Sus autores partían de la idea de que el espacio y el tiempo deben considerarse como un todo único. Esta filosofía, que evoca la teoría de la relatividad de Einstein, se materializó en Unified Spatial-Temporal Representation: una representación en la que las series temporales y las relaciones espaciales se integran sin una separación artificial. Esta solución permitió reducir drásticamente la complejidad computacional. Allí donde antes las operaciones crecían de forma exponencial, Extralonger las redujo a dependencias cuadráticas. El efecto práctico resultó impresionante. Una aceleración del entrenamiento del orden de cientos de veces, una reducción de varias veces en el consumo de memoria y, lo más importante, la posibilidad de elaborar previsiones no de unas horas, sino de días enteros e incluso semanas.
Esto abre nuevas perspectivas para los mercados financieros. Allí donde los traders y analistas tradicionalmente se limitaban a evaluaciones a corto plazo, ahora surge la posibilidad de anticiparse a varias sesiones de negociación o de pronosticar el movimiento de los mercados en torno a la publicación de datos macroeconómicos y las decisiones de los bancos centrales. Extralonger convierte la previsión semanal, antes inalcanzable, en una herramienta utilizable en la práctica.
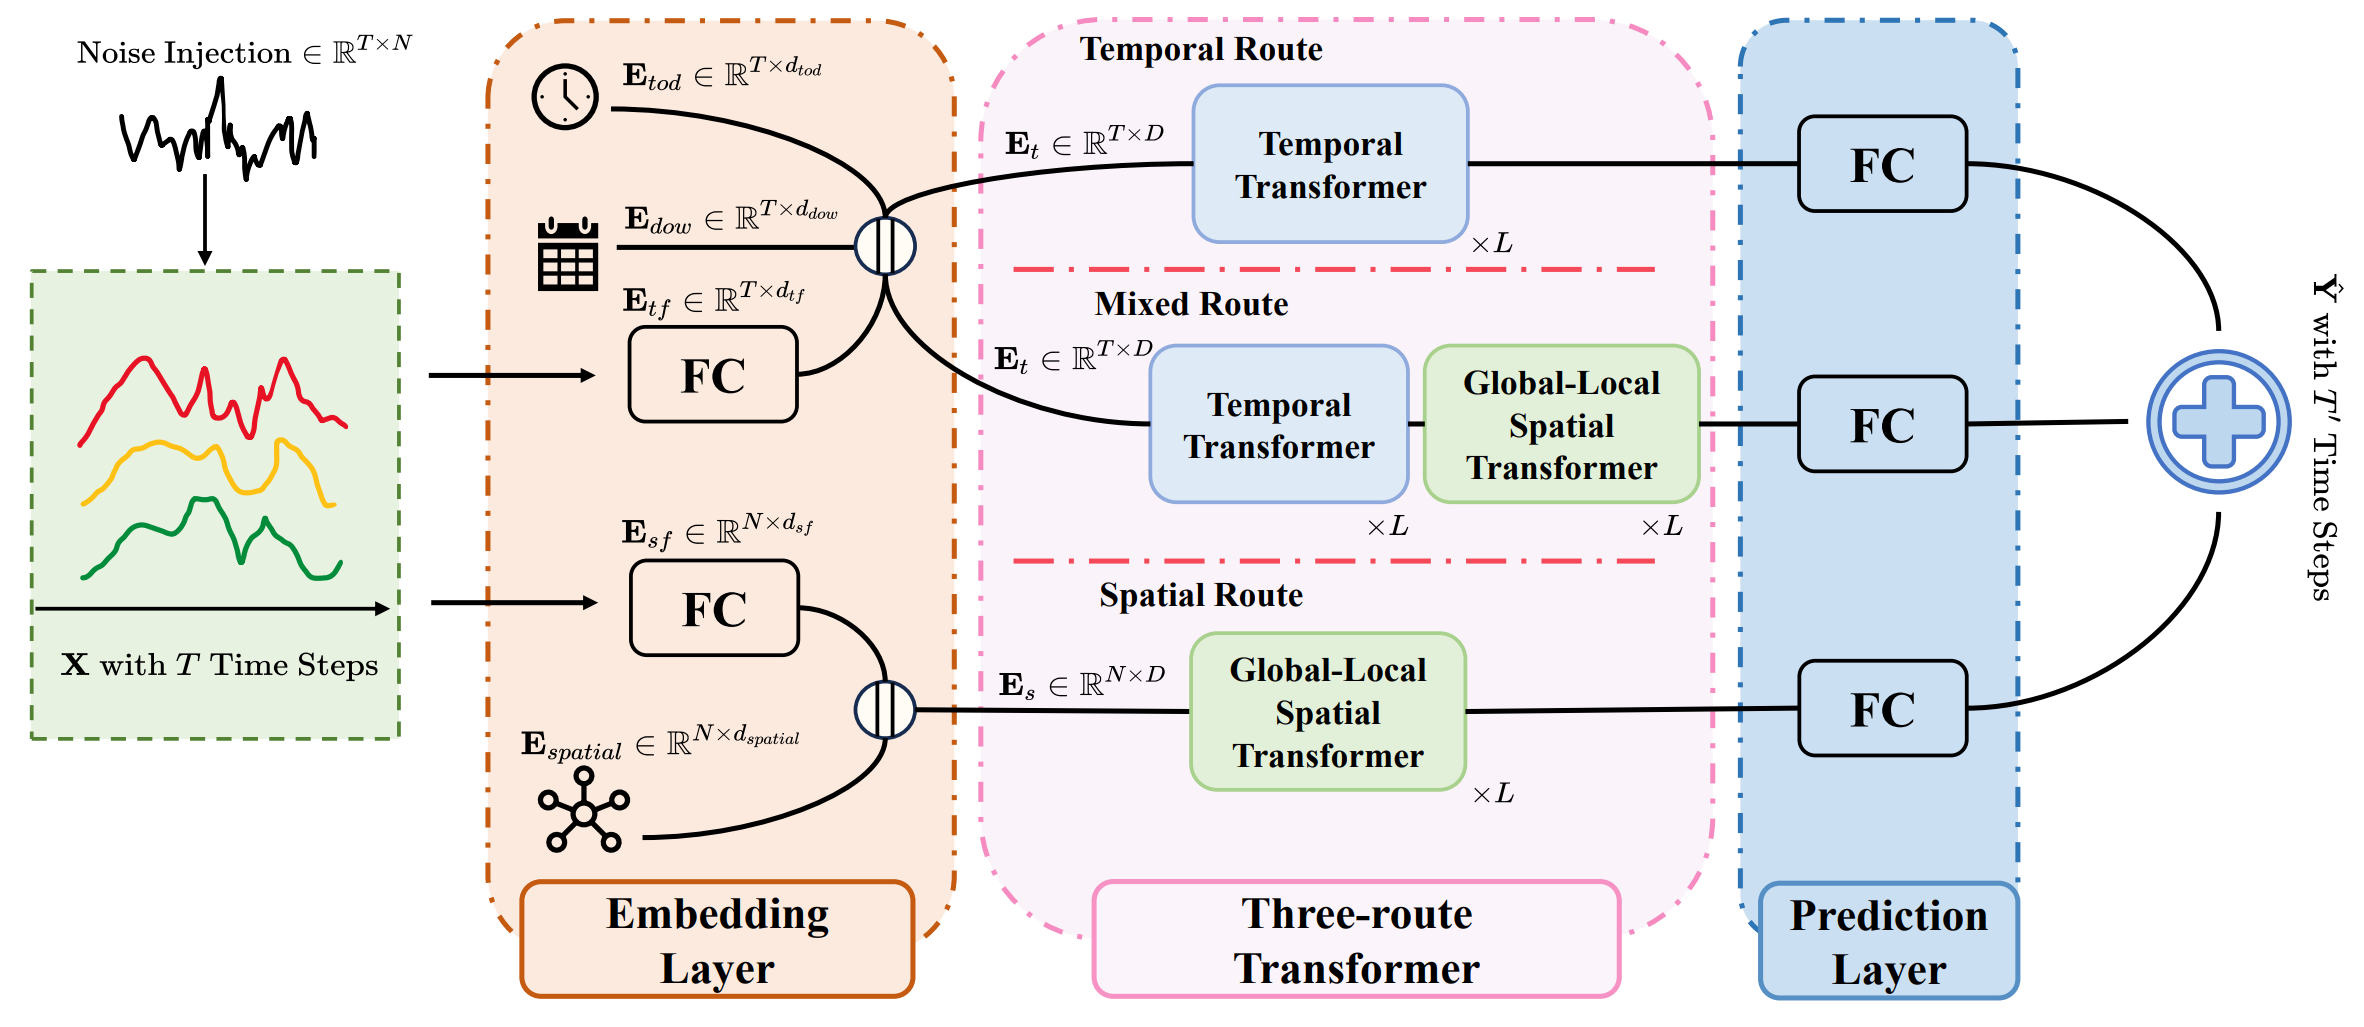
Sin embargo, la verdadera potencia del framework se revela a través de su arquitectura. Se basa en un Transformer de tres ramas, cada una de las cuales se encarga de un aspecto concreto del análisis.
La rama temporal se puede comparar con un analista macroeconómico. Analiza los ritmos del mercado, identifica los ciclos de crecimiento y recesión, y detecta la estacionalidad y los patrones recurrentes. Mediante el mecanismo Self-Attention, el modelo relaciona segmentos distantes de la serie temporal. El movimiento actual del par de divisas podría ser una continuación de la tendencia que comenzó hace un mes.
La rama espacial desempeña la función de especialista en relaciones entre mercados. En los mercados financieros, ningún activo existe de forma aislada. La evolución del precio del oro se refleja en los índices bursátiles. El tipo de cambio del dólar influye en los mercados de materias primas. Y las rentabilidades de los bonos marcan la pauta para las acciones. Extralonger lo tiene en cuenta mediante el Global-Local Spatial Transformer, que combina dos enfoques: el global, en el que cada valor está conectado con todos los demás, y el local, en el que el énfasis se pone en grupos de activos vinculados por sector o región.
La rama mixta es la que más se aproxima al papel de gestor de carteras. Su objetivo es unir la dinámica temporal y las relaciones espaciales en una versión unificada. Gracias a ello, el modelo percibe el mercado de forma integral. El aumento de la volatilidad en el sector tecnológico, acompañado de variaciones en los precios del petróleo y fluctuaciones de los tipos de interés, no es para el modelo un conjunto de hechos aleatorios, sino una señal de que se está gestando un escenario de mercado de gran envergadura.
La previsión final surge en el punto de intersección de las tres ramas. Al igual que en un comité de inversiones, en el que cada experto aporta su contribución, Extralonger sintetiza las conclusiones de todos los componentes en una decisión ponderada. Como resultado, el modelo obtiene no solo profundidad local de análisis y cobertura de las relaciones globales, sino también una percepción integral de los procesos del mercado a lo largo del tiempo.
Esta estructura hace que el framework resulte especialmente valioso para las aplicaciones financieras. Combina la profundidad del análisis de series temporales, la amplitud de la cobertura de las relaciones entre mercados y la integridad de la percepción. Gracias a ello, Extralonger es capaz de generar pronósticos robustos allí donde otros modelos pierden precisión o requieren recursos excesivos.
A continuación se muestra una visualización del framework Extralonger realizada por el autor.
En la parte práctica del artículo anterior dimos los primeros pasos para implementar los enfoques propuestos mediante MQL5. Se desarrolló un módulo de codificación espacial que permite trabajar con las interrelaciones entre instrumentos, y también se presentaron bloques independientes del programa OpenCL para la codificación temporal. Estos avances se convirtieron en la base sobre la que podemos construir una versión de ingeniería completa del framework.
Hoy continuamos esta labor, avanzando hacia la implementación práctica de las ideas de Extralonger. Nuestro objetivo es trasladar, paso a paso, la arquitectura propuesta por los autores al entorno MQL5, garantizando su viabilidad con datos financieros reales.
Embedding temporal
Seguimos trabajando en la construcción de los algoritmos del framework Extralonger mediante MQL5. En el artículo anterior analizamos en detalle los kernels de OpenCL del programa, que añaden embeddings temporales a los datos originales. Ahora pasamos a organizar este proceso en el lado del programa principal. Para ello, creamos un nuevo objeto CNeuronTempEmbedding, que hereda la funcionalidad básica de la clase CNeuronBaseOCL.
class CNeuronTempEmbedding    : public CNeuronBaseOCL
  {
protected:
   uint              iWindow;
   uint              iUnits;
   uint              aiEmbeddingDim[2];
   uint              aiFrames[2];
   uint              aiPeriod[2];
   CParams           caEmbeddings[2];
   //---
   virtual bool      ConcatByLabel(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput);
   virtual bool      ConcatByLabelGrad(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override {return false;}
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override {return false;}
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                        CBufferFloat *SecondInput,
                                        CBufferFloat *SecondGradient,
                                        ENUM_ACTIVATION SecondActivation = None
                                       ) override;

public:
                     CNeuronTempEmbedding(void) {};
                    ~CNeuronTempEmbedding(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window,
                          uint embed_dim1, uint period1, uint frame1,
                          uint embed_dim2, uint period2, uint frame2,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronTempEmbedding;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
  };
Los parámetros principales del objeto incluyen el número de características analizadas iWindow, la longitud de la secuencia iUnits, las dimensiones del embedding aiEmbeddingDim, el tamaño de un paso iFrames y los periodos de repetición aiPeriod. Todo esto se define mediante arrays, lo que hace que el objeto sea flexible y configurable para distintas escalas temporales de los datos financieros.
La arquitectura del objeto se define en el método Init, que se encarga de inicializar todos los parámetros clave de la capa de codificación temporal y sus componentes internos.
bool CNeuronTempEmbedding::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                uint units, uint window,
                                uint embed_dim1, uint period1, uint frame1,
                                uint embed_dim2, uint period2, uint frame2,
                                ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl,
                            (window + embed_dim1 + embed_dim2)*units, optimization_type, batch))
      return false;
En el primer paso se llama a la inicialización de la clase padre CNeuronBaseOCL. Aquí se definen las características principales de la capa y se inicializan las interfaces heredadas. Si la inicialización básica falla, la función devuelve false, lo que impide que se siga creando un objeto incorrecto.
A continuación, se inicializan dos componentes caEmbeddings, que generan embeddings temporales de los datos. Cada embedding se crea teniendo en cuenta su dimensión (embed_dim1 y embed_dim2) y su periodo de repetición (period1 y period2). Esto permite al modelo captar patrones temporales con diferentes escalas y profundidades de análisis, lo cual resulta especialmente importante al trabajar con la dinámica de los mercados financieros.
   if(!caEmbeddings[0].Init(0, 0, OpenCL, embed_dim1 * period1, optimization, iBatch))
      return false;
   if(!caEmbeddings[1].Init(0, 1, OpenCL, embed_dim2 * period2, optimization, iBatch))
      return false;
Tras inicializar correctamente los componentes de embedding, los parámetros del objeto se guardan en variables internas. Estos parámetros definen la estructura de la capa temporal y controlan cómo la neurona percibe el mercado a lo largo del tiempo.
   iWindow = window;
   iUnits = units;
   aiEmbeddingDim[0] = embed_dim1;
   aiEmbeddingDim[1] = embed_dim2;
   aiFrames[0] = MathMax(1, frame1);
   aiFrames[1] = MathMax(1, frame2);
   aiPeriod[0] = period1;
   aiPeriod[1] = period2;
//---
   return true;
  }
Al final, el método devuelve true, confirmando la creación correcta de un objeto completamente listo para funcionar.
El método feedForward implementa la propagación directa de la señal a través de una capa. En primer lugar, se comprueba si el objeto se encuentra en modo de entrenamiento (bTrain==true). En ese caso, se realiza una pasada directa propia para cada componente de embedding. Este paso permite formar un tensor de características temporales para captar las regularidades en diferentes escalas temporales. Si no se puede procesar al menos un embedding, la función devuelve false, lo que evita que se sigan propagando datos incorrectos.
bool CNeuronTempEmbedding::feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)
  {
   if(bTrain)
      for(uint i = 0; i < caEmbeddings.Size(); i++)
         if(!caEmbeddings[i].FeedForward())
            return false;
//---
   return ConcatByLabel(NeuronOCL, SecondInput);
  }
Tras completar correctamente la pasada directa de los componentes de embedding, los datos se combinan mediante el método ConcatByLabel, que es un envoltorio del kernel correspondiente del programa OpenCL. Aquí, las características temporales se integran cuidadosamente con los datos originales. En definitiva, el objeto genera una señal lista para su procesamiento, en la que se combinan los datos históricos y las observaciones actuales del mercado, lo que garantiza la precisión y la sensibilidad del modelo ante la dinámica del mercado financiero.
Como se puede observar, el método de pasada directa se ha implementado de forma bastante sencilla y lineal. Del mismo modo, los métodos de pasada inversa y de actualización de gradientes no presentan dificultad y siguen la lógica del entrenamiento estándar de las redes neuronales; por lo tanto, para comprenderlos mejor, se puede estudiar su funcionamiento por cuenta propia. El código fuente completo de la clase CNeuronTempEmbedding y de todos sus métodos se presenta en el archivo adjunto, lo que permitirá examinar en detalle la implementación y la integración de este objeto en la cadena de cálculo del modelo.
Objeto de atención
Tras preparar los embeddings temporales e integrarlos con los datos originales, pasamos a la siguiente fase del trabajo: la implementación de los algoritmos del módulo Global-Local Spatial Attention. Antes de empezar a programar, es importante analizar el enfoque propuesto por los autores del framework.
La idea principal consiste en combinar la atención global, característica de la Self-Attention clásica, con un foco local implementado mediante una matriz de adyacencia. Este enfoque recuerda a los métodos de convolución de grafos con los que ya nos hemos encontrado anteriormente, pero en este caso se ha adaptado a la estructura espacio-temporal de los datos.
Los autores del artículo no proporcionan información detallada sobre la construcción de la matriz de adyacencia. Para subsanar esta carencia, utilizamos el algoritmo Significant Neighbors Sampling del framework SAGDFN. Con su ayuda se crea una matriz de adyacencia dispersa, lo que permite ahorrar considerablemente recursos computacionales y, al mismo tiempo, conserva la capacidad del modelo para tener en cuenta las dependencias locales significativas. Cabe señalar que este enfoque introduce algunas particularidades en la implementación del proceso, ya que trabajar con una matriz dispersa requiere un manejo cuidadoso de los índices y los flujos de cálculo.
Implementación del lado del contexto de OpenCL
Al trasladar los algoritmos a un programa de OpenCL, nos enfrentamos a dos retos importantes que influyen directamente en la velocidad y la precisión del análisis de los datos de mercado. La primera es la ejecución secuencial de Global- y Local-Attention, lo que reduce el rendimiento general del modelo y ralentiza el procesamiento de grandes flujos de cotizaciones históricas. La segunda tarea es aún más delicada: cómo coordinar los flujos de Global-Attention completa con una matriz de adyacencia dispersa, para no perder información importante sobre las relaciones locales entre los niveles de precios. De la calidad de este ajuste depende directamente la capacidad del modelo para reconocer con eficacia patrones de mercado complejos.
La solución a ambas tareas resultó ser sorprendentemente sencilla. Siguiendo el principio de la atención multicabeza, hemos distribuido los cálculos entre flujos independientes, lo que permite al modelo analizar simultáneamente distintos aspectos de los datos de mercado. Por supuesto, esto requirió una ramificación del algoritmo en función de la cabeza de atención concreta. Sin embargo, este enfoque ha permitido mantener la velocidad y la precisión en el procesamiento de grandes series históricas, lo cual es fundamental para detectar a tiempo los patrones del mercado.
Una vez resueltos los aspectos relacionados con la arquitectura de ejecución de Global- y Local-Attention en el marco de los flujos paralelos de un mismo kernel, ha llegado el momento de pasar a la implementación práctica del algoritmo de pasada directa. Lo hemos implementado en el kernel GlobalLocalAttention. Cada línea aquí representa un paso del modelo en el análisis de datos históricos y la identificación de señales significativas.
__kernel void GlobalLocalAttention(__global const float *q,
                                   __global const float2* kv,
                                   __global float *scores,
                                   __global const float* mask,
                                   __global const float* label,
                                   __global float *out,
                                   const int dimension,
                                   const int total_kv,
                                   const int total_mask
                                  )
  {
//--- init
   const int q_id = get_global_id(0);
   const int local_id = get_local_id(1);
   const int h_id = get_global_id(2);
   const int total_q = get_global_size(0);
   const int total_local = get_local_size(1);
   const int total_heads = get_global_size(2);
//---
   __local float temp[LOCAL_ARRAY_SIZE];
El kernel recibe todos los datos clave:
- los vectores de consulta q: nuestras actuales consultas de mercado,
- los pares clave-valor kv: patrones históricos y sus resultados,
- una máscara y etiquetas para las restricciones locales,
- los parámetros para las dimensiones del espacio de características y los volúmenes de datos.
En el cuerpo del kernel, el modelo determina primero quién es quién en el espacio tridimensional de tareas:
- q_id es una consulta concreta;
- local_id: flujo dentro del grupo que, en función de la cabeza de atención, apunta a un par clave-consulta o a una posición en la matriz de adyacencia dispersa:
- h_id: la cabeza de atención que analiza un aspecto concreto del mercado.
El array local sirve como búfer temporal para los cálculos intermedios, como la mesa de trabajo de un operador, donde se acumulan todos los resultados actuales antes de la evaluación final.
A continuación, determinamos el desplazamiento en memoria de la consulta analizada; es como encontrar la barra correspondiente en el gráfico para compararla con los movimientos históricos.
int shift_q = RCtoFlat(h_id, 0, total_heads, dimension, q_id);
Y organizamos la ramificación del algoritmo: las cabezas pares representan una visión global del mercado, en la que se evalúan los patrones clave en todo el conjunto histórico, mientras que las impares representan una visión local.
Para las cabezas de atención pares, calculamos las posiciones de las claves y los coeficientes de atención correspondientes. Es como marcar en el gráfico todos los niveles anteriores de soporte y resistencia para la consulta actual.
   if(h_id % 2 == 0)
     {
      const int shift_kv = RCtoFlat(h_id, 0, total_heads, dimension, local_id);
      const int shift_s = RCtoFlat(h_id / 2, local_id, total_heads / 2, total_kv + total_mask, q_id);
      float score = 0;
      if(local_id < total_kv)
        {
         //---
         for(int d = 0; d < dimension; d++)
            score += IsNaNOrInf(q[shift_q + d] * kv[shift_kv + d].s0, 0);
        }
      else
         score = MIN_VALUE;
      //--- norm score
      score = LocalSoftMax(score, 1, temp);
      if(local_id < total_kv)
         scores[shift_s] = score;
Calculamos la correlación entre la consulta actual y los datos históricos. Si el flujo no participa en el cálculo, le asignamos el valor mínimo para que no distorsione el panorama, como los operadores inactivos en el mercado. Después, normalizamos el peso de cada patrón. Es como sopesar la importancia de las señales: algunos niveles de precios influyen más, mientras que otros apenas se tienen en cuenta.
Ensamblaje final de la salida: multiplicamos los valores históricos por su importancia y los sumamos.
      //--- out
      for(int d = 0; d < dimension; d++)
        {
         float val = (local_id < total_kv ? kv[shift_kv + d].s1 * score : 0);
         val = LocalSum(val, 1, temp);
         if(local_id == 0)
            out[shift_q + d] = val;
        }
     }
En la salida obtenemos una señal para la consulta actual, lista para su análisis o para su uso en una estrategia de trading.
La segunda rama del algoritmo procesa las conexiones locales con la máscara correspondiente. Aquí, de hecho, trabajamos con una matriz de adyacencia dispersa, en la que muchos elementos faltan o no son relevantes para el análisis actual.
El algoritmo comienza comprobando si existe una conexión para el elemento local actual. La variable local kv_id indica la clave real con la que se debe calcular el coeficiente de atención. Si kv_id es menor que 0, significa que no hay ningún elemento correspondiente en la matriz dispersa y se omite el flujo. La máscara m filtra además las conexiones no válidas.
   else
     {
      int kv_id = -1;
      float score = 0;
      int shift_kv = -1;
      float m = 0;
      if(local_id < total_mask)
        {
         const int shift_s = RCtoFlat(h_id / 2, total_kv + local_id, total_heads / 2,
                                                        total_kv + total_mask, q_id);
         const int l = RCtoFlat(q_id, local_id, total_q, total_mask, 0);
         kv_id = IsNaNOrInf(label[l], -1);
         m = IsNaNOrInf(mask[l], 0);
         shift_kv = RCtoFlat(h_id, 0, total_heads, dimension, kv_id);
         if(kv_id >= 0)
            for(int d = 0; d < dimension; d++)
               score += IsNaNOrInf(q[shift_q + d] * kv[shift_kv + d].s0, 0);
         else
            score = MIN_VALUE;
        }
      else
         score = MIN_VALUE;
      //--- norm score
      score = LocalSoftMax(score * m, 1, temp);
      if(local_id < total_mask)
         scores[shift_s] = score;
Solo las conexiones locales existentes intervienen en el cálculo de los coeficientes de atención; al resto se les asigna el valor mínimo. Esto garantiza que la estructura dispersa no contamine el resultado y que el modelo se centre exclusivamente en los patrones locales relevantes.
La normalización mediante SoftMax tiene en cuenta la máscara para que la probabilidad total se distribuya únicamente entre los elementos locales reales.
Y, por último, generamos la salida de la consulta teniendo en cuenta únicamente aquellos patrones locales que realmente están presentes en la matriz dispersa.
      //--- out
      for(int d = 0; d < dimension; d++)
        {
         float val = (kv_id >= 0 ? IsNaNOrInf(kv[shift_kv + d].s1, 0) * score : 0);
         val = LocalSum(val, 1, temp);
         if(local_id == 0)
            out[shift_q + d] = val;
        }
     }
  }
El uso de una matriz dispersa hace imposible un algoritmo sencillo y universal para todas las cabezas de atención. La cabeza global funciona con una matriz densa: todos los elementos están presentes y los cálculos son directos. La cabeza local funciona con una estructura dispersa: faltan muchas conexiones, se necesitan comprobaciones de la máscara y de las etiquetas, filtrado de NaN/Inf y una lógica de suma independiente. Por eso, dentro de un mismo kernel de OpenCL, hubo que implementar dos algoritmos distintos, cada uno optimizado para su propio tipo de datos: uno para una matriz global densa y otro para una matriz local dispersa.
Una vez implementada la pasada directa, nos encontramos con una tarea mucho más compleja: la distribución de los gradientes de error. El kernel de OpenCL GlobalLocalAttentionGrad desempeña aquí el papel de un trader experimentado que vigila al mismo tiempo el panorama global y los patrones locales. Cada flujo dentro del kernel es como un analista independiente que recibe su propia sección del gráfico. No obstante, no se trata de un ámbito de trabajo reducido.
El significado de global_id varía aquí en función de la etapa concreta. Puede apuntar a Query, Key o Value. La funcionalidad cambia en cada etapa e indica el objeto que recibe el gradiente de error. Del mismo modo, cambia la funcionalidad de local_id, que define el flujo dentro del grupo, como un trader que analiza varios timeframes. Y h_id determina la cabeza de atención, es decir, el aspecto del mercado en el que se centra el analista.
Todos estos índices conforman una red de observación que permite distribuir con precisión los gradientes, como si distribuyéramos nuestra atención entre distintas cotizaciones para que ningún detalle pase desapercibido.
__kernel void GlobalLocalAttentionGrad(__global const float *q,
                                       __global float *q_gr,
                                       __global const float *kv,
                                       __global float *kv_gr,
                                       __global float *scores,
                                       __global const float *mask,
                                       __global const float *mask_gr,
                                       __global const float *label,
                                       __global float *out_gr,
                                       const int dimension,
                                       const int total_q,
                                       const int total_kv,
                                       const int total_mask
                                      )
  {
//--- init
   const int global_id = get_global_id(0);
   const int local_id = get_local_id(1);
   const int h_id = get_global_id(2);
   const int total_global = get_global_size(0);
   const int total_local = get_local_size(1);
   const int total_heads = get_global_size(2);
//---
   __local float temp[LOCAL_ARRAY_SIZE];
En el caso de las cabezas pares, que trabajan con una matriz densa global, el proceso se asemeja al análisis del mercado basado en datos históricos completos. En primer lugar, se calculan los gradientes de Value: cada flujo acumula la influencia de su posición en el resultado global, sumándola mediante LocalSum. Es como cuando un trader suma las señales de todas las velas históricas para comprender la tendencia general.
   if(h_id % 2 == 0)
     {
      //--- Gradiente de Value global_id -> v_id, local_id -> q_id
      for(int d = 0; d < dimension; d++)
        {
         const int shift_v = RCtoFlat(h_id, 2 * d + 1, total_heads, 2 * dimension, global_id);
         float grad = 0;
         for(int q_id = local_id; q_id < total_q; q_id += total_local)
           {
            int shift_s = RCtoFlat(h_id / 2, global_id, total_heads / 2, total_kv + total_mask, q_id);
            int shift_q = RCtoFlat(h_id, d, total_heads, dimension, q_id);
            grad += IsNaNOrInf(scores[shift_s] * out_gr[shift_q], 0);
           }
         grad = LocalSum(grad, 1, temp);
         kv_gr[shift_v] = grad;
        }
A continuación, se generan los gradientes de Query. Aquí es importante tener en cuenta la normalización SoftMax, de forma similar a como un analista evalúa la importancia de cada señal frente a las demás para que ningún ruido distorsione el panorama. Los gradientes de Query se suman cuidadosamente por flujos locales y se escriben en q_gr.
      //--- Gradiente de Query global_id -> q_id, local_id -> k_id/v_id
      if(global_id < total_q)
        {
         //--- 1. Gradiente de Score
         float grad_s = 0;
         const int shift_v = RCtoFlat(h_id, 1, total_heads, 2 * dimension, local_id);
         const int shift_s = RCtoFlat(h_id / 2, local_id, total_heads / 2,
                                          total_kv + total_mask, global_id);
         int shift_q = RCtoFlat(h_id, 0, total_heads, dimension, global_id);
         if(local_id < total_kv)
            for(int d = 0; d < dimension; d++)
               grad_s += IsNaNOrInf(kv[shift_v + 2 * d] * out_gr[shift_q + d], 0);
         //--- 2. Gradiente de SoftMax
         grad_s = LocalSoftMaxGrad(scores[shift_s], grad_s, 1, temp);
         //--- 3. Gradiente de Query
         const int shift_k = shift_v - 1;
         for(int d = 0; d < dimension; d++)
           {
            float grad = 0;
            if(local_id < total_kv)
               grad = kv[shift_k + 2 * d] * grad_s;
            grad = LocalSum(grad, 1, temp);
            if(local_id == 0)
               q_gr[shift_q + d] = grad;
           }
        }
Y Key obtiene los gradientes finales sumando las contribuciones de todas las consultas.
      //--- Gradiente de Key global_id -> k_id, local_id -> score_id/v_id/dimension
      if(global_id < total_kv)
        {
         float grad = 0;
         for(int q_id = 0; q_id < total_q; q_id++)
           {
            //--- 1. Gradiente de Score local_id -> score_id/v_id
            float grad_s = 0;
            const int shift_v = RCtoFlat(h_id, 1, total_heads, 2 * dimension, local_id);
            const int shift_s = RCtoFlat(h_id / 2, local_id, total_heads / 2,
                                                total_kv + total_mask, q_id);
            int shift_q = RCtoFlat(h_id, 0, total_heads, dimension, q_id);
            if(local_id < total_kv)
               for(int d = 0; d < dimension; d++)
                  grad_s += IsNaNOrInf(kv[shift_v + 2 * d] * out_gr[shift_q + d], 0);
            //--- 2. Gradiente de SoftMax
            grad_s = LocalSoftMaxGrad(scores[shift_s], grad_s, 1, temp);
            BarrierLoc;
            if(global_id == local_id)
               temp[0] = grad_s;
            BarrierLoc;
            grad_s = temp[0];
            //--- 3. Gradiente de Key local_id -> dimension
            shift_q = RCtoFlat(h_id, local_id, total_heads, dimension, q_id);
            if(local_id < dimension)
               grad += IsNaNOrInf(q[shift_q] * grad_s, 0);
           }
         const int shift_k = RCtoFlat(h_id, 2 * local_id, total_heads, 2 * dimension, global_id);
         if(local_id < dimension)
            kv_gr[shift_k] = IsNaNOrInf(grad);
        }
     }
En el caso de la matriz global, el proceso se desarrolla sin problemas, ya que todos los datos están presentes y el algoritmo puede distribuir los gradientes en paralelo.
Las cabezas impares que trabajan con una matriz dispersa local requieren del kernel de OpenCL una auténtica meticulosidad de trader. De forma similar al algoritmo presentado anteriormente, primero sumamos en un bucle los gradientes para Value procedentes de todas las Query. Solo que aquí primero comprobamos para cada uno si existe una conexión mediante la máscara y las etiquetas. Si no hay conexión, o si la máscara prohíbe el uso del elemento, el flujo Query se omite.
   else
     {
      //--- Gradiente de Value: global_id -> v_id, local_id -> mask_index/dimension
      if(global_id < total_kv)
        {
         float grad = 0;
         for(int q_id = 0; q_id < total_q; q_id++)
           {
            //--- 1. kv_id
            int kv_id = -1;
            float m = 0;
            const int l = RCtoFlat(q_id, local_id, total_q, total_mask, 0);
            const int shift_s = RCtoFlat(h_id / 2, total_kv + local_id, total_heads / 2,
                                                           total_kv + total_mask, q_id);
            //--- Comprobar si se usa el Value actual
            if(local_id < total_mask)
               kv_id = (int)label[l];
            if(local_id == 0)
               temp[0] = 0;
            BarrierLoc;
            if(kv_id == global_id)
               temp[0] = scores[shift_s];
            BarrierLoc;
            if(temp[0] == 0)
               continue;
El gradiente de Value solo se calcula para los elementos existentes. El coeficiente de atención se multiplica por el gradiente de salida correspondiente y se acumula.
            //--- Gradiente de Value
            int shift_q = RCtoFlat(h_id, local_id, total_heads, dimension, q_id);
            if(local_id < dimension)
               grad += IsNaNOrInf(temp[0] * out_gr[shift_q], 0);
           }
         const int shift_v = RCtoFlat(h_id, 2 * local_id + 1, total_heads, 2 * dimension, global_id);
         if(local_id < dimension)
            kv_gr[shift_v] = IsNaNOrInf(grad, 0);
        }
Los gradientes de Query se generan teniendo en cuenta SoftMax y la máscara, lo que permite filtrar las señales superfluas, del mismo modo que un trader ignora las barras ruidosas y los patrones falsos.
      //--- Gradiente de Query: global_id -> q_id, local_id -> etiqueta de máscara
      if(global_id < total_q)
        {
         //--- 1. kv_id;
         int kv_id = -1;
         float m = 0;
         const int l = RCtoFlat(global_id, local_id, total_q, total_mask, 0);
         if(local_id < total_mask)
           {
            kv_id = (int)IsNaNOrInf(label[l], -1);
            m = IsNaNOrInf(mask[l], 0);
           }
         //--- 2. Gradiente de Score
         float grad_s = 0;
         const int shift_v = RCtoFlat(h_id, 1, total_heads, 2 * dimension, kv_id);
         const int shift_s = RCtoFlat(h_id / 2, total_kv + local_id, total_heads / 2,
                                                   total_kv + total_mask, global_id);
         int shift_q = RCtoFlat(h_id, 0, total_heads, dimension, global_id);
         if(local_id < total_mask)
            for(int d = 0; d < dimension; d++)
               grad_s += IsNaNOrInf(kv[shift_v + 2 * d] * out_gr[shift_q + d], 0);
         //--- 3. Gradiente de SoftMax
         float score = IsNaNOrInf(scores[shift_s], 0);
         grad_s = LocalSoftMaxGrad(scores[shift_s], grad_s, 1, temp);
         mask_gr[l] = IsNaNOrInf(grad_s * score, 0);
         grad_s *= m;
         //--- 4. Gradiente de Query
         const int shift_k = shift_v - 1;
         for(int d = 0; d < dimension; d++)
           {
            float grad = 0;
            if(local_id < total_mask)
               grad = kv[shift_k + 2 * d] * grad_s;
            grad = LocalSum(grad, 1, temp);
            if(local_id == 0)
               q_gr[shift_q + d] = grad;
           }
        }
Los gradientes de Key se acumulan únicamente en aquellas consultas que realmente tienen una conexión con la clave, y la sincronización de flujos mediante BarrierLoc garantiza que no se pierda ninguna señal. Es como si un analista cotejara los resultados de sus compañeros antes de registrar definitivamente la operación. Cada cálculo refleja con exactitud la distribución real de la influencia en la matriz dispersa local y evita la contaminación de gradientes con datos superfluos.
      //--- Gradiente de Key global_id -> k_id, local_id -> score_id/v_id/dimension
      if(global_id < total_kv)
        {
         float grad = 0;
         for(int q_id = 0; q_id < total_q; q_id++)
           {
            //--- 1. kv_id;
            int kv_id = -1;
            float m = 0;
            const int l = RCtoFlat(global_id, local_id, total_q, total_mask, 0);
            if(local_id < total_mask)
              {
               kv_id = (int)label[l];
               if(kv_id == global_id)
                  m = mask[l];
              }
            m = LocalSum(m, 1, temp);
            if(m == 0)
               continue;
            //--- 2. Gradiente de Score local_id -> score_id/v_id
            float grad_s = 0;
            const int shift_v = RCtoFlat(h_id, 1, total_heads, 2 * dimension, kv_id);
            const int shift_s = RCtoFlat(h_id / 2, total_kv + local_id, total_heads / 2,
                                                           total_kv + total_mask, q_id);
            int shift_q = RCtoFlat(h_id, 0, total_heads, dimension, q_id);
            if(local_id < total_mask)
               for(int d = 0; d < dimension; d++)
                  grad_s += IsNaNOrInf(kv[shift_v + 2 * d] * out_gr[shift_q + d], 0);
            //--- 3. Gradiente de SoftMax
            grad_s = LocalSoftMaxGrad(scores[shift_s], grad_s, 1, temp);
            BarrierLoc;
            if(global_id == local_id)
               temp[0] = grad_s * m;
            BarrierLoc;
            grad_s = temp[0];
            //--- 4. Gradiente de Key local_id -> dimension
            shift_q = RCtoFlat(h_id, local_id, total_heads, dimension, q_id);
            if(local_id < dimension)
               grad += IsNaNOrInf(q[shift_q] * grad_s, 0);
           }
         const int shift_k = RCtoFlat(h_id, 2 * local_id, total_heads, 2 * dimension, global_id);
         if(local_id < dimension)
            kv_gr[shift_k] = IsNaNOrInf(grad);
        }
     }
  }
Dentro de un mismo kernel se han implementado dos algoritmos lógicamente distintos, ya que las matrices global y local requieren enfoques fundamentalmente diferentes. La matriz densa global permite calcular directamente los gradientes de todos los elementos, como si el trader pudiera ver el mercado en su totalidad. La matriz dispersa local requiere un filtrado, una sincronización y una suma minuciosos de únicamente los enlaces existentes. Al igual que un trader que analiza minuciosamente cada señal importante en un tramo concreto del gráfico. Esta división garantiza una distribución correcta y eficaz de los gradientes al realizar el entrenamiento del modelo con grandes series históricas, en las que coexisten simultáneamente densas dependencias globales y correlaciones locales poco frecuentes.
Cada acción del kernel es como un paso concreto del trader. La comprobación de la máscara y las etiquetas recuerda a la selección de niveles de precios realmente significativos. El filtrado de NaN e Inf equivale a ignorar los datos con ruido. La suma mediante LocalSum y la sincronización de flujos equivalen a la coordinación de los analistas para no perder señales importantes. Como resultado, el modelo obtiene gradientes precisos para Value, Query y Key, lo que le permite aprender a partir de datos históricos, reconocer patrones de mercado significativos y minimizar el error de predicción. El kernel transforma los cálculos abstractos en un proceso dinámico de análisis de mercado, en el que cada operación de gradiente refleja la atención y las acciones reales del analista, lo que garantiza la precisión y la estabilidad del entrenamiento.
El código completo de los kernels se incluye en el archivo adjunto.
Implementación en el programa principal
En el programa principal, el algoritmo Global-Local Spatial Attention se ha implementado cuidadosamente como un nuevo objeto CNeuronGlobalLocalAttention, que hereda la funcionalidad de la estructura feed-forward multicabeza CNeuronMHFeedForward. Este objeto reúne varios componentes clave, cada uno de los cuales desempeña una función estrictamente definida en la construcción de la atención.
class CNeuronGlobalLocalAttention   :  public CNeuronMHFeedForward
  {
protected:
   CNeuronSNSMHAttention   cMask;
   CNeuronConvOCL          cQ;
   CNeuronConvOCL          cKV;
   CNeuronBaseOCL          cScore;
   CNeuronBaseOCL          cMHAttention;
   CNeuronConvOCL          cW0;
   CNeuronBaseOCL          cResidual;
   //---
   virtual bool      GlobalLocalAttention(void);
   virtual bool      GlobalLocalAttentionGrad(void);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronGlobalLocalAttention(void) {};
                    ~CNeuronGlobalLocalAttention(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint dimension_k,
                          uint heads, uint m_units, float sparse,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronGlobalLocalAttention;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
  };
Dentro de la clase hay un objeto cMask, encargado de gestionar las máscaras de conexiones locales, lo que permite trabajar correctamente con una matriz dispersa y filtrar los patrones locales irrelevantes. Los dos objetos de convolución cQ y cKV realizan las transformaciones de las consultas y de los pares clave-valor, respectivamente, preparando los datos para el cálculo de los coeficientes de atención. El elemento cScore acumula los resultados de las puntuaciones, mientras que cMHAttention recopila los resultados de la atención multicabeza, combinando los componentes globales y locales. Por último, cW0 y cResidual se encargan de la transformación lineal y de añadir la conexión residual, lo que garantiza la estabilidad y la corrección de la actualización de las señales de salida. La funcionalidad del bloque FeedForward se implementa mediante la clase padre.
El método Init se encarga de preparar completamente la neurona para su funcionamiento y establece todos los parámetros clave para el algoritmo Global-Local Spatial Attention. En primer lugar, se invoca la inicialización de la clase base CNeuronMHFeedForward. Aquí se configuran todos los parámetros principales del objeto.
bool CNeuronGlobalLocalAttention::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                       uint units, uint window, uint dimension_k,
                                       uint heads, uint m_units, float sparse,
                                       ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronMHFeedForward::Init(numOutputs, myIndex, open_cl, window, 2 * window, units,
                                                      1, heads, optimization_type, batch))
      return false;
   activation = None;
Si en esta fase algo falla, la sesión de trading no se inicia: el objeto no se inicializa, lo que evita cualquier cálculo incorrecto.
A continuación, desactivamos la función de activación, como si el trader decidiera operar sin filtros emocionales, confiando plenamente en las señales directas del mercado.
Lo primero que entra en escena es cMask. Gestiona las máscaras locales: filtra los patrones dispersos para que el trader no se distraiga con señales insignificantes. Con su ayuda, el modelo entiende qué relaciones locales son importantes y cuáles se pueden ignorar.
   int index = 0;
   if(!cMask.Init(0, index, OpenCL, units, window, heads, m_units, sparse, optimization, iBatch))
      return false;
A continuación, se forman cQ y cKV, que transforman los datos brutos en señales analíticas comprensibles. cQ procesa las consultas, igual que un trader evalúa las posiciones actuales en el mercado, mientras que cKV acumula claves y valores, de forma similar a como recopila información sobre velas anteriores y niveles de soporte y resistencia. En ambos bloques se ha desactivado la función de activación para que las líneas de análisis se mantengan nítidas y lineales, sin distorsiones.
   index++;
   if(!cQ.Init(0, index, OpenCL, window, window, 2 * dimension_k * heads, units, 1,
                                                             optimization, iBatch))
      return false;
   cQ.SetActivationFunction(None);
   index++;
   if(!cKV.Init(0, index, OpenCL, window, window, 4 * dimension_k * heads, units, 1,
                                                              optimization, iBatch))
      return false;
   cKV.SetActivationFunction(None);
A continuación, se activa cScore, que acumula las puntuaciones obtenidas, de forma similar a como un trader suma las señales de todos los indicadores para determinar dónde conviene apostar.
   index++;
   if(!cScore.Init(0, index, OpenCL, (units + m_units)*units * heads, optimization, iBatch))
      return false;
   cScore.SetActivationFunction(None);
   index++;
   if(!cMHAttention.Init(0, index, OpenCL, 2 * dimension_k * heads * units, optimization, iBatch))
      return false;
   cMHAttention.SetActivationFunction(None);
A partir de estas puntuaciones funciona cMHAttention, un sistema de atención multicabeza que distribuye los recursos entre distintos instrumentos y distintos intervalos temporales. Exactamente igual que un analista con experiencia decide a qué prestar la máxima atención en la situación actual del mercado.
La cadena la completan cW0 y cResidual. El primero realiza una transformación lineal de las señales, de forma similar a como un trader ajusta sus cálculos teniendo en cuenta el volumen y la liquidez actuales del mercado.
   index++;
   if(!cW0.Init(0, index, OpenCL, 2 * dimension_k * heads, 2 * dimension_k * heads,
                                           window, units, 1, optimization, iBatch))
      return false;
   cW0.SetActivationFunction(None);
   index++;
   if(!cResidual.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
      return false;
   cResidual.SetActivationFunction(None);
//---
   return true;
  }
El segundo añade una conexión residual, garantizando que no se pierda la información sobre los pasos anteriores del entrenamiento y que la señal se mantenga estable, como comprobar las posiciones de operaciones anteriores antes de abrir una nueva.
Cada bloque recibe su propio índice y sus propios parámetros, se vincula al contexto de OpenCL y queda listo para funcionar en conjunto. Todo esto se asemeja a un equipo bien coordinado de traders y analistas: uno filtra las señales, otro evalúa las tendencias, un tercero acumula los resultados y un cuarto distribuye su atención entre los distintos instrumentos. En definitiva, una vez finalizada la inicialización, el objeto está totalmente listo para funcionar y es capaz de analizar simultáneamente los patrones globales y locales del mercado, filtrar el ruido y tomar decisiones precisas basadas en datos históricos.
Una vez inicializado el objeto y configurados todos los bloques, llega la etapa de la pasada directa: el momento en que el modelo realmente observa el mercado y elabora sus previsiones. El método feedForward establece una secuencia clara de acciones, en la que cada componente desempeña una función estrictamente definida y los datos pasan por toda la cadena de transformaciones, lo que recuerda el funcionamiento de un equipo bien coordinado de traders.
bool CNeuronGlobalLocalAttention::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cMask.FeedForward(NeuronOCL))
      return false;
En primer lugar, se activa cMask, que comprueba y filtra las conexiones locales. Es como un trader que selecciona cuidadosamente solo aquellas señales que realmente tienen importancia, ignorando los patrones ruidosos o inexistentes. Si algo falla en este punto, no es posible continuar con el análisis: el modelo no elaborará una previsión a partir de datos incorrectos.
A continuación, se ejecutan sucesivamente cQ y cKV. El primero procesa las consultas, preparándolas para compararlas con las claves, del mismo modo que un analista evalúa las posiciones actuales del mercado y elabora una lista de posibles puntos de entrada.
   if(!cQ.FeedForward(NeuronOCL))
      return false;
   if(!cKV.FeedForward(NeuronOCL))
      return false;
El segundo acumula claves y valores, como si recopilara el historial de cotizaciones y los volúmenes de operaciones de cada instrumento, creando así una base para evaluar el impacto de cada señal.
Una vez finalizada con éxito la fase de trabajo preparatorio, se invoca el método envoltorio GlobalLocalAttention, en el que se organiza el proceso de puesta en cola para la ejecución del kernel de OpenCL del mismo nombre, que ejecuta el algoritmo principal en el contexto de OpenCL.
   if(!GlobalLocalAttention())
      return false;
Aquí, las consultas y las claves se combinan en la atención global y local. Aquí es donde entra en juego la magia del modelo: cada patrón se evalúa teniendo en cuenta todas las conexiones relevantes, tanto dispersas como densas, y las aportaciones se suman con precisión en todas las cabezas de atención.
Esta etapa es similar al momento en el que el trader compara las señales actuales con los datos históricos y decide a qué posiciones debe prestar mayor atención.
Luego se ejecuta cW0, que aplica una transformación lineal a los resultados de la atención multicabeza. Esto puede entenderse como un ajuste de las señales que tiene en cuenta el tamaño del mercado, la liquidez y la ponderación de cada patrón.
   if(!cW0.FeedForward(cMHAttention.AsObject()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getOutput(), cW0.getOutput(), cResidual.getOutput(),
                       cW0.GetFilters(), true, 0, 0, 0, cW0.GetUnits()))
      return false;
//---
   return CNeuronMHFeedForward::feedForward(cResidual.AsObject());
  }
A continuación, los datos pasan por la función SumAndNormalize. En ella se suman las salidas del bloque lineal y de la conexión residual, y a continuación se normalizan. Este paso garantiza que la señal se mantenga estable y sea escalable, como si el trader hubiera reunido los resultados de varios analistas, comprobado su coherencia y evaluado la solidez general de la señal antes de tomar una decisión.
Por último, la señal actualizada se transmite al método del mismo nombre de la clase padre CNeuronMHFeedForward, que finaliza la pasada directa ejecutando la funcionalidad del bloque FeedForward e integrando los resultados en la estructura general del modelo.
De este modo, todo el proceso de pasada directa puede concebirse como un análisis secuencial del mercado, en el que cada bloque desempeña su función: filtra, evalúa, acumula, corrige y suma los datos, garantizando la precisión y la coherencia de las previsiones.
Una vez que el modelo ha completado con éxito una pasada directa y ha generado una predicción, llega la fase de entrenamiento: el momento en el que la neurona evalúa con qué precisión ha funcionado y ajusta sus parámetros internos. El método calcInputGradients se encarga de esta evaluación y de distribuir la influencia cuantificada de cada componente del modelo en el resultado final.
bool CNeuronGlobalLocalAttention::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
   if(!CNeuronMHFeedForward::calcInputGradients(cResidual.AsObject());)
      return false;
En primer lugar, se comprueba que el puntero recibido al objeto de datos de origen NeuronOCL sea correcto. Si no existe el objeto, no es posible realizar cálculos posteriores, como si el trader intentara analizar los datos sin gráficos ni cotizaciones.
Después se invoca el método homónimo de la clase padre, que inicia el proceso de retropropagación de los gradientes hasta el nivel del objeto de conexiones residuales.
A continuación, se invoca el método DeActivation para el bloque cW0, donde los gradientes obtenidos se corrigen teniendo en cuenta la función de activación de la capa lineal. Es similar a la forma en que un analista tiene en cuenta la influencia de cada indicador en la decisión final, filtrando y normalizando las señales.
   if(!DeActivation(cW0.getOutput(), cW0.getGradient(), cResidual.getGradient(), cW0.Activation()))
      return false;
Luego los gradientes se transmiten a cMHAttention, donde se acumula la influencia de cada patrón de atención multicabeza.
   if(!cMHAttention.CalcHiddenGradients(cW0.AsObject()))
      return false;
   if(!GlobalLocalAttentionGrad())
      return false;
En esta fase se invoca GlobalLocalAttentionGrad, que garantiza una distribución precisa de los gradientes entre las matrices global y local, teniendo en cuenta las conexiones dispersas y densas, como si un trader evaluara la contribución de cada vela y cada nivel de soporte a la tendencia general. Y los gradientes se propagan cuidadosamente a los bloques cQ y cKV.
A continuación, tendremos que recopilar los gradientes de error a nivel de los datos de origen procedentes de todos los flujos de información. Y son cuatro. Primero, propagamos los gradientes desde cQ.
   if(!NeuronOCL.CalcHiddenGradients(cQ.AsObject()))
      return false;
Sumamos los valores obtenidos con los gradientes del tronco de las conexiones residuales, pero antes ajustamos estos últimos según la función de activación de la capa de datos de origen.
   if(!DeActivation(cResidual.getOutput(), cResidual.getGradient(),
                    cResidual.getGradient(), NeuronOCL.Activation()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), cResidual.getGradient(), cResidual.getGradient(),
                       cW0.GetFilters(), false, 0, 0, 0, cW0.GetUnits()))
      return false;
El siguiente paso consiste en procesar los gradientes cKV y añadirlos posteriormente a los datos acumulados anteriormente.
   if(!NeuronOCL.CalcHiddenGradients(cKV.AsObject()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), cResidual.getGradient(), cResidual.getGradient(),
                       cW0.GetFilters(), false, 0, 0, 0, cW0.GetUnits()))
      return false;
Por último en orden, pero no en importancia, propagamos los gradientes de las máscaras locales cMask. También sumamos su influencia a los datos acumulados anteriormente.
   if(!NeuronOCL.CalcHiddenGradients(cMask.AsObject()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), cResidual.getGradient(), NeuronOCL.getGradient(),
                       cW0.GetFilters(), false, 0, 0, 0, cW0.GetUnits()))
      return false;
//---
   return true;
  }
Como resultado, el método calcInputGradients ofrece una evaluación exhaustiva y detallada del impacto de todos los componentes del modelo, desde las cabezas de atención globales y locales hasta las consultas, las claves, los valores y las máscaras. Cada bloque recibe retroalimentación cuantitativa, lo que permite al modelo actualizar correctamente los pesos, minimizar el error y mejorar la precisión de las predicciones. Este proceso convierte los cálculos abstractos de gradientes en una evaluación real de la importancia de cada elemento del sistema, haciendo que el entrenamiento sea lo más transparente y controlable posible.
Una vez que el modelo ha evaluado la influencia de cada componente mediante la propagación inversa de gradientes, llega el momento de actuar: ajustar los parámetros internos y adaptar el modelo a los datos reales del mercado. El método updateInputWeights se encarga precisamente de esta tarea.
bool CNeuronGlobalLocalAttention::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cMask.UpdateInputWeights(NeuronOCL))
      return false;
   if(!cQ.UpdateInputWeights(NeuronOCL))
      return false;
   if(!cKV.UpdateInputWeights(NeuronOCL))
      return false;
   if(!cW0.UpdateInputWeights(cMHAttention.AsObject()))
      return false;
//---
   return CNeuronMHFeedForward::updateInputWeights(cResidual.AsObject());
  }
El algoritmo del método es, en realidad, muy sencillo: transfiere de forma secuencial el control a los componentes internos que contienen parámetros entrenables. En primer lugar, se actualizan los pesos de las máscaras locales cMask; a continuación, se ajustan los parámetros de las consultas cQ y del par clave-valor cKV. Posteriormente, se actualizan los pesos de la transformación lineal cW0. Al final se ajustan los parámetros de la clase padre.
Cada paso es un proceso sencillo, pero importante: el modelo ajusta sus parámetros para evaluar el mercado con mayor precisión y elaborar predicciones, mientras que todos los bloques actúan de forma coordinada, como un equipo de traders que trabajan siguiendo una estrategia común.
Hemos realizado un volumen considerable de trabajo y hemos resuelto numerosas tareas. Ahora es el momento ideal para hacer una pequeña pausa, recuperar el aliento y reflexionar sobre los resultados. En el próximo artículo, con energías renovadas y una nueva perspectiva, continuaremos con el trabajo y lo llevaremos hasta su conclusión lógica.
Conclusión
Hemos recorrido un largo camino: cada bloque del algoritmo Global-Local Spatial Attention se ha integrado minuciosamente y se ha organizado en una cadena de cálculos unificada. La pasada directa, la distribución de gradientes y la actualización de los parámetros del modelo: todo ello recordaba el trabajo de un trader experimentado que filtra las señales, evalúa la influencia de cada instrumento y ajusta las posiciones para obtener un resultado óptimo.
El enfoque implementado con MQL5 ha demostrado cómo se pueden adaptar los complejos algoritmos de atención a la práctica, convirtiendo cálculos abstractos en previsiones precisas y controlables. Cada bloque del modelo, al igual que un analista independiente, ha contribuido a la decisión final, garantizando la flexibilidad, la estabilidad y la escalabilidad de todo el sistema.
La siguiente etapa supondrá la comprobación final de nuestro trabajo: completaremos el modelo de forma lógica, lo probaremos con datos reales del mercado y evaluaremos la eficacia práctica del framework propuesto.
Enlaces
- Extralonger: Toward a Unified Perspective of Spatial-Temporal Factors for Extra-Long-Term Traffic Forecasting
- Otros artículos de la serie
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | Study.mq5 | Asesor experto | Asesor experto para el entrenamiento offline de modelos |
| 2 | StudyOnline.mq5 | Asesor experto | Asesor experto para entrenamiento online de modelos |
| 3 | Test.mq5 | Asesor experto | Asesor experto para probar el modelo |
| 4 | Trajectory.mqh | Biblioteca de clases | Estructura de la descripción del estado del sistema y de la arquitectura de los modelos |
| 5 | NeuroNet.mqh | Biblioteca de clases | Biblioteca de clases para crear una red neuronal |
| 6 | NeuroNet.cl | Biblioteca | Biblioteca de código del programa OpenCL |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19538
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Utilizando redes neuronales en MetaTrader
 Características del Wizard MQL5 que debe conocer (Parte 78): Estrategias con Gator y el oscilador AD para la resiliencia del mercado
 Particularidades del trabajo con números del tipo double en MQL4
 Del básico al intermedio: Indicadores técnicos (I)

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso