

Marktsimulation (Teil 22): Erste Schritte mit SQL (V)
 63
 0

Einleitung
Hallo und herzlich willkommen zu einem weiteren Artikel der Reihe darüber, wie man ein Replikations-/Simulationssystem aufbaut.
Im vorherigen Artikel „Marktsimulation (Teil 21): Erste Schritte in SQL (IV)“ haben wir in abstrakter Form erläutert, wie man eine relationale Datenbank von einer nichtrelationalen unterscheiden kann. Doch zunächst einmal (und das war der Grund für den vorherigen Artikel) haben wir versucht zu zeigen, wie man die Funktionsweise einer Datenbank verstehen kann. Dies geschah, damit Sie verstehen, dass es zwar sinnvoll erscheinen mag, bestimmte Dinge selbst zu programmieren, in manchen Fällen jedoch eine bereits vorhandene Implementierung genutzt werden kann, um das erwartete Ergebnis in einer Anwendung zu erzielen.
Genau aus diesem Grund widmen wir uns der Erläuterung von SQL, anstatt in MQL5 zu programmieren. Wir müssen hier ein wenig für Ausgleich sorgen, damit alle verstehen, warum wir SQL verwenden, obwohl wir auch immer mehr Routinen erstellen könnten, um eine bestimmte Implementierung aufzubauen.
In diesem Fall wird uns die Implementierung ermöglichen, auf einfache und zweckmäßige Weise einen Befehlsmechanismus für das Replikations-/Simulationssystem aufzubauen. Das heißt, wir benötigen eine Möglichkeit, die Order- und Positionsverwaltungsstruktur zu speichern, um Untersuchungen im Replikations-/Simulationssystem durchführen zu können. Meiner Meinung nach ist es völlig unnötig, dafür viele Routinen zu erstellen, da MQL5 es uns ermöglicht, über SQLite bestimmte SQL-Funktionen zu nutzen. Für alle, die jedoch unbedingt immer mehr eigenen Code schreiben wollen, stellen wir eine bessere Alternative vor. Der Grund dafür ist, dass die Zeit, die für die Implementierung, das Testen und die Konfiguration von Prozeduren zum Aufbau einer Art Datenbank aufgewendet würde, produktiver für andere Aufgaben genutzt werden kann.
Wenn wir also tatsächlich mit der Entwicklung des Systems beginnen, das erforderlich ist, damit das Replikations-/Simulationssystem wirklich als Alternative zu Demokonten für die Untersuchung einer Strategie genutzt werden kann, wird dies wesentlich schneller und ohne viele Probleme im Zusammenhang mit dem ordnungsgemäßen Betrieb geschehen. Der Grund dafür ist, dass wir SQL für die Schaffung eines Mechanismus zur Orderverwaltung verwenden werden.
Was im vorherigen Artikel erläutert wurde, ist jedoch sehr abstrakt, wenn wir alles so belassen, wie es ist, und im Bereich der Theorie verbleiben. Da dieses Thema jedoch auch in anderen Bereichen von Interesse sein könnte – beispielsweise wenn Sie einen Expert Advisor erstellen möchten, der mithilfe einer Datenbank das Handeln erlernt –, müssen Sie das im vorherigen Artikel Beschriebene in die Praxis umsetzen. Ein wichtiges Detail, und das möchte ich gleich vorwegnehmen: Ich habe (zumindest derzeit) nicht vor, zu erklären, wie man eine Datenbank erstellt, damit ein in MQL5 erstellter Expert Advisor lernt, mit einem bestimmten Symbol zu handeln.
Um solche Dinge zu erklären, müsste man auch viele andere Konzepte und Prinzipien der Funktionsweise von Datenbanken erläutern. Wenn Sie das aber wirklich lernen möchten, empfehle ich Ihnen, sich eingehend mit Spielalgorithmen zu beschäftigen. Das liegt daran, dass das Erstellen einer Datenbank eine triviale Aufgabe ist, genau wie die Programmierung eines Expert Advisors in MQL5. Damit die Datenbank jedoch wirklich nützlich ist und der Expert Advisor buchstäblich lernt, am Markt zu arbeiten, müssen Sie wissen, wie Sie bestimmte Daten in die zu erstellende Datenbank einfügen. Der einfachste Weg, zu lernen, wie man solche Daten erstellt, besteht darin, Spielalgorithmen zu studieren.
Es gibt jedoch auch andere, komplexere Ansätze, wie beispielsweise die Untersuchung von Wellenbewegungen oder sogar das Konzept der Wärmeverteilung. Diese Ansätze sind jedoch wesentlich schwieriger, auch wenn die Ergebnisse denen von Spielalgorithmen sehr ähnlich sein werden.
Schauen wir uns zunächst einmal in der Praxis an, was im vorherigen Artikel erläutert wurde. Da ich alles gern in Themen unterteile, um das Verständnis zu erleichtern, kommen wir nun zum ersten Thema dieses Artikels.
Eine einfache Datenbank erstellen
Wir werden hier nicht lange darauf eingehen. Das liegt daran, dass dieses Thema bereits in mehreren Artikeln zum Thema SQL behandelt wurde. Da wir jedoch im vorherigen Artikel vorgeschlagen haben, ein anderes Programm zu verwenden, damit die Arbeit direkt in SQLite erfolgt – der SQL-Implementierung, die wir über MQL5 nutzen werden –, müssen wir einige Details betrachten, die sich ausschließlich auf die Verwendung von SQLite beziehen.
Als Erstes werden wir uns mit dem Zusammenhang zwischen den SQLite-Datentypen und den Daten befassen, die wir in der Datenbank ablegen werden. Eine der Besonderheiten von SQLite, die im Zusammenhang mit Datentypen auffällt, ist, dass es weniger Typen umfasst. Das ist jedoch kein Nachteil; im Gegenteil: Je nachdem, was wir entwickeln, ist es ein großer Vorteil – zusätzlich zu einem weiteren Vorteil, den SQLite gegenüber anderen SQL-Implementierungen bietet.
Ein weiterer Vorteil, den ich gerade erwähnt habe, ist die Tatsache, dass Daten in SQLite dynamisch und nicht statisch wie in vielen anderen Implementierungen. „Aber Moment mal. Inwiefern können Daten in SQLite dynamisch sein? Und warum ist das ein Vorteil?“ Um das zu verstehen, müssen Sie sich die kleine Tabelle unten ansehen:
| Datentyp in SQLite | Erläuterung |
|---|---|
| NULL | Umfasst alle NULL-Werte. |
| INTEGER | Vorzeichenbehaftete Ganzzahlen, die je nach Größe des Werts in 1, 2, 3, 4, 6 oder 8 Byte gespeichert werden. |
| REAL | Reelle Zahlen oder Gleitkommawerte, die als 8-Byte-Gleitkommazahlen gespeichert werden. |
| TEXT | Textzeichenfolgen, die unter Verwendung der Datenbankkodierung gespeichert werden (diese kann UTF-8, UTF-16BE oder UTF-16LE sein). |
| BLOB | Beliebige Datenblöcke, wobei jeder Block genau so gespeichert wird, wie er eingefügt wurde. |
Bitte beachten Sie, dass in dieser Tabelle SQLite-Typen aufgeführt sind. Nun wollen wir aus reiner Neugier einmal sehen, wie es in anderen SQL-Implementierungen aussieht. Wir beginnen mit MySQL, dessen Typentabelle unten dargestellt ist:
| Datentyp in MySQL | Erläuterung |
|---|---|
| TINYINT | Eine sehr kleine ganze Zahl. Der Wertebereich mit Vorzeichen dieses numerischen Datentyps reicht von -128 bis 127, der Wertebereich ohne Vorzeichen von 0 bis 255. |
| SMALLINT | Eine kleine ganze Zahl. Der Wertebereich mit Vorzeichen für diesen numerischen Typ reicht von -32768 bis 32767, der Wertebereich ohne Vorzeichen von 0 bis 65535. |
| MEDIUMINT | Eine mittelgroße ganze Zahl. Der Wertebereich mit Vorzeichen dieses numerischen Datentyps reicht von -8388608 bis 8388607, der Wertebereich ohne Vorzeichen von 0 bis 16777215. |
| INTEGER | Eine Ganzzahl normaler Größe. Der Wertebereich mit Vorzeichen dieses numerischen Datentyps reicht von -2147483648 bis 2147483647, der Wertebereich ohne Vorzeichen von 0 bis 4294967295. |
| BIGINT | Eine große ganze Zahl. Der Wertebereich mit Vorzeichen dieses numerischen Datentyps reicht von -9223372036854775808 bis 9223372036854775807, der Wertebereich ohne Vorzeichen von 0 bis 18446744073709551615. |
| FLOAT | Eine kleine Gleitkommazahl (einfache Genauigkeit). |
| DOUBLE | Eine Gleitkommazahl normaler Größe (doppelte Genauigkeit). |
| DECIMAL | Eine gepackte Festkommazahl. Die Anzeigelänge der Datensätze für diesen Datentyp wird beim Anlegen der Spalte festgelegt, und jeder Datensatz wird an diese Länge angepasst. |
| BOOLEAN | Ein boolescher Datentyp kann nur zwei Werte annehmen: „wahr“ oder „falsch“. |
| BIT | Ein Bitwert-Datentyp, bei dem die Anzahl der Bits pro Wert von 1 bis 64 festgelegt werden kann. |
| DATE | Ein Datum im Format JJJJ-MM-TT. |
| DATETIME | Eine Datums- und Zeitangabe, die Datum und Uhrzeit im Format JJJJ-MM-TT HH:MM:SS enthält. |
| TIMESTAMP | Ein Zeitstempel, der die verstrichene Zeit seit Beginn der Unix-Epoche (00:00:00 am 1. Januar 1970) angibt. |
| TIME | Die Tageszeit, dargestellt im Format HH:MM:SS. |
| YEAR | Ein Jahr, das im 2- oder 4-stelligen Format angegeben wird, wobei 4 Stellen der Standard sind. |
| CHAR | Eine Zeichenkette fester Länge; Einträge dieses Typs werden beim Speichern rechts mit Leerzeichen aufgefüllt, um die angegebene Länge zu erreichen. |
| VARCHAR | Eine Zeichenkette variabler Länge. |
| BINARY | Ähnlich wie der Datentyp „char“ stellt er jedoch eine Folge binärer Bytes einer bestimmten Länge dar und nicht eine Folge nichtbinärer Zeichen. |
| VARBINARY | Ähnlich wie der Datentyp „varchar“ stellt er jedoch eine Zeichenkette variabler Länge aus binären Bytes dar und keine Zeichenkette aus nichtbinären Zeichen. |
| BLOB | Eine Binärzeichenkette mit einer maximalen Länge von 65.535 (2^16 - 1) Datenbytes. |
| TINYBLOB | Eine BLOB-Spalte mit einer maximalen Datenlänge von 255 (2^8 - 1) Byte. |
| MEDIUMBLOB | Eine BLOB-Spalte mit einer maximalen Datenlänge von 16.777.215 (2^24 - 1) Byte. |
| LONGBLOB | Eine BLOB-Spalte mit einer maximalen Datenlänge von 4.294.967.295 (2^32 - 1) Byte. |
| TEXT | Eine Zeichenkette mit einer maximalen Länge von 65.535 (2^16 - 1) Zeichen. |
| TINYTEXT | Eine Textspalte mit einer maximalen Länge von 255 (2^8 - 1) Zeichen. |
| MEDIUMTEXT | Eine Textspalte mit einer maximalen Länge von 16.777.215 (2^24 - 1) Zeichen. |
| LONGTEXT | Eine Textspalte mit einer maximalen Länge von 4.294.967.295 (2^32 - 1) Zeichen. |
| ENUM | Eine Enumeration ist ein Objekt in Form einer Zeichenkette, das einen einzelnen Wert aus einer Liste von Werten annimmt, die bei der Erstellung der Tabelle deklariert wurden. |
| SET | Ähnlich wie bei einer Enumeration handelt es sich um ein String-Objekt, das null oder mehrere Werte enthalten kann, wobei jeder Wert aus der Liste der zulässigen Werte ausgewählt werden muss, die bei der Erstellung der Tabelle festgelegt wurde. |
Bitte beachten Sie, dass es noch viele weitere Typen gibt und wir den passenden Typ korrekt auswählen müssen, um spätere Probleme zu vermeiden. Dies gilt auch für PostgreSQL, das über eine eigene Typentabelle verfügt, die im Folgenden dargestellt ist.
| Datentypen in PostgreSQL | Erläuterung |
|---|---|
| BIGINT | Eine 8-Byte-Ganzzahl mit Vorzeichen. |
| BIGSERIAL | Eine automatisch inkrementierende 8-Byte-Ganzzahl. |
| DOUBLE PRECISION | Eine 8-Byte-Gleitkommazahl mit doppelter Genauigkeit. |
| INTEGER | Eine 4-Byte-Ganzzahl mit Vorzeichen. |
| NUMERIC | Eine Zahl mit wählbarer Genauigkeit, deren Verwendung in Fällen empfohlen wird, in denen die Genauigkeit entscheidend ist, beispielsweise bei der Arbeit mit Geldbeträgen. |
| REAL | Eine Gleitkommazahl mit einfacher Genauigkeit, die 4 Byte belegt. |
| SMALLINT | Eine 2-Byte-Ganzzahl mit Vorzeichen. |
| SMALLSERIAL | Eine automatisch inkrementierende 2-Byte-Ganzzahl. |
| SERIAL | Eine automatisch inkrementierende 4-Byte-Ganzzahl. |
| CHARACTER | Eine Zeichenkette mit einer angegebenen festen Länge. |
| VARCHAR | Eine Zeichenkette variabler, aber begrenzter Länge. |
| TEXT | Eine Zeichenkette variabler und unbegrenzter Länge. |
| DATE | Ein Kalenderdatum, bestehend aus Tag, Monat und Jahr. |
| INTERVAL | Ein Zeitintervall. |
| TIME WITHOUT TIME ZONE | Die Tageszeit, ohne Angabe einer Zeitzone. |
| TIME WITH TIME ZONE | Die Uhrzeit, einschließlich der Zeitzone. |
| TIMESTAMP WITHOUT TIME ZONE | Ein Datum und eine Uhrzeit ohne Angabe einer Zeitzone. |
| TIMESTAMP WITH TIME ZONE | Ein Datum und eine Uhrzeit einschließlich einer Zeitzone. |
| BOX | Ein rechteckiger „Kasten“ auf einer Ebene. |
| CIRCLE | Ein Kreis auf einer Ebene. |
| LINE | Eine unendliche Gerade in der Ebene. |
| LSEG | Ein Liniensegment in einer Ebene. |
| PATH | Eine geometrische Gerade in einer Ebene. |
| POINT | Ein geometrischer Punkt in einer Ebene. |
| POLYGON | Ein geschlossener geometrischer Pfad in einer Ebene. |
| CIDR | Eine IPv4- oder IPv6-Netzwerkadresse. |
| INET | Eine IPv4- oder IPv6-Hostadresse. |
| MACADDR | Eine Media-Access-Control-Adresse (MAC-Adresse). |
| BIT | Eine Bitfolge fester Länge. |
| BIT VARYING | Eine Bitfolge variabler Länge. |
| TSQUERY | Eine Suchzeichenfolge für Text. |
| TSVECTOR | Ein Dokument für die Textsuche. |
| JSON | JSON-Textdaten. |
| JSONB | Zerlegte binäre JSON-Daten. |
| BOOLEAN | Ein logischer Wert, der „wahr“ oder „falsch“ darstellt. |
| BYTEA | Abkürzung für „Byte-Array“; dieser Typ wird für binäre Daten verwendet. |
| MONEY | Ein Währungsbetrag. |
| PG_LSN | Eine PostgreSQL-Log-Sequenznummer. |
| TXID_SNAPSHOT | Ein Snapshot der Transaktions-ID auf Benutzerebene. |
| UUID | Eine universell eindeutige Kennung. |
| XML | XML-Daten. |
Bitte beachten Sie, dass PostgreSQL noch weitere Datentypen bietet. Man könnte meinen: Aber all das kann für jeden, der SQL nutzen möchte, zu einem Albtraum werden. Das stimmt aber nicht ganz. SQL lässt sich an unsere Bedürfnisse anpassen. Dies ist erforderlich, damit die Datenbank auch in einer anderen, SQL-basierten Anwendung genutzt werden kann. Je nachdem, ob uns mehr oder weniger Datentypen zur Verfügung stehen, ist die Auswahl eines Datentyps mehr oder weniger schwierig. Der Grund dafür ist: Wenn wir den falschen Datentyp wählen, muss die gesamte Datenbank neu aufgebaut werden, sobald wir ihn ändern müssen. Obwohl dies eine relativ einfache Aufgabe ist, da wir speziell für diesen Zweck erstellte Skripte verwenden, kann sie für jemanden, der SQL lernen möchte und nicht weiß, wo er anfangen soll, durchaus schwierig sein.
Betrachtet man diese Tabellen jedoch, wird sofort deutlich, dass SQLite nur wenige Datentypen verwendet und die darin enthaltenen Datentypen daher weniger Wartungsaufwand erfordern. Das wirft jedoch andere Fragen auf, die hier nicht relevant sind. Was uns im Moment wirklich interessiert, ist, dass SQLite, da es weniger Datentypen hat, über dynamische Typen verfügt; das heißt, sie passen sich den Anforderungen an, die sich aus den zu speichernden Informationen ergeben.
Aber wie sieht das in der Praxis aus? Um das zu verstehen, müssen wir zwei verschiedene Datenbanken anlegen. Die eine wird mit MySQL erstellt, die andere mit SQLite. Beide verwenden SQL als Basissprache. Schauen wir uns einmal an, wie das geht. Die folgende Animation zeigt, wie dieser Vorgang in MySQL abläuft.
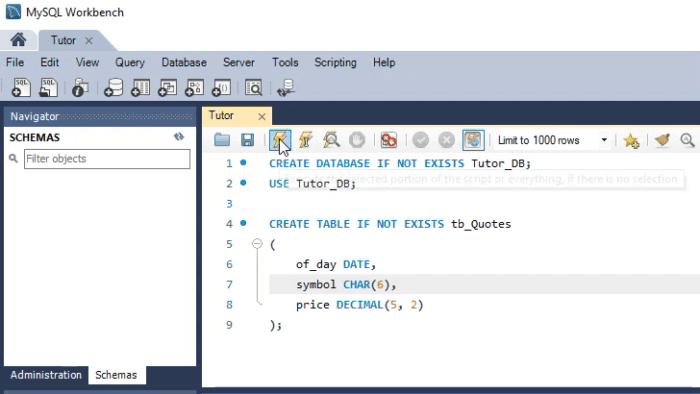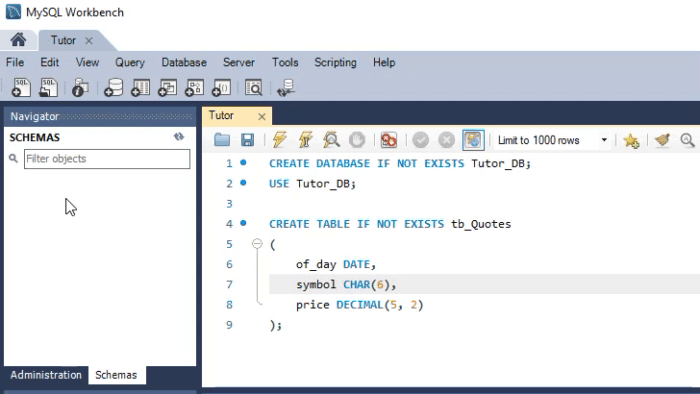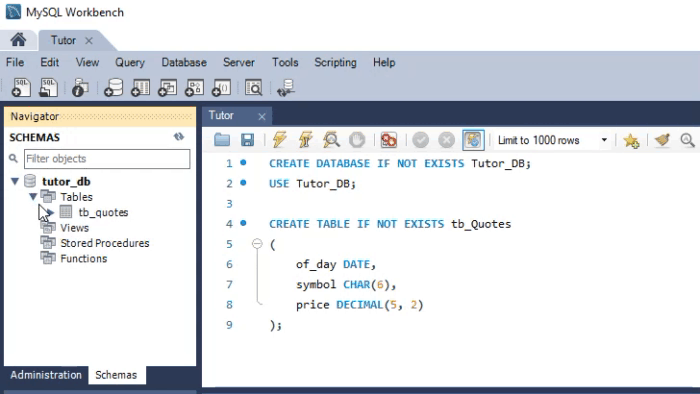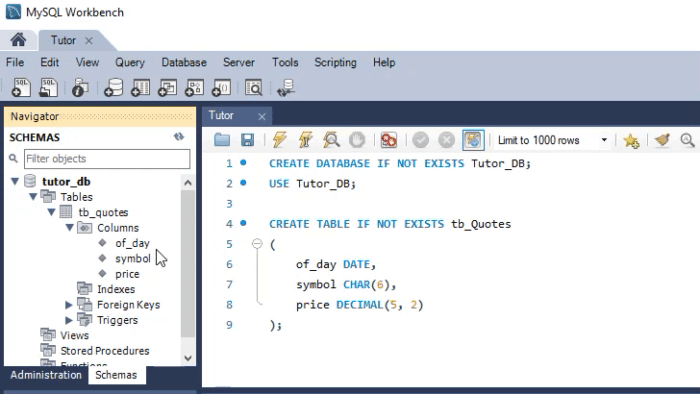
Bitte schauen Sie sich die verwendeten Datentypen genauer an. Die Animation, die Sie unten sehen, führt fast denselben Vorgang aus, nur in SQLite.
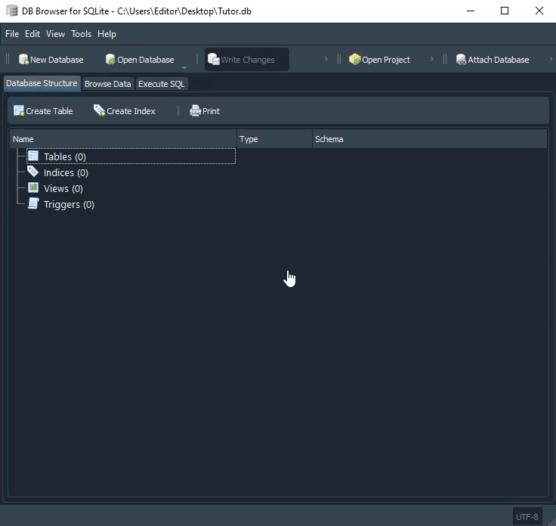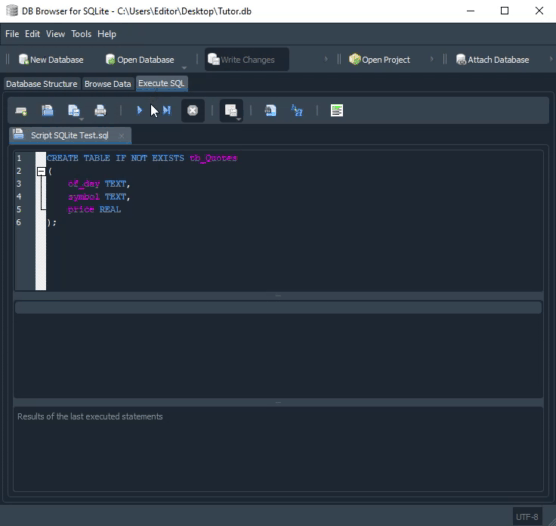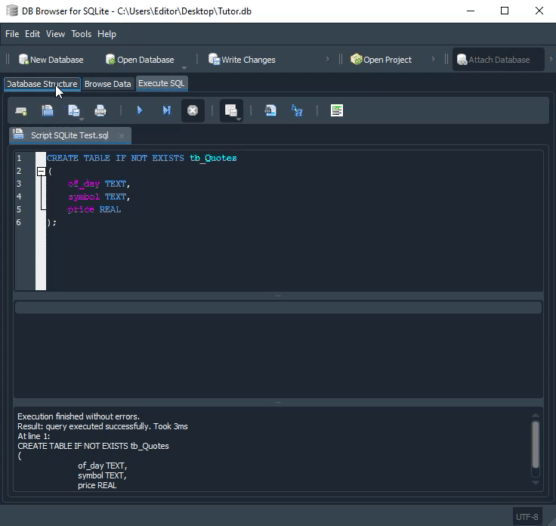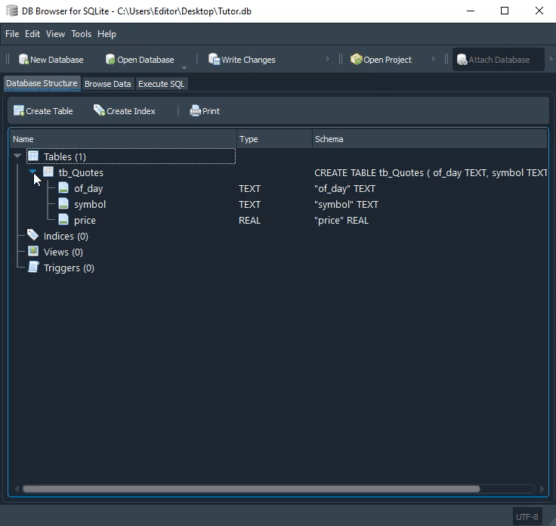
Achten Sie auf die in der zweiten Animation definierten Datentypen. Obwohl das Skript in der MySQL-Animation eine Datenbank erstellt, ist dies bei SQLite nicht der Fall. In diesem Fall muss bereits eine Datenbank angelegt und im DB-Browser geöffnet sein. Vielleicht denken Sie jetzt: „Okay, die Datentypen sind unterschiedlich, also wird der Code nicht in beiden funktionieren.“ Wenn Sie das denken, dann liegt das daran, dass Sie zufällig auf diesen Artikel gestoßen sind. Ich empfehle, die vorherigen Artikel zu lesen, in denen wir gezeigt haben, wie man denselben Code sowohl in MySQL als auch in SQLite verwenden kann. Nur haben wir in jenem Fall SQLite mit dem MetaEditor ausgeführt.
In diesem Fall interessiert uns jedoch die Tatsache, dass wir im MySQL-Code beim Anlegen von Spalten deren Größe festlegen. Bei SQLite haben wir das nicht gemacht. Eine solche Dynamik lässt sich auch in MySQL umsetzen. Dies ist jedoch in anderen Implementierungen als SQLite nicht üblich. Der Grund dafür ist, dass SQL-Programmierer es oft vorziehen, den Typ oder sogar die Größe von Feldern festzulegen, um bestimmte Eigenschaften der Datenbank zu optimieren. Daher haben wir mehr Arbeit mit der Pflege von Datenbanken in verschiedenen Implementierungen.
Hier stellt sich jedoch möglicherweise die Frage: Kann MySQL von SQLite erstellte Spalten verstehen oder umgekehrt? Darüber müssen Sie sich keine Gedanken machen. Ja, jede SQL-Implementierung kann die für die Spalten verwendeten Größenangaben bzw. Dimensionierungen verstehen. Aus diesem Grund haben wir die obigen Tabellen aufgeführt, um zu verdeutlichen, dass es gewisse Überschneidungen zwischen den Datentypen gibt. Je nach Implementierung kann sich der Programmierer jedoch dafür entscheiden, den einen oder anderen Typ zu verwenden, um bestimmte Aspekte der Datenbank zu optimieren.
Gut. Nachdem wir nun die notwendigen Elemente vorgestellt haben, wollen wir uns in der Praxis ansehen, wie Primär- und Fremdschlüssel in dieses Gesamtbild passen.
Primär- und Fremdschlüssel in der Praxis
In den obigen Animationen sehen Sie, dass wir eine sehr einfache Datenbank erstellen. Sie soll den Symbolnamen zusammen mit dem Kurs und dem Datum speichern, an dem die Kurs erfasst wurde. In der Praxis würde ein Datenbankprogrammierer eine Datenbank jedoch kaum auf diese Weise erstellen. Der Grund dafür ist, dass man möglicherweise mehr als ein Symbol oder zusätzliche Informationen in die Datenbank selbst aufnehmen möchte, wie etwa den Namen des Unternehmens, dessen Symbol in der Tabelle angezeigt wird.
Es kann aber auch vorkommen, dass ein Symbol seinen Namen ändert. Auch wenn dies recht selten ist, kommt es doch hin und wieder vor. Ein Beispiel dafür sehen wir an der B3, wo das Unternehmen VIA VAREJO eine Zeit lang den Ticker VVAR3 hatte. Aus irgendeinem Grund änderte das Symbol seinen Ticker in VIIA3. Stellen Sie sich nun einmal vor, wie viel Arbeit es bedeuten würde, den Symbolnamen in jedem bisherigen Datensatz von VVAR3 in VIIA3 zu ändern. All das hätte sich jedoch ganz einfach bewerkstelligen lassen, wenn die Grundlage anders aufgebaut worden wäre.
Auch wenn dieses Beispiel sehr einfach ist, ist es praxisnah genug, um vieles besser zu verstehen. Viele Menschen glauben, dass das Erstellen und Verwalten einer Datenbank eine einfache Aufgabe ist, doch wenn sie sich tatsächlich daran machen, unterlaufen ihnen eine ganze Reihe von Fehlern, deren Behebung später einen enormen Aufwand erfordert.
Schauen wir uns zunächst einmal an, wie man mit SQLite eine einfache Lösung erstellt. Um die Aufgabe und die Erklärung zu vereinfachen, können Sie sich den unten stehenden SQL-Skriptcode ansehen. Dieses Skript verwendet das, was wir implementieren werden.
01. PRAGMA FOREIGN_KEYS = ON;
02.
03. CREATE TABLE IF NOT EXISTS tb_Symbols
04. (
05.     id INTEGER PRIMARY KEY,
06.     symbol TEXT
07. );
08.
09. CREATE TABLE IF NOT EXISTS tb_Quotes
10. (
11.     of_day TEXT,
12. --    symbol TEXT,
13.     price NUMERIC,
14.     fk_id INTEGER,
15.     FOREIGN KEY (fk_id) REFERENCES tb_Symbol (id)
16. );
Code in SQLite
Bitte beachten Sie, dass dieser Code bereits einige Elemente enthält, die NICHT zu SQL gehören. In diesem Fall geht es um Zeile 01, in der wir eine interne SQLite-Anweisung verwenden. Aber warum verwenden wir diese Anweisung hier? Der Grund dafür ist, dass in der SQLite-Dokumentation, die wir am Ende dieses Artikels im Abschnitt „Referenzen“ angegeben haben, steht, dass SQLite vor Version 3.6.19 standardmäßig keine Fremdschlüssel verwendet hat, sodass diese explizit angegeben werden müssen. Andernfalls verwendet SQLite sie nicht. Auch wenn die genannte Version schon ziemlich alt ist, könnte sie aus irgendeinem Grund vielleicht noch von jemandem verwendet werden. Abgesehen davon wollen wir uns einmal ansehen, was in diesem Skript passiert. Beachten Sie, dass eine Datenbank im DB-Browser geöffnet sein muss, damit das Skript in SQLite korrekt ausgeführt wird.
In Zeile 03 erstellen wir (falls noch nicht vorhanden) eine Tabelle namens tb_Symbols. In dieser Tabelle definieren wir in Zeile 05 den Primärschlüssel. In Zeile 06 definieren wir den Symbolnamen. Derzeit legen wir keine Obergrenze für die Anzahl der Datensätze fest, die diese Tabelle enthalten wird. Der Grund dafür ist, dass wir noch zeigen möchten, wie wir zu einem wesentlich geeigneteren Modell für den Aufbau einer Datenbank gelangt sind. Obwohl der ID-Wert also immer eindeutig ist, kann dasselbe Symbol in mehreren IDs definiert werden. Das lässt sich jedoch ganz einfach lösen. Bevor wir uns jedoch ansehen, wie wir das machen werden, wollen wir zunächst verstehen, wie die Schlüssel hier funktionieren.
Nachdem wir die Tabelle „tb_Symbols“ angelegt haben, können wir eine neue Tabelle ändern (oder genauer gesagt: anlegen). Dies beginnt in Zeile 09, wo wir angeben, dass wir die Tabelle „tb_Quotes“ anlegen möchten. Bitte beachten Sie, dass Zeile 12 die ursprüngliche Zeile ist, wie in der obigen Animation zu sehen ist. Im Gegensatz zu dem, was in der Animation gezeigt wurde, erscheint sie hier jedoch als Kommentar. Der Grund dafür ist, dass der Symbolname in dieser Tabelle nicht mehr gespeichert wird. Aus diesem Grund haben wir die Zeilen 14 und 15 zum Code hinzugefügt. Achten Sie nun bitte ganz genau auf die Erklärung; das ist wichtig. In Zeile 14 definieren wir einen Wert, der denselben Datentyp wie der Primärschlüssel der Tabelle „tb_Symbols“ haben muss. In manchen Fällen definiert ein Programmierer, der SQLite verwendet, den Datentyp nicht, sondern überlässt dies dem Programm. Da wir einen bestimmten Standard im Code einhalten möchten, werden wir den Datentyp definieren.
Dies wird unser Fremdschlüssel in der Tabelle „tb_Quotes“ sein. Und nun kommt der wirklich wichtige Punkt in dem oben gezeigten Skript. In Zeile 15 geben wir an, was der Fremdschlüssel ist und worauf er verweist. Bitte beachten Sie, dass wir sowohl den Tabellennamen als auch den Namen des zu verwendenden Schlüssels bzw. der zu verwendenden Spalte angeben müssen. Dieser Schlüssel stammt aus der Tabelle „tb_Symbols“.
Auf diese Weise schaffen wir ein referenzielles bzw. relationales System, in dem die Informationen zum Kurs vom Symbolnamen getrennt sind. Diese Trennung ist jedoch nicht wirklich gegeben, da eine Beziehung zwischen dem Kursdatensatz und dem Symbolnamen besteht. Und genau durch die Erstellung von Primär- und Fremdschlüsseln entsteht diese Beziehung. Wenn Sie diesen Zusammenhang verstehen, werden Sie erkennen, dass eine echte Datenbank erstellt werden kann, indem verschiedene Informationen so miteinander verknüpft werden, dass sie eine Verbindung haben, während wir zugleich mehr oder weniger Daten zu demselben Datensatz hinzufügen können. All dies bei minimalem Aufwand für die Pflege oder Änderung der ursprünglichen Datenbank.
Der obige Code lässt sich wie unten gezeigt schreiben, was einer möglichen realen Situation viel näherkommt. Allerdings haben wir das Problem, dass sich der Symbolname an mehr als einer Stelle in der Tabelle „tb_Symbols“ wiederholt, noch nicht gelöst.
01. PRAGMA FOREIGN_KEYS = ON;
02.
03. CREATE TABLE IF NOT EXISTS tb_Symbols
04. (
05.     id INTEGER PRIMARY KEY,
06.     symbol TEXT
07. );
08.
09. CREATE TABLE IF NOT EXISTS tb_Quotes
10. (
11.     of_day TEXT,
12.     price NUMERIC,
13.     fk_id INTEGER REFERENCES tb_Symbol (id)
14. );
Code in SQLite
Bitte beachten Sie, dass wir nun eine kleine Änderung vorgenommen haben. Sie befindet sich in Zeile 13 und dient demselben Zweck: der Verknüpfung der Tabelle „tb_Quotes“ mit der Tabelle „tb_Symbols“ mithilfe eines Fremdschlüssels. Noch ein Punkt: Obwohl wir gesagt haben, dass wir Tabellen verknüpfen, wäre es korrekter zu sagen, dass wir einen Datensatz aus der Tabelle „tb_Quotes“ mit einem anderen Datensatz aus der Tabelle „tb_Symbols“ verknüpfen. Gut, achten Sie jetzt genau darauf: Es spielt keine Rolle, was wir in den einzelnen Tabellen speichern. Wir können den Tabellen eine größere oder kleinere Zahl von Feldern bzw. Datenspalten hinzufügen, ohne dass dies direkte Auswirkungen auf die Suche und die dabei erzielten Ergebnisse hat.
Je nach Bedarf können jedoch zusätzliche Informationen in eine der Tabellen aufgenommen werden. Gleichzeitig profitieren auch alle anderen Tabellen, die mit dieser Tabelle verknüpft sind, davon, ohne dass wir die Datenbank komplett neu schreiben müssen. Möglicherweise ist Ihnen das volle Ausmaß dieser Tatsache noch nicht bewusst. Sobald Sie jedoch anfangen, SQL zu nutzen, werden Sie schnell erkennen, dass es eine große Hilfe ist, wenn wir eine Datenbank erweitern oder ein relationales System zwischen verschiedenen Arten von Informationen aufbauen wollen.
Na gut, aber wie können wir das Problem möglicher Datenduplikate in der Datenbank lösen? Das ist ganz einfach. Beim Anlegen der Tabelle legen wir fest, dass die Spalte bestimmte Werte nicht enthalten darf oder die Werte nicht doppelt vorkommen dürfen. Ändern wir beispielsweise den oben gezeigten Code so, dass die Spalten keine NULL-Werte enthalten. Wir möchten aber auch nicht, dass der Symbolname in mehr als einem Datensatz in derselben Spalte vorkommt. Der korrigierte Code sieht also wie folgt aus:
01. PRAGMA FOREIGN_KEYS = ON;
02.
03. CREATE TABLE IF NOT EXISTS tb_Symbols
04. (
05.     id INTEGER PRIMARY KEY NOT NULL,
06.     symbol TEXT NOT NULL UNIQUE
07. );
08.
09. CREATE TABLE IF NOT EXISTS tb_Quotes
10. (
11.     of_day TEXT NOT NULL,
12.     price NUMERIC NOT NULL,
13.     fk_id INTEGER NOT NULL,
14.     FOREIGN KEY (fk_id) REFERENCES tb_Symbol (id)
15. );
Code in SQLite
Wenn wir dieses Skript nun ausführen, werden wir feststellen, dass beide Tabellen wie erwartet und wie in der obigen Erklärung beschrieben angelegt werden. Im Gegensatz zu früher wird es nun jedoch keine doppelten Datensätze mehr geben. Wenn wir versuchen, einen Datensatz zu duplizieren, lässt SQL dies nicht zu. Ebenso wird unsere Tabelle keine Werte mehr enthalten, die NULL entsprechen. Bitte beachten Sie, dass der Code hierfür sehr einfach und übersichtlich ist.
Das letzte Skript verstehen
Bevor man sich neuen Bereichen zuwendet, ist es sehr wichtig zu verstehen, wie das letzte Skript funktioniert. Wir müssen wirklich versuchen zu verstehen, was hier vor sich geht. Sonst sind wir völlig auf verlorenem Posten. Nach der Ausführung des zuletzt oben gezeigten SQL-Skripts erhalten wir im DB- Browser somit das folgende Ergebnis:
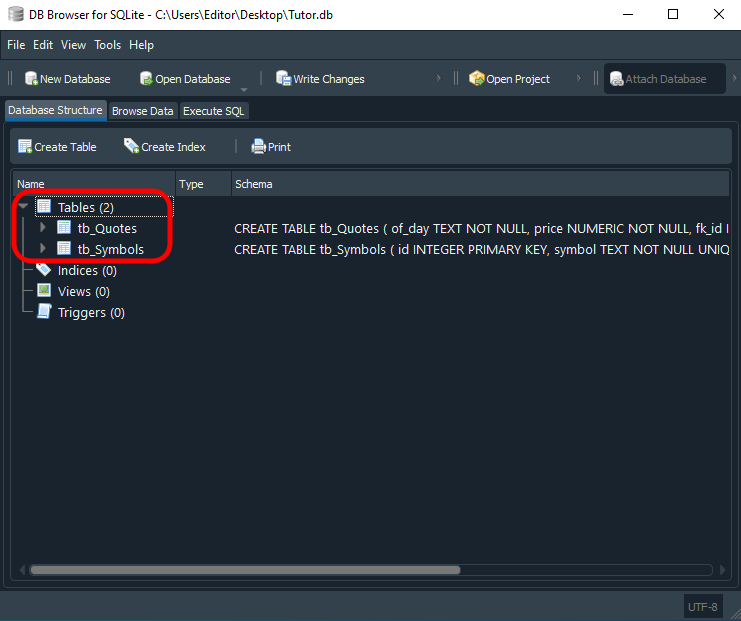
Beachten Sie, dass wir die beiden hier gezeigten Tabellen hervorgehoben haben. Aber wie verwenden wir sie eigentlich? Es mag wie etwas Kompliziertes wirken, das nur erfahrenen Fachleuten vorbehalten ist. Ganz und gar nicht. Die Verwendung dieses Schemas ist einfacher, als es zunächst scheint. Wir haben bereits gezeigt, wie man mithilfe eines Skripts Informationen zu einer Tabelle hinzufügt. Das geschah in den vorherigen Artikeln zum Thema SQL. Hier werden wir etwas verwenden, das dem, was wir bereits gesehen haben, sehr ähnlich ist.
Um zu sehen, wie das Ganze funktioniert, fügen wir als Beispiel für die Interaktion mit dieser Art der Modellierung einige Daten hinzu. Und da wir auch den grundlegenden Auswahlbefehl vorgestellt haben, können wir ihn hier ebenfalls verwenden. Aber zuerst werden wir unserer Datenbank ein paar Datensätze hinzufügen. Ersetzen wir das obige Skript durch ein anderes, das sich geringfügig davon unterscheidet.
01. PRAGMA FOREIGN_KEYS = ON;
02.
03. DROP TABLE IF EXISTS tb_Quotes;
04. DROP TABLE IF EXISTS tb_Symbols;
05.
06. CREATE TABLE IF NOT EXISTS tb_Symbols
07. (
08.     id INTEGER PRIMARY KEY,
09.     symbol TEXT NOT NULL UNIQUE
10. );
11.
12. CREATE TABLE IF NOT EXISTS tb_Quotes
13. (
14.     of_day TEXT NOT NULL,
15.     price NUMERIC NOT NULL,
16.     fk_id INTEGER NOT NULL,
17.     FOREIGN KEY (fk_id) REFERENCES tb_Symbols(id)
18. );
19.
20. INSERT INTO tb_Symbols (id, symbol) VALUES(1, 'BOVA11');
21. INSERT INTO tb_Symbols (id, symbol) VALUES(3, 'PETR4');
22. INSERT INTO tb_Symbols (id, symbol) VALUES(2, 'WDOQ23');
23. INSERT INTO tb_Symbols (id, symbol) VALUES(4, 'VALE3');
24. INSERT INTO tb_Quotes (of_day, price, fk_id) VALUES ('17-07-2023', 12.90, 4);
25. INSERT INTO tb_Quotes (of_day, price, fk_id) VALUES ('14-07-2023', 118.12, 2);
26. INSERT INTO tb_Quotes (of_day, price, fk_id) VALUES ('13-07-2023', 119.53, 1);
27. INSERT INTO tb_Quotes (of_day, price, fk_id) VALUES ('12-07-2023', 117.45, 2);
28. INSERT INTO tb_Quotes (of_day, price, fk_id) VALUES ('11-07-2023', 119.30, 3);
29. INSERT INTO tb_Quotes (of_day, price, fk_id) VALUES ('10-07-2023', 120.59, 1);
30.
31. SELECT * FROM tb_Quotes;
Skript in SQLite
Vielleicht sehen Sie sich das gerade an und denken: Wow, was für ein komplizierter Code; den werde ich nie verstehen. Ich denke, ich gebe auf und mache alles anders. Aber ich sage Ihnen: Wollen Sie jetzt schon aufgeben? Gerade jetzt, wo alles spannender geworden ist? Schließlich ist der obige Code gar nicht so kompliziert. Alles, was darin enthalten ist, wurde bereits in dieser Einführungsphase erläutert, in der wir einige Erklärungen zur Verwendung der SQL-Sprache gegeben haben.
Der einzige Teil, der vielleicht etwas Verwirrung stiften könnte, sind die Zeilen 03 und 04, in denen wir SQL mitteilen, dass die Tabellen tb_Quotes und tb_Symbols entfernt werden sollen, falls sie vorhanden sind. Aber warum löschen wir die Tabellen, bevor wir überhaupt dazu kommen, sie zu verwenden? Und die wichtigste Frage: Warum sollten wir sie entfernen? Könnten wir sie nicht einfach beibehalten und neue Daten zur Datenbank hinzufügen?
Auf all diese Fragen gibt es eine Antwort. Wir müssen die Tabellen aus dem einfachen Grund löschen, dass wir zwischen den Zeilen 20 und 29 Werte in sie einfügen werden. Jedes Mal, wenn dasselbe Skript ausgeführt wird, meldet SQL jedoch einen Fehler beim Hinzufügen von Werten zu den Tabellen. Der Grund für diesen Fehler liegt genau darin, dass wir bestimmte Felder in der Datenbank nicht duplizieren können.
Nach der Ausführung dieses Skripts erhalten wir das folgende Ergebnis:
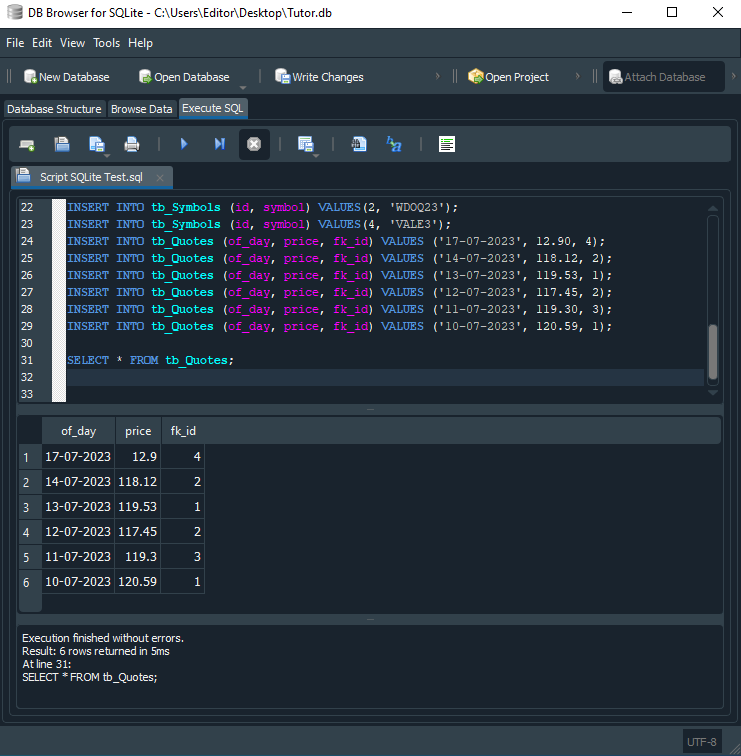
Bitte beachten Sie, dass wir im Ergebnis genau den Inhalt der Tabelle tb_Quotes erhalten. Das liegt daran, dass wir in Zeile 31 SQL auffordern, uns diese Informationen zu liefern. Der Blick darauf kann jedoch etwas entmutigend sein. Der Grund dafür ist, dass es bei einer sehr großen Datenbank mit Kursen für verschiedene Symbole schwierig ist, zu erkennen, wo sich die einzelnen Einträge befinden, da das Abfrageergebnis weder den Symbolnamen noch sonstige Informationen enthält, die uns helfen würden, besser zu verstehen, wonach wir in der Datenbank suchen. Aber schon bald werden wir sehen, wie sich dies durch eine kleine Änderung am Code in Zeile 31 verbessern lässt, wo wir den SELECT-Befehl verwenden.
Abschließende Gedanken
Bevor Sie aufgeben und beschließen, SQL nicht weiter zu lernen, möchte ich Sie, liebe Leserinnen und Leser, daran erinnern, dass wir hier immer noch nur die grundlegendsten Elemente verwenden. Einige Funktionen von SQL haben wir noch nicht behandelt. Sobald Sie diese verstanden haben, werden Sie feststellen, dass SQL viel praktischer ist, als es zunächst den Anschein hat. Allerdings werden wir höchstwahrscheinlich irgendwann die Richtung dessen ändern, was wir gerade aufbauen, da der Entwicklungsprozess dynamisch ist. Wir werden noch etwas genauer zeigen, wie man verschiedene Dinge in SQL erstellt, denn das ist für Sie wirklich wichtig und nützlich. Wenn man einfach davon ausgeht, dass man fähiger ist als eine ganze Gemeinschaft von Programmierern und Entwicklern, führt das nur dazu, dass man Zeit und Chancen verschwendet. Keine Sorge, denn was als Nächstes kommt, wird noch interessanter.
Wie gesagt, ich bin mir noch nicht sicher, ob ich SQLite oder eine andere SQL-Implementierung verwenden werde. Das liegt daran, dass die Entwicklung der für das Replikations-/Simulationssystem erforderlichen Elemente ein vollkommen dynamischer Prozess ist. Wir haben noch nicht entschieden, in welche Richtung wir als Nächstes tatsächlich gehen werden. Doch ganz gleich, wie sich die Dinge in den nächsten Phasen entwickeln – wenn wir zu MQL5 zurückkehren, werden wir sicherlich SQL einsetzen, um verschiedene Aufgaben zu lösen. Ich werde keine Routineprozeduren erstellen, um Aufgaben auszuführen, die SQL uns bereits ermöglicht und bei denen es uns unterstützt. Wie wir SQL jedoch in der Praxis einsetzen werden, steht noch nicht endgültig fest.
Im nächsten Artikel werden wir uns damit befassen, wie man einige weitere Aktionen in SQL ausführt. Schließlich kommt die Sache jetzt erst richtig in Schwung, und was wir untersuchen und erläutern werden, steht bereits fast vollständig fest. Ich möchte jedoch betonen, dass diese Artikel kein SQL-Kurs sind. Ich möchte lediglich einige Punkte aufzeigen, die in Zukunft nützlich sein könnten, denn es macht keinen Sinn, MQL5 oder eine andere Sprache für Aufgaben zu verwenden, die SQL selbst für uns erledigen kann. Und dabei geht es nicht nur um die Erstellung und Pflege einer Datenbank. Wir sprechen hier über das Programmieren an sich.
Viele Menschen kennen nur wenige SQL-Befehle, vergessen diese jedoch wieder oder zeigen nicht genügend Interesse daran, ihre Kenntnisse in diesem Bereich zu vertiefen. Dadurch verpassen sie die Gelegenheit, ein wirklich leistungsstarkes Werkzeug zu nutzen, da viele der Prozeduren, die manche in einer mit SQL integrierten Sprache erstellen, direkt in SQL ausgeführt werden können. Und wenn Sie wissen, wie man solche Dinge macht, wird Ihnen das bei Ihren Entwicklungen sehr helfen. Versuchen Sie also, Ihr Wissen zu diesem Thema zu vertiefen. Nutzen Sie diese Artikel lediglich als Orientierungshilfe: Betrachten Sie sie nicht als einzige Informationsquelle oder als endgültige Wahrheit. Herzliche Grüße an alle; bis zum nächsten Artikel.
| Datei | Beschreibung |
|---|---|
| Experts\Expert Advisor.mq5 | Veranschaulicht die Interaktion zwischen Chart Trade und dem Expert Advisor (für die Interaktion ist Mouse Study erforderlich). |
| Indicators\Chart Trade.mq5 | Erstellt ein Fenster zur Konfiguration der zu sendenden Order (für die Interaktion ist Mouse Study erforderlich). |
| Indicators\Market Replay.mq5 | Erstellt Steuerelemente für die Interaktion mit dem Replikations-/Simulationsdienst (für die Interaktion ist Mouse Study erforderlich). |
| Indicators\Mouse Study.mq5 | Ermöglicht die Interaktion zwischen grafischen Bedienelementen und dem Benutzer (sowohl für das Replikations-/Simulationssystem als auch auf dem realen Markt erforderlich). |
| Services\Market Replay.mq5 | Erstellt und verwaltet den Dienst für die Marktreplikation/-simulation (die Hauptdatei des gesamten Systems). |
| Code VS C++\Servidor.cpp | Erstellt und verwaltet einen in C++ entwickelten Server-Socket (MiniChat-Version). |
| Code in Python\Server.py | Erstellt und verwaltet einen Socket in Python für die Kommunikation zwischen MetaTrader 5 und Excel. |
| Indicators\Mini Chat.mq5 | Ermöglicht die Implementierung eines Mini-Chats über einen Indikator (erfordert die Nutzung des Servers). |
| Experts\Mini Chat.mq5 | Ermöglicht die Implementierung eines Mini-Chats mithilfe eines Expert Advisors (erfordert den Server). |
| Scripts\SQLite.mq5 | Veranschaulicht die Verwendung eines SQL-Skripts über MQL5. |
| Files\Script 01.sql | Zeigt die Erstellung einer einfachen Tabelle mit einem Fremdschlüssel. |
| Files\Script 02.sql | Zeigt, wie man Werte in eine Tabelle einfügt. |
Referenz
Übersetzt aus dem Portugiesischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/pt/articles/12986
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.
 Vom Anfänger zum Fortgeschrittenen: Objekte (II)
 Neuronale Netze im Trading: Ein domänenübergreifendes Framework für die Zeitreihenprognose (TimeFound)
 Neuronale Netze im Handel: Generalisierung von Zeitreihen ohne Abhängigkeit von spezifischen Datensätzen (Fazit)
 Marktsimulation (Teil 21): Erste Schritte mit SQL (IV)

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.