

Neuronale Netze im Trading: Effektive Merkmalsextraktion für präzise Klassifikation (Objekterstellung)
 24
 0

Einleitung
Im vorherigen Artikel untersuchten wir die theoretischen Aspekte des Mantis-Frameworks – einem Foundation-Modell (Basismodell) zur Klassifikation von Zeitreihen, das die Rechenkomplexität von Regressionsalgorithmen vermeidet, ohne dabei an Genauigkeit einzubüßen. Es wandelt die Rohdaten der analysierten Sequenz in klare Signale mit genau definierten Konfidenzwerten um und bietet damit eine neue Qualität der Analyse.
Stellen Sie sich ein klassisches Prognosemodell vor: Es lernt, den Prognosefehler zu minimieren, versagt jedoch häufig angesichts plötzlicher Volatilitätsspitzen. Solche Algorithmen driften mit dem Markt. Sie lassen sich nur schwer anpassen. Sie neigen zu Overfitting und liefern keine transparenten Zuverlässigkeitsschätzungen. Wir brauchen mehr als nur eine Prognose eines zukünftigen Wertes. Wir benötigen eine Echtzeit-Erkennung des Marktregimes, um festzustellen, ob sich der Kurs gemäß einem typischen oder einem anomalen Szenario entwickelt. Hier setzt Mantis an: Es handelt sich um ein Modell, das weniger auf Regression als vielmehr auf das Verstehen von Mustern trainiert wurde.
Mantis basiert auf dem Konzept der Tokenisierung von Zeitreihen, das von Vision Transformers übernommen wurde. Anstatt Zehntausende von Ticks oder Sekunden zu scannen, wird die Zeitreihe in eine genau festgelegte Anzahl von Patches unterteilt. Dadurch werden Zeitreihen unterschiedlicher Länge mit derselben Anzahl von Schritten verarbeitet, sodass die Architektur nicht für verschiedene Skalen umgeformt werden muss. Dann kommt die Magie der hybriden Attention ins Spiel: Aus einer Perspektive untersucht das Modell kleinste lokale Veränderungen mithilfe von Faltungen und Pooling, während es aus einer zweiten Perspektive langfristige Trends mithilfe globaler Attention erfasst. Durch die Kombination dieser beiden Perspektiven kann das Modell gleichzeitig kleinste Schwankungen erkennen und die allgemeine Bewegungsrichtung erfassen.
Die wichtigste geheime Zutat des Modells ist das kontrastive Vortraining. Stellen Sie sich zwei leicht verzerrte Versionen eines einzelnen Abschnitts des Kursverlaufs vor. Mantis lernt, deren Embeddings im Raum näher zusammenzubringen, so als würde es mehrere Lichtbänder zu einem einzigen Strahl komprimieren, während es gleichzeitig völlig unterschiedliche Abschnitte voneinander wegdrängt, wie ein Elektron und ein Positron. Dieser Kontrast verleiht dem Modell eine stabile Wahrnehmung des Musters, was insbesondere bei Amplitudenänderungen, kleinen Zeitverschiebungen oder ungewöhnlichem Rauschen besonders wertvoll ist.
Der Prozess endet mit Temperature Scaling – der abschließenden Kalibrierung der Ausgaben. Trader interessieren sich nicht nur für das Urteil „Trendwende/keine Trendwende“, sondern auch für den Konfidenzgrad. Mantis kann nicht nur abstrakte Scores, sondern plausible, gut kalibrierte Wahrscheinlichkeiten ausgeben. Die Erfahrung zeigt: Wenn ein Modell eine „Wahrscheinlichkeit einer Trendwende von 80 %“ vorhersagt, dann erweisen sich in der Realität etwa 80 von 100 solcher Signale als richtig.
Der wahre Wert von Mantis wird deutlich, wenn ihm mehrkanalige Informationen zugeführt werden. Der rhythmisch oszillierende RSI, die Handelsvolumina, die gleitenden Durchschnitte und die Korrelationen zwischen den Währungspaaren ergeben ein komplexes Gesamtbild. Eine direkte Verkettung dieser Signale führt zu einer explosionsartigen Zunahme der Parameterzahl, während bei einer getrennten Verarbeitung die kanalübergreifenden Abhängigkeiten verloren gehen. Die Lösung in Mantis besteht aus leichtgewichtigen Adaptern, die Interaktionen zwischen Kanälen komprimieren und nur das Wichtigste beibehalten: die Stärke der Verbindung zwischen Indikatoren. Das Modell spart Arbeitsspeicher, und der Trader spart Zeit bei der Konfiguration.
Um ein tieferes Verständnis der Architektur von Mantis zu erlangen, gehen wir ihre einzelnen Schritte durch. Die erste Stufe ist die initiale Faltung: Eine Zeitreihe mit d Kanälen durchläuft eine Schicht mit 256 Ausgabekanälen, wodurch eine dichte Darstellung entsteht. Der Tensor wird anschließend in gleiche Teile unterteilt, und kanalweises Mean-Pooling wandelt die resultierenden Daten in 32 Token um, die jeweils lokale Informationen tragen.
Parallel dazu wird ein Differenzstrom konstruiert: Differenzen erster Ordnung der Eingabedaten erhöhen die Empfindlichkeit gegenüber kurzfristiger Dynamik. Die daraus resultierenden Daten durchlaufen anschließend denselben Patching-Prozess.
Der dritte und der vierte Strom – die Statistikströme – erfassen den Mittelwert und die Standardabweichung der Eingabedaten innerhalb derselben 32 Fenster und vermitteln so den Gesamtkontext von Volatilität und Niveau.
Diese vier Datenströme durchlaufen separate lineare Projektionsschichten, um ihre Dimensionalität anzugleichen; anschließend werden sie verkettet und in globale Token der angegebenen Größe projiziert.
Der Tokensequenz, die die zu analysierende Sequenz kodiert, werden ein Klassentoken und eine sinusoidale Positionskodierung hinzugefügt, damit das Modell keine Informationen über die Reihenfolge verliert. Die Daten werden anschließend in den Transformer eingespeist: 6 Schichten, Multi-Head-Attention mit 8 Heads, Normalisierung, ein zweischichtiges FFN mit GELU und Dropout von 10 % während des Trainings.
Das Modell wurde in zwei Phasen trainiert. In der ersten, kontrastiven Phase wurde es auf einem kombinierten Korpus aus zehn öffentlich zugänglichen Datensätzen mit mehr als 7 Millionen Zeitreihen trainiert – über 100 Epochen hinweg, mit einer Batchgröße von 2.048 auf vier GPUs vom Typ NVIDIA Tesla V100. Das ähnelt einem regelrechten Intensivtraining. In der zweiten Stufe wird ein Klassifikationskopf hinzugefügt, und die Ausgangswerte werden mittels Temperature Scaling kalibriert. Dieser zweistufige Ansatz ermöglicht eine Kombination, die bei neuronalen Netzen selten anzutreffen ist: hohe Genauigkeit und zuverlässige Interpretierbarkeit.
Zum Schluss wollen wir noch über Flexibilität sprechen. Um Aufgaben unterschiedlicher Größenordnung zu bewältigen und Modelle an unterschiedliche Budgets und Datenstrukturen anzupassen, schlagen die Autoren des Mantis-Frameworks den Einsatz verschiedener Adaptertypen vor:
- PCA und Truncated SVD sind klassische, bewährte Methoden der linearen Dimensionsreduktion;
- Random Projection ist eine schnelle, einfache und dennoch leistungsstarke Methode zur Dimensionsreduktion eines Merkmalsvektors;
- Der varianzbasierte Selektor wählt anhand der Varianz nur die informativsten Kanäle aus;
- Der differenzierbare lineare Kombinierer (LComb) ist ein trainierbarer Adapter, der sich zusammen mit dem Hauptmodell an eine bestimmte Aufgabe anpasst.
Diese Adapter ermöglichen es, Geschwindigkeit und Genauigkeit auszubalancieren, Rechenressourcen zu schonen und den Verlust kritischer kanalübergreifender Verbindungen zu vermeiden.
Letztendlich ist Mantis nicht nur ein Modell, sondern ein umfassendes System für die eingehende Analyse von Zeitreihen. Seine Stärke liegt nicht in großspurigen Aussagen, sondern in der akribischen Umsetzung: in der sorgfältigen Beachtung jedes einzelnen Patches, der sorgfältigen Integration lokaler und globaler Kontexte, der strengen Kalibrierung und der sorgfältigen Kanalkompression. Diese Kombination aus Analytik und künstlicher Intelligenz ermöglicht es uns, mit Zuversicht zu agieren – auf der Grundlage von Statistiken und bewährten algorithmischen Prinzipien, anstatt uns auf Vermutungen zu verlassen. In einer Zeit, in der Geschwindigkeit und Genauigkeit alles sind, ist Mantis das Werkzeug, das Ihnen hilft, auf dem schmalen Grat des Marktes das Gleichgewicht zu halten.
Eine vom Autor erstellte Visualisierung des Mantis-Frameworks ist unten dargestellt.
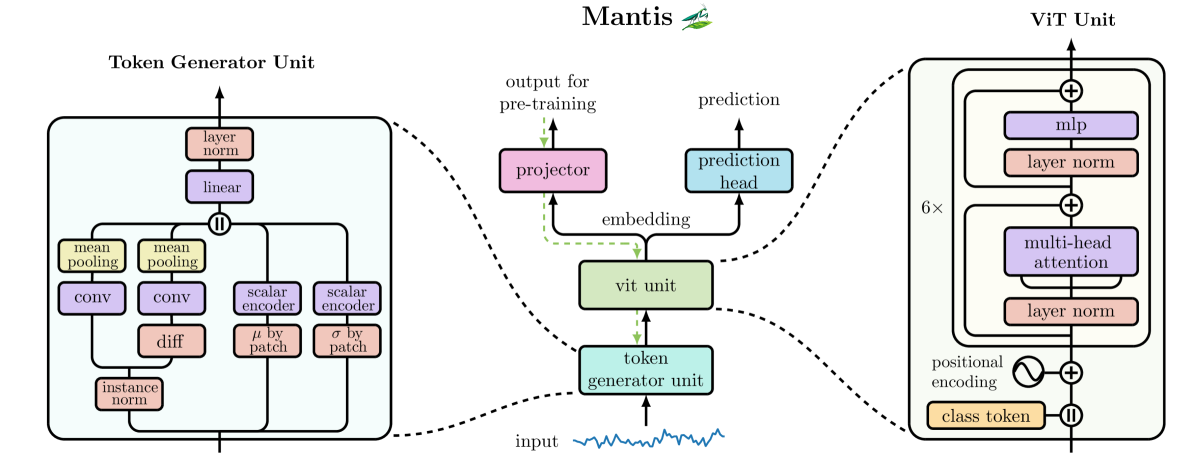
Im praktischen Teil des vorherigen Artikels haben wir eine grundlegende Komponente zur Verarbeitung von Zeitreihen implementiert – das Modul CNeuronConcatDiff. Dieses Objekt kombinierte den Algorithmus zur Berechnung von Differenzen erster Ordnung mit einem Mechanismus zur Verkettung von Tensoren aus verschiedenen Informationsströmen. Dies markierte den Beginn der praktischen Umsetzung des Kerns des Mantis-Frameworks.
Heute werden wir den Aufbau dieser Architektur fortsetzen und uns den nächsten wichtigen Bausteinen des neuronalen Netzwerkmodells zuwenden. In der Planungsphase hatten wir im vorherigen Artikel vereinbart, dass eine temporale Kodierung im Datenstrom implementiert werden muss. Diese Entscheidung wurde von dem Wunsch geleitet, die Interpretierbarkeit zu verbessern und der Positionsstruktur der Quelldaten Rechnung zu tragen, ohne dabei Leistungseinbußen in Kauf zu nehmen. Natürlich werden wir das Rad nicht neu erfinden: Glücklicherweise verfügen wir bereits über ein bewährtes Objekt – CMamba4CastEmbedding. Wir haben es im Rahmen unserer Arbeit am Mamba4Cast-Framework entwickelt, und nun eignet es sich perfekt für diese Aufgabe.
Der nächste logische Schritt besteht darin, das Patching der Zeitreihe zu organisieren. In dieser Phase verliert das Modell seine Abhängigkeit von der Länge der Eingabesequenz und erhält die Fähigkeit, mit einer festen Anzahl von Patches zu arbeiten, unabhängig von der Größenordnung der Daten. Dies ist ohne Übertreibung eines der wichtigsten Module in der Architektur des Klassifikators, da die Stabilität der gesamten nachfolgenden Verarbeitung von seiner Implementierung abhängt. Damit beginnen wir unsere heutige Arbeit: Schritt für Schritt werden wir einen Mechanismus entwickeln, der den Strom der Quellinformationen in kompakte, aussagekräftige Patches aufteilt.
Segmentierungsobjekt
Die Autoren des ursprünglichen Mantis-Frameworks gingen das Problem der Zeitreihensegmentierung aus einem unerwarteten, aber eleganten Blickwinkel an. Anstatt die Sequenz einfach in gleich große Segmente zu unterteilen, schlugen sie vor, die Daten zunächst mithilfe einer Faltungsoperation zu transformieren. Darüber hinaus wendeten sie die Faltung nicht nur um ihrer selbst willen an, sondern nutzten sie, um eine eindimensionale Zeitreihe in einen mehrkanaligen Tensor umzuwandeln. Auf den ersten Blick mag diese Idee unnötig erscheinen, doch in der Praxis bietet sie einen erheblichen Vorteil: Durch die Verwendung einer Faltung mit kleinem Fenster beginnt das Modell, lokale Signalschwankungen zu erkennen und wichtige Nuancen im Marktverhalten zu erfassen, die andernfalls vor dem Hintergrund des Gesamttrends verloren gehen könnten.
Nach dieser Transformation erhalten wir einen mehrkanaligen Tensor, in dem jeder Kanal eine separate Projektion der ursprünglichen Zeitreihe darstellt – mit anderen Worten: eine „Mini-Darstellung“ des Signals aus seiner eigenen Perspektive. Dieser Tensor wird anschließend gleichmäßig in eine feste Anzahl von Patches unterteilt. Das sind die Patches – die Bausteine, mit denen das Modell künftig arbeiten wird. Und hier kommt die nächste Phase ins Spiel: die Aggregation von Informationen innerhalb jedes Segments.
Die Autoren von Mantis schlugen vor, die klassische kanalweise Mittelwertbildung zu verwenden, die als Mean-Pooling bekannt ist. Es ist einfach, intuitiv und liefert eine gute, geglättete Darstellung des Segments. Im Gegensatz zu Max-Pooling, bei dem nur der Maximalwert beibehalten wird, bewahrt Mean-Pooling den Kontext, sodass jedes Element der Zeitreihe zum endgültigen Token beitragen kann. Dies ist besonders nützlich, wenn jeder Patch einen relativ großen Teil der Daten abdeckt – in solchen Fällen müssen Sie alle verfügbaren Informationen berücksichtigen, nicht nur die Spitzen- und Tiefstwerte. Die auf diese Weise generierten Token bieten eine kompakte und aussagekräftige Darstellung der temporalen Struktur der Quelldaten, die sich für die weitere Analyse durch einen Transformer eignet.
Wie die Praxis jedoch zeigt, kann das Mean-Pooling zu „höflich“ sein – es mittelt nicht nur die Informationen, sondern auch etwaige Anomalien oder abrupte Veränderungen in der Signalstruktur. Für ein Foundation-Modell mag dies ein akzeptabler Kompromiss sein: Es bleibt einfach, schnell und verallgemeinerbar. Wir haben jedoch beschlossen, noch einen Schritt weiterzugehen. In unserer Implementierung haben wir das standardmäßige Mean-Pooling durch eine Kombination aus kanalweiser Faltung und anschließendem Max-Pooling ersetzt.
Was bringt uns das in der Praxis? Zunächst extrahiert die Faltungsoperation Merkmale innerhalb jedes Kanals, wodurch eine erste Filterung erfolgt und lokale Veränderungen hervorgehoben werden. Anschließend hebt das Max-Pooling die ausgeprägtesten Ausprägungen dieser Merkmale hervor. Durch diesen Ansatz lässt sich das Modell genauer auf die Dynamik der Zeitreihe abstimmen. Anstatt alles zu mitteln, erfasst es die wesentlichen Merkmale, wodurch es schneller und präziser auf plötzliche Bewegungen reagiert. Diese Eigenschaft ist beim Hochfrequenz-Trading oder beim Trading mit volatilen Vermögenswerten von entscheidender Bedeutung.
Gerade dank dieser Anpassung der Patching-Methode ist unser Klassifikator in der Lage, sich an die Form und Struktur jeder einzelnen Zeitreihe anzupassen. Es gliedert Daten nicht mehr nur in Segmente auf, sondern führt auch Analyse, Extraktion, Filterung und Auswertung durch. In einem solchen System ist ein einzelner Patch nicht mehr nur ein Fragment eines Signals, sondern ein vollwertiger, informationsreicher Token, der sowohl den Kontext als auch die Form des Signals in sich trägt.
Der vorgeschlagene Algorithmus ist in der Klasse CNeuronMantisPatching implementiert. Hierbei handelt es sich um ein Spezialmodul, das für die Segmentierung einer Zeitreihe in strukturierte Patches sowie für die Erzeugung einer für die weitere Verarbeitung geeigneten höherstufigen Darstellung zuständig ist. Hier beginnt das eigentliche Verständnis der Daten: Lokale Muster werden aus einem einfachen eindimensionalen Datenstrom extrahiert und in dichte Vektorbeschreibungen umgewandelt.
Die Klasse CNeuronMantisPatching ist als mehrstufige Rechenpipeline aufgebaut. Sie enthält mehrere interne Objekte, von denen jedes eine hoch spezialisierte Aufgabe erfüllt. Die Klassenstruktur ist unten dargestellt.
class CNeuronMantisPatching   :  public CNeuronTransposeOCL
  {
protected:
   CNeuronTransposeOCL     cToVarSeq;
   CNeuronConvOCL          cProjecting;
   CNeuronTransposeVRCOCL  cToVarProjSeq;
   CNeuronConvOCL          cPatchingProj;
   CNeuronProofOCL         cProof;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL)  override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL)  override;

public:
                     CNeuronMantisPatching(void) {};
                    ~CNeuronMantisPatching(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint count, uint patchs, uint variables,
                          uint embedding_size, uint patch_filters,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual int       Type(void)  override const {  return defNeuronMantisPatching; }
   //---
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
  };
Alle internen Objekte werden statisch deklariert, wodurch der Konstruktor und der Destruktor der Klasse leer bleiben können. Sie werden in der Init-Methode konfiguriert, deren Parameter einen Satz von Konstanten bereitstellen, anhand derer wir die Architektur des zu erstellenden Objekts eindeutig bestimmen können.
bool CNeuronMantisPatching::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                 uint count, uint patchs, uint variables,
                                 uint embedding_size, uint patch_filters,
                                 ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronTransposeOCL::Init(numOutputs, myIndex, open_cl, variables * embedding_size,
                                                        patchs, optimization_type, batch))
      return false;
Es ist anzumerken, dass wir davon ausgehen, dass die Eingabe für das Objekt CNeuronMantisPatching eine Matrix mit Werten aus einer mehrkanaligen Zeitreihe ist, wobei jede Spalte einen separaten Kanal darstellt. Zudem besteht jeder Kanal aus einer Abfolge von numerischen Messwerten über die Zeit. Mit anderen Worten: Es handelt sich um eine Matrix der Dimension [T * C], wobei T die Anzahl der Zeitschritte und C die Anzahl der Kanäle (Variablen) ist.
Datentranspositionsobjekte werden verwendet, um die unabhängige Verarbeitung einzelner Kanäle innerhalb des Moduls zu ermöglichen. Dies ist notwendig, um eine getrennte Verarbeitung entlang der Kanal- und Zeitachse zu gewährleisten – eine solche Isolation lässt sich nur schwer erreichen, ohne die Achsen explizit zu verschieben. Darüber hinaus erbt die Klasse CNeuronMantisPatching selbst von CNeuronTransposeOCL, wodurch es möglich ist, nach der Anwendung aller Transformationen die inverse Transposition mithilfe der Methoden der übergeordneten Klasse durchzuführen und den Ausgabetensor in der erwarteten Form zurückzugeben.
Der erste Schritt der Initialisierungsmethode besteht darin, die gleichnamige Methode in der übergeordneten Klasse CNeuronTransposeOCL aufzurufen. Diese Methode bereitet die Grundstruktur vor und führt die vorläufige Initialisierung der Parameter durch. Dieser Schritt ist notwendig, damit alle vererbten Mechanismen ordnungsgemäß funktionieren.
Sobald die übergeordnete Klasse erfolgreich initialisiert wurde, beginnt die Konfiguration der internen Komponenten. Als Erstes wird das cToVarSeq-Objekt konfiguriert – eine Matrix-Transpositionsschicht, die einen bequemen Zugriff auf die einzelnen Zeitreihen jedes Kanals ermöglicht. Sein Zweck besteht darin, die Eingabedaten so umzuwandeln, dass jeder Kanal zu einer eigenständigen Zeitreihe wird, die für die anschließende lokale Faltung geeignet ist.
   int index = 0;
   if(!cToVarSeq.Init(0, index, OpenCL, count, variables, optimization, iBatch))
      return false;
Als Nächstes initialisieren wir das lokale Kodierungsobjekt cProjecting. Dies ist eine Faltungsschicht, die als „aufmerksamer Beobachter“ fungiert und jeden Kanal der Zeitreihe mit einem festen Fenster der Breite 3 und einem Stride von 1 abtastet. Die Aufgabe besteht darin, kurzfristige lokale Muster zu erkennen und sie in einem Raum mit der festen Dimension embedding_size darzustellen.
   index++;
   if(!cProjecting.Init(0, index, OpenCL, 3, 1, embedding_size, count - 2, variables,
                                                               optimization, iBatch))
      return false;
   cProjecting.SetActivationFunction(SoftPlus);
Es ist wichtig zu betonen, dass die Verarbeitung streng kanalweise erfolgt: Jeder Kanal wird unabhängig analysiert, wodurch sich das Modell an die individuellen Eigenschaften der Signale anpassen kann. Darüber hinaus verfügt jeder Kanal über einen eigenen, einzigartigen Satz von Faltungsfiltern, was dem Verfahren eine außergewöhnliche Flexibilität und Genauigkeit verleiht.
Das Ergebnis dieser Operation ist ein Tensor der Dimensionen [C * T' * D], wobei:
- C – die Anzahl der Kanäle (Merkmale),
- T' – die resultierende Länge der Zeitachse nach der Faltung mit einer Fenstergröße von 3,
- D – die Dimension der neuen Darstellung nach der Kodierung.
Dieser Tensor ist eine lokal komprimierte und bereits teilweise strukturierte Form der Originaldaten, die als Grundlage für die weitere Segmentierung und Aggregation dienen wird. Dies liefert uns eine Art komprimierte Momentaufnahme der kurzfristigen Dynamik innerhalb jedes Merkmals – etwas, das herkömmliche Methoden der Zeitreihenanalyse ohne umständliche und ressourcenintensive Transformationen nur selten erfassen können.
Als Nächstes folgt die Segmentierungsphase. Und hier ist es wichtig, einen subtilen Punkt zu verstehen. In unserem Kontext besteht der Segmentierungsvorgang selbst darin, die Daten entlang der Zeitachse zu teilen – das heißt, die Sequenz in Segmente fester Länge zu zerlegen. Im vorherigen Schritt wird das Faltungsergebnis jedoch als Tensor dargestellt, wobei die Zeitachse die zweite Dimension bildet. Zur Vereinfachung der weiteren Verarbeitung und zur Anpassung an die Architektur der nachfolgenden Schichten müssen wir die Achsen neu anordnen.
Daher verwenden wir ein dreidimensionales Tensor-Transpositionsobjekt, mit dem wir die Achsen neu anordnen, um die Dimensionen in eine für die temporale Segmentierung geeignete Form zu bringen. Dadurch erhalten wir einen Tensor mit der neuen Struktur [C * D * T'].
   index++;
   if(!cToVarProjSeq.Init(0, index, OpenCL, variables, count-2, embedding_size, optimization, iBatch))
      return false;
Diese Datendarstellung ist praktisch und logisch: Wir können nun direkt mit der Sequenz über die Zeit arbeiten und sie in gleich große Segmente unterteilen, von denen jedes als eigenständiges semantisches Segment behandelt wird. Dies entspricht unserer ursprünglichen Absicht – nämlich von der Analyse einzelner Punkte zur Analyse von Mustern überzugehen.
In dieser neuen Form gelangt der Tensor in die nächste Stufe, in der die Hauptoperationen der Segmentierung und der Informationsaggregation stattfinden. Die Hauptaufgabe besteht darin, eine Zeitreihe in eine festgelegte Anzahl von Segmenten zu unterteilen und aus jedem einzelnen eine aussagekräftige Darstellung zu gewinnen. Da uns jedoch zunächst nur die erforderliche Anzahl von Segmenten (Patches) vorgegeben ist, müssen wir zuerst die Größe eines einzelnen Segments berechnen – also ermitteln, wie viele Zeitschritte in jeden Patch fallen.
Als Nächstes initialisieren wir die Faltungsschicht cPatchingProj, die die Segmentierung durchführen wird. Diese Schicht verwendet ein Fenster, dessen Größe der berechneten Patch-Größe entspricht, und gleitet mit demselben Stride entlang der Zeitachse, wodurch die Erstellung nicht überlappender Segmente sichergestellt wird.
   index++;
   int patch_size = (int(count + patchs) - 3) / int(patchs);
   if(!cPatchingProj.Init(0, index, OpenCL, patch_size, patch_size, patch_filters,
                        patchs, variables * embedding_size, optimization, iBatch))
      return false;
   cPatchingProj.SetActivationFunction(SoftPlus);
Es ist wichtig zu beachten, dass hierbei – anders als beim einfachen Mean-Pooling – eine reguläre Faltungsoperation mit mehreren Filtern (patch_filters) zum Einsatz kommt. Dadurch kann das Modell nicht nur Informationen innerhalb eines Segments mitteln, sondern auch die relevantesten Merkmale aus jedem Segment extrahieren, indem es auf charakteristische lokale Muster reagiert.
Nachdem der Tensor die cPatchingProj-Schicht durchlaufen hat, erhalten wir einen vierdimensionalen Tensor mit der Form [C × D × P × F], wobei:
- P – die Anzahl der Segmente (Patches),
- F – die Anzahl der Filter, die auf jedes Patch angewendet werden.
Dieser Tensor enthält die angereicherten Darstellungen jedes Segments jedes Kanals über alle Filter hinweg. Für die weitere Verarbeitung müssen diese Daten jedoch aggregiert werden. An dieser Stelle wird die Max-Pooling-Operation entlang der letzten Dimension – also entlang der Filterachse F – angewendet. Diese Operation wählt für jede Dimension den ausgeprägtesten Wert aus und ermöglicht es, redundante oder nur schwach aktivierte Filter zu verwerfen. Danach hat der Tensor die Dimensionen [C × D × P].
   index++;
   if(!cProof.Init(0, index, OpenCL, patch_filters, patch_filters,
            patchs*variables*embedding_size, optimization, iBatch))
      return false;
//---
   return true;
  }
Die abschließende Datentransformation erfolgt mithilfe der übergeordneten Klasse, die wir zuvor initialisiert haben. Daher schließen wir die Methode ab, indem wir das boolesche Ergebnis der Operationen an das aufrufende Programm zurückgeben.
Es ist erwähnenswert, dass die CNeuronMantisPatching-Architektur äußerst modular aufgebaut ist. Jede interne Schicht verarbeitet die Kanäle unabhängig voneinander, wodurch die Architektur äußerst skalierbar ist. Unabhängig von der Anzahl der analysierten Kanäle bleibt die Verarbeitungslogik unverändert, da jeder Kanal als eigenständiger Datenstrom behandelt wird.
Zudem ermöglicht diese unabhängige Struktur eine effektive Parallelisierung der Berechnungen. Da alle verwendeten neuronalen Schichten in OpenCL implementiert sind, nutzen sie automatisch die verfügbare GPU oder ein anderes kompatibles Rechengerät. Dadurch ist es möglich, Hunderte von parallelen Threads gleichzeitig auszuführen, wobei jeder einen separaten Kanal verarbeitet, ohne dass dabei nennenswerte Zeitverluste entstehen.
Bei der Analyse der Struktur der Initialisierungsmethode haben wir die grundlegende Funktionsweise der Klasse CNeuronMantisPatching sowie das Zusammenspiel ihrer internen Komponenten ausführlich beschrieben. In dieser Methode werden alle wesentlichen Schritte der Verarbeitung einer mehrkanaligen Zeitreihe nacheinander aufgebaut: von der anfänglichen Transposition über die Segmentierung bis hin zur Informationsaggregation.
Um diesen Artikel nicht mit unnötigen Details zu überfrachten, haben wir bewusst auf Beschreibungen des Vorwärtsdurchlaufs (feedForward) und zum Rückwärtsdurchlauf (calcInputGradients, updateInputWeights) verzichtet. Sie implementieren streng sequenzielle Aufrufe der gleichnamigen Methoden der internen Objekte entsprechend der Architektur der aufgebauten Pipeline.
Der vollständige Quellcode für diese Klasse, einschließlich der Implementierung aller Hilfsmethoden, ist im Anhang enthalten. Auf Wunsch können die Leser ihn selbst einsehen und alle technischen Details eingehender untersuchen.
Attention-Modul
Entsprechend der allgemeinen Logik des Mantis-Frameworks wird die vorverarbeitete Zeitreihensequenz – die bereits in Form von Token vorliegt, die sich aus Patches einzelner Kanäle zusammensetzen – dem Transformer-Modul zugeführt. Hier findet die abschließende Verarbeitung der temporalen und kanalübergreifenden Informationen statt: Der Token-Sequenz wird ein spezielles Klassentoken hinzugefügt, und die Positionskodierung wird integriert.
Das Klassentoken dient als eine Art Informationsaggregator. Während es die sechs Schichten des Multi-Head-Self-Attention-Mechanismus (Self-Attention) durchläuft, aggregiert es strukturelle Informationen über die gesamte Sequenz. Der entsprechende Ausgabevektor dient als Klassenrepräsentation der analysierten Zeitreihe interpretiert – unabhängig davon, ob es bei der Aufgabe um die Erkennung einer Marktphase, die Klassifikation von Indikatorzuständen oder die Prognose der Art der zukünftigen Bewegung geht.
Bei unserer Umsetzung haben wir an dieser Stelle einige Anpassungen vorgenommen. Zunächst wurde die Positionskodierung weggelassen. Der Grund dafür ist, dass die temporale Struktur der Sequenz dank der integrierten temporalen Kodierung, die aus der Mamba4Cast-Architektur übernommen wurde, bereits explizit in den Token selbst kodiert ist. Dieser Ansatz ermöglicht es, die absoluten und relativen Positionen jedes Elements innerhalb des Kanals zu kodieren, ohne auf sinusförmige oder gelernte Positionsvektoren zurückzugreifen, wie dies bei klassischen Transformern üblich ist.
Diese Änderung bietet gleich zwei Vorteile. Erstens macht sie das Modell weniger empfindlich gegenüber Verschiebungen und Verzerrungen in der Eingabesequenz. Zweitens beseitigt sie den Konflikt zwischen dem festen Positionscode und dem tatsächlichen temporalen Kontext, der bereits in den Daten vorhanden ist. Bei der Anwendung auf reale Marktzeitreihen verbessert dies die Robustheit des Modells und ermöglicht es dem Transformer, sich auf den Inhalt des Eingangssignals zu konzentrieren.
Zudem wird in der vom Autor verwendeten Implementierung von Mantis am Ausgang des Transformers ausschließlich das Klassentoken verwendet – ein spezieller Vektor, der dazu dient, verallgemeinerte Informationen über die Sequenz zu akkumulieren. Dieses Token wird der Eingabesequenz vorangestellt, durchläuft alle Schichten des Transformers und wird am Ausgang extrahiert.
In unserer Umsetzung haben wir uns jedoch für eine alternative Lösung entschieden. Anstelle der herkömmlichen Methode, bei der ein Klassentoken am Anfang der Sequenz eingefügt und anschließend extrahiert wird, verwenden wir ein Cross-Attention-Modul (Cross-Attention). Das Besondere daran ist, dass das Klassentoken als Haupt-Query (Query) bereitgestellt wird, während die Token aus der Quellsequenz als Kontext (Keys und Values) bereitgestellt werden. Diese Konfiguration ermöglicht es dem Klassentoken, sich auf die wichtigsten Elemente der Sequenz zu konzentrieren, wodurch Rauschen minimiert und relevante Verbindungen verstärkt werden.
Darüber hinaus haben wir eine Cross-Attention-Variante mit unabhängigen Kanälen angewendet, bei der jeder Kanal isoliert analysiert wird. Dadurch lässt sich der Beitrag jedes einzelnen Kanals zur Attention individuell bewerten. Dieser Ansatz ist besonders nützlich bei der Analyse multimodaler oder heterogener Signale, da er verhindert, dass ein Kanal die anderen dominiert, und eine objektive, aggregierte Sicht auf die gesamte Struktur der Zeitreihe bietet.
Somit enthält der vom Cross-Attention-Block resultierende Aggregationsvektor bereits eine verallgemeinerte und ausgewogene Darstellung der gesamten zeitlichen Struktur, die sich für die anschließende Klassifikation oder Vorhersage eignet.
Aus technischer Sicht wird all dies in der Klasse CNeuronMantisAttentionUnit implementiert, die von CNeuronSoftMaxOCL abgeleitet ist. Das bedeutet, dass die Ausgabe uns sofort die Wahrscheinlichkeit angibt, mit der die analysierte Sequenz zu einer bestimmten Klasse gehört. Die Struktur des neuen Objekts ist unten dargestellt.
class CNeuronMantisAttentionUnit :  public CNeuronSoftMaxOCL
  {
protected:
   CNeuronBaseOCL                cClassToken[2];
   CNeuronMVCrossAttentionMLKV   cAttention;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL)  override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL)  override;

public:
                     CNeuronMantisAttentionUnit(void) {};
                    ~CNeuronMantisAttentionUnit(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint token_size, uint window, uint window_key, uint heads,
                          uint units_count, uint layers, uint variables,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual int       Type(void)  override const {  return defNeuronMantisAttentionUnit; }
   //---
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
  };
Innerhalb der neuen Klasse sehen wir zwei Hauptkomponenten:
- cClassToken[2] – ein zweischichtiges MLP zur Erzeugung eines trainierbaren Klassentokens;
- cAttention ist das mehrschichtige Cross-Attention-Objekt selbst.
Alle internen Objekte werden statisch deklariert, wodurch der Konstruktor und der Destruktor der Klasse leer bleiben können. Wie üblich werden interne Objekte in der Init-Methode initialisiert.
bool CNeuronMantisAttentionUnit::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                      uint token_size, uint window, uint window_key,
                                      uint heads, uint units_count, uint layers, uint variables,
                                      ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronSoftMaxOCL::Init(numOutputs, myIndex, open_cl, token_size, optimization_type, batch))
      return false;
Hier rufen wir zunächst die gleichnamige Methode in der übergeordneten Klasse auf, in der, wie Sie wissen, die Initialisierung der geerbten Objekte und Schnittstellen bereits durchgeführt wurde. Nachdem die Methode der übergeordneten Klasse erfolgreich ausgeführt wurde, fahren wir mit der Initialisierung der internen Objekte fort. Zunächst initialisieren wir das MLP zur Generierung eines trainierbaren Klassentokens. Die erste Schicht enthält immer ein einzelnes Element mit einem festen Wert, während die zweite Schicht trainierbare Parameter verwendet, um ein Klassentoken der erforderlichen Größe zu generieren.
   int index = 0;
   if(!cClassToken[0].Init(token_size, index, OpenCL, 1, optimization, iBatch))
      return false;
   if(!cClassToken[0].getOutput().Fill(1))
      return false;
   index++;
   if(!cClassToken[1].Init(0, index, OpenCL, token_size, optimization, iBatch))
      return false;
   cClassToken[1].SetActivationFunction(SIGMOID);
Um Token-Elemente innerhalb eines bestimmten Wertebereichs zu erhalten, verwenden wir in der letzten Schicht eine Sigmoid-Aktivierungsfunktion.
Der nächste Schritt besteht darin, den Cross-Attention-Block zu initialisieren. Wir erhalten alle Konfigurationsdaten vom Benutzer über die Parameter unserer Initialisierungsmethode.
   index++;
   if(!cAttention.Init(0, index, OpenCL, token_size, window_key, heads * variables, window,
                       heads, 1, units_count, layers, 1, 1, variables, optimization, iBatch))
      return false;
//---
   return true;
  }
Damit schließen wir die Methode ab, indem wir das boolesche Ergebnis der Operationen an das aufrufende Programm zurückgeben.
Die Methode feedForward ist ebenso knapp gehalten. Als Methodenparameter erhalten wir einen Zeiger auf das Kontextobjekt der zu analysierenden Sequenz und prüfen sofort dessen Gültigkeit.
bool CNeuronMantisAttentionUnit::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
Als Nächstes müssen wir das Klassentoken generieren. Dieser Vorgang wird jedoch nur während des Modelltrainings durchgeführt. Während des Betriebs ändern sich die Parameter des Modells nicht; folglich bleibt das Klassentoken unverändert. Daher müssen wir es nicht bei jeder Iteration neu generieren.
//---
   if(bTrain)
     {
      if(!cClassToken[1].FeedForward(cClassToken[0].AsObject()))
         return false;
     }
Das generierte Klassentoken wird zusammen mit dem Kontext der zu analysierenden Sequenz in den Attention-Block eingespeist.
   if(!cAttention.FeedForward(cClassToken[1].AsObject(), NeuronOCL.getOutput()))
      return false;
Die Ausgabe des Attention-Blocks – ein angereichertes Klassentoken – wird an den Eingang der übergeordneten Klasse CNeuronSoftMaxOCL weitergeleitet. In diesem Schritt wird der vorhergesagte Wert in eine probabilistische Interpretation umgewandelt. Das Ergebnis ist eine Wahrscheinlichkeitsverteilung über die Klassen.
   if(!CNeuronSoftMaxOCL::feedForward(cAttention.AsObject()))
      return false;
//---
   return true;
  }
Abschließend sei angemerkt, dass die Rückwärtsdurchlaufsmethoden (calcInputGradients und updateInputWeights) aufeinanderfolgende Aufrufe der entsprechenden Funktionen der verschachtelten Komponenten implementieren. Die Leser können deren Implementierung selbst nachvollziehen, um den Prozess des Trainings und der Aktualisierung der Gewichte im Modul CNeuronMantisAttentionUnit vollständig zu verstehen. Der vollständige Code für diese Klasse und alle ihre Methoden ist im Anhang enthalten.
Wir haben alle für heute geplanten Arbeiten abgeschlossen. Im nächsten Artikel werden wir die Architektur der Modelle untersuchen und die Effektivität der implementierten Lösungen anhand realer historischer Daten bewerten.
Fazit
Wir haben den gesamten Weg zurückgelegt – von der anfänglichen Datenaufbereitung mit der Berechnung von Differenzen erster Ordnung, der Konkatenation von Merkmalen und der temporalen Kodierung auf Basis von CMamba4CastEmbedding bis hin zur komplexen Patch-Verarbeitung und intelligenten Aggregation mittels Cross-Attention unter Verwendung des Klassentokens. Jeder Schritt in dieser Kette – von der Transposition und lokalen Faltungen bis hin zu Max-Pooling und Multi-Head-Attention – wurde sorgfältig konzipiert, um ein möglichst vollständiges Bild der zeitlichen Dynamik zu bewahren und gleichzeitig die Rechenressourcen mit Schwerpunkt auf OpenCL-Parallelismus zu optimieren.
Das Ergebnis war eine modulare Architektur, in der sich die Anzahl der Kanäle, die Patch-Größe, die Embedding-Tiefe und die Anzahl der Attention-Heads leicht anpassen lassen, ohne die zugrunde liegende Logik zu verändern. Dadurch lässt sich das Modell schnell an eine Vielzahl von Finanzszenarien anpassen – vom Hochfrequenz-Trading bis hin zur Analyse langfristiger Trends.
Im nächsten Abschnitt werden wir ein vollständiges Diagramm des trainierbaren Modells auf der Grundlage der beschriebenen Komponenten vorstellen und dessen Ergebnisse anhand historischer Daten veranschaulichen.
Literaturverzeichnis
- Mantis: Ein leichtgewichtiges, kalibriertes Foundation-Modell (Basismodell) für die benutzerfreundliche Klassifikation von Zeitreihen
- Weitere Artikel dieser Reihe
In diesem Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Research.mq5 | Expert Advisor (EA) | Expert Advisor zum Sammeln von Beispielen |
| 2 | ResearchRealORL.mq5 | Expert Advisor (EA) | Expert Advisor zum Sammeln von Beispielen mit der Real-ORL-Methode |
| 3 | StudyContrast.mq5 | Expert Advisor (EA) | Expert Advisor für kontrastives Encoder-Training |
| 4 | Study.mq5 | Expert Advisor (EA) | Expert Advisor für das Offline-Modelltraining |
| 5 | StudyOnline.mq5 | Expert Advisor (EA) | Expert Advisor für Online-Training des Modells |
| 6 | Test.mq5 | Expert Advisor (EA) | Expert Advisor für Modelltests |
| 7 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 8 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Erstellen neuronaler Netze |
| 9 | NeuroNet.cl | Bibliothek | OpenCL-Programmcode-Bibliothek |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/18307
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.

 Von den Grundlagen zur Mittelstufe: Objektereignisse (II)
 Neuronale Netze im Handel: Generalisierung von Zeitreihen ohne Abhängigkeit von spezifischen Datensätzen (Fazit)
 MQL5 meistern – Vom Anfänger zum Profi (Teil VII): Grundlagen des Debuggings von MQL-Anwendungen
 Vom Anfänger zum Fortgeschrittenen: Objekte (II)

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.