

Конструирование признаков для машинного обучения (Часть 14): Признаки на основе сканирования трендов в MQL5
 24
 2

Содержание
- Введение
- От O(H·L) до O(H) на бар
- Выполнение кода заголовочного файла, а не его повторной реализации
- Ошибка знака: то же вычислительное ядро, обратный порядок входных данных, знак не инвертирован
- Что это означает для части 13
- Маскирование по волатильности: почему volatility_threshold=0.0 означает минимум по накопленной истории
- Индикатор: буферы и контракт OnCalculate
- Результаты: производительность на уровне скомпилированного кода и численное соответствие
- Правило отбора не обеспечивает отбора по статистической значимости
- Чтение признаков из советника
- Заключение
- Список литературы
- Прикрепленные файлы
Введение
В части 13 для afml.labeling.trend_scanning был создан интерфейс get_trend_scanning_features, предоставляющий только каузальные признаки: аргумент lookforward в нем удален, а не просто описан в документации, поскольку режим разметки по умолчанию небезопасно использовать при формировании матрицы признаков. В этой статье те же каузальные вычисления перенесены на MQL5 в виде CTrendScanningFeatures.mqh. Реализация с нуля, без опоры на используемый в Python прием разворота порядка данных, выявила дефект, унаследованный кодом на Python: trend_scanning_labels(lookforward=False) возвращает наклон и t-статистику с неверным знаком.
В разделах 4 и 5 описаны обнаруженный дефект и его влияние на опубликованную в части 13 обертку, а также приведены подтверждающие данные. В разделе 9 рассматривается второй, отдельный результат, касающийся метода, а не кода: правило выбора среди окон-кандидатов не выбирает наиболее статистически значимый тренд, а выдаваемую им t-статистику при работе с ценовыми данными нельзя интерпретировать путем сравнения с номинальным порогом t-распределения Стьюдента. Оба утверждения подтверждаются с помощью моделирования, а не аргументации.
В оставшейся части статьи рассматриваются собственно технические решения, потребовавшиеся при переносе: инкрементальное обновление со сложностью O(1) для каждого горизонта вместо полного пересчета окна из части 13, упрощение маскирования по волатильности, вытекающее из значения параметра модуля по умолчанию, и индикатор для графика, предоставляющий доступ к четырем буферам каузальных признаков через тот же контракт iCustom, который используется во всей серии.
От O(H·L) до O(H) на бар
Функция trend_scanning_labels заново рассчитывает каждое окно-кандидат с помощью вычислительного ядра Numba, которое суммирует значения в окне с нуля: для H горизонтов со средней длиной L это дает O(H·L) операций на бар. В MQL5 нет векторизованной операции редукции, позволяющей выполнять суммирование столь же эффективно,, как NumPy в исходной реализации на Python, поэтому при прямом переносе на каждом баре пришлось бы выполнять явный цикл с полной сложностью O(H·L). Вместо этого CTrendScanningFeatures хранит три обновляемые суммы для каждого горизонта и обновляет их за O(1) на бар.
Это тождество следует из способа индексации времени в вычислительном ядре. Для окна длиной L выполняется подгонка регрессии по локальному индексу времени t = 0..L-1, причем индекс 0 соответствует самой старой точке окна. Запишем три суммы, необходимые для подгонки регрессии:
sum_y(t)  = sum_{i=0}^{L-1} y[t-L+1+i]
sum_y2(t) = sum_{i=0}^{L-1} y[t-L+1+i]^2
sum_ty(t) = sum_{i=0}^{L-1} y[t-L+1+i] * i
Когда окно сдвигается вперед на один бар, локальный индекс каждой оставшейся в нем точки уменьшается на единицу, а новая точка добавляется с локальным индексом L-1. Подставляя и приводя подобные слагаемые, получаем:
sum_ty(t+1) = sum_ty(t) - sum_y(t) + y_leaving + y_entering * (L-1)
sum_y(t+1)  = sum_y(t)  - y_leaving + y_entering
sum_y2(t+1) = sum_y2(t) - y_leaving^2 + y_entering^2
Каждое обновление требует четырех умножений и нескольких сложений независимо от L. Величины mean_t и var_t зависят только от L, а не от данных, поэтому они вычисляются один раз в Init по явным формулам, а не рассчитываются заново на каждом баре:
const double mean_t = (L - 1) / 2.0;
//--- closed form for sum((t - mean_t)^2), t = 0..L-1: L*(L^2-1)/12
const double var_t  = L * ((double)L * L - 1.0) / 12.0;
Эти три суммы хранятся в отдельной структуре для каждого горизонта, а один кольцевой буфер длиной max_horizon + 1 предоставляет и входящее значение (только что добавленный бар), и выбывающее значение (самую старую точку окна на предыдущем баре), необходимые для обновления каждого горизонта:
struct HorizonState
  {
   int               L;
   double            mean_t;
   double            var_t;
   double            sum_y;
   double            sum_y2;
   double            sum_ty;
   bool              ready;
  };
На первом баре, для которого доступен расчет по данному горизонту, инкрементальное обновление невозможно, поскольку предыдущего окна для сдвига еще нет; начальные суммы вычисляются однократно полным суммированием со сложностью O(L), как это делает эталонная реализация на каждом баре. На каждом последующем баре сложность составляет O(1). В разделе 8 оценивается практический выигрыш, который оказывается меньше, чем можно предположить лишь по сравнению O(H·L) и O(H).
Выполнение кода заголовочного файла, а не повторная реализация
Метод проверки тот же, что использовался ранее в этой серии для модулей структурных сдвигов и фракталов: файл CTrendScanningFeatures.mqh механически преобразуется в компилируемый код C++ (динамические массивы заменяются на std::vector, для встроенных функций вывода MQL5 используются функции-адаптеры), после чего компилируется и запускается сам преобразованный текст заголовочного файла, а не написанная вручную реализация той же логики на C++. Управляющая программа подает на вход CSV-файл с ценами закрытия и записывает четыре выходных столбца; комплекс проверки на Python обрабатывает тот же ряд с помощью эталонной реализации и сравнивает результаты двух реализаций.
g++ -O2 -std=c++17 -I test -o test/run_engine test/run_engine.cpp
python3 test/parity_test.py
Для всех пяти наборов параметров — с тремя вариантами ширины диапазона длин окон и обоими значениями use_log — результаты совпали с эталонной реализацией на Python в пределах 1e-9 для наклона и R² и в пределах относительной погрешности 3e-5 для t-статистики. Последний допуск больше остальных по конкретной, проверяемой причине: в нескольких окнах тестовых данных точки лежат почти точно на прямой (R² выше 0.9999995), а t-статистика вычисляется делением на стандартную ошибку оценки, которая в этих окнах близка к нулю. При такой вырожденности обе реализации численно неустойчивы; в обновляемых суммах инкрементального вычислительного механизма накапливается на несколько битов больше погрешности вычислений с плавающей запятой, чем при суммировании 3–4 точек заново, и эта погрешность усиливается тем же делением, которое изначально делает обе версии чувствительными к ней. Это не логическая ошибка, и такую проблему легко упустить без комплекса проверки, который действительно выполняет поставляемый код.
Ошибка знака: то же вычислительное ядро, обратный порядок входных данных, знак не инвертирован
Независимая реализация инкрементального вычислительного механизма на основе математики подгонки (а не приема с обращением порядка данных) позволила выполнить дополнительную проверку. Его результаты сравнивались по каждому бару с результатами функции trend_scanning_labels(lookforward=False). Значения по модулю совпадали с машинной точностью. Каждый наклон и каждая t-статистика имели противоположный знак.
Причина кроется в том, как реализован обратный режим. В этом режиме порядок элементов ценового ряда обращается, затем запускается то же вычислительное ядро, которое используется для разметки и работает только в прямом режиме, после чего порядок результатов снова обращается, чтобы вернуть их на соответствующие позиции баров:
y_window = y if lookforward else y[::-1]
t_vals, slopes, r_sq = _window_stats_numba(y_window, hrzn)
if not lookforward:
    t_vals, slopes, r_sq = t_vals[::-1], slopes[::-1], r_sq[::-1]
Вычислительное ядро всегда считает элемент с индексом 0 в любом полученном массиве началом локального отсчета времени. В массиве с обратным порядком элементов индекс 0 соответствует самой новой исходной точке, а не самой старой, поэтому оцененный наклон описывает изменение цены по мере увеличения локального индекса времени в направлении самой старой точки; то есть подгонка выполняется по обращенной оси времени. Последующее обращение порядка результатов возвращает каждую статистику на соответствующий бар, но не устраняет изменение знака, вызванное подгонкой по оси времени, направленной назад.
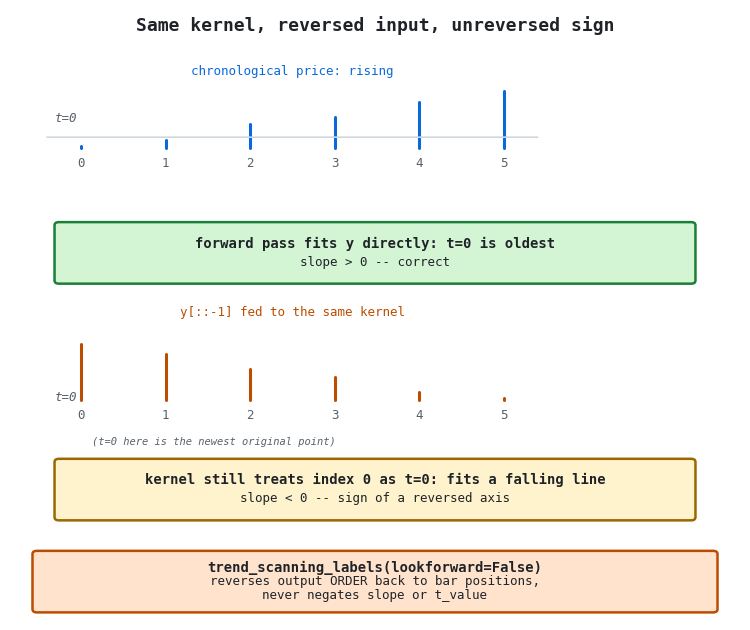
Рисунок 1. Однопанельная иллюстрация механизма инверсии знака
- Вверху: при прямом проходе подгонка выполняется непосредственно по цене, растущей в хронологическом порядке; локальному времени 0 соответствует самая старая точка, и наклон имеет правильный положительный знак.
- Внизу: при обратном проходе подгонка выполняется по тем же шести точкам в обратном порядке; локальному времени 0 теперь соответствует самая новая исходная точка, и то же вычислительное ядро возвращает отрицательный наклон.
- У основания схемы: trend_scanning_labels(lookforward=False) возвращает результаты прохода по обращенным данным на соответствующие позиции баров, но не меняет их знак.
Простой тест с однозначно ожидаемым результатом напрямую подтверждает это. Для монотонно растущего ценового ряда с небольшим шумом нет ни одной обоснованной интерпретации, при которой каузальный признак тренда должен показывать отрицательный наклон:
close = pd.Series(np.linspace(1.10, 1.14, 40) + noise)

fwd = trend_scanning_labels(close, span=(5,12), lookforward=True)   # slope = +0.001016
bwd = trend_scanning_labels(close, span=(5,12), lookforward=False)  # slope = -0.001016
На синтетическом ряду длиной 1 500 баров с тремя заданными режимами дрейфа сумма t-статистики эталонной реализации и t-статистики независимо разработанного инкрементального движка на каждом соответствующем баре равна нулю с точностью до 3e-6, а соответствующая сумма наклонов равна нулю с точностью до 2e-13. Длина окна и R², не зависящие от знака, уже совпадали в точности. Прямой режим (корректно использовавшийся для разметки во всей предыдущей серии Blueprint) не имеет этого дефекта: в нем регрессия строится непосредственно по массиву, без разворота порядка элементов, при котором мог бы потеряться знак.
Что это означает для части 13
Функция get_trend_scanning_features вызывала trend_scanning_labels(lookforward=False) и возвращала полученные наклон и t-статистику без изменений, поэтому она унаследовала инверсию знака, описанную в разделе 4. Обертка исправлена: теперь она меняет знак значений в обоих столбцах, а механизм описан в ее строке документации, чтобы будущему читателю не пришлось разбираться в нем заново:
features = raw.drop(columns=_LABEL_ONLY_COLUMNS)
# the backward call's slope/t_value are measured against a reversed
# time axis and must be negated to read as true chronological direction
features["slope"]   = -features["slope"]
features["t_value"] = -features["t_value"]
Практическое влияние на результаты части 13 ограниченно. При измерении утечки данных использовался прямой режим, который не затронут этим дефектом. Доля верных каузальных прогнозов вычислялась по совпадению sign(t_value) с направлением движения симметричного случайного блуждания; смена знака всех прогнозов преобразует p в 1-p, поэтому значение, близкое к 50 %, остается близким к 50 %. Таким образом, вывод об отсутствии утечки данных остается в силе. При сравнении, посвященном дефекту логарифмирования, для обеих сравниваемых реализаций использовался один и тот же вызов в обратном режиме, поэтому общая смена знака не влияет на приведенные там показатели совпадения и корреляции.
Один рисунок все же зависел от самого знака значений, возвращаемых оберткой: панель признаков, на которой цена окрашена в зависимости от t-статистики. Этот рисунок был построен заново с использованием исправленной обертки и включен в файлы, прилагаемые к части 13. Никакие другие рисунки, таблицы или числовые утверждения в части 13 не требовали исправления.
Маскирование по волатильности: почему volatility_threshold=0.0 соответствует минимуму по накопленной истории
Эталонная реализация исключает любое окно, локальная волатильность которого ниже квантиля по накопленной истории самого ряда волатильности; значение уровня этого квантиля по умолчанию как в trend_scanning_labels, так и в обертке из части 13 равно 0.0. Квантиль уровня 0 (нулевой процентиль) по определению является минимумом, а для минимума по накопленной истории достаточно хранить одно обновляемое значение вместо структуры данных для порядковых статистик по всей истории:
s.expanding().quantile(0.0) == s.expanding().min() # identical for every s, verified directly
Именно это и реализовано в движке: один минимум по накопленной истории, обновляемый за O(1) при получении каждого нового значения волатильности, если для определения стандартного отклонения уже есть хотя бы две точки. Именно так модуль работает с настройками по умолчанию, и это единственный вариант настройки, доступный через обертку из части 13. Ненулевое значение volatility_threshold требует полноценного вычисления квантиля по накопленной истории с неограниченным числом прошлых значений, а для этого нужна существенно иная, более ресурсоемкая структура данных — дерево порядковых статистик или буфер со вставкой с сохранением сортировки; это выходит за рамки данного переноса. Потребность в такой настройке указывает на то, что используемый в этом модуле подход к маскированию, возможно, не подходит для задачи; решение следует искать в методологии исследования, а не в усложнении примитива MQL5.
Индикатор: буферы и контракт OnCalculate
В TrendScanViewer.mq5 используется разделение буферов по классам, введенное в части 12: для отображения служит линия тренда в окне графика, окрашенная в зависимости от направления, а для расчетов — четыре расчетных буфера: window, slope, t_value, rsquared; советник должен считывать данные только из этих четырех буферов.
int horizons[];
CTrendScanningFeatures::BuildHorizons(InpMinHorizon, InpMaxHorizon, horizons);
g_engine.Init(horizons, InpUseLog);
BuildHorizons воспроизводит поведение list(range(*span)): верхняя граница не включается, что соответствует соглашению эталонной реализации, а не более интуитивному прочтению с включенной верхней границей. Если неверно понять это правило, самое длинное окно-кандидат будет незаметно исключаться при каждой подгонке модели, без каких-либо сообщений об ошибке.
Вычислительный модуль сохраняет состояние так же, как и фрактальный механизм: его обновляемые суммы и кольцевой буфер рассчитаны на то, что каждый бар обрабатывается ровно один раз, в порядке следования. OnCalculate обеспечивает это, завершая обработку за один бар до конца массива, поэтому еще формирующийся бар, который меняется с каждым тиком, никогда не попадает в механизм:
//--- only closed bars are fed: the forming bar would be reprocessed on
//--- every tick, and the engine consumes each bar exactly once
const int last_closed = rates_total - 2;
TrendScanRow row;

for(int t = g_processed; t <= last_closed; t++)
  {
   ClearBar(t);
   if(!g_engine.ProcessBar(close[t], row))
      return(0);
   StoreRow(t, row, close[t]);
   g_processed = t + 1;
  }
Результаты: производительность скомпилированного кода и численное соответствие
При первой попытке оценить преимущество инкрементального подхода сравнили реализации обоих вариантов на чистом Python, и разница в их производительности составила лишь несколько процентов. Этот результат не выдержал тщательной проверки. В наивном варианте использовались срезы массивов NumPy; векторизованная редукция на уровне C берет на себя большую часть затрат на суммирование по окну со сложностью O(L) независимо от L при рассматриваемых здесь размерах окон. В итоге сравнение измеряло общие для обоих вариантов накладные расходы интерпретатора и выделения памяти под массивы, а не затраты на вычисление сумм, которые и меняет инкрементальный подход.
Корректное сравнение следует проводить на том уровне, на котором фактически выполняется код MQL5: оба варианта скомпилированы и выполняют одинаковые последующие вычисления (наклон, сумма квадратов остатков (SSE), R², t-статистика и argmax по горизонтам), различаясь лишь способом получения трех обновляемых сумм.
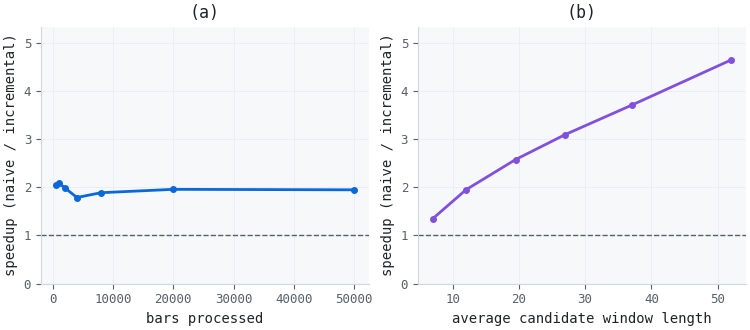
Рисунок 2. Два графика измеренного ускорения; численное соответствие результатов обоих вариантов подтверждено
- График (a): зависимость ускорения от длины ряда при диапазоне длин окон span(5,20), используемом во всем цикле статей; кривая почти горизонтальна, поскольку общая сложность обеих реализаций составляет O(bars), а различается лишь постоянный множитель затрат на один бар.
- График (b): зависимость ускорения от средней длины окна-кандидата при фиксированной длине ряда в 50 000 баров; ускорение растет с 1.35 раза при span(5,10) до 4.65 раза при span(5,100).
При диапазоне длин окон span(5,20), используемом во всем цикле статей, инкрементальный подход обеспечивает ускорение примерно в два раза, а не на порядок. Последующие вычисления статистических показателей (наклон, сумма квадратов остатков (SSE), R², t-статистика) требуют одинаковых затрат в обоих вариантах, причем эти затраты существенны по сравнению с затратами на суммирование по короткому окну; экономия достигается именно при вычислении сумм, а доля этих вычислений в общих затратах уменьшается с ростом L — именно такую тенденцию показывает график (b). Каждое значение на обоих графиках получено в запуске, в котором относительное различие результатов двух реализаций было меньше 1e-6; это различие выводилось вместе с временем выполнения, чтобы результат с расхождением нельзя было случайно опубликовать как достоверный.
Численное соответствие результатов выполнения кода заголовочного файла MQL5 и эталонной реализации на Python по всем четырем выходным столбцам:
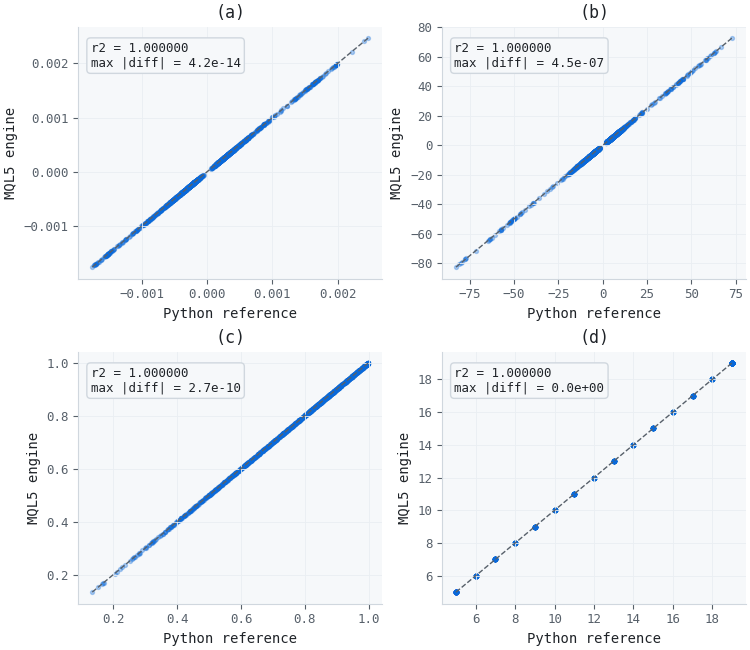
Рисунок 3. Иллюстрация из четырёх панелей, демонстрирующая численное соответствие двух реализаций
- Панель (a): наклон.
- Панель (b): t-статистика.
- Панель (c): R².
- Панель (d): выбранная длина окна, совпадающая в обеих реализациях на каждом баре.
Правило отбора не отбирает по статистической значимости
Перенесённая версия воспроизводит эталонную реализацию, включая её правило выбора среди окон-кандидатов: для каждого горизонта оценивается регрессия, затем выбирается окно с наибольшей по модулю t-статистикой. В разделе 5.4 книги «Машинное обучение для управляющих активами» это правило вводится с конкретным обоснованием: оно присваивает каждому наблюдению метку в соответствии с наиболее статистически значимым трендом среди рассматриваемых периодов. Разработка комплекса калибровки индикатора показала, что это правило не обеспечивает того, что утверждается в приведённом предложении.
Причина в том, что t-статистику нельзя напрямую сравнивать между окнами разной длины. t-статистику оценивают по t-распределению Стьюдента с L − 2 степенями свободы, причём форма этого распределения меняется в зависимости от L. Для окна из пяти баров число степеней свободы равно трём, а распределение имеет тяжёлые хвосты; для окна из сорока баров число степеней свободы равно тридцати восьми, а распределение близко к нормальному. Таким образом, одно и то же числовое значение t-статистики даёт разную силу свидетельств в зависимости от того, в каком окне оно получено, а выбор максимума по исходным значениям t-статистики систематически отдаёт предпочтение самым коротким окнам в рассматриваемом диапазоне длин окон.
Детерминированный ряд позволяет количественно оценить величину эффекта. Возьмём y[i] = 100 + 0.05i + 3sin(0.3i), оценим регрессию по логарифму цены и рассмотрим все окна длиной от 5 до 40 баров, заканчивающиеся на баре с индексом 199. Наибольшая по модулю t-статистика равна -12.840 и получена для окна из пяти баров. Его двустороннее p-значение при трёх степенях свободы составляет 1.02e-3. Окно из двадцати баров даёт t-статистику всего +6.572, но при восемнадцати степенях свободы ей соответствует p-значение 3.57e-6. Окно, которое отбрасывается в соответствии с заданным правилом, примерно в 286 раз значимее, чем окно, которое выбирается.
Кроме того, эти два окна указывают на разные направления движения цены. Линия регрессии по пяти барам направлена вниз, а по двадцати — вверх, поэтому на этом баре правило в опубликованном виде указывает на нисходящий тренд, хотя статистически более значимый результат указывает на восходящий. Это не искусственно сконструированный крайний случай: такая ситуация возникает всякий раз, когда внутри более длительного движения происходит кратковременный разворот, что часто встречается на внутридневных данных.
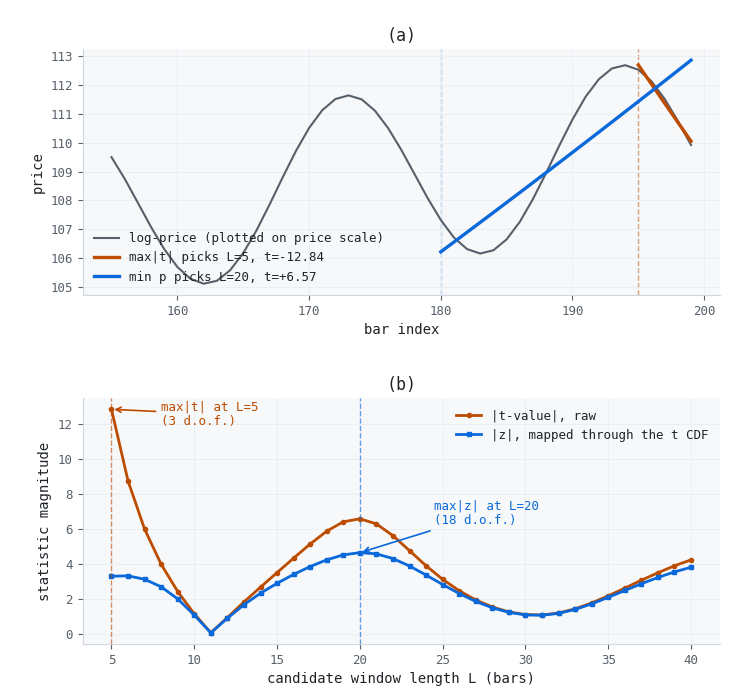
Рисунок 4. Иллюстрация из двух панелей, показывающая, как два правила отбора приводят к противоположным выводам на одном баре
- Панель (a): пятибаровое окно, выбранное по исходному правилу, и двадцатибаровое окно, выбранное после поправки на длину окна; оба окна заканчиваются на одном и том же баре, а построенные по ним линии регрессии направлены в противоположные стороны.
- Панель (b): значения обеих статистик во всем диапазоне длин окон; модуль исходной t-статистики достигает максимума при малой длине окна, а скорректированная статистика — при длине около двадцати баров.
Поправка заключается в приведении статистик всех окон-кандидатов к общей шкале перед сравнением. Преобразование каждой t-статистики с помощью функции соответствующего ей t-распределения Стьюдента дает p-значение, а преобразование этого p-значения с помощью квантильной функции стандартного нормального распределения дает оценку, единицы измерения которой больше не зависят от длины окна. В MQL5 нет встроенной гамма-функции, поэтому функцию t-распределения Стьюдента необходимо реализовать самостоятельно. Достаточно автономной реализации регуляризованной неполной бета-функции, использующей логарифм гамма-функции, вычисленный по приближению Ланцоша:
//+------------------------------------------------------------------+
//| TSS_TTwoSidedP: two-sided p-value for a t-statistic              |
//+------------------------------------------------------------------+
double TSS_TTwoSidedP(const double t, const int df)
  {
   if(df <= 0)
      return(1.0);
   return(TSS_Betai(0.5 * df, 0.5, df / (df + t * t)));
  }

//+------------------------------------------------------------------+
//| TSS_SignedZ: put a t-statistic on the standard-normal scale      |
//+------------------------------------------------------------------+
double TSS_SignedZ(const double t, const int df)
  {
   double p = TSS_TTwoSidedP(t, df);
   if(p < 1.0e-300)
      p = 1.0e-300;
   if(p > 1.0)
      p = 1.0;
   const double z = -TSS_InvNormCdf(0.5 * p);
   return(t >= 0.0 ? z : -z);
  }
Затем цикл отбора сравнивает MathAbs(TSS_SignedZ(t_value, L - 2)) вместо MathAbs(t_value). Все остальное в движке остается без изменений, поскольку ошибка была не в математике подгонки регрессии для каждого горизонта.
В движке, прилагаемом к этой статье, по умолчанию сохранено исходное правило отбора. Это сделано намеренно: раздел 3 и раздел 8 подтверждают численное соответствие эталонной реализации на Python, а изменение правила отбора нарушило бы свойство, проверяемое в этих разделах. Скорректированное сравнение реализовано в отдельном подключаемом файле, чтобы его можно было включить, не затрагивая результат проверки численного соответствия.
Номинальный порог представляет собой вторую, более серьёзную проблему
Корректировка сравнения между окнами не делает полученное p-значение достоверным, поскольку оно основано на допущении, которое нарушают данные о ценах. Обычный метод наименьших квадратов предполагает независимость остатков во времени. Уровни цен представляют собой ряд, интегрированный первого порядка, поэтому после подгонки тренда остатки сильно автокоррелированы, стандартная ошибка занижена, а t-статистика завышена. Речь идет о проблеме ложной регрессии, описанной Грейнджером и Ньюболдом в 1974 году, и она применима к тренду, подбираемому по ценам, точно так же, как и к регрессии между двумя несвязанными случайными блужданиями.
Моделирование позволяет оценить это количественно. При генерации двадцати тысяч случайных блужданий без дрейфа, состоящих из 260 наблюдений, и сканировании окон длиной от 5 до 40 баров в каждом из них 95-й процентиль максимального абсолютного значения t-статистики составляет 21.04, а 99-й процентиль — 28.24. Номинальный порог для двустороннего теста при уровне значимости 5 % и 38 степенях свободы составляет 2.024. При применении этого номинального порога к рядам без тренда 99.94 процента баров классифицируются как имеющие статистически значимый тренд.
Тот же эксперимент на независимом шуме вместо случайного блуждания дает 95-й процентиль, равный 4.22 для сканирования и 2.03 для одного окна длиной 40 баров. Второе значение, почти точно совпадающее с номинальным порогом 2.024, служит контрольным результатом: оно подтверждает, что расчет t-статистики в движке корректен, а завышение значений статистики на данных, подобных ценовым, обусловлено свойствами самих данных, а не ошибкой реализации.
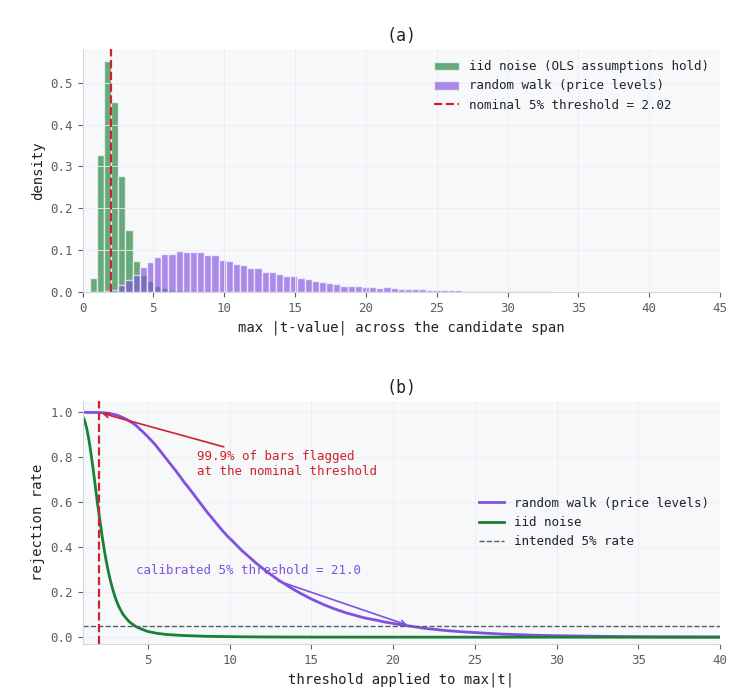
Рисунок 5. Двухпанельная иллюстрация статистики сканирования при нулевой гипотезе об отсутствии тренда
- Панель (a): распределение максимального абсолютного значения t-статистики по всему диапазону длин окон для независимого шума и случайного блуждания в сравнении с номинальным порогом для уровня значимости 5 %.
- Панель (b): доля баров без тренда, на которых выявлен статистически значимый тренд, в зависимости от применяемого порога; отмечена откалиброванная точка, соответствующая уровню 5 %.
Стоит разложить завышение значений статистики на составляющие, поскольку от этого зависит выбор подходящего способа коррекции. Уже для одного окна длиной 40 баров на случайном блуждании 95-й процентиль статистики достигает 17.32. Сканирование 36 окон с выбором экстремального значения повышает этот процентиль лишь до 21.04, то есть примерно в 1.21 раза. Почти все искажение обусловлено подгонкой тренда к интегрированному ряду, и лишь небольшая остаточная часть связана с перебором горизонтов. Таким образом, поправка на множественное тестирование с учетом числа горизонтов, например поправка Бонферрони или Шидака, скорректировала бы меньший из двух эффектов, оставив больший без изменений.
Эффективный подход — моделировать именно ту статистику, которую фактически выдает механизм, на данных, сгенерированных без тренда, используя тот же диапазон длин окон, на который настроен механизм, и брать верхние квантили полученного распределения в качестве порогов. Процедура проста: сгенерировать случайное блуждание без дрейфа из max(L) приращений, вычислить статистику для каждого окна из заданного диапазона длин, заканчивающегося на текущем баре, записать максимум, повторить несколько тысяч раз и отсортировать результаты. Поскольку статистика на данном баре зависит только от последних max(L) наблюдений, каждому повторению достаточно истории такой длины, поэтому несколько тысяч повторений требуют достаточно мало вычислительных ресурсов, чтобы выполнить их один раз при инициализации. Фиксированное начальное значение генератора случайных чисел обеспечивает воспроизводимость получаемых порогов при повторных запусках.
Здесь следует учесть два момента. Случайное блуждание без дрейфа — это удобная модель для нулевой гипотезы, а не точная модель цены, поэтому полученные на его основе пороги служат для калибровки, но не обеспечивают точного статистического теста; модель для нулевой гипотезы с тяжёлыми хвостами или кластеризацией волатильности дала бы другие пороги. При этом откалиброванный порог указывает лишь на то, что наблюдаемый тренд сильнее трендов, обычно возникающих в ряду той же длины без тренда. Он ничего не говорит о том, продолжится ли этот тренд на следующем баре.
Чтение признаков из советника
Как и в случае с визуализатором фракталов из части 12, безопасно считывать только буферы баров подтверждения, причём читать следует со сдвигом 1, а не 0: сдвиг 0 соответствует ещё формирующемуся бару, для которого индикатор намеренно оставляет буферы пустыми:
int handle = iCustom(_Symbol, _Period, "TrendScanViewer", 5, 20, true);

double t_value[];
double window[];
if(CopyBuffer(handle, 4, 1, 1, t_value) < 1)
   return;
if(CopyBuffer(handle, 2, 1, 1, window) < 1)
   return;

//--- compare on the length-corrected scale, against a threshold
//--- calibrated for this candidate span rather than the nominal 2.0.
//--- See Section 9: the nominal threshold flags almost every bar.
const int    df    = (int)window[0] - 2;
const double score = TSS_SignedZ(t_value[0], df);

if(score > g_calibrated_crit95)
   OpenLong();
Теперь положительное значение t_value означает именно то, что и должно: тренд, оценённый только по барам вплоть до текущего включительно, направлен вверх. Для аналогичного вызова на Python до исправления, описанного в разделе 5, это было неверно; именно поэтому данному вопросу посвящён отдельный раздел, а не однострочная сноска.
В этом примере используется откалиброванный порог, а не номинальный порог 2.0, с которым обычно сравнивают t-статистику. В разделе 9 объясняется, почему на ценовых данных такое сравнение выделяет практически каждый бар. Буфер window здесь считывается не только для диагностики: число степеней свободы, необходимое для интерпретации t-статистики, зависит от выбранного окна, поэтому оба значения нужно считывать вместе.
Заключение
Инкрементальную схему удалось перенести без затруднений: те же три обновляемые суммы, которые позволяют выполнять обновление за O(1) в MQL5, — это именно те величины, которые нужны для расчёта регрессии; это подтверждено выполнением поставляемого заголовочного файла как кода C++, а не доверием к отдельной повторной реализации. Выигрыш в производительности реален, но для диапазона длин окон, используемого в этой серии статей, умерен: ускорение составляет примерно 2 раза и растёт с расширением диапазона длин окон-кандидатов, поскольку по мере удлинения окон вычисление статистик для каждого горизонта, не ускоряемое инкрементальным обновлением, занимает всё меньшую долю общего объёма вычислений.
Более важный результат дала независимая реализация проверки, а не оптимизация. Функция trend_scanning_labels(lookforward=False) оценивает регрессию по обращённой оси времени и не вносит соответствующую поправку, поэтому наклон и t-статистика имеют неверный знак; обёртка для вычисления признаков из части 13 унаследовала этот дефект и была исправлена, как описано в разделе 5. Прямой режим, использовавшийся для разметки во всей предшествующей серии Blueprint, не имеет этого дефекта. Читателям, использующим конвейеры, в которых обратный режим вызывался напрямую, а не через исправленную обёртку, следует проверить знаки всех значений на последующих этапах обработки.
Второй вывод был сделан при разработке индикатора, а не движка, и касается самого метода, а не какой-либо его реализации. Выбор окна-кандидата по наибольшему модулю t-статистики не означает выбора наиболее статистически значимого тренда, поскольку t-статистики для окон разной длины сопоставляются с распределениями с разным числом степеней свободы; в разобранном примере из раздела 9 это правило выбирает окно с трендом примерно в 286 раз менее значимым, чем в одном из отвергнутых окон, и указывает противоположное направление тренда. Кроме того, на ценовых данных саму t-статистику вообще нельзя сопоставлять с номинальным порогом: при случайном блуждании без дрейфа, не содержащем тренда, на 99.94 % баров она превышает номинальный порог для уровня значимости 5 %. Почти всё это завышение значений статистики обусловлено оценкой тренда по интегрированному ряду, а не перебором горизонтов, поэтому поправка на множественное тестирование с учётом числа горизонтов — неверное решение; правильное решение — моделировать выдаваемую статистику при нулевой гипотезе об отсутствии тренда.
Это уже вторая статья серии, в которой каузальная реализация семейства признаков для MQL5 выявила ошибку, уже присутствовавшую в выпущенной реализации на Python: в части 12 обнаружилось, что поток данных с индексацией как в таймсерии незаметно инвертировал задержку подтверждения фрактала, а в этой статье была обнаружена инверсия знака в собственном модуле разметки для сканирования трендов. Проверка перенесенной реализации путем ее запуска, а не предположение о корректности эталонной реализации, с которой ее сравнивают, уже дважды оправдала себя в этой серии.
Список литературы
- Лопес де Прадо, М. Достижения в области финансового машинного обучения: лекция 3/10.
- Лопес де Прадо, М. (2018). Достижения в области финансового машинного обучения. Wiley.
- Лопес де Прадо, М. (2020). Машинное обучение для управляющих активами, раздел 5.4. Издательство Кембриджского университета.
- Грейнджер, К. У. Дж. и Ньюболд, П. (1974). Ложные регрессии в эконометрике. Journal of Econometrics, 2(2), 111–120.
Прикрепленные файлы
Файл | Местоположение | Описание | |
|---|---|---|---|
| 1. | CTrendScanningFeatures.mqh | MQL5\Include\Features | Инкрементальный вычислительный модуль. Методы Init, Reset, ProcessBar для побарной обработки и статический вспомогательный метод BuildHorizons. |
| 2. | TrendScanViewer.mq5 | MQL5\Indicators\Features | Индикатор для графика с одним отображаемым построением и четырьмя расчетными буферами, доступными через iCustom. |
| 3. | TrendScanValidation.mq5 | MQL5\Scripts\Features | Экспортирует бары и все четыре признака в CSV с точностью до шестнадцати значащих цифр. |
| 4. | incremental_scanner.py | MQL5\Files\Features | Независимая эталонная реализация с инкрементальными вычислениями для перекрестной проверки версии на MQL5; это не копия кода MQL5, переведенная обратно на Python. |
| 5. | validate_trend_scan.py | MQL5\Files\Features | Программа проверки численного соответствия данных, экспортированных из MQL5. Выводит максимальное абсолютное отклонение для каждого столбца и результат проверки относительного отклонения t-статистики. |
| 6. | trend_scanning_features.py | MQL5\Files\Features | Обертка из части 13, исправленная в соответствии с разделом 5. Устаревшая версия для тех, кто отслеживает изменения. |
| 7. | TrendScanSignificance.mqh | MQL5\Include\Features | Дополнение к разделу 9. Логарифм гамма-функции по методу Ланцоша, регуляризованная неполная бета-функция, двустороннее p-значение по t-распределению Стьюдента, обратная функция распределения нормального закона и калибратор порога на основе случайного блуждания. Оставляет без изменений вычислительный механизм, для которого уже проверено численное соответствие. |
| 8. | selection_rule_evidence.py | MQL5\Files\Features | Воспроизводит все численные значения, приведенные в разделе 9, и заново строит рисунки 4 и 5, включая разложение завышения значений статистики на две составляющие по источникам. |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/23660
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


Отличная статья!