

Единый пайплайн валидации для защиты от переобучения бэктеста
 173
 9

Введение
Каждый алгоритмический трейдер рано или поздно сталкивается с бэктестом, который выглядит слишком хорошим, чтобы быть правдой. Кривая эквити представляет собой почти идеальную лестницу, поднимающуюся к правому верхнему углу графика. Коэффициент Шарпа исключительно высок. Просадки неглубоки и кратковременны.
А затем при переходе к реальной торговле стратегия сразу же проваливается.
Этот результат настолько распространен, что в сообществе количественных исследователей для него сложилось собственное устоявшееся выражение. Причиной почти всегда является одна из форм переобучения: алгоритм запомнил исторический шум конкретного набора данных, а не устойчивую рыночную структуру, применимую к будущим данным. Менее известно, что переобучение не является единым явлением. Оно возникает по нескольким различным каналам, каждый из которых требует отдельной меры противодействия. Специалист, применяющий лишь одну меру защиты — чаще всего простое разбиение на обучающую и тестовую выборки, — по-прежнему остается уязвимым к остальным рискам.
В статье рассматриваются три наиболее строгих инструмента борьбы с переобучением при разработке алгоритмических стратегий: валидация внутри валидации (V-in-V), сформулированная Тимоти Мастерсом; комбинаторно очищенная кросс-валидация (CPCV), разработанная Маркосом Лопесом де Прадо; и комбинаторно симметричная кросс-валидация (CSCV), представленная Бейли и Лопесом де Прадо. Каждый из них устраняет отдельный тип методологического сбоя. В совокупности они образуют комплексную защиту от наиболее существенных форм статистического самообмана в количественных исследованиях.
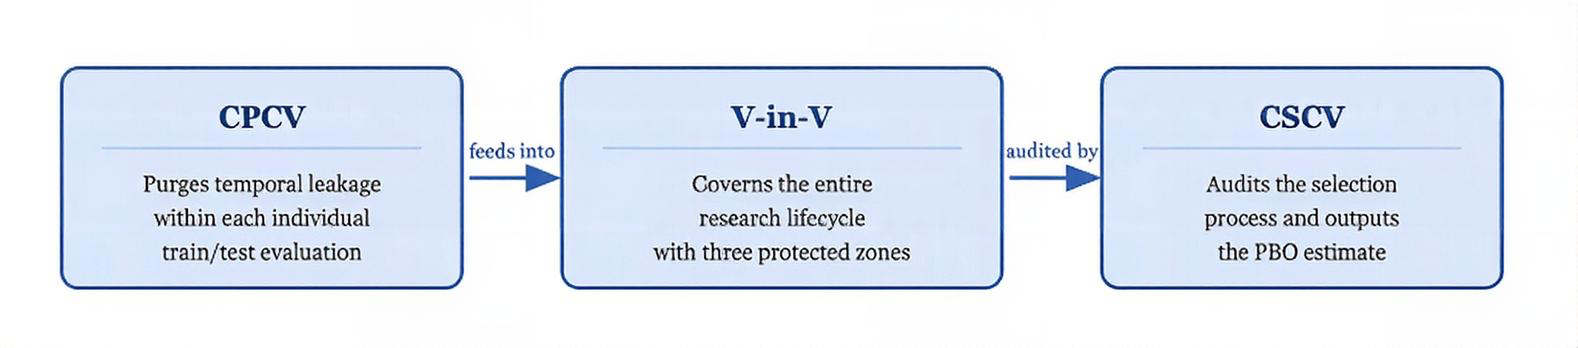
Рисунок 1. Единый исследовательский пайплайн. CPCV устраняет временные утечки в отдельных оценках; V-in-V управляет исследовательским процессом; CSCV проводит итоговый количественный аудит процесса отбора.
Часть I — проблема подхода «бросать спагетти в стену»
Искушение полного перебора
Так называемый подход "бросать спагетти в стену" означает тестирование огромного числа индикаторов, правил и комбинаций параметров на историческом наборе данных в надежде, что что-нибудь сработает. Современные вычислительные технологии делают этот подход чрезвычайно простым в реализации и столь же опасно простым с точки зрения ошибочной интерпретации результатов.
Проблема также имеет математическую природу. Если провести достаточное число тестов на любом конечном наборе данных, случайность сама по себе даст результаты, которые будут казаться статистически значимыми. Это не недостаток интеллекта или намерений, а структурное следствие многократной проверки гипотез. Каждый дополнительный тест на тех же данных повышает вероятность того, что итоговый победитель окажется статистическим артефактом, а не подлинным рыночным преимуществом.
Основные опасности
Смещение из-за подглядывания в данные. Когда одни и те же исторические данные многократно используются для проверки разных гипотез, с каждым тестом возрастает вероятность того, что итоговый кандидат с лучшей результативностью окажется лишь случайным удачным выбором. Стратегия, выбранная из 10 000 кандидатов на одном наборе данных, имеет совершенно иные вероятностные характеристики, чем стратегия, выбранная из пяти кандидатов.
Чрезмерная подгонка к историческим данным. Алгоритм, которому позволено свободно оптимизироваться на исторических данных, в той или иной степени подгоняется под конкретные реализации шума данной ценовой траектории. Он будет показывать хорошие результаты на уже произошедших данных именно потому, что научился показывать хорошие результаты на этих данных. Шум прошлого — это не сигнал будущего.
Степени свободы исследователя. Даже полностью добросовестный исследователь постепенно становится предвзятым в ходе обычного процесса разработки. Каждое решение при построении модели, пусть даже косвенно опирающееся на наблюдаемую результативность на тестовой выборке, — выбор признаков, границы параметров, структура правил — представляет собой степень свободы, завышающую кажущуюся значимость итогового результата. Эта форма загрязнения незаметна в каждом отдельном решении, но в совокупности становится серьезной.
Подход "бросать спагетти в стену" сам по себе не является неправомерным. Широкий исследовательский поиск может выявить подлинные рыночные преимущества. Ключевой вопрос в том, применил ли исследователь достаточно строгие защитные меры, чтобы отличить подлинные рыночные преимущества от статистических артефактов, неизбежно порождаемых таким поиском. Без всех трех описанных здесь уровней защиты это невозможно.
Часть II — валидация внутри валидации (V-in-V)
Скрытый изъян стандартного пошагового тестирования
На первый взгляд стандартная схема пошагового тестирования кажется полноценным решением. Вы обучаете стратегию на исторических данных, тестируете ее на последующем вневыборочном периоде, признаете успех, если она выдерживает проверку, и переходите к реальной торговле. В принципе этот подход корректен. Проблема заключается в реализации.
Каждый раз, когда исследователь наблюдает результативность на валидации и использует ее для решения при построении модели — корректирует параметр, сокращает набор признаков или выбирает один из конкурирующих вариантов правил, — вневыборочный период фактически становится частью обучающей выборки. Процесс принятия решений исследователя уже получил доступ к этим данным.
Именно это Мастерс называет накоплением степеней свободы исследователя. Вероятно, это самая опасная форма переобучения, поскольку она незаметна. На бумаге разбиения данных выглядят корректно. Код имеет корректную структуру. Однако итеративные решения исследователя, основанные на наблюдаемой вневыборочной результативности, внесли смещение, которое стандартное разбиение не способно обнаружить или исправить.
Трехуровневая архитектура
Решение Мастерса заключается в создании трех строго разделенных пулов данных. Каждый из них служит определенной цели и задействует информационное содержимое набора данных только на строго предназначенном этапе.
Полный исторический массив данных
│
├── ВНЕШНЯЯ ОБУЧАЮЩАЯ ВЫБОРКА (~60%)         ← Здесь проводится полный исследовательский поиск
│
├── ВНУТРЕННЯЯ ВАЛИДАЦИОННАЯ ВЫБОРКА (~20%)  ← Здесь проводится предварительный отбор кандидатов
│                                              (число рассматриваемых кандидатов намеренно ограниченно)
│
└── ФИНАЛЬНАЯ ТЕСТОВАЯ ВЫБОРКА (~20%)        ← Открывается только один раз – после полной фиксации решения
Именно на внешней обучающей выборке проводится полный перебор. Здесь тестируются тысячи правил, индикаторов и комбинаций параметров. Каждый перестановочный тест, этап регуляризации и исследовательский анализ выполняются в пределах этой выборки. Исследователь может свободно анализировать результативность на этих данных, поскольку они специально предназначены для исследования.
На внутренней валидационной выборке происходит отбор кандидатов. Кандидаты, прошедшие предварительный отбор на этапе 1, проверяются на этих ранее не использовавшихся данных. Кандидаты, чья результативность резко ухудшается, отбрасываются как вероятно переобученные. Этот этап используют ограниченно: исследователь заранее фиксирует небольшое число финальных конфигураций, прежде чем проверять их на этих данных.
Финальная тестовая выборка неприкосновенна. К ней обращаются только один раз — после того как исследователь письменно зафиксировал единственную окончательную конфигурацию стратегии. Результат этой единственной оценки становится опубликованным показателем результативности. Любая попытка использовать этот результат для дальнейших корректировок делает тест недействительным.
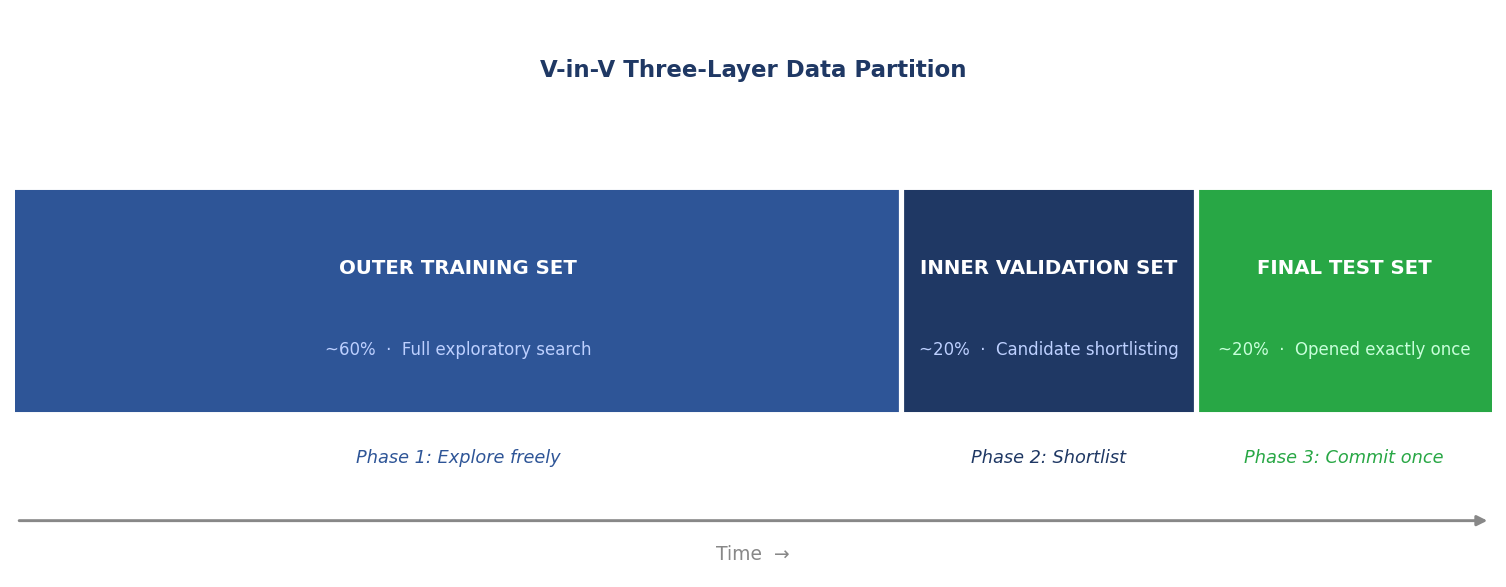
Рисунок 2. Трехслойное разбиение данных. Каждая зона служит одной определенной цели. Финальная тестовая выборка остается неприкосновенной до полной письменной фиксации единственной стратегии.
Расширение пошагового тестирования с фиксированным началом
Основная проблема, которую решает этот подход. Трехстороннее разбиение данных (60/20/20) в принципе статистически обоснованно, но на практике чрезмерно обременительно. В пятилетней выборке дневных данных может быть около 1 250 наблюдений. Финальная тестовая выборка размером 20% дает 250 баров. Этого едва хватает для оценки коэффициента Шарпа с достаточно информативными доверительными интервалами и совершенно недостаточно для выводов об устойчивости к рыночным режимам. Сокращение обучающей части разбиения ради увеличения тестовых данных лишь переносит проблему на обучающую выборку.
Чем оно отличается от стандартного скользящего пошагового тестирования. При стандартном пошаговом тестировании размер обучающего окна фиксируется, а само окно сдвигается вперед. Обучающее окно сдвигается: старые данные исключаются с левого края по мере добавления новых данных справа. Это означает, что стратегия каждый раз заново оценивается с нуля на другой выборке того же размера. Ранние рыночные режимы со временем отбрасываются.
Пошаговое тестирование с фиксированным началом (anchored walkforward) — широко используемый метод, описанный Мастерсом и другими авторами, — фиксирует начало обучающей выборки и расширяет ее вперед во времени. Обучающая выборка всегда начинается с одной и той же исторической отправной точки. Каждое последующее окно добавляет в нее новые данные. Окна финального тестирования и внутренней валидации продвигаются во времени, но сохраняют пропорциональные размеры относительно общего объема данных, задействованных к этому моменту.
Отдельные результаты финального тестирования не выбираются постфактум из числа удачных. Их следует оценивать в совокупности, как единый массив свидетельств. Стратегия, сохраняющая рыночное преимущество в большинстве тестовых окон, демонстрирует устойчивость в различных рыночных режимах и временных периодах. Это гораздо более сильный вывод, чем может дать результат одной тестовой выборки.
Почему это работает — пять взаимосвязанных причин
- Каждое окно финального тестирования действительно является вневыборочным. Конфигурация стратегии, проверяемая в каждом тестовом окне, была зафиксирована до открытия этого окна. Временная граница строго соблюдается.
- Результаты тестов в значительной степени независимы друг от друга. Поскольку каждое окно финального тестирования охватывает отдельный непересекающийся отрезок календарного времени, результаты отдельных тестов в значительной степени являются независимыми наблюдениями рыночной результативности. Однако перекрывающиеся обучающие выборки создают некоторую серийную корреляцию в оценках параметров, что следует учитывать при агрегировании результатов.
- При схеме с фиксированным началом информация накапливается, а не отбрасывается. При скользящем пошаговом тестировании ранние данные отбрасываются по мере сдвига окна. При схеме с фиксированным началом все исторические данные остаются в обучающей выборке по мере роста окна.
- Результаты нескольких тестов выявляют чувствительность к рыночным режимам. Стратегия, сохраняющая рыночное преимущество во всех тестовых окнах, подтверждает свою устойчивость в различных рыночных условиях, наблюдавшихся на всем историческом интервале. Стратегия, показывающая хорошие результаты в одних окнах и неудачные в других, выявляет действительную чувствительность к рыночным режимам — вывод, который одно тестовое окно полностью скрыло бы.
- В каждом окне сохраняется целостность трехслойной структуры. Каждое окно сохраняет собственную границу внутренней валидации. Дисциплина исследовательского процесса, придающая смысл V-in-V, не ослабляется, а применяется многократно.
Загвоздка — и почему она менее важна, чем кажется
Отдельные тестовые окна не являются полностью независимыми. Более поздние окна используют большую часть обучающих данных совместно с ранними окнами, что создает серийную корреляцию в оценках параметров, применяемых для получения результата каждого окна. Поэтому результаты тестов следует оценивать качественно — как совокупность свидетельств о том, сохраняется ли рыночное преимущество и остается ли его величина примерно стабильной, — а не объединять в единую сводную статистику с искусственно завышенным размером выборки.
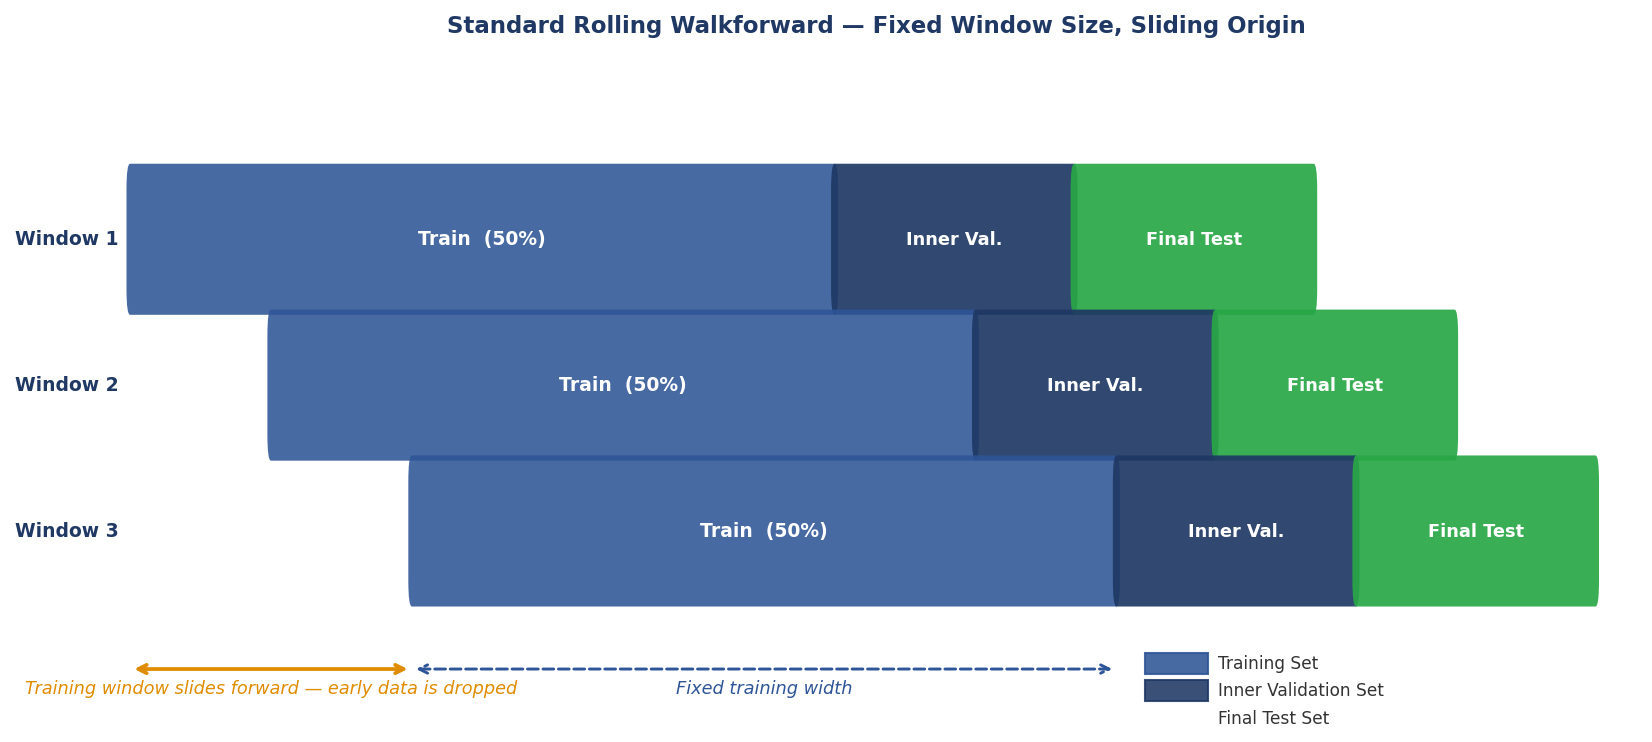
Рисунок 3. Стандартное расширение при пошаговом тестировании

Рисунок 4. Расширение при пошаговом тестировании с фиксированным началом — три окна, показывающие рост обучающей выборки и сдвиг вперед окон внутренней валидации и финального тестирования.
Реализация
В приведенном ниже коде показано, как организовать полный трехслойный пайплайн V-in-V с использованием PurgedWalkForwardCV. В PurgedWalkForwardCV передаются данные внешней обучающей выборки; выборки для внутренней валидации и финального тестирования заранее выделяются вручную.
import numpy as np
import pandas as pd
from sklearn.base import clone

from cross_validation import PurgedWalkForwardCV

def vin_v_anchored_walkforward(
    X: pd.DataFrame,
    y: pd.Series,
    t1: pd.Series,
    estimator,
    n_splits: int = 5,
    inner_val_pct: float = 0.20,
    final_test_pct: float = 0.20,
    pct_embargo: float = 0.01,
    scorer=None,
) -> dict:
    """
    Three-layer V-in-V pipeline with anchored expanding-window walkforward.

    Data is partitioned once, strictly in temporal order:
        [─── Outer Training (60%) ───][─ Inner Val (20%) ─][─ Final Test (20%) ─]

    The outer training set is further split by PurgedWalkForwardCV into
    n_splits expanding windows, each producing its own purged train/test pair.
    The inner validation set is touched only for shortlisting; the final test
    set is opened exactly once after a written commitment to a single config.

    Parameters
    ----------
    X, y, t1 : aligned DataFrame, Series, Series
    estimator  : sklearn-compatible estimator
    n_splits   : number of anchored walkforward windows within outer training
    inner_val_pct, final_test_pct : fractions of total data reserved
    pct_embargo : embargo fraction passed to PurgedWalkForwardCV
    scorer     : callable(y_true, y_pred) -> float, or None (returns raw preds)

    Returns
    -------
    dict with keys:
        outer_scores    – per-window score within outer training
        inner_val_score – score on the inner validation set (shortlisting only)
        final_test_score– score on the final test set (opened once, at the end)
        outer_cv        – the fitted PurgedWalkForwardCV object
    """
    n = len(X)

    # ── 1. Partition the data into three zones ───────────────────────────────
    outer_end   = int(n * (1.0 - inner_val_pct - final_test_pct))
    val_end     = int(n * (1.0 - final_test_pct))

    X_outer,     y_outer,     t1_outer     = X.iloc[:outer_end],  y.iloc[:outer_end],  t1.iloc[:outer_end]
    X_inner_val, y_inner_val, t1_inner_val = X.iloc[outer_end:val_end], y.iloc[outer_end:val_end], t1.iloc[outer_end:val_end]
    X_final,     y_final                   = X.iloc[val_end:],    y.iloc[val_end:]

    # ── 2. Phase 1 — exhaustive search within outer training ─────────────────
    # PurgedWalkForwardCV(expanding_window=True) anchors the start at index 0
    # and grows the training window forward — this IS anchored walkforward.
    outer_cv = PurgedWalkForwardCV(
        n_splits=n_splits,
        t1=t1_outer,
        pct_embargo=pct_embargo,
        expanding_window=True,   # ← anchored, not rolling
    )

    outer_scores = []
    outer_models = []

    for train_idx, test_idx in outer_cv.split(X_outer, y_outer):
        model = clone(estimator)
        model.fit(X_outer.iloc[train_idx], y_outer.iloc[train_idx])
        preds = model.predict(X_outer.iloc[test_idx])

        score = scorer(y_outer.iloc[test_idx], preds) if scorer else None
        outer_scores.append(score)
        outer_models.append(model)

    # At this point the researcher reviews outer_scores, shortlists candidates,
    # and selects a small number of finalist configurations. The inner
    # validation set is NOT touched yet.

    # ── 3. Phase 2 — shortlist on inner validation (sparingly) ───────────────
    # Only finalist models are exposed here. This set must not be used
    # to refine parameters — observation terminates candidate selection.
    finalist_model = outer_models[-1]   # placeholder: researcher selects this
    val_preds      = finalist_model.predict(X_inner_val)
    inner_val_score = scorer(y_inner_val, val_preds) if scorer else None

    # ── 4. Phase 3 — final test (opened exactly once) ────────────────────────
    # The researcher commits in writing to finalist_model before this line.
    # Any adjustment after seeing this result invalidates the test.
    final_preds      = finalist_model.predict(X_final)
    final_test_score = scorer(y_final, final_preds) if scorer else None

    return {
        "outer_scores":     outer_scores,
        "inner_val_score":  inner_val_score,
        "final_test_score": final_test_score,
        "outer_cv":         outer_cv,
    }

# ── Example usage ─────────────────────────────────────────────────────────
if __name__ == "__main__":
    from sklearn.ensemble import RandomForestClassifier
    from sklearn.metrics import accuracy_score

    dates  = pd.date_range("2018-01-01", periods=1000, freq="B")
    X_demo = pd.DataFrame(np.random.randn(1000, 5), index=dates)
    y_demo = pd.Series(np.random.randint(0, 2, 1000), index=dates)
    t1_demo = pd.Series(dates + pd.Timedelta(days=5), index=dates)

    results = vin_v_anchored_walkforward(
        X=X_demo, y=y_demo, t1=t1_demo,
        estimator=RandomForestClassifier(n_estimators=50, random_state=42),
        n_splits=5,
        scorer=accuracy_score,
    )

    print("Outer window scores:", results["outer_scores"])
    print("Inner validation:  ", results["inner_val_score"])
    print("Final test score:  ", results["final_test_score"])
Часть III — комбинаторно очищенная кросс-валидация (CPCV)
Проблема, для решения которой создана CPCV
Валидация внутри валидации (V-in-V) предполагает, что отдельные оценки, проводимые во внешней обучающей выборке, сами по себе не содержат утечек данных. Она управляет исследовательским процессом, но не проверяет внутреннюю валидность каждой оценки на обучающей и тестовой выборках.
Именно эту проблему и призвана решать комбинаторно очищенная кросс-валидация (CPCV), разработанная Маркосом Лопесом де Прадо в книге Advances in Financial Machine Learning. Устраняемое ею загрязнение имеет не поведенческую, а структурную природу: оно заложено в статистических свойствах самих финансовых временных рядов.
Почему финансовые данные устроены иначе
Стандартная k-блочная кросс-валидация — базовый рабочий инструмент машинного обучения — предполагает, что наблюдения независимы и одинаково распределены. Финансовые временные ряды существенно нарушают это допущение сразу несколькими взаимосвязанными способами.
Рассмотрим набор признаков, включающий 20-дневную скользящую среднюю. Наблюдение, рассчитанное на 21-й день, использует 19 из 20 тех же исходных точек данных, что и наблюдение, рассчитанное на 20-й день. Если эти два наблюдения отнести к разным блокам — одно к обучающей, другое к тестовой выборке, — тестовый блок фактически уже "видел" почти все данные, лежащие в основе соответствующего обучающего наблюдения. Граница между обучающей и тестовой выборками в таком случае оказывается иллюзорной.
Эта проблема усугубляется процессом формирования меток. В финансовом машинном обучении метки наблюдениям обычно присваиваются по результатам будущего периода удержания. Метка, сформированная на основе доходности за следующие 10 дней, создает зависимость между размеченным наблюдением и 10 последующими ценовыми барами. Эти последующие ценовые бары почти наверняка будут использоваться в качестве входных признаков в других частях набора данных, создавая канал утечки, который стандартная очистка не устраняет.
На рисунке 5 показаны k разбиений на обучающую и тестовую выборки в рамках k-блочной кросс-валидации, где k = 5. В этой схеме:
- набор данных разбивается на k подмножеств;
- Для i = 1,…,k:
- (a) алгоритм машинного обучения обучается на всех подмножествах, кроме i;
- (b) обученный алгоритм машинного обучения тестируется на подмножестве i.
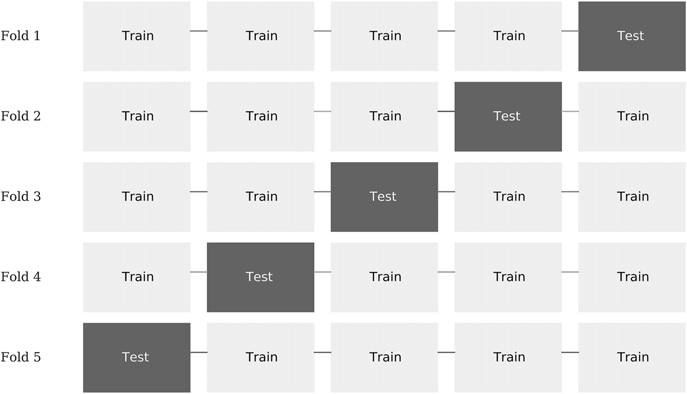
Рисунок 5. Разбиения на обучающую и тестовую выборки в схеме пятиблочной кросс-валидации
Два механизма очистки
Очистка. После назначения тестового блока CPCV удаляет из обучающей выборки любое наблюдение, окно формирования метки которого пересекается с тестовым периодом. Это не сводится к простому разделению временных периодов — при очистке необходимо учитывать конкретный горизонт, на котором рассчитывалась метка каждого наблюдения.
Эмбарго. Буфер наблюдений, непосредственно следующих за тестовым блоком, также исключается из обучающей выборки. Признаки, рассчитанные на этих наблюдениях после тестового блока, могут использовать данные из тестового периода, создавая канал обратной утечки. Размер окна эмбарго определяется самым длинным ретроспективным окном среди признаков в наборе.
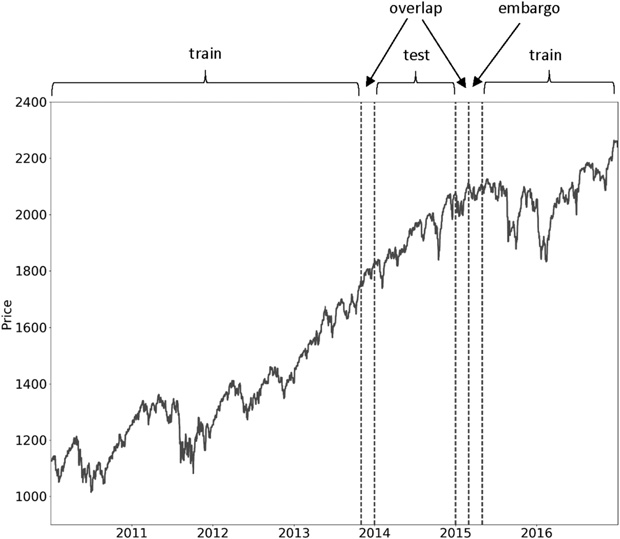
Рисунок 6. Очистка обучающих наблюдений перед тестовым блоком и эмбарго для обучающих наблюдений после него
Комбинаторные траектории
Помимо очистки и эмбарго, CPCV предлагает структурное улучшение по сравнению со стандартной k-блочной кросс-валидацией. Вместо одного разбиения на обучающую и тестовую выборки CPCV генерирует все возможные комбинации назначения блоков в тестовую выборку. Затем эти разбиения объединяются в полные траектории бэктеста.
Рассмотрим T наблюдений, разбитых без перемешивания на N групп: группы n = 1, …, N − 1 имеют размер ⌊T∕N⌋, N-я группа имеет размер T − ⌊T∕N⌋ (N − 1), а ⌊.⌋ обозначает функцию взятия целой части. Для тестовой выборки из k групп число возможных разбиений на обучающую и тестовую выборки равно:

Поскольку каждая комбинация включает k тестовых групп, общее число тестовых групп равно  . Поскольку вычислены все возможные комбинации, тестовые группы равномерно распределены по всем N группам: каждая группа входит в одинаковое число обучающих и тестовых выборок. Следовательно, для тестовых выборок из k групп при N группах можно построить в бэктесте всего φ[N, k] траекторий:

... Существует C(6, 4) = 15 разбиений, обозначенных как S1, …, S15. На рисунке … для каждого разбиения не отмечены группы, образующие обучающую выборку. Каждая группа входит 𝜑 [6, 2] = 5 тестовых выборок, поэтому эта схема разбиения позволяет построить пять траекторий бэктеста.
На рисунке 7 показано распределение каждой тестовой группы по одной из траекторий бэктеста. Например, траектория 1 строится путем объединения прогнозов из (G1, S1), (G2, S1), (G3, S2), (G4, S3), (G5, S4) и (G6, S5). Траектория 2 строится путем объединения прогнозов из (G1, S2), (G2, S6), (G3, S6), (G4, S7), (G5, S8) и (G6, S9) и т. д.
Эти траектории строятся путем обучения классификатора на доле данных 𝜃 = 1 − k∕N для каждой комбинации. Хотя теоретически обучение возможно на доле данных 𝜃 < 1∕2, на практике будем исходить из того, что k ≤ N∕2. Доля данных 𝜃 в обучающей выборке увеличивается при N → T, но уменьшается при k → N∕2. Число траекторий 𝜑 [N, k] увеличивается при N → T и при k → N∕2. В предельном случае наибольшее число траекторий достигается при N = T и k = N∕2 = T∕2, но для каждой комбинации классификатор обучается лишь на половине данных (𝜃 = 1∕2).

Рисунок 7. Распределение тестовых групп по каждой из пяти траекторий
Лопес де Прадо, 2018, с. 164-165
При N = 6 группах и k = 2 тестовых группах каждая траектория объединяет вневыборочные сегменты из подмножества разбиений так, чтобы ровно один раз охватить весь временной интервал, образуя C(6,2) × k / N = 5 полных траекторий. Именно эти траектории, а не отдельные разбиения, служат корректной основой для расчета коэффициентов Шарпа и оценки устойчивости распределения.
Это распределение само по себе информативно. Стратегия с узким положительным распределением результатов по всем комбинаторным вариантам разбиения на блоки демонстрирует устойчивость в различных временных конфигурациях. Стратегия, результативность которой существенно различается по траекториям, ненадежна независимо от средней результативности.
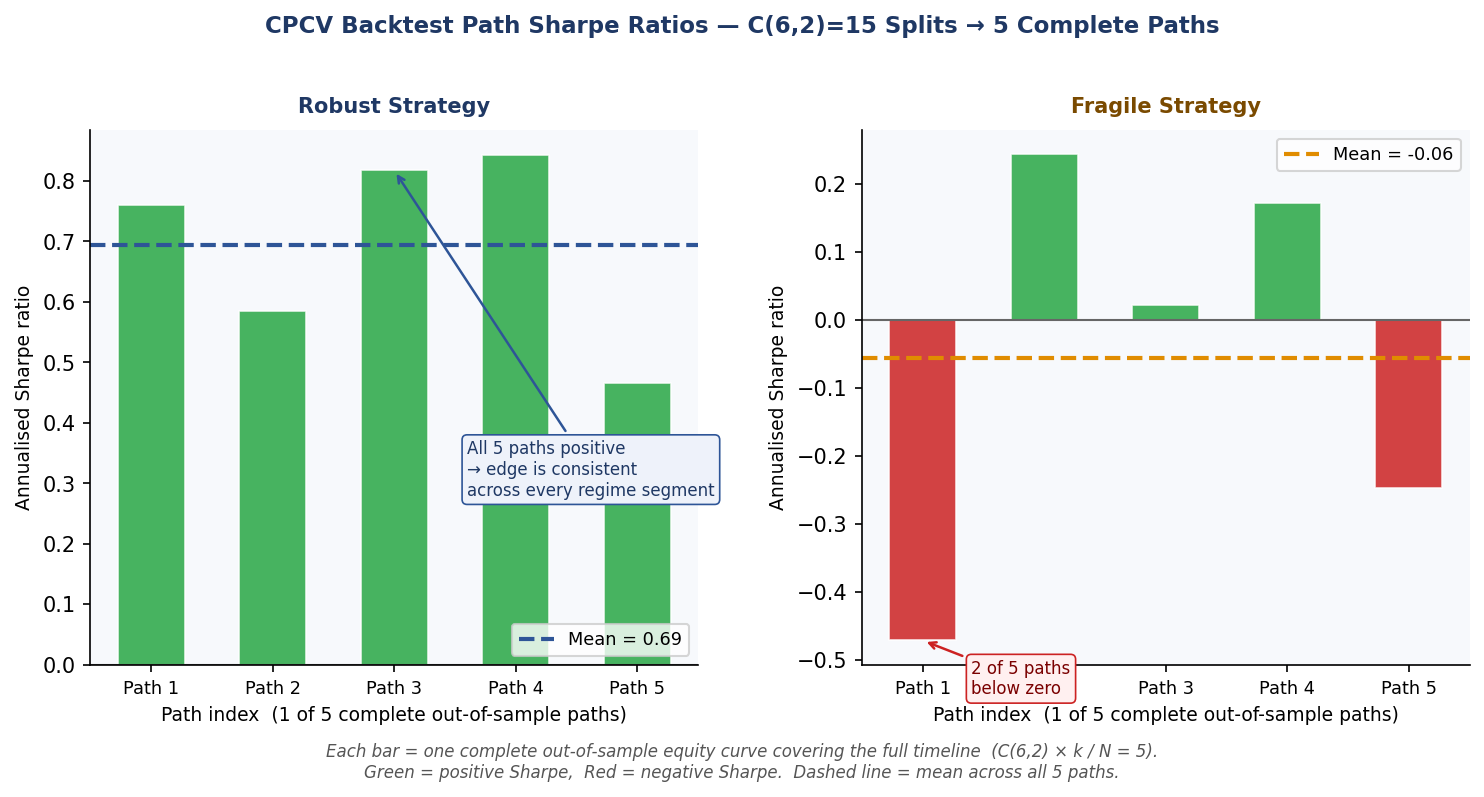
Рисунок 8. Столбчатая диаграмма с коэффициентами Шарпа по пяти траекториям CPCV для устойчивой и неустойчивой стратегий
Реализация
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestClassifier

from combinatorial import CombinatorialPurgedCV, CPCVAnalyzer, optimal_folds_number

# ── 1. Configure the CV generator ────────────────────────────────────────
# Use optimal_folds_number to find N and k that meet your targets.
# Here: aim for ~600 obs in each training set and 5 backtest paths.
n_folds, n_test_folds = optimal_folds_number(
    n_observations=1000,
    target_train_size=600,
    target_n_test_paths=5,
)
print(f"n_folds={n_folds}, n_test_folds={n_test_folds}")

cv = CombinatorialPurgedCV(
    n_folds=n_folds,
    n_test_folds=n_test_folds,
    t1=t1_outer,          # pd.Series: index=event start, values=event end
    pct_embargo=0.01,     # removes 1% of obs after each test block
)

print(cv.summary(X_outer))
# Number of Observations      1000
# Total Number of Folds          6
# Number of Test Folds           2
# Number of Test Paths           5
# Number of Training Combinations 15

# ── 2. Fit and predict across all combinatorial splits ───────────────────
# CPCVAnalyzer handles the parallel execution and path recombination.
analyzer = CPCVAnalyzer(
    estimator=RandomForestClassifier(n_estimators=100, random_state=42),
    cv_gen=cv,
    close_prices=close_prices,   # pd.Series of price for MtM Sharpe calculation
)

recombined_preds = analyzer.fit_predict(X_outer, y_outer)


# ── 3. Inspect the distribution of path Sharpe ratios ───────────────────
# Each path is an independent backtest covering the full timeline once.
# A tight, positive distribution signals robustness.
metrics = analyzer.get_distribution_metrics(primary_sides=sides)

path_sharpes = metrics.xs("binary", level="method")["mtm_sharpe"]
print("Path Sharpe ratios:")
print(path_sharpes.to_string())
print(f"Mean: {path_sharpes.mean():.3f}  Std: {path_sharpes.std():.3f}")


# ── 4. Visualise train/test fold assignments ─────────────────────────────
# Run split() fully first so index_train_test_ is complete.
_ = [s for s in cv.split(X_outer)]   # exhaust generator
fig = cv.plot_train_test_folds()
fig.show()
Часть IV — комбинаторно симметричная кросс-валидация (CSCV)
От защиты к измерению
V-in-V и CPCV являются защитными механизмами: они снижают риск переобучения за счет структурирования исследовательского процесса и очистки от утечек данных. CSCV же прежде всего служит инструментом диагностики и измерения. Результат CSCV — одно число: вероятность переобучения бэктеста (PBO).
CSCV была предложена Дэвидом Бейли и Маркосом Лопесом де Прадо как метод количественной оценки того, в какой степени результаты процесса выбора стратегии обусловлены внутривыборочной оптимизацией, а не подлинной вневыборочной предсказательной способностью. PBO — это фальсифицируемая и пригодная для представления количественная оценка, а не качественное суждение. CSCV можно применять на любом этапе исследовательского пайплайна, где имеется набор кандидатов, а не только после предварительного отбора в V-in-V. Поэтому это гибкий инструмент аудита.
Механика
Процедура начинается с разбиения исторических данных на S равных подмножеств, обычно от 8 до 16. Затем формируются все C(S, S/2) варианты разбиения этих подмножеств на обучающую и тестовую половины. Для каждого разбиения определяется стратегия с наилучшей внутривыборочной результативностью. Затем фиксируется ее ранг среди всех стратегий на вневыборочной половине того же разбиения.

Рисунок 9. CSCV, этап 1 — данные разбиваются на S равных подмножеств. Затем перечисляются все C(S, S/2) варианты распределения половины подмножеств во внутривыборочную часть (IS, зеленый), а другой половины — во вневыборочную часть (OOS, красный).

Рисунок 10. CSCV, этап 2 — для каждого разбиения определяется лучшая внутривыборочная стратегия (IS) — S3★ —, после чего фиксируется ее ранг во вневыборочной половине (OOS). Здесь она занимает 4-е место из 6 — ниже медианы, — что увеличивает счетчик PBO.

Рисунок 11. CSCV, этап 3 — доля разбиений, в которых лучшая внутривыборочная стратегия оказалась ниже медианы по вневыборочным результатам, является оценкой PBO. Показатель PBO, равный 0,38, указывает на существенное смещение отбора в процессе исследования.

Рисунок 12. Интерпретация PBO. Показатель PBO, близкий к 0, указывает на то, что процесс отбора надежно выявляет подлинно лучшие стратегии на вневыборочных данных. Показатель PBO, близкий к 0,5, указывает на то, что лучшая внутривыборочная стратегия занимает по вневыборочным результатам практически случайное место в рейтинге. Порог "приемлемости" зависит от контекста и размера набора кандидатов — это практическое правило, а не формальная статистическая граница.
Чего CSCV не делает
CSCV не устраняет переобучение. CSCV не устраняет временные утечки, не контролирует степени свободы исследователя и не структурирует исследовательский процесс. Высокий показатель PBO свидетельствует о ненадежности процесса отбора, но не указывает, как сделать этот процесс надежным.
CSCV наиболее эффективен в качестве финального аудита. После предварительного отбора кандидатов с помощью V-in-V он дает показатель PBO для всего процесса отбора. Низкий показатель PBO количественно подтверждает, что процесс отбора выявлял сигнал, а не шум. Поскольку CSCV работает с любым набором результатов испытаний стратегий, его можно применять и на более ранних этапах, например для аудита процесса формирования кандидатов во внешней обучающей выборке.
Реализация
CSCV напрямую использует CombinatorialPurgedCV. Поскольку CSCV рассматривает все подмножества симметрично и между внутривыборочной и вневыборочной половинами нет временной направленности, установите pct_embargo=0.0 и n_test_folds=n_folds//2. В результате получаются описанные выше симметричные разбиения C(S, S/2).
"""
Probability of Backtest Overfitting (PBO) — Bailey & Lopez de Prado (2014).

Uses CombinatorialPurgedCV with pct_embargo=0.0 and n_test_folds=n_folds//2
to generate the C(S, S/2) symmetric IS/OOS splits required by CSCV.
"""
from math import comb
from typing import Callable, Dict, List

import numpy as np
import pandas as pd
from scipy.stats import norm

from combinatorial import CombinatorialPurgedCV

def compute_pbo(
    returns_matrix: pd.DataFrame,
    t1: pd.Series,
    n_folds: int = 8,
    metric: Callable = None,
) -> Dict:
    """
    Compute the Probability of Backtest Overfitting (PBO).

    Parameters
    ----------
    returns_matrix : pd.DataFrame, shape (T, N)
        Columns are candidate strategies; rows are time-ordered observations.
        Values should be per-period returns (or any scalar performance measure
        that is comparable across strategies at a given time step).

    t1 : pd.Series
        Event end-times aligned with returns_matrix.index. Because CSCV is
        symmetric (no temporal arrow), pct_embargo is set to 0.0, so t1 is
        used only to satisfy the CombinatorialPurgedCV interface — you may
        pass t1 = pd.Series(index, index=index) as a neutral value.

    n_folds : int, default=8
        Number of equal subsets S. Must be even. C(S, S/2) splits are
        generated. Bailey & Lopez de Prado recommend 8–16.

    metric : callable(returns: pd.Series) -> float, optional
        Aggregates a column of returns into a scalar performance measure.
        Defaults to the Sharpe ratio (mean/std).

    Returns
    -------
    dict with keys:
        pbo          – float in [0, 1]: estimated probability of overfitting
        n_splits     – total number of IS/OOS splits evaluated (= C(S, S/2))
        below_median – number of splits where best-IS ranked below OOS median
        oos_ranks    – list of normalised OOS ranks for the best-IS strategy
                       (0 = best OOS, 1 = worst OOS)
        logit_sr     – logit-transformed OOS score (if in (0,1)) for best-IS strategy per split
    """
    if n_folds % 2 != 0:
        raise ValueError(f"n_folds must be even for symmetric CSCV; got {n_folds}.")

    n_test_folds = n_folds // 2          # ← symmetric split: half IS, half OOS

    if metric is None:
        def metric(r: pd.Series) -> float:
            """Sharpe ratio."""
            return r.mean() / r.std(ddof=1) if r.std() > 0 else 0.0

    # ── Build the CSCV generator ──────────────────────────────────────────
    # pct_embargo=0.0  → no embargo (CSCV is symmetric, not temporal)
    # n_test_folds=n_folds//2 → exactly half the folds form the OOS set
    cv = CombinatorialPurgedCV(
        n_folds=n_folds,
        n_test_folds=n_test_folds,   # = n_folds // 2
        t1=t1,
        pct_embargo=0.0,             # ← required for symmetric CSCV
    )

    n_strategies = returns_matrix.shape[1]
    below_median = 0
    oos_ranks    = []
    logit_sr     = []

    # ── Iterate over all C(n_folds, n_folds//2) symmetric splits ────────
    for train_idx, test_idx_list in cv.split(returns_matrix):
        test_idx = np.concatenate(test_idx_list)

        # IS half: compute metric for every strategy
        is_scores = returns_matrix.iloc[train_idx].apply(metric, axis=0)

        # OOS half: compute metric for every strategy
        oos_scores = returns_matrix.iloc[test_idx].apply(metric, axis=0)

        # Best IS strategy
        best_is_col = is_scores.idxmax()

        # Rank of that strategy OOS (0-based; 0 = best OOS performer)
        oos_sorted = oos_scores.rank(ascending=False)   # rank 1 = best
        oos_rank   = oos_sorted[best_is_col]               # 1-indexed

        # Normalise rank to [0, 1]: 0 = best OOS, 1 = worst OOS
        norm_rank = (oos_rank - 1) / (n_strategies - 1) if n_strategies > 1 else 0.0
        oos_ranks.append(float(norm_rank))

        # Below median? (norm_rank > 0.5 means worse than median)
        if norm_rank > 0.5:
            below_median += 1

        # Logit-transformed OOS score (if in (0,1)) for the best-IS strategy
        oos_sr = float(oos_scores[best_is_col])
        logit_sr.append(np.log(oos_sr / (1 - oos_sr)) if 0 < oos_sr < 1 else np.nan)

    n_splits = cv.n_splits
    pbo      = below_median / n_splits

    return {
        "pbo":          pbo,
        "n_splits":     n_splits,
        "below_median": below_median,
        "oos_ranks":    oos_ranks,
        "logit_sr":     [v for v in logit_sr if not np.isnan(v)],
    }

# ── Example usage ─────────────────────────────────────────────────────────
if __name__ == "__main__":
    # Simulate 50 strategy return streams over 500 time steps
    rng     = np.random.default_rng(42)
    dates   = pd.date_range("2020-01-01", periods=500, freq="B")
    returns = pd.DataFrame(
        rng.normal(0.0001, 0.01, size=(500, 50)),
        index=dates,
        columns=[f"strategy_{i}" for i in range(50)],
    )

    # Neutral t1: event start == event end (no label horizon, no purging effect)
    t1_neutral = pd.Series(dates, index=dates)

    result = compute_pbo(
        returns_matrix=returns,
        t1=t1_neutral,
        n_folds=8,      # → n_test_folds=4, C(8,4)=70 splits
    )

    print(f"PBO  : {result['pbo']:.3f}")
    print(f"Splits evaluated : {result['n_splits']}")
    print(f"Below median (IS best → OOS below median): {result['below_median']}")

    # Interpret: if returns are pure noise, PBO ≈ 0.5
    # A strategy with genuine edge should push PBO toward 0
Часть V — единый пайплайн
Соотнесение методов с этапами исследования
Взаимосвязь между этими тремя методами становится понятной, если соотнести их с этапами исследовательского процесса V-in-V. Они не конкурируют. Они занимают разные места в пайплайне и защищают от разных угроз.
| Метод | Этап в пайплайне | Устраняемая угроза | Результат |
|---|---|---|---|
| CPCV | Во внешней обучающей выборке (фаза 1) | Временная утечка в каждой оценке на обучающей и тестовой выборках | Очищенные траектории результативности для каждого оценочного прогона |
| V-in-V | Управляет всем исследовательским процессом | Степени свободы исследователя, накопленные в ходе итераций | Структура исследовательского процесса с тремя защищенными зонами |
| CSCV | После предварительного отбора кандидатов (этап 2) или на любом этапе, где имеется набор кандидатов | Смещение отбора среди кандидатов | PBO — фальсифицируемая оценка вероятности |
Решают ли они одну и ту же задачу?
Эти три метода связаны тем, что все они появились в ответ на наивные разбиения на обучающую и тестовую выборки, дающие оптимистично завышенные оценки результативности на финансовых данных. Но каждый из них устраняет свой механизм этой общей проблемы.
Валидация внутри валидации (V-in-V) устраняет поведенческое загрязнение, накапливающееся в ходе разработки из-за итеративных решений исследователя при построении модели. Это загрязнение вносит исследователь. Его не было бы, если бы в самом начале стратегия выбиралась однократно, без итераций.
Комбинаторно очищенная кросс-валидация (CPCV) устраняет структурное загрязнение, заложенное во временной зависимости финансовых наблюдений. Это загрязнение содержится в самих данных и сохранялось бы, даже если бы исследователь вообще не принимал итеративных решений. Это математическое свойство финансовых временных рядов.
Комбинаторно симметричная кросс-валидация (CSCV) количественно оценивает вероятность того, что процесс отбора кандидатов в целом дал переобученный результат. Она дает фальсифицируемую оценку надежности выбранной стратегии, которую не предоставляют два других метода.
Применение CPCV без структурной дисциплины V-in-V дает отдельные оценки без утечек, но оставляет степени свободы исследователя без контроля. Разработчик мог бы применять CPCV в ходе пятидесяти итераций доработки стратегии, наблюдать каждый результат и учитывать его при следующем решении по моделированию. Каждая отдельная оценка не содержала бы утечек, но исследовательский процесс в целом был бы загрязнен.
И наоборот, применение V-in-V без CPCV на этапе 1 полностью сохраняет неприкосновенность финальной тестовой выборки, но может дать кандидата, отобранного на основе оценок, завышенных из-за утечки данных. Трехслойная структура защищает финальную тестовую выборку, но механизм формирования кандидатов нарушен.
Отказ от CSCV означает, что у специалиста нет количественной оценки надежности процесса отбора. Известные каналы утечки данных устранены, но отсутствует проверяемая и пригодная для профессиональной коммуникации количественная оценка вероятности того, что выбранная стратегия обладает подлинным рыночным преимуществом, а не оказалась случайно удачной.
Какой метод наиболее важен?
Если ранжировать методы по тяжести смещения, возникающего при изолированном отказе от каждого из них, следующий порядок может служить разумной отправной точкой. Однако это редакционное суждение, а не устоявшийся эмпирический вывод: относительная важность каждого метода зависит от длины набора данных, сложности признаков и интенсивности исследовательской программы.
1. CPCV — обязательное условие для финансовых временных рядов. Стандартная k-блочная кросс-валидация не просто неоптимальна для финансовых данных — она структурно некорректна. Предположение о независимости и одинаковом распределении (i.i.d.), необходимое для этого метода, нарушается практически в любом наборе финансовых признаков. Временная утечка завышает оценки результативности, и исправить это задним числом невозможно.
2. V-in-V — обязательный элемент любой итеративной исследовательской программы. На практике любая серьезная разработка стратегии требует недель или месяцев итеративной доработки. Без структурной дисциплины V-in-V каждое наблюдение за вневыборочной результативностью, влияющее на последующее решение, создает неучтенные степени свободы исследователя. В длительной и интенсивной исследовательской программе этот накопленный эффект может значительно превосходить любой отдельный источник утечки данных. Это весомый аргумент в пользу того, что на практике V-in-V может быть не менее важной, чем CPCV, или даже важнее ее.
3. CSCV — особенно ценный инструмент для представления результатов. Количественный показатель PBO дает то, чего не могут дать два других метода: одно обоснованное число, отражающее надежность всего процесса отбора кандидатов. Это делает CSCV особенно ценной в институциональной среде, где исследования проходят экспертную оценку, проверку коллегами или представляются заинтересованным сторонам, не имеющим возможности изучить полную методологию.
Заключение
Подход "бросать спагетти в стену" не обязательно является интеллектуально несостоятельным подходом для поиска стратегий. Широкий исследовательский поиск в обширных пространствах индикаторов может выявить подлинные рыночные преимущества, если исследователь построил достаточно строгую инфраструктуру валидации, позволяющую отделить подлинный сигнал от статистического шума, неизбежно порождаемого полным перебором.
Ни одного метода самого по себе недостаточно. V-in-V, CPCV и CSCV устраняют разные типы сбоев, применяются на разных этапах исследовательского пайплайна и обеспечивают различные формы защиты или измерения. Применение одного метода без остальных оставляет открытыми существенные каналы уязвимости.
CPCV гарантирует отсутствие временных утечек информации в каждой оценке на обучающей и тестовой выборках на этапе исследовательского поиска. V-in-V гарантирует, что в ходе исследовательского процесса не накапливаются степени свободы исследователя, завышающие кажущуюся значимость итогового выбора стратегии. CSCV дает количественную, проверяемую оценку вероятности того, что процесс отбора выявил подлинное рыночное преимущество, а не оптимизированный артефакт доступных данных.
В совокупности эти три метода превращают коэффициент Шарпа бэктеста, как и любую другую метрику результативности, из числа, отражающего надежды исследователя, в число, отражающее то, что стратегия с высокой вероятностью действительно способна показать.
Справочник по коду
В примерах реализации этой статьи используются пять файлов. В таблице ниже приведены их роли и взаимосвязи.
| Файл | Назначение | Основное содержимое | Зависимости |
|---|---|---|---|
| cross_validation.py | Базовые примитивы очистки и пошаговой кросс-валидации (walk-forward). Основа для всех компонентов более высокого уровня. | ml_get_train_times — векторизованная очистка на основе событий; PurgedKFold — стандартная очищенная k-блочная кросс-валидация; PurgedWalkForwardCV — пошаговое тестирование с фиксированным началом и расширяющимся окном либо скользящее пошаговое тестирование с очисткой и эмбарго; ml_cross_val_score — средство запуска кросс-валидации по одной метрике; analyze_cross_val_scores — средство запуска кросс-валидации по нескольким метрикам с разбором матрицы ошибок. | Нет (базовый модуль) |
| combinatorial.py | Механизм комбинаторно очищенной кросс-валидации. Генерирует все C(N,k) разбиения на обучающую и тестовую выборки, объединяет их в φ[N,k] полных траекторий бэктеста и вычисляет полное распределение метрик результативности по траекториям. | CombinatorialPurgedCV — совместимый со sklearn генератор кросс-валидации с очисткой, эмбарго, объединением траекторий и визуализацией блоков; CPCVAnalyzer — параллельное обучение и прогнозирование, а также MtM-распределение коэффициента Шарпа по всем траекториям; optimal_folds_number — определяет пару (N, k), наиболее соответствующую целевому размеру обучающей выборки и числу траекторий. | cross_validation.py (импортирует ml_get_train_times) |
| anchored_walkforward.py | Реализует полный трехслойный исследовательский процесс V-in-V с использованием расширяющегося окна с фиксированным началом. Обеспечивает строгое разделение зон внешней обучающей выборки, внутренней валидационной выборки и финальной тестовой выборки. | vin_v_anchored_walkforward — разбивает данные на три временные зоны, запускает PurgedWalkForwardCV(expanding_window=True) во внешней зоне, предоставляет внутреннюю валидационную выборку только для предварительного отбора кандидатов и открывает финальную тестовую выборку ровно один раз после письменной фиксации решения. | cross_validation.py |
| cpcv_usage.py | Пример использования, показывающий, как настроить и запустить CPCV во внешней обучающей зоне пайплайна V-in-V, проанализировать распределение коэффициента Шарпа по траекториям и правильно вызвать методы визуализации блоков. | Демонстрирует optimal_folds_number, CombinatorialPurgedCV.summary, CPCVAnalyzer.fit_predict, get_distribution_metrics, а также правильный порядок вызова plot_train_test_index и plot_train_test_folds. | combinatorial.py |
| pbo.py | Вычисляет вероятность переобучения бэктеста (PBO) с помощью CombinatorialPurgedCV, настроенного на симметричные разбиения CSCV. Принимает любую матрицу доходностей стратегий и метрику результативности, затем возвращает оценку PBO и диагностику вневыборочных рангов (OOS) по каждому разбиению. | compute_pbo — устанавливает pct_embargo=0.0 и n_test_folds=n_folds//2, чтобы получить симметричные разбиения C(S, S/2), требуемые для CSCV; определяет лучшую внутривыборочную стратегию для каждого разбиения; записывает ее нормализованный вневыборочный ранг; агрегирует долю разбиений, в которых она оказалась ниже медианы OOS. | combinatorial.py |
Дополнительная литература
- Masters, T. (1995). Advanced Algorithms for Neural Networks. John Wiley & Sons.
- Masters, T. (2013). Permutation and Randomization Tests for Trading System Development. Self-published.
- Lopez de Prado, M. (2018). Advances in Financial Machine Learning. John Wiley & Sons.
- Bailey, D. H., & Lopez de Prado, M. (2014). The Deflated Sharpe Ratio: Correcting for Selection Bias, Backtest Overfitting and Non-Normality. Journal of Portfolio Management.
- Bailey, D. H., Borwein, J., Lopez de Prado, M., & Zhu, Q. J. (2014). Pseudo-Mathematics and Financial Charlatanism: The Effects of Backtest Overfitting on Out-of-Sample Performance. Notices of the AMS.
- White, H. (2000). A Reality Check for Data Snooping. Econometrica, 68(5), 1097–1126.
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/21603
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.

 Разработка научно обоснованного сеточного советника в MQL5: Почему большинство сеточных советников терпят неудачу и что доказал Таранто
 Освоение массивов премии и дисконта: Оптимизация торговли по дисбалансам в PD-массивах
 Использование Экономического календаря MQL5 для фильтрации новостей (Часть 3): Сохранение работы при перезапусках терминала во время новостного окна
 Использование Экономического календаря MQL5 для фильтрации новостей (Часть 2): Временное удаление и восстановление стоп-уровней во время выхода новостей

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования
Ой, я опоздал со своими мыслями — Уоррен Гиддингс уже высказал дельные замечания. ;-)
В частности, я хотел бы отметить, что в статье осталась за кадром одна очень важная метаоптимизация — а именно настройка размеров окна внутри выборки и шага продвижения. Ведь метод walkforward не ограничивается только rolling и anchored, существует также оптимизация cluster walkforward.
Поэтому все описанные методы следует, так сказать, повторно применить в другом, перпендикулярном измерении комбинаций размеров внутривыборочного и вневыборочного окон и проверить на тестовом периоде.
Отличная работа! Спасибо!
Это кот Шредингера, у которого вероятность 50/50 быть рабочей торговой стратегией. Пока кот находится в суперпозиции (не проведена финальная тестовая выборка), ТС рабочая и нерабочая одновременно.
Но как только тест проведен - это подгонка.
Да, это плохо соотносится с классической логикой. Ведь если ТС рабочая, то как ее финальный тест может сделать ее автоматически нерабочей?! У меня нет хорошего аргумента на этот логичный вопрос.
Но проведение финального теста, похоже, все же походит на приговор для ТС.
Тогда логичен другой вопрос, разве не будет финальным тестом сам реал? - Нет, не будет. Потому что это тот тест, в котором нет права выбора, запускать на прошедшем интервале реала или нет.
В общем, очень сумбурно и фундаментально.
В общем, очень сумбурно и фундаментально.
Опубликована статья Единый пайплайн валидации для защиты от переобучения бэктеста:
Автор: Patrick Murimi Njoroge
хорошая статья, тут такое редкость.