

Офлайн-обучение с подкреплением в MQL5: Обучение торговой политики по истории сделок без экспериментов на реальном рынке
 24
 0

Введение
Большинство подходов к торговле на основе обучения с подкреплением предполагают, что агент может взаимодействовать с рынком во время обучения: он пробует действие, наблюдает вознаграждение и обновляет свои оценки. В симуляторе это разумно, но на реальном счете опасно: "попробовать действие" означает разместить реальный ордер с реальным проскальзыванием, пока политика еще плохо справляется со своей задачей. Офлайн-обучение устраняет этот риск, но не риск развертывания плохой политики после завершения обучения: зафиксированная политика по-прежнему может торговать неудачно, просто она не может усугубить ситуацию, продолжая экспериментировать.
В этой статье рассматривается иной подход: обучение торговой политики исключительно на фиксированном наборе исторических переходов без дальнейшего взаимодействия с рынком во время обучения. Набор данных состоит из записей, уже сделанных стратегией на основе правил, трейдером при ручной торговле или ранее использовавшимся советником: состояние, выполненное действие, полученное вознаграждение и следующее состояние. Политика обучается только по этому журналу, а затем развертывается в зафиксированном виде: без исследования среды, без проб и ошибок в реальном времени и без риска того, что сам процесс обучения приведет к потере денег.
Офлайн-обучение важно и для возможности аудита: фиксированный набор данных можно тщательно проверить и повторно обработать до размещения первого ордера, причем каждый переход доступен для проверки в электронной таблице. Для торгового подразделения, которому нужно объяснять работу своих систем комитету по рискам, это оправданный компромисс, хотя политика исследования среды у онлайн-агента постоянно меняется. Однако в статье не показаны формальное версионирование набора данных, журнал начальных значений генератора случайных чисел и параметров или явное разбиение на обучающую и тестовую выборки — поэтому речь скорее о возможности повторного выполнения, чем о полноценном аудите.
Но есть загвоздка: наивное Q-обучение на фиксированном наборе данных плохо работает без дополнительных мер. Если в журнале нет ни одного примера открытия длинной позиции при определенном режиме волатильности, стандартная Q-сеть все равно может присвоить этому действию высокую ценность, поскольку в данных нет ничего, что снижало бы эту оценку. Обновление по Беллману с бутстрэппингом распространяет эти завышенные оценки на ранее не наблюдавшиеся пары "состояние — действие", а при развертывании политика может использовать их — в этом и состоит ошибка экстраполяции, центральная проблема офлайн-обучения с подкреплением.
Консервативное Q-обучение (CQL) добавляет штрафной член, снижающий Q-значения широкого круга действий, которые могла бы выбрать текущая политика, но при этом позволяет подгонять оценки действий, фактически представленных в данных, под истинное накопленное вознаграждение. Сеть остается консервативной там, где данных мало, и доверяет собственным оценкам лишь там, где они подкреплены данными. В литературе по CQL это описывается как нижняя граница истинной ценности. При использовании одной сети и 838 переходов считайте "консервативный" точным описанием подхода, а "нижнюю границу" — теоретическим обоснованием, но не гарантией.
О рамках статьи: здесь CQL реализовано непосредственно на MQL5, без модели ONNX и внешнего фреймворка машинного обучения: скрипт обучения, сеть и советник для развертывания — это обычные файлы .mq5/.mqh. Вспомогательный скрипт на Python лишь преобразует CSV-файлы, экспортированные самим MQL5, в формат переходов, который читает обучающий скрипт; саму модель он не затрагивает.
Содержание
- Почему офлайн-обучению с подкреплением нужна консервативная поправка
- Целевая функция CQL в том виде, в котором она фактически вычисляется в коде
- Создание офлайн-набора данных из журналов сделок MQL5
- Q-сеть на MQL5: прямой проход, функция потерь и обратное распространение ошибки
- Развертывание зафиксированной политики: реализация в советнике
- Пограничные случаи и возможные проблемы
- Проверка в тестере стратегий
- Заключение
Почему офлайн-обучению с подкреплением нужна консервативная поправка
Представьте набор данных, собранный стратегией следования за трендом, которая почти никогда не открывала короткие позиции в утренние часы с низкой волатильностью, поскольку ее правила в это время предписывали отсутствие позиции. Стандартное Q-обучение все равно вычисляет Q-значение для действия "короткая позиция" в таком режиме: сеть должна выдавать значение для каждого действия, даже если оно почти не представлено в данных. Поскольку при обучении используется бутстрэппинг на основе суммы вознаграждения и дисконтированной ценности лучшего следующего действия, случайно завышенная оценка принимается за истинное значение и распространяется назад на все предшествующие состояния, из которых можно было попасть в это состояние. При офлайн-обучении опровергнуть эту оценку нечем.
Целевая величина для обновления в Q-обучении — r + gamma * max_a' Q(s', a'): сеть использует бутстрэппинг на основе собственной оценки ценности лучшего следующего действия, а не фактически наблюдаемого результата. При онлайн-обучении неверная оценка корректируется в следующем эпизоде, когда агент выполняет это действие и получает фактическое вознаграждение. При офлайн-обучении следующего эпизода нет: завышенная оценка становится также целевой величиной для обновления оценки предыдущего состояния. Ошибка накапливается, распространяясь назад по траектории, пока небольшое завышение не приводит к политике, уверенно предпочитающей действие, которое никто никогда не демонстрировал.
Способы решения можно условно разделить на две группы: ограничивать политику, удерживая ее близкой к поведению, представленному в данных (методы с регуляризацией на основе клонирования поведения или подходы, ограничивающие выбор действиями, представленными в данных, например BCQ), либо ограничивать функцию ценности, сохраняя пессимистические оценки для действий с недостаточной поддержкой данными (CQL и родственные методы). В этой статье используется второе семейство методов, поскольку его проще реализовать при написании цикла обратного распространения ошибки вручную: поправка добавляется непосредственно в функцию потерь, вторая сеть не нужна, и скрипт занимает менее двухсот строк.
Архитектура в этой статье намеренно выстроена как линейная последовательность этапов, чтобы механизм оставался на виду в коде, а не скрывался за абстракциями фреймворка:
Полный офлайн-конвейер CQL
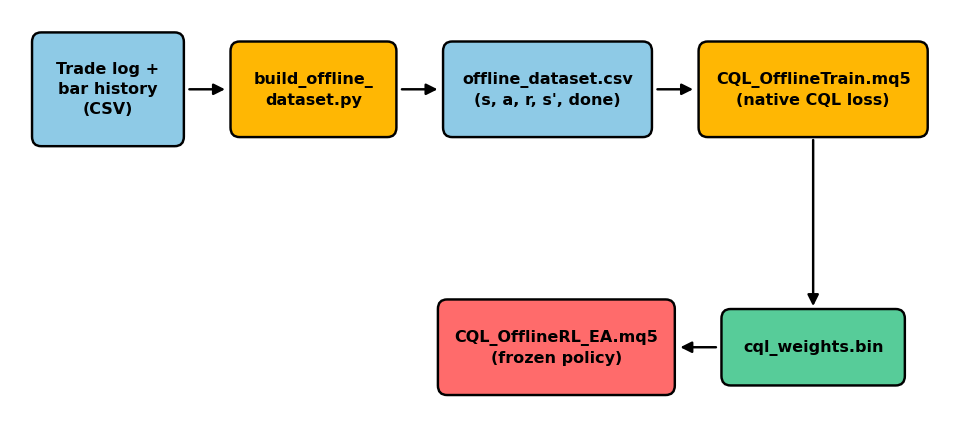
Рис. 1. Полный офлайн-конвейер: журнал сделок и история баров преобразуются в набор переходов, на котором Q-сеть обучается полностью в офлайн-режиме, а в торговый советник при развертывании поступают только полученные зафиксированные веса.
Стоит обратить внимание на две вещи. Во-первых, ни одна стрелка не ведет от текущих тиков или работы тестера стратегий обратно к обучающему скрипту: CQL_OfflineTrain.mq5 — это скрипт, а не советник или индикатор. Он выполняется однократно, вне графика, и работает со статическим файлом. Во-вторых, файл весов — единственное, что переносится с этапа обучения на этап развертывания: советник не получает исходный набор данных, а лишь вызывает Forward() и SelectAction(), используя веса, зафиксированные до его запуска.
Целевая функция CQL в том виде, в котором она фактически вычисляется в коде
Стандартная функция потерь временных разностей для Q-сети с дискретными действиями не представляет собой ничего необычного: значение Q(s,a) для действия, записанного в журнале, подгоняется к сумме наблюдаемого вознаграждения и дисконтированной ценности лучшего следующего действия. CQL добавляет второй член, вычисляемый на основе текущего выхода сети для каждого действия в состоянии s, а не только для того, которое зафиксировано в журнале:
L_TD(θ)    = 0.5 * ( Q_θ(s,a) - y )^2
y          = r + gamma * max_{a'} Q_θ(s', a') * (1 - done)

L_CQL(θ)   = alpha * ( logsumexp_{a} Q_θ(s,a) - Q_θ(s,a_data) )

L_total(θ) = L_TD(θ) + L_CQL(θ)
Член logsumexp_a представляет собой гладкую аппроксимацию "ценности, которую текущая политика получила бы при жадном выборе": основной вклад вносит действие с наибольшим Q-значением, а остальные сглаживают результат тем сильнее, чем ближе их Q-значения к максимальному. Вычитание Q(s,a_data) делает штраф малым, когда действие из журнала уже доминирует, и большим, когда наибольшую оценку получает действие, не представленное в данных. Параметр alpha регулирует силу этого эффекта: при слишком малом значении вновь возникает ошибка экстраполяции, а при слишком большом сеть становится настолько пессимистичной, что не может отдать предпочтение ни одному действию.
Дифференцирование члена CQL по каждому выходу Q(s,a) дает простой и вычислительно недорогой градиент: в точности softmax(Q(s,.))[a], с дополнительной поправкой -1 для действия, записанного в журнале. Именно поэтому этот метод вполне можно реализовать вручную на MQL5: не нужны ни сеть клонирования поведения, ни выборка действий с учетом весов важности — достаточно softmax по трем числам, уже вычисленным в ходе прямого прохода. Приведенная ниже полная реализация функции TrainStep() выполняет эти вычисления напрямую:
//+------------------------------------------------------------------+
//| CQLQNetwork::TrainStep                                           |
//+------------------------------------------------------------------+
double CQLQNetwork::TrainStep(const CQLTransition &batch[], const int batch_size,
                               const double alpha, const double gamma, const double lr)
  {
//--- gradient accumulators, zeroed once per mini-batch (batch SGD).
//--- as in the constructor, fixed-size 2D arrays cannot be zeroed a row at
//--- a time via ArrayInitialize(), so each element is set explicitly
   double gW1[CQL_STATE_FEATURES][CQL_HIDDEN_UNITS];
   double gb1[CQL_HIDDEN_UNITS];
   double gW2[CQL_HIDDEN_UNITS][CQL_ACTION_COUNT];
   double gb2[CQL_ACTION_COUNT];
   for(int i = 0; i < CQL_STATE_FEATURES; i++)
      for(int j = 0; j < CQL_HIDDEN_UNITS; j++)
         gW1[i][j] = 0.0;
   for(int j = 0; j < CQL_HIDDEN_UNITS; j++)
      for(int a = 0; a < CQL_ACTION_COUNT; a++)
         gW2[j][a] = 0.0;
   ArrayInitialize(gb1, 0.0);
   ArrayInitialize(gb2, 0.0);

   double total_loss = 0.0;
   double q_s[], q_next[];

   for(int n = 0; n < batch_size; n++)
     {
      //--- forward pass on s; m_pre/m_post are cached as a side effect and
      //--- reused below for backprop through this same sample
      Forward(batch[n].state, q_s);
      double hidden_cache[CQL_HIDDEN_UNITS];
      double pre_cache[CQL_HIDDEN_UNITS];
      ArrayCopy(hidden_cache, m_post);
      //--- pre_cache must be copied now, before the second Forward() call
      //--- below overwrites m_pre with next_state's pre-activations
      ArrayCopy(pre_cache, m_pre);

      //--- bootstrapped TD target: r + gamma * max_a' Q(s',a') * (1-done).
      //--- This is semi-gradient (no gradient flows through the target network,
      //--- which here is just the same weights evaluated at s') - standard
      //--- practice to keep training stable
      Forward(batch[n].next_state, q_next);
      double max_next = q_next[0];
      for(int a = 1; a < CQL_ACTION_COUNT; a++)
         if(q_next[a] > max_next)
            max_next = q_next[a];
      double target = batch[n].reward + (batch[n].done ? 0.0 : gamma * max_next);

      int    a_logged = batch[n].action;
      double td_error  = q_s[a_logged] - target;

      //--- CQL conservative term: softmax over the network's own current
      //--- Q(s,.) approximates E_{a~mu}[Q(s,a)] via log-sum-exp; its gradient
      //--- w.r.t. q_s[a] is softmax(q_s)[a], minus 1 at the logged action.
      //--- This pushes down Q for actions the data never demonstrated while
      //--- leaving the logged action's Q free to fit the TD target
      double max_q = q_s[0];
      for(int a = 1; a < CQL_ACTION_COUNT; a++)
         if(q_s[a] > max_q)
            max_q = q_s[a];
      double exp_sum = 0.0, softmax[CQL_ACTION_COUNT];
      for(int a = 0; a < CQL_ACTION_COUNT; a++)
        {
         softmax[a] = MathExp(q_s[a] - max_q); // subtract max_q for numerical stability
         exp_sum   += softmax[a];
        }
      for(int a = 0; a < CQL_ACTION_COUNT; a++)
         softmax[a] /= exp_sum;

      double log_sum_exp = max_q + MathLog(exp_sum);
      total_loss += 0.5 * td_error * td_error + alpha * (log_sum_exp - q_s[a_logged]);

      //--- combine TD gradient (only at the logged action) with the CQL
      //--- penalty gradient (spread across every action via the softmax)
      double dLoss_dq[CQL_ACTION_COUNT];
      for(int a = 0; a < CQL_ACTION_COUNT; a++)
         dLoss_dq[a] = alpha * softmax[a];
      dLoss_dq[a_logged] += td_error - alpha; // TD term + CQL's -1 at the logged action

      //--- backprop through the linear output layer: dL/dW2, dL/db2
      double dHidden[CQL_HIDDEN_UNITS];
      ArrayInitialize(dHidden, 0.0);
      for(int a = 0; a < CQL_ACTION_COUNT; a++)
        {
         gb2[a] += dLoss_dq[a];
         for(int j = 0; j < CQL_HIDDEN_UNITS; j++)
           {
            gW2[j][a] += dLoss_dq[a] * hidden_cache[j];
            dHidden[j] += dLoss_dq[a] * m_W2[j][a]; // accumulate for layer 1
           }
        }

      //--- backprop through ReLU: gradient is zero wherever the pre-activation
      //--- was <= 0 (the unit did not fire, so it contributed nothing forward)
      for(int j = 0; j < CQL_HIDDEN_UNITS; j++)
        {
         //--- pre_cache (this sample's s), not m_pre - by this point m_pre
         //--- holds next_state's pre-activations from the Forward() call above
         double relu_grad = (pre_cache[j] > 0.0) ? dHidden[j] : 0.0;
         gb1[j] += relu_grad;
         for(int i = 0; i < CQL_STATE_FEATURES; i++)
            gW1[i][j] += relu_grad * batch[n].state[i];
        }
     }

//--- apply averaged SGD update: mean gradient over the mini-batch keeps
//--- the effective learning rate independent of batch_size
   double inv_n = 1.0 / batch_size;
   for(int i = 0; i < CQL_STATE_FEATURES; i++)
      for(int j = 0; j < CQL_HIDDEN_UNITS; j++)
         m_W1[i][j] -= lr * gW1[i][j] * inv_n;
   for(int j = 0; j < CQL_HIDDEN_UNITS; j++)
      m_b1[j] -= lr * gb1[j] * inv_n;
   for(int j = 0; j < CQL_HIDDEN_UNITS; j++)
      for(int a = 0; a < CQL_ACTION_COUNT; a++)
         m_W2[j][a] -= lr * gW2[j][a] * inv_n;
   for(int a = 0; a < CQL_ACTION_COUNT; a++)
      m_b2[a] -= lr * gb2[a] * inv_n;

   return(total_loss * inv_n);
  }
Рассмотрим это по каждому действию: часть TD влияет только на Q-значение зарегистрированного действия, точно так же, как и в обычном Q-обучении; часть CQL влияет на каждое действие через функцию softmax, поэтому dLoss_dq[a_logged] учитывает как ошибку TD, так и поправку CQL, в то время как все остальные действия получают только поправку CQL. Далее выполняется стандартное обратное распространение ошибки через скрытый слой ReLU с обнулением градиента везде, где pre_cache[j] <= 0. Буфер pre_cache важен, поскольку Forward() вызывается дважды для каждого примера (сначала для state, затем для next_state), и оба вызова перезаписывают одни и те же буферы m_pre/m_post. Последующее чтение m_pre привело бы к маскированию градиента по значениям до активации для next_state; копия, сохраненная в pre_cache сразу после первого вызова, обеспечивает корректность вычисления.
Одна деталь, которую легко упустить: штраф CQL здесь вычисляется по текущим Q-значениям самой сети в состоянии s, а не по выходам отдельной целевой сети — в отличие от опубликованных вариантов CQL, где целевая сеть используется для компонента Беллмана, как и в DQN. Это позволяет обойтись одним файлом весов и отказаться от синхронизации основной и целевой сетей, немного жертвуя стабильностью ради простоты. Если обучение на будущем наборе данных окажется нестабильным, в первую очередь стоит вернуть целевую сеть. Структура класса позволяет добавить второй экземпляр с периодическим копированием в него весов, не меняя Forward().
Обучение двух сетей на одном и том же наборе из 838 переходов — одной с alpha=0 (CQL отключено), другой с alpha=1 (значение по умолчанию в этой статье) — и сравнение их Q-значений в состояниях, где редкое действие ни разу не было записано в журнал, выявляет крайнее проявление недостатка CQL: действие FLAT не встречается ни в одном из 838 переходов, поскольку журнал сделок содержит только открытия позиций, так что "ничего не делать" — практически предельный пример действия, почти не представленного в данных. Здесь измеряется, насколько штраф CQL сдвигает Q-значение, а не качество решений: чтобы установить реальное улучшение, по-прежнему нужна оценка по результатам:
Наивное Q-обучение в сравнении с CQL: результаты измерений на фактическом наборе данных
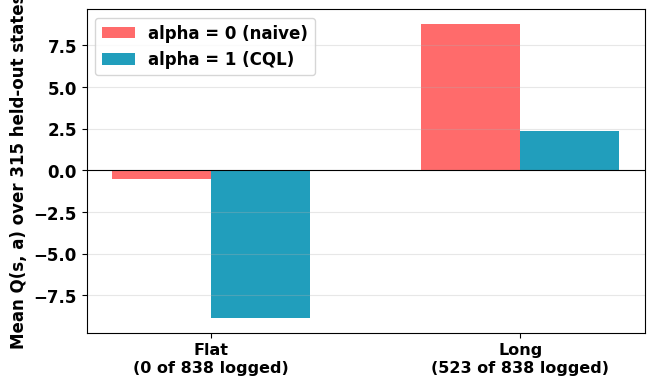
Рис. 2. Средние Q-значения для действий FLAT (зарегистрировано в 0 из 838 переходов) и LONG (в 523 из 838), усредненные по 315 состояниям из того же обучающего набора данных, в которых фактически выполнялось не редкое действие; сравниваются сеть, обученная с alpha=0, и сеть с alpha=1, используемая в этой статье. Наивная оценка для FLAT близка к нулю просто из-за полного отсутствия градиентного сигнала; штраф CQL, напротив, сдвигает ее далеко в отрицательную область, активно подавляя выбор действия, доверять которому данные не дают оснований. Q-значение для действия LONG, хорошо представленного в данных, при использовании CQL тоже снижается, но в относительном выражении слабее, поскольку на каждой эпохе его оценка по-прежнему опирается на целевые величины TD, полученные из реальных данных.
Сравнение, представленное на рис. 2, было выполнено с помощью CQL_CompareAlpha.mq5 — небольшого автономного диагностического скрипта, который не входит в состав развернутой системы. Он предназначен исключительно для оценки влияния штрафного члена CQL на данном конкретном наборе данных: скрипт загружает две независимо обученные сети и оценивает обе на одних и тех же состояниях:
//+------------------------------------------------------------------+
//| OnStart                                                          |
//+------------------------------------------------------------------+
void OnStart(void)
  {
   if(!g_net_alpha0.LoadWeights(InpWeightsAlpha0))
     {
      Print("CQL_CompareAlpha: failed to load ", InpWeightsAlpha0);
      return;
     }
   if(!g_net_alpha1.LoadWeights(InpWeightsAlpha1))
     {
      Print("CQL_CompareAlpha: failed to load ", InpWeightsAlpha1);
      return;
     }

   int loaded = LoadDatasetForComparison(InpDatasetFile, g_dataset);
   if(loaded <= 0)
     {
      Print("CQL_CompareAlpha: could not load dataset");
      return;
     }

//--- count how often each action appears in the logged data - the action
//--- with the fewest examples is the one naive Q-learning is most likely
//--- to overestimate, and the one CQL's penalty should visibly pull down
   int counts[CQL_ACTION_COUNT];
   ArrayInitialize(counts, 0);
   for(int i = 0; i < loaded; i++)
      counts[g_dataset[i].action]++;

   int rare_action = 0;
   for(int a = 1; a < CQL_ACTION_COUNT; a++)
      if(counts[a] < counts[rare_action])
         rare_action = a;

   PrintFormat("CQL_CompareAlpha: action counts - short=%d flat=%d long=%d (rarest = %d)",
               counts[CQL_ACTION_SHORT], counts[CQL_ACTION_FLAT], counts[CQL_ACTION_LONG], rare_action);

//--- average both networks' Q-value for the rare action, and separately for
//--- the most-logged action, ONLY over states where the rare action was NOT
//--- what actually happened - this is exactly the extrapolation scenario
//--- CQL is meant to guard against: judging an action the data barely tried
   int common_action = 0;
   for(int a = 1; a < CQL_ACTION_COUNT; a++)
      if(counts[a] > counts[common_action])
         common_action = a;

   double sum_rare0 = 0, sum_rare1 = 0, sum_common0 = 0, sum_common1 = 0;
   int n_eval = 0;
   double q0[], q1[];
   for(int i = 0; i < loaded; i++)
     {
      if(g_dataset[i].action == rare_action)
         continue; // only evaluate on states where this action wasn't logged
      g_net_alpha0.Forward(g_dataset[i].state, q0);
      g_net_alpha1.Forward(g_dataset[i].state, q1);
      sum_rare0   += q0[rare_action];
      sum_rare1   += q1[rare_action];
      sum_common0 += q0[common_action];
      sum_common1 += q1[common_action];
      n_eval++;
     }

   PrintFormat("CQL_CompareAlpha: over %d states (rare action=%d NOT logged):", n_eval, rare_action);
   PrintFormat("  rare action %d   -> alpha=0: %.4f   alpha=1: %.4f", rare_action, sum_rare0/n_eval, sum_rare1/n_eval);
   PrintFormat("  common action %d -> alpha=0: %.4f   alpha=1: %.4f", common_action, sum_common0/n_eval, sum_common1/n_eval);
  }
Скрипт подсчитывает, как часто каждое действие встречается в записанных данных, определяет самое редкое и самое частое из них, а затем для каждого из этих двух действий усредняет Q-значения отдельно по каждой сети. При этом учитываются только состояния, в которых редкое действие фактически не выполнялось, поскольку именно от такого сценария экстраполяции защищает CQL. Запуск этого скрипта — разовая диагностическая процедура: обучите второй набор весов с alpha=0 и сохраните его в файле с другим именем, один раз запустите скрипт, а затем удалите файл весов для alpha=0 — при развертывании он не используется.
Создание офлайн-набора данных из журналов сделок MQL5
Набор данных — это всего лишь строки вида (state, action, reward, next_state, done), но их получение из реального журнала сделок требует аккуратности. Export_TradeLog.mq5 восстанавливает сделки и записывает их в trade_log.csv, а Export_BarHistory.mq5 экспортирует соответствующие данные OHLC/ATR/RSI в bar_history.csv. Оба файла имеют кодировку UTF-16, разделитель, зависящий от региональных настроек, и лишнюю метку BOM. Скрипт build_offline_dataset.py учитывает все три особенности и параллельно обрабатывает оба экспортированных файла, восстанавливая тот же вектор признаков, который советник вычисляет в реальном времени, так что при обучении и развертывании используется одно и то же определение "состояния":
def read_mql5_csv(path: str) -> pd.DataFrame:
    df = pd.read_csv(path, encoding="utf-16", sep=None, engine="python")
    df.columns = df.columns.str.replace("", "", regex=False)
    return df
На стороне MQL5 функция LoadDataset() считывает обычный CSV-файл в кодировке UTF-8, созданный скриптом Python (намеренно не в UTF-16, используемой FILE_CSV, поскольку данные для обучения не проходят повторно через механизм экспорта MetaTrader). Есть одна загвоздка: файл открывается в режиме FILE_ANSI, который технически отличается от режима UTF-8 — в данном случае это не представляет опасности, поскольку все столбцы содержат только символы ASCII, но станет опасным, как только в один из них попадет значение, не относящееся к ASCII. Кроме того, функция увеличивает размер буфера в геометрической прогрессии, вместо того чтобы читать файл дважды (один раз для подсчета строк, второй — для загрузки), что существенно, когда журнал сделок охватывает несколько лет:
//+------------------------------------------------------------------+
//| LoadDataset                                                      |
//+------------------------------------------------------------------+
int LoadDataset(const string filename, CQLTransition &dataset[])
  {
//--- offline_dataset.csv is written by build_offline_dataset.py using
//--- pandas' default UTF-8 (not FILE_CSV's native UTF-16), so this reads
//--- as a plain UTF-8 text file with a one-line header to skip
   int handle = FileOpen(filename, FILE_READ | FILE_CSV | FILE_ANSI | FILE_COMMON, ',');
   if(handle == INVALID_HANDLE)
     {
      Print("LoadDataset: cannot open ", filename, ", err=", GetLastError());
      return(-1);
     }

//--- header row: state_0..state_8,action,reward,next_state_0..next_state_8,done
   for(int c = 0; c < 2 * CQL_STATE_FEATURES + 3; c++)
      FileReadString(handle);

   int count = 0;
   ArrayResize(dataset, 4096); // grown geometrically below as needed
   while(!FileIsEnding(handle))
     {
      CQLTransition row;
      for(int i = 0; i < CQL_STATE_FEATURES; i++)
         row.state[i] = StringToDouble(FileReadString(handle));
      row.action = (int)StringToInteger(FileReadString(handle));
      row.reward = StringToDouble(FileReadString(handle));
      for(int i = 0; i < CQL_STATE_FEATURES; i++)
         row.next_state[i] = StringToDouble(FileReadString(handle));
      row.done = (StringToInteger(FileReadString(handle)) != 0);

      //--- all fields for this row are read regardless, so the file cursor
      //--- stays aligned; only a malformed or out-of-range action is then
      //--- dropped, rather than silently indexing Q-value arrays with it
      if(row.action < 0 || row.action >= CQL_ACTION_COUNT)
         continue;

      if(count >= ArraySize(dataset))
         ArrayResize(dataset, ArraySize(dataset) * 2);
      dataset[count++] = row;
     }
   FileClose(handle);
   ArrayResize(dataset, count);
   return(count);
  }
Два проектных решения в build_offline_dataset.py заслуживают отдельного упоминания. Во-первых, вознаграждение берется непосредственно из столбца реализованной прибыли журнала сделок без дополнительной модификации функции вознаграждения. Вознаграждение по аналогии с коэффициентом Шарпа или со штрафом за просадку стимулировало бы получение более плавной кривой средств, но изменило бы смысл целевой величины Беллмана, а смысл штрафного члена CQL следует рассматривать относительно определения вознаграждения, использованного при формировании данных. Если изменить его позже, потребуется перестроить набор данных, а не просто переобучить модель.
Стоит отметить: журнал сделок и советник, используемый при развертывании, говорят не совсем на одном языке. В журнале фиксируются завершенные сделки — от открытия до закрытия, — тогда как при развертывании советник определяет целевую экспозицию на каждом закрытом баре. Поэтому набор данных охватывает только моменты, когда действовала стратегия, сформировавшая журнал, а советник оценивает каждый бар. Вознаграждение соответствует реализованной прибыли/убытку по закрытой сделке, тогда как действие в той же строке — это решение об открытии позиции; поэтому такая цепочка служит разумным, но не точным приближением к марковскому процессу принятия решений (MDP) с шагом в один бар.
Второе решение касается флага is_last_of_session, на основе которого заполняется столбец done. Пометка перехода как терминального указывает функции TrainStep() полностью исключить член продолжения, вычисляемый с помощью бутстрэппинга (batch[n].done? 0.0: gamma * max_next), что важно на реальных границах — при ночных гэпах, смене стратегии или закрытии всех позиций в конце недели. Если считать каждый переход нетерминальным, это внесет допущение о непрерывности, которой рынок никогда не обещал.
Цикл обучения в скрипте CQL_OfflineTrain.mq5 реализован в функции OnStart(). Скрипт обучает сеть на статическом наборе данных и не взаимодействует с рынком в реальном времени. Скрипт один раз загружает набор данных, вычисляет статистику признаков, которая позднее понадобится фильтру состояний вне обучающего распределения (OOD), перемешивает данные перед каждой эпохой (иначе хронологический порядок данных смещает каждый мини-батч в сторону рыночного режима, действовавшего в соответствующий период) и вызывает TrainStep() для каждого мини-батча:
//+------------------------------------------------------------------+
//| OnStart                                                          |
//+------------------------------------------------------------------+
void OnStart(void)
  {
//--- Step 1: load the fixed offline dataset - this script never places
//--- a trade or reads a live tick; every transition below comes from a
//--- CSV a strategy or trade log already produced
   int loaded = LoadDataset(InpDatasetFile, g_dataset);
   if(loaded <= 0)
     {
      Print("CQL_OfflineTrain: could not load dataset, aborting");
      return;
     }
   Print("CQL_OfflineTrain: loaded ", loaded, " transitions from ", InpDatasetFile);

//--- Step 2: compute per-feature mean/stdev up front so the OOD guard
//--- ships baked into the same weights file as the policy it protects
   ComputeFeatureStats(g_dataset, loaded, g_stats);
   g_network.SetFeatureStats(g_stats);

//--- Step 3: train
   g_network.Init(InpRandomSeed);
   MathSrand(InpRandomSeed);
   for(int epoch = 0; epoch < InpEpochs; epoch++)
     {
      ShuffleDataset(g_dataset, loaded); // i.i.d. mini-batches, not chronological blocks
      double epoch_loss = 0.0;
      int    batches     = 0;
      //--- rows left over once loaded is not an exact multiple of InpBatchSize
      //--- are simply not visited this epoch, rather than padded into a short
      //--- final batch - a small, known gap in how much of the 838 rows each
      //--- epoch actually uses
      for(int start = 0; start + InpBatchSize <= loaded; start += InpBatchSize)
        {
         CQLTransition mini_batch[];
         ArrayResize(mini_batch, InpBatchSize);
         for(int k = 0; k < InpBatchSize; k++)
            mini_batch[k] = g_dataset[start + k];
         epoch_loss += g_network.TrainStep(mini_batch, InpBatchSize, InpAlpha, InpGamma, InpLearningRate);
         batches++;
        }
      if(batches > 0 && (epoch % 20 == 0 || epoch == InpEpochs - 1))
         PrintFormat("CQL_OfflineTrain: epoch %d/%d  mean loss = %.6f", epoch + 1, InpEpochs,
                     epoch_loss / batches);
     }

//--- Step 4: persist - the deployment EA never trains, it only loads this file
   if(g_network.SaveWeights(InpWeightsFile))
      Print("CQL_OfflineTrain: weights saved to Common\\Files\\", InpWeightsFile);
   else
      Print("CQL_OfflineTrain: failed to save weights");
  }
Обратите внимание: статистика признаков вычисляется до начала обучения и сохраняется в том же файле весов, что и параметры сети, — поэтому OOD-фильтр и политика, которую он защищает, не могут рассогласоваться.
Q-сеть на MQL5: прямой проход, функция потерь и обратное распространение ошибки
Общие определения типов находятся в CQLDefs.mqh: небольшая размерность состояния, три дискретных действия и две структуры для передачи перехода и сводной статистики признаков между файлами:
//+------------------------------------------------------------------+
//| Discrete actions                                                 |
//+------------------------------------------------------------------+
enum ENUM_CQL_ACTION
  {
   CQL_ACTION_SHORT = 0, // reduce / open short exposure
   CQL_ACTION_FLAT  = 1, // flatten to zero exposure
   CQL_ACTION_LONG  = 2  // increase / open long exposure
  };

//+------------------------------------------------------------------+
//| One offline transition row                                       |
//+------------------------------------------------------------------+
struct CQLTransition
  {
   double state[CQL_STATE_FEATURES];      // s  : engineered feature vector
   int    action;                         // a  : ENUM_CQL_ACTION taken by the logging strategy
   double reward;                         // r  : realized reward for the transition
   double next_state[CQL_STATE_FEATURES]; // s' : feature vector after the transition
   bool   done;                           // terminal flag (position closed / session end)
  };
Двадцать четыре нейрона в скрытом слое — намеренно небольшое число: его подобрали, начав с меньшего и увеличивая лишь до момента, когда функция потерь при обучении перестала снижаться. Более широкая сеть не обязательно лучше работает при офлайн-обучении, хотя в условиях онлайн-обучения всё может быть иначе: достаточное количество взаимодействий позволяет заполнить пробелы в опыте, необходимом для использования возможностей модели. Каждый дополнительный параметр — ещё одна величина, которую должна ограничивать фиксированная обучающая выборка. Если данных недостаточно для однозначного определения параметров большой сети, ошибка экстраполяции лишь усугубляется. Двух слоев достаточно для нелинейного моделирования зависимости от девяти специально сформированных признаков. При этом не нужны сторонние библиотеки — достаточно встроенных массивов MQL5.
CQLQNetwork — простая двухслойная сеть прямого распространения: девять входов, двадцать четыре нейрона скрытого слоя с активацией ReLU и три линейных выхода. Forward() выполняет одинаковые вычисления как при обучении, так и в советнике при развертывании, что устраняет один риск: формула вычисления Q-значений не может незаметно различаться в этих двух случаях. Однако эта гарантия не распространяется на формирование подаваемого в сеть вектора признаков: build_offline_dataset.py и BuildStateVector() — отдельные реализации вычисления одного и того же состояния на двух языках, согласованность которых обеспечивается только ручной проверкой. См. раздел "Дрейф признаков" ниже.
//+------------------------------------------------------------------+
//| CQLQNetwork::Forward                                             |
//+------------------------------------------------------------------+
void CQLQNetwork::Forward(const double &state[], double &q_out[])
  {
   ArrayResize(q_out, CQL_ACTION_COUNT);
//--- hidden layer: pre-activation = W1^T * state + b1, then ReLU
   for(int j = 0; j < CQL_HIDDEN_UNITS; j++)
     {
      double sum = m_b1[j];
      for(int i = 0; i < CQL_STATE_FEATURES; i++)
         sum += state[i] * m_W1[i][j];
      m_pre[j]  = sum;
      m_post[j] = (sum > 0.0) ? sum : 0.0; // ReLU, cached for TrainStep()
     }
//--- output layer is linear: Q(s,a) = W2^T * hidden + b2
   for(int a = 0; a < CQL_ACTION_COUNT; a++)
     {
      double sum = m_b2[a];
      for(int j = 0; j < CQL_HIDDEN_UNITS; j++)
         sum += m_post[j] * m_W2[j][a];
      q_out[a] = sum;
     }
  }
Обученная сеть сохраняется в двоичный файл, в начало которого записывается небольшой заголовок с размерностями, поэтому устаревший или несовместимый файл весов вызывает явную ошибку сразу при загрузке, а не незаметное смещение данных при всех последующих операциях чтения:
//+------------------------------------------------------------------+
//| CQLQNetwork::SaveWeights                                         |
//+------------------------------------------------------------------+
bool CQLQNetwork::SaveWeights(const string filename)
  {
   int handle = FileOpen(filename, FILE_WRITE | FILE_BIN | FILE_COMMON);
   if(handle == INVALID_HANDLE)
     {
      Print("CQLQNetwork::SaveWeights failed to open ", filename, ", err=", GetLastError());
      return(false);
     }
//--- write the dimension header first so LoadWeights() can verify the
//--- three-way contract (this file / #define constants / any consumer)
//--- before trusting a single weight value
   FileWriteLong(handle, CQL_STATE_FEATURES);
   FileWriteLong(handle, CQL_HIDDEN_UNITS);
   FileWriteLong(handle, CQL_ACTION_COUNT);
   for(int i = 0; i < CQL_STATE_FEATURES; i++)
      for(int j = 0; j < CQL_HIDDEN_UNITS; j++)
         FileWriteDouble(handle, m_W1[i][j]);
   for(int j = 0; j < CQL_HIDDEN_UNITS; j++)
      FileWriteDouble(handle, m_b1[j]);
   for(int j = 0; j < CQL_HIDDEN_UNITS; j++)
      for(int a = 0; a < CQL_ACTION_COUNT; a++)
         FileWriteDouble(handle, m_W2[j][a]);
   for(int a = 0; a < CQL_ACTION_COUNT; a++)
      FileWriteDouble(handle, m_b2[a]);
//--- OOD reference stats travel in the same file as the weights so the
//--- two can never drift apart or be loaded from mismatched runs
   for(int i = 0; i < CQL_STATE_FEATURES; i++)
      FileWriteDouble(handle, m_stats.mean[i]);
   for(int i = 0; i < CQL_STATE_FEATURES; i++)
      FileWriteDouble(handle, m_stats.stdev[i]);
   FileClose(handle);
   return(true);
  }
Обучение на фактическом офлайн-наборе данных из 838 переходов дало скорее честную, чем аккуратную кривую функции потерь: на протяжении большей части обучения она почти не меняется, оставаясь в диапазоне 59–61, с одним провалом примерно на 161-й эпохе и последующим частичным возвратом к прежнему уровню к 200-й эпохе. Такая почти неизменная кривая согласуется с ограничениями набора данных: при наличии всего 838 сделок и использовании исходной прибыли или убытка в долларах в качестве вознаграждения, без дополнительной модификации функции вознаграждения, значительная часть значения функции потерь обусловлена неустранимой дисперсией вознаграждения, и увеличение числа эпох или изменение альфа может не дать заметного улучшения.
Функция потерь при обучении на фактическом наборе данных из 838 переходов
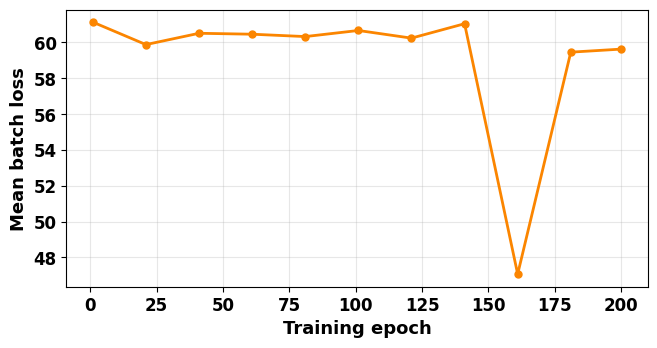
Рис. 3. Среднее значение функции потерь по мини-батчу (компонент TD плюс штрафной член CQL), записываемое каждые 20 эпох в ходе фактического обучения модели, для которой в статье приведен результат тестера стратегий. Значение функции потерь остается почти неизменным на протяжении всего обучения, за исключением разового кратковременного провала примерно на 161-й эпохе. Это согласуется с тем, что сигнал вознаграждения по отношению к девяти специально сформированным признакам представляет собой преимущественно шум.
Развертывание зафиксированной политики: реализация в советнике
Файл CQL_OfflineRL_EA.mq5 специально сделан самым простым в проекте. Он однократно загружает веса в OnInit() и не запускается, если загрузка завершается неудачей: резервного варианта поведения нет, поскольку он означал бы торговлю на основе политики, которую никто не обучал:
//+------------------------------------------------------------------+
//| OnInit                                                           |
//+------------------------------------------------------------------+
int OnInit(void)
  {
   g_ready = false;

//--- this EA is a pure consumer of an offline-trained policy: it never
//--- calls TrainStep(), so a missing weights file is a hard failure
//--- rather than something to fall back and improvise around
   if(!g_network.LoadWeights(InpWeightsFile))
     {
      Print("OnInit: failed to load ", InpWeightsFile, " - refusing to trade");
      return(INIT_FAILED);
     }

   g_h_atr = iATR(_Symbol, PERIOD_CURRENT, InpATRPeriod);
   g_h_rsi = iRSI(_Symbol, PERIOD_CURRENT, InpRSIPeriod, PRICE_CLOSE);
   if(g_h_atr == INVALID_HANDLE || g_h_rsi == INVALID_HANDLE)
     {
      Print("OnInit: indicator handle creation failed, err=", GetLastError());
      return(INIT_FAILED);
     }

   g_ready = true;
   return(INIT_SUCCEEDED);
  }
OnTick() выполняет действия не чаще одного раза на новом баре, а не на каждом тике: политика обучалась на переходах, сформированных по барам, поэтому внутрибаровый шум привел бы ее в состояния, которых она никогда не видела. Есть одна оговорка: приведенный ниже фрагмент кода срабатывает при изменении времени бара и считывает ATR, RSI и цену закрытия по индексу буфера 0, который в большинстве потоков котировок соответствует только что открывшемуся бару, а не только что завершившемуся. Рассматривайте это как оценку самого нового доступного бара, а не как гарантированное чтение данных закрытого бара. Используйте индекс 1, если ваш брокер обновляет данные по индексу 0 до завершения бара.
//+------------------------------------------------------------------+
//| OnTick                                                           |
//+------------------------------------------------------------------+
void OnTick(void)
  {
//--- act once per bar transition, not per tick - the policy was trained on
//--- bar-sampled transitions, so evaluating it intra-bar would feed it
//--- states it never saw during offline training
   static datetime last_bar_time = 0;
   datetime         bar_time      = iTime(_Symbol, PERIOD_CURRENT, 0);
   if(bar_time == last_bar_time || !g_ready)
      return;
   last_bar_time = bar_time;

   double state[CQL_STATE_FEATURES];
   if(!BuildStateVector(state))
      return; // indicators not warmed up yet

   double q_values[];
   int    action = g_network.SelectAction(state, q_values);
   ApplyAction((ENUM_CQL_ACTION)action);
  }
Именно BuildStateVector() определяет согласованность представления состояния при обучении и развертывании. Все признаки здесь должны располагаться в том же порядке и иметь ту же нормализацию, что и соответствующие столбцы в выходных данных скрипта build_offline_dataset.py. Единственные средства контроля этого соответствия — общая константа CQL_STATE_FEATURES и проверка размерности внутри функции LoadWeights():
//+------------------------------------------------------------------+
//| BuildStateVector                                                 |
//+------------------------------------------------------------------+
bool BuildStateVector(double &state[])
  {
//--- feature layout must exactly match the columns build_offline_dataset.py
//--- wrote when the offline dataset was constructed - the three-way
//--- contract (this function / CSV columns / CQL_STATE_FEATURES) is what
//--- OnInit()'s dimension check in LoadWeights() ultimately protects
   double atr_buf[], rsi_buf[], close_buf[];
   if(CopyBuffer(g_h_atr, 0, 0, 3, atr_buf) < 3)
      return(false);
   if(CopyBuffer(g_h_rsi, 0, 0, 3, rsi_buf) < 3)
      return(false);
   if(CopyClose(_Symbol, PERIOD_CURRENT, 0, 6, close_buf) < 6)
      return(false);

   double ret1 = (close_buf[5] - close_buf[4]) / close_buf[4];  // 1-bar return
   double ret3 = (close_buf[5] - close_buf[2]) / close_buf[2];  // 3-bar return
   double norm_atr = atr_buf[0] / close_buf[5];                 // volatility, price-normalized
   double norm_rsi = (rsi_buf[0] - 50.0) / 50.0;                // centered to [-1, 1]

   long   volumes[];
   if(CopyTickVolume(_Symbol, PERIOD_CURRENT, 0, 3, volumes) < 3) // long[], never double[]
      return(false);
   double vol_ratio = (volumes[2] > 0) ? (double)volumes[0] / (double)volumes[2] : 1.0;

   double pos_exposure = 0.0;
   if(PositionSelect(_Symbol))
      pos_exposure = (PositionGetInteger(POSITION_TYPE) == POSITION_TYPE_BUY) ? 1.0 : -1.0;

//--- MQL5 has no TimeHour()/TimeDayOfWeek() (those are MQL4-only); the
//--- portable way to pull calendar fields is to unpack TimeCurrent() into
//--- an MqlDateTime struct and read its named members
   MqlDateTime dt;
   TimeToStruct(TimeCurrent(), dt);

   int i = 0;
   state[i++] = ret1;
   state[i++] = ret3;
   state[i++] = norm_atr;
   state[i++] = norm_rsi;
   state[i++] = vol_ratio;
   state[i++] = pos_exposure;
   state[i++] = (double)dt.hour / 24.0;       // session position
   state[i++] = (double)dt.day_of_week / 6.0; // weekday seasonality
   state[i++] = norm_atr * norm_atr;          // volatility-of-volatility proxy
   return(true);
  }
При выборе действия OOD-фильтр применяется непосредственно перед argmax, чтобы не полагаться на исходные Q-значения во всех состояниях. Стоит прямо признать: действие FLAT не встречается ни в одном из 838 зарегистрированных переходов. Как показано выше, штрафной член CQL сильнее всего снижает Q-значение этого недостаточно представленного в данных действия. Использование этого действия как резервного варианта при OOD — проектное решение. Закрытие позиции — наименее рискованное с точки зрения рыночной экспозиции действие советника, но это не означает, что такое решение подтверждено данными. Оно также не является пассивным, поскольку выбор FLAT при открытой позиции заставляет функцию ApplyAction() закрыть ее.
//+------------------------------------------------------------------+
//| CQLQNetwork::SelectAction                                        |
//+------------------------------------------------------------------+
int CQLQNetwork::SelectAction(const double &state[], double &q_out[])
  {
//--- the policy never explores here - this is a frozen, offline-trained
//--- network, so "safety" means refusing to act outside its training
//--- distribution rather than trying something new on live capital
   if(IsOutOfDistribution(state))
     {
      ArrayResize(q_out, CQL_ACTION_COUNT);
      ArrayInitialize(q_out, 0.0);
      return(CQL_ACTION_FLAT); // fallback when uncertain, not a data-validated "safe" action
     }

   Forward(state, q_out);
   int best = 0;
   for(int a = 1; a < CQL_ACTION_COUNT; a++)
      if(q_out[a] > q_out[best])
         best = a;
   return(best);
  }
Сам OOD-фильтр использует простое среднее абсолютных z-оценок, рассчитанных по среднему значению и стандартному отклонению каждого признака, зафиксированным при обучении:
//+------------------------------------------------------------------+
//| CQLQNetwork::IsOutOfDistribution                                 |
//+------------------------------------------------------------------+
bool CQLQNetwork::IsOutOfDistribution(const double &state[])
  {
//--- without reference stats we cannot judge distance. This fails OPEN -
//--- treating the state as in-distribution rather than blocking every
//--- trade - which trades availability for protection; see the Edge
//--- cases section below before relying on this path
   if(!m_stats_ready)
      return(false);

   double sum_abs_z = 0.0;
   for(int i = 0; i < CQL_STATE_FEATURES; i++)
     {
      double sd = (m_stats.stdev[i] > 1e-8) ? m_stats.stdev[i] : 1e-8; // guard div-by-zero
      sum_abs_z += MathAbs((state[i] - m_stats.mean[i]) / sd);
     }
   double avg_abs_z = sum_abs_z / CQL_STATE_FEATURES;
   return(avg_abs_z > CQL_OOD_MAX_ZSCORE);
  }
При значении CQL_OOD_MAX_ZSCORE, равном 3.5, текущее состояние должно быть необычно далеко от всего, что встречалось в обучающих данных, прежде чем советник выберет резервное действие — отсутствие позиции. Проверка фильтра на трех тысячах смоделированных состояний из обучающего распределения показывает, насколько редко он должен срабатывать и насколько четко порог отделяет обычную изменчивость от действительно не представленного при обучении режима:
Распределение расстояний от текущих состояний до обучающего набора данных
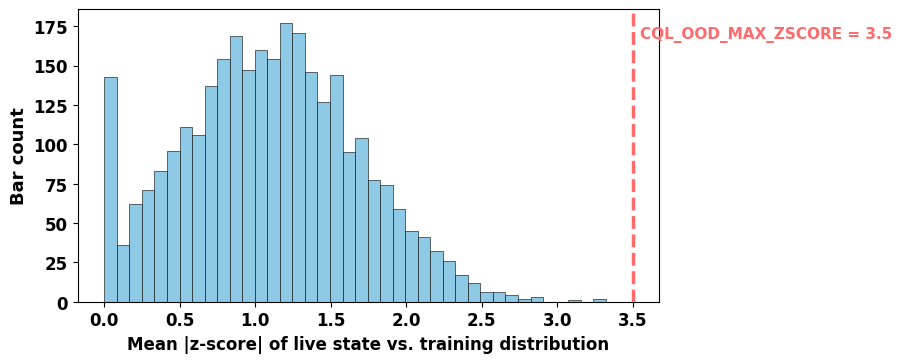
Рис. 4. Средняя абсолютная z-оценка смоделированных текущих состояний относительно обучающего распределения с отмеченным порогом отклонения состояний OOD-фильтром. Только для состояний в крайнем правом хвосте распределения вместо действия, выбранного сетью через argmax, принудительно выбирается отсутствие позиции.
После того как действие проходит проверку защитным фильтром, функция ApplyAction() преобразует его в торговые запросы. Логика исполнения намеренно проста: сначала закрывается противоположная позиция, если она есть, затем открывается позиция в требуемом направлении фиксированным лотом, — чтобы причину любой последующей торговой ошибки можно было искать в политике, а не на уровне исполнения:
//+------------------------------------------------------------------+
//| ApplyAction                                                      |
//+------------------------------------------------------------------+
void ApplyAction(const ENUM_CQL_ACTION action)
  {
//--- has_position must also check POSITION_MAGIC: PositionSelect() alone
//--- matches any position on this symbol, including one opened by a
//--- different EA or script sharing the account
   bool has_position = PositionSelect(_Symbol) && PositionGetInteger(POSITION_MAGIC) == InpMagic;
   bool is_long       = has_position && PositionGetInteger(POSITION_TYPE) == POSITION_TYPE_BUY;
   bool is_short      = has_position && PositionGetInteger(POSITION_TYPE) == POSITION_TYPE_SELL;

   MqlTradeRequest request;
   MqlTradeResult  result;
   ZeroMemory(request);
   ZeroMemory(result);

//--- the policy only ever expresses a target exposure (short/flat/long);
//--- translating that into orders is deliberately simple so any trading
//--- mistake is a policy problem, not an execution-layer one
   if(action == CQL_ACTION_FLAT && has_position)
     {
      request.action   = TRADE_ACTION_DEAL;
      request.symbol   = _Symbol;
      request.magic    = InpMagic;
      request.volume   = PositionGetDouble(POSITION_VOLUME);
      request.type     = is_long ? ORDER_TYPE_SELL : ORDER_TYPE_BUY;
      request.price    = is_long ? SymbolInfoDouble(_Symbol, SYMBOL_BID)
                                  : SymbolInfoDouble(_Symbol, SYMBOL_ASK);
      request.position = PositionGetInteger(POSITION_TICKET);
      if(!OrderSend(request, result) || result.retcode != TRADE_RETCODE_DONE)
         Print("ApplyAction: flatten OrderSend failed, retcode=", result.retcode);
      return;
     }

   if(action == CQL_ACTION_LONG && !is_long)
     {
      if(is_short)
         CloseCurrentPosition();
      request.action = TRADE_ACTION_DEAL;
      request.symbol = _Symbol;
      request.magic  = InpMagic;
      request.volume = InpLotSize;
      request.type   = ORDER_TYPE_BUY;
      request.price  = SymbolInfoDouble(_Symbol, SYMBOL_ASK);
      if(!OrderSend(request, result))
         Print("ApplyAction: open-long OrderSend failed, retcode=", result.retcode);
     }
   else if(action == CQL_ACTION_SHORT && !is_short)
     {
      if(is_long)
         CloseCurrentPosition();
      request.action = TRADE_ACTION_DEAL;
      request.symbol = _Symbol;
      request.magic  = InpMagic;
      request.volume = InpLotSize;
      request.type   = ORDER_TYPE_SELL;
      request.price  = SymbolInfoDouble(_Symbol, SYMBOL_BID);
      if(!OrderSend(request, result))
         Print("ApplyAction: open-short OrderSend failed, retcode=", result.retcode);
     }
  }
Пограничные случаи и возможные проблемы
Дрейф признаков между обучением и развертыванием. Это самая распространенная причина незаметного провала проекта офлайн-обучения с подкреплением после внешне успешного обучения: если функция BuildStateVector() и скрипт build_offline_dataset.py хотя бы один признак вычисляют по-разному, сеть оценивает текущие состояния с помощью весов, настроенных на распределение, которого никогда не существовало. Проверка CQL_STATE_FEATURES выявляет только несоответствие числа признаков, но не их определений, поэтому изменение на одной стороне требует вручную внести соответствующее изменение на другой.
Фильтр обнаружения состояний вне обучающего распределения (OOD) — это эвристика, а не доказательство. Усреднение z-оценок по признакам предполагает, что каждый признак информативен независимо от остальных, и не выявляет коррелированные сдвиги: состояние, в котором каждый признак по отдельности выглядит обычным, но их сочетание никогда не встречалось, все же может пройти фильтр. Усреднение по всем девяти признакам также означает, что один признак, далеко выходящий за допустимый диапазон, может остаться незамеченным, если остальные восемь близки к своим средним значениям. Рассматривайте CQL_OOD_MAX_ZSCORE как грубый порог срабатывания, который стоит откалибровать с учетом разброса в вашем наборе данных, а не как гарантию.
OOD-фильтр отказывает с разрешением торговли, а не с ее блокировкой. IsOutOfDistribution() возвращает false — состояние считается находящимся в пределах распределения, а торговля — безопасной — всякий раз, когда m_stats_ready равно false, что происходит при загрузке файла весов без блока статистики признаков. Такое решение отдает приоритет продолжению торговли советника, а не ее блокировке, что противоположно обычному смыслу отказобезопасности применительно к контролю рисков: отсутствие или повреждение блока статистики незаметно отключает фильтр, а не торговлю.
Параметр "Alpha" нельзя просто установить один раз и больше не обращать на него внимания. При слишком низком значении консервативный штрафной член перестает оказывать существенное влияние, и ошибка экстраполяции возникает вновь. При слишком высоком значении Q-значения всех действий стягиваются к одному и тому же консервативному нижнему уровню, и выбор действия через argmax в SelectAction() при равенстве значений становится практически произвольным.
Выбор способа расчета вознаграждения влияет на все последующие этапы. В этой реализации вознаграждением служит исходная реализованная прибыль/убыток по сделке. Модификация функции вознаграждения намеренно не применяется. Модификация функции вознаграждения меняет смысл целевой величины Беллмана и то, в отношении чего штрафной член CQL обеспечивает консервативность оценок. Изменение вознаграждения после создания набора данных требует пересоздания этого набора, а не только повторного обучения.
Входные данные не нормализуются до поступления в сеть. Среднее значение и стандартное отклонение каждого признака, вычисленные в ComputeFeatureStats(), используются OOD-фильтром, однако Forward() принимает девять признаков в исходном масштабе без стандартизации, поэтому признаки с сильно различающимися исходными диапазонами могут вносить неодинаковый вклад в активации скрытого слоя исключительно из-за масштаба, а не предсказательной ценности. Стандартизация с использованием той же статистики признаков — естественный следующий шаг, который в этой версии не реализован.
Закрытие и открытие — это два отдельных обмена запросами и ответами с сервером, а не один. При развороте позиции ApplyAction() вызывает CloseCurrentPosition(), а затем немедленно отправляет новый ордер в противоположном направлении — это два независимых обращения к серверу, а не одна атомарная операция. Если закрытие не удается или заявка на закрытие исполняется лишь частично, код все равно открывает новую позицию, в результате чего на счете возникает экспозиция, не предусмотренная логикой ни закрытия, ни открытия.
Изоляция "песочницы" тестера стратегий. Пути с флагом FILE_COMMON указывают на общую папку %APPDATA%\MetaQuotes\Terminal\Common\Files\, а не на дерево каталогов MQL5\Files\ отдельного терминала, даже внутри "песочницы" агента тестера. Если перед запуском файл cql_weights.bin отсутствует в папке Common, функция OnInit() завершится с ошибкой "файл не найден", не связанной с моделью — сначала проверьте путь.
Неявное несоответствие между набором данных и емкостью сети. Ничто не гарантирует, что офлайн-набор данных охватывает достаточно широкий диапазон условий, чтобы сеть со скрытым слоем из 24 нейронов могла адекватно обобщать закономерности. При обучении на данных за один квартал с выраженным трендом сеть может выглядеть сошедшейся, но не усвоить ничего, что можно было бы перенести на режим бокового рынка, которого она никогда не видела. OOD-фильтр выявляет состояния, далекие от обучающего распределения, но не выявляет чрезмерную узость самого этого распределения — это проблема сбора данных, которую не решить настройкой архитектуры.
Совпадение магических номеров у советников на одном счете. Проверка позиции в ApplyAction() учитывает как _Symbol, так и условие POSITION_MAGIC == InpMagic, поэтому советник считает позицию своей, только если сам ее открыл. Проверка только по символу могла бы привести к закрытию или развороту позиции другого советника. Защита с помощью магического номера работает лишь при условии, что все остальные системы используют отличные от него магические номера. На неттинговом счете MetaTrader в любом случае объединяет все позиции по одному символу, поэтому проверка позволяет определить, какие сделки совершил этот советник, но не позволяет обособить его позицию так, как это возможно на хеджинговом счете.
Проверка в тестере стратегий
Ниже приведены фактические результаты запуска зафиксированной политики в тестере стратегий на XAUUSD M5 с использованием файла cql_weights.bin с весами модели, обученной офлайн на основе 838 сделок из журнала, без дальнейшего обучения во время запуска.
| Показатель/настройка | Значение |
|---|---|
| Символ/Период | XAUUSD/M5 |
| Размер обучающего набора данных | 838 зарегистрированных переходов |
| Число эпох обучения | 200 |
| Альфа (вес штрафного члена CQL) | 1,0 |
| Качество истории | 100% |
| Общее количество сделок | 2 (обе отмечены как short; long — 0) |
| Процент выигрышных сделок | 50% (1 прибыльная сделка, 1 убыточная) |
| Чистая прибыль | 0,00 $ |
| Профит-фактор | 1,00 |
| Максимальная просадка баланса | 20,10 долл. (0,20%) |
| Максимальная просадка средств | 55,00 $ (0,55%) |
Кривые баланса и средств в тестере стратегий
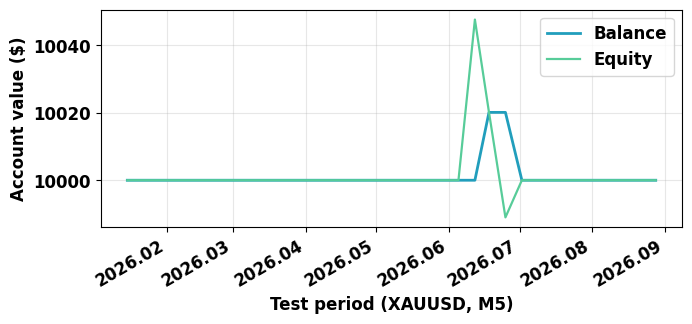
Рис. 5. Фактическая динамика баланса и средств при использовании зафиксированной политики на XAUUSD M5. Почти весь период тестирования на счете не было открытых позиций; видимый всплеск вызвал единственный кратковременный полный цикл сделки с короткой позицией (открытие и закрытие, оба отмечены в таблице выше как short).
Две сделки за многомесячный тест — недостаточная выборка для содержательной оценки результатов: честный вывод здесь — "почти не совершала действий", а не "вышла в ноль". Одна из вероятных причин связана с OOD-фильтром: ComputeFeatureStats() вычисляет эталонные средние значения и стандартные отклонения по 838 состояниям набора данных, отобранным только в моменты, когда стратегия, сформировавшая журнал сделок, открывала или закрывала позицию, а не по барам в целом. Если эта стратегия торговала лишь при достаточно специфических условиях, большинство обычных баров закономерно будут оцениваться как незнакомые, и почти во всех случаях будет выбираться CQL_ACTION_FLAT.
Вероятное, но не единственное объяснение состоит в том, что защитный фильтр делает именно то, для чего предназначен: отклоняет состояния, не поддерживаемые обучающими данными. Однако эталонная выборка OOD и оцениваемые фильтром состояния каждого бара изначально получены разными способами отбора, поэтому несоответствие между узкой эталонной выборкой и непрерывной работой после развертывания давало бы такое же почти постоянное отклонение даже при корректной работе порога. По двум сделкам нельзя различить эти два объяснения без повторной проверки фильтра на эталонной выборке, построенной по полной истории баров. В этом прогоне такая проверка не выполнялась. Данная реализация лишь показывает наблюдаемое консервативное поведение.
В прогоне тестера стратегий использовался тот самый файл cql_weights.bin, который создал офлайн-скрипт, без включения онлайн-обучения. Это честная, пусть и не зрелищная, проверка политики, обученной без взаимодействия с рынком, а не оценка точности торговли. Две сделки не дают статистически значимой информации о доле прибыльных сделок, профит-факторе или доходности с учетом риска. В этом прогоне также нет базовых методов сравнения — стратегии на основе правил, стратегии "купи и держи" или исходной стратегии. Честный итог: система совершила две сделки и вышла в ноль, а ее осторожность объясняется главным образом узостью эталонного распределения на этапе обучения, а не качеством решений в те моменты, когда она действовала.
Заключение
Офлайн-обучение с подкреплением отказывается от главной опоры онлайн-обучения с подкреплением — возможности пробовать действия и наблюдать результат, — а CQL позволяет справляться с последствиями этого компромисса. Механизм без труда удалось реализовать штатными средствами MQL5: двухслойная сеть, softmax по значениям, уже полученным при прямом проходе, и цикл обратного распространения ошибки, код которого лишь немного длиннее, чем в обычном Q-обучении. Более сложная задача заключалась не в математике, а в том, чтобы определения признаков в наборе данных и при развертывании не расходились. Именно поэтому статистика признаков для OOD-фильтра хранится в том же файле весов, что и защищаемая им политика.
Стоит четко указать, какие проблемы это не решает. CQL направлен на снижение ошибки экстраполяции в функции ценности, но не решает проблему сдвига распределения между историческим периодом набора данных и рыночным режимом, в котором политика совершает сделки. Это связанные, но разные проблемы, и OOD-фильтр нацелен на вторую, а не на первую. Политика может быть полностью консервативной по отношению к своим обучающим данным и все же столкнуться с рынком, который больше не соответствует этим данным, — это довод в пользу регулярного переобучения по мере поступления новых данных, а не разового запуска.
Стоит упомянуть еще несколько пробелов. 838 переходов — небольшая выборка для метода, который не может вернуться к взаимодействию со средой и собрать больше данных. Возможности обобщения здесь ограничивает прежде всего охват набора данных, а не механизм CQL. Здесь не проводится ни проверка с разбиением на обучающую и тестовую выборки, ни сравнение с базовым методом на основе правил, стратегией "купи и держи" или историческими результатами самой стратегии, сформировавшей журнал сделок. Приведенное выше сравнение alpha=0 и alpha=1 показывает влияние штрафного члена CQL на Q-значение. Это полезно, но не заменяет ни одной из перечисленных проверок.
Естественный следующий шаг перед выделением капитала для торговли по зафиксированной политике — полноценная дважды робастная внеполитическая оценка со сравнением с перечисленными выше базовыми методами, а не опора лишь на воспроизведение торговли в тестере стратегий. Это тема для отдельной статьи.
| Файл | Тип | Описание |
|---|---|---|
| CQLDefs.mqh | Подключаемый файл | Общие размерности состояния и действия, структура перехода, структура статистики признаков. |
| CQLQNetwork.mqh | Подключаемый файл | Двухслойная Q-сеть, реализованная на MQL5: прямой проход, шаг обучения CQL TrainStep, фильтр обнаружения состояний вне обучающего распределения (OOD), сохранение и загрузка весов. |
| CQL_OfflineTrain.mq5 | Скрипт | Цикл офлайн-обучения: загрузка набора данных, обучение, сохранение весов. Никогда не взаимодействует с реальным рынком. |
| CQL_OfflineRL_EA.mq5 | Торговый советник | Зафиксированная политика для развертывания: загрузка весов, формирование состояния на каждом баре, выбор действия, отправка ордеров. |
| Export_TradeLog.mq5 | Скрипт | Восстанавливает полные циклы сделок по истории счета и записывает файл trade_log.csv. |
| Export_BarHistory.mq5 | Скрипт | В дополнение к журналу сделок экспортирует историю баров с данными OHLC, ATR и RSI в файл bar_history.csv. |
| build_offline_dataset.py | Скрипт на Python | Преобразует журнал сделок и историю баров, экспортированные из MQL5 в формате CSV, в набор переходов для офлайн-обучения. |
| CQL_CompareAlpha.mq5 | Скрипт (диагностический) | Инструмент для разового сравнения Q-значений при alpha=0 и alpha=1 на реальном наборе данных; не входит в состав развернутой системы. |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/24592
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


