

Расстояние Вассерштейна для обнаружения дрейфа признаков в реальном времени на MQL5: Мониторинг входных данных модели ONNX методами оптимального транспорта
 17
 0

Введение
Большинство систем мониторинга дрейфа для моделей ONNX, работающих в реальном времени, отслеживают только средние значения и стандартные отклонения признаков. Этого достаточно для простых сдвигов уровня или волатильности, но такой подход не выявляет изменения формы распределения, при которых сохраняются первые два момента, — например, когда распределение признака из одномодального становится бимодальным, а среднее значение остается почти неизменным. В результате модель, обученная на данных прежнего режима, продолжает работать в уже незнакомом ей пространстве входных данных.
В этой статье создается детектор, который анализирует распределение целиком, а не пару сводных статистик, используя одномерное расстояние Вассерштейна-1 (расстояние землекопа) из теории оптимального транспорта. На основе фиксированной эталонной выборки и текущей скользящей выборки детектор измеряет минимальную «работу», необходимую для преобразования одной в другую. Для выборок одинакового размера W1 выражается простой явной формулой на основе отсортированных значений, поэтому вычислять это расстояние для каждого признака в работающем советнике MetaTrader 5 можно с небольшими затратами, не превращая OnTick в узкое место.
Место этой статьи в серии: в отличие от подхода из предыдущей статьи об ADWIN/Page-Hinkley, этот метод сравнивает эмпирические распределения, а не отслеживает точку изменения одной статистики. Эти два подхода дополняют друг друга.
Реализация включает модуль формирования восьми признаков, детектор дрейфа на основе расстояния Вассерштейна для каждого признака с порогами и действиями, задаваемыми манифестом, модель ONNX для прогнозирования направления, расчет размера позиции с учетом риска на основе ATR и офлайн-конвейер на Python для обучения и проверки на синтетических данных.
Зачем нужен оптимальный транспорт для анализа формы распределения
Для двух выборок одинакового размера n, отобранных из распределений P и Q, одномерное расстояние Вассерштейна-1 имеет точную дискретную форму. Отсортируйте обе выборки по возрастанию, попарно сопоставьте элементы с одинаковым порядковым номером i и вычислите среднее абсолютных разностей:
// W1(P, Q) for equal-size sorted samples
W1 = (1/n) * sum_i | P_sorted[i] - Q_sorted[i] |
Вот и весь расчет. Здесь не нужны ни численная оптимизация, ни симплекс-решатель, ни итеративная регуляризация Синкхорна, как в случае многомерного оптимального транспорта: одномерный случай сводится к сортировке, поскольку оптимальный план переноса между двумя упорядоченными списками всегда «монотонный», то есть сопоставляет элементы одинакового ранга. Именно поэтому описанный ниже детектор требует, чтобы эталонное окно и текущее окно имели строго одинаковый размер: попарное сопоставление имеет смысл только тогда, когда обе выборки содержат одинаковое число порядковых статистик.
Стоит явно пояснить, почему используется именно эта метрика, а не KL-дивергенция или статистика Колмогорова–Смирнова (KS). KL-дивергенция становится неопределенной всякий раз, когда текущее окно содержит значение за пределами носителя распределения эталонного окна — для финансовых признаков это обычная ситуация при переходе текущего окна в новый ценовой режим. Расстояние Вассерштейна-1 при этом остается конечным для любых двух конечных выборок, поскольку по своей сути представляет собой «стоимость переноса массы», а не отношение плотностей. Статистика KS учитывает лишь наибольший разрыв между двумя эмпирическими функциями распределения, упуская небольшое смещение распределения на всем его протяжении — типичную картину в реальных условиях. W1 интегрирует разрыв по всему распределению, поэтому фиксирует как умеренный сдвиг на широком участке, так и сильный сдвиг на узком — пропорционально количеству фактически перемещенной вероятностной массы.
Эту базовую метрику дополняют два проектных решения. Во-первых, исходное значение W1 выражено в единицах измерения самого признака, поэтому логарифмическая доходность, близкая к нулю, и z-оценка объема, измеряемая десятками, несопоставимы. Поэтому W1 каждого признака делится на межквартильный размах этого признака в эталонном окне, что приводит оценки к сопоставимому масштабу перед их объединением. Во-вторых, единая сводная оценка может скрыть проблему: если семь признаков стабильны, а распределение восьмого полностью разошлось с эталонным, взвешенное среднее все равно может оставаться ниже порога. Детектор отслеживает как взвешенную сводную оценку, так и максимальную статистику по признакам и считает сигналом пересечение критической границы любой из этих двух величин.
Архитектура системы
Конвейер обработки представляет собой прямую последовательность от закрытого бара до торгового решения, причем детектор дрейфа работает параллельно с моделью, а не перед ней. Он наблюдает тот же вектор признаков, который поступает на вход модели, поэтому всегда описывает именно то пространство входных данных, с которым фактически работает модель, а не его косвенное приближение.
Компоненты и потоки данных
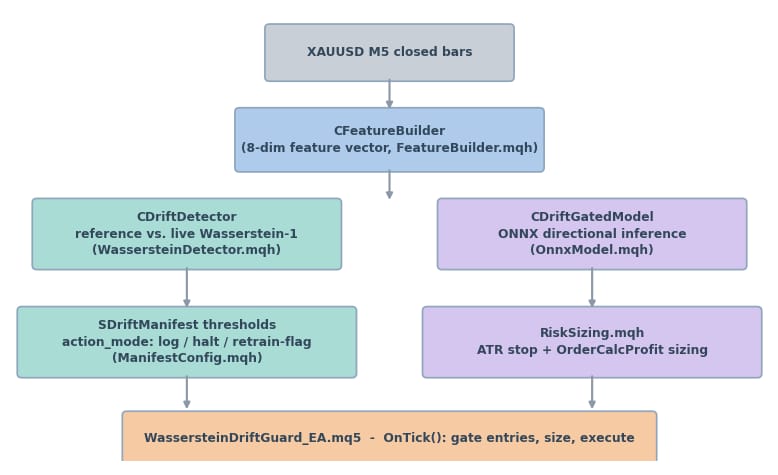
Рис. 1. Сформированный вектор признаков параллельно поступает в детектор дрейфа и модель ONNX; пороги из манифеста и результаты работы модуля расчета размера позиции поступают на уровень принятия торговых решений советника.
Логика реализована в четырех включаемых файлах, а советник в основном координирует их работу. Файл FeatureBuilder.mqh формирует 8-мерный вектор один раз на каждый закрытый бар. Файл WassersteinDetector.mqh управляет эталонным и текущим окнами и вычисляет дрейф. Файл ManifestConfig.mqh загружает пороги и обеспечивает проверку согласованности количества признаков между тремя компонентами. Файл RiskSizing.mqh преобразует расстояние до стоп-лосса, рассчитанное на основе ATR, в размер позиции с учетом риска на один лот для данного счета. Вспомогательный скрипт MQL5 экспортирует исторические признаки и метки классов в CSV, а два скрипта Python обучают классификатор ONNX и проверяют детектор дрейфа на синтетических сдвигах в автономном режиме.
Все, что относится к состоянию, а не к чистой логике, разделено по пространствам имен для каждой пары «символ — таймфрейм». Файл эталонного окна называется refwindow_<SYMBOL>_<PERIOD>.csv, поэтому при запуске одного и того же советника на графике XAUUSD M5 и на другом графике XAUUSD M15 зафиксированные эталонные данные одного экземпляра никогда не попадут в другой. Для манифеста намеренно сделано исключение: пороговые значения и веса считаются общими правилами, действующими независимо от того, к какому инструменту и таймфрейму прикреплен советник. Поэтому используется один файл drift_manifest.json, а не отдельный файл для каждой пары «символ/таймфрейм», если только различия в характере волатильности инструментов не оправдывают использование отдельных манифестов.
Проектирование вектора признаков
Каждый признак, поступающий на вход модели, должен также поддаваться содержательному отслеживанию детектором дрейфа, поэтому вектор намеренно сделан компактным: восемь скалярных величин, каждая из которых включена по конкретной причине, а не по принципу «что нашлось в библиотеке индикаторов».
//+------------------------------------------------------------------+
//| CFeatureBuilder - builds the fixed 8-dimensional feature vector  |
//+------------------------------------------------------------------+
class CFeatureBuilder
  {
private:
   string            m_symbol;         // symbol this builder is bound to
   ENUM_TIMEFRAMES   m_timeframe;      // timeframe this builder is bound to
   int               m_h_rsi;          // handle: RSI(14)
   int               m_h_atr;          // handle: ATR(14)
   int               m_h_bands;        // handle: Bollinger Bands(20,2)
   int               m_h_macd;         // handle: MACD(12,26,9)

public:
                     CFeatureBuilder(void);
                    ~CFeatureBuilder(void);
   bool              Init(const string symbol,const ENUM_TIMEFRAMES tf);
   void              Deinit(void);
   bool              BuildFeaturesAt(const int shift,double &features[]);
  };
Класс содержит четыре дескриптора индикаторов (RSI, ATR, полосы Боллинджера, MACD), которые создаются один раз в методе Init и используются на протяжении всего срока работы советника, а не создаются заново для каждого бара. BuildFeaturesAt преобразует сдвиг бара в вектор фиксированной длины из 8 значений; этот же класс без изменений используется в советнике, при начальном заполнении эталонного окна и в офлайн-экспортере, поэтому векторы признаков при работе советника и при обучении не могут незаметно разойтись.
//+------------------------------------------------------------------+
//| CFeatureBuilder::Init                                            |
//+------------------------------------------------------------------+
bool CFeatureBuilder::Init(const string symbol,const ENUM_TIMEFRAMES tf)
  {
   m_symbol    = symbol;
   m_timeframe = tf;

   m_h_rsi   = iRSI(m_symbol,m_timeframe,FB_RSI_PERIOD,PRICE_CLOSE);
   m_h_atr   = iATR(m_symbol,m_timeframe,FB_ATR_PERIOD);
   m_h_bands = iBands(m_symbol,m_timeframe,FB_BB_PERIOD,0,FB_BB_DEVIATION,PRICE_CLOSE);
   m_h_macd  = iMACD(m_symbol,m_timeframe,FB_MACD_FAST,FB_MACD_SLOW,FB_MACD_SIGNAL,PRICE_CLOSE);

//--- any INVALID_HANDLE means the terminal could not create the indicator instance
//--- (bad symbol, bad params, or history not ready yet) - fail loudly instead of
//--- silently returning zeros for every feature downstream
   if(m_h_rsi==INVALID_HANDLE || m_h_atr==INVALID_HANDLE ||
      m_h_bands==INVALID_HANDLE || m_h_macd==INVALID_HANDLE)
     {
      Print("CFeatureBuilder::Init failed - one or more indicator handles invalid");
      return(false);
     }
   return(true);
  }
//+------------------------------------------------------------------+
//| CFeatureBuilder::BuildFeaturesAt                                 |
//+------------------------------------------------------------------+
bool CFeatureBuilder::BuildFeaturesAt(const int shift,double &features[])
  {
//--- the array is resized here rather than by the caller so BuildFeaturesAt is the
//--- single source of truth for "how many features exist" - the 3-way contract check
//--- in OnInit calls this once and compares ArraySize() against NUM_FEATURES and the
//--- manifest's "num_features" field
   ArrayResize(features,NUM_FEATURES);

   double close_buf[],rsi_buf[],atr_buf[],upper_buf[],lower_buf[],macd_buf[],signal_buf[];
   long   vol_buf[];

   ArraySetAsSeries(close_buf,true);
   ArraySetAsSeries(rsi_buf,true);
   ArraySetAsSeries(atr_buf,true);
   ArraySetAsSeries(upper_buf,true);
   ArraySetAsSeries(lower_buf,true);
   ArraySetAsSeries(macd_buf,true);
   ArraySetAsSeries(signal_buf,true);
   ArraySetAsSeries(vol_buf,true);

//--- request one bar more than the deepest lookback so the "5-bar log return" (f1)
//--- and the volume z-score window (f5) always have enough closed bars behind `shift`
   int need = MathMax(FB_VOL_PERIOD,5) + shift + 2;

   if(CopyClose(m_symbol,m_timeframe,0,need,close_buf) < need)          return(false);
   if(CopyBuffer(m_h_rsi,0,0,need,rsi_buf) < need)                      return(false);
   if(CopyBuffer(m_h_atr,0,0,need,atr_buf) < need)                      return(false);
   if(CopyBuffer(m_h_bands,1,0,need,upper_buf) < need)                  return(false);
   if(CopyBuffer(m_h_bands,2,0,need,lower_buf) < need)                  return(false);
   if(CopyBuffer(m_h_macd,0,0,need,macd_buf) < need)                    return(false);
   if(CopyBuffer(m_h_macd,1,0,need,signal_buf) < need)                  return(false);
//--- bug-class guard: CopyTickVolume() requires a long[] destination, never double[]
   if(CopyTickVolume(m_symbol,m_timeframe,0,need,vol_buf) < need)       return(false);

   double atr_now = atr_buf[shift];
//--- ATR sits in every denominator below (f3, f6, f7) - a flat/illiquid opening print
//--- can make it exactly zero, which would turn every ratio into +-inf; clamp to a
//--- tiny epsilon so the feature degrades gracefully instead of poisoning the window
   if(atr_now <= 0.0) atr_now = _Point;

//--- f0: 1-bar log return
   features[0] = MathLog(close_buf[shift] / close_buf[shift+1]);

//--- f1: 5-bar log return
   features[1] = MathLog(close_buf[shift] / close_buf[shift+5]);

//--- f2: RSI rescaled from [0,100] to [-1,1] so its magnitude is comparable to the
//--- other bounded features instead of dominating the composite drift score
   features[2] = (rsi_buf[shift] - 50.0) / 50.0;

//--- f3: ATR expressed as a fraction of price - makes volatility comparable across
//--- the very different absolute price levels XAUUSD trades at over time
   features[3] = atr_now / close_buf[shift];

//--- f4: Bollinger %B - position of price within the band, deliberately left
//--- unclamped (can exceed [0,1] on a squeeze breakout, which is itself informative)
   double band_width = upper_buf[shift] - lower_buf[shift];
   if(band_width <= 0.0) band_width = _Point;
   features[4] = (close_buf[shift] - lower_buf[shift]) / band_width;

//--- f5: tick-volume z-score over FB_VOL_PERIOD bars
   double vol_sum = 0.0, vol_sq_sum = 0.0;
   for(int i=shift; i<shift+FB_VOL_PERIOD; i++)
     {
      vol_sum    += (double)vol_buf[i];
      vol_sq_sum += (double)vol_buf[i] * (double)vol_buf[i];
     }
   double vol_mean = vol_sum / FB_VOL_PERIOD;
   double vol_var  = (vol_sq_sum / FB_VOL_PERIOD) - (vol_mean*vol_mean);
   double vol_std  = (vol_var > 0.0) ? MathSqrt(vol_var) : 1.0;   // avoid /0 on a dead tape
   features[5] = ((double)vol_buf[shift] - vol_mean) / vol_std;

//--- f6: MACD histogram (main - signal), normalized by ATR so it is scale-invariant
//--- across instruments/regimes rather than carrying raw price units
   features[6] = (macd_buf[shift] - signal_buf[shift]) / atr_now;

//--- f7: bar range relative to ATR - flags abnormally wide or narrow bars vs. the
//--- prevailing volatility regime, independent of direction
   double high_val = iHigh(m_symbol,m_timeframe,shift);
   double low_val  = iLow(m_symbol,m_timeframe,shift);
   features[7] = (high_val - low_val) / atr_now;

   return(true);
  }
Восемь признаков: f0 — логарифмическая доходность за 1 бар, а f1 — логарифмическая доходность за 5 баров, что позволяет оценить как краткосрочный импульс, так и несколько более долгосрочную динамику. f2 — это RSI(14), пересчитанный в диапазон [-1,1]. f3 — это ATR(14), деленный на цену закрытия, то есть волатильность как доля цены. f4 — это %B по Боллинджеру без ограничения значений, поскольку выход из сжатия полос сам по себе информативен. f5 — это z-оценка тикового объема за 20 баров, рассчитанная вручную, поскольку ни один встроенный индикатор ее не предоставляет. f6 — гистограмма MACD, деленная на ATR, что обеспечивает инвариантность к масштабу при разных рыночных режимах. f7 — диапазон бара, деленный на ATR, позволяющий выявлять необычно широкие или узкие бары.
Для признаков, зависящих от ATR (f3, f6, f7), знаменатель ограничивается снизу очень малым значением эпсилон, чтобы начальный бар без изменения цены не приводил к незаметному появлению inf; при расчете z-оценки объема на столь же неактивном рынке вместо стандартного отклонения подставляется единица.
Честное замечание: качество прогнозов с этим набором признаков практически соответствовало случайному угадыванию — ROC-AUC на отложенной выборке составлял около 0.50 для логистической регрессии и 0.4936 для случайного леса при пяти комбинациях размера обучающей выборки и горизонта прогнозирования. Эти признаки сохранены, поскольку основное внимание в статье уделяется подсистеме выявления дрейфа, а не альфе от прогнозирования направления цены.
Детектор дрейфа на основе расстояния Вассерштейна-1
Это ключевая часть статьи: для каждого признака используются два окна — зафиксированное эталонное окно, формируемое один раз (из исторических данных при запуске советника либо путем загрузки из файла, сохраненного при предыдущем запуске), и скользящее текущее окно, которое всегда содержит последние live_window_size закрытых баров.
//+------------------------------------------------------------------+
//| CDriftDetector - per-feature Wasserstein-1 drift monitor         |
//+------------------------------------------------------------------+
class CDriftDetector
  {
private:
   int      m_num_features;     // number of monitored features (must equal NUM_FEATURES)
   int      m_ref_size;         // reference window length (fixed, frozen at bootstrap)
   int      m_live_size;        // live window length - MUST equal m_ref_size (see note in Init)
   double   m_ref_sorted[];     // flattened [feature*m_ref_size + i], pre-sorted ascending, frozen
   double   m_ref_iqr[];        // per-feature IQR of the reference window, used to normalize W1
   double   m_live_buf[];       // flattened circular buffer [feature*m_live_size + slot]
   int      m_live_head;        // next slot index to overwrite on push
   int      m_live_count;       // samples pushed since last reset, caps at m_live_size
   bool     m_reference_ready;  // true once the reference window has been frozen or loaded

   void     SortSlice(double &arr[],const int offset,const int count);
   double   Wasserstein1D(const double &sorted_a[],const int offset_a,
                           const double &sorted_b[],const int offset_b,const int n);
   double   PercentileFromSorted(const double &sorted[],const int offset,const int n,const double p);

public:
                     CDriftDetector(void);
   bool              Init(const int num_features,const int ref_size,const int live_size);
   bool              LoadOrBootstrapReference(const string file_path,CFeatureBuilder &builder);
   void              BootstrapLiveWindow(CFeatureBuilder &builder);
   void              PushLiveSample(const double &features[]);
   bool              IsLiveWindowFull(void) const { return(m_live_count>=m_live_size); }
   bool              IsReferenceReady(void)  const { return(m_reference_ready); }
   void              ComputeDriftScores(double &per_feature_w1[],double &per_feature_normalized[]);
   double            ComputeComposite(const double &normalized[],const double &weights[],double &max_stat);
  };
Эталонное окно хранится в предварительно отсортированном виде (сортировка выполняется один раз при фиксации окна, а не при каждом расчете оценки). Текущее окно представляет собой одномерный кольцевой буфер с индексацией по формуле feature * live_size + slot, что позволяет избежать затраты на сдвиг массива при поступлении каждого нового наблюдения.
Вычислительные затраты: расчет оценки для одного признака требует сортировки среза текущего окна из 250 элементов (O(n log n), встроенная функция ArraySort в MQL5) и линейного прохода с сопоставлением с предварительно отсортированным эталонным окном. Для восьми признаков это восемь сортировок, выполняемых раз в recompute_every_n_bars закрытых баров, а не на каждом тике. При таком размере окна и числе признаков затраты достаточно малы, поэтому периодичность пересчета служит средством настройки актуальности оценки, а не вынужденной мерой для обеспечения производительности.
//+------------------------------------------------------------------+
//| CDriftDetector::Wasserstein1D                                    |
//+------------------------------------------------------------------+
double CDriftDetector::Wasserstein1D(const double &sorted_a[],const int offset_a,
                                      const double &sorted_b[],const int offset_b,const int n)
  {
//--- closed-form discrete W1 for two equal-size, already-sorted 1D samples:
//--- the optimal transport plan simply matches rank-i of A to rank-i of B, so the
//--- distance collapses to the mean absolute difference between paired order statistics
   double sum_abs_diff = 0.0;
   for(int i=0;i<n;i++)
      sum_abs_diff += MathAbs(sorted_a[offset_a+i] - sorted_b[offset_b+i]);
   return(sum_abs_diff / n);
  }
//+------------------------------------------------------------------+
//| CDriftDetector::PercentileFromSorted                             |
//+------------------------------------------------------------------+
double CDriftDetector::PercentileFromSorted(const double &sorted[],const int offset,const int n,const double p)
  {
//--- linear-interpolation percentile (same convention as numpy's default) so the IQR
//--- used for normalization matches what the Python validation script computes
   double rank = p*(n-1);
   int    lo   = (int)MathFloor(rank);
   int    hi   = (int)MathCeil(rank);
   if(lo==hi) return(sorted[offset+lo]);
   double frac = rank-lo;
   return(sorted[offset+lo]*(1.0-frac) + sorted[offset+hi]*frac);
  }
Функция PercentileFromSorted() используется исключительно для вычисления межквартильного размаха (IQR) эталонного окна с применением тех же правил интерполяции, что и в NumPy, что обеспечивает согласованность результатов при вычислениях вне терминала и в самом терминале.
//+------------------------------------------------------------------+
//| CDriftDetector::BootstrapLiveWindow                              |
//+------------------------------------------------------------------+
void CDriftDetector::BootstrapLiveWindow(CFeatureBuilder &builder)
  {
//--- pre-fill the live window from the most recent m_live_size closed bars (shift 0..m_live_size-1)
//--- so the detector is immediately usable after OnInit instead of forcing a silent
//--- multi-hundred-bar warm-up period before the first drift score can be produced
   double feat[];
   for(int shift=m_live_size-1; shift>=0; shift--)
     {
      if(builder.BuildFeaturesAt(shift,feat))
         PushLiveSample(feat);
     }
  }
//+------------------------------------------------------------------+
//| CDriftDetector::PushLiveSample                                   |
//+------------------------------------------------------------------+
void CDriftDetector::PushLiveSample(const double &features[])
  {
   for(int f=0; f<m_num_features; f++)
      m_live_buf[f*m_live_size + m_live_head] = features[f];

//--- classic ring-buffer advance: wrap the write head and cap the fill count at
//--- m_live_size so IsLiveWindowFull() flips true exactly once the window is dense
   m_live_head = (m_live_head+1) % m_live_size;
   if(m_live_count < m_live_size) m_live_count++;
  }
Начальное заполнение текущего окна при запуске позволяет избежать длительного периода прогрева перед получением первой оценки.
//+------------------------------------------------------------------+
//| CDriftDetector::ComputeDriftScores                               |
//+------------------------------------------------------------------+
void CDriftDetector::ComputeDriftScores(double &per_feature_w1[],double &per_feature_normalized[])
  {
   ArrayResize(per_feature_w1,m_num_features);
   ArrayResize(per_feature_normalized,m_num_features);

   double live_slice[];
   ArrayResize(live_slice,m_num_features*m_live_size);

//--- copy the circular buffer out in plain chronological-irrelevant order - Wasserstein-1
//--- is a distribution distance, so sample ORDER inside the window does not matter, only
//--- the set of values does; this lets us skip unwinding the ring buffer's wrap point
   for(int f=0; f<m_num_features; f++)
      for(int i=0;i<m_live_size;i++)
         live_slice[f*m_live_size+i] = m_live_buf[f*m_live_size+i];

   for(int f=0; f<m_num_features; f++)
     {
      SortSlice(live_slice,f*m_live_size,m_live_size);
      double w1 = Wasserstein1D(m_ref_sorted,f*m_ref_size,live_slice,f*m_live_size,m_live_size);
      per_feature_w1[f] = w1;

      //--- normalize by the reference IQR so features with very different natural scales
      //--- (a log-return near zero vs. a volume z-score in the tens) contribute comparably
      //--- to the composite score instead of the largest-magnitude feature dominating it
      double iqr = m_ref_iqr[f];
      if(iqr <= 0.0) iqr = 1e-8;      // degenerate reference (constant feature) - avoid /0
      per_feature_normalized[f] = w1 / iqr;
     }
  }
//+------------------------------------------------------------------+
//| CDriftDetector::ComputeComposite                                 |
//+------------------------------------------------------------------+
double CDriftDetector::ComputeComposite(const double &normalized[],const double &weights[],double &max_stat)
  {
   double weighted_sum = 0.0, weight_total = 0.0;
   max_stat = 0.0;
   for(int f=0; f<m_num_features; f++)
     {
      weighted_sum += weights[f]*normalized[f];
      weight_total += weights[f];
      //--- track the single worst-drifting feature separately from the blended average -
      //--- a weighted mean can stay below threshold even while one feature has fully
      //--- decoupled from its reference distribution, which the max-statistic catches
      if(normalized[f] > max_stat) max_stat = normalized[f];
     }
   if(weight_total <= 0.0) weight_total = 1.0;
   return(weighted_sum/weight_total);
  }
Чтобы показать, что это не просто красивая формула, работающая лишь на доске, сопутствующий скрипт на Python synthetic_shift_validation.py выполняет те же вычисления вне терминала для трех типов искусственных сдвигов распределения — сдвига среднего, изменения дисперсии и изменения бимодальной смеси, сконструированного так, чтобы среднее и дисперсия оставались почти неизменными. Затем он сравнивает частоту обнаружения с результатами простого детектора на основе среднего и стандартного отклонения; пороги обоих детекторов откалиброваны так, чтобы на данных без сдвига частота ложных срабатываний составляла примерно 5 %.
Расстояние Вассерштейна-1 и простой детектор на основе среднего и стандартного отклонения: сравнение частоты обнаружения

Рис. 2. Доля обнаруженных сдвигов при одинаковой частоте ложных срабатываний около 5 %. При фактическом запуске этого скрипта: сдвиг среднего — 100 % против 100 %, изменение дисперсии — 100 % против 20 %, бимодальная смесь — 100 % против 1 %. Наивный детектор практически не реагирует на сдвиг, при котором изменяется форма распределения, но не смещается среднее значение.
Последний столбец выражает главный аргумент этой статьи одним числом. Монитор среднего значения и стандартного отклонения зафиксировал сдвиг бимодальной смеси в 1 из 100 испытаний. Детектор на основе расстояния Вассерштейна-1 зафиксировал этот сдвиг во всех 100 испытаниях.
Динамика сводной оценки дрейфа

Рис. 3. Динамика сводной оценки на синтетических данных: сначала небольшие шумовые колебания вокруг эталонного уровня, затем смена режима вызывает постепенный рост оценки через зону предупреждения в критическую зону, где срабатывает HandleDriftAction.
//+------------------------------------------------------------------+
//| CDriftDetector::LoadOrBootstrapReference                         |
//+------------------------------------------------------------------+
bool CDriftDetector::LoadOrBootstrapReference(const string file_path,CFeatureBuilder &builder)
  {
//--- prefer an existing frozen reference so a live EA restart does not silently
//--- re-baseline itself against whatever regime happens to be live at restart time
   if(FileIsExist(file_path))
     {
      int handle = FileOpen(file_path,FILE_READ|FILE_TXT|FILE_ANSI);
      if(handle==INVALID_HANDLE)
        {
         Print("LoadOrBootstrapReference: FileOpen failed for ",file_path);
         return(false);
        }

      //--- FileReadString() on FILE_TXT silently returns only the first line if you call
      //--- it once and stop - read every line explicitly with FileIsEnding() instead
      string header = "";
      if(!FileIsEnding(handle)) header = FileReadString(handle);
      string parts[];
      int n_parts = StringSplit(header,',',parts);
      if(n_parts!=2 || (int)StringToInteger(parts[0])!=m_num_features || (int)StringToInteger(parts[1])!=m_ref_size)
        {
         Print("LoadOrBootstrapReference: header mismatch in ",file_path,
               " - deleting stale file and re-bootstrapping");
         FileClose(handle);
         FileDelete(file_path);
        }
      else
        {
         for(int f=0; f<m_num_features && !FileIsEnding(handle); f++)
           {
            string line = FileReadString(handle);
            string vals[];
            int n_vals = StringSplit(line,',',vals);
            if(n_vals!=m_ref_size)
              {
               Print("LoadOrBootstrapReference: row ",f," has ",n_vals," values, expected ",m_ref_size);
               FileClose(handle);
               return(false);
              }
            for(int i=0;i<m_ref_size;i++)
               m_ref_sorted[f*m_ref_size+i] = StringToDouble(vals[i]);
           }
         FileClose(handle);

         for(int f=0; f<m_num_features; f++)
           {
            double q1 = PercentileFromSorted(m_ref_sorted,f*m_ref_size,m_ref_size,0.25);
            double q3 = PercentileFromSorted(m_ref_sorted,f*m_ref_size,m_ref_size,0.75);
            m_ref_iqr[f] = (q3-q1);
           }
         m_reference_ready = true;
         return(true);
        }
     }

//--- bootstrap path: no frozen file yet, so build the reference from the ref_size
//--- closed bars immediately BEHIND the live window (shift = live_size .. live_size+ref_size-1),
//--- keeping reference and live disjoint and time-ordered so there is no leakage between them
   double feat[];
   for(int i=0;i<m_ref_size;i++)
     {
      int shift = m_live_size + i;
      if(!builder.BuildFeaturesAt(shift,feat))
        {
         Print("LoadOrBootstrapReference: BuildFeaturesAt failed at shift ",shift,
               " - not enough history loaded yet");
         return(false);
        }
      for(int f=0; f<m_num_features; f++)
         m_ref_sorted[f*m_ref_size+i] = feat[f];
     }

   for(int f=0; f<m_num_features; f++)
     {
      SortSlice(m_ref_sorted,f*m_ref_size,m_ref_size);
      double q1 = PercentileFromSorted(m_ref_sorted,f*m_ref_size,m_ref_size,0.25);
      double q3 = PercentileFromSorted(m_ref_sorted,f*m_ref_size,m_ref_size,0.75);
      m_ref_iqr[f] = (q3-q1);
     }

//--- freeze to disk as plain comma-separated text; DoubleToString is used explicitly on
//--- every value written (never the default %s cast) to sidestep locale-dependent decimal
//--- separators when this file is later read back on a machine with different Windows regional settings
   int out_handle = FileOpen(file_path,FILE_WRITE|FILE_TXT|FILE_ANSI);
   if(out_handle==INVALID_HANDLE)
     {
      Print("LoadOrBootstrapReference: could not create ",file_path," - continuing without persistence");
     }
   else
     {
      FileWriteString(out_handle,IntegerToString(m_num_features)+","+IntegerToString(m_ref_size)+"\r\n");
      for(int f=0; f<m_num_features; f++)
        {
         string row = "";
         for(int i=0;i<m_ref_size;i++)
           {
            row += DoubleToString(m_ref_sorted[f*m_ref_size+i],8);
            if(i<m_ref_size-1) row += ",";
           }
         FileWriteString(out_handle,row+"\r\n");
        }
      FileClose(out_handle);
     }

   m_reference_ready = true;
   return(true);
  }
Эталонное окно формируется из ref_size баров, расположенных непосредственно перед текущим окном (сдвиги баров от live_size до live_size + ref_size - 1), поэтому эти два окна заведомо не пересекаются во времени — ни один бар не сравнивается с окном, в которое он сам входит.
Конфигурация на основе манифеста
Все пороговые значения, веса и размеры окон хранятся в JSON-файле, считываемом в OnInit, а не в константах #define — ужесточение порога после недели предупреждений при работе в реальном времени не должно требовать перекомпиляции.
//+------------------------------------------------------------------+
//| SDriftManifest - runtime-tunable parameters loaded from JSON     |
//+------------------------------------------------------------------+
struct SDriftManifest
  {
   int      num_features;            // must equal NUM_FEATURES (3-way contract check)
   int      reference_window_size;   // bars in the frozen reference window
   int      live_window_size;        // bars in the rolling live window (must equal reference_window_size)
   int      recompute_every_n_bars;  // cost control - drift score recomputed every N closed bars
   double   feature_weights[];       // per-feature weight in the composite weighted-sum score
   double   warn_threshold;          // composite/normalized score above this -> warning log
   double   critical_threshold;      // composite/normalized score above this -> action fires
   int      action_mode;             // 0 = log only, 1 = halt new entries, 2 = flag-for-retrain file drop
   double   risk_percent;            // percent equity risked per trade (feeds RiskSizing.mqh)
  };
Полноценный парсер JSON избыточен для файла с плоской структурой и известной схемой: загрузчик просто находит каждый ожидаемый ключ по имени и извлекает подстроку со значением, используя только встроенные строковые функции MQL5, без сторонних зависимостей.
//+------------------------------------------------------------------+
//| ExtractJsonNumber                                                |
//+------------------------------------------------------------------+
double ExtractJsonNumber(const string &text,const string key,const double default_value)
  {
   string pattern = "\""+key+"\"";
   int key_pos = StringFind(text,pattern);
   if(key_pos<0) return(default_value);

   int colon_pos = StringFind(text,":",key_pos);
   if(colon_pos<0) return(default_value);

   int start = colon_pos+1;
   int len   = StringLen(text);
   int end   = start;
//--- scan forward until a delimiter that can never appear inside a bare JSON number
   while(end<len)
     {
      ushort ch = StringGetCharacter(text,end);
      if(ch==',' || ch=='}' || ch=='\n' || ch=='\r' || ch==']') break;
      end++;
     }
//+------------------------------------------------------------------+
//| LoadManifest                                                     |
//+------------------------------------------------------------------+
bool LoadManifest(const string file_path,SDriftManifest &manifest)
  {
//--- FILE_COMMON is deliberately NOT used here: the manifest is meant to be edited
//--- per-terminal/per-tester-agent without needing to touch a shared common folder,
//--- and it is small enough that duplicating it per install costs nothing
   int handle = FileOpen(file_path,FILE_READ|FILE_TXT|FILE_ANSI);
   string full_text = "";
   bool file_found = (handle != INVALID_HANDLE);

   if(!file_found)
     {
      //--- the Strategy Tester's sandboxed Files folder is isolated from the terminal's
      //--- own Files folder (the same reason OnnxModel.mqh embeds the model as a #resource
      //--- instead of loading it by path) - a Tester agent will routinely NOT have this
      //--- file even when it is sitting exactly where it should on the live terminal.
      //--- Rather than abort OnInit over a missing config file, fall through with an empty
      //--- full_text: every field below already has a documented default via
      //--- ExtractJsonNumber's default_value argument, so an empty string simply means
      //--- every field takes its default - the exact same values the shipped
      //--- drift_manifest.json ships with. This function still returns true in that case,
      //--- since the manifest struct ends up fully and validly populated either way.
      Print("LoadManifest: could not open ",file_path," - using built-in defaults ",
            "(expected in Strategy Tester agents; copy drift_manifest.json into the ",
            "agent's own Files folder if you need non-default settings during testing)");
     }
   else
     {
      //--- read the whole file into one string rather than parsing line-by-line, since
      //--- JSON keys can legally be split across lines and a line-oriented reader would miss that
      while(!FileIsEnding(handle))
         full_text += FileReadString(handle) + "\n";
      FileClose(handle);

      //--- a UTF-16 BOM (or a stray one from a text editor) surviving into the first key
      //--- would break the very first StringFind() match, so strip it defensively
      StringReplace(full_text,"\uFEFF","");
     }

   manifest.num_features           = (int)ExtractJsonNumber(full_text,"num_features",NUM_FEATURES);
   manifest.reference_window_size  = (int)ExtractJsonNumber(full_text,"reference_window_size",250);
   manifest.live_window_size       = (int)ExtractJsonNumber(full_text,"live_window_size",250);
   manifest.recompute_every_n_bars = (int)ExtractJsonNumber(full_text,"recompute_every_n_bars",10);
   manifest.warn_threshold         = ExtractJsonNumber(full_text,"warn_threshold",1.5);
   manifest.critical_threshold     = ExtractJsonNumber(full_text,"critical_threshold",2.5);
   manifest.action_mode            = (int)ExtractJsonNumber(full_text,"action_mode",1);
   manifest.risk_percent           = ExtractJsonNumber(full_text,"risk_percent",0.5);

   int n_weights = ExtractJsonNumberArray(full_text,"feature_weights",manifest.feature_weights);
   if(n_weights != manifest.num_features)
     {
      //--- fall back to equal weighting rather than aborting - a malformed weights array
      //--- (or, as above, a genuinely empty full_text) is a recoverable config error,
      //--- unlike a feature-count mismatch below
      Print("LoadManifest: feature_weights length (",n_weights,
            ") does not match num_features (",manifest.num_features,") - using equal weights");
      ArrayResize(manifest.feature_weights,manifest.num_features);
      for(int i=0;i<manifest.num_features;i++)
         manifest.feature_weights[i] = 1.0;
     }

   return(true);
  }
Формат файла манифеста в точности соответствует тому, который считывает функция LoadManifest:
| Поле | Тип | Способ проверки |
|---|---|---|
| num_features | int | во время выполнения проверяется соответствие значению NUM_FEATURES, заданному при компиляции, и длине результата BuildFeaturesAt(); при несоответствии выполнение OnInit прерывается |
| reference_window_size / live_window_size | int | во время выполнения проверяется равенство этих значений; при несовпадении выполнение OnInit прерывается |
| recompute_every_n_bars | int | контроль вычислительных затрат предусмотрен только в документации; допускается любое положительное значение |
| feature_weights | массив элементов типа double длиной num_features | если длина массива не совпадает с num_features, используются равные веса (все равны 1.0) |
| warn_threshold / critical_threshold | double | ограничение указано только в документации; порядок порогов не проверяется, поэтому critical < warn технически допустимо (но является ошибкой конфигурации) |
| action_mode | int (0/1/2) | нераспознанное значение записывается в журнал и трактуется функцией HandleDriftAction как 1 (остановка) |
| risk_percent | double | описан только в документации, программная проверка не выполняется; значение напрямую передается в CalcLotSize |
//+------------------------------------------------------------------+
//| ValidateManifest                                                 |
//+------------------------------------------------------------------+
bool ValidateManifest(const SDriftManifest &manifest,const int actual_feature_count)
  {
//--- the 3-way feature contract: the compile-time NUM_FEATURES constant, the manifest's
//--- declared num_features, and BuildFeaturesAt()'s actual output length must all agree.
//--- Any mismatch means the code was edited (a feature added/removed) without updating
//--- the deployed manifest or vice versa - continuing would silently misalign the
//--- reference window against a live window built from a different feature set
   if(manifest.num_features != NUM_FEATURES)
     {
      Print("ValidateManifest: manifest num_features=",manifest.num_features,
            " does not match compiled NUM_FEATURES=",NUM_FEATURES);
      return(false);
     }
   if(actual_feature_count != NUM_FEATURES)
     {
      Print("ValidateManifest: BuildFeaturesAt() produced ",actual_feature_count,
            " values, expected NUM_FEATURES=",NUM_FEATURES);
      return(false);
     }
   if(manifest.reference_window_size != manifest.live_window_size)
     {
      Print("ValidateManifest: reference_window_size must equal live_window_size");
      return(false);
     }
   return(true);
  }
Функция ValidateManifest обеспечивает согласованность трех величин: NUM_FEATURES, manifest.num_features и длина, возвращаемая BuildFeaturesAt(), должны совпадать, чтобы OnInit завершилась успешно. Эта проверка нужна, поскольку предотвращаемый ею сбой остается незаметным и дорого обходится: если добавить девятый признак в FeatureBuilder.mqh, не обновив развернутый манифест, то без этой проверки советник продолжит работать с эталонным окном, сформированным для прежних 8 признаков, тогда как текущее окно незаметно будет содержать уже 9. Оценка дрейфа по-прежнему будет числом, но бессмысленным, а явной ошибки не возникнет.
Инференс ONNX и ловушка экспорта с двумя выходами
Сигнал направления специально сделан простым — это логистическая регрессия, обученная в автономном режиме, экспортированная в формат ONNX и встроенная в скомпилированный советник в качестве ресурса, а не загружаемая из файла во время выполнения.
//+------------------------------------------------------------------+
//| CDriftGatedModel - ONNX session wrapper for directional signal   |
//+------------------------------------------------------------------+
class CDriftGatedModel
  {
private:
   long     m_session;         // ONNX runtime session handle
   matrix<float> m_output;     // pre-sized output buffer, required by ONNX_NO_CONVERSION

public:
                     CDriftGatedModel(void);
                    ~CDriftGatedModel(void);
   bool              Load(void);
   void              Release(void);
   bool              Predict(const double &features[],double &prob_up);
  };
//+------------------------------------------------------------------+
//| CDriftGatedModel::Load                                           |
//+------------------------------------------------------------------+
bool CDriftGatedModel::Load(void)
  {
   m_session = OnnxCreateFromBuffer(OnnxModelBytes,ONNX_DEFAULT);
   if(m_session==INVALID_HANDLE)
     {
      Print("CDriftGatedModel::Load - OnnxCreateFromBuffer failed, error ",GetLastError());
      return(false);
     }

//--- fix the input shape explicitly to [1, NUM_FEATURES]; the model was exported with
//--- a dynamic batch axis, so the batch dimension of 1 must be pinned here or OnnxRun
//--- will reject a mismatched tensor shape at inference time
   ulong input_shape[] = {1,NUM_FEATURES};
   if(!OnnxSetInputShape(m_session,0,input_shape))
     {
      Print("CDriftGatedModel::Load - OnnxSetInputShape failed, error ",GetLastError());
      return(false);
     }

//--- ONNX_NO_CONVERSION demands the caller's buffer type match the model's declared
//--- output type exactly (float32 here, not MQL5's default double) AND be pre-sized -
//--- the runtime will not allocate or convert it on our behalf
   ulong output_shape[] = {1,2};
   if(!OnnxSetOutputShape(m_session,0,output_shape))
     {
      Print("CDriftGatedModel::Load - OnnxSetOutputShape failed, error ",GetLastError());
      return(false);
     }
   m_output.Init(1,2);

   return(true);
  }
Развертывание модели: встраивание через #resource вместо OnnxCreate(file_path) позволяет обойти реальное ограничение тестера стратегий: папка Files в изолированной среде агента тестера отделена от собственной папки Files терминала, поэтому загрузка по пути, работающая при реальной торговле, при оптимизации или в агенте тестера может завершиться сбоем либо незаметно загрузить устаревший файл. Ресурс, встроенный с помощью #resource на этапе компиляции, поставляется вместе со скомпилированным файлом .ex5 и вообще не требует поиска файла во время выполнения.
//+------------------------------------------------------------------+
//| CDriftGatedModel::Predict                                        |
//+------------------------------------------------------------------+
bool CDriftGatedModel::Predict(const double &features[],double &prob_up)
  {
//--- MQL5's bare "matrix" is matrix<double>; the ONNX model's input tensor was exported
//--- as float32, so under ONNX_NO_CONVERSION the input buffer must be matrix<float> or
//--- OnnxRun rejects the call with a type-mismatch error
   matrix<float> input_matrix;
   input_matrix.Init(1,NUM_FEATURES);
   for(int i=0;i<NUM_FEATURES;i++)
      input_matrix[0][i] = (float)features[i];

   if(!OnnxRun(m_session,ONNX_NO_CONVERSION,input_matrix,m_output))
     {
      Print("CDriftGatedModel::Predict - OnnxRun failed, error ",GetLastError());
      return(false);
     }

//--- output tensor "probabilities" is [P(down), P(up)] after stripping skl2onnx's
//--- default ZipMap wrapper at export time (see train_export_onnx.py) - column 1 is
//--- the probability of the "up" class
   prob_up = (double)m_output[0][1];
   return(true);
  }
Тип и форма тензора: входной тензор должен иметь форму [1, NUM_FEATURES] и тип float32; необходимо явно использовать matrix<float>, поскольку в MQL5 тип matrix без указания параметра означает matrix<double> и не соответствует требованиям OnnxRun при использовании ONNX_NO_CONVERSION. Память под выходной тензор формы [1, 2] с элементами типа float32 выделяется заранее, поскольку в этом режиме за выделение памяти отвечает вызывающая сторона.
Стоит отметить одну ошибку: при преобразовании классификатора skl2onnx формирует два выхода даже при zipmap=False. Выход 0 — это метка класса типа int64 (argmax), а выход 1 — тензор вероятностей. Функция OnnxRun в MQL5 привязывает выходные буферы по позиционному индексу, а приведенный выше метод CDriftGatedModel::Predict предоставляет только один выходной буфер с индексом 0 — поэтому без дополнительного шага советник привязал бы свой буфер вероятностей типа float к выходу метки класса типа int64, что привело бы к ошибке во время инференса, а не компиляции.
Исправление ошибки при экспорте: перед сохранением выход метки класса явно удаляется из графа ONNX в скрипте экспорта, а не в MQL5, так что вероятности остаются единственным выходом — следовательно, с индексом 0.
def main():
    df = load_training_data(CSV_PATH)
    X = df[FEATURE_COLS].to_numpy(dtype=np.float32)
    y = df["label"].to_numpy(dtype=np.int64)

    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.25, shuffle=False  # time series - no shuffling across the split
    )

    # diagnostic block: an exact 0.5000 ROC-AUC almost always means the model is
    # predicting the SAME probability for every row rather than genuinely finding no
    # signal - these three checks distinguish "no usable signal" from "something upstream
    # is degenerate" (a single-class training split, a constant feature, a failed fit)
    print(f"Rows: total={len(df)} train={len(y_train)} test={len(y_test)}")
    print(f"Train label balance: {dict(zip(*np.unique(y_train, return_counts=True)))}")
    print(f"Test label balance:  {dict(zip(*np.unique(y_test, return_counts=True)))}")

    # deliberately simple model by default: this article's focus is the drift-detection
    # layer, not squeezing out extra accuracy from the directional signal itself.
    # StandardScaler matters for the logistic branch specifically: f0/f1 (log returns)
    # sit around 1e-4 while f5 (a volume z-score) sits around 1-3, and under L2
    # regularization a coefficient large enough to make a tiny-scale feature matter gets
    # penalized just as hard as one on a well-scaled feature, so without scaling the model
    # can end up effectively blind to the smallest-magnitude features. Wrapping scaler +
    # classifier in a Pipeline also means skl2onnx exports BOTH steps into the same graph,
    # so OnnxRun() applies identical preprocessing at inference time automatically.
    if MODEL_TYPE == "logistic":
        model = Pipeline([
            ("scaler", StandardScaler()),
            ("classifier", LogisticRegression(max_iter=2000, C=1.0)),
        ])
    elif MODEL_TYPE == "random_forest":
        # trees split on raw feature values, so scaling is a no-op for what the model can
        # learn - the scaler step is left out here rather than kept as dead weight in the
        # exported graph. max_depth and min_samples_leaf are kept conservative on purpose:
        # a diagnostic experiment on ~15-20k noisy financial rows should be biased toward
        # NOT finding fake patterns (overfitting) rather than toward finding real ones -
        # an unconstrained forest can memorize noise and report a misleadingly high AUC
        model = RandomForestClassifier(
            n_estimators=300, max_depth=5, min_samples_leaf=50,
            random_state=42, n_jobs=-1,
        )
    else:
        raise ValueError(f"Unknown MODEL_TYPE: {MODEL_TYPE!r}")
    model.fit(X_train, y_train)

    preds = model.predict(X_test)
    probs = model.predict_proba(X_test)[:, 1]
    print(f"Holdout accuracy: {accuracy_score(y_test, preds):.4f}")
    print(f"Holdout ROC-AUC:  {roc_auc_score(y_test, probs):.4f}")
    n_unique_probs = len(np.unique(np.round(probs, 6)))
    print(f"Unique predicted probabilities on test set: {n_unique_probs}")
    print(f"Predicted probability range: [{probs.min():.4f}, {probs.max():.4f}]")
    if MODEL_TYPE == "logistic":
        clf = model.named_steps["classifier"]
        print(f"Classifier coefficients (scaled feature space): {np.round(clf.coef_[0], 4).tolist()}")
    else:
        importances = np.round(model.feature_importances_, 4).tolist()
        print(f"Feature importances ({', '.join(FEATURE_COLS)}): {importances}")
    if n_unique_probs <= 2:
        print("WARNING: the model is predicting almost the same probability for every row.")
        print("         This points to a degenerate fit (near-constant feature, extreme class")
        print("         imbalance, or a convergence problem), not just 'no signal in the data'.")

    # export with an explicit float32 input type matching the [1, NUM_FEATURES] shape.
    # OnnxModel.mqh pins at load time via OnnxSetInputShape. For the logistic branch this
    # converts a Pipeline (scaler + classifier both become graph nodes); for the forest
    # branch it converts the RandomForestClassifier directly.
    onnx_model = to_onnx(
        model,
        initial_types=[("float_input", FloatTensorType([None, len(FEATURE_COLS)]))],
        options={id(model): {"zipmap": False}},
        # skl2onnx wraps classifier outputs in a ZipMap (label -> {class: prob} dict) by
        # default; MQL5's OnnxRun cannot consume that structure under ONNX_NO_CONVERSION,
        # so zipmap=False forces a plain [N, 2] float32 probability tensor instead
    )

    # skl2onnx's classifier conversion emits TWO graph outputs even with zipmap=False:
    # "label" (the argmax class, int64) and "probabilities" (the [N,2] float tensor we
    # actually want). MQL5's OnnxRun binds output buffers by POSITIONAL index, and
    # OnnxModel.mqh only supplies one output buffer at index 0 - so the unwanted "label"
    # output must be removed from the graph here, leaving "probabilities" as the sole
    # (and therefore index-0) output. Without this step the EA would silently bind its
    # float probability buffer to the int64 label output and fail at OnnxRun.
    keep_outputs = [o for o in onnx_model.graph.output if o.name == "probabilities"]
    del onnx_model.graph.output[:]
    onnx_model.graph.output.extend(keep_outputs)

    with open(ONNX_OUT, "wb") as f:
        f.write(onnx_model.SerializeToString())

    print(f"Wrote {ONNX_OUT}")
    print(f"Input tensor name:  float_input, shape [None, {len(FEATURE_COLS)}], float32")
    print("Output tensor name: probabilities, shape [None, 2], float32 (column 1 = P(up))")


if __name__ == "__main__":
    main()
Проверено напрямую: при наивном экспорте проверка с помощью onnx.checker показывала два выхода — OUTPUT idx 0 label (метка класса) и OUTPUT idx 1 probabilities; после исправления остался единственный выход OUTPUT idx 0 probabilities с формой [None, 2], а проверка onnx.checker.check_model проходит без ошибок.
StandardScaler необходим для логистической регрессии, поскольку значения признаков различаются на несколько порядков: у f0/f1 они составляют около 1e-4, а у f5 — около 1–3; без масштабирования L2-регуляризация накладывала бы штрафы неравномерно. Экспорт масштабировщика и классификатора в составе единого конвейера Pipeline обеспечивает одинаковую предварительную обработку данных в Python и MQL5.
Расчет размера позиции с учетом риска
Расчет размера позиции намеренно отделен от слоев обнаружения дрейфа и инференса: для него нужны лишь расстояние до стоп-лосса и доля средств счета, выделяемая на риск, в процентах; способ получения расстояния до стоп-лосса не имеет значения.
//+------------------------------------------------------------------+
//| GetAtrStopDistance                                               |
//+------------------------------------------------------------------+
double GetAtrStopDistance(const string symbol,const ENUM_TIMEFRAMES tf,const int atr_handle)
  {
   double atr_buf[];
   ArraySetAsSeries(atr_buf,true);
   if(CopyBuffer(atr_handle,0,0,1,atr_buf) < 1)
     {
      Print("GetAtrStopDistance: CopyBuffer failed, falling back to a fixed point distance");
      //--- a hard fallback keeps the EA from placing a zero-distance stop (which most
      //--- brokers reject outright) if the indicator buffer is briefly unavailable
      return(200*_Point);
     }
   return(atr_buf[0]*RS_ATR_STOP_MULTIPLIER);
  }
//+------------------------------------------------------------------+
//| CalcLotSize                                                      |
//+------------------------------------------------------------------+
double CalcLotSize(const string symbol,const double risk_percent,const double stop_distance_price,
                    const ENUM_ORDER_TYPE direction)
  {
   double equity      = AccountInfoDouble(ACCOUNT_EQUITY);
   double risk_amount = equity * (risk_percent/100.0);

   double entry_price = (direction==ORDER_TYPE_BUY)
                         ? SymbolInfoDouble(symbol,SYMBOL_ASK)
                         : SymbolInfoDouble(symbol,SYMBOL_BID);
   double stop_price  = (direction==ORDER_TYPE_BUY)
                         ? entry_price-stop_distance_price
                         : entry_price+stop_distance_price;

//--- SYMBOL_TRADE_TICK_VALUE can misreport on some brokers/instruments (notably for
//--- non-USD-denominated or synthetic symbols), so the actual monetary loss for a
//--- 1.0-lot move is measured directly via OrderCalcProfit instead of derived from
//--- tick value arithmetic
   double loss_per_lot = 0.0;
   if(!OrderCalcProfit(direction,symbol,1.0,entry_price,stop_price,loss_per_lot))
     {
      Print("CalcLotSize: OrderCalcProfit failed, falling back to broker minimum lot");
      return(SymbolInfoDouble(symbol,SYMBOL_VOLUME_MIN));
     }
   loss_per_lot = MathAbs(loss_per_lot);
   if(loss_per_lot <= 0.0)
      return(SymbolInfoDouble(symbol,SYMBOL_VOLUME_MIN));

   double raw_lots = risk_amount / loss_per_lot;

//--- snap to the broker's allowed lot step and enforce min/max so the sized order is
//--- actually accepted rather than rejected for an invalid volume
   double lot_step = SymbolInfoDouble(symbol,SYMBOL_VOLUME_STEP);
   double lot_min  = SymbolInfoDouble(symbol,SYMBOL_VOLUME_MIN);
   double lot_max  = SymbolInfoDouble(symbol,SYMBOL_VOLUME_MAX);

   double snapped = MathFloor(raw_lots/lot_step)*lot_step;
   snapped = MathMax(lot_min,MathMin(lot_max,snapped));
   return(snapped);
  }
Денежный убыток на один лот рассчитывается с помощью OrderCalcProfit, а не арифметических операций с SYMBOL_TRADE_TICK_VALUE, поскольку стоимость тика для инструментов, номинированных не в долларах США, или синтетических инструментов может сообщаться неверно: OrderCalcProfit напрямую запрашивает у торгового сервера, каким будет убыток при движении цены от уровня входа до стоп-лосса для позиции объемом 1.0 лота. Остальные операции — приведение объема к шагу лота и ограничение минимальным и максимальным значениями — лишь обеспечивают соответствие рассчитанного объема ордера требованиям брокера.
Объединяем все компоненты: поток управления в советнике
Все описанные выше компоненты объединяются небольшим объемом координирующего кода в самом советнике.
//+------------------------------------------------------------------+
//| OnInit                                                           |
//+------------------------------------------------------------------+
int OnInit(void)
  {
//--- LoadManifest always returns true - a missing or unreadable file falls through to
//--- built-in defaults internally (see ManifestConfig.mqh) rather than failing OnInit,
//--- since this is the expected situation in a Strategy Tester agent's sandboxed Files
//--- folder. The call is still made unconditionally because it is what populates
//--- g_manifest in the first place.
   LoadManifest(BuildManifestPath(),g_manifest);

   if(!g_builder.Init(_Symbol,(ENUM_TIMEFRAMES)Period()))
     {
      Print("OnInit: CFeatureBuilder::Init failed");
      return(INIT_FAILED);
     }

//--- everything below this point in the ORIGINAL design ran here too: a probe
//--- BuildFeaturesAt() call, the 3-way contract check, detector/reference/live-window
//--- bootstrap, all inside OnInit. That was too strict - at the exact instant OnInit
//--- runs (particularly the very first tick of a Strategy Tester run), the terminal or
//--- tester agent may not yet have enough history warmed up for CopyClose/CopyBuffer to
//--- satisfy even a 20-30 bar lookback, even though the full history genuinely exists
//--- and becomes available moments later. Hard-failing OnInit in that situation aborts
//--- the entire run over what is really just a timing race, not a real problem. All of
//--- that work is deferred to TryLazyInit(), called from OnTick and retried on every
//--- closed bar until it succeeds or LAZY_INIT_MAX_ATTEMPTS is exhausted.
   if(!g_model.Load())
     {
      Print("OnInit: ONNX model load failed");
      return(INIT_FAILED);
     }

   g_atr_handle = iATR(_Symbol,(ENUM_TIMEFRAMES)Period(),FB_ATR_PERIOD);
   if(g_atr_handle==INVALID_HANDLE)
     {
      Print("OnInit: ATR handle for RiskSizing failed");
      return(INIT_FAILED);
     }

   g_last_bar_time      = 0;
   g_bars_since_check   = 0;
   g_trading_halted     = false;
   g_lazy_init_done     = false;
   g_lazy_init_attempts = 0;

   return(INIT_SUCCEEDED);
  }
OnInit намеренно выполняет лишь несколько действий: загружает манифест, создает модуль формирования признаков, загружает сеанс ONNX и создает дескриптор индикатора ATR для расчета размера позиции с учетом риска — операций, зависящих от наличия рабочего окна исторических ценовых данных, здесь больше нет. В более ранней версии советника в OnInit также выполнялись проверка согласованности количества признаков по трём источникам и полное начальное заполнение детектора и эталонного окна, но такие требования оказались слишком жесткими: в момент выполнения OnInit, особенно на первом тике нового прогона в тестере стратегий, история может быть еще недостаточно подготовлена даже для обращения к последним 20–30 барам, хотя сами данные существуют и становятся доступными спустя несколько мгновений. Прерывать весь прогон из-за гонки по времени, а не реальной проблемы, было неудачным решением.
//+------------------------------------------------------------------+
//| TryLazyInit                                                      |
//+------------------------------------------------------------------+
bool TryLazyInit(void)
  {
//--- 3-way feature contract check: build one live feature vector and compare its
//--- actual length against both the compiled NUM_FEATURES constant and the manifest's
//--- declared num_features before trusting any of the drift-detection machinery below.
//--- Returning false here (rather than failing hard) just means "not enough history
//--- YET" - OnTick will call this again on the next closed bar.
   double probe_features[];
   if(!g_builder.BuildFeaturesAt(1,probe_features))
      return(false);
   if(!ValidateManifest(g_manifest,ArraySize(probe_features)))
     {
      //--- unlike a history-timing gap, a genuine feature-count mismatch will never fix
      //--- itself by waiting - this is a real configuration error, so it is reported once
      //--- and then left to keep failing (the caller's attempt counter will eventually stop
      //--- the retries) rather than silently retrying forever on a problem more history
      //--- cannot solve
      Print("TryLazyInit: feature contract validation failed - check manifest num_features");
      return(false);
     }

   if(!g_detector.Init(g_manifest.num_features,g_manifest.reference_window_size,g_manifest.live_window_size))
      return(false);
   if(!g_detector.LoadOrBootstrapReference(BuildReferenceFilePath(),g_builder))
      return(false);
   g_detector.BootstrapLiveWindow(g_builder);

   return(true);
  }
Все операции, которым нужна история цен, отложены до вызова TryLazyInit из OnTick; попытки повторяются на каждом закрытом баре до успеха — проверка согласованности количества признаков по трём источникам, инициализация детектора и начальное заполнение окон теперь выполняются с повторными попытками, а не однократно. О настоящей ошибке конфигурации по-прежнему поступает сообщение, и при каждой повторной попытке происходит сбой, поскольку увеличение объема истории не может устранить несоответствие контрактов; параметр LAZY_INIT_MAX_ATTEMPTS служит предохранительным механизмом на случай, когда система действительно неисправна, а не просто работает медленно.
//+------------------------------------------------------------------+
//| OnTick                                                           |
//+------------------------------------------------------------------+
void OnTick(void)
  {
//--- everything in this EA - feature construction, drift scoring, inference and sizing -
//--- is defined on CLOSED bars, so intrabar ticks are ignored entirely; this also keeps
//--- CopyBuffer/CopyClose calls cheap since they only run once per bar close
   if(!IsNewBar()) return;

//--- lazy setup: retried on every closed bar until it succeeds, rather than being a
//--- one-shot check inside OnInit - see the comment on TryLazyInit() for why. Once it
//--- succeeds it is never called again for the lifetime of this EA instance.
   if(!g_lazy_init_done)
     {
      g_lazy_init_attempts++;
      if(TryLazyInit())
        {
         g_lazy_init_done = true;
         if(InpVerboseLogging)
            PrintFormat("TryLazyInit succeeded after %d closed bar(s)",g_lazy_init_attempts);
        }
      else
        {
         if(g_lazy_init_attempts >= LAZY_INIT_MAX_ATTEMPTS)
            Print("OnTick: lazy init still failing after ",LAZY_INIT_MAX_ATTEMPTS,
                  " bars - this is no longer a timing issue, check history/manifest");
         return;   // not ready yet - try again on the next closed bar
        }
     }

   double features[];
//--- shift=1 is the most recently CLOSED bar; shift=0 would still be forming and would
//--- make every feature (and therefore the drift score) non-deterministic mid-bar
   if(!g_builder.BuildFeaturesAt(1,features))
     {
      Print("OnTick: BuildFeaturesAt failed, skipping this bar");
      return;
     }

   g_detector.PushLiveSample(features);
   g_bars_since_check++;

   if(g_detector.IsReferenceReady() && g_detector.IsLiveWindowFull() &&
      g_bars_since_check >= g_manifest.recompute_every_n_bars)
     {
      g_bars_since_check = 0;
      RunDriftCheck();
     }

   if(!g_trading_halted)
      ExecuteTradeLogic(features);
  }
Каждый вектор признаков закрытого бара сразу после формирования безусловно добавляется в текущее окно детектора дрейфа — это обновление выполняется независимо от того, проводится ли на данном баре проверка дрейфа или принимается торговое решение. Вычисление оценок детектором запускается лишь раз в recompute_every_n_bars закрытых баров, поэтому большую часть времени затраты на сортировку и суммирование для восьми вычислений расстояния Вассерштейна-1 не нагружают основной путь выполнения; таким образом, настройка периодичности в манифесте служит исключительно для регулирования актуальности оценок, а не как необходимая мера обеспечения производительности.
//+------------------------------------------------------------------+
//| RunDriftCheck                                                    |
//+------------------------------------------------------------------+
void RunDriftCheck(void)
  {
   double per_feature_w1[], per_feature_normalized[];
   g_detector.ComputeDriftScores(per_feature_w1,per_feature_normalized);

   double max_stat = 0.0;
   double composite = g_detector.ComputeComposite(per_feature_normalized,g_manifest.feature_weights,max_stat);

   if(InpVerboseLogging)
      PrintFormat("DriftCheck: composite=%.3f max_stat=%.3f (warn=%.2f critical=%.2f)",
                  composite,max_stat,g_manifest.warn_threshold,g_manifest.critical_threshold);

//--- the composite AND the max-statistic are both checked against the critical band:
//--- either one alone can miss a real regime break (a broad mild shift raises the
//--- composite without any single feature standing out; a narrow severe shift in one
//--- feature can hide inside a low weighted average)
   double worst = MathMax(composite,max_stat);

   if(worst >= g_manifest.critical_threshold)
      HandleDriftAction(composite,max_stat);
   else if(worst >= g_manifest.warn_threshold)
     {
      Print("RunDriftCheck: WARNING band - composite=",DoubleToString(composite,3),
            " max_stat=",DoubleToString(max_stat,3));
      g_trading_halted = false;
     }
   else
      g_trading_halted = false;
  }
//+------------------------------------------------------------------+
//| HandleDriftAction                                                |
//+------------------------------------------------------------------+
void HandleDriftAction(const double composite,const double max_stat)
  {
   switch(g_manifest.action_mode)
     {
      case 0:
         //--- log-only mode: record the breach but let the model keep trading - useful
         //--- while calibrating thresholds before trusting the gate to halt live entries
         Print("HandleDriftAction: CRITICAL drift (log-only mode) composite=",
               DoubleToString(composite,3)," max_stat=",DoubleToString(max_stat,3));
         break;

      case 1:
         //--- halt mode: stop opening new positions until the next recompute cycle shows
         //--- the score back under the warning band; existing open positions are left alone
         //--- deliberately, since flattening on a drift signal is a separate policy decision
         Print("HandleDriftAction: CRITICAL drift - halting new entries");
         g_trading_halted = true;
         break;

      case 2:
        {
         //--- flag-for-retrain mode: drop a sentinel file the offline retraining pipeline
         //--- can poll for, rather than trying to trigger retraining from inside MQL5 itself
         int h = FileOpen("WassersteinDriftGuard\\retrain_flag_"+_Symbol+".txt",FILE_WRITE|FILE_TXT|FILE_ANSI);
         if(h!=INVALID_HANDLE)
           {
            FileWriteString(h,TimeToString(TimeCurrent())+" composite="+DoubleToString(composite,3)+
                             " max_stat="+DoubleToString(max_stat,3)+"\r\n");
            FileClose(h);
           }
         Print("HandleDriftAction: CRITICAL drift - retrain flag written");
         g_trading_halted = true;
         break;
        }

      default:
         Print("HandleDriftAction: unknown action_mode ",g_manifest.action_mode," - defaulting to halt");
         g_trading_halted = true;
         break;
     }
  }
Сводная оценка и максимальная статистика сравниваются с критической полосой; выход любого из этих показателей за ее границу вызывает HandleDriftAction. Эти три режима действий предлагают компромисс между агрессивностью реакции и простотой: log-only служит для калибровки; halt блокирует открытие новых позиций, но не затрагивает уже открытые (действия с ними определяются отдельным решением); flag-for-retrain создает сигнальный файл, наличие которого периодически проверяет внешний конвейер, вместо запуска переобучения непосредственно в MQL5.
//+------------------------------------------------------------------+
//| ExecuteTradeLogic                                                |
//+------------------------------------------------------------------+
void ExecuteTradeLogic(const double &features[])
  {
   if(PositionSelect(_Symbol)) return;   // one position at a time - keeps sizing/risk math unambiguous

   double prob_up;
   if(!g_model.Predict(features,prob_up)) return;

//--- symmetric 0.5 threshold: a fresh, well-calibrated binary classifier centers its
//--- decision boundary at 0.5, so no separate "confidence cutoff" input is needed here
   ENUM_ORDER_TYPE direction;
   if(prob_up > 0.55)      direction = ORDER_TYPE_BUY;
   else if(prob_up < 0.45) direction = ORDER_TYPE_SELL;
   else                    return;       // inside the dead zone - no edge, stay flat

   double stop_distance = GetAtrStopDistance(_Symbol,(ENUM_TIMEFRAMES)Period(),g_atr_handle) + InpFixedStopBuffer;
   double lots = CalcLotSize(_Symbol,g_manifest.risk_percent,stop_distance,direction);
   if(lots <= 0.0) return;

   double price = (direction==ORDER_TYPE_BUY) ? SymbolInfoDouble(_Symbol,SYMBOL_ASK)
                                               : SymbolInfoDouble(_Symbol,SYMBOL_BID);
   double sl = (direction==ORDER_TYPE_BUY) ? price-stop_distance : price+stop_distance;
   double tp = (direction==ORDER_TYPE_BUY) ? price+stop_distance*1.5 : price-stop_distance*1.5;

   if(direction==ORDER_TYPE_BUY)
      g_trade.Buy(lots,_Symbol,price,sl,tp,"WassersteinDriftGuard");
   else
      g_trade.Sell(lots,_Symbol,price,sl,tp,"WassersteinDriftGuard");
  }
Мертвая зона между 0.45 и 0.55 для исходной вероятности на выходе модели означает, что при прогнозе с примерно равными шансами обоих исходов сделка вообще не открывается, а не открывается с низкой уверенностью. Отдельного входного параметра «уверенность» для настройки нет, поскольку у только что откалиброванного бинарного классификатора граница принятия решения по определению уже находится на уровне 0.5.
Офлайн-конвейер: экспорт, обучение, проверка
Три компонента работают полностью вне MetaTrader, и все они используют тот же класс CFeatureBuilder, что и советник в реальной торговле, поэтому во всем проекте есть ровно одна реализация формирования вектора признаков.
//+------------------------------------------------------------------+
//| OnStart                                                          |
//+------------------------------------------------------------------+
void OnStart(void)
  {
   CFeatureBuilder builder;
   if(!builder.Init(_Symbol,(ENUM_TIMEFRAMES)Period()))
     {
      Print("ExportFeatureHistory: CFeatureBuilder::Init failed");
      return;
     }

   int handle = FileOpen(InpOutputFileName,FILE_WRITE|FILE_TXT|FILE_ANSI);
   if(handle==INVALID_HANDLE)
     {
      Print("ExportFeatureHistory: could not create ",InpOutputFileName);
      return;
     }

//--- header row documents the exact CSV column layout the Python trainer expects:
//--- f0..f7 are the 8 features in the same order BuildFeaturesAt() produces them,
//--- label is 1 if price rose over InpLabelHorizon bars, else 0
   string header = "f0,f1,f2,f3,f4,f5,f6,f7,label";
   FileWriteString(handle,header+"\r\n");

   double feat[];
   int written = 0;

//--- start at InpLabelHorizon+1 so every row has both a full feature lookback behind it
//--- AND a full forward window ahead of it to compute the label from - starting any
//--- closer to shift=0 would need unclosed/future bars that do not exist yet
   for(int shift=InpLabelHorizon+1; shift<InpBarsToExport+InpLabelHorizon+1; shift++)
     {
      if(!builder.BuildFeaturesAt(shift,feat)) break;   // ran out of history

      double close_now    = iClose(_Symbol,(ENUM_TIMEFRAMES)Period(),shift);
      double close_future = iClose(_Symbol,(ENUM_TIMEFRAMES)Period(),shift-InpLabelHorizon);
      int    label         = (close_future > close_now) ? 1 : 0;

      string row = "";
      for(int i=0;i<NUM_FEATURES;i++)
         row += DoubleToString(feat[i],8) + ",";
      row += IntegerToString(label);

      FileWriteString(handle,row+"\r\n");
      written++;
     }

   FileClose(handle);
   builder.Deinit();
   PrintFormat("ExportFeatureHistory: wrote %d rows to %s",written,InpOutputFileName);
  }
Экспортируемый CSV-файл имеет документированную фиксированную структуру столбцов: f0,f1,f2,f3,f4,f5,f6,f7,label. Каждому историческому бару соответствует одна строка; метка класса label равна 1, если через InpLabelHorizon баров цена закрытия оказалась выше цены закрытия этого бара, и 0 в противном случае. Цикл начинается с бара, отстоящего от текущего на InpLabelHorizon + 1 баров. Для каждой строки нужен полный интервал предшествующих данных для расчета признаков и полное окно последующих данных для вычисления метки класса; если начать ближе к текущему бару, понадобятся еще не сформировавшиеся бары.
def load_training_data(path: str) -> pd.DataFrame:
    # ExportFeatureHistory.mq5 opens its output file with FILE_ANSI explicitly
    # (FileOpen(..., FILE_WRITE|FILE_TXT|FILE_ANSI)), which forces MQL5 to write
    # plain single-byte text instead of its UTF-16 default - that flag is a
    # deliberate choice here, not an oversight, precisely so this file does NOT
    # need UTF-16 decoding on the Python side. Since every value in this CSV is
    # plain ASCII (digits, '.', ',', and the fixed column names), UTF-8 decodes
    # ANSI-written ASCII bytes identically - reading as "utf-16" here would (and
    # did, if you hit this before the fix) raise UnicodeDecodeError immediately,
    # because ANSI text has no UTF-16 byte-order-mark for pandas to detect.
    df = pd.read_csv(path, encoding="utf-8", sep=None, engine="python")

    # the delimiter MQL5 used follows the Windows regional setting at export time
    # (comma vs semicolon) - sep=None with the python engine lets pandas sniff it
    # instead of hard-coding an assumption that breaks on a different machine

    # defensive only: an ANSI-written file has no BOM, so this is normally a no-op,
    # but it costs nothing to keep in case the export path ever changes back to a
    # UTF-16 FileOpen mode
    df.columns = [c.replace("\ufeff", "") for c in df.columns]
    return df
Из того, что файл записывается средствами MQL5, а не универсальным средством записи CSV, следуют две особенности. В ExportFeatureHistory.mq5 намеренно используется FILE_ANSI, чтобы записывать обычный однобайтовый текст вместо используемой в MQL5 по умолчанию кодировки UTF-16. Поэтому encoding="utf-8" позволяет корректно прочитать файл, а "utf-16" вызывает UnicodeDecodeError, поскольку текст ANSI не содержит маркера порядка байтов. Разделитель определяется региональными настройками компьютера, на котором выполняется экспорт, поэтому параметры sep=None, engine="python" позволяют pandas автоматически определить его, а не исходить из заранее заданного значения.
Для обучения используется обычная логистическая регрессия: цель статьи — механизм выявления дрейфа, а не повышение точности модели прогнозирования направления движения цены. Затем выполняются экспорт и удаление лишних выходов модели, как показано выше. После создания WassersteinModel.onnx файл копируют в MQL5\Files\WassersteinDriftGuard\ и перекомпилируют советник, чтобы директива #resource включила новые веса.
def wasserstein_1d(sample_a: np.ndarray, sample_b: np.ndarray) -> float:
    # mirrors CDriftDetector::Wasserstein1D() exactly: sort both equal-size samples,
    # then take the mean absolute difference between paired order statistics
    a_sorted = np.sort(sample_a)
    b_sorted = np.sort(sample_b)
    return float(np.mean(np.abs(a_sorted - b_sorted)))
def naive_mean_std_score(reference: np.ndarray, live: np.ndarray) -> float:
    # the common alternative this script benchmarks against: how many reference
    # standard deviations has the live mean moved, ignoring shape entirely
    ref_std = reference.std()
    if ref_std <= 0:
        ref_std = 1e-8
    return float(abs(live.mean() - reference.mean()) / ref_std)
def make_shift(kind: str) -> np.ndarray:
    if kind == "none":
        return RNG.normal(loc=0.0, scale=1.0, size=WINDOW_SIZE)
    if kind == "mean_shift":
        return RNG.normal(loc=0.6, scale=1.0, size=WINDOW_SIZE)
    if kind == "variance_shift":
        return RNG.normal(loc=0.0, scale=1.8, size=WINDOW_SIZE)
    if kind == "bimodal_mixture":
        # construct a mixture with mean ~0 and variance ~1 by design, so a naive
        # mean/std detector sees almost nothing - the shift is purely in SHAPE
        half = WINDOW_SIZE // 2
        lobe_a = RNG.normal(loc=-1.4, scale=0.55, size=half)
        lobe_b = RNG.normal(loc=1.4, scale=0.55, size=WINDOW_SIZE - half)
        mixture = np.concatenate([lobe_a, lobe_b])
        RNG.shuffle(mixture)
        return mixture
    raise ValueError(kind)
def calibrate_thresholds():
    # calibrate both detectors' thresholds off the null ("no shift") distribution so
    # each is compared at roughly the SAME false-positive rate (~5%) - otherwise a
    # "more sensitive" detector could just be a looser one
    _, _, w1_null, naive_null = run_trials("none", threshold_w1=1e9, threshold_naive=1e9)
    threshold_w1 = float(np.percentile(w1_null, 95))
    threshold_naive = float(np.percentile(naive_null, 95))
    return threshold_w1, threshold_naive
Пример с бимодальной смесью специально построен так, чтобы детектор на основе моментов не выявил различий: две гауссовы компоненты с центрами в ±1.4 и одинаковым разбросом объединяют, а наблюдения перемешивают так, чтобы среднее объединенной выборки было близко к нулю, а дисперсия — к единице. По показателям, которые проверяет простейший детектор, она почти неотличима от эталонной выборки, но по форме совершенно иная. Пороги обоих детекторов калибруются по 95-му процентилю распределения статистики при отсутствии сдвига еще до запуска испытаний со сдвигом. Поэтому сравнение на рис. 2 проводится на равных условиях, при одинаковой частоте ложных срабатываний, а не за счет настройки одного из детекторов на более частое срабатывание.
Пограничные случаи и возможные проблемы
Размеры окон должны быть одинаковыми. Дискретная одномерная формула W1 предполагает отсортированные выборки одинаковой длины; при инициализации CDriftDetector::Init отклоняет конфигурацию с несовпадающими reference_window_size и live_window_size, а не молча вычисляет бессмысленное число.
ATR может равняться нулю. Бар без изменения цены в начале работы может обнулить ATR; при расчете всех признаков с делением на ATR (f3, f6, f7), а также стопа на основе ATR знаменатель ограничивается снизу малой величиной эпсилон, чтобы незаметно возникшее значение inf не испортило данные в окне.
Ограничения файловой песочницы тестера стратегий важны в двух случаях. При каждом запуске начальное заполнение эталонного окна выполняется заново (это корректное поведение при тестировании на истории, а не обходное решение). Чтобы манифест был доступен в тестере стратегий, в начале кода советника нужна директива #property tester_file "WassersteinDriftGuard\\drift_manifest.json". Иначе тестирование сразу завершится с ошибкой LoadManifest: could not open ..., даже если тот же файл есть в рабочем терминале.
CopyTickVolume требует массив-приемник типа long[]. С массивом double[] вызов не срабатывает без явного сообщения об ошибке; в FeatureBuilder.mqh переменная vol_buf объявлена как long[], а приведение к double выполняется только при использовании значения.
Это детектор только дрейфа в пространстве признаков. Он не дает полного объяснения причин ухудшения прогнозов модели: он не способен выявить дрейф целевой переменной, при котором распределения признаков остаются прежними, но истинная зависимость целевой переменной от них меняется. Совместное использование этого детектора и детектора ADWIN/Page-Hinkley из предыдущей статьи, который непосредственно отслеживает сигнал ошибки самой модели, позволяет выявлять более широкий спектр сбоев, чем использование каждого из них по отдельности.
Детектор является одномерным, а не многомерным. Каждый признак отслеживается независимо; сдвиг, проявляющийся только в корреляции между двумя признаками, не вызовет его срабатывания: распределение каждого признака по отдельности может оставаться прежним, тогда как взаимосвязь между ними меняется. Для выявления такого сдвига нужна многомерная постановка задачи оптимального транспорта с регуляризацией Синкхорна, поскольку для точного многомерного оптимального транспорта нет решения в замкнутом виде, подобного используемому в этой статье; этот случай намеренно оставлен за рамками статьи, а не упущен из виду.
Манифест считывается один раз — в OnInit. Изменения в drift_manifest.json во время работы вступят в силу только после повторного подключения советника — это сознательный компромисс в пользу простоты, поскольку горячая перезагрузка потребовала бы повторной проверки контракта признаков и согласования измененного размера окна с зафиксированным эталонным окном.
OnInit не должна завершаться с фатальной ошибкой из-за несогласованности во времени с первоначальной загрузкой истории. Прогон в тестере стратегий может немедленно прерваться из-за недостаточного объема загруженной истории даже для символа с данными за несколько лет: в момент выполнения OnInit загрузка истории может еще не завершиться. См. TryLazyInit в разделе об управлении потоком выполнения советника.
Режимы действий предусматривают осторожный подход к уже открытым позициям. Режимы Halt и flag-for-retrain не затрагивают открытые позиции: закрытие всех позиций по сигналу дрейфа — отдельное решение по управлению рисками, которое этот советник не принимает за вас, хотя при необходимости такую логику можно добавить в HandleDriftAction с небольшими изменениями.
Тестирование в тестере стратегий
Для проверки этой архитектуры необходимо сравнить на одном и том же историческом интервале базовый прогон (модель ONNX торгует без мониторинга, action_mode = 0) и прогон с фильтром дрейфа (та же модель, action_mode = 1, новые входы блокируются всякий раз, когда сводная оценка или максимальная статистика превышает критический порог).
| настройка | Значение |
|---|---|
| Символ / Период | XAUUSD / M5 |
| Период тестирования | 01.01.2026 – 25.08.2026 (8 месяцев, качество истории 100 %) |
| reference_window_size / live_window_size | 250 / 250 |
| recompute_every_n_bars | 10 |
| warn_threshold / critical_threshold | 1.5 / 2.5 |
| risk_percent | 0.5 |
| Моделирование | Каждый тик на основе реальных тиков |
В обоих прогонах использовалась одна и та же модель случайного леса из приведенного выше раздела о проектировании признаков — это проверка того, снижает ли фильтр дрейфа ущерб, а не того, повышает ли он альфу.
| Показатель | Базовый прогон | С фильтром дрейфа |
|---|---|---|
| Общее количество сделок | 2 983 | 2 749 |
| Чистая прибыль | −3 892.17 доллара | -3 429.13 доллара |
| Профит-фактор | 0.95 | 0.95 |
| Максимальная просадка баланса | 55.57 % | 54.66 % |
| Математическое ожидание выигрыша на сделку | -1.30 доллара | -1.25 доллара |
| Коэффициент Шарпа | -2.01 | -1.82 |
| Процент выигрышных сделок | 38.65 % | 38.92 % |
Базовый вариант в сравнении с вариантом с фильтром дрейфа: результаты тестера стратегий

Рис. 4. Фактические результаты тестера стратегий за тот же 8-месячный период для XAUUSD на таймфрейме M5: чистая прибыль и максимальная просадка баланса для базового варианта и варианта с фильтром дрейфа.
Фильтр дрейфа не сделал стратегию прибыльной — профит-фактор остался на уровне 0.95 в обоих прогонах, — но снизил частоту торговли (на 234 сделки меньше), чистый убыток (на 11.9 %), просадку, а коэффициент Шарпа улучшился с −2.01 до −1.82. Это согласуется с тем, что фильтр дрейфа ограничивает подверженность риску, а не создает альфу.
Заключение
В этой статье представлен практический детектор дрейфа в пространстве признаков для работающих систем MQL5, основанный на одномерном расстоянии Вассерштейна-1. Поскольку в одномерном случае задача сводится к сортировке и попарному сопоставлению по рангам, метод достаточно экономичен по вычислительным затратам, чтобы применять его к каждому признаку внутри советника, и при этом чувствителен к изменениям только формы распределения, которые не выявляются при мониторинге среднего и стандартного отклонения, — что подтверждено на синтетических данных: 100 % против 1 % обнаружений при сдвиге бимодальной смеси.
Реализация добавляет вокруг модели ONNX управляющий слой на основе манифеста с сохраняемыми эталонными окнами, отложенной инициализацией, обеспечивающей безопасный запуск, и настраиваемыми действиями. Результаты тестера стратегий показали умеренное снижение ущерба, а не создание альфы — именно этого и следовало ожидать с учетом слабой модели прогнозирования направления, недостатки которой в статье честно отмечались, а не замалчивались.
Главное ограничение — область применения: это детектор дрейфа в пространстве признаков, анализирующий каждый признак отдельно, а не решение для многомерного анализа или выявления дрейфа целевой переменной. Тем не менее, главный вывод прост: неизменные средние значения не означают неизменных распределений.
| Файл | Тип | Описание |
|---|---|---|
| WassersteinDriftGuard_EA.mq5 | Советник | Основной советник: объединяет модуль формирования признаков, детектор дрейфа, модель ONNX и модуль расчета размера позиции с учетом риска; реализует логику выполнения OnTick. |
| FeatureBuilder.mqh | Подключаемый файл | Формирует фиксированный 8-мерный вектор признаков, используемый советником, при начальном заполнении эталонного окна и модулем экспорта в CSV. |
| WassersteinDetector.mqh | Подключаемый файл | Детектор дрейфа по отдельным признакам на основе расстояния Вассерштейна-1: управление эталонным и текущим окнами, расчет сводной оценки. |
| ManifestConfig.mqh | Подключаемый файл | Минимальный загрузчик JSON-манифеста и трехсторонняя проверка согласованности контракта признаков. |
| RiskSizing.mqh | Подключаемый файл | Расстояние до стоп-лосса на основе ATR и расчет размера лота с помощью OrderCalcProfit. |
| OnnxModel.mqh | Подключаемый файл | Обертка сеанса ONNX с моделью, встроенной через #resource, для формирования сигнала направления. |
| ExportFeatureHistory.mq5 | Скрипт | Экспортирует исторические векторы признаков и метки класса на основе будущей доходности в CSV-файл для обучения. |
| drift_manifest.json | Настройки | Пороги, веса и режим действия, настраиваемые во время выполнения, считываются в функции OnInit. |
| WassersteinModel.onnx | Модель | Обученный и экспортированный классификатор ONNX, встроенный в советник на этапе компиляции (веса демонстрационные — переобучите модель на собственных экспортированных данных). |
| train_export_onnx.py | Python | Обучает классификатор на основе логистической регрессии и экспортирует его в формат ONNX с удалением выхода метки класса. |
| synthetic_shift_validation.py | Python | Автономная проверка, сравнивающая обнаружение сдвигов распределения с помощью расстояния Вассерштейна-1 и простого метода на основе среднего и стандартного отклонения на синтетических данных; формирует рис. 2. |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/24449
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


