

Нейронные аддитивные модели в MQL5: Точное определение вклада признаков в торговый сигнал
 38
 1

Введение
Любой метод обеспечения объяснимости, применяемый к торговой модели постфактум, дает обещание, которое не может полностью выполнить. Значения SHAP приближенно описывают работу сети типа "черный ящик" посредством возмущения входных данных и усреднения полученного эффекта. На графиках частичной зависимости используется усреднение по фоновому набору данных в надежде, что взаимодействия нивелируются. Оба подхода полезны, и оба представляют собой предположения о модели, реальные внутренние вычисления которой никто не может напрямую продемонстрировать.
Нейронная аддитивная модель (NAM) полностью исключает необходимость в догадках. Вместо одной полносвязной сети, в которой уже ко второму слою каждый вход оказывается связан со всеми остальными, NAM выделяет каждому признаку собственную небольшую подсеть, а итоговый прогноз представляет собой просто сумму выходов этих подсетей. Этап аппроксимации отсутствует, поскольку аппроксимировать нечего — вклад признака i в прогноз буквально равен выходу подсети i. Постройте график — и вы увидите собственную внутреннюю арифметику модели, а не ее реконструкцию.
В этой статье представлена реализация данной архитектуры для MetaTrader 5. В ней модель NAM с пятью признаками обучается в PyTorch, экспортируется в ONNX и запускается в советнике, который на каждом закрытом баре считывает как сигнал, так и точный вклад каждого признака. К статье прилагаются три файла: подключаемый файл с классом-оберткой для модели ONNX, сам советник и скрипт Python для обучения и экспорта. Ниже каждый из них подробно разбирается с приведением реального кода, а не только словесного описания.
Примечание о рамках статьи: предполагается, что читатель знаком с интеграцией ONNX в MQL5 (OnnxCreateFromBuffer, OnnxRun) и с обучением небольшой нейронной сети в PyTorch. В статье не разбираются с нуля алгоритм обратного распространения ошибки и тензорный формат ONNX.
Это важно не только ради концептуальной стройности — есть и практическая причина. Большинство советников на основе машинного обучения используют модель лишь как генератор сигналов: на выходе получается число, торговая операция совершается или нет, а ответ на вопрос "почему" остается разве что в том, как выглядела кривая функции потерь в скрипте обучения несколько недель назад. Все хорошо, пока модель не начинает вести себя странно на реальном счете — и тогда оператору приходится отлаживать "черный ящик", имея в распоряжении лишь входные данные и выходные результаты. Модель NAM раскрывает промежуточное звено этой цепочки: она показывает, насколько каждый вход изменяет выход и в каком направлении. Все это происходит в рамках того же прямого прохода, без отдельного этапа объяснения результата.
Это не снимает стандартных оговорок. Модель NAM по-прежнему зависит от качества признаков, может переобучаться на небольших наборах данных и требует проверки своих функций формы на вневыборочных данных перед использованием в реальной торговле. Она устраняет лишь один конкретный тип сбоя: ситуацию, когда атрибуция незаметно перестает соответствовать модели, как только кто-то пытается разобраться в ней подробно.
Архитектура и математика
Обобщенная аддитивная модель, появившаяся за несколько десятилетий до того, как нейронные сети стали применяться на практике, предсказывает результат как сумму одномерных функций — по одной на каждый признак
g(y) = beta + f_1(x_1) + f_2(x_2) + ... + f_K(x_K)
где g — функция связи (здесь — тождественная функция, поскольку советник рассматривает выход модели как непрерывный сигнал направления, а не как вероятность), а каждая функция f_i подбирается независимо от остальных, используя только свой признак. Традиционно эти функции f_i представляли собой сплайны или деревья с бустингом. Нейронная аддитивная модель заменяет каждую функцию f_i небольшой нейронной сетью — достаточно выразительной, чтобы выучить действительно нелинейную форму зависимости, но устроенной так, что она не может учитывать никакие признаки, кроме своего единственного.
Именно в этом структурном ограничении и заключается весь смысл. Обычная полносвязная сеть с пятью входами и одним скрытым слоем легко научится учитывать, что влияние RSI меняется в зависимости от динамики объема. Это настоящее взаимодействие, но из-за него вопрос "каков вклад RSI?" становится некорректно поставленным. Модель NAM не может выучить это взаимодействие, даже если оно присутствует в данных, поскольку у f_1 (подсети RSI) нет доступа к признаку объема. Компромисс заключается в ограничении выразительности в обмен на то, что вклад всегда однозначно определен. В исходной статье о NAM показано, что на табличных данных этот компромисс приводит к на удивление небольшой потере точности по сравнению с деревьями с бустингом. В данной статье делается ставка на то, что это справедливо и для торгового сигнала на основе пяти признаков.
На вход модели подаются пять признаков, выбранных так, чтобы охватить импульс, возврат к среднему, динамику объема, издержки исполнения и время в пределах торговой сессии. Эти источники намеренно разнородны, чтобы атрибуция по признакам раскрывала действительно разные аспекты их влияния:
x1 (FEATURE_RSI_NORM) = нормализованный RSI, пересчитанный из диапазона [0,100] в диапазон [-1,1]
x2 (FEATURE_ATR_MOMENTUM) = изменение цены закрытия за один бар, деленное на ATR (импульс, нормализованный по волатильности)
x3 (FEATURE_VOLUME_ZSCORE) = z-оценка тикового объема за скользящее окно из 20 баров
x4 (FEATURE_SPREAD_RANGE) = текущий спред, деленный на ATR (влияние издержек исполнения)
x5 (FEATURE_SESSION_SIN) = sin(2*pi*hour/24) — циклическое кодирование времени суток
Каждая подсеть f_i в этой реализации состоит из слоя ExU (экспоненциальный блок) и следующего за ним линейного выходного слоя. Именно такую архитектуру авторы статьи о NAM предлагают для резко меняющихся, нестационарных входных данных, отмечая, что в таких условиях обычные подсети с ReLU склонны выучивать чрезмерно сглаженные функции формы. Этот вывод получен в сравнительных испытаниях на табличных данных в исходной статье, а не в абляционном эксперименте по сравнению ExU и ReLU на данном торговом наборе данных с пятью признаками. Поэтому сделанный здесь выбор следует понимать как следование обоснованию архитектуры из исходной статьи, а не как результат, независимо подтвержденный на этих данных. Блок ExU центрирует входные данные относительно обучаемого смещения и масштабирует их, умножая на экспоненту веса, перед применением ReLU
y = ReLU( exp(w) * (x - b) )Экспоненцирование веса позволяет одному параметру уже на ранних этапах обучения охватывать гораздо больший эффективный диапазон значений, чем при использовании линейного веса. На практике это дает функции формы с более резкими переходами вместо плоских, усредненных кривых, к которым обычно сходятся обычные блоки ReLU. Обратная сторона — чувствительность к скорости обучения: при слишком высокой скорости экспонента веса взрывным образом растет; поэтому в скрипте обучения по умолчанию задана осторожно выбранная скорость 1e-3 и используется затухание весов.
Пять независимых подсетей: суммирование в единый сигнал
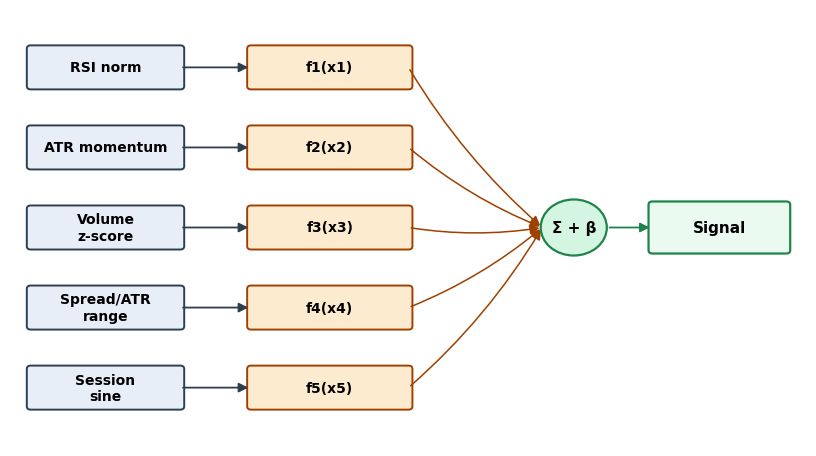
Рис. 1. Аддитивная архитектура: пять независимых подсетей, по одной на каждый признак, выходы которых суммируются в единый сигнал.
Одно проектное решение стоит обосновать отдельно: функция связи g — тождественная функция, а не сигмоида. Сигмоида на выходе представляла бы прогноз как вероятность направления движения — более привычный вариант для торгового сигнала, однако у него есть существенный недостаток, специфичный для аддитивных моделей: сигмоида сжимает сумму после того, как аддитивная структура уже выполнила свою работу, поэтому две совершенно разные комбинации вкладов признаков могут давать одну и ту же вероятность после сжатия.
В целом это небольшая потеря информации, но здесь она особенно нежелательна: число, выведенное как "вклад импульса, нормированного на ATR", уже не отражало бы напрямую, насколько этот признак изменил итоговую вероятность, — в интерпретацию вмешивалась бы кривизна самой сигмоиды. Если оставить g тождественной функцией, проверка порога в советнике (InpSignalThreshold) будет выполняться непосредственно для аддитивной суммы, а каждый вклад, выводимый на график, будет выражен в той же линейной шкале, что и сам порог.
Выбор именно пяти признаков — также сознательное ограничение, а не попытка составить исчерпывающий набор признаков. Каждому дополнительному признаку соответствует полностью независимая подсеть со своими весами, поэтому требования к объему обучающих данных растут примерно линейно с числом признаков. В NAM нельзя в той же мере, что и в регуляризованной полносвязной сети, рассчитывать на то, что "модель сама разберется, какие признаки важны": подсети разных признаков не используют общую моделирующую емкость. Было решено, что для небольшого обучающего набора лучше использовать пять максимально различных признаков (импульс, возврат к среднему, объем, издержки, время), чем пятнадцать признаков с большим количеством взаимно избыточной информации, для некоторых из которых в итоге получились бы зашумленные, недостаточно обученные функции формы.
Кроме того, стоит точно определить, что именно подразумевается под термином "интерпретируемый" в данном контексте, а что — нет. Модель NAM точно показывает, какой вклад каждый признак внес в данный прогноз. Она не объясняет, почему функция формы признака выглядит именно так, с точки зрения причинных механизмов рынка: человеку по-прежнему нужно изучить построенную кривую и осмыслить ее, подобно тому как статистик интерпретирует сплайн, подогнанный по данным. Эта архитектура устраняет один уровень неопределенности ("Точно ли эта атрибуция отражает то, что вычислила модель?"), позволяя рассматривать оставшийся, более сложный вопрос ("Имеет ли эта зависимость экономический смысл?") непосредственно по кривой, которая гарантированно отражает фактические вычисления модели.
NAMEngine.mqh: конструирование признаков и интерфейс ONNX
CNAMEngine — полноценная обертка модели: этот класс управляет буфером признаков, загружает вычислительный граф ONNX, выполняет прямой проход и возвращает как сигнал, так и вклады отдельных признаков. Ключевую роль играют шесть методов. Ниже каждый из них разобран с приведением его фактического кода.
Перечисление признаков и объявление класса. Заданный здесь порядок служит единственным эталоном для этого файла и скрипта обучения на Python: вычислительный граф ONNX обучался на признаках именно в таком порядке, и это соответствие обеспечивается лишь ручным согласованием двух файлов.
//+------------------------------------------------------------------+
//| Feature index enumeration                                        |
//| Fixes the ordering of the NAM's additive inputs. The ONNX graph  |
//| was trained with features in exactly this order, so this enum is |
//| the single source of truth shared between the Python training    |
//| script and the EA.                                               |
//+------------------------------------------------------------------+
enum ENUM_NAM_FEATURE
  {
   FEATURE_RSI_NORM = 0,   // Normalized RSI, mapped from [0,100] to [-1,1]
   FEATURE_ATR_MOMENTUM,   // Bar-to-bar close change, scaled by ATR
   FEATURE_VOLUME_ZSCORE,  // Tick volume z-score over a rolling window
   FEATURE_SPREAD_RANGE,   // Current spread, scaled by ATR
   FEATURE_SESSION_SIN,    // Sine encoding of the hour within the trading day
   NAM_FEATURE_COUNT       // Sentinel: total feature count, not a real feature
  };

//+------------------------------------------------------------------+
//| CNAMEngine                                                       |
//| Wraps the trained Neural Additive Model ONNX graph. Owns the     |
//| feature buffer, runs one forward pass per call, and exposes both |
//| the summed signal and each feature's individual additive         |
//| contribution so the EA can display true, non-approximated        |
//| attribution on the chart.                                        |
//+------------------------------------------------------------------+
class CNAMEngine
  {
private:
   long              m_onnx_handle;                     // Handle to the ONNX NAM graph
   bool              m_is_ready;                        // True once Init() has succeeded
   double            m_signal;                          // g(y) = beta + sum(f_i), last computed
   double            m_contrib[NAM_FEATURE_COUNT];      // Last per-feature f_i(x_i) values
   double            m_feature_vec[NAM_FEATURE_COUNT];  // Last built ONNX input vector

public:
                     CNAMEngine(void);
                    ~CNAMEngine(void);

   bool              Init(const uchar &model_buffer[]);
   bool              BuildFeatureVector(const string symbol,const ENUM_TIMEFRAMES tf,const int shift,
                                         const int rsi_handle,const int atr_handle);
   bool              Run(void);
   double            Signal(void)                    const { return(m_signal); }
   double            Contribution(const int feature) const;
   bool              IsReady(void)                   const { return(m_is_ready); }
   void              Release(void);
  };
BuildFeatureVector — пять аддитивных входных признаков, считываемых с фиксированным смещением. Это связующее звено между рыночными данными MetaTrader и входным тензором, который ожидает вычислительный граф ONNX. Функция принимает явно заданный аргумент shift, а не всегда считывает текущий бар: OnTick() в разделе 4 вызывает ее с shift=1, то есть для последнего полностью закрытого бара, поэтому сигнал никогда не рассчитывается по бару, который еще может измениться. Для каждого из пяти признаков предусмотрено вычисление с защитной проверкой: вместо ошибки деления на ноль возвращается резервное значение, равное ровно 0.0:
//+------------------------------------------------------------------+
//| CNAMEngine::BuildFeatureVector                                   |
//| Reads indicator and price data at the given shift and writes     |
//| the five NAM inputs, in the exact FEATURE_* order the model was  |
//| trained on. shift=1 is the last closed bar; OnTick() never calls |
//| this with shift=0, so a signal is never built from a bar that    |
//| can still repaint.                                               |
//+------------------------------------------------------------------+
bool CNAMEngine::BuildFeatureVector(const string symbol,const ENUM_TIMEFRAMES tf,const int shift,
                                     const int rsi_handle,const int atr_handle)
  {
   double rsi_buf[],atr_buf[],close_buf[];
   long   vol_buf[];

//--- pull just enough history, starting at shift, for the rolling
//--- volume z-score (20 bars)
   if(CopyBuffer(rsi_handle,0,shift,1,rsi_buf) < 1 ||
      CopyBuffer(atr_handle,0,shift,1,atr_buf) < 1 ||
      CopyClose(symbol,tf,shift,2,close_buf)   < 2 ||
      CopyTickVolume(symbol,tf,shift,20,vol_buf) < 20)
     {
      //--- any missing history means this tick is skipped, not faked
      return(false);
     }

//--- feature 0: RSI rescaled from [0,100] to [-1,1]
   m_feature_vec[FEATURE_RSI_NORM] = (rsi_buf[0] - 50.0) / 50.0;

//--- feature 1: one-bar momentum, normalized by ATR so it is comparable
//--- across symbols and volatility regimes
   if(atr_buf[0] > 0.0)
      m_feature_vec[FEATURE_ATR_MOMENTUM] = (close_buf[1] - close_buf[0]) / atr_buf[0];
   else
      m_feature_vec[FEATURE_ATR_MOMENTUM] = 0.0;
Для остальных трех признаков используется та же схема вычислений с защитными проверками. Эта защита нужна не для вида: на неликвидном инструменте при пропуске данных ATR вполне может принимать значение 0.0, а если в NAM подать NaN или бесконечность в качестве одного из признаков, вся сумма даст сигнал NaN, а не только соответствующая подсеть — аддитивная структура, обеспечивающая прозрачность атрибуции, также означает, что один некорректный вход искажает весь результат. При расчете z-оценки объема используется скользящее окно. Объем торгов подвержен смене режимов, поэтому при использовании фиксированного долгосрочного базового уровня нормальные изменения воспринимались бы как устойчивые выбросы.
//--- feature 2: volume z-score over the same 20-bar window used to
//--- compute the mean and standard deviation below
   double vol_mean = 0.0;
   for(int i = 0; i < 20; i++)
      vol_mean += (double)vol_buf[i];
   vol_mean /= 20.0;

   double vol_var = 0.0;
   for(int i = 0; i < 20; i++)
     {
      //--- nested one level in: this loop body belongs to the 'for' above
      double d = (double)vol_buf[i] - vol_mean;
      vol_var += d * d;
     }
   double vol_std = MathSqrt(vol_var / 20.0);

   if(vol_std > 0.0)
      m_feature_vec[FEATURE_VOLUME_ZSCORE] = ((double)vol_buf[19] - vol_mean) / vol_std;
   else
      m_feature_vec[FEATURE_VOLUME_ZSCORE] = 0.0;

//--- feature 3: current spread versus the ATR, catching wide-spread bars
//--- that a plain price-action feature would miss. MT5 does not keep a
//--- historical spread series, so this one input is always the live
//--- spread even when shift>0 — see the edge-cases section for why that
//--- stops this one feature's contribution from being trusted on history
   double spread_points = (double)SymbolInfoInteger(symbol,SYMBOL_SPREAD) *
                          SymbolInfoDouble(symbol,SYMBOL_POINT);
   if(atr_buf[0] > 0.0)
      m_feature_vec[FEATURE_SPREAD_RANGE] = spread_points / atr_buf[0];
   else
      m_feature_vec[FEATURE_SPREAD_RANGE] = 0.0;

//--- feature 4: sine-encoded hour of the bar at shift (not the wall-clock
//--- hour), giving the model a smooth, cyclical sense of session time
//--- instead of a discontinuous 23->0 jump
   MqlDateTime dt;
   TimeToStruct(iTime(symbol,tf,shift),dt);
   m_feature_vec[FEATURE_SESSION_SIN] = MathSin(2.0 * M_PI * dt.hour / 24.0);

   return(true);
  }
Init — загрузка встроенной модели. Здесь сеанс инференса создается из буфера в памяти — намеренно без использования пути к файлу, и причину стоит пояснить отдельно: тестер стратегий выполняет каждый проход оптимизации в отдельном агенте, а у каждого агента есть собственная изолированная папка Files\, отдельная от папки рабочего терминала. При загрузке модели по пути к файлу этот путь может разрешаться по-разному при работе на графике в реальном времени и при запуске в тестере стратегий. Встраивание байтов модели с помощью #resource и их загрузка с помощью OnnxCreateFromBuffer полностью устраняет зависимость от пути к файлу.
//+------------------------------------------------------------------+
//| CNAMEngine::Init                                                 |
//| Creates the ONNX session from an in-memory buffer (a             |
//| #resource-embedded model, per this project's convention of       |
//| avoiding Strategy Tester agent-sandbox file-path issues) and     |
//| fixes the input/output tensor shapes so OnnxRun never has to     |
//| guess them at runtime.                                           |
//+------------------------------------------------------------------+
bool CNAMEngine::Init(const uchar &model_buffer[])
  {
   m_onnx_handle = OnnxCreateFromBuffer(model_buffer,ONNX_DEFAULT);
   if(m_onnx_handle == INVALID_HANDLE)
     {
      //--- nested one level in from the 'if' that guards it
      PrintFormat("CNAMEngine::Init: OnnxCreateFromBuffer failed, error %d",GetLastError());
      m_is_ready = false;
      return(false);
     }

//--- fix the input shape: batch size 1, NAM_FEATURE_COUNT additive inputs
   const long input_shape[] = {1,NAM_FEATURE_COUNT};
   if(!OnnxSetInputShape(m_onnx_handle,0,input_shape))
     {
      Release();
      return(false);
     }

//--- two outputs: index 0 is the summed signal, index 1 is the
//--- per-feature contribution vector used for attribution display
   const long signal_shape[]   = {1,1};
   const long contrib_shape[]  = {1,NAM_FEATURE_COUNT};
   if(!OnnxSetOutputShape(m_onnx_handle,0,signal_shape) ||
      !OnnxSetOutputShape(m_onnx_handle,1,contrib_shape))
     {
      Release();
      return(false);
     }

   m_is_ready = true;
   return(true);
  }
В этом движке намеренно не используется флаг ONNX_NO_CONVERSION. Использование этого флага потребовало бы объявлять и входные, и выходные матрицы как matrix<float>, а не как используемые здесь обычные массивы double, а также заранее задавать размер каждой выходной матрицы перед вызовом — это два дополнительных источника возможных ошибок для модели с пятью признаками, которой более строгий контроль типов ничего не дает. Автоматическое преобразование из double в float при использовании ONNX_DEFAULT приводит к пренебрежимо малой потере точности для входных данных, уже масштабированных примерно до диапазона [-2, 2].
Run — прямой проход и считывание результатов атрибуции. Именно наличие двух выходов позволяет получать атрибуцию без дополнительных затрат при инференсе. Большинство советников, использующих ONNX, экспортируют лишь одно скалярное значение. Выходной тензор contributions этой модели нужен исключительно для того, чтобы вторая часть аддитивной суммы была доступна без второго прямого прохода и каких-либо постфактум-оценок
//+------------------------------------------------------------------+
//| CNAMEngine::Run                                                  |
//| Runs one ONNX forward pass over the current feature vector and   |
//| reads back both outputs. Because a NAM's second output is the    |
//| individual f_i(x_i) values by construction, no separate          |
//| explainability pass is needed here — attribution comes for free  |
//| with the prediction.                                             |
//+------------------------------------------------------------------+
bool CNAMEngine::Run(void)
  {
   if(!m_is_ready)
      return(false);

   double input_matrix[1][NAM_FEATURE_COUNT];
   for(int i = 0; i < NAM_FEATURE_COUNT; i++)
      input_matrix[0][i] = m_feature_vec[i];

   double signal_out[1][1];
   double contrib_out[1][NAM_FEATURE_COUNT];

   if(!OnnxRun(m_onnx_handle,ONNX_DEFAULT,input_matrix,signal_out,contrib_out))
     {
      PrintFormat("CNAMEngine::Run: OnnxRun failed, error %d",GetLastError());
      return(false);
     }

//--- unpack: signal is the single scalar, contributions map 1:1 to
//--- FEATURE_* indices by the order the model was trained on
   m_signal = signal_out[0][0];
   for(int i = 0; i < NAM_FEATURE_COUNT; i++)
      m_contrib[i] = contrib_out[0][i];

   return(true);
  }
Contribution и Release. Два оставшихся метода невелики, но оба важны: Contribution() при недопустимом индексе возвращает 0.0, а не вызывает ошибку, поскольку используется в коде отображения на графике. Release() можно безопасно вызывать многократно, в том числе из деструктора после явного вызова в OnDeinit()
//+------------------------------------------------------------------+
//| CNAMEngine::Contribution                                         |
//| Returns the last-computed additive contribution for one feature. |
//| Out-of-range indices return 0.0 rather than trapping, since this |
//| is called from chart-display code where a bad index should       |
//| degrade gracefully, not crash the EA.                            |
//+------------------------------------------------------------------+
double CNAMEngine::Contribution(const int feature) const
  {
   if(feature < 0 || feature >= NAM_FEATURE_COUNT)
      return(0.0);
   return(m_contrib[feature]);
  }

//+------------------------------------------------------------------+
//| CNAMEngine::Release                                              |
//| Frees the ONNX handle exactly once. Safe to call multiple times, |
//| including from the destructor after an explicit Release() in     |
//| OnDeinit().                                                      |
//+------------------------------------------------------------------+
void CNAMEngine::Release(void)
  {
   if(m_onnx_handle != INVALID_HANDLE)
     {
      OnnxRelease(m_onnx_handle);
      m_onnx_handle = INVALID_HANDLE;
     }
   m_is_ready = false;
  }
Интеграция советника: NAM_SignalAttribution_EA.mq5
Сам советник намеренно содержит минимум логики. Вся логика модели реализована в CNAMEngine. Задача советника — управлять последовательностью действий, исполнять торговые операции и — ради чего, собственно, и написана эта статья — выводить разложение сигнала на график до принятия любого торгового решения.
Подключаемые файлы. Стандартный вспомогательный класс для торговли и собственный класс-обертка ONNX этого проекта:
//+------------------------------------------------------------------+
//| Includes                                                         |
//| Standard trade helper plus this project's own ONNX wrapper class.|
//+------------------------------------------------------------------+
#include <Trade\Trade.mqh>                      // Order sending/modification helper (CTrade)
#include <NAM_SignalAttribution\NAMEngine.mqh>  // CNAMEngine: ONNX NAM wrapper
Модель как встроенный ресурс. Обученная модель NAM встроена непосредственно в скомпилированный файл .ex5, поэтому советник не зависит от пути к файлу во время выполнения — причина та же, что и в разделе 3: ограничения песочницы тестера стратегий:
//+------------------------------------------------------------------+
//| Embedded model resource                                          |
//| The trained NAM, embedded directly into the compiled .ex5 so the |
//| EA never depends on a runtime file path — this sidesteps the     |
//| Strategy Tester agent sandbox having its own isolated Files\     |
//| folder.                                                          |
//+------------------------------------------------------------------+
#resource "\\Files\\NAM_SignalAttribution\\nam_model.onnx" as uchar ExtModel[]  // Raw ONNX bytes, read by CNAMEngine::Init()
Входные параметры. Сгруппированы по назначению: сначала пороговое значение, затем параметры размера позиции и риска, затем периоды двух индикаторов, данные которых использует BuildFeatureVector(). InpSignalThreshold — единственный параметр, который подбирается на основе измеренного выхода модели с помощью LogSignalDiagnostics() в разделе 7. Для InpLots, InpStopLossPoints и InpTakeProfitPoints такая оценка не проводится: это фиксированные демонстрационные значения, выбранные для сопоставимости прогонов в тестере стратегий в разделе 7 для четырех комбинаций символа и таймфрейма, а не результат оптимизации размера позиции или SL/TP. Анализ чувствительности с перебором значений этих трех параметров указан в заключении как будущая задача, а не как уже учтенная составляющая численных результатов статьи:
//+------------------------------------------------------------------+
//| Input parameters                                                 |
//| Grouped by purpose: signal thresholding first, then risk sizing, |
//| then the two indicator periods BuildFeatureVector() reads from.  |
//+------------------------------------------------------------------+
input double   InpSignalThreshold  = 0.03;   // Set empirically via LogSignalDiagnostics(), not guessed
input double   InpLots             = 0.10;   // Demo-fixed lot size, not optimized
input int      InpStopLossPoints   = 500;    // Demo-fixed stop loss, in points, not optimized
input int      InpTakeProfitPoints = 800;    // Demo-fixed take profit, in points, not optimized
input int      InpMagicNumber      = 26011;  // Unique EA identifier for trade filtering
input int      InpRSIPeriod        = 14;     // Period for the RSI feature input
input int      InpATRPeriod        = 14;     // Period for the ATR feature input
Глобальное состояние. Один экземпляр движка NAM, один вспомогательный объект для торговли и два дескриптора индикаторов, которые нужны движку на каждом тике:
//+------------------------------------------------------------------+
//| Global state                                                     |
//| One NAM engine instance, one trade helper, and the two indicator |
//| handles the engine needs on every tick. All are set up once in   |
//| OnInit() and torn down once in OnDeinit().                       |
//+------------------------------------------------------------------+
CNAMEngine        ExtEngine;       // The NAM wrapper: forward pass + attribution
CTrade            ExtTrade;        // Standard trade-execution helper
int               ExtRSIHandle;    // Handle for the RSI indicator
int               ExtATRHandle;    // Handle for the ATR indicator
datetime          ExtLastBarTime;  // Guards one decision per closed bar
OnInit и OnDeinit. Сбой в OnInit() считается фатальной ошибкой: советник отказывается запускаться, чтобы не торговать с частично инициализированной моделью. OnDeinit() освобождает все открытые советником дескрипторы, поскольку незакрытые дескрипторы индикаторов накапливаются при повторных проходах оптимизации в тестере стратегий
//+------------------------------------------------------------------+
//| OnInit                                                           |
//| Creates the indicator handles, loads the embedded ONNX NAM graph,|
//| and configures the trade helper. Any failure here is fatal: the  |
//| EA refuses to run rather than trade on a half-initialized model. |
//+------------------------------------------------------------------+
int OnInit(void)
  {
   ExtRSIHandle = iRSI(_Symbol,_Period,InpRSIPeriod,PRICE_CLOSE);
   ExtATRHandle = iATR(_Symbol,_Period,InpATRPeriod);
   if(ExtRSIHandle == INVALID_HANDLE || ExtATRHandle == INVALID_HANDLE)
     {
      Print("OnInit: failed to create RSI/ATR indicator handles");
      return(INIT_FAILED);
     }

//--- the model bytes live in ExtModel[] via #resource above, so no
//--- file path resolution is needed even inside the Tester sandbox
   if(!ExtEngine.Init(ExtModel))
     {
      Print("OnInit: CNAMEngine failed to load the ONNX model");
      return(INIT_FAILED);
     }

   ExtTrade.SetExpertMagicNumber(InpMagicNumber);
   ExtLastBarTime = 0;

   return(INIT_SUCCEEDED);
  }

//+------------------------------------------------------------------+
//| OnDeinit                                                         |
//| Releases the ONNX handle and the two indicator handles. Indicator|
//| handles are cheap but not free, and leaving them open across     |
//| repeated optimization passes in the Strategy Tester adds up.     |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
  {
   ExtEngine.Release();
   if(ExtRSIHandle != INVALID_HANDLE)
      IndicatorRelease(ExtRSIHandle);
   if(ExtATRHandle != INVALID_HANDLE)
      IndicatorRelease(ExtATRHandle);
  }
OnTick — цикл принятия решений. Выполняет всю последовательность от построения вектора признаков до торговой операции один раз на каждый закрытый бар, а не на каждый тик: проверка времени бара в начале обработчика немедленно завершает его выполнение на каждом тике, кроме первого тика нового бара. Затем вызывается BuildFeatureVector() с shift=1 — для только что закрывшегося бара, а не для еще формирующегося, — после чего выполняются прямой проход, вывод атрибуции и проверка порога и наличия позиции
//+------------------------------------------------------------------+
//| OnTick                                                           |
//| Gated to run once per closed bar. Builds the feature vector at   |
//| shift=1, runs the forward pass, prints the attribution, then     |
//| opens a position if the signal clears the threshold and none is  |
//| already open.                                                    |
//+------------------------------------------------------------------+
void OnTick(void)
  {
//--- one decision per closed bar: exit on every tick except the
//--- first one after a new bar forms
   datetime bar_time = iTime(_Symbol,_Period,0);
   if(bar_time == ExtLastBarTime)
      return;
   ExtLastBarTime = bar_time;

//--- shift=1: the bar that just closed, never the forming one
   if(!ExtEngine.BuildFeatureVector(_Symbol,_Period,1,ExtRSIHandle,ExtATRHandle))
      return;
   if(!ExtEngine.Run())
      return;

   ShowAttribution();
   LogSignalDiagnostics(ExtEngine.Signal());

//--- one-trade gate checked before the threshold, not after: this EA
//--- never pyramids by design, so the attribution comment is always
//--- unambiguous about which open position it is describing
   if(PositionSelect(_Symbol))
      return;

   double signal = ExtEngine.Signal();
   if(MathAbs(signal) < InpSignalThreshold)
      return;

   double price = SymbolInfoDouble(_Symbol,SYMBOL_BID);
   double point  = SymbolInfoDouble(_Symbol,SYMBOL_POINT);

   if(signal > 0.0)
      ExtTrade.Buy(InpLots,_Symbol,price,
               price - InpStopLossPoints  * point,
               price + InpTakeProfitPoints * point);
   else
      ExtTrade.Sell(InpLots,_Symbol,price,
               price + InpStopLossPoints  * point,
               price - InpTakeProfitPoints * point);
  }
Стоит отметить два проектных решения в приведенной выше логике ограничений: проверка, разрешающая иметь только одну позицию, выполняется с помощью PositionSelect(_Symbol) до проверки порога, а не после, поэтому советник по замыслу никогда не наращивает позицию повторными входами — при нескольких входах по сигналам аддитивной модели было бы неясно, к какой открытой позиции относится комментарий с атрибуцией на графике. Проверка времени бара в начале обработчика выполняется до построения вектора признаков и вызова модели, поэтому сбой потока котировок лишь приостанавливает работу советника, а не приводит к многократному запуску инференса на устаревшем векторе признаков.
ShowAttribution — вывод фактических вкладов. Именно эта функция реализует то, что заявлено в названии статьи. Каждое выводимое число — это фактическое значение элемента промежуточного тензора, полученное непосредственно из графа ONNX, а не вычисленное, оцененное или восстановленное советником.
//+------------------------------------------------------------------+
//| ShowAttribution                                                  |
//| Writes the summed signal and each feature's exact contribution to|
//| the chart comment. This is the article's core demonstration: the |
//| numbers shown are the model's real internal terms, not a post-hoc|
//| estimate.                                                        |
//+------------------------------------------------------------------+
void ShowAttribution(void)
  {
   string txt = StringFormat("NAM signal: %.4f\n",ExtEngine.Signal());
   txt += StringFormat("  RSI norm        : %+.4f\n",
                       ExtEngine.Contribution(FEATURE_RSI_NORM));
   txt += StringFormat("  ATR momentum     : %+.4f\n",
                       ExtEngine.Contribution(FEATURE_ATR_MOMENTUM));
   txt += StringFormat("  Volume z-score   : %+.4f\n",
                       ExtEngine.Contribution(FEATURE_VOLUME_ZSCORE));
   txt += StringFormat("  Spread/ATR range : %+.4f\n",
                       ExtEngine.Contribution(FEATURE_SPREAD_RANGE));
   txt += StringFormat("  Session sine     : %+.4f",
                       ExtEngine.Contribution(FEATURE_SESSION_SIN));
   Comment(txt);
  }
Аддитивное разложение на одном тике
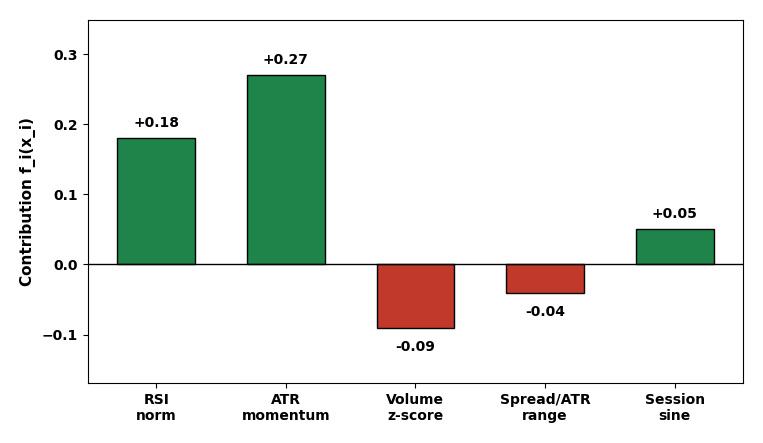
Рис. 2. Аддитивное разложение на одном тике — каждый столбец показывает точное значение, возвращенное CNAMEngine::Contribution() для соответствующего признака.
LogSignalDiagnostics — определение фактического порога. Поскольку функция связи — тождественная функция, а не сигмоида (раздел 2), фиксированного диапазона 0–1, по которому можно было бы подобрать разумный порог, нет: его необходимо определить по измерениям (причины объясняются в разделе 7). Эта функция отслеживает текущие минимальное, максимальное и среднее значения сигнала и выводит сводку каждые 200 баров, что позволяет измерить характеристики реального распределения сигнала, а не делать предположения о нем:
//+------------------------------------------------------------------+
//| LogSignalDiagnostics                                             |
//| Tracks the running min/max/mean of the NAM signal and prints a   |
//| summary every 200 bars. Added specifically to answer one question|
//| empirically instead of guessing: what does the real distribution |
//| of ExtEngine.Signal() look like on this instrument, so           |
//| InpSignalThreshold can be set from evidence rather than          |
//| assumption.                                                      |
//+------------------------------------------------------------------+
void LogSignalDiagnostics(const double signal)
  {
   static int    count    = 0;
   static double sum      = 0.0;
   static double min_val  = DBL_MAX;
   static double max_val  = -DBL_MAX;

   count++;
   sum += signal;
   if(signal < min_val)
      min_val = signal;
   if(signal > max_val)
      max_val = signal;

//--- print a compact summary every 200 bars rather than every
//--- single tick, so the Journal stays readable over a long run
   if(count % 200 == 0)
     {
      PrintFormat("signal stats after %d bars: min=%.4f max=%.4f mean=%.4f",
                  count,min_val,max_val,sum / count);
     }
  }
Генерация обучающих данных: ExportTrainingData.mq5
Для обучения с помощью train_nam.py сначала нужен CSV-файл, в котором значения признаков на исторических данных сопоставлены с фактически реализовавшимися результатами. ExportTrainingData.mq5 — это скрипт: он запускается однократно из терминала, а не работает постоянно на графике. Скрипт проходит по истории в обратном порядке и для каждого прошлого бара в точности воспроизводит расчет признаков из CNAMEngine::BuildFeatureVector(), поэтому при подготовке обучающих данных и при инференсе в реальном времени признаки вычисляются одинаково.
Входные параметры. Параметры периодов RSI и ATR намеренно названы так же, как соответствующие входные параметры советника: несоответствие здесь привело бы к обучению модели на признаках, немного отличающихся от тех, которые она получает при реальной работе
//+------------------------------------------------------------------+
//| Input parameters                                                 |
//| The bar range to export and the two indicator periods, matching  |
//| CNAMEngine::BuildFeatureVector()'s defaults exactly so the       |
//| exported features are computed the same way the live EA computes |
//| them.                                                            |
//+------------------------------------------------------------------+
input int      InpBarsToExport = 5000;  // How many closed bars to export
input int      InpRSIPeriod    = 14;    // Must match InpRSIPeriod in the EA
input int      InpATRPeriod    = 14;    // Must match InpATRPeriod in the EA
input int      InpLabelHorizon = 1;     // Bars ahead used to build the label
OnStart — запись CSV. Открывает файл с флагом FILE_CSV (без флага FILE_ANSI: именно его отсутствие сохраняет стандартную для MQL5 кодировку UTF-16, которую скрипт train_nam.py ожидает благодаря параметру encoding="utf-16". Повторное добавление флага снова незаметно нарушит чтение на стороне Python), затем проходит по диапазону баров, формируя по одной строке на каждый бар:
//+------------------------------------------------------------------+
//| OnStart                                                          |
//| Walks backward over history, rebuilding the same five features   |
//| CNAMEngine::BuildFeatureVector() computes live, pairs each with a|
//| label from price InpLabelHorizon bars later, and writes the      |
//| result as a UTF-16 CSV under MQL5\Files\NAM_SignalAttribution\ — |
//| the exact input train_nam.py expects.                            |
//+------------------------------------------------------------------+
void OnStart(void)
  {
   int rsi_handle = iRSI(_Symbol,_Period,InpRSIPeriod,PRICE_CLOSE);
   int atr_handle = iATR(_Symbol,_Period,InpATRPeriod);
   if(rsi_handle == INVALID_HANDLE || atr_handle == INVALID_HANDLE)
     {
      Print("OnStart: failed to create RSI/ATR indicator handles");
      return;
     }

//--- +2 so shifting for InpLabelHorizon and the 20-bar volume
//--- window never reads past the available history
   int total = InpBarsToExport + InpLabelHorizon + 21;
   int handle = FileOpen("NAM_SignalAttribution\\nam_training_data.csv",
                         FILE_WRITE|FILE_CSV,",");
   if(handle == INVALID_HANDLE)
     {
      PrintFormat("OnStart: FileOpen failed, error %d",GetLastError());
      return;
     }

   FileWrite(handle,"rsi_norm","atr_momentum","volume_zscore",
                    "spread_range","session_sin","label");

   int written = 0;
   for(int shift = InpLabelHorizon; shift < total - 21; shift++)
     {
      double row[5];
      if(!BuildRow(shift,rsi_handle,atr_handle,row))
         continue;

      //--- atr_handle is reused here rather than opened fresh per
      //--- row: opening a new iATR handle inside LabelFor() on every
      //--- call and never releasing it would leak a handle per row,
      //--- thousands of them across a full export
      double label = LabelFor(shift,atr_handle);
      FileWrite(handle,row[0],row[1],row[2],row[3],row[4],label);
      written++;
     }

   FileClose(handle);
   IndicatorRelease(rsi_handle);
   IndicatorRelease(atr_handle);
   PrintFormat("OnStart: exported %d rows to nam_training_data.csv",written);
  }
На этом комментарии о повторном использовании дескриптора стоит остановиться: создание нового дескриптора iATR внутри LabelFor() при каждом вызове без его освобождения приводило бы к утечке дескриптора на каждой итерации — и к тысячам открытых дескрипторов при экспорте 5000 баров. Передача уже открытого дескриптора atr_handle из OnStart() полностью устраняет эту проблему. Это как раз та ловушка, которую стоит описать в документации, а не просто обходить без комментариев.
BuildRow — точное воспроизведение вычислений признаков при реальной работе. Каждый из пяти приведенных ниже операторов присваивания построчно соответствует CNAMEngine::BuildFeatureVector() из раздела 3: то же масштабирование RSI, тот же импульс, нормированный на ATR, та же z-оценка объема по 20 барам, тот же час торговой сессии, закодированный с помощью синуса и взятый из времени самого исторического бара, а не из текущего системного времени. Есть одно прямо оговоренное в комментарии исключение: MT5 не хранит исторический спред для каждого бара, поэтому для признака 3 во всех экспортируемых строках в качестве замены используется текущий спред. Именно поэтому в разделе 9, посвященном граничным случаям, особо отмечено, что интерпретировать вклад spread_range по этим экспортированным строкам ненадежно
//+------------------------------------------------------------------+
//| BuildRow                                                         |
//| Reproduces CNAMEngine::BuildFeatureVector()'s five features for a|
//| historical bar at the given shift, so training data and live     |
//| inference are computed identically. All five row[] entries are   |
//| assigned below — none are left at their default. Returns false   |
//| if any indicator or price history at this shift is unavailable.  |
//+------------------------------------------------------------------+
bool BuildRow(const int shift,const int rsi_handle,const int atr_handle,
              double &row[])
  {
   double rsi_buf[],atr_buf[],close_buf[];
   long   vol_buf[];

   if(CopyBuffer(rsi_handle,0,shift,1,rsi_buf) < 1 ||
      CopyBuffer(atr_handle,0,shift,1,atr_buf) < 1 ||
      CopyClose(_Symbol,_Period,shift,2,close_buf)   < 2 ||
      CopyTickVolume(_Symbol,_Period,shift,20,vol_buf) < 20)
      return(false);

//--- feature 0: RSI rescaled from [0,100] to [-1,1] -- identical to
//--- BuildFeatureVector()'s feature 0
   row[0] = (rsi_buf[0] - 50.0) / 50.0;

//--- feature 1: one-bar momentum, normalized by ATR -- identical to
//--- BuildFeatureVector()'s feature 1
   if(atr_buf[0] > 0.0)
      row[1] = (close_buf[1] - close_buf[0]) / atr_buf[0];
   else
      row[1] = 0.0;

//--- feature 2: volume z-score over the same 20-bar window -- identical
//--- to BuildFeatureVector()'s feature 2
   double vol_mean = 0.0;
   for(int i = 0; i < 20; i++)
      vol_mean += (double)vol_buf[i];
   vol_mean /= 20.0;

   double vol_var = 0.0;
   for(int i = 0; i < 20; i++)
     {
      //--- nested one level in: this loop body belongs to the 'for' above
      double d = (double)vol_buf[i] - vol_mean;
      vol_var += d * d;
     }
   double vol_std = MathSqrt(vol_var / 20.0);

   if(vol_std > 0.0)
      row[2] = ((double)vol_buf[19] - vol_mean) / vol_std;
   else
      row[2] = 0.0;

//--- feature 3: historical spread is not stored per bar in MT5, so the
//--- current live spread is used as a stand-in across all exported rows
//--- -- the one feature that is NOT identical to BuildFeatureVector()'s
//--- live math, a known limitation flagged again in the edge cases
   double spread_points = (double)SymbolInfoInteger(_Symbol,SYMBOL_SPREAD) *
                          SymbolInfoDouble(_Symbol,SYMBOL_POINT);
   row[3] = (atr_buf[0] > 0.0) ? spread_points / atr_buf[0] : 0.0;

//--- feature 4: sine-encoded hour of the historical bar at shift,
//--- matching BuildFeatureVector()'s iTime()-based feature 4 exactly
   MqlDateTime dt;
   TimeToStruct(iTime(_Symbol,_Period,shift),dt);
   row[4] = MathSin(2.0 * M_PI * dt.hour / 24.0);

   return(true);
  }
LabelFor — целевая величина для обучения. Фактическое направление движения на следующем баре с масштабированием по ATR для примерного соответствия рабочему диапазону самого сигнала, а не просто разность цен
//+------------------------------------------------------------------+
//| LabelFor                                                         |
//| Realized next-bar direction: the training target. Positive when  |
//| price InpLabelHorizon bars ahead of `shift` closed higher than at|
//| `shift`, negative when lower, scaled to roughly match the        |
//| signal's own working range rather than a raw price difference.   |
//| Takes the already-open ATR handle rather than creating its own,  |
//| since this runs once per exported row.                           |
//+------------------------------------------------------------------+
double LabelFor(const int shift,const int atr_handle)
  {
   double future_close[],current_close[];
   if(CopyClose(_Symbol,_Period,shift - InpLabelHorizon,1,future_close) < 1 ||
      CopyClose(_Symbol,_Period,shift,1,current_close) < 1)
      return(0.0);

   double atr_buf[];
   if(CopyBuffer(atr_handle,0,shift,1,atr_buf) < 1 || atr_buf[0] <= 0.0)
      return(0.0);

   return((future_close[0] - current_close[0]) / atr_buf[0]);
  }
Вспомогательный скрипт обучения: train_nam.py
Вычислительный граф ONNX, используемый советником, обучается в автономном режиме с помощью скрипта train_nam.py, который поставляется вместе с файлами MQL5 в папке MQL5\Files\NAM_SignalAttribution\Python\.
ExU и FeatureNet — функции формы. Структура скрипта напрямую отражает аддитивную архитектуру: по одному модулю FeatureNet на каждый столбец входных данных, причем модули не используют общие веса и ни один из них не получает данные из других столбцов. Именно экспоненцирование веса в ExU позволяет этим подсетям выучивать функции формы с более резкими переходами и меньшим насыщением, чем при использовании обычной ReLU.
class ExU(nn.Module):
    """
    Exp-centered unit: y = relu(exp(w) @ (x - b)). The NAM paper found ExU units
    fit sharper, less-saturated shape functions than plain ReLU for the
    kind of jagged, non-smooth relationships financial features tend to
    have, at the cost of needing a smaller learning rate.
    """

    def __init__(self, in_features, out_features):
        super().__init__()
        self.w = nn.Parameter(torch.randn(in_features, out_features) * 0.5)
        self.b = nn.Parameter(torch.zeros(in_features))

    def forward(self, x):
        # --- x: (batch, in_features) -> centered, then exp-scaled weights
        centered = x - self.b
        return torch.relu(centered @ torch.exp(self.w))


class FeatureNet(nn.Module):
    """One small subnetwork per feature: this IS the shape function f_i."""

    def __init__(self, hidden=32):
        super().__init__()
        self.exu = ExU(1, hidden)
        self.out = nn.Linear(hidden, 1, bias=False)

    def forward(self, x):
        # --- x: (batch, 1) -> (batch, 1); this scalar-in scalar-out shape
        # --- is exactly what makes the output directly plottable as f_i(x_i)
        return self.out(self.exu(x))
Именно при прямом проходе модели верхнего уровня обеспечивается соблюдение ограничения аддитивности — не за счет специального слагаемого функции потерь, а за счет самой архитектуры
class NeuralAdditiveModel(nn.Module):
    def __init__(self, num_features, hidden=32):
        super().__init__()
        self.nets = nn.ModuleList([FeatureNet(hidden) for _ in range(num_features)])
        self.bias = nn.Parameter(torch.zeros(1))

    def forward(self, x):
        # --- each subnetwork only ever sees its own column: x[:, i:i+1]
        contributions = [net(x[:, i : i + 1]) for i, net in enumerate(self.nets)]
        contrib_tensor = torch.cat(contributions, dim=1)  # (batch, num_features)
        signal = self.bias + contrib_tensor.sum(dim=1, keepdim=True)
        return signal, contrib_tensor
Поскольку forward() возвращает оба тензора, при экспорте в ONNX они оба сохраняются как именованные выходы за один вызов torch.onnx.export — отдельная модель для обеспечения объяснимости, которую пришлось бы обучать, версионировать и поддерживать в синхронизированном состоянии с торговой моделью, не требуется.
Загрузка набора данных. Обучающие данные поступают из файла, экспортированного из MT5 с флагом FILE_CSV, и декодируются как UTF-16. Стоит помнить об этой характерной особенности MetaTrader: по умолчанию он записывает CSV-файлы в кодировке UTF-16, и вызов read_csv в pandas без параметра encoding="utf-16" приводит к незаметному некорректному считыванию всех полей
FEATURE_COLUMNS = [
    "rsi_norm",
    "atr_momentum",
    "volume_zscore",
    "spread_range",
    "session_sin",
]

def load_dataset(csv_path):
    # --- MT5's FILE_CSV writes UTF-16; sep=None lets pandas auto-detect the delimiter
    df = pd.read_csv(csv_path, encoding="utf-16", sep=None, engine="python")
    df.columns = [c.replace("\ufeff", "") for c in df.columns]
    x = df[FEATURE_COLUMNS].values.astype(np.float32)
    y = df["label"].values.astype(np.float32).reshape(-1, 1)
    return torch.from_numpy(x), torch.from_numpy(y)
Разделение с учетом времени, а не случайное. Строки в экспортированном файле CSV расположены в хронологическом порядке, поэтому простое случайное перемешивание перед разделением привело бы к попаданию строк из тестового окна в обучающую выборку через соседние, сильно коррелирующие между собой бары. Вместо этого функция time_aware_split() разделяет набор данных по фиксированным позициям строк, от самых старых к самым новым, без перемешивания на каком-либо этапе.
def time_aware_split(x, y, train_frac=0.70, val_frac=0.15):
    """
    Splits by row position, not randomly: rows are already in the
    chronological order ExportTrainingData.mq5 wrote them in, so cutting
    at fixed positions keeps every validation/test row strictly after
    every training row in time. The remaining 1 - train_frac - val_frac
    becomes the held-out test split.
    """
    n = x.shape[0]
    n_train = int(n * train_frac)
    n_val   = int(n * val_frac)
    return (
        (x[:n_train], y[:n_train]),
        (x[n_train:n_train + n_val], y[n_train:n_train + n_val]),
        (x[n_train + n_val:], y[n_train + n_val:]),
    )
Цикл обучения. Используется обычная среднеквадратичная ошибка (MSE) относительно целевой метки фактического направления движения на следующем баре, а не кросс-энтропия для классификации — это намеренно согласовано с тождественной функцией связи из раздела 2. Основная защита от переобучения здесь — затухание весов с коэффициентом 1e-4 в оптимизаторе Adam: при наличии всего пяти независимых подсетей, которые не делят между собой общие ресурсы модели, отдельная подсеть может запомнить шум в небольшом наборе данных быстрее, чем полносвязный слой сопоставимого размера. Каждые 20 эпох выводится именно значение функции потерь на валидационной выборке, а не на обучающей, поскольку на запомненных обучающих данных оно может продолжать снижаться еще долго после того, как модель перестала обобщать
def train(csv_path, epochs=200, lr=1e-3, weight_decay=1e-4):
    x, y = load_dataset(csv_path)
    (x_train, y_train), (x_val, y_val), (x_test, y_test) = time_aware_split(x, y)

    model = NeuralAdditiveModel(num_features=len(FEATURE_COLUMNS))
    optimizer = torch.optim.Adam(model.parameters(), lr=lr, weight_decay=weight_decay)
    loss_fn = nn.MSELoss()

    for epoch in range(epochs):
        optimizer.zero_grad()
        signal, _ = model(x_train)
        loss = loss_fn(signal, y_train)
        loss.backward()
        optimizer.step()
        if epoch % 20 == 0:
            model.eval()
            with torch.no_grad():
                val_signal, _ = model(x_val)
                val_loss   = loss_fn(val_signal, y_val).item()
            model.train()
            print(f"epoch {epoch:4d}  train loss {loss.item():.6f}  val loss {val_loss:.6f}")

    return model, (x_test, y_test)
Это по-прежнему простое разбиение, а не схема скользящего тестирования: для каждого символа данные однократно делятся на обучающую, валидационную и тестовую выборки, без последовательного переобучения на нескольких скользящих окнах. Кроме того, epochs=200 задает фиксированное число эпох, а не раннюю остановку с помощью функции обратного вызова, отслеживающей значение функции потерь на валидационной выборке. Оба улучшения разумно добавить в дальнейшем. Здесь не утверждается, что они уже реализованы. Что еще важнее, четыре модели, использованные при запусках в тестере стратегий в следующем разделе, обучены на полном экспорте за период 01.03.2026–30.08.2026 без отложенного интервала. Поэтому приведенные далее результаты — это внутривыборочные проверки работы механизма, а не вневыборочная проверка торгового преимущества. В следующем разделе это различие указано прямо, чтобы описанное выше разбиение не создавало обратного впечатления.
Экспорт в ONNX. Один вызов torch.onnx.export() с двумя именованными выходами (signal, contributions) и фиксированным размером пакета 1, что соответствует объявлению в CNAMEngine::Init() на стороне MQL5
def export_onnx(model, out_path="nam_model.onnx"):
    model.eval()
    dummy = torch.zeros(1, len(FEATURE_COLUMNS), dtype=torch.float32)
    torch.onnx.export(
        model,
        dummy,
        out_path,
        input_names=["features"],
        output_names=["signal", "contributions"],
        dynamic_axes=None,  # fixed batch size 1, matching CNAMEngine::Init
        opset_version=13,
    )
    print(f"exported {out_path}")
В этом скрипте пока не реализована ранняя остановка обучения: epochs=200 задает фиксированное число эпох, а не функцию обратного вызова, которая отслеживает указанное выше значение функции потерь на валидационной выборке и прекращает обучение, когда оно перестает улучшаться. Это следующее, что нужно добавить перед обучением на реальных исторических данных: описанное выше разбиение с учетом времени уже предотвращает более фундаментальную утечку данных. Случайное перемешивание строк временного ряда привело бы к попаданию информации из будущего в обучающие данные, из-за чего полученное значение функции потерь выглядело бы гораздо лучше, чем можно ожидать при реальной торговле. Именно такую скрытую, труднообнаружимую ошибку и призвано исключить это разбиение.
Проверка в тестере стратегий
Тестирование на одном торговом инструменте мало что говорит о способности подхода к обобщению. Ниже представлены результаты четырех фактически проведенных прогонов в тестере стратегий: XAUUSD на M5 и M15, EURUSD на M15 и GBPUSD на H1. Все они охватывают период с 01.03.2026 по 30.08.2026, используют одинаковое значение InpSignalThreshold = 0.03 и выполнены в режиме моделирования "OHLC на M1" (не на реальных тиках; это стоит указать точно, чтобы не преувеличивать достоверность моделирования). Для каждой комбинации обучена своя NAM: советник из раздела 4 встраивает ровно один ресурс ONNX на этапе компиляции. Поэтому для использования отдельной модели в каждом прогоне требовалось заново экспортировать nam_model.onnx для соответствующей пары "символ/таймфрейм", перекомпилировать советник с новым файлом, оставив ту же строку #resource, и запустить полученную сборку на соответствующей комбинации. В этом советнике нет механизма выбора модели во время выполнения, поэтому предыдущий абзац следует понимать как описание четырех отдельных компиляций, а не одного советника, автоматически выбирающего модель.
Во всех четырех прогонах использовались одинаковые настройки тестирования: сервер MetaQuotes-Demo, сборка терминала 5100 или новее, начальный депозит 10 000,00 USD, кредитное плечо 1:100, хеджинговый режим учета позиций, плавающий спред (заданный брокером по умолчанию для каждого символа, а не фиксированный), нулевая комиссия и стандартное для тестера стратегий рыночное исполнение без дополнительного проскальзывания. Ни один из этих параметров не менялся между комбинациями, поэтому различия в таблице ниже обусловлены исключительно тройкой "символ/таймфрейм/модель", а не изменением настроек счета или исполнения. В каждом прогоне использовался один и тот же скомпилированный советник и те же четыре входных параметра из предыдущего раздела.
Общее количество торговых операций и чистая прибыль по всем четырем комбинациям
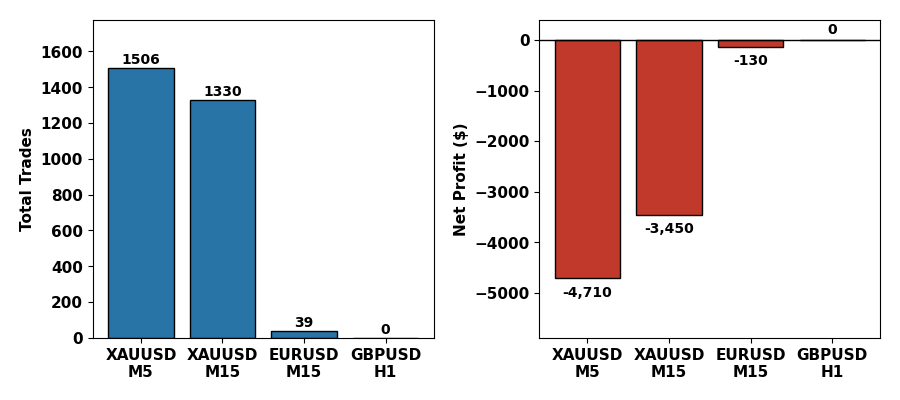
Рис. 3. Фактические результаты по всем четырем протестированным комбинациям — количество торговых операций (слева) и чистая прибыль (справа).
| Показатель | XAUUSD M5 | XAUUSD M15 | EURUSD M15 | GBPUSD H1 |
|---|---|---|---|---|
| Всего торговых операций/всего сделок | 1 506/3 012 | 1 330/2 660 | 39/78 | 0/0 |
| Чистая прибыль | -4 710,00 | -3 450,00 | -130,00 | 0,00 |
| Валовая прибыль/Валовый убыток | 43 440,00 / -48 150,00 | 38 800,00 / -42 250,00 | 1 120,00 / -1 250,00 | 0,00/0,00 |
| Профит-фактор | 0,90 | 0,92 | 0,90 | 0,00 |
| Процент прибыльных торговых операций | 36,06% (543 из 1 506) | 36,47% (485 из 1 330) | 35,90% (14 из 39) | — |
| Длинные/короткие операции (доля прибыльных, %) | Длинные: 1 443 (35,69%)/короткие: 63 (44,44%) | Длинные: 1 304 (36,43%) /короткие: 26 (38,46%) | Длинные: 33 (36,36%) /короткие: 6 (33,33%) | — |
| Максимальная просадка (баланс/средства) | 55,26%/55,39% | 41,84%/42,37% | 2,90%/3,69% | 0,00%/0,00% |
| Коэффициент Шарпа | -5,00 | -4,20 | -0,48 | 0,00 |
Прежде чем трактовать четыре строки ниже как нечто большее, чем проверку работоспособности механизма, следует учесть одну оговорку: все четыре модели NAM были обучены на полном интервале с 01.03.2026 по 30.08.2026 без выделения отложенной тестовой выборки — в скрипте train_nam.py функция time_aware_split() из раздела 6 на момент обучения этих четырех моделей еще не существовала. Таким образом, каждое число в таблице — внутривыборочный результат за тот же период, на котором обучалась модель, а не вневыборочная проверка или проверка по схеме скользящего тестирования, позволяющая выяснить, сохраняется ли торговое преимущество на ранее не использовавшихся данных. Логичный следующий шаг — заново обучить все четыре модели, исключив из обучения отложенные выборки, и отдельно представить результаты на валидационном и тестовом интервалах. В приведенных ниже показателях это еще не учтено.
Только две комбинации с XAUUSD дали достаточно торговых операций, чтобы сделать статистически значимые выводы. Обе убыточны: профит-фактор составляет 0,90 на M5 и 0,92 на M15, а коэффициент Шарпа в обоих случаях существенно отрицателен. Механизм в обоих случаях работал в точности как задумано: 1 506 и 1 330 торговых операций соответственно, причем допуск к каждой определялся реальным прямым проходом ONNX-модели, а каждое выведенное значение атрибуции соответствовало фактическим внутренним вычислениям модели — ничего не было ни выдумано, ни оценено приблизительно. Не хватает именно торгового преимущества, и в журнале обучения было раннее предупреждение, которое тогда легко было упустить: при первоначальном обучении на XAUUSD значение функции потерь почти не изменилось с 80-й эпохи (0,577008) до 180-й (0,576444). Оглядываясь назад, это можно расценить как признак того, что модель сошлась к решению, близкому к прогнозированию безусловного среднего очень зашумленной целевой величины на один бар вперед, а не выявила реальную зависимость. Если при обучении кривая функции потерь почти горизонтальна, стоит остановиться и разобраться в причинах еще до перехода к тестеру стратегий.
Распределение длинных и коротких позиций демонстрирует одну и ту же структурную закономерность на обоих таймфреймах XAUUSD: 1 443 длинные позиции против 63 коротких на M5 и 1 304 против 26 на M15, хотя среднее значение исходного сигнала слегка отрицательно. Как отмечалось в разделе 2, этот эффект обусловлен частотой отклонений, а не их величиной: небольшие положительные отклонения выше порога возникают часто, тогда как отрицательные встречаются реже, даже если достигают большей величины. Нынешние пять признаков и эта конфигурация обучения формируют систему со структурным перекосом в сторону длинных позиций по XAUUSD, а не со сбалансированным соотношением длинных и коротких позиций, какое бы впечатление ни создавал на первый взгляд диапазон исходного сигнала.
Результаты для EURUSD M15 и GBPUSD H1 здесь важнее, а вовсе не второстепенны. 39 и 0 торговых операций соответственно — это не провал теста, а наглядное проявление проблемы переносимости порога из раздела 8, теперь в полном масштабе, а не в одном абзаце. Значение InpSignalThreshold = 0.03 было подобрано эмпирически для диапазона сигнала XAUUSD с помощью LogSignalDiagnostics(). Результаты этого измерения нельзя переносить на другой инструмент или таймфрейм: для каждой такой комбинации обучена своя модель NAM с собственным масштабом сигнала. Применение порога одного инструмента ко всем четырем комбинациям воспроизводит в большем масштабе ту же ошибку, к которой привело исходное временное значение 0,35 на одном инструменте: если выбрать порог, не измерив фактический диапазон выходного сигнала целевой модели, система будет торговать крайне редко или не будет торговать вовсе. Горизонтальная линия на графике GBPUSD H1 на рис. 3 — это наглядное воплощение этого урока.
Каждая из четырех строк выше соответствует единственному прогону в тестере стратегий, а не лучшему результату из нескольких попыток для данной комбинации. Ни один прогон не повторяли и ни один результат не отбрасывали ради более привлекательных показателей. Однако единственное подтверждение этому — данное описание, а не приложенный комплект исходных отчетов тестера стратегий по всем прогонам, успешным и неудачным. Код, архитектура и механизм атрибуции работают именно так, как и было задумано. В разных комбинациях различается не сам механизм, а калибровка, необходимая для каждой из них с учетом ее особенностей. Именно необходимость разделять вопросы "работала ли система так, как было задумано" и "принесла ли она прибыль на этом инструменте при этом пороге" делает реальные прогоны в тестере стратегий важнее условных иллюстративных результатов: последние можно представить как угодно, а четыре реальных прогона для четырех комбинаций, рассматриваемые с учетом приведенной выше оговорки о внутривыборочном характере результатов, — нет.
Во всех четырех приведенных выше прогонах используется один и тот же порог — 0,03, перенесенный с XAUUSD на все комбинации, — и именно от этой ошибки предостерегает предыдущий абзац. В следующих четырех прогонах эта ошибка исправлена: InpSignalThreshold выбирается по диапазону, который выводит LogSignalDiagnostics() в каждом конкретном прогоне, а не переносится откуда-то еще. Три из четырех моделей обучаются заново на данных своего инструмента и таймфрейма, а четвертая намеренно использует веса для другого таймфрейма, чтобы ее можно было напрямую сравнить с представленными рядом моделями, обученными заново. Эти четыре прогона как раз и отвечают на вопрос, улучшает ли исправление калибровки также и итоговый результат.
| Показатель | XAUUSD M5 | XAUUSD M15 | EURUSD M15 | GBPUSD H1 |
|---|---|---|---|---|
| InpSignalThreshold (источник) | 0,10 (собственный диапазон) | 0,07 (собственный диапазон, повторно использованные веса) | 0,10 (собственный диапазон) | 0,03 (собственный диапазон) |
| Всего торговых операций/всего сделок | 65/130 | 258/516 | 42/84 | 75/150 |
| Чистая прибыль | 122,17 | –2 971,51 | 349,78 | –315,71 |
| Валовая прибыль/Валовый убыток | 2 112,79 / –1 990,62 | 6 285,50 / –9 257,01 | 1 516,34 / –1 166,56 | 2 100,75 / –2 416,46 |
| Профит-фактор | 1,06 | 0,68 | 1,30 | 0,87 |
| Процент прибыльных торговых операций | 41,54% (27 из 65) | 31,40% (81 из 258) | 45,24% (19 из 42) | 36,00% (27 из 75) |
| Длинные/короткие позиции (% прибыльных) | 48 длинных позиций (37,50%) / 17 коротких позиций (52,94%) | 215 длинных позиций (32,09%) / 43 коротких позиций (27,91%) | 5 длинных позиций (40,00%) / 37 коротких позиций (45,95%) | 10 длинных позиций (30,00%) / 65 коротких позиций (36,92%) |
| Максимальная просадка (баланс/средства) | 4,07%/4,62% | 33,14%/33,72% | 3,11%/3,41% | 6,39%/6,79% |
| Коэффициент Шарпа | 3,30 | –5,00 | 1,18 | –0,81 |
Комбинация XAUUSD M15 намеренно отличается от остальных в этой таблице: в ней используются веса XAUUSD M5 из приведенного выше прогона, а не модель, заново обученная на данных M15, причем функция BuildFeatureVector() просто вычисляет свои пять признаков по барам M15 вместо M5. Порог для этой комбинации по-прежнему выбирается по ее собственному диапазону сигналов, выведенному в журнал, но используемые веса получены при обучении без единого бара M15, и это отражается на результате: самый большой убыток и единственная трехзначная просадка в таблице. Остальные три модели обучаются с нуля на данных того же инструмента и таймфрейма, на которых затем тестируются. Две из этих трех моделей дают прибыльный результат: XAUUSD M5 — с небольшим перевесом, всего на 65 торговых операциях; EURUSD M15 — более убедительно, с большим перевесом и меньшей просадкой. GBPUSD H1, обученная и откалиброванная точно так же, все равно дает убыток. Исправление калибровки устранило именно ту проблему, которую и должно было устранить: в отличие от приведенной выше таблицы с единым порогом, здесь в каждом столбце представлены торговые операции в обоих направлениях. Однако оно не сделало прибыльной каждую комбинацию, да и не могло этого сделать. Именно это различие и призван показать данный раздел: правильно откалиброванный порог — необходимое условие корректного тестирования, а не гарантия торгового преимущества.
Граничные случаи, подводные камни и выводы
Некорректный признак искажает всю сумму, а не только собственное слагаемое. Поскольку итоговый сигнал представляет собой простую сумму, даже одно значение NaN или бесконечности в m_feature_vec[] — возникшее из-за деления на нулевой ATR, отсутствия данных о тиковом объеме бара или пропуска в потоке котировок брокера — распространяется через OnnxRun и превращает каждый элемент обоих выходных тензоров в NaN, а не только вклад соответствующего признака. Функция BuildFeatureVector() сразу возвращает false при нехватке любых исторических данных, вместо того чтобы подставлять значение-заполнитель.
Расчет признака spread_range при обучении отличается от его расчета в реальном времени, поэтому его вклад не следует трактовать слишком буквально. Функция BuildRow() из раздела 5 использует текущий спред для каждой строки исторических данных, поскольку MT5 не хранит исторический ряд спреда по барам. Поэтому spread_range в обучающем CSV-файле фактически представляет собой "спред на момент экспорта", повторенный в тысячах строк с разными значениями ATR в знаменателе, а не настоящий исторический ряд. Модель все равно обучает для него функцию формы, а ShowAttribution() все равно выводит численное значение, однако его следует трактовать как вклад признака с известным расхождением между расчетами при обучении и в реальном времени, а не как свидетельство того, как издержки исполнения в действительности повлияли на конкретное решение на исторических данных.
Атрибуция поддается интерпретации только в пределах обучающего распределения. Функции формы NAM подбираются в пределах того диапазона значений x_i, который встречался в обучающих данных. В торговой сессии с объемом, выходящим на десять стандартных отклонений за пределы всех значений, встречавшихся при обучении, функция f_3 все равно выдаст число. Но это число будет экстраполяцией сети, которая никогда не обучалась на этом участке кривой. Об этом стоит упомянуть в любой статье, заявляющей о полной интерпретируемости, поскольку утверждение "модель точно сообщает вам, что она делает" справедливо лишь в пределах данных, которые ей показывали.
Размер пакета фиксируется при экспорте. В данной реализации и в OnnxSetInputShape, и в OnnxSetOutputShape задается фиксированный размер пакета 1, что соответствует работе советника на каждом тике. Чтобы использовать этот ONNX-файл для пакетного получения прогнозов, его необходимо повторно экспортировать с динамической осью пакета.
Для блоков ExU требуется меньшая скорость обучения, чем для остальной части сети. Поскольку в каждом слое ExU вес используется в экспоненте, шаг градиента, вполне приемлемый для линейного слоя, может привести exp(w) к значениям, при которых выход подсети взрывным образом возрастает. Значение по умолчанию в скрипте обучения — 1e-3 — намеренно выбрано с запасом.
Два выхода ONNX должны оставаться синхронизированными по индексам друг с другом. Ничто в системе типов ONNX не гарантирует, что выход с индексом 1 (contributions) соответствует тому же прямому проходу, что и выход с индексом 0 (signal), за исключением того факта, что оба они являются результатом одного вызова OnnxRun. Именно получение обоих выходов в одном вычислительном графе за один вызов forward() позволяет считать m_signal и m_contrib[] достоверной согласованной парой.
Наличие защитного резервного значения еще не означает, что оно проверено на корректность. Возврат false при нехватке исторических данных не позволяет некорректному тику попасть в модель, но не подтверждает корректность фактически полученной истории: формально полный, но искаженный бар от брокера беспрепятственно пройдет все проверки в их нынешнем виде.
Нет обоснованного способа заранее угадать порог — его нужно определить по измерениям. Поскольку функция связи g является тождественной функцией, здесь нет фиксированного диапазона 0–1 или -1–1, на который можно было бы ориентироваться при выборе InpSignalThreshold, как в случае сигмоидного выхода. Выбранный наугад порог 0,35 оказался далеко за пределами фактического диапазона сигнала модели — примерно от -0,20 до +0,09 на XAUUSD M5. Поэтому значение 0,35 ни разу не достигалось, и за шесть месяцев тестирования советник не выполнил ни одной торговой операции. Функция LogSignalDiagnostics() позволила выбирать порог на основе измерений, а не догадок. Для любого торгового сигнала на основе NAM, построенного таким образом, нужна одна и та же последовательность действий: обучить модель, измерить фактическое распределение ее выходных значений на целевом инструменте и лишь затем задать порог — именно в таком порядке, а не наоборот.
Смысл этой реализации никогда не состоял в том, чтобы показать превосходство нейронной аддитивной модели над полносвязной сетью по точности как таковой: в литературе по NAM честно признается, что обычно она немного уступает полносвязной сети. Смысл в том, что, когда этот советник выводит на график "ATR momentum: +0.27" (импульс, нормированный по ATR), это число не является догадкой о работе модели. Это сама модель — ее значение, считанное непосредственно из вычислительного графа, по которому она работает. Приведенный выше фактический результат тестирования (профит-фактор 0,90, чистый убыток за тестируемый интервал) — наглядное подтверждение этой мысли, а не неудача, которую следует скрывать: модель типа "черный ящик" с тем же неутешительным результатом оставила бы трейдера гадать о причинах, применять SHAP постфактум и надеяться на достоверность приближения. Здесь можно непосредственно изучить как ранний выход функции потерь на плато, так и точные вклады каждого признака в каждой убыточной торговой операции. Благодаря этому утверждение "модель не работает" перестает быть тупиком и указывает на конкретный следующий шаг: переобучить модель с более сглаженной целевой меткой, собрать больше данных или пересмотреть, какие именно пять признаков должны входить в сумму.
Увеличение числа признаков сверх пяти не требует усложнения архитектуры: каждый дополнительный признак — это еще одна независимая подсеть и еще один столбец в тензоре вкладов, а слагаемых взаимодействия, о потере которых пришлось бы беспокоиться, здесь нет. С учетом результата этого прогона более насущный следующий шаг имеет узкую направленность: переобучить модель с более сглаженной целевой меткой на несколько баров вперед вместо использованной здесь несглаженной доходности на один бар вперед, поскольку столь ранний выход функции потерь на плато — самый явный из доступных признаков того, что текущая целевая величина в основном представляет собой шум. Еще одно естественное развитие — использовать атрибуцию не только в комментарии на графике, но и при определении размера позиции: уменьшать объем в лотах, когда доминирующий вклад вносит признак, чьи вклады в недавних вневыборочных результатах были нестабильными. Ничто из этого не требует изменений в самой модели: вся логика реализуется на этапе последующей обработки двух чисел, которые метод CNAMEngine::Run() уже возвращает на каждом баре.
| Файл | Тип | Описание |
|---|---|---|
| NAM_SignalAttribution_EA.mq5 | Советник | Цикл OnTick, выполнение торговых операций, отображение атрибуции на графике, диагностика сигналов |
| NAMEngine.mqh | Подключаемый файл (класс) | CNAMEngine: загрузка ONNX, вычисление признаков, прямой проход, считывание вкладов |
| ExportTrainingData.mq5 | Скрипт | Воспроизводит на исторических данных расчет признаков, используемый при работе в реальном времени, и записывает CSV-файл с целевыми метками для обучения в train_nam.py |
| train_nam.py | Скрипт на Python | Обучение NAM (подсети ExU) и экспорт в ONNX с двумя выходами |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/24690
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


Удобно, что вклады складываются в итог: сумма выходов подсетей плюс смещение должна давать сигнал до последнего знака, и это стоит проверять в советнике на каждом баре как защиту от ошибки в формулах признаков. Про входы вне обучающего диапазона: подсеть на ReLU за краем данных продолжает линию последнего участка, и вклад одного признака может перекрыть все остальные. Я бы обрезал каждый признак по минимуму и максимуму обучающей выборки и писал в журнал, сколько баров за день попало под обрезку.