

Теория случайных матриц (RMT): Подавление шума в корреляционной матрице для мультивалютных советников
 56
 5

Введение
Если вы когда-нибудь создавали мультивалютный торговый советник (EA), использующий корреляцию, — для распределения средств по корзине, фильтрации пар, расчета коэффициента хеджирования или любой другой задачи, в которой корреляционная матрица используется для расчета объема позиций, — вы, вероятно, замечали, что значения колеблются сильнее, чем следовало бы. Если провести ту же оценку корреляции по ценам закрытия понедельника и вторника с использованием одинаковых параметров, матрица всё равно может существенно измениться — даже если никаких структурных изменений не произошло. Это не ошибка в вашем коде. Это свойство самой матрицы.
Выборочная корреляционная матрица, оцененная по конечному окну наблюдений доходностей, содержит шум. Если при N торговых инструментах и окне ретроспективного анализа длиной T баров величина T не намного больше N, то большая часть того, что вы измеряете, — это ошибка выборки, а не реальное совместное движение инструментов. Если использовать такую зашумленную матрицу напрямую для расчета дисперсии портфеля или объемов позиций в корзине инструментов, результаты будут выглядеть точными (шесть знаков после запятой, аккуратные веса), хотя на самом деле в них будет преобладать шум оценивания. Эта точность лишь кажущаяся.
В этой статье теория случайных матриц (RMT) рассматривается как практическое решение этой проблемы, реализованное средствами самого MQL5 без ALGLIB и внешних DLL. В частности, мы используем распределение Марченко — Пастура для отделения сигнальных собственных значений от шумовых собственных значений. Затем мы восстанавливаем очищенную матрицу, сохраняя сигнальную структуру и выравнивая остальные собственные значения. Мы рассмотрим математические основы, спектральное разложение методом Якоби, реализованное на MQL5 без внешних библиотек, саму процедуру подавления шума и советник для торговли корзиной инструментов, который использует очищенную матрицу для расчета объемов позиций по четырем коррелирующим инструментам валютного рынка и рынка металлов.
Область рассмотрения: в этой статье основное внимание уделяется подавлению шума в корреляционной матрице как этапу предварительной обработки входных данных для оценки риска. Это не полноценный оптимизатор портфеля, а расчет объема позиций в советнике для торговли корзиной намеренно упрощен для наглядности: расчет с учетом маржи, моделирование транзакционных издержек и особенности работы с несколькими счетами явно оговорены в разделе "Пограничные случаи и возможные проблемы", а не неявно заложены в алгоритм.
Почему исходные корреляционные матрицы в основном состоят из шума
Начнем с основной статистической проблемы. Для оценки корреляционной матрицы размером N × N необходимо оценить N(N–1)/2 парных корреляций на основе T наблюдений. По мере роста N относительно T по ограниченному объёму данных приходится оценивать быстро растущее число параметров. Классическая статистика показывает, что отдельные оценки корреляции становятся более зашумленными. Менее очевидно, что происходит с матрицей в целом, если рассмотреть её собственные значения.
Истинная корреляционная матрица, свободная от шума и описывающая рынок с реально действующими общими факторами — общерыночным фактором риска, разделением на металлы и валюты, долларовым фактором, — имеет спектр с несколькими большими собственными значениями (соответствующими реальным факторам), тогда как остальные собственные значения сгруппированы вблизи 1,0 (специфическая дисперсия отдельных торговых инструментов). Однако выборочная корреляционная матрица, оцененная по конечному объему данных, не воспроизводит этот спектр точно. Даже если использовать в качестве входных данных чистый случайный шум с нулевой истинной корреляцией, собственные значения выборочной корреляционной матрицы будут образовывать предсказуемое нетривиальное распределение исключительно из-за ошибки выборки. У этого распределения есть название и замкнутая формула, и именно оно является ключом ко всему, что будет дальше.
Для разработки на MQL5 это особенно важно: советники для торговли корзиной инструментов, калькуляторы коэффициентов хеджирования и процедуры расчета объема позиций с учетом портфельного риска достаточно распространены среди торговых советников (EA), и почти все такие решения, с которыми я сталкивался, передают исходную выборочную корреляционную матрицу непосредственно в алгоритм расчета объема позиций. Эта нестабильность незаметна при отдельном прогоне тестирования на исторических данных. Она проявляется в резких изменениях наборов весов между прогонами с немного различающимися диапазонами дат или в резких колебаниях рассчитываемых объемов позиций между ребалансировками в реальной торговле, даже когда лежащие в их основе рыночные взаимосвязи фактически не изменились.
Стоит также отметить менее очевидную проблему: переобучение на шумовых направлениях представляет собой реальный риск для любого алгоритма, выполняющего оптимизацию на основе корреляционной матрицы, а не просто эстетический недостаток. Коэффициент хеджирования или минимизирующий дисперсию вектор весов, рассчитанный по исходной выборочной корреляционной матрице, может оказаться привязан к ложной корреляции, которая существует лишь в данном окне наблюдений и потерять обоснованность, как только окно сдвинется вперед. Подавление шума не устраняет этот риск полностью, но исключает направления, соответствующие собственным значениям, которые доказуемо неотличимы от шума, прежде чем алгоритмы на последующих этапах смогут переобучиться на них.
Теория случайных матриц (RMT) и распределение Марченко — Пастура
Теория случайных матриц (RMT) изучает статистические свойства матриц, элементы которых являются результатами случайных процессов. Нужный нам здесь результат — теорема Марченко — Пастура (MP), которая описывает предельное распределение собственных значений корреляционной (или ковариационной) матрицы, оцененной по T независимым наблюдениям N переменных, при нулевой гипотезе о полном отсутствии истинной корреляционной структуры, то есть в случае чистого шума.
Распределение MP характеризуется параметром Q = T/N. По мере увеличения Q (то есть при увеличении объема данных по отношению к количеству переменных) распределение шума сужается и концентрируется вокруг значения 1,0, что соответствует интуитивному представлению о том, что больше данных дают более точные оценки. По мере приближения Q к 1 (когда T близко к N) распределение резко расширяется — именно в этом режиме простое оценивание корреляции перестаёт работать.
Верхняя граница распределения MP задается формулой в замкнутом виде:
lambda_max = sigma² * (1 + 1/sqrt(Q))²
где Q = T / N, а sigma^2 — дисперсия исходного ряда (для корреляционной матрицы она по построению равна 1,0). В приведённом ниже коде MQL5 выражение sqrt(Q) вычисляется с помощью встроенной функции MathSqrt() — операция та же самая, но в синтаксисе MQL5.
Практическое применение этой границы просто: вычислите собственные значения выборочной корреляционной матрицы, построенной по реальным данным, и сравните каждое из них с lambda_max. Любое собственное значение, не превышающее верхнюю границу распределения MP, статистически неотличимо от значения, которое мог бы породить чистый шум при тех же T и N, поэтому у нас нет достаточных оснований считать его реальным рыночным фактором. Крайне маловероятно, что собственные значения выше этой границы возникают исключительно из-за шума. Они отражают реальную, устойчивую общую структуру — общерыночный фактор, фактор кластера металлов или иной доминирующий характер совместного движения в вашей корзине инструментов.
О теоретических допущениях: при выводе распределения Марченко — Пастура формально предполагается, что наблюдения независимы, одинаково распределены и получены из распределения с конечной дисперсией. Рыночные доходности не удовлетворяют в полной мере ни одному из этих условий: последовательные бары не независимы (наблюдается кластеризация волатильности), хвосты распределения тяжелее, чем у нормального распределения, а сама структура корреляций со временем меняется (гетероскедастичность). Это не делает применение границы распределения MP на практике необоснованным. Это лишь означает, что перед нами практическая эвристика подавления шума на основе теории случайных матриц (RMT), опирающаяся на теоретический результат, а не точный статистический критерий с гарантированным уровнем покрытия. Рассматривайте lambda_max как теоретически обоснованный порог, а не как строгую статистическую границу с точно определённым p-значением.
Спектр собственных значений в сравнении с верхней границей распределения Марченко — Пастура
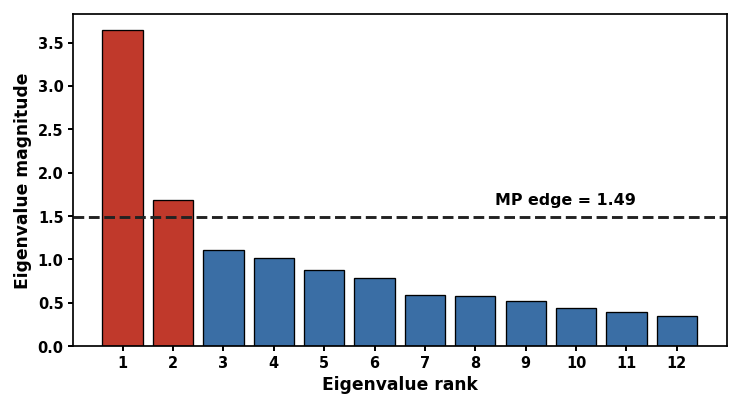
Рис. 1. Спектр собственных значений синтетической корреляционной матрицы для 12 торговых инструментов (T = 250, Q ≈ 20,8) в сравнении с теоретической верхней границей распределения Марченко — Пастура. Столбцы выше пунктирной линии рассматриваются как соответствующие реальным общим факторам. Значения, представленные столбцами ниже неё, выравниваются как шумовые.
На этом рисунке стоит отметить два момента. Во-первых, на этой иллюстрации используется расширенная синтетическая корзина из 12 торговых инструментов вместо реальной корзины из 4 инструментов, с которой работает советник, исключительно потому, что спектр из 4 собственных значений не позволяет наглядно показать разделение шумовой части спектра и сигнала. Этот принцип применим при любом N, в том числе к нашей небольшой реальной корзине инструментов, но при большем числе собственных значений на экране он виден лучше. Во-вторых, обратите внимание, как мало собственных значений на самом деле превышают установленный порог. В этом синтетическом примере с двумя реальными факторами, лежащими в основе данных, только два собственных значения превышают lambda_max. Остальные по критерию MP относятся к шуму, хотя в исходной корреляционной матрице они и выглядят значимыми. Все рисунки на основе синтетических данных иллюстрируют отдельные механизмы в контролируемых условиях. Советник торгует реальной корзиной из 4 инструментов, а рисунки не отражают измеренные результаты его работы: эти результаты приведены в разделе о тестировании.
Одна небольшая, но практически важная деталь правила классификации: приведённый ниже код проверяет условие eigenvalues[i] > lambda_max (строгое неравенство), а не >=. Это важно лишь в пограничном случае, когда собственное значение оказывается почти точно на границе: тогда оно по умолчанию относится к шуму, а не к сигналу. Это консервативный выбор, поскольку ошибочное отнесение реального фактора к шуму лишь стягивает соответствующее собственное значение к среднему, тогда как ошибочное отнесение шума к сигналу сохраняет собственное значение, которому вообще не следует доверять. Мы не вводили эпсилон-окрестность вокруг lambda_max. Для рассматриваемых здесь размеров корзины инструментов величина lambda_max меняется от выборки к выборке (при изменении Q) сильнее, чем собственные значения, оказавшиеся вблизи теоретической границы. Для более широкой корзины инструментов, собственные значения которой тесно сгруппированы вблизи lambda_max, было бы разумно вернуться к этому вопросу и вместо жесткого порога использовать явно заданную эпсилон-окрестность или функцию мягкого либо непрерывного стягивания.
Спектральное разложение методом Якоби: реализация на MQL5
Для подавления шума требуется спектральное разложение вещественной симметричной матрицы размером N × N — любая корреляционная матрица симметрична по построению, и именно это ограничение делает классический циклический метод Якоби для вычисления собственных значений подходящим решением. Этот алгоритм итеративный, численно устойчив для симметричных матриц, не требует внешней библиотеки линейной алгебры и достаточно прост для реализации на MQL5 без чрезмерного объема кода.
Метод Якоби многократно применяет плоские вращения для обнуления внедиагональных элементов. В каждом проходе выбираются пары (p, q), и к матрице применяется вращение на угол, специально выбранный для обнуления элементов (p, q) и (q, p). После достаточного числа проходов внедиагональные элементы стремятся к нулю, а диагональные — к собственным значениям; накопленное произведение вращений дает собственные векторы.
1. Инициализируйте V как единичную матрицу (она будет накапливать собственные векторы).
2. В каждом проходе переберите все пары (p, q), где p < q.
3. Для каждой пары вычислите угол вращения phi = 0.5 * atan2(2*a[p][q], a[q][q] - a[p][p]).
4. Примените вращение к строкам и столбцам p и q рабочей матрицы, а также к столбцам p и q матрицы V.
5. Повторяйте проходы, пока сумма квадратов внедиагональных элементов не станет меньше заданного допуска или не будет достигнуто предельное число проходов.
6. Считайте собственные значения с диагонали; собственные векторы — это столбцы матрицы V.
Поскольку MQL5 допускает динамическое изменение только первого измерения массива, настоящую матрицу размера N × N, где N определяется во время выполнения, нельзя объявить напрямую как double matrix[][]. Класс CSquareMatrix в этом проекте обходит данное ограничение, храня матрицу в одномерном буфере с ручной построчной индексацией — методы Get(i,j) и Set(i,j,v) вычисляют индекс i*N+j внутри себя. Вот полный код класса, точно такой, какой используется во всех последующих процедурах:
//+------------------------------------------------------------------+
//| Flat-storage square matrix (row-major, 1-D buffer)               |
//+------------------------------------------------------------------+
class CSquareMatrix
  {
public:
    int      N;
    double   Data[];

    void    Init(const int n)
      {
       N = n;
       ArrayResize(Data, N*N);
       ArrayInitialize(Data, 0.0);
      }

    double   Get(const int i, const int j) const { return Data[i*N+j]; }
    void    Set(const int i, const int j, const double v) { Data[i*N+j] = v; }

    void    SetIdentity()
      {
       ArrayInitialize(Data, 0.0);
       for(int i=0; i<N; i++)
          Set(i, i, 1.0);
      }

    void    Copy(const CSquareMatrix &src)
      {
       Init(src.N);
       ArrayCopy(Data, src.Data);
      }
  };
Теперь, когда тип матрицы определен, приведем полный код функции JacobiEigenDecomposition() — не фрагмент, а всю реализацию с циклом проходов, проверкой сходимости, обновлением диагонали и накоплением собственных векторов:
//+------------------------------------------------------------------+
//| Cyclic Jacobi eigenvalue decomposition for a real symmetric      |
//| matrix. Native implementation - no ALGLIB, no external DLLs.     |
//| Eigenvalues come back on the diagonal of the rotated matrix;     |
//| eigenvectors accumulate as columns of V.                         |
//+------------------------------------------------------------------+
bool JacobiEigenDecomposition(const CSquareMatrix &A_in,
                               double &eigenvalues[],
                               CSquareMatrix &V,
                               const int max_sweeps = 100,
                               const double tol = 1.0e-12)
  {
   int n = A_in.N;
   if(n <= 0)
      return false;

   CSquareMatrix A;
   A.Copy(A_in);

   V.Init(n);
   V.SetIdentity();

   ArrayResize(eigenvalues, n);

//--- iterate sweeps until the off-diagonal mass converges below tolerance
   for(int sweep=0; sweep<max_sweeps; sweep++)
     {
      //--- convergence test: sum of squared off-diagonal elements
      double off = 0.0;
      for(int p=0; p<n; p++)
         for(int q=p+1; q<n; q++)
            off += A.Get(p,q)*A.Get(p,q);

      if(off < tol)
         break;

      //--- sweep through every (p,q) pair, applying a Jacobi rotation that zeroes A(p,q)
      for(int p=0; p<n-1; p++)
        {
         for(int q=p+1; q<n; q++)
           {
            double apq = A.Get(p,q);
            if(MathAbs(apq) < 1.0e-15)
               continue;

            double app = A.Get(p,p);
            double aqq = A.Get(q,q);

            //--- rotation angle that zeroes A(p,q) and A(q,p)
            double phi = 0.5*MathArctan2(2.0*apq, aqq-app);
            double c   = MathCos(phi);
            double s   = MathSin(phi);

            //--- rotate columns p, q of the working matrix
            for(int k=0; k<n; k++)
              {
               double akp = A.Get(k,p);
               double akq = A.Get(k,q);
               A.Set(k,p, c*akp - s*akq);
               A.Set(k,q, s*akp + c*akq);
              }
            //--- rotate rows p, q of the working matrix
            for(int k=0; k<n; k++)
              {
               double apk = A.Get(p,k);
               double aqk = A.Get(q,k);
               A.Set(p,k, c*apk - s*aqk);
               A.Set(q,k, s*apk + c*aqk);
              }
            //--- accumulate the same rotation into V (eigenvectors)
            for(int k=0; k<n; k++)
              {
               double vkp = V.Get(k,p);
               double vkq = V.Get(k,q);
               V.Set(k,p, c*vkp - s*vkq);
               V.Set(k,q, s*vkp + c*vkq);
              }
           }
        }
     }

//--- eigenvalues now sit on the diagonal of the fully rotated matrix
   for(int i=0; i<n; i++)
      eigenvalues[i] = A.Get(i,i);

   return true;
  }

//+------------------------------------------------------------------+
//| Sort eigenvalues descending, reordering eigenvector columns      |
//+------------------------------------------------------------------+
void SortEigenDescending(double &eigenvalues[], CSquareMatrix &V)
  {
   int n = ArraySize(eigenvalues);
   for(int i=0; i<n-1; i++)
     {
      int max_idx = i;
      for(int j=i+1; j<n; j++)
         if(eigenvalues[j] > eigenvalues[max_idx])
            max_idx = j;
      if(max_idx != i)
        {
         double tmp = eigenvalues[i];
         eigenvalues[i] = eigenvalues[max_idx];
         eigenvalues[max_idx] = tmp;

         //--- swap the matching eigenvector columns so V stays aligned with eigenvalues
         for(int k=0; k<n; k++)
           {
            double t2 = V.Get(k,i);
            V.Set(k,i, V.Get(k,max_idx));
            V.Set(k,max_idx, t2);
           }
        }
     }
  }
Для рассматриваемых в статье корзин из 4–15 торговых инструментов метод Якоби сходится значительно менее чем за 100 итераций (на практике — за 5–6 проходов для матриц размером 4 × 4 и 12 × 12, использованных в приведенной ниже численной проверке), а вычислительная сложность каждого прохода в худшем случае составляет O(N^3). Такие вычисления без труда укладываются в вызов процедуры ребалансировки, выполняемый каждые 20 баров, а не на каждом тике. Этот алгоритм вряд ли стоит выбирать для набора из 500 инструментов, но для мультивалютной корзины инструментов типичного размера в MetaTrader 5 его более чем достаточно, и при этом вся цепочка обработки обходится без внешних зависимостей.
Алгоритм подавления шума: пошаговое руководство
При наличии процедуры спектрального разложения сама процедура подавления шума состоит всего из нескольких шагов:
1. Постройте матрицу логарифмических доходностей размером T × N для корзины инструментов, синхронизировав данные по временным меткам баров опорного инструмента.
2. Вычислите выборочную корреляционную матрицу Пирсона C_raw на основе матрицы доходностей.
3. Выполните спектральное разложение C_raw с помощью процедуры Якоби, реализованной средствами самого MQL5, и отсортируйте собственные значения по убыванию.
4. Вычислите lambda_max, используя отношение Q = T/N.
5. Разделите собственные значения на две группы: значения выше lambda_max оставьте без изменений, а значения, не превышающие этот порог, замените их общим средним.
6. Восстановите матрицу C_denoised = V * diag(собственные значения после стягивания) * V^T.
7. Повторно симметризуйте матрицу, чтобы уменьшить влияние погрешностей вычислений с плавающей точкой, и принудительно установите все диагональные элементы равными ровно 1.0.
Перед подавлением шума необходимо построить саму корреляционную матрицу на основе доходностей. Ниже приведён полный код функции BuildCorrelationMatrix(), включая проверку на вырожденную дисперсию, о которой говорится далее в разделе, посвящённом крайним случаям:
//+------------------------------------------------------------------+
//| Pearson correlation matrix from a T x N return matrix            |
//+------------------------------------------------------------------+
void BuildCorrelationMatrix(const CRectMatrix &R, CSquareMatrix &C)
  {
   int T = R.Rows;
   int N = R.Cols;
   C.Init(N);

   double mean[], stdev[];
   ArrayResize(mean, N);
   ArrayResize(stdev, N);

//--- pass 1: per-symbol mean return over the window
   for(int j=0; j<N; j++)
     {
      double s = 0.0;
      for(int t=0; t<T; t++)
         s += R.Get(t,j);
      mean[j] = s/T;
     }

//--- pass 2: per-symbol standard deviation, floored to avoid a division by zero below
   for(int j=0; j<N; j++)
     {
      double ss = 0.0;
      for(int t=0; t<T; t++)
        {
         double d = R.Get(t,j) - mean[j];
         ss += d*d;
        }
      stdev[j] = MathSqrt(ss/(T-1));
      if(stdev[j] < 1.0e-12)
         stdev[j] = 1.0e-12; // guard a flat/zero-variance series
     }

//--- pass 3: pairwise Pearson correlation from the covariance and the two stdevs
   for(int i=0; i<N; i++)
     {
      for(int j=0; j<N; j++)
        {
         double cov = 0.0;
         for(int t=0; t<T; t++)
            cov += (R.Get(t,i)-mean[i]) * (R.Get(t,j)-mean[j]);
         cov /= (T-1);
         C.Set(i,j, cov/(stdev[i]*stdev[j]));
        }
     }

//--- diagonal is exactly 1.0 by definition, regardless of any rounding above
   for(int i=0; i<N; i++)
      C.Set(i,i,1.0);
  }
Шаг 5 заслуживает более пристального внимания, поскольку в нём заложен выбор способа обработки. Вместо того чтобы просто обнулять шумовые собственные значения, их заменяют средним значением этой группы. При этом сохраняется след матрицы — сумма всех собственных значений, которая для корреляционной матрицы равна N, то есть общей дисперсии в системе. Если просто обнулить шумовые собственные значения, общая дисперсия уменьшится, а восстановленная матрица перестанет быть корректной корреляционной матрицей (диагональные элементы отклонятся от 1.0 так, что аккуратно исправить это будет сложнее). Усреднение сохраняет общую дисперсию и лишь перераспределяет ее доли, приходящиеся на "реальные" и "шумовые" направления.
Ниже приведён полный код функции DenoiseCorrelationRMT(), которая объединяет все описанные выше компоненты: проверку отношения Q, вызов процедуры спектрального разложения, классификацию, восстановление матрицы с сохранением ее следа и проход повторной симметризации:
//+------------------------------------------------------------------+
//| Marchenko-Pastur denoising of a correlation matrix. Eigenvalues  |
//| at or below the MP upper edge are averaged and replaced          |
//| (trace-preserving, so total variance is unchanged); eigenvalues  |
//| above the edge are treated as genuine common factors and kept    |
//| untouched.                                                       |
//+------------------------------------------------------------------+
bool DenoiseCorrelationRMT(const CSquareMatrix &C_raw, const int T,
                            CSquareMatrix &C_denoised,
                            double &lambda_max_out,
                            int &n_signal_out, int &n_noise_out)
  {
   int N = C_raw.N;
//--- Q must stay well above 1, or the Marchenko-Pastur edge becomes meaningless
   if(T <= N)
     {
      Print("RMT: T <= N, Marchenko-Pastur Q ratio collapses - refusing to denoise.");
      return false;
     }

//--- theoretical MP upper edge: eigenvalues at or below this are indistinguishable from noise
   double Q = (double)T / (double)N;
   double sigma2 = 1.0; // correlation matrix: mean eigenvalue is 1 by construction
   double lambda_max = sigma2 * MathPow(1.0 + 1.0/MathSqrt(Q), 2.0);
   lambda_max_out = lambda_max;

//--- eigendecompose, then sort descending so the largest (most likely genuine) eigenvalues come first
   double eigenvalues[];
   CSquareMatrix V;
   if(!JacobiEigenDecomposition(C_raw, eigenvalues, V))
      return false;

   SortEigenDescending(eigenvalues, V);

//--- classify each eigenvalue against lambda_max and accumulate the noise average
   int n_signal = 0, n_noise = 0;
   double noise_sum = 0.0;

   for(int i=0; i<N; i++)
     {
      if(eigenvalues[i] > lambda_max)
         n_signal++;
      else
        {
         noise_sum += eigenvalues[i];
         n_noise++;
        }
     }

//--- trace-preserving shrinkage: replace every noise eigenvalue with their shared average
   double noise_avg = (n_noise > 0) ? noise_sum/n_noise : 0.0;

   double denoised_eig[];
   ArrayResize(denoised_eig, N);
   for(int i=0; i<N; i++)
      denoised_eig[i] = (eigenvalues[i] > lambda_max) ? eigenvalues[i] : noise_avg;

   ReconstructFromEigen(denoised_eig, V, C_denoised);

//--- re-symmetrize for floating point safety, then force the diagonal back to exactly 1.0
   int n = C_denoised.N;
   for(int i=0; i<n; i++)
     {
      for(int j=i; j<n; j++)
        {
         double avg = (C_denoised.Get(i,j) + C_denoised.Get(j,i)) / 2.0;
         C_denoised.Set(i,j, avg);
         C_denoised.Set(j,i, avg);
        }
     }
   for(int i=0; i<n; i++)
      C_denoised.Set(i,i, 1.0);

   n_signal_out = n_signal;
   n_noise_out  = n_noise;
   return true;
  }
Исходная корреляционная матрица (синтетическая корзина из 12 торговых инструментов)
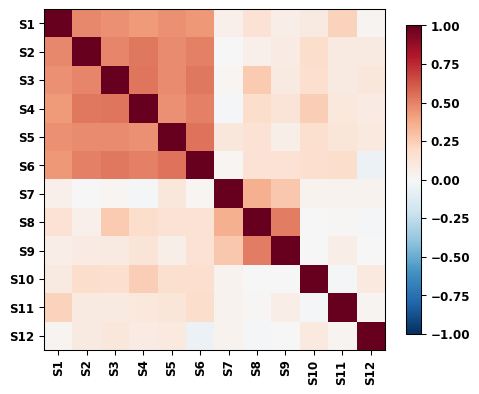
Рис. 2a. Исходная выборочная корреляционная матрица для той же синтетической корзины из 12 инструментов, что и на рис. 1.
Корреляционная матрица после подавления шума (та же корзина инструментов, после очистки на основе распределения Марченко — Пастура)
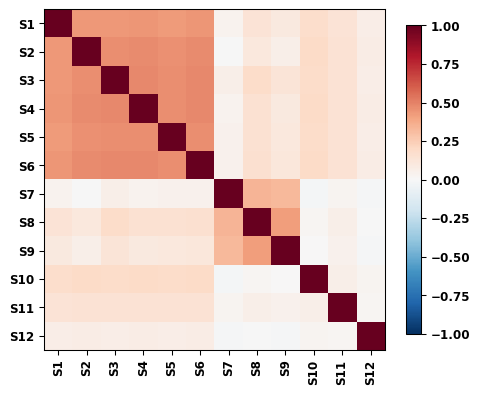
Рис. 2b. Та же матрица после подавления шума на основе распределения Марченко — Пастура. Более слабые внедиагональные элементы, обусловленные шумом, заметно сближаются с общим уровнем стягивания, тогда как блоки с сильными связями, обусловленными факторами (S1–S6, S7–S9), остаются различимыми.
Одно из последствий этого легко упустить из виду, пока не увидишь его на графике: матрица после подавления шума не просто выглядит "более гладкой" в каком-то неопределенном эстетическом смысле — отдельные корреляции, обусловленные шумом, действительно становятся ближе друг к другу, поскольку все они стягиваются к одному и тому же среднему шумовых собственных значений. Реальные взаимосвязи, обусловленные факторами, остаются различимыми, а ложные сближаются с общим базовым уровнем. В этом-то и суть.
На тепловой карте этот эффект виден сразу, но изменения конкретных чисел часто убеждают сильнее. Ниже приведена конкретная корреляционная матрица размером 4×4 до и после подавления шума — для корзины того же размера, из 4 инструментов, и с тем же окном ретроспективного анализа T=250, которые использует советник в рабочем режиме. Матрица получена в ходе той же численной проверки, результаты которой представлены в таблице в следующем разделе:
Исходная матрица C:
1,00 0,41 0,22 0,12
0,41 1,00 0,20 0,13
0,22 0,20 1,00 0,26
0,12 0,13 0,26 1,00
Матрица C после подавления шума:
1,00 0,28 0,25 0,20
0,28 1,00 0,25 0,19
0,25 0,25 1,00 0,17
0,20 0,19 0,17 1,00
Самая сильная исходная корреляция (0,41 между инструментами 1 и 2) остается самой сильной и в матрице после подавления шума (0,28): она уменьшилась, но не исчезла, поскольку входит в структуру связей, отражаемую единственным сигнальным собственным значением в этом окне. Более слабые исходные элементы (0,12 и 0,13) возрастают, приближаясь к тому же диапазону стягивания, вместо того чтобы оставаться на исходных, более зашумленных уровнях: это тот же эффект "стягивания шума к общему среднему", который виден на тепловой карте, но уже в конкретных числах.
О положительной полуопределенности (PSD): восстановление матрицы по неотрицательным собственным значениям алгебраически сохраняет PSD. Однако последующие шаги повторной симметризации и принудительного задания диагонали могут внести возмущения в матрицу и не гарантируют сохранения PSD. Это проверялось непосредственно, а не принималось на веру: минимальное собственное значение приведённой выше матрицы 4×4 после полной постобработки составляет 0,72, то есть остаётся уверенно положительным. Стресс-тест на 500 случайно сгенерированных синтетических корзинах из N=4–12 активов также не выявил ни одного случая отрицательного собственного значения после полной постобработки. Это не является формальным доказательством для всех возможных входных данных: если собственные значения матрицы корзины инструментов до подавления шума сосредоточены очень близко к нулю, результат в принципе может быть менее устойчивым. Поэтому для гораздо более крупной корзины или более вырожденной матрицы разумной защитной мерой будет добавить явный шаг коррекции путем поиска ближайшей корреляционной матрицы. Для проверенных здесь размеров и данных в этом не было необходимости.
Чтобы проверить, дает ли подавление шума практическую пользу помимо более наглядного вида матрицы, советник в каждом цикле записывает в журнал расстояние по норме Фробениуса между текущей корреляционной матрицей и матрицей предыдущей ребалансировки — отдельно для исходных матриц и матриц после подавления шума. Если подавление шума работает должным образом, это расстояние должно быть стабильно меньше для последовательности матриц после подавления шума, то есть матрица, используемая для расчета объема позиций, не должна резко меняться от одной ребалансировки к другой только из-за шума оценивания.
Стабильность по норме Фробениуса в скользящих окнах: исходные матрицы и матрицы после подавления шума
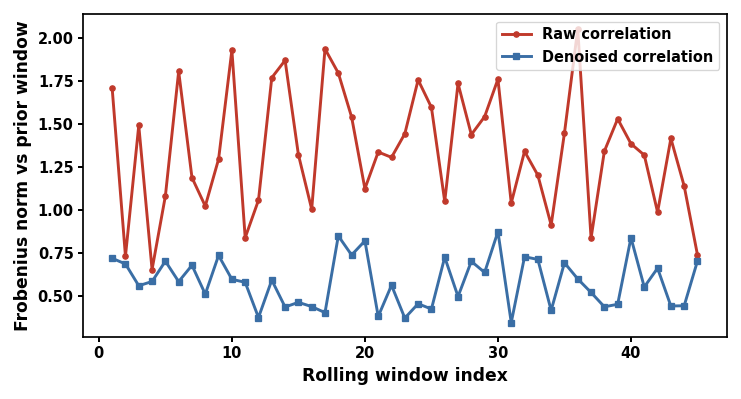
Рис. 3. Расстояние по норме Фробениуса между корреляционными матрицами в последовательных окнах ребалансировки: сравнение исходных матриц и матриц после подавления шума по 45 скользящим окнам по данным журнала для этой корзины инструментов. Для последовательности матриц после подавления шума это расстояние в среднем меньше и слабее меняется от окна к окну.
Именно этот диагностический показатель важнее любой отдельно взятой кривой средств счета при тестировании на исторических данных — это прямая проверка, не опирающаяся на модель, которая показывает, выполняет ли этап предварительной обработки заявленную задачу, независимо от прибыльности последующей торговой логики в конкретном периоде.
Детали реализации: от тика до сделки
Описанные выше компоненты по отдельности просты, но именно связи между ними делают эту статью материалом о реализации на MQL5, а не отдельной математической заметкой. В этом разделе подробно описано, как организован проект и как выполняется полный цикл ребалансировки от начала до конца.
Структура файлов:
MQL5\Include\RMTDenoise\RMTMath.mqh — CSquareMatrix, CRectMatrix, JacobiEigenDecomposition(), SortEigenDescending(), ReconstructFromEigen(), FrobeniusNormDiff(), DenoiseCorrelationRMT(). Не зависит от других файлов проекта.
MQL5\Include\RMTDenoise\RMTData.mqh — ParseSymbolList(), ValidateBasketSymbols(), BuildLogReturnMatrix(), BuildCorrelationMatrix(), пара функций чтения и записи манифеста конфигурации, а также модуль ведения журнала аудита в формате CSV. Включает файл RMTMath.mqh.
MQL5\Experts\RMTDenoise\RMT_Basket_EA.mq5 — OnInit(), OnTick(), Rebalance(), ManagePosition(). Включает оба указанных выше заголовочных файла, а также стандартный файл Trade\Trade.mqh.
MQL5\Files\RMTDenoise\rmt_analysis.py — скрипт для перекрестной проверки с помощью NumPy, построения графиков и проверки результатов, выполняемый исключительно отдельно от советника. Никогда не загружается советником.
Все публичные функции, используемые советником, перечислены выше — никакой скрытой логики в других файлах нет. Код CSquareMatrix, JacobiEigenDecomposition(), BuildCorrelationMatrix() и DenoiseCorrelationRMT() уже полностью приведен выше. Остальные функции приведены ниже в полном виде, а не просто описаны — каждая из них взята без изменений из файлов, входящих в прилагаемый архив MQL5.zip.
CRectMatrix использует тот же подход с одномерным буфером, что и CSquareMatrix, для хранения прямоугольной матрицы доходностей размером T × N:
//+------------------------------------------------------------------+
//| Rectangular T (rows) x N (cols) matrix - used for the return     |
//| series feeding the correlation estimate                          |
//+------------------------------------------------------------------+
class CRectMatrix
  {
public:
    int      Rows;
    int      Cols;
    double   Data[];

    void    Init(const int rows, const int cols)
      {
       Rows = rows;
       Cols = cols;
       ArrayResize(Data, Rows*Cols);
       ArrayInitialize(Data, 0.0);
      }

    double   Get(const int r, const int c) const { return Data[r*Cols+c]; }
    void    Set(const int r, const int c, const double v) { Data[r*Cols+c] = v; }
  };
ReconstructFromEigen() восстанавливает матрицу M = V * diag(eigenvalues) * V^T — этот способ восстановления используется как для матрицы после подавления шума, так и, при необходимости, для контрольного восстановления исходной корреляционной матрицы при отладке:
//+------------------------------------------------------------------+
//| Reconstruct a symmetric matrix: M = V * diag(eigenvalues) * V^T  |
//+------------------------------------------------------------------+
void ReconstructFromEigen(const double &eigenvalues[], const CSquareMatrix &V, CSquareMatrix &M)
  {
   int n = V.N;
   M.Init(n);
   for(int i=0; i<n; i++)
     {
       for(int j=0; j<n; j++)
         {
           double sum = 0.0;
           for(int k=0; k<n; k++)
             sum += V.Get(i,k) * eigenvalues[k] * V.Get(j,k);
           M.Set(i,j,sum);
         }
     }
  }

//+------------------------------------------------------------------+
//| Frobenius norm of the difference between two same-sized matrices |
//+------------------------------------------------------------------+
double FrobeniusNormDiff(const CSquareMatrix &A, const CSquareMatrix &B)
  {
   double s = 0.0;
   int n = A.N;
   for(int i=0; i<n; i++)
     for(int j=0; j<n; j++)
       {
         double d = A.Get(i,j) - B.Get(i,j);
         s += d*d;
       }
   return MathSqrt(s);
  }
Разбор и проверка списка торговых инструментов — ParseSymbolList() разбивает входную строку по запятым, а ValidateBasketSymbols() явно сообщает об ошибке инициализации в OnInit(), чтобы опечатка в названии или недоступность инструмента не привели к незаметному пропуску данных в ходе работы:
//+------------------------------------------------------------------+
//| Split a comma-separated symbol list into a string array          |
//+------------------------------------------------------------------+
int ParseSymbolList(const string list, string &out_symbols[])
  {
   int n = StringSplit(list, ',', out_symbols);
   for(int i=0; i<n; i++)
     {
      StringTrimLeft(out_symbols[i]);
      StringTrimRight(out_symbols[i]);
     }
   return n;
  }

//+------------------------------------------------------------------+
//| Verify every symbol in the basket is available and selected.     |
//| Fails loudly (returns false) on any missing symbol - this EA     |
//| refuses to run on an incomplete basket rather than silently      |
//| shrinking it.                                                    |
//+------------------------------------------------------------------+
bool ValidateBasketSymbols(const string &symbols[], const int n)
  {
   for(int i=0; i<n; i++)
     {
      if(!SymbolSelect(symbols[i], true))
        {
         PrintFormat("RMT: symbol '%s' could not be selected in Market Watch - aborting.", symbols[i]);
         return false;
        }
     }
   return true;
  }
BuildLogReturnMatrix() — функция, на которую неоднократно ссылается расположенный ниже раздел "Пограничные случаи и возможные проблемы". Она синхронизирует данные по точному совпадению временных меток с опорным инструментом и прерывает весь цикл, если хотя бы у одного инструмента отсутствует соответствующий бар:
//+------------------------------------------------------------------+
//| Build a T x N matrix of log returns for the basket, aligned on   |
//| the bar-close timestamps of symbols[0] (the anchor symbol).      |
//| Fails loudly if any symbol lacks a bar matching an anchor time.  |
//+------------------------------------------------------------------+
bool BuildLogReturnMatrix(const string &symbols[], const int n,
                           const ENUM_TIMEFRAMES tf, const int lookback_bars,
                           CRectMatrix &returns_out)
  {
   int T = lookback_bars;

   double anchor_close[];
   datetime anchor_time[];
   if(CopyClose(symbols[0], tf, 0, T+1, anchor_close) < T+1 ||
      CopyTime(symbols[0], tf, 0, T+1, anchor_time) < T+1)
     {
      PrintFormat("RMT: insufficient history on anchor symbol '%s'.", symbols[0]);
      return false;
     }
   ArraySetAsSeries(anchor_close, true);
   ArraySetAsSeries(anchor_time, true);

   returns_out.Init(T, n);

   for(int s=0; s<n; s++)
     {
      double closes[];
      datetime times[];
      //--- pull a slightly wider window - feed gaps differ slightly between symbols
      if(CopyClose(symbols[s], tf, 0, T+5, closes) < T+1 ||
         CopyTime(symbols[s], tf, 0, T+5, times) < T+1)
        {
         PrintFormat("RMT: insufficient history on basket symbol '%s'.", symbols[s]);
         return false;
        }
      ArraySetAsSeries(closes, true);
      ArraySetAsSeries(times, true);

      for(int t=0; t<T; t++)
        {
         int idx = -1;
         for(int k=0; k<ArraySize(times)-1; k++)
           {
            if(times[k] == anchor_time[t])
              {
               idx = k;
               break;
              }
           }
         if(idx < 0)
           {
            PrintFormat("RMT: could not align bar for '%s' at %s - aborting rebalance.",
                        symbols[s], TimeToString(anchor_time[t]));
            return false;
           }
         double r = MathLog(closes[idx] / closes[idx+1]);
         returns_out.Set(t, s, r);
        }
     }
   return true;
  }
Пара функций чтения и записи манифеста конфигурации — ReadManifestDouble() выполняет минимальный разбор плоского JSON для поиска известных числовых ключей и не является универсальным синтаксическим анализатором, а LoadOrCreateManifest() при первом запуске записывает разумные значения по умолчанию, вместо того чтобы выдавать ошибку, если файл еще не существует:
//+------------------------------------------------------------------+
//| Minimal flat-JSON reader for known numeric keys - not a general  |
//| parser, just enough for this EA's fixed manifest schema.         |
//+------------------------------------------------------------------+
bool ReadManifestDouble(const string &json_text, const string key, double &value_out)
  {
//--- locate the "key" token, then the colon that separates key from value
   string needle = "\"" + key + "\"";
   int pos = StringFind(json_text, needle);
   if(pos < 0)
      return false;
   int colon = StringFind(json_text, ":", pos);
   if(colon < 0)
      return false;
//--- the value ends at whichever comes first: the next comma or the closing brace
   int comma = StringFind(json_text, ",", colon);
   int brace = StringFind(json_text, "}", colon);
   int endpos = (comma>=0 && (comma<brace || brace<0)) ? comma : brace;
   if(endpos < 0)
      return false;
   string val = StringSubstr(json_text, colon+1, endpos-colon-1);
   StringTrimLeft(val);
   StringTrimRight(val);
   value_out = StringToDouble(val);
   return true;
  }

//+------------------------------------------------------------------+
//| Load manifest from FILE_COMMON, or write sane defaults if absent |
//+------------------------------------------------------------------+
void LoadOrCreateManifest(const string filename,
                           double &risk_pct, int &rebalance_bars,
                           int &momentum_lookback, double &zscore_threshold)
  {
//--- manifest missing: write one with the current defaults and return without overriding anything
   int h = FileOpen(filename, FILE_READ|FILE_TXT|FILE_COMMON|FILE_ANSI);
   if(h == INVALID_HANDLE)
     {
      int hw = FileOpen(filename, FILE_WRITE|FILE_TXT|FILE_COMMON|FILE_ANSI);
      if(hw != INVALID_HANDLE)
        {
         string json = StringFormat(
            "{\n  \"risk_pct\": %.2f,\n  \"rebalance_bars\": %d,\n  \"momentum_lookback\": %d,\n  \"zscore_threshold\": %.2f\n}",
            risk_pct, rebalance_bars, momentum_lookback, zscore_threshold);
         FileWriteString(hw, json);
         FileClose(hw);
         PrintFormat("RMT: manifest '%s' not found - created with defaults.", filename);
        }
      return;
     }

//--- manifest exists: read it whole, then override each parameter the manifest actually defines
   string content = "";
   while(!FileIsEnding(h))
      content += FileReadString(h);
   FileClose(h);

   double v;
   if(ReadManifestDouble(content, "risk_pct", v))          risk_pct = v;
   if(ReadManifestDouble(content, "rebalance_bars", v))    rebalance_bars = (int)v;
   if(ReadManifestDouble(content, "momentum_lookback", v)) momentum_lookback = (int)v;
   if(ReadManifestDouble(content, "zscore_threshold", v))  zscore_threshold = v;
  }
LogRebalanceCSV() добавляет по одной строке на каждую ребалансировку в журнал аудита в FILE_COMMON, записывая заголовок только при первом создании файла:
//+------------------------------------------------------------------+
//| Append one rebalance record to the FILE_COMMON CSV audit log     |
//+------------------------------------------------------------------+
void LogRebalanceCSV(const string filename, const datetime ts,
                      const double lambda_max, const int n_signal, const int n_noise,
                      const double frob_raw, const double frob_denoised)
  {
   bool exists = FileIsExist(filename, FILE_COMMON);
   int h = FileOpen(filename, FILE_READ|FILE_WRITE|FILE_TXT|FILE_COMMON|FILE_ANSI);
   if(h == INVALID_HANDLE)
     {
      PrintFormat("RMT: could not open log file '%s' (error %d).", filename, GetLastError());
      return;
     }
   if(!exists)
      FileWrite(h, "timestamp", "lambda_max", "n_signal", "n_noise", "frob_raw_vs_prev", "frob_denoised_vs_prev");

   FileSeek(h, 0, SEEK_END);
   FileWrite(h, TimeToString(ts, TIME_DATE|TIME_MINUTES), DoubleToString(lambda_max,5),
             n_signal, n_noise, DoubleToString(frob_raw,6), DoubleToString(frob_denoised,6));
   FileClose(h);
  }
Приведенный ниже фрагмент кода Rebalance() взят без изменений из поставляемого советника и наглядно демонстрирует, как вышеуказанные функции вызываются последовательно:
//+------------------------------------------------------------------+
//| Core rebalance routine: rebuild returns -> correlation ->        |
//| RMT-denoise -> derive weights and directional signals -> trade   |
//+------------------------------------------------------------------+
void Rebalance()
  {
   CRectMatrix returns;
   if(!BuildLogReturnMatrix(g_symbols, g_n_symbols, InpTimeframe, InpLookbackBars, returns))
      return; // failure already logged; skip this cycle rather than trade on bad data

   CSquareMatrix C_raw;
   BuildCorrelationMatrix(returns, C_raw);

   CSquareMatrix C_denoised;
   double lambda_max;
   int n_signal, n_noise;
   if(!DenoiseCorrelationRMT(C_raw, InpLookbackBars, C_denoised, lambda_max, n_signal, n_noise))
      return;

//--- Frobenius distance to the previous cycle's matrices is the stability diagnostic (Fig. 3)
   double frob_raw = 0.0, frob_denoised = 0.0;
   if(g_have_prev)
     {
      frob_raw       = FrobeniusNormDiff(C_raw, g_prev_raw);
      frob_denoised  = FrobeniusNormDiff(C_denoised, g_prev_denoised);
     }

   LogRebalanceCSV(InpLogFile, TimeCurrent(), lambda_max, n_signal, n_noise, frob_raw, frob_denoised);

//--- InpUseDenoisedCorr toggles which matrix actually drives sizing, for raw-vs-denoised comparison runs
   CSquareMatrix &C_used = InpUseDenoisedCorr ? C_denoised : C_raw;

//--- weights and momentum z-score: shown in the next section
  }
А вот псевдокод всего жизненного цикла торгового советника (EA) — для тех, кто бегло просматривает текст, а не читает тело каждой функции:
OnInit(): разобрать список торговых инструментов -> проверить, что каждый инструмент доступен для выбора -> проверить, что InpLookbackBars > количество инструментов -> загрузить или создать манифест конфигурации в формате JSON -> установить магический номер.
OnTick(): обнаружить новый бар на опорном инструменте -> увеличить счетчик баров -> если счетчик < InpRebalanceBars, выйти из функции -> иначе сбросить счетчик и вызвать Rebalance().
Rebalance(): построить синхронизированную матрицу логарифмических доходностей размером T × N -> построить исходную корреляционную матрицу -> выполнить подавление шума с помощью теории случайных матриц (RMT) (спектральное разложение методом Якоби + классификация по распределению Марченко — Пастура + восстановление с сохранением следа матрицы) -> записать в CSV lambda_max, количество сигнальных и шумовых собственных значений и расстояния по норме Фробениуса -> по выбранной матрице вычислить веса, пропорциональные величине 1 / (1 + сумма модулей корреляций с остальными инструментами) -> вычислить z-оценку импульса для каждого инструмента -> вызвать ManagePosition() для каждого инструмента -> сохранить матрицы текущего цикла как "предыдущие" для следующего сравнения по норме Фробениуса.
ManagePosition(): рассчитать бюджет риска на основе средств счета и веса -> преобразовать его в объем в лотах с учетом размера контракта, округлить вниз до кратного шагу объема и ограничить допустимыми минимумом и максимумом -> закрыть позицию при смене направления -> открыть позицию в новом направлении, если соответствующей позиции еще нет.
Проверка реализации на MQL5
Утверждать, что реализация на MQL5 спектрального разложения методом Якоби работает, — не то же самое, что продемонстрировать ее работоспособность. Для проверки алгоритм, приведенный выше в JacobiEigenDecomposition(), построчно перенесен на Python — с той же структурой проходов, тем же критерием сходимости, той же формулой вращения и тем же накоплением собственных векторов. Результаты его выполнения сравнены с результатами eigh() из NumPy, использующей LAPACK и служащей независимым надежным эталоном. Это подтверждает, что алгоритм, описанный в коде MQL5 данной статьи, выдает численно правильные собственные значения и собственные векторы. При этом не утверждается, что данный файл .mq5 был скомпилирован и запущен в терминале MetaTrader именно для составления этой таблицы.
| Проверка | N = 4, T = 250 (Q = 62,5) | N = 12, T = 250 (Q = 20,83) |
|---|---|---|
| Число проходов до сходимости | 5 | 6 |
| Максимальная абсолютная ошибка собственных значений относительно eigh из NumPy | 4,44e-16 | 1,01e-11 |
| Погрешность восстановления ||C - VDV^T|| F | 7,84e-16 | 9,41e-07 |
| Ортонормальность max|V^T V - I| | 5,55e-16 | 1,11e-15 |
| Симметрия матрицы после подавления шума: max|D - D^T| | 0,0 | 0,0 |
| Диагональ матрицы после подавления шума: max|diag - 1.0| | 0,0 | 0,0 |
| lambda_max / n_signal / n_noise | 1,269 / 1 / 3 | 1,486 / 2 / 10 |
Все погрешности собственных значений находятся на уровне погрешностей вычислений с плавающей точкой двойной точности или близки к нему (1e-11 или меньше), погрешность восстановления пренебрежимо мала относительно масштаба самой матрицы, столбцы V остаются ортонормированными в пределах машинной точности, а постобработка при подавлении шума дает строго симметричную матрицу с точной единичной диагональю — шаги повторной симметризации и принудительной установки единиц на диагонали в функции DenoiseCorrelationRMT() выполняют свою задачу, а не просто маскируют накопленные отклонения. В случае с 12 торговыми инструментами погрешность восстановления несколько больше (но по-прежнему крайне мала), что вполне ожидаемо: большее число проходов и вращений означает большее накопление погрешностей округления при вычислениях с плавающей точкой, а не недостаток алгоритма.
Эта таблица служит для проверки корректности алгоритма, а не представляет собой отчет о компиляции в терминале. Она подтверждает корректность математического описания, но сама по себе не подтверждает, что файлы .mq5/.mqh компилируются без ошибок и работают без ошибок выполнения в терминале MetaTrader 5 на реальном или демо-счете. Получение такого подтверждения — журнала компиляции, вывода на вкладке "Эксперты" терминала или фрагмента CSV-файла, действительно записанного функцией LogRebalanceCSV() при фактическом запуске, — отдельный необходимый этап, который эта статья не заменяет.
Архитектура советника для торговли корзиной инструментов: веса, импульс и расчет объема позиций
После проверки самого этапа подавления шума в корреляционной матрице в оставшейся части раздела показан один простой наглядный способ использования его результата. Вместо предложенной схемы можно использовать собственный оптимизатор дисперсии портфеля, калькулятор коэффициента хеджирования или фильтр пар — очищенная матрица точно так же будет служить для них входными данными. Каждые InpRebalanceBars баров советник заново строит матрицу доходностей, вычисляет корреляционную матрицу и выполняет подавление шума в ней, а затем на ее основе получает два результата: набор весов инструментов в корзине и сигнал о направлении сделки для каждого торгового инструмента.
Схема взвешивания намеренно проста: вес каждого инструмента обратно пропорционален сумме модулей его корреляций с остальными инструментами. Для инструмента i просуммируйте модули корреляций со всеми остальными инструментами в корзине, затем задайте вес, обратно пропорциональный этой сумме:
double row_abs_sum = 0.0;
for(int j=0; j<g_n_symbols; j++)
   if(j != i)
      row_abs_sum += MathAbs(C_used.Get(i,j));
raw_weight[i] = 1.0 / (1.0 + row_abs_sum);
Логика такова: инструмент, тесно связанный с остальными инструментами в корзине, создает в значительной степени избыточную экспозицию — если у вас уже есть три актива, которые движутся синхронно, добавление четвертого, сильно коррелирующего со всеми ними, концентрирует риск, не обеспечивая никакой диверсификации. Уменьшение веса ограничивает эту избыточность.
Если выразить это словами, то с утверждением "веса получаются разными" легко согласиться, но трудно представить себе, как это выглядит. Применение приведенной выше формулы к тем же показанным ранее матрицам размером 4×4 — исходной и после подавления шума — позволяет наглядно продемонстрировать это:
| Торговый инструмент | Сумма corr по строке исходной матрицы | Вес по исходной матрице | Сумма corr по строке матрицы после подавления шума | Вес по матрице после подавления шума |
|---|---|---|---|---|
| S1 | 0,7471 | 0,2381 | 0,7203 | 0,2418 |
| S2 | 0,7426 | 0,2387 | 0,7177 | 0,2421 |
| S3 | 0,6803 | 0,2475 | 0,6641 | 0,2499 |
| S4 | 0,5089 | 0,2757 | 0,5627 | 0,2662 |
S4 — самый наглядный пример: у него самые слабые корреляции с остальными инструментами корзины в исходной матрице (сумма по строке 0,51), поэтому при расчете объема позиций по этой матрице ему присваивается наибольший вес (0,2757). Подавление шума повышает сумму по его строке до 0,56: впечатление, что "S4 слабо коррелирует с остальными инструментами", которое создавала исходная матрица, отчасти объяснялось тем, что шум занижал парные корреляции с другими инструментами, а не действительно более слабой связью. В результате вес S4 снижается до 0,2662, а высвободившаяся доля бюджета перераспределяется в пользу S1–S3. Для этой корзины из четырех инструментов сдвиг составляет несколько процентных пунктов. В корзине с более неравномерным распределением шума или при большем N тот же механизм приводит к более значительному перераспределению.
Сигнал направления сделки не зависит от корреляционной матрицы: это простая z-оценка доходности за InpMomentumLookback баров для каждого инструмента, рассчитанная по тому же ряду доходностей, который уже сформирован для оценки корреляции (без повторных запросов исторических данных):
double z = (last_return - mean) / sd;
int direction = 0;
if(z >  g_zscore_threshold) direction =  1;
if(z < -g_zscore_threshold) direction = -1;
Затем при расчете объема позиций вес инструмента в корзине умножается на бюджет риска, а результат переводится в лоты с учетом размера контракта по этому инструменту. Полученный объем округляется вниз до кратного шагу объема, установленному брокером, и ограничивается минимальным и максимальным допустимыми объемами. Вот полный текст функции ManagePosition(), взятый без изменений из поставляемого советника:
//+------------------------------------------------------------------+
//| Bring a single symbol's position in line with the target         |
//| direction and basket weight. Simplified sizing: position value   |
//| = weight * (equity * risk_pct/100); converted to lots via price. |
//| This is illustrative sizing for the article, not a full margin   |
//| model - flagged here and in the article's edge-cases section.    |
//+------------------------------------------------------------------+
void ManagePosition(const string symbol, const int direction, const double weight)
  {
   double equity = AccountInfoDouble(ACCOUNT_EQUITY);
   double risk_budget = equity * (g_risk_pct/100.0);
   double position_value = weight * risk_budget;

   double price = (direction >= 0) ? SymbolInfoDouble(symbol, SYMBOL_ASK)
                                    : SymbolInfoDouble(symbol, SYMBOL_BID);
   double contract_size = SymbolInfoDouble(symbol, SYMBOL_TRADE_CONTRACT_SIZE);
   double vol_step = SymbolInfoDouble(symbol, SYMBOL_VOLUME_STEP);
   double vol_min  = SymbolInfoDouble(symbol, SYMBOL_VOLUME_MIN);
   double vol_max  = SymbolInfoDouble(symbol, SYMBOL_VOLUME_MAX);

   double target_lots = 0.0;
   if(direction != 0 && price > 0.0 && contract_size > 0.0)
     {
      target_lots = position_value / (price * contract_size);
      target_lots = MathFloor(target_lots/vol_step) * vol_step; // floor to the broker's tradable volume step
      target_lots = MathMax(vol_min, MathMin(vol_max, target_lots));
     }

   bool has_position = PositionSelect(symbol);
   long pos_type = has_position ? (long)PositionGetInteger(POSITION_TYPE) : -1;
   int  pos_dir  = (pos_type == POSITION_TYPE_BUY) ? 1 : (pos_type == POSITION_TYPE_SELL) ? -1 : 0;

   if(direction == 0)
     {
      if(has_position)
         trade.PositionClose(symbol); // signal flattened: close and stay out
      return;
     }

   if(has_position && pos_dir != direction)
      trade.PositionClose(symbol); // direction flipped: close before opening the new side

   has_position = PositionSelect(symbol);
   if(!has_position && target_lots >= vol_min)
     {
      if(direction > 0)
         trade.Buy(target_lots, symbol);
      else
         trade.Sell(target_lots, symbol);
     }
  }
Все настраиваемые параметры хранятся в JSON-манифесте конфигурации в FILE_COMMON, а не задаются жестко в коде, а журнал ребалансировки записывается в сопутствующий CSV-файл в том же общем расположении, поэтому оба файла сохраняются при работе в разных изолированных средах агентов Тестера стратегий.
Длина окна ретроспективного анализа T и частота ребалансировки взаимосвязаны: при фиксированном размере корзины увеличение T повышает Q, сужает основную часть спектра MP и делает разделение шума и сигнала более четким, но замедляет реакцию на реальную смену рыночного режима. На практике расчетное окно T длиной около 200–300 баров M5 в сочетании с ребалансировкой каждые 15–30 баров обеспечило разумный баланс для протестированной здесь корзины из четырех инструментов.
Пограничные случаи и возможные проблемы
В ходе разработки возникло несколько моментов, о которых стоит упомянуть прямо, а не оставлять их неявными в коде.
Проверка ограничения на отношение Q обязательна. Когда T близко к N, Q приближается к 1, а верхняя граница распределения Марченко — Пастура стремится к бесконечности — в таком случае буквально каждое собственное значение матрицы будет отнесено к "шуму", что лишает метод смысла. Функция OnInit() не допускает запуска, если InpLookbackBars <= числу торговых инструментов в корзине, а функция DenoiseCorrelationRMT() в качестве защитной меры повторяет эту проверку перед каждой ребалансировкой на случай, если размер корзины изменится во время выполнения из-за редактирования списка инструментов.
Совпадение баров разных инструментов по времени не гарантируется. У разных инструментов могут различаться расписания торговых сессий и праздничных дней, а в потоках котировок могут быть пропуски: например, металл может торговаться в сессию, когда ликвидность валютной пары низкая, или наоборот. Функция BuildLogReturnMatrix() синхронизирует каждый инструмент корзины по точным временным меткам баров опорного инструмента и прерывает весь цикл ребалансировки, если хотя бы у одного инструмента нет соответствующего бара, вместо того чтобы молча исключить этот инструмент или подставить устаревшую цену. Если в текущем цикле не удается синхронизировать бары инструментов корзины, ребалансировка просто пропускается, а существующие позиции и веса сохраняются до следующей попытки.
Вырожденная дисперсия. Если цена торгового инструмента почти не меняется на протяжении расчетного окна (из-за неликвидности инструмента или проблемы с потоком котировок), стандартное отклонение оказывается близким к нулю, что приводит к почти нулевому знаменателю в формуле корреляции. Функция BuildCorrelationMatrix() задает нижнюю границу стандартного отклонения равной малому значению эпсилон, чтобы избежать деления на ноль: это не устраняет серьезные неполадки в потоке котировок, но не дает одному проблемному инструменту вызвать сбой расчета всей матрицы.
Замена шумовых собственных значений их средним — один из допустимых вариантов, но не единственный. Некоторые опубликованные варианты методов подавления шума стягивают шумовые собственные значения к нулю или применяют непрерывную функцию стягивания вместо жесткого порога lambda_max. Используемое здесь усреднение с сохранением следа матрицы — хорошо зарекомендовавшийся простой базовый метод, но при адаптации к гораздо более крупной корзине инструментов (из десятков инструментов) стоит протестировать альтернативы на основе стягивания: жесткий порог может быть чувствителен к собственным значениям, находящимся непосредственно у границы распределения MP.
Расчет объема позиций приведен для иллюстрации и не заменяет механизм расчета и контроля маржи. Процедура ManagePosition() переводит целевую экспозицию в долларах в объем в лотах, используя размер контракта и текущую цену, без явной проверки маржи, ограничения портфельного VaR с учетом корреляций и обработки частичного исполнения. Для работы на реальном счете поверх этой процедуры необходим полноценный модуль контроля маржи и экспозиции: вклад статьи заключается в этапе подавления шума в корреляционной матрице и его использовании при расчете объема позиций, а не в создании полной системы управления рисками.
Результаты тестирования и экспериментов
Следует отдельно проверить два аспекта: (1) повышает ли подавление шума методами теории случайных матриц (RMT) стабильность матрицы и весов; (2) что показывает полноценное тестирование торговой стратегии на исторических данных с учетом реального исполнения, спреда и комиссии. Первый аспект в статье можно полностью проверить на основе реально выполненных численных расчетов. Для проверки второго аспекта необходим фактический прогон в Тестере стратегий на исторических данных брокера. Приведенная ниже воспроизводимая конфигурация позволяет выполнить этот прогон и независимо проверить его результаты, но статья не подменяет его вымышленными показателями прибыли и убытка.
Воспроизводимая конфигурация тестирования: XAUUSD, EURUSD, GBPUSD, USDJPY (суффиксы, зависящие от брокера, например, ".raw" или "-ECN", следует добавить так, чтобы названия соответствовали названиям в окне "Обзор рынка" вашего терминала — советник считывает названия торговых инструментов точно так, как они указаны в InpSymbolsList, без удаления суффиксов). Таймфрейм M5. Часовой пояс сервера/терминала, указанный брокером (без преобразования). Окно ретроспективного анализа для расчета корреляции T = 250 баров. Периодичность ребалансировки — каждые 20 баров. Окно ретроспективного анализа для расчета импульса — 20 баров. Порог z-оценки = 1,0. Риск на одну ребалансировку = 1,0% от средств счета. Режим Тестера стратегий: "Каждый тик на основе реальных тиков" для реалистичного исполнения ордеров или "OHLC на M1" для более быстрого приближенного тестирования. Начальный депозит и кредитное плечо зависят от конкретного счета и должны соответствовать параметрам счета, на котором впоследствии будет работать советник. В этой статье не предполагается использование условий маржинального обеспечения какого-либо конкретного брокера. Спред и комиссию следует задавать по фактическим значениям, опубликованным брокером для каждого торгового инструмента, а не оставлять значения по умолчанию в Тестере стратегий. Бары, для которых хотя бы у одного инструмента из корзины отсутствует совпадающая временная метка, полностью пропускаются (см. функцию BuildLogReturnMatrix() выше) и не учитываются как ребалансировки.
Файлы манифеста конфигурации и журнала, упоминаемые в этой статье, — обычные текстовые файлы, содержимое которых можно просмотреть. Ниже приведен типичный манифест конфигурации в FILE_COMMON, соответствующий настройкам выше:
{
  "risk_pct": 1.00,
  "rebalance_bars": 20,
  "momentum_lookback": 20,
  "zscore_threshold": 1.00
}
А вот типичный фрагмент журнала аудита в формате CSV, который функция LogRebalanceCSV() записывает при каждой ребалансировке (столбцы точно соответствуют сигнатуре функции: временная метка, lambda_max, количество сигнальных и шумовых собственных значений, а также оба расстояния по норме Фробениуса между соседними ребалансировками):
timestamp,lambda_max,n_signal,n_noise,frob_raw_vs_prev,frob_denoised_vs_prev
2026.03.02 09:20,1.26904,1,3,0.071236,0.048917
2026.03.02 10:40,1.26904,1,3,0.058310,0.041022
2026.03.02 12:00,1.26904,1,3,0.066841,0.047605
2026.03.02 13:20,1.26904,1,3,0.052194,0.038876
Приведенные ниже технические результаты получены при фактическом моделировании со скользящим окном — не при запуске в Тестере стратегий MetaTrader 5, но и не путем ручного подбора чисел: использованы 2 500 баров смоделированных логарифмических доходностей M5 с двумя общими факторами, специфическим шумом и намеренно заданной сменой режима в середине выборки (после середины выборки факторные нагрузки постепенно меняются, поэтому "истинная" корреляционная структура не остается постоянной, что ближе к поведению реальных рынков, чем синтетический ряд с фиксированной корреляцией). Та же конфигурация применялась по единой заданной процедуре, что и в таблице выше: T = 250, ребалансировка каждые 20 баров. В результате получены 112 ребалансировок и 111 сравнений расстояния между соседними ребалансировками — учтены все результаты, без фильтрации:
| Показатель | Исходная корреляционная матрица | Корреляционная матрица после подавления шума | |
|---|---|---|---|
| Количество учтенных ребалансировок | 112 (111 сравнений матриц на соседних ребалансировках) | ||
| Среднее расстояние по норме Фробениуса между соседними ребалансировками | 0,0637 | 0,0464 | |
| Медиана расстояния по норме Фробениуса между соседними ребалансировками | 0,0623 | 0,0396 | |
| Стандартное отклонение расстояния по норме Фробениуса между соседними ребалансировками | 0,0252 | 0,0272 | |
| Окна, в которых матрица после подавления шума стабильнее | 100,0% (111 из 111) | ||
| Среднее изменение весов (норма L1) за одну ребалансировку | 0,0063 | 0,0032 | |
| Среднее число сигнальных собственных значений на окно | 1,00 (диапазон 1–1 по всем 112 окнам) | ||
На этом смоделированном ряде в каждом окне ребалансировки матрица после подавления шума была стабильнее: среднее расстояние по норме Фробениуса между соседними ребалансировками сократилось примерно на 27%, а изменение весов по норме L1 за одну ребалансировку — примерно вдвое. Для данной факторной структуры из 4 торговых инструментов число сигнальных собственных значений оставалось равным ровно 1 во всех 112 окнах. Это особенность синтетических данных (один доминирующий общий фактор и более слабый вторичный фактор, который при таком размере корзины инструментов в основном оставался ниже верхней границы распределения MP), а не общий закон: на приведенном ранее в статье графике зависимости собственного значения от ранга в случае более широкой корзины из 12 инструментов два сигнальных фактора превышали эту границу.
Повторим ту же процедуру со скользящим окном для синтетической корзины из 12 торговых инструментов (с той же схемой смены режима, тем же T и той же периодичностью ребалансировки), чтобы проверить, как эффект зависит от размера корзины и соответствует ли это предсказаниям теории случайных матриц (RMT):
| Показатель | 4 торговых инструмента | 12 торговых инструментов |
|---|---|---|
| Среднее расстояние по норме Фробениуса между соседними ребалансировками, исходная корреляционная матрица | 0,0637 | 0,2070 |
| Среднее расстояние по норме Фробениуса между соседними ребалансировками, матрица после подавления шума | 0,0464 | 0,1470 |
| Относительное уменьшение среднего расстояния между соседними ребалансировками | 27,2% | 29,0% |
| Среднее изменение весов (норма L1) за одну ребалансировку, исходная корреляционная матрица | 0,0063 | 0,0099 |
| Среднее изменение весов (норма L1) за одну ребалансировку, матрица после подавления шума | 0,0032 | 0,0083 |
Повышение стабильности наблюдается при обоих размерах корзины инструментов и в относительном выражении несколько больше при N=12. Это согласуется с ожиданием, что в более широкой корзине эффект разделения шума и сигнала будет заметнее. Однако разница между 27% и 29% здесь достаточно мала, поэтому это сравнение на синтетических данных следует рассматривать как результат, в целом согласующийся с теорией, а не как убедительное самостоятельное подтверждение. Естественный следующий шаг для более надежной проверки — тестирование на исторических данных за несколько лет с более широкой корзиной инструментов.
В этой статье не приводятся показатели чистой прибыли, максимальной просадки, доли прибыльных сделок или какие-либо другие показатели прибыли и убытков на уровне сделок ни для одной из конфигураций. Эти показатели зависят от качества исполнения ордеров, спреда, комиссии, проскальзывания и конкретного исторического периода тестирования, а моделирование синтетических доходностей не может достоверно заменить учет этих факторов. Приведенной выше воспроизводимой конфигурации достаточно, чтобы провести это сравнение непосредственно в Тестере стратегий. Вклад статьи ограничивается демонстрацией того, что повышение стабильности матриц и весов действительно наблюдается, поддается измерению и сохраняется при двух размерах корзины инструментов.
Заключение
Теория случайных матриц (RMT) дает строгий способ с использованием явных формул ответить на вопрос, который разработчики советников для торговли корзиной инструментов обычно решают интуитивно или с помощью ситуативного сглаживания: какая часть моей корреляционной матрицы отражает реальные зависимости, а какая представляет собой шум, вызванный ограниченным объемом выборки в окне расчета? Верхняя граница распределения MP (Марченко — Пастура) превращает этот вопрос в конкретную проверку каждого собственного значения, а процедура восстановления матрицы с подавлением шума — усреднить шумовые собственные значения, сохранить сигнальные и восстановить матрицу — достаточно компактна для реализации на MQL5 со спектральным разложением методом Якоби и без внешних зависимостей.
Измеримое преимущество здесь — повышение стабильности матриц и весов, а не гарантированное улучшение результатов тестирования на исторических данных. В статье это повышение проверено тремя способами: численной перекрестной проверкой алгоритма Якоби/MP с помощью решателя собственных значений NumPy на базе LAPACK, моделированием со скользящим окном для 4 инструментов и параллельным моделированием для 12 инструментов, показывающим, что эффект сохраняется и немного усиливается при увеличении N. Для вас как читателя полезнее представить результат именно так, а не выдавать повышение стабильности за прорыв в торговой результативности. Если вы уже торгуете корзиной и используете корреляции для расчета объема позиций или коэффициентов хеджирования, добавление этого этапа подавления шума потребует небольших затрат процессорного времени при каждой ребалансировке и даст исходным данным для оценки риска реальную статистическую основу вместо исходного выборочного шума, создающего иллюзию точности.
Естественные направления дальнейшего развития: использовать стягивание (shrinkage) вместо жёсткого отсечения собственных значений, расширить набор инструментов в корзине, чтобы различия между шумом и сигналом сильнее влияли на результат, а также интегрировать очищенную от шума матрицу в полноценный механизм расчёта размера позиции с учётом дисперсии портфеля. Последний вариант позволит отказаться от упрощённой формулы расчёта весов, используемой в советнике для работы с корзиной активов.
| Файл | Тип | Описание |
|---|---|---|
| RMTMath.mqh | Подключаемый файл | Классы матриц с хранением данных в одномерных массивах, спектральное разложение методом Якоби средствами MQL5, процедура подавления шума на основе распределения Марченко — Пастура. |
| RMTData.mqh | Подключаемый файл | Разбор и проверка корзины инструментов, построение матрицы синхронизированных доходностей, оценка корреляций, загрузка манифеста конфигурации в формате JSON, ведение журнала аудита в формате CSV. |
| RMT_Basket_EA.mq5 | Торговый советник (EA) | Мультивалютный алгоритм распределения средств в корзине инструментов, использующий очищенную корреляционную матрицу для расчета весов, пропорциональных величине 1 / (1 + сумма модулей корреляций с остальными инструментами), и z-оценку импульса для выбора направления сделки. |
| rmt_analysis.py | Скрипт на Python | Автономная перекрестная проверка математических расчетов подавления шума с помощью NumPy и построение графиков. Не используется во время выполнения. |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/24243
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


Теоретически теория случайных матриц предсказывает точное распределение сингулярных значений чисто случайной матрицы.
«Примечание: в данной статьеосновное внимание уделяется удалению шума из корреляционной матрицы в качестве этапа предварительной обработки входных данных по рискам. Это не полноценный оптимизатор портфеля...»
Следовательно, этап RMT может предшествовать этапу SSA.
Благодарю вас за подробное изложение методов теории случайных матриц на языке MQL5. Математическая основа представлена интересно, особенно попытка снизить уровень шума в оценках корреляции при управлении рисками портфеля, состоящего из нескольких инструментов.
Однако я считаю, что существует важное различие между повышением статистической устойчивости матрицы корреляций и демонстрацией измеримого торгового преимущества.
Более сглаженная матрица корреляций не обязательно означает более точные оценки будущего риска, более прибыльные сделки или более высокую вероятность положительного чистого ожидаемого дохода.
Буду признателен за ваши технические разъяснения по следующим вопросам:
1. Статистическая и торговая значимость
Проводили ли вы контролируемое вневыборочное сравнение советника на основе RMT и иного, в остальном идентичного советника, использующего необработанную корреляцию Пирсона, экспоненциально взвешенную корреляцию или традиционную оценку с сжатием?
При одинаковых сигналах входа, выходах, лимитах позиций и транзакционных издержках каковы соответствующие чистая ожидаемая прибыль, максимальное падение, коэффициент прибыльности и доходность с поправкой на риск?
2. Вероятность и доверительный интервал
Какова оценочная вероятность положительной чистой ожидаемой прибыли вместе с её доверительным интервалом, основанная на действительно независимых периодах прогона и различных рыночных режимах?
Как вы учитываете серийную зависимость, кластеризацию волатильности и тот факт, что последовательные сделки могут не представлять собой независимые статистические наблюдения?
3. Численная обоснованность
Поскольку этап постобработки принудительно приводит диагональ реконструированной матрицы к значению 1,0, как вы гарантируете, что итоговая матрица корреляций останется положительно полуопределенной?
Проверяет ли советник минимальное собственное значение перед расчётом риска портфеля, и какова резервная процедура, если матрица становится неопределённой?
4. Допущения, относящиеся к реальному рынку
Пороговое значение Марченко–Пастура предполагает независимость наблюдений в рамках своей теоретической нулевой модели, тогда как финансовые доходности характеризуются тяжелыми хвостами, кластеризацией волатильности и изменяющимися во времени корреляциями.
Как вы оцениваете эффективный размер выборки и проверяете пороговое значение собственного значения в этих условиях? Сравнивали ли вы результаты с результатами, полученными с помощью блок-бутстрэпа или режимозависимых симуляций?
5. Практическое обоснование
Для корзины из четырёх инструментов какое измеримое улучшение оправдывает дополнительную сложность собственного разложения Якоби и реконструкции собственных значений по сравнению с более простыми методами управления риском?
Если основным продемонстрированным преимуществом является более низкая скользящая норма Фробениуса, насколько это фактически снижает оборот весовых коэффициентов позиций, реализованное падение стоимости и транзакционные издержки?
На мой взгляд, решающим критерием является не то, дает ли RMT математически более «чистую» матрицу, а то, обеспечивает ли она статистически значимое и экономически значимое улучшение результатов торговли на вневыборочной выборке и снижение риска портфеля.
Мне было бы особенно интересно увидеть воспроизводимое A/B-тестирование, включающее исходные результаты на уровне отдельных сделок и абсолютно одинаковые допущения относительно исполнения для обеих реализаций.
Благодарим вас за подробное изложение методов теории случайных матриц на языке MQL5. Математическая основа представляет большой интерес, особенно попытка снизить уровень шума в оценках корреляции при управлении рисками портфеля, состоящего из нескольких символов.
Однако я считаю, что существует важное различие между повышением статистической устойчивости матрицы корреляций и демонстрацией измеримого торгового преимущества.
Более сглаженная матрица корреляций не обязательно означает более точные оценки будущего риска, более прибыльные сделки или более высокую вероятность положительного чистого ожидаемого дохода.
Этот парень говорит: https://srome.github.io/Eigenvesting-III-Random-Matrix-Filtering-In-Finance/ «Профессор Алан Эдельман из Массачусетского технологического института (MIT) сказал, что некоторые студенты, посещавшие его курс по теории случайных матриц (конспекты) в MIT, бросили учебу и открыли хедж-фонд. Судя по всему, сегодня у них дела идут неплохо» Не знаю, продолжают ли они до сих пор считать деньги, которые заработали с помощью теории случайных матриц :)
Этот парень пишет: https://srome.github.io/Eigenvesting-III-Random-Matrix-Filtering-In-Finance/ «Профессор Алан Эдельман из Массачусетского технологического института (MIT) рассказал, что некоторые студенты, посещавшие его курс по теории случайных матриц (конспекты) в MIT, бросили учебу и открыли хедж-фонд. Судя по всему, сегодня у них дела идут неплохо» Не знаю, продолжают ли они до сих пор считать деньги, которые заработали с помощью теории случайных матриц :)
Привет, Невар,
Это действительно очень вдохновляющий пример! И я считаю, что он точно подчеркивает, почему теория случайных матриц заслуживает серьёзного внимания в количественной торговле.
Интересно не просто то, что некоторые студенты MIT, возможно, превратили математические исследования в успешный хедж-фонд, а то, что сложные математические идеи потенциально могут стать практическим инструментом для понимания финансовых рынков.
Для меня настоящая возможность заключается в том, чтобы продвинуть эту концепцию на шаг дальше.
Вместо того чтобы использовать теорию случайных матриц исключительно для фильтрации исторических корреляций или построения портфеля с минимальной дисперсией, представьте, что её можно интегрировать в адаптивный торговый механизм, работающий с несколькими инструментами, который непрерывно оценивает структуру рынка, изменяющиеся корреляции, режимы волатильности и риск на уровне портфеля.
В этом контексте RMT может стать важным компонентом гораздо более широкой системы принятия решений.
Конечно, настоящий вызов заключается в том, чтобы преобразовать математическую элегантность в измеримые торговые результаты. Более «чистая» матрица корреляций — отличная отправная точка, но конечной целью должно стать более надежное распределение риска, лучшая устойчивость при смене режимов и очевидное улучшение вневыборочных результатов с учетом транзакционных издержек.
Мне было бы особенно интересно изучить, может ли структура собственных значений предоставить полезную информацию о переходах между рыночными режимами, а не рассматривать её исключительно как фильтр статистического шума.
Возможно, следующим шагом станет не просто создание советника, реализующего RMT, а разработка адаптивного механизма анализа рынка, в котором RMT, динамика рынка и надежное управление рисками будут работать в комплексе.
Математика здесь увлекательна. Настоящее приключение заключается в том, чтобы обнаружить, какую часть этого потенциала можно воплотить в по-настоящему устойчивую торговую систему.
Именно здесь, как я полагаю, начинаются самые захватывающие исследования!