

Фундаментальные модели для торговли (Часть I): Нативная реализация Kronos средствами MQL5
 43
 0

Введение
Фундаментальная модель — большая нейронная сеть, предварительно обученная на обширном массиве данных. Ее можно применять для множества прикладных задач, не обучая каждый раз с нуля. Языковые модели — наиболее известный пример, но та же идея нашла применение и в моделировании финансовых временных рядов. Kronos — одна из таких моделей. Это трансформер, прошедший предварительное обучение на миллионах последовательностей свечей. Получив окно последних баров, модель прогнозирует следующие бары (цену открытия, максимум, минимум, цену закрытия, объем и денежный оборот).
Для нас важно не существование такой модели, а возможность запустить ее там, где ведется торговля, — внутри MetaTrader 5, без участия процесса Python во время выполнения. В этой серии мы как раз этим и занимаемся. Мы берем модель Kronos-small и ее токенизатор и вручную заново реализуем весь прямой проход на нативном MQL5, используя встроенные в платформу типы matrix и vector. Python используется только один раз, на подготовительном этапе, для экспорта обученных весов в плоские бинарные файлы. После этого терминал выполняет всю работу самостоятельно.
В первой части рассматривается начальная половина пайплайна. Здесь показано, как веса переносятся из PyTorch в MQL5, как исходные данные свечей нормируются и токенизируются и как блок трансформера собирается из элементарных матричных операций. В конце мы подтверждаем корректность переноса побитовым сравнением результатов с исходной моделью: на уверенности в этой корректности основана вся дальнейшая работа. Предиктор, цикл авторегрессионной генерации и честная оценка того, имеет ли прогноз хоть какую-то практическую ценность, будут рассмотрены в последующих частях.
Мы рассмотрим следующие темы:
- Что такое фундаментальная модель для свечей
- Архитектура Kronos
- Почему бы просто не использовать ONNX
- Офлайн-экспорт весов из PyTorch в файлы .bin
- Предобработка — z-нормирование и временные метки
- Бинарное сферическое квантование (BSQ) — от свечей к токенам
- Создание блока трансформера с помощью матричных операций MQL5
- Подтверждение корректности — проверка по эталонным данным
- Заключение
Что такое фундаментальная модель для свечей
Kronos обрабатывает свечной график так же, как языковая модель обрабатывает текст. Предложение — это последовательность токенов из фиксированного словаря. Kronos преобразует последовательность свечей в последовательность дискретных токенов из собственного словаря, сформированного в процессе обучения, а затем предсказывает следующий токен так же, как языковая модель предсказывает следующее слово. Для построения прогноза модель сэмплирует токены по одному и преобразует их обратно в свечи.
В этой архитектуре модель разделена на две взаимодействующие сети. Первая сеть — токенизатор, автокодировщик, который обучается сжимать шесть признаков бара в пару целочисленных токенов с небольшими значениями и восстанавливать из них бар. Вторая сеть — предиктор, трансформер только с декодировщиком, который по истории токенов предсказывает следующую пару токенов. Обе сети обучаются отдельно и используются совместно: контекстное окно кодируется в токены, предиктор продолжает их последовательность, затем новые токены декодируются обратно в свечи.
Мы переносим веса Kronos-Tokenizer-base и Kronos-small — наименьшей из опубликованных пар моделей. Даже "small" здесь означает трансформер размерностью 512 с 8 слоями, поэтому прямой проход требует существенных вычислений. В этой части рассматриваются только кодировщик токенизатора и общие компоненты трансформера; предиктор и декодировщик будут рассмотрены в части 2.
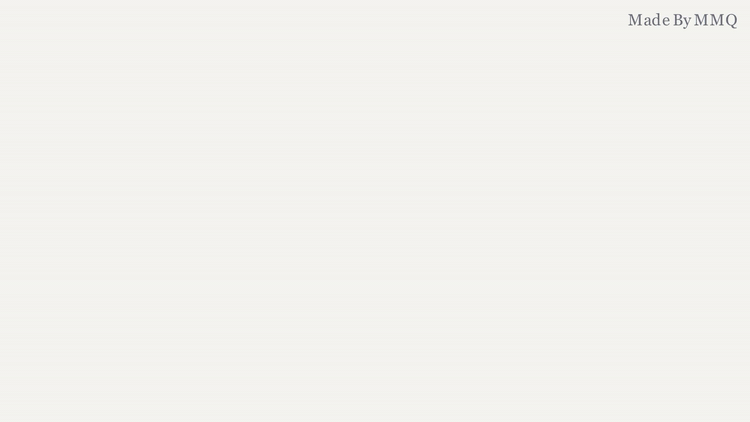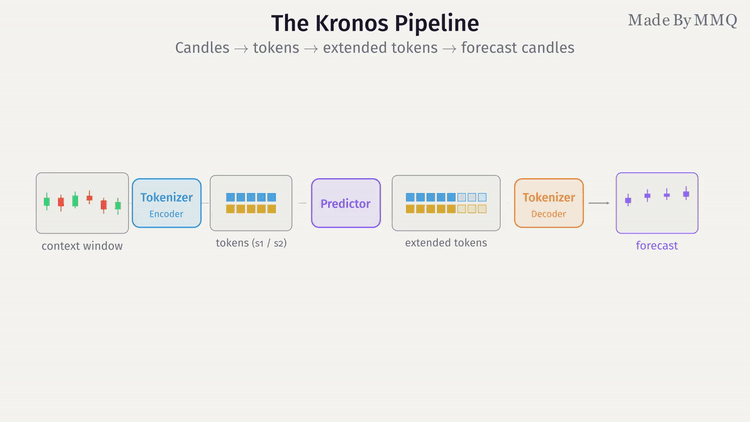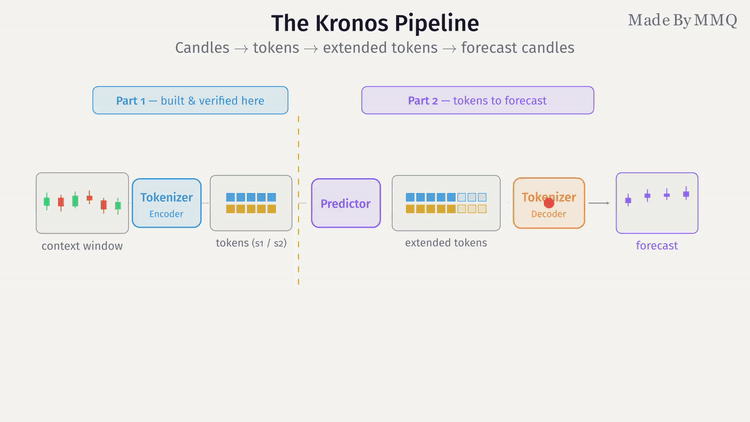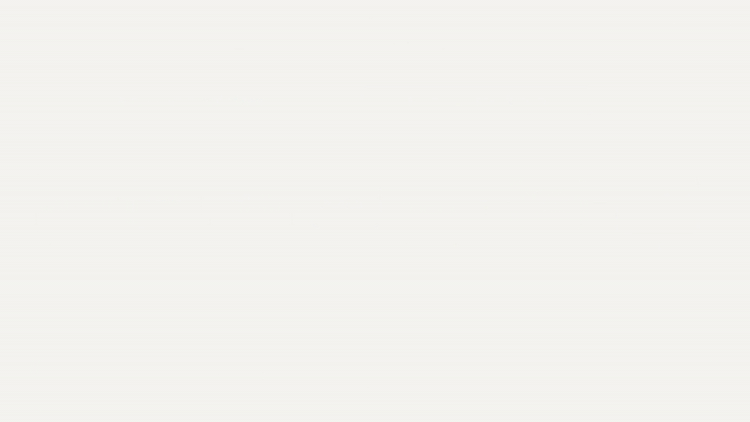
Рис. 1. Пайплайн Kronos
На рис. 1 показаны структура всей системы и место рассматриваемой в статье реализации. В этой статье мы реализуем и проверяем левую половину схемы — преобразование исходных свечей в токены. Правая половина схемы — преобразование токенов в прогноз — рассматривается в части 2.
Архитектура Kronos
Прежде чем приступать к переносу, нужно четко представить модель, которую мы воспроизводим. Kronos состоит из двух частей, которые обучаются отдельно, но работают совместно; вся архитектура представлена на одной схеме.
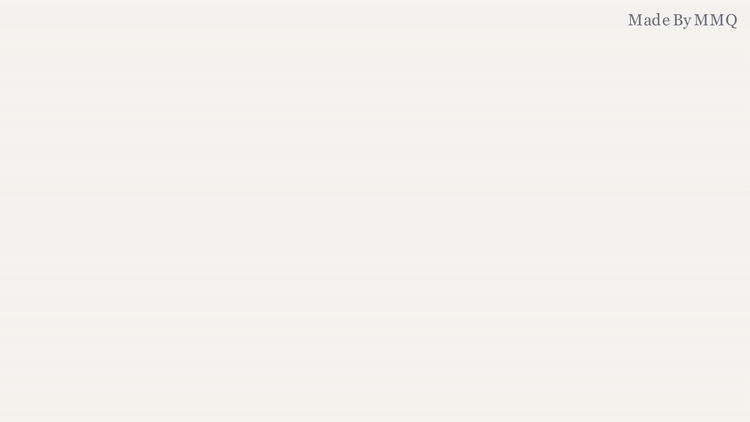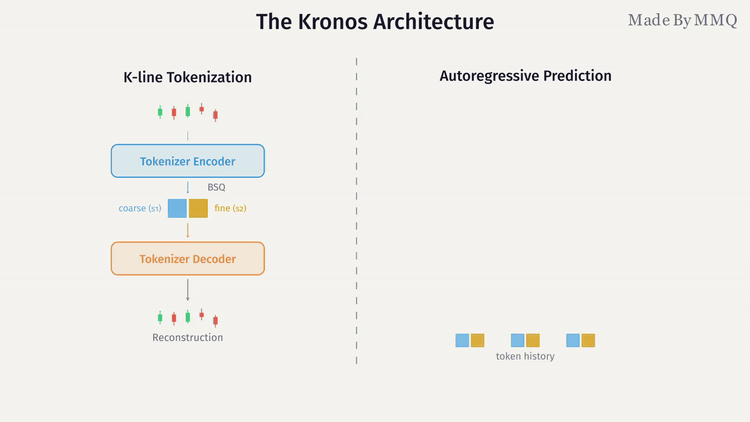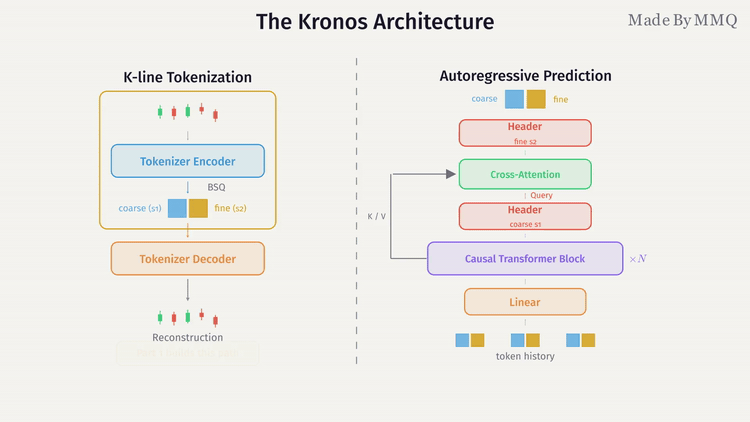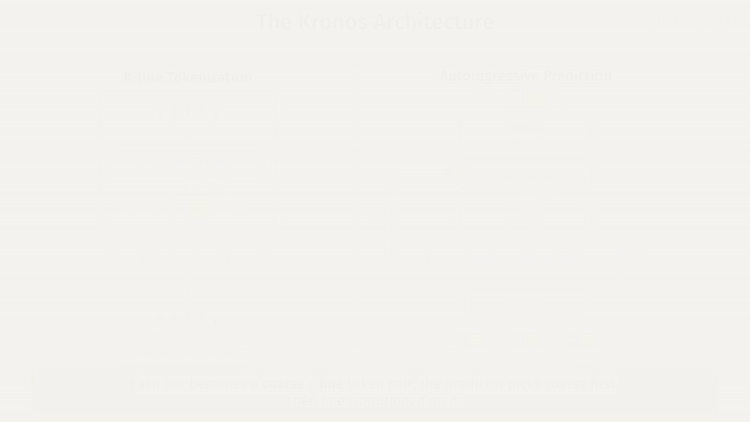
Рис. 2. Архитектура Kronos
Токенизатор (слева на рис. 2). Это автокодировщик с квантованием. Кодировщик преобразует шесть признаков бара в эмбеддинг размерности модели и пропускает его через стек блоков трансформера. Затем BSQ преобразует каждый бар в 20-битный код, разделенный на 10-битный грубый и 10-битный уточняющий подтокены — s1 и s2, с которыми мы уже знакомы. Декодировщик — стек блоков, зеркально повторяющий стек кодировщика и восстанавливающий из кода шесть признаков. Грубый подтокен передает общую форму бара, а уточняющий добавляет детали. Именно это делает пространство токенов иерархическим и определяет принцип генерации токенов предиктором.
Предиктор (справа на рис. 2). Это каузальный трансформер только с декодировщиком, работающий с историей токенов и относящийся к тому же семейству, что и текстовые языковые модели. На каждом шаге он должен формировать полный токен — оба подтокена. Сначала по выходу трансформера генерируется грубый подтокен, затем небольшая головка перекрестного внимания формирует уточняющий подтокен с учетом только что выбранного грубого. Именно этот порядок — сначала грубый подтокен, затем уточняющий — объясняет важность иерархии: уточняющий подтокен никогда не предсказывается вслепую, при его предсказании всегда учитывается выбор грубого. Эту часть модели мы реализуем в части 2.
Эти две сети различаются по размерам, и точное соблюдение приведенных значений — половина успеха при переносе с сохранением поведения исходной модели:
| Гиперпараметр | Токенизатор (base) | Предиктор (small) |
|---|---|---|
| Размерность модели (d_model) | 256 | 512 |
| Головы внимания | 4 (head_dim 64) | 8 (head_dim 64) |
| Блоки трансформера | 3 (при 4 в конфигурации — особенность n-1) | 8 (все блоки) |
| Размерность сети прямого распространения | 512 | 1024 |
| Словарь токенов | 2 x 1024 (s1, s2) | 2 x 1024 (s1, s2) |
Математическая основа каждого блока современна, но компактна. Пять операций определяют практически все вычисления Kronos; если описать их сейчас, код в следующих разделах будет восприниматься как их прямая реализация, а не как нечто неожиданное.
Среднеквадратичное нормирование (RMSNorm). Нормирование выполняется только по среднеквадратичному значению, без вычитания среднего и без смещения; результат масштабируется весом каждого признака, полученным при обучении.
RMSNorm(x) = x / sqrt(mean(x^2) + eps) * wЗдесь среднее квадратов вычисляется по всем признакам одной строки, а w — вектор весов, полученных при обучении.
Ротационные позиционные эмбеддинги (RoPE). Позиция кодируется поворотом пар координат на угол, растущий с увеличением позиции, а не добавлением позиционного вектора.
RoPE(x, t) = x * cos(t * theta) + rotate_half(x) * sin(t * theta), theta_k = base^(-2k / hd)Угол зависит от позиции t и индекса координаты k; base равно 10 000, а hd — размерность головы. Функция rotate_half меняет местами половины вектора и меняет знак у первой половины результата.
Сеть прямого распространения SwiGLU. Сеть прямого распространения использует вентильный механизм: к одной проекции применяется функция активации SiLU, результат поэлементно умножается на вторую проекцию, затем третья проекция восстанавливает размерность модели. Все три проекции — без смещения.
SwiGLU(x) = W2 * ( SiLU(W1 * x) (.) (W3 * x) ), SiLU(z) = z * sigmoid(z)
Символ (.) обозначает поэлементное умножение, реализующее вентиль.
Масштабированное внимание на основе скалярного произведения. Для каждого запроса вычисляются оценки всех доступных ему ключей; оценки масштабируются и преобразуются функцией softmax, а результат используется для взвешивания значений.
Attention(Q, K, V) = softmax( Q * K^T / sqrt(hd) ) * V
В кодировщике этот механизм каузален: запрос в позиции i может учитывать только ключи в позициях до i включительно, что сохраняет временной порядок. В головке перекрестного внимания предиктора этот механизм некаузален, что создает серьезные проблемы в части 2.
Бинарное сферическое квантование (BSQ). При квантовании индекс токена определяется только знаками координат латентного вектора.
bit_i = 1 if z_i > 0 else 0, s1 = sum_(i<10) bit_i * 2^i, s2 = sum_(i<10) bit_(10+i) * 2^i
В разделе о токенизации ниже мы вернемся к тому, почему сохраняется только знак и какое упрощение вычислений это дает.
Почему бы просто не использовать ONNX
В MetaTrader 5 есть встроенная поддержка ONNX, поэтому возникает очевидный вопрос: зачем вообще переносить модель вручную, если можно экспортировать ее в ONNX и вызывать из MQL5? Это уместный вопрос, и ответ на него зависит от особенностей выполнения этой модели.
ONNX представляет модель в виде статического вычислительного графа: фиксированной последовательности тензорных операций с входными и выходными тензорами. Это отлично подходит для одной сети прямого распространения, например классификатора или регрессора, вычисляемого один раз за вызов. Инференс Kronos не соответствует этой схеме. Это алгоритм, управляющий работой нескольких нейронных сетей, и именно в нем заключается основная сложность:
- Авторегрессионный алгоритм с потоком управления, зависящим от данных. Прогноз формируется в цикле по одному токену за шаг; ветвление зависит от состояния цикла: пока контекст заполняется, действует фаза роста, а после достижения максимальной длины — фаза сдвига. В статическом графе нет места для такого ветвления.
- Кэш с сохранением состояния, форма которого меняется на каждом шаге. Для эффективной генерации поддерживается кэш ключей и значений, который увеличивается на одну строку на каждом шаге. Его форма не фиксирована — именно это статический граф не может выразить.
- Сэмплирование внутри цикла. На каждом шаге токены выбираются сэмплированием из мультиномиального распределения с учетом температуры и фильтрацией top-k и top-p. Это стохастическая логика управления, а не тензорная операция.
- Дискретные токены между моделями. Выход кодировщика квантуется в целочисленные токены с помощью операции определения знака; предиктор принимает и выдает целочисленные токены, и только затем запускается декодировщик. Три модели, обменивающиеся дискретными целочисленными данными, — это не единый граф.
- Иерархическая зависимость внутри каждого шага. Уточняющий подтокен предсказывается только после сэмплирования грубого подтокена на том же шаге: это зависимость двух подсетей внутри цикла.
Можно было бы экспортировать каждую сеть в ONNX (кодировщик, трансформер-предиктор, декодировщик). Однако в MQL5 все равно пришлось бы реализовать авторегрессионный цикл, управление кэшем, сэмплирование, ветвление, передачу токенов и порядок выполнения перекрестного внимания. Эта связующая логика и есть инференс, и именно от нее зависит корректность результата. После реализации этой логики оставшиеся матричные умножения — уже простая часть. Выполнение их средствами самого MQL5 сохраняет весь пайплайн в одном месте, на одном языке и с единым набором числовых результатов, которые можно проверить от начала до конца. Именно поэтому мы и выполняем перенос.
Офлайн-экспорт весов из PyTorch в файлы .bin
Прежде чем запускать модель в MQL5, нужно экспортировать обученные параметры из PyTorch. У этих двух сред нет общего формата моделей, поэтому мы используем простейший способ обмена: записываем каждый тензор в плоский файл float32 с порядком байтов little-endian, затем считываем файлы в MQL5 с помощью FileReadArray. Это выполняется один раз, на подготовительном этапе, на компьютере с установленным PyTorch. Во время выполнения терминал вообще не обращается к Python.
Для начала мы клонируем официальный репозиторий Kronos на GitHub:
git clone https://github.com/shiyu-coder/Kronos kronos-gitЭкспортер обходит все параметры и буферы каждой модели, записывает каждый тензор в отдельный файл .bin и создает манифест с исходным именем в PyTorch, именем файла на диске и формой тензора. Основная часть export_kronos_weights.py невелика:
# export_kronos_weights.py
def dump_module(mod, outdir, label):
    os.makedirs(outdir, exist_ok=True)
    manifest = {"label": label, "tensors": {}}
    tensors = list(mod.named_parameters()) + list(mod.named_buffers())
    total = 0
    print(f"\n=== {label} : {len(tensors)} tensors ===")
    for name, t in tensors:
        arr = np.ascontiguousarray(t.detach().cpu().float().numpy().astype(np.float32))
        fn = safe_name(name) + ".bin"
        arr.tofile(os.path.join(outdir, fn))
        manifest["tensors"][name] = {
            "file": fn,
            "shape": list(arr.shape),
            "dtype": "float32",
            "count": int(arr.size),
        }
        total += int(arr.size)
        print(f"  {name:55s} shape={tuple(arr.shape)}")
    manifest["total_params"] = total
    with open(os.path.join(outdir, "manifest.json"), "w") as f:
        json.dump(manifest, f, indent=2)
    print(f"  -> {total:,} values, manifest at {os.path.join(outdir, 'manifest.json')}")
    return manifest
Вместе вызовы named_parameters() и named_buffers() охватывают обучаемые веса и необучаемое состояние (например, буферы нормирования), поэтому ничего не пропускается. Имена в PyTorch содержат точки и косые черты, неудобные для имен файлов, поэтому safe_name заменяет каждый символ, кроме букв и цифр, подчеркиванием. Это соответствие фиксируется в манифесте, определяющем правила чтения файлов загрузчиками MQL5.
Эта деталь позволяет избежать дальнейшей путаницы, поэтому ее стоит сформулировать явно. PyTorch хранит матрицу весов линейного слоя в форме [out, in]: в вычислении y = x W^T + b используется ее транспонированное представление. Наш файл .bin содержит именно этот исходный массив [out, in] с построчным хранением. При загрузке в MQL5 мы транспонируем массив и сохраним его в форме [in, out], чтобы вычислять линейный слой одним матричным умножением без транспонирования при каждом вызове. В части 2 мы вернемся к тому, почему это важно для производительности; пока отметим, что файл хранит веса в исходном представлении PyTorch.
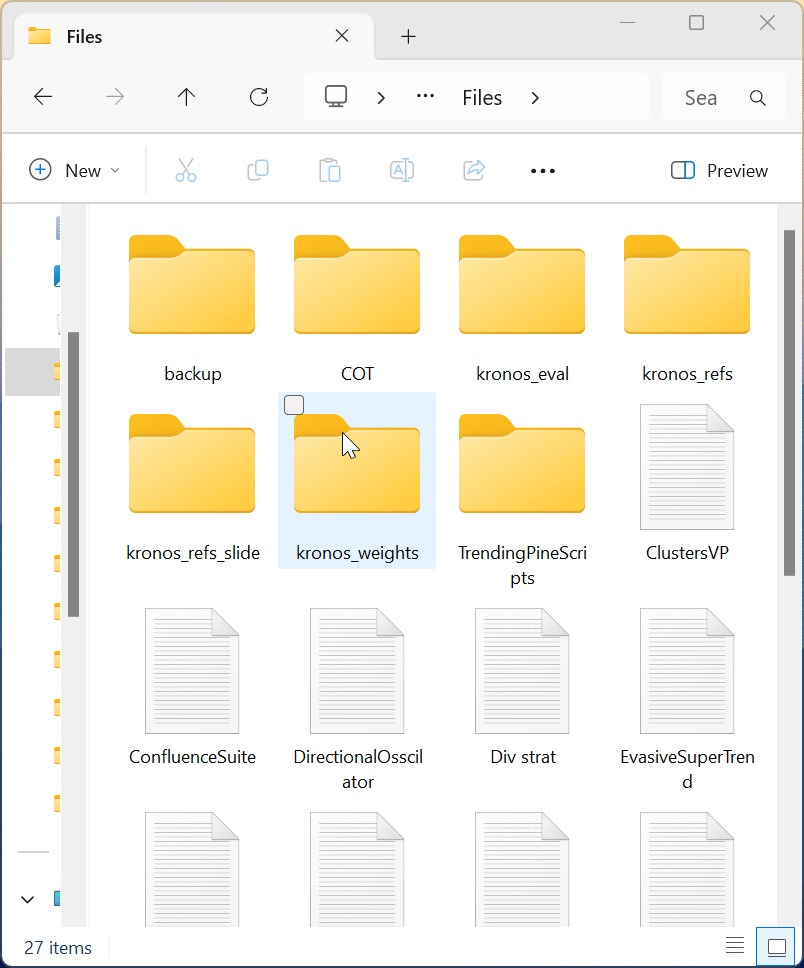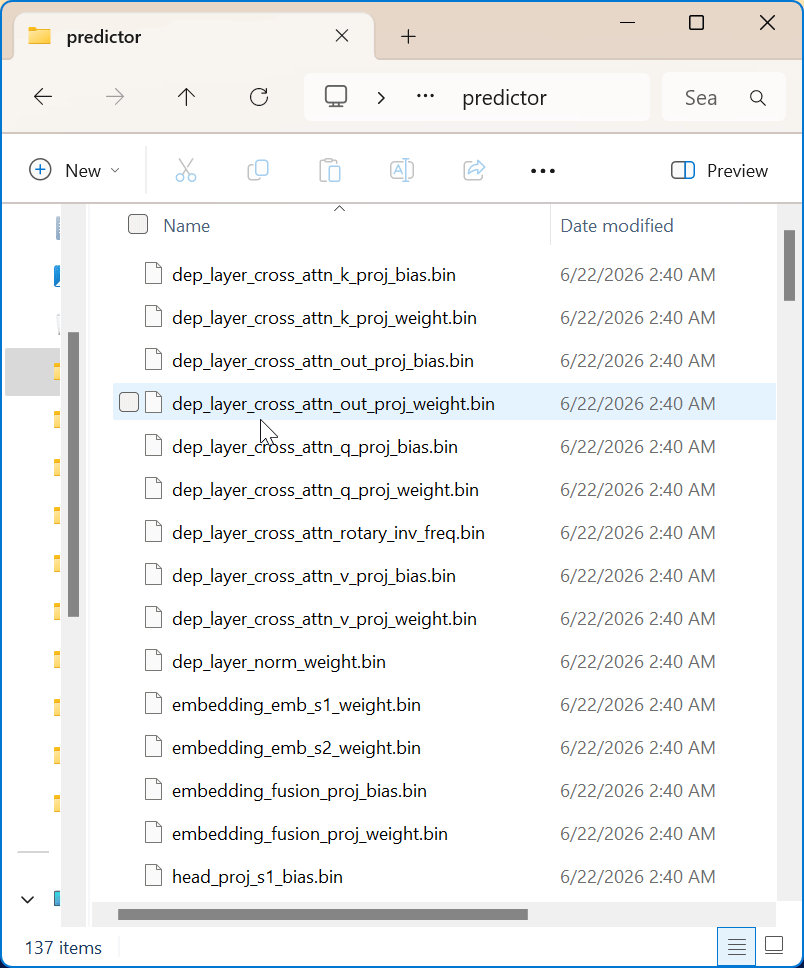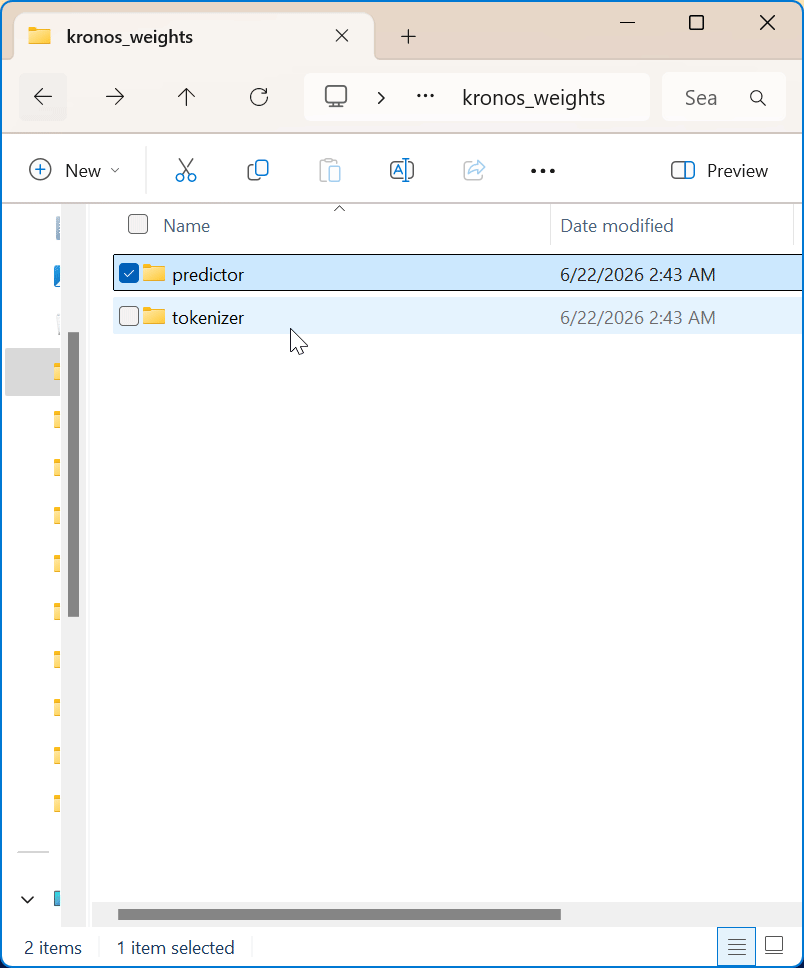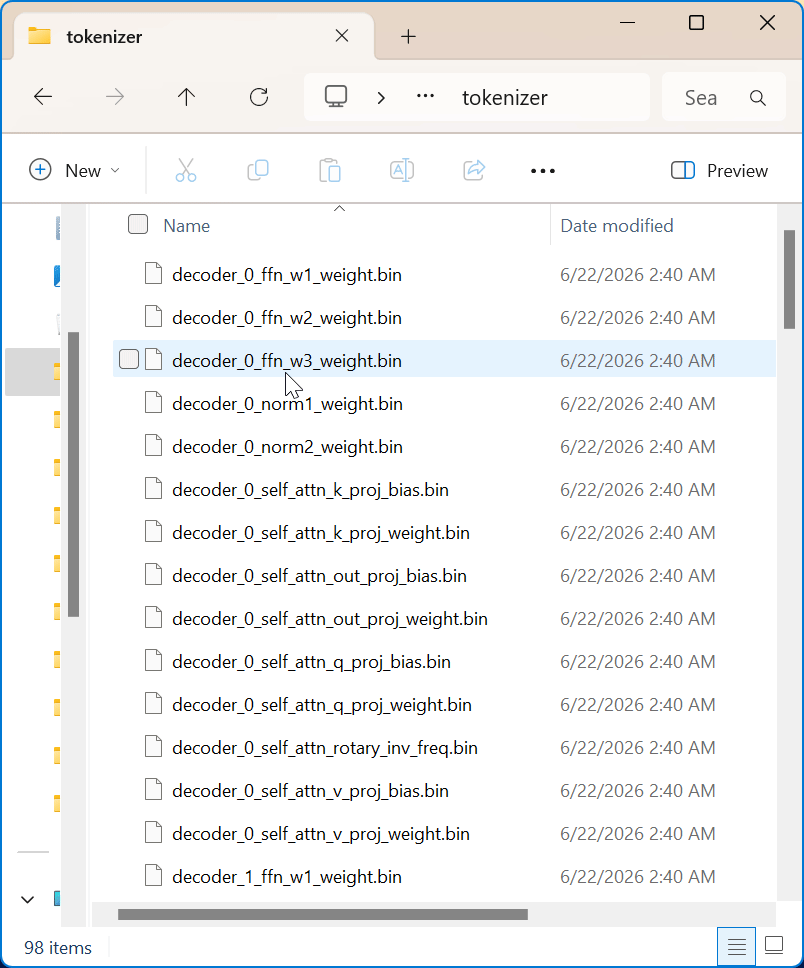
Рис. 3. Папки с экспортированными весами токенизатора и предиктора и манифестом в файловой песочнице терминала MQL5\Files
Экспортированные папки копируются в файловую песочницу терминала MQL5\Files, поскольку FileReadArray читает данные только оттуда. На рис. 3 показана структура: по одной папке на модель, манифест и набор файлов .bin без вложенных каталогов, с именами соответствующих тензоров.
Предобработка — z-нормирование и временные метки
Kronos не получает цены в исходном виде. Каждое контекстное окно нормируется отдельно по каждому признаку до подачи в модель; использованные статистики сохраняются, чтобы затем вернуть прогноз к исходным ценовым единицам. Применяется обычное z-нормирование по окну исторических данных: вычитается среднее столбца, результат делится на стандартное отклонение столбца, затем значения ограничиваются фиксированным диапазоном для уменьшения влияния выбросов.
Две детали реализации здесь должны в точности соответствовать эталону, иначе токены будут отличаться. При расчете стандартного отклонения используется делитель, равный числу строк, как для генеральной совокупности и при принятом в NumPy значении по умолчанию ddof=0. Для численной устойчивости в знаменатель добавляется небольшое значение eps. Вот полный текст функции KronosNormalize:
//+------------------------------------------------------------------+
//| Per-column z-score over the lookback rows, then clip.            |
//| raw[L][6] in feature order open,high,low,close,volume,amount.    |
//| mean/std are kept for the inverse transform. Population std      |
//| (divide by L) to match numpy ddof=0.                             |
//+------------------------------------------------------------------+
void KronosNormalize(const matrix &raw, matrix &norm, vector &mean, vector &stdv)
  {
   ulong L = raw.Rows();
   ulong F = raw.Cols();
   mean = vector::Zeros(F);
   stdv = vector::Zeros(F);
//--- per-column mean
   for(ulong j = 0; j < F; j++)
     {
      double s = 0.0;
      for(ulong i = 0; i < L; i++)
         s += raw[i][j];
      mean[j] = s / (double)L;
     }
//--- per-column population std (ddof = 0, matches numpy)
   for(ulong j = 0; j < F; j++)
     {
      double s = 0.0;
      for(ulong i = 0; i < L; i++)
        {
         double d = raw[i][j] - mean[j];
         s += d * d;
        }
      stdv[j] = MathSqrt(s / (double)L);
     }
//--- z-score, then clip to +/-KR_CLIP
   norm = matrix::Zeros(L, F);
   for(ulong j = 0; j < F; j++)
     {
      double denom = stdv[j] + KR_EPS;
      for(ulong i = 0; i < L; i++)
        {
         double v = (raw[i][j] - mean[j]) / denom;
         if(v >  KR_CLIP)
            v =  KR_CLIP;
         if(v < -KR_CLIP)
            v = -KR_CLIP;
         norm[i][j] = v;
        }
     }
  }
Шесть признаков — open, high, low, close, volume, amount — следуют именно в таком порядке. Значения ограничиваются диапазоном ±5 стандартных отклонений. Векторы средних значений и стандартных отклонений возвращаются вызывающему коду. Поэтому обратное преобразование нормированного прогноза в цены выполняется теми же арифметическими действиями в обратном порядке и использует именно статистики окна, на основе которого получен прогноз.
Kronos также использует признаки временной метки каждого бара: минуту, час, день недели, число месяца и месяц. Эти признаки используются предиктором для формирования временных эмбеддингов. Большинство этих полей заполнить просто, но в одном скрывается настоящая ловушка. Модель обучалась с использованием pandas, где дни недели нумеруются от 0 для понедельника до 6 для воскресенья. В структуре MqlDateTime языка MQL5 дни недели нумеруются начиная с воскресенья, которому соответствует 0. Если передать значение платформы без изменений, номер каждого дня недели будет неверным, а получаемый моделью временной эмбеддинг незаметно исказится. Для исправления достаточно одной строчки перенумерации:
//+------------------------------------------------------------------+
//| Timestamp features for one bar: [minute,hour,weekday,day,month]. |
//| Weekday is remapped from MQL5 (Sun=0..Sat=6) to the pandas       |
//| convention (Mon=0..Sun=6) the model was trained on.              |
//+------------------------------------------------------------------+
void KronosStamp(datetime t, int &out[])
  {
   MqlDateTime s;
   TimeToStruct(t, s);
   ArrayResize(out, 5);
   out[0] = s.min;
   out[1] = s.hour;
   out[2] = (s.day_of_week + 6) % 7;
   out[3] = s.day;
   out[4] = s.mon;
  }
Выражение (day_of_week + 6) % 7 меняет номер воскресенья с 0 на 6 и уменьшает номер каждого из остальных дней на единицу, воспроизводя нумерацию pandas. Изменение невелико, но именно такое несоответствие приводит к тому, что модель работает без ошибок и выдает бессмысленные прогнозы.
Примечание: статистики нормирования рассчитываются отдельно для каждого окна, а не глобально. Обратное нормирование прогноза всегда выполняется только со средним и стандартным отклонением именно того контекстного окна, на основе которого он получен. Смешивание статистик разных окон может незаметно исказить выходные данные.
Бинарное сферическое квантование (BSQ) — от свечей к токенам
С концепцией BSQ мы познакомились в разделе об архитектуре; теперь реализуем этот метод. Большинство читателей, скорее всего, еще не сталкивались с ним, а в реализации есть полезный прием, упрощающий вычисления. После блоков трансформера кодировщика линейный слой проецирует представление каждого бара в 20-мерный вектор. BSQ квантует этот вектор; результат кодируется двумя 10-битными целыми числами — грубым подтокеном s1 и уточняющим подтокеном s2, каждый со значением от 0 до 1023.
Полная операция BSQ выполняет L2-нормирование 20-мерного вектора на единичную гиперсферу, масштабирует его и квантует каждую координату до ближайшего из двух значений. Однако есть прием, который упрощает и ускоряет кодировщик на MQL5, сохраняя точный результат. Индекс токена зависит только от знака каждой из 20 компонент. При L2-нормировании и масштабировании используются строго положительные множители, поэтому знак ни одной координаты не меняется. Поэтому при вычислении токенов можно полностью пропустить нормирование и получить знаки непосредственно из вектора после проекции. Бит i равен 1, если компонента i положительна; индекс — обычная сумма значений битов, умноженных на соответствующие степени двойки:
//+------------------------------------------------------------------+
//| BSQ encode: the s1/s2 indices depend only on the sign of each of |
//| the 20 z components (the L2-norm and scale before quantization   |
//| preserve sign). bit_i = 1 iff z_i > 0; index = sum bit_i * 2^i   |
//| (LSB-first).                                                     |
//+------------------------------------------------------------------+
void KronosBSQ_SignsToIndices(const double &z[], int &s1_id, int &s2_id)
  {
   s1_id = 0;
   s2_id = 0;
//--- s1: first KR_S1_BITS components (LSB-first)
   for(int i = 0; i < KR_S1_BITS; i++)
      if(z[i]              > 0.0)
         s1_id |= (1 << i);
//--- s2: next KR_S2_BITS components (LSB-first)
   for(int i = 0; i < KR_S2_BITS; i++)
      if(z[KR_S1_BITS + i] > 0.0)
         s2_id |= (1 << i);
  }
Первые десять компонент образуют s1, следующие десять — s2. Декодировщику нужна обратная операция — восстановление 20-мерного кода по двум индексам. Каждый бит преобразуется в биполярное значение, равное плюс или минус единице, деленной на квадратный корень из размерности. Полученный вектор соответствует точке на гиперсфере, которую сформировал бы квантователь:
//+------------------------------------------------------------------+
//| BSQ decode: rebuild the 20-dim bipolar code from the indices.    |
//| code_i = (bit_i * 2 - 1) / sqrt(20).                             |
//+------------------------------------------------------------------+
void KronosBSQ_IndicesToCode(int s1_id, int s2_id, double &code[])
  {
   ArrayResize(code, KR_CODEBOOK_DIM);
   double q = 1.0 / MathSqrt((double)KR_CODEBOOK_DIM);
//--- s1 bits -> first KR_S1_BITS code entries
   for(int i = 0; i < KR_S1_BITS; i++)
     {
      int b = (s1_id >> i) & 1;
      code[i]              = (b * 2 - 1) * q;
     }
//--- s2 bits -> next KR_S2_BITS code entries
   for(int i = 0; i < KR_S2_BITS; i++)
     {
      int b = (s2_id >> i) & 1;
      code[KR_S1_BITS + i] = (b * 2 - 1) * q;
     }
  }
Именно разделение 20 битов на два 10-битных токена делает Kronos иерархической моделью: s1 кодирует общую структуру бара, а s2 уточняет ее; предиктор учится генерировать их в этом порядке. В части 2 мы будем активно использовать эту иерархию.
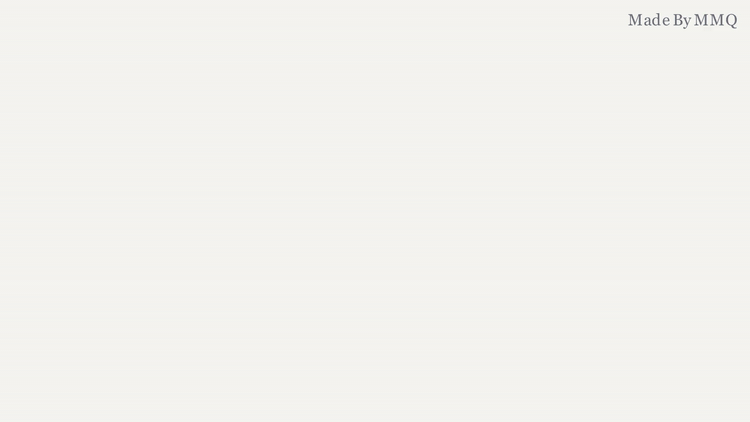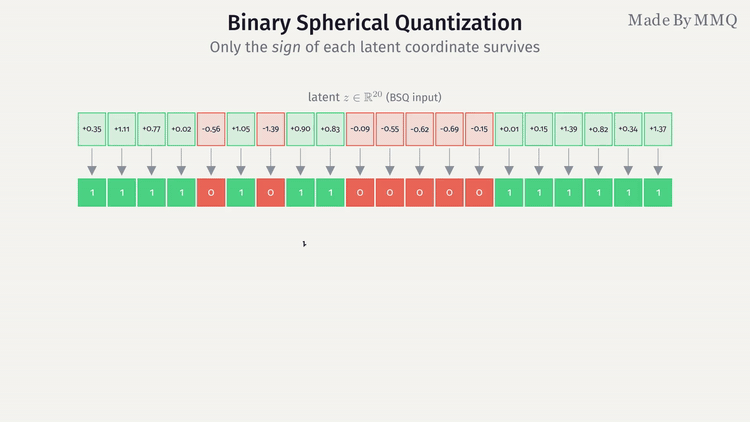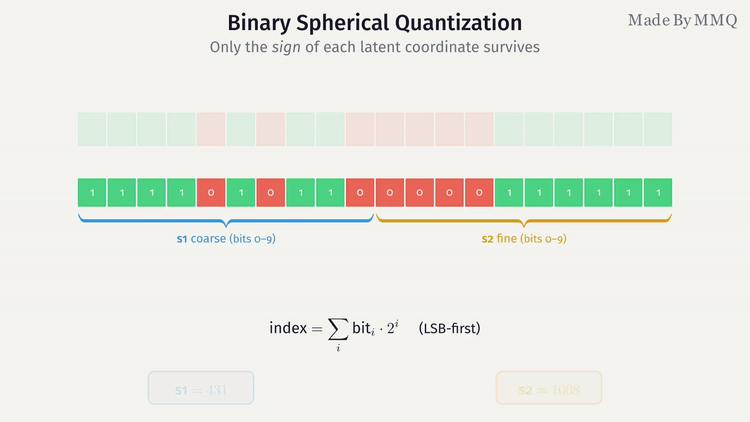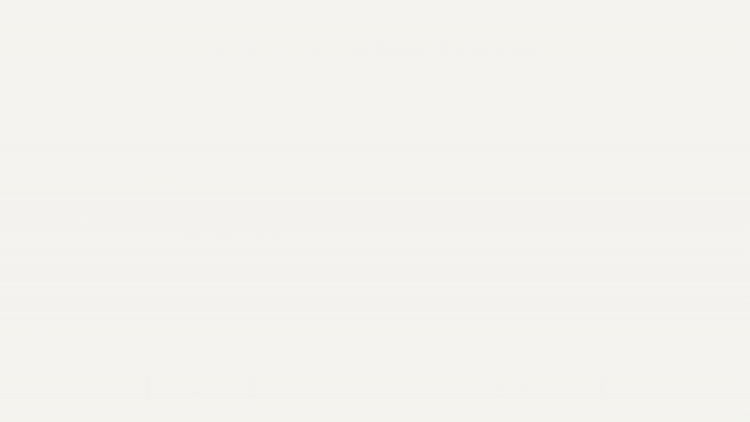
Рис. 4. Бинарное сферическое квантование: 20-мерный латентный вектор сводится к знакам его координат, которые упаковываются в идентификаторы токенов s1 и s2
Как показано на рис. 4, после квантования сохраняется только информация о том, по какую сторону от нуля находится каждая координата. Следует учитывать один нюанс точности: решение принимается по знаку, поэтому у компоненты, находящейся крайне близко к нулю — примерно на расстоянии 0,0000001 или меньше, — знак в принципе может различаться при вычислениях в MQL5 с типом double и эталонных вычислениях с типом float32. На практике этого почти никогда не происходит, и проверка в последнем разделе это подтверждает: токены совпадают в точности.
Создание блока трансформера с помощью матричных операций MQL5
Между формированием эмбеддингов свечей и квантованием расположены блоки трансформера, и именно на них приходится основная часть работы по переносу. В Kronos используется современный блок: предварительное нормирование, RMSNorm вместо LayerNorm, ротационные позиционные эмбеддинги и сеть прямого распространения SwiGLU. Каждый из этих компонентов нужно воссоздать с помощью матричных и векторных операций MQL5. Рассмотрим их в том порядке, в котором через них проходят данные.
Линейный слой
Напомним, что мы сохранили каждую матрицу весов в предварительно транспонированном виде [in, out]. Здесь это решение дает преимущество: теперь линейный слой сводится к одному матричному умножению без дополнительных операций.
//+------------------------------------------------------------------+
//| Linear (PyTorch convention): y = x @ W^T. The weight is loaded   |
//| pre-transposed (KronosLoadMatrixT stores W as [in,out] == W^T),  |
//| so this is a plain MatMul with NO per-call transpose. Profiling  |
//| showed the old per-call W.Transpose() was ~60% of the forward    |
//| pass; the transpose now happens once at load. Math is identical. |
//+------------------------------------------------------------------+
matrix LinearT(const matrix &X, const matrix &W) { return X.MatMul(W); }
Среднеквадратичное нормирование (RMSNorm)
Среднеквадратичное нормирование умножает каждую строку на величину, обратную квадратному корню из среднего квадратов ее элементов, затем поэлементно масштабирует результат весами признаков, полученными при обучении. Здесь нет вычитания среднего и смещения — этим RMSNorm отличается от LayerNorm.
//+------------------------------------------------------------------+
//| RMSNorm (row-wise): out = x / sqrt(mean(x^2) + eps) * weight.    |
//+------------------------------------------------------------------+
matrix RMSNorm(const matrix &X, const vector &w, double eps = KR_NORM_EPS)
  {
   ulong T = X.Rows(), D = X.Cols();
   matrix out = matrix::Zeros(T, D);
   for(ulong i = 0; i < T; i++)
     {
      double ms = 0.0;
      for(ulong j = 0; j < D; j++)
         ms += X[i][j] * X[i][j];
      ms /= (double)D;
      double scale = 1.0 / MathSqrt(ms + eps);
      for(ulong j = 0; j < D; j++)
         out[i][j] = X[i][j] * scale * w[j];
     }
   return out;
  }
SwiGLU
Сеть прямого распространения использует вентильный механизм. Формируются две линейные проекции входных данных; к одной применяется функция активации SiLU, а полученный результат поэлементно умножается на другую, выполняя роль вентиля; третья проекция возвращает результат к размерности модели. Все три проекции выполняются без смещения.
//+------------------------------------------------------------------+
//| SiLU activation: x * sigmoid(x).                                 |
//+------------------------------------------------------------------+
double SiLU(double x) { return x / (1.0 + MathExp(-x)); }

//+------------------------------------------------------------------+
//| SwiGLU feed-forward: w2( SiLU(w1 x) * w3 x ), all bias-free.     |
//+------------------------------------------------------------------+
matrix SwiGLU(const matrix &X, const matrix &W1, const matrix &W3, const matrix &W2)
  {
   matrix H = LinearT(X, W1);
   matrix G = LinearT(X, W3);
   ulong T = H.Rows(), FF = H.Cols();
   matrix gated = matrix::Zeros(T, FF);
   for(ulong i = 0; i < T; i++)
      for(ulong j = 0; j < FF; j++)
         gated[i][j] = SiLU(H[i][j]) * G[i][j];
   return LinearT(gated, W2);
  }
Ротационные позиционные эмбеддинги (RoPE)
RoPE кодирует позицию, поворачивая пары координат на угол, пропорциональный позиции. Мы заранее вычисляем таблицы косинусов и синусов один раз для каждой длины последовательности, затем применяем их. Kronos формирует эмбеддинг конкатенацией вектора частот с самим собой, поэтому две половины каждой строки совпадают, а при вращении координата k образует пару с координатой k + half.
//+------------------------------------------------------------------+
//| Build the RoPE cos/sin tables (T, hd). emb = cat(freqs, freqs),  |
//| so the two halves of each row are duplicated.                    |
//+------------------------------------------------------------------+
void RoPETables(ulong T, ulong hd, matrix &cosT, matrix &sinT)
  {
   ulong half = hd / 2;
   cosT = matrix::Zeros(T, hd);
   sinT = matrix::Zeros(T, hd);
   for(ulong t = 0; t < T; t++)
      for(ulong k = 0; k < half; k++)
        {
         double inv_freq = 1.0 / MathPow(KR_ROPE_BASE, (2.0 * (double)k) / (double)hd);
         double ang = (double)t * inv_freq;
         double c = MathCos(ang), s = MathSin(ang);
         cosT[t][k] = c;
         cosT[t][k + half] = c;
         sinT[t][k] = s;
         sinT[t][k + half] = s;
        }
  }

//+------------------------------------------------------------------+
//| Apply RoPE: out = x*cos + rotate_half(x)*sin, where              |
//| rotate_half(x) = cat(-x2, x1).                                   |
//+------------------------------------------------------------------+
matrix ApplyRoPE(const matrix &X, const matrix &cosT, const matrix &sinT)
  {
   ulong T = X.Rows(), hd = X.Cols(), half = hd / 2;
   matrix out = matrix::Zeros(T, hd);
   for(ulong t = 0; t < T; t++)
      for(ulong k = 0; k < hd; k++)
        {
         double rh = (k < half) ? -X[t][k + half] : X[t][k - half];
         out[t][k] = X[t][k] * cosT[t][k] + rh * sinT[t][k];
        }
   return out;
  }
Внимание
Масштабированное внимание на основе скалярного произведения для одной головы вычисляет оценки пар "запрос — ключ", масштабирует их, применяет численно устойчивый softmax по строкам и взвешивает значения. Флаг каузальности задает маску для каждого запроса так, чтобы он мог учитывать только ключи на своей позиции и на предшествующих позициях; именно это обеспечивает соблюдение временного порядка кодировщиком.
//+------------------------------------------------------------------+
//| Scaled dot-product attention for one head.                       |
//| Qh(Tq,hd), Kh(Tk,hd), Vh(Tk,hd). causal=true masks j>i and so    |
//| needs Tq==Tk. scores = Q.Kt * inv_sqrt -> stable row-softmax     |
//| -> weights . V. Returns Oh(Tq,hd).                               |
//+------------------------------------------------------------------+
matrix SDPA(const matrix &Qh, const matrix &Kh, const matrix &Vh, bool causal)
  {
   ulong Tq = Qh.Rows(), Tk = Kh.Rows(), hd = Qh.Cols();
   double inv_sqrt = 1.0 / MathSqrt((double)hd);
//--- scaled scores
   matrix scores = Qh.MatMul(Kh.Transpose());   // (Tq,Tk)
   scores *= inv_sqrt;
//--- row-wise softmax with optional causal mask
   for(ulong i = 0; i < Tq; i++)
     {
      //--- causal mask: query i attends to keys 0..i only
      ulong jmax = causal ? i : (Tk - 1);
      double smax = -DBL_MAX;
      for(ulong j = 0; j <= jmax; j++)
         if(scores[i][j] > smax)
            smax = scores[i][j];
      double denom = 0.0;
      for(ulong j = 0; j < Tk; j++)
        {
         if(causal && j > i)
           {
            scores[i][j] = 0.0;
            continue;
           }
         double e = MathExp(scores[i][j] - smax);
         scores[i][j] = e;
         denom += e;
        }
      double inv = 1.0 / denom;
      for(ulong j = 0; j < Tk; j++)
         scores[i][j] *= inv;   // masked entries already 0
     }
   return scores.MatMul(Vh);   // (Tq,hd)
  }
Многоголовое внимание объединяет эти операции: входные данные проецируются в запросы, ключи и значения, столбцы разделяются по головам, запросы и ключи поворачиваются с помощью RoPE, для каждой головы вычисляется внимание, результаты голов записываются обратно, после чего применяется выходная проекция. Обратите внимание на именованные локальные переменные Qs, Ks, Qh и т.д. внутри цикла по головам. Это не вопрос стиля. Это ограничение проявляется при работе с матрицами MQL5 чаще всего и заслуживает отдельного пояснения.
//+------------------------------------------------------------------+
//| Causal multi-head self-attention with RoPE.                      |
//| q/k/v/out projections carry a bias.                              |
//+------------------------------------------------------------------+
matrix MHA(const matrix &X,
           const matrix &Wq, const vector &bq,
           const matrix &Wk, const vector &bk,
           const matrix &Wv, const vector &bv,
           const matrix &Wo, const vector &bo,
           int n_heads)
  {
   ulong T = X.Rows();
   ulong d_model = X.Cols();
   ulong hd = d_model / (ulong)n_heads;
//--- q/k/v projections (with bias)
   matrix Q = LinearT(X, Wq);
   AddRowBias(Q, bq);
   matrix K = LinearT(X, Wk);
   AddRowBias(K, bk);
   matrix V = LinearT(X, Wv);
   AddRowBias(V, bv);
//--- shared RoPE tables for all heads
   matrix cosT, sinT;
   RoPETables(T, hd, cosT, sinT);
   matrix ctx = matrix::Zeros(T, d_model);
//--- per-head causal attention
   for(int h = 0; h < n_heads; h++)
     {
      ulong c0 = (ulong)h * hd;
      matrix Qs = SliceCols(Q, c0, hd);
      matrix Ks = SliceCols(K, c0, hd);
      matrix Qh = ApplyRoPE(Qs, cosT, sinT);
      matrix Kh = ApplyRoPE(Ks, cosT, sinT);
      matrix Vh = SliceCols(V, c0, hd);

      matrix Oh = SDPA(Qh, Kh, Vh, true);
      WriteCols(ctx, Oh, c0);
     }
//--- output projection (with bias)
   matrix out = LinearT(ctx, Wo);
   AddRowBias(out, bo);
   return out;
  }
Блок
Теперь, когда все компоненты готовы, код самого блока получается коротким. Это блок с предварительным нормированием: сначала выполняется нормирование, затем вычисляется внимание и результат прибавляется к входу по остаточной связи; после этого снова выполняется нормирование, применяется сеть прямого распространения и ее результат также прибавляется по остаточной связи. Именованные локальные переменные здесь используются из-за того же ограничения на передачу по ссылке.
//+------------------------------------------------------------------+
//| Pre-norm block:                                                  |
//|   x += MHA(RMSNorm1(x)); x += SwiGLU(RMSNorm2(x)).               |
//+------------------------------------------------------------------+
matrix TransformerBlock(const matrix &X,
                        const vector &norm1_w,
                        const matrix &Wq, const vector &bq,
                        const matrix &Wk, const vector &bk,
                        const matrix &Wv, const vector &bv,
                        const matrix &Wo, const vector &bo,
                        int n_heads,
                        const vector &norm2_w,
                        const matrix &W1, const matrix &W3, const matrix &W2)
  {
//--- attention sub-block: x1 = x + MHA(RMSNorm1(x))
   matrix n1 = RMSNorm(X, norm1_w);                 // named locals: no temporaries by reference
   matrix a  = MHA(n1, Wq, bq, Wk, bk, Wv, bv, Wo, bo, n_heads);
   matrix x1 = X + a;
//--- feed-forward sub-block: out = x1 + SwiGLU(RMSNorm2(x1))
   matrix n2 = RMSNorm(x1, norm2_w);
   matrix f  = SwiGLU(n2, W1, W3, W2);
   return x1 + f;
  }
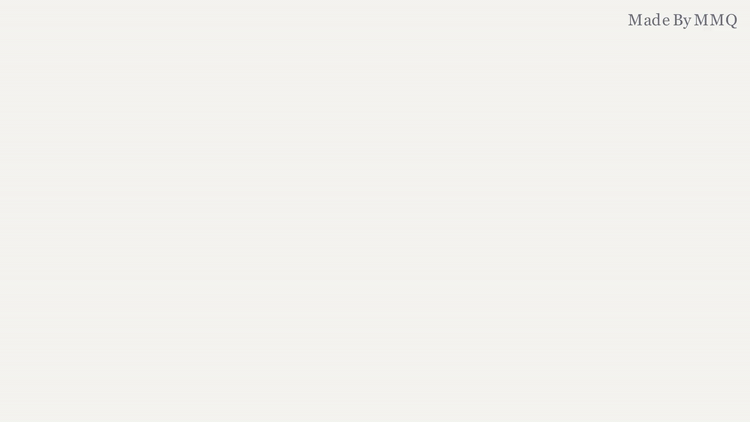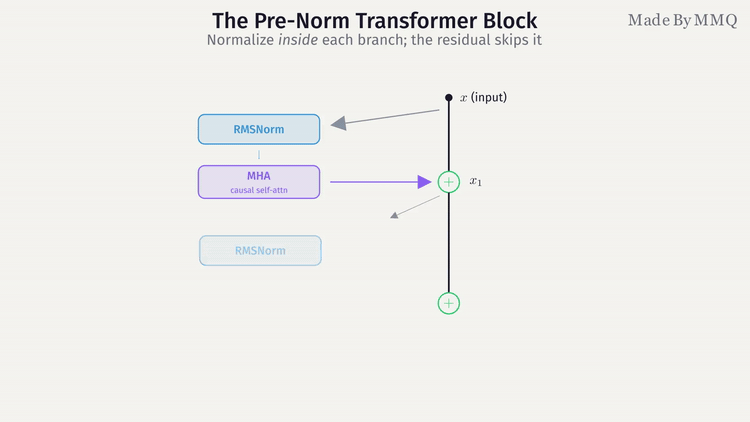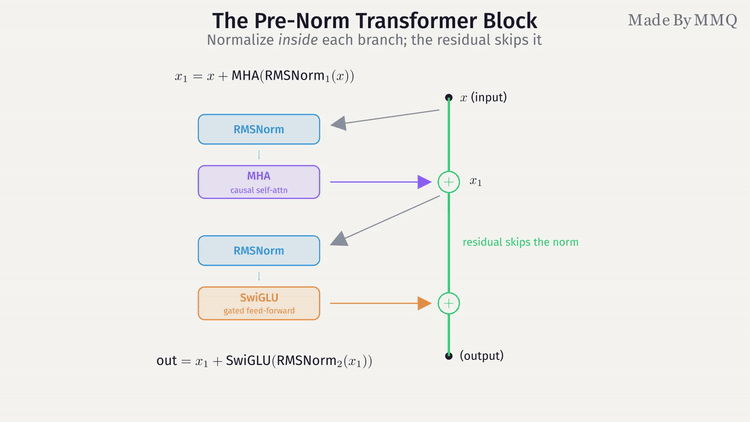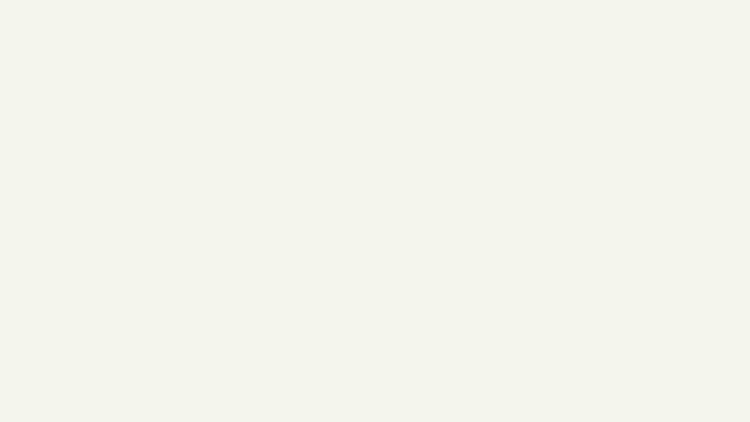
Рис. 5. Поток данных через блок с предварительным нормированием: каждая из двух остаточных ветвей нормирует входные данные, преобразует их и прибавляет результат к потоку
Теперь кодировщик можно представить как простую последовательность операций. Преобразуйте шесть признаков в эмбеддинг размерности модели, выполните блоки, спроецируйте результат в двадцатимерное входное пространство BSQ и получите токены. В числе итераций цикла есть еще одна особенность, которую мы увидим в коде ниже.
   //+---------------------------------------------------------------+
   //| Encode a normalized window into hierarchical token ids.       |
   //|   x_norm        : (L, 6), preprocessed by KronosNormalize     |
   //|   s1_ids,s2_ids : output token ids, length L                  |
   //+---------------------------------------------------------------+
   bool              Encode(const matrix &x_norm, int &s1_ids[], int &s2_ids[])
     {
      if(x_norm.Cols() != KR_NFEAT)
        { PrintFormat("CKronosEncoder::Encode: expected %d feature cols, got %I64u", KR_NFEAT, x_norm.Cols()); return false; }

      //--- embed: 6 -> d_model
      matrix z = LinearT(x_norm, m_embedW);
      AddRowBias(z, m_embedB);
      //--- (n_enc_layers - 1) causal pre-norm blocks
      for(int b = 0; b < m_blocks; b++)
         z = TransformerBlock(z, m_n1[b],
                              m_Wq[b], m_bq[b], m_Wk[b], m_bk[b],
                              m_Wv[b], m_bv[b], m_Wo[b], m_bo[b],
                              m_heads, m_n2[b], m_W1[b], m_W3[b], m_W2[b]);
      //--- quant_embed: d_model -> 20 (this is the BSQ input z)
      matrix zq = LinearT(z, m_quantW);
      AddRowBias(zq, m_quantB);
      //--- BSQ: indices depend ONLY on sign of each of the 20 components, so the
      //--- L2-normalize + scale inside BinarySphericalQuantizer are skipped here
      ulong L = zq.Rows();
      ArrayResize(s1_ids, (int)L);
      ArrayResize(s2_ids, (int)L);
      double row[];
      ArrayResize(row, KR_CODEBOOK_DIM);
      for(ulong t = 0; t < L; t++)
        {
         for(int k = 0; k < KR_CODEBOOK_DIM; k++)
            row[k] = zq[t][k];
         int s1, s2;
         KronosBSQ_SignsToIndices(row, s1, s2);
         s1_ids[(int)t] = s1;
         s2_ids[(int)t] = s2;
        }
      return true;
     }
Цикл выполняется m_blocks раз, при этом m_blocks задается равным n_enc_layers - 1. Это не ошибка. Исходный токенизатор формирует список блоков с помощью range(n_layers - 1), поэтому при четырех слоях в конфигурации создаются три блока. Эту особенность легко упустить из виду и легко ошибочно "исправить". Как мы увидим в части 2, у предиктора нет этой особенности: он использует полное количество слоев, поэтому предиктор и токенизатор нужно обрабатывать по-разному.
Подтверждение корректности — проверка по эталонным данным
Все описанное выше бесполезно, если результаты не совпадают с исходной моделью, а "выглядит правдоподобно" — не критерий. Поэтому проект строится по принципу "сначала проверка": ни один компонент не используется до подтверждения его корректности. Но подтверждение корректности не сводится к одной проверке. Здесь проверка состоит из трех ступеней, каждая из которых выявляет свой класс ошибок:
- модульные тесты отдельных примитивов без загрузки весов, которые еще до загрузки обученных весов проверяют соответствие каждой операции свойству, проверяемому вручную;
- эталонные данные, полученные от исходной модели PyTorch на фиксированных входных данных и задающие достоверные числовые значения для сравнения;
- средство поэтапной проверки, которое запускает код MQL5 на тех же фиксированных входных данных и сравнивает результат с эталонными данными.
Мы проходим эти ступени именно в таком порядке. Если в примитиве есть ошибка, первая ступень выявляет ее изолированно — без весов и эталонных данных, которые могли бы затруднить диагностику. Только убедившись в корректности примитивов, мы загружаем веса и сравниваем результаты всего кодировщика с результатами модели PyTorch.
Ступень 1 — самопроверки без загрузки весов. До загрузки каких-либо весов KronosSelfTests.mq5 проверяет каждый примитив на соответствие свойству, которое можно проверить независимо. Для этих тестов не нужен эталонный файл, поскольку ожидаемый результат заранее известен благодаря самой конструкции теста. Самый наглядный пример — каузальное внимание. Если подать в один столбец значения 0, 1, 2, 3, обнулить проекции запросов и ключей для равномерного распределения внимания и использовать тождественную проекцию значений, каузальная маска сделает каждую выходную строку равной среднему значений на текущей и всех предшествующих позициях. Строка 0 должна равняться V[0], строка 1 — среднему первых двух значений и т.д. Один этот тест одновременно проверяет направление маски, нормирование softmax и взвешивание значений:
//+------------------------------------------------------------------+
//| Causal attention: each row is the mean of values up to that row. |
//+------------------------------------------------------------------+
void Test_Attention_Causal()
  {
   ulong d=4, T=4;
   matrix X = matrix::Zeros(T,d);
   for(ulong i=0;i<T;i++)
      X[i][0]=(double)i;
   matrix Z = matrix::Zeros(d,d), I = Identity(d);
   vector zb = vector::Zeros(d);
   matrix O = MHA(X, Z,zb, Z,zb, I,zb, I,zb, 1);
   CHECK(MathAbs(O[0][0]-0.0)<1e-12, "attn row0 = V[0]");
   CHECK(MathAbs(O[1][0]-0.5)<1e-12, "attn row1 = mean(V[0..1])");
   CHECK(MathAbs(O[3][0]-1.5)<1e-12, "attn row3 = mean(V[0..3])");
  }
Вывод KronosSelfTests.mq5:
Самопроверка библиотеки Kronos: 126 тестов пройдено, 0 тестов не пройдено
ВСЕ ТЕСТЫ ПРОЙДЕНЫ — примитивы 1-3 проверены без загрузки весов.
Остальные проверки ступени 1 построены по тому же принципу. Проверяется, что RoPE задает тождественное преобразование на позиции 0 и сохраняет норму вектора на всех остальных позициях: корректное вращение должно обладать обоими свойствами. Проверяется, что RMSNorm дает выход со среднеквадратичным значением 1, схема соединений блока сводится к тождественному преобразованию при обнулении проекций, а вычисление индексов BSQ позволяет преобразовать идентификатор в код и обратно без изменений. Ни одной из этих проверок не нужен файл весов; к моменту сборки полного кодировщика корректность каждой его составной части уже подтверждена.
Ступень 2 — получение эталонных данных. Проверка свойств подтверждает внутреннюю согласованность примитива, но не доказывает, что собранный кодировщик дает те же результаты, что и Kronos. Для этого нужен численный эталон, полученный исходной моделью. Скрипт kronos_reference_capture.py дополняет описанный ранее экспорт весов: тот скрипт сохранял параметры модели, а этот запускает ее на одном фиксированном окне входных данных и сохраняет активации. Для воспроизводимости скрипт принудительно использует CPU и float32, точно повторяет предобработку Kronos, затем последовательно проходит по модели и сохраняет каждый промежуточный результат в файл .bin, который средства проверки на MQL5 считывают без изменений. Ниже приведен код предобработки, затем вызов кодировщика, формирующий эталонные идентификаторы токенов:
    # --------------------------------------------- preprocessing (exact copy)
    x_mean = x_raw.mean(axis=0)                                  # (6,)
    x_std = x_raw.std(axis=0)                                    # (6,) population std, ddof=0
    x_norm = (x_raw - x_mean) / (x_std + args.eps)
    x_norm = np.clip(x_norm, -args.clip, args.clip).astype(np.float32)

    print("\nStage 0  preprocessing")
    save("x_raw", x_raw, np.float32)
    save("x_norm", x_norm, np.float32)
    save("x_mean", x_mean, np.float32)
    save("x_std", x_std, np.float32)
    save("x_stamp", x_stamp, np.float32)
    save("y_stamp", y_stamp, np.float32)

    xt = torch.from_numpy(x_norm)[None].to(device)              # (1, L, 6)
    xs = torch.from_numpy(x_stamp)[None].to(device)             # (1, L, 5)

    # ----------------------------------------------- Stage 1: tokenizer.encode
    print("\nStage 1  tokenizer.encode (half=True -> [s1_ids, s2_ids])")
    z_idx = tok.encode(xt, half=True)
    s1_ids = z_idx[0] if isinstance(z_idx, (list, tuple)) else z_idx
    s2_ids = z_idx[1] if isinstance(z_idx, (list, tuple)) else None
    save("s1_ids", s1_ids.cpu().numpy(), np.int32)
    if s2_ids is not None:
        save("s2_ids", s2_ids.cpu().numpy(), np.int32)
Строка x_std = x_raw.std(axis=0) задает эталонное вычисление, которое нужно воспроизвести в точности: по умолчанию NumPy вычисляет стандартное отклонение генеральной совокупности (ddof=0), поэтому функция KronosNormalize на MQL5 также делит на число строк при вычислении дисперсии. Вызовы save записывают каждый массив в двух форматах: .npy для проверки в Python и .bin с порядком байтов от младшего к старшему и с построчным хранением для непосредственного чтения средством проверки. Метки Stage 0 и Stage 1 обозначают первые два этапа более длинной цепочки: далее тот же скрипт запускает decode_s1, decode_s2 и decode токенизатора, сохраняя также логиты предиктора и результат реконструкции.
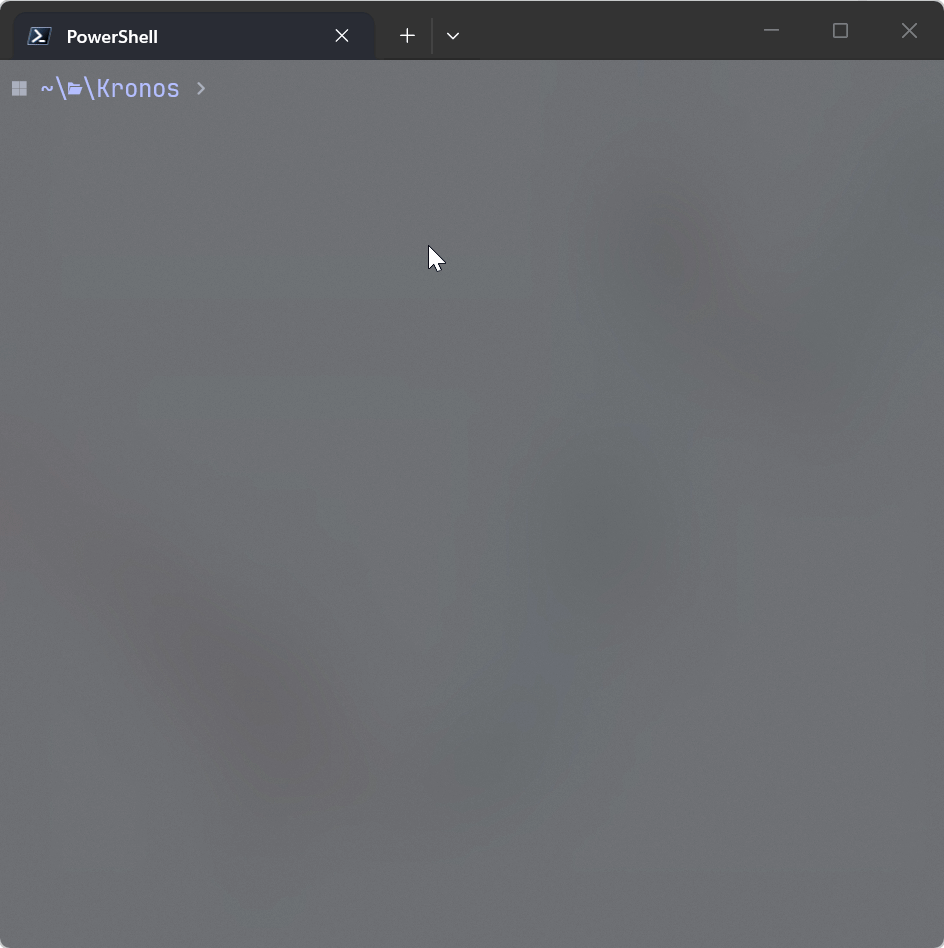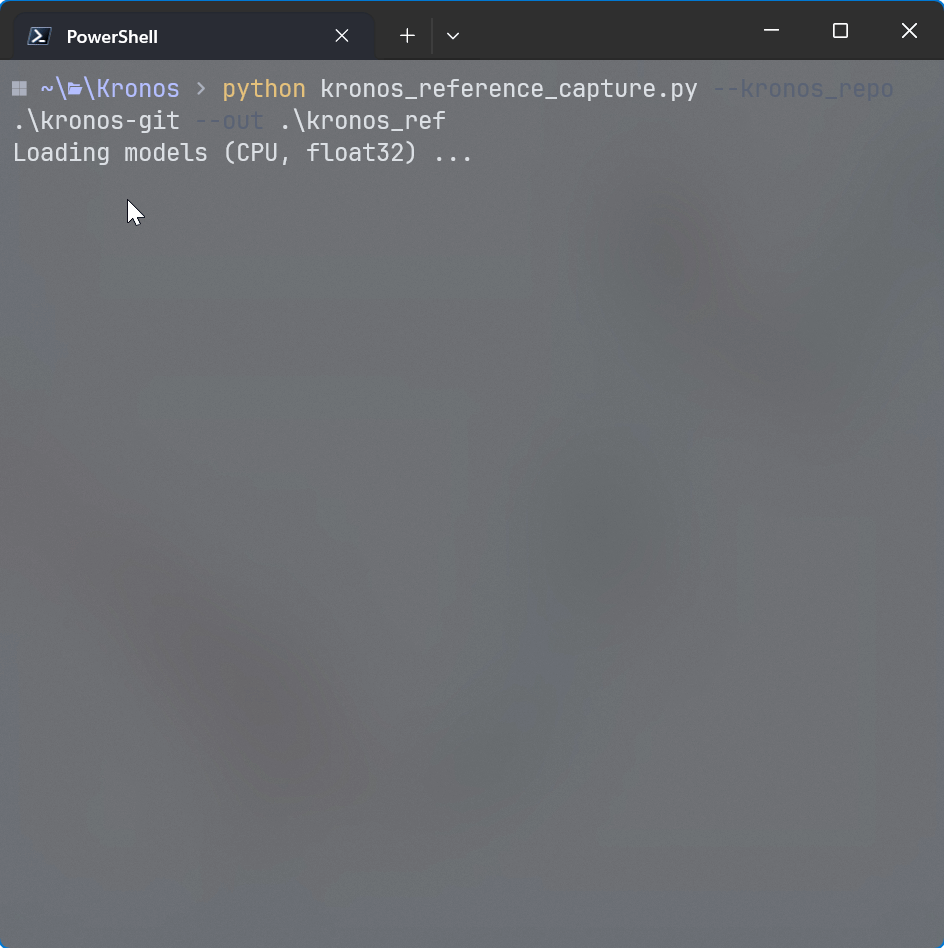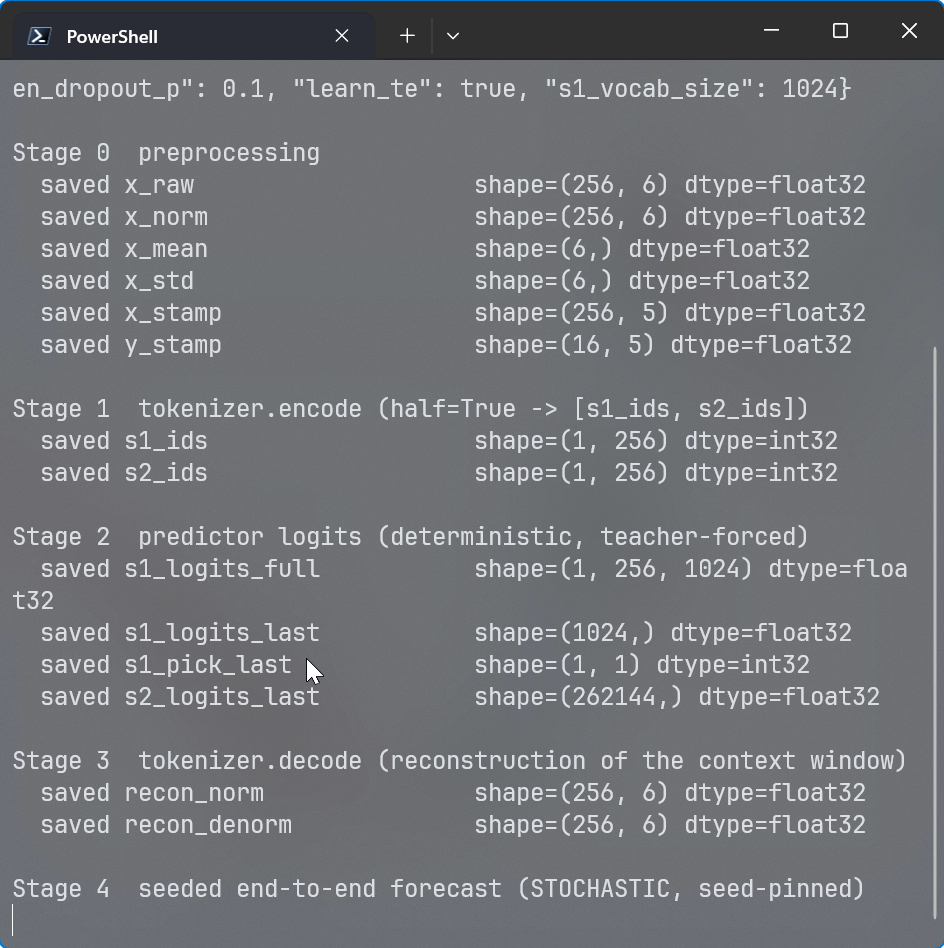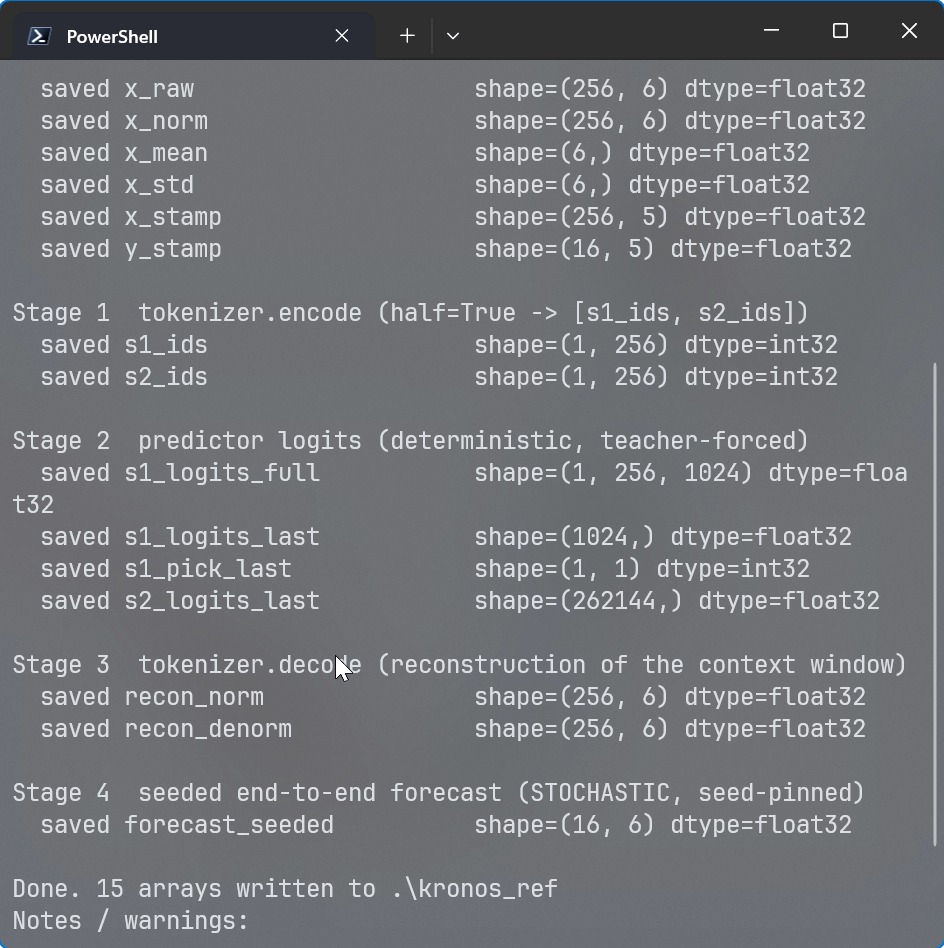
Рис. 6. Эталонные выходные данные. Для воспроизводимости принудительно используются CPU и float32.
Весь процесс получения эталонных данных намеренно детерминирован, без сэмплирования на любом этапе. Это единая воспроизводимая цепочка от нормированных входных данных через идентификаторы токенов до логитов и реконструкции. Один скрипт сохраняет результаты всех этапов цепочки за один запуск. В части 1 используются только данные первого звена — идентификаторы токенов; логиты и реконструкция служат эталонными данными для предиктора и декодировщика, которые мы создадим в части 2. Стоит еще раз напомнить, почему выше принудительно выбраны CPU и float32: запуск на GPU не обеспечил бы побитной воспроизводимости, а весь смысл проверки — в точном совпадении результатов.
Ступень 3 — средство проверки кодировщика. При наличии надежных эталонных данных сама проверка становится почти механической. Скрипт KronosVerifyEncoder.mq5 загружает фиксированные входные данные x_norm и эталонные s1_ids и s2_ids, создает и запускает кодировщик на MQL5 с точно такими же входными данными, затем сравнивает результаты. В теле скрипта эти четыре шага следуют один за другим:
   //--- 1) load the frozen normalized input window
   matrix x_norm;
   if(!LoadF32Matrix(InpRefDir + "x_norm.bin", (ulong)L, KR_NFEAT, x_norm))
     { Print("ABORT: could not load x_norm.bin"); return; }
   PrintFormat("Loaded x_norm: %I64u x %I64u", x_norm.Rows(), x_norm.Cols());

   //--- 2) load the golden token ids
   int ref_s1[], ref_s2[];
   if(!LoadI32Array(InpRefDir + "s1_ids.bin", L, ref_s1)) { Print("ABORT: s1_ids.bin"); return; }
   if(!LoadI32Array(InpRefDir + "s2_ids.bin", L, ref_s2)) { Print("ABORT: s2_ids.bin"); return; }

   //--- 3) build + load the encoder, run it
   CKronosEncoder enc;
   if(!enc.Init(KR_TOK_WEIGHT_DIR, KR_TOK_N_ENC_LAYERS, KR_TOK_D_MODEL, KR_TOK_N_HEADS, KR_TOK_FF_DIM))
     { Print("ABORT: encoder Init failed (weights/paths)"); return; }
   Print("Encoder weights loaded.");

   int s1[], s2[];
   if(!enc.Encode(x_norm, s1, s2))
     { Print("ABORT: Encode() failed"); return; }
   PrintFormat("Encode produced %d s1 ids, %d s2 ids", ArraySize(s1), ArraySize(s2));

   if(ArraySize(s1) != L || ArraySize(s2) != L)
     { PrintFormat("ABORT: length mismatch (got %d/%d, expected %d)", ArraySize(s1), ArraySize(s2), L); return; }

   //--- 4) exact integer comparison
   int first1, first2;
   int bad1 = CountMismatch(s1, ref_s1, L, first1);
   int bad2 = CountMismatch(s2, ref_s2, L, first2);

   PrintFormat("s1: %d / %d match  (mismatches: %d)", L - bad1, L, bad1);
   PrintFormat("s2: %d / %d match  (mismatches: %d)", L - bad2, L, bad2);
Для идентификаторов токенов требования максимально строгие: целочисленные значения должны точно совпадать, поэтому функция CountMismatch проверяет условие a[i] != b[i], а не использует допуск. Идентификаторы токенов дискретны, поэтому расхождение не скрыть: даже один несовпадающий бит в компоненте после проекции изменил бы токен и сразу обнаружился при проверке. В результате получено полное совпадение: 256 из 256 в обоих потоках токенов. Если число совпадений меньше ожидаемого, скрипт выводит первые несколько позиций с расхождениями, размещая рядом значения реализации на MQL5 и эталонные значения. Типичные причины — соглашение о транспонировании, схема расположения компонент RoPE или число блоков: именно эти подводные камни отмечались в статье.
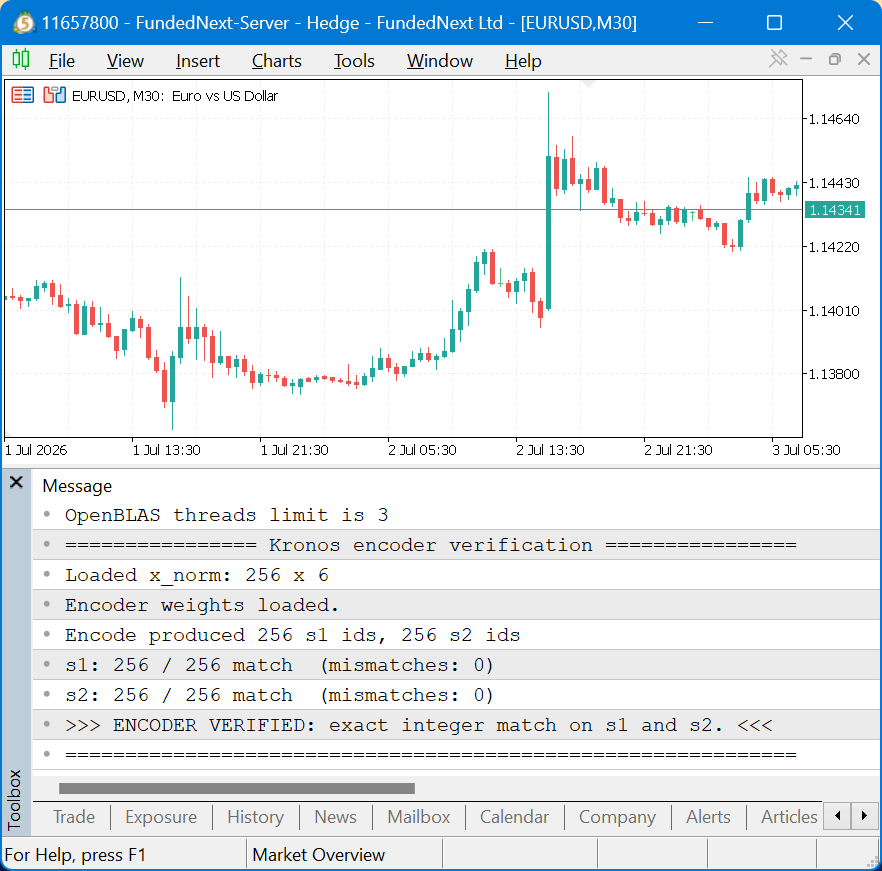
Рис. 7. Средство проверки кодировщика сообщает о точном совпадении целочисленных значений с эталонными данными PyTorch в обоих потоках токенов
На этом этапе также подтверждается корректность упрощенной реализации BSQ, учитывающей только знаки компонент. Если бы какая-либо компонента после проекции оказалась настолько близкой к нулю, что ее знак различался бы при вычислениях в double и float32, токен на этом баре был бы другим, а число совпадений оказалось бы меньше 256. Это не так. Декодировщик и предиктор проверяются аналогично по собственным эталонным данным, полученным в том же сеансе, с небольшими допусками для непрерывных выходных значений с плавающей запятой. Эти результаты относятся к части 2, где мы реализуем оба компонента. Здесь важен принцип, ради которого выстроены все ступени проверки: ничего не создается вслепую и результатам последующих этапов не доверяют, пока не подтверждена корректность их входных данных.
Заключение
Мы реализовали и проверили первую половину нативной реализации Kronos на MQL5. Взяв обученную модель PyTorch, мы экспортировали все веса в плоские бинарные файлы, нормировали исходные свечи и подготовили временные метки в соответствии с требованиями модели. Каждый бар мы преобразовали в пару иерархических токенов с помощью бинарного сферического квантования и собрали блок трансформера с RMSNorm, RoPE, SwiGLU и каузальным вниманием на основе элементарных матричных операций. Кодировщик в точности воспроизводит эталонные токены.
- Python не используется во время выполнения. Единственный этап вне выполнения модели — однократный экспорт весов; терминал запускает модель самостоятельно.
- BSQ допускает упрощение без изменения токенов. Поскольку квантование сохраняет знак, токены определяются только знаками координат латентного вектора после проекции: нормирование не требуется, а результат остается точным.
- Подводные камни вполне реальны. Перенумерация дней недели pandas, передача матриц только по ссылке и число блоков n - 1 — области, где легко допустить ошибку, не вызывающую явного сбоя, но незаметно искажающую результат.
- Проверка — это основа. Именно точное совпадение 256 из 256 токенов позволяет уверенно выстраивать на этой основе остальную часть пайплайна.
В части 2 мы перейдем к другой половине модели: рассмотрим декодировщик, преобразующий токены обратно в свечи, предиктор новых токенов, особенность перекрестного внимания, потребовавшую серьезной отладки, и авторегрессионный цикл для прогноза на несколько баров. Также мы займемся оптимизацией производительности, чтобы все это работало за разумное время.
Получение исходного кода через MQL5 Algo Forge
Все исходные файлы прикреплены ниже к этой статье, но полный репозиторий также доступен на MQL5 Algo Forge — платформе сообщества на базе Git для публикации торговых проектов и совместной работы над ними.
| Имя файла | Описание |
|---|---|
| MQL5\Include\Kronos\KronosTokenizerMath.mqh | Предобработка (z-нормирование и обратное преобразование), формирование временных меток с перенумерацией дней недели, вычисления знаков и индексов BSQ, а также загрузчики весов |
| MQL5\Include\Kronos\KronosTransformerCore.mqh | Примитивы трансформера: LinearT, RMSNorm, SwiGLU, таблицы RoPE и их применение, SDPA, каузальное самовнимание и блок с предварительным нормированием |
| MQL5\Include\Kronos\KronosEncoder.mqh | CKronosEncoder: цепочка кодирования токенизатора, преобразующая нормированные свечи в иерархические идентификаторы токенов s1/s2 |
| MQL5\Scripts\Kronos\KronosSelfTests.mq5 | Модульные самопроверки примитивов трансформера (LinearT, RMSNorm, SwiGLU, RoPE, внимание) без загрузки весов — ступень 1 общей проверки |
| MQL5\Scripts\Kronos\KronosVerifyEncoder.mq5 | Средство проверки, сравнивающее токены кодировщика с эталонными данными PyTorch (точное совпадение целочисленных значений), — ступень 3 общей проверки |
| MQL5\Kronos_Python\export_kronos_weights.py | Экспортер весов для однократного запуска на подготовительном этапе: сохраняет каждый тензор в файл .bin в формате float32 с порядком байтов от младшего к старшему и создает манифест |
| MQL5\Kronos_Python\kronos_reference_capture.py | Однократный подготовительный запуск: фиксирует входные данные и сохраняет эталонные данные PyTorch для всех средств проверки — ступень 2 общей проверки |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/23304
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.

 Кэширование метаданных символов и расписаний торговых сессий в MQL5: Устранение лишних вызовов SymbolInfo в мультисимвольных советниках
 Создание системы торговой аналитики (Часть 4): Сводные метрики и дашборд
 Разработка индикатора снятия ликвидности STF Liquidity Sweep на языке MQL5
 От клонирования и коммитов к CI: Расширенные возможности MQL5 Algo Forge

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования