

Тест Диболда–Мариано на MQL5: Сравниваем точность прогнозных моделей на разных инструментах
 40
 0

Введение
Рано или поздно у вас появляются две прогнозные модели, и вслед за этим возникает вопрос, который редко рассматривают достаточно тщательно: действительно ли новая модель лучше или она лишь выглядит лучше на том графике, который вы случайно выбрали для анализа? Кривые средств плохо отвечают на этот вопрос: две кривые могут пересечься с десяток раз, но вы так и не поймете, отражает ли расхождение реальную способность модели прогнозировать или лишь благоприятный случайный шум. Нужен формальный тест для двух рядов ошибок прогноза, который учитывает автокорреляцию и особенности малых выборок, прежде чем признать различие значимым.
Такой тест существует. Диболд и Мариано разработали его в 1995 году для сравнения макроэкономических прогнозных моделей, и он хорошо подходит для торговли. По двум рядам разностей потерь он рассчитывает статистику критерия и p-значение, позволяющие судить о том, отличается ли разность в точности прогнозирования от нуля статистически значимо. В этой статье тест реализован непосредственно на MQL5 с поправкой Ньюи–Уэста для HAC-оценки дисперсии и поправкой Харви–Лейборна–Ньюболда для малых выборок — последняя становится существенной, когда в выборке остается лишь несколько сотен баров. Советник и индикатор в подокне выполняют этот тест в реальном времени и показывают его результат для скользящего окна.
Примечание: в этой статье в первую очередь создается механизм сравнения и лишь во вторую — торговый слой. Советник параллельно запускает две прогнозные модели, в реальном времени рассчитывает статистику DM в скользящем окне, отображает информационную панель с цветовой индикацией результата теста. Только после этого он торгует в направлении, которое прогнозирует модель, получившая преимущество по текущему результату теста. Благодаря этому результат теста подкрепляется реальным числом сделок. Доверять следует именно результату сравнения моделей на информационной панели. Торговая логика нужна для того, чтобы оценить его на практике, а не для создания готовой торговой стратегии.
Почему кривые средств вводят вас в заблуждение
Уточнение по терминологии: везде, где в этой статье используется термин "изменение цены" (return), имеется в виду простая разность цен между соседними барами (close[t] - close[t-1]), а не процентная или логарифмическая доходность — для математического аппарата DM неважно, какое определение вы используете, если оно одинаково для обеих сравниваемых моделей.
Прямое сравнение уровней накопленных потерь малоубедительно: ошибки прогноза в финансовых временных рядах гетероскедастичны и автокоррелированы — на спокойных барах с низкой волатильностью ошибки обеих моделей одновременно снижаются, а при всплеске волатильности происходит обратное. Поэтому наивный t-тест, предполагающий независимость наблюдений, легко покажет значимость там, где на самом деле обе модели лишь испытывают воздействие одного и того же режима волатильности. Тест DM справляется с этой проблемой, используя ряд разностей потерь вместо уровней потерь и оценивая его долгосрочную дисперсию с помощью HAC-оценки, состоятельной при гетероскедастичности и автокорреляции, а не обычной выборочной дисперсии. Именно этот этап пропускают в большинстве реализаций с нуля, хотя именно он делает тест надежным при работе с финансовыми данными. В разделе 3 рассматривается поведение этой оценки при горизонте прогнозирования в один шаг, используемом в статье по умолчанию.
Математика: разности потерь, HAC-оценка дисперсии и поправка HLN
Пусть e1_t и e2_t — ошибки прогноза моделей A и B на баре t: фактическое изменение цены минус прогнозируемое. Выберите функцию потерь L(.), обычно квадрат ошибки для непрерывных прогнозов, и вычислите разность потерь d_t = L(e1_t) - L(e2_t) для каждого бара; отрицательное значение d_t означает, что у модели A потери были меньше. Все дальнейшие вычисления выполняются на основе этого единственного ряда, упакованного в одну небольшую структуру:
ENUM_DM_LOSS и DMResult
//--- Loss function types
enum ENUM_DM_LOSS
  {
   DM_LOSS_SQUARED = 0,   // (e)^2
   DM_LOSS_ABSOLUTE = 1   // |e|
  };

//--- Result container for a single DM test
struct DMResult
  {
   double            mean_diff;      // d-bar
   double            hac_variance;  // long-run variance estimate
   double            dm_stat;       // raw DM statistic
   double            hln_stat;      // Harvey-Leybourne-Newbold corrected statistic
   double            pvalue;        // two-tailed p-value (Student-t)
   int               n;                // sample size used
   int               horizon;       // forecast horizon h
   string         verdict;       // see the verdict strings table below
  };
Тест может вернуть пять строковых значений результата: первые два обозначают итоги проверки, остальные — причины, по которым тест не смог дать ответ:
| Строка результата теста | Значение |
|---|---|
| A_BETTER / B_BETTER | Тест выполнен и выявил статистически значимую разность потерь при заданном уровне значимости alpha |
| NO_SIGNIFICANT_DIFF | Тест выполнен; p-значение превысило уровень значимости alpha либо ошибки двух прогнозных моделей были численно неразличимы |
| INSUFFICIENT_SAMPLE | Число доступных баров было меньше значения min_sample_size в манифесте — тест не выполнялся |
| INVALID_HORIZON | Горизонт прогнозирования был нулевым или отрицательным либо (что менее очевидно) настолько большим относительно n, что подкоренное выражение в поправке HLN становилось отрицательным; оба случая явно отклоняются, чтобы не допустить возврата NaN функцией MathSqrt() |
| INVALID_VARIANCE | HAC-оценка дисперсии оказалась отрицательной — это численно недопустимый результат, а не результат "различий нет" |
Разность потерь вычисляется для каждого бара как d_t = L(e1_t) - L(e2_t) с использованием выбранной функции потерь:
DM_LossDifferential
//+------------------------------------------------------------------+
//| Compute per-bar loss differential d_t = L(e1_t) - L(e2_t)        |
//+------------------------------------------------------------------+
void DM_LossDifferential(const double &errA[], const double &errB[], const ENUM_DM_LOSS loss_type,
                         double &d_out[])
  {
   int n = MathMin(ArraySize(errA), ArraySize(errB));
   ArrayResize(d_out, n);
   for(int i = 0; i < n; i++)
     {
       double la, lb;
       if(loss_type == DM_LOSS_SQUARED)
         {
           la = errA[i] * errA[i];
           lb = errB[i] * errB[i];
         }
       else
         {
           la = MathAbs(errA[i]);
           lb = MathAbs(errB[i]);
         }
       d_out[i] = la - lb;
     }
  }
Статистика критерия вычисляется как отношение выборочного среднего d_t к оценке стандартной ошибки этого среднего: DM = d_bar / sqrt(V_hat / T), где V_hat — долгосрочная дисперсия d_bar. Вместо обычной выборочной дисперсии d_t HAC-оценка использует сумму автоковариаций по всем лагам до h-1 включительно (где h — горизонт прогнозирования) с весами, задаваемыми ядром Бартлетта, так что более отдаленные лаги вносят меньший вклад. Для вычисления автоковариации при заданном лаге используется отдельная небольшая вспомогательная функция:
DM_Autocovariance
//+------------------------------------------------------------------+
//| Sample autocovariance at lag k for a zero-lag-demeaned series    |
//+------------------------------------------------------------------+
double DM_Autocovariance(const double &d[], const double mean, const int k)
  {
   int n = ArraySize(d);
   if(k >= n)
       return(0.0);
   double sum = 0.0;
   for(int t = k; t < n; t++)
       sum += (d[t] - mean) * (d[t - k] - mean);
   return(sum / n);
  }
DM_HACVariance
//+------------------------------------------------------------------+
//| Bartlett-kernel HAC (Newey-West) long-run variance of d-bar      |
//| lag_max = h - 1, per Diebold & Mariano (1995)                    |
//+------------------------------------------------------------------+
double DM_HACVariance(const double &d[], const int horizon)
  {
   int n = ArraySize(d);
   if(n <= 1)
       return(0.0);

   double mean = 0.0;
   for(int i = 0; i < n; i++)
       mean += d[i];
   mean /= n;

   int lag_max = MathMax(0, horizon - 1);
   //--- guard: lag window cannot exceed available sample
   lag_max = MathMin(lag_max, n - 1);

   double gamma0 = DM_Autocovariance(d, mean, 0);
   double var_sum = gamma0;

   //--- h == 1 collapses to plain sample variance, no Bartlett terms needed
   for(int k = 1; k <= lag_max; k++)
     {
       double w = 1.0 - (double)k / (double)horizon;   // Bartlett kernel weight
       double gamma_k = DM_Autocovariance(d, mean, k);
       var_sum += 2.0 * w * gamma_k;
     }
   return(var_sum);
  }
Для расчета p-значения и границ критических значений требуется распределение Стьюдента, однако не во всех установках MetaTrader есть файл Math\Stat\Student.mqh из стандартной библиотеки, поэтому данная библиотека содержит собственные реализации функции распределения и расчета квантилей на основе стандартного подхода с использованием регуляризованной неполной бета-функции:
DM_StudentCDF / DM_StudentQuantile (со вспомогательными функциями для вычисления неполной бета-функции)
double DM_LogGamma(const double x)
  {
   double cof[6] =
     {
       76.18009172947146, -86.50532032941677, 24.01409824083091,
       -1.231739572450155, 0.1208650973866179e-2, -0.5395239384953e-5
     };
   double y = x;
   double tmp = x + 5.5;
   tmp -= (x + 0.5) * MathLog(tmp);
   double ser = 1.000000000190015;
   for(int j = 0; j < 6; j++)
     {
       y += 1.0;
       ser += cof[j] / y;
     }
   return(-tmp + MathLog(2.5066282746310005 * ser / x));
  }

double DM_BetaCF(const double x, const double a, const double b)
  {
   const int max_iter = 200;
   const double eps     = 3.0e-12;
   const double fpmin   = 1.0e-300;

   double qab = a + b;
   double qap = a + 1.0;
   double qam = a - 1.0;
   double c = 1.0;
   double d = 1.0 - qab * x / qap;
   if(MathAbs(d) < fpmin) d = fpmin;
   d = 1.0 / d;
   double h = d;

   for(int m = 1; m <= max_iter; m++)
     {
       double m2 = 2.0 * m;
       double aa = m * (b - m) * x / ((qam + m2) * (a + m2));
       d = 1.0 + aa * d;   if(MathAbs(d) < fpmin) d = fpmin;
       c = 1.0 + aa / c;   if(MathAbs(c) < fpmin) c = fpmin;
       d = 1.0 / d;
       h *= d * c;

       aa = -(a + m) * (qab + m) * x / ((a + m2) * (qap + m2));
       d = 1.0 + aa * d;   if(MathAbs(d) < fpmin) d = fpmin;
       c = 1.0 + aa / c;   if(MathAbs(c) < fpmin) c = fpmin;
       d = 1.0 / d;
       double del = d * c;
       h *= del;

       if(MathAbs(del - 1.0) < eps)
         break;
     }
   return(h);
  }

double DM_IncompleteBeta(const double x, const double a, const double b)
  {
   if(x <= 0.0) return(0.0);
   if(x >= 1.0) return(1.0);

   double bt = MathExp(DM_LogGamma(a + b) - DM_LogGamma(a) - DM_LogGamma(b) +
               a * MathLog(x) + b * MathLog(1.0 - x));

   if(x < (a + 1.0) / (a + b + 2.0))
       return(bt * DM_BetaCF(x, a, b) / a);
   else
       return(1.0 - bt * DM_BetaCF(1.0 - x, b, a) / b);
  }

//+------------------------------------------------------------------+
//| P(T <= t) for a Student-t distribution with the given df         |
//+------------------------------------------------------------------+
double DM_StudentCDF(const double t, const double df)
  {
   double x   = df / (df + t * t);
   double ib = DM_IncompleteBeta(x, df / 2.0, 0.5);
   return(t > 0.0 ? 1.0 - 0.5 * ib : 0.5 * ib);
  }

//+------------------------------------------------------------------+
//| Inverse CDF via bisection - monotone in t, robust for any df      |
//+------------------------------------------------------------------+
double DM_StudentQuantile(const double p, const double df)
  {
   double lo = -100.0, hi = 100.0;
   for(int i = 0; i < 200; i++)
     {
       double mid = 0.5 * (lo + hi);
       if(DM_StudentCDF(mid, df) < p)
         lo = mid;
       else
         hi = mid;
     }
   return(0.5 * (lo + hi));
  }
Функция распределения вычисляется через регуляризованную неполную бета-функцию, а квантиль — методом бисекции по функции распределения; выборочная сверка со scipy.stats.t на нескольких комбинациях df/p в ходе разработки показала близкое совпадение результатов. На рис. 2 показано, как убывают веса Бартлетта при разных горизонтах прогнозирования. При h = 1 все слагаемые с ненулевыми лагами исчезают, и оценка сводится к обычной выборочной дисперсии. Это намеренно предусмотренный граничный случай, а не упущение: у прогнозов на один шаг вперед (используемых в этой статье по умолчанию) нет автокорреляции, обусловленной перекрытием прогнозов, которая возникает при более длинных горизонтах прогнозирования. При любом горизонте прогнозирования такой подход учитывает именно временную зависимость, вызванную перекрывающимися многошаговыми прогнозами, а не устраняет все возможные источники автокорреляции разности потерь, поэтому при h = 1 зависимость, обусловленная кластеризацией волатильности и не связанная с перекрытием прогнозов, может остаться неучтенной.
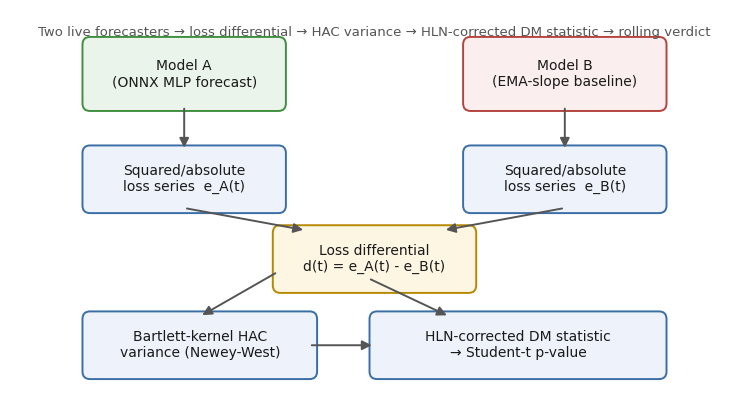
Рис. 1. Поток данных от двух работающих в реальном времени прогнозных моделей через разность потерь, HAC-оценку дисперсии и статистику DM с поправкой HLN к информационной панели результатов теста в скользящем окне.
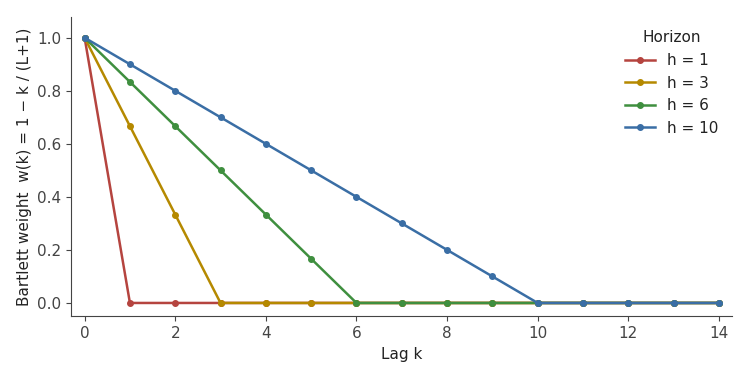
Рис. 2. Веса ядра Бартлетта по лагам для нескольких горизонтов прогнозирования h. При h = 1 в сумме нет лаговых слагаемых. При более длинных горизонтах прогнозирования в нее включаются автоковариации на более далеких лагах с весами, линейно убывающими до нуля.
Использование исходной статистики DM со стандартным нормальным распределением корректно лишь асимптотически — при наличии сотен или тысяч независимых наблюдений, которые при тестировании на исторических данных в MetaTrader редко удается получить в чистом виде. Поправка Харви–Лейборна–Ньюболда (HLN) 1997 года устраняет эту проблему за счет масштабирования статистики критерия и использования вместо нормального распределения распределения Стьюдента с n−1 степенями свободы. Практическое влияние поправки зависит от горизонта прогнозирования: при h = 1 слагаемое h(h−1) обращается в ноль, а масштабирующий коэффициент близок к 1 (примерно 0,998 при n = 250); по мере увеличения h влияние поправки становится существеннее. Все описанное выше объединено в одной функции — точке входа, которую вызывают и советник, и индикатор:
DM_RunTest
//+------------------------------------------------------------------+
//| Full Diebold-Mariano test with HLN small-sample correction       |
//+------------------------------------------------------------------+
bool DM_RunTest(const double &errA[], const double &errB[], const int horizon,
          const ENUM_DM_LOSS loss_type, DMResult &result,
          const int min_sample_size = 30, const double significance_alpha = 0.10)
  {
   result.horizon = horizon;

   //--- a horizon of zero or less breaks both the truncation lag (h-1) and
   //--- the HLN correction below, so it's rejected before touching the data
   if(horizon <= 0)
     {
       result.n = 0;
       result.verdict = "INVALID_HORIZON";
       result.mean_diff = 0.0;
       result.hac_variance = 0.0;
       result.dm_stat = 0.0;
       result.hln_stat = 0.0;
       result.pvalue = 1.0;
       return(false);
     }

   double d[];
   DM_LossDifferential(errA, errB, loss_type, d);
   int n = ArraySize(d);
   result.n = n;

   //--- insufficient sample size for asymptotic validity, driven by the
   //--- manifest's min_sample_size rather than a hardcoded literal
   if(n < min_sample_size)
     {
       result.verdict = "INSUFFICIENT_SAMPLE";
       result.mean_diff = 0.0;
       result.hac_variance = 0.0;
       result.dm_stat = 0.0;
       result.hln_stat = 0.0;
       result.pvalue = 1.0;
       return(false);
     }

   double mean = 0.0;
   for(int i = 0; i < n; i++)
       mean += d[i];
   mean /= n;

   double long_run_var = DM_HACVariance(d, horizon);
   result.mean_diff     = mean;
   result.hac_variance = long_run_var;

   //--- a negative long-run variance is a numerically invalid HAC estimate -
   //--- the Bartlett-kernel sum isn't guaranteed positive semi-definite in
   //--- finite samples - and must not be folded into "no difference" below
   if(long_run_var < 0.0)
     {
       result.dm_stat  = 0.0;
       result.hln_stat = 0.0;
       result.pvalue   = 1.0;
       result.verdict  = "INVALID_VARIANCE";
       return(false);
     }

   //--- guard against near-zero denominator (degenerate/identical forecasters);
   //--- this is a legitimate case, unlike the negative-variance one above
   double denom = long_run_var / (double)n;
   if(denom < 1e-12)
     {
       result.dm_stat  = 0.0;
       result.hln_stat = 0.0;
       result.pvalue   = 1.0;
       result.verdict  = "NO_SIGNIFICANT_DIFF";
       return(true);
     }

   double dm_raw = mean / MathSqrt(denom);

   //--- Harvey, Leybourne & Newbold (1997): S* = S * sqrt[(n+1-2h+h(h-1)/n)/n] -
   //--- the h(h-1) term is divided by n BEFORE being summed with (n+1-2h)
   double correction_numerator = (double)(n + 1 - 2 * horizon) +
                                     (double)(horizon * (horizon - 1)) / (double)n;

   //--- for a horizon large relative to n, correction_numerator can go negative -
   //--- that would hand MathSqrt() a negative argument and silently return NaN
   //--- straight into dm_hln, pvalue and verdict, so it must fail explicitly
   if(correction_numerator <= 0.0)
     {
       result.dm_stat  = dm_raw;
       result.hln_stat = 0.0;
       result.pvalue   = 1.0;
       result.verdict  = "INVALID_HORIZON";
       return(false);
     }

   double hln_factor = MathSqrt(correction_numerator / (double)n);
   double dm_hln = dm_raw * hln_factor;

   result.dm_stat  = dm_raw;
   result.hln_stat = dm_hln;

   //--- two-tailed p-value against Student-t(n-1), self-contained CDF above
   double cdf = DM_StudentCDF(MathAbs(dm_hln), (double)(n - 1));
   result.pvalue = 2.0 * (1.0 - cdf);

   if(result.pvalue > significance_alpha)
       result.verdict = "NO_SIGNIFICANT_DIFF";
   else
       result.verdict = (mean < 0.0) ? "A_BETTER" : "B_BETTER";   // d = L(A) - L(B); negative mean => A has lower loss

   return(true);
  }
В этой сигнатуре стоит обратить внимание на три момента. Слагаемое h(h-1) под квадратным корнем необходимо разделить на n до сложения с (n+1-2h): при неверном порядке операций ошибка незаметна при h=1 (где h(h-1)=0), но при более длинных горизонтах прогнозирования результат будет отклоняться от правильной поправки. Положительность correction_numerator не гарантируется: если горизонт велик относительно n, это значение может стать отрицательным. Тогда MathSqrt() получит отрицательный аргумент, а NaN незаметно попадет в hln_stat, pvalue и verdict. Явная проверка выше выявляет эту ситуацию и вместо этого возвращает INVALID_HORIZON. Кроме того, min_sample_size и significance_alpha — параметры, задаваемые в манифесте, а не жестко прописанные литералы. Это важно при тех размерах выборки, которые фактически дают несколько месяцев данных M5 при коротком скользящем окне: без поправки HLN вы будете слишком часто отвергать нулевую гипотезу и убеждать себя в наличии преимущества в точности прогнозирования, которого на самом деле нет.
Выбор функции потерь: квадрат ошибки или модуль ошибки
Для теста DM неважно, какую функцию потерь вы выберете, если для обеих моделей используется одна и та же функция: математические расчеты одинаковы и для квадрата ошибки, и для модуля ошибки, поскольку тест анализирует только разность потерь d_t (соответствующее ветвление находится в приведенной выше функции DM_LossDifferential()). На практике этот выбор все же важен. Квадрат ошибки придает непропорционально большой вес крупным промахам, что обычно подходит для логики определения размера позиции, поскольку редкий крайне неточный прогноз опаснее, чем немного большая средняя ошибка. Модуль ошибки придает одинаковый вес каждой единице ошибки, что подходит для логики, учитывающей только правильность прогнозируемого направления и не допускающей, чтобы несколько баров со всплесками волатильности определяли весь результат.
В манифесте этот выбор задается одним полем loss_type, а не константой, изменение которой требует перекомпиляции, поэтому можно повторно обработать одни и те же журналы ошибок с обеими функциями потерь и проверить, сохраняется ли вывод при смене функции. Если модель A выигрывает при использовании квадрата ошибки, но проигрывает при использовании модуля ошибки, противоречия нет: она выигрывает в среднем, но уступает по точности в типичных случаях — обычно потому, что лучше предсказывает редкие крупные движения цены и хуже — обычные.
Две конкретные прогнозные модели
Чтобы сделать тест наглядным, а не абстрактным, советник непрерывно сравнивает две прогнозные модели:
Модель A — регрессионная прогнозная модель в формате ONNX. Модель с 8 входными признаками, прогнозирующая изменение цены на следующем баре и экспортированная с помощью стандартного конвейера sklearn-to-ONNX: три лаговых изменения цены, нормализованных по ATR, отношение ATR к цене, масштабированный RSI, нормализованная по ATR гистограмма MACD, наклон EMA и логарифмированный реальный объем.
Модель B — базовая модель на основе наклона EMA. Наклон 20-периодной EMA напрямую используется как прогноз изменения цены на следующем баре — без машинного обучения. Это эталон, который более сложная модель должна действительно превзойти.
На закрытии бара t обе модели прогнозируют изменение цены, которое реализуется на баре t+1. Советник выжидает один бар, вычисляет обе ошибки прогноза по фактическим данным и добавляет их в два пополняемых массива истории, с которыми работают как статический тест DM, так и тест DM в скользящем окне. Советник и индикатор из раздела 8 вызывают одни и те же две приведенные ниже функции, а не используют каждый свою копию:
DM_BuildFeatureVector
//+------------------------------------------------------------------+
//| Shared 8-feature builder for the ONNX forecaster (Model A)       |
//| Used identically by the EA and the indicator so both ever run    |
//| the same model on the same feature contract - no separate,       |
//| drifting copy of this logic in each file.                        |
//+------------------------------------------------------------------+
bool DM_BuildFeatureVector(const string symbol, const int h_ema, const int h_atr,
                         const int h_rsi, const int h_macd, const int shift,
                         float &features[])
  {
   double close_arr[], atr_arr[], rsi_arr[], macd_main[], macd_signal[], ema_arr[];

   if(CopyClose(symbol, PERIOD_CURRENT, shift, 5, close_arr) < 5)
       return(false);
   if(CopyBuffer(h_atr, 0, shift, 2, atr_arr) < 2)
       return(false);
   if(CopyBuffer(h_rsi, 0, shift, 2, rsi_arr) < 2)
       return(false);
   if(CopyBuffer(h_macd, 0, shift, 2, macd_main) < 2)
       return(false);
   if(CopyBuffer(h_macd, 1, shift, 2, macd_signal) < 2)
       return(false);
   if(CopyBuffer(h_ema, 0, shift, 3, ema_arr) < 3)
       return(false);

   //--- volume_real, not tick_volume: falls back to tick volume only when
   //--- the broker feed genuinely has no real-volume data for this bar
   MqlRates rates[];
   if(CopyRates(symbol, PERIOD_CURRENT, shift, 2, rates) < 2)
       return(false);
   double vol_real = (rates[0].tick_volume > 0) ? (double)rates[0].tick_volume : 1.0;
   if(rates[0].real_volume > 0)
       vol_real = (double)rates[0].real_volume;

   double atr_now = MathMax(atr_arr[1], 1e-8);   // divide-by-zero guard

   ArrayResize(features, NUM_FEATURES);
   features[0] = (float)((close_arr[4] - close_arr[3]) / atr_now);   // return lag1, ATR-normalized
   features[1] = (float)((close_arr[3] - close_arr[2]) / atr_now);   // return lag2
   features[2] = (float)((close_arr[2] - close_arr[1]) / atr_now);   // return lag3
   features[3] = (float)(atr_now / close_arr[4]);            // ATR normalized by price
   features[4] = (float)(rsi_arr[1] / 100.0);             // RSI scaled 0-1
   features[5] = (float)((macd_main[1] - macd_signal[1]) / atr_now); // MACD histogram, ATR-normalized
   features[6] = (float)((ema_arr[2] - ema_arr[0]) / (2.0 * atr_now)); // EMA slope, ATR-normalized
   features[7] = (float)MathLog(1.0 + vol_real / 1000.0);       // log-scaled real volume

   //--- reject a feature vector carrying NaN/Inf before it ever reaches the
   //--- ONNX model - a bad upstream indicator tick is more useful as a
   //--- skipped bar than as silently-propagated garbage in the error history
   for(int i = 0; i < NUM_FEATURES; i++)
       if(!MathIsValidNumber(features[i]))
           return(false);

   return(true);
  }
Перед возвратом вектора каждый признак проверяется с помощью MathIsValidNumber(), поэтому при появлении значения NaN/Inf из-за некорректного тика, особого случая при делении или отсутствия данных на этапе прогрева ONNX бар пропускается, а история ошибок не искажается незаметно; такая же проверка применяется к выходному значению самой ONNX-модели в ForecastModelA().
DM_ForecastModelB
//+------------------------------------------------------------------+
//| Shared Model B forecast: raw EMA slope, used directly as the     |
//| next-bar return prediction (no ML, no rescaling) - this is the   |
//| deliberately simple momentum-continuation baseline               |
//+------------------------------------------------------------------+
double DM_ForecastModelB(const int h_ema, const int shift)
  {
   double ema_arr[];
   if(CopyBuffer(h_ema, 0, shift, 3, ema_arr) < 3)
       return(0.0);
   return((ema_arr[2] - ema_arr[0]) / 2.0);
  }
В модели B по-прежнему используется исходный наклон EMA без изменения масштаба: нормализация по ATR с последующим обратным умножением алгебраически ничего не изменила бы, лишь сопроводив то же самое число вводящим в заблуждение комментарием.
Самопроверка контракта признаков и подключение ONNX
Любому советнику на базе ONNX нужен такой же строгий подход: число признаков задается константой времени компиляции (NUM_FEATURES, определенной один раз в DMTest.mqh и общей для советника и индикатора), а в OnInit() советник формирует один вектор признаков по текущим данным и сверяет его размерность с этой константой. Если при последующих правках незаметно удалить или добавить признак, уже при запуске возникнет явная ошибка, а не ситуация, когда в течение нескольких недель модели передается вектор с несоответствующим набором признаков.
Функция формирования вектора признаков и вызов ONNX-модели для получения прогноза в советнике — это простые обертки над приведенными выше общими функциями:
BuildFeatureVector / ForecastModelA (DM_Test_EA.mq5)
//+------------------------------------------------------------------+
//| Build the 8-feature vector for the ONNX forecaster                |
//| Thin wrapper: the actual feature math lives in DM_BuildFeature-   |
//| Vector() in DMTest.mqh so the indicator uses the exact same       |
//| contract instead of a second, hand-copied version.                |
//+------------------------------------------------------------------+
bool BuildFeatureVector(const int shift, float &features[])
  {
   return(DM_BuildFeatureVector(_Symbol, g_h_ema, g_h_atr, g_h_rsi, g_h_macd, shift, features));
  }

//+------------------------------------------------------------------+
//| Model A forecast via ONNX                                        |
//+------------------------------------------------------------------+
double ForecastModelA(const int shift)
  {
   float features[];
   if(!BuildFeatureVector(shift, features))
       return(0.0);

   float input_data[1][NUM_FEATURES];
   for(int i = 0; i < NUM_FEATURES; i++)
       input_data[0][i] = features[i];

   float output_data[1][1];
   if(!OnnxRun(g_onnx_handle, ONNX_DEFAULT, input_data, output_data))
     {
       Print("DM_Test_EA: OnnxRun failed, error ", GetLastError());
       return(0.0);
     }
   if(!MathIsValidNumber(output_data[0][0]))
     {
       Print("DM_Test_EA: ONNX returned a non-finite value, treating as no forecast.");
       return(0.0);
     }
   return((double)output_data[0][0]);
  }
Самотестирование, проверяющее соблюдение этого контракта, при загрузке формирует один временный вектор признаков и сравнивает его размерность с объявленной константой. Если размерность вектора, формируемого BuildFeatureVector(), изменится, а константа не будет обновлена, эта проверка немедленно остановит советник, не дав ему торговать на основе некорректных данных:
SelfTestFeatureContract
//+------------------------------------------------------------------+
//| Feature-contract self-test: declared width vs actual output      |
//+------------------------------------------------------------------+
bool SelfTestFeatureContract()
  {
   float test_features[];
   if(!BuildFeatureVector(1, test_features))
     {
       Print("DM_Test_EA: SelfTest - could not build a sample feature vector yet (insufficient history).");
       return(true); // not fatal at chart-load, retried on first real bar
     }
   int actual_width = ArraySize(test_features);
   if(actual_width != NUM_FEATURES)
     {
       PrintFormat("DM_Test_EA: FATAL feature contract mismatch - declared NUM_FEATURES=%d, builder produced %d.",
               NUM_FEATURES, actual_width);
       return(false);
     }
   Print("DM_Test_EA: feature contract self-test passed (", NUM_FEATURES, " features).");
   return(true);
  }
Для самой ONNX-модели размерности входных и выходных данных с фиксированным размером пакета 1 задаются явно до первого вызова инференса, без опоры на метаданные о размерностях, объявленные в модели. Это выполняется внутри OnInit(), где также создаются четыре дескриптора индикаторов, необходимые функции формирования вектора признаков, и проводится описанное выше самотестирование:
OnInit (DM_Test_EA.mq5)
//+------------------------------------------------------------------+
//| Expert initialization                                            |
//+------------------------------------------------------------------+
int OnInit()
  {
   LoadManifest();

   g_h_ema  = iMA(_Symbol, PERIOD_CURRENT, InpEmaPeriod, 0, MODE_EMA, PRICE_CLOSE);
   g_h_atr  = iATR(_Symbol, PERIOD_CURRENT, InpAtrPeriod);
   g_h_rsi  = iRSI(_Symbol, PERIOD_CURRENT, InpRsiPeriod, PRICE_CLOSE);
   g_h_macd = iMACD(_Symbol, PERIOD_CURRENT, InpMacdFast, InpMacdSlow, InpMacdSignal, PRICE_CLOSE);

   if(g_h_ema == INVALID_HANDLE || g_h_atr == INVALID_HANDLE ||
     g_h_rsi == INVALID_HANDLE || g_h_macd == INVALID_HANDLE)
     {
       Print("DM_Test_EA: failed to create indicator handles.");
       return(INIT_FAILED);
     }

   //--- ONNX_COMMON_FOLDER: the Strategy Tester runs each EA inside its own
   //--- private per-agent MQL5\Files sandbox, not the live terminal's data
   //--- folder - loading from the shared Common\Files folder instead means
   //--- the model resolves the same whether this runs live or under a tester agent
   g_onnx_handle = OnnxCreate(InpOnnxModel, ONNX_COMMON_FOLDER);
   if(g_onnx_handle == INVALID_HANDLE)
     {
       PrintFormat("DM_Test_EA: failed to load ONNX model '%s', error %d.", InpOnnxModel, GetLastError());
       return(INIT_FAILED);
     }

   const long input_shape[]  = {1, NUM_FEATURES};
   const long output_shape[] = {1, 1};
   if(!OnnxSetInputShape(g_onnx_handle, 0, input_shape))
     {
       Print("DM_Test_EA: OnnxSetInputShape failed.");
       return(INIT_FAILED);
     }
   if(!OnnxSetOutputShape(g_onnx_handle, 0, output_shape))
     {
       Print("DM_Test_EA: OnnxSetOutputShape failed.");
       return(INIT_FAILED);
     }

   if(!SelfTestFeatureContract())
       return(INIT_FAILED);

   if(!g_canvas.CreateBitmapLabel("DM_Dashboard", 20, 20, 340, 110, COLOR_FORMAT_ARGB_NORMALIZE))
     {
       Print("DM_Test_EA: canvas creation failed.");
       return(INIT_FAILED);
     }

   ArrayResize(g_pred_a, 0);
   ArrayResize(g_pred_b, 0);
   ArrayResize(g_err_a, 0);
   ArrayResize(g_err_b, 0);
   ArrayResize(g_actual_ret, 0);

   DrawDashboard("Awaiting sample...", clrGray);
   return(INIT_SUCCEEDED);
  }
Для признака объема используется volume_real, а не тиковый объем. Переход к тиковому объему происходит только тогда, когда для бара действительно отсутствуют данные о реальном объеме.
Стоит отметить одну деталь: во время прогона советник не переобучает и не подгоняет заново ни одну из прогнозных моделей — веса ONNX-модели A фиксируются при экспорте, а параметры EMA модели B остаются неизменными. Это обязательное условие осмысленности теста DM: если позволить одной из моделей адаптироваться в ходе теста, в ряд разностей потерь будет внесен структурный разрыв, на учет которого HAC-оценка не рассчитана.
Тест в скользящем окне и информационная панель советника на графике
Однократный статический тест DM за весь период исторического тестирования показывает, была ли одна модель в среднем точнее другой на всем этом интервале, но скрывает смену режимов: модель A могла превосходить другую в первой половине периода, а затем ухудшить свои результаты. После закрытия каждого бара OnTick() добавляет фактические ошибки прогнозов обеих моделей в накапливаемую историю и каждые g_dash_refresh баров выполняет как тест на полной выборке, так и тест в скользящем окне, охватывающем только последние g_window баров:
OnTick (DM_Test_EA.mq5)
//+------------------------------------------------------------------+
//| Expert tick - process strictly on new bar close                  |
//+------------------------------------------------------------------+
void OnTick()
  {
   datetime cur_bar_time = iTime(_Symbol, PERIOD_CURRENT, 0);
   if(cur_bar_time == g_last_bar_time)
       return;
   g_last_bar_time = cur_bar_time;

   // shift=1 is the just-closed bar; we score its ALREADY-REALIZED outcome using
   // the forecast available for it back at shift=2 - a backward-looking pair for
   // the error history, kept separate from the live forecast used for trading below
   double predA = ForecastModelA(2);
   double predB = ForecastModelB(2);

   double close1[], close2[];
   if(CopyClose(_Symbol, PERIOD_CURRENT, 1, 1, close1) < 1) return;
   if(CopyClose(_Symbol, PERIOD_CURRENT, 2, 1, close2) < 1) return;
   double realized_ret = close1[0] - close2[0];

   double errA = realized_ret - predA;
   double errB = realized_ret - predB;

   int n = ArraySize(g_err_a);
   ArrayResize(g_pred_a, n + 1);     g_pred_a[n] = predA;
   ArrayResize(g_pred_b, n + 1);     g_pred_b[n] = predB;
   ArrayResize(g_err_a, n + 1);       g_err_a[n] = errA;
   ArrayResize(g_err_b, n + 1);       g_err_b[n] = errB;
   ArrayResize(g_actual_ret, n + 1);   g_actual_ret[n] = realized_ret;

   g_bars_since_refresh++;
   if(g_bars_since_refresh < g_dash_refresh)
       return;
   g_bars_since_refresh = 0;

   DM_RunTest(g_err_a, g_err_b, g_horizon, g_loss_type, g_static_result, g_min_sample, g_alpha);
   DM_RunRolling(g_err_a, g_err_b, g_window, g_horizon, g_loss_type, g_rolling_result, g_min_sample, g_alpha);

   string verdict_label = g_rolling_result.verdict;
   StringReplace(verdict_label, "_", " ");
   DrawDashboard(verdict_label, VerdictColor(g_rolling_result.verdict));

   // Trading uses a SEPARATE, live forecast for the bar still ahead (built from
   // shift=1, "as of the bar that just closed"), not the shift=2 forecast above -
   // that one scored a bar that already finished and is stale for a trade about
   // to be opened on the next one
   double liveA = ForecastModelA(1);
   double liveB = ForecastModelB(1);
   ManageTrading(liveA, liveB);
  }
Здесь формируются две пары прогнозов, а не одна: predA/predB при shift=2 используются для оценки ошибок на только что закрывшемся баре, пополнения истории ошибок и выполнения теста DM, а liveA/liveB при shift=1 — для получения новых прогнозов на предстоящий бар. Только последняя пара передается в ManageTrading(), поскольку торговля по устаревшей паре shift=2 означала бы принятие торговых решений для уже завершившегося бара. Сама ManageTrading() обеспечивает совершение реальных сделок: входы выполняются только при отсутствии открытой позиции и в направлении, указанном победившей моделью; SL/TP рассчитываются на основе ATR с учетом фактических ограничений брокера по минимальному расстоянию до стоп-уровней и марже; смена сигнала во время открытой сделки игнорируется. Полный листинг приведен в файле DM_Test_EA.mq5.
DM_RunRolling() — простая обертка над DM_RunTest(), выделяющая срез данных: она берет последние элементы массива истории и выполняет тот же тест только на этом окне, превращая единственное значение для полной выборки в показатель, позволяющий отслеживать смену режима:
DM_RunRolling
//+------------------------------------------------------------------+
//| Rolling-window wrapper: slices the tail of a vector-backed       |
//| history buffer and runs DM_RunTest on just that window           |
//+------------------------------------------------------------------+
bool DM_RunRolling(const double &errA_full[], const double &errB_full[], const int window,
              const int horizon, const ENUM_DM_LOSS loss_type, DMResult &result,
              const int min_sample_size = 30, const double significance_alpha = 0.10)
  {
   int total = MathMin(ArraySize(errA_full), ArraySize(errB_full));
   int start = MathMax(0, total - window);
   int len   = total - start;

   double slice_a[], slice_b[];
   ArrayResize(slice_a, len);
   ArrayResize(slice_b, len);
   for(int i = 0; i < len; i++)
     {
       slice_a[i] = errA_full[start + i];
       slice_b[i] = errB_full[start + i];
     }
   return(DM_RunTest(slice_a, slice_b, horizon, loss_type, result, min_sample_size, significance_alpha));
  }
По значению статистики критерия в скользящем окне обновляется небольшая информационная панель на базе CCanvas: зеленый цвет означает, что модель A статистически значимо лучше, красный — что статистически значимо лучше модель B, серый — что статистически значимых различий нет, а темно-серый — что выборка пока слишком мала для каких-либо выводов:
DrawDashboard / VerdictColor
//+------------------------------------------------------------------+
//| Draw the color-coded rolling verdict dashboard via CCanvas       |
//+------------------------------------------------------------------+
void DrawDashboard(const string verdict_text, const color bg_color)
  {
   g_canvas.Erase(ColorToARGB(bg_color, 220));
   g_canvas.FontSet("Consolas", -140, FW_BOLD);
   g_canvas.TextOut(10, 8, "DM Monitor: A (ONNX) vs B (EMA-slope)", ColorToARGB(clrWhite, 255));
   g_canvas.FontSet("Consolas", -120, FW_NORMAL);
   g_canvas.TextOut(10, 32, StringFormat("Static  DM=%.3f  HLN=%.3f  p=%.4f",
               g_static_result.dm_stat, g_static_result.hln_stat, g_static_result.pvalue),
               ColorToARGB(clrWhite, 255));
   g_canvas.TextOut(10, 52, StringFormat("Rolling DM=%.3f  HLN=%.3f  p=%.4f  n=%d",
               g_rolling_result.dm_stat, g_rolling_result.hln_stat, g_rolling_result.pvalue, g_rolling_result.n),
               ColorToARGB(clrWhite, 255));
   g_canvas.FontSet("Consolas", -150, FW_BOLD);
   g_canvas.TextOut(10, 80, "Verdict: " + verdict_text, ColorToARGB(clrWhite, 255));
   g_canvas.Update();
  }

color VerdictColor(const string verdict)
  {
   if(verdict == "A_BETTER")
       return(clrForestGreen);
   if(verdict == "B_BETTER")
       return(clrFireBrick);
   if(verdict == "INSUFFICIENT_SAMPLE")
       return(clrDarkSlateGray);
   return(clrSlateGray); // NO_SIGNIFICANT_DIFF
  }
Все эти параметры — горизонт прогнозирования, скользящее окно, функция потерь, уровень значимости alpha и частота обновления информационной панели — считываются из dm_manifest.json в OnInit() простым поиском пар "ключ:значение", без внешних DLL или библиотек JSON, поэтому один и тот же скомпилированный исполняемый файл можно перенастраивать без перекомпиляции:
LoadManifest / LoadManifestValue
//+------------------------------------------------------------------+
//| Manifest loader - simple key:value JSON scan, no external DLL    |
//+------------------------------------------------------------------+
bool LoadManifestValue(const string &raw, const string key, string &value_out)
  {
   int pos = StringFind(raw, "\"" + key + "\"");
   if(pos < 0)
       return(false);
   int colon = StringFind(raw, ":", pos);
   int comma = StringFind(raw, ",", colon);
   int brace = StringFind(raw, "}", colon);
   int end = (comma >= 0 && (comma < brace || brace < 0)) ? comma : brace;
   if(colon < 0 || end < 0)
       return(false);
   string v = StringSubstr(raw, colon + 1, end - colon - 1);
   StringReplace(v, "\"", "");
   StringReplace(v, " ", "");
   StringReplace(v, "\n", "");
   StringReplace(v, "\r", "");
   value_out = v;
   return(true);
  }

void LoadManifest()
  {
   g_horizon       = InpHorizon;
   g_window        = InpRollingWindow;
   g_min_sample   = InpMinSample;
   g_alpha         = InpSignificanceAlpha;
   g_loss_type    = InpLossType;
   g_dash_refresh = InpDashboardRefresh;

   int fh = FileOpen(InpManifestFile, FILE_READ | FILE_TXT | FILE_ANSI | FILE_COMMON);
   if(fh == INVALID_HANDLE)
       fh = FileOpen(InpManifestFile, FILE_READ | FILE_TXT | FILE_ANSI);
   if(fh == INVALID_HANDLE)
     {
       PrintFormat("DM_Test_EA: manifest not found (%s), using input defaults.", InpManifestFile);
       return;
     }

   string raw = "";
   while(!FileIsEnding(fh))
       raw += FileReadString(fh) + "\n";
   FileClose(fh);

   string v;
   if(LoadManifestValue(raw, "forecast_horizon_h", v))    g_horizon       = (int)StringToInteger(v);
   if(LoadManifestValue(raw, "rolling_window_bars", v))   g_window        = (int)StringToInteger(v);
   if(LoadManifestValue(raw, "min_sample_size", v))      g_min_sample   = (int)StringToInteger(v);
   if(LoadManifestValue(raw, "significance_alpha", v))   g_alpha        = StringToDouble(v);
   if(LoadManifestValue(raw, "dashboard_refresh_bars", v)) g_dash_refresh = (int)StringToInteger(v);
   if(LoadManifestValue(raw, "loss_type", v))
       g_loss_type = (v == "ABSOLUTE") ? DM_LOSS_ABSOLUTE : DM_LOSS_SQUARED;

   PrintFormat("DM_Test_EA: manifest loaded - h=%d window=%d min_n=%d loss=%s",
             g_horizon, g_window, g_min_sample, (g_loss_type == DM_LOSS_SQUARED ? "SQUARED" : "ABSOLUTE"));
  }
Считываются поля forecast_horizon_h, rolling_window_bars, min_sample_size, significance_alpha, loss_type (SQUARED или ABSOLUTE) и dashboard_refresh_bars (только для советника); в манифесте также указаны настройки периодов, с которыми создавалась модель, но они носят исключительно справочный характер — загрузчик не применяет их к периодам, используемым при работе программы. Для любого отсутствующего или нераспознанного поля без отдельного предупреждения используется значение по умолчанию из входных параметров самого советника, поэтому опечатка в конфигурации не приведет к сбою советника, но он может незаметно продолжить работу со значениями по умолчанию вместо задуманных вами настроек.
Индикатор в подокне: настоящий пересчет в скользящем окне
DM_RollingMonitor.mq5 отображает статистику DM с поправкой HLN, рассчитанную в скользящем окне, в виде линии в отдельном подокне вместе с границами критических значений для двустороннего теста, позволяя сразу увидеть всю историю сравнения, а не только одно текущее значение на информационной панели. Работая как отдельный процесс, индикатор не может читать массивы ошибок из памяти советника, поэтому самостоятельно восстанавливает историю ошибок обеих прогнозных моделей, используя собственные дескрипторы ONNX и индикаторов с теми же настройками периодов и тем же файлом dm_manifest.json, что и советник:
OnInit (DM_RollingMonitor.mq5)
int OnInit()
  {
   LoadManifest();

   SetIndexBuffer(0, BufDM, INDICATOR_DATA);
   SetIndexBuffer(1, BufUpperCrit, INDICATOR_DATA);
   SetIndexBuffer(2, BufLowerCrit, INDICATOR_DATA);
   //--- deliberately not series: OnCalculate() below walks forward,
   //--- index-aligned with the non-series time[]/close[] arrays

   g_h_ema  = iMA(_Symbol, PERIOD_CURRENT, InpEmaPeriod, 0, MODE_EMA, PRICE_CLOSE);
   g_h_atr  = iATR(_Symbol, PERIOD_CURRENT, InpAtrPeriod);
   g_h_rsi  = iRSI(_Symbol, PERIOD_CURRENT, InpRsiPeriod, PRICE_CLOSE);
   g_h_macd = iMACD(_Symbol, PERIOD_CURRENT, InpMacdFast, InpMacdSlow, InpMacdSignal, PRICE_CLOSE);

   if(g_h_ema == INVALID_HANDLE || g_h_atr == INVALID_HANDLE ||
     g_h_rsi == INVALID_HANDLE || g_h_macd == INVALID_HANDLE)
     {
       Print("DM_RollingMonitor: failed to create indicator handles.");
       return(INIT_FAILED);
     }

   //--- ONNX_COMMON_FOLDER: same reasoning as DM_Test_EA.mq5 - this indicator
   //--- also runs inside a tester-agent sandbox with its own private
   //--- MQL5\Files, so the model has to come from the shared Common folder
   g_onnx_handle = OnnxCreate(InpOnnxModel, ONNX_COMMON_FOLDER);
   if(g_onnx_handle == INVALID_HANDLE)
     {
       PrintFormat("DM_RollingMonitor: ONNX model load failed, error %d.", GetLastError());
       return(INIT_FAILED);
     }

   const long input_shape[]  = {1, NUM_FEATURES};
   const long output_shape[] = {1, 1};
   if(!OnnxSetInputShape(g_onnx_handle, 0, input_shape) ||
     !OnnxSetOutputShape(g_onnx_handle, 0, output_shape))
     {
       Print("DM_RollingMonitor: failed to set ONNX input/output shape.");
       return(INIT_FAILED);
     }

   IndicatorSetString(INDICATOR_SHORTNAME, "DM Rolling Monitor");
   return(INIT_SUCCEEDED);
  }
OnCalculate() последовательно обрабатывает бары, добавляя новые результаты к уже рассчитанным: prev_calculated указывает, сколько баров уже обработано, поэтому при обычном тике обрабатываются только один или два последних бара. Для каждого нового бара индикатор вычисляет ошибки обеих прогнозных моделей, сохраняет их в постоянном массиве, доступном между вызовами. Как только наберется g_window баров, он вызывает DM_RunTest() для окна последних наблюдений, заканчивающегося этим баром:
OnCalculate (DM_RollingMonitor.mq5)
//+------------------------------------------------------------------+
//| Indicator recalculation                                           |
//| Walks forward over newly-formed bars only (incremental via        |
//| prev_calculated), builds both forecasters' per-bar error, then    |
//| runs a real DM_RunTest() over the trailing g_window bars ending   |
//| at each one.                                                       |
//+------------------------------------------------------------------+
int OnCalculate(const int rates_total, const int prev_calculated, const datetime &time[],
          const double &open[], const double &high[], const double &low[], const double &close[],
          const long &tick_volume[], const long &volume[], const int &spread[])
  {
   //--- headroom: BuildFeatureVector needs up to 5 closes / 3 EMA points
   //--- behind whichever bar it is building for
   const int warmup = 10;
   if(rates_total < g_window + warmup)
       return(0);

   ArrayResize(g_err_a, rates_total);
   ArrayResize(g_err_b, rates_total);
   ArrayResize(BufDM, rates_total);
   ArrayResize(BufUpperCrit, rates_total);
   ArrayResize(BufLowerCrit, rates_total);

   int start = (prev_calculated > 1) ? prev_calculated - 1 : warmup;
   start = MathMax(start, 1);

   //--- stop one bar short of rates_total: the last bar is still forming
   for(int i = start; i < rates_total - 1; i++)
     {
       //--- forecast for bar i was made using data as of bar i-1; CopyBuffer's
       //--- "shift" counts bars back from the current live bar, so the
       //--- build-shift for bar (i-1) is (rates_total - i)
       int shift_predict = rates_total - i;

       double predA = ForecastModelA(shift_predict);
       double predB = DM_ForecastModelB(g_h_ema, shift_predict);
       double realized = close[i] - close[i - 1];

       g_err_a[i] = realized - predA;
       g_err_b[i] = realized - predB;

       if(i < g_window + warmup)
         {
           BufDM[i]        = EMPTY_VALUE;
           BufUpperCrit[i] = EMPTY_VALUE;
           BufLowerCrit[i] = EMPTY_VALUE;
           continue;
         }

       int win_start = i - g_window + 1;
       int win_len   = g_window;
       double slice_a[], slice_b[];
       ArrayResize(slice_a, win_len);
       ArrayResize(slice_b, win_len);
       for(int k = 0; k < win_len; k++)
         {
           slice_a[k] = g_err_a[win_start + k];
           slice_b[k] = g_err_b[win_start + k];
         }

       DMResult res;
       bool ok = DM_RunTest(slice_a, slice_b, g_horizon, g_loss_type, res, g_min_sample, g_alpha);

       //--- only plot the critical bands for a result DM_RunTest stands behind -
       //--- INSUFFICIENT_SAMPLE/INVALID_HORIZON/INVALID_VARIANCE all leave
       //--- hln_stat at 0.0, which is not a genuine "no difference" reading
       if(!ok)
         {
           BufDM[i]        = EMPTY_VALUE;
           BufUpperCrit[i] = EMPTY_VALUE;
           BufLowerCrit[i] = EMPTY_VALUE;
         continue;
         }

       //--- degrees of freedom must track the sample size DM_RunTest() actually
       //--- used (res.n), not the requested window length - they're equal today
       //--- because the slice above is always built to exactly win_len, but this
       //--- removes the dependency on that staying true if slicing ever changes
       double crit     = CriticalTValue(res.n - 1, g_alpha);
       BufDM[i]        = res.hln_stat;
       BufUpperCrit[i] = crit;
       BufLowerCrit[i] = -crit;
     }

   return(rates_total - 1);
  }
Границы критических значений рассчитываются с помощью собственной функции квантилей распределения Стьюдента с учетом числа степеней свободы каждого окна:
CriticalTValue
//+------------------------------------------------------------------+
//| Two-tailed Student-t critical value at the given alpha            |
//+------------------------------------------------------------------+
double CriticalTValue(const int df, const double alpha)
  {
   return(DM_StudentQuantile(1.0 - alpha / 2.0, (double)MathMax(df, 1)));
  }
Стоит упомянуть два заманчивых, но неверных упрощения: кэширование одного значения статистики DM и его повторение на каждом баре (это дает горизонтальную линию и лишает смысла мониторинг в скользящем окне), а также подмена исторического прогноза модели A наклоном модели B, умноженным на коэффициент, вместо выполнения настоящего инференса ONNX. В приведенной выше реализации нет ни одного из этих упрощений: для каждого бара заново рассчитывается статистика DM и выполняется настоящий вызов ONNX, идентичный вызову в советнике. На рис. 3 показан результат в режиме реального времени на графике XAUUSD M5.
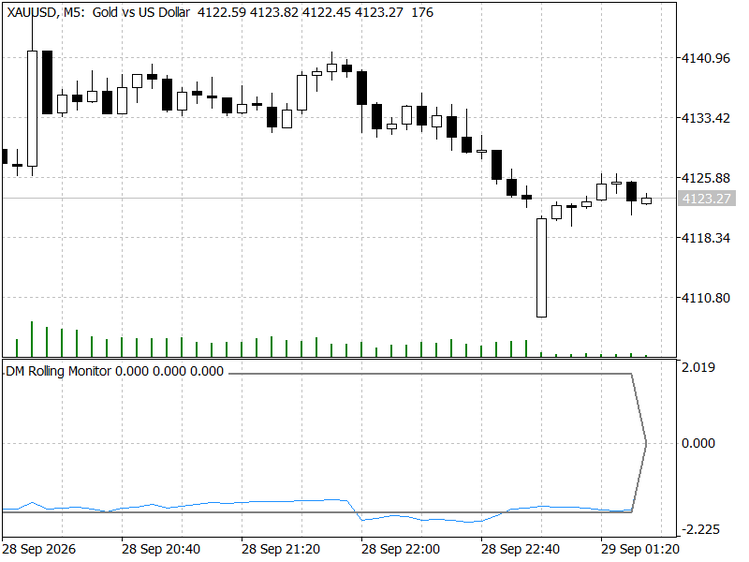
Рис. 3. DM_RollingMonitor в режиме реального времени на XAUUSD M5: статистика DM с поправкой HLN, рассчитанная в скользящем окне (синяя линия), меняется от бара к бару на фоне границ критических значений для двустороннего теста (серые пунктирные линии), а не остается на одном постоянном уровне.
Стоит учитывать один компромисс: при первом проходе расчета для каждого исторического бара выполняется один инференс ONNX, поэтому первоначальная загрузка на данных M5 за несколько лет заметно медленнее, чем у обычного индикатора, — перед появлением линии будет ощутимая пауза. При инкрементальном пересчете в режиме реального времени обрабатываются только один или два последних бара, поэтому эти затраты возникают лишь один раз.
Пограничные случаи и возможные проблемы
Некоторые моменты могут вызвать ошибки, если не обработать их явно, поэтому в реализации предусмотрены меры защиты для каждого из них, чтобы избежать "тихого" сбоя:
Несоответствие масштабов рядов потерь. Если модели A и B выдают прогнозы в разных единицах измерения, разность потерь отражает сравнение несопоставимых величин еще до этапа расчета HAC-оценки. В реализации прогнозы обеих моделей приводятся к одним и тем же единицам измерения изменения цены уже на этапе прогнозирования, а не при расчете потерь, поэтому эта проблема не может возникнуть незаметно.
Вырождение горизонта прогнозирования при h = 1. При h = 1 лаговое окно HAC имеет нулевую длину, и HAC-оценка сводится к обычной выборочной дисперсии — это корректное поведение, а не ошибка, как поясняется в разделе 3.
Близкая к нулю дисперсия в знаменателе. Почти идентичные (или случайно продублированные) прогнозные модели могут привести к тому, что HAC-оценка дисперсии приблизится к нулю, а модуль статистики критерия резко возрастет из-за деления на столь малую величину. Код сравнивает знаменатель с малой величиной эпсилон и сразу возвращает результат "статистически значимых различий нет", вместо того чтобы передавать в дальнейшие расчеты почти бесконечное значение статистики критерия.
Недостаточный размер выборки. Если число наблюдений меньше примерно 30, тест теряет статистическую обоснованность, поэтому реализация явно возвращает результат теста "INSUFFICIENT_SAMPLE" вместо значения статистики критерия, которое лишь выглядит точным.
Для модели ONNX — папка Common\Files, а не MQL5\Files. Тестер стратегий выполняет каждый прогон в собственной изолированной среде: модель, размещенная только в папке терминала, загружается при работе в реальном времени, но не загружается в тестере. Функция OnnxCreate() использует ONNX_COMMON_FOLDER, поэтому файлы dm_forecaster.onnx и dm_manifest.json следует поместить в общую папку Common\Files\DMTest\.
Вычислительные затраты на пересчет индикатора. При первоначальной загрузке DM_RollingMonitor.mq5 выполняет один инференс ONNX-модели на каждый исторический бар — на многолетней истории это существенная вычислительная работа, а не зависание (см. раздел 8).
Сравнения между торговыми инструментами. Повторное использование этого теста для сравнения точности одной модели на разных инструментах математически возможно, но сопряжено с большим статистическим риском, поскольку структура автокорреляции различается в разных режимах волатильности и торговых сессиях. Рассматривайте это как отдельную процедуру калибровки, а не как простое повторное использование тех же настроек.
Проверка в тестере стратегий
Результат теста, который никто не использует, мало чего стоит, поэтому DM_Test_EA торгует по собственному сигналу: при A_BETTER или B_BETTER советник открывает позицию в направлении прогноза соответствующей модели с фиксированным объемом 0,01 лота и SL/TP на расстоянии 1,5 и 2 ATR соответственно, с учетом фактических ограничений брокера по минимальному лоту, марже и минимальному расстоянию до стоп-уровней. При NO_SIGNIFICANT_DIFF советник остается вне рынка. Это позволяет получить реальные результаты по числу сделок и просадке, а не только статистику в журнале. Запустите советник в режиме визуализации с фиксированным вневыборочным интервалом и без повторной подгонки в ходе тестирования.
| Настройка | Значение |
|---|---|
| Символ/Период | XAUUSD / M5 |
| Горизонт прогнозирования (h) | 1 бар |
| Функция потерь | Квадрат ошибки |
| Скользящее окно | 250 баров |
| Минимальный размер выборки | 30 баров |
| Уровень значимости (альфа) | 0,10, двусторонний тест |
| Обновление информационной панели | Каждые 5 баров |
На рис. 4 представлен снимок экрана реального запуска в режиме визуализации с этой конфигурацией: все 48 047 баров M5 обработаны без единой ошибки. Статический расчет DM/HLN и расчет в скользящем окне указывают на одно и то же преимущество: обе статистики отрицательны, и в обоих случаях результат теста — A_BETTER. При этом значения статистик различаются: −3,566 при статическом расчете и −2,085 при расчете в скользящем окне, поскольку последний учитывает только 250 последних баров. От модели-заглушки, у которой изначально нет преимущества, полученного за счет подгонки, следует ожидать именно совпадения по направлению, а не по величине.
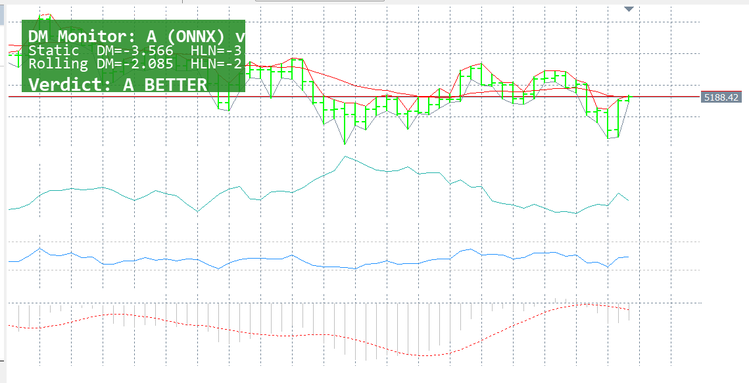
Рис. 4. DM_Test_EA с указанной выше конфигурацией в режиме визуализации на XAUUSD M5: информационная панель на графике показывает статистики DM/HLN и результаты теста для статического расчета и расчета в скользящем окне, а рядом отображаются индикаторы ATR(14), RSI(14) и MACD(12,26,9), значения которых используются при формировании вектора признаков.
Полный набор значений n/HLN/p для этого прогона не попал в приведенный ниже фрагмент журнала, поэтому строка M5 в расположенной далее таблице проверки устойчивости содержит только два значения DM, а ячейки с отсутствующими данными оставлены пустыми, без вымышленных значений. Строки M15 и H1, данные для которых взяты из итоговой строки OnDeinit, содержат полный набор показателей; именно их следует рассматривать как свидетельства, полностью подкрепленные количественными данными.
Журнал полного сквозного прогона с этой конфигурацией служит независимым подтверждением того, что прогон прошел без ошибок. "final balance 10000.00" — это строка тестера, отражающая начальный депозит, а не конечный баланс; фактический результат приведен в строке XAUUSD M5 расположенной далее таблицы торговых результатов (чистая прибыль 86,84, конечный баланс примерно 10 086,84):
2026.01.01 00:00:00   DM_Test_EA: manifest loaded - h=1 window=250 min_n=30 loss=SQUARED
2026.01.01 00:00:00   ONNX: CPU selected
final balance 10000.00
XAUUSD,M5: 114028266 ticks, 48047 bars generated. Environment synchronized in 0:00:00.114. Test passed in 0:12:55.568 (including ti...
XAUUSD,M5: total time from login to stop testing 0:12:55.682 (including 0:00:00.114 for history data synchronization)
test Experts\DMTest\DM_Test_EA.ex5 on XAUUSD,M5 thread finished
shutdown finished
Ни ошибок в OnInit, ни ошибок загрузки ONNX, ни аварийных завершений во время выполнения — прогон прошел без сбоев. Однако это ничего не говорит о содержательной значимости результата статистического теста или торгового результата; далее в этом разделе они рассматриваются на основе фактических числовых данных.
Проверка устойчивости на нескольких инструментах и таймфреймах
Один прогон на M5 без сбоев доказывает лишь то, что код не завершается аварийно, но не то, что преимущество в точности прогнозирования действительно существует. Советник запускался на пяти сочетаниях инструмента и таймфрейма: трех для XAUUSD — инструмента, ценовую динамику которого имитируют синтетические обучающие данные для dm_forecaster.onnx (это модель-заглушка, не обученная на реальной истории XAUUSD; см. таблицу файлов в конце), — и двух для валютных пар, с которыми модель ранее не сталкивалась.
В пределах исходной области (XAUUSD, разные таймфреймы) — сохраняется ли преимущество в точности прогнозирования на разных горизонтах или же оно обусловлено лишь одной длительностью бара:
| Таймфрейм | Статический расчет: n / DM / HLN / p | Расчет в скользящем окне: n / DM / HLN / p | Результат теста (статический расчет / расчет в скользящем окне) |
|---|---|---|---|
| M5* | - / -3,566 / - / - | - / -2,085 / - / - | A_BETTER / A_BETTER |
| M15 | 15230 / -4,678 / -4,678 / 0,0000 | 250 / -1,256 / -1,254 / 0,2111 | A_BETTER / NO_SIGNIFICANT_DIFF |
| H1 | 3810 / -2,836 / -2,836 / 0,0046 | 250 / -0,743 / -0,741 / 0,4593 | A_BETTER / NO_SIGNIFICANT_DIFF |
*Значения n, HLN и p для M5 не попали в приведенный фрагмент журнала этого прогона — указаны только значения DM, считанные со скриншота информационной панели. Именно строки M15 и H1 следует рассматривать как результаты с полным набором количественных показателей.
За пределами исходной области — тот же советник и тот же дескриптор ONNX без изменений использовались для EURUSD и GBPUSD:
| Символ / Таймфрейм | Статический расчет: n / DM / HLN / p | Расчет в скользящем окне: n / DM / HLN / p | Результат теста (статический расчет / расчет в скользящем окне) |
|---|---|---|---|
| EURUSD H1 | 4125 / 54,353 / 54,346 / 0,0000 | 250 / 12,022 / 11,998 / 0,0000 | B_BETTER / B_BETTER |
| GBPUSD M5 | 49470 / 167,510 / 167,509 / 0,0000 | 250 / 21,688 / 21,644 / 0,0000 | B_BETTER / B_BETTER |
На XAUUSD статический тест выявляет статистически значимое преимущество модели A в точности прогнозирования на всех таймфреймах, причем с увеличением таймфрейма оно ослабевает: p-значение растет от практически нулевого на M15 до 0,0046 на H1, что согласуется с уменьшением объема выборки, а не с изменением рынка. Еще показательнее то, что тест в скользящем окне из 250 баров дает результат NO_SIGNIFICANT_DIFF и на M15, и на H1: преимущество в точности прогнозирования, выявляемое на девятимесячной выборке баров M15, не видно на последних 250 барах, и это означает, что скользящий тест выполняет свою задачу, а не содержит ошибку.
Внимательно интерпретируйте численные результаты, полученные за пределами исходной области. Статистика критерия DM на реальных рыночных данных почти всегда находится в диапазоне 1–5; на EURUSD H1 и GBPUSD M5 получены значения 54 и 167 соответственно — настолько большие, что корректнее интерпретировать их как признак несоответствия масштабов, а не как более убедительный результат. ONNX-модель A была обучена офлайн с учетом масштаба изменений цены XAUUSD в долларах за бар и сохраняет этот масштаб независимо от инструмента, тогда как наклон EMA модели B пересчитывается в реальном времени в собственных единицах каждого инструмента; при применении к EURUSD или GBPUSD квадрат ошибки модели A многократно превышает квадрат ошибки модели B еще до того, как прогнозы направления любой из моделей приобретают содержательный смысл. Так на практике проявляется описанная в разделе 9 проблема переноса на другие инструменты: результат B_BETTER при DM=54 или 167 означает, что масштаб прогнозов одной из моделей плохо откалиброван для данного инструмента, а не то, что модель B действительно прогнозирует точнее модели A.
В совокупности результаты показывают умеренное, зависящее от таймфрейма преимущество в точности прогнозирования на инструменте, для которого создавалась эта модель, и немедленный сбой, корректно выявляемый тестом, как только любую из прогнозных моделей применяют к другому инструменту. В ходе тех же пяти прогонов также были получены фактическое число сделок, доля прибыльных сделок и величина просадки.
| Символ / Таймфрейм | Сделки | Чистая прибыль | Профит-фактор | Коэффициент Шарпа | Максимальная просадка |
|---|---|---|---|---|---|
| XAUUSD M5 (в пределах исходной области) | 1083 | 86,84 | 1,01 | 0,47 | 4,91% |
| XAUUSD M15 (в пределах исходной области) | 319 | -717,54 | 0,81 | -4,18 | 8,97% |
| XAUUSD H1 (в пределах исходной области) | 121 | 221,91 | 1,11 | 1,42 | 3,58% |
| EURUSD H1 (за пределами исходной области) | 332 | -45,17 | 0,89 | -1,31 | 0,88% |
| GBPUSD M5 (за пределами исходной области) | 4273 | -446,13 | 0,78 | -5,00 | 4,52% |
Всего 6 128 сделок, и закономерность, выявленная тестом DM, проявляется и в денежных результатах: оба прогона за пределами исходной области убыточны (отрицательный коэффициент Шарпа, профит-фактор ниже 1), тогда как результаты в пределах исходной области действительно неоднозначны — M5 и H1 дают небольшую прибыль, а M15 приносит явный убыток. Стоит отметить: все 121 сделка на H1 и 315 из 319 сделок на M15 были короткими — это скорее постоянная склонность торговать в одном направлении, чем умение учитывать контекст; на нисходящих движениях H1 она приносила прибыль, а на M15 обернулась убытками из-за движения цены в противоположную сторону. Надежного преимущества нет, результаты за пределами исходной области устойчиво плохие, а результат в пределах исходной области обусловлен скорее постоянной склонностью к коротким позициям при благоприятных условиях, чем адаптивным прогнозированием.
Сама по себе доля прибыльных сделок не говорит о том, был ли прогон прибыльным, — об этом судят по профит-фактору, приведенному выше, — но она показывает, насколько выбор направления торговли отличается по успешности от подбрасывания монеты. На рис. 5 показана доля прибыльных сделок для каждого из пяти прогонов.
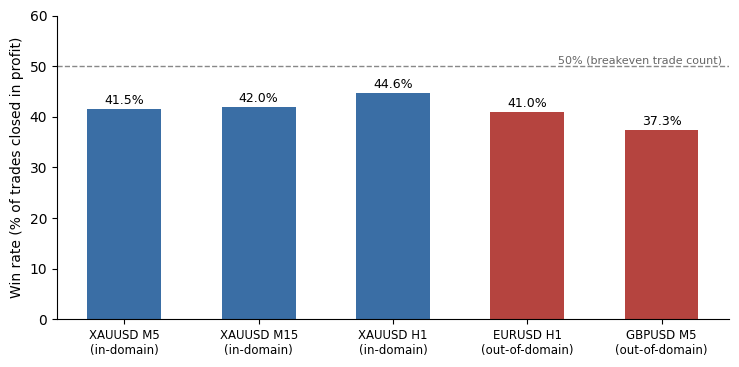
Рис. 5. Доля прибыльных сделок по инструментам и таймфреймам в пяти фактически выполненных прогонах в тестере стратегий. Во всех пяти случаях доля прибыльных сделок ниже 50% — как в пределах исходной области, так и за ее пределами; преимущество, если оно вообще есть, обеспечивается соотношением размеров прибыли и убытка (профит-фактором), а не тем, что верных решений больше, чем ошибочных.
В этом и заключается ценность непрерывного теста в скользящем окне по сравнению с разовым статистическим показателем бэктеста: он позволяет в реальном времени оценивать, стоит ли по-прежнему доверять модели A больше, чем модели B, а не просто узнать, какая из них победила в последнем бэктесте. Есть одна оговорка: информационная панель повторяет этот расчет каждые g_dash_refresh баров по окну длиной 250 баров, которое в основном перекрывается с окном, использованным пять баров назад, поэтому последовательные p-значения не являются независимыми наблюдениями; alpha=0.10 задает вероятность ложноположительного результата для одного теста, а не для многонедельного наблюдения за сменой цвета информационной панели. Рассматривайте отдельный результат теста в скользящем окне как моментальный срез, а не как независимое подтверждение.
Как интерпретировать p-значение с точки зрения трейдера, а не статистика
p-значение 0,03 в скользящем окне не означает ни превосходства в будущем, ни прибыльности после учета издержек: оно лишь количественно характеризует, насколько маловероятна наблюдаемая разность потерь при нулевой гипотезе о равенстве ожидаемых потерь; это характеристика статистических свидетельств в текущем окне, а не прогноз.
Поэтому воспринимайте зеленый, красный или серый сигнал информационной панели как один из нескольких факторов при принятии решения, а не как автоматическую команду к действию. Модель может быть статистически значимо лучше, но величина эффекта при этом может быть слишком мала, чтобы покрыть издержки; следите за mean_diff в структуре DMResult наряду с p-значением, поскольку зеленый результат теста при крошечном mean_diff — совсем иной сигнал, чем при большом значении этого показателя.
От попарного сравнения к сравнению множества моделей: переход к матрице DM
Во всех рассмотренных примерах сравниваются ровно две прогнозные модели — подходящий объем для одной статьи, но реальный рабочий процесс редко этим ограничивается: у большинства торговых подразделений накапливается три, пять, а то и дюжина моделей-кандидатов. Естественное продолжение — полная матрица попарных сравнений DM: выполнить DM_RunTest() для каждой пары и собрать матрицу размером N × N со статистиками критерия и p-значениями; она сразу покажет группы статистически неразличимых моделей и модели, действительно выделяющиеся на их фоне.
При таком переходе меняются два момента. Множество попарных тестов вновь порождает проблему множественных сравнений: при уровне значимости 10% проверка 10 пар дает примерно один ложноположительный результат по чистой случайности, поэтому требуется поправка, например контроль доли ложных открытий по методу Бенджамини–Хохберга. Кроме того, лаговую структуру HAC-оценки следует заново проверять для каждой пары, а не считать постоянной, поскольку разные архитектуры порождают разную автокорреляцию на одном и том же инструменте. Реализация в DMTest.mqh уже принимает любые два массива ошибок и горизонт прогнозирования, не предполагая, что нужно выполнить лишь одно сравнение.
Ограничения и то, чего это не доказывает
Вот несколько выводов, которых нельзя сделать на основании этой статьи и приведенных в ней численных результатов; об этих ограничениях стоит сказать прямо, а не обходить их стороной:
Пять прогонов — это выборочная проверка устойчивости, а не исследование устойчивости. Три таймфрейма XAUUSD и две пары за пределами исходной области — недостаточно большая и недостаточно рандомизированная выборка, чтобы утверждать, что закономерность распространяется за пределы этих пяти конкретных комбинаций.
Статистическая значимость — это не то же самое, что прибыльность торговли. Даже при результате теста A_BETTER торговля на XAUUSD M15 оставалась убыточной (профит-фактор 0,81): статистически значимо меньшие потери прогнозирования и прибыльность торговой системы — разные утверждения, а спред, проскальзывание и выбор размера позиции находятся за пределами того, что измеряет тест.
Фиксированный порог epsilon = 1e-12 для дисперсии в знаменателе не инвариантен к масштабу. Этот порог подобран для используемых в статье изменений цены XAUUSD/EURUSD/GBPUSD в исходных единицах; при переносе реализации на существенно иной ценовой диапазон измените его масштаб, иначе он может оказаться слишком мягким или слишком строгим.
Интервал поиска методом бисекции в DM_StudentQuantile() жестко задан как [-100, 100]. Ни эта функция, ни DM_RunTest() не проверяют, лежат ли df и alpha в области, для которой такой интервал достаточно широк, поэтому при экстремальных входных значениях, выходящих за рамки обычных значений из манифеста, функция может без сообщения об ошибке вернуть квантиль, ограниченный границей интервала.
Сверка с scipy — это несколько выборочных проверок, а не набор тестов. Скрипт dm_test_verify.py подтверждает совпадение результатов с scipy лишь для тех случаев, на которых его запускали; проверка не автоматизирована и не обеспечивает покрытия регрессионными тестами ни вычислений для распределения Стьюдента, ни самой статистики DM.
Отсутствие ошибок в журнале подтверждает выполнение кода, но не правильность его результатов. Описанный выше прогон на 48 047 барах без ошибок демонстрирует стабильность работы — реальный результат, который, однако, сам по себе не подтверждает статистическую корректность или обоснованность торгового применения.
Заключение
Математика теста Диболда–Мариано несложна, однако в большинстве упрощенных реализаций отсутствуют именно детали, обеспечивающие его надежность: HAC-оценка дисперсии вместо обычной выборочной дисперсии и поправка HLN для малых выборок вместо упрощения на основе нормального распределения. Если их пропустить, тест станет не быстрее, а некорректнее: он будет показывать значимость там, где есть лишь общая подверженность волатильности, а его статистика будет рассчитана на объем выборки, которого у вас нет.
Встраивание теста в информационную панель с расчетом в скользящем окне и обновлением в реальном времени превращает его из любопытного исследовательского инструмента в средство проверки перед изменением доли капитала, выделяемой модели. Проверка торговых результатов в пяти прогонах — другая сторона вопроса: статистически значимый результат теста DM и действительно прибыльная последовательность сделок — не одно и то же; результаты в пределах исходной области были неоднозначными, а за пределами исходной области торговля оказалась убыточной. Логичный следующий шаг — передавать результат теста в скользящем окне в модуль распределения капитала, например в селектор на основе Thompson Sampling или LinUCB, который перераспределяет веса в пользу прогнозной модели, побеждающей в данный момент, вместо ручного анализа информационной панели.
| Файл | Тип | Описание |
|---|---|---|
| DMTest.mqh | Подключаемый файл | Основная библиотека математических расчетов для теста Диболда–Мариано: разность потерь, HAC-оценка дисперсии с ядром Бартлетта, поправка HLN, p-значение на основе распределения Стьюдента, а также общий модуль формирования признаков и расчет прогноза модели B, используемые одинаковым образом в советнике и индикаторе. |
| DM_Test_EA.mq5 | Советник | Запускает прогнозные модели A (ONNX) и B (на основе наклона EMA) в реальном времени, ведет историю ошибок прогнозов, выполняет статические тесты DM и тесты DM в скользящем окне, отображает информационную панель результатов теста с помощью CCanvas и открывает сделки в направлении, прогнозируемом текущей моделью-победителем, со стоп-лоссом и тейк-профитом на основе ATR. |
| DM_RollingMonitor.mq5 | Индикатор | Визуализация в подокне статистики критерия DM с поправкой HLN и границами критических значений; статистика действительно пересчитывается в скользящем окне на каждом баре с использованием того же общего модуля формирования признаков и фактического вызова ONNX-модели для получения прогноза. |
| dm_manifest.json | Настройки | Манифест, задающий горизонт прогнозирования, тип функции потерь, размер скользящего окна, минимальный размер выборки и обновление информационной панели, — параметры теста не зашиты в код. |
| dm_test_verify.py | Python | Вспомогательная программа для автономного запуска, точно воспроизводящая контракт признаков и математические расчеты DM из реализации на MQL5 и предназначенная для автоматической проверки согласованности по журналам ошибок прогнозов, экспортированным советником. |
| dm_forecaster.onnx | Модель | Модель-заглушка — регрессор с 8 признаками (вход [1,8], выход [1,1]), точно соответствующий контракту признаков, благодаря чему весь конвейер работает без дополнительных настроек. Модель обучена на смоделированных ценовых данных, а не на реальной истории XAUUSD — прежде чем доверять каким-либо результатам ее работы, переобучите ее на собственных исторических данных признаков и изменений цены из раздела 5. |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/24060
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


