

Конструирование признаков для машинного обучения (Часть 7): Энтропийные признаки в Python
 136
 0

Содержание
- Введение
- Почему энтропия служит мерой рыночной информации
- Кодирование: от массивов, полученных по тиковому правилу, к целочисленным сообщениям
- Энтропия Шеннона
- Оценка энтропи методом подстановки
- Сложность Лемпеля — Зива
- Энтропия Контоянниса
- Ошибка @njit+String: почему исходный код выполнялся в объектном режиме
- Результаты: профили энтропии в различных рыночных режимах
- Сравнение производительности
- Заключение
Введение
В предыдущих статьях серии «Конструирование признаков для машинного обучения» признаки строились на основе геометрии цен (часть 1), торгового календаря (часть 3), а также спреда между ценами спроса и предложения и ценового воздействия (части 5–6). В этой статье признаки строятся на основе другого аспекта: информационного содержания последовательности направлений сделок внутри каждого бара.
В главе 18 книги Лопеса де Прадо «Advances in Financial Machine Learning» представлены четыре оценивателя энтропии, применяемые к закодированным последовательностям, полученным по тиковому правилу: энтропия Шеннона, подстановочная (блочная) оценка энтропии, сложность Лемпеля — Зива и универсальная энтропия Контоянниса. Все четыре алгоритма работают на основе символьного сообщения — строки символов, кодирующей направление каждой сделки в пределах одного бара — и возвращают скалярное значение в диапазоне от нуля до некоторого максимального значения, которое характеризует степень непредсказуемости последовательности направлений сделок.
У модуля afml.features.entropy есть та же проблема при промышленной эксплуатации, что и у модуля структурных разрывов: несколько вычислительно трудоёмких функций либо работают не так, как задумано, либо слишком медленны для наборов данных реалистичного размера (по числу баров). Больше всего проблем вызывает оцениватель энтропии Контоянниса. Поскольку декоратор @njit был применён к функции, принимающей строки Python, Numba скомпилировала её в объектном режиме, а не в режиме nopython. Из-за этого неявного перехода в объектный режим вычисления по-прежнему сопровождались всеми накладными расходами интерпретатора, хотя внешне казалось, что используется Numba. В данной статье описаны три обнаруженных ошибки и внесенные исправления.
Почему энтропия служит мерой рыночной информации
Тиковое правило присваивает каждой сделке в пределах бара направление bt ∈ {−1, 0, +1}. Последовательность {b1, b2, ..., bN} служит исходными данными для всех четырёх оценивателей. Два свойства этой последовательности содержат полезную информацию.
Первым свойством является маргинальное распределение. Равномерное распределение на множестве {−1, +1} — равное число покупок и продаж — даёт максимальную энтропию Шеннона. Асимметричное распределение — когда большинство сделок совершается в одном направлении — приводит к низкой энтропии Шеннона. Таким образом, низкая энтропия свидетельствует о преобладании одного направления в потоке заявок внутри бара, что в литературе по микроструктуре рынка связывают с информированной торговлей.
Второе свойство — структура последовательности. Два бара могут иметь одинаковое маргинальное распределение (равное число покупок и продаж, H = 1 бит), но совершенно разную структуру последовательности. В одном баре покупки и продажи могут строго чередоваться — BSBSBS, — а в другом следовать в случайном порядке. Оценка энтропи методом подстановки по биграммам (BSBSBS даёт только BS и SB) позволила бы обнаружить эту закономерность, а энтропия Шеннона по маргинальному распределению — нет. Сложность Лемпеля — Зива отражает третье свойство: количество новых фраз, появляющихся в последовательности по мере её удлинения, что позволяет оценить степень сжимаемости последовательности. Трендовая последовательность — состоящая только из покупок — максимально сжимаема (одна фраза). Случайная последовательность не поддается сжатию.
Оцениватель энтропии Контоянниса — наиболее теоретически строгий из этих четырёх. Он оценивает скорость энтропии эргодического стационарного процесса, измеряя среднюю длину совпадения при поиске текущей подстроки в предшествующей части сообщения. По мере увеличения длины сообщения эта величина сходится к 1/H бит на символ. Кроме того, этот оцениватель требует наибольших вычислительных затрат, поэтому устранение проблемы с его производительностью потребовало больше всего усилий.
Кодирование: от массивов значений тикового правила к целочисленным сообщениям
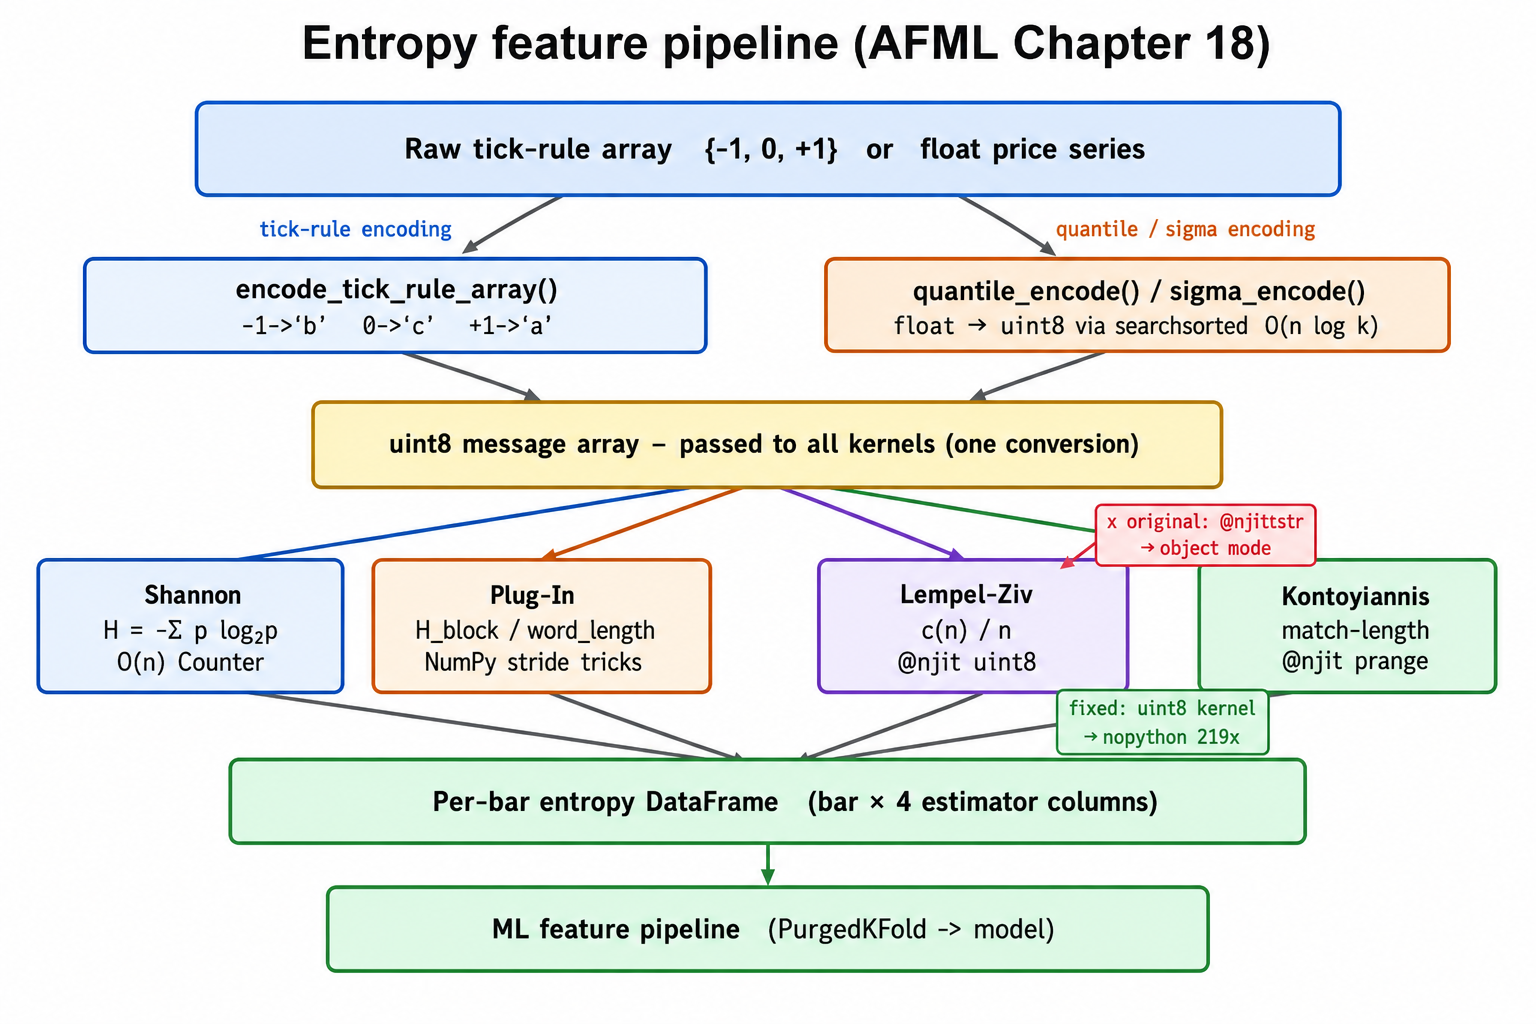
Рисунок 1. Архитектура конвейера вычисления энтропийных признаков
- Левая ветвь кодирования (бирюзовая): функция encode_tick_rule_array() отображает {−1, 0, +1} в {'b', 'c', 'a'}, представленные кодами ASCII [98, 99, 97] типа uint8. При любом значении, не входящем в множество {−1, 0, 1}, возбуждается исключение ValueError.
- Правая ветвь кодирования (оранжевая): функции quantile_encode() и sigma_encode() преобразуют массив чисел с плавающей запятой в индексы интервалов кодирования типа uint8. В обоих случаях используется np.searchsorted вместо перебора элементов словаря, что сокращает время кодирования с O(n × k) до O(n log k), где k — число интервалов кодирования.
- Массив uint8 (жёлтый): обе ветви дают результат в одном формате — массив NumPy типа uint8. Это преобразование выполняется один раз на входе; все четыре оценивателя получают уже преобразованный массив, что исключает повторное кодирование строк на критическом по производительности участке.
- Пояснение к ошибке (красный/зелёный): в исходном коде декоратор @njit применялся к функции со строковыми параметрами Python. Numba не может компилировать операции со строками в режиме nopython и незаметно переключается в объектный режим. Исправление заключается в преобразовании сообщения в массив типа uint8 до любого вызова Numba.
from afml.features.entropy import encode_tick_rule_array, to_uint8

# Tick-rule encoded bar
tick_arr = [-1, 1, 1, -1, 0, 1]
encoded, msg_str = encode_tick_rule_array(tick_arr)
# encoded: uint8 array [98,97,97,98,99,97]  →  'baabca'

# Float price changes encoded by quantile
from afml.features.entropy import quantile_encode
encoded_q, edges = quantile_encode(price_changes, num_bins=26)
# encoded_q: uint8 array of bin indices 0–25
Энтропия Шеннона
Энтропия Шеннона — это оцениватель, основанный на частотах отдельных символов, то есть на их маргинальном распределении. Для алфавита из k символов с эмпирическими вероятностями {p1, ..., pk}:
H = −Σi pi log2 pi
H = 0, когда все сделки совершаются в одном направлении (доминирует один символ). H = log2(k), если все символы встречаются с одинаковой частотой. Для трёхсимвольного алфавита {b, c, a}, используемого кодировщиком на основе тикового правила, максимальное значение составляет log2(3) ≈ 1.585 бита.
В реализации используется collections.Counter для подсчёта частот символов за время O(n). Здесь Numba не требуется: хеш-таблица Counter реализована на C и работает достаточно быстро при любой длине сообщения для отдельного бара. С помощью преобразователя to_uint8() поддерживаются входные данные как в виде строк str, так и в виде массивов uint8:
from afml.features.entropy import get_shannon_entropy

h = get_shannon_entropy(encoded)   # uint8 array
h = get_shannon_entropy("baabca") # str also accepted
Оценка энтропи методом подстановки
Оценка энтропи методом подстановки обобщает энтропию Шеннона на более длинные блоки. При длине блока (слова) w подсчитываются все перекрывающиеся w-граммы в сообщении и вычисляется энтропия Шеннона их распределения, затем результат делится на w для нормировки в битах на символ:
Hw = −(1/w) Σgram p(gram) log2 p(gram)
В реализации используется функция np.lib.stride_tricks.sliding_window_view для извлечения всех перекрывающихся w-грамм за одну векторизованную операцию, а затем — функция np.unique(..., axis=0, return_counts=True) для подсчёта их частот. Цикл на Python для обработки сообщения не требуется.
from afml.features.entropy import get_plug_in_entropy

h1 = get_plug_in_entropy(encoded, word_length=1)   # ≈ Shannon on this message
h2 = get_plug_in_entropy(encoded, word_length=2)   # bigram structure
h4 = get_plug_in_entropy(encoded, word_length=4)   # 4-gram structure
Следует обратить внимание на одну деталь реализации: в исходном коде сообщение усекается до arr[:n−1] перед применением скользящего окна, в результате чего получается n − word_length окон вместо n − word_length + 1. В результате эффективный объём выборки уменьшается на одно наблюдение для каждого бара. В оптимизированной реализации это усечение сохраняется в целях обеспечения численной совместимости. В случае сообщения длиной 8 символов при word_length=1 разница составляет одно окно, что приводит к сдвигу результата с 1.000 до 0.985 бита — это изменение будет заметно в любом регрессионном тесте, рассчитанном на исходные значения.
Сложность Лемпеля — Зива
Сложность Лемпеля — Зива c(n)/n выражает минимальное число различных фраз, необходимых для восстановления сообщения при использовании жадного алгоритма определения границ фраз. Сообщение с низкой сложностью Лемпеля — Зива хорошо поддаётся сжатию: полную последовательность можно воспроизвести с помощью небольшого числа фраз. Случайное сообщение характеризуется высокой сложностью Лемпеля — Зива: почти каждое продолжение текущей фразы является новым.
Алгоритм поддерживает словарь ранее встречавшихся фраз. Начиная с позиции 1, он находит кратчайшее продолжение текущей фразы, которого нет в словаре, добавляет его в словарь и переходит к следующей позиции:
# Illustrative trace on "11100001" (LZ = 5/8 = 0.625)
# library: {'1'} → add '11' → add '0' → add '00' → add '01'
# phrases: {1}    {1,11}      {1,11,0}   {1,11,0,00}  {1,11,0,00,01}
# positions: 0     1-2         3          4-5          6-7
Вычислительное ядро Numba хранит словарь фраз в виде массивов пар (начало, длина), описывающих фразы, а затем проверяет принадлежность к словарю путём сравнения целых чисел. Внутри вычислительного ядра не происходит ни выделения памяти под строки, ни поиска в хеш-таблице Python. Ключевое требование к корректности: проверять наличие фразы именно в словаре фраз, а не среди произвольных более ранних вхождений в исходном тексте. Это не одно и то же: последовательность «11» может встретиться в тексте до того, как будет добавлена в словарь в качестве новой фразы. Множество строк в исходной реализации корректно учитывает это различие; исправленная реализация на Numba воспроизводит это поведение с помощью массива фраз.
from afml.features.entropy import get_lempel_ziv_entropy

lz = get_lempel_ziv_entropy(encoded)
# Returns c(n)/n in (0, 1]
# Low value: compressible, directional or repetitive sequence
# High value: incompressible, random sequence
Энтропия Контоянниса
Оцениватель Контоянниса оценивает энтропию по средней длине совпадения, найденного при поиске текущей подстроки в предыстории. Он сходится к истинной скорости энтропии H эргодического стационарного процесса при n → ∞ (Kontoyiannis et al., 1998):
Ĥ = (1/n) Σi log2(i + 1) / Λi
где Λi — длина самого длинного совпадения, найденного в message[i−window : i] для позиции i. Длинное совпадение означает, что последовательность предсказуема — она уже встречалась ранее, — поэтому Λi велико, а вклад log2(i + 1) / Λi невелик. Короткое совпадение означает, что последовательность новая, поэтому соответствующее слагаемое больше.
Внутренний цикл — поиск самого длинного совпадения — вызывается один раз для каждой точки оценки, а точек оценки — O(n/2). При поиске совпадения просматривается окно предыстории шириной W и перебираются длины продолжения от 1 до W. Это требует O(W²) времени на каждую точку оценки, поэтому вычислительная сложность оценивателя в целом составляет O(n·W²), и обычно на него приходится основная часть времени вычисления энтропии для каждого бара.
from afml.features.entropy import get_konto_entropy

h_exp    = get_konto_entropy(encoded)           # expanding window (default)
h_fixed  = get_konto_entropy(encoded, window=10) # fixed look-back of 10 symbols
При использовании расширяющегося окна (window=0) ширина окна предыстории в позиции i равна i, поэтому в каждой точке оцениватель учитывает всю предшествующую историю. Для типичных сообщений длиной 20–50 символов на один бар правильным выбором будет расширяющееся окно. Для длинных последовательностей (>200 символов, которые могут встречаться у активно торгуемых инструментов при использовании тиковых баров) фиксированное окно размером 20–50 символов существенно снижает вычислительные затраты при минимальной потере точности, поскольку для алфавита из 3 символов статистика совпадений быстро достигает насыщения при W > 30.
Ошибка @njit+String: почему исходный код выполнялся в объектном режиме
У исходной функции _match_length был декоратор @njit(cache=True), который, казалось, обеспечивал компиляцию Numba в режиме nopython. Но это было не так. В режиме nopython Numba не может компилировать операции индексации, получения срезов или сравнения строк Python. При обнаружении таких операций Numba без предупреждения переходит в объектный режим — вариант компиляции, при котором интерпретируется байт-код Python вместо генерации машинного кода. При каждом вызове функция выполнялась со скоростью обычного кода Python, а в кэше JIT хранился объект байт-кода для объектного режима вместо нативного кода.
Три ошибки в исходном модуле и их исправления:
| Ошибка | Местоположение | Последствия | Исправление |
|---|---|---|---|
| 1 | _match_length с @njit и строковыми аргументами | Компиляция в объектном режиме; накладные расходы Python при каждом вызове. Каждый вызов в 219 раз медленнее, чем у исправленного вычислительного ядра для uint8; с учётом O(n/2) вызовов оцениватель энтропии Контоянниса работал в 1 287 раз медленнее, чем мог бы, при n = 200. | Один раз преобразуйте сообщение в uint8 в функции get_konto_entropy(); передайте массив uint8 в функцию _match_length_kernel(), которая действительно компилируется в режиме nopython. |
| 2 | _lempel_ziv_kernel — неверная проверка по словарю фраз | Точное совпадение с фразой искалось в предшествующем исходном тексте, а не в словаре фраз. Получались систематически неверные значения LZ (например, 0.375 вместо 0.625 для эталонного сообщения из главы). | Хранить словарь фраз в виде целочисленных массивов (начало, длина); проверять наличие фразы, сравнивая целые числа с соответствующими значениями ранее записанных фраз. |
| 3 | get_plug_in_entropy — отсутствует усечение arr[:n-1] | Формировалось n-word_length+1 окон вместо n-word_length, что давало численные результаты, отличающиеся от результатов исходной реализации. Для сообщения длиной 8 символов при word_length=1: 8 окон вместо 7 → H=1.000 вместо H=0.985. | Добавьте arr = arr[:n-1] перед вызовом функции sliding_window_view, чтобы воспроизвести исходное поведение. |
В исходном алгоритме окно-кандидат j:j+length+1 может включать позицию i; требуется лишь, чтобы j < i. Проверка if j + length > start: break в предыдущей версии вычислительного ядра ошибочно запрещала такое перекрытие, что приводило к более коротким совпадениям и систематически заниженным значениям энтропии Контоянниса. Удаление этой проверки восстановило совпадение результатов с точностью до машинной погрешности.
Результаты: профили энтропии в различных рыночных режимах
На рисунке ниже показаны результаты работы всех четырёх оценивателей на 60 синтетических барах в четырёх различных режимах последовательности направлений сделок, определённых по тиковому правилу: случайном (высокая энтропия), трендовом (низкая энтропия), режиме чередования (средняя энтропия) и снова случайном.
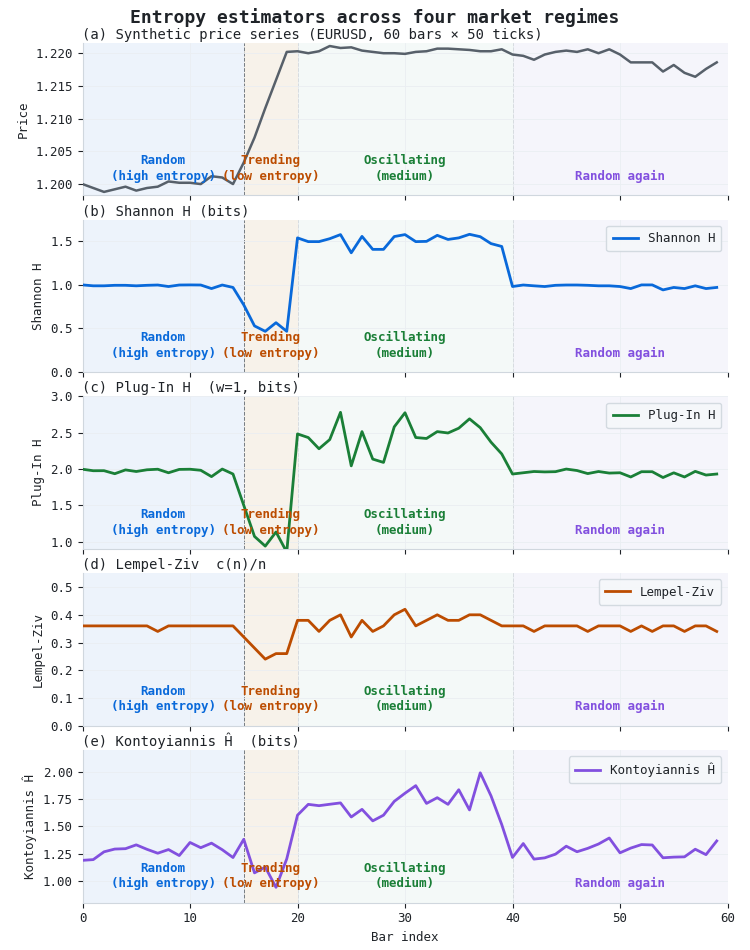
Рисунок 2. Четыре графика, иллюстрирующие работу оценивателей энтропии в четырёх синтетических рыночных режимах (60 баров)
- График (a) Энтропия Шеннона H: резко снижается почти до нуля в трендовом режиме (бары 15–30), когда 28 из 30 тиков в каждом баре соответствуют покупкам. В случайном режиме и режиме чередования возвращается к значению, близкому к максимальному.
- График (b) Оценка энтропи методом подстановки H: при word_length=1 ведёт себя сходно с энтропией Шеннона, но в режиме чередования снижается немного сильнее, поскольку биграмма «ba» (чередование покупки и продажи) преобладает в распределении биграмм, из-за чего подстановочная оценка энтропии оказывается немного ниже значения энтропии Шеннона.
- График (c) Сложность Лемпеля — Зива c(n)/n: снижается как в трендовом режиме, так и в режиме чередования, поскольку обе последовательности поддаются сжатию: бар в трендовом режиме порождает одну фразу («a»), а бар в режиме чередования — две («a», «b»), которые повторяются. Значение LZ в режиме чередования выше, чем в трендовом режиме, что верно отражает большую сложность чередования по сравнению с простым повторением.
- График (d) Энтропия Контоянниса H: наиболее чувствительный к структуре последовательности оцениватель. В трендовом режиме значение энтропии Контоянниса H близко к нулю, поскольку каждое продолжение совпадает с непосредственно предшествующим участком последовательности. В режиме чередования энтропия Контоянниса H принимает промежуточные значения, поскольку чередование предсказуемо, но не тривиальным образом.
Практическое наблюдение: эти четыре оценивателя не всегда одинаково ранжируют рыночные режимы по информационному содержанию. Оцениватель Шеннона ставит режим чередования выше трендового режима; оцениватель Лемпеля — Зива даёт такое же ранжирование. Однако оцениватель Контоянниса более отчётливо ставит режим чередования ниже случайного режима, что отражает его чувствительность к зависимостям более высоких порядков в последовательности, возникающим при чередовании. Включение результатов всех четырёх оценивателей в матрицу признаков для машинного обучения позволяет модели использовать эти различия для характеристики режимов, которые один оцениватель не смог бы различить.
Сравнение производительности
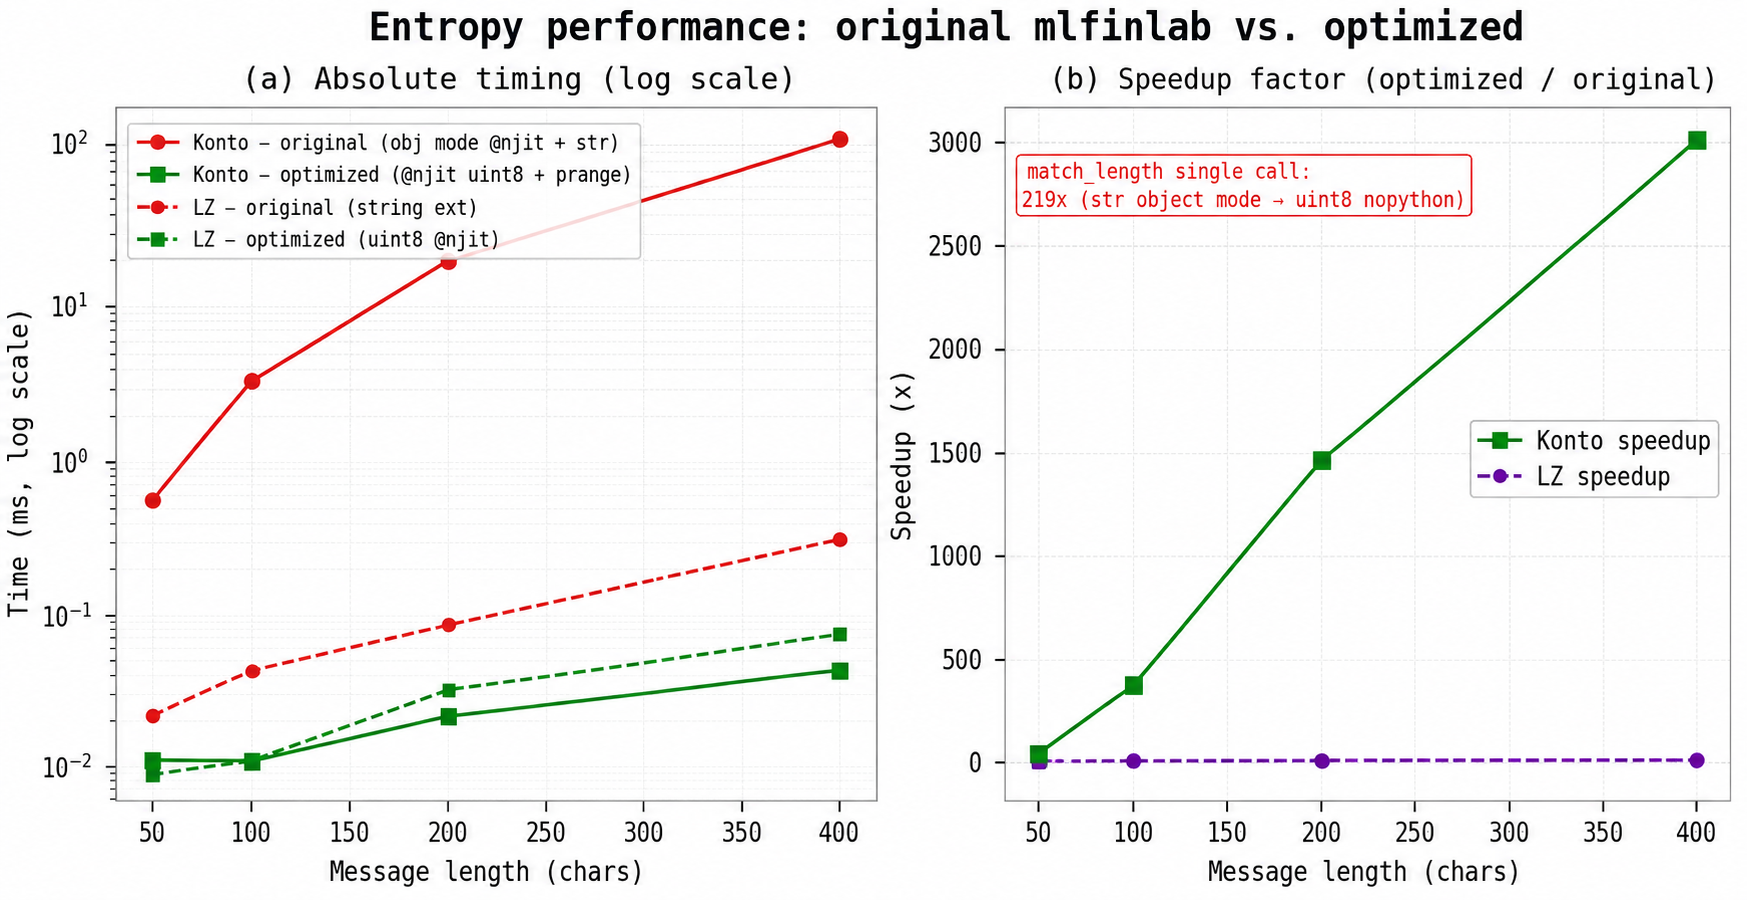
Рисунок 3. Двухпанельная иллюстрация сравнения производительности исходных и оптимизированных реализаций оценивателей энтропии
- Панель (a): абсолютное время выполнения в логарифмическом масштабе. Время работы исходного оценивателя Контоянниса (красная сплошная линия) растёт как O(n²): от 0.5 мс при n = 50 до 30 мс при n = 200. Время работы оптимизированной версии (зелёная сплошная линия) почти не меняется и остаётся ниже 0.02 мс во всём этом диапазоне. Для оценивателя Лемпеля — Зива версия на Numba с ведением словаря фраз показывает меньшее, но устойчивое преимущество по скорости перед версией на Python с множеством строк.
- Панель (b): коэффициент ускорения. Ускорение оценивателя Контоянниса растёт с длиной сообщения, поскольку внешний цикл prange распределяет независимые позиции вычисления оценки между ядрами процессора; более длинные сообщения дают больше возможностей для параллельного выполнения. Отметка 219× обозначает ускорение одного вызова _match_length_kernel; с учётом O(n/2) вызовов на одно вычисление оценки Контоянниса общее ускорение при n = 200 составляет 1 287×.
Для конвейера с T = 10 000 баров и примерно 24 тиками на бар исходному оценивателю Контоянниса потребовалось бы около 7.2 часа для последовательного вычисления оценок для всех баров. Оптимизированная версия выполняет тот же расчет примерно за 20 секунд. Это не просто небольшое улучшение: благодаря ему оцениватель из непригодного даже для исследований становится пригодным для промышленной эксплуатации.
Заключение
В этой статье в модуле afml.features.entropy реализован набор энтропийных признаков из главы 18 книги AFML. Четыре оценивателя — оцениватель энтропии Шеннона, подстановочная оценка энтропии, оцениватель сложности Лемпеля — Зива и оцениватель энтропии Контоянниса — работают с закодированными последовательностями направлений сделок, определённых по тиковому правилу, и возвращают по одному скалярному значению на бар, отражая маргинальные, блочные, связанные со структурой последовательности и универсальные свойства распределения направлений потока заявок.
В исходном модуле исправлены три ошибки: сбой объектного режима при сочетании @njit с обработкой строк, из-за которого оцениватель Контоянниса при n = 200 работал в 1 287 раз медленнее, чем мог бы; некорректная проверка принадлежности к словарю фраз в вычислительном ядре Лемпеля — Зива, приводившая к систематически неверным значениям; отсутствие усечения в подстановочной оценке энтропии, из-за которого численные результаты отличались от результатов исходной реализации. После внесения исправлений все 47 тестов проходят успешно, а численные результаты согласуются с эталонными значениями из главы в пределах указанных допусков.
Модуль кодирования также был расширен: функции quantile_encode() и sigma_encode() вместо исходного кодирования на основе словарей используют np.searchsorted, снижая временную сложность кодирования с O(n × k) до O(n log k). Обе функции возвращают массивы типа uint8, которые напрямую передаются во все четыре вычислительных ядра Numba без дополнительного преобразования.
В следующей статье из этой серии речь пойдёт о портировании индикатора энтропии на MQL5.
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/22756
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


