

Конструирование признаков для машинного обучения (Часть 9): Tесты на структурные сдвиги на Python
 100
 0

Содержание
- Введение
- Две категории тестов на структурные сдвиги
- Тесты кумулятивных сумм (CUSUM): тест Чу — Стинчкомба — Уайта
- Тесты на взрывную динамику: тест Дики — Фуллера типа Чоу
- SADF: супремум расширенного теста Дики — Фуллера
- Тесты на субмартингальность и супермартингальность
- QADF и CADF: повышение робастности супремума
- Почему фрагменты кода из книги не работают в промышленной эксплуатации
- Задача промышленной эксплуатации: выбор окон с течением времени
- Структурные сдвиги как критерии выбора рыночного режима
- Результаты на синтетических данных
- Заключение
- Список литературы
Введение
В предыдущих статьях серии "Конструирование признаков для машинного обучения" признаки создавались на основе самой структуры времени: в части 1 дробное дифференцирование было представлено как способ сохранения долгой памяти в стационарном ряде; в части 3 торговый календарь был представлен в координатах Фурье; а в части 5 поток заявок на уровне тиков был сведен к микроструктурным статистикам с индексацией по барам. В этой статье признаки конструируются на основе качественно иного вопроса: не как выглядит текущий бар, а изменился ли в последнее время процесс, порождающий данные, в результате которого этот бар сформировался.Глава 17 книги Лопеса де Прадо "Достижения в области финансового машинного обучения" начинается с меткого замечания. Структурные сдвиги — переходы от одного рыночного режима к другому — дают одни из лучших торговых возможностей с учетом риска именно потому, что большинство участников оказываются застигнутыми врасплох. Когда динамика с возвратом к среднему сменяется импульсным движением, в ловушку попадают трейдеры, которые продолжают торговать против пробоев; когда трендовый рынок возвращается к среднему, в ловушку попадают трейдеры, слишком долго удерживавшие направленные позиции. Участники, оказавшиеся в проигрыше, не сразу осознают свою ошибку. Они удерживают позиции, усредняют убыточные позиции, и в итоге их позиции закрываются по стоп-приказам. Именно эта вынужденная ликвидация и создает преимущество. Однако для выявления перехода в режиме реального времени, а не задним числом, требуется формальный статистический тест.
Модуль afml.structural_breaks реализует два семейства таких тестов. Первое семейство — тесты кумулятивных сумм (CUSUM) — позволяет определить, значимо ли накопленные ошибки прогноза отклоняются от белого шума. Второе семейство — тесты на взрывную динамику — позволяет выявить экспоненциальный рост или обвал, несовместимые со случайным блужданием. В этой статье рассматриваются оба семейства. В статье предложены два варианта, отсутствующих в исходной реализации, и описаны проблемы с производительностью приведенных в книге фрагментов кода на Python, которые делают их непригодными для временных рядов реалистичной длины. В заключение раскрывается подразумеваемая в этой главе связь с выбором стратегии.
Две категории тестов на структурные сдвиги
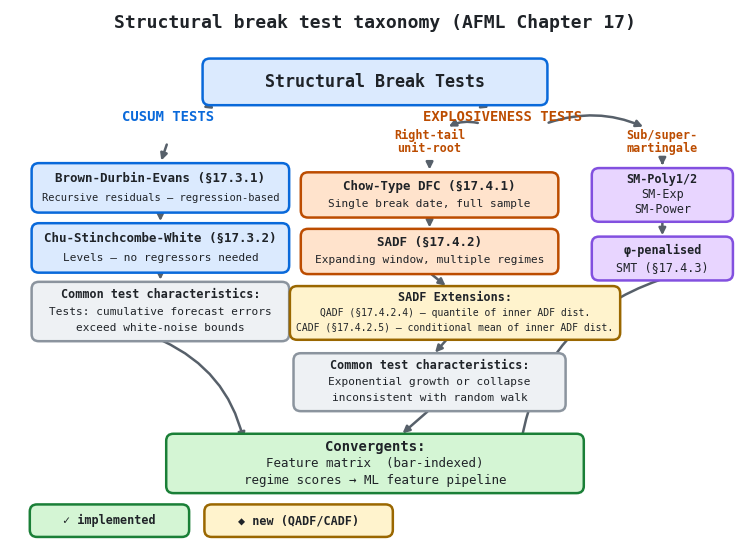
Рисунок 1. Схема классификации тестов на структурные сдвиги из главы 17 книги AFML
- Левая ветвь (CUSUM): проверяет, значимо ли накопленные ошибки прогноза отклоняются от белого шума. Тест Брауна — Дарбина — Эванса (§17.3.1) основан на регрессии и пока не реализован; тест Чу — Стинчкомба — Уайта (§17.3.2) работает только с уровнями и полностью реализован в модуле afml.structural_breaks.
- Правая ветвь (взрывная динамика): тесты на экспоненциальный рост или обвал. Тест Дики — Фуллера типа Чоу (DFC) проверяет наличие единственного структурного сдвига с неизвестной датой. SADF использует двойной вложенный цикл для обнаружения нескольких смен рыночного режима. Тесты на субмартингальность и супермартингальность (SM-Poly, SM-Exp, SM-Power) используют альтернативные функциональные формы со штрафной поправкой с параметром φ для снижения смещения в пользу длительных пузырей.
- Новые дополнения: квантильная статистика ADF (QADF) (§17.4.2.4) и условное среднее ADF (CADF) (§17.4.2.5) повышают робастность статистики супремума SADF к выбросам в распределении ADF-статистик по внутренним окнам. Обе статистики реализованы в этом модуле, но отсутствуют в исходной кодовой базе.
- Выходные данные (зелёный узел): все тесты формируют скалярные ряды с индексацией по барам, которые напрямую включаются в конвейер конструирования признаков для машинного обучения, построенный в предыдущих статьях.
Тесты кумулятивных сумм (CUSUM): тест Чу — Стинчкомба — Уайта
Тест Чу — Стинчкомба — Уайта (Homm и Breitung, 2012) упрощает более ранний метод Брауна — Дарбина — Эванса, полностью исключая массив регрессоров. В этом тесте нулевая гипотеза предполагает отсутствие тренда, E_{t-1}[Δy_t] = 0, что позволяет работать непосредственно с уровнями ряда {y_t}. Для каждой пары временных точек (n, t) тест стандартизирует отклонение логарифма цены y_t от опорного уровня y_n:
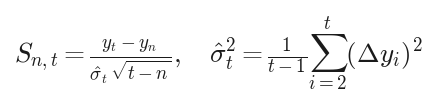
При гипотезе H_0: β_t = 0, S_{n,t} ~ N[0, 1]. Чтобы устранить зависимость от произвольного опорного уровня y_n, в тесте берется супремум по всем n ∈ [1, t]. Критическое значение, зависящее от времени и полученное методом Монте-Карло, составляет:

Когда статистика превышает своё критическое значение, нулевая гипотеза об отсутствии тренда отвергается. Практическим сигналом для конвейера признаков служит нормированная разность (статистика − критическое значение), показывающая, насколько превышен порог отклонения нулевой гипотезы. Положительное значение, поступающее в скользящее окно, указывает на наличие тренда в ряде данных; значение, близкое к нулю, свидетельствует о поведении, характерном для белого шума.
from afml.structural_breaks import get_chu_stinchcombe_white_statistics

csw = get_chu_stinchcombe_white_statistics(
    log_prices,
    test_type="one_sided",   # or "two_sided"
)
# Returns pd.DataFrame with columns "stat" and "critical_value"
# Feature: csw["stat"] - csw["critical_value"]  (excess over rejection boundary)
excess = csw["stat"] - csw["critical_value"]
В двусторонней версии используется абсолютное значение отклонения, поэтому тест симметричен по отношению к рыночным подъёмам и распродажам. В большинстве конвейеров конструирования признаков односторонний вариант более информативен, поскольку знак отклонения (вверх или вниз) сам по себе служит сигналом рыночного режима.
Тесты на взрывную динамику: тест Дики — Фуллера типа Чоу
Тест типа Чоу (Chow, 1960) основан на авторегрессионной модели первого порядка как для нулевой гипотезы (случайное блуждание), так и для альтернативной гипотезы (взрывной процесс). Тест проверяет, перешел ли ряд в некоторый неизвестный момент времени τ*T от процесса с единичным корнем к взрывному процессу. В рамках теста оценивается следующая регрессия:
где D_t[τ*] — фиктивная переменная, которая равна нулю до момента τ*T и равна единице, начиная с момента τ*T. Статистика теста — это t-статистика коэффициента δ, обозначаемая DFC_{τ*}. Поскольку τ* неизвестно, Эндрюс (1993) предложил перебрать все возможные даты структурного сдвига в интервале [τ_0, 1−τ_0] и взять супремум:
Основное ограничение этого подхода состоит в том, что он предполагает только одну дату структурного сдвига. Цикл "пузырь — крах — восстановление" выглядит стационарным с точки зрения теста Чоу, поскольку два эпизода взрывной динамики взаимно компенсируются. Поэтому SDFC лучше использовать как дополнительный признак наряду с SADF, а не как самостоятельный сигнал. Его ценность как признака заключается в самом положении точки структурного сдвига: когда SDFC достигает пика, соответствующий индекс τ* указывает, в какой момент рынок, скорее всего, сменил режим; этот индекс полезен как переменная, обусловливающая выбор стратегии.
from afml.structural_breaks import get_chow_type_stat

sdfc = get_chow_type_stat(log_prices, min_length=20)
# Returns pd.Series of DFC_τ* statistics
# SDFC = sdfc.max()  — supremum over all tested τ*
SADF: супремум расширенного теста Дики — Фуллера
Филлипс, Ву и Ю (2011) показали, что стандартные тесты на наличие единичного корня могут не отличать стационарный процесс от периодически схлопывающегося пузыря. Предложенный ими метод SADF оценивает расширенную регрессию Дики — Фуллера для каждой конечной точки t, расширяя окно назад во времени за счет сдвига начальной точки t_0:
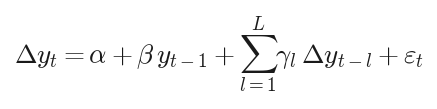
Для каждой конечной точки t проверяются все комбинации (t_0, t). SADF определяется как супремум полученных ADF-статистик:
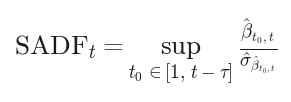
где τ — минимальная длина выборки, используемая для оценки. Когда β > 0, ряд находится в режиме взрывной динамики; статистика SADF возрастает. Когда β < 0, ряд находится в устойчивом режиме с возвратом к среднему, стремясь к долгосрочному уровню; статистика отрицательна или близка к нулю. При β = 0 ряд представляет собой процесс с единичным корнем: он нестационарен, но не обладает взрывной динамикой.
В главе выделены четыре варианта функциональной формы спецификации ADF. Линейная модель (константа + линейный тренд) представляет собой стандартную модель ADF. В квадратичной модели к компоненте тренда добавляется t². Обе модели используют разности логарифмов цен. Модели SM (sm_poly_1, sm_poly_2, sm_exp, sm_power) работают непосредственно с уровнями или логарифмами уровней, проверяя субмартингальность или супермартингальность при заданных функциональных формах. Каждая модель представляет собой отдельную гипотезу о форме траектории взрывной динамики; включение всех этих моделей в матрицу признаков позволяет последующей модели выбрать ту из них, которая обладает наибольшей прогностической способностью для рассматриваемого актива.
from afml.structural_breaks import get_sadf

# Standard linear SADF
sadf_linear = get_sadf(
    log_prices,
    model="linear",
    lags=1,
    min_length=20,
    add_const=True,
)

# Exponential sub/super-martingale test with φ=0.5
smt_exp = get_sadf(
    log_prices,
    model="sm_exp",
    lags=1,
    min_length=20,
    phi=0.5,
)
Логарифмы цен, а не исходные цены
В этой главе содержится четкое предупреждение по этому поводу, которое легко упустить из виду. Если нулевая гипотеза теста ADF отвергается для исходных цен, то делается вывод о том, что цены имеют конечную дисперсию. Из этого следует, что дисперсия доходности не является инвариантной по времени: она должна уменьшаться при росте цен и увеличиваться при их падении, чтобы дисперсия цен оставалась постоянной. Таким образом, применение ADF к исходным ценам неявно вводит предположение о структурной гетероскедастичности, которое почти наверняка нарушается на длинных выборках, содержащих пузыри. Тесты на стационарность логарифмов цен следует интерпретировать как тесты в отношении среднего значения доходности, а не ее дисперсии. Всегда передавайте np.log(price_series), а не исходный ряд цен, в функцию get_sadf().
Тесты на субмартингальность и супермартингальность
Семейство SM заменяет спецификацию ADF регрессиями, в которых в качестве регрессоров используются функции времени заданного вида. Цель состоит в том, чтобы выявить взрывные тренды, которые не соответствуют модели AR(1), заложенной в ADF. В каждой спецификации тест оценивает регрессию y (или log y) на функцию от t и проверяет, равен ли нулю коэффициент при этой функции. Здесь применяется та же логика окна, расширяющегося назад во времени, и берется тот же супремум:
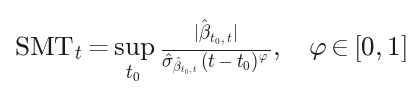
Параметр φ корректирует структурно обусловленное смещение в пользу долгосрочных пузырей. В случае простой регрессии дисперсия коэффициента β уменьшается по мере увеличения величины (t−t_0), что означает, что длинные выборки с небольшими, но устойчивыми трендами дают искусственно завышенные значения t-статистики. Установка φ = 0.5 полностью нивелирует этот эффект; при φ = 0 получается исходная статистика SMT; при φ → 1 все большее предпочтение отдается краткосрочным пузырям по сравнению с долгосрочными. На практике включение значений SMT при φ = 0, 0.5 и 1.0 в качестве отдельных признаков позволяет алгоритму машинного обучения различать горизонты удержания позиций в рамках эпизода взрывной динамики.
Квантильная статистика ADF (QADF) и условное среднее ADF (CADF): повышение робастности супремума
Статистика супремума SADF чувствительна к выбросам в распределении ADF-статистик по внутренним окнам {ADF_{t0,t}}_{t0∈[1,t−τ]}. Одно окно с почти вырожденной матрицей регрессоров может дать ложно завышенную t-статистику, которая определяет супремум, смещая SADF вверх. В этой главе предлагаются два варианта.
QADF (§17.4.2.4) заменяет супремум квантилем высокого уровня. Для заданного пользователем q ∈ [0, 1] величина Q_{t,q} представляет собой q-й квантиль распределения ADF-статистик по внутренним окнам в момент времени t. Сопутствующая мера разброса Qdot_{t,q,v} = Q_{t,q+v} − Q_{t,q−v} отражает ширину верхнего хвоста. Сам SADF представляет собой частный случай Q_{t,1}, однако Q_{t,0.95} гораздо более устойчив к окнам с выбросами.
В CADF (§17.4.2.5) используется условное среднее значений ADF-статистики, превышающих q-й квантиль; в данной главе оно обозначается C_{t,q}. Это математическое ожидание ADF_{t0,t} при условии, что эта величина превышает порог Q_{t,q}. По определению C_{t,q} ≤ SADF_t. На диаграмме рассеяния SADF_t относительно C_{t,q} в нормальных условиях прослеживается восходящая линия с наклоном, приблизительно равным единице; когда SADF значительно превышает C_{t,q}, это указывает на то, что супремум определяется отдельным окном с выбросом, а не взрывным трендом, проявляющимся в значительной части распределения ADF-статистик по внутренним окнам.
from afml.structural_breaks import get_qadf, get_cadf

qadf = get_qadf(log_prices, model="linear", lags=1,
                min_length=20, q=0.95, v=0.025)
# qadf["q_adf"]  — Q_{t,0.95}  (robust centrality of high ADF values)
# qadf["q_dot"]  — Qdot_{t,q,v} (width of upper tail)

cadf = get_cadf(log_prices, model="linear", lags=1,
                min_length=20, q=0.95)
# cadf["c_adf"]  — C_{t,q}  (conditional mean above threshold)
# cadf["c_dot"]  — conditional std above threshold

# Outlier diagnostic: when this ratio is large, SADF is driven by a single window
outlier_ratio = (sadf_linear - cadf["c_adf"]) / cadf["c_dot"].clip(lower=0.01)
Почему фрагменты кода из книги не работают в условиях промышленной эксплуатации
Фрагменты кода 17.1–17.4 в этой главе прямо названы учебными: "Цель этого кода — не быстро вычислить SADF, а разъяснить этапы его вычисления". В главе даже приводится таблица числа операций с плавающей точкой (FLOP), согласно которой одно обновление SADF для ряда долларовых баров длиной T = 356 631 требует примерно 2,035 TFLOP. Для ряда такой длины вычисление полного временного ряда SADF требует, по оценкам, 242 PFLOP — эта цифра наглядно показывает необходимость распараллеливания алгоритма.
Даже при меньших объёмах данных — на рядах дневных или часовых баров, используемых в исследовательских конвейерах, — у фрагментов кода из книги проявляются три конкретных недостатка.
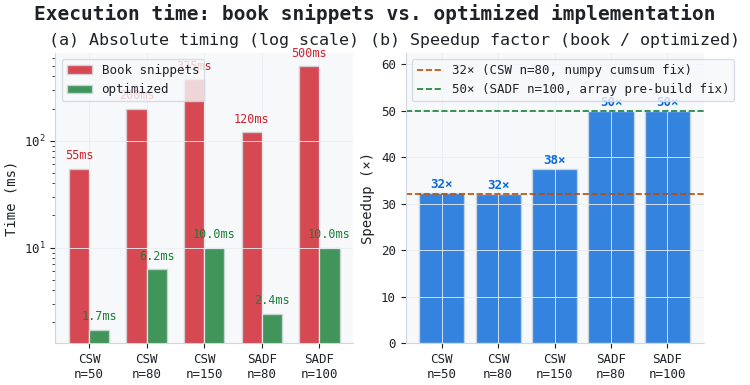
Рисунок 2. Двухпанельная иллюстрация сравнения времени выполнения фрагментов кода из книги и оптимизированной реализации
- Панель (a): абсолютное время выполнения в логарифмическом масштабе. Зелёные столбцы (оптимизированная реализация) во всех случаях в 10–50 раз короче красных (фрагменты кода из книги). В тесте CSW при n = 150 время выполнения кода из книги составляет 375 мс, тогда как у оптимизированной версии — 10 мс. Разрыв увеличивается с ростом n из-за квадратичной сложности O(T²).
- Панель (b): коэффициенты ускорения. Внутренний цикл SADF при n = 100 выполняется в 50 раз быстрее, поскольку версия из книги заново создаёт объект DataFrame библиотеки Pandas при каждом вызове getYX(), тогда как оптимизированная версия один раз предварительно вычисляет X и y в виде массивов NumPy и передаёт их срезы. Тест CSW при n = 80 выполняется в 32 раза быстрее, поскольку оптимизированная версия один раз предварительно вычисляет σ²_t с помощью кумулятивной суммы, а не пересчитывает эту величину во внутреннем цикле со сложностью O(T²).
Три недостатка в порядке убывания серьёзности:
1. Использование Series.loc во внутреннем цикле CSW со сложностью O(T²)
В исходной реализации CSW вызов series.loc[index] выполняется внутри двойного цикла Python. Хотя поиск по DatetimeIndex в Pandas имеет амортизированную сложность O(1), постоянные накладные расходы на определение позиции по метке значительны по сравнению с затратами на арифметические операции. При n = 150 барах версия из книги выполняется за 375 мс. При экстраполяции на n = 5 000 — небольшой двухлетний ряд дневных данных — время выполнения составляет примерно 7.6 минуты. Для десятилетнего ряда время выполнения превышает 30 минут.
Решением является однократное преобразование ряда в массив NumPy и предварительный расчёт σ²_t с помощью кумулятивной суммы np.cumsum(np.diff(vals)**2). Внутренний цикл при этом работает исключительно с целочисленными индексами и арифметикой типа float64, без накладных расходов, связанных с объектами Python.
2. Повторное создание DataFrame pandas во внутреннем цикле SADF
Фрагмент 17.2 (getYX) создаёт DataFrame Pandas при каждом вызове. Внешний цикл SADF вызывает эту функцию один раз на каждом временном шаге t, а внутренний цикл при каждом t вызывает функцию getBetas() примерно (t − τ) раз. Создание DataFrame, включая выравнивание индексов, проверки механизма копирования при записи и присвоение имён столбцам, — это исключительно накладные расходы: для вычислений нужны лишь массивы NumPy. Решение заключается в том, чтобы один раз сформировать полные массивы X и y вне внешнего цикла и передавать по ссылке срезы, доступные только для чтения.
3. Скрытая ошибка в порядке аргументов getBetas
В книге используется сигнатура getBetas(y, x) — сначала зависимая переменная, затем признаки. Во всех фрагментах кода функция вызывается правильно, но принятый порядок аргументов обратен стандартному для scikit-learn порядку (X, y). Любой пользователь, который перенёс эту функцию и вызвал её как getBetas(X, y), получил бы численный результат без сообщения об ошибке; вектор коэффициентов β соответствовал бы регрессии X на y, а не y на X. В оптимизированной реализации повсеместно используется единая сигнатура get_betas(X, y), а при несовместимых размерностях массивов выдаётся понятное сообщение об ошибке.
Ни одно из этих замечаний не является критикой данной главы. Фрагменты кода из книги выполняют заявленную задачу: они поясняют, что именно вычисляет алгоритм. Для промышленной эксплуатации необходимы описанные выше оптимизации.
Задача промышленной эксплуатации: выбор окон с течением времени
В алгоритме SADF используется окно, расширяющееся назад во времени: правая граница окна фиксирована в текущий момент t, а левая граница t_0 сдвигается назад до начала выборки. Это означает, что по мере накопления новых баров при каждом обновлении SADF происходит повторное считывание всей истории, начиная с 1-го бара. Для ряда, который пополняется на один бар в день, время вычислений растёт квадратично с течением календарного времени.
Практический вопрос заключается в том, необходимо ли расширять окно на всю историю или скользящее окно фиксированной длины W позволяет получить полезный сигнал при гораздо меньших вычислительных затратах. Ответ зависит от типа обнаруживаемого пузыря.
Для краткосрочных пузырей с периодом удержания позиции от нескольких дней до нескольких недель скользящее окно размером W = 252 бара (один год дневных данных) охватывает всю значимую структуру. Левая граница окна отсекает данные старше одного года, что допустимо, поскольку смены режима двухлетней давности уже нельзя использовать для торговли. Для долгосрочных пузырей, охватывающих несколько лет, — в главе приведены примеры пузыря доткомов и кризиса субстандартного ипотечного кредитования — необходимо расширяющееся окно: для достижения статистической мощности тесту нужен достаточный контраст между режимом до возникновения пузыря и режимом во время пузыря.
Практическое решение — реализовать гибридный подход: ограничить расширение окна влево фиксированной глубиной ретроспективы L, достаточно большой, чтобы охватить максимальную ожидаемую продолжительность пузыря, но не всю доступную историю. Для дневных данных по акциям разумное значение по умолчанию — L = 504 (два года). Вычисление SADF на интервале [max(1, t−L), t] сохраняет чувствительность к среднесрочным пузырям и ограничивает вычислительные затраты на один бар величиной O(L²) вместо O(T²). Реализация функции get_sadf() обеспечивает эту возможность за счёт границ окна, передаваемых в функцию _get_y_x_numpy():
# Rolling-window SADF: limit lookback to the last 504 bars
L = 504
results = {}
for t in range(min_length, len(log_prices)):
    window = log_prices.iloc[max(0, t - L): t + 1]
    sadf_t = get_sadf(window, model="linear", lags=1,
                      min_length=min_length)
    if len(sadf_t) > 0:
        results[log_prices.index[t]] = sadf_t.iloc[-1]

sadf_rolling = pd.Series(results)
Версия со скользящим окном несколько меняет интерпретацию статистики: она отвечает на вопрос "наблюдается ли взрывная динамика процесса на последних L барах?", а не "наблюдалась ли у него когда-либо взрывная динамика?". Для признака, предназначенного для выбора текущей торговой стратегии, интерпретация на более коротком горизонте уместнее. Для сигнала управления рисками, предназначенного для выявления длительного формирования пузыря, необходимо расширяющееся окно, охватывающее всю историю.
Структурные сдвиги как инструмент выбора режима
Исходная посылка главы — о том, что переходы, связанные со структурными сдвигами, открывают на финансовых рынках одни из лучших возможностей с учётом риска, — подразумевает связь между статистиками тестов и выбором стратегии, которая в главе явно не раскрывается. Связь такова: три режима, выявляемые спецификацией SADF (устойчивый, с единичным корнем и взрывной), напрямую соответствуют условиям, в которых разные типы торговых сигналов работают лучше всего.
В устойчивом режиме (β < 0, SADF принимает большое по модулю отрицательное значение) процесс характеризуется возвратом к среднему и конечным равновесным уровнем. Период полувозврата к среднему для отклонений от этого уровня можно оценить непосредственно по коэффициенту ADF: период полувозврата к среднему = −log(2) / log(1 + β). В этом режиме теоретически обоснованы сигналы, основанные на чрезмерном отклонении цены от скользящих средних, возврате к среднему от границ полос Боллинджера и возврате спреда к среднему в парной торговле. В устойчивом режиме модель запасов маркет-мейкера корректно поставлена, поскольку спрос и предложение на рынке уравновешиваются при стабильном уровне цены.
Во взрывном режиме (β > 0, SADF резко возрастает) процесс имеет трендовую динамику: согласно модели, его траектория либо продолжит развиваться экспоненциально, либо резко развернётся. В главе подчёркивается, что именно в этом режиме большинство участников оказываются застигнутыми врасплох: те, кто открыл позиции в расчёте на возврат к среднему, торгуют против тренда, и именно вынужденное закрытие этих позиций поддерживает взрывное движение. Подходящая стратегия — следовать за трендом, ограничивать размер позиций из-за неопределённости момента выхода и отслеживать SADF, чтобы заметить первые признаки сжатия множества статистик по расширяющимся окнам {ADF_{t0,t}} — это сигнализирует о том, что пузырь лопается.
Режим с единичным корнем (β ≈ 0, SADF близок к нулю) является наиболее сложным для торговли. В соответствии со спецификацией ADF этот процесс действительно непредсказуем: прошлые цены не содержат никакой информации о будущем направлении движения. В этом режиме случайные входы с близкими стоп-приказами дают такие же результаты, как и любая стратегия, основанная на сигналах, а определяющую роль играют транзакционные издержки. Правильное решение — уменьшить размер позиции и дождаться, пока режим приобретёт определённую направленность.
Этот подход отводит статистикам тестов на структурные сдвиги конкретную роль в матрице признаков, выходящую за рамки простого флага "есть ли структурный сдвиг?". Значение SADF на каждом баре представляет собой непрерывную оценку взрывной динамики; разделение на три режима — устойчивый, с единичным корнем и взрывной — является дискретизацией, выполняемой на последующем этапе. Использование в качестве признаков исходных значений SADF, положения точки структурного сдвига по SDFC и величины превышения статистикой CSW её критического значения позволяет модели машинного обучения выявлять структуру режимов по размеченным данным, а не полагаться на фиксированный порог.
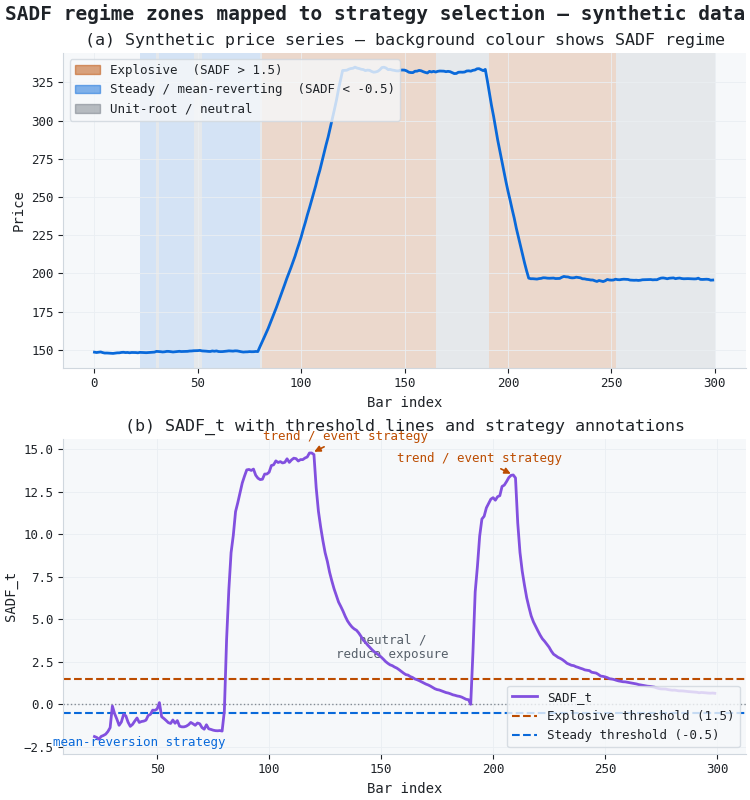
Рисунок 3. Иллюстрация из двух панелей: зоны рыночных режимов по SADF и соответствующий выбор стратегии на синтетических данных
- Панель (a): синтетический ценовой ряд, в котором цвет фона обозначает режим на каждом баре. Оранжевым цветом выделены периоды, когда SADF > 1.5 (взрывной режим); синим — периоды, когда SADF < −0.5 (устойчивый режим с возвратом к среднему); серым — нейтральная зона с единичным корнем.
- Панель (b): SADF_t с пороговыми линиями и метками стратегий. Оранжевые подписи "трендовая / событийная стратегия" обозначают два эпизода взрывной динамики. Синяя подпись "стратегия возврата к среднему" обозначает начальную фазу устойчивого режима. Серая подпись "нейтральная позиция / сокращение рыночной экспозиции" обозначает период между двумя эпизодами взрывной динамики, когда SADF был близок к нулю.
Результаты на синтетических данных
На рисунке ниже показаны результаты применения полного набора тестов к 300 синтетическим барам с двумя искусственно заданными эпизодами взрывной динамики: ралли на барах 80–120 и распродажей на барах 190–210. В обоих эпизодах модуль дрейфа значительно превышает базовый уровень шума.
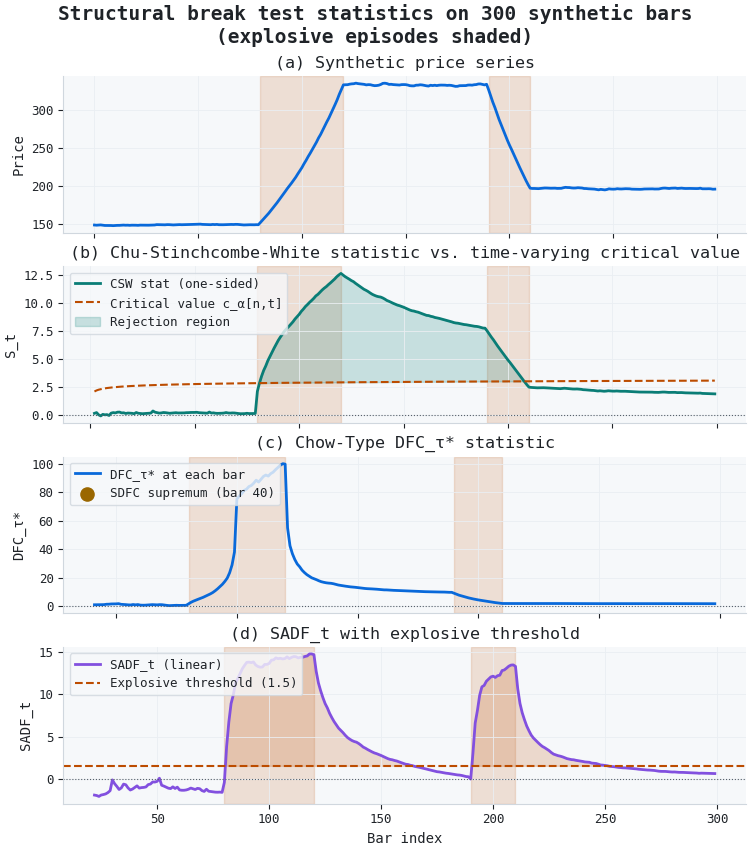
Рисунок 4. Иллюстрация из четырёх графиков со статистиками тестов на структурные сдвиги для 300 синтетических баров с двумя искусственно заданными эпизодами взрывной динамики (выделены оранжевой заливкой)
- График (a): Синтетический ценовой ряд. Первый эпизод взрывной динамики приводит к росту цены примерно со 160 до 300; второй — к быстрому развороту.
- График (b): Односторонняя статистика CSW (синяя сплошная линия) в сравнении с зависящим от времени критическим значением c_{\alpha}[n,t] (оранжевая пунктирная линия). Статистика явно превышает критическое значение во время обоих эпизодов взрывной динамики. Критическое значение медленно растёт по мере увеличения интервала (t − n), соответствующего наилучшему опорному уровню; это означает, что ближе к концу выборки отвергнуть нулевую гипотезу становится сложнее, — такое свойство заложено намеренно, чтобы предотвратить ложные срабатывания из-за накопления данных.
- График (c): Статистика Чоу DFC_{τ*}. Супремум SDFC (золотой маркер) достигается на 190-м баре — в момент начала распродажи, — поскольку смена дрейфа с положительного на отрицательный даёт наибольшее абсолютное значение t-статистики. Это иллюстрирует как преимущество, так и ограничение подхода Чоу: он правильно определяет точку наиболее выраженного структурного сдвига, однако единственное значение SDFC в момент T не позволяет различить два отдельных эпизода.
- График (d): SADF_t с пороговым значением 1.5. Во время обоих эпизодов статистика поднимается в зону взрывной динамики, а между ними возвращается к отрицательным значениям. Второй всплеск (распродажа) более резкий, поскольку в генераторе синтетических данных скорость падения цены при распродаже была выше скорости её роста.
Стоит отдельно рассмотреть следующий результат: статистика CSW на графике (b) остаётся повышенной в течение нескольких баров после окончания первого эпизода взрывной динамики. Такое сохранение повышенного значения ожидаемо, поскольку опорный уровень CSW y_n выбирается равным минимальной исторической цене, найденной при просмотре всё более протяжённого участка ряда назад во времени. После сильного роста наилучшим опорным уровнем по-прежнему остаётся минимум, предшествовавший росту, поэтому отклонение y_t − y_n остаётся большим даже после прекращения роста. Для конвейера формирования признаков такое сохранение повышенного значения информативно: тест показывает, что накопленное отклонение от уровня, предшествовавшего данному режиму, всё ещё статистически значимо, даже если текущее направление движения сменилось на противоположное. Эта информация отличается от той, которую даёт SADF, поэтому включение обеих статистик в матрицу признаков повышает её информативность.
Заключение
В этой статье набор тестов на структурные сдвиги из главы 17 AFML реализован в модуле afml.structural_breaks. Семейство тестов кумулятивных сумм (CUSUM) представлено тестом Чу — Стинчкомба — Уайта, применяемым к уровням ряда. Семейство тестов на взрывную динамику включает тест Дики — Фуллера типа Чоу (DFC), SADF для шести регрессионных моделей, квантильную статистику ADF (QADF) и условное среднее ADF (CADF). Все реализации проверяются набором из 38 тестов, охватывающих форму результатов, математические свойства, результаты регрессий, граничные случаи и численное совпадение с простыми эталонными реализациями.
Фрагменты кода на Python, приведённые в книге, математически корректны, но из-за вычислительных затрат непригодны для работы с рядами реалистичной длины. Каждая из трёх конкретных проблем — обращение к данным по меткам в Pandas со сложностью O(T²) в CSW, многократное создание DataFrame во внутреннем цикле SADF и неявное соглашение о порядке аргументов — требует отдельного исправления. Оптимизированная реализация ускоряет выполнение самых внутренних циклов в 32–50 раз за счёт перехода к предварительно вычисленным массивам NumPy и вычислительному ядру метода наименьших квадратов, скомпилированному с помощью @njit.
Выбор между расширяющимся и скользящим окном для SADF при промышленной эксплуатации зависит от длительности пузырей, которые требуется выявлять. Использование дневных рядов с двухлетней глубиной ретроспективы (L = 504) ограничивает вычислительную сложность величиной O(L²) на бар, сохраняя чувствительность к среднесрочным сменам рыночного режима.
В следующей статье этой серии мы перенесём вычислительные ядра тестов структурных сдвигов на MQL5, реализовав статистики CSW и SADF в виде повторно используемого подключаемого файла в каталоге MQL5/Include/BlueprintQuant/ для применения в торговых советниках.
Список литературы
- López de Prado, M. (2018). Достижения в области финансового машинного обучения. Wiley. Глава 17.
- Phillips, P., Wu, Y., & Yu, J. (2011). Взрывная динамика Nasdaq в 1990-е годы: когда эйфория привела к резкому росту стоимости активов? International Economic Review, 52, 201–226.
- Homm, U., & Breitung, J. (2012). Тестирование на наличие спекулятивных пузырей на фондовых рынках: сравнение альтернативных методов. Journal of Financial Econometrics, 10(1), 198–231.
- Andrews, D. (1993). Тесты на нестабильность параметров и структурные сдвиги с неизвестным моментом сдвига. Econometrica, 61(4), 821–856.
- Phillips, P., Shi, S., & Yu, J. (2013). Тестирование на наличие множественных пузырей, часть 1: исторические эпизоды эйфории и обвалов в индексе S&P 500. Препринт, Сингапурский университет менеджмента.
- Чоу, Г. (1960). Тесты равенства наборов коэффициентов в двух линейных регрессиях. Econometrica, 28(3), 591–605.
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/23158
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


