

Конструирование признаков для машинного обучения (Часть 13): Признаки на основе сканирования трендов в Python
 24
 0

Содержание
- Введение
- Что измеряет сканирование трендов
- Одна функция, два варианта вызова
- Функция-обертка: выделение каузального набора признаков
- Проверка того, что окно, направленное в прошлое, действительно использует только прошлые данные
- Два дефекта, обнаруженных при создании функции-обертки
- Результаты: количественная оценка обоих дефектов
- Результаты вычисления признаков на реалистичных данных
- Правило отбора не обеспечивает выбор по статистической значимости
- Заключение
- Список литературы
- Прикрепленные файлы
Введение
В серии статей «Схема применения машинного обучения в MetaTrader 5» было представлено сканирование трендов как метод разметки: для нескольких проверяемых длин окна оцениваются регрессии методом наименьших квадратов (МНК), выбирается окно с наибольшим абсолютным значением t-статистики, а знак этой статистики используется в качестве метки. Эта функция, trend_scanning_labels, находится в модуле afml.labeling.trend_scanning и с тех пор не менялась. В этой статье меняется вопрос, на который должна ответить эта функция. Метка отвечает на вопрос «что произошло после этого бара». Признак должен отвечать на вопрос «что можно было знать на этом баре», и одну и ту же функцию можно настроить для ответа на любой из этих вопросов, поскольку оба направления доступны через один аргумент.
Это иной тип ошибки, чем те, которые до сих пор рассматривались в этой серии. В части 11 была обнаружена утечка будущих данных, обусловленная самим использованием центрированного скользящего окна, причем каузальный режим вообще не был предусмотрен, а в части 12 исправленные каузальные фрактальные признаки были перенесены в реализацию на MQL5. Здесь каузальный вариант уже предусмотрен: lookforward=False — это полноценный, протестированный вариант выполнения кода. Риск заключается в использовании значения по умолчанию, подходящего для разметки, при построении матрицы признаков. Ничто в сигнатуре функции не препятствует успешному выполнению вызова. Она возвращает корректно сформированный DataFrame, который выглядит правильно.
В этой статье функция trend_scanning_labels обёрнута в интерфейс исключительно для вычисления признаков, который устраняет саму возможность выбора, а не просто документирует её. В статье измеряется утечка будущих данных, вызванная неправильным выбором, и описывается второй, не связанный с ней дефект, который возникает при применении функции к входному ряду, допускающему отрицательные значения, вместо исходных цен.
В статье также рассматривается третий вывод, не связанный ни с одним из двух описанных выше дефектов и касающийся метода, а не кода. Правило выбора среди проверяемых окон не выбирает статистически наиболее значимый тренд, а возвращаемую им t-статистику для ценовых данных нельзя оценивать по номинальному пороговому значению распределения Стьюдента. Оба утверждения подтверждаются с помощью моделирования.
Что измеряет сканирование трендов
Для окна длиной L, заканчивающегося (или начинающегося) на некотором баре, функция оценивает регрессию цены на временной индекс с помощью метода наименьших квадратов (МНК) и сохраняет три значения: коэффициент наклона, коэффициент детерминации R² и t-статистику коэффициента наклона. Функция повторяет эту процедуру для каждого L в проверяемом диапазоне и сохраняет окно с наибольшим модулем t-статистики. Знак t-статистики указывает направление. Её модуль показывает, насколько уверенно прямая линия описывает данные в окне, с учётом числа точек, использованных при оценивании (Лопес де Прадо, лекция 3/10).
Результат отличается от коэффициента наклона, рассчитанного по окну фиксированной длины, одной полезной особенностью: длина окна выбирается для каждого бара, а не фиксируется для всего ряда. И резкое движение за два бара, и слабый дрейф на протяжении двенадцати баров могут определяться как сильный тренд при разных L, причём ни один из них не ослабляется из-за принудительного использования одной и той же длины окна в обоих случаях.
Ядро Numba _window_stats_numba, выполняющее оценивание, вычисляет все три статистики на основе одного и того же набора накапливаемых сумм за один проход по каждому окну, что делает практически осуществимым перебор десятка и более проверяемых длин окна на тысячах баров:
@njit(parallel=True, cache=True)
def _window_stats_numba(y, window_length):
    n = len(y)
    num_windows = n - window_length + 1
    t_values = np.empty(num_windows)
    slopes   = np.empty(num_windows)
    r_squared = np.empty(num_windows)

    t = np.arange(window_length)
    mean_t = t.mean()
    Var_t  = ((t - mean_t) ** 2).sum()

    for i in prange(num_windows):
        window = y[i : i + window_length]
        mean_y = window.mean()
        S_ty   = (window * t).sum()
        slope  = (S_ty - window_length * mean_t * mean_y) / Var_t
        # SSE, R², and the t-value follow from the same running sums
        ...
До и после этого вычислительного ядра выполняются два этапа маскирования, о которых стоит упомянуть до раздела 3, поскольку оба остаются неизменными при любом варианте вызова. volatility_threshold обнуляет результаты для любого окна, локальное стандартное отклонение которого ниже квантиля, вычисленного по расширяющемуся окну, поэтому на ровном участке с низкой волатильностью шум округления не может создать ложный тренд. При этом t-статистика окна учитывается при определении ненулевого знака только при выполнении двух условий: волатильность окна должна превышать указанный нижний порог, а сама t-статистика на последующем этапе — превышать по модулю порог 1e-6.
Одна функция, два варианта вызова
Направление подгонки полностью определяется параметром lookforward. При значении True, установленном по умолчанию, из допустимого диапазона исключаются только последние max(span) баров, а каждое окно начинается на текущем баре и направлено в будущее:
if lookforward:
    valid_indices = close.index[:-max_hrzn].to_list()
else:
    valid_indices = close.index[max_hrzn - 1 :].to_list()
Окно, направленное в будущее, подходит для разметки: смысл метки как раз в том, чтобы описывать происходящее после события, к которому она привязана. Для признака же нужно окно, направленное в прошлое: оно заканчивается на баре, к которому относится признак, поэтому все данные в нём уже доступны на этот момент времени.
Чтобы реализовать окно, направленное в прошлое, на основе того же ядра, работающего только с окнами, направленными в будущее, ряд разворачивают, выполняют ту же подгонку по окнам, а затем разворачивают результат обратно:
y_window = y if lookforward else y[::-1]
t_vals, slopes, r_sq = _window_stats_numba(y_window, hrzn)
if not lookforward:
    t_vals, slopes, r_sq = t_vals[::-1], slopes[::-1], r_sq[::-1]
    start_idx = hrzn - 1
else:
    start_idx = 0
Это единственное место в функции, где легко допустить ошибку в расчётах индексов, которая останется незамеченной: развёрнутый массив, помещённый обратно с неверным смещением, всё равно даст целый столбец правдоподобных чисел. Корректность смещения проверяется напрямую, а не принимается на веру.
В обоих направлениях возвращаются одни и те же семь столбцов — t1, window, slope, t_value, rsquared, ret, bin — поскольку изначально функция была написана для одной задачи, а режим с окнами, направленными в прошлое, добавили как опцию, сохранив структуру результата. Три из этих столбцов описывают исход, для объяснения которого было выбрано окно, а не свойство, доступное на момент времени, к которому относится сам признак; это различие сохраняется при изменении параметра lookforward.
Функция-обертка: выделение каузального подмножества признаков
Решение не в том, чтобы менять функцию trend_scanning_labels, которая корректно выполняет свою исходную задачу и именно для неё используется в других статьях этой серии. Вместо этого для вычисления признаков нужно создать отдельную точку входа, через которую нельзя задать неверное направление окна:
def get_trend_scanning_features(close, span=(5, 20), volatility_threshold=0.0,
                              use_log=True):
    """Causal trend-scanning features: window, slope, t_value, rsquared."""
    raw = trend_scanning_labels(
        close, span=span, volatility_threshold=volatility_threshold,
        lookforward=False, use_log=use_log,
    )
    return raw.drop(columns=["t1", "ret", "bin"])
В этой функции отсутствует параметр lookforward, и именно в этом заключается суть. Функция-обертка, которая принимала бы этот аргумент со значением False по умолчанию, всё равно позволяла бы вызывающему коду передать True и вновь создать утечку будущих данных, изменив значение всего одного именованного аргумента. Удаление параметра исключает возможность такого вызова.
Три исключённых столбца не ошибочны — они отвечают не на тот вопрос, который нужен для матрицы признаков. t1 и ret описывают конечную точку выбранного окна и доходность за это окно; в каузальном направлении конечная точка совпадает с самим t и потому избыточна, тогда как в направлении в будущее, используемом для разметки, эти столбцы описывают именно предсказываемый исход. bin — это метка. Включение любого из этих трёх столбцов в X при использовании y, сформированного той же функцией, — это аналог смешения ролей min_ret, описанного в статье о транзакционных издержках, но уже применительно к сканированию трендов: одна и та же величина выполняет две разные задачи, которые смешиваются из-за общего имени переменной.
Проверка того, что окно действительно направлено в прошлое
Доверять приёму с разворотом ряда и переиндексацией без проверки — именно та привычка, против которой выступает эта серия статей. Нужно проверить утверждение о том, что в позиции t результата для окон, направленных в прошлое, содержится результат подгонки по данным close[t-L+1 : t+1], без использования данных начиная с t+1.
Проверка проста: запустите функцию на одном и том же ряде для окон, направленных в будущее и в прошлое, и убедитесь, что результат для окна, направленного в прошлое, на баре t совпадает с результатом для окна, направленного в будущее, на баре t-L+1 при соответствующей длине окна, поскольку оба результата описывают один и тот же участок ценового ряда, подгонка по которому выполняется в одном и том же направлении.
fwd = trend_scanning_labels(close, span=(5, 20), lookforward=True)
bwd = trend_scanning_labels(close, span=(5, 20), lookforward=False)

# bwd.loc[t] used window [t-L+1, t]; the forward call that fit the same
# span starts its window at t-L+1, so it is indexed there, not at t
L = bwd.loc[t, "window"]
match = fwd.loc[t - L + 1, ["slope", "t_value", "rsquared"]]
assert np.allclose(bwd.loc[t, ["slope", "t_value", "rsquared"]], match)
При проверке на синтетическом ряде это равенство выполнялось с точностью вычислений с плавающей запятой на каждом баре, для которого при одной и той же длине окна существовали результаты подгонки как по окну, направленному в будущее, так и по окну, направленному в прошлое. Разворот ряда реализован правильно; риск, описанный в остальной части статьи, связан исключительно с тем, как вызывается функция, а не с её вычислительным ядром.
Два дефекта, обнаруженных при создании функции-обертки
6.1 Ничто в API не позволяет различить эти два варианта использования
Сигнатура функции trend_scanning_labels не указывает на то, что режим lookforward=True небезопасен при формировании матрицы признаков. В строке документации функция описана как метод разметки, но список параметров, форма возвращаемого результата и имена столбцов одинаковы для обоих направлений окон, и у читателя, формирующего матрицу признаков по аналогии с функциями-обертками для фрактальных или энтропийных показателей из предыдущих статей серии, не было бы оснований ожидать, что четвёртый аргумент настолько важен. Измеряется результат вызова с настройками по умолчанию.
6.2 Параметр use_log незаметно меняет интерпретацию входных данных, допускающих отрицательные значения
Параметр самой функции называется close, а строка документации функции предполагает, что на вход подаётся исходный ценовой ряд со строго положительными значениями. Ничто не обеспечивает соблюдение этого требования. Ещё один естественный способ применения сканирования трендов в рамках этой серии — применить его к уже сконструированному столбцу признаков, допускающему отрицательные значения, например к результату FFD или ряду доходностей, чтобы определить, есть ли тренд в самом этом столбце. При настройке по умолчанию use_log=True функция перед логарифмированием заменяет все значения ниже 1e-8 этой нижней границей отсечения:
if use_log:
    close_processed = close.clip(lower=1e-8).astype(np.float64)
    y = np.log(close_processed).values
В ряде, пересекающем нуль, все отрицательные значения превращаются в одну и ту же константу ещё до выполнения подгонки. При этом исключения не возникают, форма выходных данных не меняется, а возвращаемые числа выглядят как обычные t-статистики.
Результаты: количественная оценка обоих дефектов
Оба дефекта были оценены количественно, а не просто заявлены. Утечку будущих данных проверяли на синтетических случайных блужданиях длиной 3 000 баров, используя двадцать начальных значений генератора случайных чисел; при этом в процессе генерации данных нигде не было заложено истинного тренда. Для каждого бара знак t-статистики, полученной при сканировании трендов, сопоставляли с направлением изменения цены закрытия следующего бара: выше она или ниже текущей. На чистом шуме доля совпадений при таком сравнении должна составлять 50 %; любое устойчивое отклонение указывает на утечку будущих данных, поскольку в этом процессе нечего предсказывать.
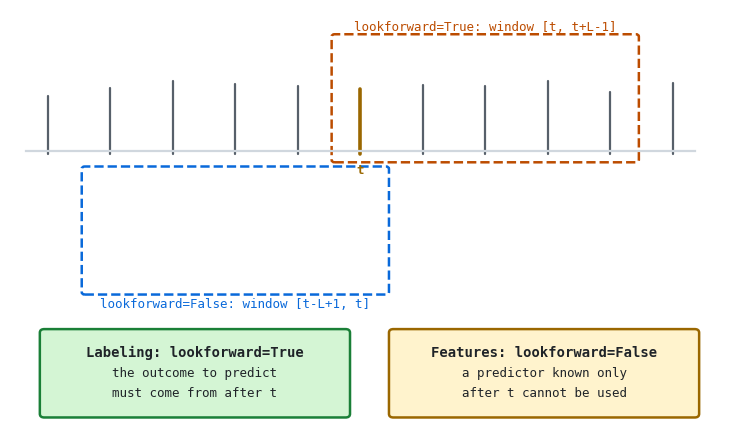
Рисунок 1. Однопанельная иллюстрация окон, направленных в будущее и в прошлое, которые формирует одна и та же функция
- Вверху: рассматриваемый бар t и показанные относительно него окно, направленное в будущее, [t, t+L-1] и окно, направленное в прошлое, [t-L+1, t].
- Внизу: окно, направленное в будущее, — правильный выбор для разметки, поскольку метка может описывать будущее. Окно, направленное в прошлое, — единственный правильный выбор для признака.
При изменении максимального проверяемого горизонта от 8 до 32 баров доля совпадений с направлением следующего бара в режиме с утечкой будущих данных составляет от 56 % до 61 % во всём диапазоне, тогда как в каузальном режиме она остаётся в пределах 49.9–50.1 % при каждой настройке:
Максимальный горизонт | С утечкой будущих данных (lookforward=True) | Каузальный (lookforward=False) | Разрыв |
|---|---|---|---|
| 8 | 0.6102 | 0.5004 | 0.1098 |
| 12 | 0.5912 | 0.4997 | 0.0915 |
| 16 | 0.5809 | 0.4992 | 0.0817 |
| 20 | 0.5746 | 0.5014 | 0.0732 |
| 26 | 0.5644 | 0.5013 | 0.0631 |
| 32 | 0.5584 | 0.4999 | 0.0585 |
По мере увеличения горизонта разрыв сужается, а не расширяется. Это противоположно динамике, наблюдавшейся при утечке будущих данных из-за центрированного скользящего окна в части 11; важно точно описать это различие, а не пытаться подогнать результат под прежнюю закономерность. Этот тест проверяет совпадение направления только для одного следующего бара. По мере расширения диапазона проверяемых горизонтов оптимизатор всё чаще выбирает более длинные окна для максимизации |t-статистики|, а результат подгонки на более длинном окне слабее коррелирует с любым отдельным баром внутри него, в том числе со следующим. Утечка будущих данных не уменьшается; уменьшается лишь та её доля, которую выявляет тест на один бар вперёд.
Второй дефект оценивали на синтетическом ряде с возвратом к среднему, имитирующем столбец FFD или доходности: в нём значения на 44.7 % баров ниже нижней границы отсечения 1e-8 и перед логарифмическим преобразованием заменяются одной и той же константой. При сравнении полученных t-статистик с t-статистиками подгонки на том же ряде при use_log=False, с каузальным вычислением в обоих случаях, знаки не совпадают на 18.3 % баров, а корреляция между двумя рядами t-статистик составляет 0.80, а не 1.0.
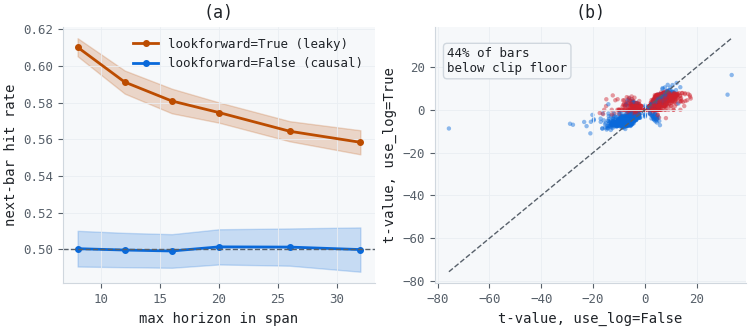
Рисунок 2. Иллюстрация из двух панелей, демонстрирующая оба дефекта на основе измерений, а не голословных утверждений
- Панель (a): доля совпадений с направлением следующего бара на данных чистого случайного блуждания при переборе значений максимального проверяемого горизонта; затененная область показывает разброс в одно стандартное отклонение по двадцати начальным значениям генератора случайных чисел.
- Панель (b): t-статистика при логарифмическом преобразовании по умолчанию в сравнении с t-статистикой линейной аппроксимации того же ряда, допускающего отрицательные значения; цвет показывает, было ли значение входного ряда на данном баре ниже нижней границы отсечения.
Полученные признаки на реалистичных данных
Результаты работы функции-обертки на синтетическом ряде из 500 баров с тремя искусственно заданными режимами дрейфа показывают, что выбор оптимального окна и коэффициент детерминации R² ведут себя ожидаемым образом: в режимах дрейфа выбираются короткие окна с уверенно выраженным трендом, а между ними — более длинные и зашумленные.
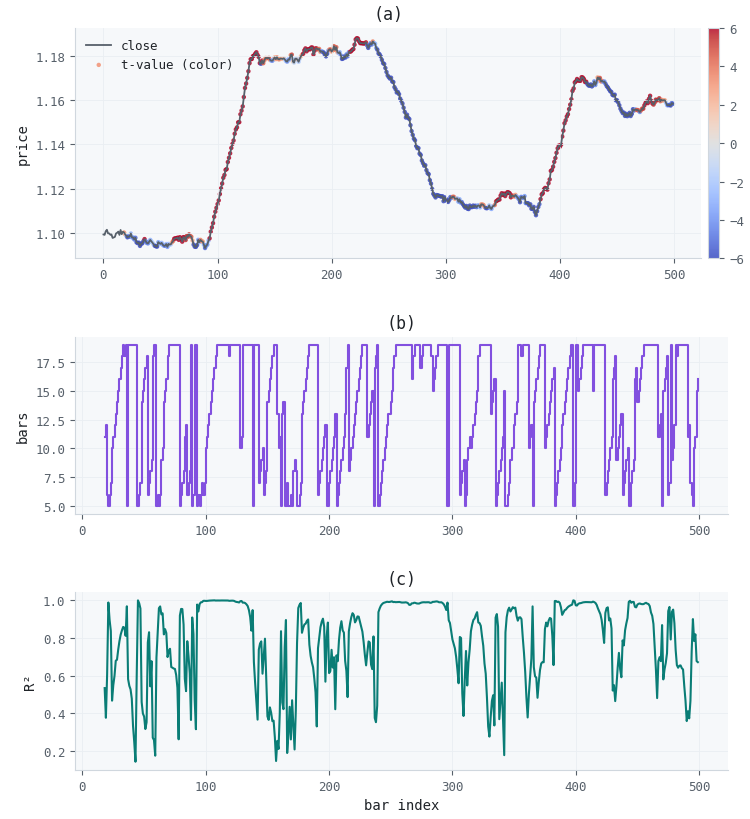
Рисунок 3. Иллюстрация из трех панелей, демонстрирующая результаты работы функции-обертки на 500 синтетических барах
- Панель (a): цена закрытия с цветовой разметкой по t-статистике на каждом баре, рассчитанной только по информации, доступной к этому бару.
- Панель (b): длина окна, выбранная на этапе argmax; она изменяется ступенчато в зависимости от того, указывают ли данные на предпочтительность аппроксимации по более короткому или более длинному окну.
- Панель (c): коэффициент детерминации R² для выбранного окна, более высокий на трех искусственно заданных участках с дрейфом, чем на окружающих шумовых участках.
В этом разделе разъясняется, что именно подтверждают полученные результаты, а что — нет. Режимы были заданы искусственно, поэтому панели (b) и (c) подтверждают лишь то, что оптимизатор находит более качественную аппроксимацию там, где для нее были созданы условия, и ничего больше. Это ничего не говорит о том, как эти признаки будут вести себя при наличии реальной структуры в данных: данный вопрос относится к этапу моделирования, а не к этапу конструирования признаков.
Правило отбора не обеспечивает отбор по статистической значимости
До сих пор мы исходили из корректности самой функции trend_scanning_labels и подтвердили, что режим с окном, направленным в прошлое, работает корректно. В этом разделе речь идет о другом: о правиле, по которому функция выбирает среди проверяемых окон, для каждого из которых строит аппроксимацию; оно корректно реализует описание из раздела 5.4 книги «Машинное обучение для управляющих активами», но не выполняет того, что ему приписывается в этом разделе.
Правило — argmax|t|: построить аппроксимацию для каждого горизонта в заданном диапазоне и оставить тот, у которого модуль t-статистики максимален.
best_j = np.nanargmax(np.abs(t_block), axis=1)
t-статистику сопоставляют с распределением Стьюдента с L - 2 степенями свободы, причем форма этого распределения зависит от L. Для окна из пяти баров распределение имеет три степени свободы и тяжелые хвосты; для окна из сорока баров — тридцать восемь степеней свободы и близко к нормальному. Поэтому одно и то же числовое значение t-статистики отражает разную силу статистических свидетельств в зависимости от окна, в котором оно получено, а выбор максимума среди исходных значений t-статистики означает сравнение величин, измеренных в разных шкалах. Он систематически отдаёт предпочтение самым коротким окнам в рассматриваемом диапазоне.
Детерминированный ряд показывает, насколько велик этот эффект. Возьмём y[i] = 100 + 0.05i + 3sin(0.3i), оценим регрессию по логарифму цены и рассмотрим каждое окно длиной от 5 до 40 баров, заканчивающееся на баре 199:
L= 5: t=-12.840  p=1.02e-03   # selected by argmax|t|
L=20: t= +6.572  p=3.57e-06   # 286x more significant, discarded
Это правило выбирает окно с p-значением примерно в 286 раз больше. Эти два окна также дают противоположные направления: регрессионная прямая на пятибарном окне направлена вниз, а на двадцатибарном — вверх, поэтому опубликованное правило указывает на нисходящий тренд на баре, для которого более веские статистические свидетельства указывают на рост. Это не специально сконструированный предельный случай — такая ситуация возникает всякий раз, когда кратковременный разворот происходит в рамках более длительного движения, что на внутридневных данных встречается часто.
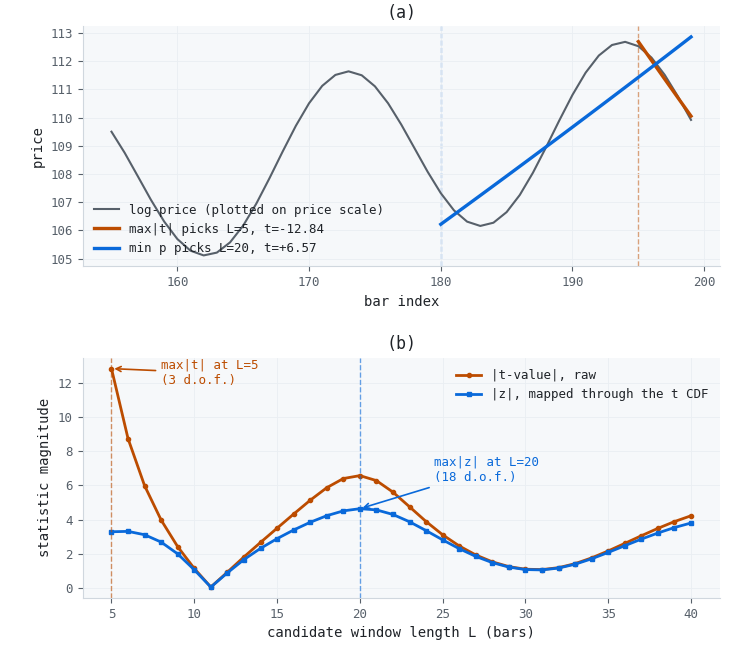
Рисунок 4. Иллюстрация из двух панелей, показывающая, как два правила выбора приводят к противоположным выводам на одном баре
- Панель (a): пятибарное окно, выбранное по исходному правилу, и двадцатибарное окно, выбранное с учётом поправки на длину; оба окна заканчиваются на одном и том же баре, а оценённые на них тренды направлены в противоположные стороны.
- Панель (b): значения обеих статистик во всём диапазоне проверяемых горизонтов; максимум исходной абсолютной t-статистики приходится на короткие окна, а максимум скорректированной статистики — на окна длиной около двадцати баров.
Скорректированное правило всего на одну строку кода длиннее того, которое оно заменяет. Преобразование t-статистики каждого проверяемого горизонта в p-значение перед сравнением устраняет зависимость от длины окна, поскольку p-значения уже выражены на общей шкале:
from scipy import stats

# t_block has shape (n_events, n_horizons); each column carries its own
# degrees of freedom, so the survival function is evaluated per column.
df = np.asarray(hrzns) - 2
p_block = 2.0 * stats.t.sf(np.abs(t_block), df[None, :])
best_j = np.nanargmin(p_block, axis=1)
Функция-обертка предоставляет этот выбор через аргумент selection, не меняя поведение по умолчанию, поэтому уже построенные на её основе конвейеры сохраняют то поведение, для которого они проходили проверку. selection="max_abs_t" в точности воспроизводит опубликованное правило; selection="min_p" применяет поправку. Все сохранённые признаки сканирования трендов из предыдущего запуска следует пересчитать, прежде чем смешивать результаты двух вариантов выбора, поскольку могут различаться как выбранное окно, так и знак тренда.
9.1 Номинальное пороговое значение — вторая, более серьёзная проблема
Исправление процедуры сравнения окон не делает полученное p-значение достоверным. Метод наименьших квадратов (МНК) предполагает независимость остатков во времени, а уровни цен являются интегрированными рядами первого порядка, поэтому после оценивания тренда остаются сильно автокоррелированные остатки. Стандартная ошибка занижена, а t-статистика завышена. Это проблема ложной регрессии, описанная Грейнджером и Ньюболдом в 1974 году; она возникает при оценивании тренда по времени точно так же, как при регрессии между двумя несвязанными случайными блужданиями.
Сканирование двадцати тысяч случайных блужданий без дрейфа, каждое из которых содержит 260 наблюдений, по окнам длиной от 5 до 40 баров дает следующие результаты. 95-й процентиль максимального абсолютного значения t-статистики составляет 21.04, а 99-й — 28.24, тогда как номинальное пороговое значение для двустороннего теста на уровне значимости 5 % при 38 степенях свободы равно 2.024. При применении номинального порогового значения к этим рядам без тренда 99.94 % баров классифицируются как имеющие статистически значимый тренд.
Тот же эксперимент с независимым шумом вместо случайного блуждания дает 4.22 при сканировании и 2.03 для одного окна длиной 40 баров. Второе значение, совпадающее с номинальным пороговым значением 2.024, служит контрольным результатом: расчет t-статистики выполнен правильно, а завышение ее значений на данных, подобных ценовым рядам, обусловлено свойствами самих данных, а не дефектом реализации.
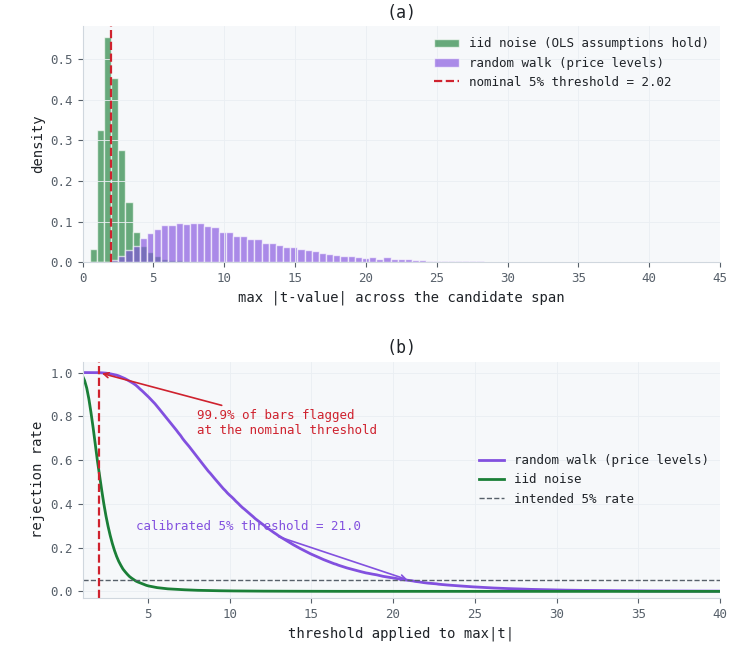
Рисунок 5. Два графика, иллюстрирующих статистику сканирования при нулевой гипотезе об отсутствии тренда
- График (a): распределение максимального абсолютного значения t-статистики по диапазону проверяемых горизонтов для независимого шума и случайного блуждания в сравнении с номинальным пороговым значением для уровня значимости 5 %.
- График (b): доля баров без тренда, для которых тренд признан статистически значимым, в зависимости от применяемого порогового значения; отмечена точка, соответствующая откалиброванному уровню 5 %.
Важно разделить завышение на составляющие, поскольку от этого зависит способ его устранения. Для одного окна длиной 40 баров на случайном блуждании 95-й процентиль абсолютного значения t-статистики уже достигает 17.32. Сканирование 36 окон с выбором максимального абсолютного значения повышает этот показатель лишь до 21.04, то есть примерно в 1.21 раза. Почти все искажение обусловлено оцениванием тренда по интегрированному ряду; лишь небольшая оставшаяся часть связана с перебором горизонтов. Поэтому поправка на множественные проверки с учетом числа горизонтов, например поправка Бонферрони или Шидака, скорректировала бы меньший эффект, оставив больший без изменений.
Действенный подход — моделировать именно ту статистику, которая фактически используется в качестве результата. Сгенерируйте случайное блуждание без дрейфа из max(L) приращений, вычислите статистику для каждого окна из заданного диапазона, направленного в прошлое, сохраните максимум, повторите процедуру несколько тысяч раз и используйте верхние квантили в качестве пороговых значений. Поскольку статистика на баре зависит только от последних max(L) наблюдений, для каждого повторения достаточно истории такой длины; благодаря этому калибровка требует достаточно мало вычислительных ресурсов, чтобы выполнять ее один раз для каждой конфигурации и кэшировать результат.
Здесь следует сделать две оговорки. Случайное блуждание без дрейфа — это удобная модель нулевой гипотезы, а не корректная модель цены, поэтому оно позволяет откалибровать пороговые значения, но не даёт точного статистического критерия; модель нулевой гипотезы с тяжёлыми хвостами или кластеризацией волатильности дала бы другие пороговые значения. При этом откалиброванное пороговое значение позволяет установить лишь то, что наблюдаемый тренд сильнее, чем обычно бывает в ряду той же длины без тренда. Из этого не следует никаких выводов о следующем баре.
Для разметки всё это не критично. Метки сканирования трендов используются как целевая переменная, и слишком частое появление определённой метки — это проблема баланса классов, а не корректности метода; ничто из описанного в этом разделе не затрагивает предыдущие статьи этой серии, в которых используются эти метки. Это становится существенным, как только t-статистику используют как признак, сравнивают с фиксированным пороговым значением или трактуют как свидетельство наличия реального тренда — именно к такому использованию располагает функция get_trend_scanning_features, и именно поэтому данное исправление должно быть описано в этой статье, а не в примечании к части 3.
Заключение
Модуль сканирования трендов отличается от других модулей, рассмотренных до сих пор в этой серии, тем, что в нём уже реализован корректный каузальный режим; риск связан не с отсутствием исправления, а с тем, что назначение режима по умолчанию не обозначено. lookforward=True подходит для разметки, но не для вычисления признаков, а сигнатура функции никак не указывает, какой из этих случаев относится к конкретному вызову. Функция get_trend_scanning_features не документирует этот выбор, а устраняет его, вообще не предоставляя доступа к параметру.
Влияние двух дефектов было измерено непосредственно, а не выведено из анализа кода. Использование функции с настройками по умолчанию, предназначенными для разметки, в качестве генератора признаков завышает долю совпадений с направлением следующего бара с 50 % до 61 % на данных без реального тренда; при этом наблюдаемая величина эффекта уменьшается с увеличением проверяемого горизонта, хотя сама утечка будущих данных не уменьшается. Если оставить логарифмическое преобразование включённым для входного ряда, допускающего отрицательные значения, значения 44.7 % баров сводятся к одной и той же константе, а знак результата меняется почти у пятой части выходных значений.
Механизм разворота порядка элементов и переиндексации, обеспечивающий работу режима с окном, направленным в прошлое, не был принят на веру: его непосредственно проверили сравнением с результатами режима с окном, направленным в будущее, и результаты совпали в пределах точности вычислений с плавающей запятой.
Отдельно от двух описанных выше дефектов, правило выбора окна, унаследованное этим модулем от опубликованного метода, сравнивает t-статистики, рассчитанные при разном числе степеней свободы. В результате это правило может не выбрать наиболее статистически значимый тренд и даже указать противоположное направление; в разобранном примере различие оказалось 286-кратным. Сама t-статистика при расчёте по уровням цен завышена настолько, что для 99.94 % баров случайного блуждания без тренда она превышает номинальное пороговое значение для пятипроцентного уровня значимости. Оба исправления реализованы в виде необязательного аргумента selection и процедуры калибровки, а не изменений поведения по умолчанию, поэтому конвейеры обработки, уже построенные на основе этой функции-обертки, сохраняют поведение, для которого они прошли валидацию.
Во второй статье из этой пары набор каузальных признаков будет перенесён на MQL5, где необходимо сохранить то же различие между окнами, направленными в будущее и в прошлое, но уже без возможности прибегнуть к развороту массива.
Список литературы
- Лопес де Прадо, М. Достижения в области финансового машинного обучения: лекция 3 из 10.
- Лопес де Прадо, М. (2018). Достижения в области финансового машинного обучения. Wiley.
- Лопес де Прадо, М. (2020). Машинное обучение для управляющих активами, раздел 5.4. Издательство Кембриджского университета.
- Грейнджер, К. У. Дж. и Ньюболд, П. (1974). Ложные регрессии в эконометрике. Journal of Econometrics, 2(2), 111–120.
Прикрепленные файлы
Файл | Модуль | Описание | |
|---|---|---|---|
| 1. | trend_scanning.py | afml.labeling | trend_scanning_labels и ядро Numba _window_stats_numba в исходном виде. Включено для справки, поскольку функция get_trend_scanning_features вызывает её напрямую с параметром lookforward=False. |
| 2. | trend_scanning_features.py | afml.features.trend_scanning | get_trend_scanning_features: каузальная функция-обертка без параметра lookforward, возвращающая window, slope, t_value, rsquared. |
| 3. | measure_leak.py | Проверка | Тест доли совпадений с направлением следующего бара на данных случайного блуждания: сравнение режима с утечкой будущих данных и каузального режима при двадцати начальных значениях генератора случайных чисел. |
| 4. | horizon_sweep.py | Проверка | Повторяет проверку доли совпадений с направлением следующего бара для шести значений максимального горизонта; строит рисунок 2(a). |
| 5. | measure_log_defect.py | Проверка | Количественно оценивает вырождение ряда с возвратом к среднему, допускающего отрицательные значения, после отсечения и логарифмирования; строит рисунок 2(b). |
| 6. | trend_scanning_selection.py | afml.features.trend_scanning | Выбор окна с поправкой на длину (select_horizon, signed_z) и калибровка порогового значения на основе случайного блуждания (calibrate_threshold). Добавляет в функцию-обертку аргумент selection, не меняя ее режим работы по умолчанию. |
| 7. | MQL5.zip | Архив | Все семь указанных выше файлов необходимо распаковать в папку MQL5\Files\TrendScanningFeatures\. Распакуйте архив, в корне которого находится папка MQL5, непосредственно в каталог данных терминала. |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/23659
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


