

Фундаментальные модели для торговли (Часть II): Декодирование, авторегрессия и точный KV-кэш
 42
 0

Введение
В части 1 мы создали и проверили первую половину нативной реализации Kronos на MQL5: перенос весов из PyTorch, предобработку, бинарное сферическое квантование, преобразующее свечу в пару иерархических токенов, и блок трансформера, собранный из элементарных матричных операций. Кодировщик в точности воспроизвел эталонные токены. Мы остановились на этапе, когда окно свечей уже преобразовано в последовательность токенов.
В этой части мы переходим ко второй половине модели. Мы создаем декодировщик, преобразующий токены обратно в свечи, предиктор, пошагово генерирующий новые токены, и авторегрессионный цикл, объединяющий их работу в прогноз на несколько баров. По ходу работы мы сталкиваемся с неочевидными подводными камнями, требующими серьезной отладки: блок перекрестного внимания с иным числом голов, чем в остальной модели, ротационным эмбеддингом, поворачивающим все ключи с использованием одной и той же позиции, и эмбеддингом, который в одном месте масштабируется, а в другом остается немасштабированным. Каждая из этих ошибок не вызывает сбоев при выполнении, но незаметно искажает результат.
Затем мы ускоряем реализацию. Первая рабочая реализация формировала прогноз настолько медленно, что ее использование в реальном исследовании было непрактичным. Две доработки вместе сократили время одного шага примерно в 4,5 раза: кэш ключей и значений, устраняющий повторные вычисления в цикле, и исправление транспонирования весов. Последнюю проблему профилировщик выявил там, где интуиция не подсказала бы искать. К концу этой части весь пайплайн работает от начала до конца, а результаты каждого этапа сверены с эталонными результатами PyTorch: на вход подается окно свечей, на выходе получается прогноз на несколько баров в исходных ценовых единицах.
Мы рассмотрим следующие темы:
- От токенов обратно к свечам — декодировщик
- Иерархический эмбеддинг предиктора
- Загрузка весов предиктора
- decode_s1 — предсказание грубого токена
- decode_s2 и подводные камни перекрестного внимания
- Сэмплирование следующего токена
- Авторегрессионный цикл
- KV-кэш, сохраняющий точность
- Ускорение вычислений — профилирование и предварительно транспонированные веса
- Заключение
От токенов обратно к свечам — декодировщик
Декодировщик зеркально повторяет архитектуру кодировщика из части 1 и использует те же компоненты трансформера. Если кодировщик преобразует шесть признаков в 20-битный код, то декодировщик преобразует код обратно в шесть признаков. Получив два идентификатора токенов для каждого бара, декодировщик восстанавливает биполярный код BSQ, проецирует его в пространство размерности модели, пропускает через стек каузальных блоков и выполняет выходную проекцию в нормированные признаки бара OHLCVA.
//+---------------------------------------------------------------+
//| Decode hierarchical token ids into a normalized OHLCVA window.|
//|   s1_ids,s2_ids : input token ids, length L                   |
//|   recon_norm    : output (L, 6), still z-scored (denormalize  |
//|                   separately with the window's mean/std)      |
//+---------------------------------------------------------------+
bool              Decode(const int &s1_ids[], const int &s2_ids[], matrix &recon_norm)
  {
   int L = ArraySize(s1_ids);
   if(L == 0 || ArraySize(s2_ids) != L)
     { PrintFormat("CKronosDecoder::Decode: bad id lengths (%d / %d)", L, ArraySize(s2_ids)); return false; }

//--- indices_to_bits (half): each row is the 20-dim bipolar code (LSB-first)
   matrix code = matrix::Zeros((ulong)L, KR_CODEBOOK_DIM);
   double row[];
   for(int t = 0; t < L; t++)
     {
      KronosBSQ_IndicesToCode(s1_ids[t], s2_ids[t], row);   // verified BSQ math
      for(int k = 0; k < KR_CODEBOOK_DIM; k++)
         code[t][k] = row[k];
     }
//--- post_quant_embed: 20 -> d_model
   matrix z = LinearT(code, m_pqW);
   AddRowBias(z, m_pqB);
//--- (n_dec_layers - 1) causal pre-norm blocks
   for(int b = 0; b < m_blocks; b++)
      z = TransformerBlock(z, m_n1[b],
                           m_Wq[b], m_bq[b], m_Wk[b], m_bk[b],
                           m_Wv[b], m_bv[b], m_Wo[b], m_bo[b],
                           m_heads, m_n2[b], m_W1[b], m_W3[b], m_W2[b]);
//--- head: d_model -> 6 (normalized OHLCVA)
   recon_norm = LinearT(z, m_headW);
   AddRowBias(recon_norm, m_headB);
   return true;
  }
Вызов KronosBSQ_IndicesToCode использует те же проверенные математические преобразования BSQ из части 1, но в обратном направлении: каждый бит преобразуется в биполярное значение на гиперсфере. Далее структура совпадает со структурой кодировщика: формирование эмбеддинга, блоки и проекция. Отличий два. Входная проекция — post_quant_embed (из 20 измерений в размерность модели) вместо embed (из 6 измерений в размерность модели); выходная — head (из размерности модели в 6 измерений), формирующая восстановленный бар. Здесь действует та же особенность подсчета блоков, что и в токенизаторе: их число равно n - 1, поэтому при заданных четырех слоях декодировщика получается три блока.
Выходные данные пока остаются нормированными. Чтобы получить цены, вызывающий код выполняет обратное преобразование с использованием среднего и стандартного отклонения исходного контекстного окна — тех самых статистик, которые были сохранены при предобработке.
Проверка продолжается по той же схеме, что в части 1, но с одним изменением. У кодировщика проверялись дискретные идентификаторы токенов — на точное равенство целочисленных значений. Все проверяемые в этой части результаты — восстановленные декодировщиком данные, логиты s1 и логиты s2 — имеют непрерывные значения, поэтому средства проверки вместо точного равенства проверяют, не превышает ли максимальная абсолютная ошибка небольшой допуск. Например, KronosVerifyDecoder загружает эталонный массив recon_norm, запускает реализацию декодировщика на MQL5 с теми же токенами и находит ячейку с наибольшей ошибкой:
//--- float comparison: max-abs and mean-abs error, plus worst cell
double maxerr = 0.0, sumerr = 0.0;
int wr = -1, wc = -1;
for(int i = 0; i < L; i++)
   for(int j = 0; j < KR_NFEAT; j++)
     {
      double e = MathAbs(mine[i][j] - ref[i][j]);
      sumerr += e;
      if(e > maxerr)
        {
         maxerr = e;
         wr = i;
         wc = j;
        }
     }
double meanerr = sumerr / (double)(L * KR_NFEAT);
Условие успешного прохождения — maxerr <= tol; средство проверки выводит сведения о ячейке с наибольшей ошибкой, чтобы не только зафиксировать расхождение, но и локализовать его. Для декодировщика максимальная абсолютная ошибка составляет около 1,8e-06; это ожидаемая величина расхождения между вычислениями в MQL5 с типом double и эталонными вычислениями с типом float32. Средства проверки предиктора (KronosVerifyPredictorS1 и KronosVerifyPredictorS2) применяют ту же проверку к логитам и дополнительно подтверждают совпадение argmax — воспроизведение токена, который выбрала бы модель. Максимальные ошибки составляют примерно 4,7e-06 и 9,8e-06 соответственно; каждый из этих этапов рассматривается ниже.
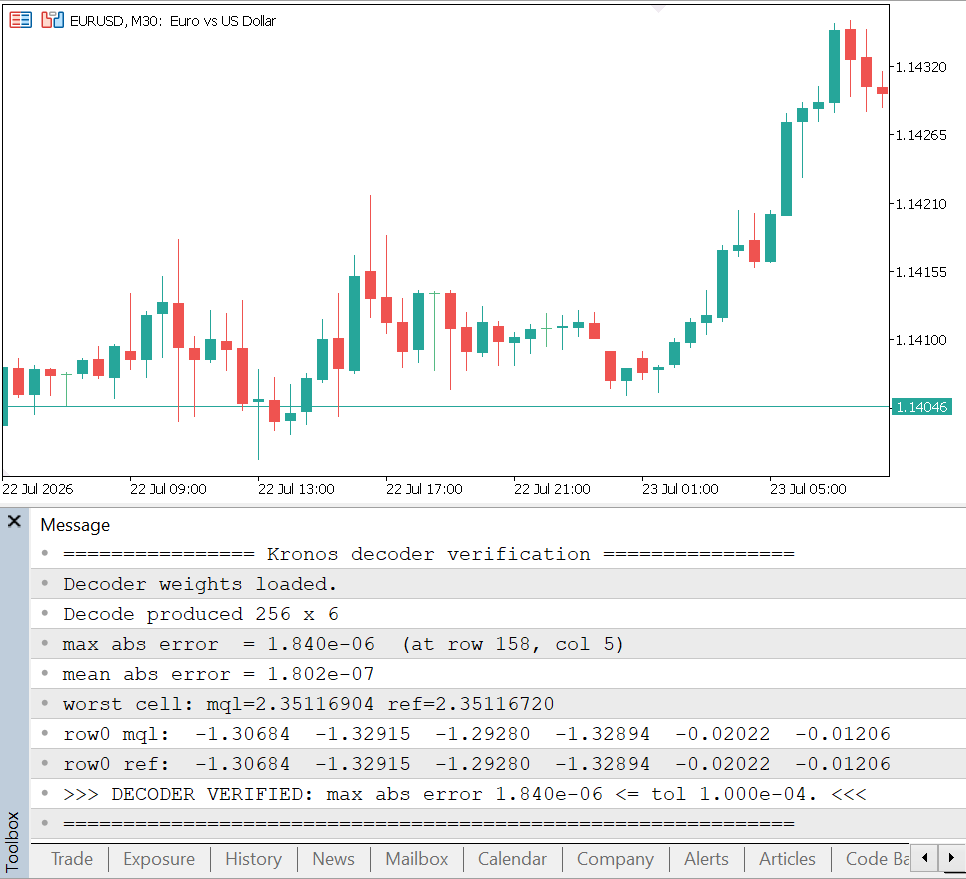
Рис. 1. Средство проверки декодировщика показывает максимальную абсолютную ошибку около 1,8e-06 относительно эталонной реконструкции
Иерархический эмбеддинг предиктора
Предиктор — отдельный, более крупный трансформер размерностью 512 с восемью слоями, который обрабатывает последовательность токенов и предсказывает следующий токен. До выполнения любого блока каждый токен нужно преобразовать в вектор, доступный для обработки трансформером. Kronos формирует его из трех компонентов: двух объединенных эмбеддингов подтокенов и временного эмбеддинга, полученного из временной метки бара.
Метод EmbedRows формирует его. Идентификатор каждого подтокена используется для выбора строки из соответствующей обученной таблицы эмбеддингов — emb_s1 или emb_s2; выбранные строки умножаются на квадратный корень из размерности модели, затем конкатенируются и подаются на линейный слой fusion_proj. Затем добавляются эмбеддинги из пяти временных таблиц: минуты, часа, дня недели, дня и месяца.
//+---------------------------------------------------------------+
//| Build the transformer input rows for the given tokens/stamp:  |
//| HierarchicalEmbedding( fusion_proj(cat(emb_s1*sqrt d,         |
//| emb_s2*sqrt d)) ) + TemporalEmbedding(stamp). Shared by the   |
//| full DecodeS1 and the cached prime/step paths so they embed   |
//| identically. out is (L, d_model).                             |
//+---------------------------------------------------------------+
void              EmbedRows(const int &s1_ids[], const int &s2_ids[], const matrix &stamp, matrix &out)
  {
   int L = ArraySize(s1_ids);
   double scale = MathSqrt((double)m_dm);

   matrix e1, e2;
   EmbedTokens(s1_ids, m_embS1, scale, e1);
   EmbedTokens(s2_ids, m_embS2, scale, e2);

   matrix cat = matrix::Zeros((ulong)L, 2 * m_dm);
   for(int t = 0; t < L; t++)
     {
      for(ulong j = 0; j < m_dm; j++)
         cat[t][j]        = e1[t][j];
      for(ulong j = 0; j < m_dm; j++)
         cat[t][m_dm + j] = e2[t][j];
     }
   out = LinearT(cat, m_fusionW);
   AddRowBias(out, m_fusionB);

   if(stamp.Rows() == (ulong)L && stamp.Cols() >= 5)
     {
      AddTimeEmbed(stamp, 0, m_teMin,  out);
      AddTimeEmbed(stamp, 1, m_teHour, out);
      AddTimeEmbed(stamp, 2, m_teWday, out);
      AddTimeEmbed(stamp, 3, m_teDay,  out);
      AddTimeEmbed(stamp, 4, m_teMon,  out);
     }
  }
EmbedRows собирает входной вектор; две вызываемые им операции выборки из таблиц выполняются на уровень ниже. Само масштабирование выполняется в EmbedTokens: каждый идентификатор указывает на строку таблицы, которая умножается на scale:
//+---------------------------------------------------------------+
//| Embedding lookup with scaling: row `id` of the table times    |
//| the given scale (sqrt(d_model) for the hierarchical embed).   |
//+---------------------------------------------------------------+
void              EmbedTokens(const int &ids[], const matrix &table, double scale, matrix &out)
  {
   int L = ArraySize(ids);
   out = matrix::Zeros((ulong)L, m_dm);
   for(int t = 0; t < L; t++)
     {
      ulong id = (ulong)ids[t];
      for(ulong j = 0; j < m_dm; j++)
         out[t][j] = table[id][j] * scale;
     }
  }
Именно передача здесь scale = sqrt(d_model) делает этот эмбеддинг иерархическим. В следующем разделе та же таблица используется без этого масштабирования для получения эмбеддинга парного подтокена; путаница между двумя вариантами — первая ловушка в decode_s2. За временную составляющую отвечает AddTimeEmbed: для каждого бара добавляется строка одной таблицы:
//+---------------------------------------------------------------+
//| Add one temporal table's contribution: for each row t, add    |
//| table row stamp[t][col] to x.                                 |
//+---------------------------------------------------------------+
void              AddTimeEmbed(const matrix &stamp, int col, const matrix &table, matrix &x)
  {
   ulong L = x.Rows();
   for(ulong t = 0; t < L; t++)
     {
      ulong idx = (ulong)MathRound(stamp[t][col]);   // stamp stored as float
      for(ulong j = 0; j < m_dm; j++)
         x[t][j] += table[idx][j];
     }
  }
Временные метки хранятся в матрице чисел с плавающей запятой, поэтому перед обращением к таблице каждый индекс округляется обратно до целого числа — для этого выше используется функция MathRound. Именно здесь проявляется польза перенумерации дней недели из части 1: в таблице есть ровно одна строка для каждого допустимого значения, поэтому индекс дня недели 7, который получился бы при использовании соглашения MQL5 без преобразования, выходит за границы таблицы из семи строк. Именно это преобразование удерживает idx в допустимом диапазоне. Пять временных составляющих — от минуты до месяца — просто прибавляются к объединенному эмбеддингу токена.
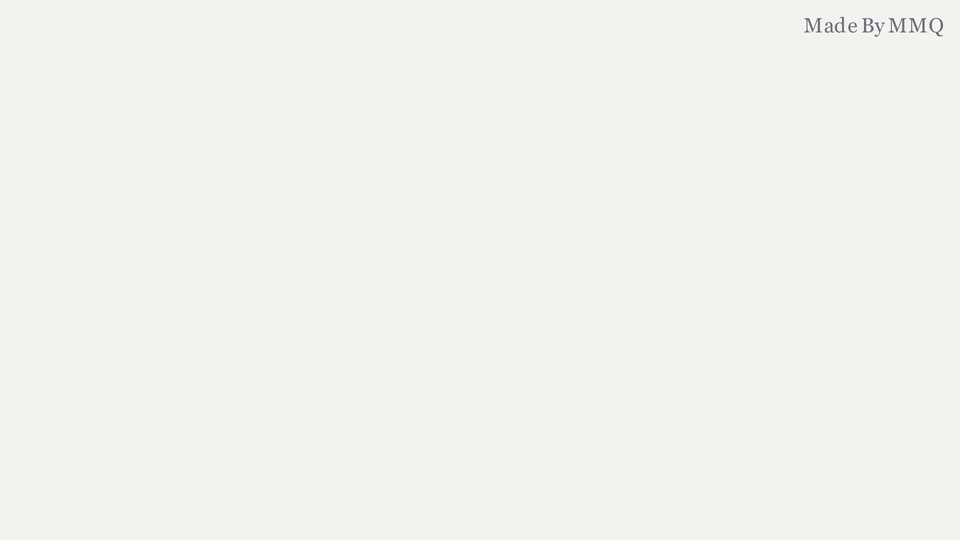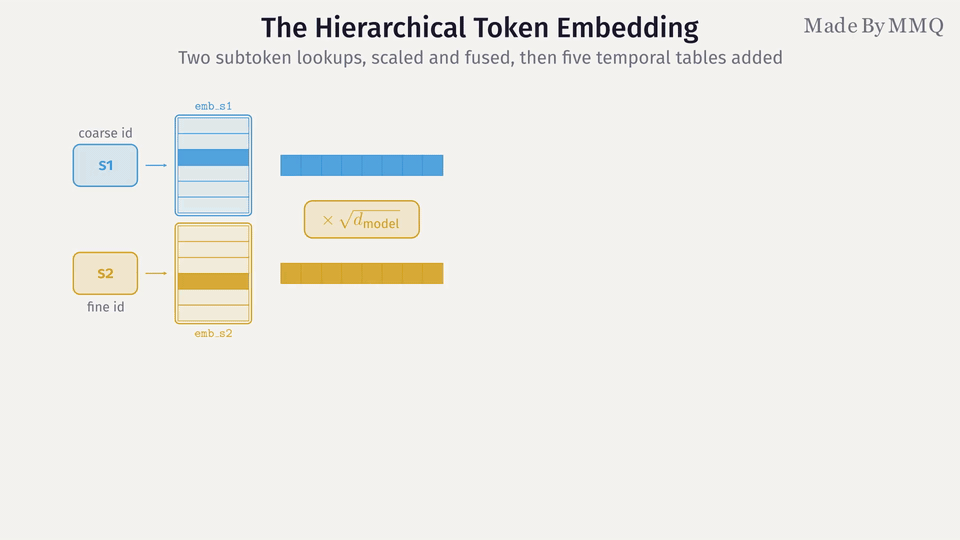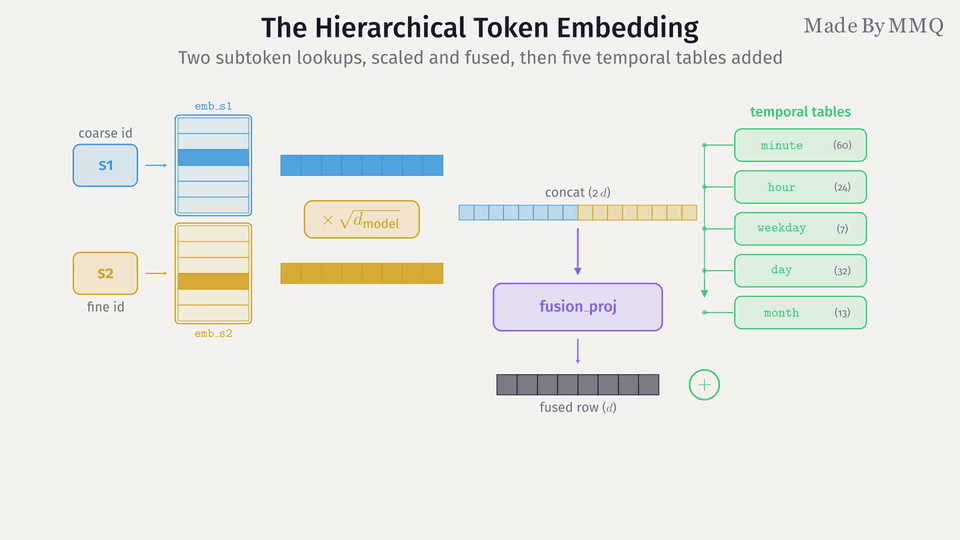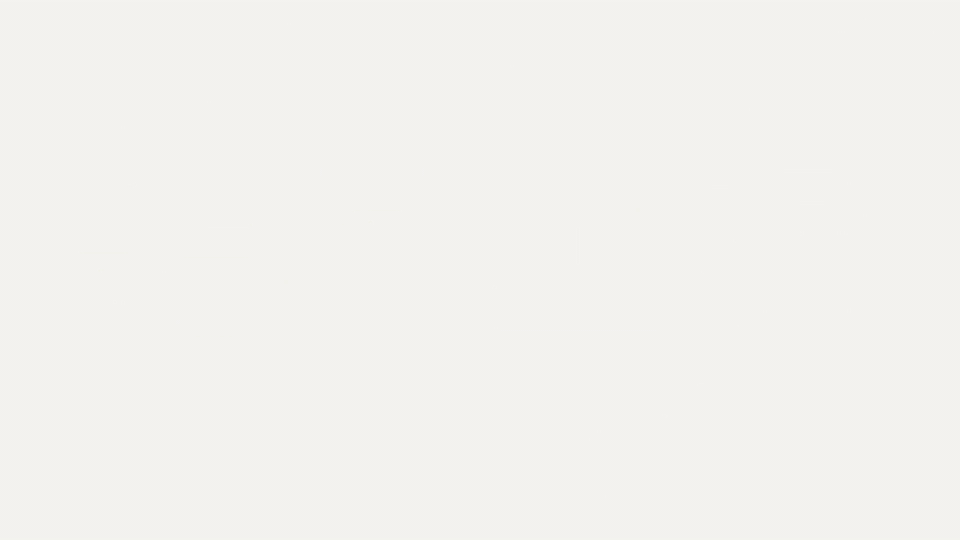
Рис. 2. Формирование одной строки входной матрицы трансформера: эмбеддинги s1 и s2 масштабируются и объединяются, затем добавляются пять временных эмбеддингов для временной метки бара
Загрузка весов предиктора
Прежде чем запустить эти вычисления, веса нужно загрузить в поля класса, из которых они считываются. Именно здесь решение о предварительном транспонировании из части 1 приобретает практический смысл: загрузчик для каждого тензора выбирается по способу его использования. Все сводится к двум правилам. Тензор, используемый как матрица весов LinearT, загружается через KronosLoadMatrixT в транспонированном виде, поэтому прямой проход сводится к обычному матричному умножению. Тензор, используемый как таблица выборки с индексацией по идентификатору токена или значению временной метки, хранится построчно и загружается обычной функцией KronosLoadMatrix: мы напрямую обращаемся к его строкам и никогда не умножаем на него. Загрузка эмбеддингов и выходной головки предиктора наглядно показывает оба правила:
bool ok = true;
//--- embeddings
//--- emb_s1/emb_s2 are lookup tables (indexed by token id) -> keep row-major
ok &= KronosLoadMatrix(F("embedding_emb_s1_weight"),    KR_PRED_VOCAB, m_dm, m_embS1);
ok &= KronosLoadMatrix(F("embedding_emb_s2_weight"),    KR_PRED_VOCAB, m_dm, m_embS2);
//--- fusion_proj is a LinearT weight -> store transposed
ok &= KronosLoadMatrixT(F("embedding_fusion_proj_weight"), m_dm, 2 * m_dm, m_fusionW);
ok &= KronosLoadVector(F("embedding_fusion_proj_bias"), m_dm,               m_fusionB);
ok &= KronosLoadMatrix(F("time_emb_minute_embed_weight"),  60, m_dm, m_teMin);
ok &= KronosLoadMatrix(F("time_emb_hour_embed_weight"),    24, m_dm, m_teHour);
ok &= KronosLoadMatrix(F("time_emb_weekday_embed_weight"),  7, m_dm, m_teWday);
ok &= KronosLoadMatrix(F("time_emb_day_embed_weight"),     32, m_dm, m_teDay);
ok &= KronosLoadMatrix(F("time_emb_month_embed_weight"),   13, m_dm, m_teMon);
//--- final norm + s1 head
ok &= KronosLoadVector(F("norm_weight"),          m_dm,                m_normW);
ok &= KronosLoadMatrixT(F("head_proj_s1_weight"), KR_PRED_VOCAB, m_dm, m_projS1W);
ok &= KronosLoadVector(F("head_proj_s1_bias"),    KR_PRED_VOCAB,       m_projS1B);
Стоит явно перечислить размеры таблиц временных эмбеддингов: 60 значений для минут, 24 для часов, 7 для дней недели, 32 для дня месяца и 13 для месяца. Именно таблица дней недели из семи строк делает перенумерацию из части 1 обязательной: индекс 7 без преобразования привел бы к чтению за пределами таблицы. Размеры таблиц дней и месяцев с запасом (32 и 13 вместо 31 и 12) просто позволяют использовать индексацию с единицы без специальной обработки. Строка, передаваемая в функцию F, — имя из манифеста экспорта части 1, где каждый символ, кроме букв и цифр, заменен подчеркиванием. Поэтому embedding.fusion_proj.weight из PyTorch стало файлом embedding_fusion_proj_weight.bin на диске и здесь запрашивается именно под этим именем. Восемь блоков трансформера загружаются так же в цикле; индекс блока подставляется в имя (transformer_0_, transformer_1_ и т.д.), чтобы оно соответствовало ключам ModuleList. Это связующее звено между подготовительным экспортом и работающей реализацией: манифест задает контракт, по которому загрузчики читают данные.
decode_s1 — предсказание грубого токена
После формирования входных строк предсказание грубого токена сводится к стандартному прямому проходу в архитектуре только с декодером. Строки токенов проходят через восемь каузальных блоков трансформера; заключительная операция RMSNorm формирует так называемый контекст, а линейная головка проецирует его в вектор из 1 024 логитов для словаря s1.
//+---------------------------------------------------------------+
//| decode_s1: returns s1_logits (L, 1024) and context            |
//| (L, d_model). stamp is (L, 5) float with columns              |
//| [minute,hour,weekday,day,month], weekday already in the       |
//| pandas convention (Mon=0..Sun=6).                             |
//+---------------------------------------------------------------+
bool              DecodeS1(const int &s1_ids[], const int &s2_ids[], const matrix &stamp,
              matrix &s1_logits, matrix &context)
  {
   int L = ArraySize(s1_ids);
   if(L == 0 || ArraySize(s2_ids) != L)
     { PrintFormat("DecodeS1: bad id lengths (%d / %d)", L, ArraySize(s2_ids)); return false; }

   matrix x;
   EmbedRows(s1_ids, s2_ids, stamp, x);   // HierarchicalEmbedding + TemporalEmbedding
//--- 8 causal pre-norm transformer blocks
   for(int b = 0; b < m_blocks; b++)
      x = TransformerBlock(x, m_n1[b],
                           m_Wq[b], m_bq[b], m_Wk[b], m_bk[b],
                           m_Wv[b], m_bv[b], m_Wo[b], m_bo[b],
                           m_heads, m_n2[b], m_W1[b], m_W3[b], m_W2[b]);
//--- final RMSNorm -> this is "context" returned for decode_s2
   context = RMSNorm(x, m_normW);
//--- s1 head: d_model -> 1024
   s1_logits = LinearT(context, m_projS1W);
   AddRowBias(s1_logits, m_projS1B);
   return true;
  }
Здесь есть одно малозаметное, но важное отличие от токенизатора; оно становится ловушкой именно потому, что код выглядит очень похожим. Цикл выполняется m_blocks раз; для предиктора m_blocks равен полному числу слоев — восьми, а не n - 1, как у токенизатора. Список блоков токенизатора формируется с помощью range(n_layers - 1), а список блоков предиктора — с помощью range(n_layers). Если по привычке перенести особенность токенизатора в предиктор, один блок незаметно выпадет из вычислений, а логиты окажутся неверными. Токенизатор и предиктор необходимо настраивать по-разному.
Контекст, возвращаемый этим методом, — это не просто промежуточный результат; он напрямую используется на следующем этапе. Это представление каждой позиции после заключительного нормирования; перекрестное внимание в decode_s2 будет обращаться ко всем этим позициям. Логиты s1 сверены с эталоном: расхождение составляет около 4,7e-06, а argmax совпадает, поэтому грубый токен, который выбрала бы модель, воспроизводится в точности.
decode_s2 и подводные камни перекрестного внимания
Именно предсказание уточняющего токена доставляет серьезные трудности при переносе. Уточняющий токен предсказывается не только по контексту: через небольшой слой перекрестного внимания учитывается только что выбранный грубый токен. В Kronos этот слой называется слоем учета зависимостей. В одном этом методе скрываются три отдельные ловушки, и каждая из них давала результат, который выглядел почти правильным, — а такие ошибки особенно опасны.
//+---------------------------------------------------------------+
//| decode_s2: context (L, d_model) from decode_s1 plus the chosen|
//| s1 ids. Returns s2_logits (L, 1024).                          |
//|                                                               |
//| s1_ids may have length L (one sibling per position) or length |
//| 1 (a single sibling broadcast across all L context rows). The |
//| length-1 case mirrors the reference capture (s1_pick = argmax |
//| of the last step), where PyTorch broadcasts (L,d)+(1,d) and   |
//| the single query sits at RoPE position 0.                     |
//+---------------------------------------------------------------+
bool              DecodeS2(const matrix &context, const int &s1_ids[], matrix &s2_logits)
  {
   ulong L = context.Rows();
   int   Q = ArraySize(s1_ids);
   if(L == 0 || (Q != (int)L && Q != 1))
     { PrintFormat("DecodeS2: length mismatch (ids %d, ctx %I64u)", Q, L); return false; }

//--- sibling_embed = raw emb_s1 table rows (NO sqrt(d) scale here).
//--- Q rows: either L (per-position) or 1 (broadcast).
   matrix sib = matrix::Zeros((ulong)Q, m_dm);
   for(int t = 0; t < Q; t++)
     {
      ulong id = (ulong)s1_ids[t];
      for(ulong j = 0; j < m_dm; j++)
         sib[t][j] = m_embS1[id][j];
     }
//--- cross-attention: q = sibling_embed (Q rows), k/v = context (L rows),
//--- n_heads=4, non-causal. attn has Q rows.
   matrix attn = CrossMHA(sib, context,
                          m_cWq, m_cBq, m_cWk, m_cBk,
                          m_cWv, m_cBv, m_cWo, m_cBo,
                          KR_DEP_N_HEADS);
//--- dep_layer: RMSNorm(context + attn). Broadcast attn row 0 across
//--- all L context rows when Q == 1 (matches PyTorch (L,d)+(1,d)).
   matrix sum = matrix::Zeros(L, m_dm);
   for(ulong i = 0; i < L; i++)
     {
      ulong ar = (Q == 1) ? 0 : i;
      for(ulong j = 0; j < m_dm; j++)
         sum[i][j] = context[i][j] + attn[ar][j];
     }
   matrix x2 = RMSNorm(sum, m_depNormW);
//--- s2 head: d_model -> 1024
   s2_logits = LinearT(x2, m_projS2W);
   AddRowBias(s2_logits, m_projS2B);
   return true;
  }
Ловушка 1 — эмбеддинг парного подтокена не масштабируется. Запросом в этом механизме перекрестного внимания служит эмбеддинг выбранного токена s1; используется та же таблица emb_s1, что и в иерархическом эмбеддинге, но без умножения на квадратный корень из d. В исходном коде иерархический эмбеддинг умножается на этот коэффициент внутри собственного метода forward, тогда как здесь обращение к таблице выполняется напрямую по индексу. Если по привычке применить масштабирование, величина каждого запроса окажется неверной.
Ловушка 2 — в этом механизме перекрестного внимания используются четыре головы, а не восемь. В остальной части предиктора используются восемь голов внимания. Слой учета зависимостей создается без указания числа голов внимания, поэтому используется значение по умолчанию — четыре, и размерность каждой головы составляет 128 вместо 64. Это различие меняет разбиение столбцов по головам и, что особенно важно, длину таблицы частот RoPE. Если использовать здесь восемь голов внимания, ротационный эмбеддинг будет незаметно искажен. Именно поэтому при вызове передается KR_DEP_N_HEADS со значением 4, а не число голов внимания предиктора.
Ловушка 3 — размер кэша RoPE определяется по запросу, а сам кэш затем применяется к ключам. Это самая неочевидная из трех ловушек, скрытая внутри CrossMHA. Механизм RoPE формирует кэш косинусов и синусов по длине последовательности запросов и применяет тот же кэш к ключам. При инференсе запрос соответствует единственному выбранному токену s1 с широковещательным распространением (broadcasting), поэтому его длина равна единице. Это означает, что все ключи кодируются так, как если бы находились в позиции 0, а не в их собственной позиции. Поворот ключей по их фактическим позициям кажется естественным решением, но здесь это неверно: такой вариант дал максимальную ошибку 0,57, хотя итоговый argmax все же случайно совпал — такое частичное расхождение легко не заметить. Исправление состоит в том, чтобы использовать для ключей ту же таблицу, построенную по длине последовательности запросов, и индексировать ее по позиции каждого ключа только при равенстве длин последовательностей запросов и ключей.
Все три ловушки видны в самой функции перекрестного внимания. Эту функцию стоит прочитать целиком: в отличие от каузального MHA из части 1, здесь каждая строчка, отличающаяся от обычного самовнимания, отражает одну из трех ловушек:
//+------------------------------------------------------------------+
//| Non-causal multi-head CROSS-attention with RoPE (inference).     |
//| q from Xq (sibling embed), k/v from Xkv (context); each query    |
//| attends to ALL key positions. q/k/v/out carry a bias. The        |
//| predictor's dep_layer uses n_heads=4 (head_dim=128), NOT 8.      |
//|                                                                  |
//| RoPE quirk (matches RotaryPositionalEmbedding.forward): the      |
//| cos/sin cache is sized to the QUERY length and the same cache is |
//| applied to the keys. So when Tq==1 (a single broadcast s1 pick)  |
//| every key is rotated at position 0; when Tq==Tk keys rotate by   |
//| their own positions. We index the key rotation by (Tq==1 ? 0:j), |
//| reusing the query's table.                                       |
//+------------------------------------------------------------------+
matrix CrossMHA(const matrix &Xq, const matrix &Xkv,
                const matrix &Wq, const vector &bq,
                const matrix &Wk, const vector &bk,
                const matrix &Wv, const vector &bv,
                const matrix &Wo, const vector &bo,
                int n_heads)
  {
   ulong Tq = Xq.Rows();
   ulong Tk = Xkv.Rows();
   ulong d_model = Xq.Cols();
   ulong hd = d_model / (ulong)n_heads;      // scaling handled inside SDPA
//--- q from Xq, k/v from Xkv (all with bias)
   matrix Q = LinearT(Xq,  Wq);
   AddRowBias(Q, bq);
   matrix K = LinearT(Xkv, Wk);
   AddRowBias(K, bk);
   matrix V = LinearT(Xkv, Wv);
   AddRowBias(V, bv);
//--- single cache sized to the query length, reused for keys (PyTorch quirk).
//--- valid only when Tq==1 (broadcast) or Tq==Tk (position-matched); any other
//--- mix would have failed PyTorch's broadcast, so reject it loudly.
   if(!(Tq == 1 || Tq == Tk))
     { PrintFormat("CrossMHA: unsupported Tq=%I64u, Tk=%I64u (need Tq==1 or Tq==Tk)", Tq, Tk); }
   matrix cosT, sinT;
   RoPETables(Tq, hd, cosT, sinT);
//--- per-key rotation table: row j uses position (Tq==1 ? 0 : j)
   matrix cosK = matrix::Zeros(Tk, hd), sinK = matrix::Zeros(Tk, hd);
   for(ulong j = 0; j < Tk; j++)
     {
      ulong p = (Tq == 1) ? 0 : j;           // broadcast when single query
      for(ulong k = 0; k < hd; k++)
        {
         cosK[j][k] = cosT[p][k];
         sinK[j][k] = sinT[p][k];
        }
     }
   matrix ctx = matrix::Zeros(Tq, d_model);
//--- per-head non-causal cross-attention
   for(int h = 0; h < n_heads; h++)
     {
      ulong c0 = (ulong)h * hd;
      matrix Qs = SliceCols(Q, c0, hd);
      matrix Ks = SliceCols(K, c0, hd);
      matrix Qh = ApplyRoPE(Qs, cosT, sinT);
      matrix Kh = ApplyRoPE(Ks, cosK, sinK);
      matrix Vh = SliceCols(V, c0, hd);

      matrix Oh = SDPA(Qh, Kh, Vh, false);   // non-causal: all keys
      WriteCols(ctx, Oh, c0);
     }
//--- output projection (with bias)
   matrix out = LinearT(ctx, Wo);
   AddRowBias(out, bo);
   return out;
  }
Если читать эту функцию с учетом трех ловушек, она дает полную картину. Именно при вычислении размерности головы hd = d_model / n_heads проявляется вторая ловушка: если передать восемь, размерность каждой головы окажется вдвое меньше нужной, а длина таблицы RoPE будет неверной. Вызов RoPETables(Tq, hd, ...) связан с третьей ловушкой: размер таблицы задается по длине последовательности запросов, а не ключей. Цикл по ключам решает проблему: при Tq==1 он устанавливает позицию p равной 0 для всех ключей, иначе каждый ключ поворачивается для собственного индекса j. Обратите внимание: запрос поворачивается с использованием исходной таблицы cosT/sinT, а ключи — с использованием полученной из нее таблицы cosK/sinK; именно такую асимметрию создает широковещательное распространение в PyTorch. Первая ловушка — немасштабированный эмбеддинг парного подтокена — относится к более раннему этапу: построению Xq в DecodeS2, а не к этой функции. Все три ловушки вместе объясняют название раздела.
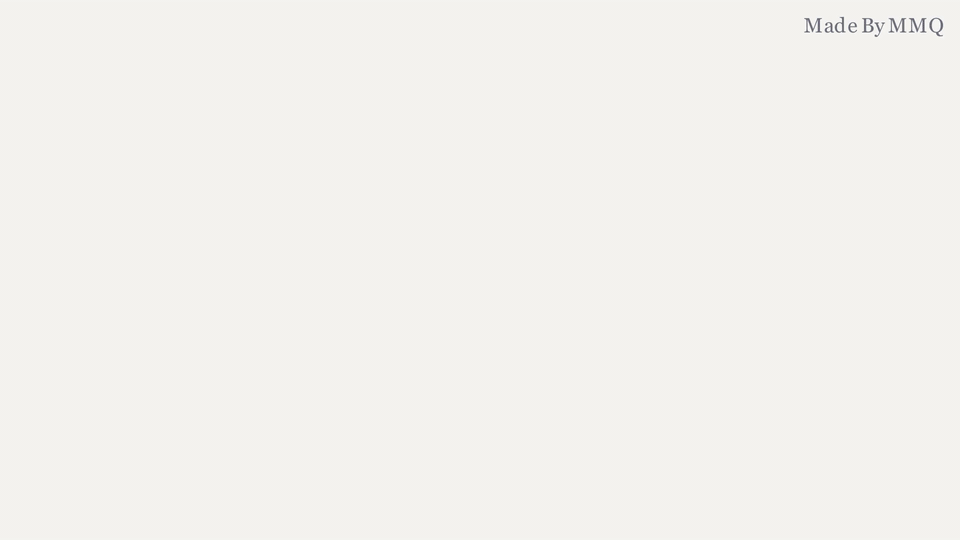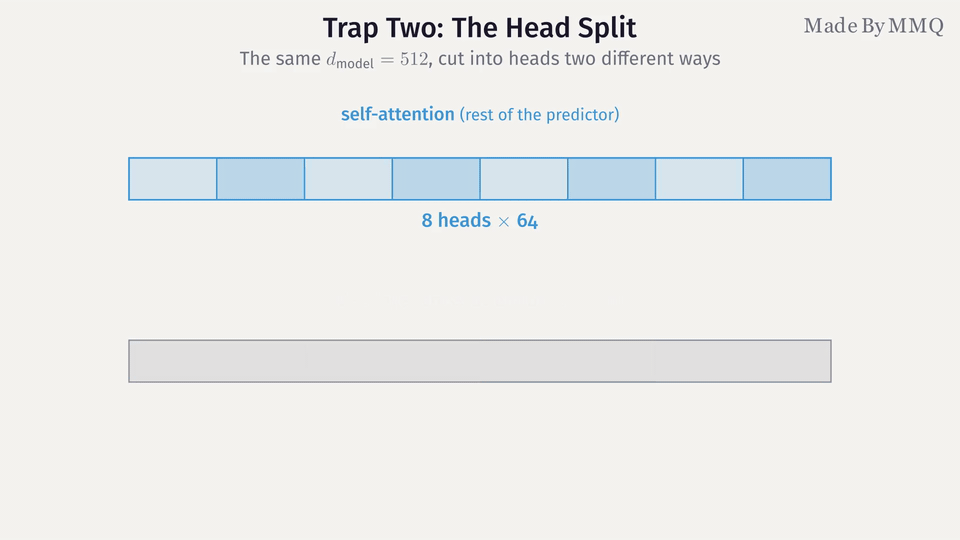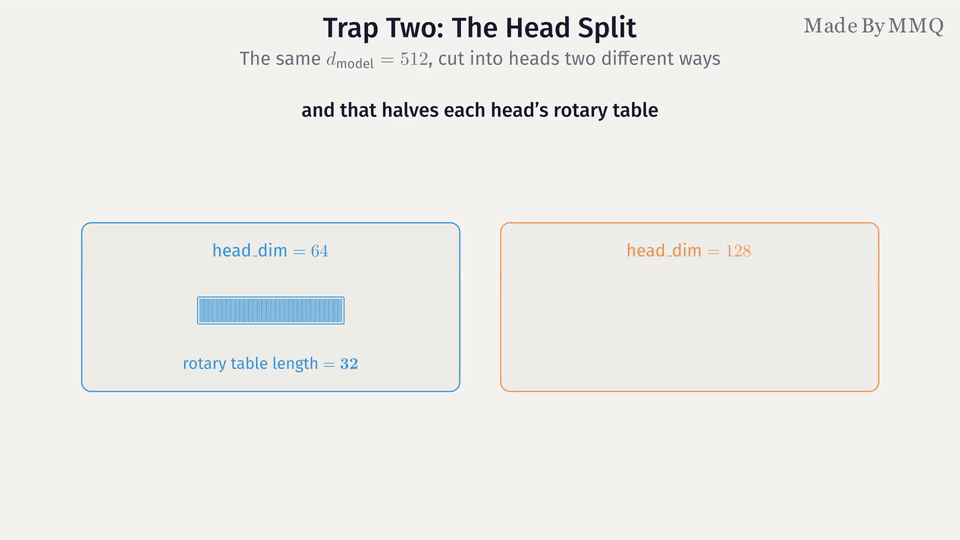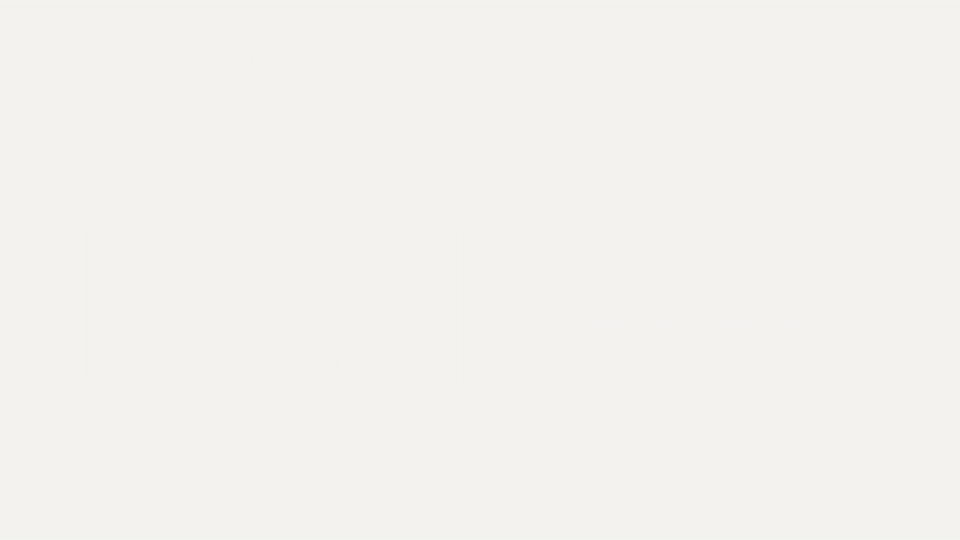
Рис. 3. Вторая ловушка — разбиение на головы внимания. В самовнимании предиктора d_model=512 разбивается на восемь голов размерностью 64, а в перекрестном внимании слоя учета зависимостей те же 512 разбиваются на четыре головы размерностью 128, что также вдвое уменьшает длину таблицы частот RoPE для каждой головы
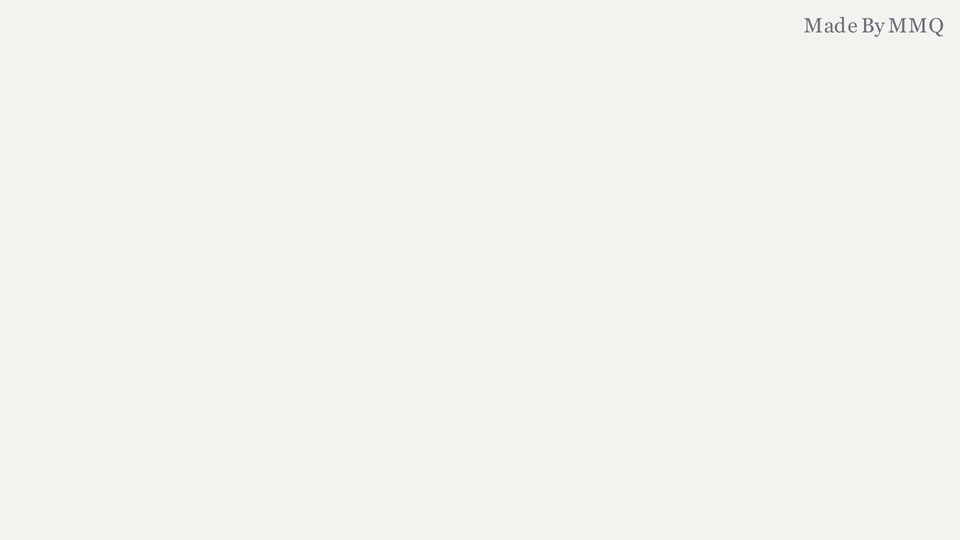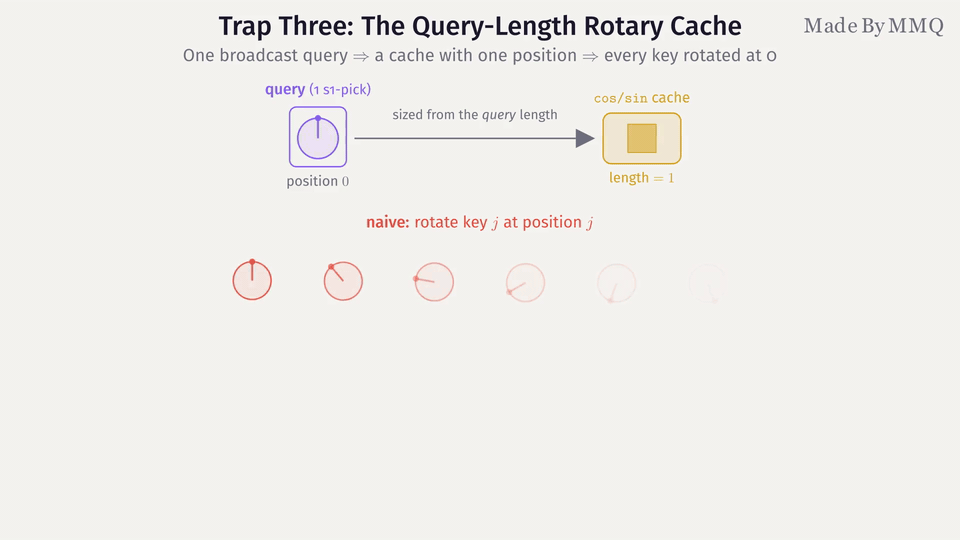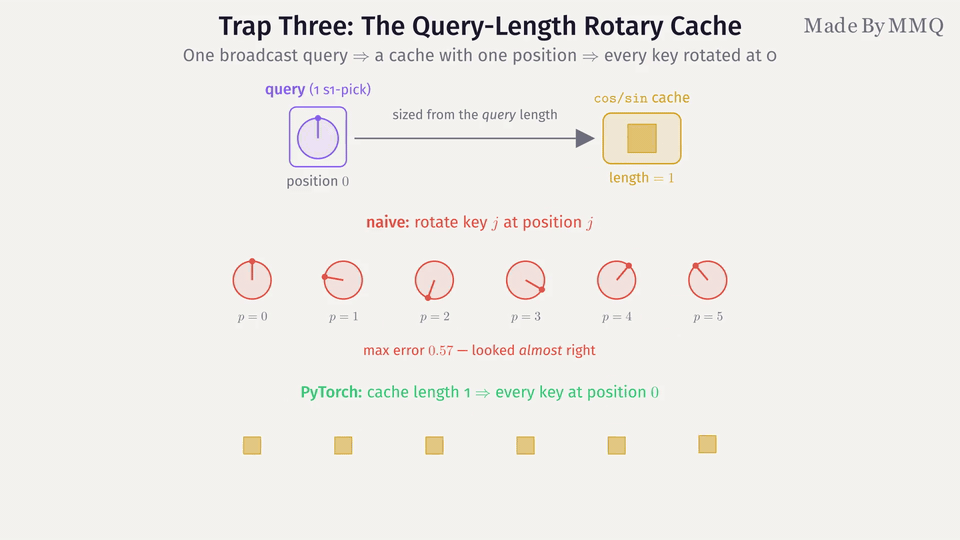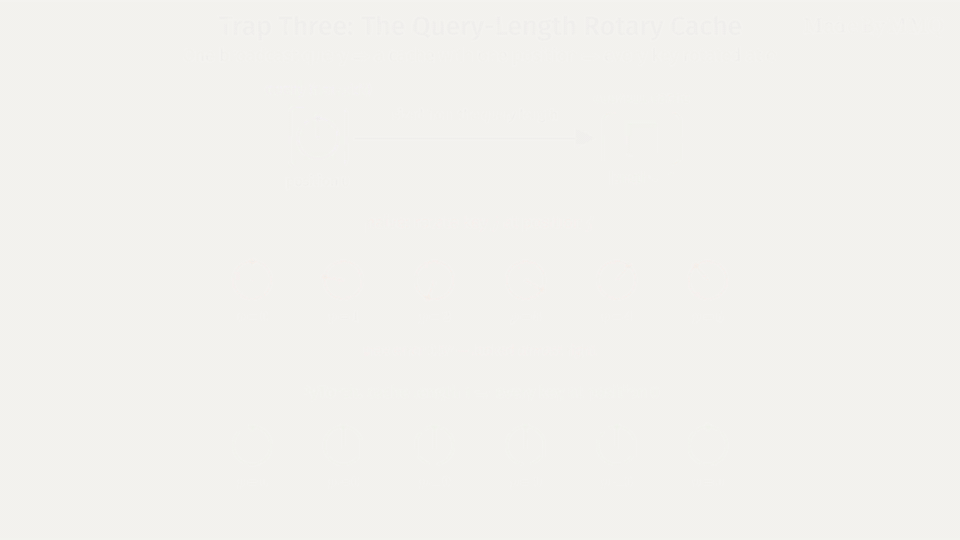
Рис. 4. Третья ловушка — кэш RoPE, размер которого задается длиной последовательности запросов. При единственном запросе с широковещательным распространением кэш содержит одну позицию, поэтому к каждому ключу применяется RoPE для позиции 0, а не для собственного индекса
После устранения всех трех ловушек расхождение логитов s2 с эталоном составляет около 9,8e-06; argmax также совпадает (рис. 5). Уточняющий токен воспроизводится в точности. Стоит отметить, насколько близки были все три ошибочные реализации к успешной проверке. Неверное число голов внимания, пропущенный масштабный коэффициент и поворот ключей для неверной позиции давали правдоподобные результаты, а в одном случае — даже правильный конечный ответ по неверной причине. Именно поэтому в проекте результаты каждого этапа сверяются с эталоном: нельзя считать код корректным лишь потому, что он компилируется и выполняется.
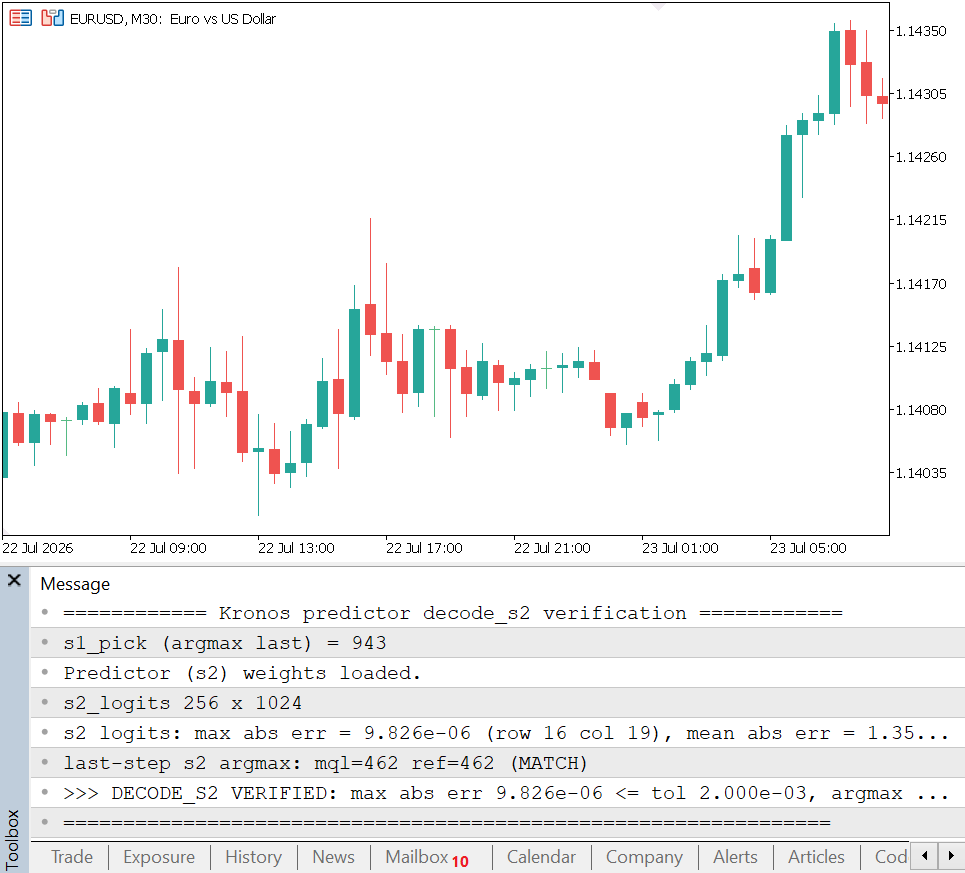
Рис. 5. Средство проверки decode_s2: после учета всех трех особенностей перекрестного внимания расхождение логитов s2 с эталоном составляет около 9,8e-06, а argmax уточняющего токена совпадает в точности (mql=462, ref=462)
Сэмплирование следующего токена
И decode_s1, и decode_s2 возвращают вектор из 1 024 логитов, а не токен. Преобразование вектора логитов в идентификатор токена — задача слоя сэмплирования, и она не сводится к argmax. В KronosSampling.mqh реализованы те же четыре настройки, что и в эталонной реализации: температура, top-k, top-p и переключатель жадного режима. В них стоит разобраться подробно: при оценке в части 3 модель работает в жадном режиме ради воспроизводимости, а при реальном развертывании использовалось бы сэмплирование. Различие между режимами полностью задается этим файлом.
Тонкость заключается в этапе фильтрации. Top-k сохраняет только k наибольших логитов; top-p (сэмплирование по ядру распределения) сохраняет наименьший набор токенов, сумма вероятностей которых превышает порог. Ловушка в top-p связана с граничным токеном — тем, при добавлении которого накопленная сумма превышает порог. Его нужно сохранить, а не удалять, иначе в ядре будет на один токен меньше, чем нужно. В этой реализации маска удаления вычисляется по накопленной сумме, затем сдвигается на одну позицию. Благодаря этому сохраняется граничный токен, при добавлении которого накопленная сумма превышает порог:
//+------------------------------------------------------------------+
//| Top-k then top-p filtering. Removed logits are set to -inf, at   |
//| least one token is kept, and the first token that crosses the    |
//| cumulative top-p threshold is itself kept.                       |
//+------------------------------------------------------------------+
void TopKTopPFilter(double &logits[], int top_k, double top_p)
  {
   int n = ArraySize(logits);

   if(top_k > 0)
     {
      int k = (int)MathMin(MathMax(top_k, 1), n);
      double tmp[];
      ArrayCopy(tmp, logits);
      int order[];
      ArgsortDesc(tmp, order);
      double kth = logits[order[k - 1]];
      for(int i = 0; i < n; i++)
         if(logits[i] < kth)
            logits[i] = KR_NEG_INF;
     }

   if(top_p < 1.0)
     {
      int order[];
      ArgsortDesc(logits, order);
      double probs[];
      ArrayResize(probs, n);
      for(int i = 0; i < n; i++)
         probs[i] = logits[order[i]];
      Softmax(probs);

      bool remove_sorted[];
      ArrayResize(remove_sorted, n);
      double cum = 0.0;
      for(int i = 0; i < n; i++)
        {
         cum += probs[i];
         remove_sorted[i] = (cum > top_p);
        }
      for(int i = n - 1; i > 0; i--)
         remove_sorted[i] = remove_sorted[i - 1];
      remove_sorted[0] = false;

      for(int i = 0; i < n; i++)
         if(remove_sorted[i])
            logits[order[i]] = KR_NEG_INF;
     }
  }
Исключаемые токены не удаляются из массива: их логитам присваивается большое по модулю отрицательное значение-маркер, чтобы сохранить индексацию по словарю; соответствующая функция Softmax преобразует эти значения в нулевые вероятности. Наконец, функция SampleFromLogits объединяет эти средства управления в порядке, принятом в эталонной реализации: деление на температуру, фильтрация, softmax, а затем либо выбор argmax, либо сэмплирование токена:
//+------------------------------------------------------------------+
//| Full decode step: temperature scale, top-k/top-p filter,         |
//| softmax, then sample. greedy=true returns the argmax instead.    |
//+------------------------------------------------------------------+
int SampleFromLogits(const double &logits_in[], double T, int top_k, double top_p, bool greedy)
  {
   double l[];
   ArrayCopy(l, logits_in);
   int n = ArraySize(l);
   for(int i = 0; i < n; i++)
      l[i] /= T;
   if(top_k > 0 || top_p < 1.0)
      TopKTopPFilter(l, top_k, top_p);
   double probs[];
   ArrayCopy(probs, l);
   Softmax(probs);
   return greedy ? Argmax(probs) : MultinomialDraw(probs);
  }
Перед softmax логиты делятся на температуру T: при T меньше единицы распределение сильнее концентрируется на наиболее вероятном токене, а при T больше единицы становится более равномерным. Ветвь greedy полностью исключает случайный выбор и возвращает наиболее вероятный токен, что делает весь прогноз детерминированным и воспроизводимым. Именно этот детерминизм позволяет нам проверять результаты генерации по фиксированному эталону и обеспечивает воспроизводимость оценки в части 3. Ветвь без жадного выбора вызывает MultinomialDraw — обычный выбор из отфильтрованного распределения методом обращения функции распределения (CDF). Это единственное место во всем пайплайне, где намеренно не обеспечивается побитное совпадение с PyTorch; именно поэтому проверка выполняется в жадном режиме.
Авторегрессионный цикл
Теперь у нас есть все четыре компонента: кодирование окна в токены, decode_s1 для предсказания грубого токена, decode_s2 для предсказания уточняющего токена с учетом выбранного грубого токена и декодирование токенов обратно в свечи. Авторегрессионный цикл внутри GeneratePathNorm объединяет их работу в прогноз. Для каждого будущего бара алгоритм предсказывает грубый токен и сэмплирует его, затем предсказывает уточняющий с учетом выбранного грубого и тоже сэмплирует его. Новая пара добавляется к текущей последовательности. Сразу после того, как decode_s1 сформировал s1_logits для текущего шага, основная часть итерации выглядит так:
for(int i = 0; i < pred_len; i++)
  {
   //--- ... decode_s1 for this step fills s1_logits, context and last (next section) ...
   double l1[];
   ArrayResize(l1, (int)s1_logits.Cols());
   for(int j = 0; j < (int)s1_logits.Cols(); j++)
      l1[j] = s1_logits[last][j];
   int s1_pick = SampleFromLogits(l1, T, top_k, top_p, greedy);
   //--- decode_s2(context, [s1_pick]) -> sample last-step s2. The cross-attn
   //--- query (the single s1 pick) attends over the FULL context, so we pass
   //--- the whole context and read its last row.
   int pick_arr[];
   ArrayResize(pick_arr, 1);
   pick_arr[0] = s1_pick;
   matrix s2_logits;
   if(!m_p2.DecodeS2(context, pick_arr, s2_logits))
      return false;
   int s2_last = (int)s2_logits.Rows() - 1;
   double l2[];
   ArrayResize(l2, (int)s2_logits.Cols());
   for(int j = 0; j < (int)s2_logits.Cols(); j++)
      l2[j] = s2_logits[s2_last][j];
   int s2_pick = SampleFromLogits(l2, T, top_k, top_p, greedy);

   gen_s1[i] = s1_pick;
   gen_s2[i] = s2_pick;
   //--- append, sliding the buffer to max_context
   int n = ArraySize(pre);
   if(n < m_max_context)
     {
      ArrayResize(pre,  n + 1);
      pre[n]  = s1_pick;
      ArrayResize(post, n + 1);
      post[n] = s2_pick;
     }
   else
     {
      for(int t = 0; t < n - 1; t++)
        {
         pre[t] = pre[t + 1];
         post[t] = post[t + 1];
        }
      pre[n - 1]  = s1_pick;
      post[n - 1] = s2_pick;
     }
  }
В этом цикле стоит обратить внимание на две особенности. Во-первых, выбранный токен s1 передается в decode_s2 как одноэлементный массив pick_arr. Это тот самый случай широковещательного распространения из раздела о перекрестном внимании: один запрос, множество ключей, к каждому ключу применяется RoPE для позиции 0. Этот запрос учитывает весь контекст через механизм внимания, поэтому его результат попадает в последнюю строку s2_logits, которую и считывает цикл. Оба токена выбираются с помощью одной и той же функции SampleFromLogits, которую мы только что реализовали, поэтому переключатель жадного режима и параметры температуры, top-k и top-p одинаково действуют на грубый и уточняющий токены.
Во-вторых, именно при добавлении новой пары реализуются фазы роста и сдвига. Пока длина буфера меньше m_max_context, новая пара токенов просто добавляется в конец — это фаза роста. После заполнения буфера эта ветвь кода сдвигает все элементы на одну позицию к началу и записывает новую пару в конец. Самый старый токен отбрасывается, размер окна остается фиксированным — это фаза сдвига. Это ветвление кажется технической мелочью, но именно от него зависит применимость KV-кэша: кэш остается корректным только в первой ветви.
После завершения цикла полная последовательность токенов — исходный контекст вместе со сгенерированными токенами — передается декодировщику, а последние pred_len восстановленных баров составляют прогноз. Весь этот процесс — генерация с последующим декодированием — дает одну сэмплированную траекторию, и GeneratePathNorm формирует ровно одну такую траекторию. Публичный метод Predict дополняет этот процесс двумя необходимыми для практического использования этапами — нормированием на входе и усреднением на выходе:
//+---------------------------------------------------------------+
//| Full predict: a raw OHLCVA window (L,6) plus stamps becomes a |
//| forecast (pred_len,6) in raw units. full_stamp is             |
//| (L+pred_len, 5) covering context and horizon, weekday in the  |
//| pandas convention. Averages sample_count paths in normalized  |
//| space (as the reference does), then denormalizes once.        |
//+---------------------------------------------------------------+
bool              Predict(const matrix &raw, const matrix &full_stamp, int pred_len,
              double T, int top_k, double top_p, int sample_count, bool greedy,
              matrix &forecast)
  {
   matrix x_norm;
   vector mean, stdv;
   KronosNormalize(raw, x_norm, mean, stdv);

   matrix avg = matrix::Zeros((ulong)pred_len, KR_NFEAT);
   int got = 0;
   for(int s = 0; s < sample_count; s++)
     {
      matrix p;
      int g1[], g2[];
      if(!GeneratePathNorm(x_norm, full_stamp, pred_len, T, top_k, top_p, greedy, p, g1, g2))
         return false;
      avg += p;
      got++;
     }
   if(got == 0)
      return false;
   avg *= (1.0 / (double)got);
//--- denormalize with the context window's per-feature stats
   KronosDenormalize(avg, mean, stdv, forecast);
   return true;
  }
Усреднение намеренно выполняется в нормированном пространстве, как и в эталонной реализации. Сумма полных сгенерированных траекторий в количестве sample_count делится на этот параметр, и лишь затем средняя траектория однократно преобразуется в исходный масштаб с использованием статистик самого контекстного окна. Именно поэтому шум при сэмплировании не разрушает прогноз: результаты нескольких случайных генераций сглаживают друг друга. В жадном режиме все траектории одинаковы, поэтому sample_count фактически равен единице, и усреднение дает тот же результат, что и одна траектория; именно этот режим используется для оценки в части 3. Этот метод — весь публичный интерфейс реализации. Он принимает окно исходных данных OHLCVA с соответствующими временными метками и возвращает прогноз в исходных ценовых единицах; все описанное в двух частях скрыто за этим интерфейсом.
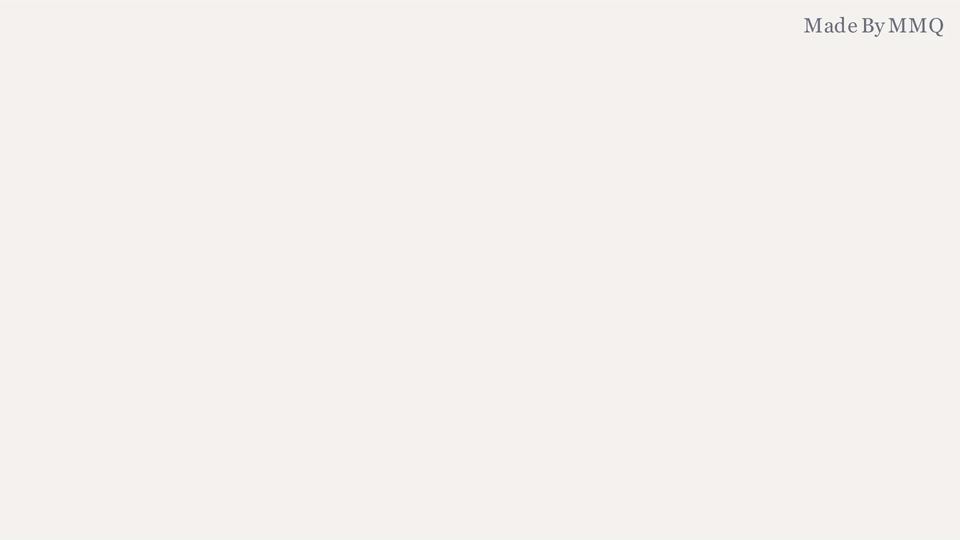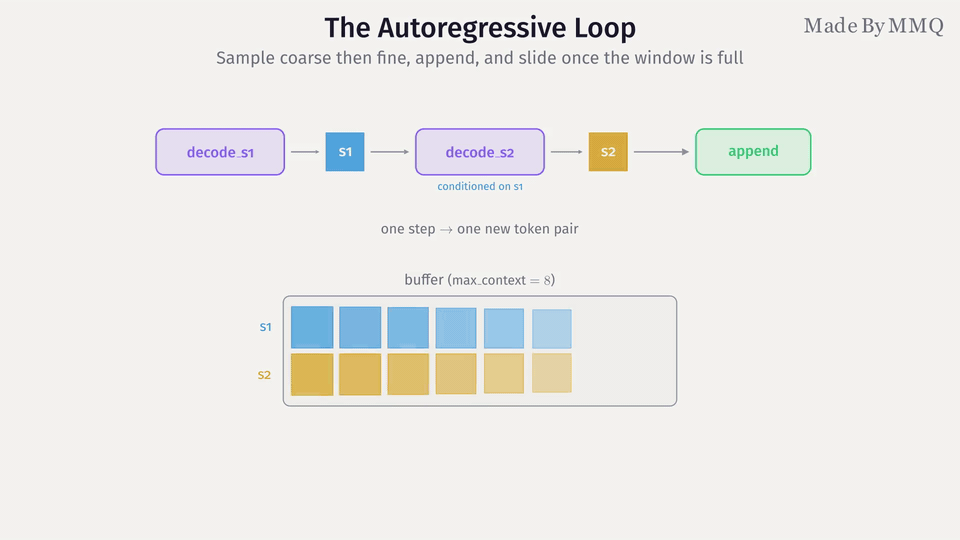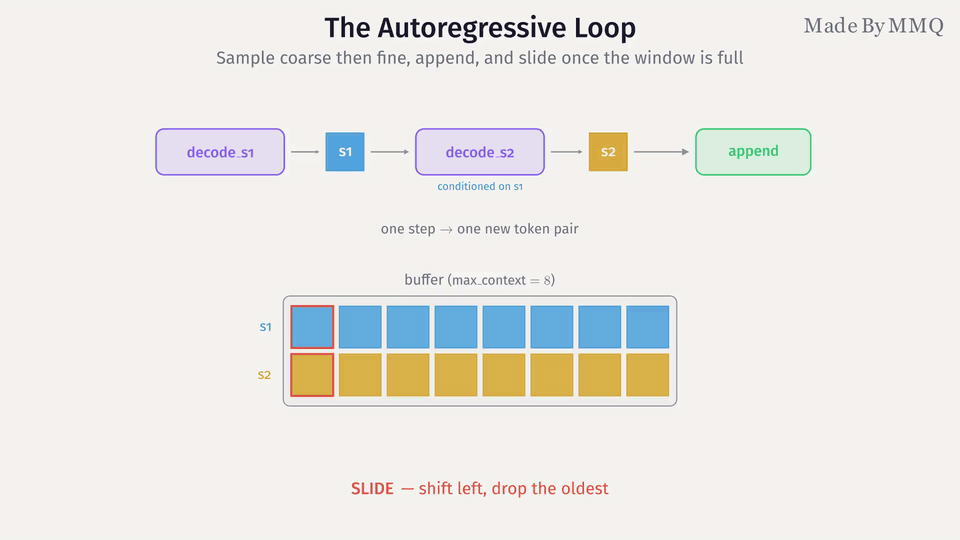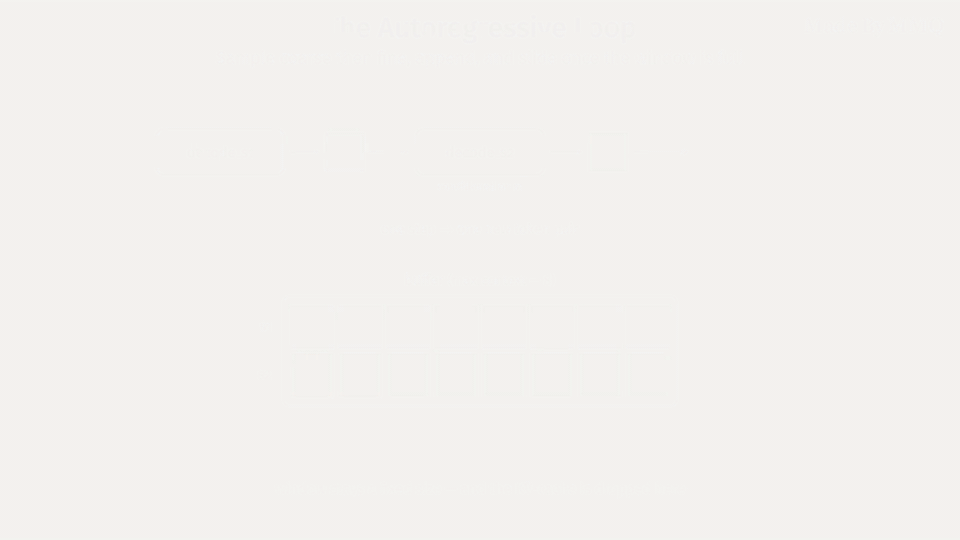
Рис. 6. Авторегрессионный цикл: на каждом шаге сначала предсказывается и сэмплируется грубый токен, затем — уточняющий; оба добавляются в последовательность, а при достижении максимальной длины контекста окно сдвигается
Ветвь сдвига также проходит проверку. Специальное средство проверки KronosVerifyInference запускает генерацию в жадном режиме и сверяет токены первого шага с проверенными значениями argmax (рис. 7). KronosVerifySlide продолжает генерацию после достижения максимальной длины контекста и подтверждает точное совпадение токенов при переходе через эту границу с эталоном — 30 из 30. Таким образом, корректность работы окна не просто выглядит правдоподобной, а подтверждена проверкой.
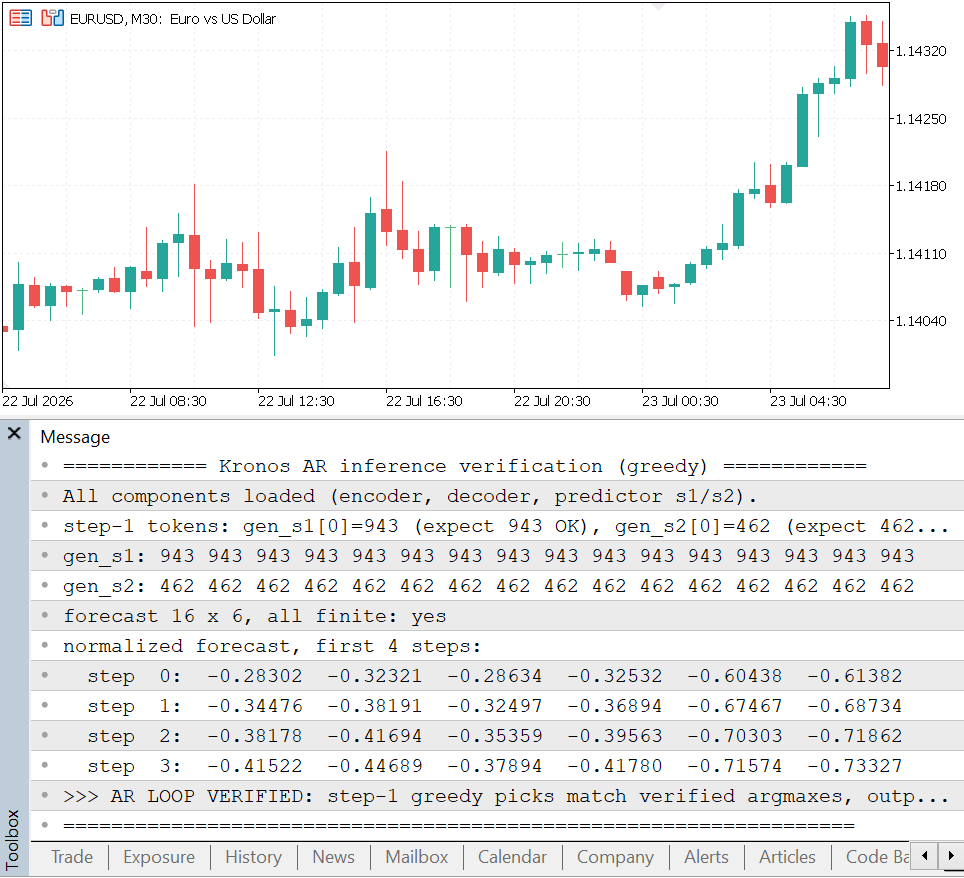
Рис. 7. Проверка полного авторегрессионного цикла в жадном режиме: грубый и уточняющий токены первого шага (943 и 462) совпадают с проверенными значениями argmax, а прогноз содержит конечные значения на всех шестнадцати шагах
KV-кэш, сохраняющий точность
Наивная реализация приведенного выше цикла неэкономно расходует вычислительные ресурсы. На каждом шаге все восемь блоков трансформера заново обрабатывают все окно токенов, хотя новым является только последний токен. Все результаты вычислений, полученные на предыдущих позициях, отбрасываются и пересчитываются заново. Это типичный случай, когда помогает кэш ключей и значений: для каждого блока сохраняются ключи и значения, полученные после проекций для уже обработанных позиций, а на каждом шаге вычисляется только новая строка, для которой внимание рассчитывается с использованием кэша. Вычислительная сложность каждого шага снижается с квадратичной по длине последовательности до линейной.
Реализацию кэша этой модели усложняют ротационные позиционные эмбеддинги (RoPE). RoPE кодирует абсолютную позицию токена в его ключе в момент вращения ключа, поэтому кэшированный ключ остается корректным лишь до тех пор, пока эта позиция не меняется. Это условие выполняется в фазе роста, когда новые токены добавляются в конец последовательности и ничего не сдвигается. Но как только окно начинает сдвигаться, позиция каждого сохранившегося токена уменьшается на единицу, и все ключи в кэше становятся устаревшими. Поэтому реализация использует кэш лишь при точном результате и переходит к полному пересчету, как только точность перестает обеспечиваться.
Кэшу нужен примитив, которого не было в части 1: применение RoPE ко всей строке со всеми головами внимания с произвольным абсолютным смещением позиции. При шаге с кэшем поворачивается одна новая строка в позиции pos, а не в позиции 0. Именно таким примитивом является RoPEAllHeads. Он выделяет каждую голову внимания, поворачивает ее с помощью строки cos/sin для позиции posOffset + r и записывает обратно:
//+---------------------------------------------------------------+
//| Apply RoPE per head over a (T, d_model) projection, using a   |
//| cos/sin table of width head_dim. Rotates each head's column   |
//| slice independently, matching MHA's per-head ApplyRoPE.       |
//| posOffset shifts the row->position mapping (row r uses        |
//| position posOffset+r) so a single appended row can be rotated |
//| at its true absolute position.                                |
//+---------------------------------------------------------------+
matrix            RoPEAllHeads(const matrix &M, const matrix &cosT, const matrix &sinT, int posOffset)
  {
   ulong T = M.Rows();
   ulong hd = m_dm / (ulong)m_heads;
   matrix outM = matrix::Zeros(T, m_dm);
   for(int h = 0; h < m_heads; h++)
     {
      ulong c0 = (ulong)h * hd;
      matrix Ms = SliceCols(M, c0, hd);
      //--- rotate slice; cos/sin row for output row r comes from posOffset+r
      matrix Mr = matrix::Zeros(T, hd);
      ulong half = hd / 2;
      for(ulong r = 0; r < T; r++)
        {
         ulong p = (ulong)posOffset + r;
         for(ulong k = 0; k < hd; k++)
           {
            double rh = (k < half) ? -Ms[r][k + half] : Ms[r][k - half];
            Mr[r][k] = Ms[r][k] * cosT[p][k] + rh * sinT[p][k];
           }
        }
      WriteCols(outM, Mr, c0);
     }
   return outM;
  }
Первоначальное заполнение кэша. Перед началом генерации PrimeCache один раз пропускает исходное контекстное окно через восемь блоков. Просто вызвать TransformerBlock нельзя: нужен доступ к внутренним вычислениям каждого блока, чтобы сохранить именно те тензоры, которые формирует внимание, — ключи после RoPE и значения без поворота RoPE. Поэтому тело блока реализуется повторно, а ключи сохраняются сразу после поворота:
for(int b = 0; b < m_blocks; b++)
  {
   //--- pre-norm + projections (mirrors MHA on RMSNorm(x))
   matrix n1 = RMSNorm(x, m_n1[b]);
   matrix Q  = LinearT(n1, m_Wq[b]);
   AddRowBias(Q, m_bq[b]);
   matrix K  = LinearT(n1, m_Wk[b]);
   AddRowBias(K, m_bk[b]);
   matrix V  = LinearT(n1, m_Wv[b]);
   AddRowBias(V, m_bv[b]);
   //--- RoPE the full Q and K per head at their own positions (posOffset 0)
   matrix Qr = RoPEAllHeads(Q, cosT, sinT, 0);
   matrix Kr = RoPEAllHeads(K, cosT, sinT, 0);
   //--- cache the post-RoPE K and raw V for this block
   m_cacheK[b] = Kr;
   m_cacheV[b] = V;
   //--- attention per head (causal), then out-proj + residual + FFN
   matrix ctx = matrix::Zeros((ulong)L, m_dm);
   for(int h = 0; h < m_heads; h++)
     {
      ulong c0 = (ulong)h * hd;
      matrix Qh = SliceCols(Qr, c0, hd);
      matrix Kh = SliceCols(Kr, c0, hd);
      matrix Vh = SliceCols(V,  c0, hd);
      matrix Oh = SDPA(Qh, Kh, Vh, true);   // causal, matches MHA
      WriteCols(ctx, Oh, c0);
     }
   matrix a = LinearT(ctx, m_Wo[b]);
   AddRowBias(a, m_bo[b]);
   matrix x1 = x + a;
   matrix n2 = RMSNorm(x1, m_n2[b]);
   matrix f  = SwiGLU(n2, m_W1[b], m_W3[b], m_W2[b]);
   x = x1 + f;
  }
После первоначального заполнения m_cacheK[b] и m_cacheV[b] содержат ключи и значения для каждой позиции контекста в каждом блоке, а отдельный m_cacheContext хранит контекст после заключительного нормирования, необходимый decode_s2. Это намеренное воспроизведение обычного блока, а не упрощение: каузальный вызов SDPA и схема остаточных соединений и FFN идентичны используемым в MHA и TransformerBlock, поэтому результат первоначального заполнения кэша побитно совпадает с результатом полного вызова DecodeS1 для того же окна.
Пошаговая обработка. Затем каждый шаг фазы роста выполняется с малыми вычислительными затратами. DecodeS1Step формирует эмбеддинг только одного нового токена, в каждом блоке проецирует лишь эту строку, выполняет поворот для ее абсолютной позиции pos, добавляет ключ и значение в кэш и вычисляет внимание для единственного нового запроса по всей сохраненной истории:
int pos = m_cacheLen;             // absolute position of the new row
ulong hd = m_dm / (ulong)m_heads;
//--- RoPE table sized to cover position `pos` (rows 0..pos), query reads row pos
matrix cosT, sinT;
RoPETables((ulong)(pos + 1), hd, cosT, sinT);

for(int b = 0; b < m_blocks; b++)
  {
   matrix n1 = RMSNorm(x, m_n1[b]);          // (1, d_model)
   matrix Q  = LinearT(n1, m_Wq[b]);
   AddRowBias(Q, m_bq[b]);
   matrix K  = LinearT(n1, m_Wk[b]);
   AddRowBias(K, m_bk[b]);
   matrix V  = LinearT(n1, m_Wv[b]);
   AddRowBias(V, m_bv[b]);
   //--- rotate the single new row at its absolute position `pos`
   matrix Qr = RoPEAllHeads(Q, cosT, sinT, pos);
   matrix Kr = RoPEAllHeads(K, cosT, sinT, pos);
   //--- append new K/V to the cache for this block -> (pos+1, d_model)
   matrix Kall = AppendRow(m_cacheK[b], Kr);
   matrix Vall = AppendRow(m_cacheV[b], V);
   m_cacheK[b] = Kall;
   m_cacheV[b] = Vall;
   //--- attention: single query (row pos) over all cached keys (non-causal:
   //--- the new row is the latest position, so it attends to everything)
   matrix ctx = matrix::Zeros(1, m_dm);
   for(int h = 0; h < m_heads; h++)
     {
      ulong c0 = (ulong)h * hd;
      matrix Qh = SliceCols(Qr,   c0, hd);   // (1, hd)
      matrix Kh = SliceCols(Kall, c0, hd);   // (pos+1, hd)
      matrix Vh = SliceCols(Vall, c0, hd);
      matrix Oh = SDPA(Qh, Kh, Vh, false);   // (1, hd)
      WriteCols(ctx, Oh, c0);
     }
   matrix a  = LinearT(ctx, m_Wo[b]);
   AddRowBias(a, m_bo[b]);
   matrix x1 = x + a;
   matrix n2 = RMSNorm(x1, m_n2[b]);
   matrix f  = SwiGLU(n2, m_W1[b], m_W3[b], m_W2[b]);
   x = x1 + f;
  }
Здесь внимание помечено как некаузальное, что корректно именно потому, что новая строка находится в последней позиции: ей доступны все предыдущие ключи, а более поздних позиций, которые нужно маскировать, нет. Каждый считываемый ключ был повернут в соответствии со своей позицией при первоначальном сохранении в кэше, поэтому единственный новый запрос, повернутый для позиции pos, видит историю с тем же позиционным кодированием, которое было бы получено при полном пересчете. В m_cacheContext также добавляется новая строка, поскольку перекрестное внимание в decode_s2 по-прежнему обращается ко всем позициям, а не только к последней.
Вся эта схема применяется только в фазе роста. Авторегрессионный цикл на каждом шаге определяет, остается ли кэш точным, и использует его только в этом случае:
//--- decode_s1: cached grow-phase step, or full-window fallback
matrix s1_logits, context;
int last;
bool use_cache = (cache_ok && current_seq_len < m_max_context);
Пока current_seq_len меньше максимальной длины контекста, цикл выполняет шаг с использованием кэша; как только требуется сдвиг окна, use_cache принимает значение false и для текущего окна вызывается полная неизмененная реализация DecodeS1. Корректностью никогда не жертвуют ради скорости: расхождение логитов при использовании кэша и полном пересчете составляет около 1e-14, а все проверки генерации, включая тест сдвига окна, проходят без изменений при включенном кэше. Это самая масштабная инженерная доработка в рамках нативной реализации на MQL5, и именно благодаря ей прогноз на несколько баров рассчитывается за секунды, а не за минуты.
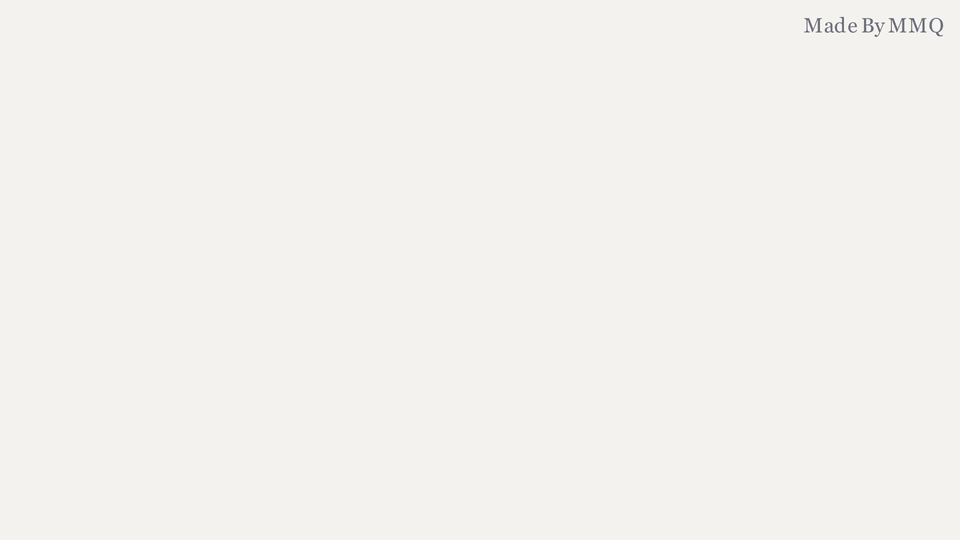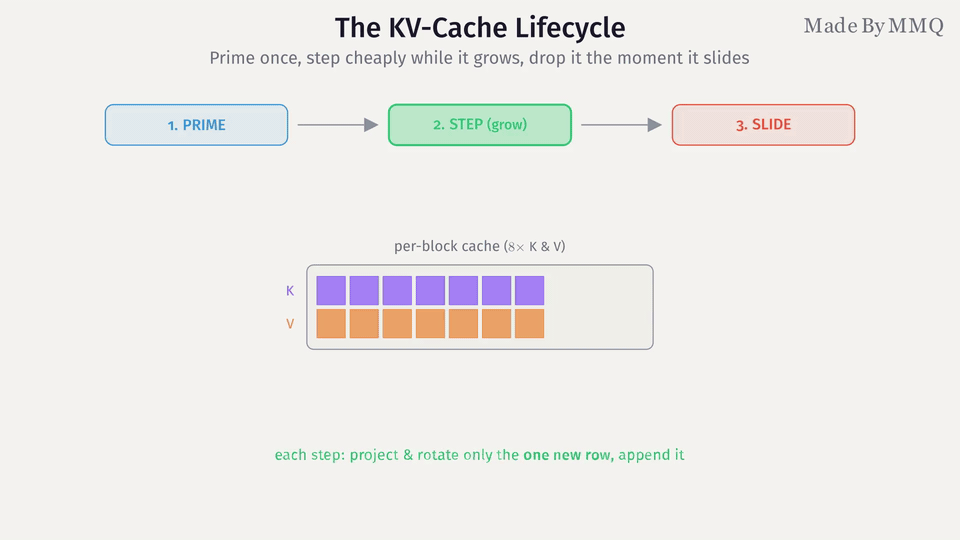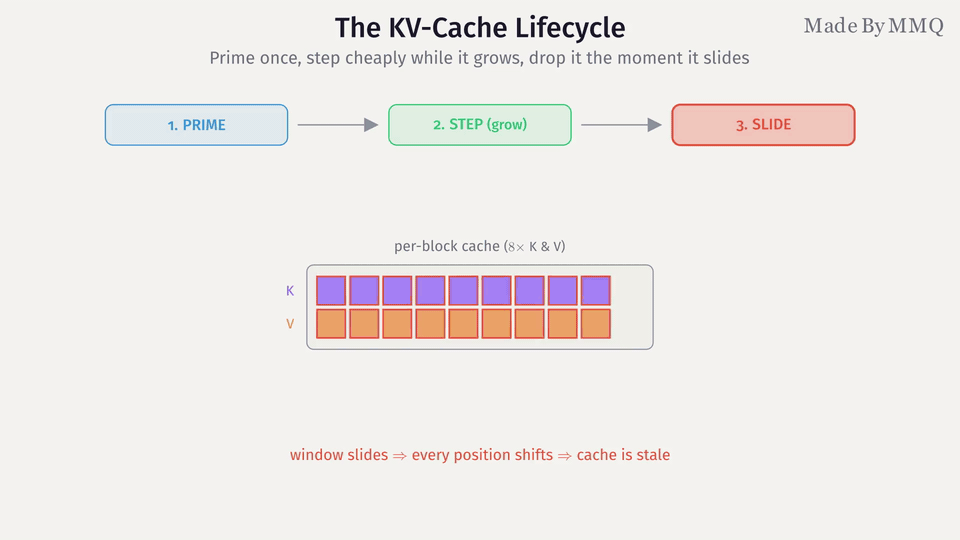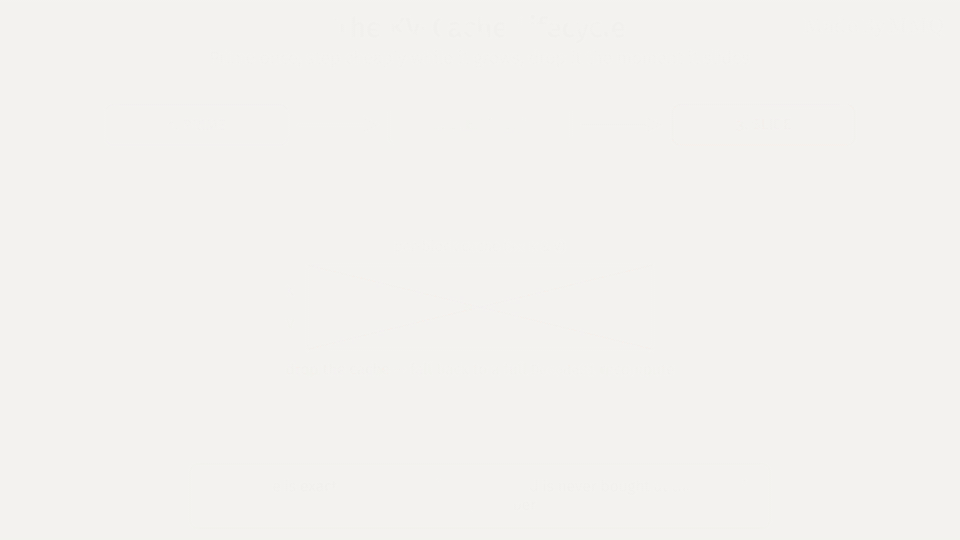
Рис. 8. Жизненный цикл кэша. PrimeCache однократно заполняет кэш K/V каждого блока для всего контекста; на каждом шаге фазы роста проекция и поворот выполняются только для новой строки, которая затем добавляется в кэш; как только окно должно сдвинуться, цикл прекращает использовать кэш и возвращается к полному пересчету DecodeS1
Ускорение вычислений — профилирование и предварительно транспонированные веса
KV-кэш стал первым и очевидным способом ускорения: он устраняет избыточные вычисления, которые выполняла модель. Второй способ ускорения был совсем не очевиден, и история его обнаружения более поучительна: он был найден благодаря измерениям, результаты которых противоречили интуиции.
Даже с кэшем первая версия, реализующая полный цикл обработки, работала медленно. Генерация одного прогноза при контексте из 256 баров занимала порядка 900 миллисекунд на шаг, из-за чего пошаговое исследование на тысячах баров становилось непрактичным. В этот момент возникает соблазн угадать, что ограничивает производительность, и сразу приступить к оптимизации. Вместо этого мы провели профилирование с помощью скрипта KronosProfile.mq5 без пользовательского интерфейса, который однократно вызывает Predict под профилировщиком MetaEditor. Здесь важно вызывать Predict из скрипта, а не из советника, служащего только для визуализации: под профилировщиком советник зависает, а скрипт дает один отдельный проход для измерений. Результаты профилирования оказались неожиданными.
Больше всего времени занимало транспонирование весов. В первоначальной реализации линейный слой при каждом вызове транспонировал свою матрицу весов, чтобы соответствовать принятому в PyTorch формату. Поскольку матрица весов неизменна, одна и та же операция транспонирования повторялась тысячи раз и в сумме занимала примерно 60% времени всего прямого прохода. Исправление не добавляет затрат при выполнении модели: матрицы весов всех линейных слоев однократно транспонируются при загрузке и сохраняются в таком виде. Мы уже познакомились с этим решением в части 1 — с загрузчиком KronosLoadMatrixT и функцией LinearT из одной строчки; именно эти измерения послужили основанием для его внедрения. Математические вычисления остаются теми же; транспонирование просто переносится с каждого вызова на однократную загрузку.
Две доработки дополняют друг друга: кэширование из предыдущего раздела и перенос транспонирования на этап загрузки. Небольшой скрипт KronosBench.mq5 измеряет время выполнения одного шага при заданной длине контекста; в таблице приведены результаты для контекста длиной 256 баров, жадного режима и одной траектории:
| Сборка | Время выполнения одного шага | Ускорение |
|---|---|---|
| Базовая версия до внедрения кэша | ~906 мс | 1,0x |
| + KV-кэш в фазе роста | ~423 мс | ~2,1x |
| + предварительно транспонированные веса | ~201 мс | ~4,5x |
В совокупности это дает ускорение примерно в 4,5 раза. В таблице отдельно показано время одного шага в жадном режиме для сравнения двух доработок. Полный прогноз требует больше ресурсов, поскольку несколько сэмплированных траекторий рассчитываются на всю длину. Профилирование такого запуска с прогнозом на 16 баров вперед и 5 сэмплированными траекториями показывает полные затраты: около 17,5 секунды в общей сложности, примерно 220 миллисекунд на шаг каждой траектории. До двух доработок потребовалось бы значительно больше минуты. После переноса транспонирования на этап загрузки профиль затрат становится равномерным, без единственного доминирующего источника: собственно матричное умножение задает необходимый минимум затрат, а остальное время распределяется между перемещением данных, циклами поэлементного нормирования и активации и сэмплированием. Есть и другие возможности оптимизации: арифметика float32, пакетная обработка сэмплированных траекторий и OpenCL. Но ни одна не применяется вслепую. Стоит запомнить урок профилировщика: ограничение производительности было не там, где подсказывала интуиция.
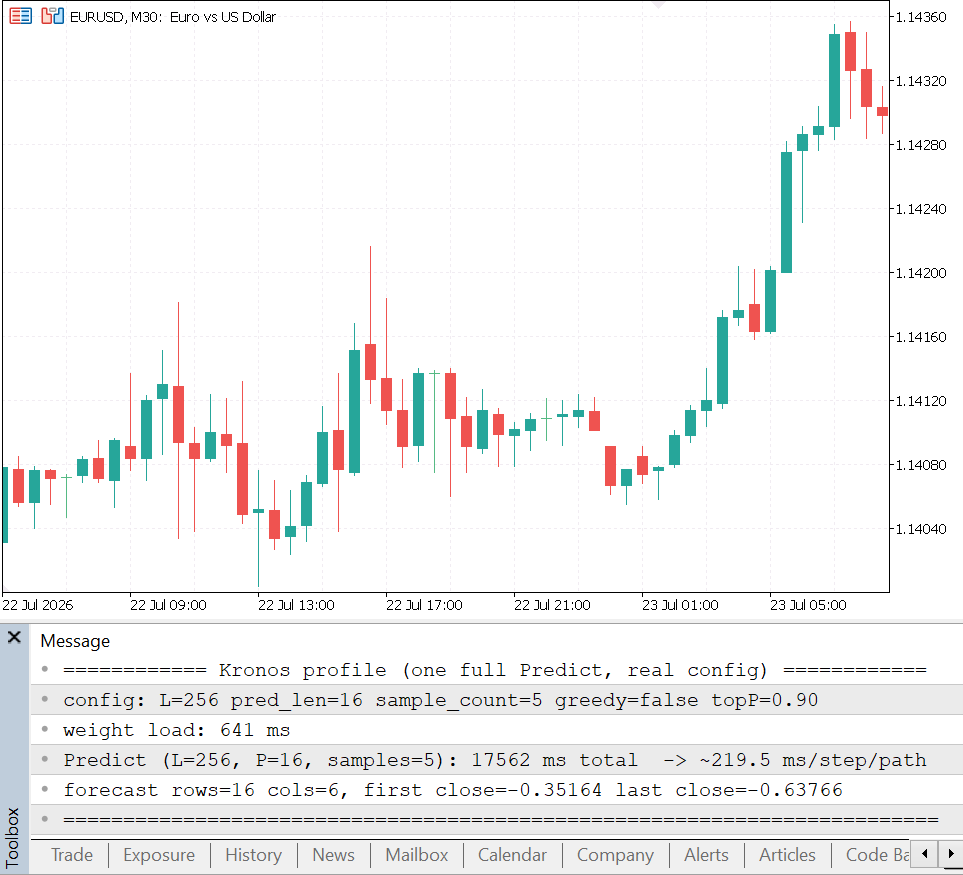
Рис. 9. Профилирование одного полного вызова Predict в рабочей конфигурации (контекст из 256 баров, прогноз на 16 баров вперед, 5 сэмплированных траекторий): около 17,5 секунды в общей сложности, примерно 220 миллисекунд на шаг каждой траектории после обеих доработок — внедрения KV-кэша и предварительного транспонирования весов
Заключение
Теперь пайплайн полностью готов и проверен от начала до конца. Мы реализовали декодировщик, преобразующий токены обратно в свечи, иерархический эмбеддинг предиктора, этапы decode_s1 и decode_s2 с зависимостью между ними на основе перекрестного внимания, а также авторегрессионный цикл, генерирующий прогноз на несколько баров. Затем мы провели профилирование результата и ускорили реализацию примерно в 4,5 раза, не изменив ни одного выходного значения.
- Подводные камни сосредоточены в нескольких местах и неочевидны. Выбор между полным и сокращенным числом блоков, немасштабированный эмбеддинг парного подтокена, перекрестное внимание с четырьмя головами и кэш RoPE, рассчитанный на длину последовательности запросов, — в каждом из этих мест возникали ошибки, из-за которых результат выглядел правильным, хотя таковым не был.
- Кэш точный, а не приближенный. Он используется только в фазе роста, когда абсолютные позиции остаются неизменными, а при сдвиге окна цикл немедленно переходит к полному пересчету.
- Проводите профилирование перед оптимизацией. Основные затраты приходились на транспонирование неизменных весов, повторявшееся тысячи раз. Интуиция не подсказала бы искать причину здесь в первую очередь.
- Каждый этап привязан к эталону. Ошибка декодировщика — около 1,8e-06, s1 — около 4,7e-06, s2 — около 9,8e-06; ветвь сдвига дает точное совпадение, кэш — совпадение с точностью до 1e-14.
Мы всесторонне проверили, что нативная реализация на MQL5 точно воспроизводит работу Kronos. Речь идет о точности воспроизведения PyTorch, и только это может установить проверка. Стоит четко разграничить, что именно это утверждение означает, а чего не означает: реализация выполняет те же вычисления, что и исходная модель, но это не говорит о том, что прогнозы исходной модели полезны на рынке. Это два разных вопроса, и следующая часть призвана помочь избежать ловушки их смешения. Пайплайн, построенный и проверенный в двух частях, позволяет получить честный ответ; в части 3 он используется для пошаговой оценки с продвижением по времени без заглядывания в будущее.
Получение исходного кода через MQL5 Algo Forge
Все исходные файлы прикреплены ниже к этой статье, но полный репозиторий также доступен на MQL5 Algo Forge — платформе сообщества на базе Git для публикации торговых проектов и совместной работы над ними.
| Имя файла | Описание |
|---|---|
| MQL5\Include\Kronos\KronosDecoder.mqh | CKronosDecoder: цепочка декодирования токенизатора, преобразующая идентификаторы токенов обратно в окно нормированных данных OHLCVA |
| MQL5\Include\Kronos\KronosPredictorS1.mqh | CKronosPredictorS1: иерархический и временной эмбеддинги, decode_s1 и KV-кэш фазы роста (PrimeCache / DecodeS1Step) |
| MQL5\Include\Kronos\KronosPredictorS2.mqh | CKronosPredictorS2: decode_s2 с блоком перекрестного внимания, учитывающим зависимости |
| MQL5\Include\Kronos\KronosSampling.mqh | Средства сэмплирования: softmax, фильтрация top-k и top-p, выбор из мультиномиального распределения и жадный выбор |
| MQL5\Include\Kronos\KronosInference.mqh | CKronosModel: авторегрессионный цикл, усреднение сэмплированных траекторий и точка входа Predict для полного цикла прогнозирования |
| MQL5\Scripts\Kronos\KronosVerifyDecoder.mq5 | Средство проверки восстановленных декодировщиком данных по эталону |
| MQL5\Scripts\Kronos\KronosVerifyPredictorS1.mq5 | Средство проверки логитов decode_s1 по эталонным данным |
| MQL5\Scripts\Kronos\KronosVerifyPredictorS2.mq5 | Средство проверки логитов decode_s2 по эталонным данным |
| MQL5\Scripts\Kronos\KronosVerifySlide.mq5 | Средство проверки токенов, сгенерированных в фазе сдвига после достижения границы контекста, по эталонным данным |
| MQL5\Scripts\Kronos\KronosVerifyInference.mq5 | Средство проверки авторегрессионного цикла по эталонным данным: сравнение токенов первого шага в жадном режиме с проверенными значениями argmax |
| MQL5\Scripts\Kronos\KronosBench.mq5 | Скрипт измерения времени одного шага прогнозирования при заданной длине контекста |
| MQL5\Scripts\Kronos\KronosProfile.mq5 | Точка входа для однократного вызова Predict() без графического интерфейса, используемая для профилирования в MQL5 |
| MQL5\Kronos\kronos_slide_capture.py | Однократный подготовительный запуск: сохраняет эталонные результаты жадной генерации со сдвигом окна при длинном контексте для средства проверки фазы сдвига |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/23674
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.

 Конструирование признаков для машинного обучения (Часть 7): Энтропийные признаки в Python
 Метаразметка классических стратегий (Часть 1): Фильтрация сделок по RSI и определение размера позиций
 Конструирование признаков для машинного обучения (Часть 5): Микроструктурные признаки на Python
 Разработка индикатора снятия ликвидности STF Liquidity Sweep на языке MQL5

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования