

Конструирование признаков для машинного обучения (Часть 8): Энтропийные признаки в MQL5
 46
 2

Содержание
- Введение
- Получение тиковых данных внутри бара в MQL5
- Кодирование: от MqlTick к последовательности uchar
- Архитектура: CEntropyFeatures
- Энтропия Шеннона
- Подстановочная оценка энтропии (Plug-In)
- Сложность Лемпеля — Зива
- Энтропия Контоянниса
- Интеграция с советником
- Индикатор просмотра энтропии
- Проверка
- Заключение
- Прикрепленные файлы
- Список литературы
Введение
В статье описывается перенос с Python на MQL5 четырех методов оценки энтропии — энтропии Шеннона, подстановочной оценки энтропии (Plug-In), сложности Лемпеля — Зива и энтропии Контоянниса, — реализованных в части 7, а также объясняются проектные решения, необходимые для их практического применения в MetaTrader 5. Эталонная реализация на Python использовала скользящие окна NumPy, словари Python и ускорение с помощью Numba; ни одно из этих средств недоступно в MQL5. Что еще важнее, доступ к тикам внутри бара в MQL5 ограничен окном тикового кеша брокера, данные из которого возвращает функция CopyTicksRange(), поэтому исторические последовательности тиков за пределами этого кеша просто недоступны. Таким образом, при переносе учитываются сразу три основных ограничения:
- как получать и кодировать значения тикового правила внутри бара с помощью CopyTicksRange(), помечая бары с недостаточным количеством тиков значением-маркером ENT_EMPTY;
- как подсчитывать перекрывающиеся w-граммы без NumPy (целочисленный хеш на основе троичной системы счисления служит индексом в массиве счетчиков фиксированного размера, заменяя sliding_window_view и unique);
- как ограничить поиск совпадений в методе Контоянниса (настраиваемое окно предыстории ограничивает область поиска во внутреннем цикле со сложностью O(n²)).
Цель практическая: добиться численного соответствия эталонной реализации на Python, предоставить безопасные точки интеграции с советниками и индикаторами и сделать набор признаков пригодным для реальной торговли, несмотря на ограничение тикового кеша.
Получение тиковых данных внутри бара в MQL5
Конвейер расчета энтропии на Python из части 7 получает последовательности значений тикового правила в виде заранее вычисленных массивов NumPy — сбор данных выполняется на другом этапе конвейера, до вызова функций расчета энтропии. В MQL5 класс сам отвечает за сбор тиковых данных внутри бара. Единственный рабочий механизм — это CopyTicksRange():
int CopyTicksRange(
   string   symbol,
   MqlTick  &ticks[],
   uint     flags,
   long     from_msc,
   long     to_msc
   );
from_msc и to_msc — это временные метки в миллисекундах. Для бара i по текущему символу и на текущем периоде диапазон задается так:
from_msc = (long)iTime(symbol, period, i)     * 1000;
to_msc   = (long)iTime(symbol, period, i - 1) * 1000 - 1;
При этом учитываются тики, приходящиеся строго на интервал бара i: от момента его открытия до момента за 1 мс до открытия бара i−1. Флаг COPY_TICKS_ALL используется для того, чтобы были возвращены все доступные записи тиков независимо от их типа.
Ограничение глубины тиковой истории
Функция CopyTicksRange() получает данные из локального тикового кеша терминала, который MetaTrader 5 заполняет по мере необходимости, пока график открыт. Глубина кеша определяется брокером: на большинстве платформ для розничных трейдеров она обычно составляет несколько дней, а на платформах, настроенных на экспорт исторических тиков, иногда достигает нескольких недель. Для баров старше доступной в кеше истории возвращается пустой массив (возвращаемое значение — 0 или −1), и класс записывает для этих баров ENT_EMPTY. Это ограничение не влияет на использование в реальном времени, когда тиковые данные для самых последних баров всегда доступны; однако оно ограничивает покрытие исторических баров тиковыми данными при расчете индикатора на только что открытом графике.
Это ограничение существенно отличается от проблемы с тиковым объемом, описанной в части 6. Там поле реального торгового объема (MqlTick.volume) в потоках данных розничного рынка Форекс содержало ноль, но количество тиков всегда было доступно в качестве косвенного показателя, а охват исторических данных был неограниченным. В данном случае сама последовательность тиков недоступна за пределами тикового кеша, и нет заменителя, который сохранял бы информацию о направлении, необходимую для методов оценки энтропии.
Кроме того, чтобы оценки были содержательными, для бара должно быть доступно минимальное число наблюдений за направлением изменения цены на тиках. Параметр конструктора min_ticks (по умолчанию 8) задает нижний порог: для баров с меньшим числом допустимых изменений направления возвращается ENT_EMPTY, а не оценки, рассчитанные по двум или трем символам.
Кодирование: от MqlTick к последовательности uchar
В части 7 массив, полученный по тиковому правилу в Python, кодировался в виде bytes с использованием отображения −1 → 98 ('b'), 0 → 99 ('c'), +1 → 97 ('a'). В реализации для MQL5 используется более простое числовое отображение в значения типа uchar (0–255):
| Изменение цены Bid | Направление | Значение uchar |
|---|---|---|
| Δbid < 0 | снижение | 0 |
| Δbid = 0 | без изменения | 1 |
| Δbid > 0 | рост | 2 |
Поле цены last (MqlTick.last) равно нулю практически во всех потоках котировок розничного рынка Форекс. В тиковом правиле везде используется цена Bid в качестве опорной цены. Для акций и фьючерсов, у которых поле last заполнено, тот же класс можно адаптировать, заменив разность d_bid на ticks[i].last − ticks[i−1].last.
Вся логика кодирования, включая формирование временного диапазона в миллисекундах, инкапсулирована в функции _GetTickSequence():
//+------------------------------------------------------------------+
//| _GetTickSequence: fetch ticks for one bar and apply tick rule    |
//+------------------------------------------------------------------+
int CEntropyFeatures::_GetTickSequence(
   datetime bar_open, datetime bar_close, uchar &seq[])
  {
   MqlTick ticks[];
   long from_msc = (long)bar_open  * 1000;
   long to_msc   = (long)bar_close * 1000 - 1;

   int n = (int)CopyTicksRange(m_symbol, ticks,
                               COPY_TICKS_ALL, from_msc, to_msc);
   if(n <= 1)
      return(0);

   if(ArrayResize(seq, n - 1) < 0)
      return(0);

   int cnt = 0;
   for(int i = 1; i < n; i++)
     {
      double d_bid = ticks[i].bid - ticks[i - 1].bid;
      uchar  dir;
      if(d_bid > 0.0)      dir = 2;
      else if(d_bid < 0.0) dir = 0;
      else                 dir = 1;
      seq[cnt++] = dir;
     }

   ArrayResize(seq, cnt);
   return(cnt);
  }
Функция заранее выделяет n − 1 ячеек и записывает только изменения направления (у тика 0 нет предшественника). Завершающий вызов ArrayResize(seq, cnt) сокращает массив до точного числа допустимых направлений, которое может отличаться от n − 1, если в каких-либо записях тиков поля bid имели неопределённые значения.
Архитектура: CEntropyFeatures
Класс использует ту же архитектуру с вычислительным ядром и полной реализацией в заголовочном файле, что и описанный в части 6 класс CMicrostructureFeatures. Файл CEntropyFeatures.mqh находится в папке MQL5\Include\Features\ и подключается с помощью синтаксиса с угловыми скобками:
#include <Features\CEntropyFeatures.mqh> Открытый интерфейс минимален: конструктор, задающий символ, период и три параметра алгоритма; метод Calculate(), который перебирает бары; а также четыре метода доступа только для чтения.
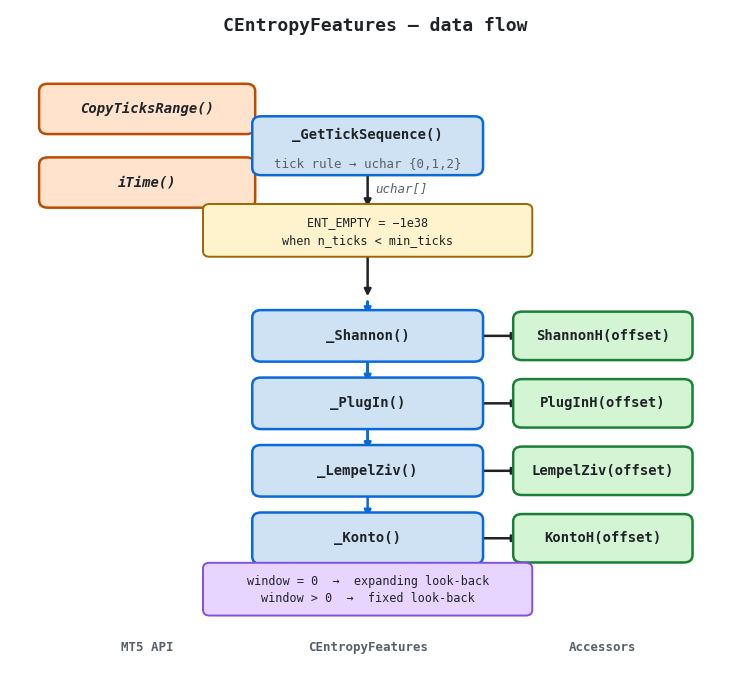
Рисунок 1. Архитектура CEntropyFeatures — поток данных от тикового API MetaTrader 5 к четырём методам доступа к оценкам энтропии
- API MetaTrader 5 (слева): функции CopyTicksRange() и iTime() возвращают соответственно исходный массив тиков и временные метки границ баров.
- CEntropyFeatures (в центре): метод _GetTickSequence() применяет тиковое правило на основе изменения цены Bid и кодирует направления значениями {0, 1, 2} типа uchar. Янтарная метка обозначает ветвь со значением-маркером: если количество тиков меньше min_ticks, во все четыре выходных массива для данного бара записывается ENT_EMPTY = −1e38 без вызова методов оценки энтропии. В нижней ветви диаграммы закодированный массив передаётся четырём закрытым методам оценки энтропии.
- Методы доступа (справа): каждый метод принимает целочисленное смещение offset, где 0 соответствует бару с индексом start_bar, и предотвращает обращение за пределы допустимого диапазона, возвращая ENT_EMPTY.
Сигнатура конструктора
//+------------------------------------------------------------------+
//| CEntropyFeatures constructor                                     |
//+------------------------------------------------------------------+
CEntropyFeatures::CEntropyFeatures(
   string          symbol,
   ENUM_TIMEFRAMES period,
   int             konto_window = 20,
   int             plugin_word  = 2,
   int             min_ticks    = 8
   )
  {
   m_symbol       = symbol;
   m_period       = period;
   m_konto_window = MathMax(0, konto_window);
   m_plugin_w     = MathMax(1, MathMin(ENT_MAX_W, plugin_word));
   m_min_ticks    = MathMax(4, min_ticks);
   m_n            = 0;
  }
konto_window = 0 включает вариант метода оценки энтропии Контоянниса с расширяющимся окном: для каждой точки оценки поиск ведётся назад до начала последовательности. konto_window > 0 ограничивает окно предыстории последними konto_window символами, ограничивая тем самым объём работы внутреннего цикла со сложностью O(n²). Значение по умолчанию 20 — разумное ограничение для последовательностей из 24–50 тиков на бар. Параметр plugin_word задаёт длину w-граммы для подстановочной оценки энтропии (Plug-In); значения больше 4 ограничиваются величиной ENT_MAX_W = 4 (81 уникальная w-грамма для алфавита из 3 символов — подходящий верхний предел, за которым таблица w-грамм становится разреженной). Нижняя граница для min_ticks равна 4 — это минимум, необходимый для получения содержательного результата методом оценки энтропии Контоянниса.
Энтропия Шеннона
Энтропия Шеннона характеризует маргинальное распределение символов, рассматривая каждое направление тика как результат независимого выбора из трёхсимвольного алфавита {0, 1, 2}:
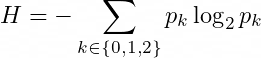
В реализации на MQL5 количество вхождений подсчитывается в целочисленном массиве из трёх элементов, что позволяет избежать выделения памяти в куче:
//+------------------------------------------------------------------+
//| _Shannon: marginal symbol-frequency entropy in bits              |
//+------------------------------------------------------------------+
double CEntropyFeatures::_Shannon(const uchar &seq[], int n)
  {
   if(n < 2)
      return(ENT_EMPTY);

   int cnt[3] = {0, 0, 0};
   for(int i = 0; i < n; i++)
     {
      if(seq[i] < 3) cnt[seq[i]]++;
     }

   double h = 0.0;
   for(int k = 0; k < 3; k++)
     {
      if(cnt[k] > 0)
        {
         double p = (double)cnt[k] / n;
         h -= p * MathLog(p) / MathLog(2.0);
        }
     }
   return(h);
  }
Энтропия Шеннона H лежит в интервале [0, log₂(3) ≈ 1.585]. Она достигает максимального значения, когда все три направления встречаются с одинаковой частотой (максимальная неопределённость относительно направления следующего тика), и снижается до нуля, когда встречается только одно направление. На баре с сильным трендом 80–90 % тиков соответствуют росту цены Bid; энтропия Шеннона H опускается значительно ниже 1.0. На баре со случайной последовательностью направлений тиков энтропия Шеннона H приближается к 1.585.
Энтропия Шеннона H представляет собой оценку по маргинальному распределению: она отражает частотное распределение отдельных символов, но не учитывает структуру их последовательности. Последовательность со строгим чередованием роста и снижения имеет ту же энтропию Шеннона H, что и последовательность с тем же числом тиков роста и снижения, расположенных в случайном порядке. Три следующих метода оценки энтропии предназначены именно для учёта этой структуры последовательности.
Подстановочная оценка энтропии (Plug-In)
Метод подстановочной оценки энтропии (Plug-In) обобщает энтропию Шеннона H на w-граммы: он вычисляет энтропию Шеннона по распределению всех перекрывающихся подпоследовательностей длины w, а затем нормирует результат, деля его на w, чтобы получить значение в битах на символ. На трендовом баре распределение w-грамм крайне неравномерно (доминирует одна и та же биграмма "рост→рост"), что снижает нормированную энтропию. На баре без выраженной структуры последовательности распределение w-грамм почти равномерно, поэтому нормированная энтропия близка к своему максимуму.
Подсчёт w-грамм на основе хешей
В Python используется функция numpy.lib.stride_tricks.sliding_window_view для извлечения всех перекрывающихся w-грамм в виде двумерного массива, а затем функция numpy.unique для подсчёта частот уникальных строк. В MQL5 нет ни того, ни другого. В реализации на MQL5 используется целочисленный хеш на основе троичной системы счисления: для w-граммы, начинающейся с позиции i, хеш равен
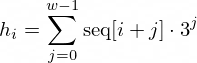
Поскольку алфавит состоит из символов {0, 1, 2}, каждая уникальная w-грамма сопоставляется с уникальным целым числом из интервала [0, 3^w). Это позволяет хранить счётчики в массиве фиксированного размера 3^w (не более 81 элемента при w = 4) без сортировки или поиска в словаре.
В реализации также применяется усечение arr[:n−1] из исходного модуля AFML на Python: обрабатываются только первые n − 1 символов закодированного массива:
//+------------------------------------------------------------------+
//| _PlugIn: block w-gram entropy, normalized to bits/symbol         |
//+------------------------------------------------------------------+
double CEntropyFeatures::_PlugIn(const uchar &seq[], int n, int w)
  {
   int m = n - 1;            // truncate to n-1 (Python compatibility)
   if(m < w)
      return(ENT_EMPTY);

   int alpha_pow = 1;
   for(int k = 0; k < w; k++) alpha_pow *= 3;

   int counts[];
   if(ArrayResize(counts, alpha_pow) < 0)
      return(ENT_EMPTY);
   ArrayInitialize(counts, 0);

   int total = 0;
   for(int i = 0; i <= m - w; i++)
     {
      int hash = 0, base = 1;
      for(int j = 0; j < w; j++)
        {
         hash += (int)seq[i + j] * base;
         base *= 3;
        }
      if(hash >= 0 && hash < alpha_pow)
        {
         counts[hash]++;
         total++;
        }
     }

   if(total == 0)
      return(ENT_EMPTY);

   double h = 0.0;
   for(int k = 0; k < alpha_pow; k++)
     {
      if(counts[k] > 0)
        {
         double p = (double)counts[k] / total;
         h -= p * MathLog(p) / MathLog(2.0);
        }
     }
   return(h / w);
  }
При w = 1 подстановочная оценка энтропии (Plug-In) сводится к энтропии Шеннона H, вычисленной по первым n − 1 символам; она отличается от энтропии Шеннона H, вычисленной по всем n символам, не более чем на вклад одного символа. Значение по умолчанию w = 2 позволяет учитывать первый уровень зависимости между последовательными символами: "рост→рост", "рост→снижение", "снижение→рост" и так далее. Усечение arr[:n−1] необходимо для численного совпадения с эталонной реализацией на Python; без него результаты на большинстве баров будут отличаться на небольшую, но систематическую величину.
Сложность Лемпеля — Зива
Сложность Лемпеля — Зива c(n)/n показывает количество различных фраз, полученных при жадном разборе последовательности по алгоритму LZ76. Алгоритм ведёт словарь фраз: начиная с позиции 1, он удлиняет текущую фразу-кандидат, пока не найдёт кратчайшее продолжение, отсутствующее в словаре, добавляет его как новую фразу и переходит к следующей позиции. Сложность определяется как общее количество фраз, деленное на длину последовательности.
Принадлежность к словарю фраз и вхождение в произвольном месте текста
В исходном модуле AFML на Python была ошибка в проверке принадлежности к словарю: внутренний цикл проверял, встречается ли фраза-кандидат где-либо в тексте до текущей позиции, а не входит ли она в словарь фраз. Эти два условия не являются эквивалентными. Рассмотрим последовательность, в которой фраза "AB" была добавлена в словарь на позиции 3, а та же подстрока "AB" встречается в другом месте текста на позиции 7, но на этой позиции в словарь не добавлялась. Версия с ошибкой считает "AB" уже встречавшейся подстрокой; правильная версия проверяет только словарь. В части 7 эта ошибка была исправлена в коде на Python; в реализации на MQL5 применено то же исправление.
Словарь представлен двумя параллельными целочисленными массивами — lib_starts[] и lib_lengths[], — в которых хранятся начальная позиция и длина каждой фразы. Принадлежность к словарю проверяется сравнением содержимого фразы-кандидата с каждой записью словаря той же длины:
//+------------------------------------------------------------------+
//| _LempelZiv: LZ complexity c(n)/n with phrase-library check       |
//+------------------------------------------------------------------+
double CEntropyFeatures::_LempelZiv(const uchar &seq[], int n)
  {
   if(n < 2)
      return(ENT_EMPTY);

   int lib_starts[], lib_lengths[];
   if(ArrayResize(lib_starts,  n) < 0) return(ENT_EMPTY);
   if(ArrayResize(lib_lengths, n) < 0) return(ENT_EMPTY);

   lib_starts[0]  = 0;
   lib_lengths[0] = 1;
   int lib_size = 1, phrase_cnt = 1, pos = 1;

   while(pos < n)
     {
      bool found_new = false;
      for(int length = 1; length <= n - pos; length++)
        {
         bool in_lib = false;
         for(int p = 0; p < lib_size && !in_lib; p++)
           {
            if(lib_lengths[p] != length) continue;
            bool match = true;
            int  s     = lib_starts[p];
            for(int k = 0; k < length && match; k++)
               match = (seq[pos + k] == seq[s + k]);
            if(match) in_lib = true;
           }
         if(!in_lib)
           {
            if(lib_size < n)
              {
               lib_starts[lib_size]  = pos;
               lib_lengths[lib_size] = length;
               lib_size++;
              }
            phrase_cnt++;
            pos += length;
            found_new = true;
            break;
           }
        }
      if(!found_new)
        { phrase_cnt++; break; }
     }

   return((double)phrase_cnt / n);
  }
В худшем случае временная сложность составляет O(n²) на бар: каждая новая фраза потенциально требует проверки всех предыдущих записей словаря. Для сообщений из 24–50 тиков, формируемых для каждого бара, это означает не более нескольких сотен сравнений и на практике не становится узким местом. Если тиковые последовательности становятся значительно длиннее (например, при обработке баров M1 с сотнями тиков), внутренний цикл следует заменить использованием хеш-таблицы или префиксного дерева.
Энтропия Контоянниса
Метод оценки энтропии Контоянниса приближенно определяет скорость энтропии, измеряя, насколько быстро усложняется поиск совпадений по мере продвижения точки оценки по последовательности. Для каждой позиции i во второй половине последовательности алгоритм находит самую длинную подпоследовательность, начинающуюся в позиции i и встречающуюся также в окне предыстории [look_start, i). Длина совпадения Λi используется в методе оценки энтропии следующим образом:
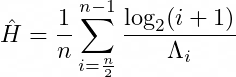
Высокая степень совпадения (большое значение Λi) указывает на предсказуемую последовательность и низкую энтропию. Низкая степень совпадения (короткие совпадения, Λi = 1) указывает на случайную последовательность и большой вклад в оценку энтропии.
Нижняя граница значения лямбда
Если в окне предыстории для заданной позиции не найдено совпадений ни одной длины — что может произойти, если символ в позиции i вообще не встречался в этом окне, — исходная длина самого длинного совпадения будет равна нулю, что приведёт к ошибке деления на ноль. В реализации значение Λi ограничивается снизу единицей:
int lambda_i = MathMax(1, lam - 1);
Это гарантирует, что совершенно новый символ вносит в оценку энтропии полный вклад в размере log₂(i+1) единиц, что согласуется с максимальной локальной неожиданностью такого символа.
//+------------------------------------------------------------------+
//| _Konto: Kontoyiannis entropy rate with bounded look-back         |
//+------------------------------------------------------------------+
double CEntropyFeatures::_Konto(const uchar &seq[], int n, int window)
  {
   if(n < ENT_MIN_N)
      return(ENT_EMPTY);

   double sum  = 0.0;
   int    half = n / 2;

   for(int i = half; i < n; i++)
     {
      int look_start = (window > 0) ? MathMax(0, i - window) : 0;

      int lam = 1;
      while(true)
        {
         if(i + lam > n) break;
         bool found = false;
         for(int j = look_start; j < i && !found; j++)
           {
            if(j + lam > n) continue;
            bool match = true;
            for(int k = 0; k < lam && match; k++)
               match = (seq[i + k] == seq[j + k]);
            if(match) found = true;
           }
         if(!found) break;
         lam++;
        }

      int lambda_i = MathMax(1, lam - 1);
      sum += MathLog((double)(i + 1)) / MathLog(2.0) / lambda_i;
     }
   return(sum / n);
  }
Обратите внимание, что внутренний поиск по j допускает для кандидата в позиции j перекрытие с точкой оценки i (т. е. j < i ≤ j + lam). Это корректно: окно предыстории определяется относительно i, а не относительно конечной точки кандидата. В исходном коде AFML на Python ранее по ошибке использовалось защитное условие
if j + length > start:
    break
которое ошибочно запрещало такое перекрытие, приводя к систематически более коротким совпадениям и заниженным оценкам скорости энтропии. Реализация на MQL5 воспроизводит исправленное поведение из части 7.
Интеграция с советником
Советник подключает файл CEntropyFeatures.mqh и выделяет память для объекта в функции OnInit(). Чтобы добавить энтропийные признаки в вектор признаков перед каждой оценкой сигнала, советник вызывает метод Calculate() для последнего закрытого бара и считывает четыре оценки со смещением 0:
#include <Features\CEntropyFeatures.mqh>

CEntropyFeatures *g_ent;

int OnInit()
  {
   g_ent = new CEntropyFeatures(_Symbol, _Period,
                                   20,   // Konto window
                                   2,    // plugin word length
                                   8);  // min ticks per bar
   return(INIT_SUCCEEDED);
  }

void OnTick()
  {
   //--- recompute on new-bar event only
   static datetime last_bar = 0;
   datetime        current  = iTime(_Symbol, _Period, 0);
   if(current == last_bar) return;
   last_bar = current;

   if(!g_ent.Calculate(1, 1))
      return;

   double h  = g_ent.ShannonH(0);
   double pi = g_ent.PlugInH(0);
   double lz = g_ent.LempelZiv(0);
   double kt = g_ent.KontoH(0);

   if(h <= ENT_EMPTY + 1.0)
      return;   // tick data unavailable for this bar

   //--- append to feature vector and run ONNX inference ...
  }

void OnDeinit(const int reason)
  {
   if(g_ent != NULL) { delete g_ent; g_ent = NULL; }
  }
Вызов Calculate(1, 1) при появлении каждого нового бара выполняет расчёт для одного бара и однократно вызывает CopyTicksRange(). При работе в реальном времени это требует небольших вычислительных затрат. Если советнику нужна история большей глубины (например, для вычисления скользящего среднего энтропии за 20 баров), при первом вызове передайте большее значение аргумента n_bars и сохраните результаты в кеше; последующие вызовы с n_bars = 1 будут обновлять только последний бар.
Проверка значения-маркера — if(h <= ENT_EMPTY + 1.0) — определяет, будет ли обновляться весь вектор признаков. Если данные об энтропии недоступны (бар находится за пределами тикового кеша), советник пропускает оценку сигнала для этого бара, вместо того чтобы использовать устаревший или выдуманный признак.
Индикатор просмотра энтропии
EntropyViewer.mq5 отображает результаты всех четырех методов оценки энтропии в виде линейных графиков в отдельном подокне индикатора с возможностью нормализации по z-оценке в скользящем окне, которая устраняет различия в масштабах, например между значениями LZ в диапазоне (0, 1] и значениями Konto, которые могут достигать log₂(n). Индикатор имеет четыре входных параметра:
| Входной параметр | По умолчанию | Назначение |
|---|---|---|
| inp_max_bars | 300 | Количество последних баров, для которых выполняется расчет; определяет частоту вызовов CopyTicksRange() |
| inp_konto_window | 20 | Окно предыстории для метода оценки энтропии Контоянниса (0 = расширяющееся окно) |
| inp_plugin_word | 2 | Длина w-граммы для подстановочной оценки энтропии (Plug-In) (1–4) |
| inp_normalize | false | Применить нормализацию по z-оценке в скользящем окне (окно = 60 баров) |
При каждом вызове OnCalculate() индикатор вызывает CEntropyFeatures::Calculate(1, inp_max_bars) и повторно выполняет расчет для всего окна. Это сделано намеренно: оценки энтропии зависят от последовательности тиков внутри бара, которая продолжает пополняться до его закрытия, поэтому оценка для самого последнего бара может меняться по мере поступления новых тиков. Значение параметра inp_max_bars по умолчанию, равное 300, позволяет удерживать суммарные накладные расходы на вызовы CopyTicksRange() в приемлемых пределах; уменьшите его для графиков с более высокой частотой, на которых бары содержат сотни тиков и внутренний цикл LZ становится узким местом.
Сопоставление индексов буферов
CEntropyFeatures хранит результаты в порядке индексации таймсерии: индекс 0 соответствует самому последнему бару. Буферы индикатора MetaTrader 5 хранят результаты, причем элемент с индексом 0 соответствует самому старому бару, отображаемому на графике (в хронологическом порядке). Сопоставление индекса класса k индексу буфера выглядит следующим образом:
buf_idx = rates_total - 2 - k;
Индекс rates_total − 1 соответствует текущему формирующемуся бару (бару 0 в классе), который исключается. Индекс rates_total − 2 соответствует последнему закрытому бару (индекс класса 0). Последующие индексы класса соответствуют все более старым барам.
Проверка
Профили рыночных режимов
На рисунке 2 показаны все четыре оценки энтропии, рассчитанные с помощью CEntropyFeatures для 60 синтетических баров, разделенных на четыре последовательных участка с разными рыночными режимами. Каждый бар содержит синтетическую последовательность из 24 направлений изменения цены на тиках; распределение направлений различается в зависимости от режима, что позволяет получить ожидаемое поведение энтропии.
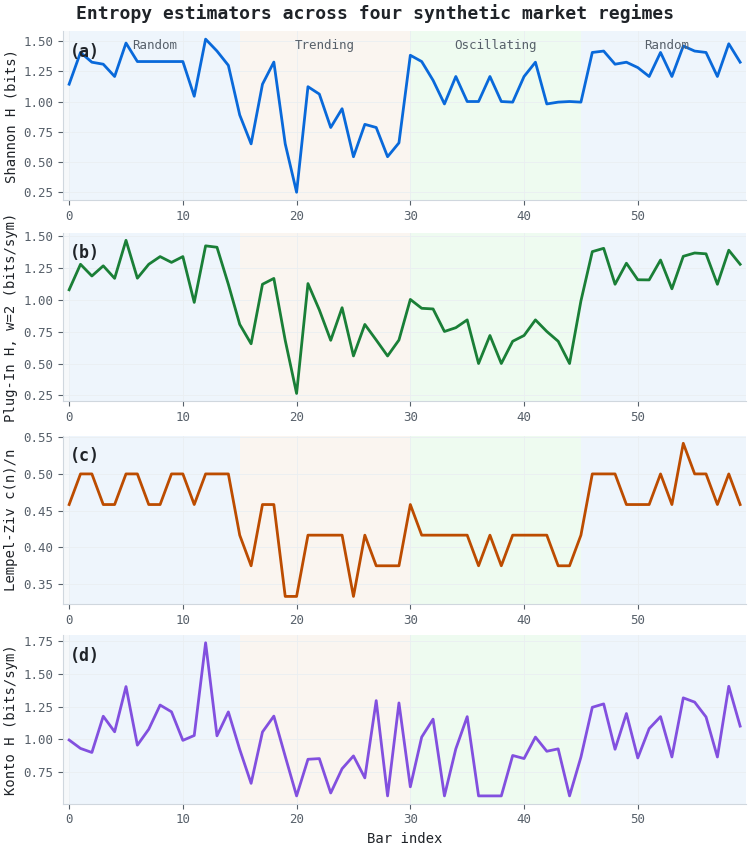
Рисунок 2. Четыре графика, иллюстрирующие результаты методов оценки энтропии в четырех синтетических рыночных режимах
- График (a) — энтропия Шеннона H: резко снижается в трендовом режиме (бары 15–30), где 80 % тиков соответствуют росту цены; восстанавливается в колебательном и заключительном случайном режимах. Максимальное значение для равномерного распределения по трем символам составляет log₂(3) ≈ 1.585.
- График (b) — подстановочная оценка энтропии (Plug-In) H (w=2): также снижается в трендовом режиме и еще сильнее падает в колебательном режиме, поскольку преобладают биграммы "рост→снижение" и "снижение→рост", создавая неравномерное распределение биграмм даже при сбалансированных частотах отдельных направлений. В этом заключается информационное преимущество метода подстановочной оценки энтропии (Plug-In) перед энтропией Шеннона H.
- График (c) — сложность Лемпеля — Зива c(n)/n: снижается в трендовом режиме (повторяющиеся последовательности тиков формируют небольшой словарь фраз) и умеренно повышается в колебательном режиме (чередующийся шаблон поддается сжатию, но в меньшей степени, чем чистый тренд). Теоретический максимум приближается к 1 для максимально сложной (несжимаемой) последовательности.
- График (d) — энтропия Контоянниса H: демонстрирует более высокую дисперсию значений от бара к бару, чем другие методы оценки, при n = 24 тика на бар и ограниченном окне длиной 12. Тенденция прослеживается, но с более высоким уровнем шума, что согласуется с известной чувствительностью метода оценки энтропии Контоянниса к длине сообщения при малых значениях n.
Согласованность результатов Python и MQL5
Рисунок 3 подтверждает, что реализация на MQL5 точно воспроизводит результаты эталонной реализации на Python для всех четырёх методов оценки энтропии. Проверка проводилась на 100 синтетических барах с последовательностями тиков, сгенерированными по тем же трём распределениям рыночных режимов, что и на рисунке 2. На каждом графике по оси x отложены результаты реализации на Python, а по оси y — соответствующие результаты реализации на MQL5; все 100 точек лежат на диагонали y = x, что даёт r² = 1.000000 для каждого метода оценки энтропии.
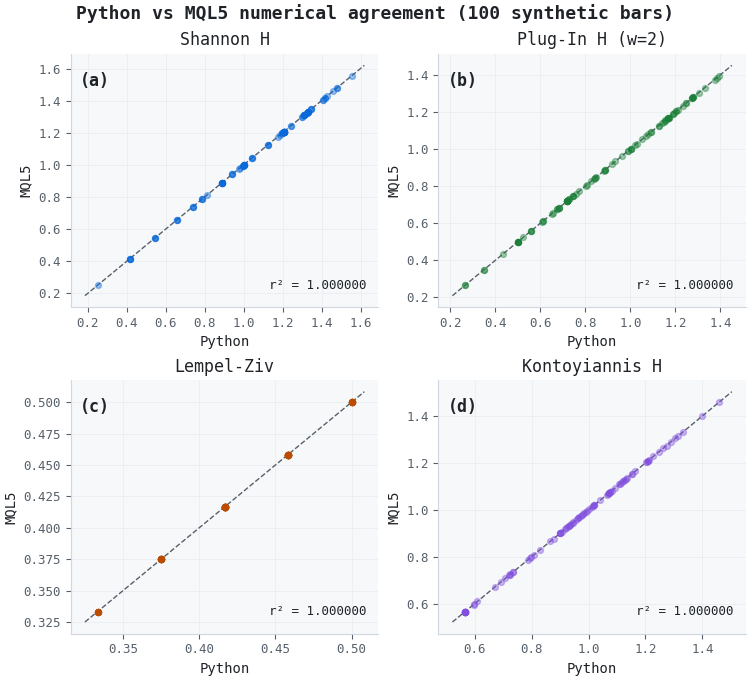
Рисунок 3. Иллюстрация из четырёх графиков (2×2), демонстрирующая совпадение численных результатов реализаций на Python и MQL5 на 100 синтетических барах
- Графики (a)–(d): по одному графику для каждого метода оценки энтропии. Все точки лежат на диагонали y = x; r² = 1.000000 для энтропии Шеннона H, подстановочной оценки энтропии (Plug-In) H, сложности Лемпеля — Зива и энтропии Контоянниса H. Точное совпадение объясняется тем, что обе реализации выполняют одинаковые шаги алгоритмов: усечение arr[:n−1] в подстановочной оценке энтропии (Plug-In), проверку принадлежности словарю фраз (а не произвольного вхождения) при вычислении сложности Лемпеля — Зива и ограничение снизу Λi ≥ 1 при вычислении энтропии Контоянниса.
Скрипт проверки
Скрипт EntropyValidation.mq5 автоматизирует проверку пяти свойств при запуске в качестве скрипта на любой ликвидной валютной паре с актуальными тиковыми данными:
// Expected output (any liquid pair with tick data available):
// [CHECK 1] PASS — Count() = n_bars
// [CHECK 2] PASS — Shannon's H ∈ [0, 1.585]: N valid, 0 violations
// [CHECK 3] PASS — Plug-In H ∈ [0, 1.585]: N valid, 0 violations
// [CHECK 4] PASS — Lempel-Ziv ∈ (0, 1]: N valid, 0 violations
// [CHECK 5] PASS — Konto H > 0: N valid, 0 violations
// Tick data coverage: N / 50 bars had >= 8 ticks
Строка с данными о покрытии тиковыми данными — ключевой диагностический показатель: сразу после запуска скрипта на графике в тиковом кеше терминала ещё может не быть данных для всех 50 баров, поэтому значение N может быть меньше 50. После того как график пробудет открытым несколько минут и MetaTrader 5 загрузит необходимую историю тиков, покрытие тиковыми данными для ликвидных пар на часовом и более коротких таймфреймах приближается к 50/50. Если через несколько минут покрытие тиковыми данными остаётся низким, глубина тикового кеша брокера может быть недостаточной для выбранного таймфрейма и количества баров; проблему можно решить, уменьшив значение inp_n_bars или перейдя на более короткий таймфрейм.
Заключение
Версия для MQL5 содержит готовую к практическому применению реализацию четырёх методов оценки энтропии и сопутствующие компоненты интеграции, необходимые для их использования в советнике или индикаторе. Основные компоненты — полностью реализованный в заголовочном файле класс CEntropyFeatures (ShannonH, PlugInH, LempelZiv, KontoH и значение-маркер ENT_EMPTY), индикатор EntropyViewer для визуализации (с необязательной нормализацией по z-оценке) и скрипт Validation, проверяющий границы значений и покрытие тиковыми данными. В версии для MQL5 реализованы три адаптации с учётом специфики платформы: использование CopyTicksRange() и отдельной ветви обработки со значением-маркером ENT_EMPTY для баров за пределами тикового кеша брокера; целочисленный хеш на основе троичной системы счисления для индексации массива счётчиков фиксированного размера и эффективного подсчёта частот w-грамм; ограниченное окно предыстории при вычислении энтропии Контоянниса для ограничения вычислительных затрат на коротких тиковых последовательностях.
Все четыре метода оценки энтропии дают результаты, точно совпадающие с эталонной реализацией на Python в синтетических тестах (r² = 1.000000), и учитывают алгоритмические исправления из части 7 (усечение arr[:n−1] для подстановочной оценки энтропии (Plug-In), проверку принадлежности словарю фраз для сложности Лемпеля — Зива и ограничение снизу Λi ≥ 1 для энтропии Контоянниса). Обратите внимание на практическое ограничение: энтропийные признаки доступны только для баров в пределах тикового кеша брокера, поэтому реализация лучше всего подходит для работы в реальном времени и с недавними историческими барами по ликвидным инструментам. В следующей статье мы вернёмся к Python и рассмотрим признаки для обнаружения структурных сдвигов, которые дополняют эти меры энтропии при определении рыночных режимов.
Прикрепленные файлы
| # | Файл | Каталог назначения | Назначение |
|---|---|---|---|
| 1 | CEntropyFeatures.mqh | MQL5\Include\Features\ | Класс, полностью реализованный в заголовочном файле: извлечение последовательности тиков и четыре метода оценки энтропии |
| 2 | EntropyViewer.mq5 | MQL5\Indicators\ | Индикатор в отдельном окне с четырьмя буферами DRAW_LINE и опциональной нормализацией по z-оценке |
| 3 | EntropyValidation.mq5 | MQL5\Scripts\ | Скрипт: пять проверок свойств (границы значений и количество) с отчётом о покрытии тиковыми данными |
Список литературы
- Лопес де Прадо, М. (2018). Достижения в области финансового машинного обучения, глава 18: Энтропийные признаки. Wiley.
- Контояннис, И., Альгоет, П. Х., Сухов, Ю. М. и Вайнер, А. Дж. (1998). Непараметрическая оценка энтропии для стационарных процессов и случайных полей: применение к английскому тексту. IEEE Transactions on Information Theory, 44(3), 1319–1324.
- Зив, Дж., и Лемпель, А. (1976). О сложности конечных последовательностей. IEEE Transactions on Information Theory, 22(1), 75–81.
- Шеннон, К. Э. (1948). Математическая теория связи. "Bell System Technical Journal", 27(3), 379–423.
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/23077
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.

 Интерактивное управление зонами спроса и предложения на MQL5 (Часть III): Анализ зон и отслеживание взаимодействий цены с зоной
 Создание индикатора EquiVolume на языке MQL5

 Каналы линейной регрессии на MQL5: Построение статистически обоснованных доверительных и прогнозных полос

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования
Ознакомьтесь с новой статьей: «Инженерия признаков для машинного обучения (часть 8): энтропийные признаки в MQL5».
Автор: Патрик Мурими Ньороге
Какая замечательная статья!