

Redes neuronales en el trading: Framework de predicción cruzada de dominios de series temporales (Final)
 63
 0

Introducción
En las últimas décadas, el trading financiero ha experimentado cambios fundamentales, hasta convertirse en un ámbito altamente tecnológico y regido por métodos rigurosos. Si antes el éxito de un trader dependía en gran medida de la intuición, la experiencia y las observaciones personales, hoy en día cobra protagonismo la capacidad de procesar de forma rápida y eficaz enormes volúmenes de datos, elaborar previsiones precisas y tomar decisiones basadas en algoritmos avanzados. Con el desarrollo de la potencia computacional y la aparición de métodos modernos de aprendizaje automático, los traders e investigadores disponen ahora de nuevas herramientas capaces de detectar patrones y tendencias en el aparente caos de los datos de mercado. No obstante, a pesar de los importantes avances, la predicción a corto y medio plazo de las series temporales de los mercados financieros sigue siendo una tarea de gran complejidad.
La razón radica en la naturaleza única y compleja de los mercados financieros. Se trata de sistemas que se caracterizan por un alto nivel de ruido, en los que las señales reales suelen quedar ocultas bajo una gran cantidad de fluctuaciones aleatorias y artefactos. Los datos de mercado son no estacionarios: sus propiedades estadísticas cambian con el tiempo, lo que se manifiesta en cambios de régimen de mercado, pasando de fases tranquilas a fases volátiles y viceversa. Además, los mercados están sujetos a acontecimientos imprevistos, como noticias, crisis o intervenciones de los organismos reguladores, que alteran los patrones habituales de comportamiento de los precios. Todo ello crea un entorno en el que los modelos tradicionales de series temporales se enfrentan a limitaciones fundamentales.
Los métodos estadísticos clásicos han demostrado su eficacia en el análisis de procesos estacionarios; sin embargo, su aplicabilidad a los datos de mercado actuales es limitada. Por otro lado, las redes neuronales —incluidas las LSTM y las GRU— se han generalizado como herramientas más flexibles para modelar dependencias temporales complejas. No obstante, también requieren grandes volúmenes de datos para el entrenamiento y, al pasar a nuevos activos o condiciones de mercado, suelen perder precisión y estabilidad. El motivo es que la mayoría de los modelos están vinculados a determinadas estructuras y patrones de datos que no siempre son universales.
En este sentido, surge un problema clave: cómo construir un modelo capaz de generalizar y adaptarse sin necesidad de entrenamiento adicional, lo que se conoce como Zero-Shot Forecasting. Un modelo de este tipo, entrenado con una gran cantidad de series temporales diversas procedentes de distintos dominios, debe tener una representación interna que le permita reconocer patrones y regularidades similares en datos completamente nuevos, no vistos anteriormente. Esto cambia radicalmente el enfoque de la predicción: el modelo deja de ser un especialista en un solo mercado y se convierte en un analista universal, capaz de transferir conocimientos entre diferentes tareas.
Precisamente para este concepto se desarrolló el framework TimeFound, que empezamos a conocer en el artículo anterior. TimeFound es un modelo de series temporales potente y versátil, aplicable a múltiples dominios, basado en la arquitectura Transformer. Transformer es un método revolucionario, propuesto por primera vez en tareas de procesamiento del lenguaje natural, que se ha difundido ampliamente gracias a su capacidad para captar eficazmente dependencias largas en secuencias. En TimeFound, este potencial se aprovecha para analizar series financieras, pero con un añadido importante: la aplicación del mecanismo de Multi-Resolution Patching (segmentación en parches multiescala).
La idea del Multi-Resolution Patching consiste en dividir la serie temporal original en parches, es decir, fragmentos de distinta longitud que reflejan diferentes escalas temporales. Por ejemplo, los parches cortos captan las oscilaciones locales y rápidas, mientras que los largos captan tendencias más lentas y globales. Este enfoque multinivel permite al modelo tener en cuenta simultáneamente varias capas de información, lo cual es fundamental en el caso de los datos financieros, donde las señales se manifiestan en distintos horizontes temporales.
Desde el punto de vista técnico, la arquitectura de TimeFound incluye un conjunto de módulos de proyección independientes: uno para cada grupo de parches de una escala determinada. Cada uno de estos módulos es un pequeño perceptrón de dos capas con conexiones residuales. Recibe como entrada parches y máscaras binarias de puntos válidos, lo que ayuda a ignorar eficazmente el padding y el llenado artificial de valores ausentes. Gracias a los módulos de proyección independientes y a las particularidades de la repetición de parches, el modelo distingue las aportaciones de cada escala temporal, lo que le confiere robustez frente a desplazamientos de fase, variaciones en la longitud de los datos de entrada y valores ausentes.
Para el entrenamiento de TimeFound, se recopiló y preparó minuciosamente una amplia muestra de series temporales procedentes de ámbitos muy diversos, desde indicadores macroeconómicos y cotizaciones de mercado hasta procesos físicos. Esto permitió que el modelo desarrollara capacidad de generalización y trabajara con éxito con datos nuevos, no vistos anteriormente.
A continuación se muestra la visualización del framework realizada por el autor:
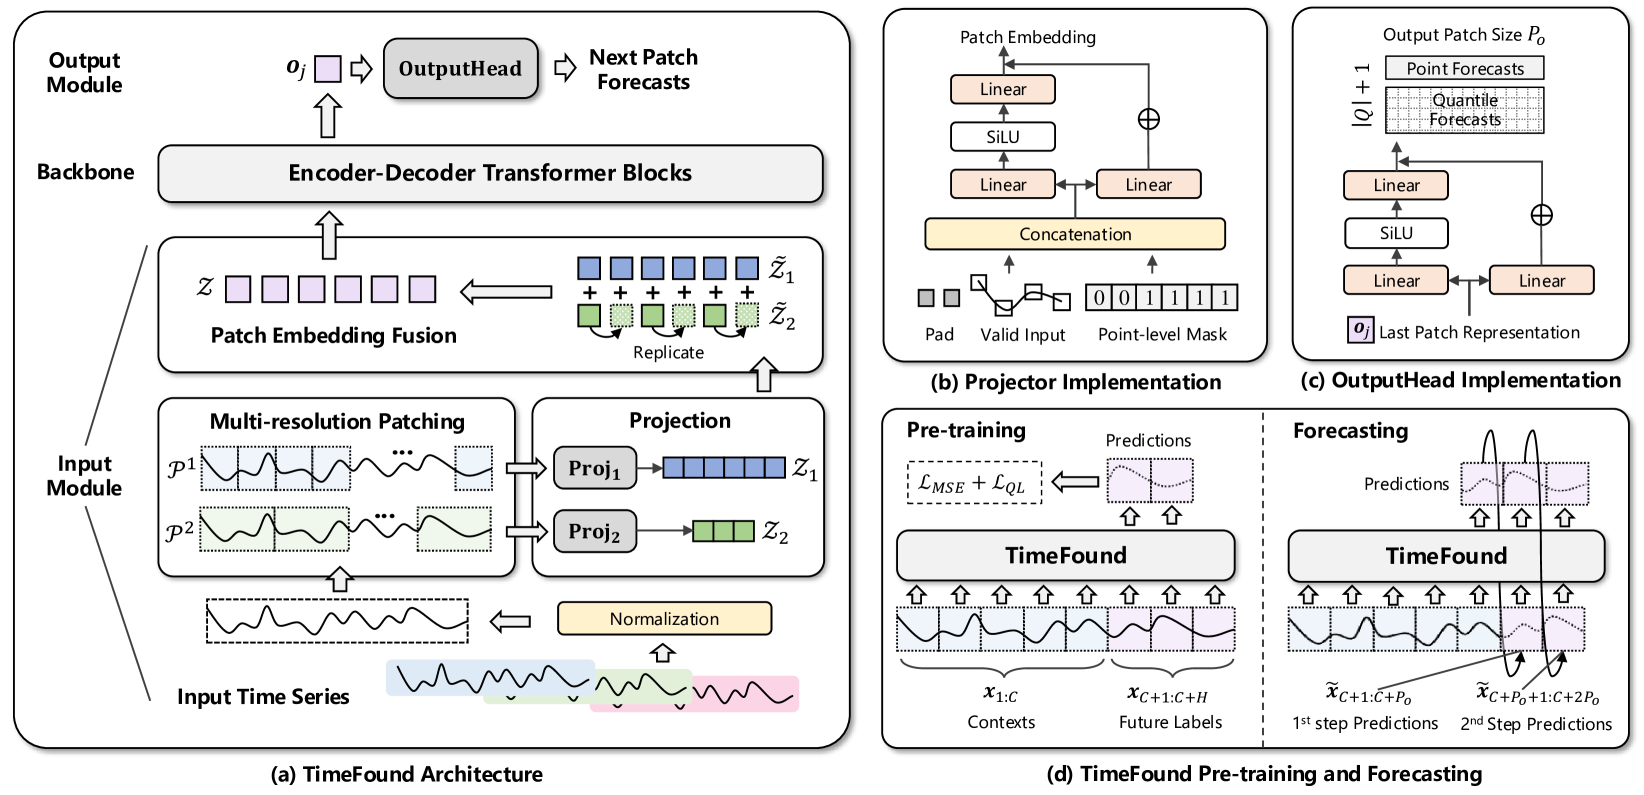
En la parte práctica del artículo anterior, analizamos en detalle la implementación del módulo de segmentación en parches multiescala, un componente clave del bloque de preparación de datos del framework TimeFound. Este módulo se encarga de formar de manera eficaz tokens informativos: representaciones compactas y expresivas de fragmentos individuales de una serie temporal, segmentados en parches de distinta longitud y escala. Precisamente gracias a este mecanismo, el modelo puede percibir y procesar los datos teniendo en cuenta tanto las características locales como las globales del mercado.
Hoy continuaremos el trabajo iniciado.
Codificador-decodificador de TimeFound
El tensor de tokens formado en la etapa de segmentación en parches se transfiere al bloque Transformer para su posterior análisis. Es precisamente aquí donde comienza el procesamiento inteligente de los datos: la identificación de patrones ocultos, la predicción de la dinámica y la generación de señales.
Los autores del framework TimeFound proponen utilizar en esta parte de la arquitectura el esquema clásico «codificador-decodificador», muy conocido en los modelos de traducción automática y análisis de secuencias. Sin embargo, en el contexto de las series temporales, este esquema se ha adaptado y reforzado con una serie de añadidos para tener en cuenta las características específicas de los datos.
En el codificador se utiliza la autoatención bidireccional. Esto significa que cada token se analiza en el contexto del resto, tanto directa como inversa en la línea temporal. De este modo, el modelo puede tener en cuenta no solo lo que ha ocurrido hasta el momento actual, sino también las posibles relaciones con los acontecimientos que se producirán más adelante. Esto resulta especialmente útil a la hora de analizar periodos históricos ya concluidos. Este enfoque permite captar relaciones más profundas.
En el decodificador, por el contrario, la visibilidad está limitada de forma intencionada: cada token solo puede ver aquellos que lo preceden en el tiempo. Un elemento clave del decodificador es el módulo de atención cruzada (Cross-Attention). En este caso, los datos recibidos del codificador se proporcionan como contexto, y el decodificador relaciona los tokens recibidos en la entrada con esta información contextual. Esto permite generar predicciones de salida con mayor precisión.
Esta distribución de tareas entre el codificador y el decodificador, así como el uso de mecanismos de atención, hacen que la arquitectura TimeFound sea especialmente flexible. No solo es capaz de reaccionar ante los últimos movimientos del precio, sino también de analizar el comportamiento del activo en un amplio contexto histórico, tener en cuenta los patrones del mercado y distinguir el ruido habitual de las señales significativas.
En el arsenal de nuestra biblioteca ya contamos con numerosas variantes de los módulos de autoatención (Self-Attention) y atención cruzada (Cross-Attention), desde los más básicos hasta los más avanzados, con enmascaramiento y selección dinámica de las cabezas de atención. Y, por supuesto, no dejaremos pasar la oportunidad de aprovechar estos avances en el marco de la implementación del modelo TimeFound. Sin embargo, es importante tener en cuenta aquí un matiz conceptual: los autores del framework proponen utilizar un enfoque autorregresivo para generar la previsión.
El modelo no elabora una previsión para todo el intervalo de tiempo en un solo paso. En cambio, funciona de forma iterativa. En cada iteración, el Transformer recibe como entrada datos históricos —un tensor de tokens que refleja las distintas escalas de los patrones de mercado— y genera un token que corresponde al siguiente segmento. Este token se interpreta como un estado predicho. El resultado obtenido se añade a los datos históricos y se repite el proceso. Así, paso a paso, se va elaborando la previsión para todo el horizonte de interés.
En nuestro caso, no pretendemos hacer previsiones a largo plazo. No nos dedicamos a adivinar el futuro, sino a desarrollar un algoritmo sistemático de gestión de posiciones. El modelo se ejecuta en cada nueva barra, recalcula el estado basándose en los datos reales ya conocidos y toma una decisión: mantener, cerrar, invertir la posición o aumentar el volumen. Por supuesto, al realizar una operación de trading hacemos una previsión a cierto horizonte, pero en cada nueva barra la ajustamos de acuerdo con la realidad actualizada.
No obstante, el propio principio de autorregresión impone ciertos requisitos arquitectónicos. En cada paso es necesario introducir el mismo conjunto de datos históricos tanto en el codificador como en el decodificador. El codificador los analiza en el contexto de toda la historia, identificando patrones comunes, mientras que el decodificador utiliza el estado actual —que forma parte de esa misma secuencia histórica— para analizarlo en el contexto de las dependencias históricas identificadas por el codificador y construir valores predictivos. De este modo, obtenemos dos flujos de trabajo paralelos con los mismos datos.
Para garantizar dicha sincronización, crearemos el objeto CNeuronTimeFoundTransformerUnit. Su función consiste en gestionar de forma centralizada el flujo de información. Esto permitirá mantener la limpieza de la arquitectura y facilitará la futura ampliación o sustitución de componentes. A continuación se muestra la estructura del nuevo objeto.
class CNeuronTimeFoundTransformerUnit  :  public CNeuronCrossDMHAttention
  {
protected:
   CNeuronMVMHAttentionMLKV   cSelfAttention;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override
                                                              { return feedForward(NeuronOCL); }
   virtual bool      calcInputGradients(CNeuronBaseOCL *prevLayer) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput,
                                        CBufferFloat *SecondGradient, ENUM_ACTIVATION SecondActivation = None)
                                        override
                                        { return calcInputGradients(NeuronOCL); }
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override
                                        { return updateInputWeights(NeuronOCL); }

public:
                     CNeuronTimeFoundTransformerUnit(void) {};
                    ~CNeuronTimeFoundTransformerUnit(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl, uint window,
                          uint window_key, uint heads, uint heads_kv, uint units_count,
                          uint layers, uint layers_to_one_kv, uint variables,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override const { return defNeuronTimeFoundTransformerUnit; }
   //---
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
  };
En la estructura de la nueva clase presentada observamos un único objeto interno: el módulo de autoatención, que desempeña las funciones de codificador del modelo que se está creando. La funcionalidad del decodificador se implementa mediante la clase padre, que utiliza como base el módulo de atención cruzada.
Sin embargo, tras esa aparente sencillez se esconde un algoritmo minuciosamente elaborado. Como codificador actúa el bloque de análisis independiente de canales CNeuronMVMHAttentionMLKV. Su característica principal es la capacidad de realizar un análisis independiente de cada secuencia unitaria, es decir, de cada variable o indicador por separado. Si a la entrada del modelo llegan, por ejemplo, precios, volúmenes y volatilidad, CNeuronMVMHAttentionMLKV capta dependencias internas dentro de cada serie temporal, sin mezclar las señales en una fase temprana. Esto minimiza el ruido cruzado y permite que el modelo comprenda mejor la estructura de cada fuente de datos, lo que mejora considerablemente la interpretabilidad de los resultados obtenidos.
El uso del mecanismo Multi-Layer Key-Value (MLKV) —una de las ideas más elegantes para optimizar la complejidad computacional de Transformer— aporta una eficiencia adicional. En las implementaciones clásicas, cada capa de autoatención utiliza sus propios Key y Value. Aquí, en cambio, estos tensores se conservan y se reutilizan para varias capas, mientras que Query se refina en cada nivel. Este enfoque reduce la carga computacional y, al mismo tiempo, permite precisar el significado de forma progresiva, como si volviéramos a leer un texto que ya conocemos y cada vez descubriéramos nuevos detalles. Esto resulta especialmente valioso en el trading: en la primera pasada, el modelo puede detectar patrones locales y, posteriormente, estructuras de mercado cada vez más generales.
De este modo, el codificador en esta implementación cumple una doble función:
- Por un lado, la autoatención bidireccional clásica, que identifica las relaciones entre los tokens en ambas direcciones a lo largo del eje temporal.
- Por otro lado, el análisis modular de cada secuencia unitaria, con la posibilidad de comprender su estructura en múltiples capas.
Ahora pasemos al decodificador. En esta sección utilizamos el módulo CNeuronCrossDMHAttention, que implementa una atención cruzada diversificada de múltiples cabezas. Además, presenta una serie de ventajas arquitectónicas.
En primer lugar, el decodificador, de acuerdo con la estructura clásica de Transformer, incluye módulos de dos tipos de atención:
- Autoatención: analiza las dependencias entre los tokens de los datos de entrada del flujo principal de información;
- Atención cruzada: enriquece estos tokens con el contexto obtenido del codificador.
En ambos casos se utilizan módulos de codificación posicional relativa. Esto significa que el bloque de atención tiene en cuenta no solo la posición absoluta del token, sino también su posición relativa con respecto a los demás. Además, la atención se complementa con tres tipos de sesgos:
- un sesgo posicional dependiente del contenido,
- un sesgo global de contexto,
- un sesgo posicional global.
Esto permite que el modelo tenga en cuenta con mayor precisión no solo las distancias entre los eventos, sino también las relaciones cualitativas entre ellos, lo cual es fundamental para el análisis de datos de mercado secuenciales.
Tras el módulo de atención, viene el bloque FeedForward multicabeza. Su objetivo es llevar a cabo un procesamiento no lineal independiente en distintos subespacios de características. Esto permite identificar una amplia gama de patrones de mercado sin perder, al mismo tiempo, elementos estructurales importantes de la secuencia.
También conviene prestar atención a una diferencia importante entre los componentes de la arquitectura. A diferencia del codificador, el decodificador no divide las secuencias unitarias. Mientras que en el codificador el análisis de cada variable se realiza de forma aislada, conservando secuencias unitarias independientes, en el decodificador todos los tokens se agrupan en un único flujo. Aquí ya no hay límites entre las series unitarias: el modelo las percibe como un todo único.
Gracias a ello, en el decodificador es posible analizar las dependencias entre dominios. Es decir, relaciones entre variables que podrían pasar desapercibidas si se analizan por separado. El precio puede explicarse no solo por la evolución histórica del propio precio, sino también por la volatilidad, el volumen o, por ejemplo, la actividad del entorno informativo. Todas estas dependencias comienzan a manifestarse precisamente en los bloques de atención cruzada, donde los tokens del estado actual se enriquecen con la información codificada por el codificador.
El resultado es una arquitectura potente e interpretable, en la que el módulo del codificador CNeuronMVMHAttentionMLKV, compacto y elegante, se combina con un decodificador flexible y adaptativo basado en CNeuronCrossDMHAttention. Este modelo es fácilmente escalable, se adapta a distintos tipos de datos de mercado y mantiene una alta eficiencia computacional.
La declaración del codificador se realiza de forma estática, lo que nos permite dejar vacíos el constructor y el destructor de la clase. La inicialización de los componentes heredados y declarados se lleva a cabo de forma centralizada en el método Init. En los parámetros del método obtenemos una serie de constantes que permiten interpretar de forma inequívoca la arquitectura del objeto que se está creando.
bool CNeuronTimeFoundTransformerUnit::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl, uint window,
                                           uint window_key, uint heads, uint heads_kv, uint units_count,
                                           uint layers, uint layers_to_one_kv, uint variables,
                                           ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronCrossDMHAttention::Init(numOutputs, myIndex, open_cl, window, window_key, variables, window,
                                      units_count * variables, heads, layers, optimization_type, batch))
      return false;
   SetActivationFunction(None);
En el cuerpo del método, lo primero que hacemos es llamar al método homónimo de la clase padre, en el que ya se ha implementado el algoritmo de inicialización de los objetos e interfaces heredados.
En este punto conviene detenerse con más detalle en los parámetros de inicialización que se pasan al método de la clase padre. En primer lugar, hay que señalar que el objeto padre, a diferencia del que estamos creando, requiere dos flujos de datos de entrada: los datos que se van a analizar y el contexto. Por nuestra parte, en la entrada del objeto tenemos previsto recibir solo uno. El contexto se forma mediante el codificador dentro del módulo.
Es más, como datos de entrada, se transmite al objeto una secuencia multimodal de tokens que describen la ventana de datos históricos que se está analizando. Cada secuencia unitaria está representada por toda una serie de tokens, donde cada token corresponde a un parche: un segmento local de la serie temporal. Estos parches permiten al modelo centrarse en los cambios y patrones locales, identificando dependencias a corto plazo dentro de cada variable.
A la salida del objeto se espera solo un token por cada secuencia unitaria, que representa la predicción codificada del siguiente segmento de la serie temporal multimodal analizada. Al mismo tiempo, la arquitectura Transformer prevé que se mantengan las dimensiones del flujo de información principal.
Teniendo en cuenta lo anterior, hemos decidido enviar por la vía principal del decodificador únicamente los tokens que describen el último segmento del estado del entorno: uno por cada secuencia unitaria. Al mismo tiempo, a través del flujo de información adicional se transmite todo el volumen de información recibida, enriquecida con las dependencias internas en el codificador.
Una vez ejecutado con éxito el método de la clase padre, pasamos a la inicialización del codificador. Aquí pasamos información sobre el tamaño completo de la secuencia analizada.
   if(!cSelfAttention.Init(0, 0, OpenCL, window, window_key, heads, heads_kv, units_count, layers, layers_to_one_kv,
                           variables, optimization, iBatch))
      return false;
   cSelfAttention.SetActivationFunction(None);
//---
   return true;
  }
Tenga en cuenta que, en nuestra implementación, el codificador y el decodificador utilizan objetos de una arquitectura multicapa. Utilizamos el mismo número de capas en ambos módulos.
La siguiente etapa de nuestro trabajo consiste en construir el algoritmo de pasada directa de nuestro objeto. El algoritmo es bastante sencillo: solo hay que llamar a los métodos homónimos, primero al codificador y luego al decodificador. Sin embargo, es necesario prestar atención a algunos matices de los flujos de información. En los parámetros del método obtenemos un puntero al objeto de datos de origen. En él esperamos obtener datos en forma de tensor tridimensional [Longitud de la serie × Variable × Tamaño del token]. Ese es precisamente el orden de datos que necesitamos para el codificador, y le pasamos directamente un puntero al objeto.
bool CNeuronTimeFoundTransformerUnit::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cSelfAttention.FeedForward(NeuronOCL))
      return false;
Hemos acordado utilizar como datos de entrada del flujo de información principal del decodificador los tokens del segmento que contienen el último estado del entorno. Pero sabemos que los datos que se analizan se introducen en el modelo en orden cronológico inverso: primero se introducen los datos más recientes. Por lo tanto, los tokens que necesitamos se encuentran al principio del búfer de datos de origen. Aprovechando esta circunstancia, nos saltamos el paso de copiar el fragmento de datos necesario y simplemente transmitimos un puntero al objeto de los datos originales a través del flujo de información principal, mientras que los resultados del trabajo del codificador se transmiten a través del flujo auxiliar.
   if(!CNeuronCrossDMHAttention::feedForward(NeuronOCL, cSelfAttention.getOutput()))
      return false;
//---
   return true;
  }
Y finalizamos la ejecución del método, devolviendo previamente al programa llamador el resultado lógico de las operaciones.
Les propongo que revisen por su cuenta el algoritmo de los métodos de la pasada inversa. El código completo de la clase CNeuronCrossDMHAttention y de todos sus métodos se incluye en el archivo adjunto.
Arquitectura del modelo
Una vez creados todos los elementos necesarios, que constituyen los componentes estructurales de nuestro modelo, pasamos a la siguiente fase: la construcción de una arquitectura integral. Es importante señalar aquí que, al igual que en nuestros proyectos anteriores, estamos creando un agente de trading que funciona en el marco del concepto de aprendizaje por refuerzo.
En el contexto de la tarea planteada, el framework TimeFound se limita a la función de analizar el estado del entorno: el procesamiento previo de la información de mercado y la detección de patrones ocultos en las series temporales históricas. Precisamente en esta función, su componente se integrará en la arquitectura del codificador del entorno, que proporciona al resto del modelo una representación estructurada, depurada e interpretable de la situación actual del mercado.
En el marco del agente de trading, seguimos la estructura Actor–Director–Critic, en la que cada componente resuelve una tarea estrictamente definida. En la implementación actual, el sistema incluye 4 modelos autónomos que funcionan de forma conjunta:
- El Codificador del estado del entorno (Encoder) — se encarga de realizar un análisis en profundidad de los datos de mercado entrantes. Detecta patrones estables en las series temporales analizadas, creando una representación rica del contexto actual de trading. Es precisamente esta representación la que se transmite posteriormente al actor.
- El Actor (Actor) es el elemento central del agente. Al recibir como entrada información del codificador, genera decisiones concretas de trading.
- El Director (Director) y Crítico (Critic) — son subsistemas de evaluación. Evalúan las decisiones del actor, utilizando un modelo interno del futuro, y predicen las posibles consecuencias. Además, Director ofrece una evaluación binaria más estricta —si merece la pena siquiera tener en cuenta ese tipo de comportamiento— y Critic, una métrica cuantitativa de la recompensa esperada. Juntos generan la señal de retroalimentación necesaria para el entrenamiento y la adaptación del agente a las condiciones cambiantes del mercado.
Gracias a este enfoque, se consigue que el sistema sea modular y flexible: cada componente puede mejorarse o adaptarse de forma independiente a una clase concreta de estrategias de trading.
La arquitectura de todos los modelos se define en el método CreateDescriptions, cuyos parámetros reciben punteros a cuatro matrices dinámicas (según el número de modelos). En cada uno de ellos se guardará una secuencia única de objetos que ofrece una representación completa del modelo creado.
bool CreateDescriptions(CArrayObj *&encoder,
                        CArrayObj *&actor,
                        CArrayObj *&director,
                        CArrayObj *&critic
                       )
  {
//---
   CLayerDescription *descr;
//---
   if(!encoder)
     {
      encoder = new CArrayObj();
      if(!encoder)
         return false;
     }
   if(!actor)
     {
      actor = new CArrayObj();
      if(!actor)
         return false;
     }
   if(!director)
     {
      director = new CArrayObj();
      if(!director)
         return false;
     }
   if(!critic)
     {
      critic = new CArrayObj();
      if(!critic)
         return false;
     }
Empezaremos por el codificador. Tenemos previsto pasar a la entrada del modelo un tensor con la historia de las series temporales, cuyos datos trasladamos directamente a una capa totalmente conectada de dimensión suficiente. Esta capa actúa como una especie de compuerta del modelo. Fijamos el número de neuronas igual al producto del número de barras de la historia por el número de descriptores de cada barra, lo que permite conservar toda la información sobre la dinámica de los precios, los volúmenes y otros indicadores.
//--- Codificador
   encoder.Clear();
//--- Capa de entrada
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   int prev_count = descr.count = (HistoryBars * BarDescr);
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
A continuación viene la capa BatchNormWithNoise. Su objetivo es estabilizar el entrenamiento e introducir un pequeño componente estocástico, lo que ayuda a que el modelo no se quede atascado en mínimos locales durante la optimización. Es precisamente aquí donde introducimos el control del ruido: durante el proceso de normalización se añaden fluctuaciones aleatorias, lo que proporciona una mejor capacidad de generalización con datos de mercado reales, que a menudo contienen ruido.
//--- capa 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormWithNoise;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Una vez normalizados los datos, añadiremos algo de información sobre su dinámica en el módulo ConcatDiff. Esta capa calcula las primeras diferencias a lo largo del eje temporal y las añade a los datos originales como nuevos canales, lo que permite que el modelo capte mejor el ritmo de variación de los indicadores.
//--- capa 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConcatDiff;
   prev_count = descr.count = HistoryBars;
   descr.layers = BarDescr;
   descr.step = 1;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
A continuación viene Mamba4CastEmbedding: aquí incorporamos la codificación temporal de cada barra de la historia. Definimos los armónicos de dos periodicidades —horaria y diaria— para que el modelo capte los patrones diarios y las fluctuaciones intradía. A continuación, los embeddings de cada barra se combinan en una representación común.
//--- capa 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defMamba4CastEmbeding;
   prev_count = descr.count = HistoryBars;
   descr.window = 2 * BarDescr;
   int prev_out = descr.window_out = NSkills;
     {
      int temp[] = {PeriodSeconds(PERIOD_H1), PeriodSeconds(PERIOD_D1)};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Una vez que el embedding está listo, pasamos a TimeFoundPatching. El módulo divide el tensor obtenido en un número predefinido de segmentos (parches) de igual tamaño y los organiza en una sola matriz. Cada parche contiene información sobre la dinámica local, y su conjunto sirve de entrada para el bloque Transformer.
//--- capa 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTimeFoundPatching;
   descr.count = prev_count;
   prev_count=descr.window = Segments;
   descr.variables = prev_out;
   descr.window_out = EmbeddingSize;
   descr.step = 8;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Y aquí es donde entra en juego nuestra capa clave: TimeFoundTransformerUnit. Este objeto permite que el modelo analice simultáneamente cada secuencia unitaria por separado y capte dependencias entre dominios.
//--- capa 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTimeFoundTransformerUnit;
   descr.count = prev_count;
   descr.window = EmbeddingSize;
   descr.window_out =descr.window/4;
   {
      int temp[]={4,2};
      if(ArrayCopy(descr.heads,temp)<ArraySize(temp))
        return false;
   }
   descr.layers=3;
   descr.step=3;
   descr.variables=prev_out;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
A la salida de Transformer, esperamos obtener los tokens predictivos del siguiente parche para cada canal analizado. Recordemos que, en la fase de preprocesamiento, el número de canales se amplió considerablemente. Ahora tenemos un nuevo token por cada canal, que refleja la predicción de su comportamiento en el siguiente intervalo temporal.
Para desplegar este corte compacto de nuevo en una serie predictiva completa para el horizonte de planificación especificado, aplicamos una capa convolucional. La capa toma un conjunto de tokens predictivos, los pasa por varios filtros y los transforma en una secuencia de elementos de la longitud requerida, lista para el trabajo posterior del robot de trading. Este enfoque permite conservar las ventajas de la predicción autorregresiva a nivel de token y, al mismo tiempo, obtener a la salida una serie temporal completa para usarla en estrategias.
//--- capa 6
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = 1;
   descr.step = EmbeddingSize;
   prev_count=descr.layers = prev_out;
   descr.window = EmbeddingSize;
   prev_out=descr.window_out = NForecast;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = SoftPlus;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
A la salida de la capa convolucional, obtenemos un conjunto de secuencias unitarias de la longitud requerida. Cada una de ellas refleja la previsión correspondiente a su canal. Sin embargo, para la comparación con los datos reales, no necesitamos un conjunto de series independientes, sino una única secuencia multimodal en la que los elementos adyacentes correspondan a distintas fuentes de información en un mismo momento. Por lo tanto, el siguiente paso consiste en transponer el resultado. El resultado es una matriz de tamaño [horizonte de planificación × número de canales].
//--- capa 7
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.window=prev_out;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Luego aplicamos a la matriz obtenida otra capa convolucional, cuya función es devolver el número de canales a la dimensión original.
//--- capa 8
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = prev_out;
   descr.window = prev_count;
   descr.step = prev_count;
   descr.layers = 1;
   prev_out=descr.window_out = BarDescr;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = TANH;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_count=descr.count;
Y, por último, para que nuestras predicciones adquieran magnitudes reales, las pasamos por una capa de normalización inversa. Toma cada una de las secuencias multimodales obtenidas y restaura los parámetros estadísticos originales —la media y la varianza— de los mismos canales con los que empezamos. De este modo, convertimos los tokens estandarizados de nuevo en las unidades de medida habituales.
//--- capa 9
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronRevInDenormOCL;
   descr.count = prev_count * prev_out;
   descr.layers = 1;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Así, como resultado del trabajo del codificador, obtenemos a la salida valores predictivos completos de toda la serie multimodal en las unidades de medida habituales para el trader: precios, volúmenes e indicadores. Estos datos se pueden visualizar, comparar con las cotizaciones reales y utilizar para interpretar las acciones del agente.
Además, esto nos permite entrenar el codificador en modo de aprendizaje autosupervisado, prediciendo el movimiento futuro a partir de un gran volumen de datos históricos sin etiquetar. Esto, a su vez, permitirá generar representaciones latentes informativas de los tokens predictivos. Precisamente estas representaciones son las que tenemos previsto transmitir al Actor, al Director y al Crítico, garantizando así la estabilidad, la adaptabilidad y la capacidad de generalización del modelo.
CLayerDescription *latent = encoder. At(LatentLayer);
A continuación, pasamos a describir la arquitectura del Actor. Como se ha mencionado anteriormente, este modelo analiza el estado actual de la cuenta en el contexto de la situación del mercado y toma una decisión de trading. A través del canal principal de información, tenemos previsto transmitir al modelo un tensor que describa la representación de la cuenta: saldo, equity y posiciones abiertas.
Para obtener los datos de partida y realizar su procesamiento preliminar, utilizamos una combinación de una capa totalmente conectada y una capa de normalización por lotes. Sin embargo, a diferencia del codificador, nosotros no añadimos ruido, ya que nuestra situación financiera no admite fluctuaciones artificiales. En primer lugar, el tensor de la cuenta se pasa por una capa totalmente conectada de dimensión suficiente y, a continuación, se normaliza, lo que garantiza una representación estable y determinista.
//--- Actor
   actor.Clear();
//--- Capa de entrada
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = AccountDescr;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- capa 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = AccountDescr;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Los datos preparados se enriquecen con el contexto de la información de mercado en el módulo de atención multicabeza diversificada, lo que permite tener en cuenta las interrelaciones entre el estado de la cuenta y los patrones globales del mercado, proporcionando así una elección más fundamentada de la estrategia de trading.
//--- capa 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronCrossDMHAttention;
     {
      int temp[] = {AccountDescr,    // Ventana «Entradas»
                    latent.window    // Ventana cruzada
                   };
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
     {
      int temp[] = {1,                 // Unidades de entrada
                    latent.variables    // Unidades cruzadas
                   };
      if(ArrayCopy(descr.units, temp) < (int)temp.Size())
         return false;
     }
   descr.step = 4;                  // Cabezas
   descr.window_out = 32;
   descr.batch = 1e4;
   descr.layers = 3;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Para la toma final de decisiones se utiliza un perceptrón multicapa (MLP) de tres capas con distintas funciones de activación entre las capas, que aportan la no linealidad necesaria. En la primera capa se aplica la tangente hiperbólica (tanh), lo que permite separar los efectos de las señales en direcciones positivas y negativas. Tras la segunda capa, se aplica SoftPlus, que resalta la importancia de las respuestas positivas y suaviza los valores bajos. Por último, la capa de salida está controlada por una función sigmoide, que normaliza el espacio de acciones del Actor y garantiza que sus valores se sitúen en el intervalo [0,1], lo cual resulta útil para escalar los parámetros de trading.
//--- capa 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = LatentCount;
   descr.batch = BatchSize;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- capa 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = LatentCount;
   descr.activation = SoftPlus;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- capa 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   prev_count = descr.count = NActions;
   descr.activation = SIGMOID;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Los modelos «Director» y «Critic» tienen una arquitectura similar, solo que el tensor de estado de la cuenta se sustituye por el vector de acciones del «Actor», y se modifica el tamaño de la capa de resultados. Por lo tanto, no los analizaremos en detalle en este artículo, sino que lo dejaremos para su estudio independiente. La arquitectura completa de todos los modelos se incluye en el archivo adjunto.
Programa de entrenamiento del codificador del entorno
Y así llegamos al entrenamiento de los modelos. Este proceso se dividió en tres fases. En primer lugar, aislamos el entrenamiento del codificador del estado del entorno. Con el fin de garantizar que el entrenamiento se realice con el mayor volumen de datos disponible, este proceso se lleva a cabo sin crear una muestra de entrenamiento explícita: todos los datos necesarios se obtienen directamente del terminal de trading en tiempo real.
La implementación de esta fase de entrenamiento se organiza en el Asesor Experto "…\Experts\TimeFound\StudyEncoder.mq5". Aquí, el método CreateBuffers se encarga de gestionar los búferes; en sus parámetros se pasan el índice del estado inicial y los punteros a dos búferes: uno para los datos de origen analizados y otro para los valores objetivo del movimiento previsto. Este enfoque permite desarrollar un entrenamiento autosupervisado del codificador sin costes adicionales derivados del etiquetado de las series históricas.
bool CreateBuffers(const int start_bar, CBufferFloat* state, CBufferFloat *time, CBufferFloat* forecast)
  {
   if(!state || !time || start_bar < 0 ||
      (start_bar + HistoryBars + NForecast) >= int(Rates.Size()))
      return false;
//---
   vector<float> vState = vector<float>::Zeros(HistoryBars * BarDescr);
   vector<float> vForecast = vector<float>::Zeros(NForecast * BarDescr);
   time.Clear();
   time.Reserve(HistoryBars);
En el cuerpo del método, comprobamos si hay información suficiente en los datos cargados previamente y preparamos los búferes internos para almacenar los valores. A continuación, se organizan los ciclos de preparación de datos. Las series temporales originales, cargadas previamente desde el terminal, se almacenan de tal forma que los puntos más recientes se sitúan al principio y los más antiguos al final, aunque se mantiene el orden cronológico. Para ajustar los parámetros del codificador, en cada paso del entrenamiento necesitamos obtener un intervalo de tiempo completo que abarque la ventana de datos históricos y el horizonte de planificación establecido.
En primer lugar, se forma el vector del estado analizado: a partir del índice especificado en los parámetros, aplicamos un desplazamiento igual al horizonte de planificación establecido y copiamos todos los elementos siguientes en el búfer de datos de origen. Este orden de operaciones, que sigue la cronología de las series temporales, minimiza la sobrecarga de preparación de datos y garantiza el funcionamiento eficaz del modelo en tiempo real.
int bar = start_bar + NForecast;
for(int b = 0; b < (int)HistoryBars; b++)
  {
   float open = (float)Rates[b + bar].open;
   float rsi = (float)RSI.Main(b + bar);
   float cci = (float)CCI.Main(b + bar);
   float atr = (float)ATR.Main(b + bar);
   float macd = (float)MACD.Main(b + bar);
   float sign = (float)MACD.Signal(b + bar);
   if(rsi == EMPTY_VALUE || cci == EMPTY_VALUE || atr == EMPTY_VALUE ||
      macd == EMPTY_VALUE || sign == EMPTY_VALUE)
      return false;
   //---
   int shift = b * BarDescr;
   vState[shift] = (float)(Rates[b + bar].close - open);
   vState[shift + 1] = (float)(Rates[b + bar].high - open);
   vState[shift + 2] = (float)(Rates[b + bar].low - open);
   vState[shift + 3] = (float)(Rates[b + bar].tick_volume / 1000.0f);
   vState[shift + 4] = rsi;
   vState[shift + 5] = cci;
   vState[shift + 6] = atr;
   vState[shift + 7] = macd;
   vState[shift + 8] = sign;
   if(!time.Add(float(Rates[b + bar].time)))
      return false;
  }
A continuación, pasamos a la preparación de los valores objetivo. Dado que se trata de datos predictivos, pertenecen al futuro, por lo que, para formar correctamente los búferes objetivo, es necesario invertir el orden de los valores. Para ello, al transferir los datos utilizamos la indexación inversa: el último elemento del horizonte objetivo pasa a ser el primero en el búfer, y así sucesivamente. Esta técnica garantiza que, en cada paso del entrenamiento, el modelo asocie correctamente la entrada actual con el valor futuro correspondiente.
bar--;
for(int b = 0; b < (int)NForecast; b++)
  {
   float open = (float)Rates[bar - b].open;
   float rsi = (float)RSI.Main(bar - b);
   float cci = (float)CCI.Main(bar - b);
   float atr = (float)ATR.Main(bar - b);
   float macd = (float)MACD.Main(bar - b);
   float sign = (float)MACD.Signal(bar - b);
   if(rsi == EMPTY_VALUE || cci == EMPTY_VALUE || atr == EMPTY_VALUE ||
      macd == EMPTY_VALUE || sign == EMPTY_VALUE)
      return false;
   //---
   int shift = (NForecast - b - 1) * BarDescr;
   vForecast[shift] = (float)(Rates[bar - b].close - open);
   vForecast[shift + 1] = (float)(Rates[bar - b].high - open);
   vForecast[shift + 2] = (float)(Rates[bar - b].low - open);
   vForecast[shift + 3] = (float)(Rates[bar - b].tick_volume / 1000.0f);
   vForecast[shift + 4] = rsi;
   vForecast[shift + 5] = cci;
   vForecast[shift + 6] = atr;
   vForecast[shift + 7] = macd;
   vForecast[shift + 8] = sign;
  }
Trasladamos las series temporales preparadas a los búferes de datos y finalizamos la ejecución del método, devolviendo previamente al programa que lo ha llamado el resultado lógico de la ejecución de las operaciones.
   if(!state.AssignArray(vState))
      return false;
   if(!forecast.AssignArray(vForecast))
      return false;
   if(time.GetIndex() >= 0)
      if(!time.BufferWrite())
         return false;
//---
   return true;
  }
El proceso de entrenamiento en sí está organizado en el método Train. En él, primero determinamos el tamaño del búfer de la muestra de entrenamiento a partir de las fechas de inicio y fin del periodo de entrenamiento especificadas por el usuario.
void Train(void)
  {
   int start = iBarShift(Symb.Name(), TimeFrame, Start);
   int end = iBarShift(Symb.Name(), TimeFrame, End);
   int bars = CopyRates(Symb.Name(), TimeFrame, 0, start, Rates);
A partir de estos límites, se calcula el número de barras y se reserva el espacio de memoria necesario para los búferes de datos.
if(!RSI.BufferResize(bars) || !CCI.BufferResize(bars) ||
   !ATR.BufferResize(bars) || !MACD.BufferResize(bars))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   ExpertRemove();
   return;
  }
A continuación, se lleva a cabo una carga dinámica de los datos históricos desde el terminal para el instrumento y el marco temporal especificados.
   int count = -1;
   bool load = false;
   do
     {
      RSI.Refresh();
      CCI.Refresh();
      ATR.Refresh();
      MACD.Refresh();
      count++;
      load = (RSI.BarsCalculated() >= bars &&
              CCI.BarsCalculated() >= bars &&
              ATR.BarsCalculated() >= bars &&
              MACD.BarsCalculated() >= bars
             );
      Sleep(100);
      count++;
     }
   while(!load && count < 100);
   if(!load)
     {
      PrintFormat("%s -> %d The training data has not been loaded", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
//---
   if(!ArraySetAsSeries(Rates, true))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
   bars -= end + HistoryBars + NForecast;
   if(bars < 0)
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
Una vez preparados los datos de entrenamiento, pasamos directamente al proceso de entrenamiento propiamente dicho, organizándolo dentro de un sistema de ciclos. El ciclo externo se encarga de contar las iteraciones de entrenamiento. El usuario establece su número total a través de los parámetros del programa.
   vector<float> result, target, neg_target;
   bool Stop = false;
//---
   uint ticks = GetTickCount();
//---
   for(int iter = 0; (iter < Iterations && !IsStopped() && !Stop); iter ++)
     {
      int posit = (int)((MathRand() * MathRand() / MathPow(32767, 2)) * bars);
      if(!CreateBuffers(posit + end, GetPointer(bState), GetPointer(bTime), Result))
        {
         PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
         ExpertRemove();
         return;
        }
En el cuerpo del ciclo de entrenamiento externo, seleccionamos mediante muestreo el índice de un estado del conjunto de entrenamiento, que sirve de referencia para formar los datos analizados y los datos objetivo. Este índice, junto con los punteros a los búferes correspondientes, se pasa al método CreateBuffers, lo que permite que cada iteración obtenga secuencias históricas y predictivas correctamente alineadas para un entrenamiento autosupervisado eficaz.
A continuación, organizamos un ciclo interno, cuyo número de iteraciones lo establece el usuario mediante el parámetro «Repeats». Aquí hay que tener mucho cuidado: dentro de este ciclo, entrenamos el modelo repetidamente con los mismos datos analizados y objetivo. La presencia en el codificador de una capa de normalización con adición de ruido proporciona el aumento de datos necesario: el modelo aprende a centrarse en la estructura interna de los datos y no en valores concretos. Sin embargo, si el número de iteraciones es demasiado elevado y los valores objetivo se mantienen constantes, el modelo corre el riesgo de empezar a ignorar los datos de entrada y a generar siempre el mismo resultado. Por eso recomendamos ajustar el parámetro Repeats a unas cinco iteraciones aproximadamente.
for(int r = 0; r < Repeats; r++)
  {
   //--- Feed Forward
   if(!cEncoder.feedForward((CBufferFloat*)GetPointer(bState), 1, false, (CBufferFloat*)GetPointer(bTime)))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
   //--- Entrenamiento
   if(!cEncoder.backProp(Result, (CBufferFloat*)NULL))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
En el cuerpo del ciclo se llevan a cabo las operaciones de pasada directa e inversa del modelo. Luego informamos al usuario sobre el progreso del entrenamiento y pasamos a la siguiente iteración del sistema de ciclos.
    if(GetTickCount() - ticks > 500)
      {
       double percent = double(iter) * 100.0 / (Iterations);
       string str = StringFormat("%-12s %6.2f%% -> Error %15.8f\n", "Encoder",
                                   percent, cEncoder.getRecentAverageError());
       Comment(str);
       ticks = GetTickCount();
      }
   }
}
Una vez finalizadas todas las iteraciones, se muestran en el registro los resultados del entrenamiento y damos por concluido el funcionamiento del programa.
   Comment("");
//---
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__, "Encoder", cEncoder.getRecentAverageError());
   ExpertRemove();
//---
  }
Los programas de entrenamiento offline y de ajuste fino online de los modelos Actor, Director y Critic se han trasladado íntegramente desde los proyectos anteriores sin ningún tipo de modificación. Además, utilizamos soluciones ya probadas para recopilar el conjunto de datos de entrenamiento y evaluar los modelos entrenados, lo que nos permitió centrarnos en las innovaciones arquitectónicas sin dedicar recursos al rediseño de los componentes auxiliares.
Todo el código fuente de los programas utilizados para la elaboración de este artículo se incluye en el anexo.
Pruebas
Como ya se ha mencionado anteriormente, el proceso de entrenamiento del modelo se organizó en tres fases consecutivas, lo que permitió estructurar todo el sistema de forma lógica, gradual y con la máxima fiabilidad.
El primer paso consistió en entrenar el codificador con cinco años de datos históricos del par EURUSD en un marco temporal de un minuto. Este volumen y este nivel de detalle permiten formar una representación latente realmente profunda y sustancial del estado actual del mercado. El codificador aprende a distinguir patrones importantes, a identificar regularidades y a codificar la situación del mercado en un vector compacto pero informativo, que posteriormente utilizan todos los demás módulos.
A continuación viene la segunda fase: el entrenamiento offline de los principales componentes de nuestra arquitectura: el Actor, el Director y el Crítico. Para ello, se recopiló una muestra de datos de mercado correspondientes al año 2024, conservando todos los parámetros utilizados en el entrenamiento del codificador. Durante el entrenamiento se utilizó el concepto de trayectoria casi ideal: las acciones del agente no se seleccionaban de forma aleatoria, sino basándose en el análisis del movimiento posterior del precio. En otras palabras, al disponer de toda la trayectoria de precios, sabíamos de antemano qué acciones habrían dado los mejores resultados y utilizamos precisamente esas acciones para el entrenamiento. Este enfoque permite mostrar al modelo cómo debe operar, en lugar de obligarlo a buscar a ciegas una estrategia eficaz mediante el método de prueba y error, deambulando por el entorno sin mapa. Gracias a ello, el agente aprende a partir de ejemplos previamente verificados: claros, fundamentados y lo más cercanos posible a lo ideal desde el punto de vista del resultado. Esto no solo simplifica el proceso de entrenamiento, sino que lo hace dirigido a un objetivo y económicamente significativo.
La etapa final consiste en un ajuste fino online, que se lleva a cabo directamente en el Probador de estrategias. Aquí, los modelos se enfrentan a datos históricos en un modo lo más cercano posible a la operativa real y adaptan sus parámetros a la dinámica real del mercado. Esto es especialmente importante, ya que permite ajustar el comportamiento del agente teniendo en cuenta las condiciones cambiantes, el ruido del mercado y las fluctuaciones aleatorias que no se aprecian en la muestra de entrenamiento.
Una vez completada toda la cadena de entrenamiento, el modelo se sometió a pruebas con datos nuevos: las cotizaciones de enero de 2025. Todos los parámetros y ajustes utilizados durante el entrenamiento se conservaron sin modificaciones, lo que garantiza una total objetividad e imparcialidad en la evaluación. A continuación se presentan los resultados de las pruebas.
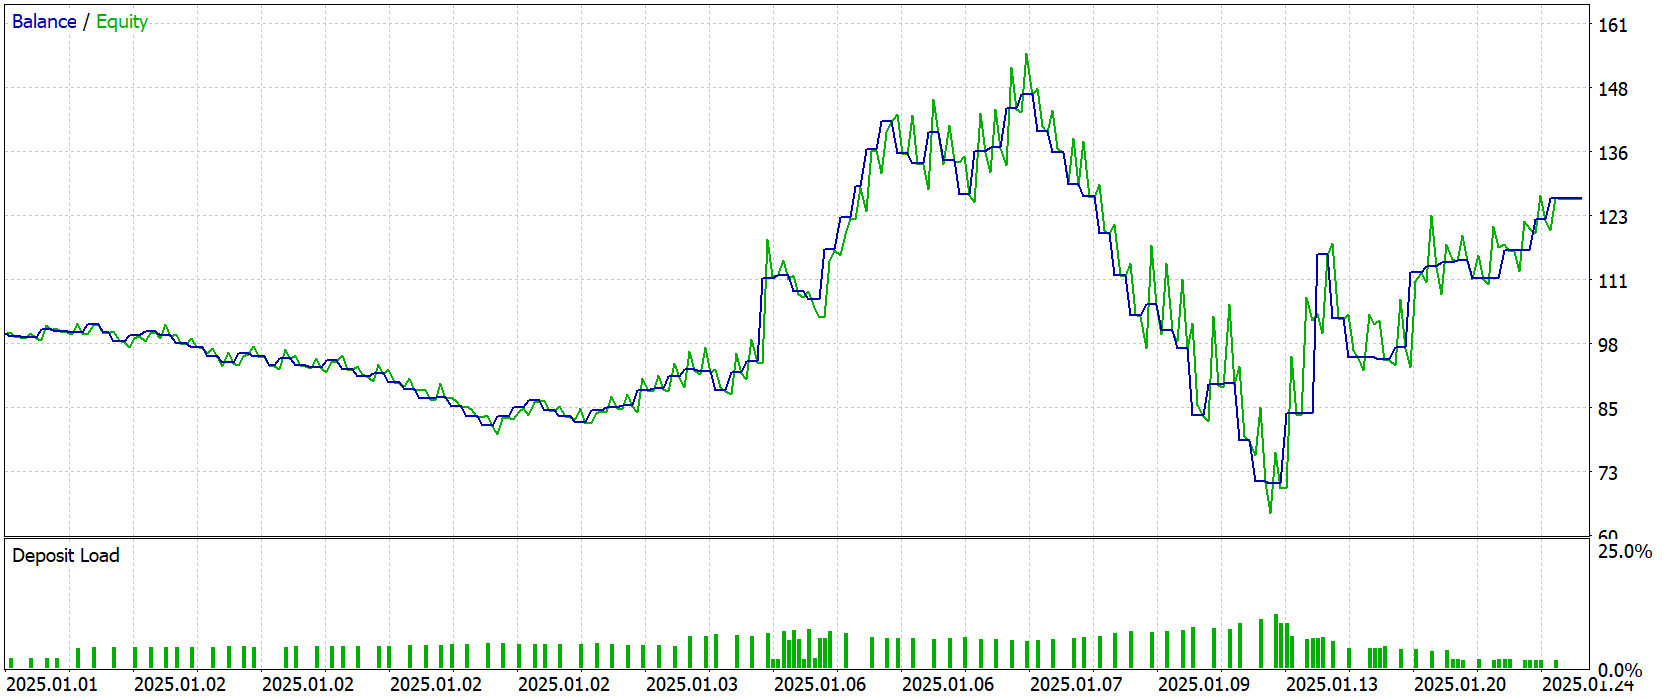
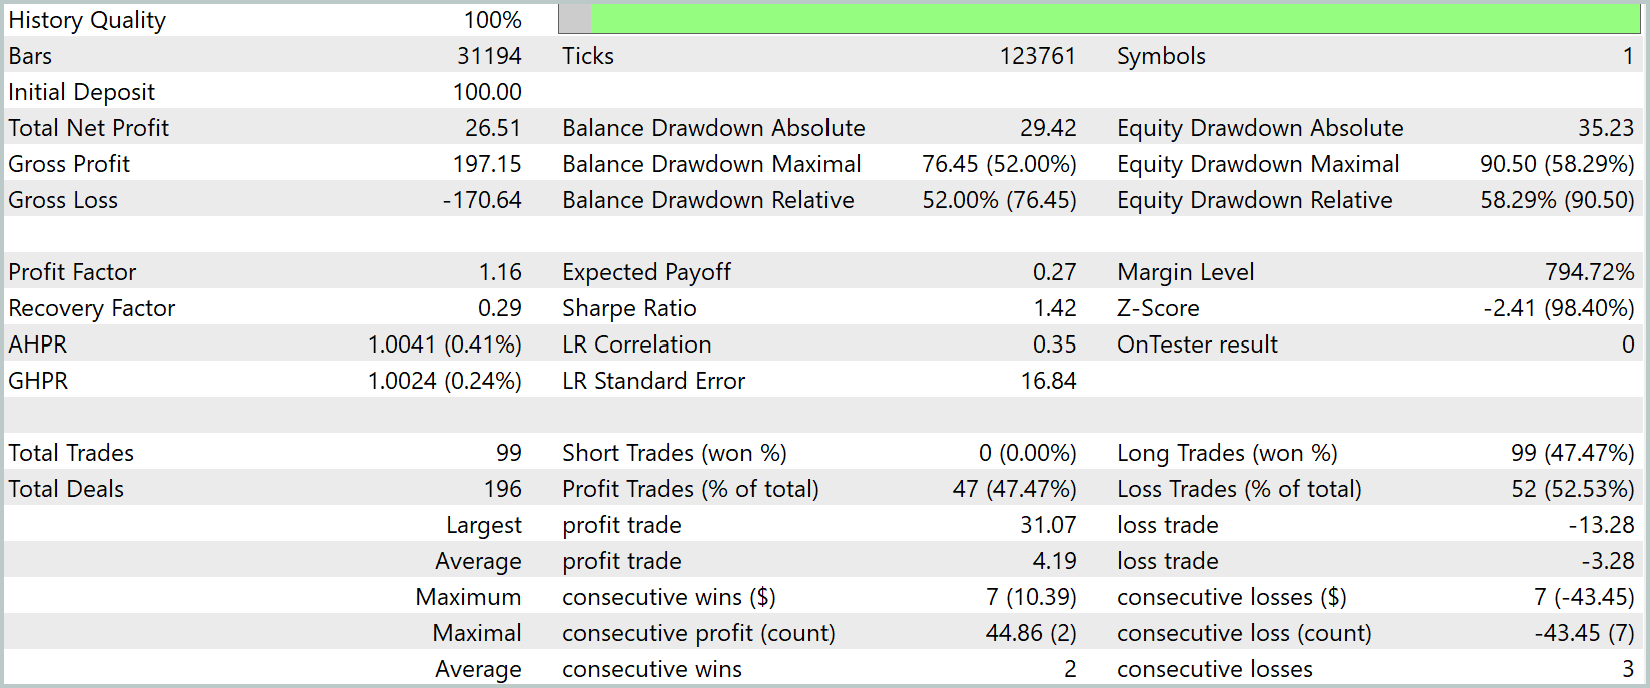
Los resultados de las pruebas pueden calificarse de alentadores, aunque con algunas salvedades. La rentabilidad total fue del +26,5 % en un mes; sin embargo, el gráfico del saldo no muestra una tendencia alcista sostenida. Al contrario: la mayor parte del tiempo se observa un movimiento lateral con periodos de inestabilidad y reducciones pronunciadas. La reducción máxima alcanzó el 58 %, lo que pone de manifiesto la elevada volatilidad y la inestabilidad de las decisiones en determinadas situaciones de mercado.
Este panorama parece indicar más bien que el modelo aún está buscando un estilo de trading estable, en lugar de seguir una trayectoria clara y rentable. No obstante, el resultado positivo en sí mismo es una señal alentadora: la base ya está sentada; ahora el reto es aumentar la robustez.
Conclusión
A lo largo de este trabajo, hemos recorrido el camino desde el concepto de predicción universal de series temporales entre dominios hasta su implementación práctica en el entorno de MetaTrader 5. Hemos analizado en detalle la estructura del codificador, hemos dominado el mecanismo de segmentación en parches multiescala y, a continuación, hemos integrado las representaciones latentes obtenidas en la arquitectura Actor–Director–Critic. Cada paso —desde la preparación de los datos y el entrenamiento autosupervisado del codificador hasta el ajuste offline y online de los módulos clave— ha demostrado hasta qué punto una combinación armoniosa de investigación de vanguardia y soluciones de ingeniería puede mejorar la calidad del análisis de la dinámica del mercado.
Las pruebas realizadas con las cotizaciones de enero de 2025 han demostrado que nuestro sistema es capaz de generar beneficios, aunque no está exento de reducciones profundas. Esto pone de relieve la importancia de seguir perfeccionando la gestión de riesgos y los mecanismos adaptativos de limitación de pérdidas. Al mismo tiempo, el mero hecho de obtener una rentabilidad positiva sin necesidad de optimizar adicionalmente los parámetros demuestra que la arquitectura elegida cuenta con un armazón sólido y permite elaborar previsiones reutilizando los conocimientos ya adquiridos.
Referencias
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | Research.mq5 | Asesor experto | Asesor experto para la recopilación de ejemplos |
| 2 | ResearchRealORL.mq5 | Asesor experto | Asesor experto para la recopilación de ejemplos mediante el método Real-ORL |
| 3 | StudyEncoder.mq5 | Asesor experto | Asesor experto para el entrenamiento del codificador del entorno |
| 4 | Study.mq5 | Asesor experto | Asesor experto para el entrenamiento offline de modelos |
| 5 | StudyOnline.mq5 | Asesor experto | Asesor experto para el entrenamiento online de modelos |
| 6 | Test.mq5 | Asesor experto | Asesor experto para probar el modelo |
| 7 | Trajectory.mqh | Biblioteca de clases | Estructura de la descripción del estado del sistema y de la arquitectura de los modelos |
| 8 | NeuroNet.mqh | Biblioteca de clases | Biblioteca de clases para crear una red neuronal |
| 9 | NeuroNet.cl | Biblioteca | Biblioteca de código del programa OpenCL |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/18447
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Redes neuronales en el trading: Modelo de consultas temporales (Final)
 Superando las limitaciones del aprendizaje automático (Parte 2): Falta de reproducibilidad
 Entrenamiento de un U-Transformer no lineal sobre los residuos de un modelo autorregresivo lineal
 Redes neuronales en el trading: Extracción eficaz de características para una clasificación precisa (Implementación de objetos)

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso