

市场模拟(第 22 部分):SQL 入门(五)
 100
 0

引言
大家好,欢迎阅读本系列文章的另一篇,本系列文章将介绍如何构建复制/模拟系统。
在上一篇文章“市场模拟(第 21 部分):SQL 入门(四)”中,我们以抽象的形式解释了如何将关系型数据库与非关系型数据库区分开来。但是,首先(这也是撰写前一篇文章的原因),我们试图展示如何理解数据库的工作原理。这样做是为了让你明白,尽管在某些情况下,为某些事情编程似乎是合理的,但在某些情况下,可以使用现有的实现来在应用程序中达到预期的结果。
这正是我们花时间解释 SQL 而不是用 MQL5 编程的原因。我们需要稍微平衡一下,以便每个人都能理解,当我们本可以创建更多例程来实现某些功能时,为什么我们会选择使用 SQL。
在这种情况下,该实现将使我们能够为复制/模拟系统开发一种合适且简单的方法来实现一套命令处理机制。也就是说,我们需要一种方法来存储订单及持仓管理机制所需的数据结构,以便在复制/模拟系统中进行研究。在我看来,为此创建许多例程是完全不必要的,因为 MQL5 允许我们通过 SQLite 使用特定的 SQL 支持。但对于那些热衷于不断编写代码的人来说,我们将展示一个更好的替代方案。这是因为,将用于实现、测试和配置创建某种数据库的程序的时间,可以更有效地用于其他事务。
因此,当我们真正开始开发所需的系统,以便复制/模拟系统能够真正作为研究交易策略时模拟账户的替代方案时,开发过程将会更快,且不会出现许多与正常运行相关的问题。原因在于,我们将使用 SQL 为创建订单管理机制提供必要的路径。
然而,如果我们保持现状,仅仅停留在理论层面,那么上一篇文章中所解释的内容就非常抽象了。但由于这个主题在其他领域也可能具有意义,例如,如果您想创建一个使用数据库来学习交易的 EA,那么您就需要将上一篇文章中描述的内容付诸实践。一个重要的细节,我马上就来说明:我(至少目前)不打算解释如何创建一个数据库,以便让用 MQL5 编写的 EA 开始学习如何交易特定品种。
解释这些内容还需要解释数据库操作的许多其他概念和原理。但如果你真的想学习这些,我建议你深入研究博弈类算法。这是因为创建数据库是一项简单的任务,就像用 MQL5 编写一个 EA 一样。但是,为了让数据库真正发挥作用,让 EA 真正学会如何在市场上运作,你需要知道如何向正在创建的数据库中添加特定数据。学习如何创建这些数据的最简单方法就是研究博弈算法。
然而,还有其他更复杂的研究方向,例如研究波动理论,甚至是热分布的概念。但是这些方向要困难得多,尽管结果与博弈算法的结果非常相似。
让我们先来看一下上一篇文章中解释的内容在实践中的应用。因为我喜欢把所有内容分成不同的主题,以便更容易理解,所以让我们进入本文的第一个主题。
创建一个简单的数据库
我们就不在这里过多讨论这个问题了。这是因为,在讨论 SQL 的几篇文章中已经涉及到了这个主题。然而,鉴于在上一篇文章中我们建议使用另一个程序,以便直接在 SQLite 中完成工作(我们将通过 MQL5 使用 SQLite 作为实现),因此我们需要考虑一些专门与使用 SQLite 相关的细节。
我们首先要探讨的是 SQLite 数据类型与我们放入数据库中的数据之间的关系。在数据类型方面,SQLite 的一个显著特点是其类型较少。但这并不是一个缺点;相反,根据我们开发的内容,这反而是一个巨大的优势,此外,SQLite 相较于其他实现还有另一个优势。
我刚才提到的另一个优点是,在 SQLite 中,数据是动态的,而不是像许多其他实现那样是静态的。“但是等一下。SQLite 中的数据怎么可能是动态的?为什么这是一个优点?”要理解这一点,你需要看看下面的小表格:
| SQLite 中的数据类型 | 说明 |
|---|---|
| NULL | 包含所有空值。 |
| INTEGER | 有符号整数根据数值的大小,分别存储在 1、2、3、4、6 或 8 个字节中。 |
| REAL | 以 8 字节浮点数形式存储的实数或浮点值。 |
| TEXT | 使用数据库编码(可能是 UTF-8、UTF-16BE 或 UTF-16LE)存储的文本字符串。 |
| BLOB | 任何数据块,每个数据块都按插入时的状态原样存储。 |
请注意,此表列出了 SQLite 类型。现在,出于好奇,让我们看看在其他 SQL 实现中情况如何。我们将从 MySQL 开始,其类型表如下所示:
| MySQL 中的数据类型 | 说明 |
|---|---|
| TINYINT | 一个非常小的整数。该数值数据类型的有符号值范围为 -128 到 127,无符号值范围为 0 到 255。 |
| SMALLINT | 一个较小的整数。该数值类型的有符号值范围为 -32768 到 32767,无符号值范围为 0 到 65535。 |
| MEDIUMINT | 一个中等大小的整数。该数值数据类型的有符号值范围为 -8388608 到 8388607,无符号值范围为 0 到 16777215。 |
| INTEGER | 一个正常大小的整数。该数值数据类型的有符号值范围为 -2147483648 到 2147483647,无符号值范围为 0 到 4294967295。 |
| BIGINT | 一个很大的整数。该数值数据类型的有符号值范围为 -9223372036854775808 到 9223372036854775807,无符号值范围为 0 到 18446744073709551615。 |
| FLOAT | 一个较小的浮点数(单精度)。 |
| DOUBLE | 一个标准大小的浮点数(双精度)。 |
| DECIMAL | 一个打包的定点数。该数据类型的记录显示长度在创建列时定义,并且每条记录都会调整到该长度。 |
| BOOLEAN | 布尔值是一种只能取两个值的数据类型:“true” 或 “false”。 |
| BIT | 一种位值类型,每个值的位数可以从 1 到 64 指定。 |
| DATE | 日期格式为 YYYY-MM-DD。 |
| DATETIME | 日期和时间记录,以 YYYY-MM-DD HH:MM:SS 格式显示日期和时间。 |
| TIMESTAMP | 时间戳,表示自 Unix 纪元开始(1970 年 1 月 1 日 00:00:00)以来经过的时间。 |
| TIME | 以 HH:MM:SS 格式显示的时间。 |
| YEAR | 年份以 2 位或 4 位数字表示,4 位数字为标准格式。 |
| CHAR | 固定长度的字符串;存储时,此类条目会在右侧填充空格以匹配指定的长度。 |
| VARCHAR | 长度可变的字符串。 |
| BINARY | 与 char 类型类似,但它表示指定长度的二进制字节字符串,而不是非二进制字符字符串。 |
| VARBINARY | 与 varchar 类型类似,但它表示的是可变长度的二进制字节字符串,而不是非二进制字符字符串。 |
| BLOB | 长度最大为 65535 (2^16 - 1) 字节的二进制字符串。 |
| TINYBLOB | BLOB 列,最大长度为 255 (2^8 - 1) 字节的数据。 |
| MEDIUMBLOB | BLOB 列的最大长度为 16777215 (2^24 - 1) 字节的数据。 |
| LONGBLOB | BLOB 列的最大长度为 4294967295 (2^32 - 1) 字节的数据。 |
| TEXT | 长度不超过 65535 (2^16 - 1) 个字符的字符串。 |
| TINYTEXT | 文本列的最大长度为 255 (2^8 - 1) 个字符。 |
| MEDIUMTEXT | 文本列的最大长度为 16777215 (2^24 - 1) 个字符。 |
| LONGTEXT | 文本列的最大长度为 4294967295 (2^32 - 1) 个字符。 |
| ENUM | 枚举是一个字符串形式的对象,它接收在创建表时声明的值列表中的单个值。 |
| SET | 与枚举类似,它是一个字符串对象,可以有零个或多个值,每个值都必须从创建表时指定的允许值列表中选择。 |
请注意,还有许多其他类型,我们必须正确选择合适的类型,以避免将来出现问题。PostgreSQL 也是如此,它有自己的类型表,如下所示。
| PostgreSQL 中的数据类型 | 说明 |
|---|---|
| BIGINT | 一个 8 字节的有符号整数。 |
| BIGSERIAL | 一个 8 字节的自增整数。 |
| DOUBLE PRECISION | 一个 8 字节的双精度浮点数。 |
| INTEGER | 一个 4 字节的有符号整数。 |
| NUMERIC | 建议在精度要求很高的情况下使用可选择精度的数值,例如处理货币值时。 |
| REAL | 占用 4 个字节的单精度浮点数。 |
| SMALLINT | 一个 2 字节的有符号整数。 |
| SMALLSERIAL | 一个 2 字节的自增整数。 |
| SERIAL | 一个 4 字节的自增整数。 |
| CHARACTER | 具有指定固定长度的字符串。 |
| VARCHAR | 长度可变但有限的字符串。 |
| TEXT | 长度可变且无限制的字符串。 |
| DATE | 由日、月、年组成的日历日期。 |
| INTERVAL | 时间间隔。 |
| TIME WITHOUT TIME ZONE | 一天中的具体时间,不指定时区。 |
| TIME WITH TIME ZONE | 一天中的时间,包括时区。 |
| TIMESTAMP WITHOUT TIME ZONE | 日期和时间,但未指定时区。 |
| TIMESTAMP WITH TIME ZONE | 日期和时间,包括时区。 |
| BOX | 平面上的一个矩形“盒子”。 |
| CIRCLE | 平面上的一个圆。 |
| LINE | 平面上的一条无限长的直线。 |
| LSEG | 平面上的一条线段。 |
| PATH | 平面上的几何线。 |
| POINT | 平面上的几何点。 |
| POLYGON | 平面上的闭合几何路径。 |
| CIDR | IPv4 或 IPv6 网络地址。 |
| INET | IPv4 或 IPv6 主机地址。 |
| MACADDR | 媒体访问控制(MAC)地址。 |
| BIT | 固定长度的比特串。 |
| BIT VARYING | 可变长度的比特串。 |
| TSQUERY | 用于搜索文本的字符串。 |
| TSVECTOR | 用于文本搜索的文档。 |
| JSON | JSON 文本数据。 |
| JSONB | 分解后的二进制 JSON 数据。 |
| BOOLEAN | 表示 “true” 或 “false” 的逻辑值。 |
| BYTEA | “array of bytes”的缩写;这种类型用于二进制数据。 |
| MONEY | 货币金额。 |
| PG_LSN | PostgreSQL 日志序列号。 |
| TXID_SNAPSHOT | 用户级交易 ID 快照。 |
| UUID | 一个全局通用的唯一标识符。 |
| XML | XML数据。 |
请注意,PostgreSQL 提供了更多类型。人们可能会想:然而,对于任何想要使用 SQL 的人来说,所有这些都会变成一场噩梦。但这并不完全正确。SQL 能够适应我们的需求。这是必要的,因为数据库可以在另一个同样用 SQL 创建的应用程序中使用。我们拥有更多或更少的类型,这使得选择类型或多或少有些困难。这是因为,如果我们选择了错误的类型,那么在需要更改时,整个数据库都必须重建。虽然这是一项相当简单的任务,但由于我们使用的是专门为此目的创建的脚本,对于想要学习 SQL 但不知道从哪里开始的人来说,这可能相当困难。
然而,查看这些表格后,我们立即发现,由于 SQLite 使用的类型较少,其所包含的类型所需的维护工作也较少。但这引出了其他在此处不相关的问题。我们目前真正感兴趣的是,尽管类型较少,但 SQLite 具有动态类型;也就是说,这些类型会根据所存储信息的需求而增加。
但这在实践中是如何应用的呢?为了理解这一点,我们需要创建两个不同的数据库。一个将使用 MySQL 创建,另一个将使用 SQLite 创建。两者都以 SQL 作为基础语言。让我们来看看如何操作。下面的动画展示了在 MySQL 中执行此过程的方式。
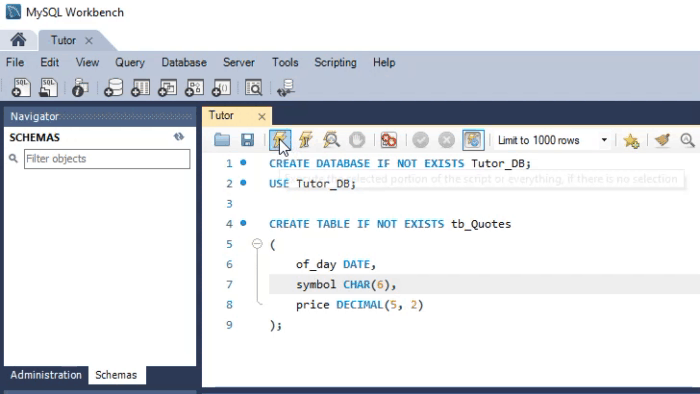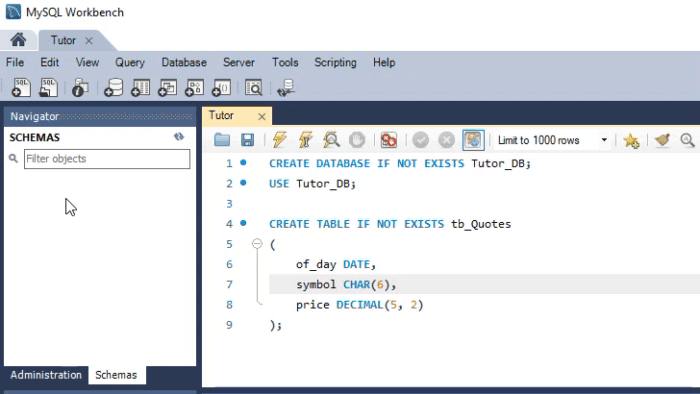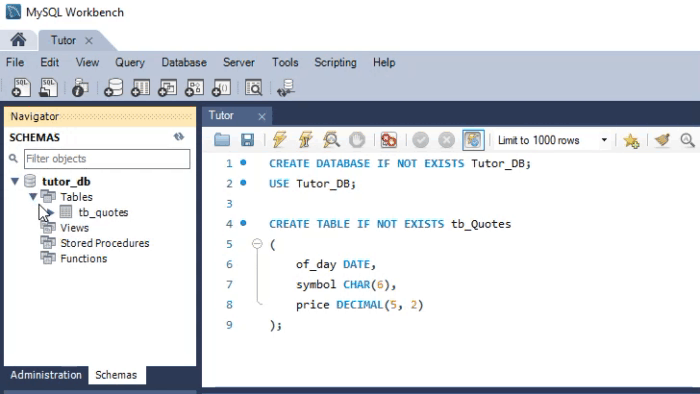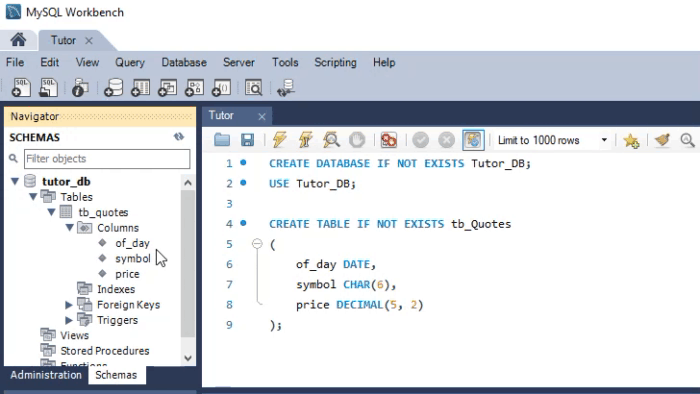
请仔细查看所使用的类型。下面看到的动画演示了几乎相同的过程,只是使用的是 SQLite。
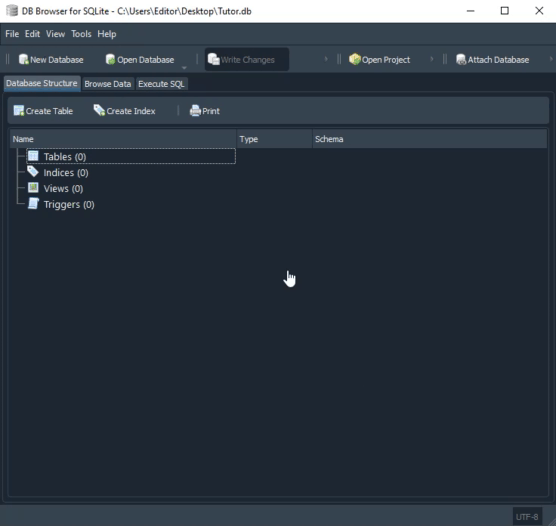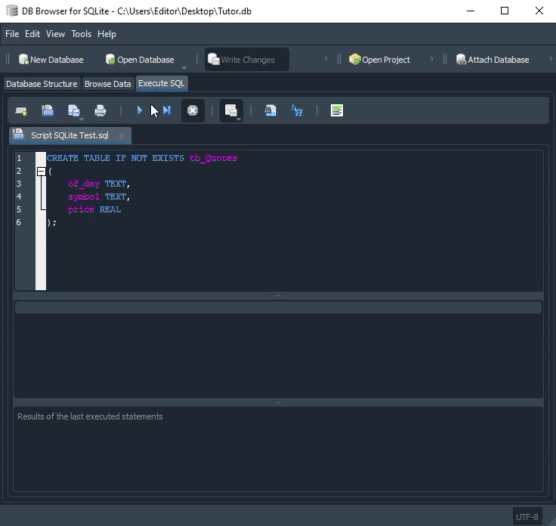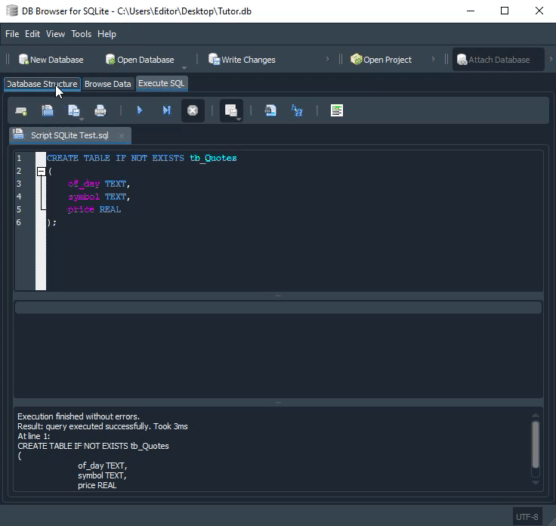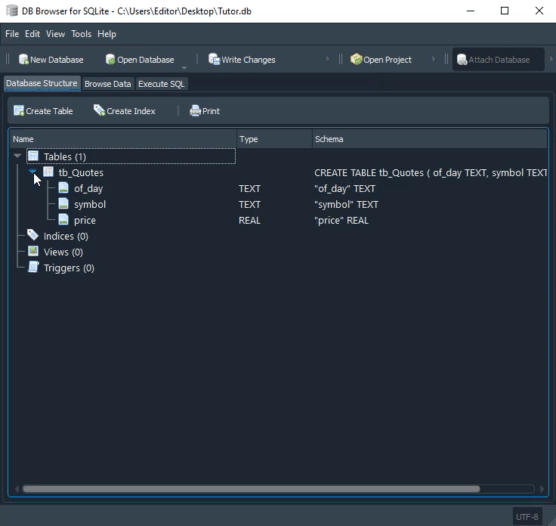
请注意第二个动画中定义的类型。虽然在 MySQL 动画中,脚本会创建一个数据库,但在 SQLite 中并不会这样。在这种情况下,我们必须已经在 DB Browser 中创建并打开了一个数据库。你或许在想:“好吧,类型不同,所以代码不能在两者之间通用。”如果你这么想,那是因为你偶然看到了这篇文章。我建议你阅读之前的文章,我们在其中展示了如何在 MySQL 和 SQLite 中使用相同的代码。只有在那种情况下,我们才使用 MetaEditor 来运行 SQLite。
然而,在这种情况下,我们关注的是这样一个事实:在 MySQL 代码中,创建列时需要定义其大小。而在 SQLite 中,我们则不需要这样做。MySQL 也可以实现这种动态性。但除了 SQLite 之外,这在其他实现中并不常见。原因是 SQL 程序员通常更喜欢定义字段的类型甚至大小,以优化数据库的某些特性。因此,我们在维护不同实现方式的数据库时需要做更多的工作。
但这里可能会产生一个问题:MySQL 能理解 SQLite 创建的列吗?反之亦然?你无需担心这个问题。是的,任何 SQL 实现都能理解列中使用的维度。因此,我们展示了上述表格,以便更容易理解数据类型之间存在一定的重叠。然而,根据实现的不同,程序员可能会决定使用一种特定的类型来优化数据库的某些方面。
好,既然我们已经介绍了必要的元素,接下来让我们在实践中看看主键和外键是如何融入这个故事的。
实际应用中的主键和外键
从上面的动画中可以看到,我们正在创建一个非常简单的数据库。它的目的是存储交易品种名称、报价以及获得报价的日期。但实际上,数据库程序员几乎不会以这种方式创建数据库。这是因为人们可能希望在数据库中保存多个交易品种或附加信息,例如该代码对应公司的交易名称或公司名称。
但交易品种也可能更改名称。虽然这种情况非常罕见,但偶尔还是会发生。我们在 B3 板块看到了一个例子,VIA VAREJO 公司曾有一段时间使用过该股票代码:VVAR3 。由于某种原因,该股票代码变为 VIIA3 。现在想象一下,要将所有历史记录中的品种名称从 VVAR3 更改为 VIIA3,需要做多少工作。但如果基础建设方式不同,所有这些原本都可以很容易地做到。
虽然这个例子很简单,但它足以帮助我们理解更多内容。许多人认为创建和维护数据库是一项简单的任务,但当他们真正着手去做时,却犯了很多错误,这些错误后来需要付出巨大的努力才能纠正。
我们先来看看如何使用 SQLite 创建一个基本解决方案。为了简化任务和解释,您可以查看下面的 SQL 脚本代码。它将使用我们即将实施的技术。
01. PRAGMA FOREIGN_KEYS = ON;
02.
03. CREATE TABLE IF NOT EXISTS tb_Symbols
04. (
05.     id INTEGER PRIMARY KEY,
06.     symbol TEXT
07. );
08.
09. CREATE TABLE IF NOT EXISTS tb_Quotes
10. (
11.     of_day TEXT,
12. --    symbol TEXT,
13.     price NUMERIC,
14.     fk_id INTEGER,
15.     FOREIGN KEY (fk_id) REFERENCES tb_Symbol (id)
16. );
SQLite 代码
请注意,此代码中已经包含一些不属于 SQL 的元素。在这种情况下,我们指的是第 01 行,其中我们使用了 SQLite 内部指令。但我们为何在此使用此指令呢?原因是,我们在本文末尾的参考文献部分提到的 SQLite 文档指出,在 3.6.19 版本之前,SQLite 默认不使用外键,因此需要明确指定。否则,它将不会使用外键。尽管上述版本较为陈旧,但出于某些原因,可能仍有人在使用它。除此之外,让我们来看看这段脚本中发生了什么。请记住,为了让脚本在 SQLite 中正确执行,必须在 DB Browser 中打开一个数据库。
在第 03 行,我们创建(如果不存在)一个名为 tb_Symbols 的表。在此表中,第 05 行定义了主键。在第 06 行,我们定义交易品种名称。目前,我们不限制此表中记录的数量。原因在于,我们仍然想展示我们是如何得出一个更为合适的数据库构建模型的。因此,虽然 id 值始终是唯一的,但同一个交易品种可以在多个 id 中定义。但这很容易解决。不过,在了解我们将如何做到这一点之前,让我们先来了解一下这里的键是如何工作的。
创建 tb_Symbols 表之后,我们可以修改(或者更准确地说,创建)一个新表。它从第 09 行开始,我们在那里表示要创建 tb_Quotes 表。请注意,第 12 行是原始行,如上动画所示。然而,与动画中显示的不同,它在这里以注释的形式出现。原因是该交易品种名称将不再出现在此表中。因此,我们在代码中添加了第 14 行和第 15 行。请密切注意解释;这一点很重要。在第 14 行,我们定义了一个值,该值必须与 tb_Symbols 表的主键类型相同。在某些情况下,使用 SQLite 的程序员不会定义类型,而是将其留给程序自行处理。由于我们希望代码保持一定的标准,我们将定义类型。
这个字段将作为 tb_Quotes 表中的外键。现在到了上面脚本中真正重要的部分。第 15 行我们指明了外键是什么以及它将指向什么。请注意,我们需要指定表名以及要使用的键或列名。该键源自 tb_Symbols 表。
因此,我们创建了一个参照系统或关系系统,其中报价信息与交易品种名称分离。但这种分离并不是绝对独立的,因为报价记录和交易品种之间存在关联。这种关系正是通过创建主键和外键而产生的。如果你理解了这种关系,你就会明白,通过将不同的信息片段链接在一起,使它们之间有联系,就可以创建一个真正的数据库,同时允许我们向同一记录中添加更多或更少的数据。并且维护或修改原有数据库的成本也很低。
上面的代码可以改写成如下所示,这样会更接近实际情况。尽管我们尚未解决 tb_Symbols 表中交易品种名称在多个位置重复出现的问题。
01. PRAGMA FOREIGN_KEYS = ON;
02.
03. CREATE TABLE IF NOT EXISTS tb_Symbols
04. (
05.     id INTEGER PRIMARY KEY,
06.     symbol TEXT
07. );
08.
09. CREATE TABLE IF NOT EXISTS tb_Quotes
10. (
11.     of_day TEXT,
12.     price NUMERIC,
13.     fk_id INTEGER REFERENCES tb_Symbol (id)
14. );
SQLite 代码
请注意,我们现在做了一些小改动。它位于第 13 行,其目的相同:使用外键将 tb_Quotes 表与 tb_Symbols 表连接起来。还有一点:虽然我们说我们链接了表,但更准确的说法是,我们将 tb_Quotes 表中的一条记录与 tb_Symbols 表中的另一条记录链接起来。很好,现在请注意:我们在每个表中存储什么内容都无关紧要。我们可以向表中添加更多或更少的字段或数据列,但这不会直接影响搜索以及我们搜索时得到的结果。
但是,根据需要,可以在其中一个表中添加其他信息。同时,与此表关联的所有其他表也将从中受益,但我们不必完全重写数据库。你可能还没有意识到这一点的重要性。但是一旦你开始使用 SQL,你很快就会明白,当我们想要扩展数据库或在不同类型的信息之间创建关系系统时,它会有很大的帮助。
好的,但是我们如何解决数据库中可能存在重复数据的问题呢?这很简单。创建表时,我们会指定该列不得包含某些值,或者这些值不能重复。例如,让我们修改上面的代码,使各列中没有空值。但我们也不希望交易品种名称出现在同一列的多个记录中。因此,修正后的代码如下所示:
01. PRAGMA FOREIGN_KEYS = ON;
02.
03. CREATE TABLE IF NOT EXISTS tb_Symbols
04. (
05.     id INTEGER PRIMARY KEY NOT NULL,
06.     symbol TEXT NOT NULL UNIQUE
07. );
08.
09. CREATE TABLE IF NOT EXISTS tb_Quotes
10. (
11.     of_day TEXT NOT NULL,
12.     price NUMERIC NOT NULL,
13.     fk_id INTEGER NOT NULL,
14.     FOREIGN KEY (fk_id) REFERENCES tb_Symbol (id)
15. );
SQLite 代码
现在,如果我们运行这个脚本,我们会发现两个表都按预期创建,正如上面的解释所示。但是,与以前不同的是,现在不会再有重复记录了。如果我们尝试插入重复记录,SQL 将不允许。同样,我们的表将不再包含空值。请注意,这段代码非常简单明了。
如何理解最后一个脚本
在进入新领域之前,了解最后一个脚本是如何运作的非常重要。我们真的需要努力弄清楚这里到底发生了什么。否则我们将彻底迷失方向。因此,执行完上面所示的最后一个 SQL 脚本代码后,在数据库浏览器中我们将得到以下结果:
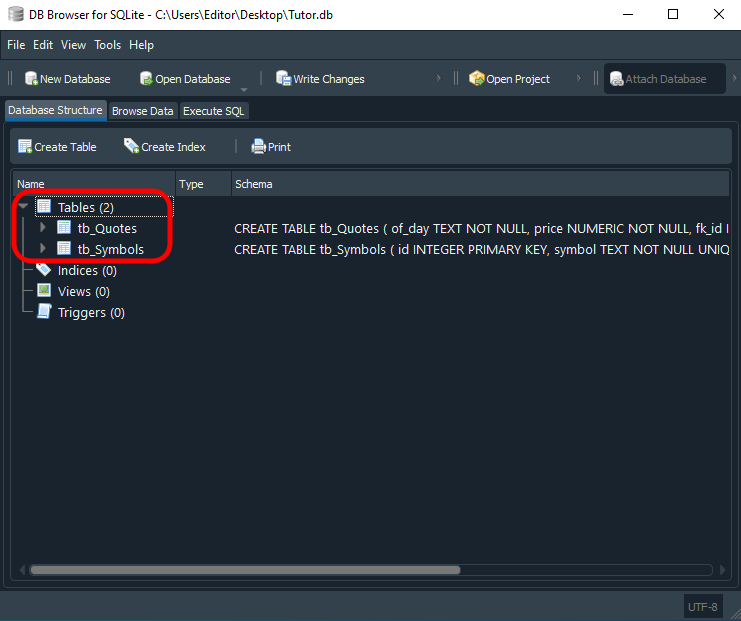
请注意,我们已将此处显示的两张表高亮显示。但我们究竟该如何使用它们呢?这看起来似乎很复杂,似乎只有计算机技术的高手才能做到。其实不然。使用这种结构其实并不复杂,反而非常直接。我们已经演示了如何使用脚本向表添加信息。这在之前关于 SQL 的文章中已经提到过了。这里我们将使用与之前看到的非常相似的方法。
为了了解所有流程,让我们添加一些数据,仅作为使用这种建模方式的一个示例。由于我们也展示了基本选择命令,因此也可以在此使用。但首先,我们要向数据库中添加一些记录。让我们用另一个与上述脚本略有不同的脚本替换它。
01. PRAGMA FOREIGN_KEYS = ON;
02.
03. DROP TABLE IF EXISTS tb_Quotes;
04. DROP TABLE IF EXISTS tb_Symbols;
05.
06. CREATE TABLE IF NOT EXISTS tb_Symbols
07. (
08.     id INTEGER PRIMARY KEY,
09.     symbol TEXT NOT NULL UNIQUE
10. );
11.
12. CREATE TABLE IF NOT EXISTS tb_Quotes
13. (
14.     of_day TEXT NOT NULL,
15.     price NUMERIC NOT NULL,
16.     fk_id INTEGER NOT NULL,
17.     FOREIGN KEY (fk_id) REFERENCES tb_Symbols(id)
18. );
19.
20. INSERT INTO tb_Symbols (id, symbol) VALUES(1, 'BOVA11');
21. INSERT INTO tb_Symbols (id, symbol) VALUES(3, 'PETR4');
22. INSERT INTO tb_Symbols (id, symbol) VALUES(2, 'WDOQ23');
23. INSERT INTO tb_Symbols (id, symbol) VALUES(4, 'VALE3');
24. INSERT INTO tb_Quotes (of_day, price, fk_id) VALUES ('17-07-2023', 12.90, 4);
25. INSERT INTO tb_Quotes (of_day, price, fk_id) VALUES ('14-07-2023', 118.12, 2);
26. INSERT INTO tb_Quotes (of_day, price, fk_id) VALUES ('13-07-2023', 119.53, 1);
27. INSERT INTO tb_Quotes (of_day, price, fk_id) VALUES ('12-07-2023', 117.45, 2);
28. INSERT INTO tb_Quotes (of_day, price, fk_id) VALUES ('11-07-2023', 119.30, 3);
29. INSERT INTO tb_Quotes (of_day, price, fk_id) VALUES ('10-07-2023', 120.59, 1);
30.
31. SELECT * FROM tb_Quotes;
SQLite 脚本
也许你看到这里会想:哇,多么复杂的代码啊;我永远也看不懂了。我想我会放弃,用不同的方式去做每件事。但我告诉你:你现在就要放弃吗?现在,当一切都变得更有意思的时候?毕竟,上面的代码并不复杂。它所包含的绝对所有内容,在我们提供了一些关于如何使用 SQL 语言的解释的初始阶段,就已经解释过了。
或许唯一可能让你感到困惑的部分是第 03 行和第 04 行,我们在这两行中告诉 SQL,如果 tb_Quotes 表和 tb_Symbols 表存在,则应将其删除。但是,为什么在我们还没来得及使用这些表之前就要删除它们呢?主要的问题是:为什么要删除它们?我们难道不能简单地保留它们,并向数据库中添加新数据吗?
所有这些问题其实只有一个答案。我们需要删除这些表,原因很简单,因为在第 20 行到第 29 行之间,我们将向其中添加值。但是,每次运行相同的脚本时,SQL 在向表中添加值时都会报告错误。出现此错误的原因正是因为数据库中某些字段的值不允许重复。
运行此脚本后,我们将得到以下结果:
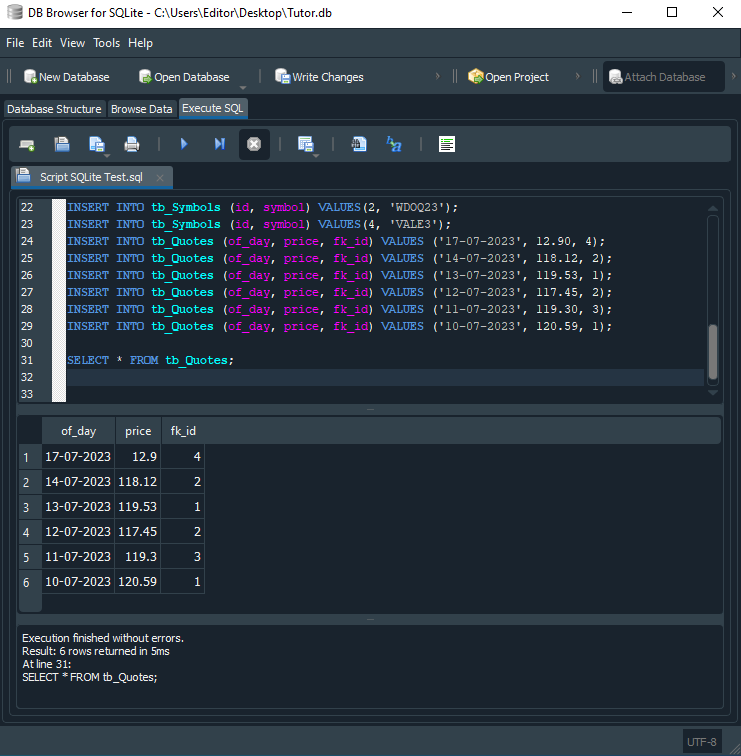
请注意,结果中我们得到的正是 tb_Quotes 表的内容。这是因为,在第 31 行,我们要求 SQL 提供此信息。但看到这些可能会让人有点沮丧。这是因为,如果我们拥有一个包含各种交易品种报价的庞大数据库,那么由于查询结果中不包含交易品种名称或其他任何有助于我们更好地理解在数据库中查找内容的信息,因此就很难看出每条报价分别对应哪个交易品种。但很快我们就会看到,通过对第 31 行代码进行一些小的更改(即使用 SELECT 命令),可以如何改进这一点。
最后的想法
亲爱的读者,在你放弃并决定不再学习 SQL 之前,请允许我提醒你,我们目前所使用的只是最基本的内容。我们尚未探讨 SQL 的一些功能。一旦你理解了这些功能,你会发现 SQL 远比它看起来要实用得多。不过,由于创作过程是动态的,我们最终很可能会改变我们正在构建的方向。我们将更多地展示如何在 SQL 中创建不同的内容,因为这对你来说确实非常重要且有用。仅仅认为自己比整个程序员和开发人员社区更有能力,只会导致时间和机会的浪费。别担心,因为接下来的内容将会更加有趣。
正如我所说,我仍然不确定是使用 SQLite 还是其他 SQL 实现。这是因为复制/模拟系统所需元素的发展是一个完全动态的过程。我们尚未决定下一步实际将朝哪个方向发展。但无论接下来阶段事件如何发展,当我们回到 MQL5 时,我们肯定会使用 SQL 来解决各种任务。我不会创建任何例程程序来执行 SQL 允许我们做并帮助我们完成的事情。但我们如何在实践中使用 SQL 尚未最终确定。
在下一篇文章中,我们将探讨如何在 SQL 中执行其他一些操作。毕竟,现在事情真的开始有了进展,而我们将要研究和解释的内容也几乎已经完全确定。然而,我想强调的是,这些文章并不是一门 SQL 课程。我只是想展示一些将来可能会用到的要点,因为对于 SQL 本身能为我们完成的任务,使用 MQL5 或其他任何语言都是没有意义的。而且我们讨论的不仅仅是创建和维护数据库。我们正在讨论的是编程本身。
许多人只了解少数 SQL 命令,但要么把它们忘了,要么对深入学习这一领域的知识兴趣不大,从而错失了使用这一真正强大工具的机会,因为许多人在与 SQL 集成的语言中创建的程序可以直接用 SQL 执行。而了解如何做到这些将在你的开发中大有裨益。所以,请尝试加深你对这一主题的了解。这些文章仅作为指南使用:不要把它们当成唯一的信息来源,也不要视为最终定论。给大家一个拥抱,我们下篇文章见。
| 文件 | 描述 |
|---|---|
| Experts\Expert Advisor.mq5 | 演示 Chart Trade 与 EA 之间的交互(交互需要 Mouse Study)。 |
| Indicators\Chart Trade.mq5 | 创建一个窗口,用于配置待发送的委托(需要 Mouse Study 才能进行交互) |
| Indicators\Market Replay.mq5 | 创建与复制/模拟服务交互的控件(交互需要 Mouse Study)。 |
| Indicators\Mouse Study.mq5 | 提供图形控件与用户之间的交互(这对于复制/模拟系统和真实市场都是必要的)。 |
| Services\Market Replay.mq5 | 创建并维护市场复制/模拟服务(整个系统的主文件)。 |
| Code VS C++\Servidor.cpp | 创建并维护用 C++ 开发的服务器套接字(MiniChat 版本)。 |
| Code in Python\Server.py | 在 Python 中创建并维护一个套接字,用于 MetaTrader 5 和 Excel 之间的通信。 |
| Indicators\Mini Chat.mq5 | 允许通过指标实现迷你聊天(需要使用服务器)。 |
| Experts\Mini Chat.mq5 | 允许使用 EA 实现迷你聊天功能(需要服务器)。 |
| Scripts\SQLite.mq5 | 演示如何通过 MQL5 使用 SQL 脚本。 |
| Files\Script 01.sql | 演示如何创建带有外键的简单表。 |
| Files\Script 02.sql | 演示如何向表中插入值。 |
参考
本文由MetaQuotes Ltd译自葡萄牙语
原文地址: https://www.mql5.com/pt/articles/12986
注意: MetaQuotes Ltd.将保留所有关于这些材料的权利。全部或部分复制或者转载这些材料将被禁止。
本文由网站的一位用户撰写,反映了他们的个人观点。MetaQuotes Ltd 不对所提供信息的准确性负责,也不对因使用所述解决方案、策略或建议而产生的任何后果负责。
 交易中的神经网络:自适应周期分段(结论)
 科学家群体优化(CoSO):算法实现
 市场模拟:MQL5 中的 SQL 入门(一)
 交易中的神经网络:自适应周期分块(Token生成)
