Redes neuronales en el trading: De los modelos Transformer a las neuronas de impulsos (Final)
 20
 0

Introducción
Los mercados financieros pueden compararse con un océano inmenso, en el que las olas suben y bajan cada segundo. A veces el mar está en calma y es predecible; otras, se agita y amenaza con volcar el barco; y, en ocasiones, se muestra engañosamente tranquilo, ocultando bajo la superficie fuertes corrientes. En este océano, el trader es como un patrón que no debe fijarse en cada pequeña ondulación del agua, sino precisamente en esa ráfaga de viento capaz de marcar el rumbo correcto. Un error de percepción o una interpretación errónea de las señales, y el barco se hundirá. En esta metáfora se resume toda la esencia de la búsqueda de herramientas analíticas eficaces. Lo importante no es la cantidad de información, sino su calidad, la capacidad de extraer sentido del caos.
Es precisamente aquí donde el framework SpikingBrain abre nuevos horizontes. Se basa en los principios del procesamiento orientado a eventos. El sistema no reacciona ante un flujo continuo de datos, sino únicamente ante aquellos impulsos que encierran un significado auténtico. Para un trader, esto significa una cosa: el modelo no se pierde en el mar de ruido del mercado, sino que aprende a captar señales auténticas capaces de cambiar el rumbo de las operaciones.
En la práctica, esto ofrece toda una serie de ventajas al operar en los mercados financieros. En primer lugar, se reducen los costes de cálculo, lo cual es especialmente importante cuando se trabaja con datos de alta frecuencia. El modelo se vuelve más ligero y rápido, y se puede integrar fácilmente en las plataformas de negociación sin temor a una carga excesiva sobre el sistema. En segundo lugar, aumenta la resistencia al ruido, lo que permite obtener señales de trading más claras y reducir la probabilidad de entradas erróneas. Y, por último, en tercer lugar, SpikingBrain permite una respuesta adaptativa: la capacidad del modelo para reajustarse rápidamente cuando el mercado cambia de rumbo de forma inesperada.
El framework SpikingBrain resulta interesante no solo por su filosofía de la percepción basada en eventos, sino también por su arquitectura, que convierte esa filosofía en una herramienta práctica. Su arquitectura se basa en la idea de representar el flujo de datos como una serie de impulsos discretos. Cada uno de estos impulsos no se produce de forma constante, sino solo cuando ocurre un evento que altera el equilibrio anterior. Esto permite pasar de un análisis continuo a trabajar con puntos compactos, pero repletos de información.
La arquitectura de SpikingBrain se compone de varios módulos clave, cada uno de los cuales se encarga de un aspecto concreto de la percepción del mercado. Lo primero que llama la atención son las neuronas de impulsos con umbral adaptativo. Solo reaccionan ante acontecimientos que se salen de lo habitual. El umbral de activación varía dinámicamente en función del comportamiento de los datos, lo que hace que el modelo sea más sensible o, por el contrario, filtre las pequeñas fluctuaciones.
El segundo elemento fundamental es el módulo de atención. Los transformadores clásicos son famosos por su capacidad para trabajar con el contexto. Pero ese poder tiene un alto precio. Cuanto más larga es la secuencia, más costosos resultan los cálculos. SpikingBrain aborda este problema de otra manera. Utiliza la atención lineal y una estrategia de ventana deslizante. Y en las versiones más complejas, se aplica un enfoque híbrido en el que los distintos tipos de atención actúan de forma conjunta. Esto permite al modelo procesar largas series de precios y volúmenes sin costes desorbitados y sin perder la capacidad de tener una visión global.
El mecanismo de mezcla de expertos ocupa un lugar especial. En la versión con arquitectura ampliada, no todos los bloques del modelo funcionan al mismo tiempo. Solo se activan los que son necesarios en cada situación concreta. En esencia, esto refleja la estrategia del propio trader, que durante los días laborables opera con calma y, en momentos de fuertes fluctuaciones, actúa con especial concentración.
Pero quizá la solución más elegante de SpikingBrain sea el sistema de codificación de eventos en forma de impulsos. Los datos iniciales se transforman en una serie de impulsos, en la que cada pulso refleja no solo el hecho de que el precio ha variado, sino también la importancia de dicho cambio. La frecuencia y la intensidad de los impulsos se convierten en una especie de lenguaje mediante el cual el modelo describe el mercado. Si el movimiento es débil, la señal es poco frecuente y tenue. Si el mercado estalla, los impulsos se convierten en un estruendoso repique de campanas y el sistema responde al instante.
Por lo tanto, SpikingBrain no es solo un conjunto de trucos matemáticos, sino un intento de construir un modelo que razone en términos de eventos. Sabe escuchar al mercado. Y precisamente por eso su arquitectura merece un análisis detallado, sobre todo en el contexto de su aplicación en los mercados financieros.
A continuación se muestra una representación propia del framework SpikingBrain.
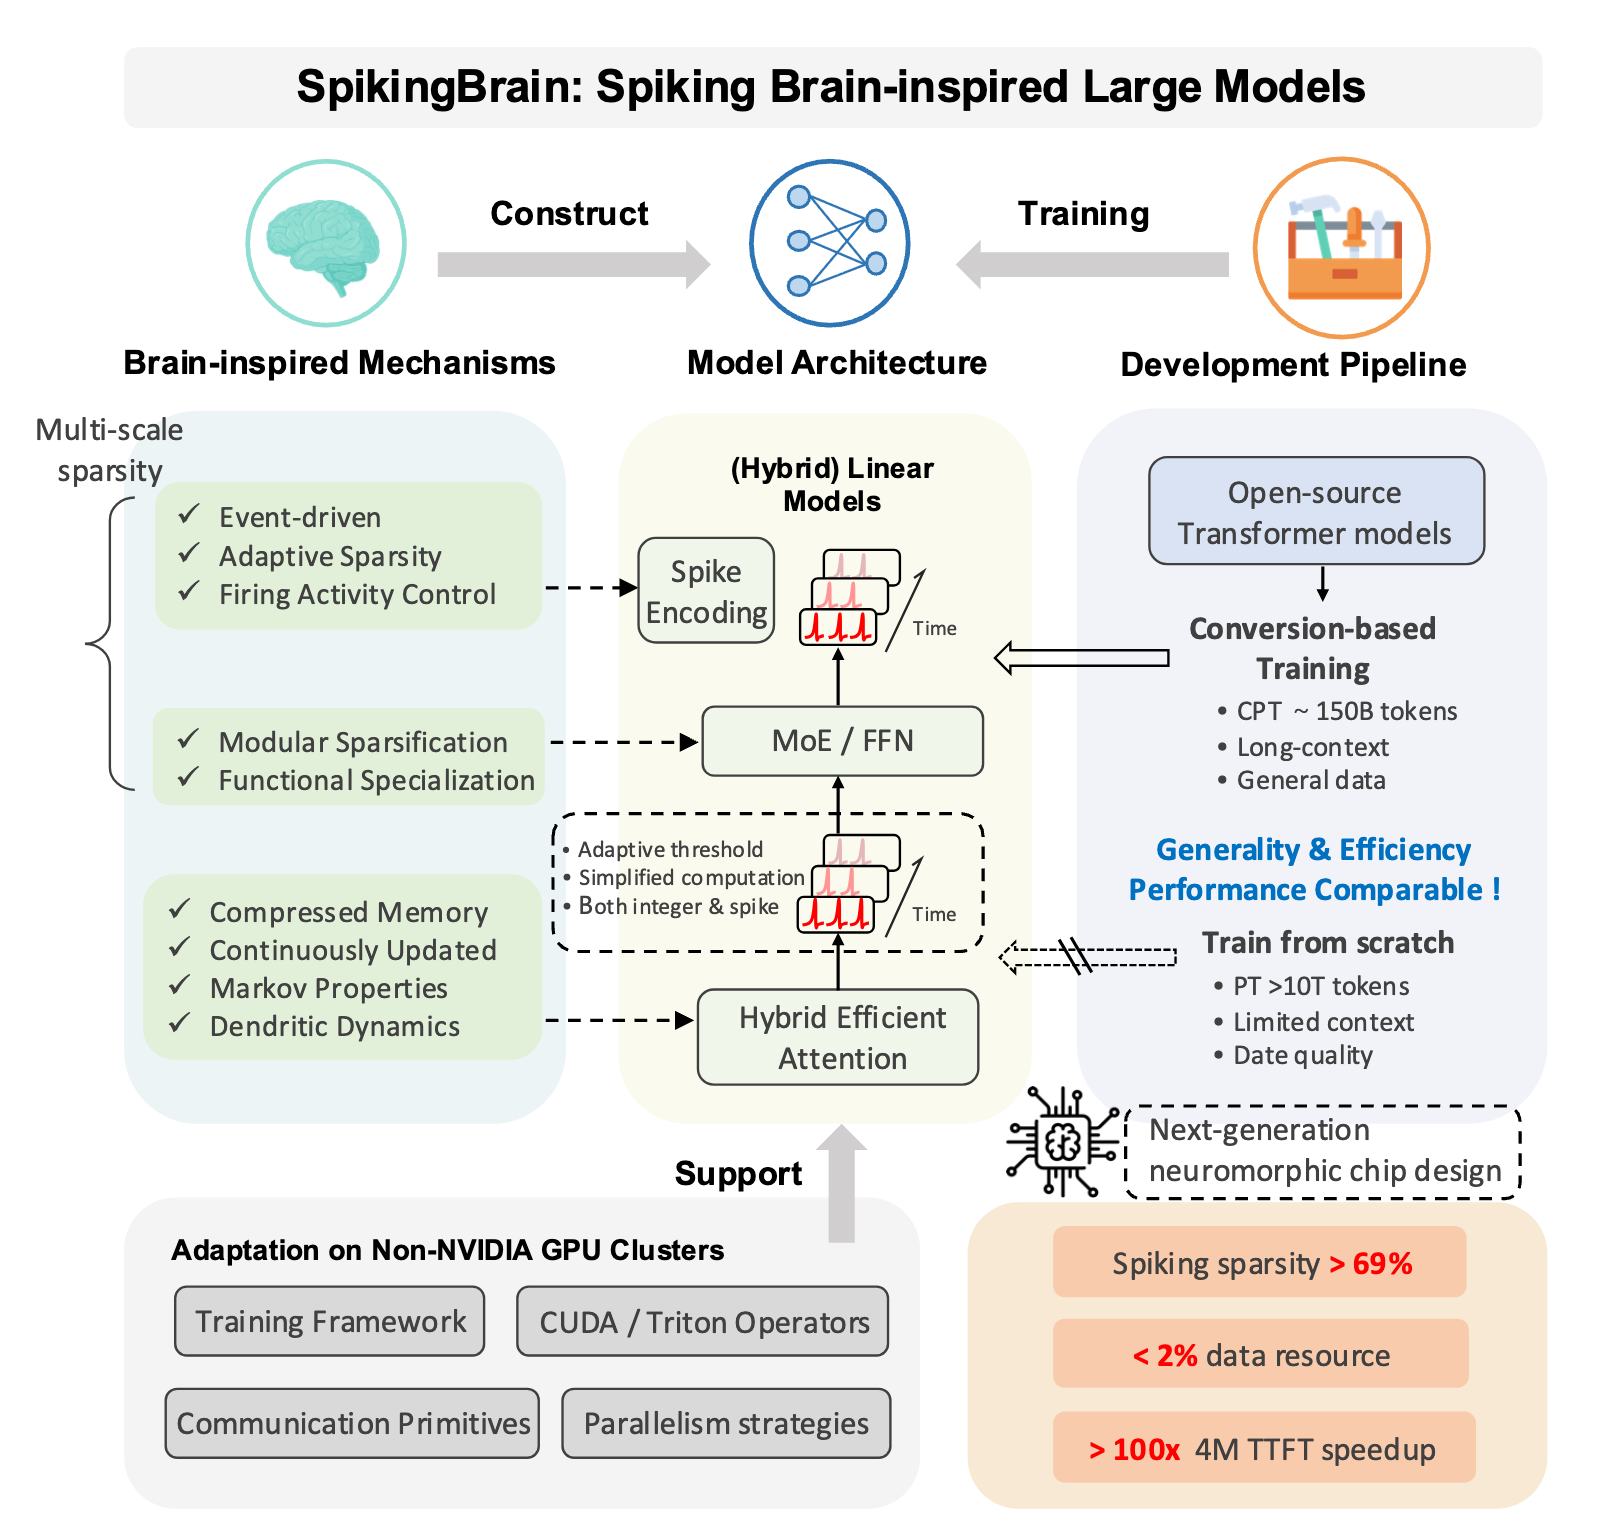
Cualquier arquitectura en el ámbito de la ciencia y la tecnología no pasa de ser un esquema sobre el papel hasta que sus líneas y bloques cobran vida en una implementación concreta. Por eso, nuestra explicación sobre SpikingBrain la estructuramos de forma sistemática. Paso a paso, para que las ideas no se queden en el aire, sino que se conviertan en herramientas de análisis útiles. La arquitectura de la que hemos hablado anteriormente marca la dirección y define la estructura. Pero cualquier diseño solo cobra sentido cuando sus componentes se integran en el trabajo práctico y los módulos teóricos pasan a formar parte del código que responde al flujo de datos del mercado.
Nuestro camino comenzó con nuestro primer contacto con SpikingBrain. En primer lugar, analizamos las ideas de los creadores del framework e intentamos explicarlas desde la perspectiva de los mercados financieros. Allí donde el texto original de los investigadores tenía un tono académico, buscamos un sentido práctico. En realidad, se trataba de preparar el terreno. Hemos esbozado una perspectiva y hemos demostrado que SpikingBrain tiene potencial para ir más allá de la mera teoría.
A continuación, mostramos cómo se pueden plasmar en código los conceptos de la lógica de eventos y dimos un paso importante: enseñamos al modelo a convertir un flujo continuo de números en impulsos discretos. En este caso, el elemento clave fue la transformación de la señal mediante un umbral. La neurona permanece en silencio hasta que el valor alcanza un umbral crítico, y solo entonces emite un breve impulso. Este enfoque permitió distinguir de inmediato el ruido de los cambios realmente significativos y abordar las cotizaciones desde una perspectiva diferente. Pero para evitar que este mecanismo se convirtiera en un callejón sin salida, hemos añadido la capacidad de aprendizaje: hemos hecho que los umbrales sean adaptativos y hemos garantizado que los gradientes se transmitan incluso a través de las neuronas silenciosas. Como resultado, la red ha adquirido la capacidad de adaptarse al mercado con el tiempo, en lugar de quedarse estancada en una forma estática.
Sin embargo, fuimos más allá y desarrollamos esas ideas hasta convertirlas en una arquitectura completa. Han pasado a primer plano los componentes principales que deben mantener el sistema en funcionamiento. Hemos integrado las transformaciones de impulsos en la estructura habitual de capas y hemos demostrado cómo pueden coexistir con bloques de convolución y otros elementos clásicos de las redes neuronales. La implementación práctica en MQL5 requirió un enfoque minucioso en lo que respecta a la memoria y los recursos de cálculo. Las neuronas no deben funcionar al mismo tiempo; de lo contrario, se pierde la propia esencia del enfoque basado en eventos. Por eso hemos diseñado un mecanismo en el que una parte significativa de las neuronas permanece inactiva, mientras que la capacidad de cálculo se concentra allí donde realmente se produce el movimiento. En esencia, hemos sentado las bases para que SpikingBrain pueda integrarse de forma orgánica en el ecosistema de trading, sin desmantelar la arquitectura habitual, sino enriqueciéndola con una nueva dimensión basada en eventos.
Módulo de atención dispersa
Continuamos nuestro recorrido desde la filosofía general del enfoque basado en eventos hasta la implementación concreta de la arquitectura propuesta. Bajemos de las alturas de los esquemas directamente a la cubierta del barco: al código y a la lógica de ejecución. Anteriormente explicamos por qué SpikingBrain concibe el mercado como una cadena de episodios significativos y mostramos los primeros pasos prácticos para convertir las activaciones continuas en impulsos. Ahora surge una pregunta lógica: ¿cómo debería comportarse esta lógica basada en eventos en aquellos ámbitos en los que tradicionalmente operan las ventanas de atención locales? ¿Qué cambios serán necesarios para que la atención local funcione siguiendo el espíritu de los impulsos y resista la avalancha de ruido del mercado?
Los creadores del framework proponen una ventana desplazable, pero el mercado es caprichoso. La distancia entre los destellos importantes varía dinámicamente, y el ruido suele llenar las ventanas con más densidad de la que nos gustaría, por lo que optamos por otro enfoque: mantenemos una lógica de atención dispersa basada en grafones. Pero la construimos de tal forma que respete la esencia misma de los impulsos: la asincronía, la adaptabilidad de los umbrales y el valor informativo del silencio de la neurona. Se trata de una réplica del módulo CNeuronSparseGraphAttention que no se limita a copiar la antigua implementación, sino que supone una evolución de la misma. CNeuronSpikeSparseAttention es nuestro atento guardián de la atención, adaptado al ritmo del mercado y al lenguaje de los impulsos.
class CNeuronSpikeSparseAttention   :  public CNeuronSpikeConv
  {
protected:
   CNeuronConvOCL       cValue;
   CNeuronGraphons      cGraphs;
   CNeuronSparseSoftMax cScores;
   CNeuronBaseOCL       cAttention;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronSpikeSparseAttention(void) {};
                    ~CNeuronSpikeSparseAttention(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint experts, float dropout,
                          uint emb_dimension, uint sparse_dimension,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override const   {  return defNeuronSpikeSparseAttention;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      TrainMode(bool flag) override;
  };
En primer lugar, cabe destacar que el nuevo objeto hereda de CNeuronSpikeConv, nuestro mecanismo de conversión de señales continuas en impulsos. Esto ya dice mucho sobre la finalidad de la clase. No reinventa los impulsos, sino que continúa procesándolos de forma adecuada. La herencia garantiza que se herede la lógica básica de convolución y de codificación inicial de eventos, mientras que en la clase derivada nos centramos exclusivamente en la lógica de atención basada en impulsos.
A primera vista, lo que más llama la atención en el cuerpo de la clase es un conjunto familiar de objetos internos: cValue, cGraphs, cScores, cAttention. Sus nombres son los de siempre, pero lo importante es que hay menos que en la versión original. Hemos prescindido deliberadamente de la estructura de conexiones residuales y de un módulo FeedForward independiente. La razón es sencilla: es la misma que ya hemos mencionado al trabajar con la atención lineal con compuertas: en el paradigma basado en eventos, las rutas superfluas diluyen el impulso y dan lugar a cálculos innecesarios. En cambio, la ruta residual y la FFN compartida se sitúan a nivel de bloque, donde se reúnen los resultados de las distintas ramas de atención y donde tiene sentido armonizar y amplificar la señal una sola vez.
Quiero destacar un aspecto importante del diseño. Todos los objetos internos se declaran de forma estática, como miembros de la clase. Esto permite dejar vacíos el constructor y el destructor: la inicialización se traslada a un método independiente, Init.
bool CNeuronSpikeSparseAttention::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                       uint units, uint window, uint experts, float dropout,
                                       uint emb_dimension, uint sparse_dimension,
                                       ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronSpikeConv::Init(numOutputs, myIndex, open_cl, window, window, window,
                              units, 1, optimization_type, batch))
      return false;
   activation = None;
El método Init prepara el módulo para operar en condiciones reales de mercado. La firma del método contiene todo lo necesario para gestionar las dimensiones y el comportamiento de la atención dispersa. Dentro del método, primero delegamos parte de la inicialización en la clase padre para mantener la compatibilidad con el codificador de impulsos.
A continuación, se ejecuta la inicialización sucesiva de los módulos internos. cValue es el primero en encargarse de recopilar la representación local: se trata de una convolución que prepara los valores V para la ponderación posterior.
   int index = 0;
   if(!cValue.Init(0, index, OpenCL, window, window, window, units, 1, optimization, iBatch))
      return false;
   cValue.SetActivationFunction(None);
Observe que eliminamos desde el principio la función de activación de cValue. La razón es práctica: las representaciones basadas en impulsos ya incorporan no linealidad y un patrón de activación disperso, y una activación adicional punto a punto aplicada justo después solo difumina el impulso. Necesitamos vectores V sin procesar para que la atención pueda ponderar correctamente la contribución de cada impulso.
A continuación, se inicializa la mezcla de grafones cGraphs, que constituye el núcleo de nuestro mecanismo de atención dispersa. Aprende la estructura de los datos teniendo en cuenta las distancias temporales, los volúmenes y la densidad de los impulsos.
   index++;
   if(!cGraphs.Init(0, index, OpenCL, units, window, emb_dimension, experts, dropout, optimization, iBatch))
      return false;
cScores es nuestra SoftMax dispersa. Esta adopta la estructura de datos propuesta por los grafones y centra la atención únicamente en los vecinos más relevantes, creando así una atención local dispersa. Dicho enfoque reduce la complejidad computacional a un nivel similar al de la atención por ventanas, pero mantiene la flexibilidad: la propia ventana es dinámica y depende de la actividad actual y de las estadísticas de los impulsos.
   index++;
   if(!cScores.Init(0, index, OpenCL, units, units, sparse_dimension, optimization, iBatch))
      return false;
cAttention acumula el resultado final α·V.
   index++;
   if(!cAttention.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
      return false;
   cAttention.SetActivationFunction(None);
//---
   return true;
  }
La utilidad práctica de todas estas decisiones es evidente: nos deshacemos de lo superfluo de antemano, porque en la lógica de impulsos esto suele ser más un obstáculo que una ayuda. Dejamos solo aquellos elementos que influyen realmente en la selección de impulsos. Organizamos la memoria de tal forma que el núcleo OpenCL trabaje con estructuras compactas y comprimidas. Esto supone una ventaja en cuanto a latencia y consumo energético, dos parámetros fundamentales para el trading en tiempo real.
Vamos a pasar ahora del nivel de inicialización directamente a la ejecución. El método feedForward supone ese ritual de trabajo en el que la teoría se une a los datos. El algoritmo es sencillo en su estructura y expresivo en su significado. Nada de más. Todo está orientado a un único objetivo: el resultado obtenido debe reflejar los impulsos importantes, y no el ruido.
bool CNeuronSpikeSparseAttention::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cValue.FeedForward(NeuronOCL))
      return false;
En primer lugar, se invoca el método de pasada directa del objeto cValue. Se trata de una etapa de convolución que recopila características locales y forma la matriz de valores V. Aquí preparamos lo que será ponderado por el mecanismo de atención.
Luego se generan las máscaras de grafón, la lista de vecinos y sus pesos relativos. La máscara no refleja una ventana estática, sino una vecindad dinámica que depende del tiempo, el volumen y la densidad de los impulsos. En este paso decidimos con qué posiciones comparamos exactamente la posición que estamos analizando.
   if(!cGraphs.FeedForward(NeuronOCL))
      return false;
   if(!cScores.FeedForward(cGraphs.AsObject()))
      return false;
cScores se utiliza para obtener una matriz dispersa de pesos de atención a partir de los grafones generados. En realidad, cScores genera dos artefactos clave: índices compactos (listas de vecinos) y un array de pesos para cada par posición — vecino.
El paso computacional clave es SparseMatMul. Esta función multiplica la matriz de pesos (scores), que es una matriz dispersa, por la matriz densa de valores V. El resultado es una matriz de atención densa con valores continuos.
   if(!SparseMatMul(cScores.GetIndexes(), cScores.getOutput(), cValue.getOutput(),
                    cAttention.getOutput(), cScores.Heads(), cScores.DimensionOut(),
                    cValue.GetUnits(), cValue.GetFilters()))
      return false;
//---
   return CNeuronSpikeConv::feedForward(cAttention.AsObject());
  }
El algoritmo de pasada directa finaliza con la llamada al método homónimo de la clase padre. Es un regreso al espacio de los impulsos. Luego transmitimos el vector de atención agregado al sistema de codificación de impulsos. Aquí se aplicarán los mecanismos de umbral y de generación de impulsos, y se preparará la salida del módulo para su integración en el nivel superior del bloque de atención.
En general, feedForward es un nodo de sincronización entre la lógica dispersa del grafón y la codificación de impulsos. Este transforma con precisión el contexto dinámico y local en representaciones densas de la atención y las devuelve al mundo de los impulsos.
Le sugiero que se familiarice por su cuenta con los algoritmos de retropropagación. Todos los detalles, incluido el código completo de la clase y la implementación de cada método, se incluyen en el archivo adjunto.
Variante de mezcla de expertos
Una vez implementados los módulos de atención, pasamos a la construcción del módulo de mezcla de expertos. Ya nos habíamos encontrado con diseños similares en artículos anteriores, pero ninguno de ellos estaba exento de concesiones. El equilibrio entre la eficiencia computacional y la expresividad del modelo siempre ha sido complicado. La filosofía de la arquitectura de impulsos aporta sus propias particularidades: el silencio de las neuronas, el carácter disperso de las señales y la actividad dinámica de los expertos hacen que la tarea resulte aún más delicada. Por eso, en el marco de este artículo, creamos un nuevo objeto que tiene en cuenta estas realidades.
Y, una vez más, cobra protagonismo la cuestión del ahorro de recursos informáticos y del trabajo paralelo eficaz de los expertos. La complejidad se ve agravada por el hecho de que cada elemento de la secuencia puede recurrir a su propio grupo de expertos. Y el enfoque habitual, en el que cada experto tiene su propia entrada, conduce rápidamente a la duplicación de cálculos.
Para entender cómo solucionarlo, echemos un vistazo a la representación del bloque MoE realizada por el autor.
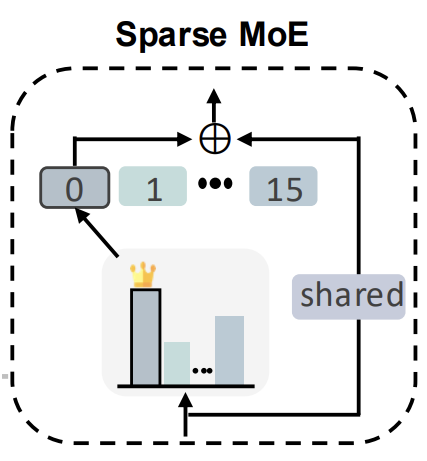
Los resultados de los expertos simplemente se suman. Y aquí se abre una importante oportunidad de optimización. A todos los expertos activos se les proporciona el mismo conjunto de datos. Desde un punto de vista matemático, esto permite sacar la entrada como factor común y, en lugar de realizar múltiples proyecciones individuales, efectuar una única proyección lineal utilizando la suma de los parámetros de los expertos. Este truco mantiene la corrección de los cálculos, pero reduce considerablemente la carga sobre la memoria y el procesador, lo cual es especialmente importante cuando se trabaja con series temporales largas de instrumentos financieros y con una alta frecuencia de actualización de los datos.
El resultado es un módulo MoE económico, pero a la vez expresivo, que se ajusta a la filosofía de la arquitectura de impulsos y está preparado para gestionar flujos paralelos de atención y señales del mercado.
Implementaremos el enfoque propuesto mediante una nueva clase denominada CNeuronMoEConv. Se trata de un módulo completo que se integra perfectamente en la arquitectura de impulsos y garantiza un reparto eficaz de la carga de trabajo entre los expertos. La clase hereda de la clase base CNeuronBaseOCL, lo que le permite compartir un mismo contexto de OpenCL con las demás capas e interactuar fácilmente con otros módulos.
class CNeuronMoEConv   :  public CNeuronBaseOCL
  {
protected:
   CLayer            acProbability;
   CParams           cExperts;
   CNeuronBaseOCL    cWeightsConv;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronMoEConv(void) {};
                    ~CNeuronMoEConv(void) {};
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint window_out,
                          uint experts, float dropout, uint topK,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override const   {  return defNeuronMoEConv;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      TrainMode(bool flag) override;
  };
Dentro de la clase se distinguen varios componentes clave. acProbability se encarga de la distribución probabilística de la actividad de los expertos, determinando cuáles de ellos participarán en el procesamiento de cada elemento de la secuencia. cExperts almacena los parámetros de todos los expertos, que en conjunto conforman el amplio conjunto de funciones del modelo. cWeightsConv se utiliza para generar el conjunto de parámetros de los expertos activos. Aquí es donde se pone en práctica la idea de sacar la entrada como factor común, mencionada anteriormente. Esta técnica reduce considerablemente el número de cálculos y el consumo de memoria, sin que por ello se pierda la expresividad del modelo.
La inicialización de un nuevo objeto se realiza en el método Init, que prepara minuciosamente todos los componentes internos y garantiza el correcto funcionamiento de la capa.
bool CNeuronMoEConv::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint window_out,
                          uint experts, float dropout, uint topK,
                          ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, units * window_out, optimization_type, batch))
      return false;
En primer lugar, se ejecuta la inicialización de la clase padre.
A continuación, se crean y configuran, uno por uno, los elementos clave del módulo. En primer lugar, se crea una cadena para calcular las probabilidades de activación de los expertos: acProbability.
//---
   int index = 0;
//---
   CNeuronConvOCL       *conv    = NULL;
   CNeuronDropoutOCL    *dout    = NULL;
   CNeuronSparseSoftMax *softmax = NULL;
//--- Probability
   acProbability.Clear();
   acProbability.SetOpenCL(OpenCL);
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(experts, index, OpenCL, window, window, 2 * experts, units, 1, optimization, iBatch) ||
      !acProbability.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(experts, index, OpenCL, 2 * experts, 2 * experts, experts, units, 1, optimization, iBatch) ||
      !acProbability.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
   index++;
   dout = new CNeuronDropoutOCL();
   if(!dout ||
      !dout.Init(0, index, OpenCL, conv.Neurons(), dropout, optimization, iBatch) ||
      !acProbability.Add(dout))
     {
      DeleteObj(dout);
      return false;
     }
   index++;
   softmax = new CNeuronSparseSoftMax;
   if(!softmax ||
      !softmax.Init(0, index, OpenCL, units, experts, topK, optimization, iBatch) ||
      !acProbability.Add(softmax))
     {
      DeleteObj(softmax);
      return false;
     }
   softmax.SetHeads(units);
Aquí se crea una secuencia formada por dos capas de convolución con activación SoftPlus entre ellas. Esta organización garantiza una distribución suave y estable de los valores, lo cual resulta especialmente importante a la hora de trabajar con señales financieras dinámicas, en las que los picos bruscos y el ruido pueden saturar fácilmente el modelo. Las capas de convolución generan distribuciones de relevancia de los expertos para cada elemento de la secuencia, evaluando cuál de los expertos es el más relevante en ese momento. La cadena la cierra el objeto de la función SoftMax dispersa, que selecciona un número determinado de los expertos más relevantes y asigna a cada uno de ellos un coeficiente de relevancia, lo que permite al modelo centrarse en las señales del mercado que realmente importan, ignorando el ruido y los patrones poco significativos.
La incorporación de Dropout antes de SoftMax regula la desactivación aleatoria de los elementos, lo que evita el sobreajuste y aumenta la robustez del modelo frente al ruido del mercado.
Al mismo tiempo, se inicializa el objeto cExperts, que almacena los parámetros de todos los expertos, agrupándolos en un único espacio.
   index++;
   if(!cExperts.Init(0, index, OpenCL, window * window_out * experts, optimization, iBatch))
      return false;
   index++;
   if(!cWeightsConv.Init(0, index, OpenCL, window * window_out * units, optimization, iBatch))
      return false;
//---
   return true;
  }
Y cWeightsConv actúa como un conjunto agregado de parámetros de los expertos activos.
Cada paso de la inicialización de los componentes internos va acompañado de una comprobación de que las operaciones se han realizado correctamente. Si se produce un error, el objeto se elimina y el método devuelve false. Esto garantiza la fiabilidad y la previsibilidad del funcionamiento de la capa, incluso con combinaciones complejas de parámetros.
El método feedForward es el ciclo de trabajo principal en el que la teoría de la mezcla de expertos se traduce en cálculos concretos.
bool CNeuronMoEConv::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   CNeuronBaseOCL* prev = NeuronOCL;
   CNeuronBaseOCL* current = NULL;
   CNeuronConvOCL *conv = NULL;
   CNeuronSparseSoftMax *softmax = NULL;
//--- Probability
   for(int i = 0; i < acProbability.Total(); i++)
     {
      current = acProbability[i];
      if(!current ||
         !current.FeedForward(prev))
         return false;
      prev = current;
     }
   conv = acProbability[0];
   softmax = prev;
En primer lugar, se procesan todas las capas de la cadena de probabilidades acProbability. Las capas convolucionales y la capa de SoftMax dispersa procesan sucesivamente la señal de entrada, generando una distribución de la relevancia de los expertos para cada elemento de la secuencia. Al mismo tiempo, se comprueba que cada paso se haya realizado correctamente. Si alguna capa no ha podido procesar la entrada, el método devuelve false de forma controlada, lo que garantiza la estabilidad del funcionamiento.
Después se trabaja con los expertos. En el modo de entrenamiento (bTrain==true), se invoca el método de pasada directa del objeto cExperts, lo que genera los parámetros de todos los expertos. Durante el funcionamiento, los parámetros de los expertos son estáticos, por lo que se omite este paso, lo que reduce la complejidad computacional del modelo.
//--- Experts
   if(bTrain)
      if(!cExperts.FeedForward())
         return false;
El siguiente paso clave es generar una mezcla de parámetros mediante SparseMatMul. La operación matricial dispersa combina con precisión los expertos activos seleccionados (top-K) con sus parámetros, creando la matriz de pesos final cWeightsConv. Este enfoque permite ahorrar recursos computacionales, al tiempo que tiene en cuenta la actividad dinámica de los expertos y la estructura dispersa de los datos, un aspecto de vital importancia a la hora de analizar series temporales financieras con señales ruidosas y poco frecuentes.
   uint units = conv.GetUnits();
   uint window_in = conv.GetWindow();
   uint window_out = Neurons() / units;
   uint topK = softmax.DimensionOut();
   uint experts = cExperts.Neurons() / (window_in * window_out);
//--- Generate Weights
   if(!SparseMatMul(softmax.GetIndexes(), softmax.getOutput(), cExperts.getOutput(),
                    cWeightsConv.getOutput(), units, topK, window_in * window_out, experts))
      return false;
Por último, la matriz de pesos resultante se aplica a los datos de entrada mediante el método MatMul, generando la salida de la capa.
//--- result
   if(!MatMul(NeuronOCL.getOutput(), cWeightsConv.getOutput(), Output, 1, window_in, window_out, units, true))
      return false;
   if(activation != None)
      if(!Activation(Output, Output, activation))
         return false;
//---
   return true;
  }
Si se ha definido una función de activación, esta se aplica a la salida, lo que añade no linealidad y estabiliza la distribución de las señales.
De este modo, el método feedForward combina con precisión tres niveles de lógica: el cálculo de las probabilidades de los expertos, la selección de los participantes activos y su influencia agregada en la señal de salida. Todo ello garantiza un procesamiento de series temporales flexible, económico y adaptable, lo cual resulta especialmente importante para el análisis de los mercados financieros, caracterizados por su gran dinamismo y su alto nivel de ruido.
Como resultado, obtenemos un módulo MoE que no solo ahorra recursos, sino que también mantiene la flexibilidad en la distribución de la atención a nivel de los expertos, permitiendo que cada elemento de la serie temporal active su propio conjunto único de expertos.
Se recomienda familiarizarse por cuenta propia con los algoritmos de los métodos de retropropagación para comprender plenamente el funcionamiento de la capa y su interacción con otros componentes del modelo. Todo el código de la clase y la implementación de cada método se incluyen en el archivo adjunto, lo que permite estudiarlos en detalle y paso a paso.
Objeto de nivel superior
Ahora que hemos analizado en detalle el funcionamiento de cada uno de los componentes del framework, ha llegado el momento de dar un paso más y unificarlo todo en un único objeto de nivel superior: CNeuronSpikingBrain. Esta clase implementa la sincronización y la interacción de varios módulos clave: el funcionamiento en paralelo de dos algoritmos de atención, el procesamiento posterior de los resultados mediante una mezcla de expertos, así como la integración de conexiones residuales. Este enfoque permite combinar los contextos locales y globales, teniendo en cuenta la actividad dinámica de los impulsos y el carácter disperso de las señales, lo cual resulta especialmente importante para el análisis de series temporales financieras con alta volatilidad.
El objeto de nivel superior que hemos implementado no se ciñe al marco estricto del framework de los autores, sino que se basa en una solución contextual más amplia. Utilizaremos la atención dispersa no solo como un mecanismo de análisis local, sino como una herramienta para identificar los pasos temporales más significativos en el contexto de toda la secuencia analizada. Esto permite centrarse en aquellos momentos en los que realmente se producen cambios capaces de influir en el comportamiento del mercado.
Al mismo tiempo, los módulos de atención lineal, que en un principio están orientados a la agregación global de características, los utilizamos para el análisis independiente de la dinámica de secuencias unitarias individuales. Este enfoque permite lograr un equilibrio entre la profundidad de la muestra local y la amplitud de la cobertura global. Los mecanismos locales identifican los impulsos significativos, mientras que los mecanismos lineales construyen una visión global de la dinámica. En conjunto, esto da lugar a una representación más estable de los datos y refuerza la capacidad del modelo para hacer frente al ruido propio de las series temporales financieras.
class CNeuronSpikingBrain  :  public CNeuronBaseOCL
  {
protected:
   CNeuronSpikeSparseAttention   cTimeAttention;
   CLayer                        caSpatialAttention;
   CNeuronBaseOCL                cResidual;
   CLayer                        caFFN;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronSpikingBrain(void) {};
                    ~CNeuronSpikingBrain(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint experts, float dropout,
                          uint emb_dimension, uint sparse_dimension,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override const   {  return defNeuronSpikingBrain;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      TrainMode(bool flag) override;
   virtual bool      Clear(void) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
  };
Dentro de la clase se definen varios objetos centrales:
- cTimeAttention implementa la atención dispersa local en el dominio del tiempo, acentuando la señal únicamente en los momentos significativos de la secuencia;
- caSpatialAttention permite un análisis independiente de secuencias unitarias, generando una representación paralela del contexto;
- cResidual suma con precisión las salidas de ambos módulos de atención, lo que garantiza la estabilidad y evita la degradación de las señales al combinar los resultados;
- caFFN realiza un procesamiento posterior mediante una mezcla de expertos, lo que potencia la expresión de las características más significativas y permite preparar los datos de entrada para el módulo siguiente.
La inicialización del objeto se lleva a cabo en el método Init, que, de hecho, constituye su núcleo. Aquí ensamblamos de forma secuencial todos los componentes clave y definimos la arquitectura de alto nivel.
bool CNeuronSpikingBrain::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                               uint units, uint window, uint experts, float dropout,
                               uint emb_dimension, uint sparse_dimension,
                               ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, window * units, optimization_type, batch))
      return false;
   activation = None;
En primer lugar, se invoca la inicialización de la clase padre, en la que se establecen las dimensiones del espacio de resultados y el tipo de optimización. En esta fase se establece una activación neutra, ya que la transformación final se formará mediante una combinación más compleja de módulos.
A continuación, configuramos el módulo de atención temporal cTimeAttention, basado en una arquitectura de impulsos dispersa. Su objetivo es identificar los pasos temporales más significativos de la secuencia, lo que responde directamente a las particularidades del análisis de las señales del mercado, donde no importa cada tick, sino solo los momentos clave de la dinámica.
   int index = 0;
   if(!cTimeAttention.Init(0, index, OpenCL, units, window, experts, dropout, emb_dimension,
                           sparse_dimension, optimization, iBatch))
      return false;
El siguiente bloque es la atención espacial caSpatialAttention, en la que se utiliza un par de objetos de transposición de datos y el módulo de atención lineal CNeuronGateLineAttention.
   CNeuronTransposeOCL* transp = NULL;
   CNeuronGateLineAttention* line_att = NULL;
   caSpatialAttention.Clear();
   caSpatialAttention.SetOpenCL(OpenCL);
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, units, window, optimization, iBatch) ||
      !caSpatialAttention.Add(transp))
     {
      DeleteObj(transp)
      return false;
     }
   index++;
   line_att = new CNeuronGateLineAttention();
   if(!line_att ||
      !line_att.Init(0, index, OpenCL, window, units, emb_dimension, experts, optimization, iBatch) ||
      !caSpatialAttention.Add(line_att))
     {
      DeleteObj(line_att)
      return false;
     }
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, window, units, optimization, iBatch) ||
      !caSpatialAttention.Add(transp))
     {
      DeleteObj(transp)
      return false;
     }
Esta combinación permite analizar las relaciones entre las características en diferentes proyecciones, manteniendo un equilibrio entre la velocidad de cálculo y la exhaustividad a la hora de tener en cuenta el contexto global. Las capas se añaden al contenedor una tras otra, lo que garantiza la flexibilidad y la capacidad de ampliación de la arquitectura.
Luego se incorpora al esquema el objeto cResidual, que actúa como estabilizador. Acumula los resultados de los bloques de atención paralelos y garantiza la transmisión correcta de las señales hacia adelante, sin pérdida de información ni degradación de los gradientes.
   index++;
   if(!cResidual.Init(0, index, OpenCL, window * units, optimization, iBatch))
      return false;
   cResidual.SetActivationFunction(None);
Se ha prestado especial atención al diseño del bloque caFFN, en el que se combina una capa de mezcla de expertos (CNeuronMoEConv) con la transformación de impulsos mediante CNeuronSpikeConv. En primer lugar, se crea un módulo MoE que distribuye dinámicamente la carga entre varios expertos, manteniendo la eficiencia computacional gracias a una SoftMax dispersa.
   CNeuronSpikeConv* conv = NULL;
   CNeuronMoEConv* moe = NULL;
   caFFN.Clear();
   caFFN.SetOpenCL(OpenCL);
   index++;
   moe = new CNeuronMoEConv();
   if(!moe ||
      !moe.Init(0, index, OpenCL, units, window, 2 * window, experts, dropout,
                                    sparse_dimension, optimization, iBatch) ||
      !caFFN.Add(moe))
     {
      DeleteObj(moe)
      return false;
     }
   moe.SetActivationFunction(SoftPlus);
A continuación, se añade una capa de convolución que se encarga del procesamiento final de la secuencia. Es importante destacar que, entre las capas, se utiliza SoftPlus como función de activación, lo que suaviza la dinámica y resulta muy adecuado para el análisis de señales financieras inestables.
   index++;
   conv = new CNeuronSpikeConv();
   if(!conv ||
      !conv.Init(0, index, OpenCL, 2 * window, 2 * window, window, units, 1, optimization, iBatch) ||
      !caFFN.Add(conv))
     {
      DeleteObj(conv)
      return false;
     }
   if(!Clear())
      return false;
//---
   return true;
  }
El proceso finaliza con la llamada al método Clear, lo que garantiza la inicialización correcta del estado de todos los objetos internos antes de comenzar a trabajar.
En definitiva, el método Init reúne con precisión todos los componentes, creando a partir de ellos una estructura unificada. Aquí se aprecia claramente la idea del funcionamiento paralelo de los mecanismos de atención locales y globales, con su posterior integración y filtrado a través del bloque MoE.
El método feedForward, implementado en la clase CNeuronSpikingBrain, desempeña un papel fundamental en la configuración del ciclo computacional completo del framework. Imaginemos que tenemos ante nosotros a un analista cuya tarea consiste en recopilar datos sobre el mercado y convertirlos en una previsión coherente. Lo primero que hace es recurrir a la atención temporal: es como echar un vistazo a la dinámica de los precios en las últimas horas. Identifica los pasos temporales clave: variaciones bruscas, períodos de consolidación e informes importantes. Todo ello se registra como un conjunto de puntos de referencia sobre los que se puede basar el análisis posterior.
bool CNeuronSpikingBrain::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   CNeuronBaseOCL* prev = NeuronOCL;
   CNeuronBaseOCL* current = NULL;
//---
   if(!cTimeAttention.FeedForward(prev))
      return false;
A continuación, el analista pasa a la atención espacial. Es similar a la distribución de eventos por sectores o activos. Estas interrelaciones no siempre son evidentes a simple vista, pero son precisamente ellas las que conforman el contexto global que el analista debe tener presente.
   for(int i = 0; i < caSpatialAttention.Total(); i++)
     {
      current = caSpatialAttention[i];
      if(!current ||
         !current.FeedForward(prev))
         return false;
      prev = current;
     }
Para no perderse entre la gran cantidad de señales, el analista utiliza el mecanismo de conexión residual. Es la capacidad de volver a los hechos básicos y compararlos con las nuevas conclusiones. Como experto con amplia experiencia, siempre compara sus últimas observaciones con lo que ya se sabe, manteniendo un equilibrio sensato entre los conocimientos previos y la nueva información.
   if(!SumAndNormilize(prev.getOutput(), cTimeAttention.getOutput(), cResidual.getOutput(),
                       cTimeAttention.GetFilters(), false, 0, 0, 0, 1) ||
      !SumAndNormilize(cResidual.getOutput(), NeuronOCL.getOutput(), cResidual.getOutput(),
                       cTimeAttention.GetFilters(), true, 0, 0, 0, 1))
      return false;
La fase final es el trabajo de los expertos. Aquí es donde entra en juego el módulo Mixture of Experts, que se asemeja a un equipo de analistas de diferentes especialidades: uno se especializa en análisis técnico, otro en macroeconomía y un tercero en flujos de capital. Según la situación del mercado, el sistema determina qué opinión tiene más peso en ese momento y agrupa sus decisiones. La convolución de impulsos es un método para identificar patrones locales: un analista técnico que estudia los gráficos hasta el más mínimo detalle.
   prev = cResidual.AsObject();
   for(int i = 0; i < caFFN.Total(); i++)
     {
      current = caFFN[i];
      if(!current ||
         !current.FeedForward(prev))
         return false;
      prev = current;
     }
   if(!SumAndNormilize(cResidual.getOutput(), prev.getOutput(), Output,
                       cTimeAttention.GetFilters(), true, 0, 0, 0, 1))
      return false;
//---
   return true;
  }
El método feedForward no es simplemente un algoritmo de pasada directa, sino un trabajo del equipo analítico cuidadosamente organizado. Empieza por identificar los acontecimientos clave, luego profundiza en las relaciones entre los activos, compara los nuevos datos con los resultados anteriores y concluye el análisis con una síntesis de las opiniones de los expertos. El resultado es una previsión coherente que refleja tanto el contexto global como las señales locales del mercado.
Como resultado, CNeuronSpikingBrain se convierte en un potente módulo integrador, capaz de tener en cuenta simultáneamente los contextos temporal y espacial, adaptarse a las señales dinámicas del mercado y distribuir eficazmente la actividad entre los expertos. Esto lo convierte en el componente central de nuestra arquitectura de impulsos para el análisis de datos financieros, al aportar flexibilidad, eficiencia computacional y resistencia al ruido. El código completo de esta clase y de todos sus métodos se puede consultar en el archivo adjunto.
Arquitectura de modelos
Ahora que los módulos individuales están listos, es el momento de ensamblarlos para crear modelos reales: el codificador del estado del entorno, el actor y el crítico.
Empezamos por el codificador: es la parte que lee el historial del instrumento financiero y lo convierte en una representación compacta y de varios niveles. En primer lugar va la capa básica, que contiene HistoryBars * BarDescr valores. Cada barra es un conjunto de características de una vela. Datos sin procesar, sin destacar ningún aspecto en particular.
bool CreateDescriptions(CArrayObj *&encoder,
                        CArrayObj *&actor,
                        CArrayObj *&critic
                       )
  {
//---
   CLayerDescription *descr;
//---
   if(!encoder)
     {
      encoder = new CArrayObj();
      if(!encoder)
         return false;
     }
   if(!actor)
     {
      actor = new CArrayObj();
      if(!actor)
         return false;
     }
   if(!critic)
     {
      critic = new CArrayObj();
      if(!critic)
         return false;
     }
//--- Encoder
   encoder.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   uint prev_count = descr.count = (HistoryBars * BarDescr);
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
A continuación, aplicamos la normalización con regularización por ruido: BatchNormWithNoise. Esta capa evita que los datos se estanquen. Equilibra las escalas y añade un ligero ruido estocástico durante el entrenamiento, lo cual resulta útil cuando la volatilidad de los mercados es variable.
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormWithNoise;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
A continuación viene el paso de agregación ConcatDiff. Tomamos los datos y les añadimos una secuencia de diferencias: se trata de una técnica clásica que pone de relieve la evolución, en lugar de los niveles absolutos.
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConcatDiff;
   prev_count = descr.count = HistoryBars;
   descr.layers = BarDescr;
   descr.step = 1;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   uint prev_out = descr.layers * 2 ;
Luego viene Mamba4CastEmbedding, una capa específica que genera embeddings de múltiples períodos. Aquí tenemos en cuenta explícitamente diferentes marcos temporales para dotar al modelo de un amplio contexto histórico, sin perder la sensibilidad local.
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defMamba4CastEmbeding;
   prev_count = descr.count = HistoryBars;
   descr.window = prev_out;
   prev_out = descr.window_out = NSkills;
     {
      uint temp[] = {PeriodSeconds(PERIOD_D1), PeriodSeconds(PERIOD_MN1)};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
El elemento clave es nuestro bloque de impulsos NeuronSpikingBrain. Lo incorporamos AttentionLayers veces: se trata de una pila en la que la atención temporal dispersa de ámbito local convive con la atención espacial lineal/con compuertas, y los resultados se agregan después mediante una conexión residual común y una MoE-FFN.
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronSpikingBrain;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.variables = NExperts;          // Expertos
   descr.window_out = EmbeddingSize;    // Inside Dimension
   descr.step = TopK;                   // Top-K
   descr.probability = 0.3f;
   descr.optimization = ADAM;
   descr.batch = BatchSize;
   descr.activation = None;
   for(int i = 0; i < AttentionLayers; i++)
      if(!encoder.Add(descr))
        {
         delete descr;
         return false;
        }
   uint window = descr.window;
   uint count = prev_count;
Tras la capa de atención, reducimos la representación al espacio original de características y al horizonte de planificación establecido.
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.step = prev_out;
   prev_out = descr.window_out = BarDescr;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 6
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.count = prev_count;
   prev_count = descr.window = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = descr.count;
//--- layer 7
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.step = prev_out;
   prev_out = descr.window_out = NForecast;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 8
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.count = prev_count;
   prev_count = descr.window = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = descr.count;
El codificador termina con RevInDenorm, que devuelve las predicciones a sus escalas originales y los valores a un formato adecuado para el trading.
//--- layer 9
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronRevInDenormOCL;
   descr.count = prev_count * prev_out;
   descr.layers = 1;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Los resultados del codificador del estado del entorno sirven como datos de entrada para los modelos del actor y del crítico, que se encargan de generar las decisiones de trading y de su posterior evaluación. La arquitectura de estos modelos se basa, en general, en los avances de investigaciones anteriores; sin embargo, incorpora modificaciones importantes: elementos de soluciones basadas en impulsos que permiten aumentar la adaptabilidad y la sensibilidad del sistema a la dinámica del mercado. Estos cambios dan lugar a un mecanismo de toma de decisiones más flexible, en el que la estructura clásica se ve enriquecida con capas adicionales de procesamiento neuronal. Para quienes deseen profundizar en los detalles técnicos, recomendamos consultar el código completo de la arquitectura de los modelos, incluido en el archivo adjunto.
Pruebas
Antes de confiar fondos reales al modelo, comprobamos minuciosamente la estrategia con datos históricos, como si estuviéramos entrenando las habilidades de evaluación de riesgos y toma de decisiones en las más diversas condiciones de mercado. Cada etapa simulaba un mercado real, lo que permitía al modelo adquirir experiencia de forma gradual y desarrollar algoritmos de comportamiento estables.
La primera fase —el entrenamiento offline— se llevó a cabo con datos históricos del par de divisas EURUSD en el marco temporal H1, durante el periodo comprendido entre enero de 2024 y junio de 2025. Este periodo se convirtió en un auténtico campo de entrenamiento. El modelo aprendió a reproducir patrones históricos, a comprender la dinámica del mercado y a identificar regularidades en la evolución de los precios y el volumen de operaciones, adaptándose a los cambios del mercado. Se podría decir que desarrollaba la intuición del trader, combinada con una evaluación estratégica precisa.
La siguiente fase —el ajuste online en el probador de estrategias de MetaTrader 5— permitió que el modelo trabajara con flujos de datos en tiempo real, vela a vela. En esta fase, el modelo aprendió a desenvolverse en la dinámica del mercado real, a mantener la estabilidad en medio del ruido, a ajustar sus acciones ante una baja liquidez y a reaccionar al instante ante variaciones bruscas de los precios. Esta fase supuso el perfeccionamiento de la estrategia: la estructura básica, formada a partir de datos históricos, se mantuvo inalterada, pero el modelo aprendió a adaptarse con flexibilidad a la situación actual del mercado, minimizando el riesgo de sobreajuste y aumentando la precisión de las previsiones en un entorno impredecible.
La comprobación final se llevó a cabo con datos correspondientes a julio y agosto de 2025, totalmente nuevos y que no se habían utilizado anteriormente. Todos los parámetros obtenidos en las fases anteriores se cargaron sin modificaciones, lo que permitió evaluar de forma imparcial la capacidad de generalización del modelo y comprobar su robustez ante nuevas situaciones de mercado. A continuación se presentan los resultados de las pruebas, que demuestran la eficacia del enfoque por etapas para el entrenamiento y la adaptación del modelo a las condiciones reales del mercado financiero.
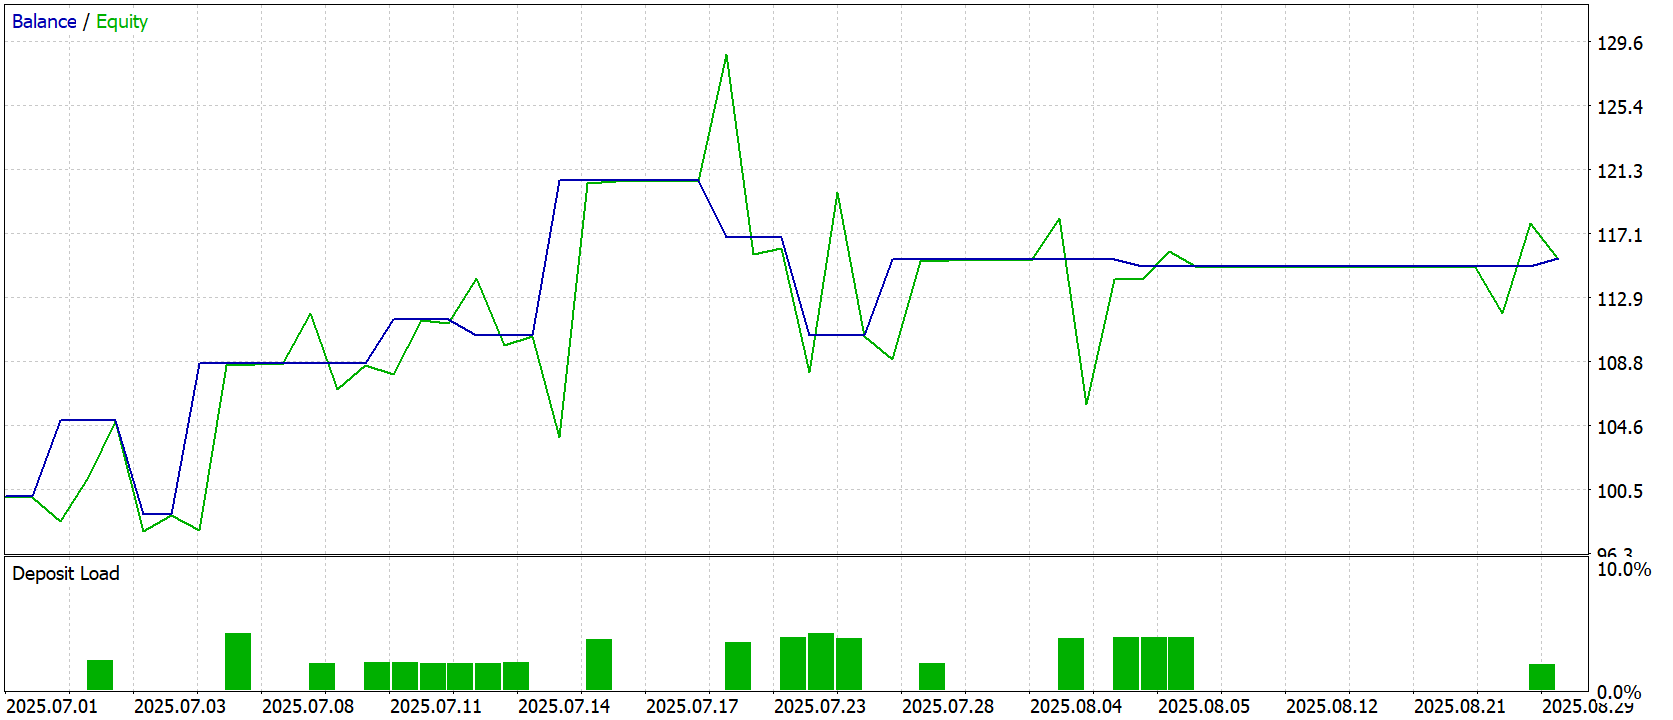
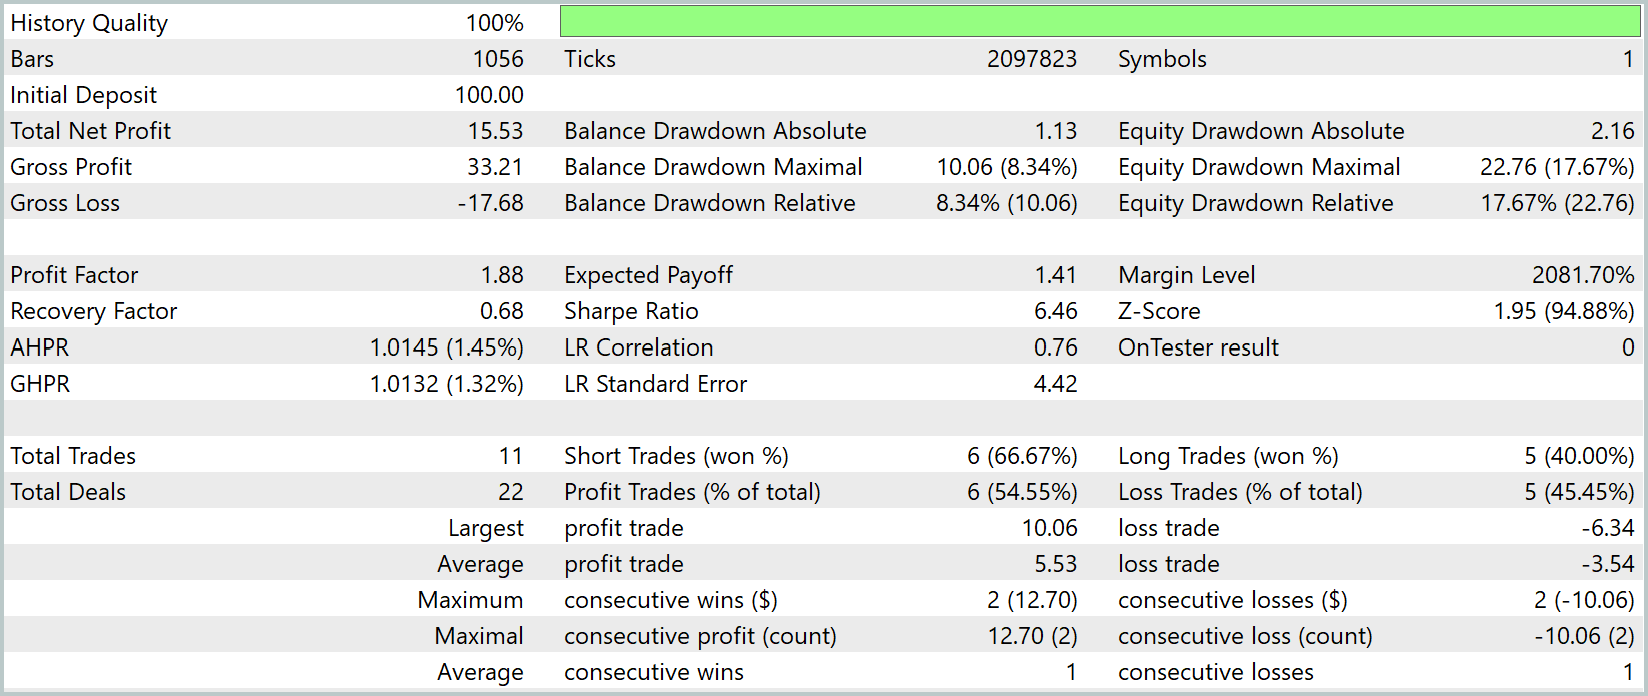
Los resultados de las pruebas demuestran la eficacia del modelo con datos que no se habían utilizado anteriormente. El gráfico del saldo y el patrimonio muestra un aumento gradual y controlado del capital. Al mismo tiempo, el saldo muestra una trayectoria relativamente estable, mientras que el patrimonio refleja las fluctuaciones a corto plazo propias de un entorno de mercado real. Se observan picos y correcciones aislados, lo que pone de manifiesto la capacidad del modelo para adaptarse a acontecimientos inesperados del mercado, manteniendo al mismo tiempo una tendencia general al alza.
Las cifras estadísticas respaldan la impresión visual. La ganancia total ascendió a 15,53 USD con un depósito inicial de 100 USD, lo que supone una rentabilidad moderada con un riesgo controlado. El drawdown máximo del patrimonio alcanzó el 22,76 %, lo cual es relativamente significativo, pero se encuentra dentro de los límites de riesgo admisibles para una estrategia de prueba. El factor de beneficio (Profit Factor) es de 1,88, lo que confirma que las operaciones rentables superan a las deficitarias.
El modelo realizó un total de 11 operaciones de trading (22 transacciones), de las cuales el 54,55 % resultaron rentables. La ganancia media por operación fue de 5,53 USD, mientras que la pérdida media fue de 3,54 USD, lo que demuestra una relación ganancia/riesgo razonable. La racha ganadora más larga fue de 2 operaciones con un resultado de 12,70 USD, mientras que la racha perdedora más larga fue de 2 operaciones con un resultado de -10,06 USD. Estos indicadores confirman que el modelo es capaz de mantener un equilibrio entre la agresividad y la estabilidad, sin exponer el capital a un riesgo excesivo.
En general, los resultados de las pruebas muestran que el modelo integra con éxito los enfoques de SpikingBrain, es capaz de procesar señales financieras dinámicas y tomar decisiones de forma controlada en condiciones de mercado reales, manteniendo la estabilidad y una rentabilidad controlada.
Conclusión
La evolución de las arquitecturas de redes neuronales hacia los modelos de impulsos abre nuevos horizontes para el trading. Si bien los transformadores han demostrado su eficacia en el análisis de grandes conjuntos de datos de mercado y en la generación de señales estables, las neuronas de impulsos nos acercan a sistemas biológicamente más plausibles y más eficientes desde el punto de vista energético. Su capacidad para trabajar con patrones temporales y flujos de información con ruido las convierte en una opción prometedora para el trading de alta frecuencia y las estrategias adaptativas.
Sin embargo, el principal reto sigue siendo el mismo: la integración de estos modelos en sistemas de negociación reales exige realizar pruebas rigurosas, tener en cuenta los riesgos y comprender las limitaciones de cada arquitectura.
Enlaces
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | Study.mq5 | Asesor experto | Asesor experto para el entrenamiento offline de modelos |
| 2 | StudyOnline.mq5 | Asesor experto | Asesor experto para el entrenamiento online de modelos |
| 3 | Test.mq5 | Asesor experto | Asesor experto para probar el modelo |
| 4 | Trajectory.mqh | Biblioteca de clases | Estructura para describir el estado del sistema y la arquitectura de los modelos |
| 5 | NeuroNet.mqh | Biblioteca de clases | Biblioteca de clases para crear una red neuronal |
| 6 | NeuroNet.cl | Biblioteca | Biblioteca de código del programa OpenCL |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19802
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.