Redes neuronales en el trading: Un enfoque semántico de impulsos para la identificación espaciotemporal (S3CE-Net)
 27
 0

Introducción
En el mundo financiero actual, el mercado hace tiempo que dejó de ser un lugar donde solo se negocian activos. Aquí se comercia con información, tiempo y atención. La rapidez de reacción se está convirtiendo en la nueva moneda, y la capacidad de extraer patrones de un flujo continuo de datos, en la principal ventaja. Cada segundo, millones de cotizaciones, órdenes y noticias conforman un océano agitado de eventos, en el que el azar y la regularidad se entrelazan tan estrechamente que, a veces, los límites entre ambos se difuminan. Este flujo no tiene límites claros: no es ni discreto ni sincrónico, por lo que requiere modelos capaces de percibir no solo la secuencia, sino también la estructura de los cambios, las relaciones y las tensiones que se dan dentro de los datos.
Los métodos tradicionales de análisis de series temporales financieras —ya sean modelos estadísticos clásicos, redes recurrentes o incluso transformadores pesados— se enfrentan a una serie de limitaciones. Con frecuencia son demasiado lentos, presentan sobreajuste o pierden el contexto al intentar captar únicamente las relaciones superficiales. Les resulta especialmente difícil trabajar con datos dispersos y asíncronos: los eventos importantes ocurren con poca frecuencia, pero son precisamente ellos los que determinan la dinámica del mercado. En estos casos, cada tick, cada repunte de volumen y cada desequilibrio anómalo entre la oferta y la demanda equivalen a eventos: impulsos poco frecuentes, pero de gran importancia, de los que depende la estructura del movimiento posterior del precio.
Se puede comparar el mercado con un gigantesco flujo neuromórfico. Vive a través de ráfagas de actividad y breves reacciones ante estímulos externos y fluctuaciones internas. Al igual que el sistema nervioso, reacciona ante los estímulos transmitiendo señales a través de una compleja red de conexiones. Y si lo consideramos precisamente como un sistema de eventos, resulta evidente que los enfoques clásicos, basados en muestreos temporales uniformes, no reflejan la verdadera naturaleza de lo que está ocurriendo. Precisamente por eso, en los últimos años los investigadores han recurrido a arquitecturas inspiradas en las redes neuronales de impulsos y en el enfoque neuromórfico del análisis de datos.
En este contexto surge el framework S3CE-Net (Spike-guided Spatiotemporal Semantic Coupling and Expansion Network), una arquitectura propuesta en el trabajo «S3CE-Net: Spike-guided Spatiotemporal Semantic Coupling and Expansion Network for Long Sequence Event Re-Identification». Este modelo se propuso para resolver el problema de la reidentificación de eventos en secuencias largas (long-sequence event re-identification) en flujos de datos obtenidos de sensores neuromórficos. Estos sensores solo registran cambios: destellos de luminosidad, señales asíncronas que se producen cuando realmente ocurre algo. El modelo S3CE-Net se basa en la intersección de las dependencias espaciales y temporales, lo que permite potenciar las señales informativas y suprimir el ruido, al tiempo que mantiene una alta eficiencia computacional.
La idea clave consiste no solo en analizar los eventos a lo largo del tiempo, sino también en captar las interrelaciones entre los canales espaciales; es decir, en términos figurados, entre las distintas zonas del campo de visión. En el ámbito financiero, esto puede interpretarse como las relaciones entre distintos activos, niveles de liquidez o componentes de la estructura del mercado. Cuando un sector del mercado comienza a moverse y otro se queda atrás o se adelanta, se crea una correlación espacio-temporal, una especie de resonancia. Es precisamente este tipo de resonancias lo que intenta captar el mecanismo de atención dentro de S3CE-Net: el Spike-guided Spatiotemporal Attention Mechanism (SSAM). Este mecanismo evalúa la importancia del evento actual y lo pondera considerando el contexto histórico, sin utilizar información futura, lo cual es fundamental para cualquier modelo de predicción.
Otra innovación del framework es la estrategia de muestreo de características espaciotemporales (STFS). Permite que, durante el proceso de aprendizaje, el modelo trabaje con subconjuntos de características espaciotemporales, evitando el sobreajuste en fragmentos fijos. En pocas palabras, enseña al modelo a detectar patrones generales, en lugar de memorizar combinaciones concretas de señales. En el contexto financiero, esta estrategia resulta especialmente relevante: el mercado no admite patrones fijos, cambia constantemente y cualquier memorización conduce a un deterioro de los resultados. La STFS aporta flexibilidad: obliga al modelo a adaptarse y a desarrollar su capacidad de percibir la dinámica, en lugar de la estática.
Si intentamos trasladar mentalmente la arquitectura de S3CE-Net al mundo del trading, su analogía podría ser un sistema que escucha el mercado de la misma forma que el nervio auditivo percibe el sonido: no registrando cada nota, sino destacando las transiciones, los contrastes, la intensidad y el ritmo. Un modelo de este tipo podría detectar microeventos: impulsos de volumen, aparición de órdenes de gran volumen y breves picos de volatilidad. Al mismo tiempo, no se limitaría a registrar la ocurrencia del evento, sino que comprendería su significado en el contexto de otros activos y de los repuntes anteriores, como un director de orquesta que no oye un violín aislado, sino toda la partitura.
Los mercados financieros llevan mucho tiempo necesitando este tipo de enfoques. El paso de los modelos estáticos a sistemas capaces de analizar de forma significativa secuencias de eventos no es solo una evolución, sino una necesidad. Cuanto más rápido se mueve el mercado, mayor es la importancia de la reacción y más relevante resulta la capacidad del modelo para extraer significado de datos dispersos. S3CE-Net destaca por combinar la ligereza de las redes neuronales de impulsos con la expresividad de los mecanismos de atención, sin sacrificar por ello la velocidad ni la eficiencia energética. Son precisamente estas cualidades las que la hacen conceptualmente adecuada para las necesidades de los modelos financieros, especialmente los que funcionan en tiempo real o con intervalos de tiempo cortos.
Además, la propia filosofía de S3CE-Net —potenciar lo esencial y descartar lo superfluo— está en sintonía con los objetivos del trading. El mercado está lleno de señales falsas, ruido y coincidencias fortuitas. Y el verdadero arte del análisis consiste en saber ver lo esencial.
Algoritmo S3CE-Net
El framework S3CE-Net se articula en torno a una idea central: relacionar la dinámica de los impulsos con las regularidades espaciotemporales del flujo de datos, creando así un modelo capaz de registrar la ocurrencia de eventos y establecer conexiones significativas entre ellos. Si una red neuronal clásica se asemeja a una cámara fotográfica que toma imágenes uniformes a una frecuencia constante, S3CE-Net se parece más a un sistema auditivo: solo oye lo que realmente ha ocurrido y reacciona ante los cambios, las transiciones y los contrastes. Ahí radica el poder fundamental de los modelos de impulsos: funcionan a nivel de picos, es decir, de eventos individuales que, en conjunto, conforman un panorama completo.
A la entrada de S3CE-Net se envía una secuencia de tensores de eventos formados a partir de un flujo asíncrono. Cada impulso individual registrado por el sensor se describe mediante las coordenadas (x, y), la marca temporal t y la polaridad p, que indica la dirección del cambio: aumento o disminución de la luminosidad. Como resultado, el flujo de eventos puede considerarse como un conjunto de datos de cuatro dimensiones: el tiempo, dos dimensiones espaciales y la polaridad. Para dar a este flujo una forma regular, los eventos asíncronos se agrupan en una secuencia de ventanas temporales fijas —una especie de minicortes del mundo—, donde cada corte contiene dos canales: uno para los cambios positivos y otro para los negativos. El conjunto de estos tensores forma una estructura Xₑ ∈ RT×2×W×H, donde T es el número de pasos temporales y W×H es la resolución espacial de la escena.
Este enfoque resuelve dos problemas a la vez. En primer lugar, transforma el flujo irregular de impulsos en un formato adecuado para el procesamiento convolucional; es decir, permite aplicar métodos de extracción de características que han demostrado su eficacia a lo largo del tiempo. En segundo lugar, conserva la propia naturaleza de los datos de eventos: su carácter disperso, su asincronía y su direccionalidad. Mientras que un vídeo normal lo capta todo, aquí la red solo recibe latidos, puntos de energía que señalan cambios. En el contexto financiero, el equivalente no sería cada valor del precio, sino solo sus movimientos bruscos, los impulsos de volumen y los repuntes de liquidez: precisamente esos instantes en los que el mercado se despierta.
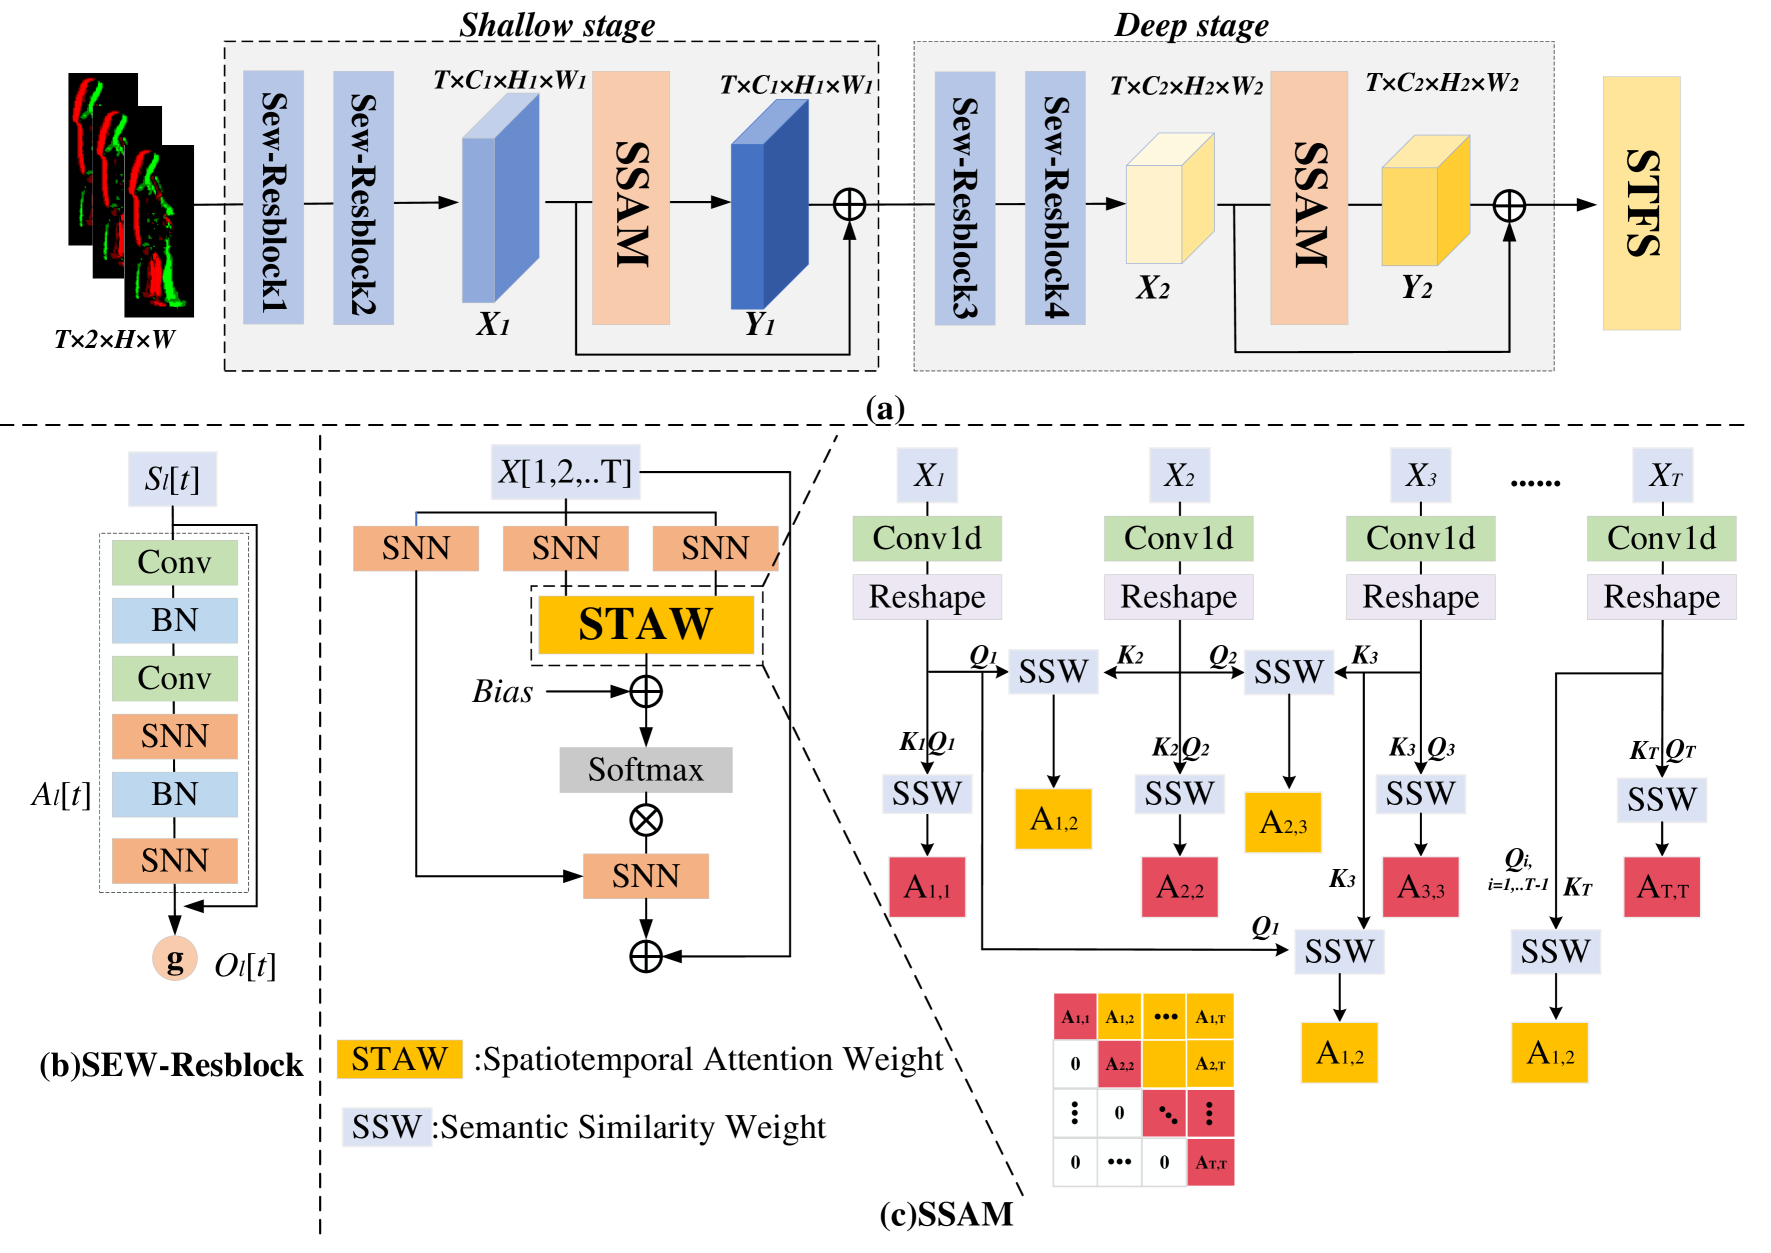
El esqueleto interno del modelo es SEW-ResNet, un framework residual de impulsos ligero y resistente al desvanecimiento del gradiente. Su núcleo es el Spike-Element-Wise Residual Block. En esencia, se trata de un bloque básico de la red que combina dos ideas: el procesamiento energéticamente eficiente de eventos y la propagación estable de la señal a través de las capas de la arquitectura. Cada bloque recibe un flujo de impulsos, acumula su potencial a nivel de las neuronas y transmite el impulso transformado hacia adelante, sumándolo a la señal original según el principio del aprendizaje residual.
La ResNet clásica resolvía el problema del desvanecimiento del gradiente en las redes convolucionales profundas. En el ámbito de las redes de impulsos, el objetivo es el mismo, pero con señales basadas en eventos y umbrales. SEW-ResNet resuelve esto de forma elegante, implementando una conexión residual mediante operaciones elemento a elemento, lo que permite transmitir la información sin distorsiones, conservando la forma del impulso y la estabilidad del potencial.
Esta arquitectura actúa como un extractor fundamental de características espaciotemporales. En los primeros niveles, registra las estructuras locales: formas, contornos y cambios de luminosidad (o, por analogía con el mercado, micropatrones en el flujo de operaciones y cotizaciones). En las capas más profundas, las agrupa en composiciones temporales y espaciales: identifica configuraciones estables de actividad y patrones en la distribución de los impulsos. En otras palabras, SEW-ResNet transforma una secuencia de eventos sin procesar y caótica en una jerarquía de características, en la que cada nivel sucesivo depende cada vez menos de coordenadas concretas y refleja cada vez más la estructura semántica de lo que está ocurriendo.
Esta representación multinivel desempeña un papel decisivo. Esta representación crea una base sobre la que se pueden construir mecanismos de orden superior: de interacción semántica y de atención contextual. Y es que, para que un modelo pueda dar sentido a los eventos, es necesario que primero aprenda a percibir las formas y los ritmos de dichos eventos. SEW-ResNet ofrece precisamente eso: una base limpia, pero expresiva, en la que los impulsos se transforman en imágenes de actividad.
Sin embargo, a pesar de la eficiencia energética y la capacidad innata de las SNN para procesar datos en flujo, la estructura de SEW-ResNet por sí sola no resuelve el problema clave: la fragmentación y el carácter discreto de la semántica de los eventos. Los flujos de eventos, ya sean señales de una cámara neuromórfica o ticks de precios del mercado, presentan un alto grado de fragmentación. Cada evento contiene información local, pero no guarda relación con el contexto. Como resultado, el modelo puede detectar destellos aislados de actividad, pero no comprender su significado en el tiempo y el espacio.
Es precisamente en esta etapa cuando surge la necesidad de un mecanismo capaz de enlazar los distintos impulsos en una secuencia dinámica coherente. Aquí entra en juego el Spike-guided Spatiotemporal Attention Mechanism (SSAM), una especie de puente entre fragmentos aislados de la percepción. Este módulo añade un elemento de atención al modelo, creando vínculos asociativos entre los eventos en el espacio y el tiempo. En esencia, SSAM transforma SEW-ResNet de un simple intérprete rápido de eventos en un sistema capaz de comprender —es decir, de identificar patrones significativos y dependencias contextuales en el flujo de datos—.
La idea se basa en la comprensión de que el mundo real nunca se encuentra en un estado estático. Los eventos están indisolublemente entrelazados, formando un tejido continuo del tiempo. Sin embargo, la mayoría de los modelos, incluso los bastante complejos, tratan los datos como instantáneas aisladas, desprovistas de contexto. SSAM, por su parte, pretende colmar esta brecha, proporcionando una conexión semántica entre los distintos momentos y transformando la percepción discreta en una comprensión continua.
La principal dificultad a la hora de procesar datos de eventos es su carácter fragmentario. Cada evento, ya sea un fotón registrado por un sensor o un tick de precio que refleja una variación en la cotización, existe solo un instante y no lleva consigo el pasado. Sin contexto, una señal así es prácticamente inútil. Precisamente por eso, en los sistemas clásicos se utilizan mecanismos de almacenamiento en búfer, promediado o agregación por convolución. Pero todos ellos, en esencia, difuminan la realidad, privando al modelo de sutileza perceptiva. SSAM aborda este problema de otra manera: no suaviza el flujo, sino que vincula los eventos por su significado, creando conexiones asociativas entre los estados temporales.
Estas conexiones se establecen mediante Spike-Guided Spatiotemporal Attention, un mecanismo de atención espaciotemporal guiado por los propios impulsos. A diferencia de los modelos clásicos de atención, en los que cada estado puede interactuar con todos los demás, en el SSAM se aplica un estricto principio de causalidad: un evento del momento actual solo puede basarse en eventos que ya han ocurrido, sin anticiparse al futuro. Este principio acerca la arquitectura a la realidad de los sistemas vivos, en los que la percepción siempre va un instante por detrás y la decisión se toma basándose en la experiencia acumulada, y no en el conocimiento del futuro.
Si lo traducimos al lenguaje de los mercados financieros, SSAM actúa como un analista que ve el movimiento de los precios como una secuencia de impulsos interrelacionados. Cada nuevo tick no es para él solo un número, sino la continuación de una historia cuyo contexto ya recuerda e interpreta. No conoce los precios futuros, pero es capaz de intuir la dirección probable, porque en su interior ya se han establecido vínculos asociativos entre el movimiento pasado y el actual. Lo mismo ocurre con el SSAM: cada estado actual se forma como resultado de la integración de todos los estados anteriores, y no como una simple reacción a los datos de entrada actuales.
Técnicamente, el mecanismo pone en práctica este concepto a través del trío formado por Q, K y V —consultas, claves y valores— generados por capas SNN independientes. Estos parámetros actúan como una especie de coordenadas de la atención, gracias a las cuales el modelo calcula qué fragmentos del pasado son más relevantes para el momento actual. Para cada paso temporal se genera una matriz de atención propia At',t, en la que las conexiones entre el tiempo actual t y todos los estados anteriores t'≤t se calculan mediante un mecanismo de impulsos, utilizando una operación de producto suavizado con normalización.
Un detalle fundamental es el sesgo de posición relativa entrenable B, que refleja las dependencias espaciales entre los elementos dentro de cada fotograma. En las redes clásicas, esta información suele perderse durante las convoluciones, pero en SSAM se conserva y se desarrolla, lo que permite tener en cuenta no solo las relaciones temporales, sino también la topología espacial de los datos. En el caso de las series temporales financieras, esto puede entenderse como la capacidad del modelo para detectar correlaciones no solo entre momentos concretos, sino también entre diferentes segmentos del mercado: zonas de liquidez, agrupaciones de volumen y estructura de las órdenes.
Desde el punto de vista matemático, la atención en SSAM se implementa mediante una matriz de pesos triangular superior:
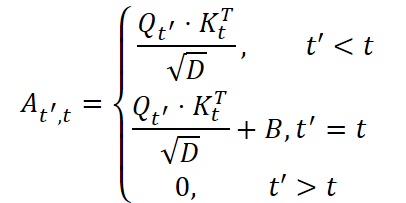
Esta estructura, sencilla pero de importancia fundamental, transforma el flujo de impulsos en un grafo de dependencias temporales organizado de forma causal. Cada nuevo evento actualiza el estado interno del modelo, añadiéndole el contexto semántico del pasado. De este modo, la red, por así decirlo, reflexiona sobre su propia experiencia, creando una especie de huella cognitiva.
La representación resultante Ot, tras su normalización, se transmite a la siguiente etapa de procesamiento, donde se integra en la salida final Ys = [O1; O2; …; OT]. En este conjunto, cada elemento no solo contiene información local, sino también la huella de toda la historia previa, como un operador que, al observar la última vela, percibe toda la tendencia anterior.
De este modo, SSAM se convierte para S3CE-Net en lo que la experiencia es para un analista: la capacidad de ver conexiones que no se aprecian al observar un instante aislado. Ofrece al modelo una respiración semántica fluida, creando una coherencia perceptiva estable entre sus capas. Gracias a ello, el modelo comprende y capta el significado de las estructuras temporales.
Si SSAM se puede comparar con una mirada atenta, capaz de distinguir el significado a lo largo del tiempo, la estrategia de muestreo de características espaciotemporales (STFS) es más bien la capacidad de observar una situación desde distintas perspectivas sin perder la visión global. Este mecanismo enseña al modelo a percibir no solo los detalles, sino también el contexto: aquello que se encuentra más allá de la percepción local. En esencia, STFS es un metanivel de percepción que contrarresta uno de los principales problemas de las redes neuronales profundas: la tendencia a quedarse estancadas en la semántica local, perdiendo así la visión de la estructura amplia y global.
Esta visión de túnel no es exclusiva de los sistemas artificiales. Esto también se puede observar en los mercados financieros, donde un operador, al centrarse en los movimientos a corto plazo de los precios, pierde la perspectiva de la tendencia a largo plazo. El mecanismo STFS pretende eliminar precisamente este efecto. Enseña al modelo a percibir datos simultáneamente en varias escalas (local, sublocal y global), creando una percepción estable y multicapa de la dinámica.
Desde el punto de vista técnico, STFS se basa en la idea de dividir el campo de características espaciotemporal en subconjuntos: subsecuencias temporales y subregiones espaciales. Esta división no se realiza para simplificar los datos, sino para incitar al modelo a generalizar. La red, al enfrentarse en cada iteración a diferentes combinaciones de fragmentos, se ve obligada a buscar el sentido no en una estructura concreta del mapa de características, sino en aquellos invariantes que se mantienen independientemente de cómo se realice la división. Se trata precisamente de una capacidad de percepción generalizada desarrollada artificialmente.
Formalmente, la estrategia opera con un mapa profundo de características Y2, en el que se llevan a cabo sucesivamente tres procedimientos interrelacionados:
- selección de subsecuencias temporales,
- selección de subregiones en el espacio,
- creación de un descriptor semántico global.
En el primer nivel, la STFS selecciona aleatoriamente un subconjunto de pasos temporales Trandom ⊂ {1, 2, …, T}, formando así una especie de extracto del flujo general de eventos. Para cada instante seleccionado se calcula un mapa de características espacial promediado, que se transforma en un vector compacto Vti = Avg2d(Y2[ti,:,:,:]). El conjunto de estos vectores Ytemporal = {Vti | ti ∈ Trandom} refleja la esencia de las subsecuencias temporales: no almacena todo el flujo, sino sus puntos de referencia significativos.
Este procedimiento crea una experiencia única para el modelo. La red aprende a no basarse en la continuidad de los datos, sino a comprender su esencia incluso a partir de fragmentos seleccionados. Es algo parecido a la capacidad que tiene un operador experimentado de intuir la tendencia del mercado con solo echar un vistazo a unas pocas velas características: sin conocer todo el recorrido, pero percibiendo su estructura.
En el segundo nivel, la STFS divide el mapa de características Y2 en cuatro áreas espaciales: superior izquierda, superior derecha, inferior izquierda e inferior derecha. Para cada una de ellas se calcula la media (Avg2d), con el fin de destacar las características más estables de la región correspondiente. Este enfoque puede interpretarse como la formación de imágenes perceptivas locales, donde cada parte de la escena (o de la estructura del mercado) se analiza por separado y luego se integra en un sistema de coordenadas unificado.
La selección aleatoria de los límites de las subregiones (Wrandom, Hrandom) añade un elemento de aleatoriedad, lo cual resulta especialmente valioso en las tareas de aprendizaje. El modelo deja de depender de la posición fija de los objetos y aprende a reconocer el significado en cualquier configuración. En el contexto financiero, es similar a cómo un analista realiza un seguimiento del comportamiento de distintos segmentos del mercado sin perder de vista su interrelación.
En el tercer nivel, que es el más importante, la STFS reconstruye la representación espaciotemporal Y2 y extrae de ella un descriptor global Yglobal = Avg2d(Y2[:,:,:,:]). Se trata de una forma condensada de toda la información acumulada, una especie de núcleo intelectual de la experiencia del modelo. No transmite detalles, sino el significado: la esencia de la percepción, acumulada a partir de multitud de observaciones particulares.
Es precisamente en esta etapa cuando se desarrolla la capacidad definitiva del modelo para realizar juicios semánticos. En el análisis financiero, esto equivale al momento en el que múltiples señales locales, ruido y movimientos se combinan para formar una comprensión unificada del estado del mercado. El modelo ya no percibe impulsos de precios aislados, sino que capta el tono general del mercado, la dinámica melodía de los datos.
Para mejorar la estabilidad del aprendizaje, STFS utiliza una función de pérdida combinada: la pérdida de tripletas y la pérdida de entropía cruzada con suavizado de etiquetas, integradas en una fórmula final. La primera parte enseña al modelo a diferenciar entre estados semánticos cercanos y lejanos (de forma análoga al contraste perceptivo humano), mientras que la segunda estabiliza la confianza en la clasificación, evitando una certeza excesiva.
Durante las pruebas solo se usa el vector global Yglobal, lo que pone de relieve la idea de que basta con una percepción única y profundamente generalizada para clasificar o comparar con precisión un estado. En el ámbito de los modelos financieros, equivale a un indicador final: una cifra concisa, pero significativa, que resume todo el análisis multidimensional de los eventos previos.
STFS completa la arquitectura S3CE-Net, convirtiéndola en un sistema con conciencia multinivel. Si SEW-ResNet genera un flujo estable de información y SSAM dota a la red de atención y memoria, STFS le enseña a ver el todo en la parte y a sintetizar el significado a partir de fragmentos. Esa es precisamente la forma más elevada de percepción artificial: la comprensión de las regularidades en el tiempo y el espacio.
En lo que respecta a los mercados financieros, esto abre el camino a la creación de modelos de redes neuronales capaces de predecir las variaciones de precios y reconocer los significados ocultos del comportamiento del mercado: el cambio de fase de las tendencias, la aparición de sinergias entre activos y la formación de nuevos patrones de liquidez. S3CE-Net, con el módulo STFS, se convierte en este sentido en una herramienta de comprensión: un sistema capaz de ver la estructura allí donde otros solo ven un flujo de datos.
A continuación se muestra una representación propia del framework S3CE-Net.
Implementación en MQL5
Ahora que hemos analizado en detalle los aspectos teóricos del framework S3CE-Net, es hora de pasar a la parte práctica de nuestro trabajo y mostrar cómo se pueden poner en práctica estas ideas mediante MQL5. Cabe recordar que en trabajos anteriores ya nos habíamos familiarizado con la arquitectura SEW-ResNet, que aquí sirve de base sólida. Hemos implementado los enfoques propuestos, integrándolos con ResNeXt, lo que nos ha permitido crear una plataforma flexible capaz de procesar de forma robusta flujos temporales complejos.
Ahora podemos utilizar estos avances como base e incorporarles los módulos SSAM y STFS, para que el modelo no se limite a registrar los eventos, sino que aprenda a percibir sus interrelaciones en el tiempo y el espacio. En el contexto de los mercados financieros, esto se asemeja a la experiencia de un operador profesional: no basta con ver las velas o los ticks de precios por separado, sino que es importante percibir su ritmo, comprender cómo el pasado da forma al presente y cómo los eventos actuales influyen en la dinámica del mercado. Eso es precisamente lo que aportan los módulos SSAM y STFS, al transformar S3CE-Net de una simple herramienta de análisis en un sistema capaz de percibir el contexto y comprender con mayor profundidad la estructura de los datos.
Y comenzaremos nuestro trabajo con la construcción del módulo de atención espaciotemporal SSAM. Aquí llama inmediatamente la atención el parecido del algoritmo propuesto con la autoatención causal. Sin embargo, se ha complementado con elementos de la arquitectura de impulsos, lo que le confiere una dinámica única y la capacidad de tener en cuenta eventos discretos en el tiempo. Esta característica requiere introducir los cambios oportunos en los algoritmos que hemos desarrollado anteriormente para que la integración de SSAM se realice correctamente y el modelo pueda captar de forma eficaz tanto las dependencias espaciales como las temporales de los datos.
Para generar las entidades de consultas (Q), claves (K) y valores (V), utilizaremos los algoritmos existentes de capas convolucionales en combinación con activaciones de impulsos. Además, el propio algoritmo de atención se implementará en OpenCL, lo que permitirá paralelizar eficazmente los cálculos y acelerar considerablemente el procesamiento de las relaciones espaciotemporales. Este enfoque combina las ventajas de las redes de impulsos y del cálculo paralelo de alto rendimiento, garantizando al mismo tiempo la precisión y la velocidad de funcionamiento del módulo SSAM.
La implementación del módulo SSAM se basa en el núcleo del programa OpenCL denominado SpikeMHAttention, que permite paralelizar por completo los cálculos para todos los tokens espaciotemporales y todas las cabezas de atención. Los datos de entrada consisten en un tensor combinado QKV (consultas, claves y valores), así como un sesgo diagonal diag_bias, que garantiza el procesamiento correcto de los propios tokens al calcular los pesos de atención.
__kernel void SpikeMHAttention(__global const float *qkv,
                               __global const float *diag_bias,
                               __global float *scores,
                               __global float *out,
                               const int dimension,
                               const int mask_future
                              )
  {
//--- init
   const int q_id = get_global_id(0);
   const int k_id = get_local_id(1);
   const int h_id = get_global_id(2);
   const int total_q = get_global_size(0);
   const int total_heads = get_global_size(2);
//---
   __local float temp[LOCAL_ARRAY_SIZE];
Cada cálculo comienza con la determinación de los índices global y local para la cabeza de atención y el token actuales, tras lo cual se calculan los desplazamientos para acceder a los componentes Q, K y V correspondientes en la representación aplanada del tensor.
//--- Shifts
   const int shift_q = RCtoFlat(h_id, 0, total_heads, dimension, 3 * q_id);
   const int shift_k = RCtoFlat(h_id, 0, total_heads, dimension, 3 * k_id + 1);
   const int shift_v = RCtoFlat(h_id, 0, total_heads, dimension, 3 * k_id + 2);
   const int shift_s = RCtoFlat(h_id, k_id, total_heads, total_q, q_id);
   const int shift_out = RCtoFlat(h_id, 0, total_heads, dimension, q_id);
La parte principal del algoritmo consiste en calcular el producto escalar entre Q y K para generar la matriz de atención. En este caso, se respeta el principio causal: si el indicador mask_future está activado, la consulta actual no tendrá en cuenta las claves futuras, lo que se ajusta plenamente al concepto de SSAM y evita el uso de información futura.
//--- Score
   float score = 0;
   if(mask_future == 0 || q_id <= k_id)
     {
      for(int d = 0; d < dimension; d++)
        {
         float q = IsNaNOrInf(qkv[shift_q + d], 0);
         if(q == 0)
            continue;
         float k = IsNaNOrInf(qkv[shift_k + d], 0);
         if(k == 0)
            continue;
         score += q * k;
        }
     }
   else
      score = MIN_VALUE;
Aquí es importante señalar que trabajamos con una representación de impulsos de las claves y las consultas, en la que existe una alta probabilidad de obtener valores iguales a cero. Para reducir el número de operaciones innecesarias y aumentar la eficiencia, antes de realizar operaciones matemáticas comprobamos los valores obtenidos de los búferes globales. Y realizamos los cálculos únicamente para aquellos componentes que sean distintos de cero. Este enfoque permite optimizar considerablemente el funcionamiento del núcleo, manteniendo la corrección de los cálculos y la precisión en la distribución de la atención.
A continuación, si la consulta actual coincide con la clave (q_id == k_id, elemento diagonal), se añade a score el sesgo diagonal entrenable de diag_bias.
   if(q_id == k_id)
      score += IsNaNOrInf(diag_bias[q_id], 0);
Lugo se lleva a cabo la normalización de los coeficientes de atención mediante la llamada a la función LocalSoftMax.
//--- norm score
   score = LocalSoftMax(score, 1, temp);
   scores[shift_s] = score;
Cabe señalar que la normalización de los datos se lleva a cabo dentro de un grupo de trabajo que corresponde a una consulta Q concreta. Es decir, SoftMax no se aplica a toda la matriz de atención de una sola vez, sino de forma local a todas las claves K correspondientes a esa consulta y esa cabeza de atención. Esto garantiza que se mantenga una distribución correcta de la atención para cada consulta. De este modo, se garantiza un alto grado de paralelismo en los cálculos a nivel de OpenCL.
En la última etapa se forma el tensor de salida out. Cada vector de valores V se multiplica por el peso de atención correspondiente y se acumula mediante LocalSum.
//--- out
   for(int d = 0; d < dimension; d++)
     {
      float val = 0;
      if(score > 0)
        {
         float v = IsNaNOrInf(qkv[shift_v + d], 0);
         if(v != 0)
            val = v * score;
        }
      val = LocalSum(val, 1, temp);
      if(k == 0)
         out[shift_out + d] = val;
     }
  }
Esto permite obtener una representación ponderada precisa de cada token, al combinar la información de todas las posiciones temporales y espaciales relevantes.
El núcleo presentado implementa todo el mecanismo de atención espaciotemporal a bajo nivel con un alto rendimiento, aprovechando las capacidades de OpenCL para paralelizar los cálculos por tokens, cabezas de atención y coordenadas espaciotemporales. En términos financieros, esto se asemeja al trabajo de un analista experimentado que evalúa simultáneamente la interrelación entre múltiples características temporales y locales, asignando a cada una un peso de importancia en función del contexto y de la experiencia previa.
Para entrenar correctamente el modelo, es importante no solo realizar los cálculos de atención de la pasada hacia delante, sino también distribuir los errores de la pasada hacia atrás entre todos los participantes en el proceso, teniendo en cuenta su influencia en el resultado final. Esta funcionalidad se implementa mediante el núcleo SpikeMHAttentionGrad, que permite calcular los gradientes de Q, K, V y del sesgo diagonal diag_bias de forma simultánea y coordinada.
__kernel void SpikeMHAttentionGrad(__global const float *qkv,
                                   __global float *qkv_gr,
                                   __global const float *diag_bias,
                                   __global float *diag_bias_gr,
                                   __global const float *scores,
                                   __global const float *gradients,
                                   const int dimension,
                                   const int mask_future
                                  )
  {
//--- init
   const int global_id = get_global_id(0);
   const int local_id = get_local_id(1);
   const int h_id = get_global_id(2);
   const int total_global = get_global_size(0);
   const int total_local = get_local_size(1);
   const int total_heads = get_global_size(2);
//---
   __local float temp[LOCAL_ARRAY_SIZE];
El núcleo comienza su funcionamiento definiendo los índices globales y locales. Para almacenar las sumas intermedias y calcular correctamente el gradiente de la función SoftMax, se crea un array local que permite una interacción eficiente entre los hilos de un mismo grupo de trabajo.
En primer lugar, se calculan los gradientes para los valores de V, ya que influyen directamente en la representación de salida del módulo. En una pasada directa, cada valor de V influye en todos los elementos del tensor resultante a través del coeficiente de atención correspondiente. Esto significa que, al calcular el gradiente del error para un elemento concreto de V, multiplicamos el gradiente en el nivel del tensor de salida por el mismo coeficiente de atención, lo que refleja con exactitud en qué medida ese valor de V ha influido en el resultado final.
//--- Value Gradient global_id -> v_id, local_id -> q_id
     {
      //--- Shifts
      const int shift_v = RCtoFlat(h_id, 0, total_heads, dimension, 3 * global_id + 2);
      const int shift_s = RCtoFlat(h_id, glodal_id, total_heads, total_q, local_id);
      const int shift_out = RCtoFlat(h_id, 0, total_heads, dimension, local_id);
      for(int d = 0; d < dimension; d++)
        {
         float grad = 0;
         if(mask_future == 0 || local_id <= global_id)
           {
            float score = IsNaNOrInf(scores[shift_s], 0);
            if(score > 0)
               grad = IsNaNOrInf(score * gradients[shift_out + d], 0);
           }
         grad = LocalSum(grad, 1, temp);
         if(local_id == 0)
            qkv_gr[shift_v + d] = grad;
        }
     }
Al mismo tiempo, tenemos en cuenta la causalidad del algoritmo. El algoritmo permite determinar analíticamente sobre qué elementos de la secuencia resultante no se ha ejercido influencia y evitar de inmediato las operaciones matemáticas innecesarias y los costosos accesos a la memoria global.
A continuación, todos los gradientes parciales se acumulan mediante una suma local, y el valor resultante se almacena en el elemento correspondiente del búfer global qkv_gr. De este modo, cada componente de V recibe una señal de error correcta, proporcional a su contribución al resultado, lo que garantiza un entrenamiento preciso y coherente del modelo.
Después le toca el turno a las consultas Q. Para estas consultas, primero se calcula el gradiente de los coeficientes de atención como producto de los vectores correspondientes de valores V y los gradientes de salida; a continuación, se aplica la función local del gradiente de SoftMax, que ajusta la distribución de las señales de acuerdo con la normalización.
//--- Query Gradient global_id -> q_id, local_id -> k_id/v_id
     {
      //--- Shifts
      const int shift_q = RCtoFlat(h_id, 0, total_heads, dimension, 3 * global_id);
      const int shift_k = RCtoFlat(h_id, 0, total_heads, dimension, 3 * local_id + 1);
      const int shift_v = RCtoFlat(h_id, 0, total_heads, dimension, 3 * local_id + 2);
      const int shift_s = RCtoFlat(h_id, local_id, total_heads, total_q, global_id);
      const int shift_out = RCtoFlat(h_id, 0, total_heads, dimension, global_id);
      //--- 1. Score grad
      float grad_s = 0;
      if(mask_future == 0 || global_id <= local_id)
         for(int d = 0; d < dimension; d++)
           {
            float val = IsNaNOrInf(qkv[shift_v + d], 0);
            if(val == 0)
               continue;
            grad_s += IsNaNOrInf(qkv[shift_v + d] * out_gr[shift_out + d], 0);
           }
      //--- 2. SoftMax grad
      grad_s = LocalSoftMaxGrad(scores[shift_s], grad_s, 1, temp);
      if(global_id == local_id)
         diag_bias_gr[gloval_id] = grad_s;
Por último, el gradiente de Q se forma como una combinación del gradiente de score y las claves K, lo que permite que cada componente de la consulta obtenga una señal de error ponderada. Los elementos diagonales del sesgo diagonal reciben un gradiente independiente, teniendo en cuenta su función de reforzar la influencia del token sobre sí mismo.
      //--- 3. Query grad
      for(int d = 0; d < dimension; d++)
        {
         float grad = 0;
         if(mask_future == 0 || global_id <= local_id)
           {
            float key = IsNaNOrInf(qkv[shift_k + d], 0);
            if(key != 0)
               grad = key * grad_s;
           }
         grad = LocalSum(grad, 1, temp);
         if(local_id == 0)
            qkv_gr[shift_q + d] = grad;
        }
     }
Al mismo tiempo, respetamos estrictamente la causalidad, que es un principio clave de SSAM: el modelo no mira hacia el futuro, ya que la máscara correspondiente se aplica ya en la pasada directa. Esto requiere un enfoque cuidadoso durante la retropropagación del error: la derivada de SoftMax devuelve un gradiente distinto de cero incluso para valores nulos, lo que podría generar una señal de error para los elementos de los pasos temporales futuros. Al procesar secuencias temporales respetando la causalidad, no deben aparecer señales de este tipo, ya que, de lo contrario, se vulneraría el principio de causalidad. Para garantizar la corrección del aprendizaje y evitar cálculos innecesarios, antes de realizar las operaciones matemáticas comprobamos los valores de las claves y las consultas, y excluimos del cálculo todos los componentes futuros.
Además, tenemos en cuenta la naturaleza de impulsos de los datos analizados, una parte considerable de los cuales puede estar representada por valores nulos. Por eso, primero comprobamos los datos recibidos y, a continuación, las operaciones matemáticas solo se realizan con los elementos distintos de cero. Esto permite no solo reducir la carga computacional, sino también garantizar una distribución precisa de los gradientes únicamente entre los impulsos realmente existentes.
En la siguiente etapa se calculan los gradientes de las claves K. Para cada clave se acumula la contribución de todas las consultas Q, teniendo en cuenta su interacción con los valores V correspondientes a través de los coeficientes de atención.
//--- Key Gradient global_id -> k_id, local_id -> score_id/v_id/dimension
     {
      //--- Shifts
      const int shift_k = RCtoFlat(h_id, 0, total_heads, dimension, 3 * global_id + 1);
      const int shift_v = RCtoFlat(h_id, 0, total_heads, dimension, 3 * local_id + 2);
      const int shift_out = RCtoFlat(h_id, 0, total_heads, dimension, local_id);
      float grad = 0;
      for(int q_id = 0; q_id < total_q; q_id++)
        {
         //--- 1. Score grad local_id -> score_id/v_id
         float grad_s = 0;
         const int shift_s = RCtoFlat(h_id, local_id, total_heads, total_q, q_id);
         int shift_q = RCtoFlat(h_id, 0, total_heads, dimension, 3 * q_id);
         if(mask_future == 0 || q_id <= local_id)
            for(int d = 0; d < dimension; d++)
              {
               float val = IsNaNOrInf(qkv[shift_v + d], 0);
               if(val == 0)
                  continue;
               grad_s += IsNaNOrInf(val * out_gr[shift_q + d], 0);
              }
         //--- 2. SoftMax grad
         grad_s = LocalSoftMaxGrad(scores[shift_s], grad_s, 1, temp);
         BarrierLoc;
         if(global_id == local_id)
            temp[0] = grad_s;
         BarrierLoc;
         grad_s = temp[0];
         //--- 3. Key grad local_id -> dimension
         if(local_id < dimension)
           {
            float query = IsNaNOrInf(qkv[shift_q + local_id], 0);
            if(query != 0)
               grad += IsNaNOrInf(query * grad_s, 0);
           }
        }
      if(local_id < dimension)
         qkv_gr[shift_k + local_id] = IsNaNOrInf(grad, 0);
     }
  }
La máscara causal garantiza que los tokens futuros no influyan en el cálculo actual, y que los gradientes se acumulen y se registren en qkv_gr. Este enfoque permite distribuir correctamente los errores y, al mismo tiempo, actualizar todos los parámetros de SSAM, manteniendo la coherencia y la precisión del aprendizaje.
Como resultado, el núcleo SpikeMHAttentionGrad implementa íntegramente el mecanismo de retropropagación del error para SSAM, lo que garantiza una actualización coherente de Q, K, V y de los sesgos diagonales. En el contexto de los mercados financieros, esto puede entenderse como un proceso en el que cada error de previsión se distribuye de forma precisa entre todos los factores que influyen, lo que permite al sistema aprender gradualmente a evaluar correctamente las interrelaciones entre los eventos y a predecir la evolución del mercado con gran precisión.
Hoy hemos trabajado mucho y ha llegado el momento de tomarnos un pequeño descanso. Dejemos que la mente descanse para que la información recibida tenga tiempo de asimilarse y reflexionemos sobre ella. En el próximo artículo continuaremos con la implementación de los enfoques del framework S3CE-Net mediante MQL5. Nos acercaremos paso a paso a la integración completa de todos los módulos y a su puesta a punto en la práctica.
Conclusión
En este artículo hemos conocido el framework S3CE-Net y sus mecanismos clave: el mecanismo espaciotemporal SSAM y la estrategia de muestreo STFS. El modelo trabaja con eventos de impulsos y respeta estrictamente la causalidad, lo que le permite identificar con precisión los patrones importantes y tener en cuenta correctamente la dinámica de las series temporales, sin utilizar información futura.
S3CE-Net combina la ligereza de su arquitectura, un alto grado de paralelización y la capacidad de identificar relaciones temporales y espaciales complejas. Para los mercados financieros, esto supone reaccionar rápidamente ante las señales y tomar decisiones precisas en medio de un enorme flujo de datos ruidosos.
La implementación mediante las herramientas de MQL5 allanará el camino para probar el modelo en escenarios de negociación reales. S3CE-Net muestra cómo los métodos modernos para trabajar con eventos dispersos pueden convertirse en una potente herramienta para el análisis y la predicción del mercado. Apenas hemos empezado a explorar el potencial del framework, y en el próximo artículo continuaremos con su implementación práctica.
Enlaces
- S3CE-Net: Spike-guided Spatiotemporal Semantic Coupling and Expansion Network for Long Sequence Event Re-Identification
- Otros artículos de la serie
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | Study.mq5 | Asesor experto | Asesor experto para el entrenamiento offline de modelos |
| 2 | StudyOnline.mq5 | Asesor experto | Asesor experto para el entrenamiento de modelos en línea |
| 3 | Test.mq5 | Asesor experto | Asesor experto para probar el modelo |
| 4 | Trajectory.mqh | Biblioteca de clases | Estructura que describe el estado del sistema y la arquitectura de los modelos |
| 5 | NeuroNet.mqh | Biblioteca de clases | Biblioteca de clases para crear una red neuronal |
| 6 | NeuroNet.cl | Biblioteca | Biblioteca de código del programa OpenCL |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19928
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.