

Red neuronal en la práctica: Descenso de gradiente estocástico
 12
 0

Introducción
En el artículo anterior, Red neuronal en la práctica: Descenso de gradiente, mostré algo que quizá haya quedado un tanto confuso. Así que voy a comenzar exactamente desde ese punto. Es importante que tú, mi querido lector, no tengas dudas sobre lo que estoy explicando dentro de este tema. El detalle se muestra a continuación:
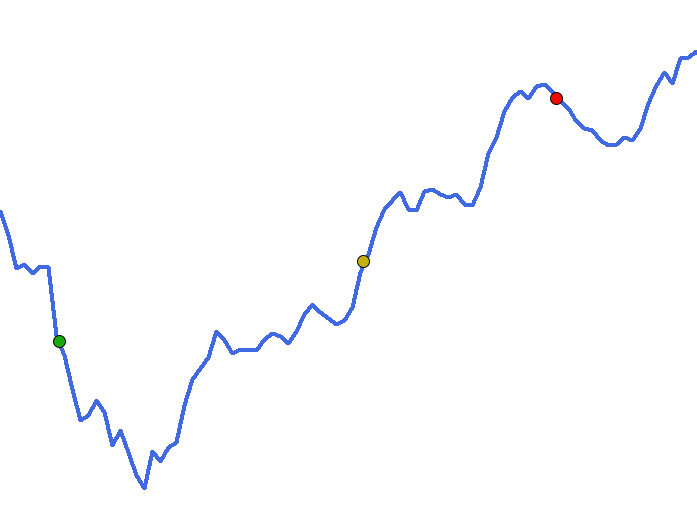
La cuestión es la siguiente: en el artículo anterior menciono que, en algún momento, puedes tener un conjunto de datos que podría representarse mediante la línea azul. Es decir, tenemos un polinomio bastante complejo. Este polinomio se proporciona a la red neuronal para que intente encontrar una ecuación capaz de representar los datos presentes en el conjunto. Hasta aquí, creo que no hay nada especialmente difícil de entender. Durante la explicación, menciono que los puntos que aparecen en la imagen representan la medida del error generado durante la inicialización de la red neuronal. Y esta es la parte que quizá haya quedado algo confusa. Me gustaría aclarar mejor esta cuestión.
El detalle es que, cuando representamos algo en un gráfico, como muchos habrán visto en las explicaciones sobre el error, el gráfico normalmente es una superficie. El problema es que, para dibujar un gráfico de superficie, necesitas dos variables: una para el eje X y otra para el eje Y. Los valores correspondientes a la combinación de estas variables se representan mediante el eje Z. Algo parecido a lo que se muestra en la siguiente animación.
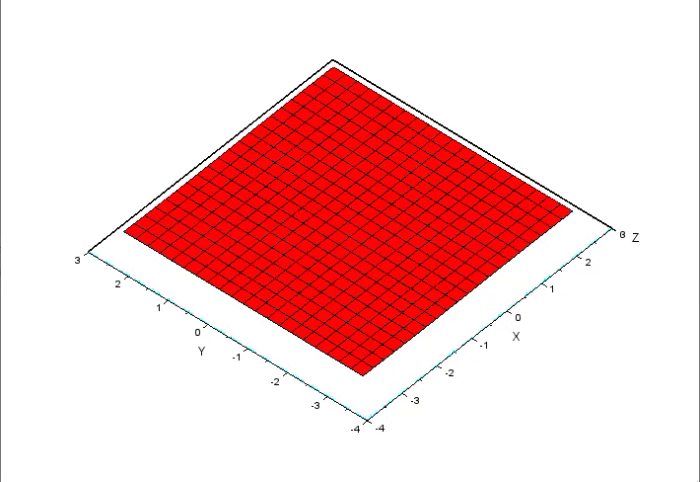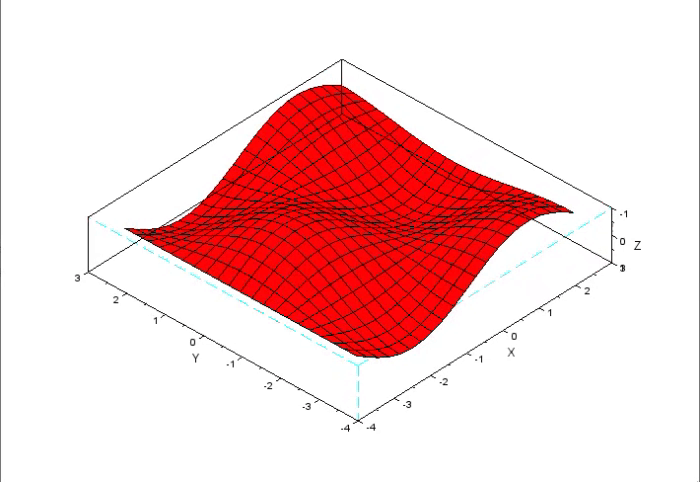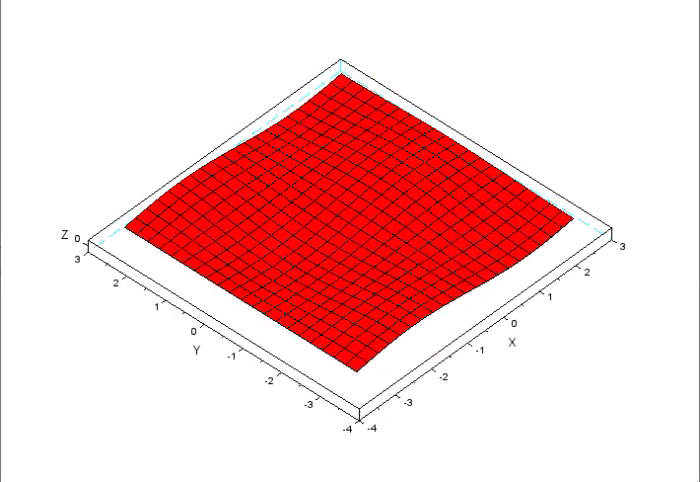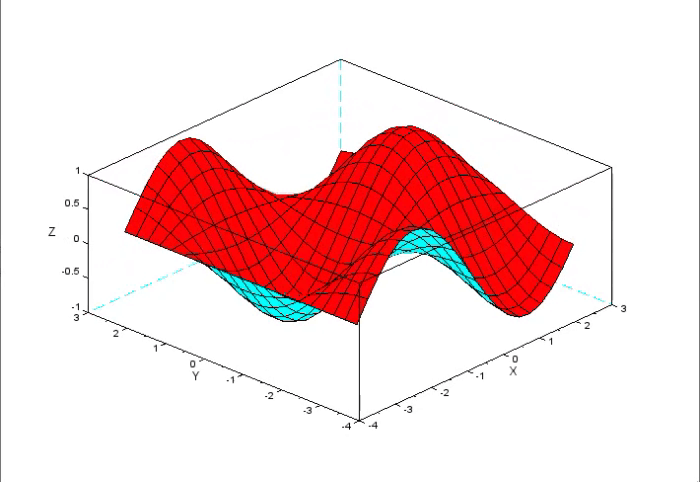
En esta animación podemos ver que, cuando cambian los valores del eje Z, cada valor del eje Z corresponde a una combinación de un valor del eje X y otro del eje Y. Sin embargo, la curva mostrada en la imagen del comienzo del artículo no puede representarse en un gráfico de superficie, ni siquiera es posible imaginar cómo sería dicho gráfico. Esto se debe a que, claramente, necesitaría muchas más de dos variables para poder dibujarse.
Por esta razón, quizá haya resultado algo confuso entender la cuestión del error al observar la curva. Muchos podrían imaginar que el gráfico que representa un conjunto de datos contiene en su interior el punto en el que se encuentra el error mínimo. Esto no es cierto. Pido disculpas si eso fue lo que se dio a entender, porque en realidad no funciona así. Solo utilicé un gráfico 2D para representar la idea de valles y picos. Muchas veces, nuestra intención es intentar visualizar lo que sería un valle ideal. Sin embargo, dependiendo del punto desde el que iniciemos, es posible que nunca consigamos alcanzar el punto con el menor valor de error.
Sé que esto parece extremadamente complicado. Y, en realidad, es complicado de explicar, sobre todo porque desconozco hasta qué punto cada uno está familiarizado con las matemáticas utilizadas en una red neuronal. Estoy intentando hacer que el material sea lo más sencillo y didáctico posible. Sería mucho más fácil explicarlo de otra manera. No importa. Espero haber aclarado esta cuestión que, desde mi punto de vista, había quedado algo confusa y podía llevar a una interpretación equivocada del tema.
El código utilizado para crear la animación anterior se muestra a continuación. Se trata de código escrito para SCILAB, por si alguien siente curiosidad y quiere visualizar los datos con más calma.
 t=-%pi:0.3:%pi;
 plot3d(t,t,sin(t)'*cos(t),80,50,'X@Y@Z',[5,2,4]);
Si te interesa examinarlo con más detenimiento, puedes probar el código anterior para comprender mejor el concepto de valle y pico. Para mover el gráfico 3D, haz clic con el botón derecho, mantén pulsado el botón y arrastra el puntero del ratón. Muy bien, ahora que creo haber aclarado el punto que me preocupaba, podemos pasar a lo que veremos en este artículo.
Añadiendo el sesgo al descenso de gradiente
Como he seguido una determinada metodología desde el principio, pretendo mantenerla en todos los artículos sobre redes neuronales, aunque en ocasiones pueda parecer que estamos dando vueltas sobre lo mismo. Quiero recordarte, mi querido lector, que las redes neuronales no son un tema con un punto de partida y un objetivo final claramente definidos. Cuando se habla de redes neuronales, todo resulta bastante más peculiar. A veces piensas que estamos al principio cuando, en realidad, estamos al final. Otras veces piensas que estamos al final cuando, en realidad, estamos al principio. Es bastante extraño y algo confuso, especialmente para quienes prefieren comenzar y terminar cada tema en puntos perfectamente definidos. Estas personas terminan abandonando el estudio de este tema.
Que esto ocurra, es decir, que no tengamos un punto de inicio y un punto final, tiene una razón: las redes neuronales no tienen una única solución. Cada clase de problema implica, o puede implicar, una solución completamente distinta. Antes de entrar en estas cuestiones, veamos qué faltaba para completar la neurona artificial que vimos en el artículo anterior, la que utilizaba el descenso de gradiente. El código original, que se encuentra en el artículo anterior, se muestra íntegramente a continuación.
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. #define PrintEx(A) Print(#A, " => ", A)
05. #define macroRandom (rand() / (double)SHORT_MAX)
06. //+------------------------------------------------------------------+
07. double Train[][2] {
08.                     {0, 0},
09.                     {1, 3},
10.                     {2, 6},
11.                     {3, 9},
12.                     {4, 12},
13.                   };
14. //+------------------------------------------------------------------+
15. const uint nTrain = Train.Size() / 2;
16. const double epsilon = 1e-3;
17. //+------------------------------------------------------------------+
18. double Cost(const double w)
19. {
20.     double err, x, y;
21.
22.     err = 0;
23.     for (uint c = 0; c < nTrain; c++)
24.     {
25.         x = Train[c][0];
26.         y = Train[c][1];
27.         err += 2 *(x * w - y) * x;
28.     }
29.
30.     return err;
31. }
32. //+------------------------------------------------------------------+
33. void OnStart()
34. {
35.     double weight, err;
36.     ulong it0, it1, count;
37.
38.     Print("************************************");
39.     Print("Linear gradient neuron...");
40.     MathSrand(512);
41.     weight = (double)macroRandom;
42.
43.     it0 = GetTickCount();
44.     for(count = 0; (count < ULONG_MAX) && (MathAbs(err = Cost(weight)) > epsilon); count++)
45.         weight -= (err * epsilon);
46.     it1 = GetTickCount();
47.     Print("Time: ", (it1 - it0) / 1000.0, " seconds.");
48.     PrintEx(count);
49.     PrintEx(weight);
50.     PrintEx(err);
51. }
52. //+------------------------------------------------------------------+
Observa que, en la línea 18, donde definimos la función de costo, solo se nos proporciona el parámetro correspondiente al peso. Y, en la línea 27, donde se realiza el cálculo, no estamos utilizando el sesgo ni el término independiente. Quiero recordar nuevamente al lector que el descenso de gradiente no es más que una forma algo más interesante de expresar la regresión lineal. Nada más que eso. Para entenderlo mejor, consulta los artículos anteriores.
Aun así, tiene sus ventajas frente a la neurona de regresión lineal. Sin embargo, el simple hecho de añadir un parámetro para representar el sesgo en las líneas 18 y 27 no hace que el cálculo sea adecuado. Esto se debe a que la forma de calcular el error será ligeramente distinta de la utilizada para calcular el error del sesgo. Esto puede verse en las siguientes imágenes.


La primera imagen muestra el cálculo del error correspondiente al peso; la segunda muestra el cálculo del error correspondiente al sesgo. Observa que son ligeramente distintos porque uno utiliza un valor que no aparece en el otro. Pero aquí tenemos otro problema, relacionado con el código que debemos crear. Observa que la función devuelve un valor double, pero necesitamos devolver dos valores double: uno para el sesgo y otro para el peso. Bien, si ya sabes desenvolverte con la programación en MQL5, no verás esto como un problema. En realidad, existen varias formas de resolver este pequeño inconveniente. Algunas son más sencillas y otras algo más elaboradas. De cualquier modo, no me interesa cómo se resuelva el problema.
Lo que nos interesa son los resultados obtenidos. Probablemente notarás que, con el tiempo, cambiaré la forma de resolver esta cuestión. Pero quiero dejar claro, una vez más, que lo que nos interesa es el resultado y no la forma de obtenerlo. Así, una primera forma de resolver la cuestión puede verse en el siguiente código.
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. #define PrintEx(A) Print(#A, " => ", A)
05. #define macroRandom (rand() / (double)SHORT_MAX)
06. //+------------------------------------------------------------------+
07. double Train[][2] {
08.                     {0, 0},
09.                     {1, 3},
10.                     {2, 6},
11.                     {3, 9},
12.                     {4, 12},
13.                   };
14. //+------------------------------------------------------------------+
15. const uint nTrain = Train.Size() / 2;
16. const double epsilon = 1e-3;
17. //+------------------------------------------------------------------+
18. struct stErr
19. {
20.     double  Weight,
21.             Bias;
22. };
23. //+------------------------------------------------------------------+
24. stErr Cost(const double w, const double b)
25. {
26.     double x, y, t;
27.     stErr err;
28.
29.     ZeroMemory(err);
30.     for (uint c = 0; c < nTrain; c++)
31.     {
32.         x = Train[c][0];
33.         y = Train[c][1];
34.         t = 2 * ((x * w + b) - y);
35.         err.Weight += (t * x);
36.         err.Bias += t;
37.     }
38.
39.     return err;
40. }
41. //+------------------------------------------------------------------+
42. void OnStart()
43. {
44.     double weight, bias;
45.     ulong it0, it1, count;
46.     stErr err;
47.
48.     Print("************************************");
49.     Print("Gradient Descent Neuron...");
50.     MathSrand(512);
51.     weight = (double)macroRandom;
52.     bias = (double)macroRandom;
53.
54.     it0 = GetTickCount();
55.     for(count = 0; count < ULONG_MAX; count++)
56.     {
57.         err = Cost(weight, bias);
58.         if ((MathAbs(err.Weight) <= epsilon) && (MathAbs(err.Bias) <= epsilon))
59.             break;
60.         weight -= (err.Weight * epsilon);
61.         bias -= (err.Bias * epsilon);
62.     }
63.     it1 = GetTickCount();
64.     Print("Time: ", (it1 - it0) / 1000.0, " seconds.");
65.     PrintEx(count);
66.     PrintEx(weight);
67.     PrintEx(bias);
68.     PrintEx(err.Weight);
69.     PrintEx(err.Bias);
70. }
71. //+------------------------------------------------------------------+
Al observar este código, quizá estés pensando: Vaya, qué cosa tan complicada. ¿No habría una forma más sencilla de hacerlo? Como dije hace poco, no me interesa la forma de hacerlo. Lo que me interesa son los resultados. Tanto es así que, al ejecutarlo en el terminal de MetaTrader 5, verás el siguiente resultado:
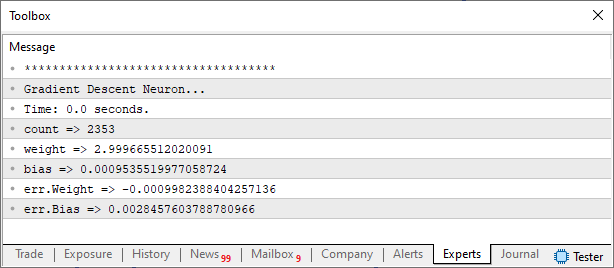
Bien, entonces voy a dar una breve explicación para quienes acaban de incorporarse. En la línea 18 declaro una estructura. La utilizaremos para devolver el costo calculado. Observa, en la línea 24, cómo queda ahora la declaración de la función de costo. A continuación, en la línea 27, declaramos una variable interna de la función. Esta se utilizará para almacenar los valores que se devolverán. Realizamos los cálculos en la línea 34. Sin embargo, ahí solo calculamos una parte. En la línea 35 ajustamos el cálculo para incluir la parte que faltaba en el error correspondiente al peso. Al final, obtenemos correctamente el cálculo del error tanto para el peso como para el sesgo, de acuerdo con la fórmula.
Todavía falta una pequeña cuestión: la función de activación. Hay casos en los que la función de activación no es realmente necesaria, mientras que en otros resulta fundamental. Ya vimos esto en el artículo donde mostré cómo entrenar una neurona para representar una puerta lógica. Aquí, sin embargo, como estamos utilizando valores descritos por una función que corresponde claramente a la siguiente ecuación:

La función de activación no es necesaria. Pronto entenderemos mejor esta cuestión de la función de activación. Lo único que necesitas entender en este momento, mi querido lector, es que no existe una fórmula única para crear una red neuronal. Cada caso es diferente. Y existen muchas situaciones en las que una red neuronal entorpece más de lo que ayuda. También veremos esto muy pronto. Vayamos con calma, no hay motivo para poner el carro delante de los bueyes. Una cosa a la vez.
Bien, volvamos a nuestra cuestión principal, que es la neurona que usa descenso de gradiente. Puedes compilarla y ejecutar el código en el terminal. Notarás que los resultados no cambiarán con respecto a lo visto en el artículo anterior. De hecho, uno de los códigos incluidos en el archivo adjunto de este artículo es precisamente el código de esta neurona que acabamos de ver. ¿Qué ocurre si cambiamos la ecuación de forma que obtengamos una ecuación ligeramente diferente? ¿Qué sucederá con la neurona, teniendo en cuenta que su código no incluye una función de activación? Quiero que tú, mi querido lector, hagas esta prueba. Y, para guiarte, vamos a experimentar con algunos valores para obtener la siguiente ecuación:

Para hacerlo, necesitamos modificar algunas partes del código.
. //+------------------------------------------------------------------+
07. double Train[][2] {
08.                     {0, -0.8},
09.                     {1, 0.85},
10.                     {2, 2.5},
11.                     {3, 4.15},
12.                     {4, 5.8},
13.                   };
14. //+------------------------------------------------------------------+
                                   .
                                   .
                                   .
41. //+------------------------------------------------------------------+
42. void OnStart()
43. {
                                   .
                                   .
                                   .
55.     for(count = 0; count < 10; count++)
56.     {
57.         err = Cost(weight, bias);
58.         if ((MathAbs(err.Weight) <= epsilon) && (MathAbs(err.Bias) <= epsilon))
59.             break;
60.         weight -= (err.Weight * epsilon);
61.         bias -= (err.Bias * epsilon);
62.         PrintFormat("%I64u > w0: %.4f %.4f || b: %.4f %.4f", count, weight, err.Weight, bias, err.Bias);
63.     }
Estos cambios pueden verse en el siguiente fragmento: Observa los puntos en los que cambió el código. El primero corresponde a los datos utilizados para el entrenamiento. El siguiente está en el código del procedimiento OnStart. Muy bien, antes de ver el resultado, quiero advertirte, mi querido lector y entusiasta, de que estamos utilizando una neurona que podría simplemente decir: NO VOY A PODER CONVERGIR.
Y, si esto ocurre, el bucle de la línea 55 puede hacer que el programa tarde bastante tiempo en finalizar. Como no tenemos la certeza de que vaya a converger, necesitamos limitar el bucle a un número reducido de iteraciones. En este caso, estoy estableciendo diez iteraciones. En cada una de ellas imprimiremos lo que está haciendo la neurona. De ello se encarga la línea 62. Así podremos ver si la neurona está consiguiendo converger o no. Muy bien, teniendo en cuenta esta advertencia, podemos compilar y ejecutar el código modificado.
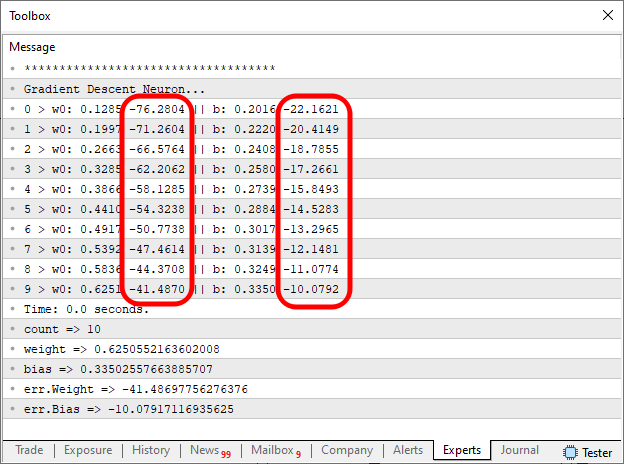
Como resultado, verás la siguiente imagen en el terminal de MetaTrader 5. Lo que nos interesa son precisamente las regiones marcadas en la imagen. Queremos que sus valores intenten aproximarse a cero. En realidad, nunca llegarán exactamente a cero. Esto se debe a que la línea 58 hará que el bucle de iteración termine en cuanto el valor del error quede por debajo del umbral definido previamente. Esta condición deberá cumplirse al mismo tiempo tanto para el error del peso como para el error del sesgo. De lo contrario, el bucle seguirá realizando iteraciones hasta alcanzar el límite de iteraciones establecido.
Muy bien, ya sabemos que la neurona está consiguiendo converger. Así que vamos a dejar que siga intentándolo hasta alcanzar el límite definido en la línea 58 o hasta llegar al número máximo de iteraciones. Para ello, cambiamos el valor de la línea 55, que está definido como diez, y lo sustituimos por ULONG_MAX. O por cualquier otro valor que prefieras. Como resultado, obtenemos lo que se muestra en la siguiente imagen:
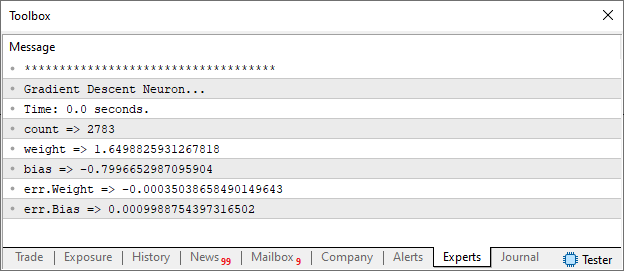
Observa que el resultado obtenido es muy cercano al que esperábamos. Y ni siquiera fue necesario incluir una función de activación para que la neurona consiguiera converger. Bien, ¿y si la neurona no consiguiera converger hacia un resultado que permitiera representar mediante una ecuación los datos utilizados en el entrenamiento? ¿Cómo deberíamos proceder? Cada caso es diferente. No existe una regla que debas seguir. O, mejor dicho, no existe una fórmula única para lograr que el entrenamiento converja hacia una ecuación matemática que represente los datos. Intentar seguir una regla para entrenar una neurona o una red neuronal es un error. Porque TAL REGLA NO EXISTE.
Y este es precisamente uno de los errores que suelen cometer muchos de quienes comienzan a estudiar redes neuronales. Quieren, a toda costa, seguir reglas rígidas, cuando en realidad lo que debemos hacer es entender lo que estamos creando, y no intentar seguir una fórmula preestablecida ni utilizar algo ya hecho. Por eso estoy escribiendo estos artículos sobre el tema. Intento transmitirte parte de mi experiencia en este campo, mi querido lector. Quizá alguno que otro consiga asimilar una parte de lo que estoy mostrando.
Bien, antes de pasar al siguiente tema, quiero dar una breve pincelada sobre algo de lo que quizá llegues a oír hablar. Tal vez incluso ya lo hayas oído, pero probablemente no hayas entendido realmente de qué se trataba. Estoy hablando del llamado descenso de gradiente estocástico. Vaya, esto sí que es un palabrón. Hasta puede dar escalofríos de miedo con solo escuchar semejante término. Al menos, muchos quizá lo vean así. Pero, si este es tu caso, o si nunca habías oído hablar de ello, no tienes por qué alarmarte ni salir corriendo a averiguar de qué se trata. El descenso de gradiente estocástico no es más que una variante del descenso de gradiente. La diferencia es que esta variante busca precisamente hacer que el descenso de gradiente sea algo más rápido durante su ejecución.
Bien, ¿y cómo podemos conseguirlo? Quizá sea algo interesante de utilizar. En efecto, el descenso de gradiente estocástico es interesante y ayuda a acelerar el descenso de gradiente. Pero esto tiene un costo. No hay almuerzo gratis. Para hacer que el descenso de gradiente sea más rápido, el estocástico —lo llamaré así para no repetir constantemente el nombre completo— utiliza el siguiente truco. Veamos un fragmento del código que creamos para entenderlo. Se muestra a continuación.
06. //+------------------------------------------------------------------+
07. double Train[][2] {
08.                     {0, -0.8},
09.                     {1, 0.85},
10.                     {2, 2.5},
11.                     {3, 4.15},
12.                     {4, 5.8},
13.                   };
14. //+------------------------------------------------------------------+
15. const uint nTrain = Train.Size() / 2;
16. const double epsilon = 1e-3;
17. //+------------------------------------------------------------------+
18. struct stErr
19. {
20.     double  Weight,
21.             Bias;
22. };
23. //+------------------------------------------------------------------+
24. stErr Cost(const double w, const double b)
25. {
26.     double x, y, t;
27.     stErr err;
28.
29.     ZeroMemory(err);
30.     for (uint c = 0; c < nTrain; c++)
31.     {
32.         x = Train[c][0];
33.         y = Train[c][1];
34.         t = 2 * ((x * w + b) - y);
35.         err.Weight += (t * x);
36.         err.Bias += t;
37.     }
38.
39.     return err;
40. }
41. //+------------------------------------------------------------------+
Nuestro conjunto de entrenamiento es bastante pequeño, pero imagina que tuviera miles o millones, quizá incluso miles de millones de datos. Si utilizaras el fragmento anterior, entrenar una sola neurona podría tardar horas o incluso días. Y eso suponiendo que el conjunto de datos permitiera entrenar una única neurona. Si fuera necesario utilizar una red neuronal, el tiempo podría aumentar muy rápidamente. Muy bien, una vez entendido esto, veamos cómo resuelve el estocástico este problema de tiempo.
La magia ocurre cuando se ejecuta la línea 30. En el gradiente normal, se utiliza todo el conjunto de datos en cada llamada a la función de costo. Es decir, cada vez que se ejecuta la llamada de la línea 24, el bucle de la línea 30 recorre todo el conjunto de datos para entrenar la red o incluso una sola neurona. Sin embargo, durante las investigaciones se observó que esto supone una pérdida de tiempo. Podemos obtener el mismo resultado, o al menos uno bastante satisfactorio, haciendo un pequeño cambio en este esquema. En lugar de utilizar todo el conjunto de datos en cada iteración, o cada vez que se ejecuta la llamada de la línea 24, utilizaremos solo una parte. En este punto quizá estés pensando: Pero esto no parece muy inteligente, ya que el entrenamiento quedaría incompleto. Sin embargo, esta impresión se debe precisamente a que tú, mi querido lector, todavía no has comprendido del todo la idea que hay detrás de esta implementación. Veamos cómo quedaría el fragmento anterior si utilizáramos el estocástico. Se muestra a continuación.
23. //+------------------------------------------------------------------+
24. stErr Cost(const double w, const double b, const uint p1 = 0, const uint p2 = nTrain)
25. {
26.     double x, y, t;
27.     stErr err;
28.
29.     ZeroMemory(err);
30.     for (uint c = p1; c < p2; c++)
31.     {
32.         x = Train[c][0];
33.         y = Train[c][1];
34.         t = 2 * ((x * w + b) - y);
35.         err.Weight += (t * x);
36.         err.Bias += t;
37.     }
38.
39.     return err;
40. }
41. //+------------------------------------------------------------------+
Como solo necesitamos modificar la parte encargada del cálculo del costo, muestro únicamente el fragmento que realmente hace falta. Ahora quizá resulte más claro cómo funciona el estocástico. Observa que solo se han realizado cambios en las líneas 24 y 30. Todo el resto del código permanece idéntico. Solo debemos tener en cuenta dos cosas: primero, el valor de p1 debe ser distinto de p2 y menor que este. Segundo, el valor de p2 debe ser igual o menor que la cantidad de datos del conjunto de entrenamiento. Teniendo en cuenta estas condiciones, veamos cómo podríamos utilizarlo.
El autor de llamada puede realizar una determinada cantidad de llamadas para entrenar el sistema con X datos. Una vez que la red haya sido entrenada con esos X datos, pasas al siguiente lote. De esta forma, entrenas con una cantidad Y de datos, que puede ser igual o mayor que la cantidad anterior. Como la red ya estará en una fase algo más avanzada en cuanto a la reducción del costo, esta segunda tanda de entrenamiento será, muchas veces, considerablemente más rápida. Y así sucesivamente.
Divides los datos que se utilizarán para el entrenamiento en bloques más pequeños, que pasan mucho más rápido por la función de costo. Por ejemplo, supongamos que nuestro conjunto tuviera un millón de datos para utilizar durante el entrenamiento. Si tuviéramos que hacer pasar ese millón de datos cien mil veces por la función de costo, necesitaríamos una enorme cantidad de tiempo. En cambio, si hiciéramos pasar diez mil datos cien mil veces para reducir el costo asociado a los pesos y al sesgo, el siguiente lote de diez mil quizá ya no tendría que pasar cien mil veces. Tal vez bastarían unas ochenta mil iteraciones antes de terminar. Y el siguiente lote necesitaría todavía menos intentos para reducir aún más el costo. Al final, habrás utilizado todos los datos de entrenamiento, pero sin dedicar todo el tiempo que habría sido necesario si hubieras procesado el conjunto completo en cada iteración.
Esta es la clave del estocástico: intentar reducir el costo lo más rápidamente posible. Como probablemente no tendrás la suerte de que el generador pseudoaleatorio asigne a los pesos y al sesgo valores cercanos a los adecuados, aplicar este enfoque a un conjunto de datos grande es una decisión inteligente. Sin embargo, para conjuntos pequeños, o incluso para el que estoy utilizando para mostrar cómo funciona todo, implementar un descenso de gradiente estocástico o es completamente innecesario y supone una enorme pérdida de tiempo. Por lo tanto, no tiene mucho sentido utilizarlo cuando métodos más sencillos y, aparentemente, más lentos pueden ofrecer buenos resultados.
Bien. Considero explicado el tema del descenso de gradiente estocástico, ya que tampoco hay mucho más que decir al respecto. Como todavía tenemos algo de tiempo, puedo empezar a mostrar algo que se entenderá mejor en el próximo artículo. Así que vamos a adelantarnos un poco. Para ello, pasemos a un nuevo tema.
¿No existe otro camino?
Muy bien, mi querido lector. Hasta ahora, todo ha avanzado de forma gradual y sin demasiados contratiempos, lo que ha permitido explicar muchas cosas con relativa facilidad. También es cierto que todavía estamos en una etapa muy inicial de todo lo que podemos abordar. Sin embargo, como algunas de las cuestiones que veremos son algo difíciles de mostrar de manera sencilla, he intentado avanzar tan despacio y gradualmente como sea posible. La idea es presentar el tema de una forma didáctica para que todos puedan comprenderlo. Aunque hayamos tenido algunos altibajos, creo que has conseguido seguir las explicaciones y entender el material.
Hay algo que me gustaría explicar antes de entrar en otras cuestiones un poco más profundas. Para hacerlo, tendremos que modificar ligeramente el código de la neurona que vimos en este artículo. No hace falta que te asustes ni que te preguntes por qué. Como decía EN SABAH NUR: «Todo se aclarará a su debido tiempo, mi niño». Bien, una vez entendido esto, veamos los cambios realizados en el código para que pueda explicarte una cosa. De nuevo, no te preocupes por entender todavía el motivo; limítate a observar el código que se muestra a continuación.
001. //+------------------------------------------------------------------+
002. #property copyright "Daniel Jose"
003. //+------------------------------------------------------------------+
004. #include <Canvas\Canvas.mqh>
005. //+------------------------------------------------------------------+
006. #define PrintEx(A)  Print(#A, " => ", A)
007. #define macroRandom (rand() / (double)SHORT_MAX)
008. #define _SizeLine   300
009. #define nColuns     2
010. //+------------------------------------------------------------------+
011. CCanvas canvas;
012. //+------------------------------------------------------------------+
013. double Train[][nColuns] {
014.                     {0, -0.8},
015.                     {1, 0.85},
016.                     {2, 2.5},
017.                     {3, 4.15},
018.                     {4, 5.8},
019.                   };
020. //+------------------------------------------------------------------+
021. const double epsilon = 1e-3;
022. //+------------------------------------------------------------------+
023. struct stErr
024. {
025.     double  Weight,
026.             Bias;
027. };
028. //+------------------------------------------------------------------+
029. stErr Cost(const double w, const double b, const uint p1 = 0, const uint p2 = Train.Size() / nColuns)
030. {
031.     double x, y, t;
032.     stErr err;
033.
034.     ZeroMemory(err);
035.     for (uint c = p1; c < p2; c++)
036.     {
037.         x = Train[c][0];
038.         y = Train[c][1];
039.         t = 2 * ((x * w + b) - y);
040.         err.Weight += (t * x);
041.         err.Bias += t;
042.     }
043.
044.     return err;
045. }
046. //+------------------------------------------------------------------+
047. void PlotText(const int x, const int y, const uchar line, const string sz0)
048. {
049.     uint w, h;
050.
051.     TextGetSize(sz0, w, h);
052.     canvas.TextOut(x - (w / 2), y + _SizeLine + (line * h) + 5, sz0, ColorToARGB(clrBlack));
053. }
054. //+------------------------------------------------------------------+
055. inline double CallZoom(void)
056. {
057.     double d1 = 0;
058.
059.     for (uint c = 0; c < Train.Size() / nColuns; c++)
060.     {
061.         d1 = MathMax(d1, MathAbs(Train[c][0]));
062.         d1 = MathMax(d1, MathAbs(Train[c][1]));
063.     }
064.
065.     return _SizeLine / d1;
066. }
067. //+------------------------------------------------------------------+
068. void Plot_Train2D(const int x, const int y, const double weight, double bias)
069. {
070.     int vx, vy;
071.     double zoom;
072.     uint n = Train.Size() / nColuns;
073.
074.     zoom = CallZoom();
075.     canvas.LineVertical(x, y - _SizeLine, y + _SizeLine, ColorToARGB(clrRoyalBlue, 255));
076.     canvas.LineHorizontal(x - _SizeLine, x + _SizeLine, y, ColorToARGB(clrRoyalBlue, 255));
077.     for (uint c = 0; c < n; c++)
078.     {
079.         vx = (int)(Train[c][0] * zoom);
080.         vy = (int)(Train[c][1] * zoom);
081.        canvas.FillCircle(x + vx, y - vy, 5, ColorToARGB(clrRed, 255));
082.     }
083.     canvas.LineAA(
084.                 x + (int)(Train[0][0] * zoom),
085.                 y - (int)((Train[0][0] * weight + bias) * zoom),
086.                 x + (int)(Train[n - 1][0] * zoom),
087.                 y - (int)((Train[n - 1][0] * weight + bias) * zoom),
088.                 ColorToARGB(clrForestGreen));
089.     PlotText(x, y, 1, StringFormat("Zoom: %.2fx", zoom));
090.     PlotText(x, y, 2, StringFormat("f(x) = %.4fx %c %.4f", weight, (bias < 0 ? '-' : '+'), MathAbs(bias)));
091. }
092. //+------------------------------------------------------------------+
093. void OnStart()
094. {
095.     double weight, bias;
096.     int    x, y;
097.     ulong  it0, it1, count;
098.     stErr  err;
099.
100.     Print("************************************");
101.     Print("Stochastic Gradient Descent Neuron...");
102.     Print("************************************");
103.     MathSrand(512);
104.     weight = (double)macroRandom;
105.     bias = (double)macroRandom;
106.
107.     it0 = GetTickCount();
108.     for(count = 0; count < ULONG_MAX; count++)
109.     {
110.         err = Cost(weight, bias);
111.         if ((MathAbs(err.Weight) <= epsilon) && (MathAbs(err.Bias) <= epsilon))
112.             break;
113.         weight -= (err.Weight * epsilon);
114.         bias -= (err.Bias * epsilon);
115.     }
116.     it1 = GetTickCount();
117.     Print("Time: ", (it1 - it0) / 1000.0, " seconds.");
118.     PrintEx(count);
119.     PrintEx(weight);
120.     PrintEx(bias);
121.     PrintEx(err.Weight);
122.     PrintEx(err.Bias);
123.     Print("Press ESC to close....");
124.     Print("************************************");
125.
126.    x = (int)ChartGetInteger(0, CHART_WIDTH_IN_PIXELS, 0);
127.    y = (int)ChartGetInteger(0, CHART_HEIGHT_IN_PIXELS, 0);
128.    canvas.CreateBitmapLabel("BL", 0, 0, x, y, COLOR_FORMAT_ARGB_NORMALIZE);
129.    canvas.Erase(ColorToARGB(clrWhite, 255));
130.     x /= 2;
131.     y /= 2;
132.
133.     Plot_Train2D(x, y, weight, bias);
134.
135.    canvas.Update(true);
136.
137.     while(!IsStopped())
138.         if (TerminalInfoInteger(TERMINAL_KEYSTATE_ESCAPE) !=0)
139.             break;
140.
141.     canvas.Destroy();
142. }
143. //+------------------------------------------------------------------+
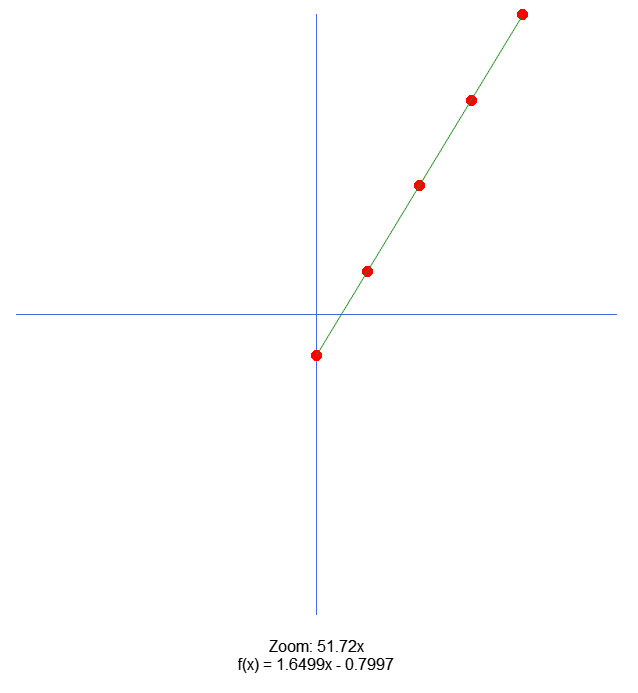
Este código estará disponible en el archivo adjunto. Tal vez, de aquí al próximo artículo, realice algunos cambios para hacerlo más didáctico. Aunque todavía tengo que pensar si realmente será necesario. En cualquier caso, al ejecutarlo obtenemos el resultado que se muestra en la siguiente imagen.
Y en el terminal podrás ver la siguiente información:
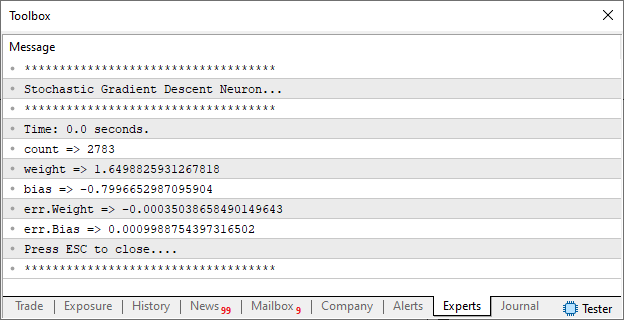
Bien, veamos qué está ocurriendo aquí. A partir de los datos de entrenamiento declarados en la línea 13, durante el procedimiento OnStart utilizamos la neurona para generar una ecuación. Esta ecuación será una recta. La neurona creará la representación mediante el descenso de gradiente estocástico. Sin embargo, como el conjunto de datos es muy pequeño, utilizaremos la forma más sencilla, es decir, el descenso de gradiente. Una vez que la neurona indique que ha terminado, imprimiremos cierta información en el terminal. Esto se hace entre las líneas 117 y 124. A continuación, utilizaremos la biblioteca estándar CCanvas para trazar un gráfico sencillo en la pantalla de MetaTrader 5. Este gráfico se creará cuando se ejecute la línea 133, que a su vez transferirá el flujo de ejecución a la línea 68.
Dentro del procedimiento Plot_Train2D, en la línea 74 pediremos a la aplicación que determine el mejor nivel de zoom para mostrar los datos, ya que podemos estar trabajando con valores muy pequeños o muy grandes. Queremos que todos ellos aparezcan dentro de la región en la que colocaremos un plano cartesiano. Las líneas Y y X que representan el plano se dibujan en las líneas 75 y 76, respectivamente. A continuación, entramos en un bucle for en la línea 77. El objetivo de este bucle es mostrar todos los puntos utilizados durante el entrenamiento. Por supuesto, estarán correctamente situados en las posiciones correspondientes, de acuerdo con el zoom establecido a partir de los valores encontrados. Muy bien, una vez hecho esto, en la línea 83 dibujaremos una línea basada en la ecuación de la recta encontrada por la neurona. Después, en las líneas 89 y 90, mostramos algunos datos sobre lo que representa el gráfico y el nivel de zoom de la imagen.
El objetivo es permitir que los datos se visualicen de la mejor manera posible. Así podrás empezar a comprender lo que veremos en el próximo artículo.
Consideraciones finales
En este artículo nos hemos centrado, básicamente, en crear una neurona capaz de utilizar el descenso de gradiente. También vimos una variante de este modelo denominada descenso de gradiente estocástico. Sin embargo, no todo es tan sencillo. Aquí existen algunos problemas.
Y, en este punto, quiero que tú, mi querido lector, intentes analizar y experimentar con este último código mostrado en el artículo. Pero hazlo con cautela, ya que la neurona no incluye una función de activación. Esto puede hacer que simplemente alcance un punto de estancamiento. Ya vimos anteriormente que esto puede ocurrir. Sin embargo, todavía no vamos a entrar en la cuestión de las funciones de activación ni en su verdadera importancia. Antes quiero explicar otra cosa. Y, para ello, necesito que la neurona permanezca en su forma más sencilla y básica. Porque, si entiendes lo que veremos en el próximo artículo, comprobarás que las redes neuronales no siempre son la mejor opción, independientemente de lo que todos quieran decirte.
Antes de eso, prueba a modificar los valores de entrenamiento de esta última neurona, cuyo código estará incluido en el archivo adjunto. No cambies nada más, únicamente los valores de entrenamiento. Hazlo intentando comprender qué está ocurriendo. Esto hará que resulte más sencillo entender lo que veremos en los próximos artículos. Sin embargo, hay algunas cuestiones que no se han abordado en este artículo, lo que quizá dificulte un poco la comprensión de la parte matemática. No te preocupes; volveremos sobre esta cuestión en otro artículo.
Traducción del portugués realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/pt/articles/13841
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Utilizando redes neuronales en MetaTrader
 Del nivel básico al intermedio: Indicadores técnicos (II)
 Particularidades del trabajo con números del tipo double en MQL4
 Red neuronal en la práctica: Descenso de gradiente

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso