

Asesor experto de Forex basado en la red neuronal N-BEATS
 33
 2

Los robots de trading modernos en el mercado de divisas siguen utilizando indicadores que tienen ya veinte años. Cruce de medias móviles, RSI por encima de 70, el MACD se ha girado a la baja… y el robot toma la decisión de comprar o vender por millones de dólares. Suena absurdo, pero así es precisamente como funciona la mayoría de los asesores expertos.
Los mercados financieros presentan características fundamentales que los enfoques clásicos pasan por alto. La relación señal-ruido es de aproximadamente 1:10: nueve décimas partes de todos los movimientos del precio son fluctuaciones aleatorias. Las dependencias a largo plazo desempeñan un papel fundamental: las decisiones del Banco Central Europeo tomadas hace un mes pueden influir en el tipo de cambio del euro hoy, pero los indicadores clásicos no tienen esto en cuenta.
La no estacionariedad de los mercados plantea dificultades adicionales. Los patrones que funcionaban hace un mes pueden dejar de ser válidos debido a cambios en la situación macroeconómica o en el comportamiento de los principales actores del mercado. Cualquier sistema de trading debe ser capaz de adaptarse a estos cambios.
Por eso precisamente hemos recurrido a la arquitectura N-BEATS, un enfoque revolucionario para la predicción de series temporales, creado específicamente para modelar dependencias temporales complejas.
N-BEATS: un avance arquitectónico en el análisis de series temporales
En 2019, los investigadores de Element AI propusieron un enfoque radicalmente nuevo para la predicción. En lugar de modificar las arquitecturas RNN o CNN existentes, se plantearon una pregunta fundamental: ¿qué arquitectura sería ideal específicamente para tareas de pronóstico?
N-BEATS se basa en el principio de descomposición de la serie temporal. Imaginemos una composición musical: en lugar de intentar predecir la siguiente nota basándonos en el sonido general, analizamos por separado la melodía, el ritmo y la armonía, y luego sintetizamos la predicción. Del mismo modo, N-BEATS desglosa la serie temporal en tendencia, fluctuaciones estacionales y patrones residuales.
La arquitectura utiliza aprendizaje residual, en el que cada bloque no solo proyecta la serie hacia al futuro, sino que también explica la parte histórica. Si la explicación es imprecisa, el error se transmite al siguiente bloque. Esto recuerda a una investigación detectivesca: cada investigador explica parte de las pistas y transmite las cuestiones sin resolver a un colega.
La ventaja clave de N-BEATS es su interpretabilidad. A diferencia de la «caja negra» de las redes neuronales convencionales, esta arquitectura puede mostrar qué papel desempeña la tendencia en el pronóstico y cuál desempeñan las fluctuaciones estacionales. Para un trader, esto significa comprender no solo qué ocurrirá, sino también por qué.
Los resultados de las pruebas realizadas con los benchmarks estándar dejaron atónita a la comunidad científica. N-BEATS ha superado a todos los métodos existentes, incluidas las redes LSTM y las arquitecturas Transformer. Pero lo más impresionante es que lo ha conseguido utilizando únicamente los datos históricos de la propia serie temporal, sin recurrir a características externas.
A diferencia de las RNN, que procesan los datos de forma secuencial, N-BEATS puede procesar toda la serie temporal en paralelo. En el caso del trading algorítmico, esto supone la posibilidad de realizar pronósticos en tiempo real en mercados de alta velocidad.
Sin embargo, la adaptación de la arquitectura académica al caótico mundo de los mercados de divisas requiere modificaciones importantes. Se necesitan pronósticos cuantílicos en lugar de estimaciones puntuales, entradas multivariantes y un tratamiento específico del ruido del mercado.
Estructura básica de Matrix con gradientes
MetaTrader 5 no ofrece herramientas listas para usar para el aprendizaje automático, por lo que hay que crear todo desde cero. Nuestro sistema se basa en la estructura Matrix, que almacena no solo los datos, sino también los gradientes de cada elemento:
struct Matrix {
    double data[];
    double gradients[];  // Complemento clave para backprop
    int rows, cols;

    void Init(int r, int c) {
        rows = r; cols = c;
        ArrayResize(data, r * c);
        ArrayResize(gradients, r * c);
        ArrayInitialize(data, 0.0);
        ArrayInitialize(gradients, 0.0);
    }

    double Get(int r, int c) {
        if(r < 0 || r >= rows || c < 0 || c >= cols) return 0.0;
        return data[r * cols + c];
    }

    void AddGrad(int r, int c, double grad) {
        if(r < 0 || r >= rows || c < 0 || c >= cols) return;
        gradients[r * cols + c] += grad;  // Acumulación de gradientes
    }

    void ZeroGrad() {
        ArrayInitialize(gradients, 0.0);  // Puesta a cero antes de una nueva iteración
    }
};
Esta estructura permite que cada capa de la red acumule automáticamente los gradientes y los transmita a los niveles anteriores.
Para activar las neuronas se utiliza la función SiLU, que ofrece mejores resultados con datos financieros en comparación con la función ReLU clásica. Es importante implementar no solo la función en sí, sino también su derivada para que la retropropagación se realice correctamente.// Activación SiLU (Swish): más suave que la ReLU double SiLU(double x) { double sig = 1.0 / (1.0 + MathExp(-MathMin(MathMax(x, -50), 50))); return x * sig; } double SiLUDerivative(double x) { double sig = 1.0 / (1.0 + MathExp(-MathMin(MathMax(x, -50), 50))); return sig * (1.0 + x * (1.0 - sig)); } // Función sigmoide para la capa de salida double Sigmoid(double x) { return 1.0 / (1.0 + MathExp(-MathMin(MathMax(x, -50), 50))); } double SigmoidDerivative(double x) { double s = Sigmoid(x); return s * (1.0 - s); }
La restricción de los valores de entrada en el intervalo de -50 a 50 evita el desbordamiento al calcular la función exponencial, lo cual es fundamental para la estabilidad del entrenamiento con datos financieros ruidosos.
El descenso de gradiente simple no funciona bien con series temporales financieras debido al elevado nivel de ruido. Por ello, se ha implementado el optimizador Adam, que ajusta de forma adaptativa la tasa de aprendizaje de cada parámetro basándose en el historial de gradientes.
struct AdamOptimizer {
    Matrix m, v;  // Momento y velocidad
    double beta1, beta2, eps;
    int step;

    void Init(int rows, int cols) {
        m.Init(rows, cols);
        v.Init(rows, cols);
        beta1 = 0.9; beta2 = 0.999; eps = 1e-8; step = 0;
    }

    void Update(Matrix &weights, double lr, double weight_decay = 0.01) {
        step++;
        for(int i = 0; i < weights.rows; i++) {
            for(int j = 0; j < weights.cols; j++) {
                double grad = weights.GetGrad(i, j) + weight_decay * weights.Get(i, j);

                // Actualización de momentos
                double m_val = beta1 * m.Get(i, j) + (1 - beta1) * grad;
                double v_val = beta2 * v.Get(i, j) + (1 - beta2) * grad * grad;

                m.Set(i, j, m_val); v.Set(i, j, v_val);

                // Corrección del sesgo
                double m_hat = m_val / (1 - MathPow(beta1, step));
                double v_hat = v_val / (1 - MathPow(beta2, step));

                // Actualización de los pesos
                double update = lr * m_hat / (MathSqrt(v_hat) + eps);
                weights.Set(i, j, weights.Get(i, j) - update);
            }
        }
        weights.ZeroGrad();  // Limpiamos los gradientes tras la actualización
    }
};
Las pasadas «hacia delante» y «hacia atrás» en el bloque N-BEATS
Cada bloque N-BEATS lleva a cabo una secuencia compleja de operaciones. Es fundamental guardar los valores intermedios para la pasada hacia atrás:
struct NBeatsBlock {
    Matrix fc1_w, fc1_b, fc2_w, fc2_b, theta_projection;
    AdamOptimizer fc1_opt, fc2_opt, theta_opt;

    // Valores intermedios para el backprop
    Matrix fc1_input, fc1_output, fc2_input, fc2_output;

    void Forward(Matrix &input_patch, Matrix &backcast, Matrix &forecast) {
        // Guardamos la entrada para el backprop
        fc1_input.Copy(input_patch);

        // Capa FC1
        fc1_output.Init(1, HIDDEN_SIZE);
        for(int j = 0; j < HIDDEN_SIZE; j++) {
            double s = 0.0;
            for(int i = 0; i < input_patch.cols; i++)
                s += input_patch.Get(0, i) * fc1_w.Get(i, j);
            s += fc1_b.Get(0, j);
            fc1_output.Set(0, j, s);  // Guardamos ANTES de la activación
        }

        // Activación con almacenamiento para la retropropagación
        fc2_input.Init(1, HIDDEN_SIZE);
        for(int j = 0; j < HIDDEN_SIZE; j++) {
            fc2_input.Set(0, j, SiLU(fc1_output.Get(0, j)));
        }

        // La capa FC2, de forma análoga...
        // Theta projection y generación de backcast/forecast
    }

    void Backward(Matrix &backcast_grad, Matrix &forecast_grad) {
        // La retropropagación comienza con los gradientes de salida
        // Combinamos los gradientes de backcast y forecast
        Matrix theta_grad;
        theta_grad.Init(1, theta_projection.cols);

        // Calculamos los gradientes de la proyección theta
        for(int i = 0; i < theta_projection.cols; i++) {
            double grad = 0.0;
            if(i < backcast_size) {
                grad += backcast_grad.GetGrad(0, i);
            } else {
                grad += forecast_grad.GetGrad(0, i - backcast_size);
            }
            theta_grad.SetGrad(0, i, grad);
        }

        // Backprop a través de theta projection hacia FC2
        Matrix fc2_grad;
        fc2_grad.Init(1, HIDDEN_SIZE);
        for(int i = 0; i < HIDDEN_SIZE; i++) {
            double grad_sum = 0.0;
            for(int j = 0; j < theta_projection.cols; j++) {
                grad_sum += theta_grad.GetGrad(0, j) * theta_projection.Get(i, j);
                // Acumulamos los gradientes para los pesos de theta_projection
                theta_projection.AddGrad(i, j, theta_grad.GetGrad(0, j) * fc2_output.Get(0, i));
            }
            fc2_grad.SetGrad(0, i, grad_sum);
        }

        // Backpropagación a través de la activación SiLU
        Matrix fc2_input_grad;
        fc2_input_grad.Init(1, HIDDEN_SIZE);
        for(int i = 0; i < HIDDEN_SIZE; i++) {
            double grad = fc2_grad.GetGrad(0, i) * SiLUDerivative(fc1_output.Get(0, i));
            fc2_input_grad.SetGrad(0, i, grad);
        }

        // Backprop a través de FC1 layer hacia las entradas
        // ... cálculos similares para todas las capas
    }
};
Función de pérdida cuantílica
Para predecir la incertidumbre, utilizamos las pérdidas cuantílicas en lugar del MSE habitual:
void Train(double &time_series[], double target) {
    step_count++;

    // Pasada hacia delante para todos los cuantiles
    double predictions[QUANTILE_LEVELS];
    Predict(time_series, predictions);

    // Calculamos las pérdidas cuantílicas
    for(int q = 0; q < QUANTILE_LEVELS; q++) {
        double pred = predictions[q];
        double error = target - pred;
        double quantile = quantiles[q];  // 0,1; 0,5; 0,9

        // Pérdida cuantílica
        double loss_weight = (error >= 0) ? quantile : (1.0 - quantile);
        double focal_weight = class_weights.GetFocalWeight(target, pred);

        double loss = focal_weight * loss_weight * MathAbs(error);

        // Gradiente de la pérdida cuantílica
        double grad_wrt_pred = focal_weight * loss_weight * ((error >= 0) ? -1.0 : 1.0);
        double grad_wrt_logit = grad_wrt_pred * SigmoidDerivative(pred);

        // Backprop hacia los pesos de salida
        for(int h = 0; h < HIDDEN_SIZE; h++) {
            double grad = grad_wrt_logit * pooled_features[h];
            output_proj[q].SetGrad(h, 0, grad);
        }
    }

    // Ejecutamos la pasada hacia atrás (backward pass) a través de toda la red
    BackpropagateToAllLayers();

    // Actualizamos los pesos de todas las capas
    UpdateAllWeights();
}
La calidad de los datos de entrada es fundamental para el éxito de cualquier modelo de aprendizaje automático, pero en el caso de los algoritmos de trading es una cuestión de vida o muerte para la cuenta.
Características multivariantes
En lugar de una simple secuencia de precios de cierre, utilizamos un amplio conjunto de características:
void PrepareInputData(MqlRates &rates[], double &input_data[], int input_bars) {
    ArrayResize(input_data, input_bars * 2);  // 2 características por barra

    for(int i = 0; i < input_bars; i++) {
        if(i < ArraySize(rates) - 1) {
            // Característica 1: variación normalizada del precio
            double price_change = (rates[i].close - rates[i].open) / rates[i].open;
            input_data[i * 2] = MathMax(-1.0, MathMin(1.0, price_change * 100));

            // Característica 2: volumen normalizado logarítmicamente
            double vol_ratio = (rates[i].tick_volume > 0) ?
                MathLog(1.0 + rates[i].tick_volume / 1000.0) : 0.0;
            input_data[i * 2 + 1] = MathMax(0.0, MathMin(1.0, vol_ratio / 10.0));
        } else {
            input_data[i * 2] = 0.0;
            input_data[i * 2 + 1] = 0.0;
        }
    }
}
El recorte de los valores dentro de rangos razonables evita que los valores atípicos extremos afecten al entrenamiento del modelo.
Normalización robusta frente al ruido
Los datos financieros están llenos de anomalías: picos de precios, fallos técnicos y volúmenes anómalos. Una simple normalización min-max puede quedar distorsionada por un solo valor atípico:
void RobustNormalization(double &data[], int window_size = 200) {
    int data_size = ArraySize(data);

    for(int i = window_size; i < data_size; i++) {
        // Calculamos estadísticas robustas para una ventana deslizante
        double window_data[];
        ArrayResize(window_data, window_size);

        for(int j = 0; j < window_size; j++) {
            window_data[j] = data[i - window_size + j];
        }

        // La mediana en lugar de la media (resistente a los valores atípicos)
        ArraySort(window_data);
        double median = window_data[window_size / 2];

        // MAD (desviación absoluta mediana) en lugar de la desviación estándar
        double deviations[];
        ArrayResize(deviations, window_size);
        for(int j = 0; j < window_size; j++) {
            deviations[j] = MathAbs(window_data[j] - median);
        }
        ArraySort(deviations);
        double mad = deviations[window_size / 2];

        // Normalización robusta
        if(mad > 1e-8) {
            data[i] = MathMax(-3.0, MathMin(3.0, (data[i] - median) / mad));
        }
    }
}
El uso de la mediana y el MAD en lugar de la media y la desviación estándar hace que la normalización sea resistente a los valores atípicos.
Detección y tratamiento de anomalías
El sistema debe detectar automáticamente las condiciones anómalas del mercado:
bool DetectMarketAnomaly(MqlRates &rates[], int lookback = 50) {
    if(ArraySize(rates) < lookback) return false;

    // Calculamos la volatilidad del periodo
    double volatilities[];
    ArrayResize(volatilities, lookback);

    for(int i = 1; i < lookback; i++) {
        double change = MathAbs(rates[i].close - rates[i-1].close) / rates[i-1].close;
        volatilities[i] = change;
    }

    ArraySort(volatilities);
    double median_vol = volatilities[lookback / 2];
    double vol_95 = volatilities[(int)(lookback * 0.95)];

    // Volatilidad actual
    double current_vol = MathAbs(rates[0].close - rates[1].close) / rates[1].close;

    // Se considera una anomalía si la volatilidad actual supera el percentil 95 en dos veces o más.
    return (current_vol > vol_95 * 2.0);
}
Si se detectan anomalías, el sistema de trading puede reducir temporalmente el tamaño de las posiciones o pausar el trading.
Los enfoques tradicionales de predicción ofrecen una única estimación puntual: el precio será tal o cual. Sin embargo, para el trading es fundamental comprender la incertidumbre del pronóstico. Precisamente por eso, nuestra implementación de N-BEATS utiliza el pronóstico por cuantiles.
En lugar de un único valor, el sistema ofrece tres estimaciones: un escenario pesimista (10.º cuantil), un pronóstico realista (mediana) y un escenario optimista (90.º cuantil). La diferencia entre los cuantiles indica el nivel de confianza del modelo en el pronóstico.
Para el entrenamiento de los pronósticos por cuantiles se utiliza una función de pérdida especial, que penaliza de forma diferente la subestimación y la sobreestimación en función del cuantil objetivo.
void ProcessQuantilePredictions(double &predictions[]) {
    double q10 = predictions[0];  // Escenario pesimista
    double q50 = predictions[1];  // Pronóstico mediano
    double q90 = predictions[2];  // Escenario optimista

    // Calculamos la incertidumbre del modelo
    double uncertainty = q90 - q10;
    double confidence = 1.0 - MathMin(1.0, uncertainty / 0.4);  // Normalizamos a [0,1]

    // Ajuste dinámico del tamaño de la posición
    double base_lot = CalculateBaseLotSize();
    double adjusted_lot = base_lot * confidence;

    if(q50 > 0.65 && uncertainty < 0.2) {
        // Alta confianza en el crecimiento, baja incertidumbre
        OpenPosition(ORDER_TYPE_BUY, adjusted_lot * 1.5, "High confidence");
    }
    else if(q50 > 0.6 && uncertainty < 0.3) {
        // Confianza moderada en el crecimiento
        OpenPosition(ORDER_TYPE_BUY, adjusted_lot, "Medium confidence");
    }
    else if(q10 > 0.55) {
        // Incluso el escenario pesimista muestra crecimiento
        OpenPosition(ORDER_TYPE_BUY, adjusted_lot * 0.7, "Conservative long");
    }

    Print("Uncertainty: ", DoubleToString(uncertainty, 3),
          " | Confidence: ", DoubleToString(confidence, 3),
          " | Adjusted lot: ", DoubleToString(adjusted_lot, 2));
}
Focal Loss: lucha contra el desequilibrio de clases
Los mercados financieros son, por naturaleza, desequilibrados: los periodos de trading tranquilo se alternan con movimientos poco frecuentes, pero intensos. La función de pérdida habitual no resuelve este problema, por lo que utilizamos Focal Loss:
struct ClassWeights {
    double strong_bull, weak_bull, neutral, weak_bear, strong_bear;

    void UpdateWeights(int &counts[]) {
        int total = counts[0] + counts[1] + counts[2] + counts[3] + counts[4];
        if(total == 0) return;

        // Pesos invertidos: las clases poco frecuentes reciben mayor peso
        strong_bear = (counts[0] > 0) ? (double)total / (5 * counts[0]) : 1.0;
        weak_bear = (counts[1] > 0) ? (double)total / (5 * counts[1]) : 1.0;
        neutral = (counts[2] > 0) ? (double)total / (5 * counts[2]) : 1.0;
        weak_bull = (counts[3] > 0) ? (double)total / (5 * counts[3]) : 1.0;
        strong_bull = (counts[4] > 0) ? (double)total / (5 * counts[4]) : 1.0;
    }

    double GetFocalWeight(double target, double pred) {
        double alpha = GetClassWeight(target);
        double pt = (target > 0.5) ? pred : (1.0 - pred);

        // Focal Loss: se centra en ejemplos difíciles
        return alpha * MathPow(MathMax(1.0 - pt, 1e-8), FOCAL_GAMMA);
    }
};
Focal Loss presta automáticamente mayor atención a los eventos de mercado poco frecuentes pero importantes, precisamente aquellos con los que se puede ganar más.
Stop-loss adaptativo basado en la incertidumbre
El enfoque tradicional de los stop-loss es rudimentario: una cantidad fija de puntos desde la entrada. Nuestro sistema utiliza la incertidumbre predicha:
double CalculateAdaptiveStopLoss(double entry_price, ENUM_ORDER_TYPE order_type,
                                double uncertainty, double base_sl_points = 500) {
    // Aumentamos el stop-loss cuando la incertidumbre es alta
    double uncertainty_multiplier = 1.0 + uncertainty * 2.0;  // [1,0; 3,0]
    double adaptive_sl_points = base_sl_points * uncertainty_multiplier;

    // Tenemos en cuenta la volatilidad actual
    double atr = CalculateATR(14);  // Average True Range de 14 periodos
    double volatility_adjustment = MathMax(0.5, MathMin(2.0, atr / (Point() * 100)));

    adaptive_sl_points *= volatility_adjustment;

    double sl_price;
    if(order_type == ORDER_TYPE_BUY) {
        sl_price = entry_price - adaptive_sl_points * Point();
    } else {
        sl_price = entry_price + adaptive_sl_points * Point();
    }

    Print("Adaptive SL: base=", base_sl_points,
          " uncertainty_mult=", DoubleToString(uncertainty_multiplier, 2),
          " volatility_adj=", DoubleToString(volatility_adjustment, 2),
          " final=", DoubleToString(adaptive_sl_points, 0));

    return sl_price;
}

double CalculateATR(int period) {
    double atr_values[];
    if(CopyBuffer(iATR(Symbol(), Period(), period), 0, 0, 1, atr_values) <= 0) {
        return Point() * 100;  // Valor de fallback
    }
    return atr_values[0];
}
Integración con la lógica de trading de MetaTrader 5
Crear una red neuronal potente es solo la mitad del trabajo. La tarea principal es integrarla con la plataforma de trading de forma que funcione en tiempo real, procese cada tick y tome decisiones de trading en milisegundos.
MetaTrader 5 funciona según un modelo basado en eventos. Cada tick, cada cambio de precio, activa la función OnTick(). Sin embargo, ejecutar cálculos pesados de la red neuronal en cada tick no es eficiente; se necesita un sistema inteligente de caché:
datetime g_last_bar_time = 0;
double   g_cached_prediction = 0.5;
bool     g_prediction_valid = false;

bool IsNewBar() {
    datetime current_bar_time = iTime(Symbol(), Period(), 0);
    if(current_bar_time != g_last_bar_time) {
        g_last_bar_time = current_bar_time;
        g_prediction_valid = false;  // La caché está obsoleta
        return true;
    }
    return false;
}

void OnTick() {
    if(!g_net_initialized) return;

    // Realizamos las operaciones ligeras en cada tick
    if(UseTrailingStop) UpdateTrailingStops();

    // Cálculos pesados solo en una nueva barra
    if(IsNewBar()) {
        double prediction = GetAIPrediction();  // Operación pesada
        g_cached_prediction = prediction;
        g_prediction_valid = true;

        ProcessTradingSignals(prediction);
    }

    // Comprobamos las salidas de emergencia en cada tick
    if(g_prediction_valid) {
        CheckEmergencyExits(g_cached_prediction);
    }
}
Sistema de señales con histéresis
La sencilla lógica de «por encima del umbral, compramos; por debajo, vendemos» genera un problema de oscilación de señales. Cuando el pronóstico fluctúa en torno al valor umbral, el sistema abre y cierra posiciones constantemente. La solución es la histéresis:
void ProcessTradingSignalsWithHysteresis(double prediction) {
    static double last_prediction = 0.5;
    static datetime last_signal_time = 0;

    // Intervalo mínimo entre señales
    if(TimeCurrent() - last_signal_time < PeriodSeconds(Period()) * 2) return;

    int current_positions = CountPositions();
    bool currently_long = HasLongPosition();
    bool currently_short = HasShortPosition();

    // Umbrales diferentes para la entrada y la salida (histéresis)
    double long_entry_threshold = 0.70;
    double long_exit_threshold = 0.55;
    double short_entry_threshold = 0.30;
    double short_exit_threshold = 0.45;

    // Lógica con histéresis
    if(!currently_long && prediction > long_entry_threshold &&
       last_prediction <= long_entry_threshold) {

        if(currently_short) CloseAllPositions("Signal reversal");

        OpenPosition(ORDER_TYPE_BUY, prediction);
        last_signal_time = TimeCurrent();
        Print("🚀 LONG ENTRY: ", DoubleToString(prediction, 3));
    }
    else if(currently_long && prediction < long_exit_threshold &&
            last_prediction >= long_exit_threshold) {

        CloseAllPositions("Long exit signal");
        Print("📤 LONG EXIT: ", DoubleToString(prediction, 3));
    }

    // Lógica análoga para posiciones cortas...

    last_prediction = prediction;
}
Entrenamiento continuo en producción
Los mercados están en constante evolución. Un modelo que funcionaba bien hace un mes puede resultar inútil hoy. Por eso es necesario contar con un sistema de entrenamiento continuo:
struct ContinuousLearning {
    datetime last_retrain_time;
    double performance_buffer[];
    int performance_window;
    double performance_threshold;

    void Init() {
        last_retrain_time = TimeCurrent();
        performance_window = 100;  // Hacemos un seguimiento de las últimas 100 operaciones
        performance_threshold = 0.45;  // Umbral de degradación
        ArrayResize(performance_buffer, performance_window);
    }

    void AddTradeResult(double prediction, double actual_outcome) {
        // Desplazamos el búfer
        for(int i = 0; i < performance_window - 1; i++) {
            performance_buffer[i] = performance_buffer[i + 1];
        }

        // Añadimos un nuevo resultado (1.0 = pronóstico exacto, 0.0 = totalmente incorrecto)
        double accuracy = 1.0 - MathAbs(prediction - actual_outcome);
        performance_buffer[performance_window - 1] = accuracy;

        // Comprobamos si es necesario volver a entrenar el modelo
        if(ShouldRetrain()) {
            ScheduleRetraining();
        }
    }

    bool ShouldRetrain() {
        // Condición 1: Ha transcurrido suficiente tiempo
        bool time_condition = (TimeCurrent() - last_retrain_time) > 24 * 3600;

        // Condición 2: Ha disminuido el rendimiento
        double avg_performance = 0.0;
        for(int i = 0; i < performance_window; i++) {
            avg_performance += performance_buffer[i];
        }
        avg_performance /= performance_window;
        bool performance_condition = avg_performance < performance_threshold;

        return time_condition || performance_condition;
    }

    void ScheduleRetraining() {
        Print("🔄 Scheduling model retraining...");
        Print("Average performance: ", DoubleToString(GetAveragePerformance(), 3));

        // Reentrenamiento en un flujo separado (simulado)
        RetrainModel();
        last_retrain_time = TimeCurrent();
    }
};

ContinuousLearning g_learning_system;
N-BEATS es una arquitectura compleja con multitud de parámetros. En un entorno de producción, cada milisegundo de retraso puede suponer un coste económico, por lo que la optimización del rendimiento es fundamental.
Gestión de la memoriaCada matriz de la red puede contener miles de parámetros. Sin una gestión adecuada de la memoria, el sistema agotará rápidamente sus recursos:
struct MemoryManager {
    Matrix temp_matrices[];
    int allocated_count;
    int max_temp_matrices;

    void Init() {
        max_temp_matrices = 100;
        ArrayResize(temp_matrices, max_temp_matrices);
        allocated_count = 0;
    }

    Matrix* AllocateTempMatrix(int rows, int cols) {
        if(allocated_count >= max_temp_matrices) {
            Print("⚠️ Temporary matrix pool exhausted!");
            return NULL;
        }

        temp_matrices[allocated_count].Init(rows, cols);
        return &temp_matrices[allocated_count++];
    }

    void ResetTempPool() {
        // «Liberación» rápida sin una desasignación real
        allocated_count = 0;
    }

    void PrintMemoryUsage() {
        int total_elements = 0;
        for(int i = 0; i < allocated_count; i++) {
            total_elements += temp_matrices[i].rows * temp_matrices[i].cols;
        }

        double memory_mb = total_elements * sizeof(double) / (1024.0 * 1024.0);
        Print("Memory usage: ", DoubleToString(memory_mb, 2), " MB");
        Print("Active matrices: ", allocated_count);
    }
};

MemoryManager g_memory_manager;
Perfilado de las rutas críticas
Es importante saber en qué se invierte exactamente el tiempo de ejecución:
struct Profiler {
    string operation_names[];
    ulong operation_times[];
    int operation_counts[];
    int num_operations;

    void Init() {
        num_operations = 0;
        ArrayResize(operation_names, 50);
        ArrayResize(operation_times, 50);
        ArrayResize(operation_counts, 50);
    }

    void StartTimer(string operation) {
        // MQL5 no dispone de temporizadores de alta precisión, por lo que utilizamos GetMicrosecondCount()
        ulong start_time = GetMicrosecondCount();

        // Buscamos una operación existente o creamos una nueva
        int index = FindOrCreateOperation(operation);
        operation_times[index] = start_time;
    }

    void EndTimer(string operation) {
        ulong end_time = GetMicrosecondCount();
        int index = FindOperation(operation);

        if(index >= 0) {
            ulong elapsed = end_time - operation_times[index];
            operation_times[index] = elapsed;  // Lo reutilizamos para almacenar el tiempo
            operation_counts[index]++;
        }
    }

    void PrintReport() {
        Print("=== PERFORMANCE REPORT ===");
        for(int i = 0; i < num_operations; i++) {
            double avg_time_ms = operation_times[i] / (double)operation_counts[i] / 1000.0;
            Print(operation_names[i], ": ", DoubleToString(avg_time_ms, 3), " ms avg, ",
                  operation_counts[i], " calls");
        }
    }
};

Profiler g_profiler;

// Uso:
void OptimizedPredict(double &time_series[]) {
    g_profiler.StartTimer("PatchEmbedding");
    // ... código de patch embedding
    g_profiler.EndTimer("PatchEmbedding");

    g_profiler.StartTimer("StackForward");
    // ... pasada hacia delante a través de las pilas
    g_profiler.EndTimer("StackForward");
}
El perfilado ayuda a identificar los cuellos de botella y a centrar los esfuerzos de optimización allí donde realmente importa.
Un robot de trading con red neuronal no es simplemente código que se pueda ejecutar y luego olvidar. Se trata de un sistema complejo que requiere supervisión, diagnóstico y ajustes constantes. Sin un sistema de monitorización adecuado, incluso la arquitectura más perfeccionada puede degradarse de forma imperceptible y empezar a perder dinero.
Monitorización en tiempo real de la calidad de los pronósticosLa primera línea de defensa consiste en monitorizar constantemente la precisión de los pronósticos en tiempo real:
struct PredictionMonitor {
    double accuracy_buffer[];
    double confidence_buffer[];
    double actual_outcomes[];
    int buffer_size, current_index;
    datetime last_evaluation;

    void Init(int size = 1000) {
        buffer_size = size;
        current_index = 0;
        ArrayResize(accuracy_buffer, buffer_size);
        ArrayResize(confidence_buffer, buffer_size);
        ArrayResize(actual_outcomes, buffer_size);
        ArrayInitialize(accuracy_buffer, 0.5);
        last_evaluation = TimeCurrent();
    }

    void RecordPrediction(double prediction, double confidence) {
        confidence_buffer[current_index] = confidence;
        // Guardamos el pronóstico para su evaluación futura
        // actual_outcomes se completará más adelante, cuando se conozca el resultado
    }

    void RecordOutcome(double actual_movement) {
        if(current_index >= buffer_size) return;

        actual_outcomes[current_index] = actual_movement;

        // Calculamos la precisión del pronóstico
        double predicted = confidence_buffer[current_index];
        double accuracy = 1.0 - MathAbs(predicted - actual_movement);
        accuracy_buffer[current_index] = accuracy;

        current_index = (current_index + 1) % buffer_size;

        // Mostramos estadísticas periódicamente
        if(TimeCurrent() - last_evaluation > 3600) {  // Cada hora
            PrintAccuracyReport();
            last_evaluation = TimeCurrent();
        }
    }

    void PrintAccuracyReport() {
        double total_accuracy = 0.0, total_confidence = 0.0;
        int valid_samples = 0;

        for(int i = 0; i < buffer_size; i++) {
            if(accuracy_buffer[i] > 0) {
                total_accuracy += accuracy_buffer[i];
                total_confidence += confidence_buffer[i];
                valid_samples++;
            }
        }

        if(valid_samples > 10) {
            double avg_accuracy = total_accuracy / valid_samples;
            double avg_confidence = total_confidence / valid_samples;

            Print("=== PREDICTION QUALITY REPORT ===");
            Print("Average accuracy: ", DoubleToString(avg_accuracy * 100, 2), "%");
            Print("Average confidence: ", DoubleToString(avg_confidence * 100, 2), "%");
            Print("Valid samples: ", valid_samples);

            // Advertencia de degradación
            if(avg_accuracy < 0.5) {
                Print("⚠️ WARNING: Model accuracy below random baseline!");
            }
            if(avg_accuracy < avg_confidence - 0.1) {
                Print("⚠️ WARNING: Model overconfident - accuracy vs confidence gap!");
            }
        }
    }

    double GetRecentAccuracy(int lookback = 100) {
        double sum = 0.0;
        int count = 0;

        for(int i = 0; i < MathMin(lookback, buffer_size); i++) {
            int idx = (current_index - i - 1 + buffer_size) % buffer_size;
            if(accuracy_buffer[idx] > 0) {
                sum += accuracy_buffer[idx];
                count++;
            }
        }

        return (count > 0) ? sum / count : 0.5;
    }
};

PredictionMonitor g_monitor;
Detección de deriva conceptual
Los mercados financieros están en constante evolución. Los patrones que funcionaban hace un mes pueden haber dejado de ser válidos. El sistema debe detectar automáticamente este tipo de cambios:
struct ConceptDriftDetector {
    double recent_performance[];
    double historical_baseline;
    int window_size;
    bool drift_detected;
    datetime last_drift_check;

    void Init(int window = 200) {
        window_size = window;
        ArrayResize(recent_performance, window_size);
        historical_baseline = 0.55;  // Precisión de referencia del modelo
        drift_detected = false;
        last_drift_check = TimeCurrent();
    }

    void AddPerformancePoint(double accuracy) {
        // Desplazamos la ventana
        for(int i = 0; i < window_size - 1; i++) {
            recent_performance[i] = recent_performance[i + 1];
        }
        recent_performance[window_size - 1] = accuracy;

        // Comprobamos la deriva cada 4 horas
        if(TimeCurrent() - last_drift_check > 4 * 3600) {
            CheckForDrift();
            last_drift_check = TimeCurrent();
        }
    }

    void CheckForDrift() {
        // Calculamos el desempeño medio en la ventana
        double window_mean = 0.0;
        int valid_count = 0;

        for(int i = 0; i < window_size; i++) {
            if(recent_performance[i] > 0) {
                window_mean += recent_performance[i];
                valid_count++;
            }
        }

        if(valid_count < 50) return;  // No hay datos suficientes

        window_mean /= valid_count;

        // Prueba estadística para detectar una desviación significativa
        double variance = 0.0;
        for(int i = 0; i < window_size; i++) {
            if(recent_performance[i] > 0) {
                double diff = recent_performance[i] - window_mean;
                variance += diff * diff;
            }
        }
        variance /= (valid_count - 1);
        double std_error = MathSqrt(variance / valid_count);

        // Prueba Z para determinar la significación de la desviación
        double z_score = (window_mean - historical_baseline) / std_error;
        bool significant_drift = MathAbs(z_score) > 2.58;  // Nivel de confianza del 99 %

        if(significant_drift && !drift_detected) {
            drift_detected = true;
            Print("🚨 CONCEPT DRIFT DETECTED!");
            Print("Historical baseline: ", DoubleToString(historical_baseline, 3));
            Print("Recent performance: ", DoubleToString(window_mean, 3));
            Print("Z-score: ", DoubleToString(z_score, 2));
            Print("Recommendation: Schedule model retraining");

            // Iniciamos automáticamente el reentrenamiento
            TriggerEmergencyRetraining();
        }
        else if(!significant_drift && drift_detected) {
            drift_detected = false;
            Print("✅ Concept drift resolved - model performance stabilized");
        }
    }

    void UpdateBaseline(double new_baseline) {
        historical_baseline = new_baseline;
        Print("📊 Performance baseline updated to ", DoubleToString(new_baseline, 3));
    }
};

ConceptDriftDetector g_drift_detector;
Sistema de alertas y respuesta automática
Las situaciones críticas exigen una respuesta inmediata, incluso si el trader está durmiendo o no está localizable:
struct AlertSystem {
    enum ALERT_LEVEL {
        INFO = 0,
        WARNING = 1,
        CRITICAL = 2,
        EMERGENCY = 3
    };

    struct Alert {
        ALERT_LEVEL level;
        string message;
        datetime timestamp;
        bool acknowledged;
    };

    Alert active_alerts[];
    int max_alerts;
    datetime last_notification;

    void Init() {
        max_alerts = 100;
        ArrayResize(active_alerts, max_alerts);
        last_notification = 0;
    }

    void RaiseAlert(ALERT_LEVEL level, string message) {
        // Buscamos un espacio libre para la alerta
        int slot = -1;
        for(int i = 0; i < max_alerts; i++) {
            if(active_alerts[i].timestamp == 0) {
                slot = i;
                break;
            }
        }

        if(slot == -1) {
            // Sustituimos la alerta más antigua
            datetime oldest = TimeCurrent();
            for(int i = 0; i < max_alerts; i++) {
                if(active_alerts[i].timestamp < oldest) {
                    oldest = active_alerts[i].timestamp;
                    slot = i;
                }
            }
        }

        // Creamos una alerta
        active_alerts[slot].level = level;
        active_alerts[slot].message = message;
        active_alerts[slot].timestamp = TimeCurrent();
        active_alerts[slot].acknowledged = false;

        // Escribimos en el log con los prefijos correspondientes
        string prefix = GetAlertPrefix(level);
        Print(prefix, " ", message);

        // Las alertas críticas requieren una acción inmediata
        if(level >= CRITICAL) {
            HandleCriticalAlert(message);
        }

        // Limitamos la frecuencia de las notificaciones
        if(TimeCurrent() - last_notification > 300) {  // No más de una vez cada 5 minutos
            SendNotification(level, message);
            last_notification = TimeCurrent();
        }
    }

    string GetAlertPrefix(ALERT_LEVEL level) {
        switch(level) {
            case INFO: return "ℹ️ INFO:";
            case WARNING: return "⚠️ WARNING:";
            case CRITICAL: return "🚨 CRITICAL:";
            case EMERGENCY: return "🆘 EMERGENCY:";
            default: return "❓ UNKNOWN:";
        }
    }

    void HandleCriticalAlert(string message) {
        // Acciones automáticas ante alertas críticas
        if(StringFind(message, "accuracy") >= 0) {
            // Problemas de precisión: reducimos el tamaño de las posiciones
            ReducePositionSizes(0.5);
        }
        else if(StringFind(message, "memory") >= 0) {
            // Problemas de memoria: limpieza forzada
            g_memory_manager.ResetTempPool();
        }
        else if(StringFind(message, "drift") >= 0) {
            // Deriva conceptual: detenemos el trading hasta el reentrenamiento
            DisableTrading("Concept drift detected");
        }
    }

    void SendNotification(ALERT_LEVEL level, string message) {
        // En un sistema real, aquí podría haber:
        // - Envío de emails mediante solicitudes web
        // - Notificaciones push a través de la API de Telegram Bot
        // - SMS a través de servicios externos

        string notification = StringFormat("[%s] %s: %s",
            TimeToString(TimeCurrent()),
            EnumToString(level),
            message);

        // Para la demostración, simplemente lo mostramos en el terminal
        Print("📱 NOTIFICATION SENT: ", notification);
    }
};

AlertSystem g_alerts;
Tras desarrollar el sistema N-BEATS, ha llegado el momento de comprobar su eficacia en condiciones reales de trading. MetaTrader 5 ofrece herramientas profesionales de prueba, que son las que utilizamos.
Resultados de las pruebas del robot N-BEATS
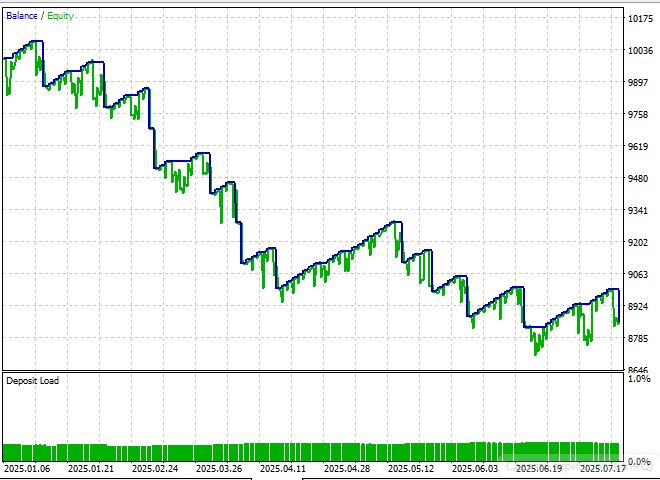
Lamentablemente, a diferencia de los modelos funcionales anteriores del ciclo —Mamba y PatchTST—, a pesar de su prometedora arquitectura, no logramos obtener beneficios en el periodo de prueba comprendido entre enero de 2025 y agosto de 2025:
Y ni siquiera el estudio de varias decenas de artículos sobre el algoritmo ni la creación de una segunda versión del Asesor experto ayudaron demasiado a mejorar la situación:
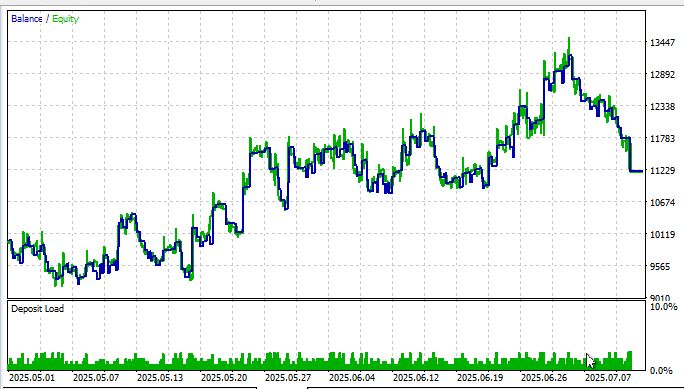
A pesar de la complejidad técnica y la elegancia de su implementación, las pruebas realizadas con datos históricos del periodo comprendido entre enero y agosto de 2025 mostraron la incapacidad del sistema para generar beneficios estables. A diferencia de las arquitecturas anteriores exitosas, Mamba y PatchTST, N-BEATS no logró funcionar de manera eficaz en condiciones reales de trading.
Conclusión
El estudio realizado ha puesto de manifiesto que la adaptación directa de la arquitectura N-BEATS a la tarea de pronóstico en series temporales financieras no ofrece los resultados esperados. Las principales causas fueron el alto nivel de ruido en los datos de Forex, la falta de consideración de la microestructura del mercado y la desproporción entre los costes computacionales y las mejoras obtenidas en el trading.
No obstante, el proyecto tiene un gran valor práctico. Se ha creado una infraestructura para realizar experimentos con redes neuronales en MQL5, se ha implementado la retropropagación desde cero y se han desarrollado herramientas de gestión de riesgos basadas en la incertidumbre. Además, se han implementado sistemas de monitorización y diagnóstico, incluida la detección de deriva conceptual y la respuesta automática ante la degradación de los modelos, lo que resulta de interés para una amplia gama de soluciones de trading basadas en aprendizaje automático.
El código presentado puede servir de base para futuras investigaciones y para el desarrollo de algoritmos especializados que reflejen con mayor precisión las características de los mercados financieros. Los resultados obtenidos ponen de relieve la necesidad de adaptar las arquitecturas y las técnicas de aprendizaje automático a las particularidades de la dinámica del mercado y confirman que el éxito en este ámbito requiere una combinación de soluciones de ingeniería y un profundo conocimiento de los procesos económicos.
| Nombre del archivo | Uso del archivo |
|---|---|
| NBeats_TimeSeriesNet.mqh | Primera versión del modelo del artículo: debe colocarse en la carpeta /Include |
| NBeats_TimeSeriesNetV2.mqh | Segunda versión del modelo del artículo: debe colocarse en la carpeta /Include |
| NBeats_EA.mq5 | Primera versión del asesor experto del artículo: debe colocarse en la carpeta /Experts |
| NBeats_EAV2.mq5 | La segunda versión del asesor experto del artículo debe colocarse en la carpeta /Experts |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19317
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.


 Utilizando redes neuronales en MetaTrader
 Tablas en el paradigma MVC en MQL5: integramos el componente Model en el componente View
 Particularidades del trabajo con números del tipo double en MQL4
 Desarrollo de un kit de herramientas para el análisis de la acción del precio (Parte 34): Conversión de datos brutos del mercado en modelos predictivos mediante un pipeline avanzado de ingesta

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso