克服机器学习的局限性(第三部分):不可约误差的新视角
 43
 0

本文将向读者介绍当前机器学习模型的一些深层局限,而从业者在部署这些模型之前,通常并未接受过有关这些局限的明确讲授。 机器学习领域主要由数学符号和文献主导。 由于从业者可以从多个抽象层次研究机器学习,所采用的方法也往往各不相同。 例如,一些从业者仅通过scikit-learn等高级库学习机器学习;这些库提供了简单直观的模型使用框架,同时屏蔽了模型背后的数学概念。
然而,视从业者希望达到的掌握程度和控制程度而定,有时必须剥离这些抽象层,才能看清底层究竟发生了什么。 因此,在任何涉及机器学习模型的项目中,不可约误差(irreducible error)始终存在,只是很少被直接提及。
让我们来看看简单线性回归的公式。 通常,我们试图预测的目标变量Y可以看作可测量输入 X 的函数f:输入X经一组系数B变换,并叠加一定量无法观测或控制的随机噪声e,得到目标变量Y。 我们今天的讨论重点是这个误差项e,它默默地存在于所有机器学习模型之中。 我们的目的是向读者表明,这个误差项并非像经典文献所暗示的那样完全是随机的。 认为该误差项是随机的且完全不可约的,这似乎与事实相悖。
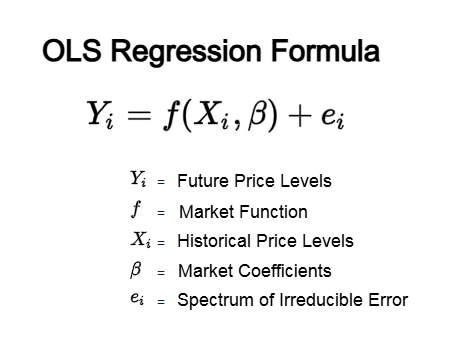
图1:关于普通最小二乘回归的数学解释,对不可约误差项及其成因几乎未作详细说明
我们的唯一目标是向读者展示:通常被视为单一量的“不可约误差”,可能可以分解为一系列相互独立的误差来源,从而为读者提供理解不可约误差的新视角。 前两种误差来源在科学界已有充分共识:
- 真实底层过程固有的变异性或自然随机性。
- 模型本身的偏差。
因此,我们今天的讨论旨在介绍不可约误差中第三类鲜为人知的组成部分。 这里的关键结论是,我们可以控制这第三类误差来源,从而提升交易表现。
机器学习模型可以从多个角度进行研究,因此任何读者都很难全面掌握所有这些视角下的知识。 我们通常从统计学的角度来学习这些模型。 然而,很少有读者会从几何学的角度来探究这些模型——第三类不可约误差的来源恰恰隐藏于此,那些始终停留在较高抽象层面的从业者往往看不到它。
这第三类误差不仅难以消除——因而被称为“不可约”误差——甚至连察觉其存在都很困难。 它往往隐藏在简洁的数学符号背后,因此我们每个人都可能同样难以察觉它。
本文并不声称能将该误差降至零。 相反,本文展示了在认识到这种误差的存在后,如何更明智、更恰当地使用机器学习模型。
从几何学的角度来看,读者应当理解,机器学习模型并不会真正“学习”将输入映射到输出的函数。 事实上,模型并未真正尝试直接逼近生成目标变量的函数。
试想一位艺术家正在纸上作画。 纸张就像是艺术家用来描绘缪斯形象的画布。 同样,机器学习模型利用我们提供的输入,构建出一个名为“流形”的新“画布”。 现在,试想我们手持一枚硬币,使其在机器学习模型根据我们提供的输入生成的“画布”上投下阴影。 阴影投射到画布上的位置,就是模型给出的预测。 但我们真正的目标变量是硬币本身。 希望读者理解的关键在于:机器学习模型本质上是将目标变量的投影(projection)嵌入由所提供的输入形成的某种组合或流形中。
但我们试图预测的目标变量并不一定位于根据输入所能构建的流形中——它位于自身的流形空间中。 因此,由输入构建的流形与真实目标变量所在的流形之间,总是存在某种不可约的距离。 这就是误差的一个来源。 再加上该过程固有的随机性(第一种来源)和模型的偏差(第二种来源),整个情况就一目了然了。
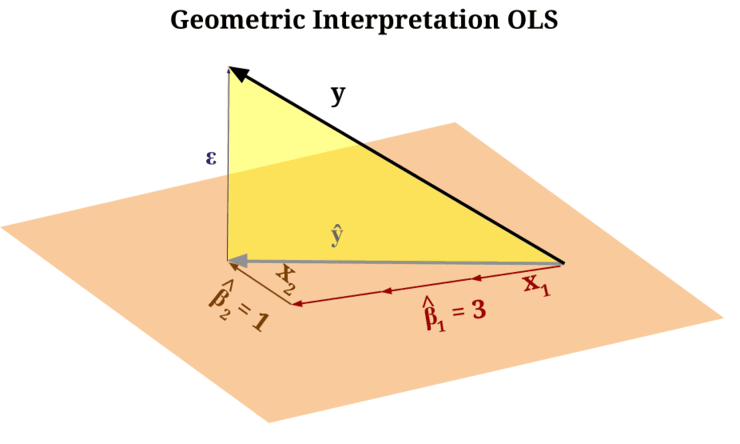
图2:“橙色平面”代表模型根据您提供的输入生成的“画布”,而“黄色三角形”则表示画布与真实目标变量之间的不可约误差
已经熟悉解析几何的读者会意识到,机器学习模型所接收的输入的张成空间定义了一个新的坐标系。 随后,模型会尝试利用从输入数据中学习到的这个新坐标系来描述目标变量。 但请记住:目标变量位于其自身的坐标系中,该坐标系独立于输入所定义的坐标系!
对于已经熟悉机器学习这一几何视角的进阶读者而言,下文的讨论可能不言自明;如果愿意继续阅读本文,不妨略读这部分内容。 对于尚未从这一角度看待该问题的读者,本文余下的内容正是为您准备的。
关键要点在于,通过更自觉、更周全、更明智地运用机器学习模型,我们可以在交易活动中对这种误差施加一定程度的控制。
我们的讨论将从此前反馈控制器文章中确立的基准性能水平开始,相关内容可参见此处。 与之前讨论的最初版本相比,我们的反馈控制器性能已显著提升。 在按照本文建议进行调整后,我们的系统表现优于旧的反馈控制器——而该控制器原本的表现已接近可接受水平。
我们的方法是不再进行直接的点对点比较。 我们没有要求模型预测未来的价格水平并将其与当前价格进行比较,而是对两个不同时间跨度的价格水平进行建模,并根据预期的斜率或趋势进行交易。 换句话说,我们根据模型在两个时间跨度上预测出的斜率进行交易,而不是直接比较预测价格与实际价格。
我们使用完全相同的策略对欧元兑美元货币对进行了为期五年的回测,唯一的区别在于我们如何指导模型对价格进行建模。 结果显示,以下绩效指标均有所改善:
交易盈利能力
我们的总净利润从245美元增至253美元,盈利能力提升了3%;与此同时,夏普比率从0.68上升至0.84,提升了23%。在欧元兑美元这样极具挑战性的金融市场中,夏普比率的这一提升尤为显著。
更令人惊讶的是,5年回测期间亏损交易的亏损总额从838美元降至721美元;这表明我们的交易应用程序承担的总风险降低了13%。 此外,我们的累计交易笔数从152笔降至139笔,所需交易总数减少了8%。 这意味着我们的应用程序在承担较少风险的同时,实现了更高的利润率。交易准确率
最后,盈利交易的比例提高了4%,从反馈控制器最初基准测试中的57.24%,提高到按我们的建议调整后的59.71%。 这意味着总体而言,我们的系统在承担更少风险的同时,盈利能力却得到了提升——这对任何交易应用来说都是一个理想的特征。
所有从业者都应认真考虑这些修改。 不过,我们先来回顾一下在之前的讨论中实现的首个反馈控制器的性能表现。
首次回测的时间范围为2020年1月1日至2025年5月1日。 第二次测试也将采用相同的日期范围。
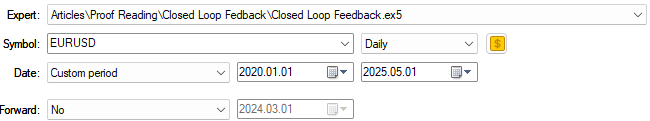
图3:重新审视我们在开篇讨论中确立的基准性能水平
旧的反馈控制器得出的结果确实可以接受,但我们仍能做得更好。 我们在此保留这些旧结果,以便读者将其与我们即将得出的新结果进行对比;因此,下方图4展示的是旧版反馈控制器的结果。 它为我们今天的改进提供了一个有待超越的基准。
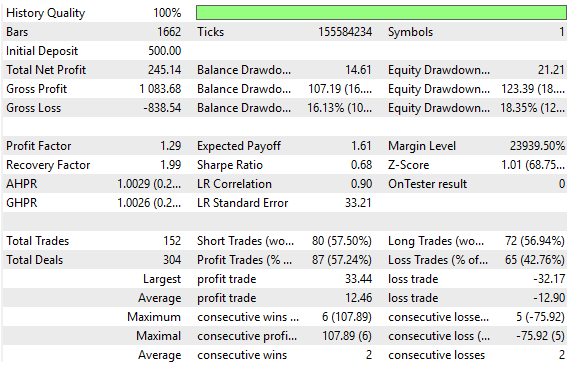
图4:首次尝试构建反馈控制器时取得的性能表现
旧版反馈控制器生成的净值曲线表现可观。 通过对原始策略进行一些调整,我们成功地从该策略中获得了更多利润,这些调整最终对我们整个系统的盈利能力产生了显著影响。 从下方图5可以看出,旧版反馈控制器直到2023年才达到700美元的利润水平。 然而,正如我们稍后将看到的,改进后的反馈控制器早在2021年就达到了700美元的利润水平。 虽然其盈利能力在2021年后不久曾受到冲击,但改进效果仍然显而易见。
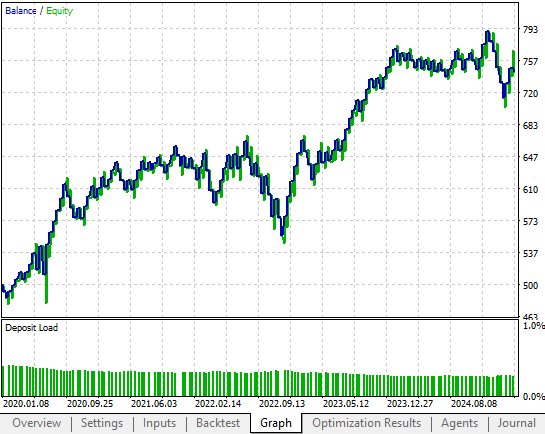
图5:我们交易策略基准版本生成的利润与净值曲线
MQL5入门指南
与我们所有的交易应用程序一样,我们首先给出重要的系统定义,这些定义原样沿用交易策略的初始版本,不作任何修改。 请记住,这些定义很重要,因为它们有助于确保测试的公平性,并使比较标准保持一致。//+------------------------------------------------------------------+ //| Closed Loop Feedback 1.2.mq5 | //| Gamuchirai Ndawana | //| https://www.mql5.com/en/users/gamuchiraindawa | //+------------------------------------------------------------------+ #property copyright "Gamuchirai Ndawana" #property link "https://www.mql5.com/en/users/gamuchiraindawa" #property version "1.00" //+------------------------------------------------------------------+ //| System definitions | //+------------------------------------------------------------------+ #define MA_PERIOD 10 #define FEATURES 12 #define TARGETS 15 #define HORIZON 10 #define OBSERVATIONS 90 #define ACCOUNT_STATES 3
接下来,我们将定义交易策略中将用到的关键全局变量。 这些变量用于跟踪技术指标、交易账户的状况和状态、止损幅度,以及策略应在不进行预测的情况下直接交易,还是先进行预测再进行交易。 全局变量使我们能够以一种既可预测又可重复的方式来定义和控制应用程序的行为。
//+------------------------------------------------------------------+
//| Global variables                                                 |
//+------------------------------------------------------------------+
int    ma_h_handler,ma_l_handler,atr_handler,scenes,b_matrix_scenes;
double ma_h[],ma_l[],atr[];
double padding;
matrix snapshots,OB_SIGMA,OB_VT,OB_U,b_vector,b_matrix;
vector S,prediction;
vector account_state;
bool predict,permission;
所有交易应用程序也都包含依赖项,这些依赖项有助于避免重复编写相同的样板代码。 因此,我们加载了重要的库,例如交易库(用于开仓和平仓),以及为本次讨论专门构建的两个自定义库:时间库和交易信息库。 时间库帮助我们确定新K线何时形成,而交易信息库则提供允许的最小手数以及当前买方报价和卖方报价等重要信息。
//+------------------------------------------------------------------+
//| Dependencies                                                     |
//+------------------------------------------------------------------+
#include <Trade\Trade.mqh>
#include <VolatilityDoctor\Time\Time.mqh>
#include <VolatilityDoctor\Trade\TradeInfo.mqh>

CTrade      Trade;

Time        *DailyTimeHandler;
TradeInfo   *TradeInfoHandler;
在初始化时,我们会为迄今为止构建的所有自定义类创建新的实例。 我们还定义了技术指标的实例,例如移动平均线和ATR指标,以及后续将用到的关键矩阵和向量。 每次启动应用程序时,都会初始化各布尔标志,并将场景计数器(scenes)重置为零。
//+------------------------------------------------------------------+
//| Expert initialization function                                   |
//+------------------------------------------------------------------+
int OnInit()
  {
//---
   DailyTimeHandler  = new Time(Symbol(),PERIOD_D1);
   TradeInfoHandler  = new TradeInfo(Symbol(),PERIOD_D1);
   ma_h_handler      = iMA(Symbol(),PERIOD_D1,MA_PERIOD,0,MODE_EMA,PRICE_HIGH);
   ma_l_handler      = iMA(Symbol(),PERIOD_D1,MA_PERIOD,0,MODE_EMA,PRICE_LOW);
   atr_handler       = iATR(Symbol(),PERIOD_D1,14);
   snapshots         = matrix::Ones(FEATURES,OBSERVATIONS);
   scenes            = 0;
   b_matrix_scenes   = 0;
   account_state     = vector::Zeros(3);
   b_matrix          = matrix::Zeros(1,1);
   prediction        = vector::Zeros(2);
   predict           = false;
   permission        = true;
//---
   return(INIT_SUCCEEDED);
  }
在MQL5中,当应用程序不再使用时,妥善管理内存是一项良好实践。 因此,我们会删除自定义对象实例,并释放所有不再使用的技术指标。
//+------------------------------------------------------------------+
//| Expert deinitialization function                                 |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
  {
//---
   delete DailyTimeHandler;
   delete TradeInfoHandler;
   IndicatorRelease(ma_h_handler);
   IndicatorRelease(ma_l_handler);
   IndicatorRelease(atr_handler);
  }
当从交易服务器接收到新的价格数据时,我们的智能交易系统也会调用其OnTick函数。 在此设置中,首先要检查的是是否形成了一根新K线。 这确保了我们的回测运行速度更快,因为每根K线仅执行一次操作。
确认新K线已形成后,我们会更新技术指标读数以及用于确定止损距离的padding变量。 然后,我们会记录最新的收盘价。 如果存在一个或多个未平仓头寸,我们会获取相应持仓的票号,并调整其止损位,使止损随盈利增加而移动。
要设置移动止损,我们首先需要获取当前止损和止盈的数值。 通过将这些数值与建议的更新数值进行比较,我们决定是否进行更新。 如果建议的新止损位对持仓更有利,则进行更新;否则不作更改。 重要的是,在执行此更新之前,我们必须确认要修改的持仓类型。
如果没有未平仓头寸,则初始化账户状态向量。 回顾一下,该向量用于记录我们打算建立的持仓类型。 如果收盘价高于最高价移动平均线,我们就开仓做多。 如果收盘价低于最低价移动平均线,我们就开仓做空。
如果将布尔标志predict设置为false,且布尔标志permission为true,则直接开仓。 否则,系统会在开仓前记录所有变量并进行预测。
//+------------------------------------------------------------------+
//| Expert tick function                                             |
//+------------------------------------------------------------------+
void OnTick()
  {
//---
   if(DailyTimeHandler.NewCandle())
     {
      CopyBuffer(ma_h_handler,0,0,1,ma_h);
      CopyBuffer(ma_l_handler,0,0,1,ma_l);
      CopyBuffer(atr_handler,0,0,1,atr);
      padding = atr[0]*2;
      double c = iClose(Symbol(),PERIOD_D1,0);

      if(PositionsTotal() > 0)
        {
         ulong ticket = PositionSelectByTicket(PositionGetTicket(0));
         if(ticket)
           {
            double sl,tp;

            sl = PositionGetDouble(POSITION_SL);
            tp = PositionGetDouble(POSITION_TP);

            if(PositionGetInteger(POSITION_TYPE) == POSITION_TYPE_BUY)
              {
               double new_sl = TradeInfoHandler.GetBid()-padding;
               double new_tp = TradeInfoHandler.GetBid()+padding;

               if(new_sl > sl)
                  Trade.PositionModify(ticket,new_sl,new_tp);
              }

            else
               if(PositionGetInteger(POSITION_TYPE) == POSITION_TYPE_SELL)
                 {
                  double new_sl = TradeInfoHandler.GetAsk()+padding;
                  double new_tp = TradeInfoHandler.GetAsk()-padding;

                  if(new_sl < sl)
                     Trade.PositionModify(ticket,new_sl,new_tp);
                 }
           }
        }

      if(PositionsTotal() == 0)
        {
         account_state = vector::Zeros(ACCOUNT_STATES);

         if(c > ma_h[0])
           {
            if(!predict)
              {
               if(permission)
                  Trade.Buy(TradeInfoHandler.MinVolume(),Symbol(),TradeInfoHandler.GetAsk(),(TradeInfoHandler.GetBid()-(padding)),(TradeInfoHandler.GetBid()+(padding)),"");
              }

            account_state[0] = 1;
           }

         else
            if(c < ma_l[0])
              {
               if(!predict)
                 {
                  if(permission)
                     Trade.Sell(TradeInfoHandler.MinVolume(),Symbol(),TradeInfoHandler.GetBid(),(TradeInfoHandler.GetAsk()+(padding)),(TradeInfoHandler.GetAsk()-(padding)),"");
                 }

               account_state[1] = 1;
              }

            else
              {
               account_state[2] = 1;
              }
        }

      if(scenes < OBSERVATIONS)
        {
         take_snapshots();
        }

      else
        {
         matrix temp;
         temp.Assign(snapshots);
         snapshots = matrix::Ones(FEATURES,scenes+1);

         //--- The first row is the intercept and must be full of ones
         for(int i=0;i<FEATURES;i++)
            snapshots.Row(temp.Row(i),i);

         take_snapshots();
         fit_snapshots();

         predict = true;
         permission = false;
        }
      scenes++;
     }
  }
我们用于创建快照的方法非常简单。 它将重要的市场信息记录到名为snapshots(快照)的矩阵中。 这包括开盘价、最高价、最低价和收盘价,以及账户余额与净值。 看过此前几篇文章的读者应该能识别出这段代码,因为它与本系列开头使用的代码完全相同。
//+------------------------------------------------------------------+
//| Record the current state of our system                           |
//+------------------------------------------------------------------+
void take_snapshots(void)
  {
   snapshots[1,scenes] = iOpen(Symbol(),PERIOD_D1,1);
   snapshots[2,scenes] = iHigh(Symbol(),PERIOD_D1,1);
   snapshots[3,scenes] = iLow(Symbol(),PERIOD_D1,1);
   snapshots[4,scenes] = iClose(Symbol(),PERIOD_D1,1);
   snapshots[5,scenes] = AccountInfoDouble(ACCOUNT_BALANCE);
   snapshots[6,scenes] = AccountInfoDouble(ACCOUNT_EQUITY);
   snapshots[7,scenes] = ma_h[0];
   snapshots[8,scenes] = ma_l[0];
   snapshots[9,scenes] = account_state[0];
   snapshots[10,scenes] = account_state[1];
   snapshots[11,scenes] = account_state[2];
  }
不过,现在我们开始看到与最初版本相比所做的改进。 到目前为止,对于老读者来说,这一切应该都很熟悉了。 现在,我们正在为用于建模快照演变过程的系统准备输入和输出。 请记住,快照记录了我们的策略与市场互动过程中的重要细节——例如,我们的账户余额和净值随时间的变化情况。
X矩阵存储输入数据,而Y矩阵存储输出数据。 如果读者仔细观察Y矩阵,就会发现Y中索引为4、5、6、7的行,对应X中索引为5、6、7、8的行。 然后,将X中的这些行再次复制,并将数据在时间上向未来偏移。 这意味着,我们不仅要求模型预测一步之后的账户余额,还要求它预测十步之后的账户余额。
我们根据这两个预测跨度下预测的趋势,决定是否开仓。 一旦使用伪逆法(前文已讨论)找到最优解,我们的模型将输出两个预测结果:
- 下一根K线时的预期账户余额prediction[4]。
- 十根K线后的预期账户余额prediction[8]。
随后,该模型会根据这些预测做出交易决策。 如果模型预计账户余额将增加,则允许交易。 如果模型预计账户余额将下降,则不允许交易。
与之前的方法相比,这是一项显著的改进。 在之前的版本中,我们将模型预测的账户余额与当前实际余额直接比较,仿佛两者可以直接等同。 而借助本文的方法,即可避免重犯这一错误。
//+------------------------------------------------------------------+
//| Fit our linear model to our collected snapshots                  |
//+------------------------------------------------------------------+
void fit_snapshots(void)
  {
   matrix X,y;
   X.Reshape(FEATURES,scenes);
   y.Reshape(TARGETS,scenes);

   for(int i=0;i<scenes-HORIZON;i++)
     {
      X[0,i] = snapshots[0,i];
      X[1,i] = snapshots[1,i];
      X[2,i] = snapshots[2,i];
      X[3,i] = snapshots[3,i];
      X[4,i] = snapshots[4,i];
      X[5,i] = snapshots[5,i];
      X[6,i] = snapshots[6,i];
      X[7,i] = snapshots[7,i];
      X[8,i] = snapshots[8,i];
      X[9,i] = snapshots[9,i];
      X[10,i] = snapshots[10,i];
      X[11,i] = snapshots[11,i];

      y[0,i] = snapshots[1,i+1];
      y[1,i] = snapshots[2,i+1];
      y[2,i] = snapshots[3,i+1];
      y[3,i] = snapshots[4,i+1];
      y[4,i] = snapshots[5,i+1];
      y[5,i] = snapshots[6,i+1];
      y[6,i] = snapshots[7,i+1];
      y[7,i] = snapshots[8,i+1];
      y[8,i] = snapshots[5,i+HORIZON];
      y[9,i] = snapshots[6,i+HORIZON];
      y[10,i] = snapshots[7,i+HORIZON];
      y[11,i] = snapshots[8,i+HORIZON];
      y[12,i] = snapshots[9,i+1];
      y[13,i] = snapshots[10,i+1];
      y[14,i] = snapshots[11,i+1];
     }

   if(PositionsTotal() == 0)
     {
      //--- Find optimal solutions
      b_vector = y.MatMul(X.PInv());
      Print("Day Number: ",scenes+1);
      Print("Snapshot");
      Print(snapshots);
      Print("Input");
      Print(X);
      Print("Target");
      Print(y);
      Print("Coefficients");
      Print(b_vector);
      Print("Prediciton");
      prediction = b_vector.MatMul(snapshots.Col(scenes-1));
      Print("Expected Balance at next candle: ",prediction[4],". Expected Balance after 10 candles: ",prediction[8]);

      permission = false;

      if(prediction[4] < prediction[8])
        {
         Print("Account size expected to grow, permission granted");
         permission = true;
        }

      else
         permission = false;

      if(permission)
        {
         if(PositionsTotal() == 0)
           {
            if(account_state[0] == 1)
               Trade.Buy(TradeInfoHandler.MinVolume(),Symbol(),TradeInfoHandler.GetAsk(),(TradeInfoHandler.GetBid()-(atr[0]*2)),(TradeInfoHandler.GetBid()+(atr[0]*2)),"");

            else
               if(account_state[1] == 1)
                  Trade.Sell(TradeInfoHandler.MinVolume(),Symbol(),TradeInfoHandler.GetBid(),(TradeInfoHandler.GetAsk()+(atr[0]*2)),(TradeInfoHandler.GetAsk()-(atr[0]*2)),"");
           }
        }
     }
  }
//+------------------------------------------------------------------+
与之前讨论时一样,我们必须保持测试所用的日期范围一致,以确保比较始终公平。
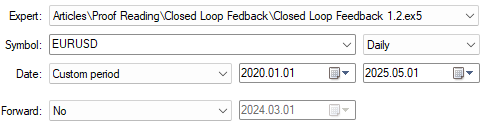
图6:在同一时间段内对改进版反馈控制器进行回测
详细统计数据显示,与初始版本相比,我们的交易策略在表现上有明显且可量化的提升。 与该交易策略的初始版本相比,这一改进版本使我们面临的总体风险更低。 值得注意的是,空头交易的盈利比例也显著提高,已接近70%。
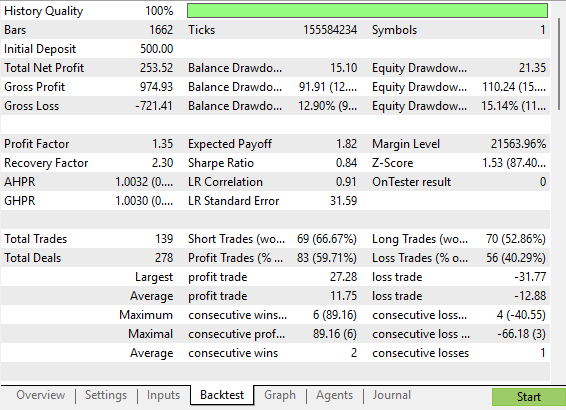
图7:对我们交易系统所作改进的详细分析
与原有策略相比,我们的新策略生成的净值曲线中,出现回撤的时段更少。 该策略展现出稳健的增长态势,波动性较小,但增长速度仍快于我们交易策略最初的高风险版本。
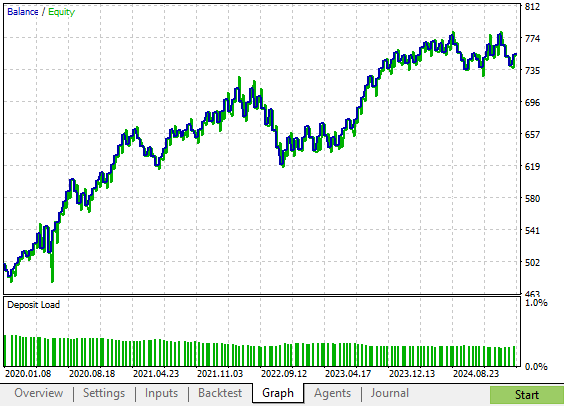
图8:改进版交易策略生成的净值曲线表明,与原始策略相比,净值增长更快
结论
试想一下,您伸直手臂,拿着一个高尔夫球对着天空,让您的AI模型目测比较高尔夫球与月亮的大小。 有些日子,该模型会认定月亮比高尔夫球稍大一些;而另一些日子,它又可能会声称高尔夫球比月亮稍大一些。 作为人类,我们知道这种做法从根本上就有问题,甚至有些可笑。
然而,当我们意识到机器学习模型在金融市场交易中也可能不知不觉地犯同样的错误时,就再也笑不出来了。 在这个思想实验中,模型所犯的错误在于:它没有意识到自己面对的并非月亮本身——它用来比较的其实是月亮在天空中的投影图像。
而在市场中,我们的机器学习模型并非在预测“真实”的未来价格,而是在生成目标变量在特征上的映像。 因此,我们不应将模型的预测结果与实际价格直接比较,仿佛两者是同一种东西。 相反,我们必须认识到,机器学习模型试图利用从输入数据中学到的坐标系来描绘目标变量的图像,而图像与现实之间始终存在某种无法消除的距离。 该图像可能会因多种因素而失真,因此我们应避免依赖直接预测。
读完本文后,读者将不再局限于依赖直接预测,而会明白为何应采用多个预测跨度来减轻这种通常不受质疑的错位误差的影响,从而更有把握地采取行动。
本文由MetaQuotes Ltd译自英文
原文地址: https://www.mql5.com/en/articles/19371
注意: MetaQuotes Ltd.将保留所有关于这些材料的权利。全部或部分复制或者转载这些材料将被禁止。
本文由网站的一位用户撰写,反映了他们的个人观点。MetaQuotes Ltd 不对所提供信息的准确性负责,也不对因使用所述解决方案、策略或建议而产生的任何后果负责。