
Guía de aprendizaje automático para MetaTrader 5 (Parte 2): Etiquetado de datos financieros para modelos de aprendizaje automático
 15
 2

Tabla de contenido
- Introducción
- Descripción general de los métodos de etiquetado
- Implementación: Método de etiquetado de triple barrera
- Informes de metaetiquetado: Estrategia de bandas de Bollinger
- Conclusión
Introducción
Imagínate esto: estás entrenando para convertirte en un francotirador de élite. ¿Prefieres practicar tiro al blanco acertando en círculos perfectos, o entrenar con blancos con silueta humana que imitan situaciones de combate reales? La respuesta es obvia: necesitas objetivos que reflejen la realidad a la que te enfrentarás.
El mismo principio se aplica al aprendizaje automático en finanzas. La mayoría de las investigaciones académicas utilizan lo que se denomina «etiquetado con horizonte temporal fijo», que equivale a intentar acertar en esos círculos perfectos. Este enfoque plantea una pregunta sencilla: «¿El precio será más alto o más bajo dentro de exactamente X días?» Pero aquí está el problema: a los traders reales no solo les importa cuál será el precio final. Les importa el recorrido, es decir, cuándo se activa su stop-loss, cuándo deben cerrar la posición para obtener beneficios y cómo evoluciona el precio a lo largo del proceso.
Bienvenidos de nuevo a nuestra serie «Guía de aprendizaje automático para MetaTrader 5». En la Parte 1, resolvimos la crítica «trampa de la marca de tiempo» que destruye silenciosamente la mayoría de los algoritmos de negociación. Ahora nos enfrentamos a un desafío igualmente importante: cómo crear etiquetas que reflejen de verdad cómo se opera en el mundo real.
Piénsalo de esta manera: si estás creando un modelo para predecir si alguien sufrirá un ataque al corazón, no te limitarías a observar si está vivo o muerto dentro de exactamente 365 días. Querrás conocer las señales de alerta, las intervenciones tempranas y la secuencia de eventos relevantes para las decisiones médicas. Los mercados financieros funcionan de la misma manera.
Este artículo presupone que ya tienes conocimientos básicos de Python y una comprensión fundamental de los conceptos de aprendizaje automático. Profundizaremos en código práctico y aplicaciones del mundo real que podrás implementar de inmediato.
Resumen de la Parte 1: Fugas de datos y correcciones de marcas de tiempo
En la primera entrega de la serie, abordamos un problema crítico, aunque a menudo pasado por alto, que puede socavar silenciosamente los modelos de aprendizaje automático en los mercados financieros: la «trampa de la marca de tiempo» y los problemas de fuga de datos inherentes a la estructura de datos predeterminada de MetaTrader 5. Sentamos las bases fundamentales abordando la integridad de los datos, haciendo hincapié en la necesidad de construir barras limpias e imparciales a partir de datos brutos de ticks. Esta base es indispensable para desarrollar modelos fiables de aprendizaje automático en el ámbito financiero. Si aún no has revisado la Parte 1, te recomendamos encarecidamente que lo hagas antes de continuar.
La base establecida en esa primera parte garantiza:
- Integridad de los datos: Todas las marcas de tiempo indican el momento en que la información estaba realmente disponible.
- Solidez estadística: Las barras basadas en la actividad ofrecen mejores propiedades estadísticas para los modelos de aprendizaje automático.
- Alineación con la realidad: La construcción de las barras se ajusta al flujo real de información del mercado.
Una vez resueltos estos problemas fundamentales relacionados con la calidad de los datos, disponemos ahora de conjuntos de datos limpios e imparciales, listos para el siguiente paso clave en nuestro proceso de aprendizaje automático: técnicas de etiquetado que reflejen fielmente la dinámica del mercado.
Descripción general de los métodos de etiquetado
La mayoría de los modelos de aprendizaje automático en finanzas fallan por una razón sorprendentemente mundana: no por malos algoritmos o potencia informática insuficiente, sino por etiquetas pésimas. Cuando comencé a construir modelos de negociación, pasé meses optimizando características y probando diferentes arquitecturas de redes neuronales, solo para descubrir que mi esquema de etiquetado tenía fallas fundamentales. Básicamente, estaba enseñando a mi modelo a dar en el blanco cuando en realidad necesitaba que acertara en un objetivo en movimiento en medio de un huracán.
Los mercados financieros son implacablemente ruidosos. Cada tick contiene una mezcla de información genuina y caos aleatorio, y nuestro trabajo consiste en extraer la señal, reconociendo que la mayoría de los movimientos de precios son simplemente cambios de opinión de los participantes del mercado o reacciones de los algoritmos a fluctuaciones a nivel de microsegundos. Un buen etiquetado no solo nos dice lo que sucedió, sino que también nos ayuda a comprender qué es importante para tomar decisiones reales de trading.
El método más sencillo, y por el que suele empezar la mayoría de la gente, es el etiquetado con horizonte temporal fijo. Se elige un período —por ejemplo, cinco días— y se pregunta si el precio será más alto o más bajo al final de ese período. Si Apple cierra a 150 dólares el lunes y alcanza los 155 dólares el viernes, el lunes se considera una señal de "compra". Es limpio, intuitivo y fundamentalmente erróneo en comparación con cómo funciona el trading real. ¿Cuándo fue la última vez que compraste una acción pensando: "Volveré a comprobarlo dentro de exactamente cinco días, pase lo que pase"? Si las acciones se desploman un 20% el martes, no vas a esperar hasta el viernes para reevaluar la situación. Si sube un 15% el miércoles, quizás convenga recoger beneficios de inmediato.
Esto nos lleva al método de la triple barrera, que ha cambiado la forma en que los profesionales más comprometidos abordan el aprendizaje automático aplicado a las finanzas. En lugar de establecer horizontes temporales arbitrarios, se fijan tres barreras alrededor de cada posible operación, tal como lo haría un trader profesional. Ahí está tu objetivo de ganancias: tal vez un 5% por encima de tu precio de entrada. Ahí está tu límite de pérdidas, quizás un 3% por debajo del precio de compra. Y hay un límite de tiempo porque no conviene mantener posiciones perdedoras indefinidamente. Tu etiqueta dependerá de qué barrera se alcance primero. De repente, tu modelo ya no está aprendiendo movimientos abstractos de los precios, sino que está aprendiendo si es probable que determinadas configuraciones de operaciones alcancen los objetivos de beneficio antes de llegar a los stop loss.
La belleza de este enfoque reside en que refleja la psicología real del trading. A los verdaderos traders no les importa si una acción finalmente sube si primero cae lo suficiente como para activar sus reglas de gestión de riesgos. El camino es tan importante como el destino, y el método de triple barrera captura esta dependencia del camino de forma natural. Incluso puedes hacer que las barreras sean dinámicas: límites más amplios durante los períodos de volatilidad y más ajustados cuando los mercados están tranquilos.
En los mercados en los que la duración de las tendencias varía considerablemente, los métodos de análisis de tendencias ofrecen una solución elegante. En lugar de imponer un plazo fijo, estos algoritmos prueban múltiples períodos de tiempo futuros e identifican la tendencia estadísticamente más significativa. Quizás la tendencia de 5 días sea débil, la de 10 días sea fuerte y la de 15 días sea moderada. El método selecciona la señal más fuerte y la etiqueta en consecuencia. Es como si el propio algoritmo determinara el horizonte de predicción óptimo para cada condición del mercado.
Por otra parte, está el metaetiquetado, que aborda un problema totalmente distinto. En lugar de predecir la dirección del mercado, pregunta: "¿Cuándo debo confiar en mis otras predicciones?" Imagina que ya tienes una estrategia de trading que genera señales de compra y venta. El metaetiquetado crea un segundo modelo que evalúa si es probable que cada señal sea rentable. Puede que tu estrategia principal diga "comprar", pero el metamodelo considera factores adicionales (rendimiento reciente, volatilidad del mercado, tiempo transcurrido desde el último acontecimiento noticioso importante) y genera una puntuación de confianza. Tener mucha confianza significa aumentar agresivamente el tamaño de la posición. Un nivel bajo de confianza significa que pasas o apuestas poco.
Este enfoque reconoce una idea crucial: saber cuándo es probable que tengas razón suele ser más valioso que intentar tener razón con mayor frecuencia. Es la diferencia entre ser un buen pronosticador y ser un operador rentable. Muchas estrategias fracasan no porque sus predicciones direccionales sean deficientes, sino porque apuestan la misma cantidad a señales de alta y baja confianza.
Cada método de etiquetado enseña a tu modelo lecciones diferentes. Los métodos de horizonte fijo se centran en la dirección pura de los precios. Los métodos de triple barrera incorporan la gestión de riesgos y la dependencia de la trayectoria. El análisis de tendencias se adapta a las diferentes condiciones del mercado. El metaetiquetado optimiza el grado de confianza y el tamaño de la posición. El método que elijas influye fundamentalmente en lo que aprende tu modelo y en cómo se comporta en las operaciones reales.
Consideraciones clave al trabajar con datos financieros
- Evita el sesgo retrospectivo: Asegúrate de que tus etiquetas se basen únicamente en la información disponible hasta el momento de la decisión. Por ejemplo, al etiquetar un punto de datos para "hoy", solo se puede usar información de "hoy" o anterior para determinar las características, y la información del "futuro" (en relación con "hoy") para determinar la etiqueta.
- Equilibra tus clases: Si estás clasificando las operaciones en «comprar», «vender» y «mantener», es posible que observes que las señales de «mantener» (o los movimientos pequeños) son mucho más frecuentes. Las clases muy desequilibradas pueden dificultar que los modelos de aprendizaje automático aprendan sobre las clases minoritarias. Existen técnicas para abordar este problema (por ejemplo, sobremuestreo, submuestreo o el uso de métricas de evaluación adecuadas).
- La volatilidad es clave: La volatilidad de los mercados financieros varía constantemente. Una variación del precio del 2% puede ser enorme en un mercado tranquilo, pero insignificante durante un período de volatilidad. Considera la posibilidad de utilizar umbrales ajustados a la volatilidad para sus etiquetas (como en el método de triple barrera).
- Estacionariedad: Las series temporales financieras suelen ser no estacionarias (sus propiedades estadísticas, como la media y la varianza, varían con el tiempo). Aunque el mero hecho de asignar etiquetas no hace que los datos sean estacionarios de forma directa, la elección de las etiquetas (por ejemplo, etiquetar las rentabilidades, que suelen ser más estacionarias que los precios) y la posterior ingeniería de características son fundamentales.
- Repetir y perfeccionar: Es posible que tu primer método de etiquetado no sea el mejor. Prepárate para probar diferentes métodos, horizontes y umbrales para ver qué es lo que mejor se adapta a tus objetivos concretos y a los activos que estás analizando.
Implementación: Método de etiquetado de triple barrera
Establecer barreras dinámicas
Como se argumentó en la sección anterior, en la práctica queremos establecer límites de toma de ganancias y de stop-loss que sean función de los riesgos que implica una apuesta. De lo contrario, a veces fijaremos objetivos demasiado altos (𝜏 ≫ 𝜎ti,0) y otras veces demasiado bajos (𝜏 ≪ 𝜎ti,0), teniendo en cuenta la volatilidad imperante.
El código que se muestra a continuación calcula la volatilidad diaria en puntos de estimación intradiarios, aplicando un intervalo de días de retrospectiva a una desviación estándar móvil ponderada exponencialmente. Esta volatilidad se utilizará para establecer los límites de toma de ganancias y de stop-loss.
def get_daily_vol(close, lookback=100):
    """
    Advances in Financial Machine Learning, Snippet 3.1, page 44.

    Daily Volatility Estimates

    Computes the daily volatility at intraday estimation points.

    In practice we want to set profit taking and stop-loss limits that are a function of the risks involved
    in a bet. Otherwise, sometimes we will be aiming too high (tao ≫ sigma_t_i,0), and sometimes too low
    (tao ≪ sigma_t_i,0), considering the prevailing volatility. Snippet 3.1 computes the daily volatility
    at intraday estimation points, applying a span of lookback days to an exponentially weighted moving
    standard deviation.

    See the pandas documentation for details on the pandas.Series.ewm function.
    Note: This function is used to compute dynamic thresholds for profit taking and stop loss limits.

    :param close: (pd.Series) Closing prices
    :param lookback: (int) Lookback period to compute volatility
    :return: (pd.Series) Daily volatility value
    """
    # Find previous valid trading day for each date
    prev_idx = close.index.searchsorted(close.index - pd.Timedelta(days=1))
    prev_idx = prev_idx[prev_idx > 0]  # Drop indices before the start

    # Align current and previous closes
    curr_idx = close.index[close.shape[0] - prev_idx.shape[0] :]
    prev_close = close.iloc[prev_idx - 1].values  # Previous day's close
    ret = close.loc[curr_idx] / prev_close - 1
    vol = ret.ewm(span=lookback).std()
    return vol
Establecer barreras verticales
Para establecer las barreras verticales utilizamos la siguiente función. Al utilizar barras basadas en la actividad, tiene más sentido que las barreras se basen en el número de barras restantes hasta su vencimiento, en lugar de un período fijo, ya que puede haber una variabilidad extrema dentro de un horizonte temporal.
# Snippet 3.4 page 49, Adding a Vertical Barrier
def add_vertical_barrier(t_events, close, num_bars=0, **time_delta_kwargs):
    """
    Advances in Financial Machine Learning, Enhanced Implementation.

    Adding a Vertical Barrier

    For each event in t_events, finds the timestamp of the next price bar at or immediately after:
    - A fixed number of bars (for activity-based sampling), OR
    - A time delta (for time-based sampling)

    This function creates a series of vertical barrier timestamps aligned with the original events index.
    Out-of-bound barriers are marked with NaT for downstream handling.

    :param t_events: (pd.Series) Series of event timestamps (e.g., from symmetric CUSUM filter)
    :param close: (pd.Series) Close price series with DateTimeIndex
    :param num_bars: (int) Number of bars for vertical barrier (activity-based mode).
                     Takes precedence over time delta parameters when > 0.
    :param time_delta_kwargs: Time components for time-based barrier (mutually exclusive with num_bars):
        :param days: (int) Number of days
        :param hours: (int) Number of hours
        :param minutes: (int) Number of minutes
        :param seconds: (int) Number of seconds
    :return: (pd.Series) Vertical barrier timestamps with same index as t_events.
             Out-of-bound events return pd.NaT.

    Example:
        # Activity-bar mode (tick/volume/dollar bars)
        vertical_barriers = add_vertical_barrier(t_events, close, num_bars=10)

        # Time-based mode
        vertical_barriers = add_vertical_barrier(t_events, close, days=1, hours=3)
    """
    # Validate inputs
    if num_bars and time_delta_kwargs:
        raise ValueError("Use either num_bars OR time deltas, not both")

    # BAR-BASED VERTICAL BARRIERS
    if num_bars > 0:
        indices = close.index.get_indexer(t_events, method="nearest")
        t1 = []
        for i in indices:
            if i == -1:  # Event not found
                t1.append(pd.NaT)
            else:
                end_loc = i + num_bars
                t1.append(close.index[end_loc] if end_loc < len(close) else pd.NaT)
        return pd.Series(t1, index=t_events)

    # TIME-BASED VERTICAL BARRIERS
    td = pd.Timedelta(**time_delta_kwargs) if time_delta_kwargs else pd.Timedelta(0)
    barrier_times = t_events + td

    # Find next index positions
    t1_indices = np.searchsorted(close.index, barrier_times, side="left")
    t1 = []
    for idx in t1_indices:
        if idx < len(close):
            t1.append(close.index[idx])
        else:
            t1.append(pd.NaT)  # Mark out-of-bound for downstream

    return pd.Series(t1, index=t_events)
Aplicación del etiquetado de triple barrera
El método de triple barrera depende intrínsecamente de la trayectoria, lo que significa que no podemos simplemente fijarnos en el precio final para determinar nuestra etiqueta. En cambio, debemos hacer un seguimiento de toda la evolución del precio desde el momento en que abrimos una posición hasta que la cerramos, ya sea porque se ha alcanzado un objetivo de beneficios, un stop loss o un límite de tiempo.
Cuando aplicamos el método de la triple barrera, lo que estamos preguntando, en esencia, es: «Partiendo del instante ti,0, ¿qué ocurre primero a medida que avanzamos en el tiempo?». El proceso continúa hasta que llegamos a ti,1, que representa el momento en que se alcanza la primera barrera. Esto podría ser nuestro objetivo de beneficios, nuestro stop loss o nuestro periodo máximo de tenencia (la barrera vertical fijada en ti,0 + h). El retorno que utilizamos para el etiquetado se calcula a partir de nuestro punto de entrada ti,0 hasta este primer momento de contacto ti,1.
La función apply_pt_sl_on_t1() implementa esta lógica y requiere varias entradas para funcionar correctamente. En primer lugar, necesita la serie de precios de cierre para poder seguir la evolución real del precio. El marco de datos «events» contiene la información esencial de cada operación potencial: la columna «t1» especifica cuándo debe vencer cada operación (la barrera vertical), mientras que la columna trgt define la amplitud que deben tener nuestras barreras horizontales.
El parámetro pt_sl es especialmente importante. Es una lista de dos elementos que controla la anchura de las barreras. El primer elemento (pt_sl[0]) establece cuántos múltiplos del ancho objetivo se deben utilizar para el límite de toma de beneficios, mientras que el segundo elemento (pt_sl[1]) hace lo mismo para el límite de corte de pérdidas. Si alguno de los valores es cero, esa barrera en particular queda desactivada. Esta flexibilidad permite crear configuraciones asimétricas de riesgo/recompensa. Por ejemplo, podrías establecer un límite de pérdidas ajustado, pero dejar que las ganancias sigan aumentando.
Esta función procesa sistemáticamente estas barreras, haciendo un seguimiento de los movimientos de precios barra por barra hasta que se supera una de ellas, lo que nos proporciona la información precisa sobre el momento y el retorno necesaria para un etiquetado exacto.
# Snippet 3.2, page 45, Triple Barrier Labeling Method
def apply_pt_sl_on_t1(close, events, pt_sl, molecule):
    """
    Advances in Financial Machine Learning, Snippet 3.2, page 45.

    Triple Barrier Labeling Method

    This function applies the triple-barrier labeling method. It works on a set of
    datetime index values (molecule). This allows the program to parallelize the processing.

    Mainly it returns a DataFrame of timestamps regarding the time when the first barriers were reached.

    :param close: (pd.Series) Close prices
    :param events: (pd.Series) Indices that signify "events" (see cusum_filter function for more details)
    :param pt_sl: (np.array) Element 0, indicates the profit taking level; Element 1 is stop loss level
    :param molecule: (an array) A set of datetime index values for processing
    :return: (pd.DataFrame) Timestamps of when first barrier was touched
    """
    # Apply stop loss/profit taking, if it takes place before t1 (end of event)
    events = events.loc[molecule].copy()
    out = events[["t1"]].copy(deep=True)

    profit_taking_multiple = pt_sl[0]
    stop_loss_multiple = pt_sl[1]

    # Profit taking active
    if profit_taking_multiple > 0:
        profit_taking = np.log(1 + profit_taking_multiple * events["trgt"])
    else:
        profit_taking = pd.Series(index=events.index)  # NaNs

    # Stop loss active
    if stop_loss_multiple > 0:
        stop_loss = np.log(1 - stop_loss_multiple * events["trgt"])
    else:
        stop_loss = pd.Series(index=events.index)  # NaNs

    # Use dictionary to collect barrier hit times
    barrier_dict = {"sl": {}, "pt": {}}

    # Get events
    for loc, vertical_barrier in events["t1"].fillna(close.index[-1]).items():
        closing_prices = close[loc:vertical_barrier]  # Path prices for a given trade
        cum_returns = np.log(closing_prices / close[loc]) * events.at[loc, "side"]  # Path returns
        barrier_dict["sl"][loc] = cum_returns[
            cum_returns < stop_loss[loc]
        ].index.min()  # Earliest stop loss date
        barrier_dict["pt"][loc] = cum_returns[
            cum_returns > profit_taking[loc]
        ].index.min()  # Earliest profit taking date

    # Convert dictionary to DataFrame and join to `out`
    barrier_df = pd.DataFrame(barrier_dict)
    out = out.join(barrier_df)  # Join on index (loc)

    return out
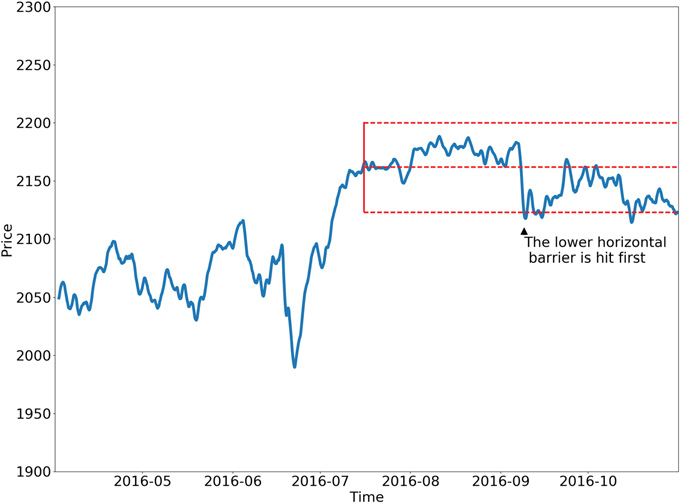
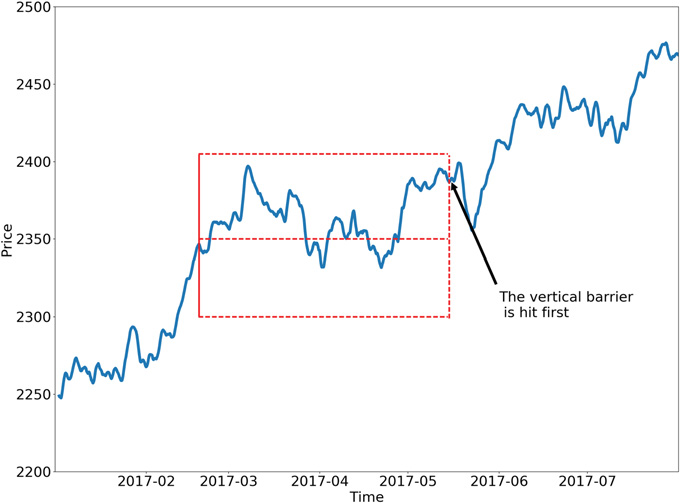
El método de triple barrera ofrece ocho configuraciones posibles, dependiendo de qué barreras se activen. Piensa en cada configuración como [objetivo_de_ganancias, límite_de_pérdidas, límite_de_tiempo], donde 1 significa activo y 0 significa deshabilitado.
- La mayoría de las estrategias de trading prácticas utilizan una de tres configuraciones:
- [1,1,1] - Configuración completa: Las tres barreras activas. Buscas obtener beneficios gestionando tanto el riesgo a la baja como el plazo de tenencia. Esto refleja la forma en que operan la mayoría de los operadores profesionales.
- [0,1,1] - Dejar correr a los ganadores: Sin objetivo de ganancias, pero saldrás después de X períodos a menos que se active el stop antes. Ideal para estrategias de impulso en las que se busca aprovechar las tendencias.
- [1,1,0] - Sin presión de tiempo: Objetivo de ganancias y límite de pérdidas activos, pero sin límite de tiempo. Mantendrás la posición hasta que se alcance uno de los límites de precio, sin importar cuánto tiempo tome.
- Tres configuraciones técnicamente posibles pero menos realistas:
- [0,0,1] - Horizonte fijo: Solo salidas basadas en el tiempo. Se trata esencialmente de un etiquetado con un horizonte temporal fijo, aunque también puede funcionar con barras basadas en la actividad.
- [1,0,1] - Ignorar pérdidas: Mantener hasta que sea rentable o se acabe el tiempo, independientemente de las pérdidas intermedias. Peligroso para la gestión de riesgos.
- [1,0,0] - Mantener indefinidamente: Sin límite de pérdidas ni límite de tiempo. Mantener posiciones perdedoras hasta que eventualmente se vuelvan rentables: una receta para la destrucción de la cartera de inversiones.
- Dos configuraciones esencialmente inútiles:
- [0,1,0] - Anticipando el fracaso: Mantenga las posiciones hasta que alcancen el stop loss. ¿Por qué entrar en operaciones esperando solo pérdidas?
- [0,0,0] - Sin salida: Todas las barreras desactivadas. Las posiciones nunca se cierran y no se generan etiquetas.
A continuación se muestran dos posibles configuraciones del método de triple barrera.
Aprendizaje para el lado y el tamaño
Las funciones de esta sección utilizan el método de triple barrera para aprender el lado, {1, 0, -1}, cuando side_prediction = None en get_events(), o para aprender el tamaño a partir de los datos metaetiquetados cuando se conoce el lado. Aprender el lado de la apuesta implica que no haya barreras horizontales o que estas sean simétricas. Esto se debe a que, en este momento, no podemos distinguir entre los niveles de toma de beneficios y los de stop-loss. Una vez conocido el lado de la operación, podemos optimizar las barreras para averiguar qué combinación da como resultado el modelo más eficaz. Obtenemos las fechas de la primera barrera tocada ejecutando get_events().
# Snippet 3.3 -> 3.6 page 50, Getting the Time of the First Touch, with Meta Labels
def get_events(close, t_events, pt_sl, target, min_ret, num_threads, vertical_barrier_times=False,
               side_prediction=None, verbose=True):
    """
    Advances in Financial Machine Learning, Snippet 3.6 page 50.

    Getting the Time of the First Touch, with Meta Labels

    This function is orchestrator to meta-label the data, in conjunction with the Triple Barrier Method.

    :param close: (pd.Series) Close prices
    :param t_events: (pd.Series) of t_events. These are timestamps that will seed every triple barrier.
        These are the timestamps selected by the sampling procedures discussed in Chapter 2, Section 2.5.
        E.g.: CUSUM Filter
    :param pt_sl: (list) Element 0, indicates the profit taking level; Element 1 is stop loss level.
        A non-negative float that sets the width of the two barriers. A 0 value means that the respective
        horizontal barrier (profit taking and/or stop loss) will be disabled.
    :param target: (pd.Series) of values that are used (in conjunction with pt_sl) to determine the width
        of the barrier. In this program this is daily volatility series.
    :param min_ret: (float) The minimum target return required for running a triple barrier search.
    :param num_threads: (int) The number of threads concurrently used by the function.
    :param vertical_barrier_times: (pd.Series) A pandas series with the timestamps of the vertical barriers.
        We pass a False when we want to disable vertical barriers.
    :param side_prediction: (pd.Series) Side of the bet (long/short) as decided by the primary model
    :param verbose: (bool) Flag to report progress on asynch jobs
    :return: (pd.DataFrame) Events
            -events.index is event's starttime
            -events['t1'] is event's endtime
            -events['trgt'] is event's target
            -events['side'] (optional) implies the algo's position side
            -events['pt'] is profit taking multiple
            -events['sl']  is stop loss multiple
    """

    # 1) Get target
    target = target.reindex(t_events)
    target = target[target > min_ret]  # min_ret

    # 2) Get vertical barrier (max holding period)
    if vertical_barrier_times is False:
        vertical_barrier_times = pd.Series(pd.NaT, index=t_events, dtype=t_events.dtype)

    # 3) Form events object, apply stop loss on vertical barrier
    if side_prediction is None:
        side_ = pd.Series(1.0, index=target.index)
        pt_sl_ = [pt_sl[0], pt_sl[0]]
    else:
        side_ = side_prediction.reindex(target.index)  # Subset side_prediction on target index.
        pt_sl_ = pt_sl[:2]

    # Create a new df with [v_barrier, target, side] and drop rows that are NA in target
    events = pd.concat({'t1': vertical_barrier_times, 'trgt': target, 'side': side_}, axis=1)
    events = events.dropna(subset=['trgt'])

    # Apply Triple Barrier
    first_touch_dates = mp_pandas_obj(func=apply_pt_sl_on_t1,
                                      pd_obj=('molecule', events.index),
                                      num_threads=num_threads,
                                      close=close,
                                      events=events,
                                      pt_sl=pt_sl_,
                                      verbose=verbose)

    for ind in events.index:
        events.at[ind, 't1'] = first_touch_dates.loc[ind, :].dropna().min()

    if side_prediction is None:
        events = events.drop('side', axis=1)

    # Add profit taking and stop loss multiples for vertical barrier calculations
    events['pt'] = pt_sl[0]
    events['sl'] = pt_sl[1]

    return events
Utilizamos get_bins() para obtener un dataframe events en el que:
- events.index es la hora de inicio del evento
- events['t1'] es la hora de finalización del evento
- events['trgt'] es el objetivo del evento
- events['side'] (opcional) indica el lado de la posición de la estrategia
- Caso 1: Si «side» no aparece en los eventos → bin ∈ {-1, 1} (etiqueta según la evolución del precio)
- Caso 2: Si «side» está presente → bin ∈ {0, 1} (etiqueta según PnL — metaetiquetado)
# Snippet 3.4 -> 3.7, page 51, Labeling for Side & Size with Meta Labels
def get_bins(triple_barrier_events, close, vertical_barrier_zero=False, pt_sl=[1, 1]):
    """
    Advances in Financial Machine Learning, Snippet 3.7, page 51.

    Labeling for Side & Size with Meta Labels

    Compute event's outcome (including side information, if provided).
    events is a DataFrame where:

    Now the possible values for labels in out['bin'] are {0,1}, as opposed to whether to take the bet or pass,
    a purely binary prediction. When the predicted label the previous feasible values {−1,0,1}.
    The ML algorithm will be trained to decide is 1, we can use the probability of this secondary prediction
    to derive the size of the bet, where the side (sign) of the position has been set by the primary model.

    :param triple_barrier_events: (pd.DataFrame) Events DataFrame with the following structure:
    - **index**: pd.DatetimeIndex of event start times
    - **t1**: (pd.Series) Event end times
    - **trgt**: (pd.Series) Target returns
    - **side**: (pd.Series, optional) Algo's position side
      Labeling behavior depends on the presence of 'side':
        - Case 1: If 'side' not in events → `bin ∈ {-1, 1}` (label by price action)
        - Case 2: If 'side' is present    → `bin ∈ {0, 1}`  (label by PnL — meta-labeling)
    :param close: (pd.Series) Close prices
    :param vertical_barrier_zero: (bool) If True, set bin to 0 for events that touch vertical barrier, else bin is the sign of the return.
    :param pt_sl: (list) Take-profit and stop-loss multiples
    :return: (pd.DataFrame) Meta-labeled events
    :returns index: Event start times
    :returns t1: Event end times
    :returns trgt: Target returns
    :returns side: Optional. Algo's position side
    :returns ret: Returns of the event
    :returns bin: Labels for the event, where 1 is a positive return, -1 is a negative return, and 0 is a vertical barrier hit
    """

    # 1. Align prices with their respective events
    events = triple_barrier_events.dropna(subset=["t1"])
    all_dates = events.index.union(other=events["t1"].array).drop_duplicates()
    prices = close.reindex(all_dates, method="bfill")

    # 2. Create out DataFrame
    out_df = events[["t1"]].copy()
    out_df["ret"] = np.log(prices.loc[events["t1"].array].array / prices.loc[events.index])
    out_df["trgt"] = events["trgt"]

    # Meta labeling: Events that were correct will have pos returns
    if "side" in events:
        out_df["ret"] *= events["side"]  # meta-labeling

    if vertical_barrier_zero:
        # Label 0 when vertical barrier reached
        out_df["bin"] = barrier_touched(
            out_df["ret"].values,
            out_df["trgt"].values,
            np.array(pt_sl, dtype=float),
        )
    else:
        # Label is the sign of the return
        out_df["bin"] = np.where(out_df["ret"] > 0, 1, -1).astype("int8")

    # Meta labeling: label incorrect events with a 0
    if "side" in events:
        out_df.loc[out_df["ret"] <= 0, "bin"] = 0

    # Add the side to the output. This is useful for when a meta label model must be fit
    if "side" in triple_barrier_events.columns:
        out_df["side"] = triple_barrier_events["side"].astype("int8")

    out_df["ret"] = np.exp(out_df["ret"]) - 1  # Convert log returns to simple returns
    return out_df
NOTA: mp_pandas_obj() , tal y como se ha utilizado anteriormente, es una función auxiliar que facilita el procesamiento paralelo al trabajar con objetos de pandas (pandas siempre se ejecuta en una sola CPU). El archivo adjunto multiprocess.py contiene esta función y otras funciones auxiliares para el multiprocesamiento.
Para poner la etiqueta a cero cuando se alcanza primero la barrera vertical, llamamos a barrier_touched() en get_bins().
# Snippet 3.9, page 55, Question 3.3
def barrier_touched(ret, target, pt_sl):
    """
    Advances in Financial Machine Learning, Snippet 3.9, page 55, Question 3.3.

    Adjust the getBins function (Snippet 3.7) to return a 0 whenever the vertical barrier is the one touched first.

    Top horizontal barrier: 1
    Bottom horizontal barrier: -1
    Vertical barrier: 0

    :param ret: (np.array) Log-returns
    :param target: (np.array) Volatility target
    :param pt_sl: (ArrayLike) Take-profit and stop-loss multiples
    :return: (np.array) Labels
    """
    N = ret.shape[0]  # Number of events
    store = np.empty(N, dtype=np.int8)  # Store labels in an array

    profit_taking_multiple = pt_sl[0]
    stop_loss_multiple = pt_sl[1]

    # Iterate through the DataFrame and check if the vertical barrier was reached
    for i in range(N):
        pt_level_reached = ret[i] > np.log(1 + profit_taking_multiple * target[i])
        sl_level_reached = ret[i] < np.log(1 - stop_loss_multiple * target[i])

        if ret[i] > 0.0 and pt_level_reached:
            # Top barrier reached
            store[i] = 1
        elif ret[i] < 0.0 and sl_level_reached:
            # Bottom barrier reached
            store[i] = -1
        else:
            # Vertical barrier reached
            store[i] = 0

    return store
Cuándo marcar como «cero» o como «signo de la rentabilidad»
Asignar un valor cero a un evento que no toca ninguna barrera tiene sentido cuando se quiere que el modelo se centre estrictamente en resultados claros y gestionados en función del riesgo, , mientras que utilizar el signo de la rentabilidad en el horizonte permite captar toda la deriva direccional, incluso si no se superan los umbrales de riesgo.
Marcar como cero si:
- Estás creando un clasificador de tres clases («al alza», «a la baja» y «neutral») y quieres que «neutral» signifique «sin movimiento decisivo» dentro de tus límites de riesgo.
- Prefieres descartar del entrenamiento las señales ambiguas —pequeñas desviaciones que nunca tocan ninguna de las dos barreras—.
- Quieres medir el éxito de un evento basándote únicamente en si se alcanzan los umbrales de beneficios o pérdidas predefinidos, sin tener en cuenta ningún otro caso.
Etiquetar según el signo del retorno si:
- Es necesario que cada muestra tenga una dirección binaria (arriba/abajo) en un problema de dos clases y se quiere evitar un exceso de etiquetas neutras.
- Estás modelando el impulso o la rentabilidad en un horizonte temporal, en lugar de salidas estrictamente controladas en función del riesgo.
- Consideras que la evolución de los precios —por pequeña que sea— es reveladora y debería influir en tu estimación.
Más allá de esta elección, ten en cuenta cómo afecta al equilibrio entre clases y al ruido de las etiquetas. Si ves demasiados ceros, es posible que submuestrees los valores neutros o que aumentes tus barreras horizontales, y si tus etiquetas de «signo de retorno» tienen demasiado ruido, podrías aplicar un umbral mínimo de retorno antes de asignar +1/−1.
Muestreo basado en eventos
Como operadores, no decidimos al azar cuándo comprar o vender valores. En cambio, esperamos a que ocurran cosas específicas en el mercado antes de tomar nuestras decisiones. Estos "acontecimientos desencadenantes" podrían incluir:
- Cuando se publican datos económicos importantes (como cifras de empleo o informes de inflación)
- Cuando los precios del mercado se vuelven repentinamente muy inestables
- Cuando la diferencia de precio entre inversiones relacionadas se aleja mucho de lo que normalmente se espera
Cuando se produce uno de estos eventos, lo interpretamos como una señal de que algo importante podría estar ocurriendo en el mercado. Entonces podremos dejar que nuestros algoritmos determinen si existe una función predictiva fiable en esas circunstancias.
La idea clave es averiguar si existe una forma precisa de predecir los movimientos del mercado específicamente cuando ocurren estos eventos. Si el algoritmo muestra que un tipo particular de evento no conduce a predicciones precisas, entonces debemos cambiar la forma en que definimos qué se considera un evento significativo, o intentarlo de nuevo utilizando diferentes características como entradas para el modelo.
El filtro CUSUM
Una técnica eficaz para el muestreo basado en eventos es el filtro CUSUM, un método de control de calidad utilizado para detectar cambios en el valor medio de una magnitud medida. En finanzas, podemos adaptar este filtro para muestrear puntos de datos siempre que se produzca una desviación significativa en una variable de mercado, como el precio. El filtro CUSUM funciona acumulando las desviaciones respecto a un valor esperado y activando un evento de muestreo cuando esta acumulación supera un determinado umbral.
El filtro CUSUM simétrico se define de la siguiente manera:
-
S⁺ = max(0, S⁺ + ΔP)
-
S⁻ = min(0, S⁻ + ΔP)
Donde ΔP es el cambio de precio. Un evento se activa cuando S⁺ supera un umbral positivo h o cuando S⁻ cae por debajo de un umbral negativo -h. Cuando se activa un evento, el acumulador correspondiente se pone a cero. Este método evita que se activen múltiples eventos cuando el precio oscila en torno a un umbral, un defecto habitual en señales de mercado muy utilizadas, como las bandas de Bollinger. Mediante el uso de un filtro CUSUM, podemos crear una matriz de características X que se muestrea en momentos de actividad de mercado significativa, lo que proporciona datos más relevantes para nuestros modelos de aprendizaje automático.
# Snippet 2.4, page 39, The Symmetric CUSUM Filter.
def cusum_filter(raw_time_series, threshold, time_stamps=True):
    """
    Advances in Financial Machine Learning, Snippet 2.4, page 39.

    The Symmetric Dynamic/Fixed CUSUM Filter.

    The CUSUM filter is a quality-control method, designed to detect a shift in the mean value of a measured quantity
    away from a target value. The filter is set up to identify a sequence of upside or downside divergences from any
    reset level zero. We sample a bar t if and only if S_t >= threshold, at which point S_t is reset to 0.

    One practical aspect that makes CUSUM filters appealing is that multiple events are not triggered by raw_time_series
    hovering around a threshold level, which is a flaw suffered by popular market signals such as Bollinger Bands.
    It will require a full run of length threshold for raw_time_series to trigger an event.

    Once we have obtained this subset of event-driven bars, we will let the ML algorithm determine whether the occurrence
    of such events constitutes actionable intelligence. Below is an implementation of the Symmetric CUSUM filter.

    Note: As per the book this filter is applied to closing prices but we extended it to also work on other
    time series such as volatility.

    :param raw_time_series: (pd.Series) Close prices (or other time series, e.g. volatility).
    :param threshold: (float or pd.Series) When the abs(change) is larger than the threshold, the function captures
                      it as an event, can be dynamic if threshold is pd.Series
    :param time_stamps: (bool) Default is to return a DateTimeIndex, change to false to have it return a list.
    :return: (datetime index vector) Vector of datetimes when the events occurred. This is used later to sample.
    """

    t_events = []
    s_pos = 0
    s_neg = 0

    # log returns
    raw_time_series = pd.DataFrame(raw_time_series)  # Convert to DataFrame
    raw_time_series.columns = ['price']
    raw_time_series['log_ret'] = raw_time_series.price.apply(np.log).diff()
    if isinstance(threshold, (float, int)):
        raw_time_series['threshold'] = threshold
    elif isinstance(threshold, pd.Series):
        raw_time_series.loc[threshold.index, 'threshold'] = threshold
    else:
        raise ValueError('threshold is neither float nor pd.Series!')

    raw_time_series = raw_time_series.iloc[1:]  # Drop first na values

    # Get event time stamps for the entire series
    for tup in raw_time_series.itertuples():
        thresh = tup.threshold
        pos = float(s_pos + tup.log_ret)
        neg = float(s_neg + tup.log_ret)
        s_pos = max(0.0, pos)
        s_neg = min(0.0, neg)

        if s_neg < -thresh:
            s_neg = 0
            t_events.append(tup.Index)

        elif s_pos > thresh:
            s_pos = 0
            t_events.append(tup.Index)

    # Return DatetimeIndex or list
    if time_stamps:
        event_timestamps = pd.DatetimeIndex(t_events)
        return event_timestamps

    return t_events
Analicemos el rendimiento de una estrategia de bandas de Bollinger con reversión a la media al utilizar señales de entrada sin filtrar frente a señales filtradas con CUSUM. Utilizaremos barras temporales de 5 minutos de EURUSD desde el 1 de enero de 2018 hasta el 31 de diciembre de 2021 para entrenamiento y validación, y datos desde el 1 de enero de 2022 hasta el 31 de diciembre de 2024 para pruebas fuera de muestra.
Para los fines de esta demostración, utilizaremos una configuración de bandas de Bollinger deliberadamente sensible (20 períodos, 1,5 desviaciones estándar) para generar un alto volumen de señales de trading que el metamodelo pueda evaluar. Si bien esto resultaría excesivamente ruidoso para una estrategia independiente, proporciona una prueba de estrés ideal para nuestro proceso de etiquetado y filtrado.
Para garantizar la coherencia y la interoperabilidad en todas las estrategias, prefiero estructurarlas utilizando el diseño orientado a objetos de Python, concretamente a través de una interfaz o clase base compartida. Este enfoque permite que cada estrategia exponga la misma funcionalidad básica (por ejemplo, generación de señales, filtrado de eventos), lo que facilita su comparación, ampliación e integración en flujos de trabajo más amplios. El uso de TA-Lib y Pandas TA para la generación de señales de uso habitual resulta ventajoso, ya que ambas bibliotecas se apoyan en un backend en C altamente optimizado, lo que las hace entre 2 y 4 veces más rápido que las implementaciones equivalentes en Python y garantiza que los resultados estén estandarizados y que los casos extremos se traten de forma coherente, lo que simplifica las tareas posteriores, como el etiquetado, el filtrado o la visualización. A veces, instalar esta biblioteca puede resultar complicado, por lo que te recomiendo que sigas las instrucciones de este artículo.
import pandas as pd
from typing import Tuple, Union
import logging

from abc import ABC, abstractmethod
from typing import Dict, Tuple, Union

import numpy as np
import pandas as pd
import talib
from loguru import logger

class BaseStrategy(ABC):
    """Abstract base class for trading strategies"""

    @abstractmethod
    def generate_signals(self, data: pd.DataFrame) -> pd.Series:
        """Generate trading signals (1 for long, -1 for short, 0 for no position)"""
        pass

    @abstractmethod
    def get_strategy_name(self) -> str:
        """Return strategy name"""
        pass

    @abstractmethod
    def get_objective(self) -> str:
        """Return strategy objective"""
        pass

class BollingerMeanReversionStrategy(BaseStrategy):
    """Bollinger Bands mean reversion strategy"""

    def __init__(self, window: int = 20, num_std: float = 2.0, objective: str = "mean_reversion"):
        self.window = window
        self.num_std = num_std
        self.objective = objective

    def generate_signals(self, data: pd.DataFrame) -> pd.Series:
        """Generate mean-reversion signals using Bollinger Bands"""
        close = data["close"]

        # Calculate Bollinger Bands
        upper_band, _, lower_band = talib.BBANDS(
            close, timeperiod=self.window, nbdevup=self.num_std, nbdevdn=self.num_std
        )

        # Generate signals
        signals = pd.Series(0, index=data.index, dtype="int8", name="side")
        signals[(close >= upper_band)] = -1  # Sell signal (mean reversion)
        signals[(close <= lower_band)] = 1  # Buy signal (mean reversion)
        return signals

    def get_strategy_name(self) -> str:
        return f"Bollinger_w{self.window}_std{self.num_std}"

    def get_objective(self) -> str:
        return self.objective

def get_entries(
    strategy: 'BaseStrategy',
    data: pd.DataFrame,
    filter_events: bool = False,
    filter_threshold: Union[float, pd.Series] = None,
    on_crossover: bool = True,
) -> Tuple[pd.Series, pd.DatetimeIndex]:
    """Get timestamps and position information for entry events.

    This function processes signals from a given `BaseStrategy` to identify trade
    entry points. It can apply a CUSUM filter to isolate significant events or,
    by default, detect entries at signal crossover points.

    Args:
        strategy (BaseStrategy): The trading strategy object that generates the
            primary signals.
        data (pd.DataFrame): A pandas DataFrame containing the input data, expected
            to have a 'close' column if `filter_events` is True.
        filter_events (bool, optional): If True, a CUSUM filter is applied to the
            signals to identify significant events. Defaults to False.
        filter_threshold (Union[float, pd.Series], optional): The threshold for the
            CUSUM filter. Must be a float or a pandas Series. Defaults to None.
        on_crossover (bool, optional): If True, only events where the signal changes
            from the previous period are considered entry points. Defaults to True.

    Raises:
        ValueError: If `filter_events` is True and `filter_threshold` is not a
            `float` or `pd.Series`.

    Returns:
        Tuple[pd.Series, pd.DatetimeIndex]: A tuple containing:
            side (pd.Series): A Series with the same index as the input data,
                where each value represents the trading position (-1 for short,
                1 for long, 0 for no position).
            t_events (pd.DatetimeIndex): A DatetimeIndex of the timestamps for
                each detected entry event.
    """
    primary_signals = strategy.generate_signals(data)
    signal_mask = primary_signals != 0

    # Vectorized CUSUM filter application
    if filter_events:
        try:
            close = data.close
        except AttributeError as e:
            logger.error(f"Dataframe must have a 'close' column: {e}")
            raise e

        if not isinstance(filter_threshold, (pd.Series, float)):
            raise ValueError("filter_threshold must be a Series or a float")
        elif isinstance(filter_threshold, pd.Series):
            filter_threshold = filter_threshold.copy().dropna()
            close = close.reindex(filter_threshold.index)

        # Assuming cusum_filter is a function that takes a Series and a threshold
        filtered_events = cusum_filter(close, filter_threshold)
        signal_mask &= primary_signals.index.isin(filtered_events)
    else:
        # Vectorized signal change detection
        if on_crossover:
            signal_mask &= primary_signals != primary_signals.shift()

    t_events = primary_signals.index[signal_mask]

    side = pd.Series(index=data.index, name="side")
    side.loc[t_events] = primary_signals.loc[t_events]
    side = side.ffill().fillna(0).astype("int8")

    if filter_events:
        s = " generated by CUSUM filter"
    elif on_crossover:
        s = " generated by crossover"
    else:
        s = ""

    logger.info(f"Generated {len(t_events):,} trade events{s}.")

    return side, t_events
Ingeniería de características para el metaetiquetado
Para capturar la dinámica matizada de las series temporales financieras, construimos un conjunto de características completo que combina el rigor estadístico con un conocimiento específico del dominio. Esto incluye indicadores de impulso ajustados a la volatilidad, estructuras de autocorrelación y momentos de retorno de orden superior (asimetría y curtosis), junto con métricas derivadas de Bollinger y diferenciales de medias móviles normalizadas. Las señales técnicas como RSI, MACD, ADX y ATR se extrajeron utilizando TA-Lib y pandas-ta, lo que garantiza la coherencia y la reproducibilidad. Al incorporar características tanto a corto como a largo plazo —que abarcan rentabilidades rezagadas, estimaciones de volatilidad de Yang-Zhang e indicadores de seguimiento de tendencias—, el modelo está preparado para detectar cambios sutiles en el comportamiento del mercado y responder a las condiciones de negociación cambiantes. El código se puede encontrar en el archivo adjunto features.py.
Para ilustrar la eficacia del filtro CUSUM, entrené un «random forest» utilizando señales sin filtrar y filtradas de nuestros datos del EURUSD en el gráfico M5. Establecí mis barreras horizontales utilizando como objetivo la volatilidad diaria ponderada exponencialmente a lo largo de 100 días, fijando la barrera de toma de beneficios en 1 y la barrera de stop-loss en 2. Mi barrera vertical estaba ajustada a 50 barras.
target = get_daily_vol(close, lookback=100)
cusum_filter_threshold = target.mean()
Efectos del filtrado de datos
Antes de entrar en detalle con nuestras comparativas de modelos, aquí tienes una breve introducción a los indicadores clave que figuran en cada tabla de clasificación:- Precision: Porcentaje de predicciones positivas correctas respecto al total de predicciones positivas. Una alta precisión implica pocas falsas alarmas.
- Recall: Proporción de positivos reales identificados correctamente. Una alta tasa de detección implica que se pierden pocos eventos.
- F1-score: Es posible que la exactitud (accuracy) no sea una métrica adecuada para las aplicaciones de metaetiquetado. Supongamos que, tras aplicar el metaetiquetado, hay muchos más casos negativos (etiqueta «0») que casos positivos (etiqueta «1»). En ese escenario, un clasificador que prediga que todos los casos son negativos alcanzará una alta precisión, aunque el recall sea 0 y la precisión no esté definida. La puntuación F1-score corrige ese defecto al evaluar el clasificador en función de la media armónica (con ponderación igual) de la precisión y el recall.
- Support: El número de instancias de cada clase en el conjunto de validación.
- Accuracy: Proporción global de aciertos en todas las clases.
Para obtener una explicación detallada de estas métricas, consulta «How to Interpret the Classification Report in sklearn».
Antes de comparar cualquier puntuación, fíjate en cómo el filtro CUSUM reduce el tamaño de la muestra en un 76,1 %.
| Señales sin filtrar | Señales filtradas | Porcentaje de reducción |
|---|---|---|
| 32828 | 7825 | 76,1 |
TABLA 0: Recuento de señales: filtradas frente a no filtradas
El filtro CUSUM tiene como objetivo eliminar el «ruido», que está intrínsecamente ligado a la dinámica de clase 0. El resultado ideal es mejorar el F1 para la clase 1 (mejor captura de eventos), al tiempo que se mantiene el F1 para la clase 0 (sin señales falsas añadidas). Nuestro modelo primario filtrado es ideal, pero nuestro metamodelo filtrado presenta una disminución del 5,8 % en el F1 para la clase 0. Para paliar esto, podríamos ajustar los hiperparámetros utilizados en el modelo o modificar nuestro conjunto de características.
| Métrica | Sin filtrar | Filtrado | Δ |
|---|---|---|---|
| Recall (1) | 1.00 | 1.00 | 0% |
| Precision (1) | 0.33 | 0.38 | +15.2% |
| F1 (1) | 0.49 | 0.55 | +11.0% |
| Métrica | Sin filtrar | Filtrado | Δ |
|---|---|---|---|
| F1 (0) | 0.69 | 0.65 | -5.8% |
| F1 (1) | 0.57 | 0.60 | +5.3% |
| Accuracy | 0.64 | 0.63 | -1.6% |
Tabla 4: Comparación de metamodelos filtrados y no filtrados
La relación entre la reducción de datos y el rendimiento del modelo puede calcularse de la siguiente manera:
- retención del rendimiento = rendimiento filtrado / rendimiento sin filtrar * 100
- beneficio neto = retención por rendimiento - reducción de datos
Si obtenemos un beneficio neto positivo, el filtro es eficiente y debería utilizarse.
| Modelo | Reducción de datos | Retención del rendimiento | Beneficio neto |
|---|---|---|---|
| Primario | 76.1% | 112.2% | +36.1% |
| Meta | 76.1% | 98.5% | +22.4% |
Tabla 5: Análisis del compromiso entre reducción de datos y rendimiento
Obtenemos las siguientes conclusiones al comparar las señales sin filtrar y filtradas:
- El filtro CUSUM descartó con éxito el 76,1% de los eventos como ruido.
- El filtrado mejoró la precisión tanto en el modelo primario como en el metamodelo.
- El filtrado solo degradó ligeramente el rendimiento general del metamodelo a pesar de contar con un 76 % menos de datos. Se observó una ganancia del 5,3 % para la clase 1 y una caída del 5,6 % para la clase 0. A pesar de la caída en la F1 de la clase 0, aún así se obtuvo un beneficio neto al utilizar el filtro CUSUM.
Informes de metaetiquetado: Estrategia de bandas de Bollinger
Los informes de clasificación y las curvas ROC que se muestran a continuación ponen de relieve una idea clave: el metaetiquetado funciona mejor cuando se combina con esquemas de etiquetado realistas y que tienen en cuenta los riesgos.
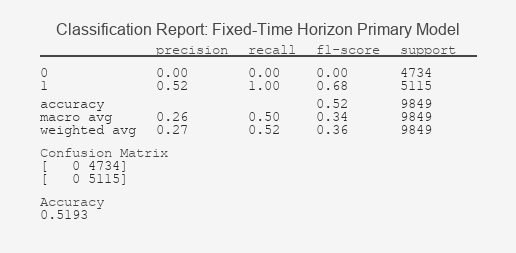
Figura 1: Horizonte temporal fijo Modelo principal Informe de clasificación
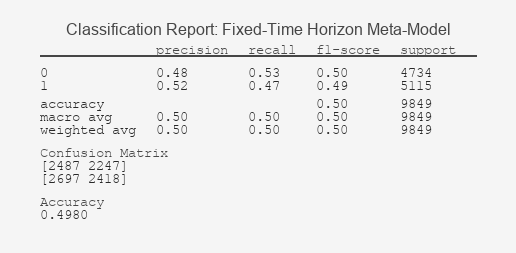
Figura 2: Horizonte temporal fijo Metamodelo Informe de clasificación
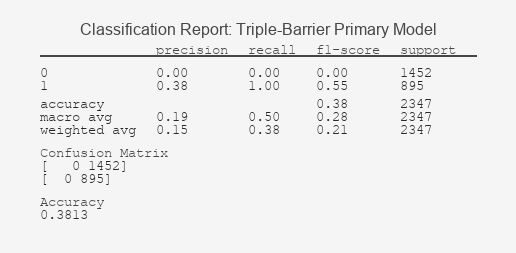
Figura 3: Barrera triple Informe de clasificación del modelo primario
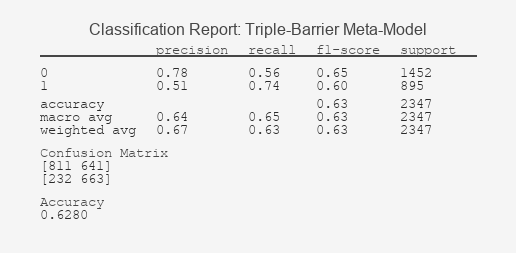
Figura 4: Barrera triple Metamodelo Informe de clasificación
Curvas de características operativas del receptor
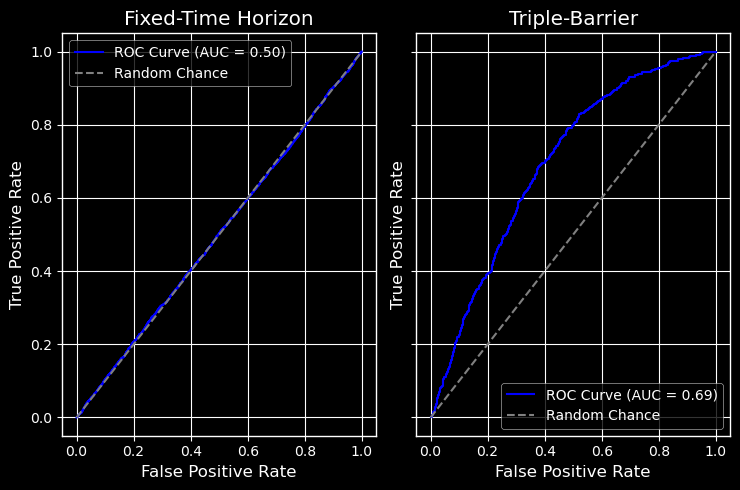
Figura 5: Curva ROC para el horizonte temporal fijo y los metamodelos de triple barrera
Interpretación de los resultados: Decodificando el rendimiento del modelo
El marcado contraste en estos resultados valida la tesis central: el etiquetado define el éxito. El informe de clasificación del modelo de horizonte temporal fijo revela un fallo fundamental en el aprendizaje; su incapacidad para distinguir señales por encima del azar se confirma gráficamente por su curva ROC, que permanece cercana a la diagonal, un sello distintivo de un clasificador inútil. En cambio, el informe del método de triple barrera muestra un modelo que ha identificado con éxito patrones predictivos, un hecho que se ve reforzado por la marcada curvatura de su curva ROC hacia la esquina superior izquierda, lo que indica un importante equilibrio entre la tasa de verdaderos positivos y la de falsos positivos. Este valor de AUC ROC, significativamente superior a 0,5, demuestra el poder predictivo tangible del modelo.
Más importante aún, las métricas de precisión se traducen directamente en la realidad del trading: una mayor precisión para la clase '1' significa que una mayor proporción de nuestras operaciones rentables previstas (metaetiquetas) tienen más probabilidades de ser correctas, lo que aumenta la rentabilidad potencial de la estrategia y proporciona una base estadística sólida para el dimensionamiento de posiciones basado en la confianza.
Importancia económica: Rendimiento fuera de la muestra
Si bien el modelo de triple barrera mostró una mejora estadísticamente significativa en el AUC, su verdadero valor se revela en la curva de capital de la estrategia simulada. La Figura 7 muestra que la estrategia que aprovecha nuestro nuevo método de etiquetado logró una rentabilidad del -0,03% con una caída máxima del 36,9%, superando significativamente a la estrategia de referencia de horizonte fijo, que logró una rentabilidad del -0,71% con una caída máxima del 76%.
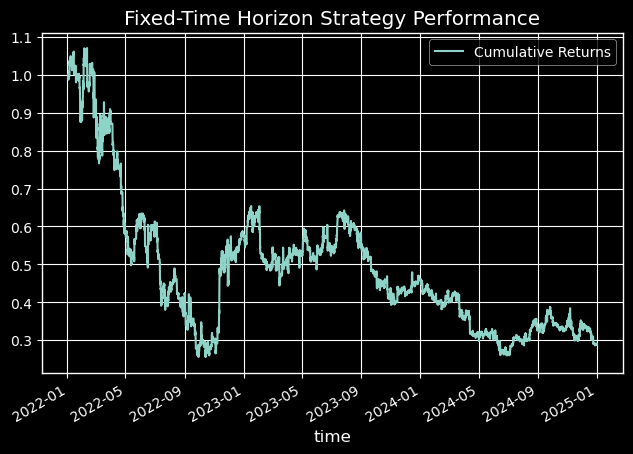
Figura 6: Horizonte temporal fijo Curva de rendimiento del capital
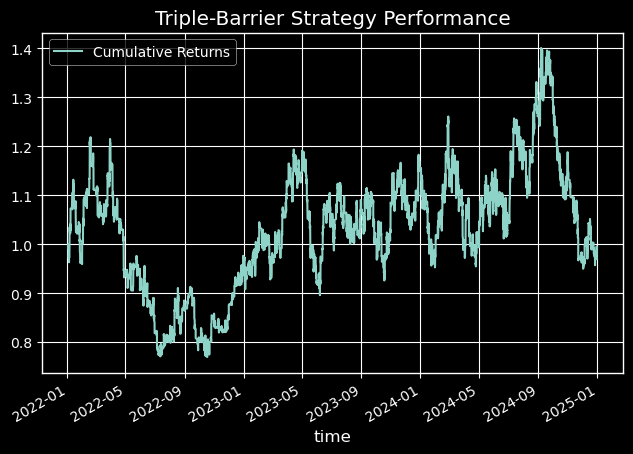
Figura 7: Curva de rendimiento de la estrategia de triple barrera
A continuación se muestra una tabla completa con las métricas de rendimiento para cada método de etiquetado:
| Métrica | Horizonte de tiempo fijo | Triple barrera |
|---|---|---|
| total_return | -0.709771 | -0.028839 |
| annualized_return | -0.338102 | -0.009714 |
| volatility | 0.483111 | 0.37613 |
| downside_volatility | 0.336945 | 0.231413 |
| sharpe_ratio | -4.778646 | -0.021566 |
| sortino_ratio | -6.851611 | -0.035053 |
| var_95 | -0.002864 | -0.00215 |
| cvar_95 | -0.004164 | -0.002992 |
| skewness | -0.014451 | 0.034745 |
| kurtosis | 3.857222 | 2.507046 |
| max_drawdown | 0.761708 | 0.368585 |
| avg_drawdown | 0.08375 | 0.039945 |
| drawdown_duration | 84 días 01:18:50 | 32 días 03:17:12 |
| ulcer_index | 0.217503 | 0.098507 |
| calmar_ratio | -0.443874 | -0.026354 |
| bet_frequency | 3901 | 3969 |
| bets_per_year | 1300.040115 | 1322.701671 |
| num_trades | 37691 | 27426 |
| trades_per_year | 12560.83363 | 9139.93853 |
| win_rate | 0.497546 | 0.504339 |
| avg_win | 0.001266 | 0.001081 |
| avg_loss | -0.001322 | -0.001105 |
| best_trade | 0.014599 | 0.01451 |
| worst_trade | -0.013828 | -0.010548 |
| profit_factor | 0.952754 | 0.999799 |
| expectancy | -0.000034 | -0.000002 |
| kelly_criterion | -0.027194 | -0.002226 |
| consecutive_wins | 77 | 92 |
| consecutive_losses | 66 | 90 |
| avg_trade_duration | 0 días 00:39:18 | 0 días 06:22:15 |
Tabla 6: Indicadores de rendimiento fuera de la muestra
Conclusión
En esta segunda entrega de Guía de aprendizaje automático para MetaTrader 5, hemos explorado cómo las decisiones de etiquetado influyen en el comportamiento y la fiabilidad de los modelos financieros. Al ir más allá de los horizontes temporales fijos y adoptar técnicas dependientes de la trayectoria, como el método de la triple barrera, hemos demostrado cómo incorporar la conciencia del riesgo y la dinámica comercial realista directamente en el proceso de aprendizaje.
El metaetiquetado surgió como una estrategia superpuesta que filtra las señales de baja convicción y mejora la precisión, especialmente cuando se combina con esquemas de etiquetado robustos. Los informes de clasificación y las curvas ROC demuestran cómo este enfoque por capas mejora la calidad de la señal, incluso bajo un filtrado agresivo.
Pero nuestro viaje está lejos de haber terminado.
En el próximo artículo, implementaremos el método de análisis de tendencias, que permite a los modelos seleccionar dinámicamente su horizonte de predicción en función de movimientos de precios estadísticamente significativos. Esto abre las puertas a un nuevo nivel de adaptabilidad en mercados volátiles.
También abordaremos el reto de la concurrencia en los datos financieros —en los que varias señales se solapan en el tiempo— mediante la introducción de ponderaciones de muestra que reflejen la singularidad y la relevancia de cada observación. Esto garantiza que nuestros modelos aprendan a partir de señales verdaderamente independientes, y no de ruido redundante.
Por último, analizaremos cómo aprovechar las probabilidades generadas por el metaetiquetado para calcular las apuestas de forma más inteligente. En lugar de una ejecución binaria, utilizaremos la confianza probabilística para ajustar el tamaño de las posiciones, alineando así la convicción del modelo con la asignación de capital.
En conjunto, estas mejoras nos acercarán a un pipeline de aprendizaje automático listo para producción en los mercados financieros, que no solo sea técnicamente sólido, sino que también esté estratégicamente alineado con el comportamiento real del trading.
Traducción del inglés realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/en/articles/18864
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.

 Utilizando redes neuronales en MetaTrader
 MetaTrader se une a Google Sheets con Pythonanywhere: guía para un flujo de datos seguro
 Particularidades del trabajo con números del tipo double en MQL4
 Creación de un sistema de trading (parte 3): Determinación de los niveles mínimos de riesgo para objetivos de beneficio realistas

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso
Hay algo que no acabo de entender:
Si entrenas los modelos no con los datos de ticks sin procesar, sino con barras construidas (tiempo, ticks, etc.), ¿tienes que construir esas barras durante la negociación en tiempo real?
Hay algo que no entiendo:
Si entrenas los modelos no con los datos de ticks sin procesar, sino con barras construidas (tiempo, ticks, etc.), ¿tienes que construir esas barras durante la negociación en tiempo real?