Red neuronal en la práctica: Una cuestión de escala
 133
 0

Introducción
En el artículo anterior, Red neuronal en la práctica: Perceptrón, se explicó de forma más adecuada y completa todo lo que hemos construido hasta ahora. Principalmente, se hizo una revisión para mostrar cómo las cosas van surgiendo de manera natural a medida que las matemáticas avanzan hacia lo que realmente necesitamos implementar.
En este artículo veremos y exploraremos la necesidad de modificar la escala de los datos que se utilizarán. El objetivo de este cambio resulta, en cierto modo, algo confuso para la mayoría de las personas, ya que muchos lo hacen sin comprender realmente por qué es necesario, mientras que otros simplemente creen que no hace falta hacerlo.
¿Por qué cambiar la escala de los datos?
Durante este artículo no prestaremos tanta atención al código, ni seguiremos hablando o mencionando los mínimos cuadrados, salvo en situaciones muy concretas. Aunque sigan presentes en el código de la clase C_Neuron, estarán allí únicamente porque será necesario explicar otra cuestión que todavía no hemos abordado y que utiliza precisamente la función de coste de mínimos cuadrados. A partir de ahora, el enfoque principal será el uso del gradiente. De cualquier forma, no quiero que te aferres demasiado a ninguna parte del código. Quiero que intentes entender por qué utilizar una cosa u otra y cuándo hacerlo.
La razón es muy sencilla: no existe una única forma perfecta de hacer las cosas cuando se habla de redes de perceptrones. Existe la forma que funciona y la que no funciona. Y, en muchos casos, la forma que funciona puede resultar bastante costosa desde el punto de vista computacional, por lo que será necesario ajustarla a un modelo más adecuado. Para ello, debes saber cómo modificar el código. A medida que vayamos añadiendo cada vez más entradas al perceptrón y aumentando el número de perceptrones, estas cuestiones tendrán cada vez más sentido, y las entenderás mejor en la práctica.
Existe una falsa sensación, entre el público general, de que una red de perceptrones, o una inteligencia artificial, puede, de algún modo, comprender el mundo en el que vivimos. En algunos casos, esto incluso puede ser cierto. Pero tú, que quieres conseguir que una red de perceptrones, o incluso un único perceptrón, converja lo más rápido posible, necesitas entender que la escala utilizada en los valores muchas veces termina influyendo en la velocidad de convergencia.
Esto puede parecer, en cierto modo, una tontería e incluso algo contrario a la intuición, ya que, durante la retropropagación, el valor del error hace que el perceptrón parezca dar saltos relativamente grandes al principio hacia un punto de convergencia. Y, a medida que pasa el tiempo, empezamos a dar pasos cada vez más pequeños en la corrección del error. Así que, a primera vista, cambiar la escala de los datos no tendría demasiada influencia. Bien, esto es cierto en muchas situaciones. Sin embargo, existen situaciones muy concretas en las que cambiar la escala de los valores sí puede mejorar de forma excepcional la velocidad de convergencia. Hay además otro factor que hace que el cambio de escala resulte bastante interesante. Este factor está relacionado con una cuestión que se explicará cuando hablemos de normalización y estandarización. Pero, adelantando un poco el tema, sería como si redujéramos en cierta medida el sesgo del aprendizaje. Muchas veces, una red, o incluso un perceptrón aislado, termina adquiriendo cierto sesgo precisamente porque está trabajando con datos sin procesar.
Una vez más, no siempre necesitamos hacer lo que se mostrará aquí. De hecho, todavía no estoy seguro de si mantendré lo que veremos aquí en algún código futuro. Como todavía no he tomado una decisión al respecto, necesitas entender que, dependiendo del propósito de tu red de perceptrones, o de tu perceptrón, tendrás que aplicar algún tipo de tratamiento a los datos antes incluso de que estos pasen por el perceptrón o por una red de perceptrones. Esto ocurre durante la fase de entrenamiento. Una vez terminado el entrenamiento, es posible que el tratamiento aplicado a los datos deje de ser necesario. Pero, una vez más, este tipo de situación debe analizarse con calma.
Una de las formas más sencillas de tratamiento consiste en cambiar la escala de los valores. Para comprender la importancia de este tratamiento, quiero que busques en el mercado financiero un símbolo que pague dividendos. Si observas el gráfico histórico de ese mismo símbolo, notarás que el tamaño de las barras va disminuyendo gradualmente, al igual que la cotización del símbolo. Esto nos da la falsa impresión de que el movimiento porcentual ha cambiado con el paso del tiempo, aunque la cotización del símbolo se haya mantenido aproximadamente en el mismo nivel a lo largo del tiempo. Nuestra percepción superficial de las cosas nos indicará exactamente lo contrario de lo que ocurre en realidad. Y este tipo de situación termina generándonos un sesgo.
Lo mismo ocurre durante el entrenamiento de una red de perceptrones, o de un perceptrón. Si los datos se presentan de una determinada manera, el cálculo realizado construirá una ecuación completamente sesgada. Y esto ocurre precisamente porque se está llevando al sistema a utilizar valores bastante diferentes cuando, en realidad, se encontrarían dentro de un mismo rango, lo que demuestra que el símbolo no presenta el movimiento que creemos estar observando. Esto termina forzando al sistema a generar un falso positivo o un falso negativo.
Por ahora, solo estoy introduciendo este tema, ya que se explorará con mayor profundidad cuando hablemos de normalización y estandarización. Allí notarás realmente hasta qué punto este tratamiento puede marcar la diferencia, ya que puede ayudar mucho, pero también perjudicar considerablemente si no se toman todas las precauciones necesarias para evitar la dispersión de los datos. Aquí, por el momento, la idea es bastante más sencilla de comprender y servirá únicamente como base para algo mucho más profundo.
Para que puedas entenderlo un poco mejor, pensemos en un bloque de datos cuyos valores estén distribuidos entre cero y quince mil. Para el perceptrón, o incluso una red de perceptrones, esta distribución importa poco, ya que, al final, las variables internas que conocemos como pesos y sesgo se ajustarán para crear una ecuación que represente la dispersión de esos datos. Así que, aunque cambiemos la escala para que quede comprendida entre cero y uno, en principio esto no supondrá una gran diferencia, siempre que mantengamos la misma distribución.
Aunque el cambio de escala no altere esa distribución, sí puede hacer que la factorización sea algo más eficiente. Recuerda que comenzamos con los valores internos situados entre cero y uno, de forma pseudoaleatoria. Aunque el perceptrón, utilizando el gradiente, intente analizar rápidamente el bloque de datos y converger hacia alguna solución, al principio podemos tener un error gigantesco que irá disminuyendo poco a poco. Sin embargo, si comenzamos con una escala diferente, ese error podrá ser considerablemente menor o mayor e incluso lo bastante pequeño como para aproximarse al error estimado.
Así, cuando volvamos a aumentar la escala, el perceptrón, o la red, ya no estará tan sesgado, puesto que existirá un margen de error mayor entre los cálculos realizados por el perceptrón, o la red, y los valores estimados. Y, si tenemos valores estimados muy próximos entre sí, el perceptrón, o la red, no sabrá exactamente cuál es el valor correcto, lo que nos dará la oportunidad de estudiar cuál sería el valor más adecuado. Esto se debe a que el perceptrón, o la red, podría indicarnos cuáles son los valores más próximos al valor correcto. Y esto no ocurre cuando la red o el perceptrón ya se encuentra, de algún modo, sesgado por un determinado conjunto de datos.
Así que aquí nos centraremos precisamente en la cuestión de la escala. Lo haremos antes incluso de intentar entender por qué necesitamos normalizar o estandarizar los valores de una base de datos. En cierto modo, estandarizar o incluso normalizar los datos no es más que hacer que una dispersión de valores quede comprendida dentro de un rango específico. Aunque en principio parezcan cosas diferentes, el objetivo principal es el mismo. Así que, para empezar a verlo en forma de código, vamos a abrir un nuevo tema y separar mejor las cosas.
Diferencia entre escalas
Lo primero en lo que debemos pensar está directamente relacionado con las matemáticas. Quiero que primero entiendas esto para que no imagines que estamos haciendo una cosa cuando, en realidad, estemos haciendo otra.
Básicamente, existen dos tipos de escalas bastante conocidas. Una es la escala aritmética y la otra es la escala logarítmica. Pero ¿cuál debemos utilizar? O, mejor dicho, ¿cuándo utilizar una y cuándo la otra? Bien, probablemente, al oír hablar de estas escalas, pienses en el gráfico de algún símbolo. Aunque no te equivocas al pensar así, la idea y, sobre todo, el concepto de escala no están directamente relacionados con el mercado financiero. La escala sirve para ayudarnos a dimensionar de forma más adecuada valores que, de otro modo, serían mucho más difíciles de medir.
Por ejemplo, cuando utilizamos una regla para medir algo, probablemente estaremos usando una escala aritmética, ya que sería mucho más complicado comprender y comparar cosas diferentes si el valor no progresara de manera lineal. Y precisamente aquí reside la gran diferencia entre estas dos escalas. La escala logarítmica no tiene una progresión lineal. Aunque pueda parecer una locura intentar medir algo utilizando una escala logarítmica, lo cierto es que tiene muchas aplicaciones, como, por ejemplo, medir la amplitud de una señal o incluso la magnitud de una fuerza.
Observa que, en estos casos, no existe la posibilidad de tener un valor negativo. Aunque podemos utilizar valores negativos en logaritmos, esto nos obligaría a trabajar con números complejos. Eso solo complicaría toda la explicación y nos alejaría por completo del objetivo de este artículo. Así que vamos a quedarnos únicamente con la parte sencilla de la idea de escala.
En resumen: si necesitas medir valores tanto positivos como negativos y estos deben progresar de manera gradual y siempre lineal, utilizamos la escala aritmética. Si los datos que deben medirse aumentan de valor muy rápidamente y no pueden asumir valores negativos, es preferible utilizar la escala logarítmica. Básicamente, eso es todo. Pero solo la práctica te ayudará a elegir la mejor opción en cada caso concreto.
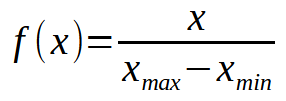
Imagen 01
Puede que esto parezca una tontería. Pero presta atención a una cosa: podemos cambiar el valor de < x > simplemente modificando el rango. En este caso, no vamos a imponer un valor concreto, sino a llevarlo a un determinado intervalo de valores. Tal vez la expresión anterior no tenga demasiado sentido a primera vista. Así que vamos a desarrollarla un poco. Quizá de ese modo empiece a tener algo más de sentido para ti.
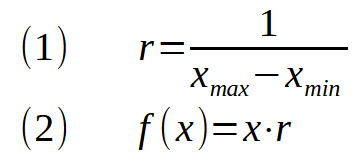
Imagen 02
La expresión (1) indica en qué medida modificaremos la relación de escala. Si el valor de < r >, en la expresión (2), es menor que uno, tendremos una compresión de los valores. Si es mayor que uno, tendremos una ampliación de los valores. Sería como aumentar o reducir el zoom dentro del sistema.
En el caso de la escala logarítmica, la expresión es un poco diferente, como probablemente ya imaginas. El detalle es que podemos utilizar cualquier base para representar los datos. Pero, por lo general, se utiliza la base diez o la base e, que da lugar al logaritmo natural, conocido como ln. Es posible que ni siquiera explique esta parte de la escala logarítmica, ya que, en términos de programación, es muy parecida a lo que veremos aquí.
Ahora, para pasar a la parte práctica y dar sentido a lo explicado, vamos a tomar el código del artículo anterior y modificar únicamente los datos de entrenamiento. No haremos nada más. Es importante que veas y entiendas que ese será el único cambio. Así pues, en el código original tenemos el siguiente fragmento:
//+------------------------------------------------------------------+
//Training expression: f(x) = (w0 * 1.8) + (w1 * 2.15) + 2.1
//+------------------------------------------------------------------+
double Train[] {
                  1,    3,  10.35,
                1.5,  3.25, 11.7875,
                1.75, 3.94, 13.721,
                2.85, 3.46, 14.669
               };
//+------------------------------------------------------------------+
#define nColumns    3
#define nLines      Train.Size() / nColumns
//+------------------------------------------------------------------+
Fragmento 01
Este fragmento será sustituido por el que se muestra a continuación:
//+------------------------------------------------------------------+
//Training expression: f(x) = (w0 * 1.8) + (w1 * 1.254) + (w2 * 2.35) + 4.1258
//+------------------------------------------------------------------+
double Train[] {
                5.89,   12.473, 18.452,  73.731142,
                8.452,  13.154, 24.2541, 92.831651,
                7.512,  14.576, 15.831,  73.128554,
                3.452,  8.459,  30.1254, 91.741676
               };
//+------------------------------------------------------------------+
#define nColumns    4
#define nLines      Train.Size() / nColumns
//+------------------------------------------------------------------+
Fragmento 02
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. #property script_show_inputs
04. #property description   "Script to compare execution speed\n" \
05.                         "Here we are using only the CPU.\n" \
06.                         "However, the results are still very interesting."
07. //+------------------------------------------------------------------+
08. #include <Neural Network\C_Check_Neuron.mqh>
09. //+------------------------------------------------------------------+
10. enum eFactorization {
11.                         Minimum_Square,
12.                         Gradient_Descent,
13.                     };
14. //+------------------------------------------------------------------+
15. input eFactorization        user00 = Minimum_Square;        //Type of factorization
16. input double                user01 = 1e-3;                  //Estimated error
17. input double                user02 = 1e-3;                  //Learning Rate
18. input C_Neuron::eFnActivate user03 = C_Neuron::Identity;    //Activation function
19. input ulong                 user04 = 5;                     //Number of interactions
20. //+------------------------------------------------------------------+
21. //Training expression: f(x) = (w0 * 1.8) + (w1 * 1.254) + (w2 * 2.35) + 4.1258
22. //+------------------------------------------------------------------+
23. double Train[] {
24.                 5.89,       12.473, 18.452,  73.731142,
25.                 8.452,      13.154, 24.2541, 92.831651,
26.                 7.512,      14.576, 15.831,  73.128554,
27.                 3.452,      8.459,  30.1254, 91.741676
28.                };
29. //+------------------------------------------------------------------+
30. #define nColumns    4
31. #define nLines      Train.Size() / nColumns
32. //+------------------------------------------------------------------+
33. void OnStart()
34. {
35.     C_Check_Neuron *neuron;
36.
37.     Print("************************************");
38.     Print("Simple Neuron in Class...");
39.     Print("************************************");
40.     Print("Parameters:");
41.     Print("Type of factorization: ", EnumToString(user00));
42.     Print("Estimated error: ", user01);
43.     Print("Learning Rate:", user02);
44.     Print("Activation function: ", EnumToString(user03));
45.     Print("Number of interactions: ", user04);
46.     Print("************************************");
47.
48.     neuron = new C_Check_Neuron(nColumns - 1, user03, user00 == Minimum_Square);
49.
50.     (*neuron).View_Training_Data(Train, nColumns);
51.     (*neuron).Performs_Training(Train, user01, user02, user04);
52.     // (*neuron).Check_Training(Train, nColumns);
53.
54.     delete neuron;
55. }
56. //+------------------------------------------------------------------+
Código 01
Observa que, además del array de entrenamiento modificado, también tenemos la línea diecinueve. Esta permitirá configurar el número de iteraciones que realizará el código. Por motivos prácticos, la línea cincuenta y dos, encargada de mostrar los resultados, se ha comentado, por lo que dejará de ejecutarse. Sin embargo, esto importa poco, ya que lo que realmente necesitamos es que se ejecute la línea cincuenta y uno, pues será la que nos muestre el error que presenta el perceptrón para ese número de iteraciones. Ahora observa qué ocurre cuando ejecutamos este código en el terminal de MetaTrader 5. El resultado se muestra en la imagen inferior.
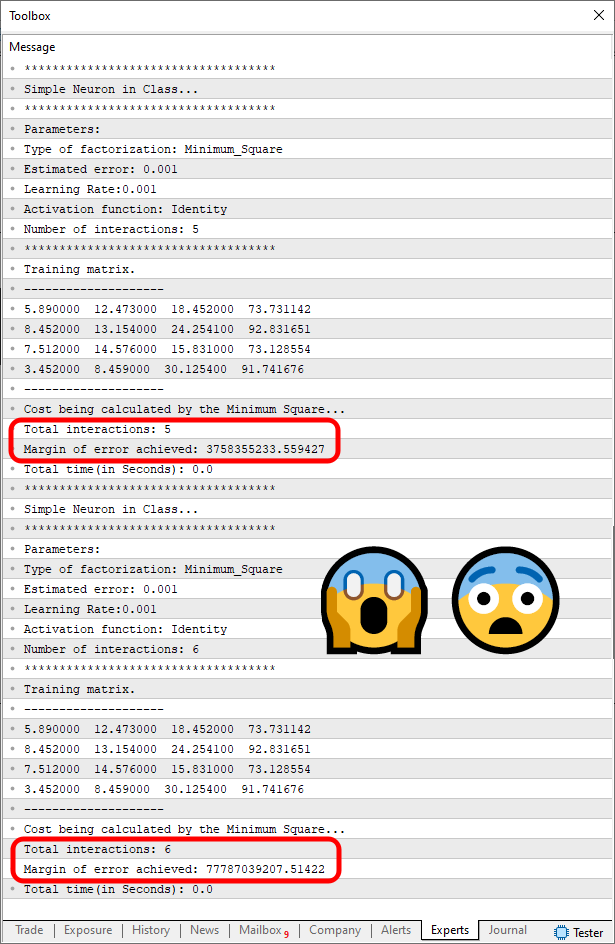
Imagen 03
Para facilitar la visualización, he marcado el punto exacto donde podemos ver el error que presenta el perceptrón. Y, para tu sorpresa, observa que el error no ha disminuido, sino que ha aumentado, y mucho. Esto significa que el perceptrón no puede manejar los datos presentes en el array de entrenamiento. Pero ¿por qué? Si cambias los valores, verás que el perceptrón funciona. Pero, cuando nos salimos de ciertos límites, simplemente parece volverse un poco loco, completamente perdido, sin saber hacia dónde ir.
Este es uno de los problemas que, para poder resolver, tendremos que modificar la escala de los valores. Presta atención a lo que acabo de decir. No estoy diciendo que tengas que buscar valores adecuados para utilizarlos. Te estoy diciendo que engañes al perceptrón, haciendo que crea que está manejando una cosa cuando, en realidad, está manejando otra diferente.
Existen diversas formas de hacerlo, cada una con un propósito diferente y un objetivo muy concreto. Pero aquí, como la intención es ser lo más didáctico posible, vamos a utilizar una forma especialmente útil para explicarlo. Haremos que la propia aplicación, que en este caso es un script para MetaTrader 5, modifique los valores de manera que el perceptrón bobo no se dé cuenta de que las cosas son diferentes. Para ello, vamos al código de la clase C_Check_Neuron.
Un detalle: en el archivo adjunto dejaré el código original, para que puedas ver los resultados tal como los mostré en la imagen superior, y también el código que implementaremos ahora. Así podrás entender, en la práctica, cómo y por qué necesitamos hacer las cosas de una determinada manera.
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. #include <Neural Network\C_Neuron.mqh>
05. //+------------------------------------------------------------------+
06. class C_Check_Neuron : private C_Neuron
07. {
08. //+------------------------------------------------------------------+
09.     private :
10. //+------------------------------------------------------------------+
11.         struct st_0
12.         {
13.             double  Hi,
14.                     Lo,
15.                     Reason;
16.             uint    nColumns,
17.                     nLines;
18.         }m_Limits;
19.         double m_arr[];
20. //+------------------------------------------------------------------+
21.     public  :
22. //+------------------------------------------------------------------+
23.         C_Check_Neuron(const double &arr[], uint nInputs = 1, eFnActivate fn = Identity, bool isFx = false)
24.             :C_Neuron(nInputs, fn, isFx)
25.         {
26.             ZeroMemory(m_Limits);
27.             m_Limits.nColumns = nInputs + 1;
28.             m_Limits.nLines = arr.Size() / m_Limits.nColumns;
29.             m_Limits.Lo = m_Limits.Hi = arr[0];
30.             for (ulong c = 1, m = arr.Size(); c < m; c++)
31.             {
32.                 m_Limits.Hi = MathMax(arr[c], m_Limits.Hi);
33.                 m_Limits.Lo = MathMin(arr[c], m_Limits.Lo);
34.             };
35.             ArrayResize(m_arr, arr.Size());
36.             m_Limits.Reason = 1 / (m_Limits.Hi - m_Limits.Lo);
37.             for (ulong c = 0, m = arr.Size(); c < m; c++)
38.                 m_arr[c] = arr[c] * m_Limits.Reason;
39.         }
40. //+------------------------------------------------------------------+
41.         ~C_Check_Neuron()
42.         {
43.             ArrayFree(m_arr);
44.         }
45. //+------------------------------------------------------------------+
46.         void View_Training_Data(void)
47.         {
48.             string sz0;
49.
50.             Print("Training matrix.");
51.             Print("--------------------");
52.             for (uchar i = 0; i < m_Limits.nLines; i++)
53.             {
54.                 sz0 = "";
55.                 for (uchar j = 0; j < m_Limits.nColumns; j++)
56.                     sz0 += StringFormat("%f  ", m_arr[(i * m_Limits.nColumns) + j]);
57.                 Print(sz0);
58.             }
59.             Print("--------------------");
60.         }
61. //+------------------------------------------------------------------+
62.         void Performs_Training(double epsilon, double LearningRate, ulong limit)
63.         {
64.             ulong it0, it1;
65.
66.             it0 = GetTickCount();
67.             Print("Margin of error achieved: ", Learning(m_arr, epsilon, LearningRate, limit));
68.             it1 = GetTickCount();
69.             Print("Total time(in Seconds): ", (it1 - it0) / 1000.0);
70.         }
71. //+------------------------------------------------------------------+
72.         void Check_Training(const double &arr[])
73.         {
74.             string  sz0;
75.             double  mem[];
76.
77.             Print("********** RESULT *************");
78.             ArrayResize(mem, m_Limits.nColumns);
79.             for (uchar i = 0; i < m_Limits.nLines; i++)
80.             {
81.                 sz0 = "";
82.                 for (uchar j = 0; j < m_Limits.nColumns - 1; j++)
83.                     sz0 += StringFormat("%f  ", mem[j] = arr[(i * m_Limits.nColumns) + j]);
84.                 sz0 += StringFormat("%f", Perceptron(mem));
85.                 Print(sz0);
86.             }
87.             Print("--------------------");
88.             ArrayFree(mem);
89.             View_Variables();
90.         }
91. //+------------------------------------------------------------------+
92. };
93. //+------------------------------------------------------------------+
Código 02
Este código todavía no está terminado y aún tiene un pequeño problema. Pero lo veremos más adelante con mayor detenimiento. Primero, observa que se ha añadido una estructura en la línea once. Su objetivo es crear el mecanismo que utilizaremos para engañar al perceptrón bobo. Observa que tenemos un array declarado en la línea diecinueve. Ahora viene lo curioso. En la línea veintitrés, donde el constructor ahora recibe un array, tendremos que utilizar este nuevo array de entrenamiento.
Ahora presta atención a lo que vamos a hacer. Primero, en la línea veintiséis, limpiamos la región de memoria donde se encuentra la estructura de datos. A continuación, inicializamos algunos valores de esta estructura, y la razón de limpiar la memoria es evitar trabajar con basura. Aunque después asignemos valores, siempre conviene asegurarnos de que todo esté limpio, porque podemos olvidarnos de asignar alguno y entonces las cosas se complican. Ahora viene la parte divertida. En la línea veintinueve inicializamos los valores máximo y mínimo e inmediatamente después entramos en el bucle que recorrerá todo el array de entrenamiento buscando el mayor y el menor valor presentes en él.
Después, en la línea treinta y cinco, asignamos memoria al array interno de la clase. En la línea treinta y seis aplicamos la ecuación vista anteriormente en este artículo para crear una escala aritmética. Así, en la línea treinta y siete entramos en un nuevo bucle. Pero esta vez crearemos un array de entrenamiento falso a partir del array de entrenamiento original. Así finalizamos el constructor.
//+------------------------------------------------------------------+
void OnStart()
{
    C_Check_Neuron *neuron;

    Print("************************************");
    Print("Simple Neuron in Class...");
    Print("************************************");
    Print("Parameters:");
    Print("Type of factorization: ", EnumToString(user00));
    Print("Estimated error: ", user01);
    Print("Learning Rate:", user02);
    Print("Activation function: ", EnumToString(user03));
    Print("Number of interactions: ", user04);
    Print("************************************");

    neuron = new C_Check_Neuron(Train, nColumns - 1, user03, user00 == Minimum_Square);

    (*neuron).View_Training_Data();
    (*neuron).Performs_Training(user01, user02, user04);
    // (*neuron).Check_Training(Train);

    delete neuron;
}
//+------------------------------------------------------------------+
Fragmento 03
Aquí destaco únicamente la parte que cambió en el código. No hay nada que necesite explicación, dada la sencillez del asunto. Pero observa ahora qué ocurre cuando compilamos y ejecutamos este código en el terminal de MetaTrader 5. El resultado se muestra en la imagen inferior.
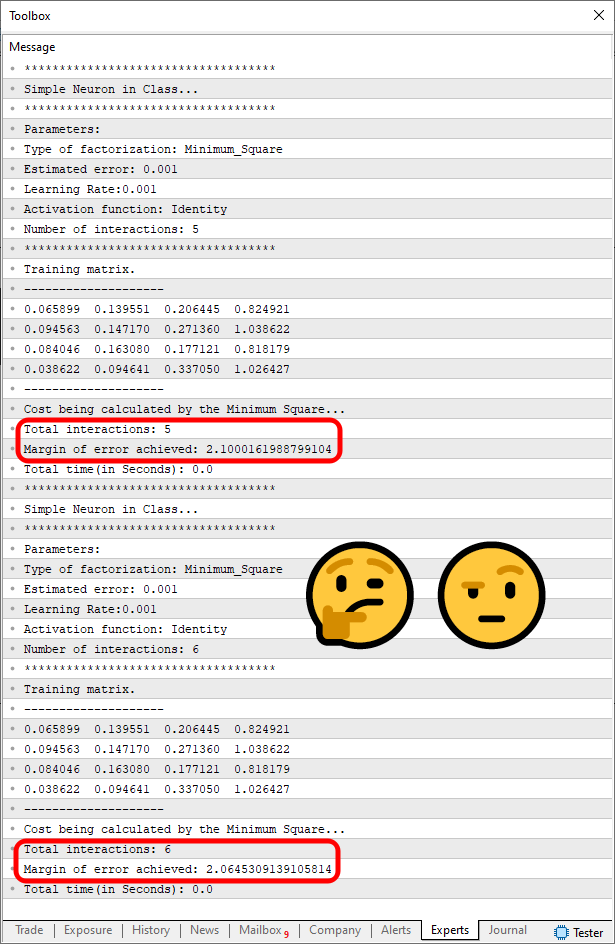
Imagen 04
Pero ¿qué diablos es esto? Esto no puede ser cosa de DIOS. ¿Cómo es posible que ahora el perceptrón haya entendido la situación y haya empezado a converger? ¿Qué locura acaba de ocurrir? Amigo mío, hay cosas que solo se pueden entender y creer cuando se ven. Si simplemente lo contaras, nadie te creería y diría que no tienes ni idea de lo que estás explicando o, como mínimo, que no sabes lo que estás haciendo. Pero puedes observar, con toda claridad, que el perceptrón ha cambiado su comportamiento. Y todo por el simple hecho de haber cambiado la escala de los valores. ¿Es o no es una locura? Y todavía hay gente que cree haberlo visto todo en esta vida. Yo digo: «No sabes nada, inocente».
45. //+------------------------------------------------------------------+
46.         void View_Training_Data(void)
47.         {
48.             string sz0;
49.
50.             Print("Training matrix.");
51.             Print("--------------------");
52.             for (uchar i = 0; i < m_Limits.nLines; i++)
53.             {
54.                 sz0 = "";
55.                 for (uchar j = 0; j < m_Limits.nColumns; j++)
56.                     sz0 += StringFormat("%f  ", m_arr[(i * m_Limits.nColumns) + j] / m_Limits.Reason);
57.                 Print(sz0);
58.             }
59.             Print("--------------------");
60.         }
61. //+------------------------------------------------------------------+
Fragmento 04
Bien, ahora compilamos y ejecutamos nuevamente el código. Obtendremos el siguiente resultado, que se muestra en la imagen inferior:
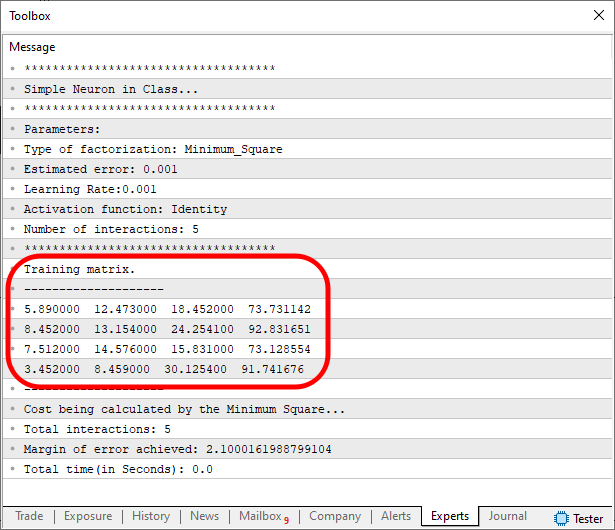
Imagen 05
Ahora sí. Además de engañar al perceptrón bobo y estúpido, también estamos mostrando al inocente usuario que todo está perfecto. Pero todavía tenemos otro problema. Para detectar este nuevo problema, es necesario volver a habilitar el código que muestra los resultados. Además de dejar que el perceptrón converja hasta alcanzar un valor de error más adecuado, ya que sabemos que ahora sí está convergiendo, podremos eliminar la posibilidad de ajuste por parte del usuario y dejar el código como se muestra a continuación.
//+------------------------------------------------------------------+
void OnStart()
{
    C_Check_Neuron *neuron;

    Print("************************************");
    Print("Simple Neuron in Class...");
    Print("************************************");
    Print("Parameters:");
    Print("Type of factorization: ", EnumToString(user00));
    Print("Estimated error: ", user01);
    Print("Learning Rate:", user02);
    Print("Activation function: ", EnumToString(user03));
    Print("************************************");

    neuron = new C_Check_Neuron(Train, nColumns - 1, user03, user00 == Minimum_Square);

    (*neuron).View_Training_Data();
    (*neuron).Performs_Training(user01, user02, ULONG_MAX);
    (*neuron).Check_Training(Train);

    delete neuron;
}
//+------------------------------------------------------------------+
Código 03
Una vez más, compilamos y ejecutamos la nueva versión del código y el resultado en el terminal de MetaTrader 5 será el siguiente:
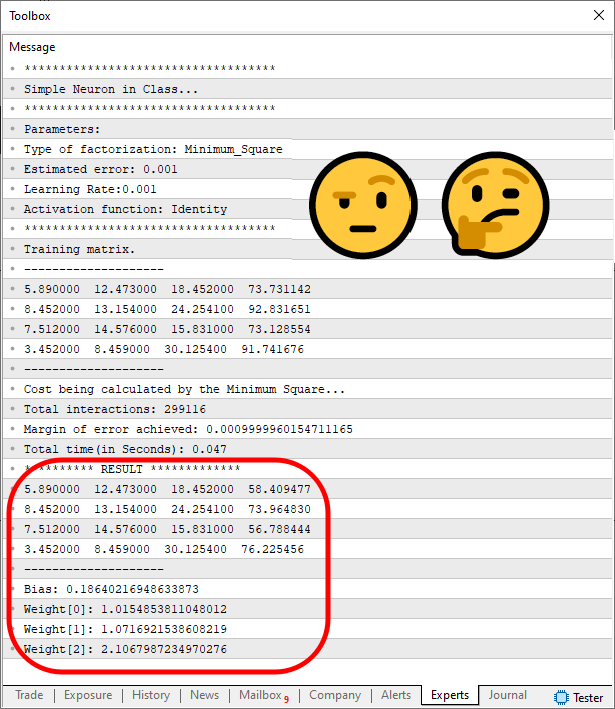
Imagen 06
Pero espera un momento. Esto no está bien. ¿Qué ha ocurrido para que el resultado haya quedado así de mal? Bien, mi querido lector, la vida de un programador no siempre es perfecta ni tranquila. A veces tenemos que entender lo que estamos haciendo; de lo contrario, terminamos encontrando una respuesta que no comprendemos. Y, al no comprenderla, acabamos renunciando a la solución, incluso cuando esta no está tan equivocada como podría parecer a primera vista. Por esta razón, vamos a intentar entender qué ocurrió para que el resultado fuera tan diferente de lo previsto.
Para ello, necesitamos recurrir a un programa matemático en el que podamos trazar un gráfico en pantalla. Así será más sencillo entender qué está ocurriendo aquí. Utilizaré el código que se muestra a continuación en SciLab, que es gratuito, aunque también podría utilizarse MatLab. Ambos muestran el mismo tipo de resultado.
clc;
clear;
clf;

x = [-2:0.01:2];
y =  (1.8 * x) + (1.254 * x) + (2.35 * x) + 4.1258;
plot(x, y, 'p-');

y = (1.0154853811048012 * x) + (1.0716921538608219 * x) + (2.1067987234970276 * x) + 0.18640216948633873;
plot(x, y, 'r-');

xgrid(0, 1);
Script SciLab
El resultado se muestra a continuación.
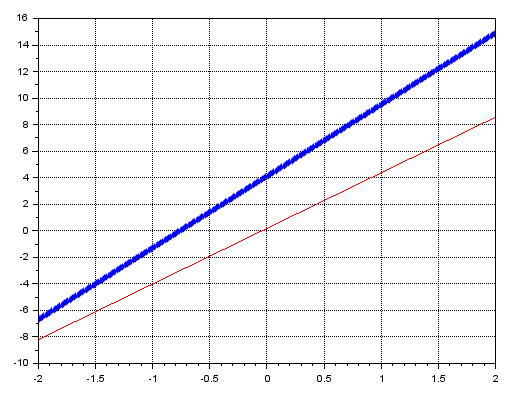
Imagen 07
//+------------------------------------------------------------------+
        inline double Learning(const double &train[], double reason, double epsilon, double LearningRate, ulong limit = ULONG_MAX)
        {
           double err = (m_Infos.IsFx ? Learning_FX(train, epsilon, LearningRate, limit) : Learning_DX(train, epsilon, LearningRate, limit));

           m_Infos.Bias /= reason;

           return err;
        }
 //+------------------------------------------------------------------+
Fragmento 05
//+------------------------------------------------------------------+
        void Performs_Training(double epsilon, double LearningRate, ulong limit)
        {
            ulong it0, it1;

            it0 = GetTickCount();
            Print("Margin of error achieved: ", Learning(m_arr, m_Limits.Reason, epsilon, LearningRate, limit));
            it1 = GetTickCount();
            Print("Total time(in Seconds): ", (it1 - it0) / 1000.0);
        }
//+------------------------------------------------------------------+
Fragmento 06
Así solucionamos una parte del problema. Ahora volvemos a ejecutar el script y obtendremos el siguiente resultado.
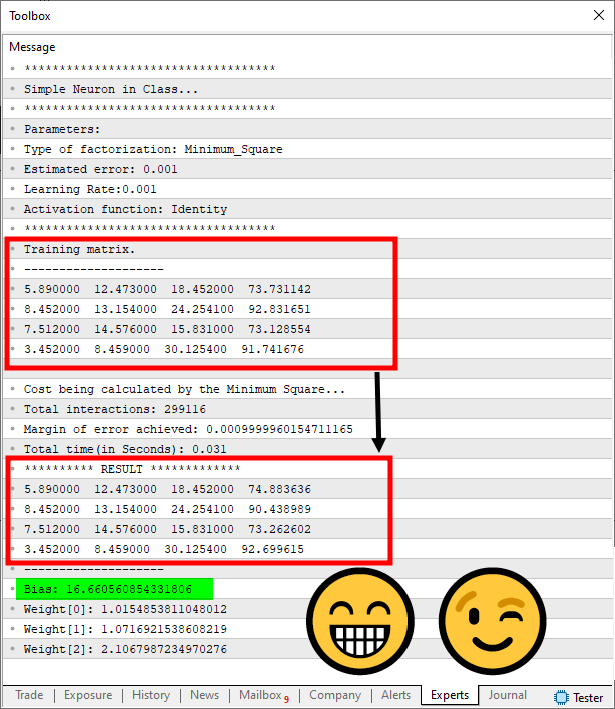
Imagen 08
clc;
clear;
clf;

x = [-2:0.01:2];
y =  (1.8 * x) + (1.254 * x) + (2.35 * x) + 4.1258;
plot(x, y, 'p-');

y = (1.0154853811048012 * x) + (1.0716921538608219 * x) + (2.1067987234970276 * x) + 0.18640216948633873;
plot(x, y, 'r-');


y = (1.0154853811048012 * x) + (1.0716921538608219 * x) + (2.1067987234970276 * x) + 16.660560854331806;
plot(x, y, 'g-');


xgrid(0, 1);
Script SciLab
Obtendremos el siguiente gráfico.
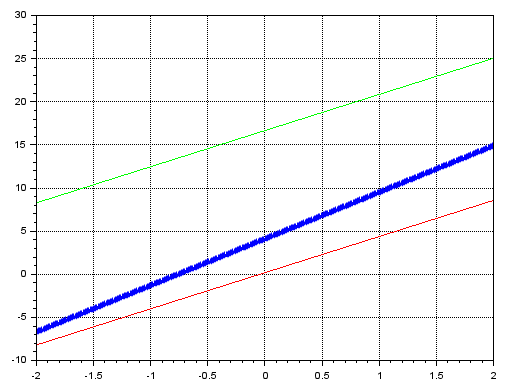
Imagen 09
Observa que la línea verde representa los valores obtenidos después de haber ajustado el sesgo. Aunque estos valores pueden ser adecuados para algunas situaciones, es posible que no lo sean para muchas otras. Así que, para intentar mejorar un poco más las cosas, modificamos el valor del error estimado y la tasa de aprendizaje. Como los valores predeterminados son del orden de 1e-3, vamos a intentar utilizar un valor de 1e-5 tanto para el error estimado como para la tasa de aprendizaje. Obtendremos el resultado que se muestra en la imagen inferior:
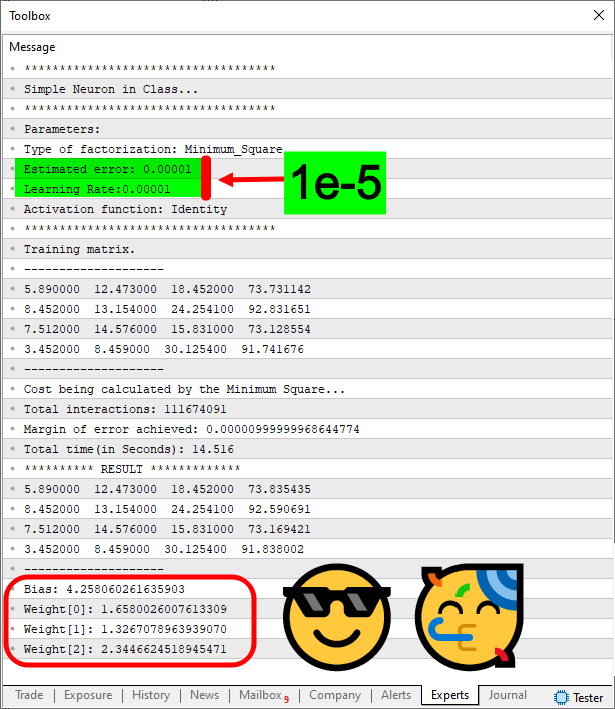
Imagen 10
clc;
clear;
clf;

x = [-2:0.25:2];
y =  (1.8 * x) + (1.254 * x) + (2.35 * x) + 4.1258;
plot(x, y, 'p-');

y = (1.0154853811048012 * x) + (1.0716921538608219 * x) + (2.1067987234970276 * x) + 0.18640216948633873;
plot(x, y, 'r-');


y = (1.0154853811048012 * x) + (1.0716921538608219 * x) + (2.1067987234970276 * x) + 16.660560854331806;
plot(x, y, 'g-');

y = (1.6580026007613309 * x) + (1.3267078963939070 * x) + (2.3446624518945471 * x) + 4.258060261635903;
plot(x, y, 'mo');

xgrid(0, 1);
Script SciLab
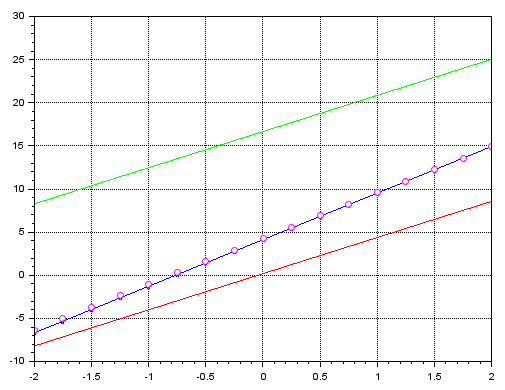
Imagen 11
Observa algo interesante. La línea azul representa los datos de entrenamiento reales. La línea verde representa el error cuando realizamos un entrenamiento con un error estimado y una tasa de aprendizaje de 1e-3. Los pequeños círculos de color púrpura representan el resultado cuando utilizamos el mismo código, pero con valores de 1e-5. Este tipo de resultado es realmente sorprendente.
Consideraciones finales
En este artículo he mostrado que todavía tenemos mucho que estudiar antes de pensar que ya lo sabemos todo. Ya he mencionado varias veces que, a pesar de todos los avances, LA HUMANIDAD TODAVÍA NO SABE CÓMO CREAR UNA RED DE PERCEPTRONES DEFINITIVA. Lo que hacemos es investigar e intentar aprender de nuestros propios aciertos y errores.
No estoy aquí para difamar ni ofender a nadie, ni siquiera necesito demostrar nada a nadie. Estoy aquí simplemente para compartir un poco de mi experiencia como programador. Y, como ha quedado claro en este artículo, no basta con recopilar un conjunto de datos para crear algo realmente capaz de simular la mente humana.
Hay detalles que muchos desconocen. Pero después de leer este artículo, ya entiendes que muchas veces necesitamos ajustar el código para convertir datos aparentemente dispersos en algo realmente utilizable.
| Archivo MQ5 | Descripción |
|---|---|
| Scripts\Example A | Demostración básica |
Traducción del portugués realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/pt/articles/13942
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.